Warum übersieht Ihre OCR Dezimalpunkte
& Währungssymbole?
Wenn Ihr OCR-Tool gerade $154.99 in $15499 verwandelt hat – und damit einen Rechnungsbetrag um das 100-Fache aufbläht – sind Sie nicht allein. Dies ist einer der am häufigsten gemeldeten Datenextraktionsfehler in der Kreditorenbuchhaltung und im Ausgabenmanagement. Das Problem hat vier klar unterscheidbare Ursachen, und zu wissen, welche Ihr Dokument betrifft, ist der schnellste Weg zur Lösung.
Wichtigste Erkenntnisse
- OCR-Tools werben mit 99 % Zeichengenauigkeit, konzentrieren ihre 1 % Fehlerquote jedoch auf genau das Zeichen, das Ihren Rechnungsbetrag um den Faktor 100 aufbläht.
- Jeder Dezimalpunktfehler trägt einen erkennbaren Fingerabdruck, der auf eine von nur vier Ursachen zurückgeht – von JPEG-Komprimierung, die 2-Pixel-Punkte verwirft, bis zu europäischen Komma-Dezimalen, die in den USA trainierte Engines verwirren.
- Wenn Sie diesen Fingerabdruck seiner Ursache zuordnen, hören Sie auf, blind Auflösungseinstellungen durchzuprobieren, und wenden auf Anhieb die eine Lösung an, die das eigentliche Problem behebt.
Die Kosten gehen über eine falsche Zahl auf dem Bildschirm hinaus. Gemäß den SOX-Compliance-Anforderungen müssen börsennotierte Unternehmen vollständige und genaue Finanzunterlagen führen – ein Dezimalfehler in einer automatisierten Pipeline ist ein Compliance-Risiko. Für jedes Unternehmen bedeutet eine Zahlung von 15.499,00 $ gegen eine Rechnung über 154,99 $ eine Überzahlung von 15.344,01 $, bis der Monatsabschluss es aufdeckt. Die meisten OCR-Engines werben mit 99 % Zeichengenauigkeit, aber diese Zahl ist irreführend, wenn ein einzelner Zeichenfehler in einem numerischen Feld eine gesamte Datenzeile zerstören kann. Hier ist, was diese Fehler auf Pixelebene verursacht – und wie man sie stoppt.
Ursache 1: Kompression mit niedriger Auflösung löscht winzige Punkte
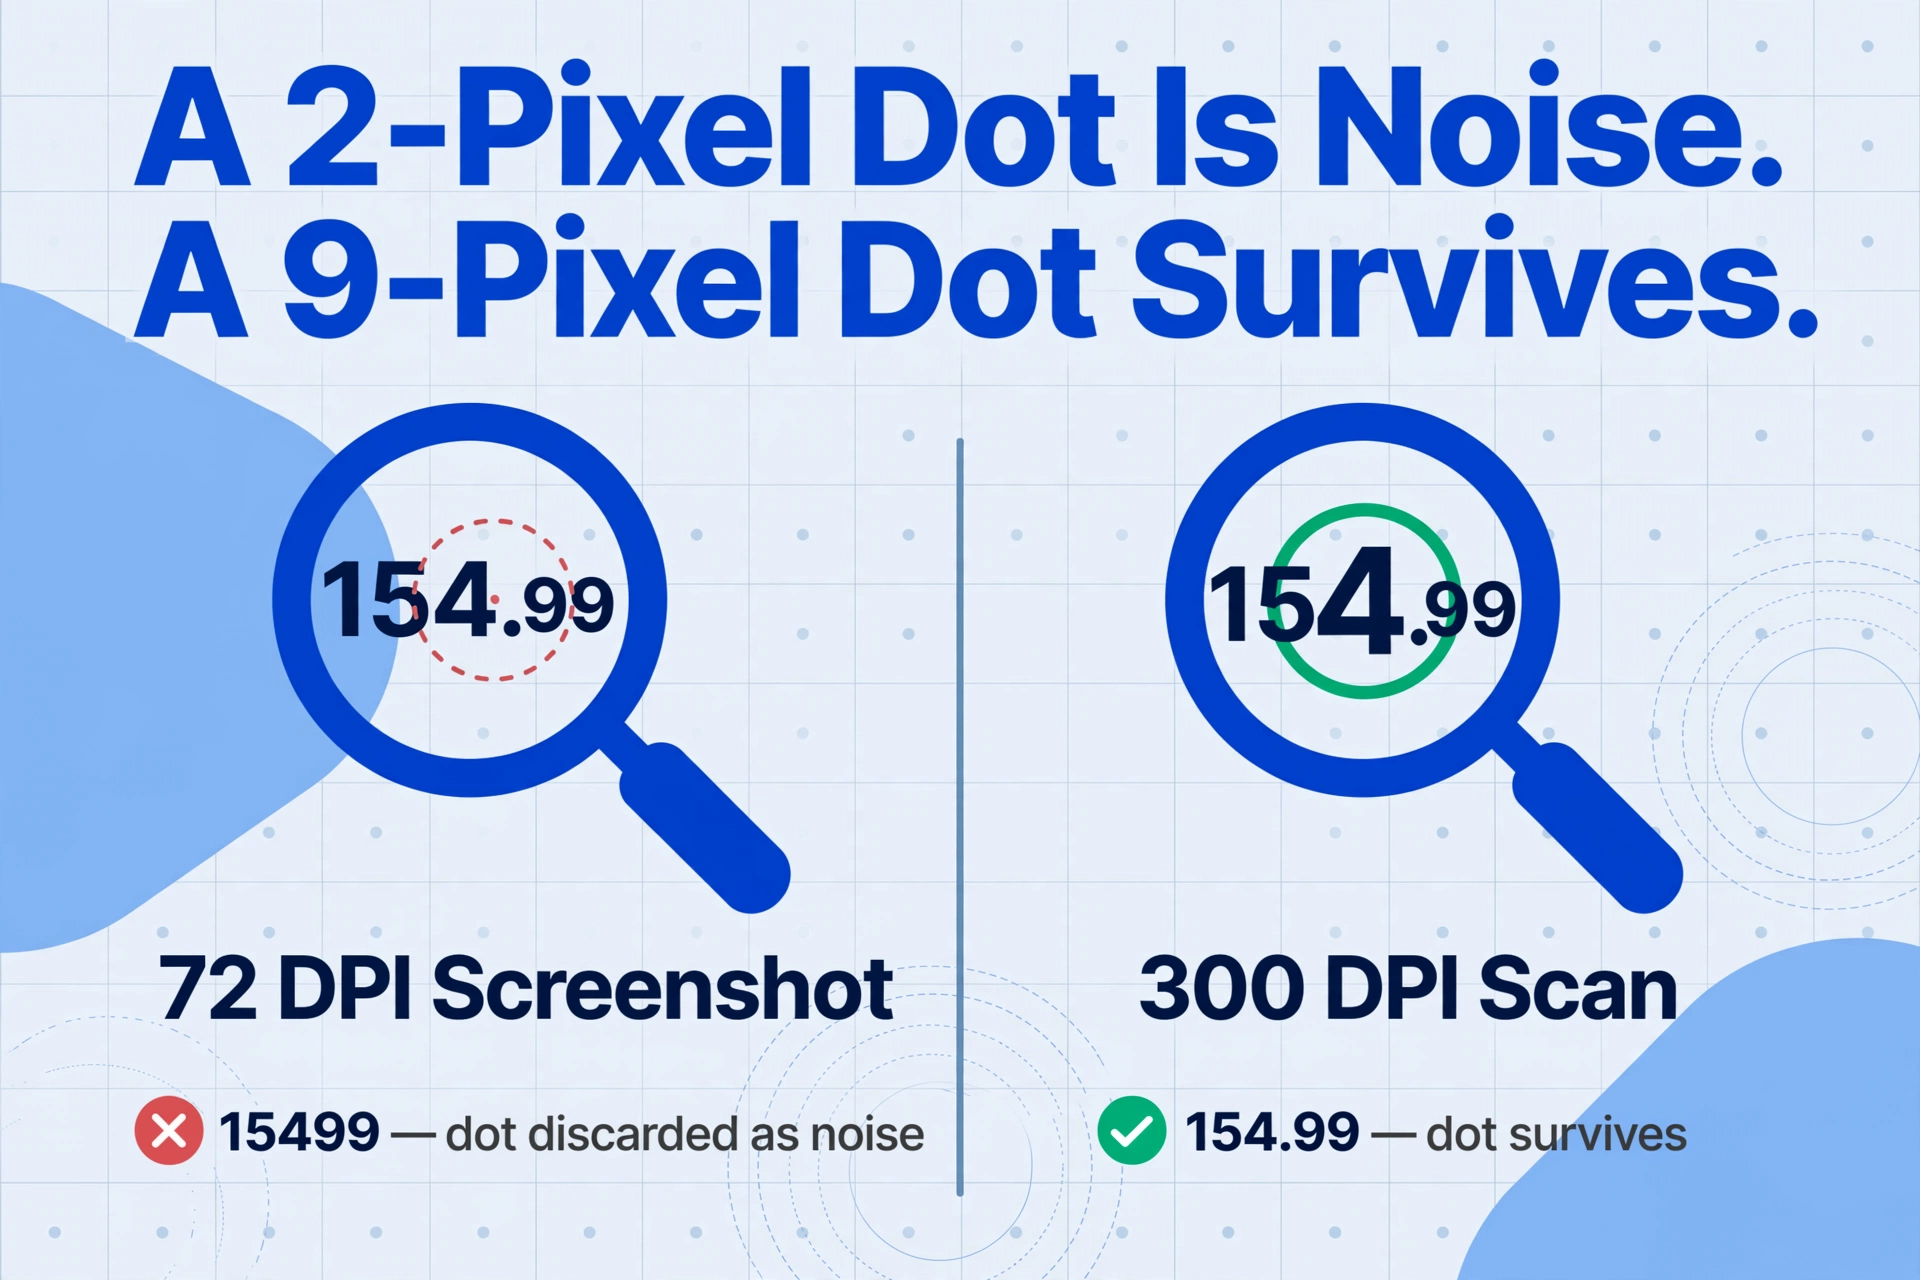
Ein Dezimalpunkt in einer 10-Punkt-Schrift ist bei 100 DPI nur 3 bis 5 Pixel breit. Bei 72 DPI – der Auflösung der meisten Screenshots – schrumpft er auf etwa 2 Pixel. JPEG-Kompression verarbeitet Bilder in 8×8-Pixel-Blöcken, und ein 2-Pixel-Punkt in einem überwiegend weißen Block wird als Rauschen behandelt und verworfen.
So wird aus 154,99 $ einfach 15499 $ – der Dezimalpunkt zwischen 4 und 9 verschwindet schlichtweg, und die zuvor getrennten Werte 154 und 99 verschmelzen zu einer einzigen Zahl, die 100-mal größer ist als das Original. Derselbe Mechanismus betrifft Positionsbeträge, Einzelpreise, Steuersummen und jedes andere Feld, das von einem zweistelligen Nachkommateil abhängt.
Der Effekt verschlimmert sich bei schlechter Beleuchtung – Schatten oder Blendung um einen Dezimalpunkt erschweren es dem Binarisierungsfilter (Umwandlung von Farbe in Schwarz-Weiß-Pixel) zusätzlich, den Punkt vom Hintergrund zu unterscheiden. Ist der Punkt im binarisierten Bild erst einmal verschwunden, kann kein Sprachmodell ihn wiederherstellen – denn die Engine hat ihn nie gesehen.
Ursache 2: Verwechslung durch die Nähe von Währungssymbolen
Währungssymbole liegen für die meisten OCR-Engines in einem toten Winkel. Das Dollarzeichen ($), Eurozeichen (€), Pfundzeichen (£) und Yenzeichen (¥) sind dekorative Zeichen, die unmittelbar vor oder nach einem numerischen Wert erscheinen. Herkömmliche OCR behandelt sie als isolierte Glyphen, die es zu identifizieren gilt, und sie werden dabei häufig falsch erkannt.
In der Praxis gibt es drei verschiedene Fehlermodi, die Währungssymbole betreffen:
- Das Symbol wird vollständig weggelassen – die OCR-Engine entscheidet, dass aus $1.234,56 einfach 1.234,56 werden soll, und entfernt den Währungsindikator stillschweigend. Dies erzeugt mehrdeutige Ausgaben: Handelt es sich bei 1.234,56 um USD, EUR oder eine andere Einheit? Wenn Daten von mehreren Lieferanten oder in verschiedenen Währungen in einer einzigen Tabelle zusammengeführt werden, macht der Verlust des Währungskennzeichens es unmöglich zu bestimmen, welche Werte vergleichbar sind.
- Das Symbol wird als Buchstabe oder Ziffer fehlgelesen – $ wird häufig als S oder 5 gelesen. £ kann als großes L oder als stilisiertes E gelesen werden. Diese Ersetzungen erzeugen Ausgaben wie
S1.234,56, die nachgelagerte Systeme möglicherweise als Zeichenfolge und nicht als numerischen Wert interpretieren, was zu Typkonvertierungsfehlern bei Datenbankimporten oder Excel-Formeln führt. - Das Symbol verschmilzt mit einer angrenzenden Ziffer – wenn ein $-Zeichen in einer fetten oder Serifenschrift gedruckt ist und nahe an der ersten Ziffer liegt, kann die OCR den kombinierten Bereich als ein einzelnes Zeichen lesen.
$5wird zu55oder95, abhängig von den Schriftdetails.
Die Verwechslung von Währungssymbolen ist frustrierend, weil die Ausgabe eine schnelle Sichtprüfung besteht – die Zahlen sehen richtig aus –, aber die Information darüber, welche Währung diese Zahlen darstellen, verloren gegangen ist. Deshalb ist bei der Verarbeitung von Finanzdokumenten die Genauigkeit auf Feldebene wichtiger als die Genauigkeit auf Zeichenebene.
Ursache 3: Anti-Aliasing-Unschärfe bei kleinen Zeichen
Anti-Aliasing (Schriftglättung) rendert Zeichenränder als Verläufe teilweise gefüllter Pixel, um die Illusion glatter Kurven zu erzeugen. Bei großem Fließtext verbessert dies die Lesbarkeit, aber bei kleinen Zeichen wie Dezimalpunkten und Währungssymbolen bewirkt es das Gegenteil.
Ein Dezimalpunkt, der mit 8pt oder 9pt gerendert wird – üblich in Positionszeilen von Rechnungen oder im Kleingedruckten von Belegen – hat so wenige Pixel, dass jede Glättung ihn im Hintergrund verschwimmen lässt. Wenn die OCR-Engine die Binarisierung anwendet (Umwandlung des Bildes in Schwarzweiß), wird der Punkt zu einem grauen Schmierfleck, der unter die Konfidenzschwelle fällt, und die Engine gibt für diese Position nichts aus.
Dasselbe gilt für Minuszeichen bei negativen Beträgen, Klammern für Gutschriften und die dünnen Striche in Währungssymbolen wie ¥ oder € – alle werden häufig in sehr kleinen Größen in dichten Tabellenzellen gerendert, wo Anti-Aliasing am zerstörerischsten ist.
Ursache 4: Mehrdeutigkeit der Komma- & Dezimalkonvention
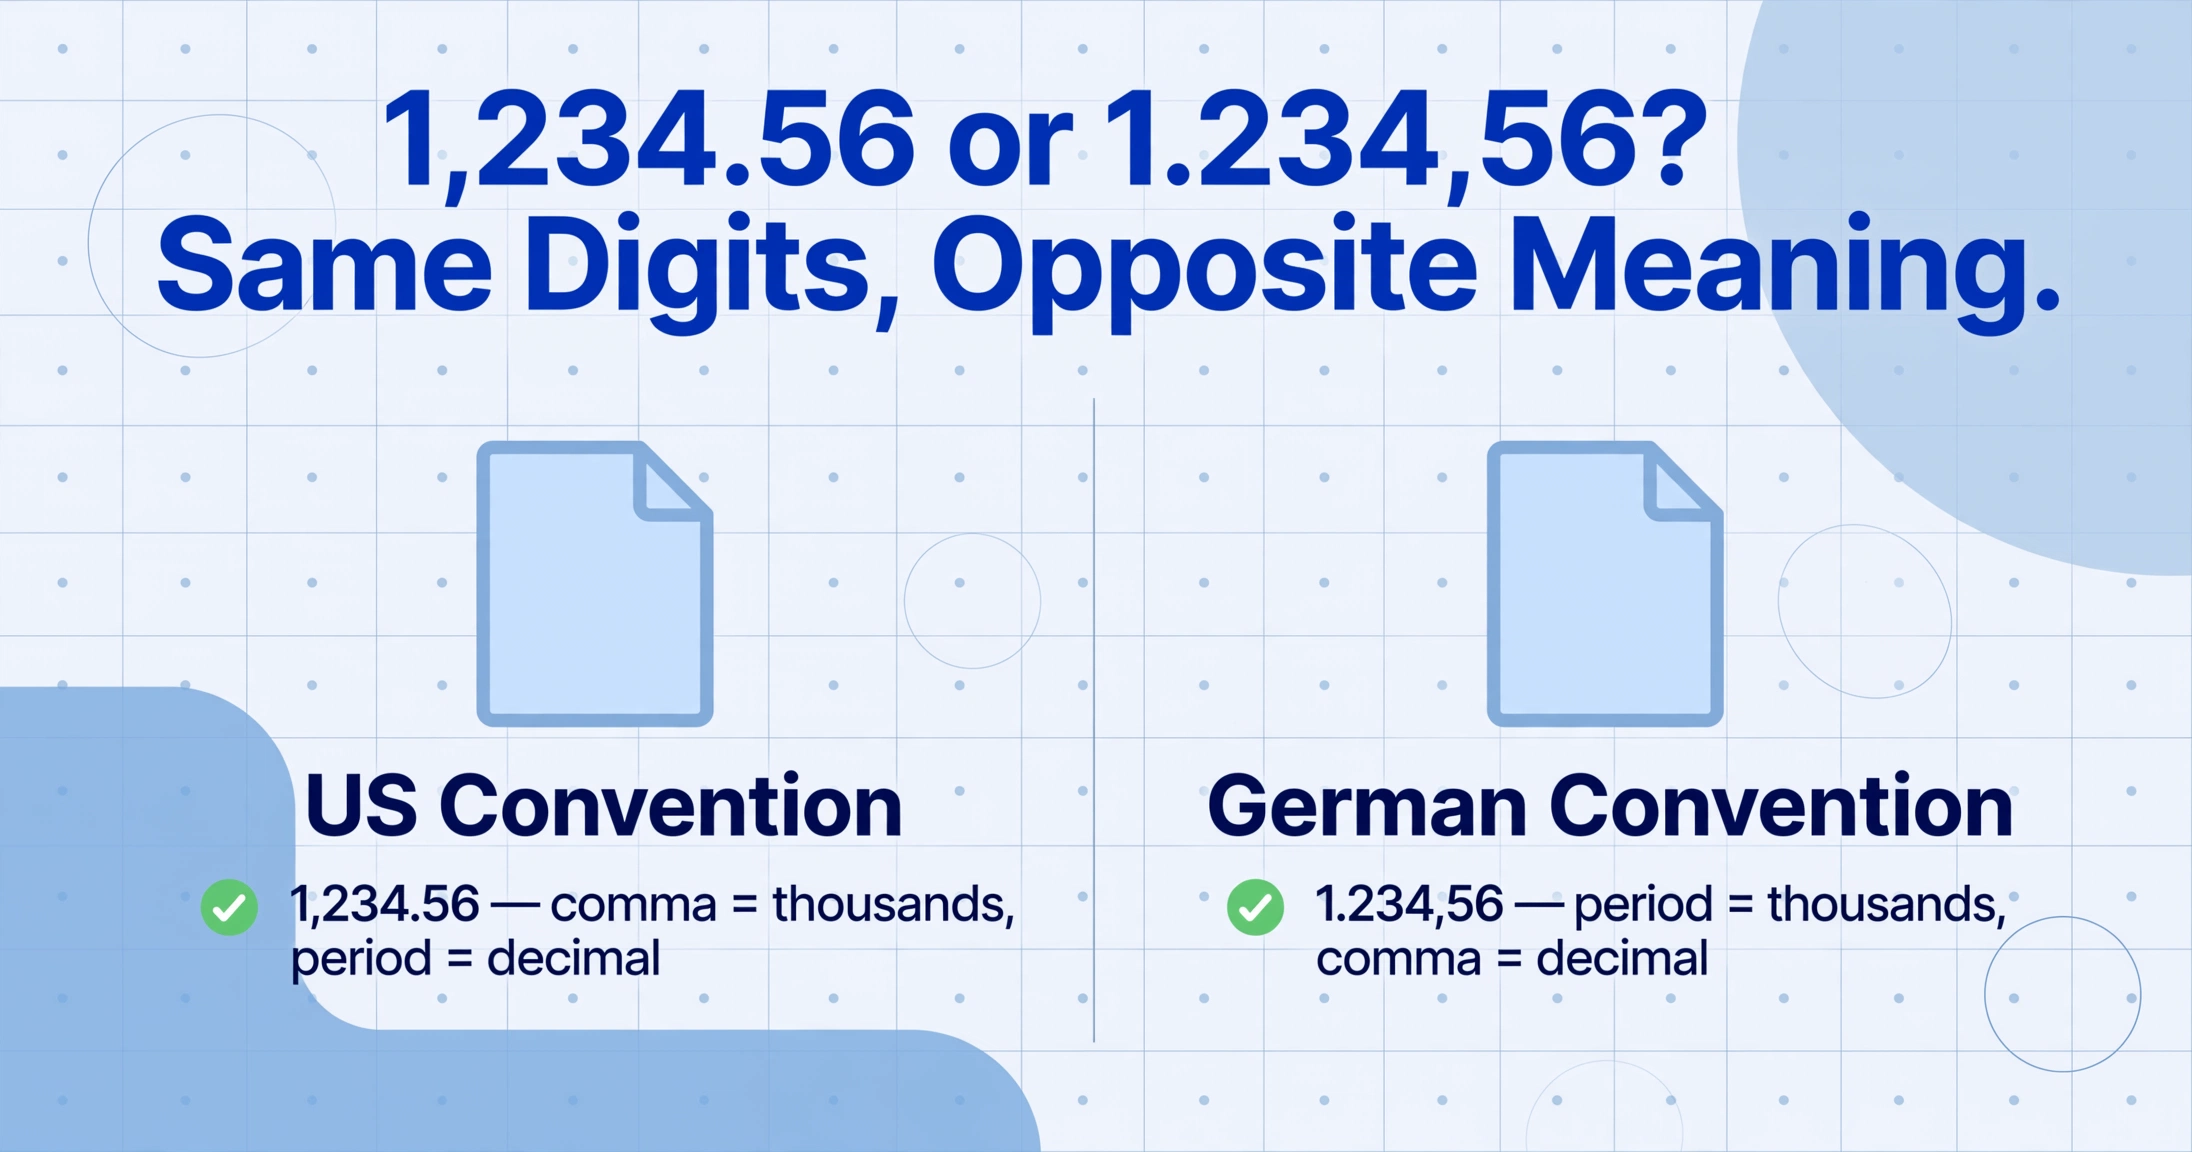
Ein einzelnes Zeichen – der Punkt oder das Komma – trägt je nach Herkunftsland des Dokuments gegensätzliche Bedeutungen. In den USA verwendet 1,234.56 ein Komma als Tausendertrennzeichen und einen Punkt als Dezimalzeichen. In weiten Teilen Kontinentaleuropas erscheint derselbe geschriebene Wert als 1.234,56 – Punkt als Tausendertrennzeichen, Komma als Dezimalzeichen. Eine OCR-Engine ohne regionalen Kontext hat keine zuverlässige Möglichkeit, diese zu unterscheiden.
Ein auf US-Rechnungen ausgelegtes OCR-System, das auf ein deutsches 1.234,56 trifft, kann es in zwei Zahlen aufteilen (1 und 234,56) oder beide Trennzeichen vollständig entfernen (123456), wodurch sich der Wert um das 100-Fache erhöht. In beiden Fällen gelangen korrupte Daten stillschweigend in das Buchhaltungssystem.
Das Problem verschärft sich bei Dokumenten aus gemischten Regionen – ein französischer Lieferant, der Komma-Dezimalzeichen, aber englische Feldbezeichnungen verwendet, verwirrt lokalisierungsbasierte OCR-Tools, die eine einzige regionale Konvention erwarten.
Die tatsächlichen Kosten der Dezimal-Mehrdeutigkeit: Eine Kreditorenbuchhaltung, die 1.000 internationale Rechnungen pro Monat verarbeitet und eine Fehlerrate von 2 % beim Erkennen von Dezimalzeichen aufweist, steht vor 20 stillen Fehlern. Wenn nur 5 davon zu falschen Zahlungen führen, bedeuten die durchschnittlichen $3.000 pro Korrektur $15.000 an vermeidbaren Verlusten pro Monat – und das bevor die Zeit für Untersuchungen und die Reparatur von Lieferantenbeziehungen berücksichtigt wird.
So beheben Sie es: Ein symptomorientiertes Diagnose-Framework
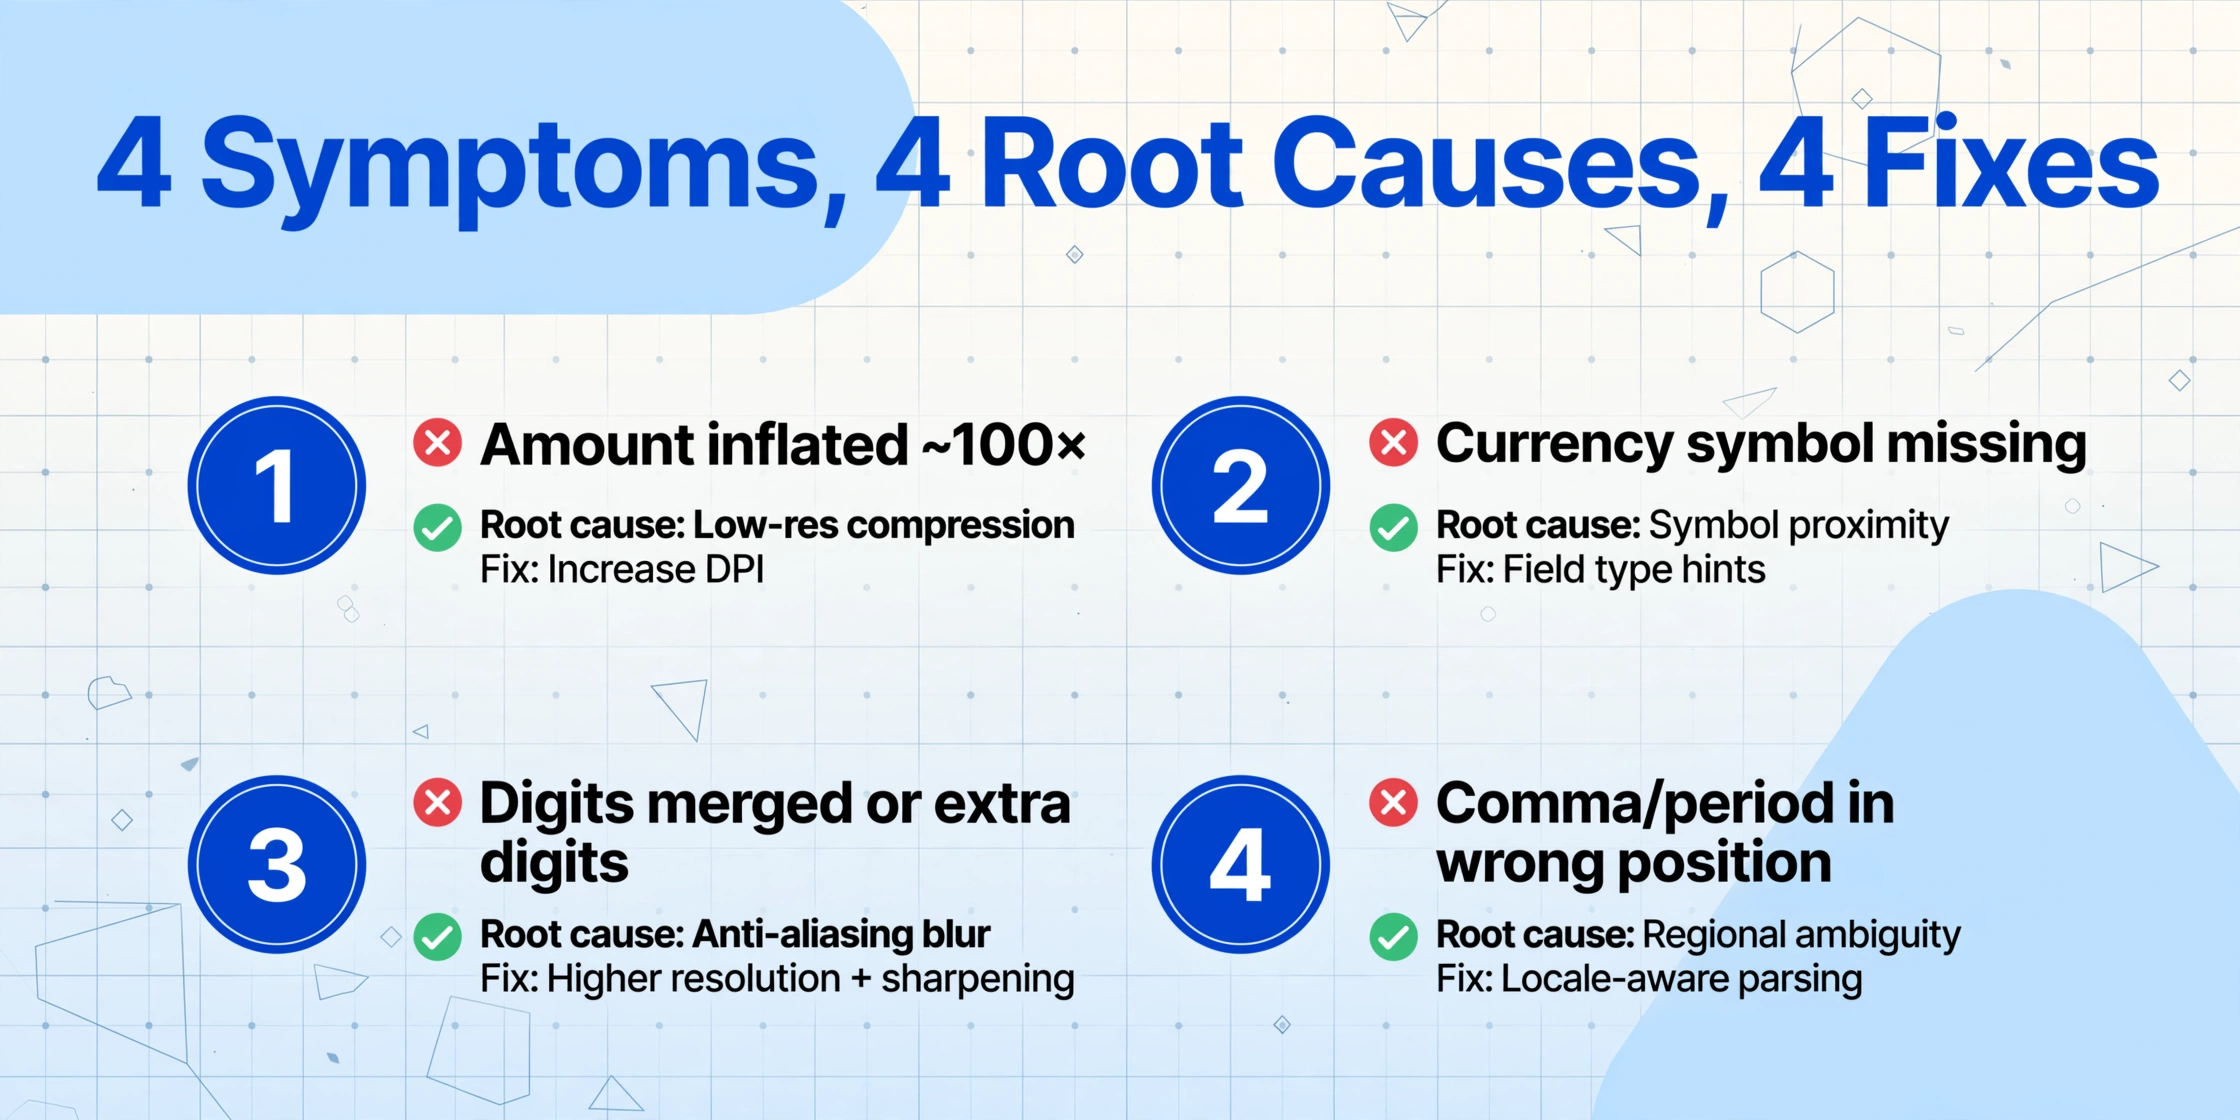
Nicht alle Dezimal- und Währungsfehler haben dieselbe Ursache. Die falsche Lösung kostet Zeit und übersieht das eigentliche Problem. Die folgende Tabelle ordnet das Symptom, das Sie in Ihrer extrahierten Ausgabe sehen, der wahrscheinlichsten Ursache und der entsprechenden Lösung zu.
| Symptom in der Ausgabe | Wahrscheinlichste Ursache | Primäre Lösung |
|---|---|---|
| Betrag um ~100× erhöht (z. B. 154,99 → 15499) | Niedrigauflösende Komprimierung (Ursache 1) | Eingabe-DPI erhöhen / verlustfreies Format verwenden |
| Währungssymbol fehlt ($/€/£ weggelassen) | Symbolnähe oder Schriftdarstellung (Ursache 2 oder 3) | Feldtyp-Hinweise + semantische Extraktion |
| Währungssymbol als Buchstabe fehlgelesen (z. B. $ → S) | Verwechslung der Zeichenform (Ursache 2) | Regex-Musterabgleich in der Nachbearbeitung |
| Ziffern zusammengefügt oder zusätzliche Ziffern erscheinen | Anti-Aliasing-Unschärfe (Ursache 3) | Höhere Eingabeauflösung + Schärfungs-Vorverarbeitung |
| Komma/Punkt an falscher Position (123.456 vs. 123,456) | Mehrdeutigkeit regionaler Konventionen (Ursache 4) | Gebietsschema-bewusste Nachbearbeitung + Quersummenprüfung |
| Betrag in zwei separate Werte aufgeteilt | Fehlinterpretation des Dezimalkommas (Ursache 4) | Kontextbewusster Parser mit Regionserkennung |
Fix 1: Verbessern Sie die Qualität des Quellbilds
Der effektivste Fix ist auch der einfachste: Geben Sie der OCR-Engine mehr Pixel zum Arbeiten. Ein Dezimalpunkt bei 300 DPI belegt etwa 9 Pixel – genug, dass JPEG-Kompression ihn nicht als Rauschen verwerfen kann. Bei 600 DPI umfasst derselbe Punkt 18 Pixel und übersteht aggressive Komprimierungseinstellungen.
- Mindestens mit 300 DPI scannen – 200 DPI ist die Untergrenze; 300 DPI ist der zuverlässige Standard für Finanzdokumente. Verwenden Sie wann immer möglich einen Flachbettscanner statt einer Handykamera.
- Als TIFF oder PNG speichern, nicht als JPEG – Die verlustbehaftete JPEG-Kompression ist die Hauptursache für verlorene Dezimalpunkte. TIFF und PNG erhalten die 2 bis 3 Pixel großen Punkte, die JPEG verwirft.
- Bei Handyfotos – Fotografieren Sie direkt von oben, verwenden Sie eine gut beleuchtete Fläche und exportieren Sie in der maximalen Kameraauflösung. Beschneiden Sie das Bild eng auf den Dokumentbereich, um die Pixeldichte im Textbereich zu maximieren.
Fix 2: Feldtyp-Hinweise verwenden
Dies ist der Fix, den die meisten Allzweck-OCR-Tools nicht bieten können – und der effektivste für Finanzdaten. Wenn Sie dem System mitteilen, dass ein Feld ein Währungsbetrag ist, behandelt es den Dezimalpunkt und das Währungssymbol als semantische Signale für den Wert, nicht als gewöhnliche Zeichen.
In ImageToTable.ai funktioniert dies über die Benutzerdefinierte Spaltenextraktion: Sie definieren Spalten wie „Rechnungssumme“ und die KI versteht den Feldtyp. Wenn sie einen Wert in einem bekannten Währungsfeld findet, sucht sie aktiv nach dem Dezimaltrennzeichen und nutzt die erwartete Zwei-Dezimal-Struktur, um Ziffern zu validieren. Wenn die Rohausgabe „15499“ für ein Feld „Gesamt (USD)“ liefert, markiert die KI den fehlenden Dezimalpunkt und wendet eine probabilistische Korrektur an.
Dies ist der grundlegende Unterschied zwischen positionsbasierter Extraktion (bei der das Tool jedes Zeichen in einer Zone liest und ausgibt, was es sieht) und semantischer Extraktion (bei der das Tool versteht, wonach es sucht, und diesen Kontext nutzt, um Mehrdeutigkeiten aufzulösen). Feldtyp-Hinweise verwandeln einen verlorenen Dezimalpunkt von einer stillen Datenkorruption in eine korrigierbare Mehrdeutigkeit. Derselbe Ansatz ermöglicht es Ihnen, Stapel von Lieferantenrechnungen direkt in strukturierte Excel-Tabellen zu verarbeiten, ohne Vorlagenkonfiguration pro Anbieter – die KI übernimmt die Formatvarianten, indem sie versteht, was jedes Feld bedeutet, nicht wo es auf der Seite steht.
Fix 3: Regex- und Quersummenprüfung-Nachbearbeitung
Wenn Sie die Quellenqualität oder das Extraktionstool nicht kontrollieren können, ist die Nachbearbeitung das Sicherheitsnetz. Zwei Techniken fangen die Mehrheit der Dezimal- und Währungsfehler nach der Extraktion ab. Für einen breiteren Überblick über Vorverarbeitung, Engine-Tuning und feldbezogene Validierungsstrategien lesen Sie unseren vollständigen Leitfaden zu wie Sie die OCR-Genauigkeit bei Finanzdokumenten verbessern.
Musterbasierte Validierung. Die meisten Währungsbeträge folgen vorhersehbaren Mustern. Ein Regex wie ^\d{1,3}(?:,\d{3})*\.\d{2}$ validiert US-Format-Beträge. Jeder Wert ohne Dezimalpunkt, mit vier Dezimalstellen oder mit nicht übereinstimmenden Trennzeichen wird zur Überprüfung markiert.
Quersummenprüfung (mathematische Validierung). Bei jedem Dokument mit Positionszeilen sollte die Summe der Positionsbeträge der Gesamtsumme entsprechen. Eine Abweichung deutet auf falsch erkannte Dezimalpunkte hin. Wenn die Positionsbeträge $1.249,85 ergeben, die Gesamtsumme aber als $124.985,00 extrahiert wird, ist der Dezimalpunkt um drei Stellen gewandert – fast sicher ein Punktverlust-Fehler. Die Quersummenprüfung erkennt dies sofort, unabhängig von der Ursache.
Die Nachbearbeitung ist kein Ersatz für gute Quellenqualität oder semantische Extraktion – sie ist eine Erkennungsebene, die Fehler abfangen soll, die durchgerutscht sind.
Wann eskalieren: Die Grenzen der Fixes erkennen
Nicht alle Dezimalpunkt- und Währungssymbol-Fehler können durch verbesserte Eingabequalität oder zusätzliche Nachbearbeitungsregeln behoben werden. Drei Szenarien zeigen, dass sich der Extraktionsansatz selbst ändern muss:
Szenario 1: Hochvolumige Verarbeitung gemischter Quellen. Wenn Ihr Workflow Rechnungen von Hunderten von Lieferanten mit unterschiedlichen Formaten und regionalen Konventionen verarbeitet, skaliert die Vorverarbeitungsoptimierung pro Anbieter nicht – der Aufwand hebt die Effizienzgewinne der Automatisierung auf.
Szenario 2: Überwiegend mobil erfasste Dokumente. Handyfotos führen zu Perspektivverzerrung, Blendung und variabler Beleuchtung, die die Erkennung kleiner Zeichen konsequent verschlechtern. Die Lösung ist nicht bessere Vorverarbeitung, sondern ein System, das semantischen Kontext nutzt, um Werte zu interpretieren, wenn die Zeichenerkennung unsicher ist.
Szenario 3: Dokumente mit extrem dichten Tabellen. Kontoauszüge, Brokerage-Berichte und mehrzeilige Rechnungen packen Zahlen in kleine Tabellenzellen, in denen Dezimalpunkte in 6pt bis 8pt dargestellt werden. Bei dieser Größe ist Anti-Aliasing-Unschärfe nahezu unvermeidbar, unabhängig von der Scan-Auflösung – pixelbasierte OCR erreicht eine grundlegende Genauigkeitsgrenze.
In diesen Szenarien kann selbst perfekte Vorverarbeitung die Lücke nicht schließen – die Lösung ist ein visionbasierter Ansatz, der Dokumentstruktur und Feld-Semantik versteht, nicht nur Pixelwerte. Für verwandte Hinweise siehe wie verbundene Zellen die Tabellenextraktion brechen und warum OCR Tabellen nicht erkennt – häufige Szenarien, in denen Dezimalfehler aus strukturellen Fehllesungen und nicht aus Pixelproblemen entstehen.
Häufig gestellte Fragen
Warum verliert meine OCR bei Handyfotos ständig den Dezimalpunkt, bei gescannten Dokumenten aber nicht?
Handyfotos, die auf Armeslänge aufgenommen werden, erzeugen Bilder im 72–150-DPI-Bereich – ein Dezimalpunkt hat bei dieser Auflösung nur eine Breite von 2–4 Pixeln. JPEG-Komprimierung verarbeitet das Bild in 8×8-Pixel-Blöcken, und ein 2-Pixel-Punkt in einem überwiegend weißen Block wird als Rauschen behandelt und verworfen. Flachbettscanner mit 300 DPI erzeugen Punkte mit 9+ Pixeln, die die Komprimierung zuverlässig überstehen. Das ist eine harte physikalische Grenze: Kleine Zeichen brauchen genügend Pixel, um von Sensorrauschen unterscheidbar zu sein.
Kann KI-basierte OCR Dezimalpunktfehler beheben, die herkömmliche OCR übersieht?
Ja – aber nicht, indem sie einen Punkt „sieht“, den JPEG zerstört hat. KI-basierte Extraktion leitet die Dezimalposition aus dem Kontext ab. Wenn das System weiß, dass es einen Rechnungsgesamtbetrag liest und die Rohausgabe „15499“ lautet, wendet es erlernte Muster an – die meisten Gesamtbeträge haben zwei Dezimalstellen – und rekonstruiert $154.99. Das funktioniert nur, wenn der Feldtyp bekannt ist; in einem OCR-Szenario ohne Vorkenntnisse kann keine KI beheben, was nie erfasst wurde.
Wie gehe ich mit Rechnungen mit gemischter regionaler Formatierung um (US- und EU-Lieferanten)?
Die Verarbeitung gemischter Regionen ist der schwierigste Fall für konventionsabhängiges Parsing. Der praktischste Ansatz ist, extrahierte Beträge gegen mathematische Konsistenz zu validieren – ergeben die Positionsbeträge die Summe? Wenn eine Komma-Dezimal-Lesart von 1.234,56 einen eindeutig unplausiblen Wert erzeugt, versucht das System die alternative Interpretation. Semantische Extraktionstools können dies automatisch anwenden – wenn die KI versteht, dass ein Feld ein plausibler Betrag sein sollte, schließt sie unplausible Trennzeichen-Interpretationen aus.
Hilft das Hochskalieren eines Bildes mit niedriger Auflösung vor der OCR, Dezimalpunkte wiederherzustellen?
Traditionelles Hochskalieren (bilineare oder bikubische Interpolation) stellt verlorene Details nicht wieder her – es verteilt vorhandene Pixel auf eine größere Fläche. Ein 2-Pixel-Dezimalpunkt, der auf 200 % hochskaliert wird, wird zu 4 Pixeln interpoliertem Grau, immer noch unter den meisten OCR-Erkennungsschwellen. Mit einem qualitativ hochwertigeren Quellbild zu beginnen, ist immer effektiver, als zu versuchen, ein degradiertes Bild zu reparieren.
Was ist die minimale Scanauflösung, um Dezimalpunkte in Finanzdokumenten zuverlässig zu erfassen?
300 DPI ist das praktische Minimum. Bei 200 DPI umfassen Dezimalpunkte in Standard-10pt-Schriften 4–5 Pixel – nur geringfügig besser als die Auflösung einer Handykamera. Bei 300 DPI umfasst derselbe Punkt 8–9 Pixel, was OCR-Engines genügend Signal bietet, um ihn von Hintergrundrauschen zu unterscheiden. Für Dokumente mit sehr kleinen Schriften (8pt oder kleiner in Positionslistentabellen) werden 400–600 DPI empfohlen, mit dem Verständnis, dass höhere DPI die Dateigröße linear erhöhen.
Sind Tausendertrennzeichen mit Komma (1.234,56) bei den meisten OCR-Tools sicher?
Nicht grundsätzlich. Während die meisten OCR-Engines die US-Konvention recht gut verarbeiten, kann das Komma als Punkt fehlgelesen oder verworfen werden, was 1.234.56 oder 1234.56 ergibt. Kritischer ist, dass die OCR keine Möglichkeit hat, die beiden Verwendungen allein anhand der Form zu unterscheiden, wenn dasselbe Dokument Werte enthält, bei denen das Komma das Dezimaltrennzeichen ist (häufig in gemischten Lieferanten-Workflows) – sie benötigt kontextuelles Wissen darüber, welches Feld welches ist. Deshalb sind Feldtyp-Hinweise für eine zuverlässige Verarbeitung über mehrere Regionen hinweg unerlässlich.
Lassen Sie nicht zu, dass ein fehlender Dezimalpunkt Sie Tausende kostet
Dezimalpunkte und Währungssymbole sind kleine Zeichen mit enormen Konsequenzen – ein einziger übersehener Punkt kann einen Lieferanten um $15.000 überbezahlen oder einen Compliance-Verstoß durch die Monatsabschlussprüfungen schlüpfen lassen. Die Fehler sind nicht zufällig: Jeder hat eine nachvollziehbare Ursache, die darin wurzelt, wie OCR-Engines Bilder auf Pixelebene verarbeiten. Zu wissen, welche Ursache Ihr Dokument betrifft, ist der Unterschied zwischen blindem Einstellen von Optionen und dauerhafter Behebung des Problems.
Die zuverlässigste Lösung ist ein Extraktionssystem, das versteht, was es liest – fehlende Dezimalpunkte rekonstruiert, Werte gegen erwartete Formate validiert und regionale Trennzeichen-Konventionen ohne manuelle Konfiguration behandelt. Das ermöglicht semantische Extraktion. Laden Sie eine Rechnung hoch, mit der Ihr aktuelles Tool Schwierigkeiten hat, und vergleichen Sie die Genauigkeit direkt nebeneinander.