Pourquoi votre OCR omet-il les points décimaux
et les symboles monétaires ?
Si votre outil OCR vient de transformer 154,99 $ en 15499 $ — gonflant un total de facture par 100 — vous n'êtes pas seul. C'est l'une des défaillances d'extraction de données les plus fréquemment signalées dans la gestion des comptes fournisseurs et des dépenses. Le problème a quatre causes racines distinctes, et savoir laquelle a touché votre document est le moyen le plus rapide de le résoudre.
Points clés à retenir
- Les outils OCR vantent une précision de caractères de 99 % mais concentrent leur taux d'erreur de 1 % sur le seul caractère qui gonfle le montant de votre facture par un facteur de 100.
- Chaque erreur de point décimal porte une empreinte reconnaissable qui remonte à l'une des quatre causes racines, de la compression JPEG qui élimine les points de 2 pixels aux virgules décimales européennes qui déroutent les moteurs formés aux États-Unis.
- Faire correspondre cette empreinte à sa cause signifie que vous arrêtez de passer en revue des ajustements de résolution aveugles et que vous appliquez la seule solution qui traite le problème réel du premier coup.
Le coût dépasse un simple chiffre erroné à l'écran. Selon les exigences de conformité SOX, les sociétés cotées en bourse doivent tenir des registres financiers complets et exacts — une erreur de point décimal dans un pipeline automatisé constitue une exposition à la conformité. Pour toute entreprise, un paiement de 15 499,00 $ sur une facture de 154,99 $ signifie un trop-payé de 15 344,01 $ jusqu'à ce que la clôture de fin de mois le détecte. La plupart des moteurs OCR annoncent une précision de 99 % au niveau des caractères, mais ce chiffre est trompeur lorsqu'une seule erreur de caractère dans un champ numérique peut casser une ligne entière de données. Voici ce qui cause ces erreurs au niveau des pixels — et comment les éviter.
Cause 1 : La compression basse résolution efface les petits points
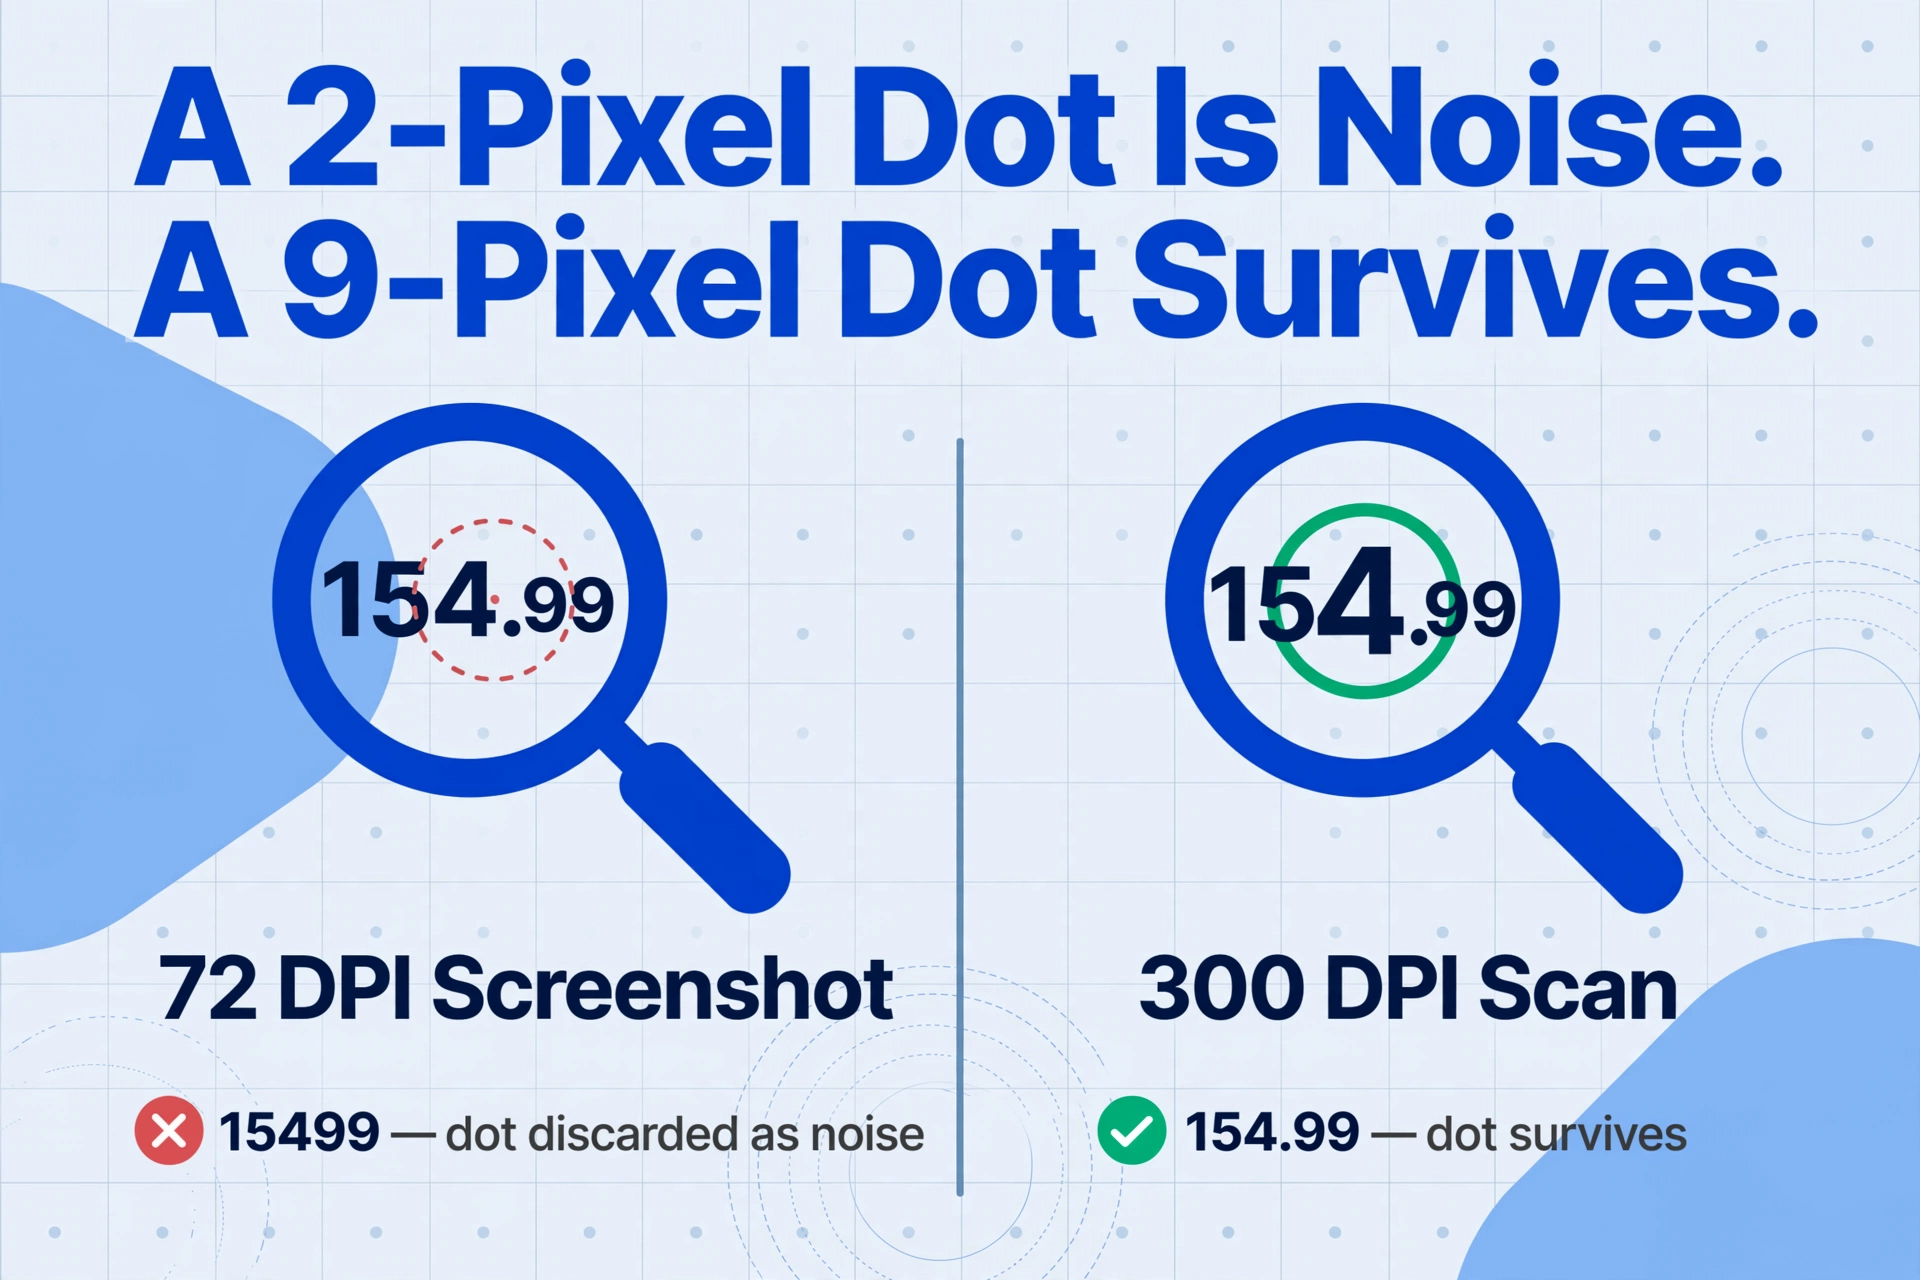
Un point décimal dans une police de 10 pt ne fait que 3 à 5 pixels de large à 100 DPI. À 72 DPI — la résolution de la plupart des captures d'écran — il se réduit à environ 2 pixels. La compression JPEG traite les images par blocs de 8×8 pixels, et un point de 2 pixels dans un bloc majoritairement blanc est traité comme du bruit et supprimé.
C'est ainsi que 154,99 $ devient 15499 $ — le point décimal entre 4 et 9 disparaît simplement, et les valeurs auparavant distinctes 154 et 99 fusionnent en un seul nombre 100 fois plus grand que l'original. Le même mécanisme affecte les montants de lignes, les prix unitaires, les totaux de taxes et tout autre champ dépendant d'une composante fractionnaire à deux chiffres.
L'effet s'aggrave avec un mauvais éclairage — les ombres ou les reflets autour d'un point décimal rendent encore plus difficile pour le filtre de binarisation (conversion de la couleur en pixels noir et blanc) de distinguer le point de son arrière-plan. Une fois le point disparu dans l'image binarisée, aucun modèle de langage ne peut le récupérer — car le moteur ne l'a jamais vu.
Cause 2 : Confusion due à la proximité du symbole monétaire
Les symboles monétaires se trouvent dans un angle mort pour la plupart des moteurs d'OCR. Le signe dollar ($), le symbole euro (€), le signe livre (£) et le signe yen (¥) sont des caractères décoratifs qui apparaissent immédiatement avant ou après une valeur numérique. L'OCR traditionnel les traite comme des glyphes isolés à identifier, et il se trompe fréquemment.
Trois modes de défaillance distincts affectent les symboles monétaires en pratique :
- Le symbole est entièrement supprimé — le moteur d'OCR décide que 1 234,56 $ devrait simplement être 1 234,56, supprimant silencieusement l'indicateur de devise. Cela crée une sortie ambiguë : 1 234,56 est-il en USD, en EUR ou dans une autre unité ? Lorsque des données provenant de plusieurs fournisseurs ou devises sont fusionnées dans une seule feuille de calcul, la perte du marqueur de devise rend impossible de déterminer quelles valeurs sont comparables.
- Le symbole est mal lu comme une lettre ou un chiffre — $ est fréquemment lu comme S ou 5. £ peut être lu comme un L majuscule ou un E stylisé. Ces substitutions produisent une sortie comme
S1 234,56, que les systèmes en aval peuvent interpréter comme une chaîne plutôt que comme une valeur numérique, provoquant des erreurs de conversion de type lors des importations de bases de données ou des formules Excel. - Le symbole fusionne avec un chiffre adjacent — lorsqu'un signe $ est imprimé dans une police grasse ou serif et se trouve près du premier chiffre, l'OCR peut lire la région combinée comme un seul caractère.
5 $devient55ou95selon les détails de la police.
La confusion des symboles monétaires est frustrante car la sortie passe un examen visuel rapide — les chiffres semblent corrects — mais l'information sur quelle devise ces chiffres représentent a été perdue. C'est pourquoi la précision au niveau du champ importe plus que la précision au niveau du caractère dans le traitement de documents financiers.
Cause 3 : Flou d'anticrénelage sur les petits caractères
L'anticrénelage (lissage des polices) rend les contours des caractères sous forme de dégradés de pixels partiellement remplis pour créer l'illusion de courbes lisses. Pour les grands corps de texte, cela améliore la lisibilité, mais pour les petits caractères comme les points décimaux et les symboles monétaires, c'est l'inverse.
Un point décimal rendu en 8 pt ou 9 pt — courant dans les tableaux de lignes de factures ou les mentions en petits caractères sur les reçus — a si peu de pixels que tout lissage le fond dans l'arrière-plan. Lorsque le moteur OCR applique la binarisation (conversion de l'image en noir et blanc), le point devient une tache grise qui tombe sous le seuil de confiance, et le moteur ne produit rien pour cette position.
Il en va de même pour les signes moins des montants négatifs, les parenthèses utilisées pour les crédits, et les traits fins des symboles monétaires comme ¥ ou € — tous fréquemment rendus en très petite taille dans des cellules de tableau denses où l'anticrénelage est le plus destructeur.
Cause 4 : Ambiguïté des conventions de virgule et de point décimal
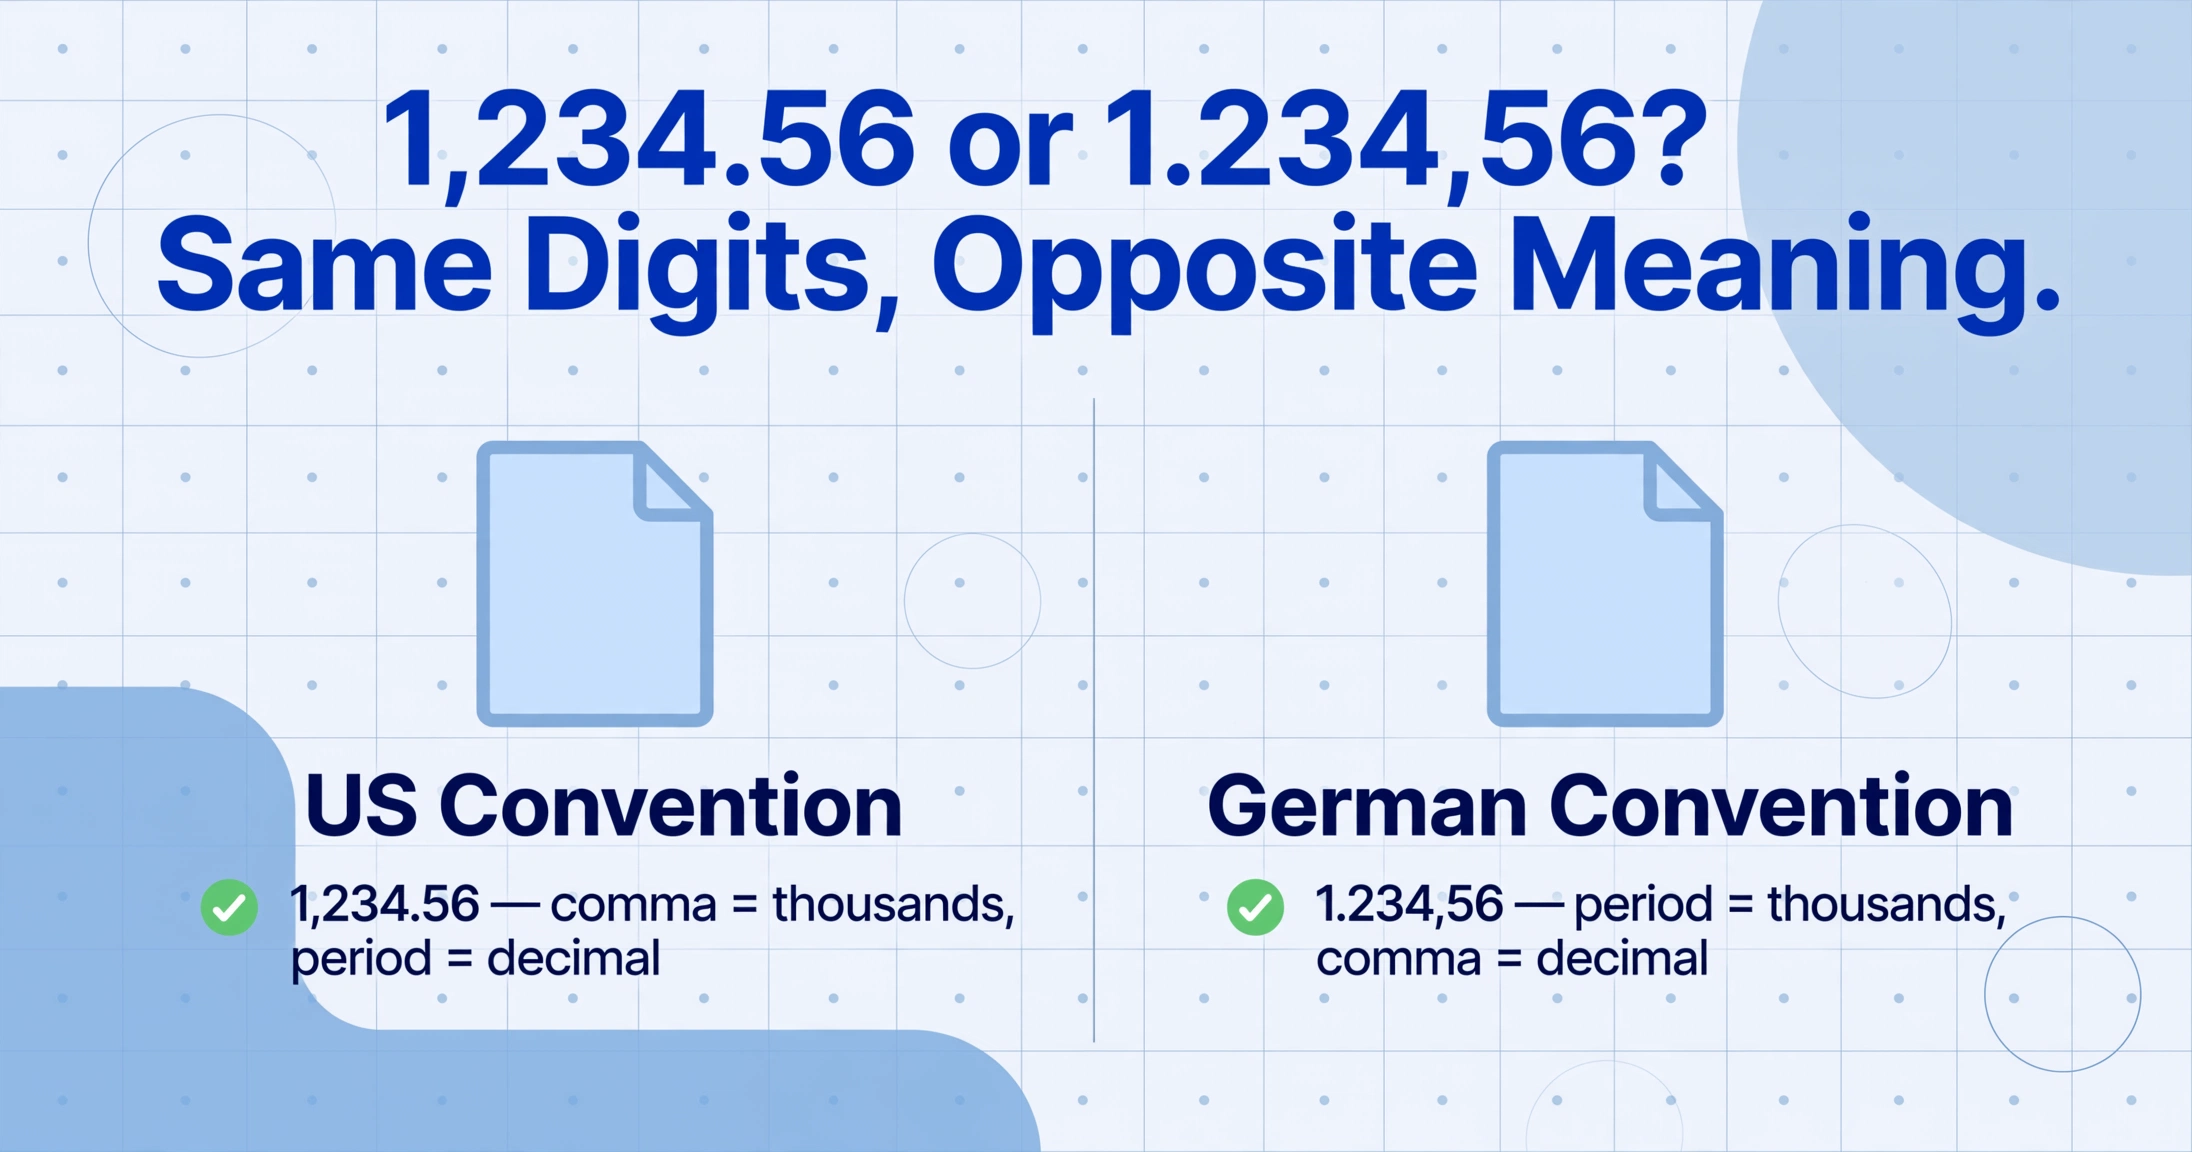
Un seul caractère — le point ou la virgule — porte des significations opposées selon l'origine du document. Aux États-Unis, 1,234.56 utilise une virgule comme séparateur de milliers et un point comme point décimal. Dans la majeure partie de l'Europe continentale, la même valeur écrite apparaît comme 1.234,56 — le point comme séparateur de milliers, la virgule comme point décimal. Un moteur OCR sans contexte régional n'a aucun moyen fiable de les distinguer.
Un système OCR conçu pour les factures américaines rencontrant un 1.234,56 allemand peut le diviser en deux nombres (1 et 234,56) ou supprimer les deux séparateurs entièrement (123456), gonflant la valeur par 100×. Dans les deux cas, des données corrompues entrent silencieusement dans le système comptable.
Le problème s'aggrave avec les documents de régions mixtes — un fournisseur français utilisant des virgules décimales mais des étiquettes de champs en anglais perturbe les outils OCR basés sur la locale qui s'attendent à une seule convention régionale.
Le coût réel de l'ambiguïté décimale : Une équipe de comptabilité fournisseurs traitant 1 000 factures internationales par mois avec un taux d'erreur de lecture décimale de 2 % fait face à 20 erreurs silencieuses. Si seulement 5 d'entre elles entraînent des paiements incorrects, le coût moyen de 3 000 $ par correction signifie 15 000 $ de pertes évitables chaque mois — et cela sans compter le temps consacré aux enquêtes et à la réparation des relations fournisseurs.
Comment résoudre le problème : un cadre de diagnostic basé sur les symptômes
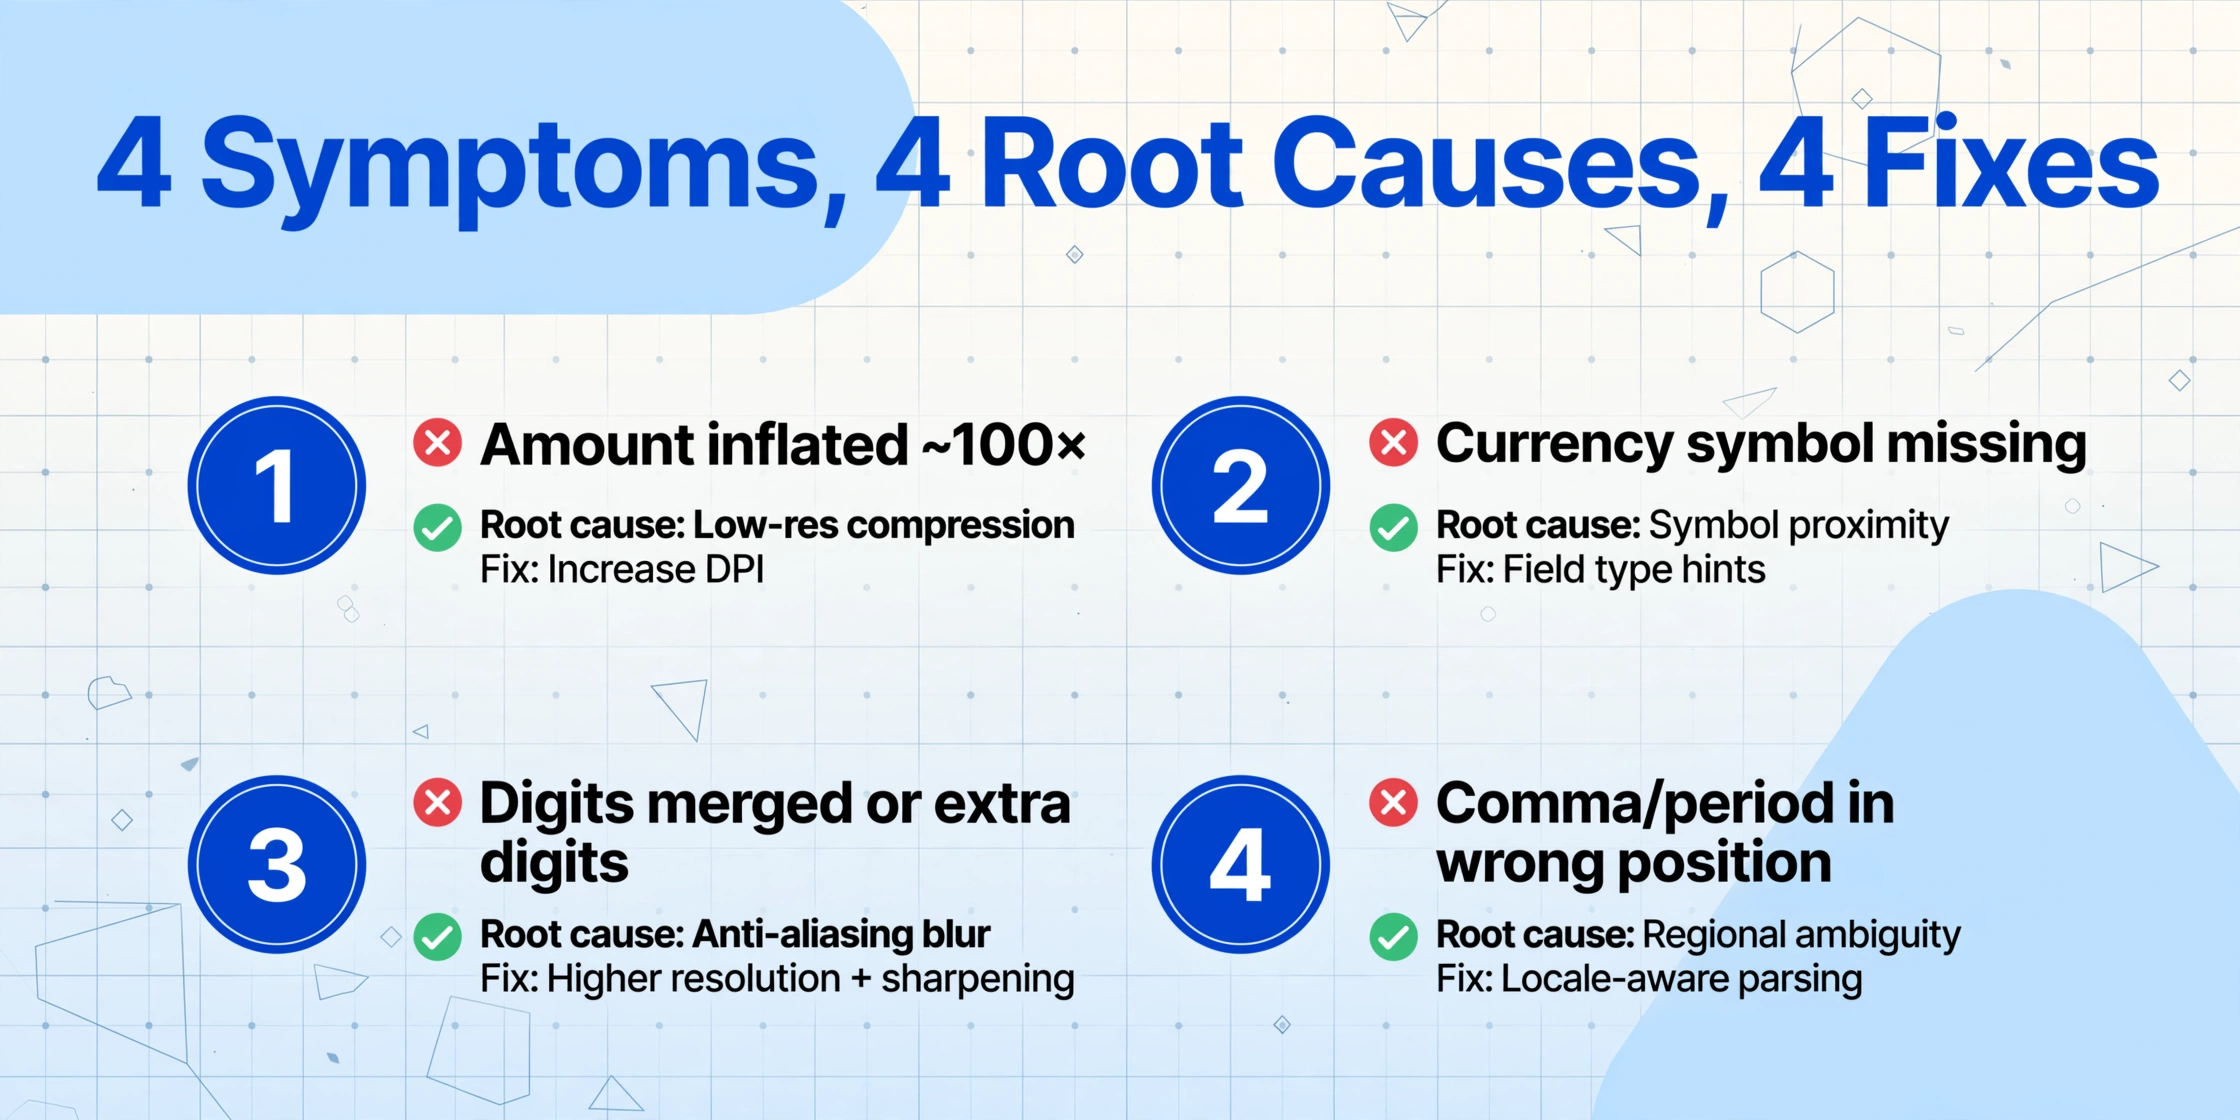
Toutes les erreurs de décimale et de devise n'ont pas la même cause racine. Utiliser le mauvais correctif fait perdre du temps et ne résout pas le vrai problème. Le tableau ci-dessous associe le symptôme observé dans votre sortie extraite à la cause la plus probable et au correctif correspondant.
| Symptôme dans la sortie | Cause la plus probable | Correctif principal |
|---|---|---|
| Montant gonflé d'environ 100× (ex. 154.99 → 15499) | Compression basse résolution (Cause 1) | Augmenter le DPI d'entrée / utiliser un format sans perte |
| Symbole monétaire manquant ($/€/£ supprimé) | Proximité du symbole ou rendu de police (Cause 2 ou 3) | Indications de type de champ + extraction sémantique |
| Symbole monétaire mal lu comme une lettre (ex. $ → S) | Confusion de forme de caractère (Cause 2) | Correspondance de motif regex en post-traitement |
| Chiffres fusionnés ou chiffres supplémentaires apparaissant | Flou d'anticrénelage (Cause 3) | Résolution d'entrée plus élevée + prétraitement de netteté |
| Virgule/point en position incorrecte (123.456 vs 123,456) | Ambiguïté de convention régionale (Cause 4) | Post-traitement adapté à la locale + recoupement |
| Montant divisé en deux valeurs distinctes | Mauvaise interprétation de la virgule décimale (Cause 4) | Analyseur contextuel avec détection de région |
Correctif 1 : Améliorer la qualité de l'image source
Le correctif le plus efficace est aussi le plus simple : donner plus de pixels au moteur OCR. Un point décimal à 300 DPI occupe environ 9 pixels — assez pour que la compression JPEG ne puisse pas l'éliminer comme bruit. À 600 DPI, ce même point s'étend sur 18 pixels et survit aux réglages de compression agressifs.
- Numériser à 300 DPI minimum — 200 DPI est le minimum absolu ; 300 DPI est la norme fiable pour les documents financiers. Utilisez un scanner à plat plutôt qu'un appareil photo de téléphone lorsque c'est possible.
- Enregistrer en TIFF ou PNG, pas en JPEG — la compression avec perte du JPEG est la cause principale de la perte des points décimaux. Le TIFF et le PNG préservent les points de 2 à 3 pixels que le JPEG élimine.
- Pour les photos de téléphone — photographiez directement au-dessus, sur une surface bien éclairée, et exportez à la résolution maximale de l'appareil. Recadrez précisément sur la zone du document pour maximiser la densité de pixels sur la zone de texte.
Correctif 2 : Utiliser les indications de type de champ
C'est le correctif que la plupart des outils OCR généralistes ne peuvent pas offrir — et le plus efficace pour les données financières. Lorsque vous indiquez au système qu'un champ est un montant en devise, il traite le point décimal et le symbole monétaire comme des signaux sémantiques sur la valeur, et non comme des caractères ordinaires.
Dans ImageToTable.ai, cela fonctionne grâce à l'Extraction de colonnes personnalisées : vous définissez des colonnes comme « Total de la facture » et l'IA comprend le type de champ. Lorsqu'elle rencontre une valeur dans un champ de devise connu, elle recherche activement le séparateur décimal et utilise la structure attendue à deux décimales pour valider les chiffres. Si le résultat brut produit « 15499 » pour un champ « Total (USD) », l'IA signale la décimale manquante et applique une correction probabiliste.
C'est la différence fondamentale entre l'extraction basée sur la position (où l'outil lit chaque caractère dans une zone et affiche ce qu'il voit) et l'extraction basée sur la sémantique (où l'outil comprend ce qu'il cherche et utilise ce contexte pour résoudre les ambiguïtés). Les indications de type de champ transforment une perte de point décimal d'une corruption silencieuse des données en une ambiguïté corrigeable. La même approche vous permet de traiter des lots de factures fournisseurs directement dans des feuilles Excel structurées sans configuration de modèle par fournisseur — l'IA gère les variations de format en comprenant ce que chaque champ signifie, et non où il se trouve sur la page.
Correctif 3 : Post-traitement par regex et recoupement
Lorsque vous ne pouvez pas contrôler la qualité de la source ou l'outil d'extraction, le post-traitement est le filet de sécurité. Deux techniques permettent de détecter la majorité des erreurs de décimales et de devises après l'extraction. Pour une vue d'ensemble plus large des stratégies de prétraitement, de réglage du moteur et de validation au niveau des champs, consultez notre guide complet sur comment améliorer la précision de l'OCR sur les documents financiers.
Validation basée sur des motifs. La plupart des montants en devises suivent des motifs prévisibles. Une regex comme ^\d{1,3}(?:,\d{3})*\.\d{2}$ valide les montants au format américain. Toute valeur sans point décimal, avec quatre décimales ou avec des séparateurs incohérents est signalée pour examen.
Recoupement (validation mathématique). Sur tout document comportant des lignes d'articles, la somme des montants des lignes doit être égale au total. Un écart signale une erreur de lecture du point décimal. Si les montants des lignes totalisent 1 249,85 $ mais que le total extrait est de 124 985,00 $, la décimale a migré de trois positions — presque certainement une erreur de perte de point. Le recoupement détecte cela instantanément, quelle qu'en soit la cause.
Le post-traitement ne remplace pas une bonne qualité de source ou une extraction sémantique — c'est une couche de détection conçue pour attraper les erreurs qui ont échappé aux étapes précédentes.
Quand passer à l'étape supérieure : reconnaître les limites des correctifs
Toutes les erreurs de point décimal et de symbole monétaire ne peuvent pas être corrigées en améliorant la qualité des entrées ou en ajoutant des règles de post-traitement. Trois scénarios indiquent que l'approche d'extraction elle-même doit changer :
Scénario 1 : Traitement à volume élevé de sources mixtes. Si votre flux de travail traite des factures provenant de centaines de fournisseurs utilisant des formats et des conventions régionales différents, le réglage du prétraitement par fournisseur ne passe pas à l'échelle — la surcharge annule les gains d'efficacité de l'automatisation.
Scénario 2 : Documents principalement capturés sur mobile. Les photos prises au téléphone introduisent une distorsion de perspective, des reflets et un éclairage variable qui dégradent systématiquement la reconnaissance des petits caractères. La solution n'est pas un meilleur prétraitement ; c'est un système qui utilise le contexte sémantique pour interpréter les valeurs lorsque la reconnaissance au niveau des caractères est incertaine.
Scénario 3 : Documents avec des tableaux extrêmement denses. Les relevés bancaires, les rapports de courtage et les factures multilignes concentrent les nombres dans de petites cellules de tableau où les points décimaux sont rendus en 6 pt à 8 pt. À cette taille, le flou d'anticrénelage est presque inévitable, quelle que soit la résolution de numérisation — l'OCR basé sur les pixels atteint un plafond de précision fondamental.
Dans ces scénarios, même un prétraitement parfait ne peut pas combler l'écart — la solution est une approche basée sur la vision qui comprend la structure du document et la sémantique des champs, et pas seulement les valeurs des pixels. Pour des conseils connexes, voir comment les cellules fusionnées cassent l'extraction de tableaux et pourquoi l'OCR échoue à reconnaître les tableaux — des scénarios courants où les erreurs de décimales proviennent de lectures structurelles erronées plutôt que de problèmes au niveau des pixels.
Questions fréquemment posées
Pourquoi mon OCR perd-il le point décimal sur les photos prises au téléphone, mais pas sur les documents scannés ?
Les photos prises à bout de bras produisent des images dans la plage de 72 à 150 DPI — à cette résolution, un point décimal ne fait que 2 à 4 pixels de large. La compression JPEG traite l'image en blocs de 8×8 pixels, et un point de 2 pixels dans un bloc majoritairement blanc est traité comme du bruit et supprimé. Les scanners à plat à 300 DPI produisent des points de 9 pixels ou plus, qui survivent de manière fiable à la compression. C'est une limitation physique incontournable : les petits caractères ont besoin d'assez de pixels pour être distingués du bruit du capteur.
L'OCR basé sur l'IA peut-il corriger les erreurs de point décimal que l'OCR traditionnel manque ?
Oui — mais pas en « voyant » un point que le JPEG a détruit. L'extraction basée sur l'IA déduit la position du point décimal à l'aide du contexte. Lorsque le système sait qu'il lit un total de facture et que la sortie brute indique « 15499 », il applique des modèles appris — la plupart des totaux ont deux décimales — et reconstruit 154,99 $. Cela ne fonctionne que si le type de champ est connu ; dans un scénario d'OCR sans contexte, aucune IA ne peut corriger ce qui n'a jamais été capturé.
Comment gérer les factures avec un formatage régional mixte (fournisseurs américains et européens) ?
Le traitement multi-régions est le cas le plus difficile pour l'analyse dépendante des conventions. L'approche la plus pratique consiste à valider les montants extraits par rapport à la cohérence mathématique — les lignes de détail correspondent-elles au total ? Si une lecture avec virgule décimale de 1.234,56 produit une valeur clairement invraisemblable, le système essaie l'autre interprétation. Les outils d'extraction sémantique peuvent appliquer cela automatiquement — si l'IA comprend qu'un champ doit être un montant raisonnable, elle écarte les interprétations de séparateurs invraisemblables.
L'agrandissement d'une image basse résolution avant l'OCR aide-t-il à récupérer les points décimaux ?
L'agrandissement traditionnel (interpolation bilinéaire ou bicubique) ne récupère pas les détails perdus — il étale les pixels existants sur une toile plus grande. Un point décimal de 2 pixels agrandi à 200 % devient 4 pixels de gris interpolé, toujours en dessous des seuils de détection de la plupart des OCR. Partir d'une image source de meilleure qualité est toujours plus efficace que d'essayer de réparer une image dégradée.
Quelle est la résolution de numérisation minimale pour capturer de manière fiable les points décimaux dans les documents financiers ?
300 DPI est le minimum pratique. À 200 DPI, les points décimaux dans les polices standard de 10 pt couvrent 4 à 5 pixels — à peine mieux que la résolution d'un appareil photo. À 300 DPI, le même point couvre 8 à 9 pixels, ce qui donne aux moteurs OCR suffisamment de signal pour le distinguer du bruit de fond. Pour les documents avec de très petites polices (8 pt ou moins dans les tableaux de lignes), 400 à 600 DPI est recommandé, en sachant qu'un DPI plus élevé augmente la taille du fichier de manière linéaire.
Les milliers séparés par des virgules (1 234,56) sont-ils sûrs avec la plupart des outils OCR ?
Pas intrinsèquement. Bien que la plupart des moteurs OCR gèrent raisonnablement bien la convention américaine, la virgule peut être mal lue comme un point ou supprimée, produisant 1.234.56 ou 1234.56. Plus critique encore, si le même document contient des valeurs où la virgule est le séparateur décimal (courant dans les flux de travail multi-fournisseurs), l'OCR n'a aucun moyen de distinguer les deux usages par la seule forme — il a besoin d'une connaissance contextuelle du champ concerné. C'est pourquoi les indications de type de champ sont essentielles pour un traitement multi-régions fiable.
Ne laissez pas un point manquant vous coûter des milliers
Les points décimaux et les symboles monétaires sont de petits caractères aux conséquences énormes — un seul point manqué peut vous faire surpayer un fournisseur de 15 000 $ ou laisser passer une violation de conformité lors des contrôles de fin de mois. Ces erreurs ne sont pas aléatoires : chacune a une cause traçable, ancrée dans la façon dont les moteurs OCR traitent les images au niveau du pixel. Savoir quelle cause a touché votre document fait la différence entre ajuster les paramètres à l'aveugle et corriger le problème définitivement.
La solution la plus fiable est un système d'extraction qui comprend ce qu'il lit — reconstruisant les points décimaux manquants, validant les valeurs par rapport aux formats attendus et gérant les conventions de séparateurs régionaux sans configuration manuelle. C'est ce que rend possible l'extraction sémantique. Téléversez une facture avec laquelle votre outil actuel a du mal et comparez la précision côte à côte.