Por que seu OCR está perdendo pontos decimais
& símbolos de moeda?
Se sua ferramenta de OCR acabou de transformar $154.99 em $15499 — inflando o total de uma fatura em 100× — você não está sozinho. Essa é uma das falhas de extração de dados mais relatadas em contas a pagar e gestão de despesas. O problema tem quatro causas distintas, e saber qual delas atingiu seu documento é o caminho mais rápido para corrigi-lo.
Principais Conclusões
- Ferramentas de OCR divulgam 99% de precisão de caracteres, mas concentram seus 1% de erro no único caractere que infla o valor da sua fatura por um fator de 100.
- Cada erro de ponto decimal carrega uma assinatura reconhecível que remonta a uma de apenas quatro causas, desde compressão JPEG descartando pontos de 2 pixels até vírgulas decimais europeias enganando motores treinados nos EUA.
- Associar essa assinatura à sua causa significa parar de tentar ajustes cegos de resolução e aplicar a única correção que resolve o problema real na primeira tentativa.
O custo vai além de um número errado na tela. Sob os requisitos de conformidade SOX, empresas de capital aberto devem manter registros financeiros completos e precisos — um erro de ponto decimal em um pipeline automatizado é uma exposição de conformidade. Para qualquer empresa, um pagamento de $15.499,00 contra uma fatura de $154,99 significa pagar a mais $15.344,01 até que o fechamento mensal o detecte. A maioria dos motores de OCR anuncia 99% de precisão a nível de caractere, mas esse número é enganoso quando um único erro de caractere em um campo numérico pode corromper uma linha inteira de dados. Aqui está o que causa esses erros no nível de pixel — e como detê-los.
Causa 1: Compressão de Baixa Resolução Elimina Puntos Minúsculos
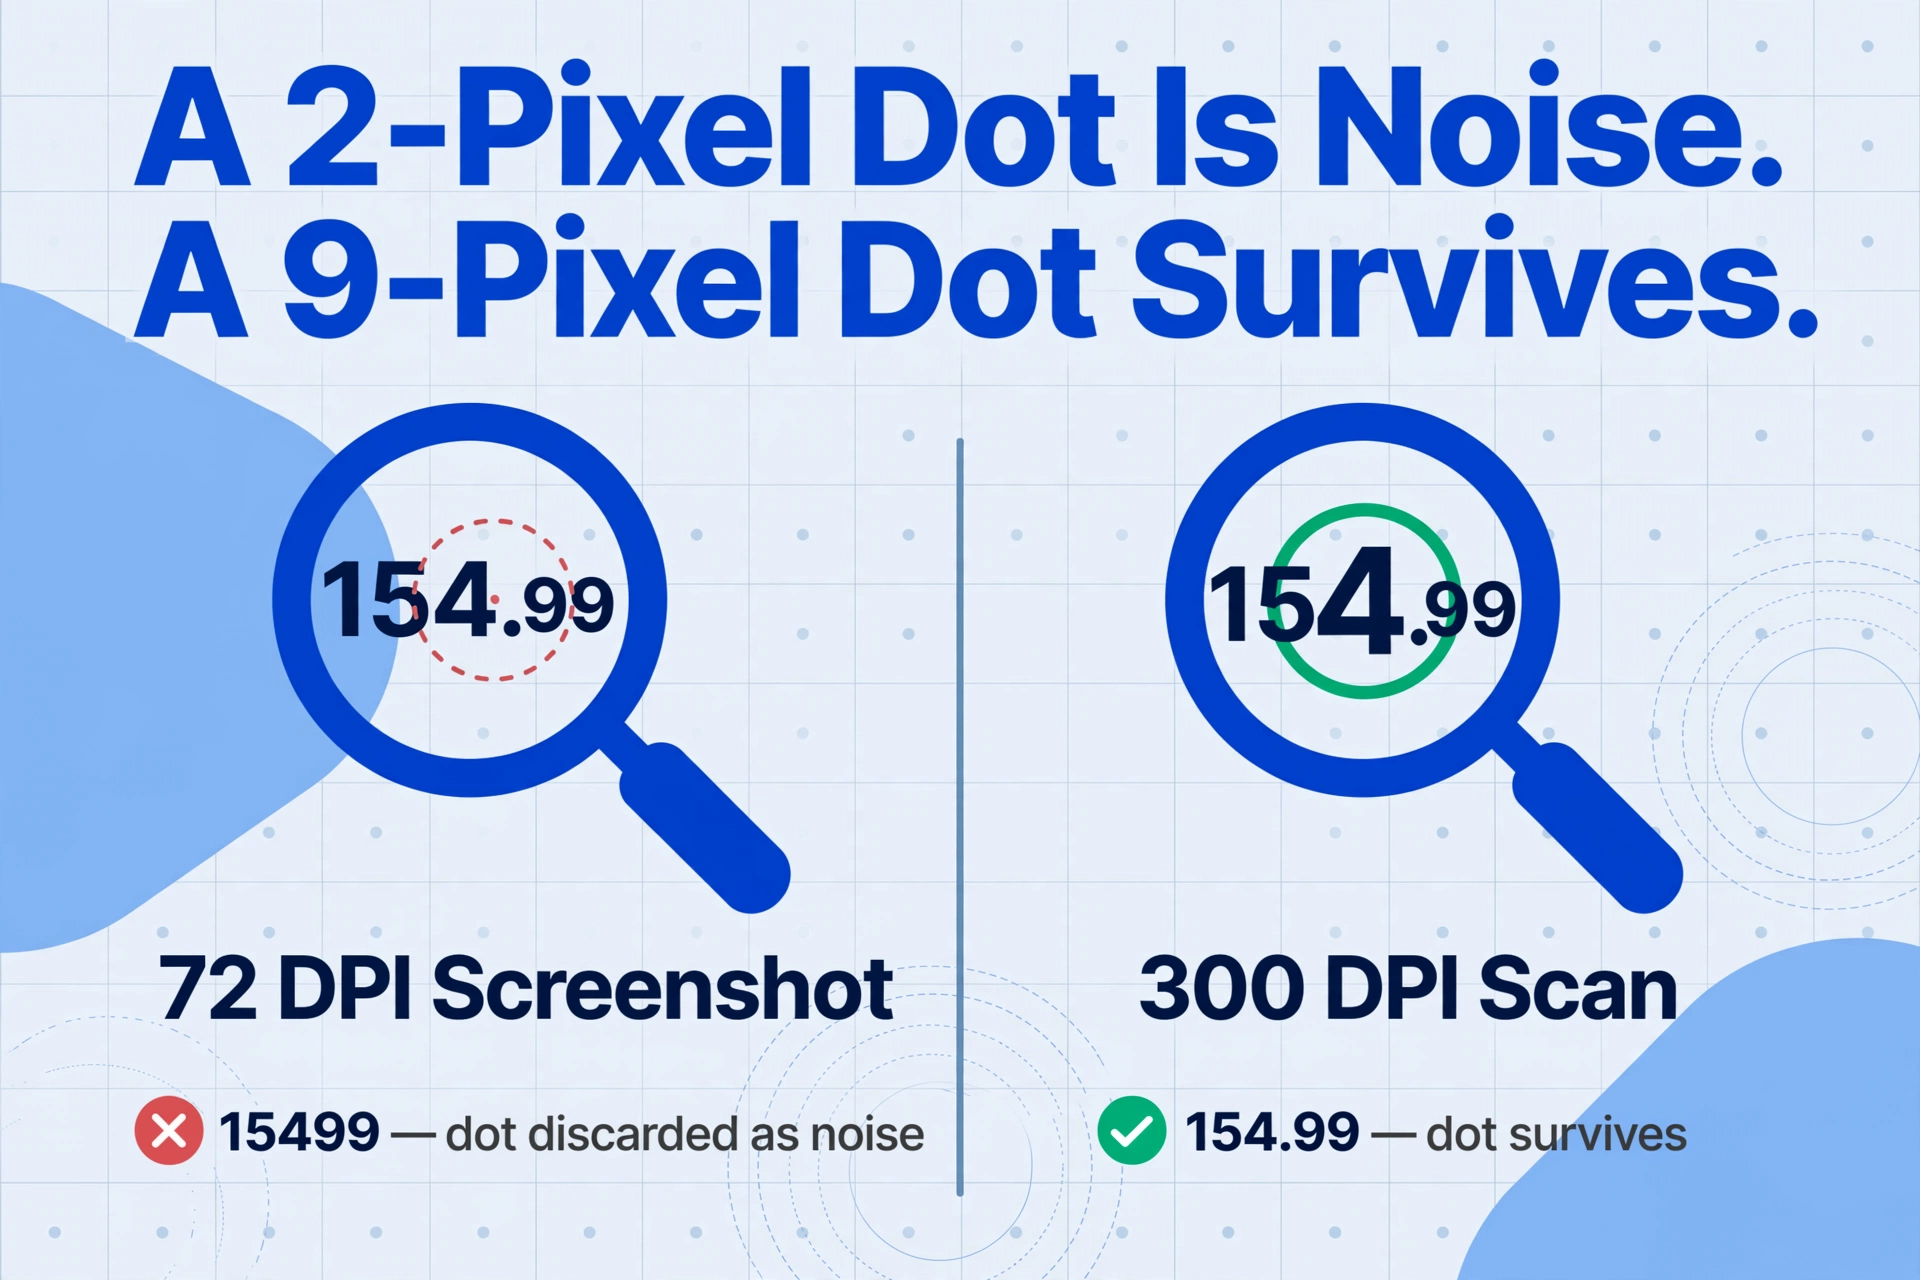
Um ponto decimal em uma fonte de 10pt tem apenas 3 a 5 pixels de largura a 100 DPI. A 72 DPI — a resolução da maioria das capturas de tela — ele encoge a aproximadamente 2 pixels. A compressão JPEG processa imagens em blocos de 8×8 pixels, e um ponto de 2 pixels dentro de um bloco majoritariamente branco é tratado como ruido e descartado.
É assim que $154,99 se torna $15499 — o ponto decimal entre 4 e 9 simplesmente desaparece, e os valores anteriormente distintos 154 e 99 se fundem em um único número que é 100 vezes maior que o original. O mesmo mecanismo afeta montantes de itens de linha, preços unitários, totais de impuestos, e qualquer outro campo que dependa de um componente fracionário de dois dígitos.
O efeito se agrava com má iluminación — sombras ou brilho ao redor de um ponto decimal dificultan ainda mais que o filtro de binarização (conversão de color a pixels preto-e-blanco) distinga o ponto de seu fundo. Uma vez que o ponto desaparece na imagem binarizada, nenhún modelo de linguagem pode recuperá-lo — porque o motor nunca o viu.
Causa 2: Confusão pela Proximidade do Símbolo de Moeda
Os símbolos de moeda ficam em um ponto cego para a maioria dos mecanismos de OCR. O cifrão ($), o símbolo do euro (€), o da libra (£) e o do iene (¥) são caracteres decorativos que aparecem imediatamente antes ou depois de um valor numérico. O OCR tradicional os trata como glifos isolados a serem identificados, e frequentemente os reconhece de forma errada.
Três modos distintos de falha afetam os símbolos de moeda na prática:
- O símbolo é totalmente descartado — o mecanismo de OCR decide que $1.234,56 deve ser simplesmente 1.234,56, removendo silenciosamente o indicador de moeda. Isso gera uma saída ambígua: 1.234,56 está em USD, EUR ou outra unidade? Quando dados de vários fornecedores ou moedas são mesclados em uma única planilha, a perda do marcador de moeda torna impossível determinar quais valores são comparáveis.
- O símbolo é interpretado como letra ou dígito — $ é frequentemente lido como S ou 5. £ pode ser lido como um L maiúsculo ou um E estilizado. Essas substituições produzem saídas como
S1.234,56, que sistemas downstream podem interpretar como texto em vez de valor numérico, causando erros de conversão de tipo em importações de banco de dados ou fórmulas do Excel. - O símbolo se funde com um dígito adjacente — quando um cifrão é impresso em fonte em negrito ou serifada e fica próximo ao primeiro dígito, o OCR pode ler a região combinada como um único caractere.
$5vira55ou95, dependendo dos detalhes da fonte.
A confusão com símbolos de moeda é frustrante porque a saída passa por uma inspeção visual rápida — os números parecem corretos — mas a informação sobre qual moeda aqueles números representam foi perdida. É por isso que a precisão em nível de campo importa mais do que a precisão em nível de caractere no processamento de documentos financeiros.
Causa 3: Desfoque por anti-aliasing em caracteres pequenos
O anti-aliasing (suavização de fontes) renderiza as bordas dos caracteres como gradientes de pixels parcialmente preenchidos para criar a ilusão de curvas suaves. Em textos grandes, isso melhora a legibilidade, mas em caracteres pequenos, como pontos decimais e símbolos de moeda, o efeito é o oposto.
Um ponto decimal renderizado em 8pt ou 9pt — comum em tabelas de itens de faturas ou nas letras miúdas de recibos — tem tão poucos pixels que qualquer suavização o desfoca contra o fundo. Quando o mecanismo de OCR aplica a binarização (conversão da imagem para preto e branco), o ponto vira um borrão cinza que fica abaixo do limite de confiança, e o mecanismo não gera nada para aquela posição.
O mesmo vale para sinais de menos em valores negativos, parênteses usados em créditos e os traços finos de símbolos de moeda como ¥ ou € — todos frequentemente renderizados em tamanhos muito pequenos em células densas de tabelas, onde o anti-aliasing é mais destrutivo.
Causa 4: Ambiguidade entre vírgula e ponto decimal
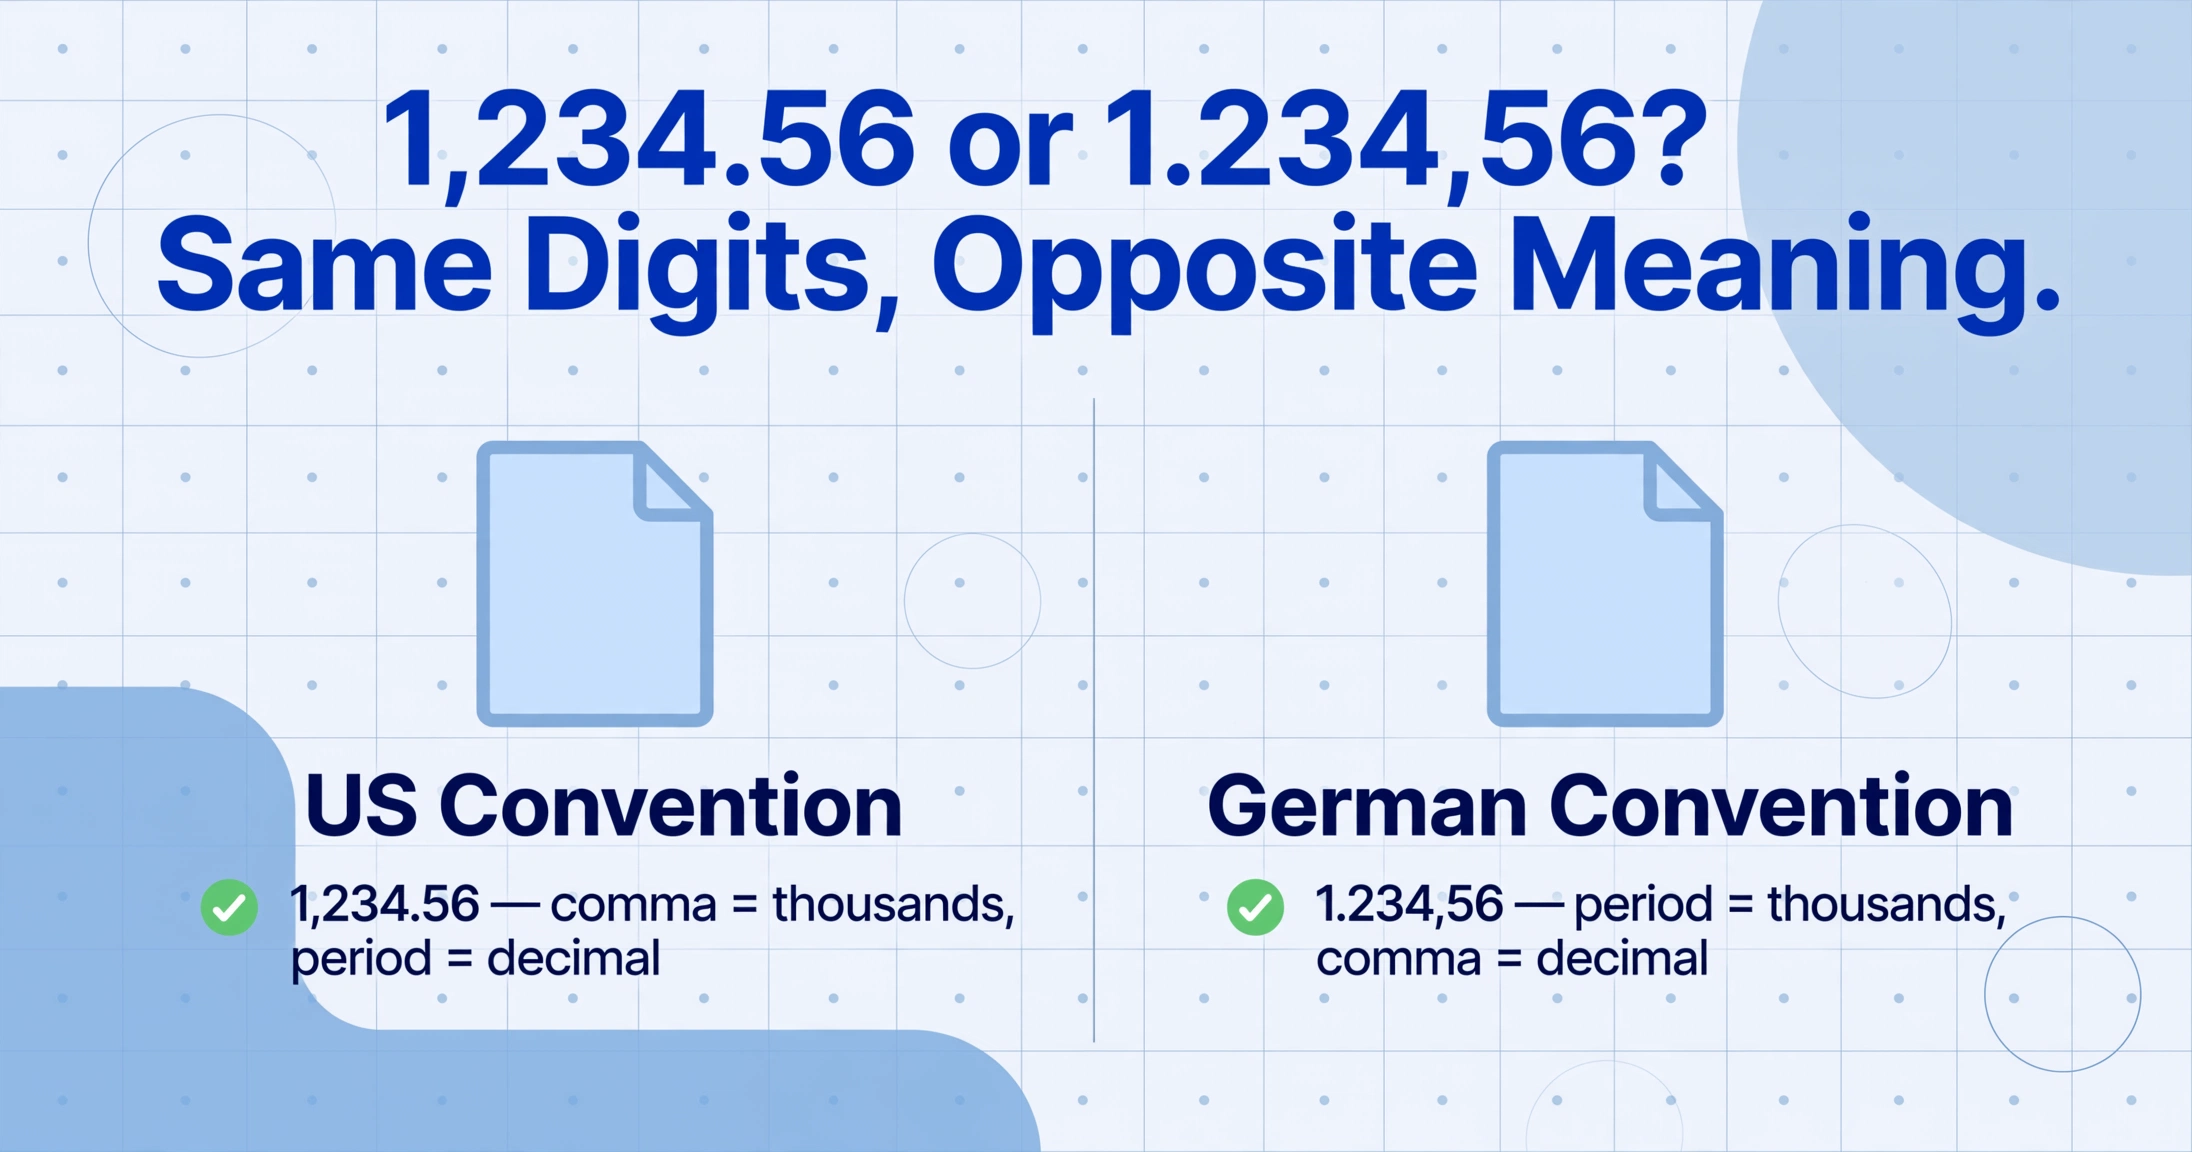
Um único caractere — o ponto ou a vírgula — carrega significados opostos dependendo da origem do documento. Nos EUA, 1,234.56 usa a vírgula como separador de milhares e o ponto como decimal. Na maior parte da Europa continental, o mesmo valor escrito aparece como 1.234,56 — ponto como separador de milhares, vírgula como decimal. Um mecanismo de OCR sem contexto regional não tem uma forma confiável de distingui-los.
Um sistema de OCR projetado para faturas dos EUA que encontra um 1.234,56 alemão pode dividi-lo em dois números (1 e 234,56) ou remover ambos os separadores completamente (123456), inflando o valor em 100×. De qualquer forma, dados corrompidos entram silenciosamente no sistema contábil.
O problema se agrava com documentos de regiões mistas — um fornecedor francês que usa vírgula decimal, mas rótulos de campos em inglês, confunde ferramentas de OCR baseadas em localidade que esperam uma única convenção regional.
O custo real da ambiguidade decimal: Uma equipe de contas a pagar que processa 1.000 faturas internacionais por mês, com uma taxa de erro de leitura decimal de 2%, enfrenta 20 erros silenciosos. Se apenas 5 deles resultarem em pagamentos incorretos, a média de $3.000 por correção significa $15.000 em perdas evitáveis por mês — e isso sem contar o tempo gasto em investigações e reparação do relacionamento com fornecedores.
Como corrigir: uma estrutura de diagnóstico baseada em sintomas
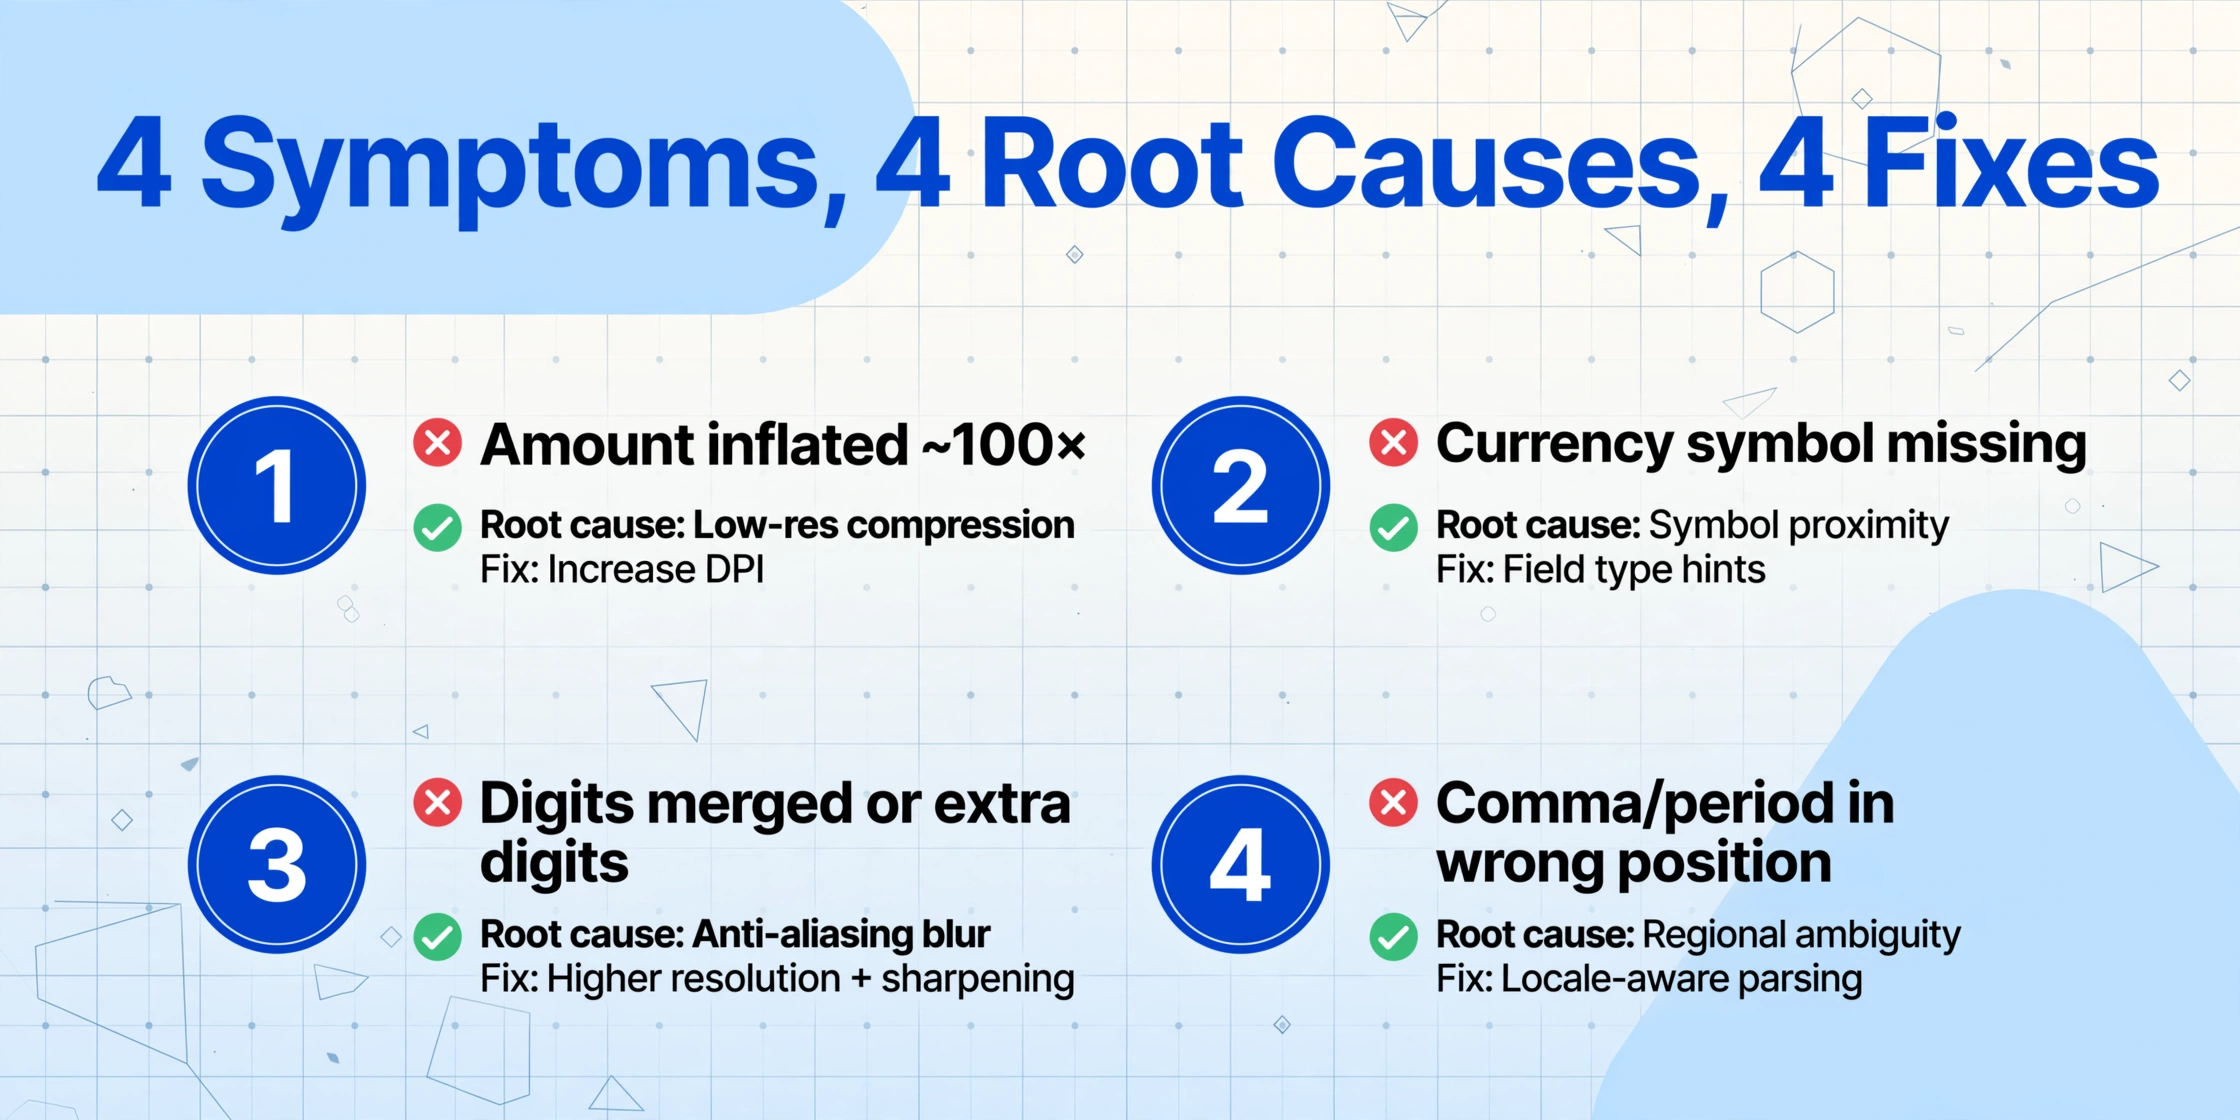
Nem todos os erros de decimais e moeda têm a mesma causa raiz. Usar a correção errada desperdicia tempo e não resolve o problema real. A tabela abaixo mapea o sintoma que você vê na saída extraída à causa mais provável e à correção correspondente.
| Sintoma na saída | Causa mais provável | Correção principal |
|---|---|---|
| Valor inflado ~100× (por exemplo, 154,99 → 15499) | Compression de baixa resolução (Causa 1) | Aumentar DPI de entrada / usar formato sem perdas |
| Símbolo de moeda ausente ($/€/£ omitido) | Proximidade do símbolo ou renderização da fonte (Causa 2 ou 3) | Dicas de tipo de campo + extração semântica |
| Símbolo de moeda interpretado como letra (por exemplo, $ → S) | Confusão de forma de caractere (Causa 2) | Correspondência de padrão regex em pós-processamento |
| Dígitos mesclados ou dígitos extras aparecendo | Desfoque anti-aliasing (Causa 3) | Resolução de entrada maior + preprocessamento de nitidez |
| Vírgula/ponto em posição incorreta (123.456 vs 123,456) | Ambiguidade de convenção regional (Causa 4) | Pós-processamento com reconhecimento de localidade + conferência cruzada |
| Valor dividido em dois valores separados | Interpretación incorreta da vírgula decimal (Causa 4) | Analizador contextual com detección de região |
Correção 1: Melhore a Qualidade da Imagem de Origem
A correção mais eficaz é a mais direta: dê ao mecanismo de OCR mais pixels para trabalhar. Um ponto decimal a 300 DPI ocupa cerca de 9 pixels — o suficiente para que a compressão JPEG não o descarte como ruído. A 600 DPI, esse mesmo ponto abrange 18 pixels e sobrevive a configurações de compressão agressivas.
- Digitalize com mínimo de 300 DPI — 200 DPI é o mínimo absoluto; 300 DPI é o padrão confiável para documentos financeiros. Use um scanner de mesa em vez de câmera de celular sempre que possível.
- Salve como TIFF ou PNG, não JPEG — a compressão com perdas do JPEG é a principal causa do desaparecimento do ponto decimal. TIFF e PNG preservam os pontos de 2 a 3 pixels que o JPEG descarta.
- Para fotos de celular — fotografe diretamente de cima, use uma superfície bem iluminada e exporte na resolução máxima da câmera. Corte rente à área do documento para maximizar a densidade de pixels na região do texto.
Correção 2: Use Dicas de Tipo de Campo
Esta é a correção que a maioria das ferramentas de OCR de uso geral não pode oferecer — e a mais eficaz para dados financeiros. Quando você informa ao sistema que um campo é um valor monetário, ele trata o ponto decimal e o símbolo de moeda como sinais semânticos sobre o valor, não como caracteres comuns.
No ImageToTable.ai, isso funciona por meio da Extração de Colunas Personalizadas: você define colunas como "Total da Fatura" e a IA entende o tipo de campo. Quando encontra um valor em um campo de moeda conhecido, ela procura ativamente pelo separador decimal e usa a estrutura esperada de duas casas decimais para validar os dígitos. Se a saída bruta produzir "15499" para um campo "Total (USD)", a IA sinaliza o decimal ausente e aplica correção probabilística.
Esta é a diferença fundamental entre extração baseada em posição (onde a ferramenta lê cada caractere em uma zona e gera o que vê) e extração baseada em semântica (onde a ferramenta entende o que está procurando e usa esse contexto para resolver ambiguidades). As dicas de tipo de campo transformam um ponto decimal perdido de uma corrupção silenciosa de dados em uma ambiguidade corrigível. A mesma abordagem permite que você processe lotes de faturas de fornecedores diretamente em planilhas Excel estruturadas sem configuração de modelo por fornecedor — a IA lida com as variações de formato entendendo o que cada campo significa, não onde ele está na página.
Correção 3: Pós-processamento com Regex e Conferência Cruzada
Quando você não consegue controlar a qualidade da fonte ou a ferramenta de extração, o pós-processamento é a rede de segurança. Duas técnicas capturam a maioria dos erros de decimais e moeda após a extração. Para uma visão geral mais ampla sobre pré-processamento, ajuste do mecanismo e estratégias de validação em nível de campo, leia nosso guia completo sobre como melhorar a precisão do OCR em documentos financeiros.
Validação baseada em padrões. A maioria dos valores monetários segue padrões previsíveis. Um regex como ^\d{1,3}(?:,\d{3})*\.\d{2}$ valida valores no formato dos EUA. Qualquer valor sem ponto decimal, com quatro casas decimais ou com separadores incompatíveis é sinalizado para revisão.
Conferência cruzada (validação matemática). Em qualquer documento com itens de linha, a soma dos valores das linhas deve ser igual ao total. Uma discrepância indica pontos decimais mal lidos. Se os itens somam $1.249,85 mas o total é extraído como $124.985,00, o decimal migrou três posições — quase certamente um erro de perda de ponto. A conferência cruzada detecta isso instantaneamente, independentemente da causa raiz.
O pós-processamento não substitui uma boa qualidade da fonte ou extração semântica — é uma camada de detecção projetada para capturar os erros que passaram despercebidos.
Quando Escalar: Reconhecendo os Limites das Correções
Nem todos os erros de ponto decimal e símbolo de moeda podem ser corrigidos melhorando a qualidade da entrada ou adicionando regras de pós-processamento. Três cenários indicam que a abordagem de extração em si precisa mudar:
Cenário 1: Processamento de alto volume com fontes mistas. Se seu fluxo de trabalho processa faturas de centenas de fornecedores usando formatos e convenções regionais diferentes, o ajuste de pré-processamento por fornecedor não escala — a sobrecarga anula os ganhos de eficiência da automação.
Cenário 2: Documentos predominantemente capturados por celular. Fotos de celular introduzem distorção de perspectiva, reflexos e iluminação variável que degradam consistentemente o reconhecimento de caracteres pequenos. A correção não é melhor pré-processamento; é um sistema que usa contexto semântico para interpretar valores quando o reconhecimento em nível de caractere é incerto.
Cenário 3: Documentos com tabelas extremamente densas. Extratos bancários, relatórios de corretoras e faturas com várias linhas compactam números em células pequenas onde os pontos decimais são renderizados de 6pt a 8pt. Nesse tamanho, o desfoque de anti-aliasing é quase inevitável, independentemente da resolução de digitalização — o OCR baseado em pixels atinge um teto fundamental de precisão.
Nesses cenários, mesmo um pré-processamento perfeito não consegue preencher a lacuna — a solução é uma abordagem baseada em visão que entende a estrutura do documento e a semântica dos campos, não apenas os valores dos pixels. Para orientação relacionada, veja como células mescladas quebram a extração de tabelas e por que o OCR falha ao reconhecer tabelas — cenários comuns onde erros de decimal se originam de leituras estruturais incorretas, em vez de problemas em nível de pixel.
Perguntas Frequentes
Por que meu OCR fica perdendo o ponto decimal em fotos de celular, mas não em documentos digitalizados?
Fotos de celular tiradas à distância do braço produzem imagens na faixa de 72–150 DPI — um ponto decimal nessa resolução tem apenas 2–4 pixels de largura. A compressão JPEG processa a imagem em blocos de 8×8 pixels, e um ponto de 2 pixels dentro de um bloco majoritariamente branco é tratado como ruído e descartado. Scanners de mesa a 300 DPI produzem pontos com 9+ pixels, que sobrevivem à compressão de forma confiável. Esta é uma limitação física difícil: caracteres pequenos precisam de pixels suficientes para serem distinguíveis do ruído do sensor.
O OCR baseado em IA consegue corrigir erros de ponto decimal que o OCR tradicional não detecta?
Sim — mas não "vendo" um ponto que o JPEG destruiu. A extração baseada em IA infere a posição do decimal usando contexto. Quando o sistema sabe que está lendo um total de fatura e a saída bruta mostra "15499", ele aplica padrões aprendidos — a maioria dos totais tem duas casas decimais — e reconstrói $154.99. Isso funciona apenas quando o tipo de campo é conhecido; em um cenário de OCR sem contexto, nenhuma IA consegue corrigir o que nunca foi capturado.
Como lidar com faturas com formatação regional mista (fornecedores dos EUA e da UE)?
O processamento de regiões mistas é o caso mais difícil para análise dependente de convenções. A abordagem mais prática é validar os valores extraídos contra a consistência matemática — os itens de linha somam o total? Se uma leitura com vírgula decimal de 1.234,56 produzir um valor claramente implausível, o sistema tenta a interpretação alternativa. Ferramentas de extração semântica podem aplicar isso automaticamente — se a IA entende que um campo deve ser um valor razoável, ela descarta interpretações de separadores implausíveis.
Aumentar a resolução de uma imagem de baixa qualidade antes do OCR ajuda a recuperar pontos decimais?
Aumentar a resolução tradicionalmente (interpolação bilinear ou bicúbica) não recupera detalhes perdidos — ela espalha os pixels existentes por uma tela maior. Um ponto decimal de 2 pixels ampliado em 200% vira 4 pixels de cinza interpolado, ainda abaixo dos limites de detecção da maioria dos OCRs. Começar com uma imagem de origem de maior qualidade é sempre mais eficaz do que tentar corrigir uma imagem degradada.
Qual é a resolução mínima de digitalização para capturar pontos decimais de forma confiável em documentos financeiros?
300 DPI é o mínimo prático. A 200 DPI, pontos decimais em fontes padrão de 10pt ocupam 4–5 pixels — apenas marginalmente melhor que a resolução de câmera de celular. A 300 DPI, o mesmo ponto ocupa 8–9 pixels, dando aos mecanismos de OCR sinal suficiente para distingui-lo do ruído de fundo. Para documentos com fontes muito pequenas (8pt ou menos em tabelas de itens), recomenda-se 400–600 DPI, com a ressalva de que DPI mais alto aumenta o tamanho do arquivo linearmente.
Milhares separados por vírgula (1.234,56) são seguros com a maioria das ferramentas de OCR?
Não inerentemente. Embora a maioria dos mecanismos de OCR lide razoavelmente bem com a convenção dos EUA, a vírgula pode ser interpretada como ponto ou descartada, produzindo 1.234.56 ou 1234.56. Mais criticamente, se o mesmo documento contém valores onde a vírgula é o separador decimal (comum em fluxos de trabalho com múltiplos fornecedores), o OCR não tem como distinguir os dois usos apenas pela forma — ele precisa de conhecimento contextual sobre qual campo é qual. É por isso que dicas de tipo de campo são essenciais para processamento confiável em múltiplas regiões.
Não Deixe um Ponto Decimal Faltando Custar Milhares para Você
Pontos decimais e símbolos de moeda são caracteres pequenos com consequências enormes — um único ponto perdido pode pagar a mais a um fornecedor em $15.000 ou deixar passar uma violação de conformidade nos fechamentos mensais. Os erros não são aleatórios: cada um tem uma causa rastreável enraizada em como os mecanismos de OCR processam imagens no nível do pixel. Saber qual causa afetou seu documento é a diferença entre ajustar configurações às cegas e corrigir o problema permanentemente.
A correção mais confiável é um sistema de extração que entende o que lê — reconstruindo pontos decimais ausentes, validando valores contra formatos esperados e lidando com convenções regionais de separadores sem configuração manual. É isso que a extração semântica torna possível. Envie uma fatura com a qual sua ferramenta atual tem dificuldade e compare a precisão lado a lado.