¿Por qué tu OCR omite los puntos decimales
y los símbolos de moneda?
Si tu herramienta de OCR acaba de convertir $154.99 en $15499 — inflando el total de una factura por 100× — no estás solo. Este es uno de los fallos de extracción de datos más reportados en cuentas por pagar y gestión de gastos. El problema tiene cuatro causas raíz distintas, y saber cuál afectó a tu documento es la forma más rápida de solucionarlo.
Conclusiones clave
- Las herramientas de OCR presumen de una precisión de caracteres del 99%, pero concentran su tasa de error del 1% en el único carácter que infla el importe de tu factura por un factor de 100.
- Cada error de punto decimal tiene una huella reconocible que se remonta a una de solo cuatro causas raíz, desde la compresión JPEG que descarta puntos de 2 píxeles hasta las comas decimales europeas que confunden a los motores entrenados en EE. UU.
- Relacionar esa huella con su causa significa dejar de probar ajustes de resolución a ciegas y aplicar la única solución que aborda el problema real al primer intento.
El costo va más allá de un número incorrecto en una pantalla. Bajo los requisitos de cumplimiento de SOX, las empresas que cotizan en bolsa deben mantener registros financieros completos y precisos: un error de punto decimal en un proceso automatizado es una exposición al cumplimiento. Para cualquier negocio, un pago de $15,499.00 contra una factura de $154.99 significa pagar de más $15,344.01 hasta que el cierre de fin de mes lo detecte. La mayoría de los motores de OCR anuncian una precisión del 99% a nivel de caracteres, pero esa cifra es engañosa cuando un solo error de carácter en un campo numérico puede romper una fila completa de datos. Esto es lo que causa estos errores a nivel de píxel — y cómo detenerlos.
Causa 1: La Compresión de Baja Resolución Elimina Puntos Diminutos
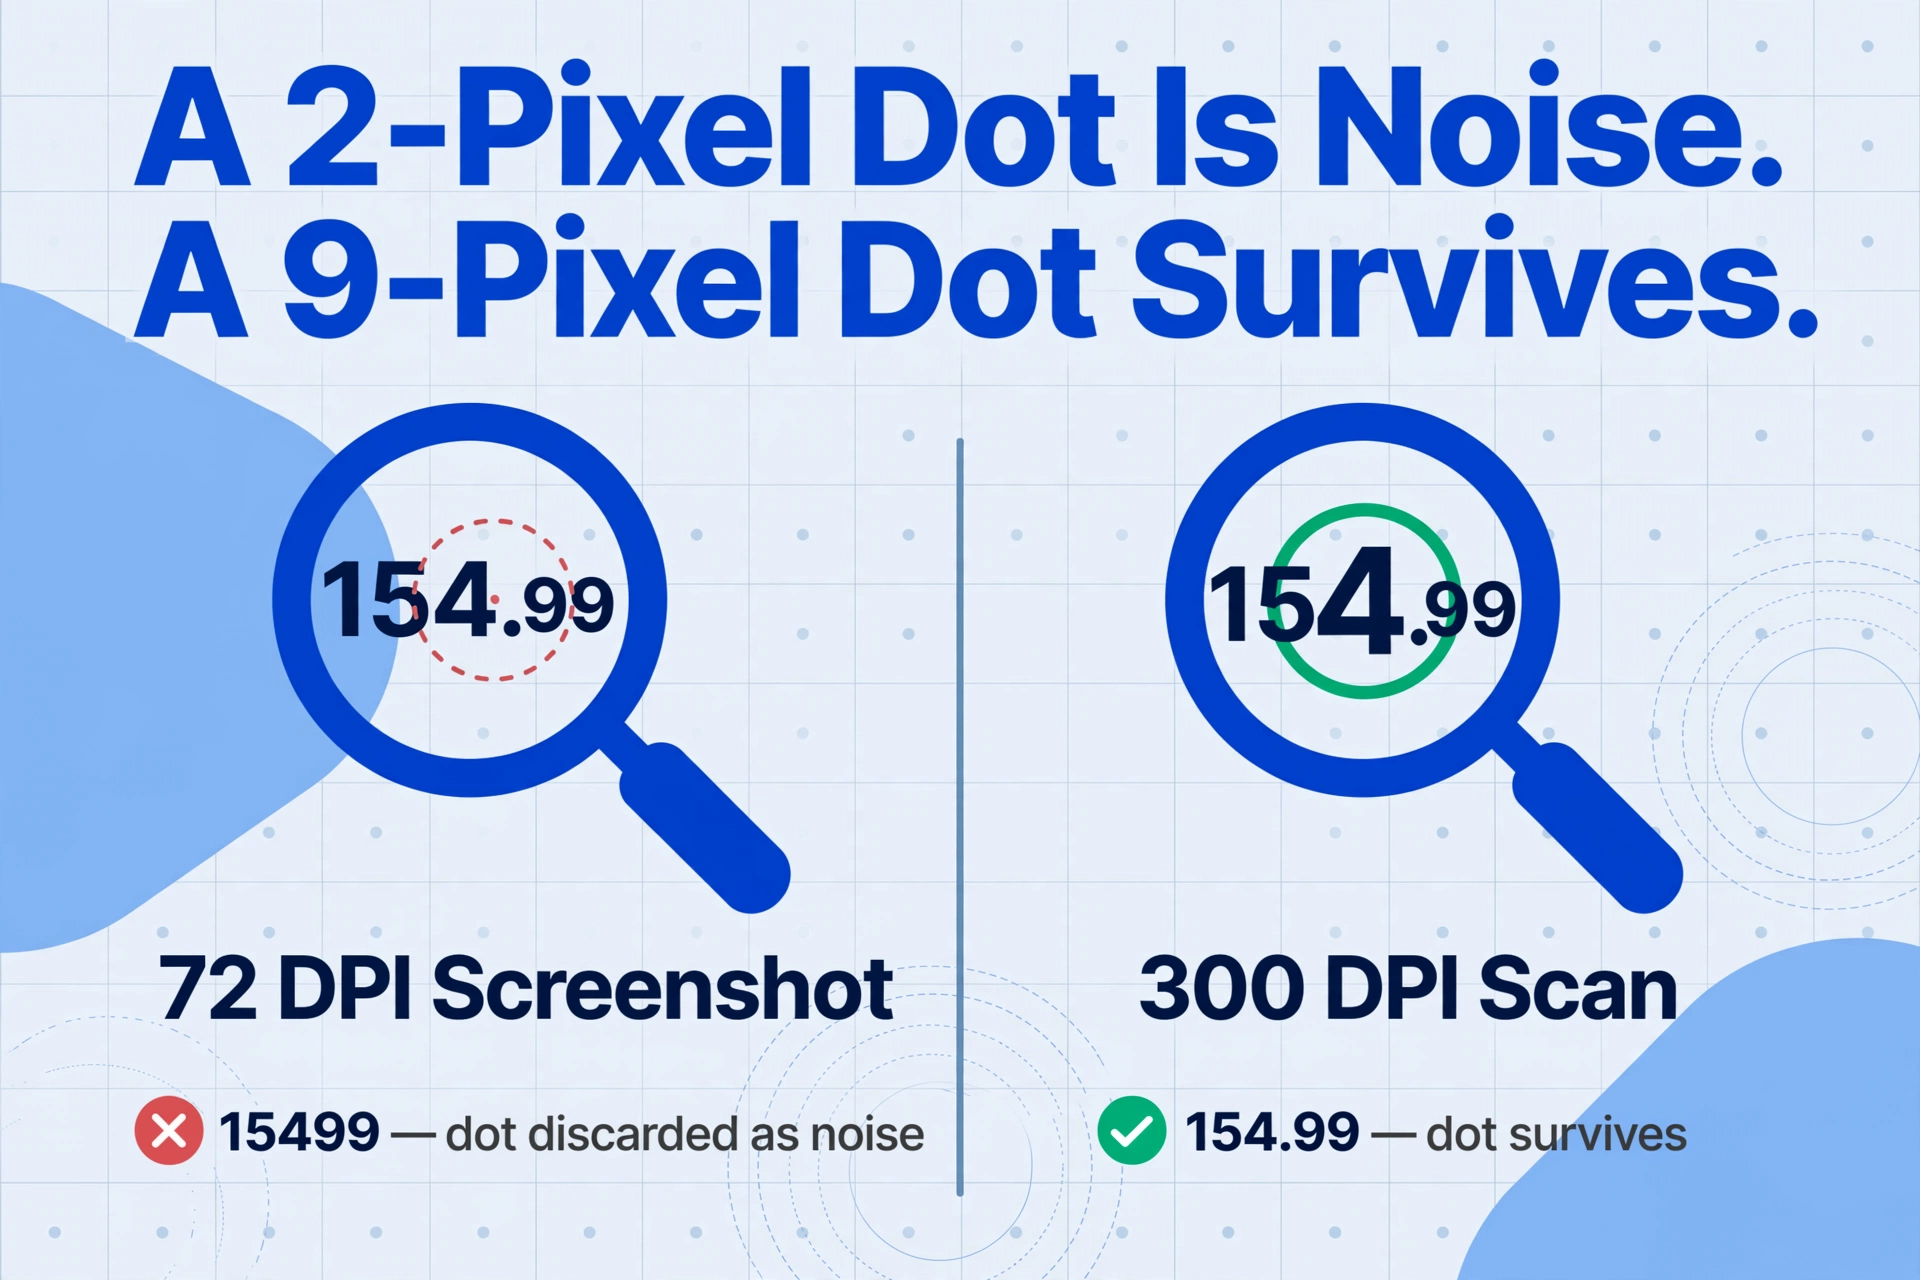
Un punto decimal en una fuente de 10pt tiene solo de 3 a 5 píxeles de ancho a 100 DPI. A 72 DPI — la resolución de la mayoría de las capturas de pantalla — se reduce a aproximadamente 2 píxeles. La compresión JPEG procesa imágenes en bloques de 8×8 píxeles, y un punto de 2 píxeles dentro de un bloque mayormente blanco se trata como ruido y se descarta.
Así es como $154.99 se convierte en $15499: el punto decimal entre 4 y 9 simplemente desaparece, y los valores previamente distintos 154 y 99 se fusionan en un solo número que es 100 veces mayor que el original. El mismo mecanismo afecta los montos de partidas, precios unitarios, totales de impuestos y cualquier otro campo que dependa de un componente fraccionario de dos dígitos.
El efecto empeora con mala iluminación: las sombras o el resplandor alrededor de un punto decimal hacen que sea aún más difícil para el filtro de binarización (conversión de color a píxeles en blanco y negro) distinguir el punto de su fondo. Una vez que el punto desaparece en la imagen binarizada, ningún modelo de lenguaje puede recuperarlo — porque el motor nunca lo vio.
Causa 2: Confusión por Proximidad del Símbolo de Moneda
Los símbolos de moneda se encuentran en un punto ciego para la mayoría de los motores de OCR. El signo de dólar ($), el símbolo de euro (€), el signo de libra (£) y el signo de yen (¥) son caracteres decorativos que aparecen inmediatamente antes o después de un valor numérico. El OCR tradicional los trata como glifos aislados que deben identificarse, y con frecuencia los interpreta incorrectamente.
En la práctica, tres modos de fallo distintos afectan a los símbolos de moneda:
- El símbolo se elimina por completo — el motor de OCR decide que $1,234.56 debería ser simplemente 1,234.56, eliminando silenciosamente el indicador de moneda. Esto crea una salida ambigua: ¿1,234.56 está en USD, EUR u otra unidad? Cuando se combinan datos de múltiples proveedores o monedas en una sola hoja de cálculo, la pérdida del marcador de moneda hace imposible determinar qué valores son comparables.
- El símbolo se interpreta erróneamente como una letra o dígito — $ se lee con frecuencia como S o 5. £ puede leerse como una L mayúscula o una E estilizada. Estas sustituciones producen salidas como
S1,234.56, que los sistemas posteriores pueden interpretar como una cadena en lugar de un valor numérico, causando errores de conversión de tipo en importaciones de bases de datos o fórmulas de Excel. - El símbolo se fusiona con un dígito adyacente — cuando un signo $ se imprime en una fuente negrita o serif y se sitúa cerca del primer dígito, el OCR puede leer la región combinada como un solo carácter.
$5se convierte en55o95según los detalles de la fuente.
La confusión con el símbolo de moneda es frustrante porque la salida supera una revisión visual rápida — los números parecen correctos — pero la información sobre qué moneda representan esos números se ha perdido. Por eso la precisión a nivel de campo importa más que la precisión a nivel de carácter en el procesamiento de documentos financieros.
Causa 3: Desenfoque por anti-aliasing en caracteres pequeños
El anti-aliasing (suavizado de fuentes) representa los bordes de los caracteres como degradados de píxeles parcialmente rellenos para crear la ilusión de curvas suaves. En el texto del cuerpo grande, esto mejora la legibilidad, pero en caracteres pequeños como puntos decimales y símbolos de moneda, produce el efecto contrario.
Un punto decimal representado a 8pt o 9pt — común en tablas de partidas de facturas o en la letra pequeña de los recibos — tiene tan pocos píxeles que cualquier suavizado lo difumina contra el fondo. Cuando el motor de OCR aplica la binarización (conversión de la imagen a blanco y negro), el punto se convierte en una mancha gris que cae por debajo del umbral de confianza, y el motor no genera nada para esa posición.
Lo mismo se aplica a los signos menos para cantidades negativas, los paréntesis utilizados para créditos y los trazos finos de símbolos de moneda como ¥ o € — todos ellos se representan con frecuencia en tamaños muy pequeños en celdas de tablas densas, donde el anti-aliasing es más destructivo.
Causa 4: Ambigüedad entre coma y convención decimal
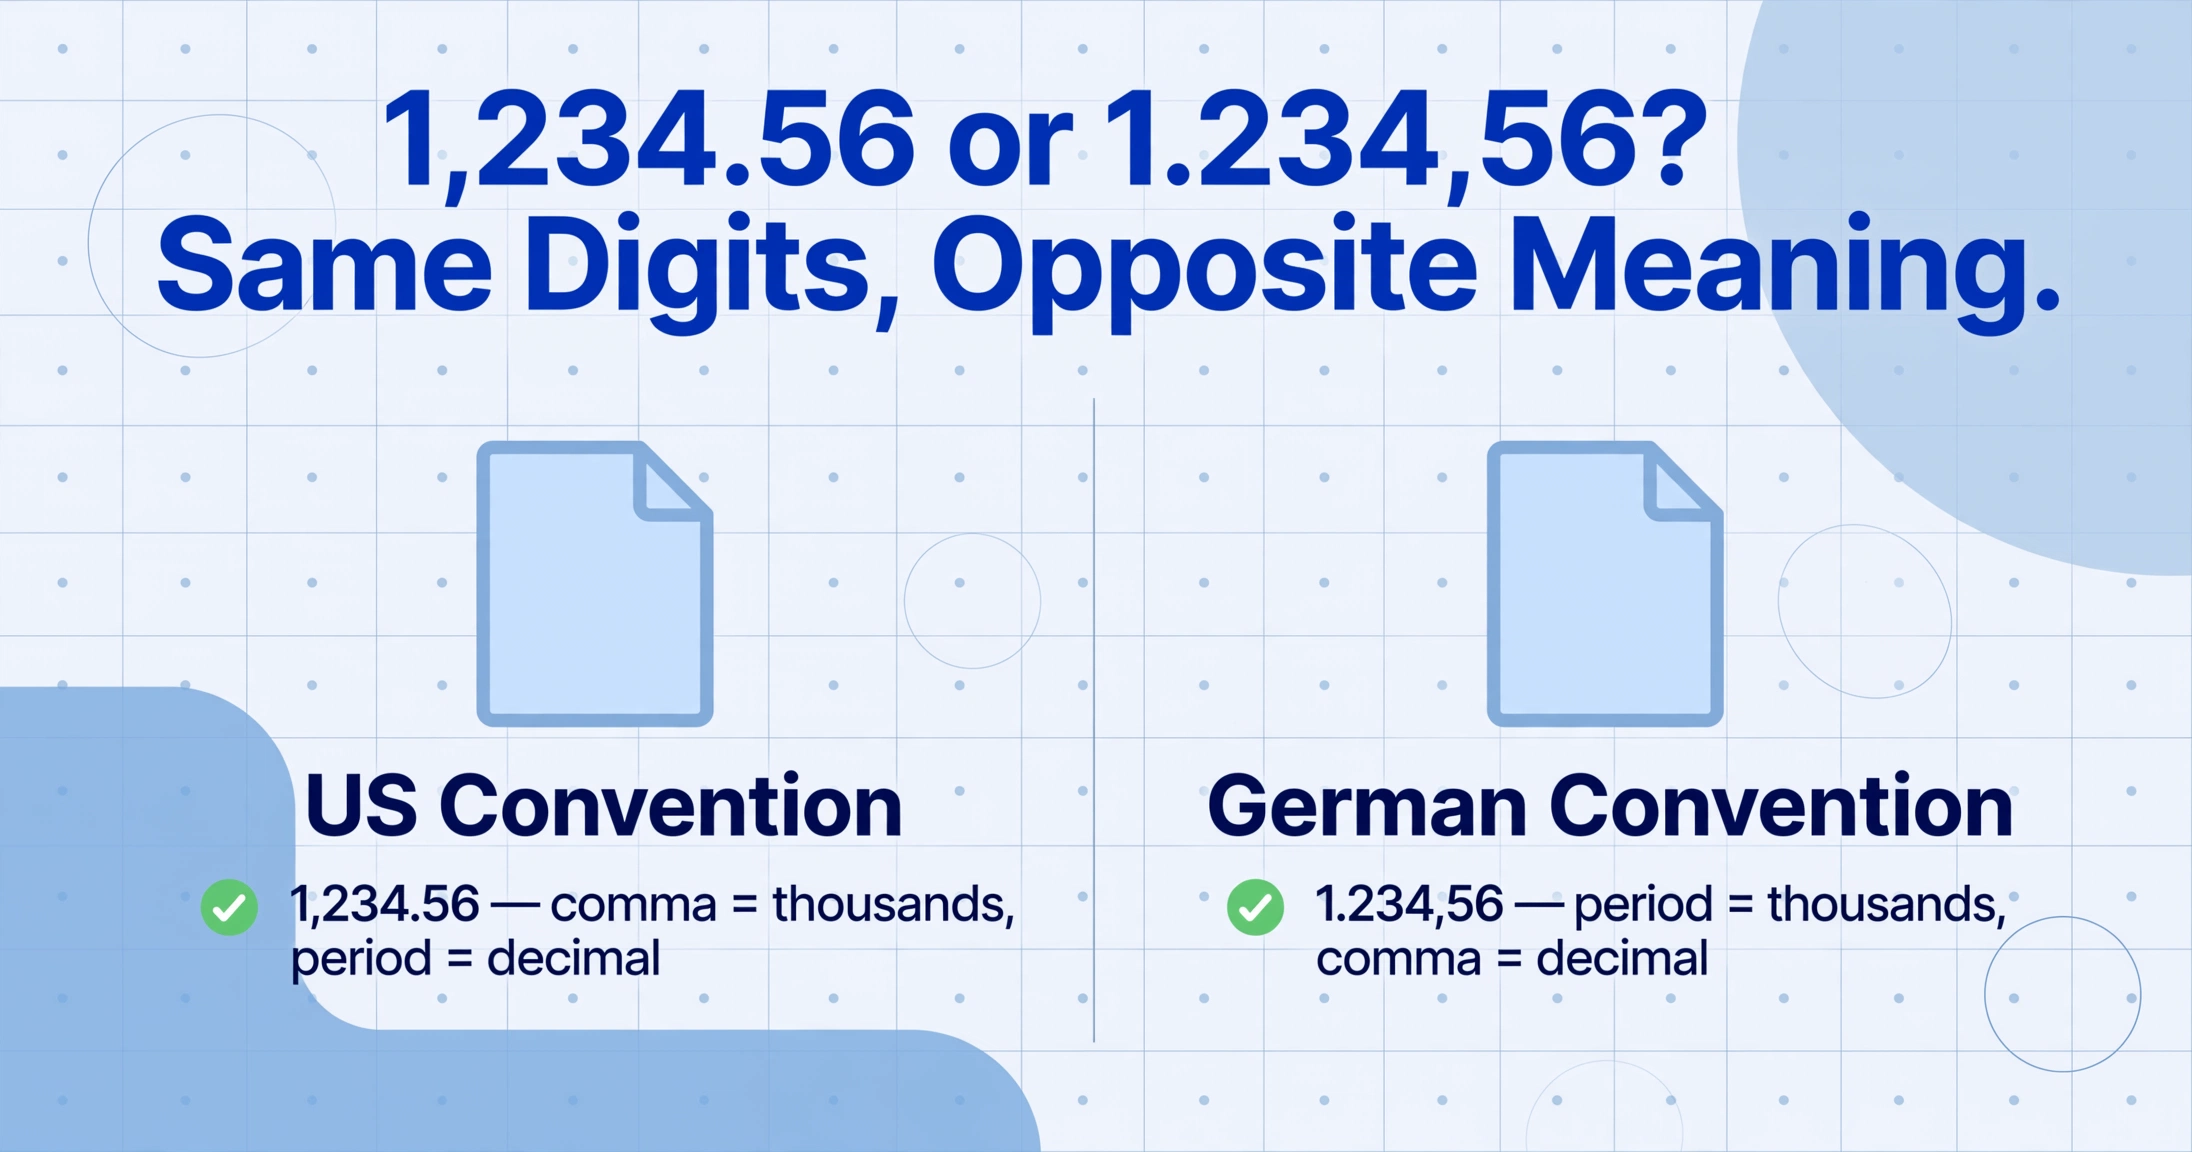
Un solo carácter — el punto o la coma — tiene significados opuestos según el origen del documento. En Estados Unidos, 1,234.56 usa la coma como separador de miles y el punto como decimal. En la mayor parte de Europa continental, el mismo valor escrito aparece como 1.234,56 — el punto como separador de miles y la coma como decimal. Un motor de OCR sin contexto regional no tiene una forma fiable de distinguirlos.
Un sistema de OCR diseñado para facturas estadounidenses que encuentre un 1.234,56 alemán puede dividirlo en dos números (1 y 234,56) o eliminar ambos separadores por completo (123456), inflando el valor en 100×. En cualquier caso, los datos corruptos entran silenciosamente en el sistema contable.
El problema se agrava con documentos de regiones mixtas: un proveedor francés que usa comas decimales pero etiquetas de campo en inglés confunde a las herramientas de OCR basadas en la configuración regional que esperan una única convención regional.
El costo real de la ambigüedad decimal: Un equipo de cuentas por pagar que procesa 1,000 facturas internacionales al mes con una tasa de error de lectura decimal del 2% se enfrenta a 20 errores silenciosos. Si incluso 5 de ellos resultan en pagos incorrectos, el promedio de $3,000 por corrección significa $15,000 en pérdidas evitables mensuales — y eso sin contar el tiempo dedicado a investigaciones y a la reparación de las relaciones con los proveedores.
Cómo solucionarlo: un marco de diagnóstico basado en síntomas
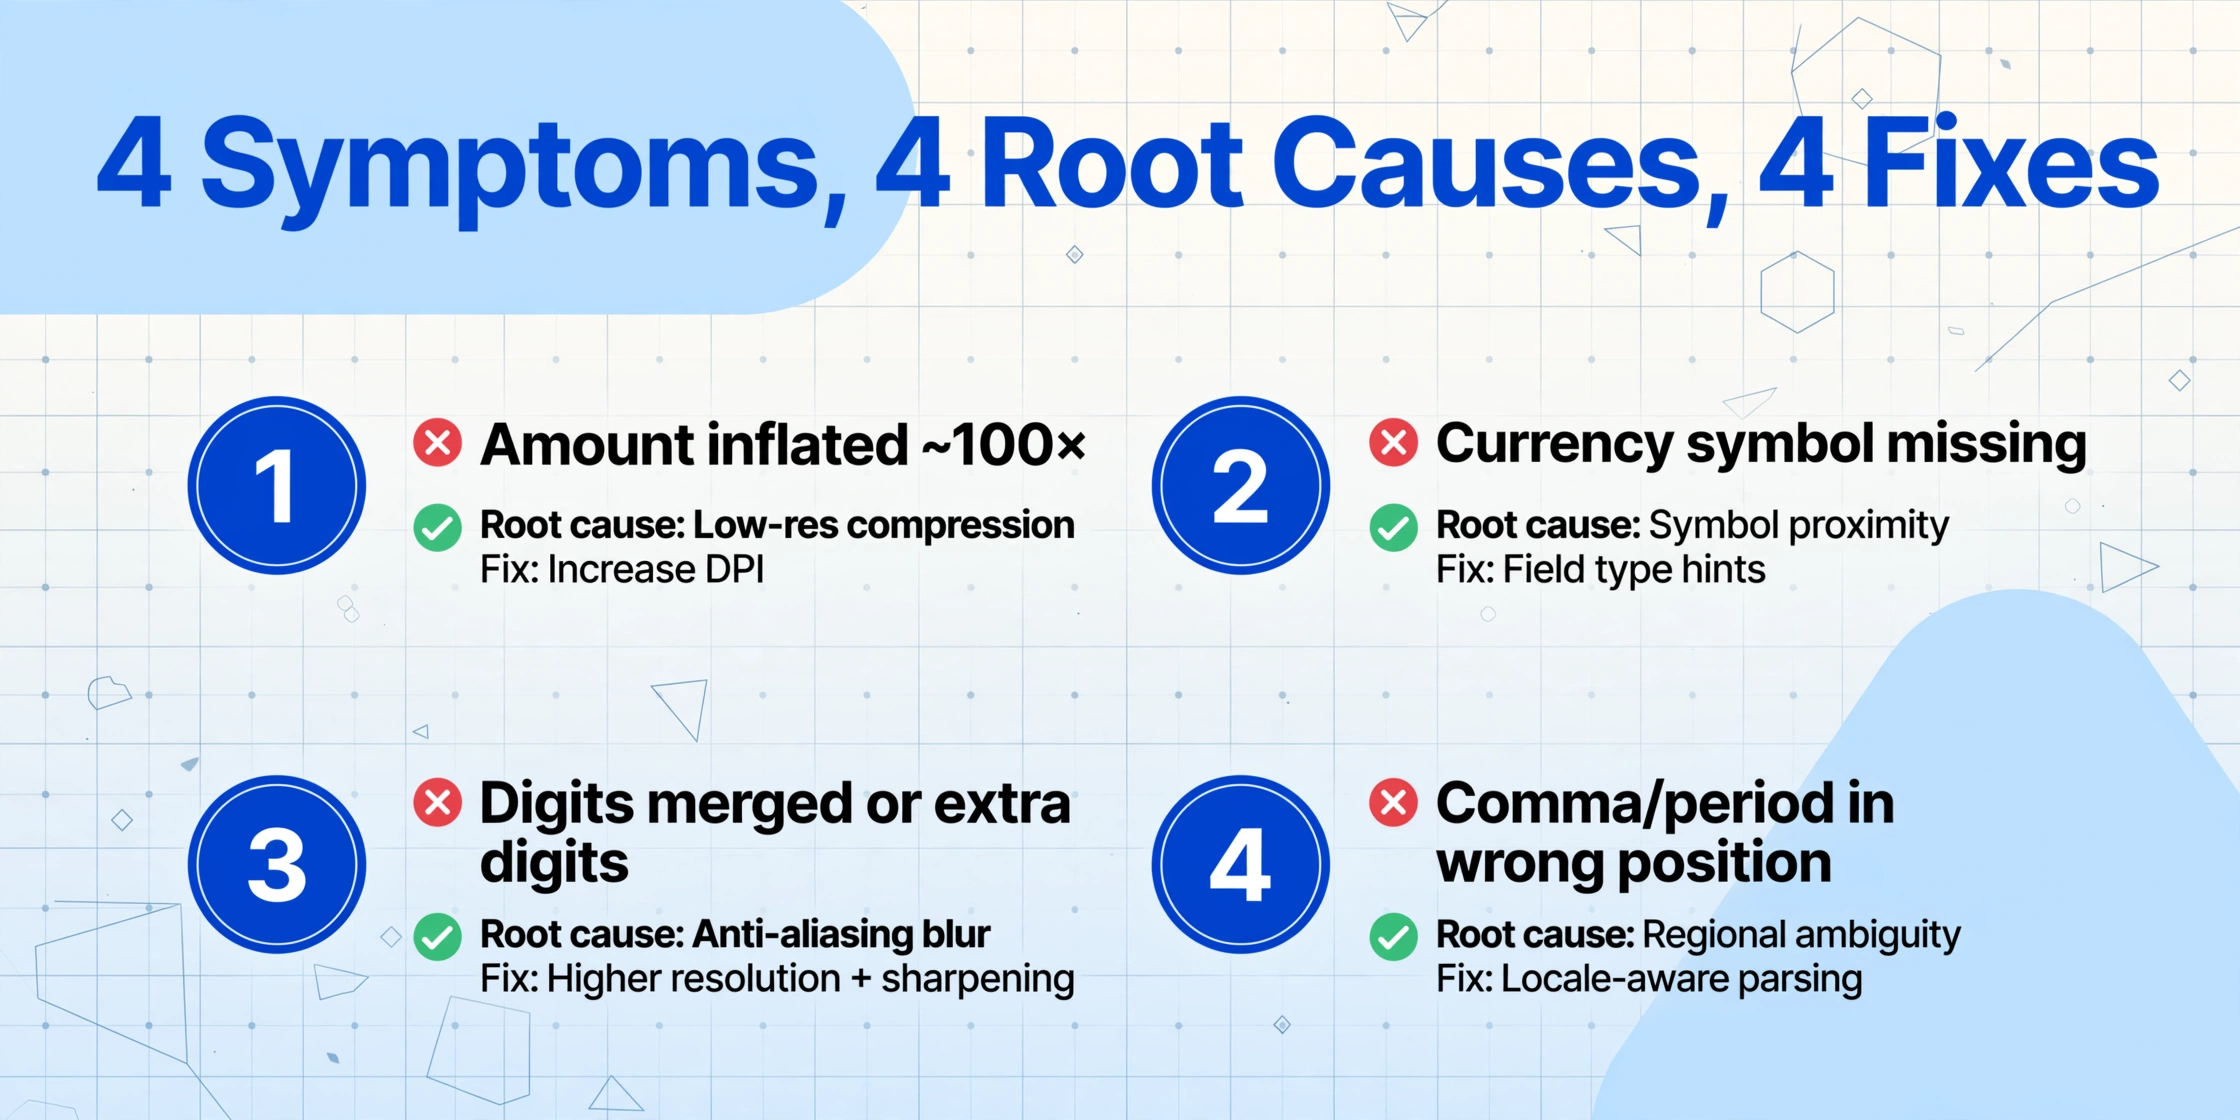
No todos los errores de decimales y moneda tienen la misma causa raíz. Usar la solución incorrecta pierde tiempo y no aborda el problema real. La tabla siguiente relaciona el síntoma que observa en su salida extraída con la causa más probable y la solución correspondiente.
| Síntoma en la salida | Causa más probable | Solución principal |
|---|---|---|
| Monto inflado ~100× (p. ej., 154.99 → 15499) | Compresión de baja resolución (Causa 1) | Aumentar el DPI de entrada / usar formato sin pérdida |
| Símbolo de moneda faltante ($/€/£ omitido) | Proximidad del símbolo o renderizado de fuente (Causa 2 o 3) | Sugerencias de tipo de campo + extracción semántica |
| Símbolo de moneda mal leído como letra (p. ej., $ → S) | Confusión de forma de caracteres (Causa 2) | Coincidencia de patrón regex en posprocesamiento |
| Dígitos fusionados o dígitos adicionales | Desenfoque por anti-aliasing (Causa 3) | Mayor resolución de entrada + preprocesamiento de nitidez |
| Coma/punto en posición incorrecta (123.456 vs 123,456) | Ambigüedad de convención regional (Causa 4) | Posprocesamiento según configuración regional + verificación cruzada |
| Monto dividido en dos valores separados | Interpretación errónea de coma decimal (Causa 4) | Analizador sensible al contexto con detección de región |
Solución 1: Mejorar la calidad de la imagen de origen
La solución más eficaz es también la más sencilla: darle al motor de OCR más píxeles con los que trabajar. Un punto decimal a 300 DPI ocupa aproximadamente 9 píxeles, suficiente para que la compresión JPEG no lo descarte como ruido. A 600 DPI, ese mismo punto abarca 18 píxeles y sobrevive a ajustes de compresión agresivos.
- Escanear a 300 DPI como mínimo — 200 DPI es el límite inferior; 300 DPI es el estándar fiable para documentos financieros. Utilice un escáner de cama plana en lugar de la cámara del teléfono siempre que sea posible.
- Guardar como TIFF o PNG, no JPEG — la compresión con pérdida de JPEG es la causa principal de la pérdida del punto decimal. TIFF y PNG conservan los puntos de 2 a 3 píxeles que JPEG descarta.
- Para fotos de teléfono — tome la foto desde directamente arriba, use una superficie bien iluminada y exporte a la resolución máxima de la cámara. Recorte ajustadamente al área del documento para maximizar la densidad de píxeles en la región del texto.
Solución 2: Usar sugerencias de tipo de campo
Esta es la solución que la mayoría de las herramientas de OCR de propósito general no pueden ofrecer, y la más eficaz para datos financieros. Cuando le indica al sistema que un campo es un monto de moneda, este trata el punto decimal y el símbolo de moneda como señales semánticas sobre el valor, no como caracteres ordinarios.
En ImageToTable.ai, esto funciona mediante la Extracción de Columnas Personalizadas: usted define columnas como "Total de Factura" y la IA comprende el tipo de campo. Cuando encuentra un valor en un campo de moneda conocido, busca activamente el separador decimal y utiliza la estructura esperada de dos decimales para validar los dígitos. Si el resultado bruto produce "15499" para un campo "Total (USD)", la IA señala el decimal faltante y aplica una corrección probabilística.
Esta es la diferencia fundamental entre la extracción basada en posición (donde la herramienta lee cada carácter en una zona y genera lo que ve) y la extracción basada en semántica (donde la herramienta entiende lo que busca y utiliza ese contexto para resolver ambigüedades). Las sugerencias de tipo de campo convierten una pérdida de punto decimal de una corrupción silenciosa de datos en una ambigüedad corregible. El mismo enfoque le permite procesar lotes de facturas de proveedores directamente en hojas de Excel estructuradas sin configuración de plantilla por proveedor: la IA maneja las variaciones de formato al comprender qué significa cada campo, no dónde se encuentra en la página.
Corrección 3: Procesamiento posterior con regex y verificación cruzada
Cuando no puede controlar la calidad de la fuente ni la herramienta de extracción, el procesamiento posterior es la red de seguridad. Dos técnicas detectan la mayoría de los errores de decimales y moneda después de la extracción. Para una visión más amplia sobre el preprocesamiento, el ajuste del motor y las estrategias de validación a nivel de campo, lea nuestra guía completa sobre cómo mejorar la precisión del OCR en documentos financieros.
Validación basada en patrones. La mayoría de los montos en moneda siguen patrones predecibles. Una regex como ^\d{1,3}(?:,\d{3})*\.\d{2}$ valida montos en formato estadounidense. Cualquier valor sin punto decimal, con cuatro decimales o con separadores no coincidentes se marca para revisión.
Verificación cruzada (validación matemática). En cualquier documento con partidas, la suma de los montos de las partidas debe ser igual al total. Una discrepancia indica un punto decimal mal leído. Si las partidas suman $1,249.85 pero el total se extrae como $124,985.00, el decimal se desplazó tres posiciones — casi con certeza un error de pérdida de punto. La verificación cruzada detecta esto al instante, independientemente de la causa raíz.
El procesamiento posterior no reemplaza una buena calidad de fuente ni la extracción semántica — es una capa de detección diseñada para capturar los errores que se colaron.
Cuándo escalar: Reconocer los límites de las correcciones
No todos los errores de punto decimal y símbolo de moneda pueden corregirse mejorando la calidad de entrada o añadiendo reglas de procesamiento posterior. Tres escenarios indican que el enfoque de extracción en sí debe cambiar:
Escenario 1: Procesamiento de alto volumen con fuentes mixtas. Si su flujo de trabajo procesa facturas de cientos de proveedores con diferentes formatos y convenciones regionales, el ajuste del preprocesamiento por proveedor no escala — la sobrecarga anula las ganancias de eficiencia de la automatización.
Escenario 2: Documentos capturados predominantemente con móvil. Las fotos de teléfono introducen distorsión de perspectiva, reflejos e iluminación variable que degradan constantemente el reconocimiento de caracteres pequeños. La solución no es un mejor preprocesamiento; es un sistema que utiliza el contexto semántico para interpretar valores cuando el reconocimiento a nivel de caracteres es incierto.
Escenario 3: Documentos con tablas extremadamente densas. Los estados de cuenta bancarios, los informes de corretaje y las facturas multilínea concentran números en celdas pequeñas donde los puntos decimales se renderizan de 6pt a 8pt. A ese tamaño, el desenfoque por anti-aliasing es casi inevitable independientemente de la resolución de escaneo — el OCR basado en píxeles alcanza un techo de precisión fundamental.
En estos escenarios, incluso un preprocesamiento perfecto no puede cerrar la brecha — la solución es un enfoque basado en visión que comprende la estructura del documento y la semántica de los campos, no solo los valores de píxeles. Para orientación relacionada, consulte cómo las celdas combinadas rompen la extracción de tablas y por qué el OCR no reconoce tablas — escenarios comunes donde los errores decimales se originan por lecturas estructurales incorrectas más que por problemas a nivel de píxel.
Preguntas frecuentes
¿Por qué mi OCR pierde el punto decimal en fotos de teléfono pero no en documentos escaneados?
Las fotos tomadas con el teléfono a la distancia del brazo producen imágenes en el rango de 72–150 DPI; un punto decimal a esta resolución tiene solo 2–4 píxeles de ancho. La compresión JPEG procesa la imagen en bloques de 8×8 píxeles, y un punto de 2 píxeles dentro de un bloque mayormente blanco se trata como ruido y se descarta. Los escáneres de cama plana a 300 DPI producen puntos de 9 o más píxeles, que sobreviven a la compresión de forma fiable. Esta es una limitación física difícil: los caracteres pequeños necesitan suficientes píxeles para distinguirse del ruido del sensor.
¿Puede el OCR basado en IA corregir errores de punto decimal que el OCR tradicional no detecta?
Sí, pero no "viendo" un punto que JPEG destruyó. La extracción basada en IA infiere la posición del decimal usando el contexto. Cuando el sistema sabe que está leyendo un total de factura y la salida en bruto dice "15499", aplica patrones aprendidos — la mayoría de los totales tienen dos decimales — y reconstruye $154.99. Esto funciona solo cuando se conoce el tipo de campo; en un escenario de OCR sin contexto previo, ninguna IA puede arreglar lo que nunca se capturó.
¿Cómo manejo facturas con formato regional mixto (proveedores de EE. UU. y la UE)?
El procesamiento de regiones mixtas es el caso más difícil para el análisis que depende de convenciones. El enfoque más práctico es validar los montos extraídos contra la consistencia matemática: ¿los totales de las líneas suman el total? Si una lectura con coma decimal de 1.234,56 produce un valor claramente improbable, el sistema prueba el análisis alternativo. Las herramientas de extracción semántica pueden aplicar esto automáticamente: si la IA entiende que un campo debe ser un monto razonable, descarta interpretaciones de separadores improbables.
¿Escalar una imagen de baja resolución antes del OCR ayuda a recuperar los puntos decimales?
El escalado tradicional (interpolación bilineal o bicúbica) no recupera el detalle perdido: distribuye los píxeles existentes en un lienzo más grande. Un punto decimal de 2 píxeles escalado al 200% se convierte en 4 píxeles de gris interpolado, aún por debajo de la mayoría de los umbrales de detección del OCR. Empezar con una imagen fuente de mayor calidad siempre es más efectivo que intentar arreglar una imagen degradada.
¿Cuál es la resolución de escaneo mínima para capturar de forma fiable los puntos decimales en documentos financieros?
300 DPI es el mínimo práctico. A 200 DPI, los puntos decimales en fuentes estándar de 10pt abarcan de 4 a 5 píxeles, solo ligeramente mejor que la resolución de la cámara de un teléfono. A 300 DPI, el mismo punto abarca de 8 a 9 píxeles, lo que da a los motores de OCR suficiente señal para distinguirlo del ruido de fondo. Para documentos con fuentes muy pequeñas (8pt o menos en tablas de partidas), se recomienda de 400 a 600 DPI, con la salvedad de que un DPI más alto aumenta el tamaño del archivo de forma lineal.
¿Son seguros los millares separados por comas (1,234.56) con la mayoría de las herramientas de OCR?
No de forma inherente. Aunque la mayoría de los motores de OCR manejan razonablemente bien la convención estadounidense, la coma puede leerse mal como un punto o descartarse, produciendo 1.234.56 o 1234.56. Más críticamente, si el mismo documento contiene valores donde la coma es el separador decimal (algo común en flujos de trabajo con múltiples proveedores), el OCR no tiene forma de distinguir los dos usos solo por la forma: necesita conocimiento contextual de qué campo es cuál. Por eso las sugerencias de tipo de campo a nivel de campo son esenciales para un procesamiento fiable en múltiples regiones.
No Deje que un Punto Faltante le Cueste Miles
Los puntos decimales y los símbolos de moneda son caracteres pequeños con consecuencias enormes: un solo punto omitido puede hacer que pague de más a un proveedor por $15,000 o que se le pase una infracción de cumplimiento en las verificaciones de fin de mes. Los errores no son aleatorios: cada uno tiene una causa rastreable arraigada en cómo los motores de OCR procesan las imágenes a nivel de píxel. Saber qué causa afectó a su documento es la diferencia entre ajustar configuraciones a ciegas y solucionar el problema de forma permanente.
La solución más fiable es un sistema de extracción que entienda lo que lee: que reconstruya los puntos decimales faltantes, valide los valores contra los formatos esperados y gestione las convenciones regionales de separadores sin configuración manual. Eso es lo que hace posible la extracción semántica. Suba una factura con la que su herramienta actual tenga dificultades y compare la precisión lado a lado.