画像をOCR用に前処理する方法
認識精度を高める6ステップのパイプライン
OCRの出力結果をそのまま使えるか、それとも手入力し直さなければならないか。その違いは、多くの場合、エンジン自体には関係ありません。OCRエンジンが画像を処理する前に、その画像に何が行われたかが鍵を握ります。スマートフォンのカメラで撮影した請求書、150 DPIのFAXで送られてきた契約書、くしゃくしゃに丸まったレシート——こうした実際の現場で遭遇する入力が、前処理によって修正されるべき対象です。適切に設計された6ステップのパイプラインがあれば、ノイズが多く、傾きがあり、コントラストの低い画像でも、エンジンにとって清潔な印刷ページと同じくらい読みやすい状態にすることができます。
前処理がOCRエンジンよりも重要な理由
従来のOCRエンジン — Tesseract、ABBYY FineReader、Google Cloud Vision — は、フラットベッドスキャナで300 DPIのクリーンで高コントラストなスキャンを想定して設計されています。実際の画像はまったく異なります。スマートフォンで撮影した請求書には、撮影者の手による影、傾いた遠近感、レンズの歪みがあります。FAXで送られた注文書は200 DPIでモアレ縞が発生します。くしゃくちゃのレシートには折り目による人工的なエッジができ、テキストの一部は影になり、他の部分は白飛びします。
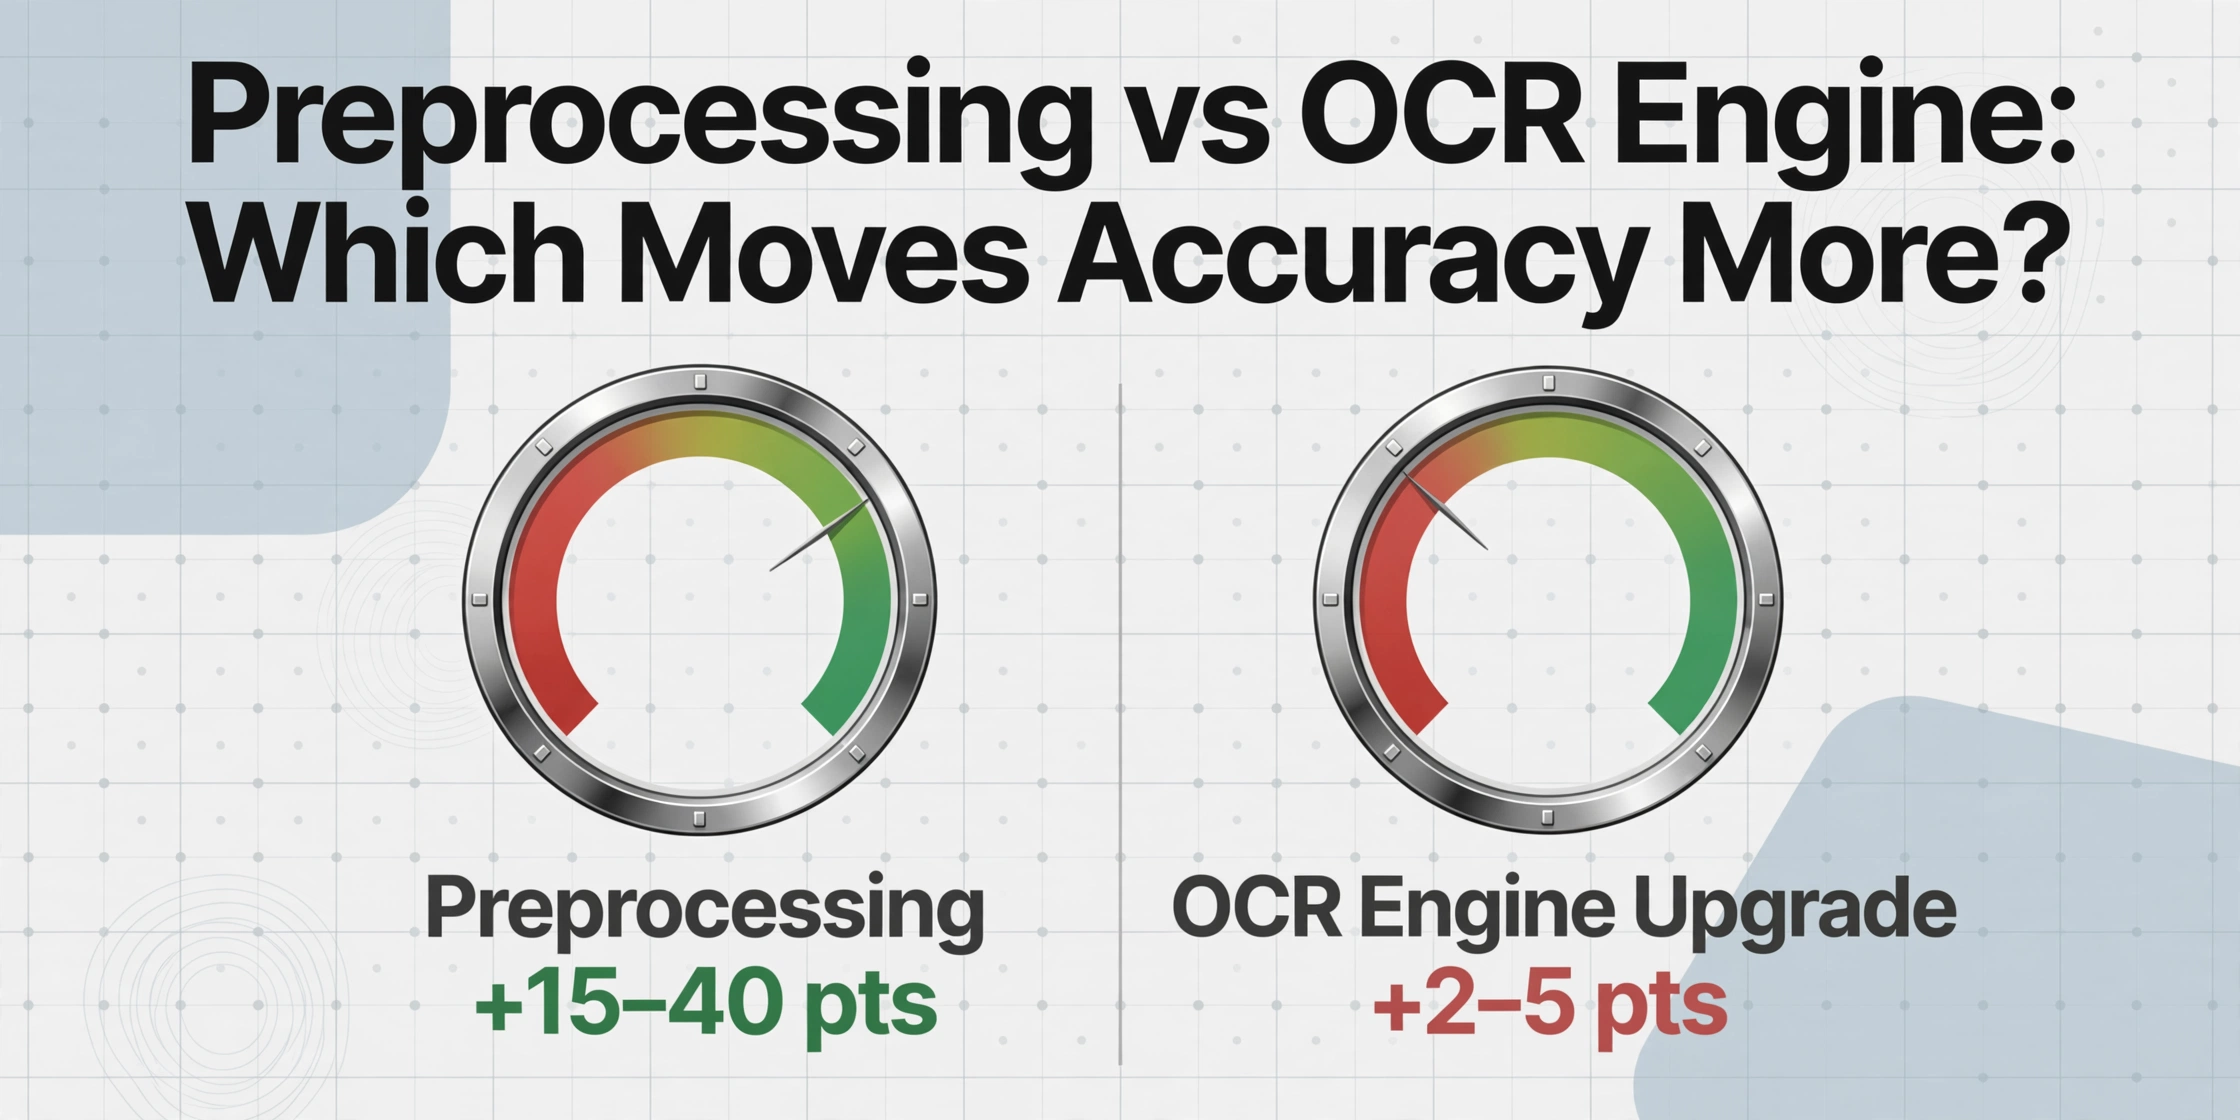
前処理はこのギャップを埋めます。文書画像二値化コンテスト (DIBCO) のベンチマークは、同じOCRエンジンと同一ドキュメントを使用した場合、前処理技術の選択が文字レベルの精度を15〜40パーセントポイント変動させることを一貫して示しています。劣化したドキュメント — 黄ばんだ紙、かすれたカーボンコピー、感熱レシート — では、その差はさらに広がります。
以下の6つのステップで完全な前処理パイプラインを構成します。依存関係に基づいて順序付けられており、各ステップは前のステップが適用されていることを前提としています。ソース画像がすでにクリーンな場合はステップを省略できますが、順序を並べ替えるべきではありません。
ステップ1:グレースケール変換 — 色を除去しても信号を失わない
カラー画像は、赤・緑・青の3チャンネルを格納しており、それぞれが独自の照明特性を持っています。混合照明下では、1つのチャンネルが白飛びしても、別のチャンネルにはディテールが残ることがあります。3つすべてを個別に処理すると計算負荷が増え、OCRには不要なチャンネル固有のノイズが発生します。グレースケール変換では、輝度重み付け(Y = 0.299R + 0.587G + 0.114B)を使用してこれらを単一の輝度チャンネルに統合し、OCRが依存するコントラスト情報を保持しながら、色に基づくノイズを除去します。結果は、明るさだけが重要となる単一チャンネルの画像となり、ノイズ除去の準備が整います。
ステップ2:ノイズ除去 — ガウシアンとメディアンの使い分け
ノイズは複数の要因から発生します:スマートフォンカメラのセンサーノイズ、JPEG圧縮アーティファクト、印刷物のハーフトーンディザリング、スキャナーガラスのほこりなどです。2つのフィルタリング手法が主流で、それぞれ異なるノイズタイプに適しています。
ガウシアンブラーは各ピクセルを周囲のピクセルと平均化し、カメラセンサーに典型的な正規分布の明るさ変動に効果的です。欠点はエッジが柔らかくなることで、9ptフォントの細いストロークがOCRで分離しにくくなります。カーネルは3×3または5×5で通常十分です。
メディアンフィルタリングは各ピクセルを近傍の中央値に置き換え、スキャン文書やFAX文書によく見られる白黒の散在ピクセル、つまりごま塩ノイズに対してはるかに効果的です。孤立したノイズピクセルを除去しながら、エッジをほぼ完全に保持します。標準ウィンドウサイズは3×3で、劣化が激しいスキャンでは5×5を使用します。
実用的なルール:散在する斑点にはメディアンフィルタリング、全体的なざらつきにはガウシアンブラーを使用します。どちらも控えめに適用してください — 各フィルタはノイズとともに実際のコンテンツも除去します。
ステップ3:二値化 — 最も影響の大きいステップ
二値化は、グレースケール画像を純粋な白黒画像に変換します。各ピクセルはインク(黒)か紙(白)のいずれかになります。このステップで、最大の精度向上 — そして最大の精度低下 — が発生します。過去10年間のDIBCOコンテストの結果によると、最良の二値化手法と単純なグローバル閾値との差は、劣化した文書では平均30〜40パーセントポイントにもなります。誤った二値化手法を選ぶことは、前処理における最も一般的なミスです。
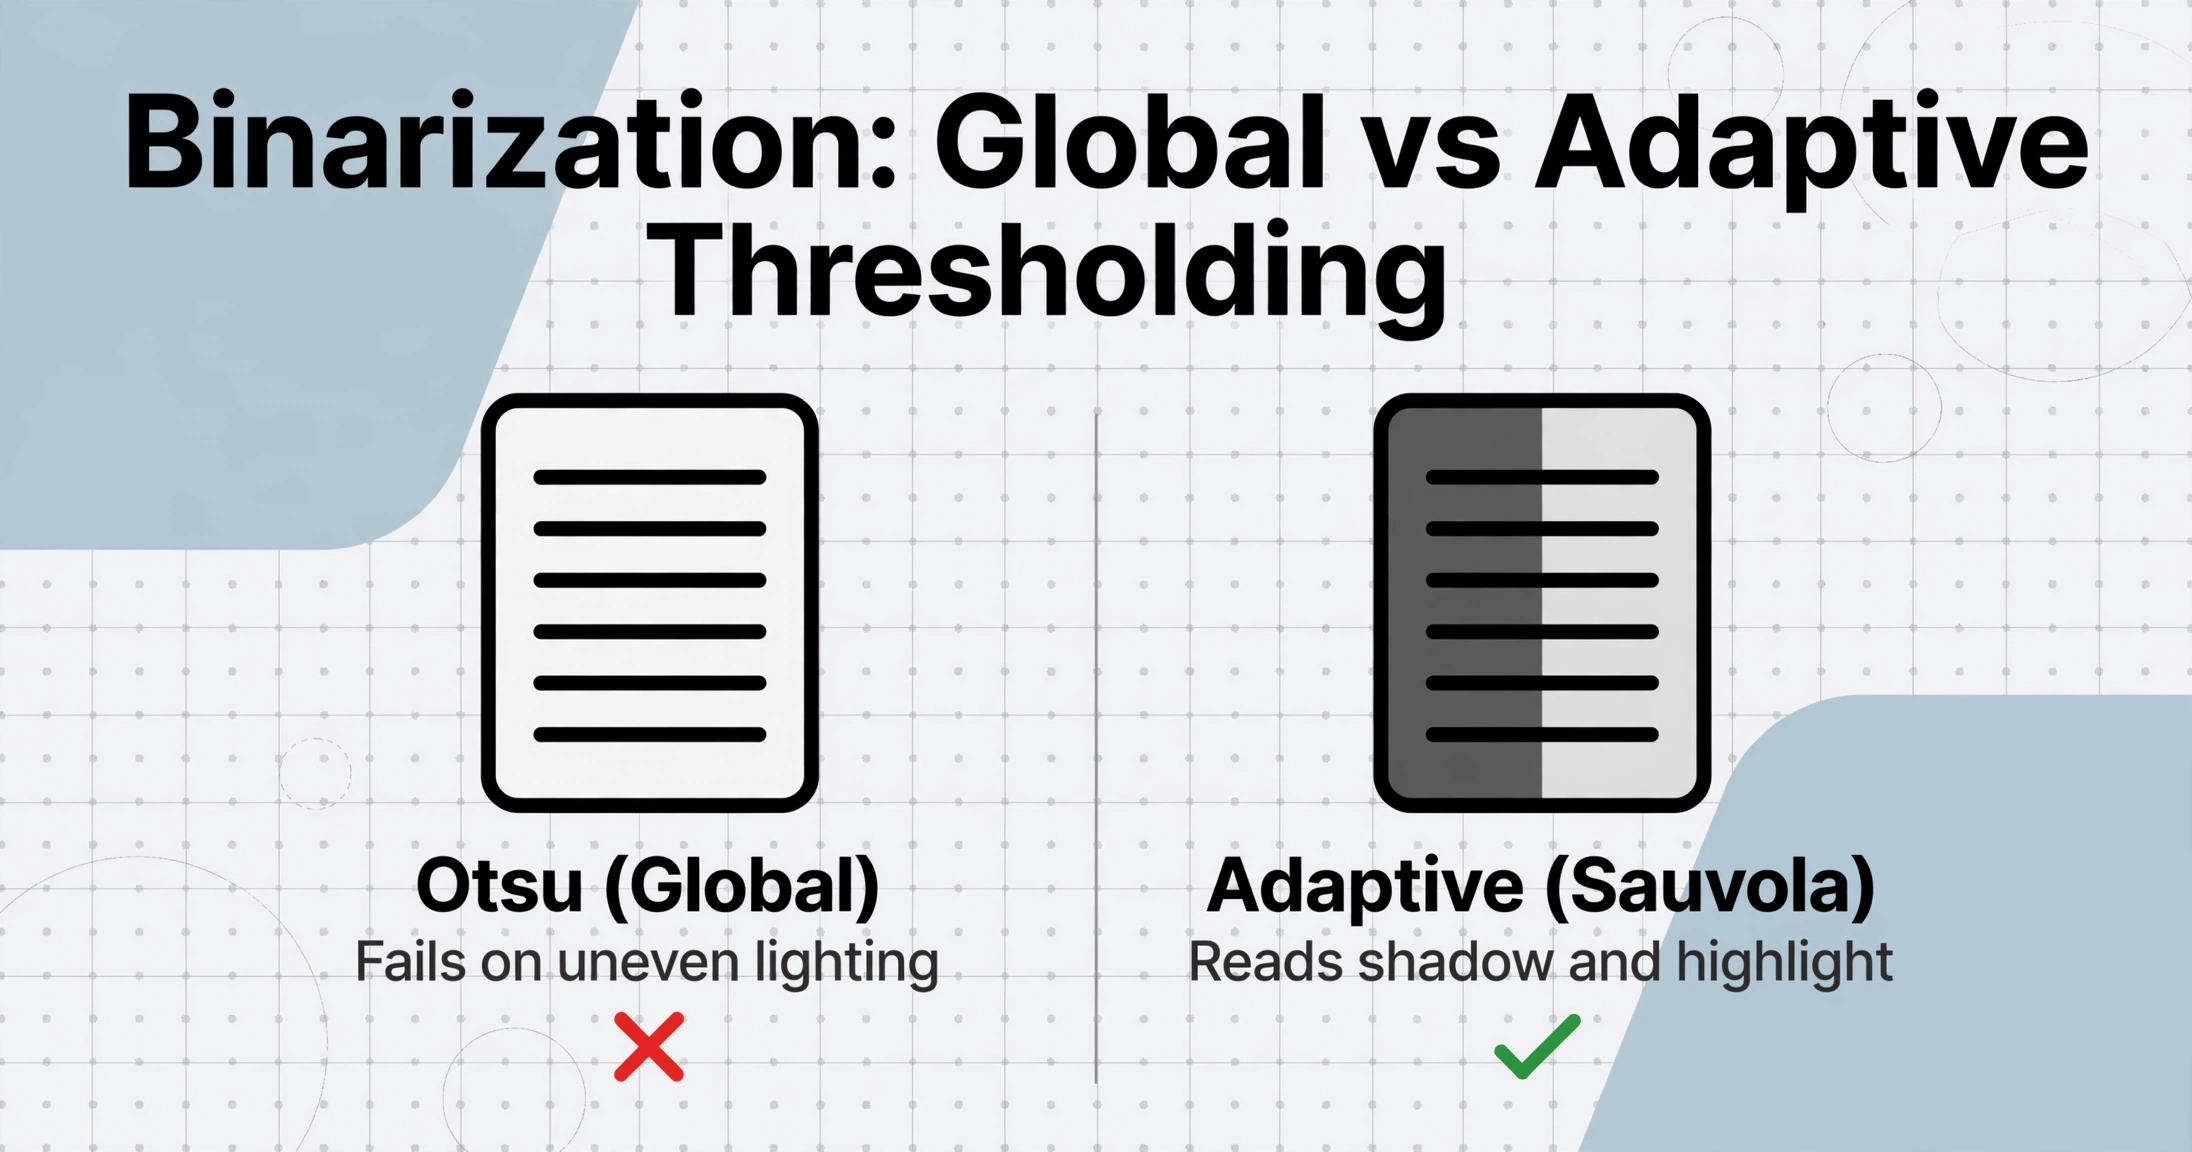
大津の手法(Otsu's method)は、ほとんどのOCRライブラリでデフォルトの二値化手法です。黒と白のピクセルクラス間の分散を最大化することで、単一のグローバル閾値を計算します。均一な照明下の白いページに黒いテキストという、クリーンで均一に照らされたスキャンでは、大津の手法は1回のパスでほぼ完璧な二値化を実現します。問題は、実際の文書のほとんどが均一に照らされていないことです。机の上で撮影されたページには、明るい窓側から影の側へのグラデーションがあります。大津の手法は画像全体に対して1つの閾値を選択するため、影になったテキストは背景に消え、明るい側のテキストは露出過多になります。
適応的閾値処理は、各ピクセルの周囲の近傍領域 — 通常15×15から51×51ピクセルのウィンドウ — に基づいて局所的な閾値を計算することで、この問題を解決します。各領域が独自の閾値を持つため、半分が影で半分が日光の文書でも、ページ全体で読みやすいテキストが得られます。Sauvolaの手法は、適応的閾値処理を改良したもので、バイアス項を追加することで、カーボンコピーや歴史的文書によく見られる、さまざまなストローク幅でのパフォーマンスを向上させます。
トレードオフは、速度とパラメータ感度です。適応的閾値処理は大津の手法より5〜10倍遅く、ウィンドウサイズが出力に大きく影響します。小さすぎる場合(11×11未満)は、大きな文字が背景として扱われます。大きすぎる場合(75×75以上)は、大津の手法の動作に近づきます。良い出発点は、画像幅の約1/20のウィンドウサイズです。
ステップ4:傾き補正 — 文字行の誤読を防ぐ回転補正
傾き(文書画像の水平からの回転)は、カメラ撮影文書ではほぼ必ず発生し、スキャン文書でもよく見られます。わずかな傾きでもOCR精度は不釣り合いに低下します。これは、エンジンのセグメンテーションアルゴリズムが水平ベースラインを前提としているためです。学術誌Pattern Recognitionに掲載された研究では、その影響が正確に測定されています。5°の傾きで文字認識精度は15~20%低下します。10°では、行が行境界からずれるため、エラー率は40%を超えます。15°(文書を斜めから撮影すると容易に発生)では、ほとんどのOCRエンジンは改行境界のない、単一の結合された文字ストリームとしてテキストを出力します。
標準的な傾き補正方法はハフ変換を使用します。これは直線(テキストのベースライン)を検出し、その支配的な角度を計算し、画像をその角度の逆方向に回転させます。より簡単な代替方法として、投影プロファイル(各行の黒ピクセルの合計)を計算する方法があります。これはテキストが水平の場合にピークとなります。どちらの方法も、きれいな文書では0.1°以内の精度で収束します。ノイズの多い画像では、ハフ変換の方が外れ値の線を除外し、支配的なテキスト方向に集中できるため、より堅牢です。
ステップ5:余白除去 — レイアウト解析を妨げる端部ノイズの除去
スキャン文書やスマートフォン撮影画像には、文書自体以外の視覚的要素(スキャナ蓋の暗い端、机の上に置かれた文書の写真、FAXヘッダーのタイムスタンプなど)がほぼ常に含まれます。これらの要素はレイアウト解析ステップを妨害します。OCRアルゴリズムは連結成分を識別することでページ領域を検出するためです。太い黒い余白は画像全体の幅にわたる連結成分を作り出し、アルゴリズムはそれをページ境界と解釈します。その結果、実際の文書コンテンツ内に切り込んだり、近くのヘッダーテキストを誤った読み順に割り当てたりします。端にある文書の日付、ページ番号、仕入先名は、最初に失われる傾向があります。
自動余白除去では、輪郭検出を使用して文書コンテンツの最外郭の矩形境界を見つけ、その範囲に切り抜きます。アルゴリズムは各端から内側に向かってスキャンし、暗い余白から明るいページへの遷移を探します。切り抜きは控えめに行うべきです。切りすぎると端のテキストが失われ、薄いマージン(2~5ピクセル)を残しても後続の処理には影響しません。
ステップ6:解像度の向上 — ピクセル数が多いほど効果的な場合
OCRの精度は、画像の解像度と密接な関係があります。200 DPI未満では、文字のエッジがピクセル化してしまい、「O」とゼロ、「l」(小文字のエル)と「I」(大文字のアイ)など、似た字形の区別がつかなくなります。標準的な300 DPIは、8〜12ptのフォントに十分な詳細を提供しつつ、ファイルサイズを管理しやすい範囲に保ちます。600 DPIでは、精度はわずか2〜5%しか向上しない一方で、ファイルサイズは4倍になります。
課題は、入力画像が常に制御下にあるとは限らないことです。スマートフォンで撮影したレシートの実効解像度が150 DPIしかない場合や、ファックスは200 DPIに固定されている場合があります。このようなケースでは、超解像技術(ニューラルネットワークを使用して高解像度の詳細を推測する技術)によって失われた情報の一部を回復でき、200 DPI未満では控えめながらも測定可能な5〜8ポイントの精度向上が期待できます。従来のバイキュービック補間では同じ効果は得られません。滑らかなエッジは生成されますが、実際の詳細は追加されないからです。何百万もの文書画像でトレーニングされた超解像技術だけが、ぼやけたパッチからシャープな文字エッジを再構築できます。
前処理を省略できる場合
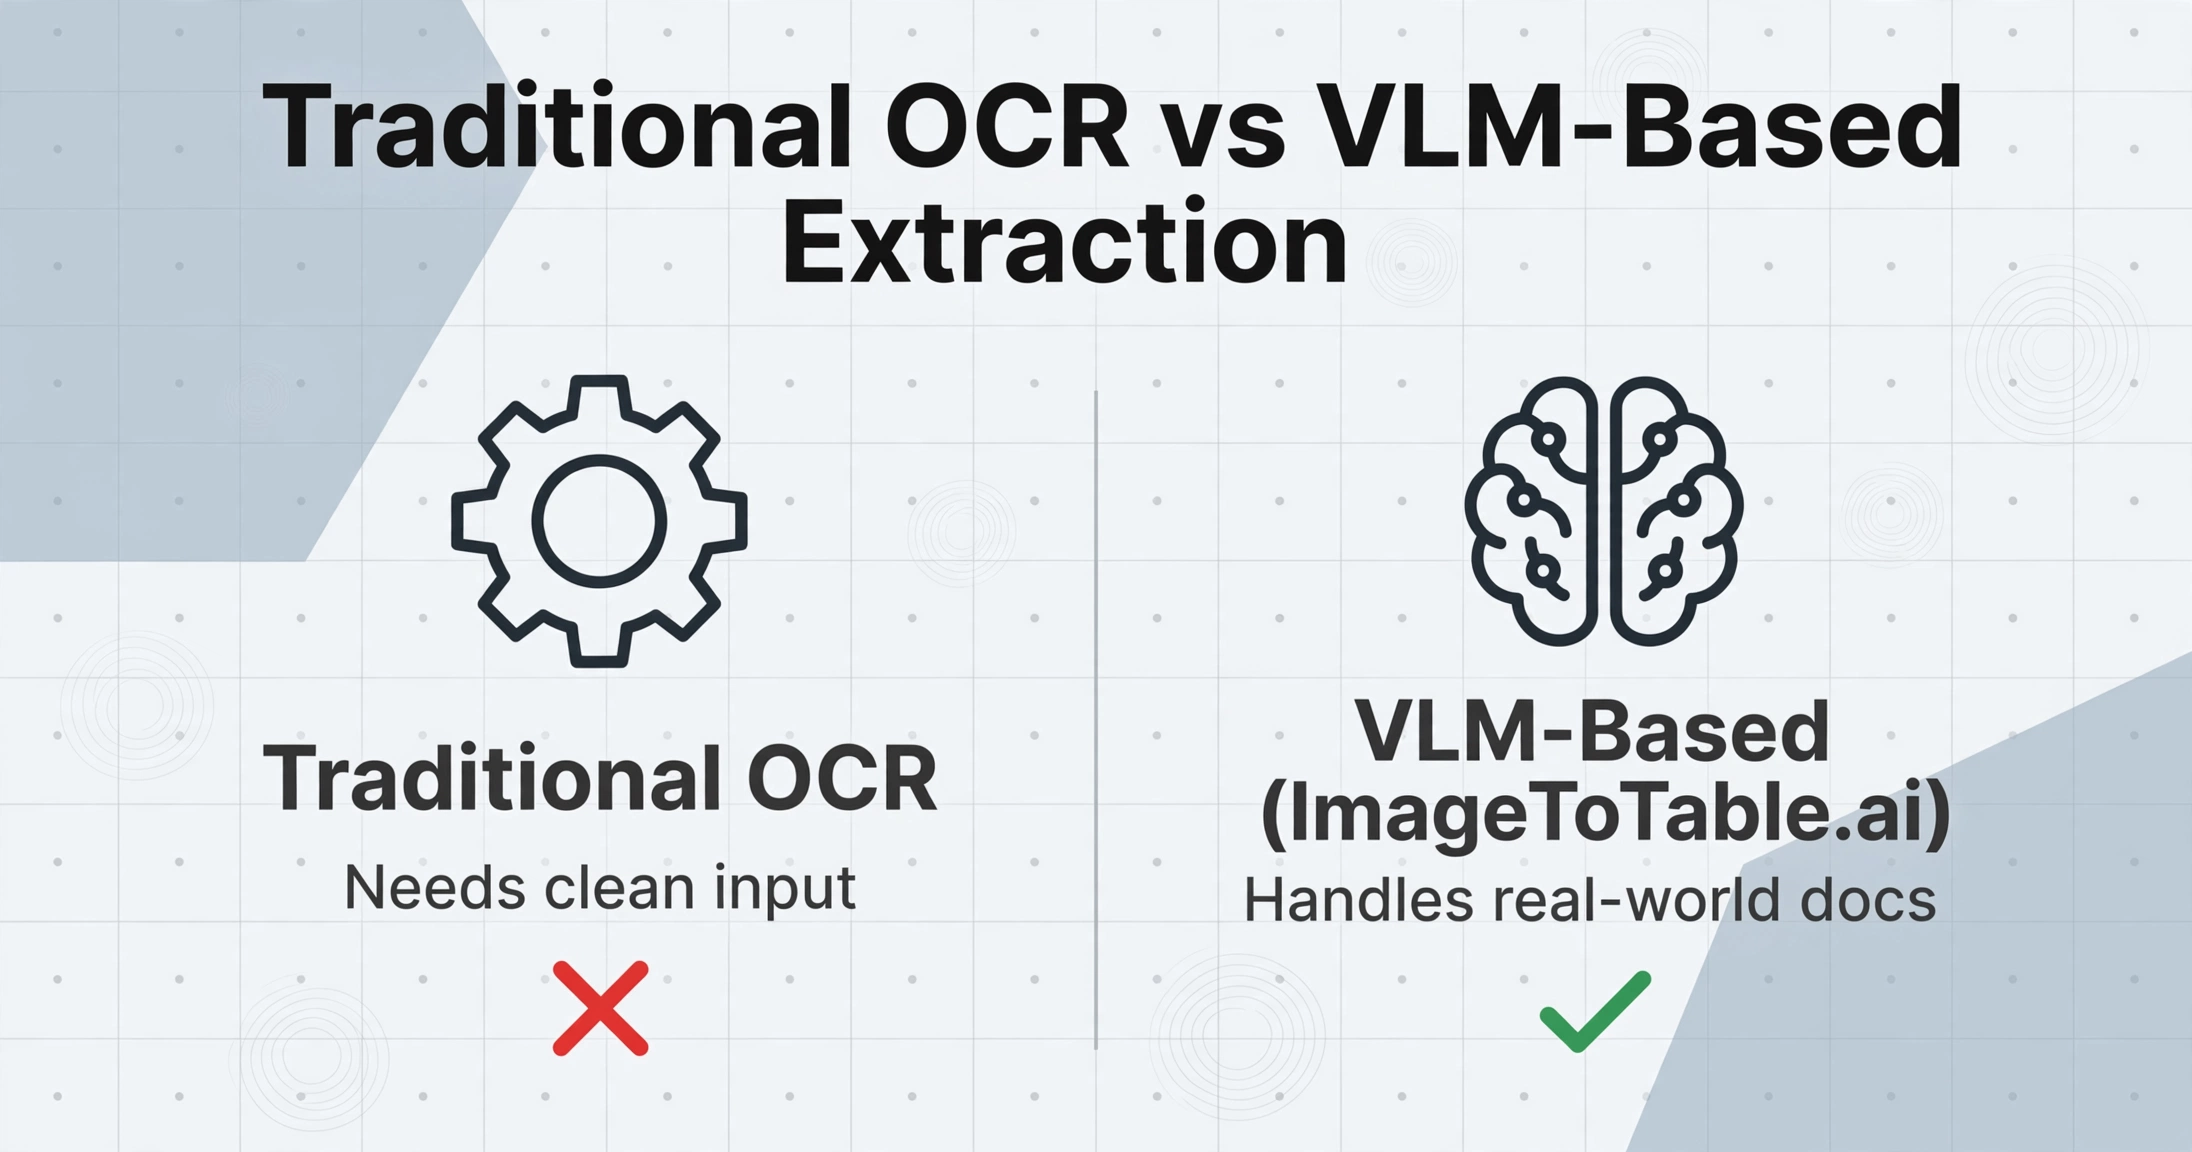
上記の前処理パイプラインは、文字単位で動作する従来のOCRエンジン(Tesseract、ABBYY、Google Cloud Vision)向けに開発されたものです。これらのエンジンは、アーキテクチャに文脈認識がないため、クリーンでコントラストの高い入力が必要です。ノイズによる文字セグメントの欠落は、そのまま失われてしまいます。
一方、最新の視覚言語大規模モデル (VLM) ベースのOCR(ImageToTable.aiで採用されているアーキテクチャ)は、動作が異なります。VLMは文字を一つずつ認識する代わりに、文書画像全体を視覚的なシーンとして読み取り、各領域の意味を理解することでデータを抽出します。スマートフォン写真、くしゃくしゃのレシート、傾いたスキャンなど、何百万もの実世界の文書画像でトレーニングされているため、前処理で修正されるような劣化は、すでにトレーニングデータに含まれています。15°傾いた混合照明下の文書は、モデルにとってエッジケースではなく、数千ものトレーニング例と統計的に区別がつかないのです。
これは前処理が時代遅れになったことを意味するものではありません。極端に劣化した画像(茶色く変色したサーマルレシートや、5世代目のコピーなど)では、VLMでも適応的二値化やコントラスト強調の恩恵を受けられます。しかし、日常使用の90%を占める現実的な文書品質の中間領域では、最新のVLMベースのツールは前処理パイプライン全体を省略し、直接正確な抽出を行うことができます。
2つのアプローチの詳細な比較については、OCR vs. AI抽出:前処理が必要なケースと、最新の抽出ツールでOCR精度を向上させる方法に関するガイドをご覧ください。
一般的な前処理の問題のトラブルシューティング
しきい値が強すぎます。Otsu から適応的しきい値処理に切り替え、ウィンドウサイズを画像幅の 1/20 に設定してください。深い影が残る場合は、まずコントラスト制限付き適応ヒストグラム均等化 (CLAHE) を適用してください。
カーネルサイズが大きすぎます。3×3 カーネルに縮小するか、ガウシアンからメディアンフィルタに切り替えてください。メディアンフィルタは細いエッジをよりよく保持します。細かい文字の文書では、画像がすでにきれいな場合はノイズ除去を完全にスキップしてください。
Hough 変換が誤った支配的な線(枠線や表の罫線)を検出した可能性があります。傾き補正の前に枠線除去を適用するか、画像の上下 5% をマスクしてください。Hough のしきい値を上げて、ほぼ全幅の線だけがベースラインとして認識されるようにしてください。
適応的しきい値処理と超解像は計算コストが高くなります。大規模なバッチでは、ページごとに単一の推論パスでこれらの変換を内部的に処理する VLM ベースの抽出ツールの使用を検討してください。
よくある質問
すべてのドキュメントで前処理が必要ですか?
いいえ。白い紙に黒い文字で書かれた300 DPIのクリーンなスキャンには前処理は不要です。前処理の価値は、入力がその理想状態からどれだけずれているかに比例します。スマートフォンの写真、ファックス、感熱レシート、色あせた原本に最も効果があります。視覚言語大規模モデル (VLM) ベースのツールを使用する場合、その閾値ははるかに低くなります。モデルが適度な傾き、不均一な照明、ノイズを内部で処理するためです。
前処理は手書き文字認識と印刷テキスト認識で異なる影響を与えますか?
はい。印刷テキストはストローク幅と間隔が規則的であるため、標準的なパイプラインで問題なく処理できます。手書き文字はストロークが可変で、文字が重なり、間隔も不均一です。強い二値化(特にOtsu's method)は筆記体のストロークを塊に融合させてしまいます。手書きドキュメントには、より大きな適応閾値ウィンドウ(51×51以上)と、より穏やかなノイズ除去を使用してください。一部のVLMベースのツールは、手書き文字に対して二値化を完全にスキップし、グレースケール画像を直接処理します。より詳細な分析については、OCRが手書き文字で苦労する理由のガイドをご覧ください。
ドキュメントスキャンにはどのDPIを使用すべきですか?
ほとんどのビジネスドキュメントでは300 DPIが標準です。8〜12ptのフォントを約25 MB/カラーページで十分に解像度で捉えることができます。大きな文字(14pt以上)のドキュメントには200 DPIで十分です。OCRに600 DPIはほとんど必要ありません。300 DPIに対する精度向上は平均わずか2〜5%で、ファイルサイズは4倍になります。例外は、非常に小さいフォント(6〜8ptの脚注、細かい文字)を含むドキュメントです。
前処理で、ぼやけたスマートフォンで撮影したドキュメントの写真を修正できますか?
部分的に可能です。軽度のモーションブラー(3ピクセル未満)は、WienerまたはRichardson-Lucyデコンボリューションフィルター(OpenCVおよびscikit-imageで利用可能)を使用して補正できます。中程度のぼやけ(3〜10ピクセル)には、ニューラルデブラーモデルが必要です。重度のピントぼけは通常、復元できません。高周波情報(文字ストロークのエッジ)がセンサーで捕捉されていないためです。カメラを安定させ、ドキュメントを平らにして撮り直すことが唯一の確実な修正方法です。
前処理の前にPDFページを画像に変換する必要がありますか?
PDFの種類によって異なります。デジタル生成PDFには選択可能なテキストが含まれており、OCRは不要です。スキャンPDFはPDFラッパーに画像が集まったものです。PopplerのpdftoppmまたはPythonのpdf2imageを使用して各ページを300 DPIのPNGにレンダリングしてから、パイプラインを適用します。完全なワークフローについては、スキャンPDFからデータを抽出するためのガイドをご覧ください。
どの前処理ステップに問題があるかをどうやって知るのですか?
各ステップの出力を個別の画像ファイルとして保存してください。OCR出力が不正確な場合は、まず二値化された画像から確認してください。そのステップは精度のばらつきが最も大きいためです。二値化がきれいなのに出力がまだ間違っている場合は、傾き補正された画像と元の入力を比較してください。目に見えない3°の残留傾きで、精度が10%低下する可能性があります。保存された各中間出力は、エラーがどのステップで発生したかを正確に示します。
パイプラインが答えにならない場合
6ステップのパイプラインは、入力データを管理できる場合に適したアプローチです。つまり、スキャナーとDPIを自分で選べる場合です。しかし、実際の多くのシナリオでは、そうではありません。請求書は、デジタル生まれのPDFからスマートフォンの写真まで、さまざまな形式で何百ものベンダーから届きます。前処理の負担はツール側に移ります。
ImageToTable.aiのようなVLMベースの抽出ツールは、カスタム列抽出を使用して、ピクセル座標ではなく意味的な意味でデータフィールドを特定します。このツールには、前処理パイプラインが推論プロセスに組み込まれています。傾いた文書、影のある文書、低解像度の文書をそのままアップロードします。モデルは文書全体を読み取り、定義した列に構造化データを抽出します。
これは前処理の知識が時代遅れになることを意味しません。各ステップを理解することで、特定の画像で抽出ツールが失敗する理由を診断し、何を修正すべきかを正確に把握できます。文書タイプ別の抽出失敗の診断については、文書タイプ別のOCR精度低下の理由をご覧ください。
6ステップのパイプラインを適用する前と後で、同じ文書を抽出ツールでテストしてください。その違いから、ワークフローに必要な前処理の量が正確にわかります。