手書き文字のOCR精度はどれほどか?
90%の精度でも合計は間違う理由
OCRベンダーが「手書き文字で90%の精度」と主張するとき、それは文字レベルの認識、つまり個々の文字や数字がページ全体で平均してどれだけ正しく読み取られたかを指しています。しかしその平均は深刻な問題を隠しています。10%の文字誤り率は、10%の不正なデータを生むのではありません。特定のフィールドで壊滅的な失敗を引き起こします。手書きの誤りは最も重要な箇所——合計、日付、識別子——に集中し、請求書の合計や検針票の数字が1つでも間違えば、抽出結果全体が誤りになるからです。「90%の文字精度」と「使えるフィールド単位のデータ」の間のギャップは、今日のドキュメント自動化における最も高くつく誤解です。
主なポイント
- 「手書きOCRの精度90%」とは10文字に1文字が誤っているということで、誤りはレターヘッドではなく合計や検針票に集中します。
- 8桁の手書き合計を90%の精度で読み取ると、少なくとも1つの誤りを含む確率は57%です。手作業をなくしたのではなく、データ入力を「検証」と呼び名を変えただけで、依然としてすべての値を確認する必要があります。
- 文字レベルの精度を追い求めるのはやめましょう。AIが「受領数量」は数値、「請求書日付」は日付だと理解する意味的抽出は、あり得ない解釈がスプレッドシートに届く前に排除します。
手書き文字で「精度90%」が実際に意味するもの
文字誤り率(CER)は、手書き文字認識を評価する標準的な指標です。置換(「5」が「6」と読まれるなど)、挿入、削除のすべてを数え、総文字数で割ります。印刷テキスト——クリーンで高解像度、標準フォント——の業界ベンチマークはCER 1%未満、つまり99%以上の文字精度です。
手書き文字は計算を完全に変えます。主要なOCRツールの独立比較では、手書きの活字体(ブロック体)でABBYY FineReaderが95.2%、Adobe Acrobatが88.6%の精度を達成しました。筆記体では差が広がり、ABBYYが91.7%、Adobeが79.3%、Readirisが84.9%でした。これらは専用デスクトップOCRの最高クラスの結果であり、モバイル撮影や混在ドキュメントの話ではありません。
実際の業務文書——手書きの請求書、納品書、検針票——では、実効文字精度は80%から90%の間に落ち着くことが多いです。そしてここが問題です:100文字あたり10〜20個の誤りは均等に分布していません。誤りは、間違えるとコストがかかる文字に集中します。
異なるOCR精度指標が互いにどう関連するかを理解するには、CER、WER、フィールド単位の精度のガイドから始めてください。
手書き文字がOCRにとって根本的に難しい理由
手書き文字のOCR精度が印刷テキストのOCRに大きく及ばない理由は、単に手書きが「汚い」からではありません。問題は構造的なものです:手書き文字には安定した文字形状がありません。Arial、Times New Roman、Courierの印刷された「a」は、閉じたループと縦棒という同じ基本構造を共有します。手書きの「a」は、ループが閉じていることも、uのように開いていることも、一筆書きであることも、点に簡略化されることもあります。同じ書き手でも、速度やペンの角度によって異なる形状を生み出します。複数の書き手にわたれば、ばらつきは爆発的に増えます。この構造的な違いが文字レベルでなぜ重要なのか、そしてAIがその周辺をどう読むのかをステップバイステップで解説した、手書き文字認識の仕組みの詳細ガイドをご覧ください。
これにより、3つの明確な失敗モードが生じます:
セグメンテーションの失敗
従来のOCRは文字間の明確な境界に依存しています。筆記体は文字がつながっているため、文字単位のエンジンではどこで1つの文字が終わり、次の文字が始まるのかを判断できません。素早く書かれた「n」と「i」は「m」と視覚的に区別がつかなくなり、OCRは単語の意味を理解しない限り、どちらの解釈が正しいかを判断する手段がありません。
字形の曖昧さ
同じ数字でも、書く人によって、あるいは同じ人が日によって異なる書き方をすると、本来の字形よりも別の数字に見えることがあります。横棒のない急いで書かれた「7」は「1」に見えます。ループが短い「9」は「4」や「8」に見えるかもしれません。何百万ものサンプルで学習したOCRモデルでも、視覚的な情報自体が不十分な場合には、根本的な曖昧さに直面します。
文脈の無視
従来のOCRは各文字を単独で読み取ります。「合計」というラベルのフィールドには数字が入るべきことや、「日付」というラベルのフィールドは日付形式に一致すべきことを認識しません。この文脈上の制約がないと、エンジンはあり得ない解釈を排除する手段がありません。手書きの「Smith」の「S」を、ストロークパターンが偶然一致するという理由で「5」と読んでしまうことがあります。
3つ目の失敗モードが最も重要です。文脈の無視こそが、従来のOCRとAIベースの抽出を分ける点です。従来のOCRエンジンは、すべてのピクセルに同じ文字照合ロジックを適用します。一方、最新の視覚言語モデルは文書を意味的に読み取ります。フィールドが数値であること、日付が特定の形式に準拠する必要があること、合計が明細項目と一致する必要があることを識別します。これらの制約により、考えられる文字の解釈が大幅に絞り込まれます。
CERの罠:文字精度90%がフィールド精度0%を意味する理由
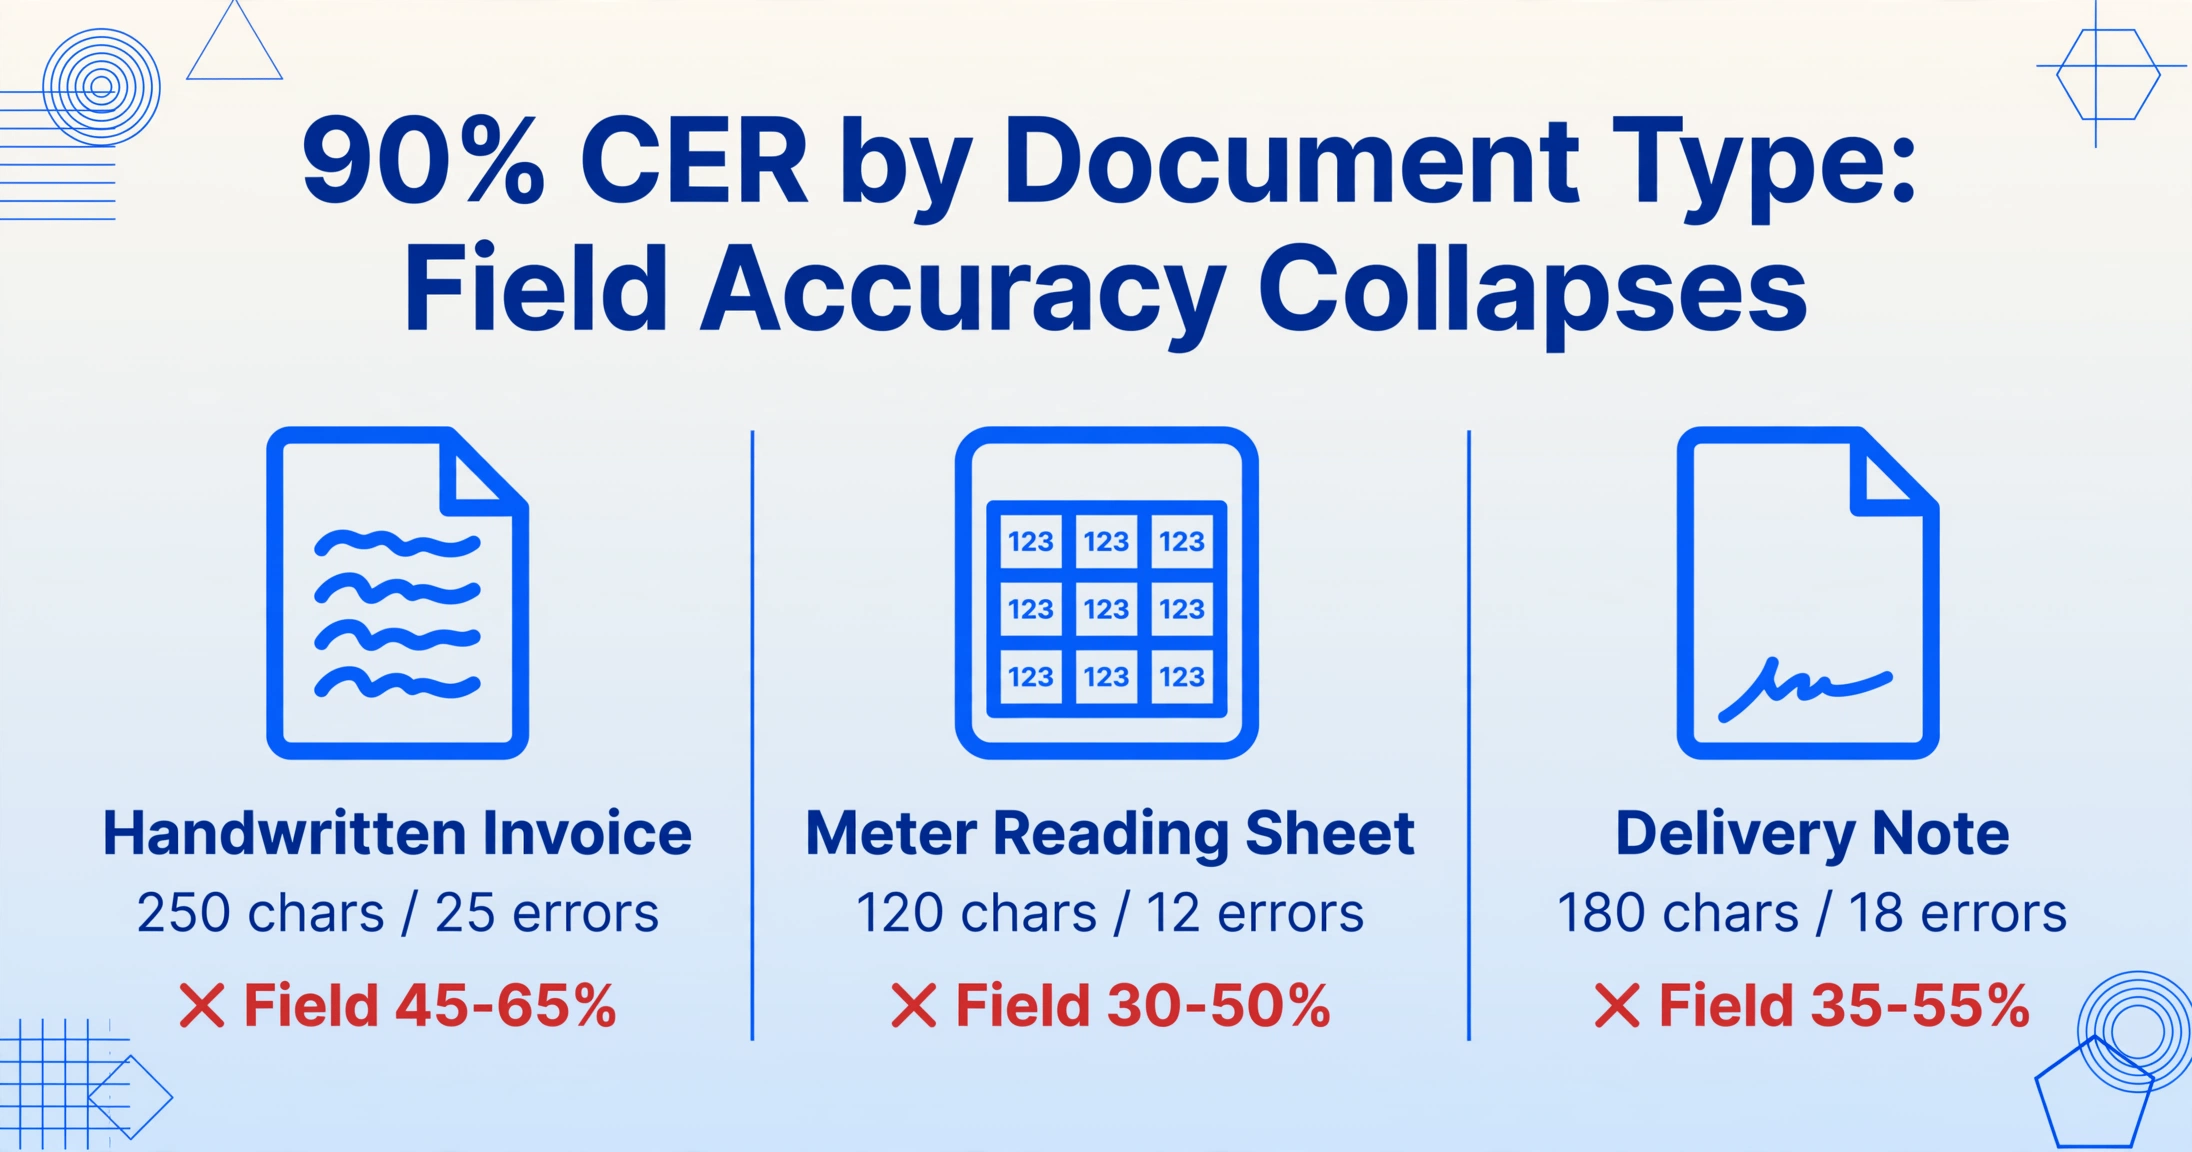
ベンダー情報、明細行、数量、価格、小計、税、合計を含む250文字の手書き請求書を考えてみましょう。手書きOCRエンジンが90%の精度を達成した場合、250文字のうち25文字が誤っていることになります。
抽出が役立つかどうかを決める問いはこれです:どの25文字か?
| 文書タイプ | 総文字数 | 精度90%=エラー数 | フィールド単位の結果 | 業務への影響 |
|---|---|---|---|---|
| 印刷された請求書 | 200 | 2件のエラー(精度99%) | 98~100% | レビューなしで処理可能な場合がある |
| 手書き請求書 | 250 | 25件のエラー | 45~65% | ほとんどのフィールドが誤り — 全面的な手入力のやり直しが必要 |
| 検針票 | 120(数字のみ) | 12件のエラー | 30~50% | 誤った検針値 → 誤った請求 |
| 納品書(数量+署名) | 180 | 18件のエラー | 35~55% | 誤った数量 → 在庫の不一致 |
手書きの検針票で90%の精度とは、およそ10桁に1桁が誤っていることを意味します。検針値は数字のみであり、「0013847」と「0013841」の違いは数千件のメーターにわたって積み重なる請求の不一致を生むため、フィールド単位の失敗率は100%の人手による検証なしには抽出を実用不可能にします。時間を節約しているのではなく、データ入力作業を検証ステップに移しているだけであり、そこでは依然としてすべての値を目視する必要があります。
3つの実例、3つの失敗パターン
CER の数値という抽象論は、実際の手書きドキュメントを見て、どこでエラーが起きているかを追うと具体的になります。
1. 手書きの請求書 — 合計フィールドの崩壊
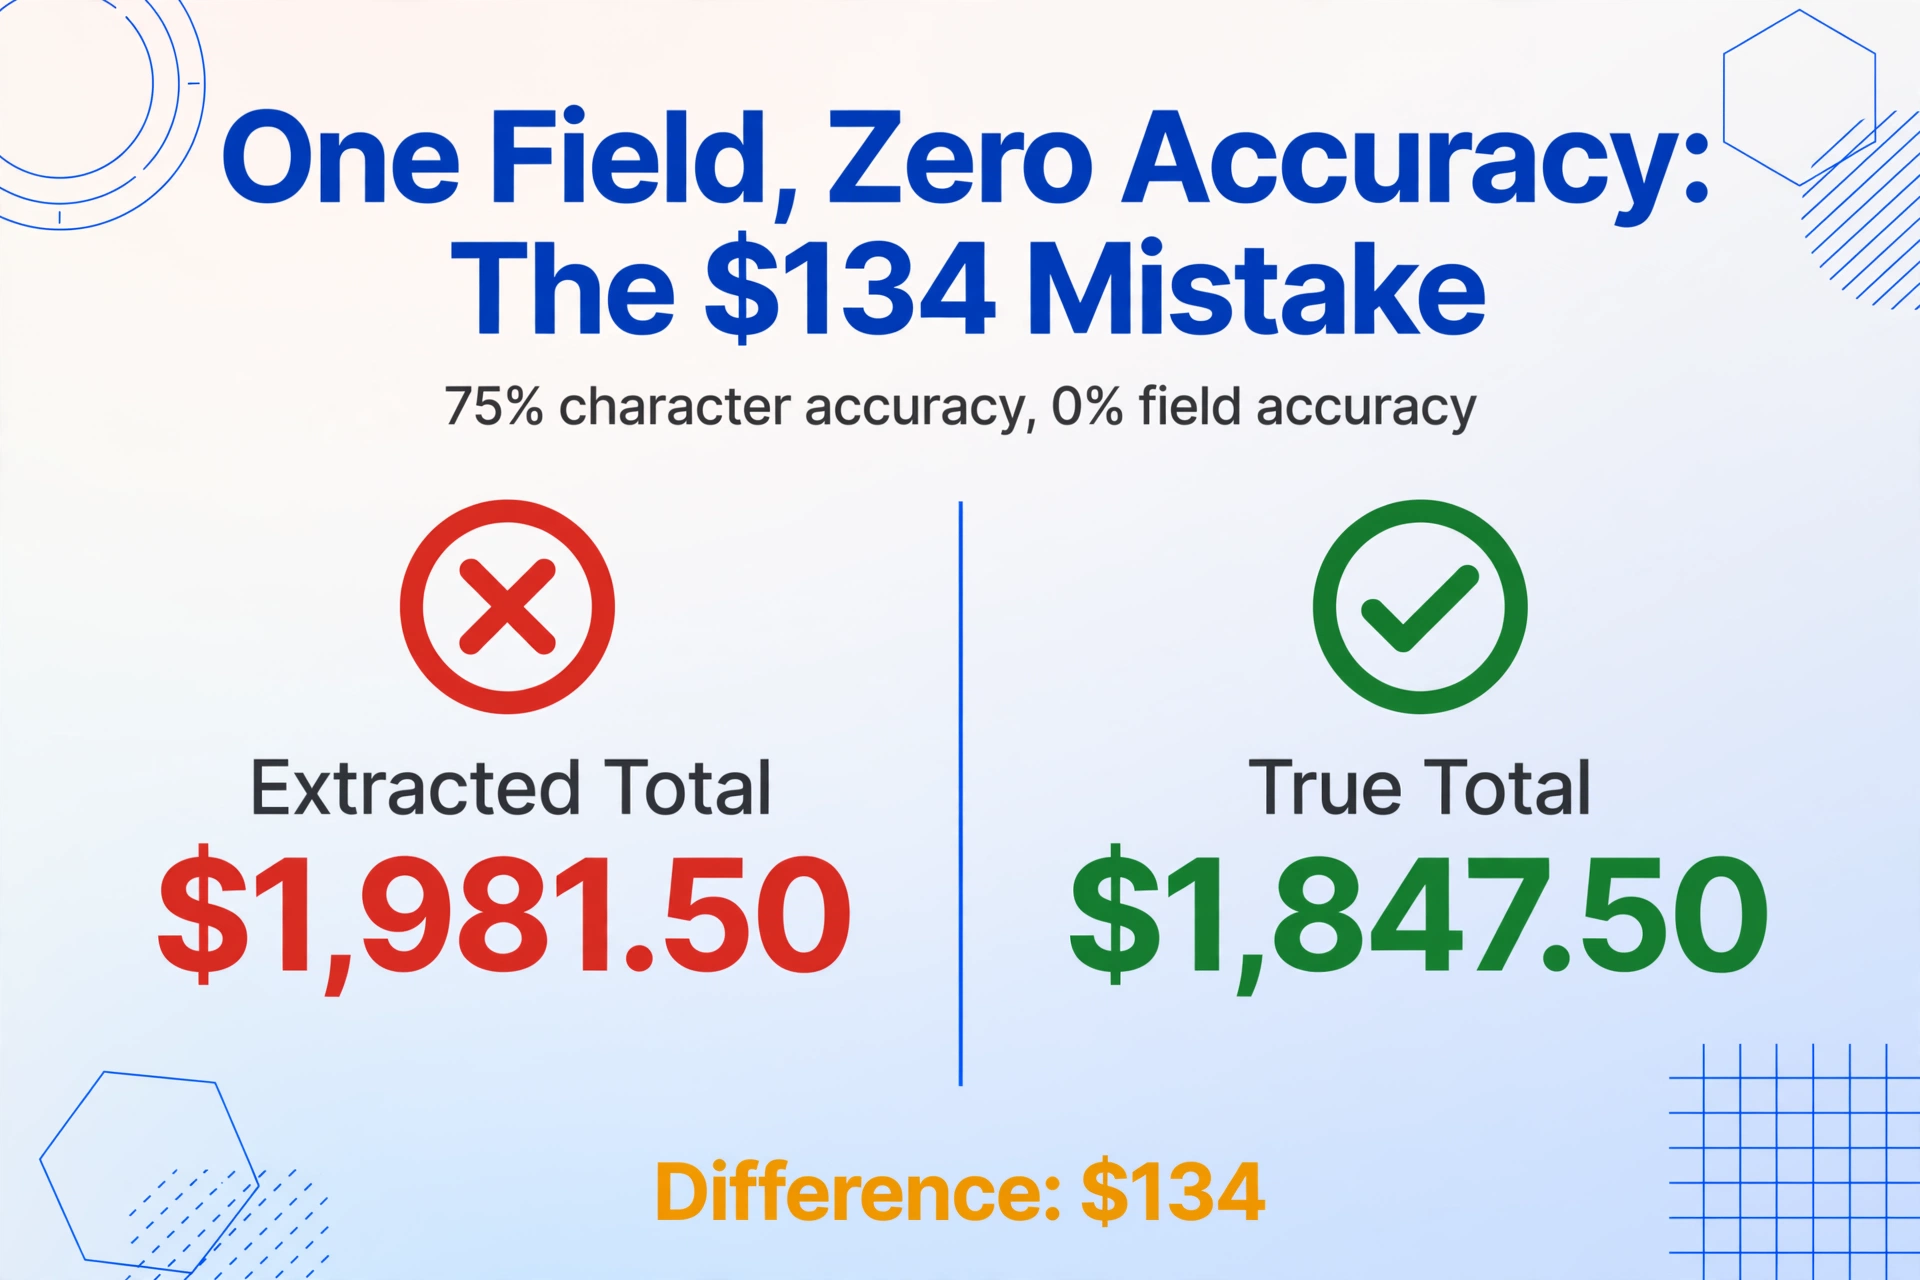
小さな工務店が資材の請求書を提出します。ヘッダーはきれいに印字されていますが、明細行、数量、最終合計は手書きです。合計欄には「$1,847.50」と書かれています。OCR エンジンは手書きの「4」を「9」と誤読し、「7」を「1」と誤読します。抽出された合計は「$1,981.50」になり、$134 の差が生じます。この1つのフィールドの文字精度は 75%(8文字中6文字が正しい)です。フィールド単位の精度は 0% です。ページ全体の精度は依然として 88〜92% と報告されます。ヘッダーテキストのほとんどが完璧に印字されているからです。しかし、請求書が伝えるために存在するその1つのフィールドが誤っており、しかも支払い紛争を引き起こすほどの誤りなのです。
これは特殊なケースではありません。手書きの数字は OCR にとって最もエラーが起きやすい入力です。数字は文字よりも識別特徴が少ないからです。「4」と「9」の違いは閉じたループが1つあるかどうか、「3」と「8」の違いは上のループが閉じているかどうか、「1」と「7」の違いは書き手のスタイルによっては存在しない横棒があるかどうかです。
2. 納品書 — 数量の混同
納品書には「Item」「Qty Ordered」「Qty Received」という事前印刷されたヘッダーがあります。数量は手書きで丸で囲まれたり、取り消し線が引かれています。手書き OCR はここで失敗します。素早いチェックマークや丸で囲まれた数字として書かれた数量は曖昧だからです。丸で囲まれた「6」は「8」と混同される可能性があります。倉庫の現場では、120 個と 180 個の数量の読み間違いが在庫の再発注を左右します。Qty Received 列の 10% の文字誤り率は、在庫切れか、帳消しを意味します。
3. 検針票 — 連鎖するエラー
検針員は紙のルートシートに検針値を記録します。これは、メーターID、前回検針値、今回検針値、使用量のグリッドです。文字は数字のみで、小さなセルに斜めに素早く書かれます。1桁の誤りが連鎖します。今回の検針値03842が03892と読み間違えられると、使用量は50単位増加します。ルートあたり5,000メーターに集計すると、請求エラーは数万ドルに膨らみます。公益事業業界は、誤請求を含む非技術的損失により年間推定900〜1,000億ドルを失っており、そのかなりの部分が手書きシートの誤読に起因しています。
数字のみのフィールドは、OCRにとって同時に簡単でありながら困難でもあります。文字セットは小さいものの、単一の数字クラス内のばらつきがクラス間の差を超えることがあるため、曖昧さは極端です。横棒のない「7」とセリフ付きの斜めの「1」は、視覚的に区別がつかないことがあります。
手書きOCR精度について実際にできること
現実的な見方は絶望的ではありません。ただし、制約を理解し、適切なアプローチを選ぶ必要があります。ここでは、効果のある方法をご紹介します。
1. 文字認識よりも意味的抽出を選ぶ
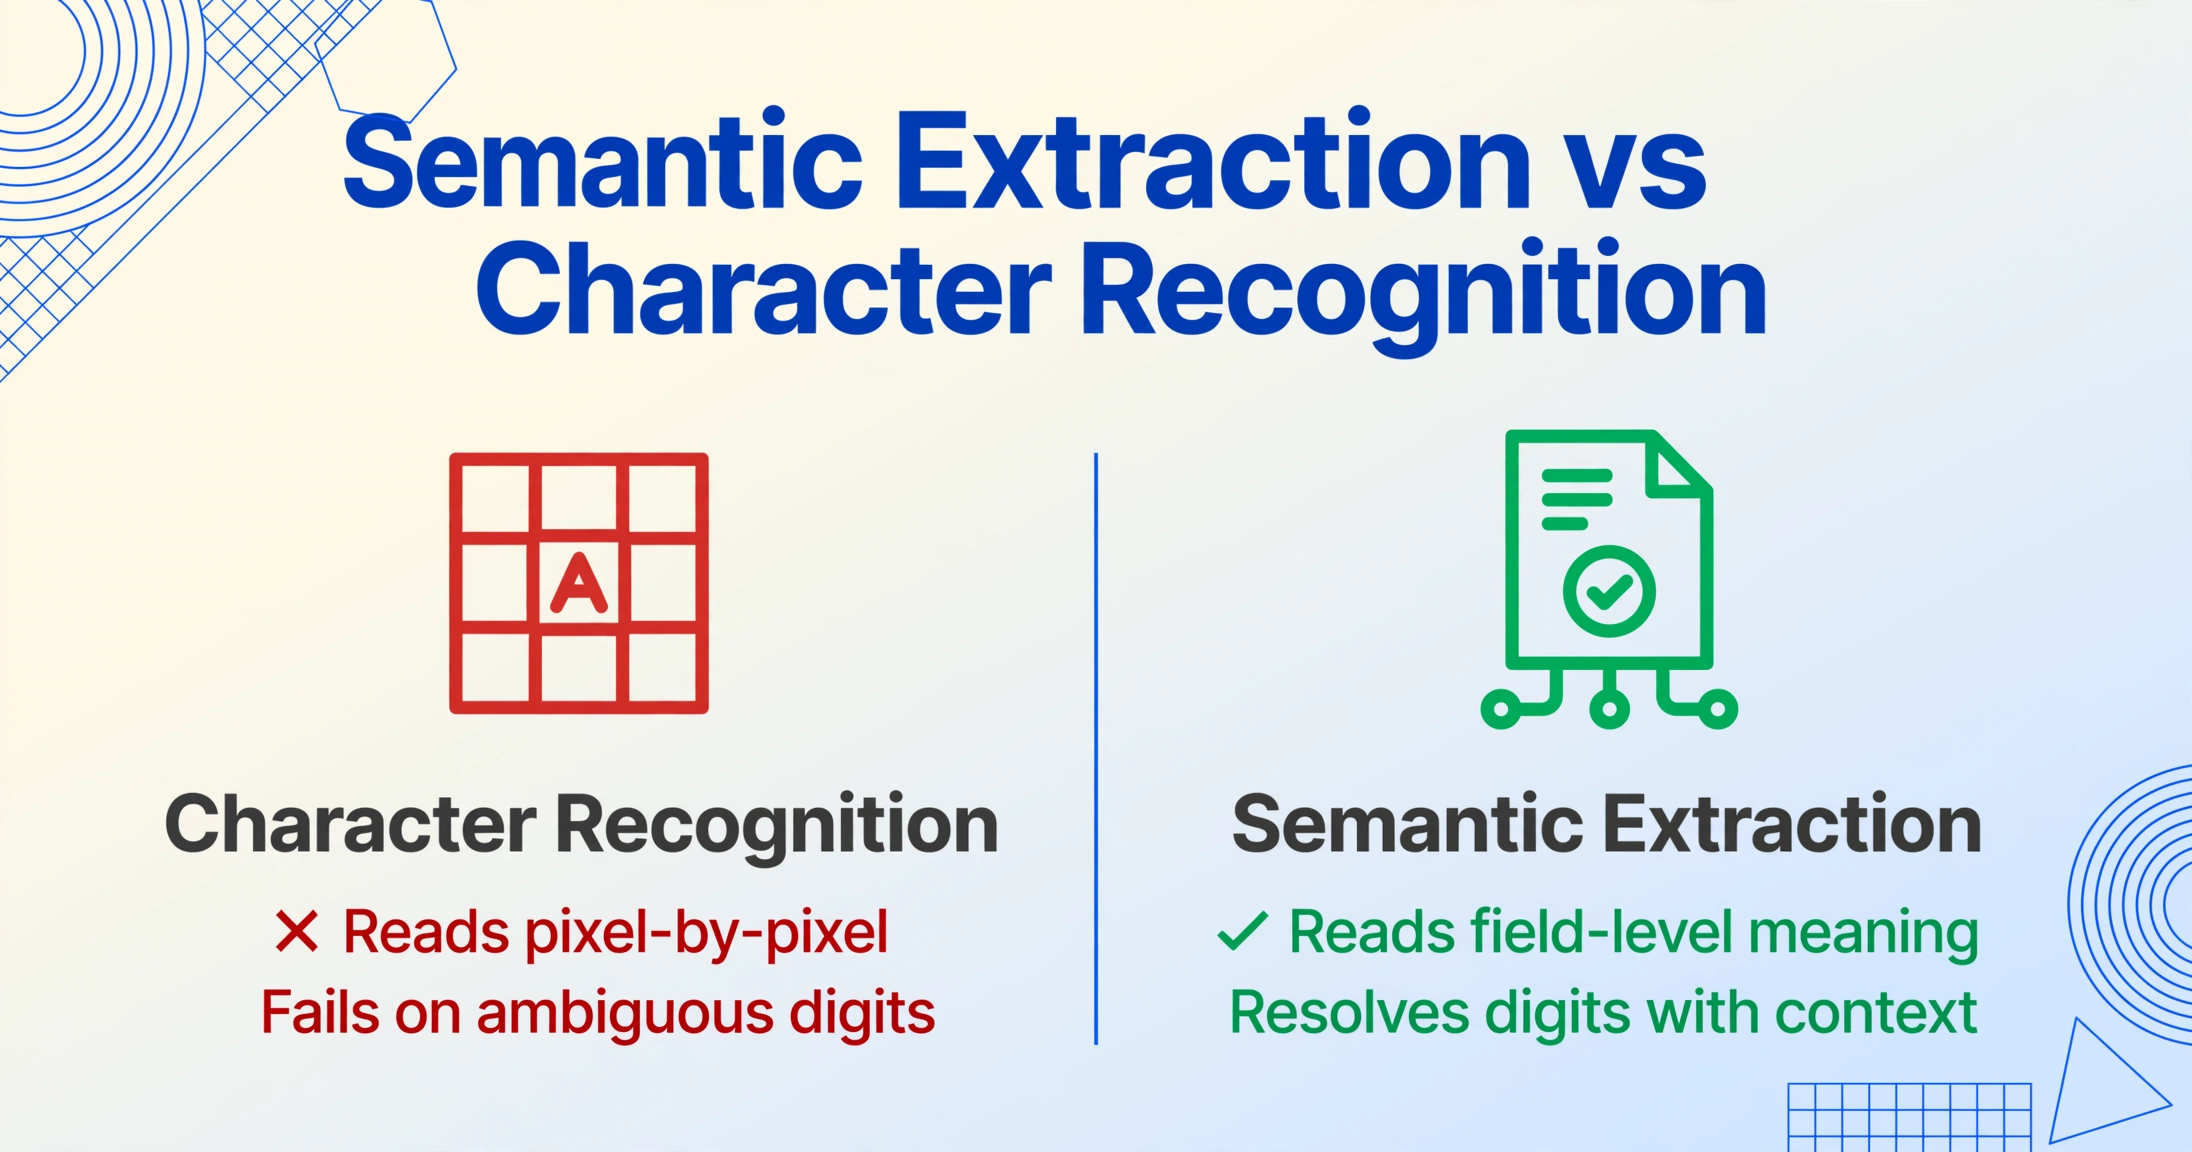
手書きを許容範囲内で処理できるツールとそうでないツールの最大の違いは、ドキュメントを意味的に読むか、ピクセル単位で読むかです。従来のOCRは手書きを文字認識の問題として扱います。AIベースの抽出は、それをフィールド単位のセマンティックな問題として扱います。
AIモデルが「受領数量」が数値であるべきだと知っていれば、その制約を使って曖昧な数字を解決します。「日付」が形式に準拠しなければならないと知っていれば、無効な日付を除外します。この意味的な制約により、文字認識を改善するのではなく、エンジンにどの答えが不可能かを伝えることで、重要なフィールドの文字誤り率(CER)を劇的に削減します。
ImageToTable.aiはこの意味的アプローチを使用しています。「メーターID」「今回検針値」「使用量」などの列を定義すると、AIは各値がどこにあるかではなく、何を意味するかを理解して特定します。2026年の最高の手書きOCRツールはすべてこの意味的抽出パラダイムを活用しており、手書きドキュメントでは従来のエンジンを上回ります。
手書き精度が最も重要視されるドキュメントタイプである検針票での動作をご覧ください。
ファイルは安全に処理され、保存されません。
2. 入力品質を管理する
手書きOCRの精度は、200 DPI未満や、斜めからの撮影・不均一な照明の写真では著しく低下します。最もコスト効果の高い精度向上策は、取り込みの標準化です。最低300 DPIでスキャンし、綴じられた書類にはドキュメントフィーダーを使用し、管理されていないスマホ撮影は避けてください。これにより、気軽なスマホ撮影と比較して文字誤り率(CER)を5〜15ポイント改善できます。これは、現在のどのアルゴリズム改善よりも大きな効果です。
スマホ撮影が避けられない場合(現場の検針ではよくあることですが)、正面からの角度、均一な照明、コントラストチェックを画像受け入れ前に強制するキャプチャアプリを使用してください。丁寧な撮影と素早い撮影の違いは、実用的な抽出と役に立たない出力の違いになることがよくあります。
3. 検証ワークフローを構築する — 盲目的なパイプラインではなく
どんな手書きOCRシステムでも — どれほど高度であっても — 検証ステップなしにデータを請求システムや在庫システムに直接送り込むべきではありません。問題はエラーが発生するかどうかではなく、被害が生じる前に検出されるかどうかです。
エラーが発生する場合、それらは認識可能なパターンに従います — そしてそのほとんどは防ぐことができます。当社の手書き抽出の失敗モードガイドでは、最も一般的な8つの失敗パターンとそれぞれの修正方法を分類しているので、問題がキャプチャプロセスにあるのか、フィールド設計にあるのか、ツール自体にあるのかを判断できます。
実践的なアプローチ:手書きドキュメントを抽出にかけ、信頼度スコアがしきい値(通常85〜90%)未満の出力を人間によるレビューに回し、すべての文字ではなく合計・数量・識別子に注意を集中させます。このターゲットを絞った検証により、100%の手動再入力なしで、影響の大きいエラーの10〜20%を検出できます。ワークフロー:バッチ処理で意味的AI抽出ツールにかけ、フラグ付きフィールドをレビューし、修正して確認し、エクスポートして会計・請求システムに送ります。
このハイブリッドアプローチ — AI抽出+ターゲットを絞った人間によるレビュー — は、自動化のスピード向上と、業務上重要なデータに必要な精度保証の両方を提供します。ドキュメントの種類によって精度の結果は劇的に異なります。そのため、ワークフローを確定する前に実際のドキュメントでテストすることが不可欠です。
よくある質問
2026年の手書きOCRの実際の精度はどのくらいですか?
正直な答えは、手書きの種類と入力品質によって異なります。構造化フォームのきれいなブロック体を300 DPIで読み取る場合、最良のシステムは85〜93%の文字精度を達成します。スマホ写真からの筆記体や混在した手書きの場合、実効文字精度は65〜80%に低下します。重要な指標であるフィールド単位の精度は、通常文字精度より10〜25ポイント低くなります。「手書き精度95%」と主張するベンダーが、CERとフィールド単位の精度を区別せず、テストセットも説明していない場合、ほぼ確実に厳選されたセットからの最良ケースの文字レベル数値を報告しています。手書きの種類別の精度の内訳 — 活字体、きれいな筆記体、乱雑な筆記 — については、AIが写真から手書きを読めるかどうかに関するリファレンスをご覧ください。
筆記体の手書き文字は、活字よりもOCRにとって難しいですか?
はい、かなり難しいです。独立した比較調査によると、同じツールでも筆記体の手書き文字のOCR精度は、活字の手書き文字認識より10〜15ポイント低くなっています。ABBYY FineReaderは手書きの活字で95.2%ですが、筆記体では91.7%です。Adobe Acrobatは活字で88.6%から筆記体で79.3%に低下します。理由は構造的なものです。筆記体は文字がつながっているため、従来のOCRが依存する明確な文字の区切りがなくなります。AIベースの視覚モデルは、単語レベルの文脈を使って曖昧な文字の境界を解決するため、従来のOCRよりもうまく対処できますが、筆記体は依然として難しい問題です。
AIの手書き文字OCRは手入力作業を置き換えられますか?
整った手書き文字と高品質な入力がある構造化ドキュメントであれば、AIの手書き文字OCRは手入力作業を70〜80%削減できます。ただし、人による確認を完全に置き換えるべきではありません。現実的な目標はハイブリッドなワークフローです。AIがすべてのフィールドを抽出し、信頼度の低い結果にフラグを立てて確認を促し、人はフラグが立った値だけを検証します。請求業務で抽出エラーを修正しない場合のコストは、通常、確認中に発見するコストの10〜20倍です。
なぜ手書き文字OCRは特に数字で失敗するのですか?
数字は文字よりも識別できる視覚的特徴が少ないからです。「4」と「9」の違いは閉じたループが1つあるかどうか、「7」と「1」の違いは存在しないかもしれない横棒です。ドキュメントがほとんど数字の場合(検針票、数量、価格など)、すべての文字が曖昧さの高い文字であるため、1桁ごとの誤り率が積み重なります。全文テキストの手書き文字で90%の精度でも、数値フィールドでは1桁あたり80%の精度になり、フィールド単位の抽出は少なくとも1つの重要な値でほぼ確実に失敗します。
ベンダーの「手書き文字精度90%」という主張を信じるべきですか?
3つの質問をせずに信じてはいけません。(1) それは文字レベルですか、フィールドレベルですか? (2) どのようなドキュメントタイプがテストされましたか — ブロック体、筆記体、それともモバイル写真ですか? (3) 何種類の異なる手書きスタイル(10人か500人か)ですか? ほとんどのベンダーは、少数の書き手による整ったブロック体の厳選されたテストセットでCERを報告しています。多様な入力品質を持つ数十人の書き手による実世界のドキュメントでは、実効精度は通常10〜20ポイント低くなります。これら3つの質問に具体的な数字で答えられない、または答えようとしないベンダーは、手書き文字に関する実世界でのテストをほとんど行っていない可能性が高いです。