Precisão de OCR em Manuscritos:
Por Que 90% de CER Ainda Significa Totais Errados
Quando um fornecedor de OCR afirma "90% de precisão em manuscritos", ele está se referindo ao reconhecimento no nível de caracteres — se letras e dígitos individuais foram lidos corretamente, em média, na página. Mas essa média esconde um problema devastador: uma taxa de erro de 10% em caracteres não gera 10% de dados ruins. Ela gera falhas catastróficas em campos específicos, porque os erros de manuscrito se concentram nos lugares que mais importam — totais, datas, identificadores — e um único dígito errado em um total de fatura ou em uma leitura de medidor torna toda a extração incorreta. A lacuna entre "90% de precisão em caracteres" e "dados utilizáveis no nível de campo" é o mal-entendido mais caro na automação de documentos hoje.
Principais Conclusões
- "90% de precisão de OCR em manuscritos" significa que 1 em cada 10 caracteres está errado — e os erros se concentram nos seus totais e leituras de medidor, não no cabeçalho.
- Um total manuscrito de 8 dígitos com 90% de CER tem 57% de chance de conter pelo menos um erro — você não eliminou o trabalho manual, apenas renomeou a entrada de dados para "verificação" e ainda confere cada valor.
- Pare de perseguir precisão no nível de caracteres. A extração semântica — onde a IA sabe que "Qtd. Recebida" é um número e "Data da Fatura" é uma data — elimina interpretações impossíveis antes que cheguem à sua planilha.
O que "90% de precisão" realmente mede em escrita à mão
A Taxa de Erro de Caracteres é a métrica padrão para avaliar o reconhecimento de escrita à mão. Ela conta cada substituição (um "5" lido como "6"), inserção e exclusão, e divide pelo total de caracteres. O benchmark do setor para texto impresso — limpo, em alta resolução, com fontes padrão — é uma CER abaixo de 1%, ou seja, 99% ou mais de precisão de caracteres.
A escrita à mão muda completamente a matemática. Uma comparação independente das principais ferramentas de OCR descobriu que em letra de forma manuscrita (letras de forma), o ABBYY FineReader alcançou 95,2% de precisão e o Adobe Acrobat chegou a 88,6%. Em escrita cursiva, a diferença aumentou: ABBYY com 91,7%, Adobe com 79,3% e Readiris com 84,9%. Esses são resultados de primeira linha de OCR desktop dedicado — não de fotos de celular ou documentos mistos.
Para documentos empresariais reais — faturas manuscritas, notas de entrega, folhas de leitura do medidor — a precisão efetiva de caracteres geralmente fica entre 80% e 90%. E aqui está o problema: esses 10 a 20 erros por 100 caracteres não são distribuídos uniformemente. Eles se concentram nos caracteres em que errar custa dinheiro.
Para entender como diferentes métricas de precisão de OCR se relacionam entre si, comece com nosso guia sobre CER, WER e precisão a nível de campo.
Por que escrever à mão é fundamentalmente diferente para OCR
A razão pela qual a precisão do OCR de escrita à mão fica tão atrás do OCR de texto impresso não é simplesmente que a escrita à mão é "mais bagunçada". O problema é estrutural: a escrita à mão não tem formatos de caracteres estáveis. Um "a" impresso em Arial, Times New Roman e Courier compartilha a mesma estrutura essencial — um laço fechado com uma haste. Um "a" manuscrito pode ser fechado com um laço, aberto como um "u", escrito em um único traço ou simplificado para um ponto. O mesmo escritor produz formatos diferentes dependendo da velocidade e do ângulo da caneta. Entre vários escritores, a variação explode. Para uma explicação passo a passo de por que essa diferença estrutural importa no nível de caracteres — e como a IA contorna isso — veja nosso mergulho profundo em como funciona o reconhecimento de escrita à mão.
Isso cria três modos distintos de falha:
Falha de segmentação
O OCR tradicional depende de limites claros entre caracteres. A escrita cursiva conecta as letras, tornando impossível para um mecanismo de nível de caractere saber onde uma termina e a próxima começa. Um "n" seguido de "i" escrito rapidamente se torna visualmente idêntico a um "m" — e o OCR não tem como decidir qual interpretação está correta sem entender a palavra.
Ambiguidade de forma
O mesmo dígito escrito de forma diferente por duas pessoas — ou pela mesma pessoa em dias diferentes — pode parecer mais com um dígito diferente do que com sua própria variante. Um "7" escrito às pressas sem a barra transversal se parece com um "1". Um "9" com um laço curto pode ser um "4" ou um "8". Um modelo de OCR treinado com milhões de exemplos ainda enfrenta ambiguidade fundamental quando o próprio sinal visual é subdeterminado.
Cegueira de contexto
O OCR tradicional lê cada caractere isoladamente. Ele não sabe que um campo rotulado como "Total" deve conter um número, ou que um campo rotulado como "Data" deve corresponder a um formato de data. Sem essa restrição contextual, o mecanismo não tem como descartar interpretações impossíveis — ler o "S" em um "Smith" manuscrito como um "5" porque o traçado coincide.
O terceiro modo de falha é o mais consequente. A cegueira de contexto é o que separa o OCR tradicional da extração baseada em IA. Um mecanismo de OCR tradicional aplica a mesma lógica de correspondência de caracteres a cada pixel. Um modelo moderno de visão-linguagem lê o documento semanticamente: ele identifica que um campo é numérico, que uma data deve estar em um formato específico, que um total deve ser consistente com os itens de linha. Essas restrições reduzem drasticamente as interpretações plausíveis de caracteres.
A Armadilha do CER: Por Que 90% de Precisão de Caracteres Pode Significar 0% de Precisão de Campo
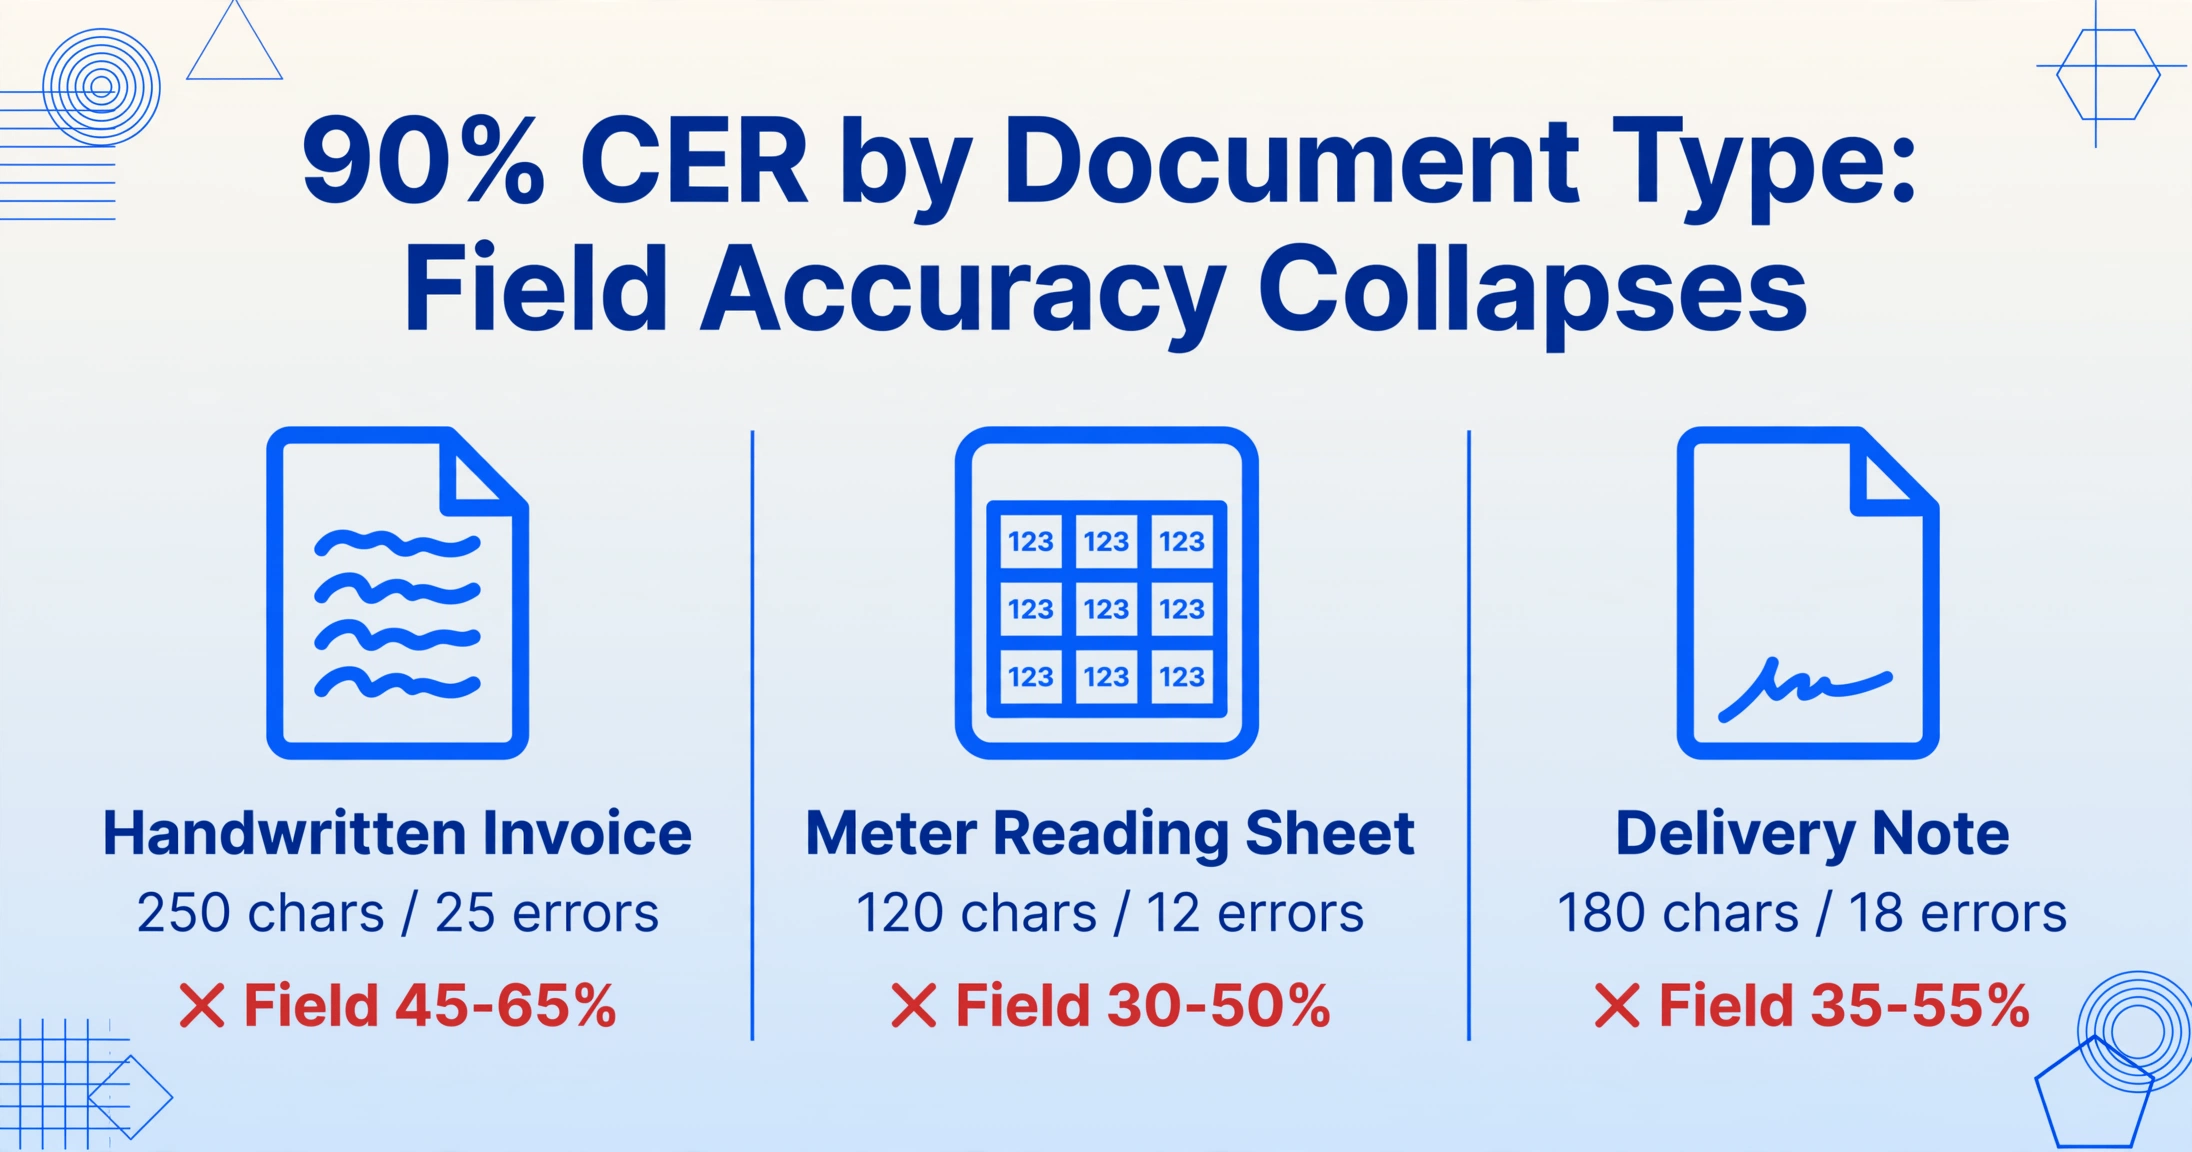
Considere uma fatura manuscrita com 250 caracteres — dados do vendedor, itens de linha, quantidades, preços, subtotal, imposto e total. Um motor de OCR para escrita manual alcanza 90% CER: 25 caracteres errados de 250.
A questão que decide se a extração é útil: quais 25 caracteres?
| Tipo de documento | Total de caracteres | CER 90% = erros | Resultado a nível de campo | Impacto no negocio |
|---|---|---|---|---|
| Fatura impressa | 200 | 2 erros (99% CER) | 98-100% | Puede procesarse sin revisión |
| Fatura manuscrita | 250 | 25 erros | 45-65% | La mayoría de los campos están mal — requiere reingreso manual completo |
| Folha de leitura do medidor | 120 (solo numérico) | 12 erros | 30-50% | Lecturas incorrectas → facturación incorrecta |
| Nota de entrega (qtd. + firmas) | 180 | 18 erros | 35-55% | Cantidades incorrectas → desajuste de inventario |
Un 90% CER en una folha de leitura del medidor manuscrita significa aproximadamente 1 de cada 10 dígitos está mal. Dado que las lecturas son exclusivamente numéricas y la diferencia entre "0013847" y "0013841" es una discrepancia de facturación que se acumula en miles de medidores, la tasa de fallo a nivel de campo hace que la extracción sea inutilizable sin verificación humana al 100%. No estás ahorrando tiempo — solo estás moviendo el trabajo de entrada de datos a un paso de verificación que aún requiere revisar cada valor.
Três Documentos Reais, Três Modos de Falha
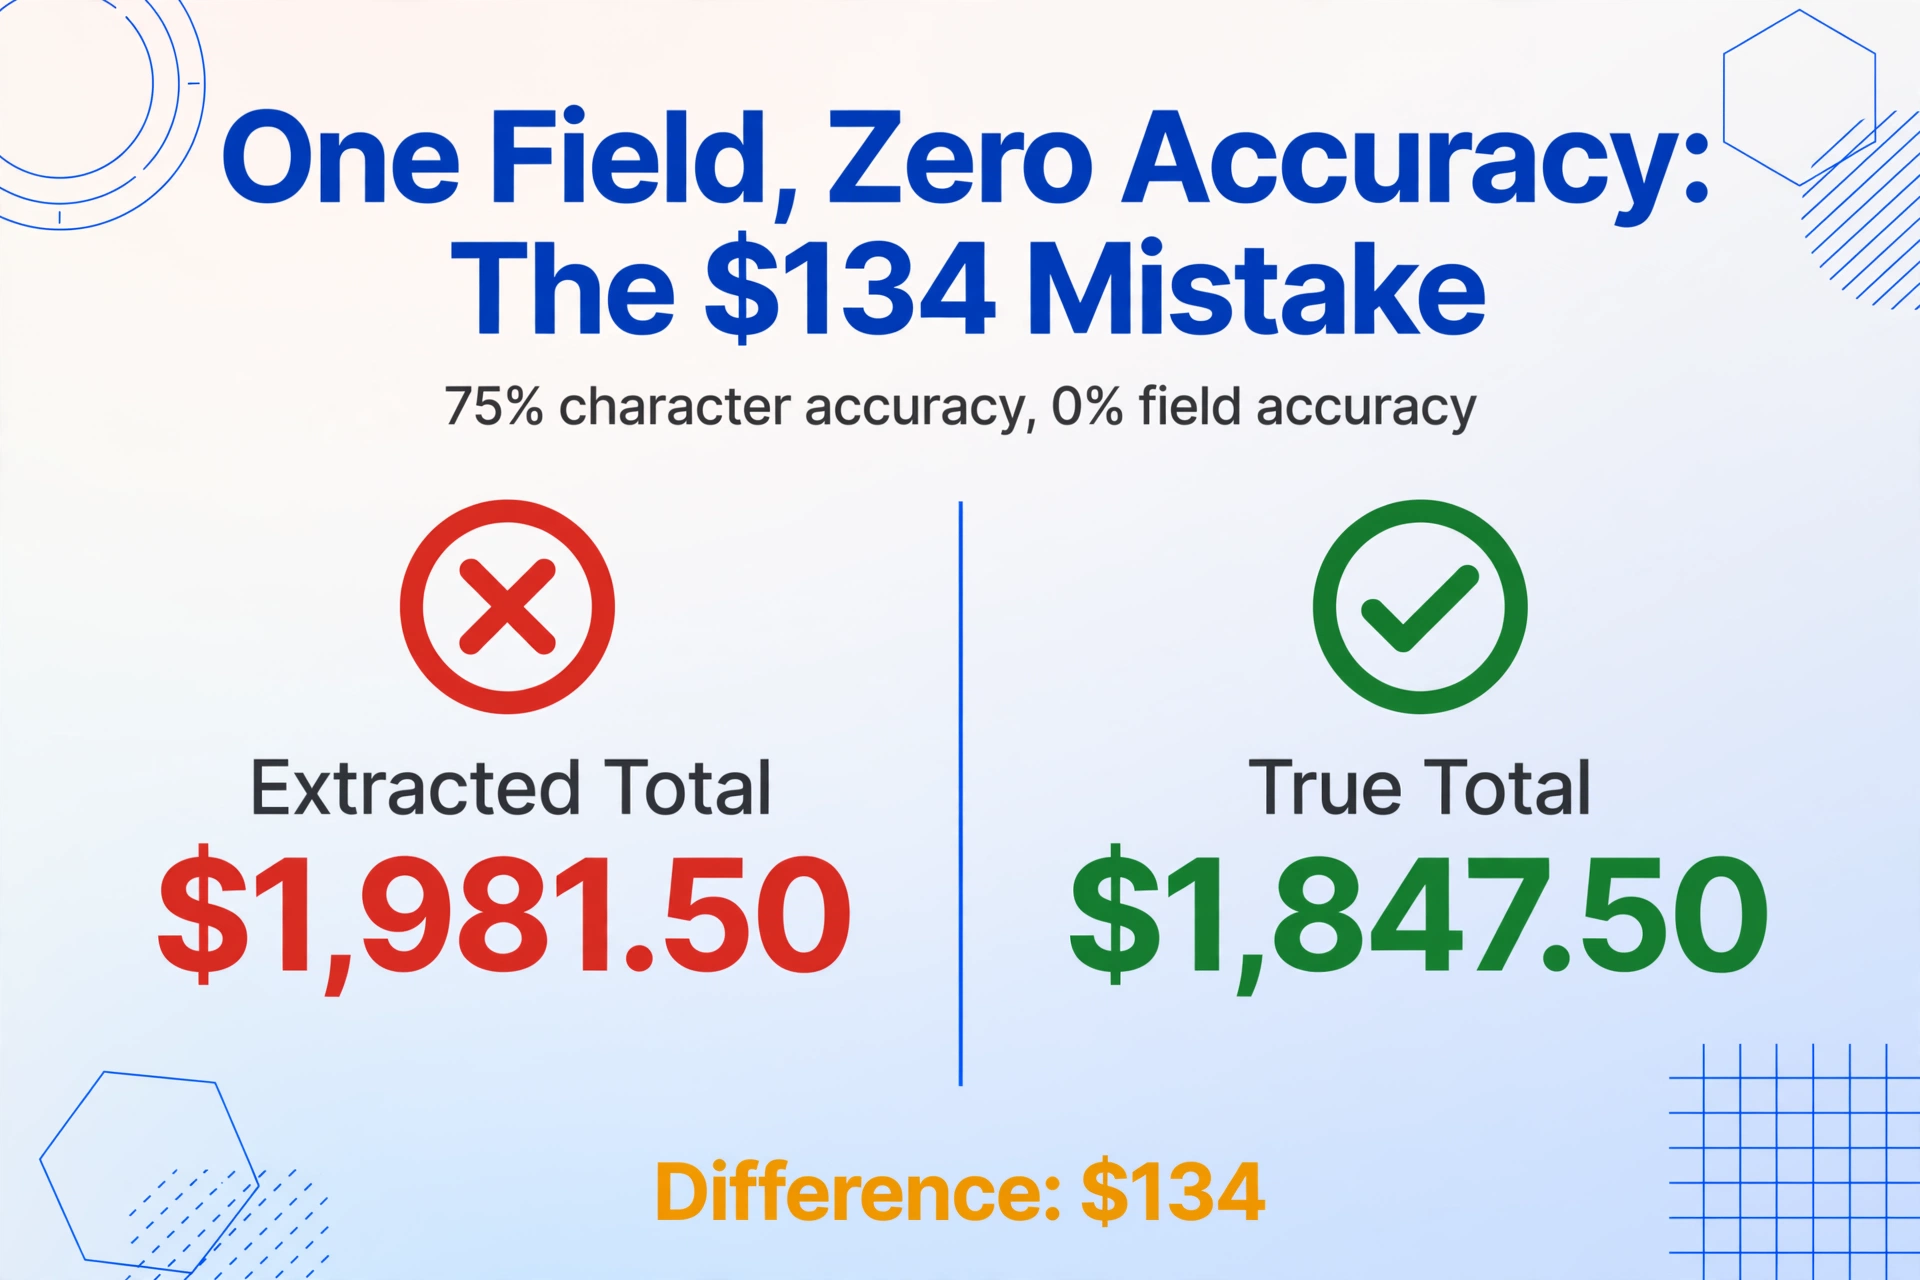
A abstração dos números de CER se torna concreta quando você observa documentos manuscritos reais e rastreia onde os erros se concentram.
1. Fatura Manuscrita — Colapso do Campo Total
Um pequeno empreiteiro envia uma fatura de materiais. O cabeçalho é digitado de forma organizada, mas os itens, as quantidades e o total final são manuscritos. O campo total indica "$1.847,50." O mecanismo de OCR lê incorretamente o "4" manuscrito como "9" e o "7" como "1." O total extraído vira "$1.981,50" — uma diferença de $134. A precisão de caracteres neste único campo é de 75% (6 de 8 caracteres corretos). A precisão a nível de campo é de 0%. O CER da página ainda reporta 88-92% porque a maior parte do texto do cabeçalho foi impressa perfeitamente — mas o único campo que a fatura existe para comunicar está errado, e errado o suficiente para gerar uma disputa de pagamento.
Isso não é um caso extremo. Números manuscritos são a entrada mais propensa a erros para OCR porque dígitos têm menos características distintivas do que letras — um "4" e um "9" diferem por um único laço fechado, um "3" e um "8" por saber se o laço superior está fechado, um "1" e um "7" por uma barra transversal que pode não estar presente no estilo de escrita da pessoa.
2. Nota de Entrega — Confusão de Quantidades
Uma nota de entrega tem cabeçalhos pré-impressos: "Item," "Qtd. Pedida," "Qtd. Recebida." As quantidades são circuladas ou riscadas à mão. O OCR de manuscritos falha aqui porque quantidades escritas como marcas rápidas ou números circulados são ambíguas — um "6" com um círculo ao redor pode ser confundido com um "8." Em um contexto de armazém, onde uma única quantidade lida incorretamente de 120 unidades versus 180 unidades determina se o estoque será reabastecido, uma taxa de erro de caracteres de 10% na coluna Qtd. Recebida significa falta de estoque ou baixa contábil.
3. Folha de Leitura do Medidor — Erros em Cascata
Leituristas registram as leituras em folhas de rota em papel — grades de IDs de medidores, leituras anteriores, leituras atuais e consumo. Os caracteres são exclusivamente dígitos, escritos rapidamente em células pequenas e inclinadas. Um erro de um único dígito se propaga: se a leitura atual de 03842 for lida como 03892, o consumo aumenta em 50 unidades. Agregado em 5.000 medidores por rota, erros de faturamento se acumulam em dezenas de milhares de dólares. A indústria de utilities perde cerca de US$ 90-100 bilhões anualmente com perdas não técnicas, incluindo faturamento incorreto — e uma parcela significativa vem de leituras incorretas de folhas manuscritas.
Campos apenas numéricos são ao mesmo tempo mais fáceis e mais difíceis para OCR: o conjunto de caracteres é pequeno, mas a ambiguidade é extrema porque a variação dentro de uma única classe de dígito pode exceder a variação entre classes. Um "7" sem barra transversal e um "1" inclinado com serifa podem ser visualmente indistinguíveis.
O Que Você Pode Fazer de Fato Sobre a Precisão do OCR de Manuscritos
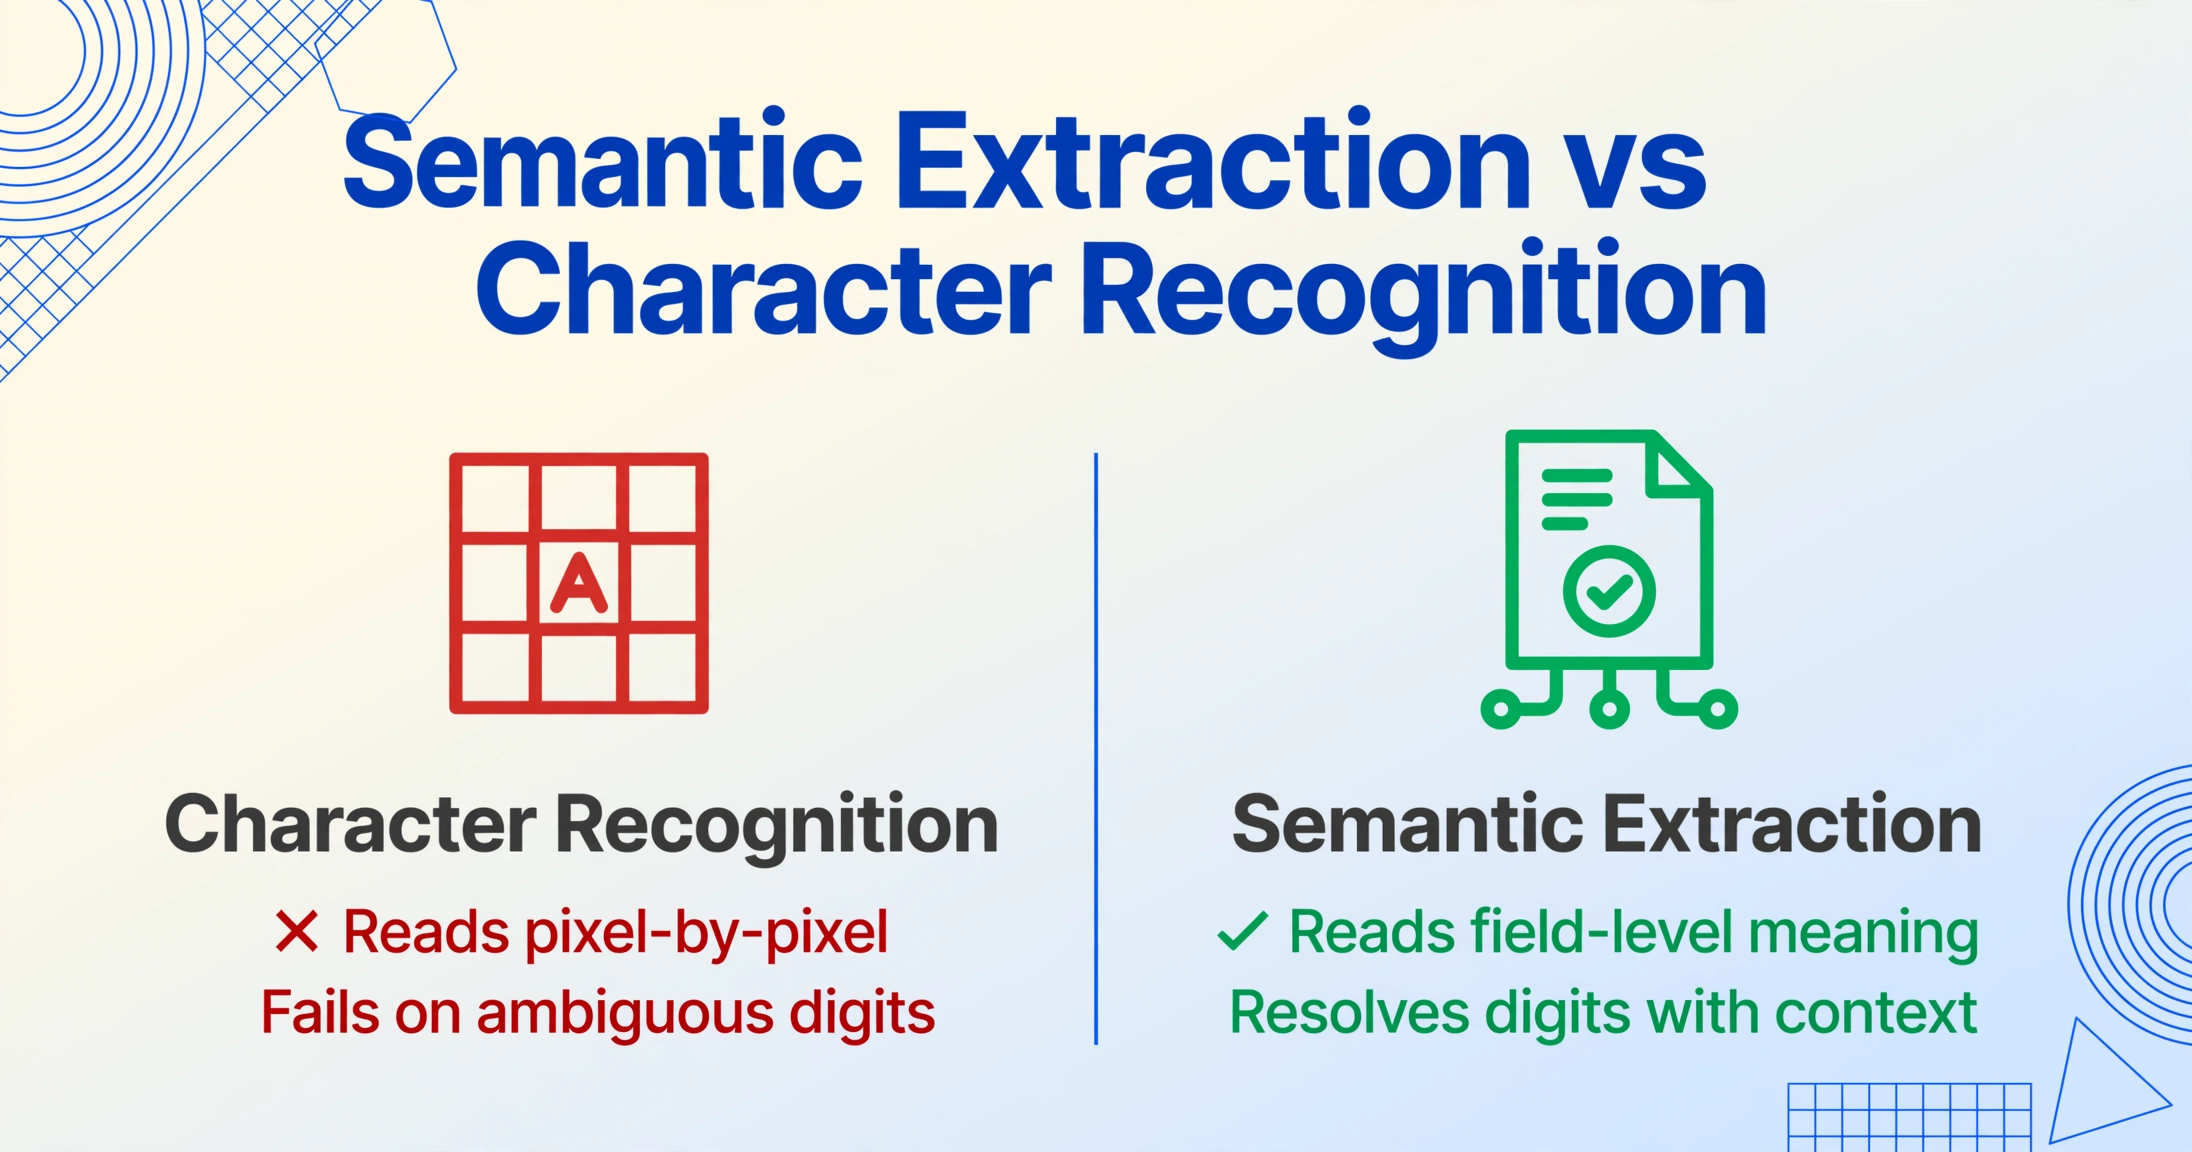
O cenário realista não é desesperador — mas exige entender as limitações e escolher a abordagem certa. Aqui está o que faz diferença.
1. Escolha Extração Semântica em Vez de Reconhecimento de Caracteres
A maior diferença entre uma ferramenta que lida bem com manuscritos e uma que não lida é se ela lê o documento semanticamente ou pixel por pixel. OCR tradicional trata manuscritos como um problema de reconhecimento de caracteres. Extração baseada em IA trata como um problema semântico a nível de campo.
Quando um modelo de IA sabe que "Qtd. Recebida" deve ser um número, ele usa essa restrição para resolver dígitos ambíguos. Quando sabe que "Data" deve seguir um formato, ele descarta datas inválidas. Essa restrição semântica reduz drasticamente a Taxa de Erro de Caracteres em campos críticos — não melhorando o reconhecimento de caracteres, mas dizendo ao mecanismo quais respostas são impossíveis.
ImageToTable.ai usa essa abordagem semântica. Você define as colunas — "ID do Medidor", "Leitura Atual", "Consumo" — e a IA localiza cada valor entendendo o que ele significa, não onde está. As melhores ferramentas de OCR para manuscritos em 2026 todas usam esse paradigma de extração semântica, superando mecanismos tradicionais em documentos manuscritos.
Veja em ação em uma folha de leitura do medidor — um tipo de documento onde a precisão de manuscritos importa mais:
Os arquivos são processados de forma segura e não são armazenados.
2. Controlar a Qualidade de Entrada
A precisão do OCR de escrita manual cai drasticamente abaixo de 200 DPI e em fotos tiradas em ângulo ou com iluminação irregular. A melhora de precisão mais barata é padronizar a captura: digitalize a pelo menos 300 DPI, use um alimentador de documentos para documentos encuadernados e evite fotos móveis não controladas. Isso pode melhorar a Taxa de Erro de Caracteres (CER) em 5-15 pontos em comparação com a captura móvel casual — mais do que qualquer melhora algorítmica oferece atualmente.
Se a captura móvel for inevitável (como costuma ser para leituras de medidores de campo), use um aplicativo de captura que imponga um ângulo reto, iluminação uniforme e uma verificação de contraste antes de aceitar a imagem. A diferença entre uma foto cuidadosa e uma rápida é muitas vezes a diferença entre uma extração utilizável e uma saída inútil.
3. Cree um Fluxo de Verificação, Não um Pipeline Cego
Nenhum sistema de OCR de escrita manual — por mais avançado que seja — deve alimentar dados diretamente em sistemas de faturação ou inventário sem uma etapa de verificação. A questão não é se ocorrerão erros, mas se serão detectados antes de causar danos.
Quando ocorren erros, eles seguem padrões reconhecibles — e a maioria são evitáveis. Nosso guia de modos de falha na extração de escrita manual classifica os oito padrões de falha mais comuns e a solução para cada um, para que você possa identificar se o problema está no seu processo de captura, no design dos campos ou na própria ferramenta.
Uma abordagem prática: execute documentos manuscritos através da extração, envie resultados com pontuações de confianza abaixo de um limiar (tipicamente 85-90%) para revisão humana, e concentre a atenção em totais, quantidades e identificadores em vez de cada caractere. Esta verificação direcionada detecta 10-20% dos erros de alto impacto sem exigir reentrada manual de 100%. O fluxo: processamento em lote através de uma ferramenta de extração semântica por IA, revise campos marcados, corrija e confirme, depois exporte ao seu sistema de contabilidade ou faturação.
Esta abordagem híbrida — extração por IA + revisão humana direcionada — oferece tanto o ganho de velocidade da automação como a garantia de precisão que os dados críticos para o negocio exigem. Diferentes tipos de documentos producen resultados de precisão dramaticamente diferentes, por isso testar com seus documentos reais é essencial antes de comprometerse com qualquer fluxo de trabalho.
Preguntas Frecuentes
Qual é a precisão real do OCR de escrita manual em 2026?
A resposta honesta depende do tipo de escrita manual e da qualidade da entrada. Em letra de forma limpa em formulários estruturados a 300 DPI, os melhores sistemas alcanzan 85-93% de precisão de caracteres. Em escrita cursiva ou mista a partir de fotos de celular, a precisão de caracteres efetiva cae a 65-80%. A precisão a nível de campo — a métrica que importa — é tipicamente 10-25 pontos menor que a precisão de caracteres. Um vendedor que afirma "95% de precisão de escrita manual" sem especificar CER vs. precisão a nível de campo e sem descrever o conjunto de teste quase certamente está reportando o número de melhor caso a nível de caracteres de um conjunto curado. Para a desglose de precisão por tipo de escrita manual — impressa, cursiva limpa e script desordenado — veja nossa referência sobre si a IA pode ler escrita manual a partir de fotos.
A caligrafia cursiva é mais difícil para OCR do que a letra de forma?
Sim, significativamente. Comparações independentes mostram que a precisão do OCR para caligrafia cursiva fica 10-15 pontos percentuais atrás do reconhecimento de escrita à mão em letra de forma nas mesmas ferramentas. O ABBYY FineReader pontua 95,2% em letra de forma manuscrita, mas 91,7% em cursiva — e o Adobe Acrobat cai de 88,6% em letra de forma para 79,3% em cursiva. A razão é estrutural: a cursiva conecta caracteres, eliminando os limites claros de segmentação dos quais o OCR tradicional depende. Modelos de visão baseados em IA lidam melhor com isso do que o OCR tradicional, usando contexto no nível da palavra para resolver limites ambíguos de caracteres, mas a cursiva continua sendo o problema mais difícil.
O OCR de IA para caligrafia pode substituir a entrada manual de dados?
Para documentos estruturados com caligrafia legível e entradas de qualidade, o OCR de IA para caligrafia pode reduzir a entrada manual de dados em 70-80% — mas não deve substituir completamente a revisão humana. O alvo realista é um fluxo de trabalho híbrido: a IA extrai todos os campos, sinaliza resultados de baixa confiança para revisão, e um humano verifica apenas os valores sinalizados. O custo de um erro de extração não corrigido na cobrança é tipicamente 10-20 vezes o custo de detectá-lo durante a revisão.
Por que o OCR de caligrafia falha especificamente em números?
Dígitos têm menos características visuais distintivas do que letras — a diferença entre "4" e "9" é um único laço fechado, entre "7" e "1" é uma barra transversal que pode nem existir. Quando um documento é majoritariamente numérico — leituras de medidores, quantidades, preços — o erro por dígito se acumula porque cada caractere é de alta ambiguidade. Uma CER de 90% em texto manuscrito geral pode se traduzir em 80% de precisão por dígito em campos numéricos, tornando quase certo que a extração a nível de campo falhe em pelo menos um valor crítico.
Devo confiar na alegação de "90% de precisão em caligrafia" de um fornecedor?
Não sem fazer três perguntas: (1) Isso é a nível de caractere ou de campo? (2) Quais tipos de documento foram testados — letra de forma, cursiva ou fotos de celular? (3) Quantos estilos únicos de caligrafia (10 escritores ou 500)? A maioria dos fornecedores relata CER em um conjunto de teste selecionado de letra de forma legível de um pequeno número de escritores. Em documentos do mundo real de dezenas de escritores com qualidade de entrada variada, a precisão efetiva é geralmente 10-20 pontos menor. Qualquer fornecedor que não possa ou não queira responder essas três perguntas com números específicos provavelmente não fez testes reais com caligrafia.