¿Qué tan precisa es la OCR para escritura a mano?
Por qué el 90 % de precisión aún significa totales incorrectos
Cuando un proveedor de OCR afirma "90 % de precisión en escritura a mano", se refiere al reconocimiento a nivel de carácter: si las letras y dígitos individuales se leyeron correctamente, en promedio, en toda la página. Pero ese promedio oculta un problema devastador: una tasa de error de caracteres del 10 % no produce un 10 % de datos malos. Produce fallos catastróficos en campos específicos, porque los errores de escritura a mano se agrupan en los lugares que más importan —totales, fechas, identificadores— y un solo dígito erróneo en el total de una factura o en la lectura de un contador hace que toda la extracción sea incorrecta. La brecha entre "90 % de precisión de caracteres" y "datos utilizables a nivel de campo" es el malentendido más costoso en la automatización de documentos actual.
Puntos clave
- "90 % de precisión de OCR en escritura a mano" significa que 1 de cada 10 caracteres está mal, y los errores se agrupan en sus totales y lecturas de contador, no en el membrete.
- Un total manuscrito de 8 dígitos con 90 % de precisión tiene un 57 % de probabilidad de contener al menos un error: usted no eliminó el trabajo manual, solo renombró la entrada de datos como "verificación" y sigue revisando cada valor.
- Deje de perseguir la precisión a nivel de carácter. La extracción semántica —donde la IA sabe que "Cant. Recibida" es un número y "Fecha de factura" es una fecha— elimina interpretaciones imposibles antes de que lleguen a su hoja de cálculo.
Qué mide realmente el «90 % de precisión» en la escritura manuscrita
La Tasa de Error de Caracteres (CER) es la métrica estándar para evaluar el reconocimiento de escritura manuscrita. Cuenta cada sustitución (un «5» leído como «6»), inserción y eliminación, y luego divide por el total de caracteres. El punto de referencia de la industria para texto impreso —limpio, de alta resolución y con fuentes estándar— es una CER inferior al 1 %, lo que significa una precisión de caracteres del 99 % o mejor.
La escritura manuscrita cambia las matemáticas por completo. Una comparación independiente de las principales herramientas de OCR encontró que, en escritura manuscrita de imprenta (letra de imprenta), ABBYY FineReader logró un 95,2 % de precisión y Adobe Acrobat un 88,6 %. En escritura cursiva, la brecha se amplió: ABBYY con un 91,7 %, Adobe con un 79,3 % y Readiris con un 84,9 %. Estos son resultados de primer nivel de OCR de escritorio dedicado, no de fotos de móvil ni de documentos mixtos.
Para documentos empresariales reales —facturas manuscritas, albaranes de entrega, hojas de lectura de contador— la precisión efectiva de caracteres suele situarse entre el 80 % y el 90 %. Y aquí está el problema: esos 10–20 errores por cada 100 caracteres no se distribuyen de manera uniforme. Se concentran en los caracteres donde equivocarse le cuesta dinero.
Para entender cómo se relacionan entre sí las distintas métricas de precisión de OCR, comience con nuestra guía sobre CER, WER y precisión a nivel de campo.
Por qué la escritura manuscrita es fundamentalmente diferente para el OCR
La razón por la que la precisión del OCR en escritura manuscrita queda tan por detrás de la del texto impreso no es simplemente que la escritura manuscrita sea «más desordenada». El problema es estructural: la escritura manuscrita no tiene formas de caracteres estables. Una «a» impresa en Arial, Times New Roman y Courier comparte la misma estructura esencial: un bucle cerrado con un trazo vertical. Una «a» manuscrita puede estar cerrada con un bucle, abierta como una «u», escrita con un solo trazo o simplificada a un punto. El mismo escritor produce formas diferentes según la velocidad y el ángulo del bolígrafo. Entre varios escritores, la variación se dispara. Para un recorrido paso a paso de por qué esta diferencia estructural importa a nivel de carácter —y cómo la IA lee a pesar de ello—, consulte nuestro análisis en profundidad sobre cómo funciona el reconocimiento de escritura manuscrita.
Esto crea tres modos de fallo distintos:
Fallo de segmentación
El OCR tradicional depende de límites claros entre caracteres. La escritura cursiva conecta las letras, lo que hace imposible que un motor a nivel de caracteres sepa dónde termina uno y comienza el siguiente. Una "n" seguida de una "i" escrita rápidamente se vuelve visualmente idéntica a una "m", y el OCR no tiene forma de decidir qué interpretación es la correcta sin comprender la palabra.
Ambigüedad de forma
El mismo dígito escrito de forma diferente por dos personas — o por la misma persona en días distintos — puede parecerse más a un dígito diferente que a su propia variante. Un "7" escrito rápidamente sin barra transversal coincide con un "1". Un "9" con un bucle corto podría ser un "4" o un "8". Un modelo de OCR entrenado con millones de ejemplos sigue enfrentando una ambigüedad fundamental cuando la señal visual en sí misma está subdeterminada.
Ceguera al contexto
El OCR tradicional lee cada carácter de forma aislada. No sabe que un campo etiquetado como "Total" debe contener un número, ni que un campo etiquetado como "Fecha" debe coincidir con un formato de fecha. Sin esta restricción contextual, el motor no tiene forma de descartar interpretaciones imposibles — como leer la "S" en un "Smith" manuscrito como un "5" porque el patrón de trazos coincide.
El tercer modo de fallo es el más trascendental. La ceguera al contexto es lo que separa al OCR tradicional de la extracción basada en IA. Un motor de OCR tradicional aplica la misma lógica de coincidencia de caracteres a cada píxel. Un modelo de visión-lenguaje moderno lee el documento semánticamente: identifica que un campo es numérico, que una fecha debe ajustarse a un formato, que un total debe ser coherente con las partidas. Estas restricciones reducen drásticamente las interpretaciones plausibles de caracteres.
La trampa del CER: por qué un 90 % de precisión de caracteres puede significar un 0 % de precisión a nivel de campo
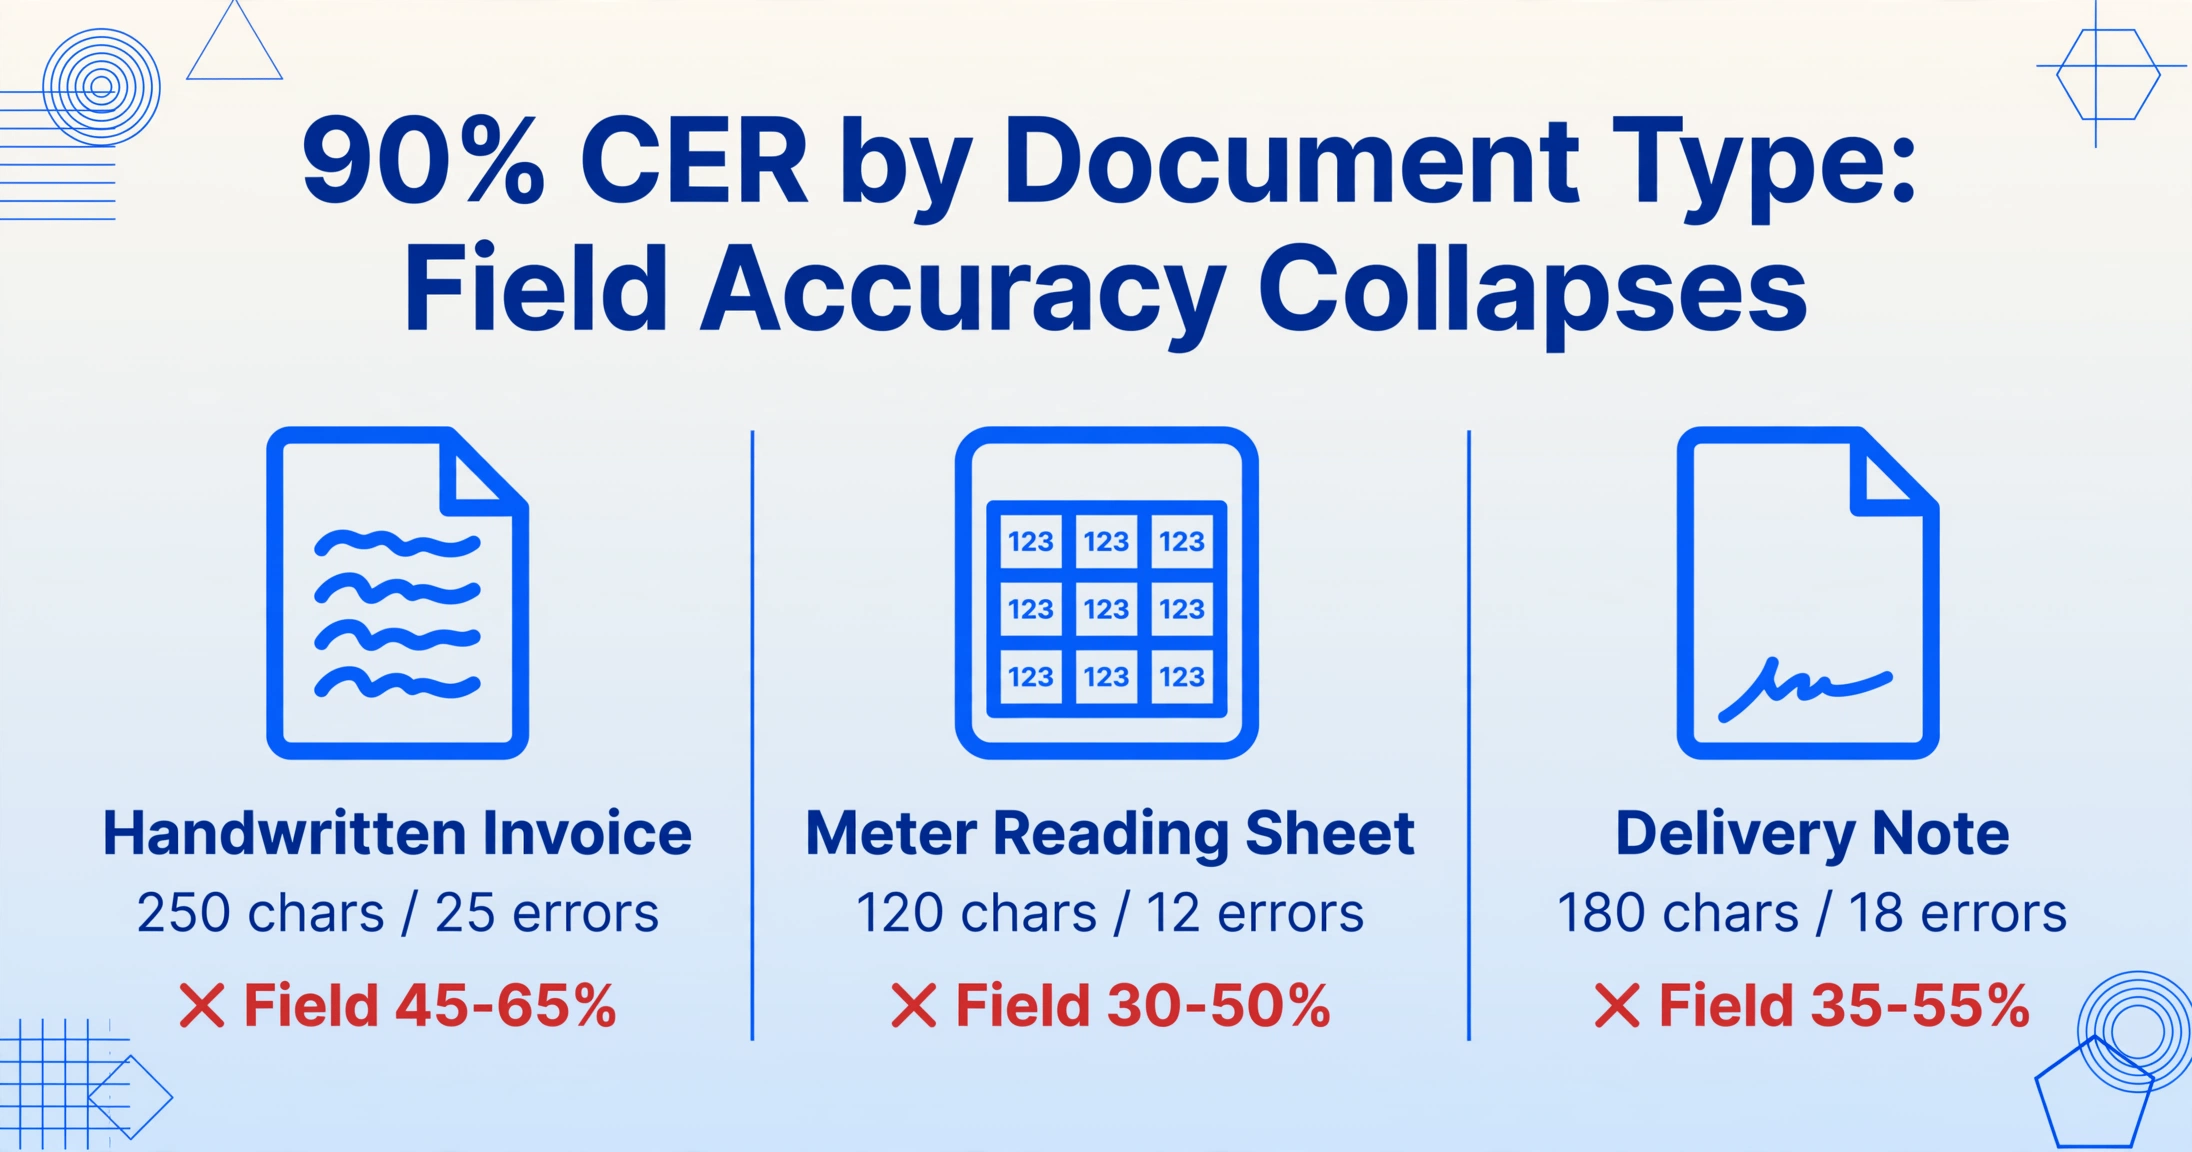
Piense en una factura manuscrita con 250 caracteres: datos del proveedor, líneas de detalle, cantidades, precios, subtotal, impuestos y total. Un motor de OCR de escritura a mano alcanza un 90 % de precisión: 25 caracteres erróneos de 250.
La pregunta que decide si la extracción es útil: ¿cuáles 25 caracteres?
| Tipo de documento | Caracteres totales | 90 % de precisión = errores | Resultado a nivel de campo | Impacto empresarial |
|---|---|---|---|---|
| Factura impresa | 200 | 2 errores (99 % de precisión) | 98-100 % | Puede procesarse sin revisión |
| Factura manuscrita | 250 | 25 errores | 45-65 % | La mayoría de los campos son erróneos: requiere reintroducción manual completa |
| Hoja de lectura de contador | 120 (solo numéricos) | 12 errores | 30-50 % | Lecturas erróneas → facturación incorrecta |
| Albarán de entrega (cant. + firmas) | 180 | 18 errores | 35-55 % | Cantidades erróneas → descuadre de inventario |
Un 90 % de precisión en una hoja de lectura de contador manuscrita significa que aproximadamente 1 de cada 10 dígitos es erróneo. Dado que las lecturas son exclusivamente numéricas y la diferencia entre «0013847» y «0013841» es una discrepancia de facturación que se acumula a lo largo de miles de contadores, la tasa de fallo a nivel de campo hace que la extracción sea inutilizable sin una verificación humana del 100 %. No está ahorrando tiempo: solo está trasladando el trabajo de introducción de datos a un paso de verificación que sigue exigiendo revisar cada valor.
Tres documentos reales, tres modos de fallo
La abstracción de las cifras de CER se vuelve concreta cuando se observan documentos manuscritos reales y se rastrea dónde aparecen los errores.
1. Factura manuscrita — colapso del campo Total
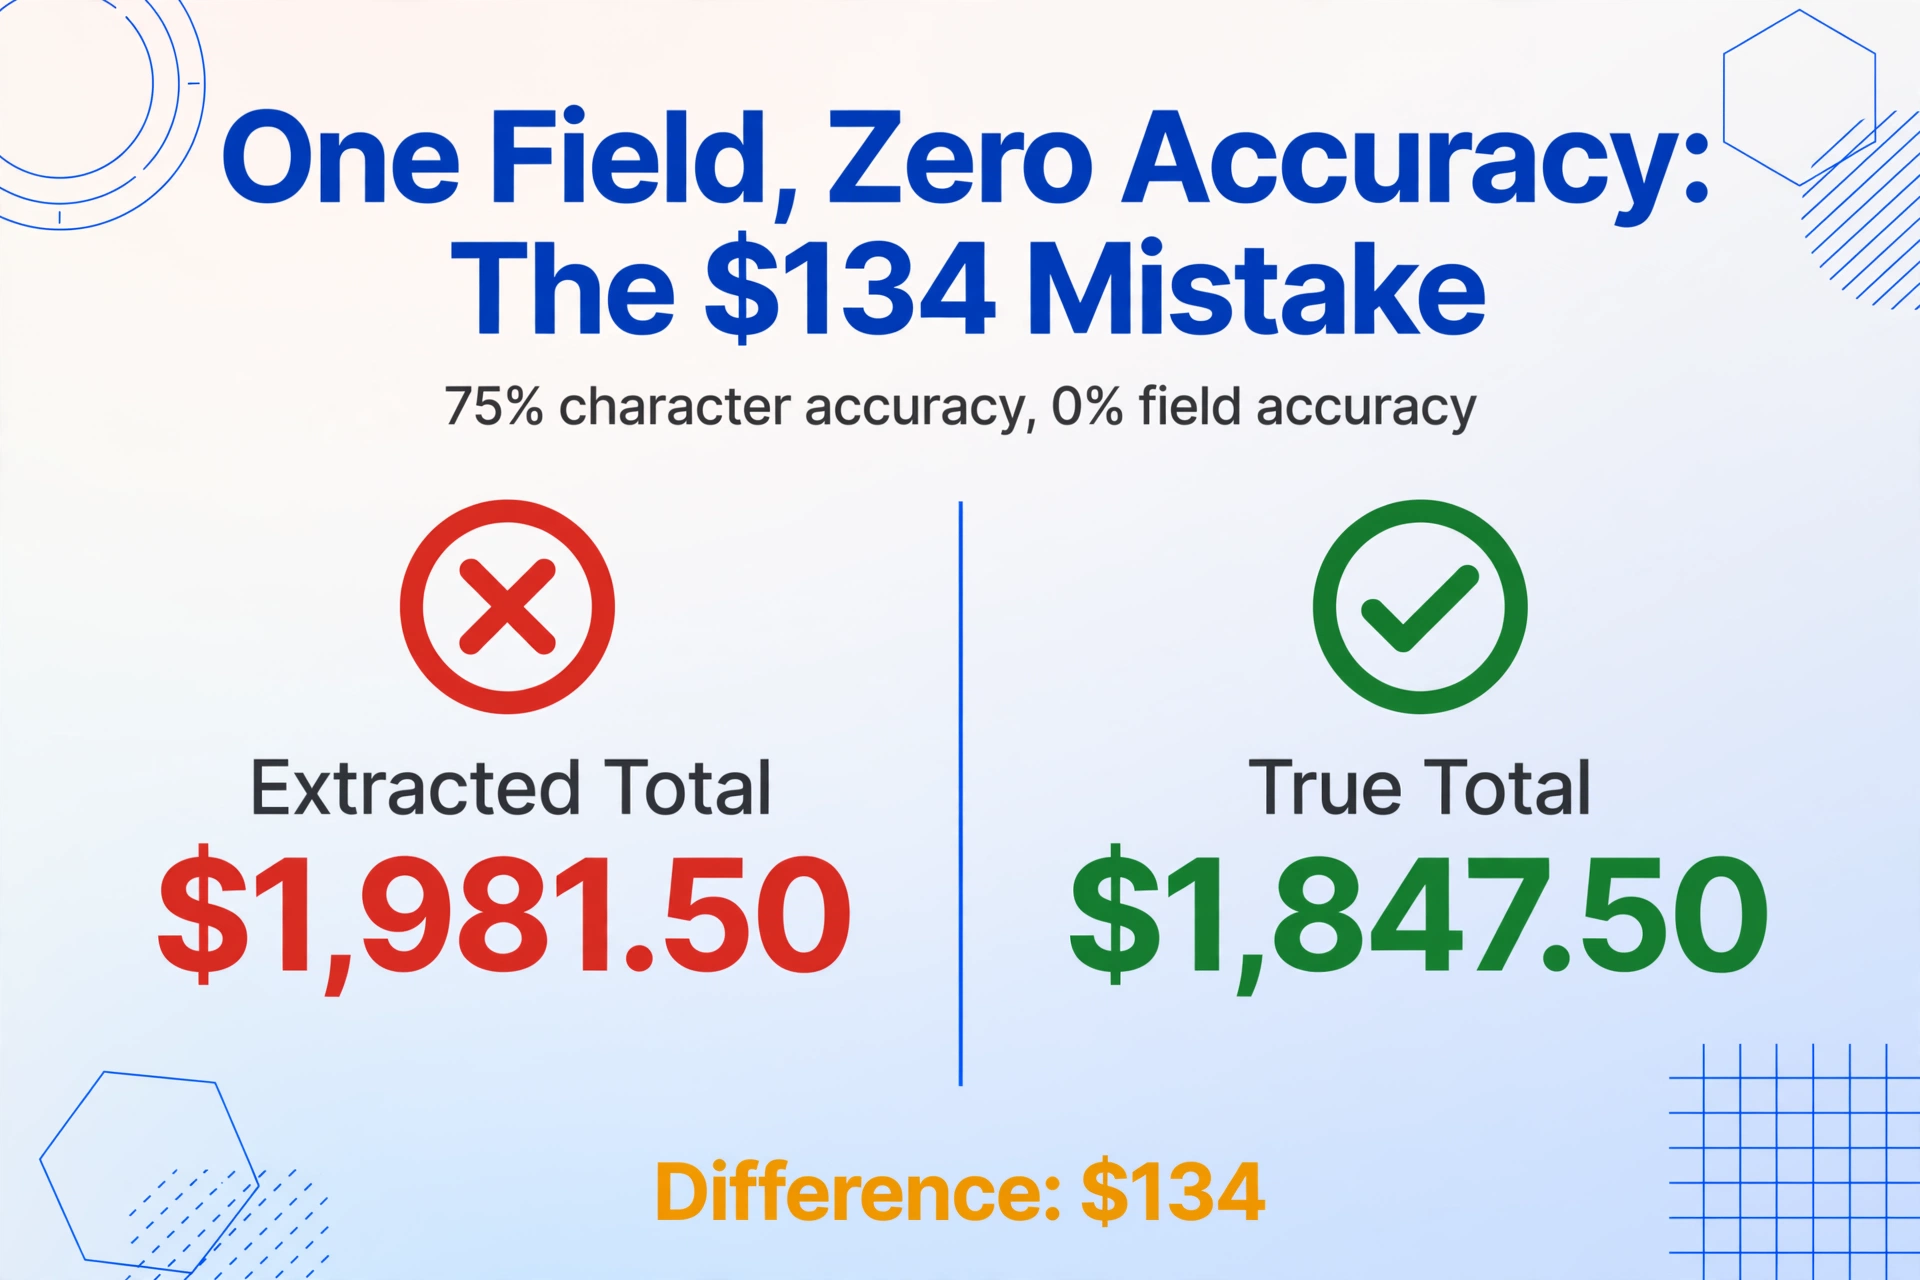
Un pequeño contratista presenta una factura por materiales. El encabezado está mecanografiado con claridad, pero los conceptos, las cantidades y el total final están escritos a mano. El campo del total indica "$1,847.50". El motor de OCR lee mal el "4" manuscrito como un "9" y el "7" como un "1". El total extraído pasa a ser "$1,981.50", una diferencia de $134. La precisión de caracteres en este único campo es del 75% (6 de 8 caracteres correctos). La precisión a nivel de campo es del 0%. La precisión a nivel de página sigue indicando un 88-92% porque la mayor parte del texto del encabezado se imprimió perfectamente, pero el único campo que la factura existe para comunicar está mal, y lo está por suficiente margen como para desencadenar una disputa de pago.
Esto no es un caso aislado. Los números manuscritos son la entrada más propensa a errores para el OCR porque los dígitos tienen menos rasgos distintivos que las letras: un "4" y un "9" se diferencian por un solo bucle cerrado, un "3" y un "8" por si el bucle superior está cerrado, un "1" y un "7" por una barra transversal que puede no estar presente en el estilo del escritor.
2. Albarán de entrega — confusión de cantidades
Un albarán de entrega tiene encabezados preimpresos: "Item", "Qty Ordered", "Qty Received". Las cantidades están rodeadas con un círculo o tachadas a mano. El OCR de escritura a mano falla aquí porque las cantidades escritas como marcas rápidas o números rodeados con un círculo son ambiguas: un "6" con un círculo alrededor puede confundirse con un "8". En un contexto de almacén, donde una sola cantidad mal leída de 120 unidades frente a 180 unidades determina si se vuelve a pedir inventario, una tasa de error de caracteres del 10% en la columna Cant. Recibida significa un desabastecimiento o una baja de inventario.
3. Hoja de Lectura de Contador — Errores en Cascada
Los lectores de contadores registran las lecturas en hojas de ruta en papel: cuadrículas de ID de contador, lecturas anteriores, lecturas actuales y consumo. Los caracteres son exclusivamente dígitos, escritos rápidamente en celdas pequeñas y en ángulo. Un error de un solo dígito se propaga en cascada: si la lectura actual de 03842 se lee como 03892, el consumo aumenta en 50 unidades. Acumulado en 5.000 contadores por ruta, los errores de facturación se compondrían en decenas de miles de dólares. La industria de servicios públicos pierde unos $90-100 mil millones anuales debido a pérdidas no técnicas, incluida la facturación incorrecta — y una parte significativa proviene de hojas manuscritas mal leídas.
Los campos de solo números son a la vez más fáciles y más difíciles para el OCR: el conjunto de caracteres es pequeño, pero la ambigüedad es extrema porque la variación dentro de una misma clase de dígito puede superar la variación entre clases. Un "7" sin barra transversal y un "1" inclinado con serifa pueden ser visualmente indistinguibles.
Lo Que Realmente Puede Hacer para Mejorar la Precisión del OCR de Escritura Manual
La imagen realista no es desesperanzadora — pero requiere comprender las limitaciones y elegir el enfoque adecuado. Esto es lo que marca la diferencia.
1. Elija la Extracción Semántica en Lugar del Reconocimiento de Caracteres
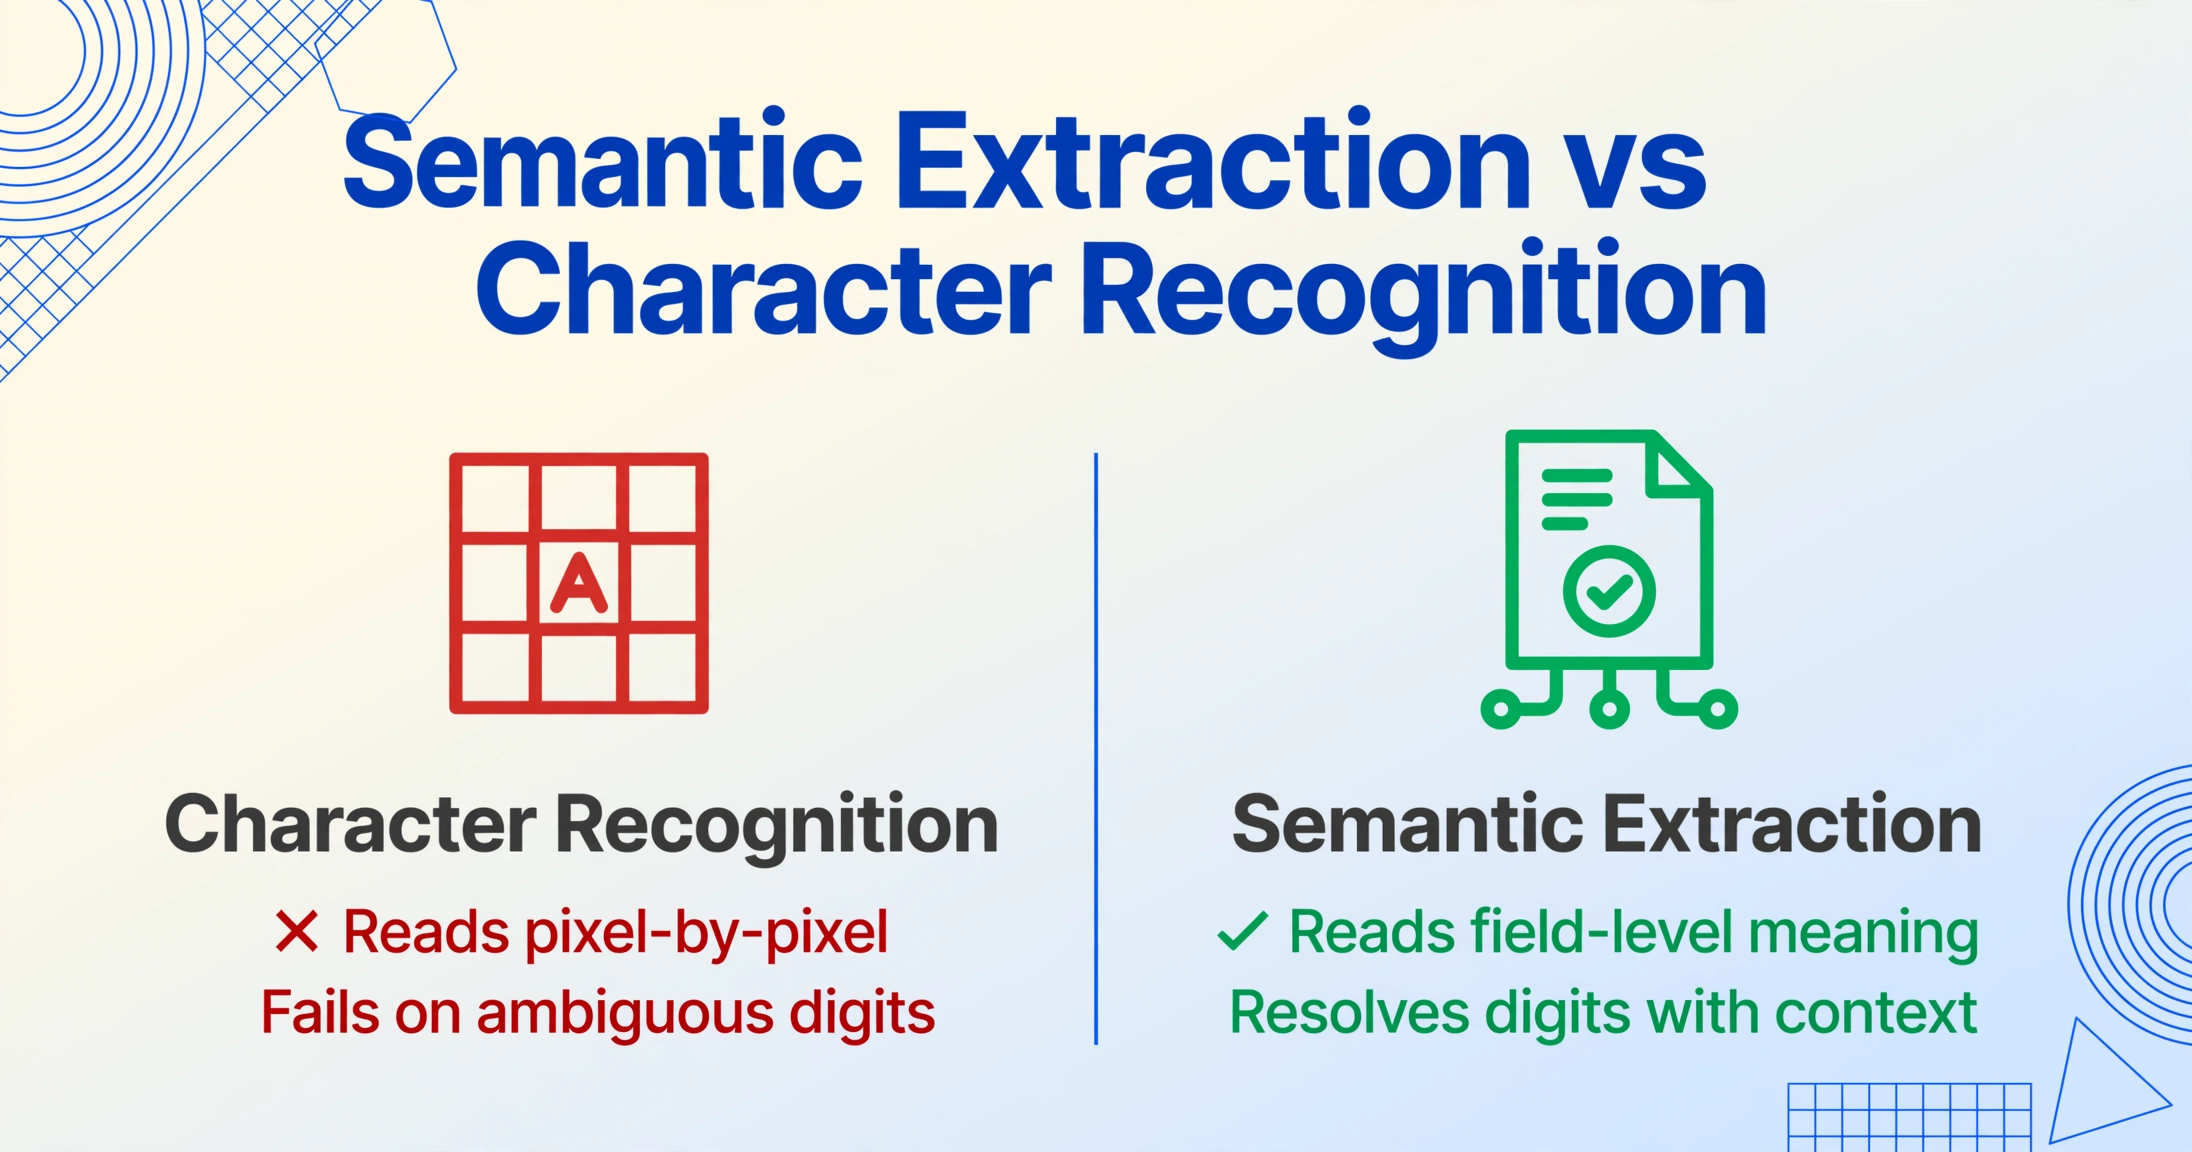
La diferencia más importante entre una herramienta que maneja la escritura manual de forma aceptable y una que no lo hace es si lee el documento semánticamente o píxel por píxel. El OCR tradicional trata la escritura manual como un problema de reconocimiento de caracteres. La extracción basada en IA la trata como un problema semántico a nivel de campo.
Cuando un modelo de IA sabe que "Cant. Recibida" debe ser un número, usa esa restricción para resolver dígitos ambiguos. Cuando sabe que una "Fecha" debe cumplir un formato, descarta fechas inválidas. Esta restricción semántica reduce drásticamente la Tasa de Error de Caracteres (CER) en campos críticos — no mejorando el reconocimiento de caracteres, sino indicando al motor qué respuestas son imposibles.
ImageToTable.ai utiliza este enfoque semántico. Usted define las columnas — "ID de Contador," "Lectura Actual," "Consumo" — y la IA localiza cada valor comprendiendo qué significa, no dónde se encuentra. Los mejores herramientas de OCR de escritura manual en 2026 aprovechan este paradigma de extracción semántica, superando a los motores tradicionales en documentos manuscritos.
Véalo en acción en una hoja de lectura de contador — un tipo de documento donde la precisión de la escritura manual importa más:
Los archivos se procesan de forma segura y no se almacenan.
2. Controlar la calidad de entrada
La precisión del OCR de escritura manual cae drásticamente por debajo de 200 DPI y en fotos tomadas en ángulo o con iluminación desigual. La mejora de precisión más económica es estandarizar la captura: escanear a un mínimo de 300 DPI, usar un alimentador de documentos para documentos encuadernados y evitar fotos móviles sin control. Esto puede mejorar la Tasa de Error de Caracteres (CER) en 5-15 puntos en comparación con la captura móvil casual, más que cualquier mejora algorítmica actual.
Si la captura móvil es inevitable (como suele serlo para lecturas de contador en campo), use una aplicación de captura que exija un ángulo recto, iluminación uniforme y una verificación de contraste antes de aceptar la imagen. La diferencia entre una foto cuidadosa y una rápida suele ser la diferencia entre una extracción útil y un resultado inútil.
3. Cree un flujo de verificación, no un proceso ciego
Ningún sistema de OCR de escritura manual — por avanzado que sea — debería enviar datos directamente a sistemas de facturación o inventario sin un paso de verificación. La pregunta no es si ocurrirán errores, sino si se detectarán antes de causar daños.
Cuando ocurren errores, siguen patrones reconocibles — y la mayoría son prevenibles. Nuestra guía de modos de fallo en extracción de escritura manual clasifica los ocho patrones de fallo más comunes y la solución para cada uno, para que pueda determinar si el problema está en su proceso de captura, en el diseño de sus campos o en la propia herramienta.
Un enfoque práctico: procese los documentos manuscritos mediante extracción, envíe los resultados con puntuaciones de confianza por debajo de un umbral (normalmente 85-90%) para revisión humana y centre la atención en totales, cantidades e identificadores en lugar de en cada carácter. Esta verificación selectiva detecta el 10-20% de los errores de alto impacto sin requerir una reentrada manual del 100%. El flujo de trabajo: procesamiento por lotes mediante una herramienta de extracción semántica con IA, revise los campos marcados, corrija y confirme y, a continuación, exporte a su sistema de contabilidad o facturación.
Este enfoque híbrido — extracción con IA + revisión humana selectiva — ofrece tanto la ganancia de velocidad de la automatización como la garantía de precisión que exigen los datos críticos para el negocio. Los distintos tipos de documento producen resultados de precisión muy diferentes, por lo que probar con sus documentos reales es esencial antes de comprometerse con cualquier flujo de trabajo.
Preguntas frecuentes
¿Cuál es la precisión real del OCR de escritura manual en 2026?
La respuesta honesta depende del tipo de escritura y de la calidad de la entrada. Con letra de imprenta clara en formularios estructurados a 300 DPI, los mejores sistemas alcanzan una precisión de caracteres del 85-93%. Con escritura cursiva o mixta procedente de fotos de móvil, la precisión efectiva de caracteres baja al 65-80%. La precisión a nivel de campo — la métrica que importa — suele ser de 10 a 25 puntos inferior a la precisión de caracteres. Un proveedor que afirme una "precisión del 95% en escritura manual" sin especificar la Tasa de Error de Caracteres (CER) frente a la precisión a nivel de campo y sin describir el conjunto de pruebas casi con seguridad está informando del mejor caso a nivel de caracteres de un conjunto seleccionado. Para conocer el desglose de precisión por tipo de escritura — imprenta, cursiva clara y caligrafía desordenada — consulte nuestra referencia sobre si la IA puede leer escritura manual de fotos.
¿Es la letra cursiva más difícil para el OCR que la letra de imprenta?
Sí, significativamente. Las comparaciones independientes muestran que la precisión del OCR en letra cursiva queda entre 10 y 15 puntos porcentuales por detrás del reconocimiento de letra de imprenta en las mismas herramientas. ABBYY FineReader obtiene un 95,2 % en letra de imprenta manuscrita, pero un 91,7 % en cursiva, y Adobe Acrobat baja del 88,6 % en imprenta al 79,3 % en cursiva. La razón es estructural: la cursiva conecta los caracteres, eliminando los límites de segmentación claros de los que depende el OCR tradicional. Los modelos de visión con IA lo manejan mejor que el OCR tradicional al usar el contexto a nivel de palabra para resolver límites de caracteres ambiguos, pero la cursiva sigue siendo el problema más difícil.
¿Puede el OCR de escritura a mano con IA reemplazar la introducción manual de datos?
Para documentos estructurados con escritura a mano clara y entradas de calidad, el OCR de escritura a mano con IA puede reducir la introducción manual de datos entre un 70 y un 80 %, pero no debería reemplazar por completo la revisión humana. El objetivo realista es un flujo de trabajo híbrido: la IA extrae todos los campos, marca los resultados de baja confianza para su revisión y una persona verifica únicamente los valores marcados. El coste de un error de extracción no corregido en facturación suele ser de 10 a 20 veces el coste de detectarlo durante la revisión.
¿Por qué falla el OCR de escritura a mano específicamente en los números?
Los dígitos tienen menos rasgos visuales distintivos que las letras: la diferencia entre «4» y «9» es un único bucle cerrado, y entre «7» y «1» es una barra transversal que puede no existir. Cuando un documento es mayoritariamente numérico —lecturas de contador, cantidades, precios—, la tasa de error por dígito se multiplica porque cada carácter es un carácter de alta ambigüedad. Una precisión del 90 % en escritura a mano de solo texto podría traducirse en un 80 % de precisión por dígito en campos numéricos, lo que hace casi seguro que la extracción a nivel de campo falle en al menos un valor crítico.
¿Debería confiar en la afirmación de un proveedor de un «90 % de precisión en escritura a mano»?
No sin hacer tres preguntas: (1) ¿Es a nivel de carácter o a nivel de campo? (2) ¿Qué tipos de documentos se probaron: letra de imprenta, cursiva o fotos de móvil? (3) ¿Cuántos estilos de escritura distintos (10 escritores o 500)? La mayoría de los proveedores informan de la Tasa de Error de Caracteres (CER) sobre un conjunto de pruebas seleccionado de letra de imprenta clara de un número reducido de escritores. En documentos del mundo real de docenas de escritores con calidad de entrada variada, la precisión efectiva suele ser entre 10 y 20 puntos inferior. Cualquier proveedor que no pueda o no quiera responder a estas tres preguntas con cifras concretas probablemente no haya realizado pruebas reales con escritura a mano.