Wie genau ist OCR für Handschrift?
Warum 90 % Genauigkeit trotzdem falsche Summen bedeutet
Wenn ein OCR-Anbieter „90 % Genauigkeit bei Handschrift“ verspricht, meint er die Zeichenerkennung — ob einzelne Buchstaben und Ziffern im Durchschnitt über die Seite hinweg korrekt gelesen wurden. Doch dieser Durchschnitt verbirgt ein verheerendes Problem: Eine Zeichenfehlerrate von 10 % erzeugt keine 10 % schlechten Daten. Sie erzeugt katastrophale Fehler bei bestimmten Feldern, denn Handschriftfehler häufen sich genau dort, wo es am wichtigsten ist — bei Summen, Datumsangaben und Identifikatoren — und eine einzige falsche Ziffer in einer Rechnungssumme oder einem Zählerstand macht die gesamte Extraktion falsch. Die Kluft zwischen „90 % Zeichengenauigkeit“ und „verwertbaren Daten auf Feldebene“ ist das teuerste Missverständnis in der Dokumentenautomatisierung von heute.
Die wichtigsten Erkenntnisse
- „90 % Genauigkeit bei Handschrift-OCR“ bedeutet, dass 1 von 10 Zeichen falsch ist — und die Fehler häufen sich in Ihren Summen und Zählerständen, nicht im Briefkopf.
- Eine handschriftliche 8-stellige Summe hat bei 90 % Genauigkeit eine 57-prozentige Wahrscheinlichkeit, mindestens einen Fehler zu enthalten — Sie haben die manuelle Arbeit nicht beseitigt, sondern Dateneingabe in „Verifizierung“ umbenannt und prüfen trotzdem jeden Wert.
- Hören Sie auf, Zeichengenauigkeit anzustreben. Semantische Extraktion — bei der die KI weiß, dass „Erhaltene Menge“ eine Zahl und „Rechnungsdatum“ ein Datum ist — schließt unmögliche Interpretationen aus, bevor sie Ihre Tabelle erreichen.
Was „90 % Genauigkeit“ bei Handschrift tatsächlich bedeutet
Die Zeichenfehlerrate (CER) ist die Standardmetrik zur Bewertung der Handschrifterkennung. Sie zählt jede Substitution (eine „5“, die als „6“ gelesen wird), Einfügung und Löschung und dividiert dann durch die Gesamtzahl der Zeichen. Der Branchenstandard für gedruckten Text – sauber, hochauflösend, Standard-Schriftarten – ist eine CER unter 1 %, also 99 % oder besser Zeichengenauigkeit.
Handschrift verändert die Rechnung komplett. Ein unabhängiger Vergleich gängiger OCR-Tools ergab, dass ABBYY FineReader bei handgeschriebener Druckschrift (Blockbuchstaben) 95,2 % Genauigkeit erreichte und Adobe Acrobat 88,6 %. Bei Schreibschrift vergrößerte sich die Lücke: ABBYY bei 91,7 %, Adobe bei 79,3 % und Readiris bei 84,9 %. Das sind Bestwerte von speziellen Desktop-OCR-Lösungen – nicht von Handyfotos oder gemischten Dokumenten.
Bei realen Geschäftsdokumenten – handgeschriebenen Rechnungen, Lieferscheinen, Zählerableseblättern – liegt die effektive Zeichengenauigkeit oft zwischen 80 % und 90 %. Und hier liegt das Problem: Diese 10–20 Fehler pro 100 Zeichen sind nicht gleichmäßig verteilt. Sie häufen sich an den Zeichen, bei denen ein Fehler Sie Geld kostet.
Um zu verstehen, wie verschiedene OCR-Genauigkeitsmetriken zusammenhängen, beginnen Sie mit unserem Leitfaden zu CER, WER und Feldgenauigkeit.
Warum Handschrift für OCR grundlegend anders ist
Der Grund, warum die OCR-Genauigkeit bei Handschrift so weit hinter der bei gedrucktem Text zurückliegt, ist nicht einfach, dass Handschrift „unordentlicher“ ist. Das Problem ist strukturell: Handschrift hat keine stabilen Zeichenformen. Ein gedrucktes „a“ in Arial, Times New Roman und Courier teilt dieselbe grundlegende Struktur – eine geschlossene Schleife mit einem Stamm. Ein handgeschriebenes „a“ kann geschlossen mit Schleife, offen wie ein „u“, als einzelner Strich oder vereinfacht zu einem Punkt sein. Derselbe Schreiber produziert je nach Geschwindigkeit und Stiftwinkel unterschiedliche Formen. Über mehrere Schreiber hinweg explodiert die Varianz. Für eine Schritt-für-Schritt-Erklärung, warum dieser strukturelle Unterschied auf Zeichenebene wichtig ist – und wie KI darum herumliest –, sehen Sie sich unseren Deep Dive an: wie Handschrifterkennung funktioniert.
Das erzeugt drei verschiedene Fehlermodi:
Segmentierungsfehler
Herkömmliche OCR basiert auf klaren Grenzen zwischen Zeichen. Schreibschrift verbindet Buchstaben, sodass eine zeichenbasierte Engine nicht erkennen kann, wo ein Buchstabe endet und der nächste beginnt. Ein schnell geschriebenes „n“ gefolgt von „i“ ist visuell identisch mit einem „m“ – und die OCR kann ohne Wortverständnis nicht entscheiden, welche Interpretation richtig ist.
Form-Mehrdeutigkeit
Dieselbe Ziffer, von zwei Personen unterschiedlich geschrieben – oder von derselben Person an verschiedenen Tagen – kann mehr wie eine andere Ziffer aussehen als wie ihre eigene Variante. Eine hastig geschriebene „7“ ohne Querstrich ähnelt einer „1“. Eine „9“ mit kurzer Schleife könnte eine „4“ oder „8“ sein. Ein OCR-Modell, das mit Millionen von Beispielen trainiert wurde, steht dennoch vor grundlegender Mehrdeutigkeit, wenn das visuelle Signal selbst unterbestimmt ist.
Kontextblindheit
Herkömmliche OCR liest jedes Zeichen isoliert. Sie weiß nicht, dass ein Feld mit der Beschriftung „Gesamtbetrag“ eine Zahl enthalten sollte oder dass ein Feld mit „Datum“ einem Datumsformat entsprechen sollte. Ohne diese kontextuelle Einschränkung kann die Engine unmögliche Interpretationen nicht ausschließen – etwa das „S“ in einem handschriftlichen „Smith“ als „5“ zu lesen, weil das Strichmuster zufällig übereinstimmt.
Die dritte Fehlerart ist die folgenreichste. Kontextblindheit unterscheidet herkömmliche OCR von KI-basierter Extraktion. Eine herkömmliche OCR-Engine wendet dieselbe Zeichenabgleich-Logik auf jedes Pixel an. Ein modernes Vision-Language-Model liest das Dokument semantisch: Es erkennt, dass ein Feld numerisch ist, dass ein Datum einem Format entsprechen muss, dass ein Gesamtbetrag mit den Positionen übereinstimmen muss. Diese Einschränkungen reduzieren die möglichen Zeicheninterpretationen erheblich.
Die CER-Falle: Warum 90 % Zeichengenauigkeit 0 % Feldgenauigkeit bedeuten können
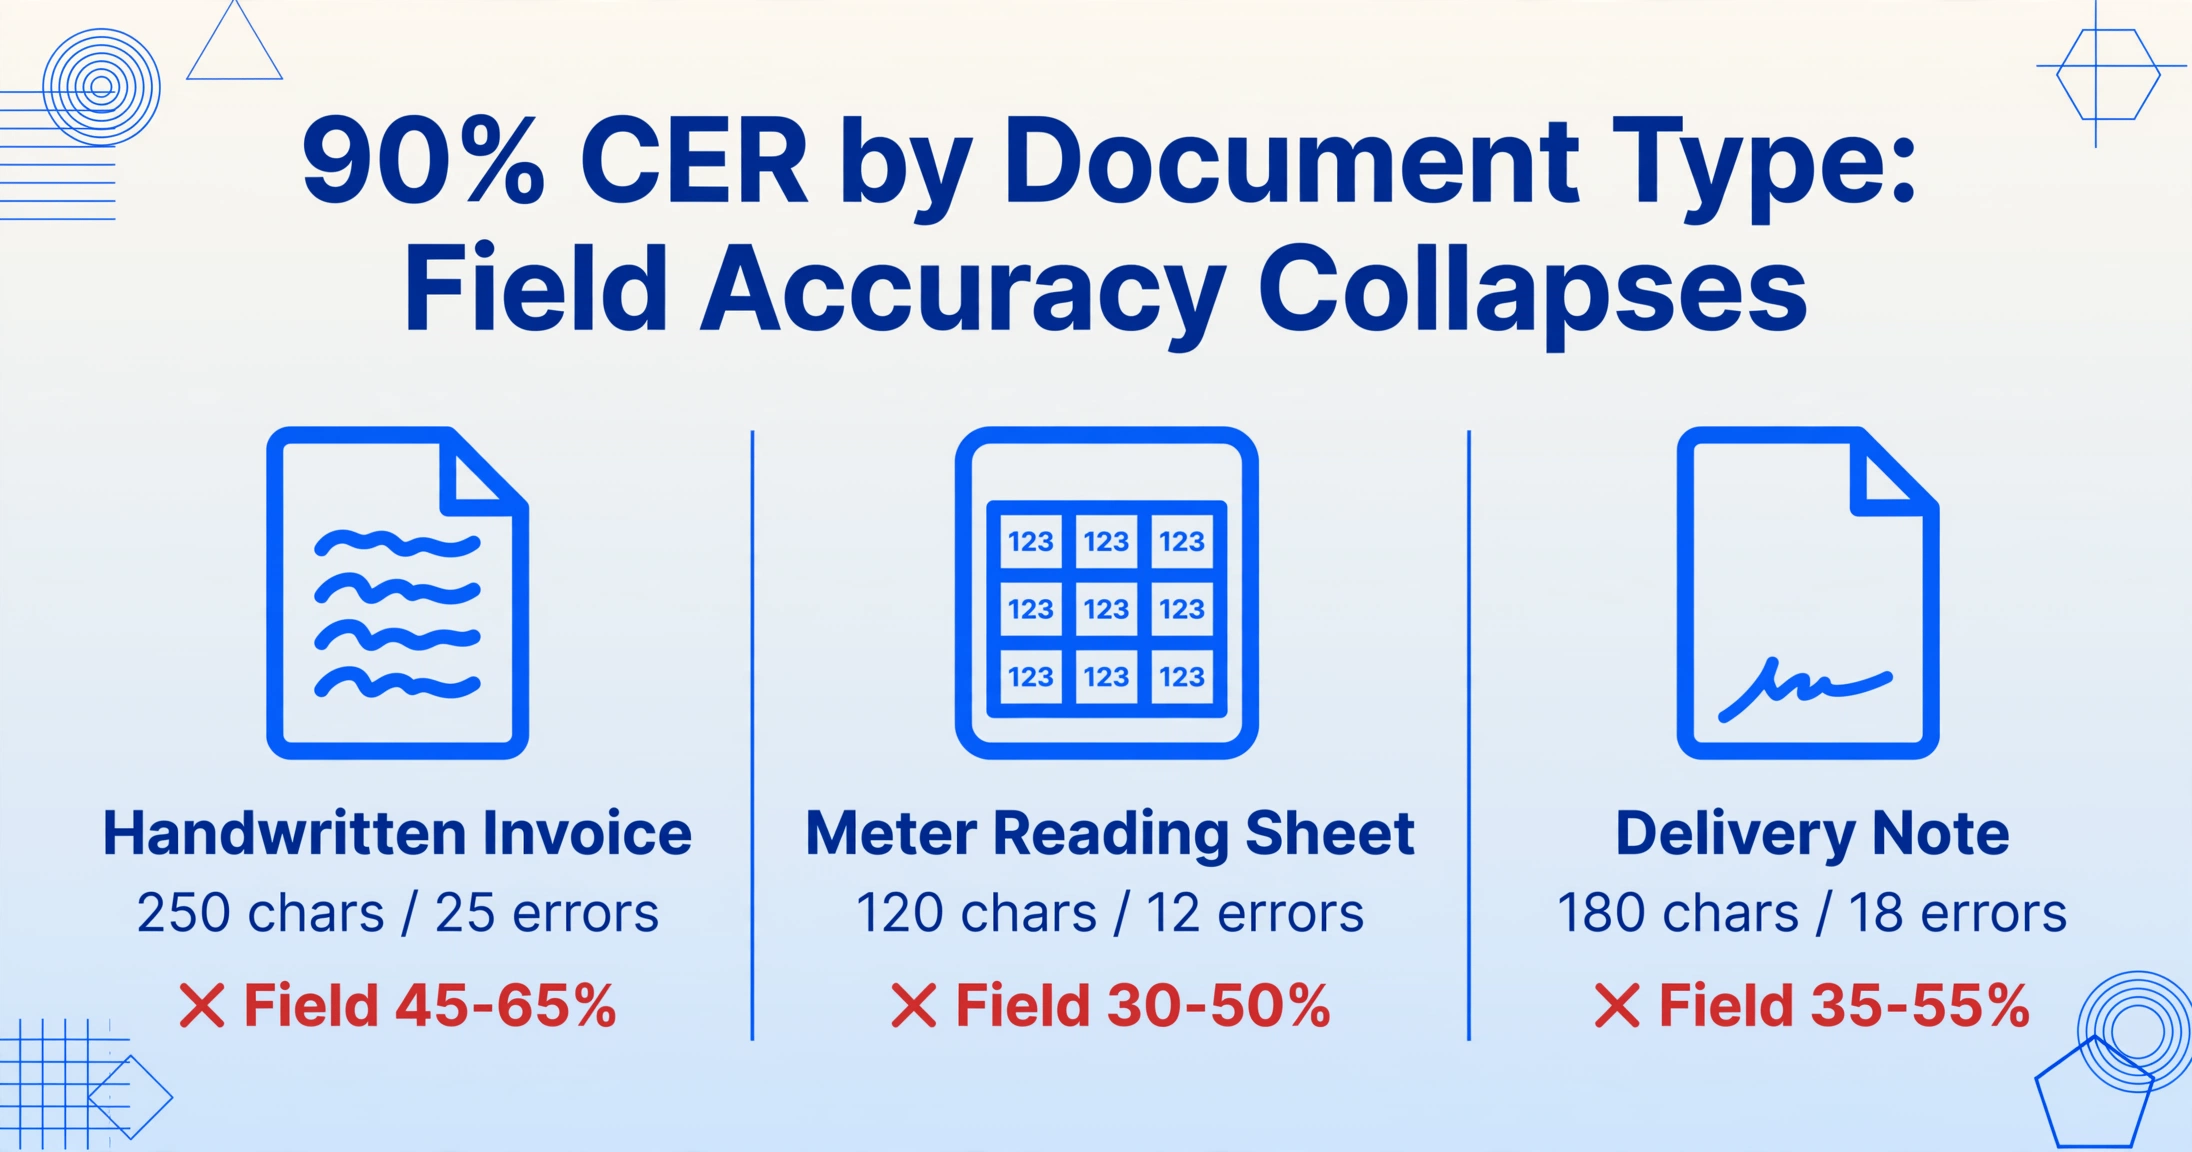
Nehmen Sie eine handschriftliche Rechnung mit 250 Zeichen — Lieferantendaten, Positionen, Mengen, Preise, Zwischensumme, Steuer und Gesamtbetrag. Eine Handschrift-OCR-Engine erreicht 90 % Genauigkeit: 25 von 250 Zeichen sind falsch.
Die Frage, die entscheidet, ob die Extraktion nützlich ist: Welche 25 Zeichen?
| Dokumenttyp | Zeichen gesamt | 90 % Genauigkeit = Fehler | Ergebnis auf Feldebene | Geschäftliche Auswirkung |
|---|---|---|---|---|
| Gedruckte Rechnung | 200 | 2 Fehler (99 % Genauigkeit) | 98-100 % | Verarbeitung ohne Prüfung möglich |
| Handschriftliche Rechnung | 250 | 25 Fehler | 45-65 % | Die meisten Felder falsch — vollständige manuelle Neueingabe erforderlich |
| Zählerableseblatt | 120 (nur numerisch) | 12 Fehler | 30-50 % | Falsche Ablesungen → fehlerhafte Abrechnung |
| Lieferschein (Menge + Unterschriften) | 180 | 18 Fehler | 35-55 % | Falsche Mengen → Bestandsabweichungen |
Eine Genauigkeit von 90 % bei einem handschriftlichen Zählerableseblatt bedeutet, dass etwa jede 10. Ziffer falsch ist. Da Ablesungen ausschließlich numerisch sind und der Unterschied zwischen „0013847" und „0013841" eine Abrechnungsdifferenz ist, die sich über Tausende von Zählern summiert, macht die Fehlerquote auf Feldebene die Extraktion ohne 100%ige menschliche Prüfung unbrauchbar. Sie sparen keine Zeit — Sie verlagern die Dateneingabe lediglich auf einen Prüfschritt, bei dem weiterhin jeder Wert angesehen werden muss.
Drei echte Dokumente, drei Fehlermuster
Die Abstraktion der CER-Zahlen wird konkret, wenn Sie sich tatsächliche handschriftliche Dokumente ansehen und nachvollziehen, wo die Fehler auftreten.
1. Handschriftliche Rechnung — Zusammenbruch des Gesamtbetrag-Felds
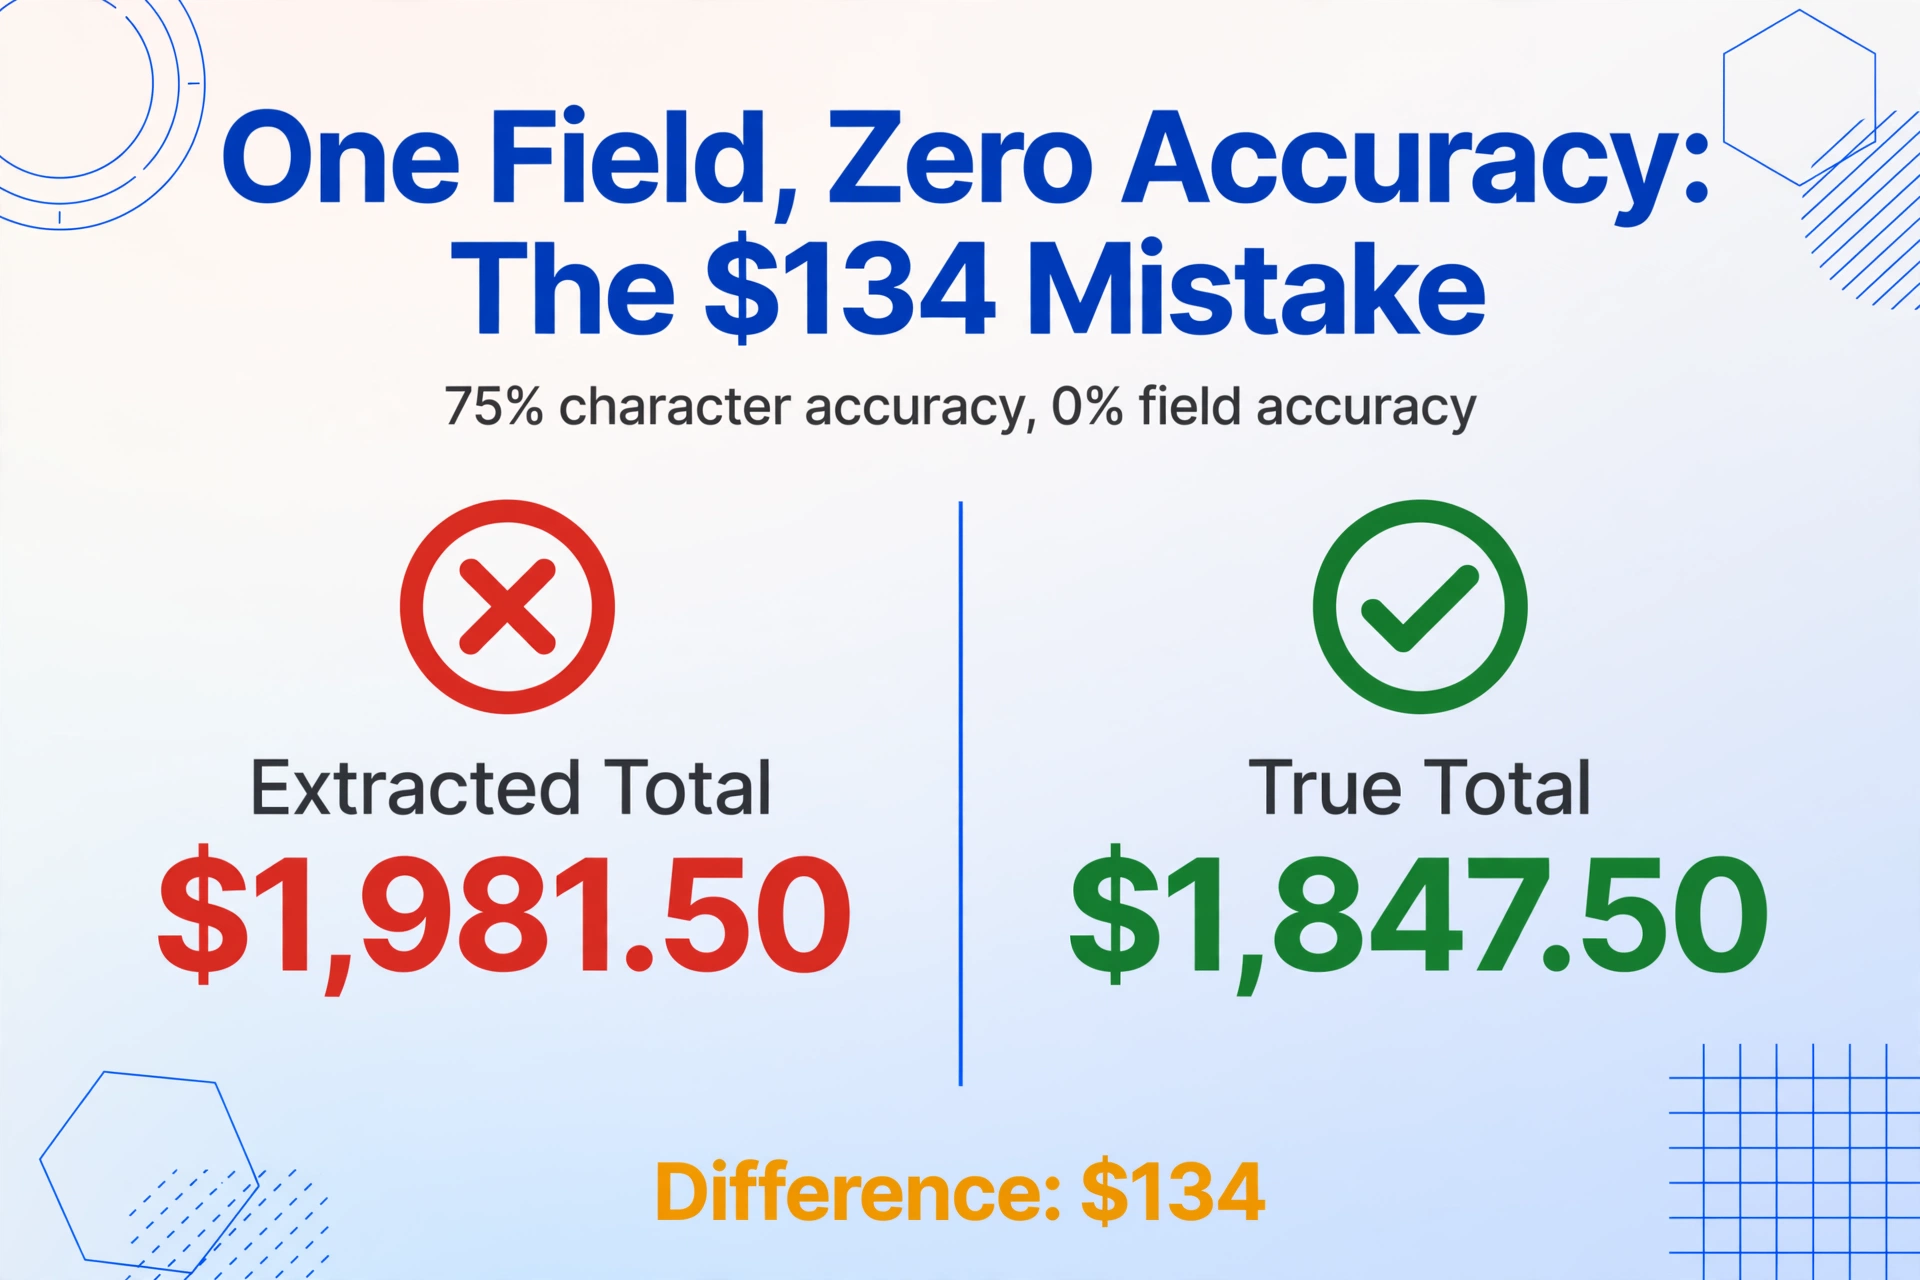
Ein kleiner Auftragnehmer reicht eine Rechnung für Materialien ein. Der Kopfbereich ist sauber getippt, aber die Positionen, Mengen und der Endbetrag sind handschriftlich. Das Feld Gesamtbetrag zeigt „$1,847.50". Die OCR-Engine liest die handschriftliche „4" fälschlich als „9" und die „7" als „1". Der extrahierte Gesamtbetrag wird „$1,981.50" — eine Differenz von $134. Die Zeichengenauigkeit in diesem einzelnen Feld beträgt 75 % (6 von 8 Zeichen korrekt). Die Feldgenauigkeit beträgt 0 %. Die seitenweite Genauigkeit meldet weiterhin 88–92 %, weil der meiste Kopftext perfekt gedruckt war — aber das eine Feld, für dessen Übermittlung die Rechnung existiert, ist falsch, und zwar falsch genug, um einen Zahlungsstreit auszulösen.
Dies ist kein Sonderfall. Handschriftliche Zahlen sind die fehleranfälligste Eingabe für OCR, weil Ziffern weniger unterscheidende Merkmale haben als Buchstaben — eine „4" und eine „9" unterscheiden sich durch eine einzige geschlossene Schleife, eine „3" und eine „8" dadurch, ob die obere Schleife geschlossen ist, eine „1" und eine „7" durch einen Querstrich, der im Schreibstil des Verfassers fehlen kann.
2. Lieferschein — Mengenverwechslung
Ein Lieferschein hat vorgedruckte Kopfzeilen: „Item", „Qty Ordered", „Qty Received". Die Mengen sind von Hand eingekreist oder durchgestrichen. Handschrift-OCR scheitert hier, weil als schnelle Häkchen oder eingekreiste Zahlen geschriebene Mengen mehrdeutig sind — eine „6" mit einem Kreis darum kann mit einer „8" verwechselt werden. In einem Lagerkontext, in dem eine einzige falsch gelesene Menge von 120 Einheiten gegenüber 180 Einheiten darüber entscheidet, ob der Bestand nachbestellt wird, bedeutet eine Zeichenfehlerrate von 10 % in der Spalte Erhaltene Menge entweder einen Lagerengpass oder eine Abschreibung.
3. Zählerableseblatt – Kettenfehler
Zählerableser erfassen die Werte handschriftlich auf Papier-Routenbögen – Raster aus Zähler-IDs, vorherigen Ablesungen, aktuellen Ablesungen und Verbrauch. Die Zeichen sind ausschließlich Ziffern, schnell in kleine Zellen geschrieben und oft schräg. Ein einzelner Ziffernfehler hat Kettenwirkung: Wird die aktuelle Ablesung von 03842 als 03892 gelesen, steigt der Verbrauch um 50 Einheiten. Über 5.000 Zähler pro Route summiert, führen Abrechnungsfehler zu zehntausenden Dollar. Die Versorgungsbranche verliert schätzungsweise 90–100 Milliarden Dollar jährlich durch nicht-technische Verluste, einschließlich fehlerhafter Abrechnungen – und ein erheblicher Teil davon stammt aus falsch gelesenen handschriftlichen Bögen.
Reine Zahlenfelder sind für OCR gleichzeitig einfacher und schwieriger: Der Zeichensatz ist winzig, aber die Mehrdeutigkeit extrem, weil die Variation innerhalb einer einzelnen Ziffernklasse größer sein kann als die Variation zwischen Klassen. Eine „7“ ohne Querbalken und eine schräge „1“ mit Serife können visuell ununterscheidbar sein.
Was Sie tatsächlich gegen Handschrift-OCR-Ungenauigkeit tun können
Das realistische Bild ist nicht hoffnungslos – aber es erfordert, die Grenzen zu verstehen und den richtigen Ansatz zu wählen. Hier ist, was den Unterschied macht.
1. Semantische Extraktion statt Zeichenerkennung wählen
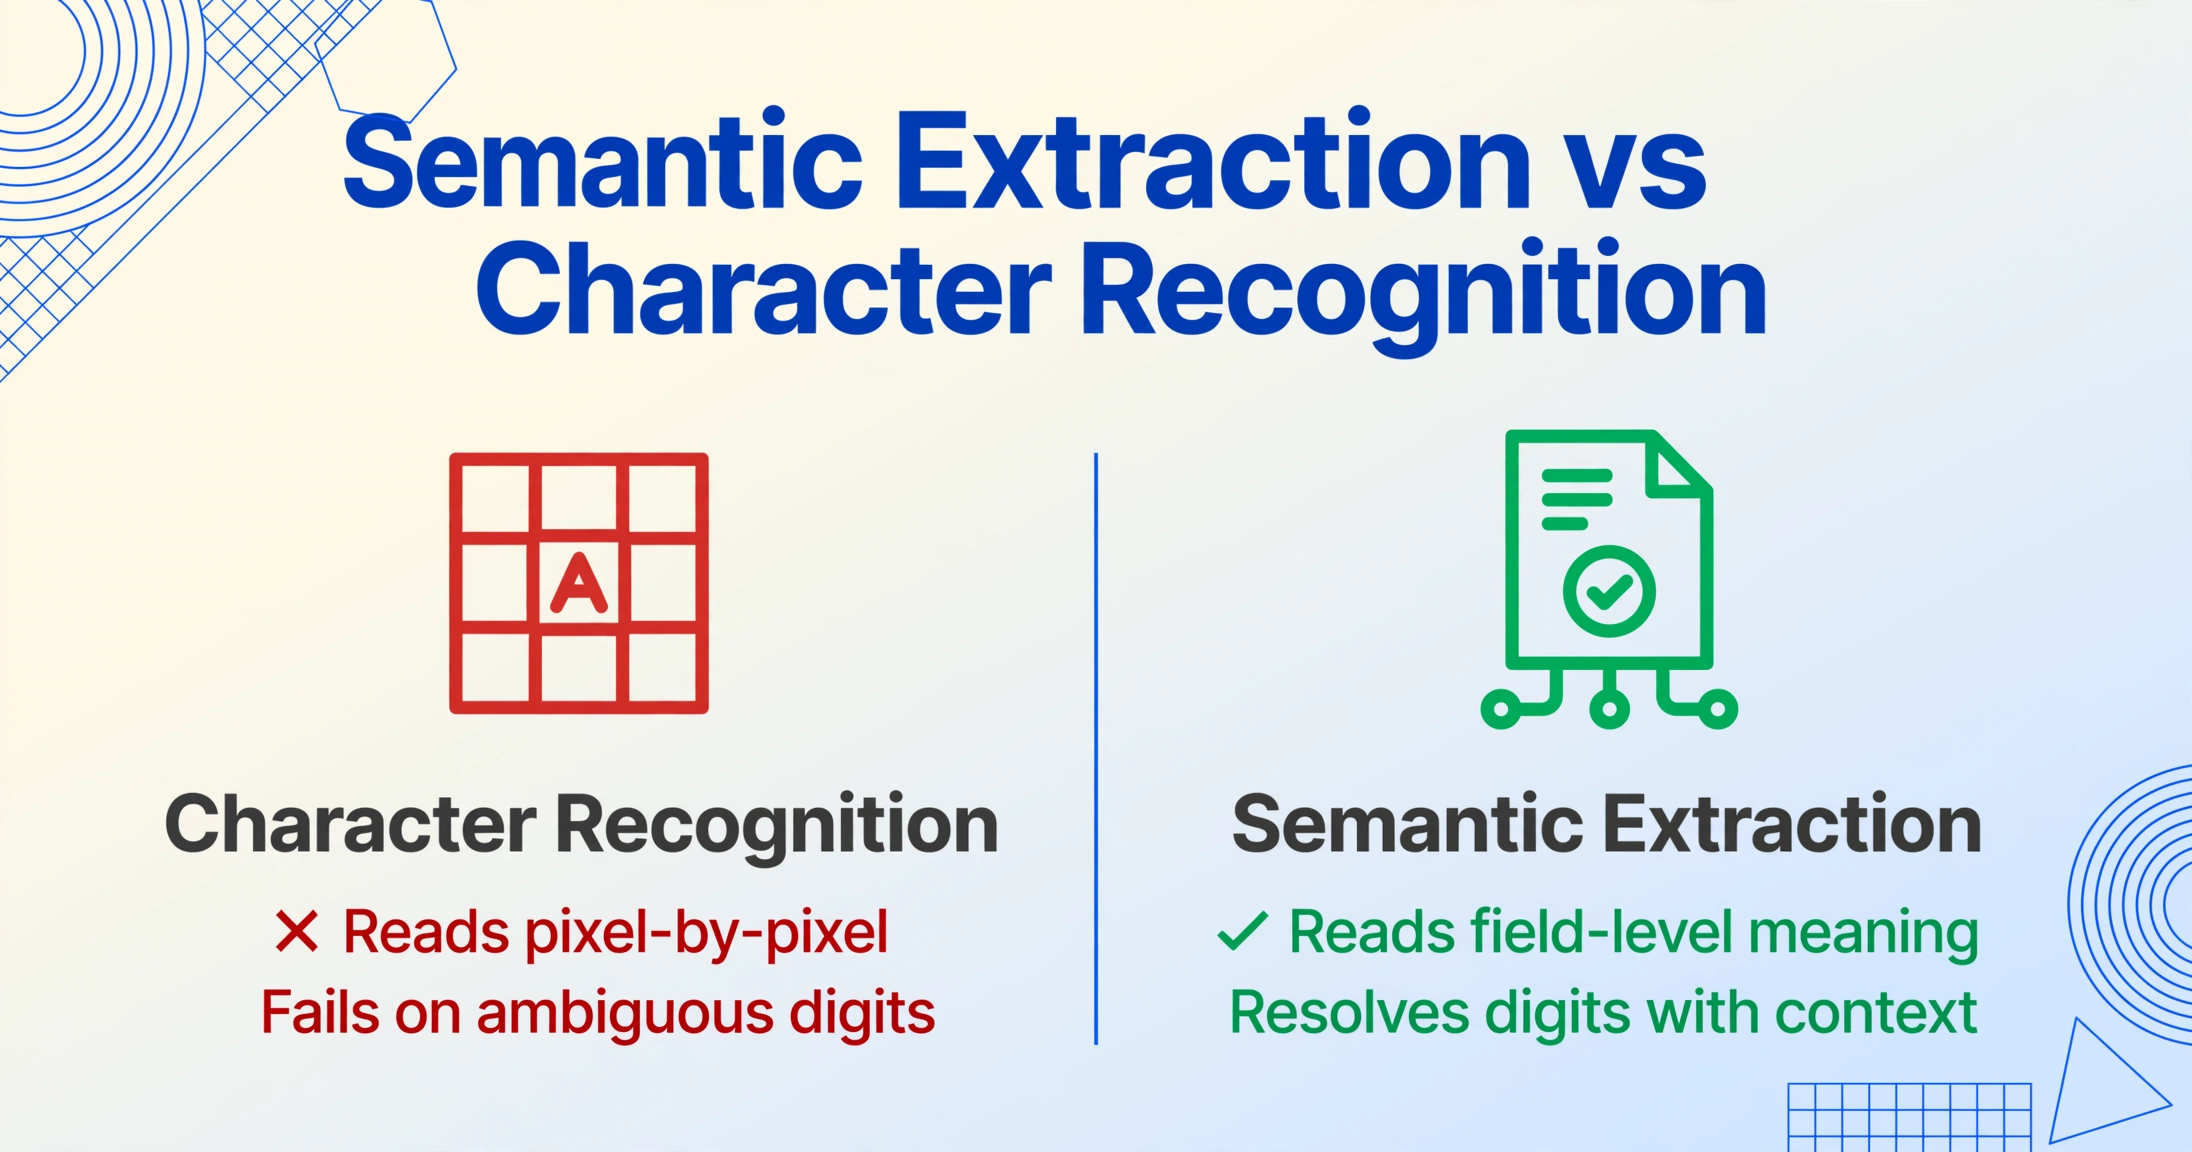
Der größte Unterschied zwischen einem Tool, das Handschrift akzeptabel verarbeitet, und einem, das das nicht tut, liegt darin, ob es das Dokument semantisch oder pixelweise liest. Traditionelle OCR behandelt Handschrift als Zeichenerkennungsproblem. KI-basierte Extraktion behandelt sie als semantisches Problem auf Feldebene.
Wenn ein KI-Modell weiß, dass „Erhaltene Menge“ eine Zahl sein sollte, nutzt es diese Einschränkung, um mehrdeutige Ziffern aufzulösen. Wenn es weiß, dass „Datum“ einem Format entsprechen muss, schließt es ungültige Daten aus. Diese semantische Einschränkung reduziert die Zeichenfehlerrate (CER) bei kritischen Feldern drastisch – nicht durch bessere Zeichenerkennung, sondern indem sie der Engine sagt, welche Antworten unmöglich sind.
ImageToTable.ai nutzt diesen semantischen Ansatz. Sie definieren die Spalten – „Zähler-ID“, „Aktuelle Ablesung“, „Verbrauch“ – und die KI lokalisiert jeden Wert, indem sie versteht, was er bedeutet, nicht wo er steht. Die besten Handschrift-OCR-Tools 2026 nutzen alle dieses Paradigma der semantischen Extraktion und übertreffen traditionelle Engines bei handschriftlichen Dokumenten.
Sehen Sie es in Aktion auf einem Zählerableseblatt – einem Dokumenttyp, bei dem Handschriftgenauigkeit am wichtigsten ist:
Dateien werden sicher verarbeitet und nicht gespeichert.
2. Eingabequalität kontrollieren
Die Genauigkeit der Handschrift-OCR sinkt unter 200 DPI deutlich und bei Fotos, die schräg oder bei ungleichmäßiger Beleuchtung aufgenommen wurden. Die einfachste und günstigste Möglichkeit, die Genauigkeit zu verbessern, ist die Standardisierung der Erfassung: Scannen Sie mit mindestens 300 DPI, verwenden Sie einen Dokumenteneinzug für gebundene Dokumente und vermeiden Sie unkontrollierte Handyfotos. Das kann die Zeichenfehlerrate (CER) im Vergleich zu beiläufigen Handyaufnahmen um 5–15 Punkte verbessern – mehr als jede derzeit verfügbare algorithmische Verbesserung.
Wenn die Aufnahme mit dem Handy unvermeidbar ist (wie es bei Zählerständen vor Ort oft der Fall ist), verwenden Sie eine Erfassungs-App, die einen geraden Aufnahmewinkel, gleichmäßige Beleuchtung und eine Kontrastprüfung erzwingt, bevor das Bild akzeptiert wird. Der Unterschied zwischen einem sorgfältigen und einem schnellen Foto ist oft der Unterschied zwischen brauchbarer Extraktion und unbrauchbarer Ausgabe.
3. Bauen Sie einen Verifizierungs-Workflow, keine blinde Pipeline
Kein Handschrift-OCR-System – egal wie fortschrittlich – sollte Daten ohne einen Verifizierungsschritt direkt in Abrechnungs- oder Inventarsysteme einspeisen. Die Frage ist nicht, ob Fehler auftreten, sondern ob sie erkannt werden, bevor sie Schaden anrichten.
Wenn Fehler auftreten, folgen sie erkennbaren Mustern – und die meisten sind vermeidbar. Unser Leitfaden zu Fehlermodi bei der Handschrift-Extraktion klassifiziert die acht häufigsten Fehlermuster und die Lösung für jedes, sodass Sie erkennen können, ob das Problem bei Ihrem Erfassungsprozess, Ihrem Felddesign oder dem Tool selbst liegt.
Ein praktischer Ansatz: Lassen Sie handschriftliche Dokumente durch die Extraktion laufen, leiten Sie Ausgaben mit Konfidenzwerten unter einem Schwellenwert (typischerweise 85–90 %) zur manuellen Prüfung weiter und konzentrieren Sie sich auf Summen, Mengen und Kennungen statt auf jedes einzelne Zeichen. Diese gezielte Verifizierung fängt 10–20 % der Fehler mit hoher Auswirkung ab, ohne dass eine 100 %ige manuelle Neueingabe erforderlich ist. Der Workflow: Stapelverarbeitung durch ein semantisches KI-Extraktionstool, markierte Felder prüfen, korrigieren und bestätigen, dann exportieren in Ihr Buchhaltungs- oder Abrechnungssystem.
Dieser hybride Ansatz – KI-Extraktion plus gezielte manuelle Prüfung – bietet sowohl den Geschwindigkeitsvorteil der Automatisierung als auch die Genauigkeitsgarantie, die geschäftskritische Daten erfordern. Verschiedene Dokumenttypen führen zu dramatisch unterschiedlichen Genauigkeitsergebnissen, weshalb Tests mit Ihren tatsächlichen Dokumenten unerlässlich sind, bevor Sie sich auf einen Workflow festlegen.
Häufig gestellte Fragen
Wie hoch ist die tatsächliche Genauigkeit von Handschrift-OCR im Jahr 2026?
Die ehrliche Antwort hängt von der Handschriftart und der Eingabequalität ab. Bei sauberer Druckschrift in strukturierten Formularen mit 300 DPI erreichen die besten Systeme 85–93 % Zeichengenauigkeit. Bei Schreibschrift oder gemischter Handschrift von Handyfotos sinkt die effektive Zeichengenauigkeit auf 65–80 %. Die Feldgenauigkeit – die Kennzahl, die wirklich zählt – liegt typischerweise 10–25 Prozentpunkte unter der Zeichengenauigkeit. Ein Anbieter, der „95 % Handschriftgenauigkeit“ angibt, ohne CER vs. Feldgenauigkeit zu spezifizieren und ohne den Testsatz zu beschreiben, berichtet mit ziemlicher Sicherheit den Best-Case-Zeichenwert aus einem kuratierten Datensatz. Für die Genauigkeitsaufschlüsselung nach Handschriftart – gedruckt, saubere Schreibschrift und unleserliche Schrift – finden Sie in unserer Referenz zu ob KI Handschrift aus Fotos lesen kann.
Ist Schreibschrift für OCR schwieriger als Druckschrift?
Ja, deutlich. Unabhängige Vergleiche zeigen, dass die OCR-Genauigkeit bei Schreibschrift bei denselben Tools 10-15 Prozentpunkte hinter der Erkennung gedruckter Handschrift liegt. ABBYY FineReader erreicht 95,2 % bei handschriftlicher Druckschrift, aber 91,7 % bei Schreibschrift — und Adobe Acrobat fällt von 88,6 % bei Druckschrift auf 79,3 % bei Schreibschrift. Der Grund ist struktureller Natur: Schreibschrift verbindet Zeichen und beseitigt damit die klaren Segmentierungsgrenzen, auf die herkömmliche OCR angewiesen ist. KI-basierte Vision-Modelle kommen damit besser zurecht als herkömmliche OCR, indem sie Kontext auf Wortebene nutzen, um mehrdeutige Zeichengrenzen aufzulösen, doch Schreibschrift bleibt das schwierigere Problem.
Kann KI-Handschrift-OCR die manuelle Dateneingabe ersetzen?
Bei strukturierten Dokumenten mit sauberer Handschrift und guter Eingabequalität kann KI-Handschrift-OCR die manuelle Dateneingabe um 70-80 % reduzieren — sie sollte die menschliche Prüfung jedoch nicht vollständig ersetzen. Das realistische Ziel ist ein hybrides Vorgehen: Die KI extrahiert alle Felder, markiert Ergebnisse mit geringer Konfidenz zur Prüfung, und ein Mensch verifiziert nur die markierten Werte. Die Kosten eines unkorrigierten Extraktionsfehlers in der Abrechnung sind in der Regel 10-20 Mal so hoch wie die Kosten, ihn bei der Prüfung zu entdecken.
Warum scheitert Handschrift-OCR speziell bei Zahlen?
Ziffern haben weniger unterscheidende visuelle Merkmale als Buchstaben — der Unterschied zwischen „4" und „9" ist eine einzige geschlossene Schleife, zwischen „7" und „1" ein Querstrich, der möglicherweise nicht vorhanden ist. Wenn ein Dokument überwiegend aus Zahlen besteht — Zählerstände, Mengen, Preise — summiert sich die Fehlerrate pro Ziffer, weil jedes Zeichen ein hochgradig mehrdeutiges Zeichen ist. Eine Genauigkeit von 90 % bei reiner Text-Handschrift könnte bei numerischen Feldern 80 % Genauigkeit pro Ziffer bedeuten, wodurch die Extraktion auf Feldebene mit hoher Wahrscheinlichkeit bei mindestens einem kritischen Wert scheitert.
Sollte ich der Angabe „90 % Handschrift-Genauigkeit" eines Anbieters vertrauen?
Nicht, ohne drei Fragen zu stellen: (1) Ist das zeichen- oder feldbezogen? (2) Welche Dokumenttypen wurden getestet — Druckschrift, Schreibschrift oder Handyfotos? (3) Wie viele verschiedene Handschriftstile (10 Schreiber oder 500)? Die meisten Anbieter melden die CER auf einem kuratierten Testsatz mit sauberer Druckschrift von einer kleinen Anzahl von Schreibern. Bei realen Dokumenten von Dutzenden Schreibern mit unterschiedlicher Eingabequalität liegt die effektive Genauigkeit meist 10-20 Punkte niedriger. Jeder Anbieter, der diese drei Fragen nicht mit konkreten Zahlen beantworten kann oder will, hat wahrscheinlich keine echten Praxistests mit Handschrift durchgeführt.