Précision OCR sur écriture manuscrite :
pourquoi un CER de 90 % donne toujours des totaux erronés
Lorsqu'un fournisseur d'OCR annonce « 90 % de précision sur l'écriture manuscrite », il parle de reconnaissance au niveau du caractère — c'est-à-dire si les lettres et chiffres individuels ont été lus correctement, en moyenne, sur la page. Mais cette moyenne masque un problème dévastateur : un taux d'erreur sur les caractères de 10 % ne produit pas 10 % de données erronées. Il provoque des échecs catastrophiques sur des champs spécifiques, car les erreurs d'écriture manuscrite se concentrent là où cela compte le plus — totaux, dates, identifiants — et un seul chiffre erroné dans un total de facture ou un relevé de compteur rend l'extraction entière incorrecte. L'écart entre « 90 % de précision sur les caractères » et « des données exploitables au niveau du champ » est le malentendu le plus coûteux de l'automatisation documentaire aujourd'hui.
Points clés à retenir
- « 90 % de précision OCR sur écriture manuscrite » signifie qu'1 caractère sur 10 est erroné — et les erreurs se concentrent dans vos totaux et relevés de compteur, pas dans l'en-tête du document.
- Un total manuscrit de 8 chiffres à 90 % de CER a 57 % de chances de contenir au moins une erreur — vous n'avez pas éliminé le travail manuel, vous avez simplement renommé la saisie de données en « vérification » et vous vérifiez toujours chaque valeur.
- Arrêtez de viser la précision au niveau du caractère. L'extraction sémantique — où l'IA sait que « Qté reçue » est un nombre et que « Date de facture » est une date — élimine les interprétations impossibles avant qu'elles n'atteignent votre feuille de calcul.
Ce que « 90 % de précision » mesure réellement sur l'écriture manuscrite
Le taux d'erreur sur les caractères est la métrique standard pour évaluer la reconnaissance de l'écriture manuscrite. Il compte chaque substitution (un « 5 » lu comme un « 6 »), insertion et suppression, puis divise par le nombre total de caractères. La référence du secteur pour le texte imprimé — propre, haute résolution, polices standard — est un CER inférieur à 1 %, soit une précision de 99 % ou plus au niveau des caractères.
L'écriture manuscrite change complètement la donne. Une comparaison indépendante des principaux outils OCR a révélé que sur l'écriture manuscrite en caractères d'imprimerie (lettres capitales), ABBYY FineReader atteignait 95,2 % de précision et Adobe Acrobat 88,6 %. Sur l'écriture cursive, l'écart s'est creusé : ABBYY à 91,7 %, Adobe à 79,3 % et Readiris à 84,9 %. Ce sont des résultats de premier ordre pour des OCR de bureau dédiés — pas des photos prises au mobile ni des documents mixtes.
Pour les documents professionnels réels — factures manuscrites, bons de livraison, feuilles de relevé de compteur — la précision effective au niveau des caractères se situe souvent entre 80 % et 90 %. Et voici le problème : ces 10 à 20 erreurs pour 100 caractères ne sont pas réparties uniformément. Elles se concentrent sur les caractères où une erreur vous coûte de l'argent.
Pour comprendre comment les différentes métriques de précision OCR se rapportent les unes aux autres, commencez par notre guide sur le CER, le WER et la précision au niveau du champ.
Pourquoi l'écriture manuscrite est fondamentalement différente pour l'OCR
La raison pour laquelle la précision de l'OCR sur l'écriture manuscrite est si loin derrière celle sur le texte imprimé n'est pas simplement que l'écriture manuscrite est « plus brouillonne ». Le problème est structurel : l'écriture manuscrite n'a pas de formes de caractères stables. Un « a » imprimé en Arial, Times New Roman et Courier partage la même structure essentielle — une boucle fermée avec une hampe. Un « a » manuscrit peut être fermé avec une boucle, ouvert comme un « u », écrit en un seul trait, ou simplifié en un point. Le même scripteur produit des formes différentes selon la vitesse et l'angle du stylo. Entre plusieurs scripteurs, la variance explose. Pour une explication pas à pas de pourquoi cette différence structurelle compte au niveau des caractères — et comment l'IA contourne le problème — consultez notre analyse approfondie sur comment fonctionne la reconnaissance de l'écriture manuscrite.
Cela crée trois modes de défaillance distincts :
Échec de segmentation
L'OCR traditionnel repose sur des limites claires entre les caractères. L'écriture cursive relie les lettres, ce qui empêche un moteur au niveau des caractères de savoir où l'une se termine et où la suivante commence. Un « n » suivi d'un « i » écrit rapidement devient visuellement identique à un « m » — et l'OCR n'a aucun moyen de décider quelle interprétation est correcte sans comprendre le mot.
Ambiguïté des formes
Le même chiffre écrit différemment par deux personnes — ou par la même personne à des jours différents — peut ressembler davantage à un autre chiffre qu'à sa propre variante. Un « 7 » écrit rapidement sans barre transversale ressemble à un « 1 ». Un « 9 » avec une petite boucle pourrait être un « 4 » ou un « 8 ». Un modèle OCR entraîné sur des millions d'exemples est toujours confronté à une ambiguïté fondamentale lorsque le signal visuel lui-même est sous-déterminé.
Absence de contexte
L'OCR traditionnel lit chaque caractère isolément. Il ne sait pas qu'un champ intitulé « Total » doit contenir un nombre, ni qu'un champ intitulé « Date » doit correspondre à un format de date. Sans cette contrainte contextuelle, le moteur n'a aucun moyen d'écarter les interprétations impossibles — par exemple lire le « S » d'un « Smith » manuscrit comme un « 5 » parce que le tracé du trait y ressemble par hasard.
Le troisième mode de défaillance est le plus lourd de conséquences. L'absence de contexte est ce qui distingue l'OCR traditionnel de l'extraction basée sur l'IA. Un moteur OCR traditionnel applique la même logique de correspondance de caractères à chaque pixel. Un modèle vision-langage moderne lit le document sémantiquement : il identifie qu'un champ est numérique, qu'une date doit respecter un format, qu'un total doit être cohérent avec les lignes d'articles. Ces contraintes réduisent considérablement les interprétations plausibles des caractères.
Le piège du CER : pourquoi 90 % de précision sur les caractères peut signifier 0 % de précision au niveau du champ
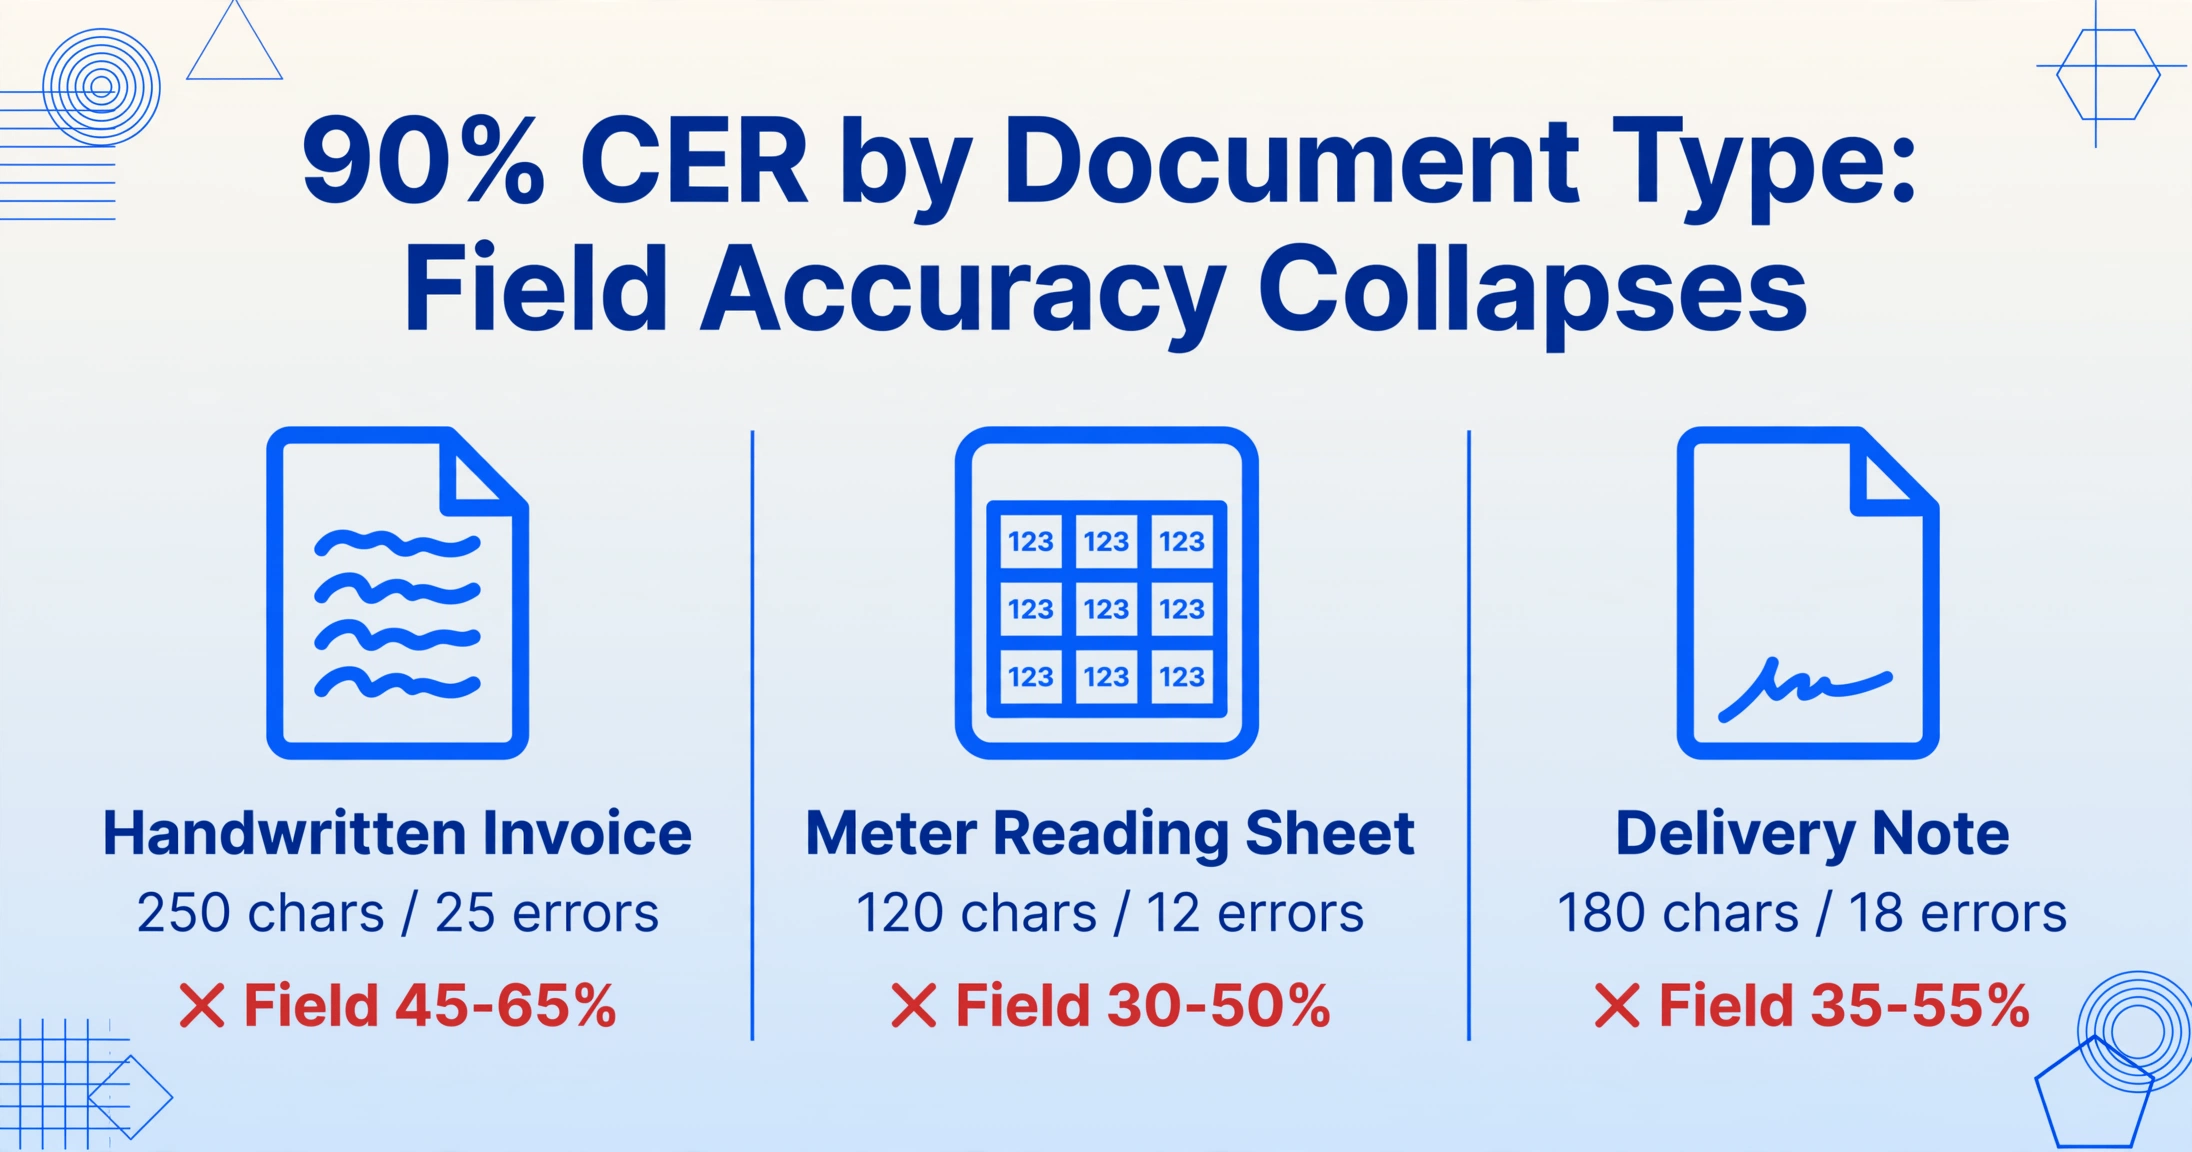
Prenons une facture manuscrite de 250 caractères — coordonnées du fournisseur, lignes d'articles, quantités, prix, sous-total, taxes et total. Un moteur OCR de reconnaissance d'écriture manuscrite atteint un CER de 90 % : 25 caractères erronés sur 250.
La question qui détermine si l'extraction est utile : quels 25 caractères ?
| Type de document | Nombre total de caractères | CER 90 % = erreurs | Résultat au niveau du champ | Impact métier |
|---|---|---|---|---|
| Facture imprimée | 200 | 2 erreurs (CER 99 %) | 98-100 % | Peut être traitée sans vérification |
| Facture manuscrite | 250 | 25 erreurs | 45-65 % | La plupart des champs sont erronés — nécessite une ressaisie manuelle complète |
| Feuille de relevé de compteur | 120 (uniquement numérique) | 12 erreurs | 30-50 % | Relevés erronés → facturation incorrecte |
| Bon de livraison (qté + signatures) | 180 | 18 erreurs | 35-55 % | Quantités erronées → écart d'inventaire |
Un CER de 90 % sur une feuille de relevé de compteur manuscrite signifie qu'environ 1 chiffre sur 10 est erroné. Comme les relevés sont exclusivement numériques et que la différence entre « 0013847 » et « 0013841 » est un écart de facturation qui se cumule sur des milliers de compteurs, le taux d'échec au niveau du champ rend l'extraction inutilisable sans vérification humaine à 100 %. Vous ne gagnez pas de temps — vous déplacez simplement le travail de saisie vers une étape de vérification qui exige toujours d'examiner chaque valeur.
Trois documents réels, trois modes de défaillance
L'abstraction des taux de CER devient concrète lorsqu'on examine de vrais documents manuscrits et qu'on trace l'origine des erreurs.
1. Facture manuscrite — effondrement du champ Total
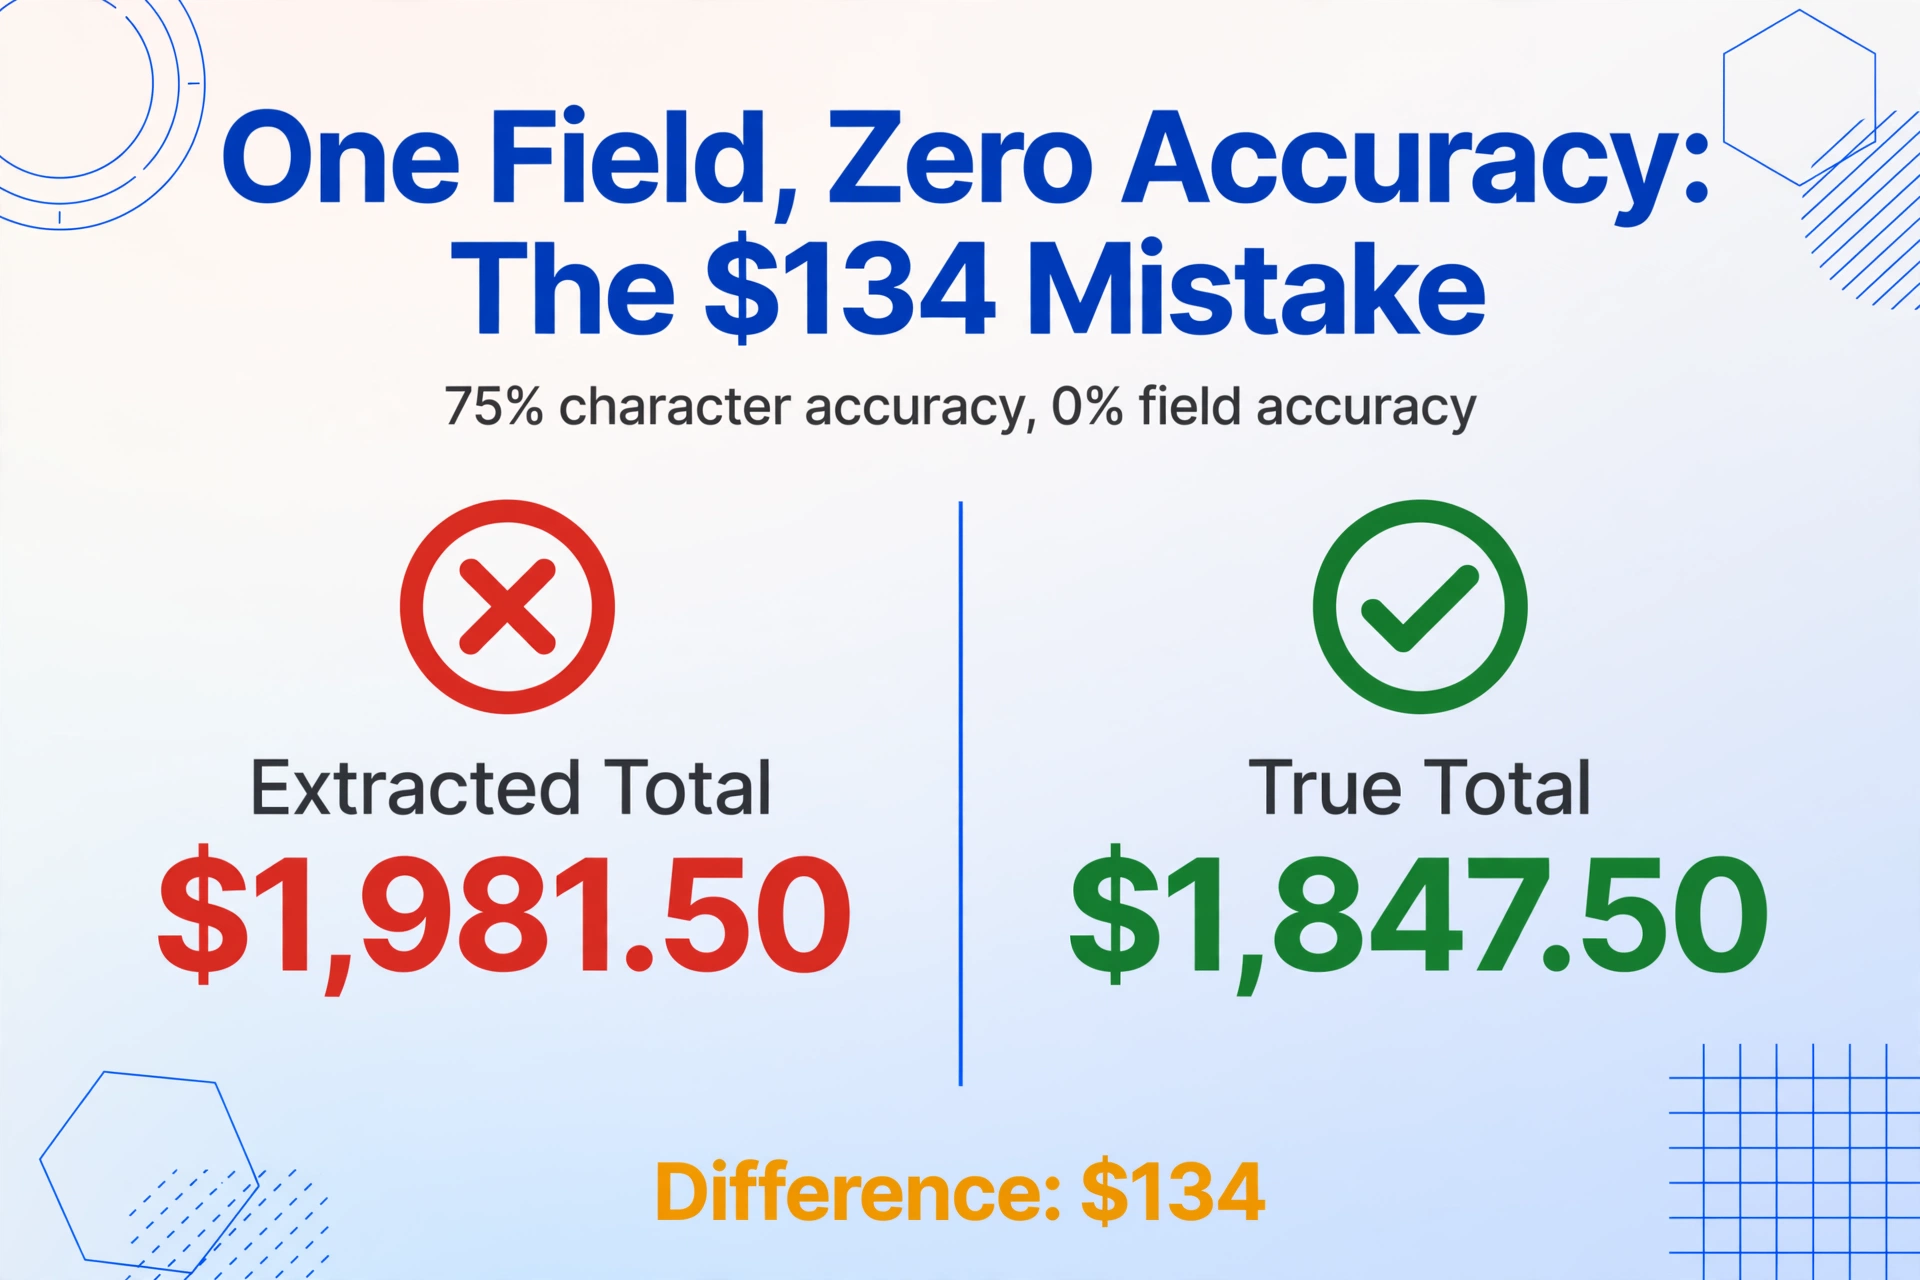
Un petit entrepreneur soumet une facture pour des matériaux. L'en-tête est proprement tapé, mais les lignes d'articles, les quantités et le total final sont manuscrits. Le champ Total indique « 1 847,50 $ ». Le moteur d'OCR lit mal le « 4 » manuscrit comme un « 9 » et le « 7 » comme un « 1 ». Le total extrait devient « 1 981,50 $ » — une différence de 134 $. La précision sur les caractères de ce seul champ est de 75 % (6 caractères corrects sur 8). La précision au niveau du champ est de 0 %. Le CER au niveau de la page affiche toujours 88 à 92 % parce que la majeure partie du texte d'en-tête est imprimée parfaitement — mais le seul champ que la facture existe pour communiquer est faux, et faux d'assez pour déclencher un litige de paiement.
Ce n'est pas un cas limite. Les chiffres manuscrits sont l'entrée la plus sujette aux erreurs pour l'OCR, car les chiffres ont moins de caractéristiques distinctives que les lettres — un « 4 » et un « 9 » diffèrent par une seule boucle fermée, un « 3 » et un « 8 » par la fermeture de la boucle supérieure, un « 1 » et un « 7 » par une barre transversale qui peut être absente du style d'écriture.
2. Bon de livraison — confusion sur les quantités
Un bon de livraison comporte des en-têtes préimprimés : « Article », « Qté commandée », « Qté reçue ». Les quantités sont entourées ou barrées à la main. L'OCR de l'écriture manuscrite échoue ici parce que les quantités écrites sous forme de coches rapides ou de chiffres entourés sont ambiguës — un « 6 » entouré d'un cercle peut être confondu avec un « 8 ». Dans un contexte d'entrepôt, où une seule quantité mal lue de 120 unités contre 180 unités détermine si le stock doit être réapprovisionné, un taux d'erreur sur les caractères de 10 % sur la colonne Qté reçue signifie une rupture de stock ou une radiation.
3. Feuille de relevé de compteur — Erreurs en cascade
Les releveurs de compteurs consignent leurs relevés sur des feuilles de route papier — des grilles d'identifiants de compteurs, de relevés précédents, de relevés actuels et de consommation. Les caractères sont exclusivement des chiffres, écrits rapidement dans de petites cases en biais. Une erreur d'un seul chiffre se propage en cascade : si le relevé actuel de 03842 est lu comme 03892, la consommation augmente de 50 unités. Agrégées sur 5 000 compteurs par tournée, les erreurs de facturation se cumulent en dizaines de milliers de dollars. L'industrie des services publics perd environ 90 à 100 milliards de dollars par an en pertes non techniques, y compris la facturation incorrecte — et une part significative provient de la mauvaise lecture des feuilles manuscrites.
Les champs composés uniquement de chiffres sont à la fois plus faciles et plus difficiles pour l'OCR : le jeu de caractères est réduit, mais l'ambiguïté est extrême, car la variation au sein d'une même classe de chiffres peut dépasser la variation entre les classes. Un « 7 » sans barre transversale et un « 1 » incliné avec un empattement peuvent être visuellement impossibles à distinguer.
Ce que vous pouvez réellement faire pour améliorer la précision de l'OCR sur l'écriture manuscrite
Le tableau réaliste n'est pas désespéré — mais il exige de comprendre les contraintes et de choisir la bonne approche. Voici ce qui fait vraiment la différence.
1. Choisir l'extraction sémantique plutôt que la reconnaissance de caractères
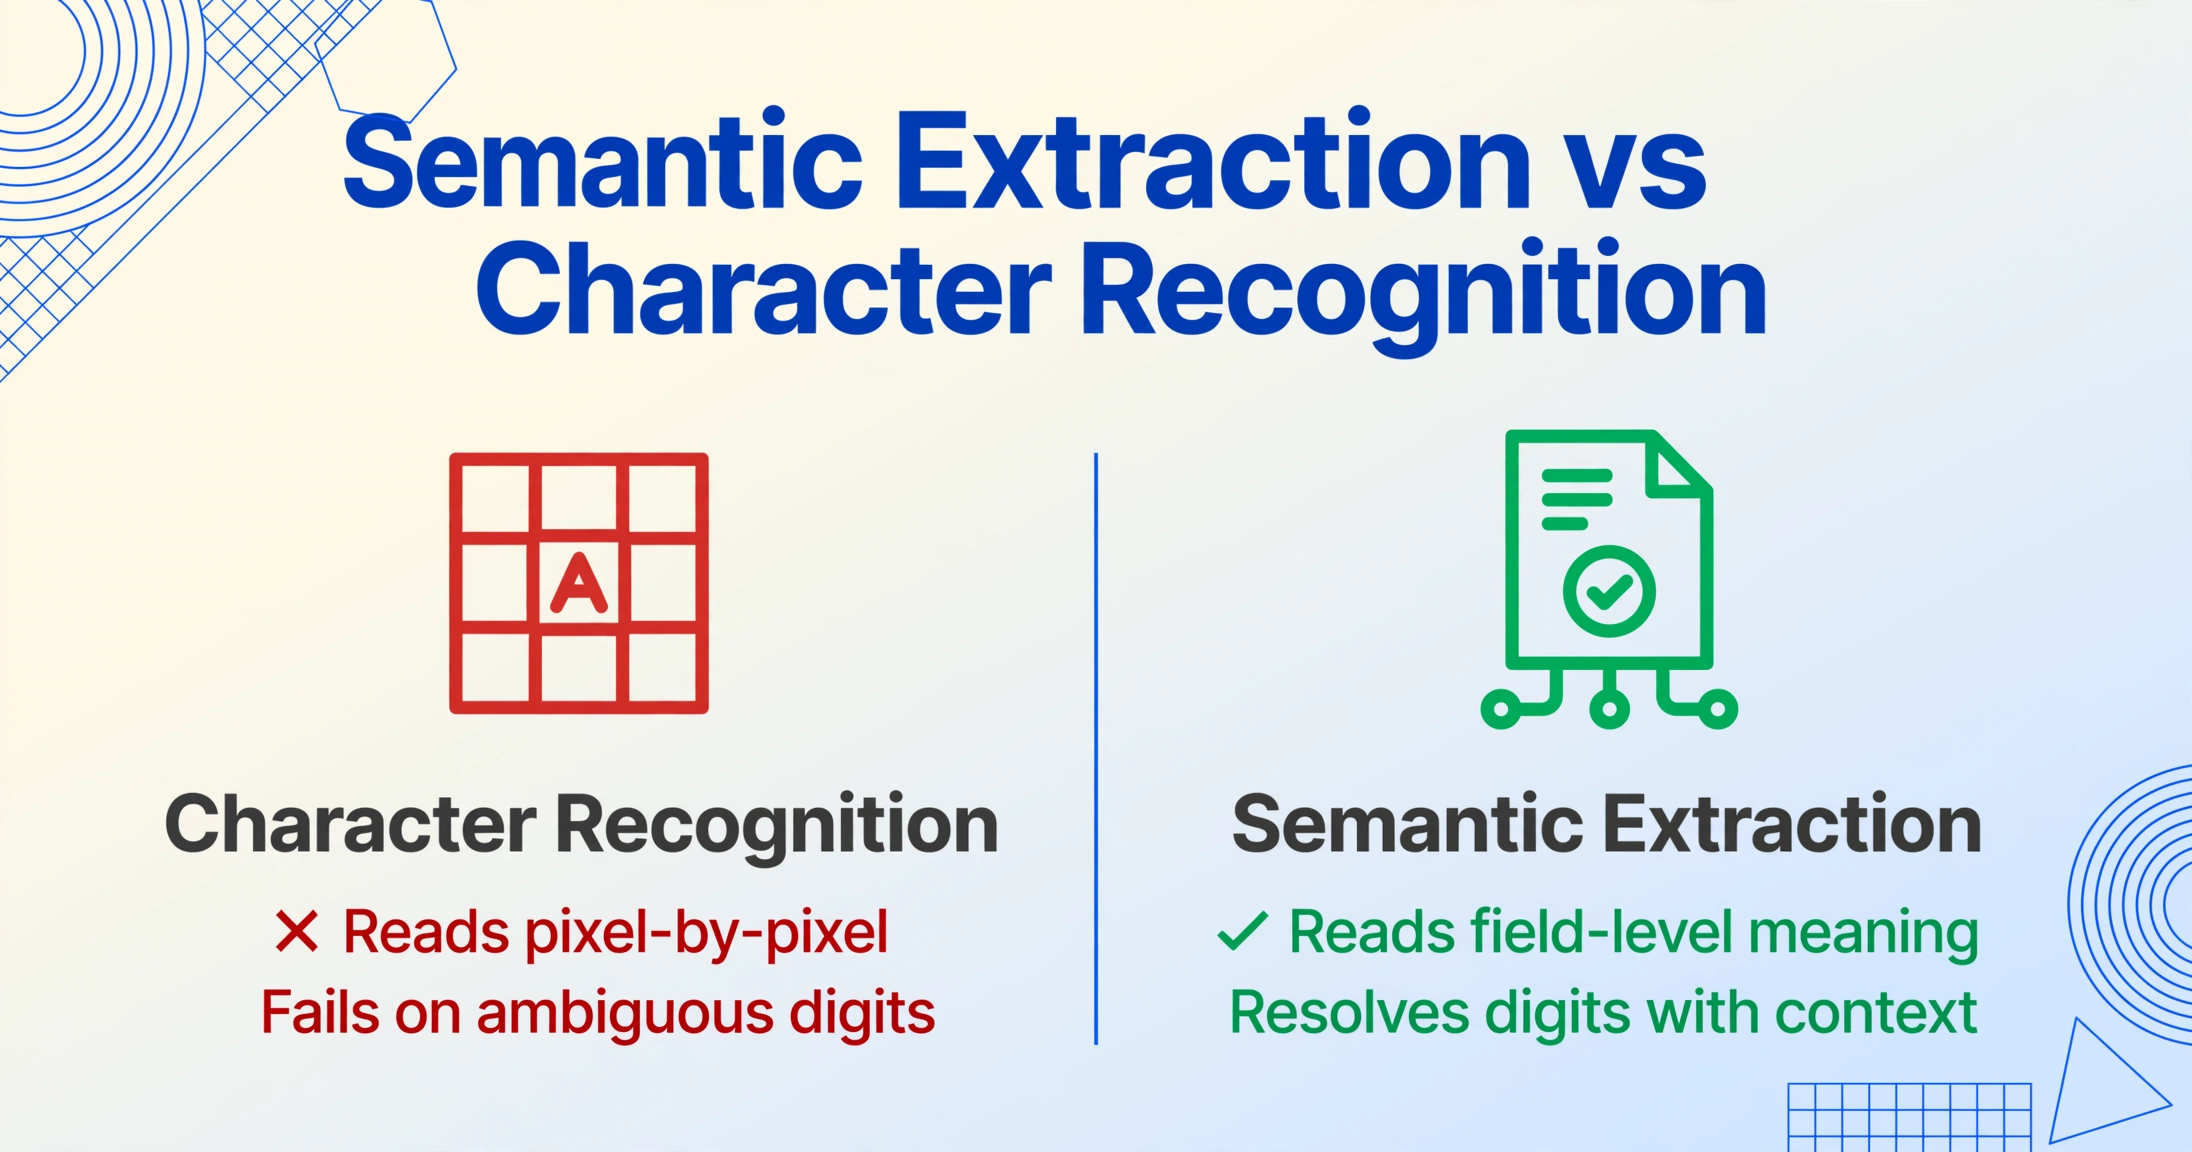
La plus grande différence entre un outil qui gère correctement l'écriture manuscrite et un autre qui n'y parvient pas réside dans sa façon de lire le document : sémantiquement ou pixel par pixel. L'OCR traditionnel traite l'écriture manuscrite comme un problème de reconnaissance de caractères. L'extraction basée sur l'IA la traite comme un problème sémantique au niveau du champ.
Lorsqu'un modèle d'IA sait que « Qté reçue » doit être un nombre, il utilise cette contrainte pour résoudre les chiffres ambigus. Lorsqu'il sait que « Date » doit respecter un format, il élimine les dates invalides. Cette contrainte sémantique réduit considérablement le taux d'erreur sur les caractères sur les champs critiques — non pas en améliorant la reconnaissance des caractères, mais en indiquant au moteur quelles réponses sont impossibles.
ImageToTable.ai utilise cette approche sémantique. Vous définissez les colonnes — « Identifiant du compteur », « Relevé actuel », « Consommation » — et l'IA localise chaque valeur en comprenant ce qu'elle signifie, et non où elle se trouve. Les meilleurs outils d'OCR pour l'écriture manuscrite en 2026 exploitent tous ce paradigme d'extraction sémantique, surpassant les moteurs traditionnels sur les documents manuscrits.
Voyez-le en action sur une feuille de relevé de compteur — un type de document où la précision de l'écriture manuscrite est primordiale :
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
2. Contrôler la qualité des entrées
La précision de l'OCR pour l'écriture manuscrite chute fortement en dessous de 200 DPI et sur les photos prises en angle ou avec un éclairage inégal. L'amélioration la plus rentable est de standardiser la capture : numériser à au moins 300 DPI, utiliser un chargeur de documents pour les documents reliés, et éviter les photos mobiles non contrôlées. Cela peut améliorer le CER de 5 à 15 points par rapport à une capture mobile occasionnelle — plus que toute amélioration algorithmique actuelle.
Si la capture mobile est inévitable (comme c'est souvent le cas pour les relevés de compteur sur le terrain), utilisez une application de capture qui impose un angle droit, un éclairage uniforme et une vérification du contraste avant d'accepter l'image. La différence entre une photo soignée et une photo rapide est souvent la différence entre une extraction exploitable et un résultat inutilisable.
3. Créez un workflow de vérification, pas un pipeline aveugle
Aucun système d'OCR manuscrite — aussi avancé soit-il — ne devrait alimenter directement vos systèmes de facturation ou d'inventaire sans étape de vérification. La question n'est pas de savoir si des erreurs se produiront, mais si elles seront détectées avant de causer des dégâts.
Lorsque des erreurs se produisent, elles suivent des schémas reconnaissables — et la plupart sont évitables. Notre guide des modes de défaillance de l'extraction manuscrite classe les huit schémas d'échec les plus courants et la solution pour chacun, afin que vous puissiez déterminer si le problème vient de votre processus de capture, de la conception de vos champs ou de l'outil lui-même.
Une approche pratique : faites passer les documents manuscrits par l'extraction, acheminez les résultats dont le score de confiance est inférieur à un seuil (généralement 85-90 %) vers une revue humaine, et concentrez l'attention sur les totaux, les quantités et les identifiants plutôt que sur chaque caractère. Cette vérification ciblée détecte 10 à 20 % des erreurs à fort impact sans exiger une ressaisie manuelle à 100 %. Le workflow : traitement par lots via un outil d'extraction IA sémantique, revue des champs signalés, correction et confirmation, puis export vers votre système comptable ou de facturation.
Cette approche hybride — extraction IA + revue humaine ciblée — offre à la fois le gain de rapidité de l'automatisation et la garantie de précision exigée par les données critiques. Les différents types de documents produisent des résultats de précision très variables, c'est pourquoi tester sur vos documents réels est essentiel avant d'adopter un workflow.
Questions fréquentes
Quelle est la précision réelle de l'OCR manuscrite en 2026 ?
La réponse honnête dépend du type d'écriture et de la qualité de l'entrée. Sur des caractères d'imprimerie soignés dans des formulaires structurés à 300 DPI, les meilleurs systèmes atteignent une précision de caractères de 85 à 93 %. Sur de l'écriture cursive ou mixte issue de photos prises au téléphone, la précision effective sur les caractères chute à 65-80 %. La précision au niveau du champ — la métrique qui compte — est généralement inférieure de 10 à 25 points à la précision sur les caractères. Un fournisseur qui annonce « 95 % de précision sur l'écriture manuscrite » sans préciser le Taux d'erreur sur les caractères (CER) par rapport au niveau de champ et sans décrire l'ensemble de test rapporte presque certainement le chiffre optimal au niveau des caractères issu d'un ensemble sélectionné. Pour la répartition de la précision par type d'écriture — imprimée, cursive soignée et scripte brouillonne — consultez notre référence sur la capacité de l'IA à lire l'écriture manuscrite à partir de photos.
L'écriture cursive est-elle plus difficile à reconnaître par OCR que l'écriture imprimée ?
Oui, nettement. Des comparaisons indépendantes montrent que la précision de l'OCR sur l'écriture cursive est inférieure de 10 à 15 points de pourcentage à celle sur l'écriture imprimée, avec les mêmes outils. ABBYY FineReader obtient 95,2 % sur l'écriture imprimée manuscrite mais 91,7 % sur la cursive — et Adobe Acrobat passe de 88,6 % sur l'imprimé à 79,3 % sur la cursive. La raison est structurelle : la cursive relie les caractères, éliminant les frontières de segmentation claires dont dépend l'OCR traditionnel. Les modèles de vision basés sur l'IA gèrent mieux cela que l'OCR traditionnel en utilisant le contexte au niveau du mot pour résoudre les frontières ambiguës entre caractères, mais la cursive reste le problème le plus difficile.
L'OCR IA pour l'écriture manuscrite peut-il remplacer la saisie manuelle des données ?
Pour les documents structurés avec une écriture soignée et des entrées de qualité, l'OCR IA pour l'écriture manuscrite peut réduire la saisie manuelle de 70 à 80 % — mais il ne doit pas remplacer entièrement la vérification humaine. L'objectif réaliste est un flux de travail hybride : l'IA extrait tous les champs, signale les résultats à faible confiance pour vérification, et un humain ne vérifie que les valeurs signalées. Le coût d'une erreur d'extraction non corrigée dans la facturation est généralement 10 à 20 fois supérieur au coût de sa détection lors de la vérification.
Pourquoi l'OCR pour l'écriture manuscrite échoue-t-il spécifiquement sur les chiffres ?
Les chiffres ont moins de caractéristiques visuelles distinctives que les lettres — la différence entre « 4 » et « 9 » est une seule boucle fermée, entre « 7 » et « 1 » une barre transversale qui peut ne pas exister. Lorsqu'un document est principalement composé de chiffres — relevés de compteur, quantités, prix — le taux d'erreur par chiffre se cumule car chaque caractère est hautement ambigu. Un CER de 90 % sur du texte manuscrit tout en lettres peut se traduire par une précision de 80 % par chiffre sur les champs numériques, rendant l'extraction au niveau du champ presque certaine d'échouer sur au moins une valeur critique.
Dois-je faire confiance à l'affirmation d'un fournisseur de « 90 % de précision sur l'écriture manuscrite » ?
Pas sans poser trois questions : (1) S'agit-il d'une précision au niveau du caractère ou du champ ? (2) Quels types de documents ont été testés — caractères d'imprimerie, cursive ou photos mobiles ? (3) Combien de styles d'écriture uniques (10 scripteurs ou 500) ? La plupart des fournisseurs rapportent un CER sur un ensemble de test soigneusement sélectionné de caractères d'imprimerie soignés provenant d'un petit nombre de scripteurs. Sur des documents réels provenant de dizaines de scripteurs avec une qualité d'entrée variable, la précision effective est généralement inférieure de 10 à 20 points. Tout fournisseur qui ne peut pas ou ne veut pas répondre à ces trois questions avec des chiffres précis n'a probablement effectué aucun test réel sur l'écriture manuscrite.