教育分野のOCR:
学生記録・成績証明書・入学フォームの完全ガイド
教育分野のOCRとは、文字認識とAI文書抽出を学生記録に適用することです。成績証明書、入学フォーム、奨学金関連書類、標準テストのスコア、IEP、卒業証明書など、各入学サイクルで学校や大学が数千件単位で処理する学術文書が対象となります。 形式が比較的安定している請求書や領収書の抽出とは異なり、教育文書は数千の異なる教育機関から届き、それぞれ独自のレイアウト、成績評価基準、単位制度、用語を使用しています。ピクセルを読み取るだけのツールと学術データ構造を理解するツールの違いが、あなたの教務課が1日50件の成績証明書を処理するか500件を処理するかを左右します。
重要ポイント
- 中規模の大学は入学サイクルごとに30,000件の成績証明書を受け取りますが、各1件につき、ページ上のGPAの位置を探し、成績評価基準を解釈し、コース名を学生システムに入力するだけで、いまだに15〜25分の人手が必要です。
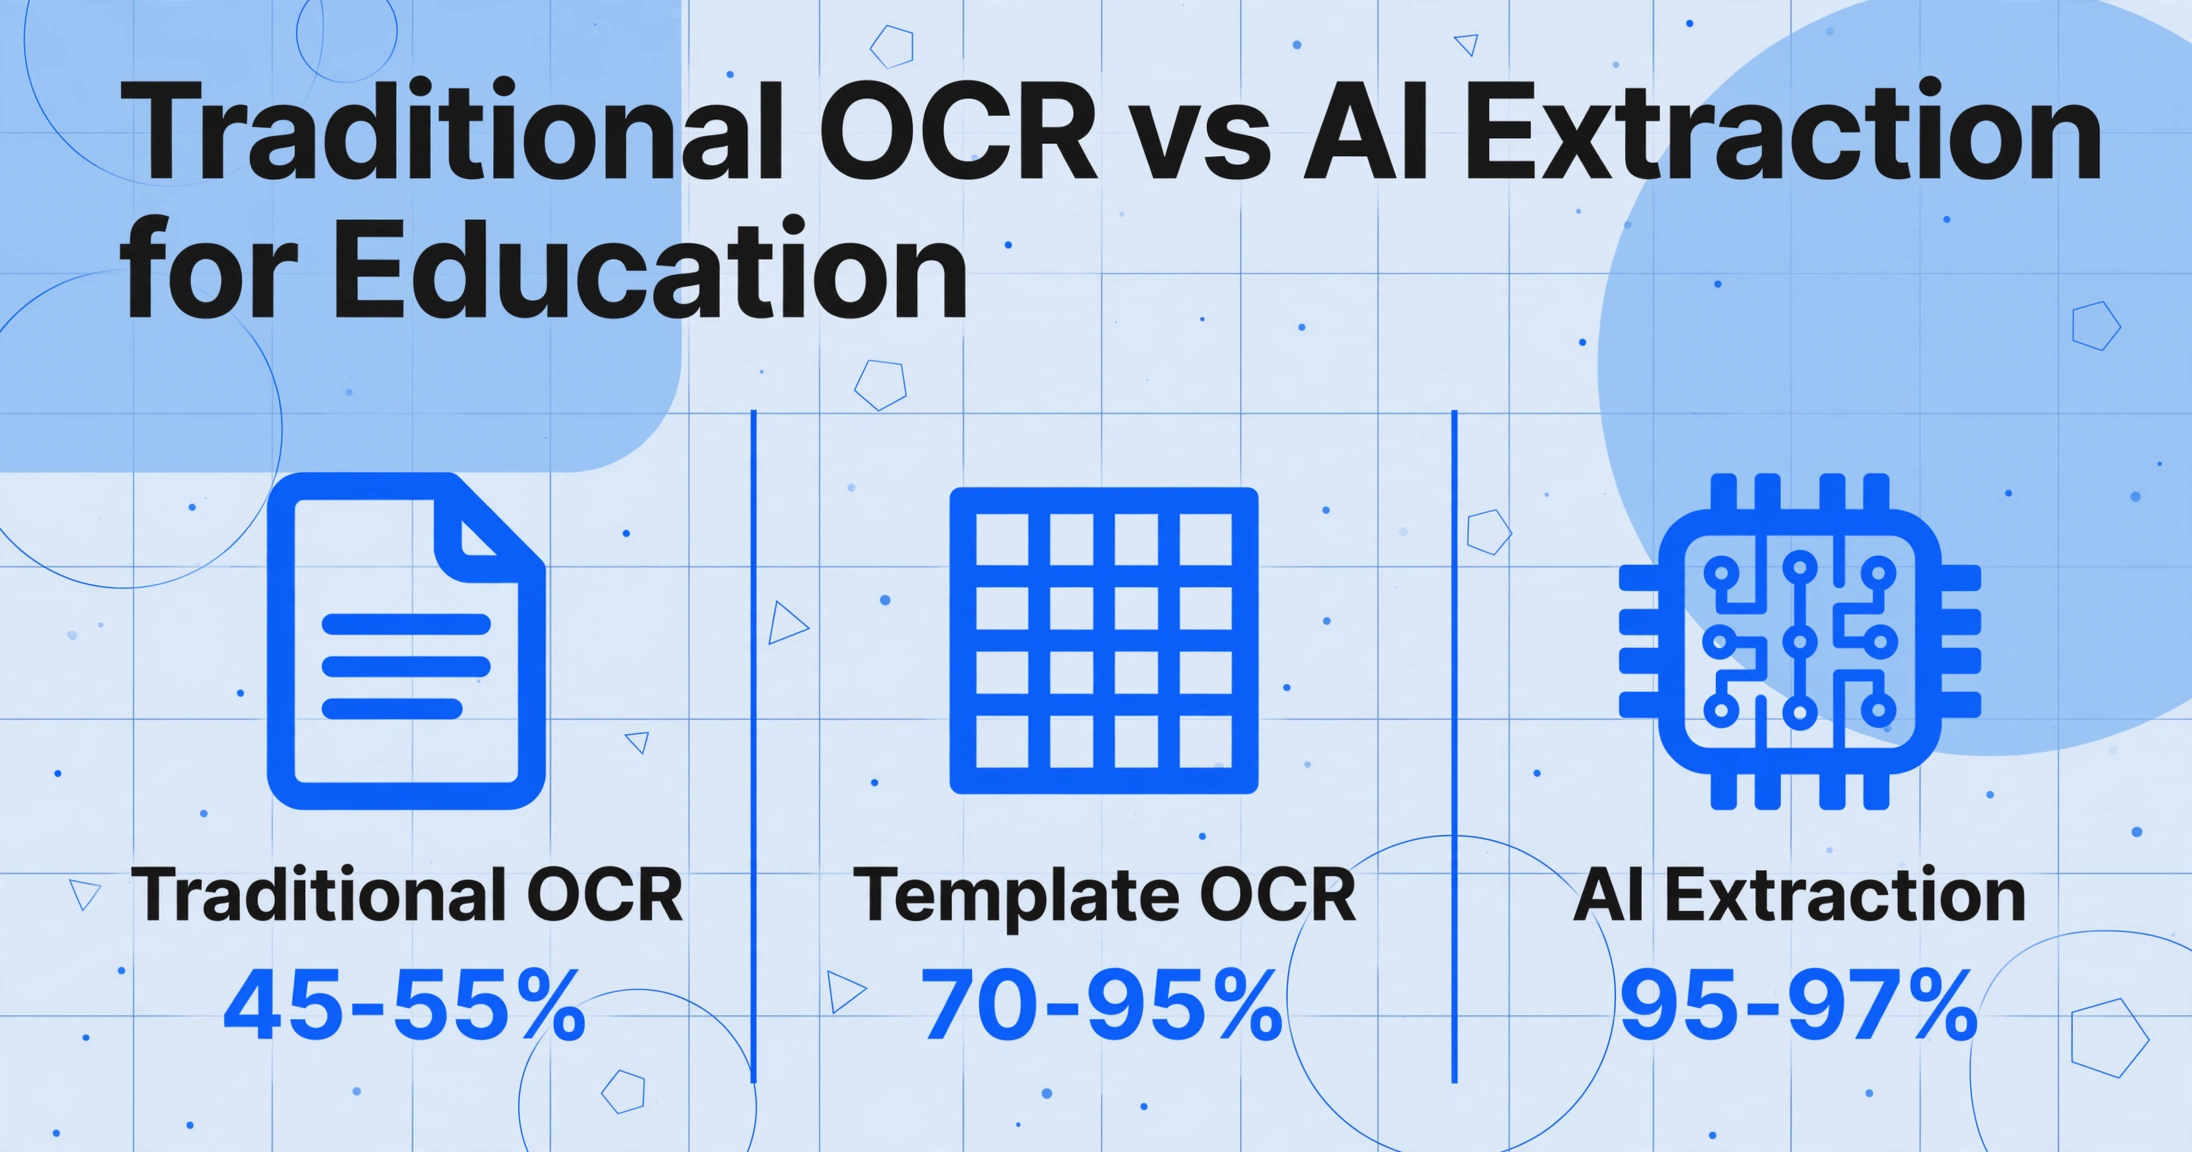
- テンプレートベースのOCRは、馴染みのない形式では55%のGPA抽出エラー率を生み出します。米国の4,000以上の高等教育機関がそれぞれ異なる成績証明書のレイアウトを使用しており、ピクセル位置を意味よりも優先するツールは、レイアウトがわずかにずれただけで誤った数値を取得してしまうからです。
- セマンティックAIは、1件の成績証明書を45秒で96.7%の精度、1ドキュメントあたり$0.15で抽出します。ピクセル座標ではなく意味を読み取り、次の提携校がGPAをページの別の場所に配置しても壊れないためです。
教育向けOCRとは?
光学文字認識(OCR)技術は、スキャンまたは撮影されたテキストを機械可読な文字に変換します。これはどの業界でも同じです。教育向けOCRが独自のカテゴリーとなる理由は、処理されるドキュメントの性質と、学校が実際にそこから抽出する必要がある情報にあります。
大学の入学課は、成績証明書を読むだけでなく、特定のGPA値を抽出し、それが4.0スケール(4.3や5.0ではなく)で計算されているかを確認し、どのコースが単位互換の対象かを特定し、単位時間がセメスター制かクォーター制かをチェックし、重複をフラグ付けする必要があります。K-12学区が入学フォームを処理する場合、保護者の連絡先情報、以前の学校の記録、特別支援教育のステータス、無料・割引ランチの対象資格を、手書きまたはコピーされた—それぞれ異なる形式の—書類の山から引き出す必要があります。
従来のOCR—ピクセルパターンを文字データベースと照合する方式—は、これらのドキュメントのテキストをデジタル化できます。しかし、GPAが何を表すのか、「3.75」が成績平均点なのかコース番号なのか、「09/01/2026」が入学日であって手数料額ではないということを理解していません。この意味論的なギャップこそが、教育機関が従来のOCRからAI搭載のドキュメント抽出へと移行している理由です。
教育に自動ドキュメント処理が必要な理由
平均的な学校システムを通過する紙の量は、誇張なしに膨大です。米国の中規模の公立大学1校で、入学サイクルごとに20,000〜30,000件の学部入学願書を処理します。例えばサンディエゴ州立大学は、2018年秋だけで93,000件以上の願書を処理し、その年に31,000件以上の大学成績証明書を扱いました—そのうち18%はPDFスキャンとして届いたためOCR処理が必要でした。
K-12学区の場合、管理負荷は異なりますが同様に重いものです。オクラホマ州の大規模なバーチャル公立チャータースクールであるEpic Charter Schoolsは、65以上のドキュメントタイプを分類するAIシステムを使用して、単一の入学期間で15,000件以上の学生記録を処理し、学生1人あたりの処理時間を数時間から数秒に短縮しました。
手動処理のコストは、機関が扱うあらゆるドキュメントタイプにわたって累積します:
- 成績証明書評価 — 届いた成績証明書ごとに、スタッフがコースコードを読み、成績を自機関のスケールに変換し、認定を確認し、結果を手動で入力する必要があります。成績証明書1件あたり15〜25分として、30,000件の願書は入学サイクルごとに7,500〜12,500時間の労働に相当します。
- 入学フォーム — 新入生の登録パケットには通常8〜15ページ(緊急連絡先、健康情報、居住証明、以前の学校教育)が含まれます。管理フォーム処理における手動データ入力のエラー率は平均18〜25%で、最も重要なフィールド—保護者の連絡先番号や医療アラート情報—に最も高いエラーコストがかかります。
- 奨学金書類 — FAFSAデータ、税務成績証明書、収入証明書類の検証は、高等教育で最もドキュメント集約的なワークフローの1つであり、学生1人あたり複数回の書類レビューが必要になることがよくあります。
ほとんどの学校が依然として手動処理をデフォルトとする理由は同じです:フォーマットが従来のテンプレートベースのOCRには多様すぎるため、そして抽出エラー—誤ったGPA、見落とされたコース単位—の影響が、ほとんどのビジネスドキュメント処理シナリオよりも大きいためです。
教育現場の文書種類
教育エコシステムにおける各文書タイプには、それぞれ固有の抽出課題があります。その範囲を理解することで、学校向けの画一的なOCRアプローチがほとんど機能しない理由が明確になります。
1. 学業成績証明書
成績証明書は、教育文書の中でも大規模処理が最も複雑なものです。米国の高校の成績証明書1枚には通常、生徒の氏名、生年月日、卒業日、累積GPA(加重・非加重)、クラス順位(該当する場合)、学年別の履修科目一覧、各科目の最終成績、取得単位数、出席記録、標準テストのスコアが含まれます。国際的な成績証明書では、言語の壁、異なる評価尺度(パーセント方式、アルファベット方式、IBの1〜7段階、英国Aレベルのタリフポイント)、および資格評価の要件が加わります。
中核となる抽出課題は、GPAは固定ラベルではないということです。ある学校では「Grade Point Average」と呼び、別の学校では「Cumulative GPA」、また別の学校では「Academic Standing」という欄に配置し、加重GPAと非加重GPAの両方をラベルなしで表示する学校もあります。テンプレートベースのOCRシステムでは、これらのバリエーションごとに個別の設定が必要です。ストーニーブルック大学では、成績証明書を処理する従来のOCRツールで最大55%のエラー率が発生しました。これはOCRが文字を読み取れなかったからではなく、ページ上のどの数字がGPAなのかを確実に判別できなかったからです。
2. 入学・登録フォーム
入学フォームは、せいぜい半構造化されている程度です。全米の学区では異なるフォームレイアウトを使用しており、PowerSchoolやInfinite Campusなどの学生情報システム(SIS)で生成されるものもあれば、紙の原本からコピーされたものもあります。主要フィールド(生徒の法的氏名、生年月日、保護者・後見人の連絡先、前籍校)はほぼすべてのフォームに存在しますが、それぞれの配置は異なります。
手書き要素がさらなる困難をもたらします。保護者の署名、手書きの緊急連絡先電話番号、医療情報シートは、従来のOCRでは抽出失敗の一般的な原因となっています。手書き文字認識でトレーニングされたAIモデルは、品質が合理的な手書き入学フォームで85〜95%の精度を達成していますが、フィールドレベルのばらつきは依然として大きいままです。電話番号の数字が1桁でも読みにくいと、連絡先フィールド全体が使用不能になる可能性があります。
3. 奨学金・給付関連の通知書類と授与文書
奨学金の授与通知書には構造化された財務データが含まれており、各教育機関はFAFSA/ISIRの記録と照合して検証する必要があります。授与金額、奨学金名、支給スケジュール、ローン条件は、機関ごとに異なる形式で表示されます。ここでの抽出の課題は文字認識というよりも、意味的マッピングにあります。同じ種類の援助(連邦ペル奨学金)でも、機関のテンプレートによって「Pell Grant」「Federal Pell」「PELL」「Pell Award」などと表記が異なる場合があります。意味的な理解がなければ、それぞれの表記の違いが個別のデータ入力判断を引き起こすことになります。
4. 標準化テストのスコアレポート
SAT、ACT、AP、IB、州の評価テストのスコアレポートには、それぞれ独自のレイアウト形式があり、さらに年度によっても形式にばらつきがあります。例えば、APのスコアレポートは2023年にレイアウト構造が変更され、旧形式に基づくテンプレートが使えなくなりました。これらの文書は通常短く(1〜2ページ)ですが、フィールドが密集しています。APのスコアレポート1ページには、複数の受験科目、スコア(1〜5の尺度)、成績評価の説明が列挙されています。ページ数が少ないにもかかわらず、高い抽出密度を誇り、フィールドレベルの正確さが求められます。
5. 個別教育計画(IEP)および特別支援教育関連文書
IEPは、K-12教育において最も法的に機密性の高い文書の一つです。生徒の障害分類、年間目標、合理的配慮、支援時間、進捗報告データが含まれており、生徒が学区を移る際には、これらすべてを正確にシステム間で転送する必要があります。おおよそ共通の形式に従う成績証明書とは異なり、IEPの構成は州、学区、さらには個々の学校によって大きく異なります。ある学区のIEPでは合理的配慮がチェックリスト形式で整理されている一方、別の学区では同じ情報が物語形式の段落に埋め込まれている場合もあります。
FERPA規制により、さらに複雑さが加わります。成績証明書には、生徒が一般教育の教室で特別支援教育の配慮を受けていたことを示してはなりません。米国教育省の公民権局(OCR)は、この点について複数の裁定を下しています。つまり、抽出システムは何を含めるかだけでなく、特定の出力から何を除外すべきかを把握している必要があるのです。
6. 卒業証書・修了証明書・資格証明書
卒業証書や修了証明書は、成績証明書ほどデータ密度は高くありませんが、検証上の重要性は非常に高いものです。偽造された卒業証書や、誤って転記された資格取得日は、発行機関の責任問題につながる可能性があります。卒業証書スキャンから卒業生の氏名、授与日、資格の種類、発行機関を抽出するには、伝統的なOCRエンジンが苦手とする装飾フォント、箔押し文字、非標準的なレイアウトに対応できるOCRが必要です。
教育分野における固有の抽出課題
文書の多様性に加えて、教育分野のOCRシステムは構造的な課題に直面しており、教育は文書抽出において最も困難な分野の一つとなっています。
機関をまたぐフォーマットの多様性
米国には4,000以上の学位授与機関と、約100,000校の公立K-12学校があります。その大多数が異なる成績証明書やフォームのレイアウトを使用しています。テンプレートベースのOCRアプローチ(各フォーマットに事前設定されたテンプレートが必要)では、維持管理が不可能なほどの負担に直面します。新しい提携校が増えるたび、既存校がフォーマットを変更するたび、海外の成績証明書が来るたびに、新しいテンプレートか手動での対応が必要になるからです。
AIを活用した抽出は、フォーマット非依存であることでこの問題を解決します。モデルはデータがページのどこにあるかを学習するのではなく、データが意味的にどのように見えるかを学習します。周囲の文脈に「GPA」や「Grade Point Average」とあればGPAだと認識し、数字が特定の視覚的位置で単位数の隣にあればGPAだと認識します。従来のOCRは文字を識別しても意味を理解しませんが、AI抽出は人間と同じように文書を全体像と文脈で読み取ります。
GPA抽出の精度
GPAは成績証明書の中で最も重要な項目である一方、自動抽出において最もエラーが発生しやすい項目でもあります。2つの問題が重なっています:
- 1つの文書に複数のGPAが存在する — 多くの成績証明書には、加重GPA、非加重GPA、さらに学期GPAと合わせて累積GPAが表示されることがあります。誤ったGPAを抽出すると、学生の入学資格の分類が変わってしまう可能性があります。
- スケールの曖昧さ — 4.0スケールでのGPA 4.0と、5.0スケールでの4.0は同じ業績ではありませんが、文書にはスケールが明記されていないことがよくあります。抽出システムは、文脈からスケールを推測するか、外部の参照データを使用する必要があります。
高校の成績証明書処理におけるマルチエージェントAIシステムに関する2026年の研究論文では、多様な高校の成績証明書に対して96.7%の精度と100%の完了率を報告し、各成績証明書を45秒で処理し、コストは$0.15でした。この論文は、GPA抽出が抽出品質全体の主要な「信頼シグナル」であると特定しました。GPAが正しければ、他のフィールドもほぼ確実に正しいということです。
手書き・歴史的な紙文書アーカイブ
数十年分の紙の記録から移行しようとする学校は、何世代もの生徒にわたるデジタル化のバックログに直面しています。多くの入学願書、特別支援教育の記録、古い成績証明書は、手書きの原本またはコピーとしてのみ存在します。手書きの難しさは、インクの品質のばらつき、経年劣化した紙、記入方法の不統一(ペンで記入された欄、鉛筆で記入された欄、空欄のままの欄)によってさらに複雑になります。
これは従来のOCRでは実用的な精度基準を下回るシナリオですが、多様な手書きサンプルで学習された最新のビジョン・ランゲージモデルは、より高い割合の文書から実用的なデータを抽出できます。歴史的アーカイブへの実践的なアプローチは、人間がループに参加するレビューパイプラインです。AIが最初のパスを処理し、低信頼度のフィールドにフラグを立て、訓練されたレビュアーがそれらの特定の値を検証または修正します。
システム間のデータ整合性
抽出されたGPAや入学日は、大学のSIS(Ellucian Banner、Workday Student、PowerSchoolなど)の正しいフィールドに格納されて初めて有用になります。多くのOCRツールはデータをスプレッドシートに抽出しますが、SIS統合は手動ステップのまま残します。抽出ツールを評価する教育IT部門は、自動インポート用の構造化CSV/JSONデータをエクスポートするか、SISプラットフォームにAPI経由で直接接続するソリューションを優先すべきです。
従来方式とAI抽出の比較
| 項目 | 従来のOCR/テンプレート方式 | AI抽出 |
|---|---|---|
| フォーマット対応 | 各機関のレイアウトごとに個別テンプレートが必要 | 事前設定なしで任意のレイアウトを読み取り |
| GPA抽出 | ゾーン方式:位置がずれると誤ったGPAを抽出する恐れ | 意味論的方式:意味と文脈からGPAを識別 |
| 手書き | 筆記体や混在する手書きフォームでは精度50%未満 | 品質が妥当な手書きで85〜95%の精度 |
| スケール対応 | 手動ラベル付けなしでは4.0と5.0のGPAスケールを区別できない | 文脈からスケールを推論(例:「AP」コース→加重スケール) |
| フォーマット変更への対応 | テンプレートが破綻し、手動での再設定が必要 | 自動的に適応し、メンテナンス不要 |
| 国際文書 | 国別テンプレートが必要で、想定外のレイアウトには対応不可 | 多言語・未知のフォーマットにも対応 |
| セットアップ時間 | テンプレート作成とテストに数週間〜数ヶ月 | 数分:文書をアップロードし、フィールドを指定して抽出 |
決定的な違い: 従来のOCRは文字を認識するだけで意味を理解しません。AIによる抽出はドキュメントを意味的に読み取ります — 「Cumulative GPA」の隣にある「3.75」が入学資格を左右する数字だと理解し、同じ3文字がコースコード列にあればまったく別のものだと判断します。
文書タイプ別の主要抽出フィールド
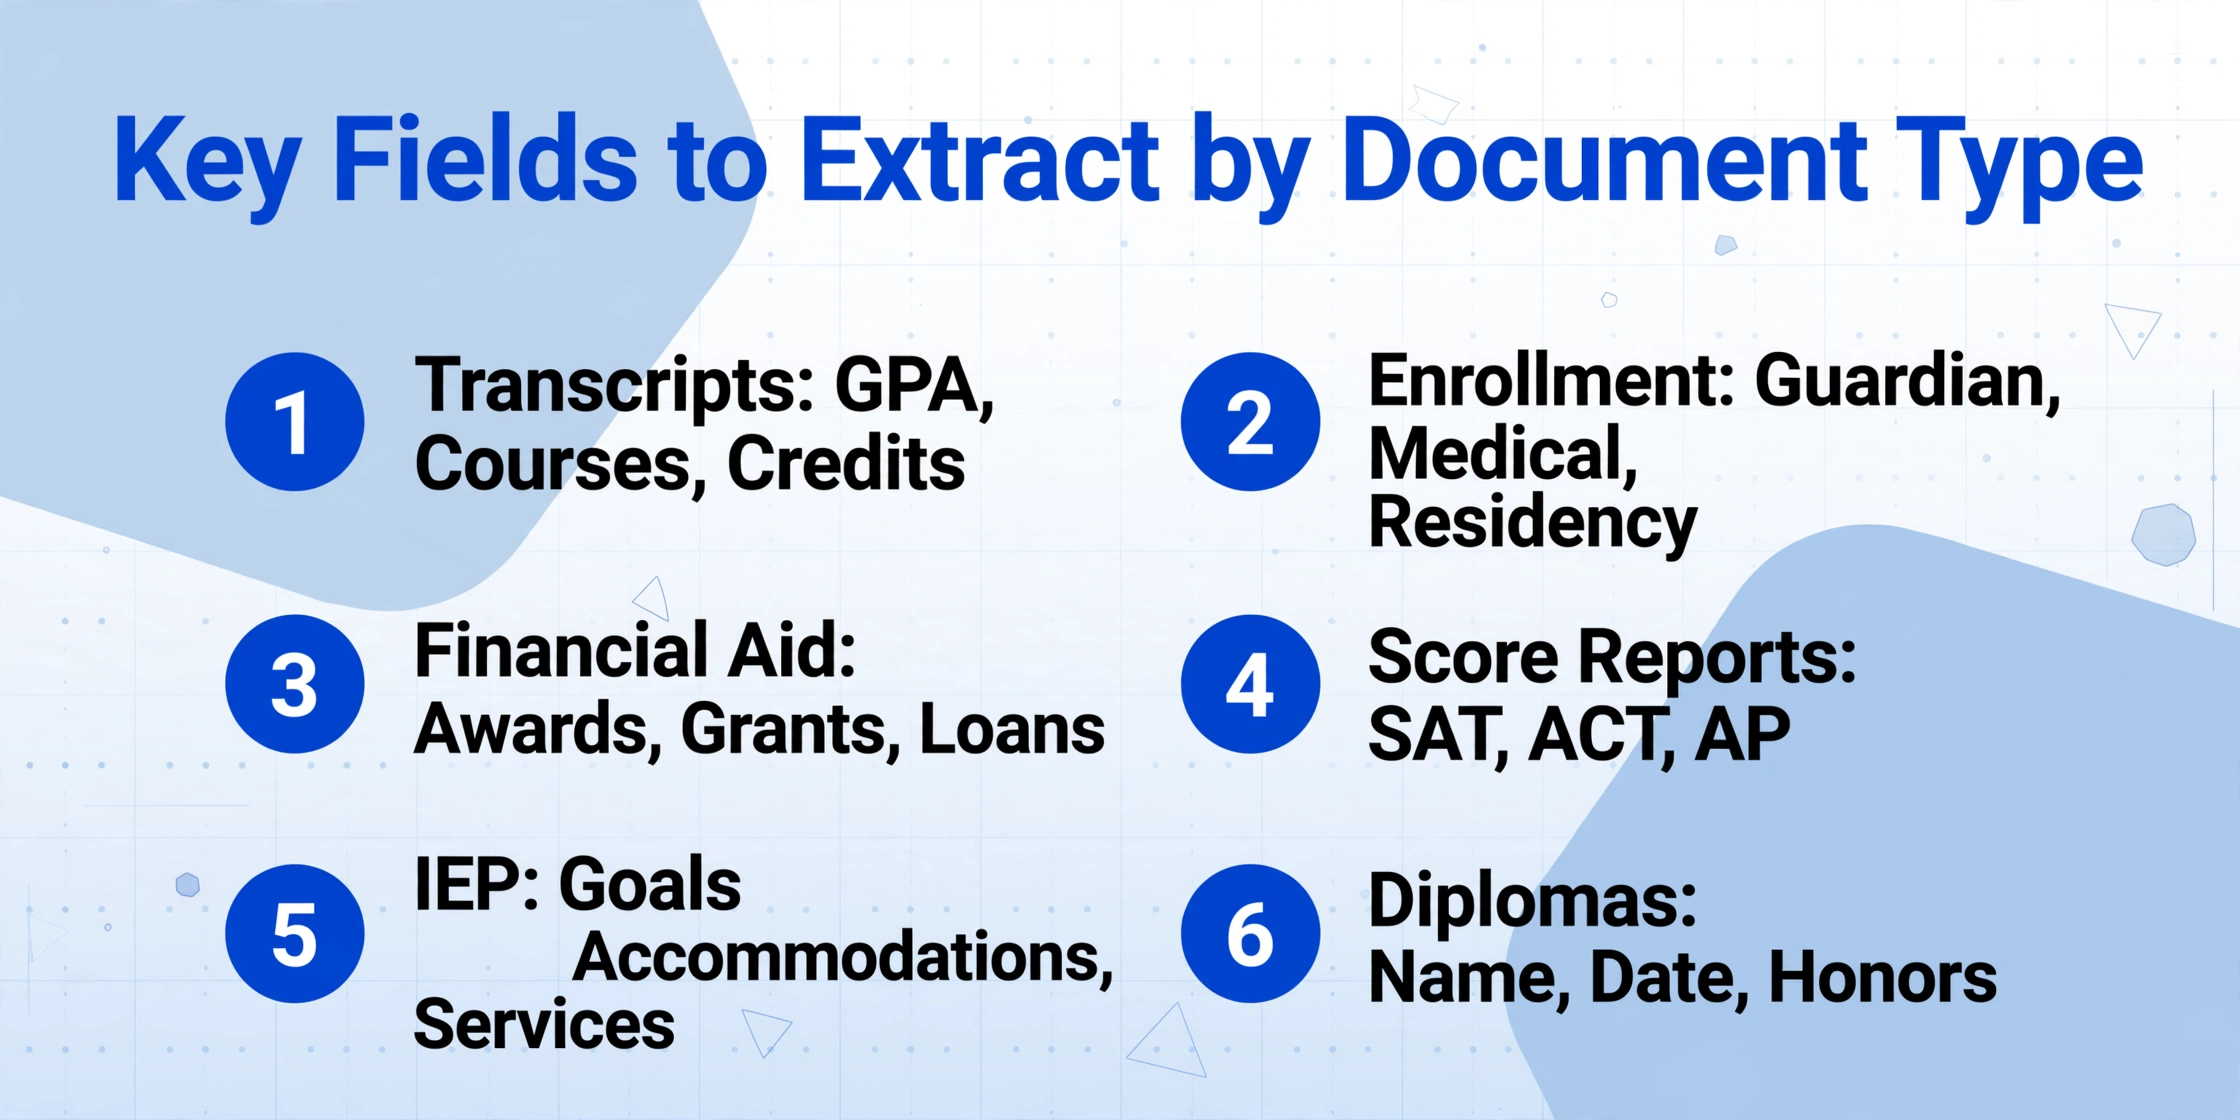
以下は、主要な教育文書タイプにおける最も重要なフィールドのリファレンス表です。抽出の導入を計画している教育機関は、このリストを出発点として、自機関のワークフロー要件に合わせてカスタマイズしてください。
| 文書タイプ | 主要フィールド | 主要な抽出課題 |
|---|---|---|
| 成績証明書 | 学生名、生年月日、GPA(加重・非加重)、クラス順位、成績付きコース一覧、単位数、卒業日、成績評価スケール | 複数のGPA、スケールの曖昧さ、機関ごとのコースコードの差異 |
| 入学フォーム | 学生の正式名、生年月日、住所、保護者名、連絡先情報、前籍校、学年、緊急連絡先、医療アラート | 手書きフィールド、半構造化レイアウト、フィールドラベルの欠落や不整合 |
| 奨学金受給通知書 | 受給額、奨学金名、助成金タイプ(Pell、SEOG、機関内)、ローン条件、支給スケジュール、学年度 | 同じ助成金タイプでも名称が不統一 |
| SAT/ACT/APスコアレポート | 学生名、受験日、科目スコア、総合スコア、パーセンタイル順位、スコアスケール | 多科目の密集レイアウト、受験年度によるフォーマット変更 |
| IEP / 特別支援教育文書 | 学生名、障害分類、年間目標、合理的配慮、サービス時間、IEP日付、レビュー日付、ケースマネージャー | 構造のばらつきが大きい、叙述形式とチェックリスト形式の混在、FERPA機密情報 |
| 卒業証明書 / 修了証書 | 卒業生名、授与日、資格タイプ、発行機関、優等称号 | 装飾的なフォント、金箔、非標準レイアウト、スキャン時のコントラスト不足 |
カスタム列抽出アプローチを採用する教育機関 — 抽出したいフィールド名を入力するだけでAIが意味的に特定してくれる方式 — では、この表がそのまま設定ガイドとして機能します。サンプル文書上の各フィールドにゾーンを描画する必要があるテンプレートベースのツールとは異なり、意味的抽出ではフィールド名を入力するだけで新しいフィールドを追加できます。新しい提携校が「GPA」を「Academic Index」と表記した成績証明書を送ってきても、新しいテンプレートは不要です — AIが文脈から一致を推論します。
FERPAとコンプライアンス:OCRシステムが対応すべき事項
家庭教育権利およびプライバシー法(FERPA)は、1974年に制定され、34 CFR Part 99に規定されており、米国教育省から連邦資金を受けているすべての教育機関における学生の教育記録のプライバシーを管理しています。OCRまたはAIベースの文書抽出を検討している学校にとって、FERPAは、抽出システムとその導入が対応しなければならない特定の義務を生み出します。これは、法務文書OCRがFRCPおよびABAモデル規則を満たさなければならないのと同様ですが、親の同意と開示追跡に関する独自の要件があります。
FERPAが保護するもの
FERPAは「教育記録」を広く定義しています。学生に直接関連し、教育機関またはその代理人によって維持される記録です。これには、成績証明書、成績、GPA計算、クラススケジュール、懲戒記録、特別教育記録(IEPを含む)、および学校が維持する健康・予防接種記録が明示的に含まれます。学校が第三者製の文書抽出ツールを使用してこれらの記録を処理する場合、FERPAの要件は、学校自体に適用されるのと同様に、ツールとそのデータ処理にも適用されます。
文書抽出システムの主要要件
- アクセス制御 — 「正当な教育上の利益」を持つ職員のみが学生記録にアクセスできます。抽出システムは、ロールベースのアクセス制御を実施し、各文書を閲覧またはエクスポートした人物の監査ログを維持する必要があります。
- 開示追跡 — FERPAは、教育記録からの個人を特定できる情報への各アクセス要求と各開示の記録を維持することを機関に義務付けています。抽出プラットフォームは、すべてのデータエクスポートと共有アクションをデフォルトでログに記録する必要があります。
- 保護者および対象学生の権利 — 未成年の学生の保護者および対象学生(18歳以上または高等教育機関に在籍する学生)は、要求から45日以内に教育記録を閲覧する権利があります。デジタル化された記録は、その期間内に取得・提出可能でなければなりません。
- 第三者サービス義務 — 学生の教育記録を保存、処理、または送信する第三者抽出プロバイダーは、FERPAの使用制限を遵守することを契約上義務付けられなければなりません。学校は、導入前にベンダーのデータセキュリティ慣行、暗号化基準、およびサブプロセッサー契約を評価する必要があります。
FERPAに基づく記録保存期間
FERPA自体は特定の保存期間を定めていませんが、州法や認定要件が実用的な最低期間を定めています。一般的な業界標準は以下のとおりです:
- 一時記録(出席データ、成績名簿、スケジュール関連文書)— 学生が機関を離れた後、少なくとも5年間保存します。
- 永久記録(成績証明書、卒業証書、公式テストスコア、最終懲戒記録)— 少なくとも60年間保存します。
この枠組み内で動作するOCRまたはAI抽出システムは、同等の期間、抽出データを保存し、データの完全性を保証し、標準形式(CSV、JSON、XLSX)でエクスポート可能にする必要があります。これにより、元の抽出ツールに関係なく記録へのアクセスが維持されます。
特別支援教育文書に関する特別な考慮事項
IEPおよび特別支援教育記録には、追加のコンプライアンス上の注意点があります。米国教育省公民権局は、成績証明書に、一般教育の教室で学生が合理的配慮を受けたことを示す特別な表記、アスタリスク、または記号を記載してはならないと判断しています。IEPデータを扱う同じシステムから成績証明書データを出力する抽出パイプラインは、障害関連のマーカーが誤って成績証明書フィールドに引き継がれないようにする必要があります。
これは、テンプレートベースのOCRシステムが対応するのに苦労するコンプライアンス要件です。これらのシステムは、特定の出力にどのコンテンツを含めることが許可されているかを理解せずに、ゾーン内のものを抽出するだけです。セマンティック抽出システムは出力ルールを適用できます。「合理的配慮:時間延長」がIEPデータセットに属する一方で、成績証明書フィードからは除外する必要があることを理解します。
教育用OCRツールに求めるべき点
すべての文書抽出ツールが教育ワークフローに適しているわけではありません。学生記録処理用のソリューションを選択する際に評価すべき具体的な基準は次のとおりです:
このツールは、フィールドがどこにあるかだけでなく、そのフィールドが何を意味するかを理解する必要があります。新しい提携校の成績証明書でGPAフィールドが別の場所に配置されただけで抽出が失敗するようでは、教育現場での大規模利用には適していません。
ロールベースのアクセス制御、保存時および転送時の暗号化、監査ログ、FERPAコンプライアンスに関する契約上のコミットメントが必要です。ベンダーが署名済みのFERPAデータ保護契約を提示できない場合は、次に進みましょう。
教育現場はバッチワークフローです。200件の成績証明書が一度に届き、1件ずつ処理されることはありません。ツールは複数の文書を同時に処理し、抽出した各値を特定の文書にマッピングした単一の集計テーブルに結果を統合できる必要があります。
入学フォーム、許可書、過去の記録のかなりの部分に手書きの記入が含まれています。ツールの手書き文字認識機能は、これらの文書を手動転記なしで処理できるかどうかを直接左右します。
フィールドが明確にマッピングされたCSVおよびJSONエクスポートにより、ITチームはEllucian、Workday、PowerSchool、その他のSISプラットフォームへの自動インポートパイプラインを構築できます。抽出データの手動再入力は、自動化の目的を無意味にします。
抽出されたすべての値の確実性が同じとは限りません。文書単位ではなくフィールド単位で信頼度スコアを報告するツールは、レビュー担当者がすべての項目を再確認するのではなく、確認が必要な10%のフィールドに検証作業を集中させることを可能にします。
よくある質問
OCRはどのような教育文書を処理できますか?
最新のAI搭載OCRは、学業成績証明書、入学・登録フォーム、奨学金受給通知書、標準テストのスコアレポート(SAT、ACT、AP、IB)、IEPおよび特別支援教育文書、卒業証書・修了証、予防接種記録、居住確認フォームなどを処理できます。重要なのは文書の種類ではなく、スキャンの品質と、固定位置ではなくフィールドの意味を理解できるツールの能力です。
成績証明書のGPA抽出におけるOCRの精度はどの程度ですか?
精度は、ツールが位置ベースのOCR(テンプレートマッチング)を使用するか、意味的AI抽出を使用するかに大きく依存します。テンプレートベースのシステムでは精度のばらつきが大きく、既知の形式では95%にも達する一方、馴染みのないレイアウトでは45%まで低下することがあります。学術的文脈を理解するAI搭載システムは、多様な成績証明書形式で95〜97%のフィールドレベル精度を達成しており、主な失敗要因は曖昧なGPAスケール表示です。多くの本番環境では、最も重要なフィールドに対して人間によるレビュー工程を自動抽出に併用しています。
第三者製のOCRツールを使用することはFERPAに準拠していますか?
はい、教育機関とベンダーがFERPAの要件を満たす場合に限ります。ベンダーは契約上「学校関係者」かつ「正当な教育的関心」を持つ者として指定され、学生データは保存時および転送時に暗号化され、アクセスは役割ベースで管理され、教育機関がデータの使用および保持方法を直接管理する必要があります。学校は、実際の学生記録を処理する前に、いずれかのベンダーから署名済みのFERPAコンプライアンス契約を取得する必要があります。
OCRは手書きの入学フォームを読み取れますか?
従来のOCRの手書き認識能力は限定的で、筆記体や混在する手書き文書では通常50%未満の精度です。手書きデータセットでトレーニングされた最新のAIビジョンモデルは、明瞭な手書きテキストで85〜95%、難易度の高い手書き(読みにくい筆跡、低コントラストのインク、重なるマーク)で70〜80%の精度を達成します。電話番号や法的氏名などの重要なフィールドについては、手書きコンテンツに対して人間によるレビュー工程を挟むことを推奨します。
学生記録にOCRを導入する費用はどのくらいかかりますか?
費用は、無料のオープンソースOCRエンジン(手動設定の労力が大きく、テンプレートの継続的なメンテナンスが必要)から、ページ単位または文書単位で課金されるサブスクリプション型のAI抽出ツールまで幅広くあります。年間10,000〜50,000件の文書を処理する中規模の教育機関の場合、AIを活用した抽出は通常、テンプレート設定費用なしで1ページあたり$0.10〜$0.50です。これは、データ入力、検証、システム更新を考慮した場合、職員の時間だけで1件の成績証明書あたり平均$3〜$6かかる手動処理の人件費と比較して有利です。
数十年分の歴史的な紙の記録をOCRでデジタル化できますか?
はい、ただし注意点があります。歴史的な紙のアーカイブには、現在受け付ける文書にはない課題があります。黄ばんだ紙はコントラストを低下させ、数十年にわたる手書き記録は異なる筆記具やスタイルを使用しており、古い成績証明書のレイアウトは現代のものとはほとんど似ていません。段階的なアプローチ(まず受け付ける文書から始めてワークフローを構築し、その後、人間によるレビュー工程を挟みながら歴史的アーカイブをバッチ処理する)が、単一の大規模デジタル化プロジェクトを試みるよりも現実的です。
教育記録の処理がボトルネックになる必要はありません。入学シーズン中も、成績証明書の評価も、過去の文書のデジタル化も、そうである必要はないのです。
文字を読み取るだけのツールと学術データを理解するツールの違いが、あなたのオフィスが1日50件の文書を処理するか500件を処理するかを左右します。テンプレート不要のセマンティック抽出では、必要なフィールド(学生名、GPA、コースコード、入学日など)を定義するだけで、AIが事前設定なしに、どの教育機関のどの文書形式でもそれらを特定します。
実際の学生記録でお試しください。次の成績証明書評価サイクルがどのように変わるかをご確認いただけます。