OCR para Educación:
Una Guía Completa para Expedientes Estudiantiles, Transcripciones y Formularios de Inscripción
El OCR para educación es la aplicación del reconocimiento de caracteres y la extracción de documentos con IA a los expedientes estudiantiles, incluidos transcripciones, formularios de inscripción, cartas de ayuda financiera, puntajes de exámenes estandarizados, IEP, diplomas y otros documentos académicos que las escuelas y universidades procesan por miles en cada ciclo de inscripción. A diferencia de la extracción de facturas o recibos, donde los formatos son relativamente estables, los documentos educativos provienen de miles de instituciones diferentes, cada una con su propio diseño, escala de calificaciones, sistema de créditos y terminología. La diferencia entre una herramienta que lee píxeles y una que entiende las estructuras de datos académicos determina si la oficina de su registrador procesa 50 transcripciones al día o 500.
Conclusiones Clave
- Una universidad mediana recibe 30,000 transcripciones en cada ciclo de admisiones y cada una aún requiere de 15 a 25 minutos de atención humana solo para localizar el GPA en la página, traducir la escala de calificaciones y escribir los nombres de los cursos en el sistema estudiantil.
- El OCR basado en plantillas produce una tasa de error del 55% en la extracción del GPA en formatos desconocidos porque más de 4,000 instituciones postsecundarias de EE. UU. organizan sus transcripciones de manera diferente, y las herramientas que confían en la posición de los píxeles en lugar del significado capturan el número equivocado cuando el diseño cambia aunque sea ligeramente.
- La IA semántica extrae una transcripción en 45 segundos con una precisión del 96.7% y a $0.15 por documento, porque lee el significado en lugar de las coordenadas de píxeles y no se rompe cuando la próxima escuela alimentadora coloca el GPA en una esquina diferente de la página.
¿Qué es OCR para la educación?
La tecnología de Reconocimiento Óptico de Caracteres convierte texto escaneado o fotografiado en caracteres legibles por máquina. Eso es cierto para cualquier industria. Lo que hace que OCR para la educación sea una categoría distinta es la naturaleza de los documentos que se procesan y lo que las escuelas realmente necesitan extraer de ellos.
La oficina de admisiones de una universidad no solo necesita leer un expediente académico — necesita extraer un valor de GPA específico, verificar que se calculó en una escala de 4.0 (no 4.3 o 5.0), identificar qué cursos son transferibles, comprobar si las horas de crédito son por semestre o por trimestre, y marcar cualquier duplicado. Un distrito K-12 que procesa formularios de inscripción necesita obtener información de contacto del tutor, registros escolares previos, estado de educación especial y elegibilidad para almuerzo gratuito o reducido de una pila de formularios escritos a mano o fotocopiados — cada uno con un formato diferente.
El OCR tradicional — que compara patrones de píxeles contra una base de datos de caracteres — puede digitalizar el texto de estos documentos. Pero no tiene comprensión de lo que representa un GPA, si "3.75" es un promedio de calificaciones o un número de curso, o que "09/01/2026" es una fecha de inscripción y no un monto de tarifa. Esa brecha semántica es la razón por la cual las instituciones educativas están avanzando más allá del OCR tradicional hacia la extracción de documentos impulsada por IA.
Por qué la educación necesita procesamiento automatizado de documentos
El volumen de papel que circula por un sistema escolar promedio es difícil de exagerar. Una sola universidad pública mediana en los Estados Unidos procesa de 20,000 a 30,000 solicitudes de pregrado por ciclo de admisiones. La Universidad Estatal de San Diego, por ejemplo, procesó más de 93,000 solicitudes solo para el otoño de 2018, y manejó más de 31,000 expedientes académicos universitarios ese año — el 18% de los cuales requirió procesamiento OCR porque llegaron como escaneos PDF en lugar de datos EDI estructurados.
Para los distritos K-12, la carga administrativa es diferente pero igualmente pesada. Una gran escuela autónoma pública virtual como Epic Charter Schools en Oklahoma procesó más de 15,000 registros de estudiantes en un solo período de inscripción utilizando un sistema de IA que clasificó más de 65 tipos de documentos — reduciendo el procesamiento por estudiante de horas a segundos.
El costo del procesamiento manual se acumula en cada tipo de documento que la institución maneja:
- Evaluación de expedientes académicos — Cada expediente entrante requiere que un miembro del personal lea los códigos de curso, convierta las calificaciones a la escala de la institución de origen, verifique la acreditación e ingrese los resultados manualmente. A 15-25 minutos por expediente, 30,000 solicitudes equivalen a 7,500 a 12,500 horas de trabajo por ciclo de admisiones.
- Formularios de inscripción — Los paquetes de registro para estudiantes nuevos generalmente contienen de 8 a 15 páginas separadas (contacto de emergencia, información de salud, comprobante de residencia, escolaridad previa). Las tasas de error en la entrada manual de datos en el procesamiento de formularios administrativos promedian 18-25%, siendo los campos más críticos — números de contacto del tutor y detalles de alerta médica — los que conllevan el mayor costo de error.
- Trámites de ayuda financiera — La verificación de datos de FAFSA, expedientes de impuestos y documentación de ingresos es uno de los flujos de trabajo más intensivos en documentos en la educación superior, a menudo requiriendo múltiples rondas de revisión de documentos por estudiante.
La mayoría de las escuelas todavía recurren al procesamiento manual por la misma razón: los formatos son demasiado variados para el OCR convencional basado en plantillas, y las consecuencias de un error de extracción — un GPA incorrecto, un crédito de curso omitido — son mayores que en la mayoría de los escenarios de procesamiento de documentos empresariales.
Tipos de Documentos en la Educación
Cada tipo de documento en el ecosistema educativo presenta sus propios desafíos de extracción. Comprender el alcance ayuda a aclarar por qué un enfoque de OCR único rara vez funciona para las escuelas.
1. Expedientes Académicos
Los expedientes son el documento educativo más complejo de procesar a escala. Un solo expediente de una escuela secundaria estadounidense generalmente incluye el nombre del estudiante, fecha de nacimiento, fecha de graduación, GPA acumulativo (ponderado y no ponderado), rango de clase (si aplica), una lista de cursos por año académico, calificaciones finales para cada curso, horas de crédito obtenidas, registros de asistencia y puntajes de exámenes estandarizados. Un expediente internacional añade barreras de idioma, diferentes escalas de calificación (basadas en porcentajes, letras, escala IB 1-7, puntos de arancel A-level del Reino Unido) y requisitos de evaluación de credenciales.
El desafío central de extracción: el GPA no es una etiqueta fija. Una escuela lo llama "Grade Point Average", otra usa "Cumulative GPA", una tercera lo coloca en un recuadro etiquetado como "Academic Standing", y algunas solo muestran un GPA ponderado junto a uno no ponderado sin etiquetar ninguno. Un sistema de OCR basado en plantillas necesita una configuración separada para cada una de estas variaciones. En la Universidad de Stony Brook, las herramientas de OCR heredadas que procesaban expedientes produjeron tasas de error de hasta el 55% — no porque el OCR no pudiera leer los caracteres, sino porque no podía identificar de manera confiable cuál número en la página era el GPA.
2. Formularios de Inscripción y Registro
Los formularios de inscripción son semiestructurados en el mejor de los casos. Los distritos escolares de todo el país utilizan diferentes diseños de formularios, algunos generados por sistemas de información estudiantil (SIS) como PowerSchool o Infinite Campus, otros fotocopiados de originales en papel. Los campos clave — nombre legal del estudiante, fecha de nacimiento, contacto del padre/tutor, escuela anterior — están presentes en casi todos los formularios, pero posicionados de manera diferente en cada uno.
El elemento manuscrito añade dificultad adicional. Las firmas de los padres, los números de contacto de emergencia escritos a mano y las hojas de información médica son fuentes comunes de fallos de extracción para el OCR tradicional. Los modelos de IA entrenados en reconocimiento de escritura manual ahora logran una precisión del 85-95% en formularios de inscripción manuscritos de calidad razonable, pero la variabilidad a nivel de campo sigue siendo significativa — un dígito mal escrito en un número de teléfono puede inutilizar todo el campo de contacto.
3. Cartas de Ayuda Financiera y Documentos de Adjudicación
Las cartas de adjudicación de ayuda financiera contienen datos financieros estructurados que las instituciones deben verificar contra los registros de FAFSA/ISIR. Los montos de adjudicación, nombres de becas, calendarios de desembolso y términos de préstamos aparecen en formatos variables según la institución. El desafío de extracción aquí tiene menos que ver con el reconocimiento de caracteres y más con el mapeo semántico — el mismo tipo de ayuda (una Beca Federal Pell) podría etiquetarse como "Pell Grant," "Federal Pell," "PELL" o "Pell Award" dependiendo de la plantilla de la institución. Sin comprensión semántica, cada variación genera una decisión separada de entrada de datos.
4. Informes de Puntajes de Exámenes Estandarizados
Los informes de puntajes de SAT, ACT, AP, IB y evaluaciones estatales tienen cada uno sus propias convenciones de diseño — y dentro de ellas, variaciones de formato entre años. Los informes de puntajes AP cambiaron su estructura de diseño en 2023, por ejemplo, rompiendo plantillas construidas sobre formatos más antiguos. Estos documentos suelen ser cortos (1-2 páginas) pero densos en campos: una sola página de informe de puntajes AP enumera múltiples materias de examen, puntajes (escala 1-5) y descriptores de rendimiento. El bajo número de páginas enmascara una alta densidad de extracción que exige precisión a nivel de campo.
5. Programas de Educación Individualizada (IEP) y Documentos de Educación Especial
Los IEP se encuentran entre los documentos más sensibles legalmente en la educación K-12. Contienen la clasificación de discapacidad del estudiante, metas anuales, adaptaciones, minutos de servicio y datos de informes de progreso — todo lo cual debe transferirse con precisión entre sistemas cuando un estudiante cambia de distrito. A diferencia de los expedientes académicos que siguen convenciones vagamente compartidas, las estructuras de los IEP varían drásticamente según el estado, el distrito e incluso la escuela individual. Un IEP de un distrito podría organizar las adaptaciones en formato de lista de verificación, mientras que otro incorpora la misma información en párrafos narrativos.
Las regulaciones de FERPA añaden una capa adicional: el expediente académico nunca debe indicar que un estudiante recibió adaptaciones de educación especial en un aula de educación general. La Oficina de Derechos Civiles (OCR) del Departamento de Educación de EE. UU. ha emitido múltiples fallos sobre este punto — lo que significa que el sistema de extracción debe saber qué excluir de ciertos resultados, no solo qué incluir.
Diplomas y Certificados
Los diplomas y certificados de finalización contienen menos datos que los expedientes académicos, pero conllevan una alta exigencia de verificación. Un diploma falsificado o una credencial transcrita incorrectamente puede generar responsabilidad legal para la institución emisora. Extraer el nombre del graduado, la fecha de concesión, el tipo de credencial y la autoridad emisora de escaneos de diplomas requiere OCR que maneje fuentes ornamentadas, texto en lámina dorada y diseños no estándar, condiciones que superan a los motores de OCR tradicionales.
Desafíos Únicos de Extracción en Educación
Más allá de la variedad a nivel de documento, los sistemas de OCR en educación enfrentan desafíos estructurales que convierten a la educación en uno de los verticales más difíciles para la extracción de documentos:
Variedad de Formatos entre Instituciones
Hay más de 4,000 instituciones postsecundarias que otorgan títulos en los Estados Unidos y aproximadamente 100,000 escuelas públicas K-12. La gran mayoría utiliza diferentes diseños de expedientes y formularios. Un enfoque de OCR basado en plantillas — donde cada formato requiere una plantilla preconfigurada — enfrenta una carga de mantenimiento imposible: cada nueva escuela de origen, cada rediseño de formato por una escuela existente y cada expediente internacional requiere una nueva plantilla o un respaldo manual.
La extracción impulsada por IA resuelve esto siendo independiente del formato. En lugar de aprender dónde se ubican los datos en una página, el modelo aprende cómo se ven los datos semánticamente: reconoce un GPA porque el contexto circundante dice "GPA" o "Grade Point Average" o porque el número se encuentra junto a un total de créditos en una posición visual específica. El OCR tradicional identifica caracteres sin comprenderlos; la extracción con IA lee el documento como lo haría un humano: de manera holística y contextual.
Precisión en la Extracción de GPA
El GPA es el campo más crítico en un expediente académico y, sin embargo, también es el más propenso a errores en la extracción automática. Dos problemas se combinan:
- Múltiples GPA en un solo documento — Muchos expedientes muestran un GPA ponderado, un GPA no ponderado y, a veces, un GPA acumulativo junto con un GPA del período. Extraer el incorrecto puede cambiar la clasificación de elegibilidad de admisión de un estudiante.
- Ambigüedad de escala — Un GPA de 4.0 en una escala de 4.0 no es el mismo logro que un 4.0 en una escala de 5.0, pero el documento a menudo no hace explícita la escala. El sistema de extracción debe inferir la escala del contexto o utilizar datos de referencia externos.
Un artículo de investigación de 2026 sobre sistemas de IA multiagente para el procesamiento de expedientes de secundaria reportó una precisión del 96.7% con tasas de finalización del 100% en diversos expedientes de secundaria, procesando cada expediente en 45 segundos a un costo de $0.15. El artículo identificó la extracción del GPA como la principal "señal de confianza" para la calidad general de la extracción: cuando el GPA era correcto, era abrumadoramente probable que el resto de los campos también fueran correctos.
Archivos históricos en papel y escritura a mano
Las escuelas que transitan desde décadas de registros en papel enfrentan un atraso de digitalización que abarca generaciones de estudiantes. Muchos formularios de inscripción, registros de educación especial y expedientes académicos antiguos existen solo como originales escritos a mano o fotocopias. La dificultad de la escritura a mano se agrava con la calidad variable de la tinta, el papel envejecido y la cumplimentación inconsistente de formularios: algunas secciones se llenan con bolígrafo, otras con lápiz y otras quedan en blanco.
Este es un escenario donde el OCR tradicional queda por debajo de los umbrales de precisión utilizables, pero los modelos modernos de visión y lenguaje entrenados con diversas muestras de escritura a mano pueden extraer datos utilizables de una mayor proporción de documentos. El enfoque práctico para archivos históricos es un flujo de revisión con supervisión humana: la IA realiza la primera pasada, marca los campos de baja confianza y un revisor capacitado valida o corrige esos valores específicos.
Consistencia de datos entre sistemas
Un GPA extraído o una fecha de inscripción solo es útil si llega al campo correcto del SIS de la institución (Ellucian Banner, Workday Student, PowerSchool, etc.). Muchas herramientas de OCR extraen datos a una hoja de cálculo, pero dejan la integración con el SIS como un paso manual. Los departamentos de TI educativos que evalúan herramientas de extracción deben priorizar soluciones que exporten datos estructurados en CSV/JSON para importación automatizada o que se conecten directamente mediante API a su plataforma SIS.
Método tradicional vs. extracción con IA
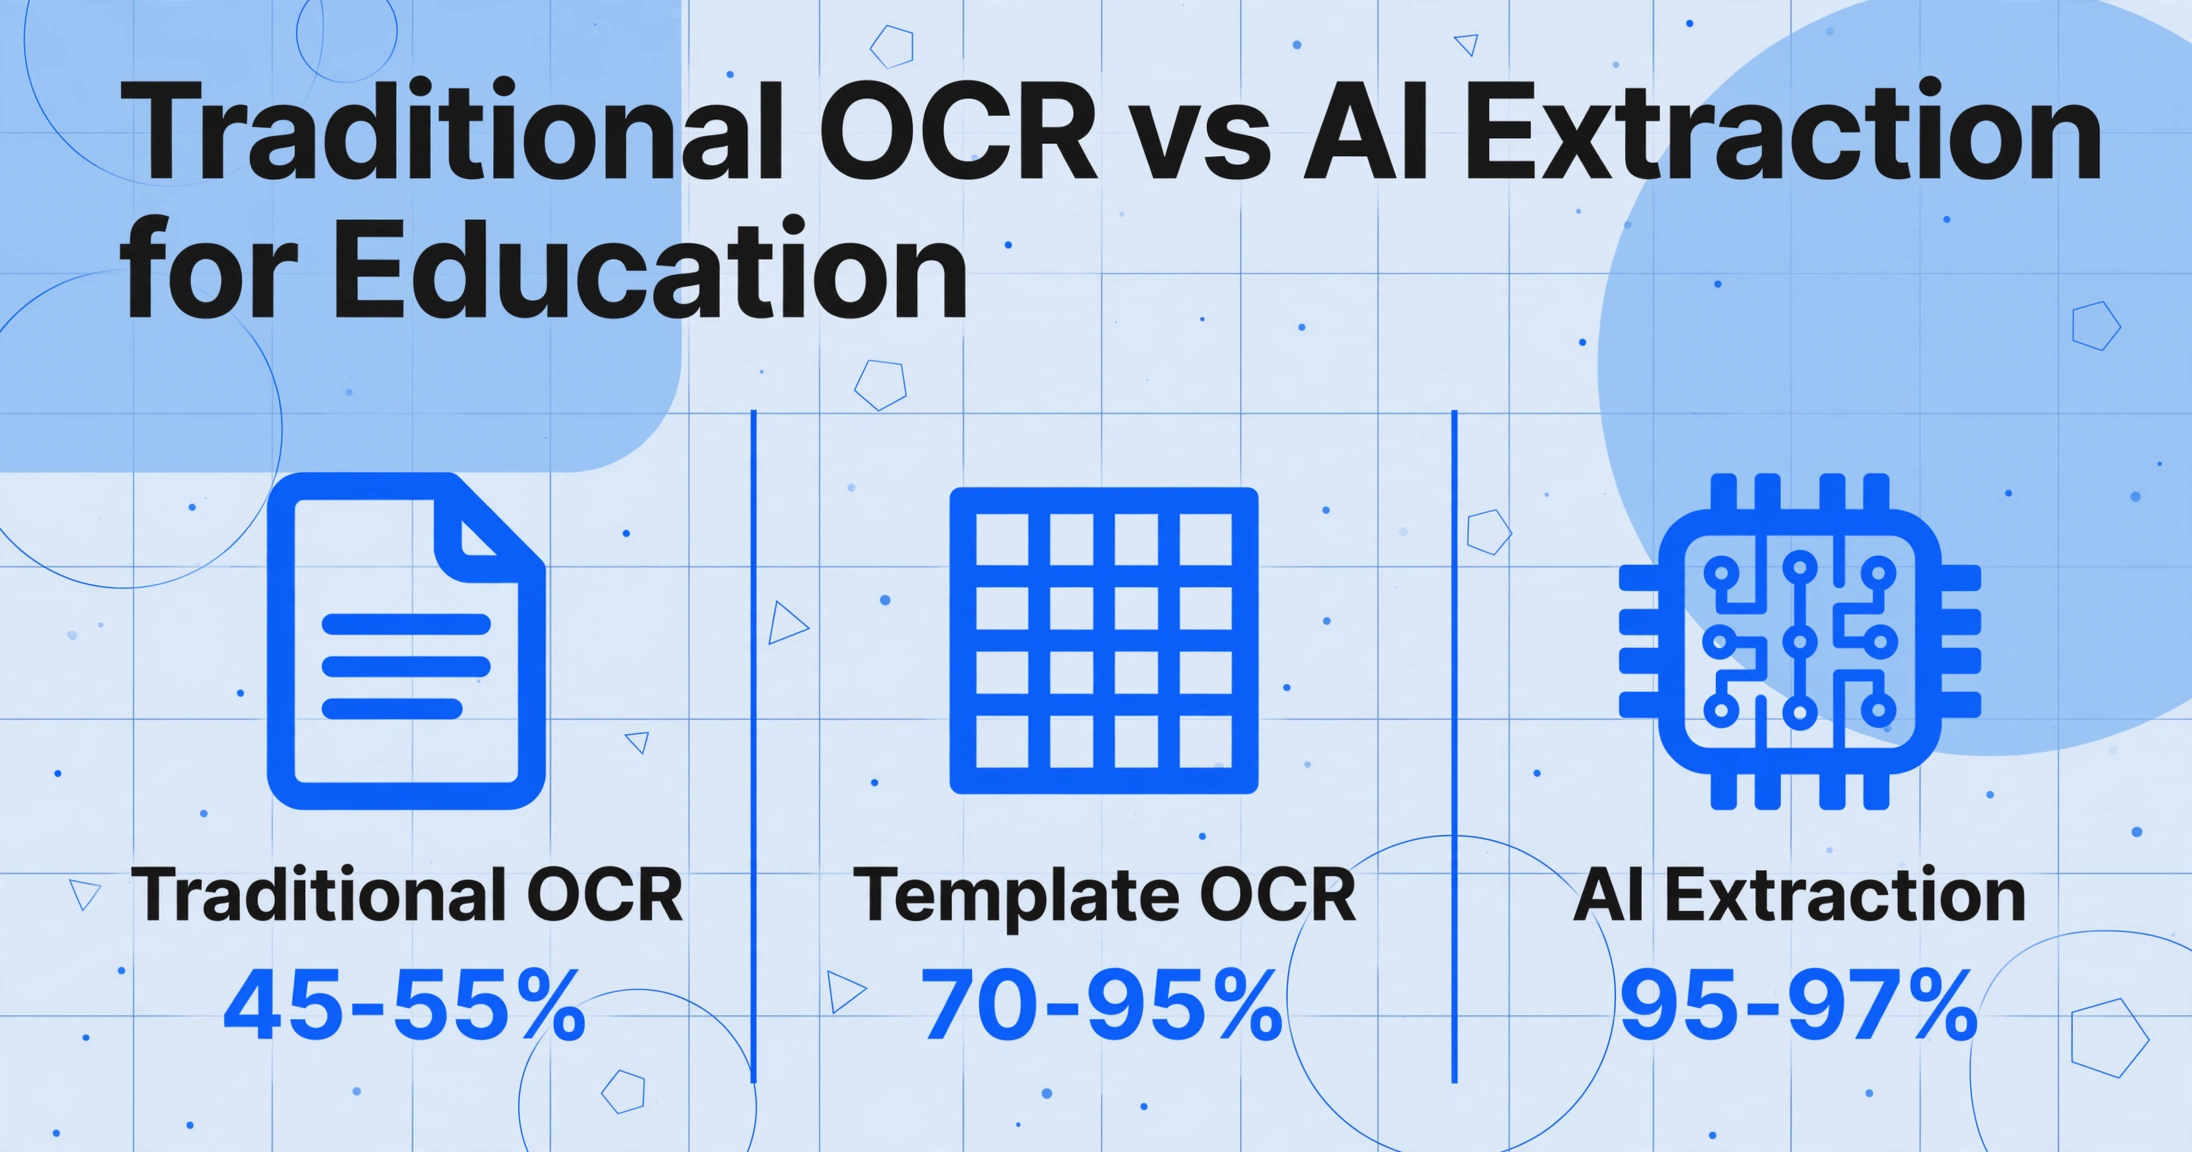
| Dimensión | OCR tradicional / enfoque con plantillas | Extracción con IA |
|---|---|---|
| Manejo de formatos | Requiere una plantilla separada para el diseño de cada institución | Lee cualquier diseño sin configuración previa |
| Extracción de GPA | Basada en zonas: propensa a extraer el GPA incorrecto cuando la posición cambia | Semántica: identifica el GPA por significado y contexto |
| Escritura a mano | Menos del 50 % de precisión en formularios con escritura cursiva o mixta | 85-95 % de precisión en escritura a mano de calidad razonable |
| Manejo de escalas | No puede distinguir entre escalas de GPA de 4.0 y 5.0 sin etiquetado manual | Infiere la escala a partir del contexto (p. ej., cursos "AP" → escala ponderada) |
| Respuesta a cambios de formato | La plantilla se rompe; se requiere reconfiguración manual | Se adapta automáticamente; no requiere mantenimiento |
| Documentos internacionales | Se necesitan plantillas por país; falla con diseños no previstos | Maneja formatos multilingües y desconocidos |
| Tiempo de configuración | Semanas o meses de creación y prueba de plantillas | Minutos: suba un documento, nombre sus campos y extraiga |
La diferencia crítica: El OCR tradicional extrae caracteres sin comprenderlos. La extracción impulsada por IA lee un documento de forma semántica: sabe que "3.75" junto a "Cumulative GPA" es el número que determina la elegibilidad de admisión, mientras que los mismos tres caracteres en una columna de código de curso son algo completamente distinto.
Campos clave para extraer según el tipo de documento
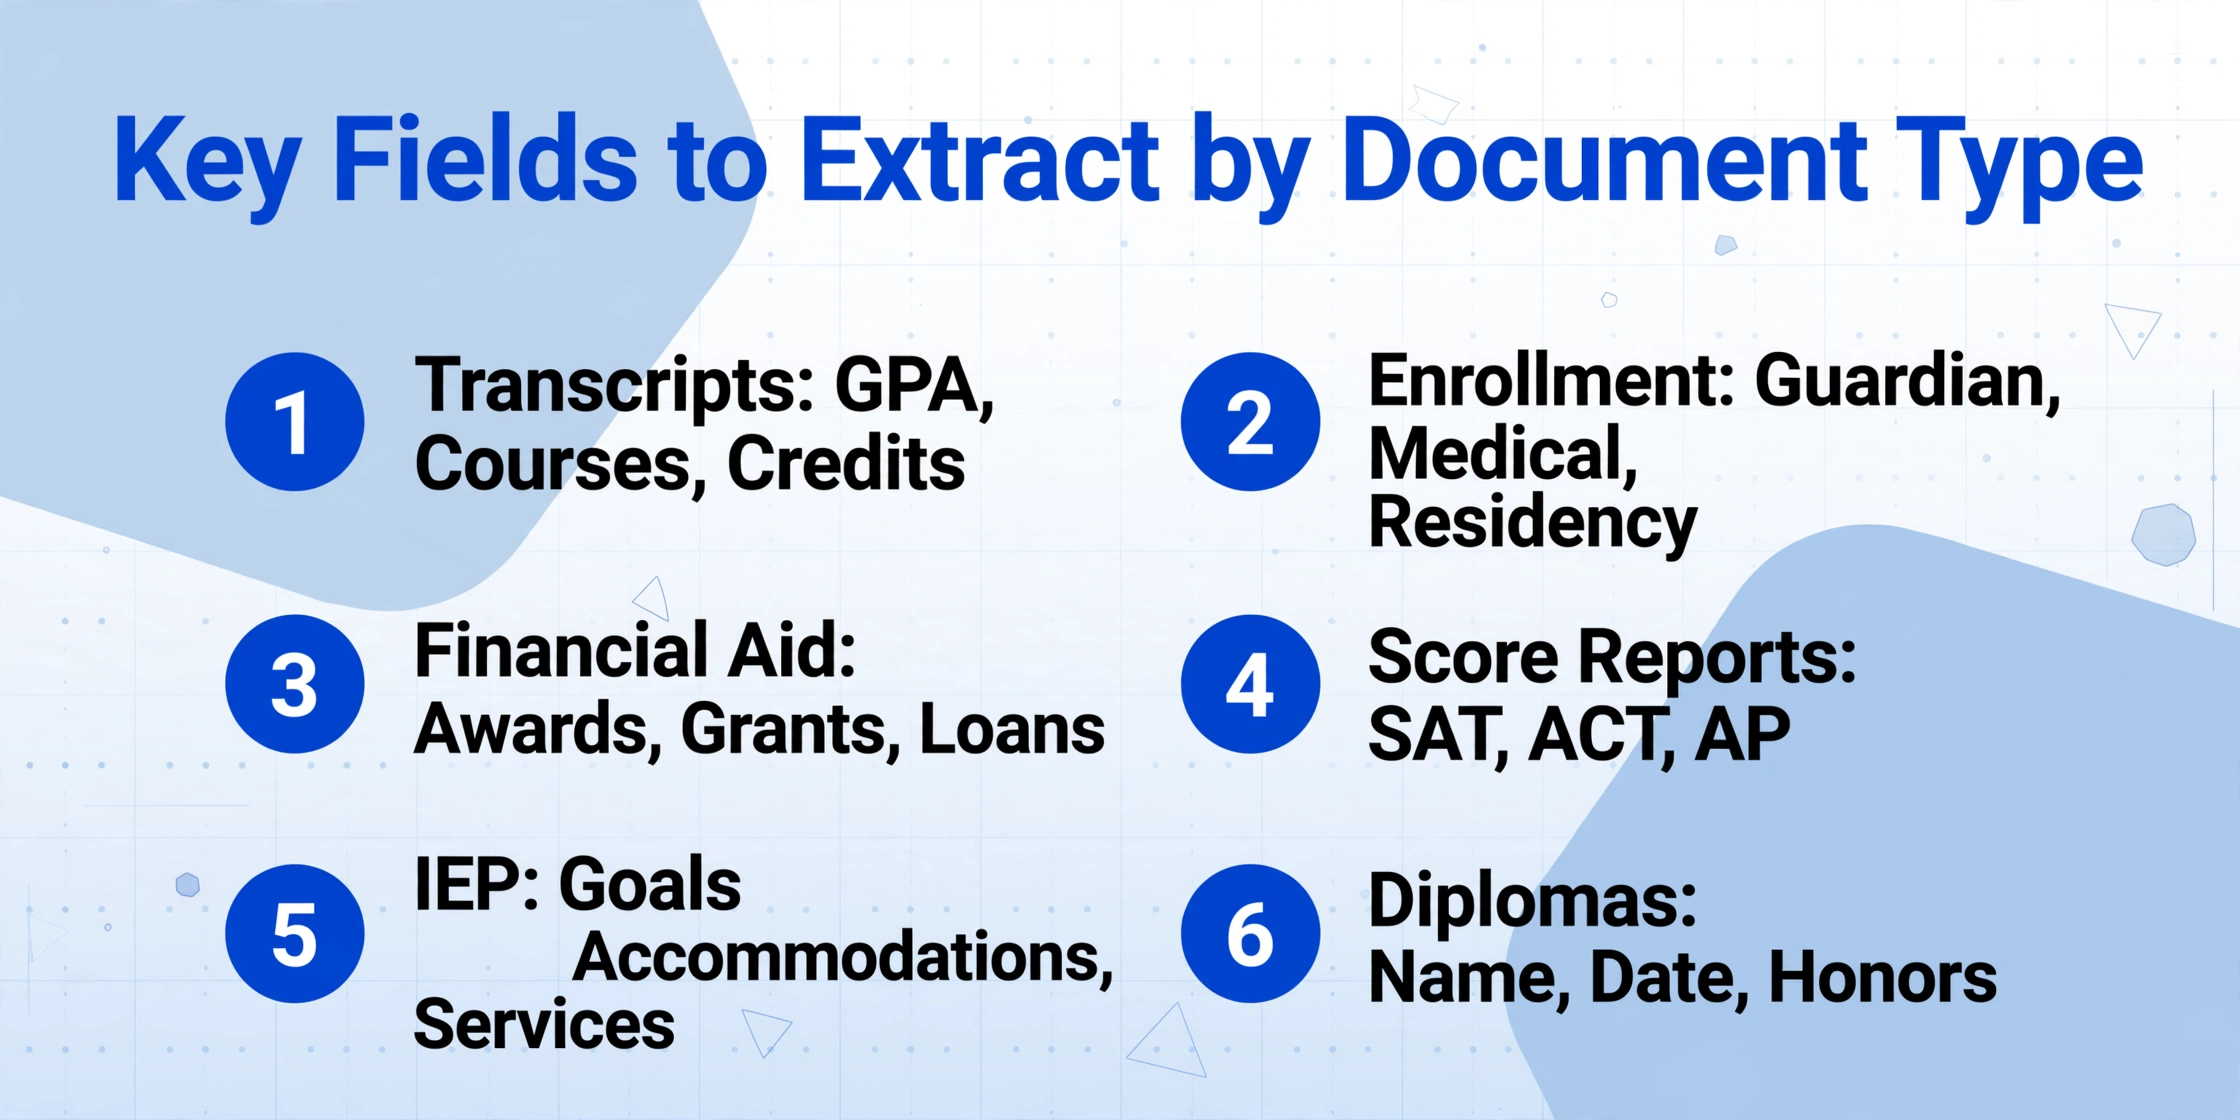
A continuación se presenta una tabla de referencia con los campos más importantes en los principales tipos de documentos educativos. Las instituciones que planeen implementar la extracción deben comenzar con esta lista y personalizarla según los requisitos específicos de su flujo de trabajo.
| Tipo de documento | Campos principales | Desafío clave de extracción |
|---|---|---|
| Expediente académico | Nombre del estudiante, fecha de nacimiento, GPA (ponderado y no ponderado), rango de clase, lista de cursos con calificaciones, horas de crédito, fecha de graduación, escala de calificaciones | Múltiples GPA, ambigüedad de escala, variación de códigos de curso entre instituciones |
| Formulario de inscripción | Nombre legal del estudiante, fecha de nacimiento, dirección, nombre del padre/tutor, información de contacto, escuela anterior, nivel de grado, contactos de emergencia, alertas médicas | Campos manuscritos, diseño semiestructurado, etiquetas de campo faltantes o inconsistentes |
| Carta de adjudicación de ayuda financiera | Montos adjudicados, nombres de becas, tipos de subvención (Pell, SEOG, institucional), condiciones del préstamo, calendario de desembolso, año académico | Convenciones de nomenclatura inconsistentes para el mismo tipo de ayuda |
| Informe de puntuación SAT/ACT/AP | Nombre del estudiante, fecha del examen, puntuaciones por materia, puntuación compuesta, rango percentil, escala de puntuación | Diseño denso de múltiples materias, cambios de formato entre años de examen |
| Documento IEP / Educación especial | Nombre del estudiante, clasificación de discapacidad, metas anuales, adaptaciones, minutos de servicio, fecha del IEP, fecha de revisión, administrador del caso | Amplia variación estructural, formatos narrativos frente a listas de verificación, contenido sensible según FERPA |
| Diploma / Certificado | Nombre del graduado, fecha de otorgamiento, tipo de credencial, autoridad emisora, designación de honores | Tipografías ornamentadas, lámina dorada, diseño no estándar, bajo contraste de escaneo |
Para las instituciones que utilizan un enfoque de Extracción de Columnas Personalizadas — donde simplemente escribe los nombres de los campos que desea y la IA los localiza semánticamente — esta tabla funciona también como guía de configuración. A diferencia de las herramientas basadas en plantillas que requieren dibujar zonas alrededor de cada campo en un documento de muestra, la extracción semántica le permite añadir nuevos campos simplemente escribiendo un nombre. Cuando una nueva escuela asociada envía un expediente que etiqueta el "GPA" como "Academic Index", no necesita una nueva plantilla: la IA infiere la coincidencia a partir del contexto.
FERPA y Cumplimiento: Qué Deben Abordar los Sistemas de OCR
La Ley de Derechos Educativos y Privacidad Familiar (FERPA), promulgada en 1974 y codificada en 34 CFR Parte 99, regula la privacidad de los registros educativos de los estudiantes en cualquier institución que reciba fondos federales del Departamento de Educación de EE. UU. Para las escuelas que consideran OCR o extracción de documentos basada en IA, FERPA crea obligaciones específicas que el sistema de extracción y su implementación deben cumplir — de manera similar a cómo el OCR de documentos legales debe cumplir con las Reglas Federales de Procedimiento Civil y las Reglas Modelo de la ABA, pero con sus propios requisitos distintivos en torno al consentimiento de los padres y el seguimiento de divulgaciones.
Qué Protege FERPA
FERPA define "registros educativos" de manera amplia: cualquier registro directamente relacionado con un estudiante y mantenido por una institución educativa o su agente. Esto incluye explícitamente expedientes académicos, calificaciones, cálculos de GPA, horarios de clases, registros disciplinarios, registros de educación especial (incluidos los IEP) y registros de salud/inmunización mantenidos por la escuela. Cuando una escuela utiliza una herramienta de extracción de documentos de terceros para procesar estos registros, los requisitos de FERPA se aplican a la herramienta y su manejo de datos como si fuera la propia escuela.
Requisitos Clave para Sistemas de Extracción de Documentos
- Controles de acceso — Solo el personal con un "interés educativo legítimo" puede acceder a los registros de los estudiantes. El sistema de extracción debe implementar controles de acceso basados en roles y mantener registros de auditoría de quién vio o exportó cada documento.
- Seguimiento de divulgaciones — FERPA exige que las instituciones mantengan un registro de cada solicitud de acceso y cada divulgación de información de identificación personal de los registros educativos. La plataforma de extracción debe registrar todas las exportaciones de datos y acciones de uso compartido de forma predeterminada.
- Derechos de los padres y estudiantes elegibles — Los padres de estudiantes menores y los estudiantes elegibles (mayores de 18 años o que asisten a una institución postsecundaria) tienen derecho a inspeccionar los registros educativos dentro de los 45 días posteriores a la solicitud. Los registros digitalizados deben poder recuperarse y producirse dentro de ese plazo.
- Obligaciones de servicios de terceros — Cualquier proveedor de extracción de terceros que almacene, procese o transmita registros educativos de estudiantes debe estar contractualmente obligado a cumplir con las restricciones de uso de FERPA. Las escuelas deben evaluar las prácticas de seguridad de datos de los proveedores, los estándares de cifrado y los acuerdos de subprocesamiento antes de la implementación.
Retención de registros según FERPA
FERPA en sí no prescribe períodos de retención específicos, pero las leyes estatales y los requisitos de acreditación establecen mínimos prácticos. El estándar común de la industria:
- Registros temporales (datos de asistencia, listas de calificaciones, documentos de programación) — conservar durante al menos 5 años después de que el estudiante se separe de la institución.
- Registros permanentes (expedientes académicos, diplomas, puntajes oficiales de exámenes, registros disciplinarios finales) — conservar durante al menos 60 años.
Un sistema de extracción por OCR o IA que opere dentro de este marco debe almacenar los datos extraídos durante un período comparable, con garantías de integridad de datos y exportabilidad en formatos estándar (CSV, JSON, XLSX) para que los registros permanezcan accesibles independientemente de la herramienta de extracción original.
Consideraciones especiales para documentos de educación especial
Los IEP y los registros de educación especial tienen matices adicionales de cumplimiento. La Oficina de Derechos Civiles del Departamento de Educación de EE. UU. ha determinado que los expedientes académicos no pueden indicar que un estudiante recibió adaptaciones en un aula de educación general mediante notaciones especiales, asteriscos o símbolos. Cualquier canal de extracción que genere datos de expedientes académicos desde el mismo sistema que maneja datos de IEP debe garantizar que los marcadores relacionados con discapacidades no se transfieran inadvertidamente a los campos del expediente académico.
Este es un requisito de cumplimiento que los sistemas de OCR basados en plantillas difícilmente cumplen: extraen lo que hay en la zona, sin comprender qué contenido es permisible incluir en una salida determinada. Los sistemas de extracción semántica pueden aplicar reglas de salida: entienden que "Adaptaciones: tiempo extendido" pertenece al conjunto de datos del IEP, pero debe excluirse del flujo del expediente académico.
Qué buscar en una herramienta de OCR para educación
No toda herramienta de extracción de documentos es adecuada para flujos de trabajo educativos. Estos son los criterios específicos a evaluar al seleccionar una solución para el procesamiento de registros estudiantiles:
La herramienta debe comprender qué significan los campos, no solo dónde se ubican. Si el campo de GPA falla porque un expediente de una nueva escuela de origen lo coloca en un rincón diferente de la página, la herramienta no es adecuada para la educación a escala.
Controles de acceso basados en roles, cifrado en reposo y en tránsito, registro de auditoría y compromisos contractuales de cumplimiento de FERPA. Si el proveedor no puede presentar un acuerdo de protección de datos FERPA firmado, siga adelante.
La educación es un flujo de trabajo por lotes: 200 expedientes llegan juntos, no uno a la vez. La herramienta debe procesar múltiples documentos de forma concurrente y fusionar los resultados en una única tabla agregada que asigne cada valor extraído a un documento específico.
Una parte significativa de los formularios de inscripción, autorizaciones y registros históricos incluyen entradas manuscritas. La capacidad de reconocimiento de escritura a mano de la herramienta determina directamente si puede procesar estos documentos sin transcripción manual.
Las exportaciones en CSV y JSON con campos claramente mapeados permiten a los equipos de TI crear canalizaciones de importación automatizadas hacia Ellucian, Workday, PowerSchool u otras plataformas SIS. La reentrada manual de los datos extraídos anula el propósito de la automatización.
No todos los valores extraídos son igualmente seguros. Una herramienta que informe puntuaciones de confianza por campo — no solo por documento — permite a los revisores centrar su esfuerzo de verificación en el 10% de los campos que lo necesitan, en lugar de volver a comprobar cada entrada.
Preguntas Frecuentes
¿Qué tipos de documentos educativos puede procesar el OCR?
El OCR moderno impulsado por IA puede procesar expedientes académicos, formularios de inscripción y registro, cartas de adjudicación de ayuda financiera, informes de puntuación de exámenes estandarizados (SAT, ACT, AP, IB), IEP y documentos de educación especial, diplomas y certificados, registros de vacunación y formularios de verificación de residencia. La variable clave no es el tipo de documento, sino la calidad del escaneo y la capacidad de la herramienta para comprender la semántica de los campos en lugar de posiciones fijas.
¿Qué tan preciso es el OCR para la extracción del GPA de expedientes académicos?
La precisión depende en gran medida de si la herramienta utiliza OCR basado en posiciones (coincidencia de plantillas) o extracción semántica con IA. Los sistemas basados en plantillas muestran una amplia variación en precisión — desde un 95% en formatos conocidos hasta un 45% en diseños desconocidos. Los sistemas impulsados por IA que comprenden el contexto académico alcanzan una precisión del 95-97% a nivel de campo en diversos formatos de expedientes, siendo el principal punto de fallo los indicadores ambiguos de escala de GPA. La mayoría de los despliegues de producción complementan la extracción automatizada con una capa de revisión humana para los campos de mayor importancia.
¿El uso de una herramienta OCR de terceros cumple con FERPA?
Sí, siempre que la institución y el proveedor cumplan con los requisitos de FERPA: el proveedor debe estar designado contractualmente como "funcionario escolar" con un "interés educativo legítimo"; los datos de los estudiantes deben estar cifrados en reposo y en tránsito; el acceso debe basarse en roles; y la institución debe mantener control directo sobre cómo se utilizan y retienen los datos. Las escuelas deben solicitar un acuerdo de cumplimiento de FERPA firmado a cualquier proveedor antes de procesar registros estudiantiles reales.
¿Puede el OCR leer formularios de inscripción escritos a mano?
El OCR tradicional tiene capacidad limitada para escritura a mano — típicamente por debajo del 50% de precisión en documentos cursivos o con escritura mixta. Los modelos modernos de visión con IA entrenados en conjuntos de datos de escritura manual alcanzan una precisión del 85-95% en texto manuscrito claro y del 70-80% en escritura difícil (mala caligrafía, tinta de bajo contraste, marcas superpuestas). Para campos críticos como números de teléfono o nombres legales, se recomienda un paso de revisión con intervención humana para contenido manuscrito.
¿Cuánto cuesta implementar OCR para registros de estudiantes?
Los costos varían desde motores OCR de código abierto gratuitos (con alto esfuerzo de configuración manual y mantenimiento continuo de plantillas) hasta herramientas de extracción con IA basadas en suscripción, con precios por página o por documento. Para instituciones de tamaño mediano que procesan entre 10,000 y 50,000 documentos al año, la extracción impulsada por IA suele costar entre $0.10 y $0.50 por página, sin cargos de configuración de plantillas. Esto resulta favorable frente al costo laboral del procesamiento manual, que promedia entre $3 y $6 por expediente académico solo en tiempo de personal, al considerar la entrada de datos, la verificación y las actualizaciones del sistema.
¿Podemos digitalizar décadas de registros históricos en papel con OCR?
Sí, pero con salvedades. Los archivos históricos en papel enfrentan desafíos que los documentos entrantes actuales no presentan: el papel envejecido o amarillento reduce el contraste, los registros manuscritos de varias décadas utilizan diferentes instrumentos y estilos de escritura, y los formatos de expedientes antiguos guardan poca semejanza con los modernos. Un enfoque por fases —comenzar con documentos entrantes para establecer el flujo de trabajo y luego procesar archivos históricos por lotes con una revisión humana— es más práctico que intentar un proyecto único de digitalización masiva.
El procesamiento de expedientes educativos no tiene que ser un cuello de botella, ni durante la temporada de inscripción, ni para la evaluación de transcripciones, ni para la digitalización histórica.
La diferencia entre una herramienta que lee caracteres y una que entiende los datos académicos determina si su oficina procesa 50 documentos al día o 500. Con la extracción semántica sin plantilla, usted define los campos que necesita (nombre del estudiante, GPA, códigos de curso, fechas de inscripción) y la IA los localiza en cualquier formato de documento, de cualquier institución, sin configuración previa.
Pruébela con sus propios expedientes estudiantiles. Vea cómo podría ser su próximo ciclo de evaluación de transcripciones.