OCR para Educação:
Um Guia Completo para Registros de Alunos, Históricos Escolares e Formulários de Matrícula
OCR para educação é a aplicação de reconhecimento de caracteres e extração de documentos por IA em registros de alunos — incluindo históricos escolares, formulários de matrícula, cartas de auxílio financeiro, resultados de testes padronizados, IEPs, diplomas e outros documentos acadêmicos que escolas e universidades processam aos milhares a cada ciclo de matrícula. Diferente da extração de faturas ou recibos, onde os formatos são relativamente estáveis, os documentos educacionais vêm de milhares de instituições diferentes, cada uma com seu próprio layout, escala de notas, sistema de créditos e terminologia. A diferença entre uma ferramenta que lê pixels e uma ferramenta que entende estruturas de dados acadêmicos determina se o seu escritório de registro processa 50 históricos por dia ou 500.
Principais Conclusões
- Uma universidade de médio porte recebe 30.000 históricos escolares a cada ciclo de admissão e cada um ainda exige de 15 a 25 minutos de atenção humana só para localizar o GPA na página, traduzir a escala de notas e digitar os nomes das disciplinas no sistema do aluno.
- O OCR baseado em modelo produz uma taxa de erro de 55% na extração de GPA em formatos desconhecidos porque mais de 4.000 instituições de ensino superior dos EUA organizam seus históricos de forma diferente, e ferramentas que confiam na posição dos pixels em vez do significado capturam o número errado quando o layout muda, mesmo que levemente.
- A IA semântica extrai um histórico escolar em 45 segundos com 96,7% de precisão e $0,15 por documento — porque lê o significado em vez das coordenadas dos pixels e não quebra quando a próxima escola coloca o GPA em um canto diferente da página.
O que é OCR para Educação?
A tecnologia de Reconhecimento Óptico de Caracteres (OCR) converte texto escaneado ou fotografado em caracteres legíveis por máquina. Isso vale para qualquer setor. O que torna o OCR para educação uma categoria distinta é a natureza dos documentos processados e o que as escolas realmente precisam extrair deles.
O setor de matrículas de uma universidade não precisa apenas ler um histórico escolar — precisa extrair um valor específico de GPA, verificar se foi calculado em escala 4.0 (não 4.3 ou 5.0), identificar quais disciplinas são transferíveis, verificar se as horas de crédito são baseadas em semestre ou trimestre e sinalizar quaisquer duplicatas. Um distrito de ensino básico processando formulários de matrícula precisa extrair informações de contato do responsável, registros escolares anteriores, status de educação especial e elegibilidade para alimentação gratuita/reduzida de uma pilha de formulários manuscritos ou fotocopiados — cada um formatado de maneira diferente.
O OCR tradicional — que compara padrões de pixels com um banco de dados de caracteres — consegue digitalizar o texto desses documentos. Mas não entende o que um GPA representa, se "3.75" é uma média de notas ou um número de disciplina, ou que "09/01/2026" é uma data de matrícula e não um valor de taxa. Essa lacuna semântica é a razão pela qual as instituições de ensino estão indo além do OCR tradicional em direção à extração de documentos com IA.
Por que a Educação Precisa de Processamento Automatizado de Documentos
O volume de papel que circula em um sistema escolar médio é difícil de exagerar. Uma única universidade pública de médio porte nos Estados Unidos processa de 20.000 a 30.000 inscrições de graduação por ciclo de admissão. A San Diego State University, por exemplo, processou mais de 93.000 inscrições somente para o outono de 2018 e lidou com mais de 31.000 históricos escolares naquele ano — 18% dos quais exigiram processamento por OCR porque chegaram como PDFs escaneados em vez de dados EDI estruturados.
Para distritos de ensino básico, a carga administrativa é diferente, mas igualmente pesada. Uma grande escola charter pública virtual como a Epic Charter Schools em Oklahoma processou mais de 15.000 registros de alunos em um único período de matrícula usando um sistema de IA que classificou mais de 65 tipos de documentos — reduzindo o processamento por aluno de horas para segundos.
O custo do processamento manual se multiplica em cada tipo de documento que a instituição manipula:
- Avaliação de históricos escolares — Cada histórico recebido exige que um funcionário leia códigos de disciplinas, converta notas para a escala da instituição de destino, verifique credenciamento e insira os resultados manualmente. A 15-25 minutos por histórico, 30.000 inscrições equivalem a 7.500 a 12.500 horas de trabalho por ciclo de admissão.
- Formulários de matrícula — Os pacotes de registro para novos alunos normalmente contêm de 8 a 15 páginas separadas (contato de emergência, informações de saúde, comprovante de residência, escolaridade anterior). As taxas de erro de entrada manual de dados no processamento de formulários administrativos ficam em média entre 18-25%, com os campos mais críticos — números de contato do responsável e detalhes de alerta médico — apresentando o maior custo de erro.
- Documentação de auxílio financeiro — A verificação de dados do FAFSA, transcrições fiscais e documentação de renda é um dos fluxos de trabalho mais intensivos em documentos no ensino superior, frequentemente exigindo múltiplas rodadas de revisão de documentos por aluno.
A maioria das escolas ainda recorre ao processamento manual pelo mesmo motivo: os formatos são muito variados para o OCR convencional baseado em modelo, e as consequências de um erro de extração — um GPA errado, um crédito de disciplina perdido — são maiores do que na maioria dos cenários de processamento de documentos empresariais.
Tipos de Documentos na Educação
Cada tipo de documento no ecossistema educacional apresenta seus próprios desafios de extração. Entender essa variedade ajuda a esclarecer por que uma abordagem de OCR única raramente funciona para as escolas.
1. Históricos Escolares
Os históricos escolares são o documento educacional mais complexo de processar em escala. Um único histórico de uma escola de ensino médio dos EUA normalmente inclui o nome do aluno, data de nascimento, data de formatura, GPA acumulado (ponderado e não ponderado), posição na turma (se aplicável), uma lista de disciplinas por ano letivo, notas finais de cada disciplina, horas de crédito obtidas, registros de frequência e pontuações de testes padronizados. Um histórico internacional acrescenta barreiras linguísticas, diferentes escalas de avaliação (baseada em porcentagem, baseada em letras, escala IB 1-7, pontos tarifários do A-level do Reino Unido) e requisitos de avaliação de credenciais.
O principal desafio de extração: o GPA não é um rótulo fixo. Uma escola o chama de "Grade Point Average", outra usa "Cumulative GPA", uma terceira o coloca em uma caixa rotulada como "Academic Standing", e algumas mostram apenas um GPA ponderado ao lado de um não ponderado sem rotular nenhum dos dois. Um sistema de OCR baseado em modelo precisa de uma configuração separada para cada uma dessas variações. Na Stony Brook University, ferramentas de OCR legadas que processavam históricos escolares produziam taxas de erro de até 55% — não porque o OCR não conseguia ler os caracteres, mas porque não conseguia identificar de forma confiável qual número na página era o GPA.
2. Formulários de Matrícula e Registro
Os formulários de matrícula são, na melhor das hipóteses, semiestruturados. Os distritos escolares de todo o país usam layouts de formulário diferentes, alguns gerados por sistemas de informação estudantil (SIS) como PowerSchool ou Infinite Campus, outros fotocopiados de originais em papel. Campos-chave — nome legal do aluno, data de nascimento, contato dos pais/responsável, escola anterior — estão presentes em quase todos os formulários, mas posicionados de forma diferente em cada um.
O elemento manuscrito adiciona mais dificuldade. Assinaturas dos pais, números de contato de emergência manuscritos e fichas de informações médicas são fontes comuns de falha de extração para o OCR tradicional. Modelos de IA treinados em reconhecimento de escrita manual agora alcançam 85-95% de precisão em formulários de matrícula manuscritos de qualidade razoável, mas a variabilidade no nível do campo continua significativa — um dígito mal escrito em um número de telefone pode tornar todo o campo de contato inutilizável.
3. Cartas de Auxílio Financeiro e Documentos de Bolsas
As cartas de concessão de auxílio financeiro contêm dados financeiros estruturados que as instituições devem verificar em relação aos registros FAFSA/ISIR. Valores de bolsas, nomes de bolsas, cronogramas de desembolso e condições de empréstimo aparecem em formatos variados entre as instituições. O desafio de extração aqui é menos sobre reconhecimento de caracteres e mais sobre mapeamento semântico — o mesmo tipo de auxílio (um Federal Pell Grant) pode ser rotulado como "Pell Grant", "Federal Pell", "PELL" ou "Pell Award", dependendo do modelo da instituição. Sem compreensão semântica, cada variação gera uma decisão separada de entrada de dados.
4. Relatórios de Pontuação de Testes Padronizados
Os relatórios de pontuação do SAT, ACT, AP, IB e avaliações estaduais têm cada um suas próprias convenções de layout — e, dentro delas, variações de formato ao longo dos anos. Os relatórios de pontuação do AP mudaram sua estrutura de layout em 2023, por exemplo, quebrando modelos criados com base em formatos mais antigos. Esses documentos geralmente são curtos (1-2 páginas), mas densos em campos: uma única página de relatório de pontuação do AP lista várias matérias de teste, pontuações (escala de 1 a 5) e descritores de desempenho. A baixa contagem de páginas mascara uma alta densidade de extração que exige precisão precisa no nível do campo.
5. Programas de Educação Individualizada (IEPs) e Documentos de Educação Especial
Os IEPs estão entre os documentos mais legalmente sensíveis na educação K-12. Eles contêm a classificação de deficiência de um aluno, metas anuais, adaptações, minutos de serviço e dados de relatórios de progresso — todos os quais devem ser transferidos com precisão entre sistemas quando um aluno muda de distrito. Diferentemente dos históricos escolares que seguem convenções vagamente compartilhadas, as estruturas dos IEPs variam drasticamente por estado, distrito e até mesmo escola individual. Um IEP de um distrito pode organizar as adaptações em formato de lista de verificação, enquanto outro incorpora as mesmas informações em parágrafos narrativos.
As regulamentações FERPA adicionam uma camada adicional: o histórico escolar nunca deve indicar que um aluno recebeu adaptações de educação especial em uma sala de aula de educação geral. O Office for Civil Rights (OCR) do Departamento de Educação dos EUA emitiu várias decisões sobre este ponto — o que significa que o sistema de extração deve saber o que excluir de certas saídas, não apenas o que incluir.
6. Diplomas, Certificados e Credenciais
Diplomas e certificados de conclusão são menos densos em dados do que históricos escolares, mas envolvem alto risco de verificação. Um diploma falsificado ou uma data de credencial transcrita incorretamente pode gerar responsabilidade para a instituição emissora. Extrair o nome do formando, a data de outorga, o tipo de credencial e a autoridade emissora de digitalizações de diplomas exige OCR que lide com fontes ornamentadas, texto em folha de ouro e layouts não padronizados — condições que derrubam os motores de OCR tradicionais.
Desafios Únicos de Extração na Educação
Além da variedade no nível dos documentos, os sistemas de OCR na educação enfrentam desafios estruturais que tornam a educação um dos setores mais difíceis para a extração de documentos:
Variação de Formato entre Instituições
Existem mais de 4.000 instituições de ensino superior que concedem diplomas nos Estados Unidos e cerca de 100.000 escolas públicas de ensino fundamental e médio. A grande maioria usa layouts diferentes de históricos escolares e formulários. Uma abordagem de OCR baseada em modelo — em que cada formato exige um modelo pré-configurado — enfrenta um ônus de manutenção impossível: cada nova escola de origem, cada reformulação de formato por uma escola existente e cada histórico escolar internacional exige um novo modelo ou um recurso manual alternativo.
A extração com IA resolve isso por ser independente de formato. Em vez de aprender onde os dados ficam na página, o modelo aprende como os dados se parecem semanticamente: ele reconhece um GPA porque o contexto ao redor diz "GPA" ou "Grade Point Average", ou porque o número fica ao lado de um total de créditos em uma posição visual específica. O OCR tradicional identifica caracteres sem compreendê-los; a extração com IA lê o documento como um humano faria — de forma holística e em contexto.
Precisão na Extração de GPA
O GPA é o campo mais crítico de um histórico escolar, mas também é o mais propenso a erros na extração automática. Dois problemas se somam:
- Vários GPAs em um mesmo documento — Muitos históricos escolares exibem um GPA ponderado, um GPA não ponderado e, às vezes, um GPA cumulativo ao lado de um GPA do período. Extrair o errado pode alterar a classificação de elegibilidade para admissão de um estudante.
- Ambiguidade de escala — Um GPA 4,0 em uma escala de 4,0 não é a mesma conquista que um 4,0 em uma escala de 5,0, mas o documento frequentemente não deixa a escala explícita. O sistema de extração deve inferir a escala a partir do contexto ou usar dados de referência externos.
Um artigo de pesquisa de 2026 sobre sistemas de IA multiagente para processamento de históricos escolares do ensino médio relatou 96,7% de precisão com 100% de taxas de conclusão em históricos escolares diversificados do ensino médio, processando cada histórico em 45 segundos a um custo de $0.15. O artigo identificou a extração de GPA como o principal "sinal de confiança" para a qualidade geral da extração — quando o GPA estava correto, os demais campos tinham probabilidade esmagadora de também estarem corretos.
Manuscritos e Arquivos de Papel Históricos
Escolas em transição de décadas de registros em papel enfrentam um acúmulo de digitalização que abrange gerações de alunos. Muitos formulários de matrícula, registros de educação especial e boletins mais antigos existem apenas como originais manuscritos ou fotocópias. A dificuldade da caligrafia se intensifica com a qualidade variável da tinta, o envelhecimento do papel e o preenchimento inconsistente dos formulários — algumas seções preenchidas a caneta, outras a lápis, outras deixadas em branco.
Este é um cenário em que o OCR tradicional fica abaixo dos limites de precisão utilizáveis, mas os modelos modernos de visão-linguagem treinados em diversas amostras de caligrafia conseguem extrair dados utilizáveis de uma proporção maior de documentos. A abordagem prática para arquivos históricos é um fluxo de revisão com humano no circuito: a IA processa a primeira passagem, sinaliza campos de baixa confiança e um revisor treinado valida ou corrige esses valores específicos.
Consistência de Dados entre Sistemas
Um GPA ou data de matrícula extraído só é útil se chegar ao campo correto do SIS da instituição (Ellucian Banner, Workday Student, PowerSchool, etc.). Muitas ferramentas de OCR extraem dados para uma planilha, mas deixam a integração com o SIS como uma etapa manual. Os departamentos de TI educacional que avaliam ferramentas de extração devem priorizar soluções que exportem dados estruturados em CSV/JSON para importação automatizada ou que se conectem diretamente via API à sua plataforma SIS.
Método Antigo vs Extração com IA
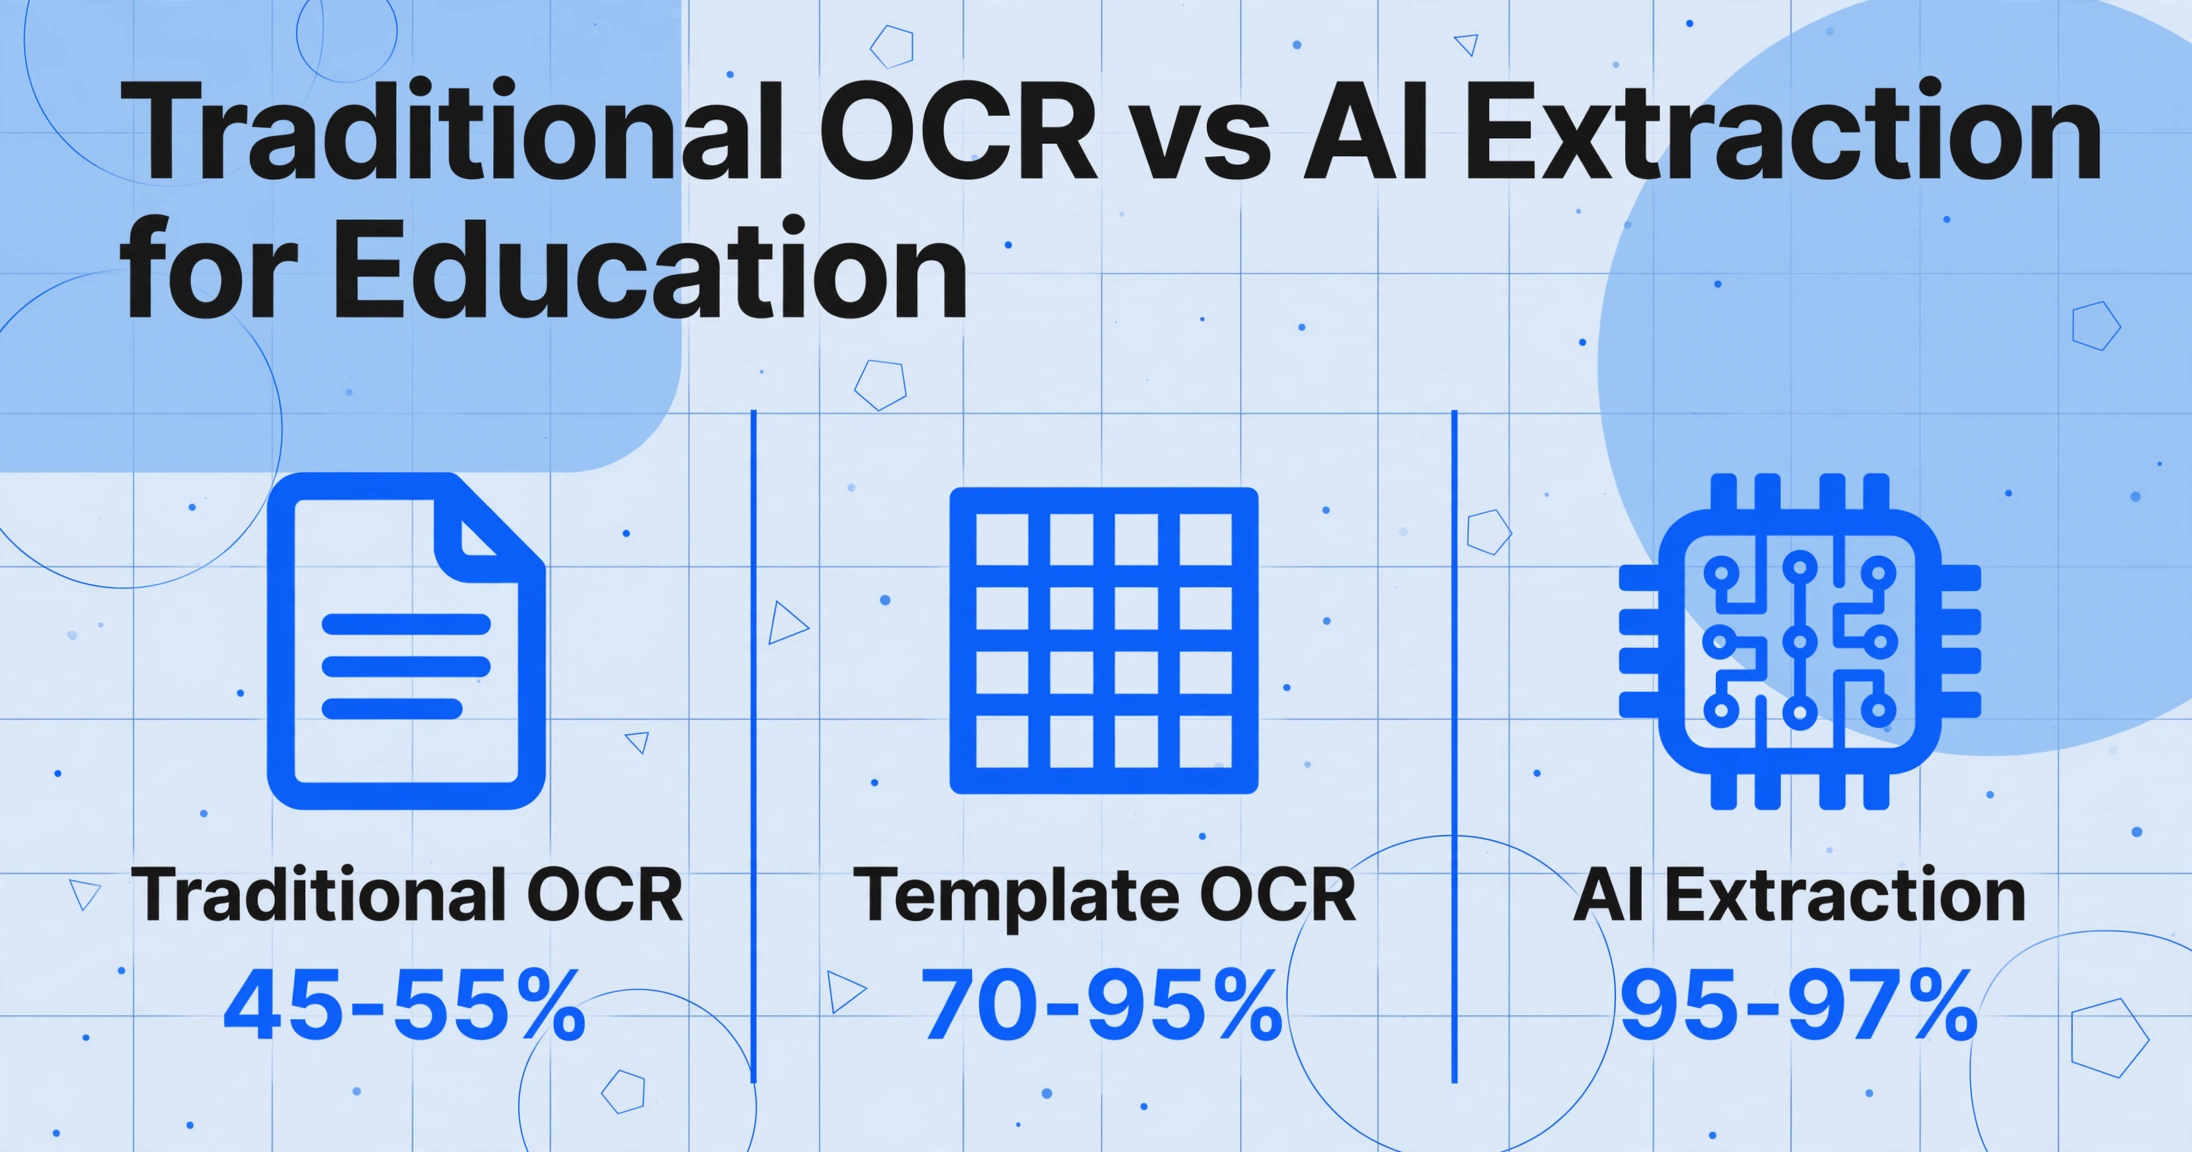
| Dimensão | Abordagem de OCR Tradicional / com modelo | Extração com IA |
|---|---|---|
| Tratamento de formato | Requer um modelo separado por layout de instituição | Lê qualquer layout sem pré-configuração |
| Extração de GPA | Baseada em zonas: propensa a extrair o GPA errado quando a posição muda | Semântica: identifica o GPA por significado e contexto |
| Caligrafia | Abaixo de 50% de precisão em formulários cursivos ou de caligrafia mista | 85-95% de precisão em caligrafia de qualidade razoável |
| Tratamento de escalas | Não consegue distinguir escalas de GPA 4.0 vs 5.0 sem rotulagem manual | Infere a escala pelo contexto (ex.: cursos "AP" → escala ponderada) |
| Resposta a mudanças de formato | O modelo quebra; é necessária reconfiguração manual | Adapta-se automaticamente; nenhuma manutenção necessária |
| Documentos internacionais | Modelos por país necessários; falha em layouts imprevistos | Lida com formatos multilíngues e desconhecidos |
| Tempo de configuração | Semanas a meses de criação e teste de modelos | Minutos: envie um documento, nomeie seus campos, extraia |
A diferença crítica: O OCR tradicional extrai caracteres sem entendê-los. A extração com IA lê um documento semanticamente — ela sabe que "3.75" ao lado de "Cumulative GPA" é o número que determina a elegibilidade para admissão, enquanto os mesmos três caracteres em uma coluna de código de curso são algo completamente diferente.
Campos Principais a Extrair por Tipo de Documento
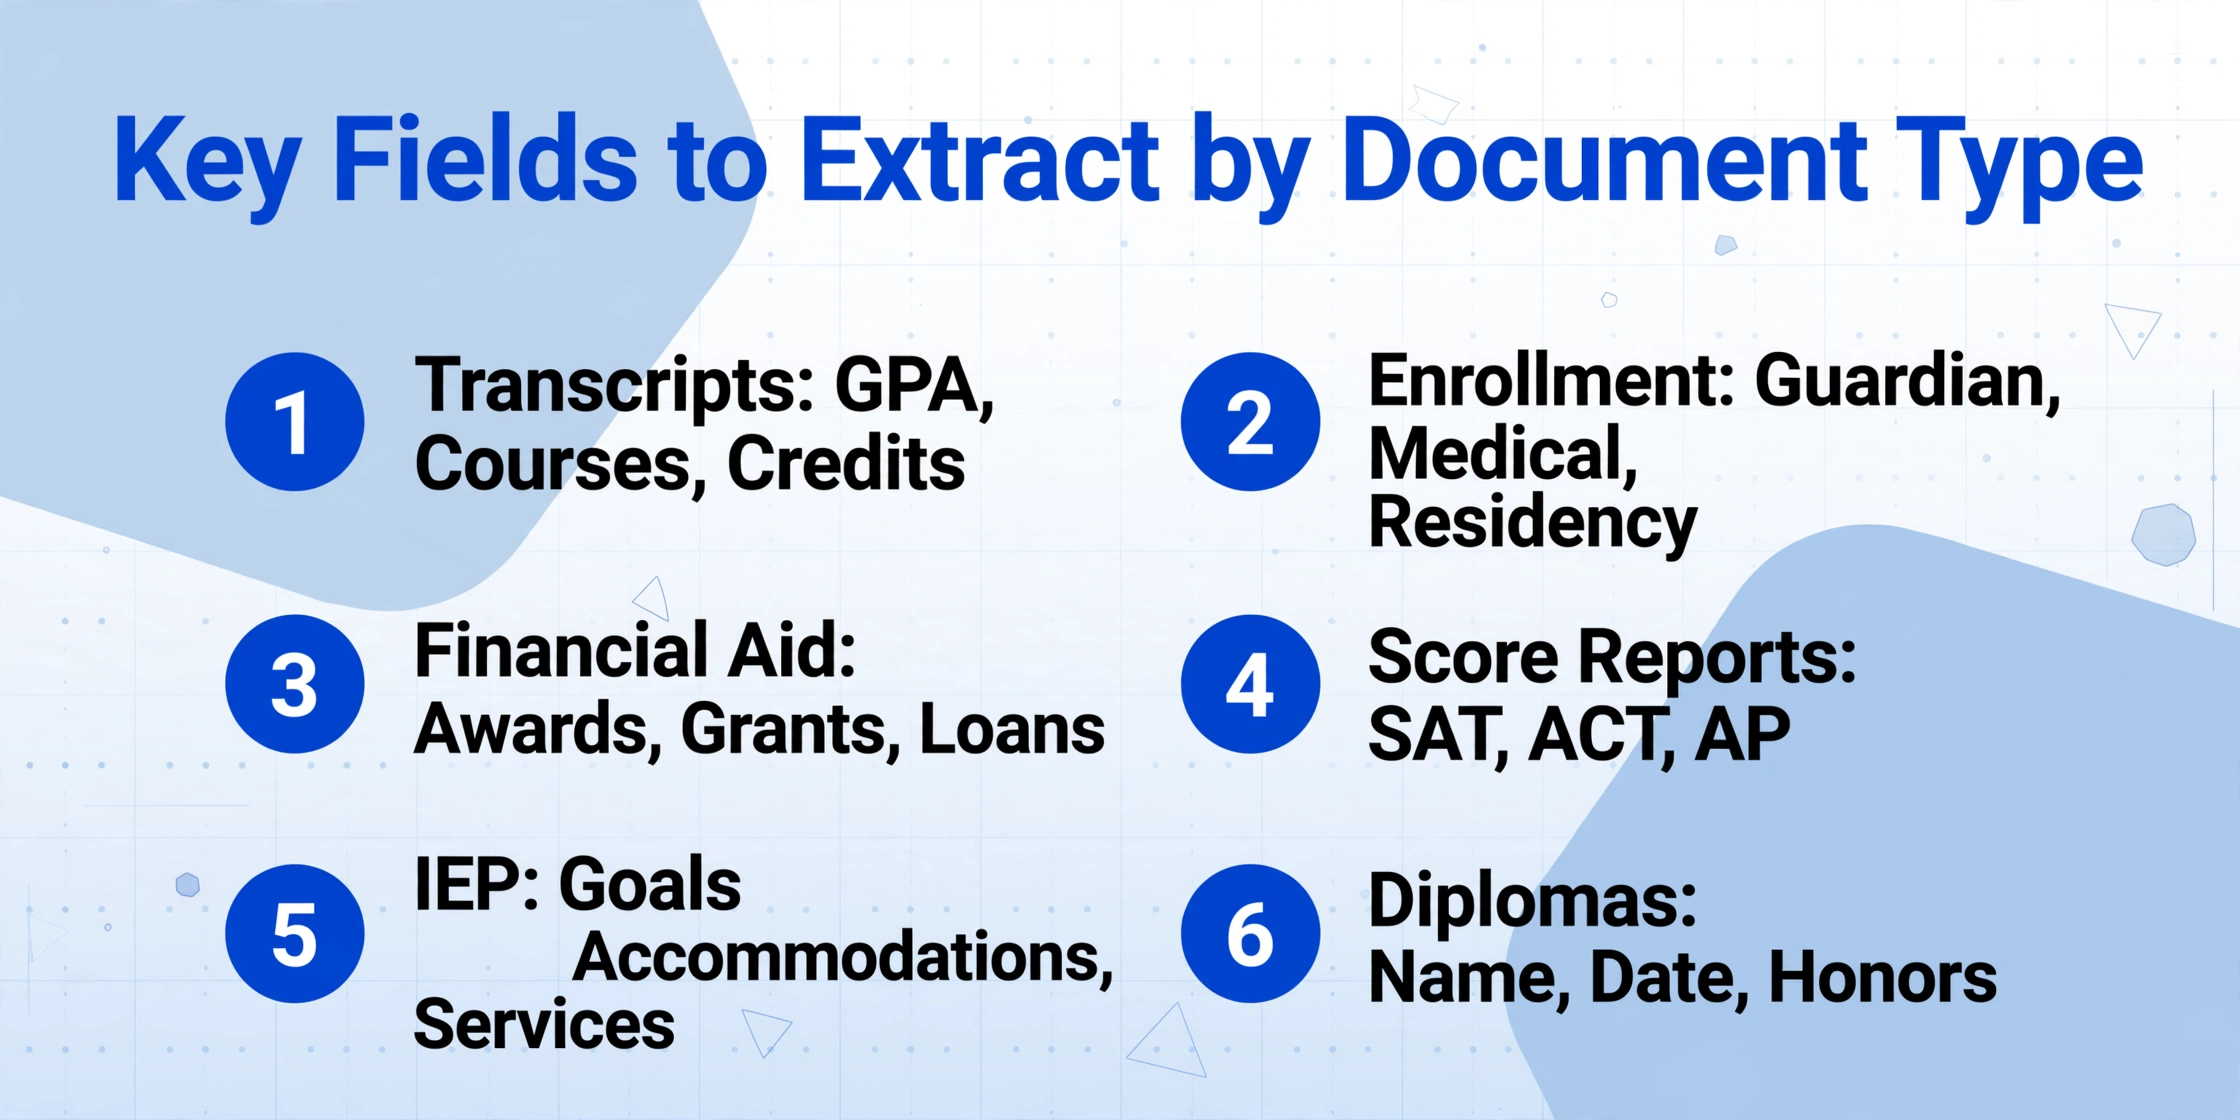
Abaixo está uma tabela de referência dos campos mais importantes entre os principais tipos de documentos educacionais. Instituições que planejam uma implantação de extração devem começar com esta lista e personalizá-la com base nos requisitos específicos de seu fluxo de trabalho.
| Tipo de Documento | Campos Principais | Principal Desafio de Extração |
|---|---|---|
| Histórico Escolar Acadêmico | Nome do aluno, data de nascimento, GPA (ponderado e não ponderado), posição na turma, lista de cursos com notas, horas de crédito, data de formatura, escala de notas | Múltiplos GPAs, ambiguidade de escala, variação de códigos de curso entre instituições |
| Formulário de Matrícula | Nome legal do aluno, data de nascimento, endereço, nome do pai/responsável, informações de contato, escola anterior, série, contatos de emergência, alertas médicos | Campos manuscritos, layout semiestruturado, rótulos de campo ausentes ou inconsistentes |
| Carta de Concessão de Auxílio Financeiro | Valores concedidos, nomes de bolsas, tipos de subsídio (Pell, SEOG, institucional), termos de empréstimo, cronograma de desembolso, ano acadêmico | Convenções de nomenclatura inconsistentes para o mesmo tipo de auxílio |
| Relatório de Notas SAT/ACT/AP | Nome do aluno, data do teste, notas por matéria, pontuação composta, classificação percentil, escala de pontuação | Layout denso com múltiplas matérias, mudanças de formato entre anos de teste |
| IEP / Documento de Educação Especial | Nome do aluno, classificação de deficiência, metas anuais, adaptações, minutos de serviço, data do IEP, data de revisão, gestor de caso | Ampla variação estrutural, formatos narrativos vs. listas de verificação, conteúdo sensível à FERPA |
| Diploma / Certificado | Nome do formando, data de outorga, tipo de credencial, autoridade emissora, designação de honras | Fontes ornamentadas, folha dourada, layout não padronizado, baixo contraste de digitalização |
Para instituições que usam uma abordagem de Extração de Colunas Personalizadas — em que você simplesmente digita os nomes dos campos desejados e a IA os localiza semanticamente — esta tabela também serve como seu guia de configuração. Diferentemente de ferramentas baseadas em modelo que exigem que você desenhe zonas ao redor de cada campo em um documento de amostra, a extração semântica permite adicionar novos campos digitando um nome. Quando uma nova escola de origem envia um histórico escolar que rotula "GPA" como "Academic Index", você não precisa de um novo modelo — a IA infere a correspondência a partir do contexto.
FERPA e Conformidade: O que os Sistemas de OCR Devem Abordar
A Lei de Direitos e Privacidade Educacionais da Família (FERPA), promulgada em 1974 e codificada no 34 CFR Parte 99, rege a privacidade dos registros educacionais dos alunos em qualquer instituição que receba financiamento federal do Departamento de Educação dos EUA. Para escolas que consideram OCR ou extração de documentos baseada em IA, a FERPA cria obrigações específicas que o sistema de extração e sua implantação devem atender — semelhante a como o OCR de documentos jurídicos deve atender às FRCP e às Regras Modelo da ABA, mas com seus próprios requisitos distintos em torno do consentimento dos pais e do rastreamento de divulgações.
O que a FERPA Protege
A FERPA define "registros educacionais" de forma ampla: qualquer registro diretamente relacionado a um aluno e mantido por uma instituição educacional ou seu agente. Isso inclui explicitamente históricos escolares, notas, cálculos de GPA, horários de aulas, registros disciplinares, registros de educação especial (incluindo IEPs) e registros de saúde/imunização mantidos pela escola. Quando uma escola usa uma ferramenta de extração de documentos de terceiros para processar esses registros, os requisitos da FERPA se aplicam à ferramenta e ao seu tratamento de dados como se fosse a própria escola.
Requisitos-Chave para Sistemas de Extração de Documentos
- Controles de acesso — Apenas funcionários com "interesse educacional legítimo" podem acessar registros de alunos. O sistema de extração deve impor controles de acesso baseados em funções e manter registros de auditoria de quem visualizou ou exportou cada documento.
- Rastreamento de divulgações — A FERPA exige que as instituições mantenham um registro de cada solicitação de acesso e de cada divulgação de informações de identificação pessoal contidas em registros educacionais. A plataforma de extração deve registrar todas as exportações de dados e ações de compartilhamento por padrão.
- Direitos dos pais e de alunos elegíveis — Pais de alunos menores de idade e alunos elegíveis (18 anos ou mais ou matriculados em instituição de ensino superior) têm o direito de inspecionar registros educacionais em até 45 dias após a solicitação. Os registros digitalizados devem ser recuperáveis e disponibilizáveis dentro desse prazo.
- Obrigações de serviços de terceiros — Qualquer fornecedor de extração terceirizado que armazene, processe ou transmita registros educacionais de alunos deve ser contratualmente obrigado a cumprir as restrições de uso da FERPA. As escolas devem avaliar as práticas de segurança de dados dos fornecedores, os padrões de criptografia e os acordos de subprocessamento antes da implantação.
Retenção de Registros sob a FERPA
A própria FERPA não prescreve períodos de retenção específicos, mas leis estaduais e requisitos de credenciamento estabelecem mínimos práticos. O padrão comum do setor:
- Registros temporários (dados de frequência, listas de notas, documentos de agendamento) — retenha por pelo menos 5 anos após o desligamento do aluno da instituição.
- Registros permanentes (históricos escolares, diplomas, resultados oficiais de exames, registros disciplinares finais) — retenha por pelo menos 60 anos.
Um sistema de OCR ou extração por IA que opere dentro desse framework deve armazenar os dados extraídos por um período comparável, com garantias de integridade dos dados e exportabilidade em formatos padrão (CSV, JSON, XLSX), para que os registros permaneçam acessíveis independentemente da ferramenta de extração original.
Considerações Especiais para Documentos de Educação Especial
Os IEPs e registros de educação especial têm nuances adicionais de conformidade. O Office for Civil Rights do Departamento de Educação dos EUA determinou que os históricos escolares não podem indicar que um aluno recebeu acomodações em uma sala de aula de educação geral por meio de notações especiais, asteriscos ou símbolos. Qualquer pipeline de extração que produza dados de histórico escolar a partir do mesmo sistema que processa dados de IEP deve garantir que marcadores relacionados a deficiência não sejam inadvertidamente transferidos para os campos do histórico escolar.
Este é um requisito de conformidade que os sistemas de OCR baseados em modelo têm dificuldade em atender — eles extraem tudo o que está na zona, sem entender qual conteúdo é permitido incluir em uma determinada saída. Os sistemas de extração semântica podem aplicar regras de saída: eles entendem que "Acomodações: tempo estendido" pertence ao conjunto de dados do IEP, mas deve ser excluído do feed do histórico escolar.
O Que Procurar em uma Ferramenta de OCR para Educação
Nem toda ferramenta de extração de documentos é adequada para fluxos de trabalho educacionais. Aqui estão os critérios específicos a avaliar ao selecionar uma solução para o processamento de registros de alunos:
A ferramenta precisa entender o que os campos significam, não apenas onde estão. Se o campo GPA quebra porque um histórico de uma nova escola de origem o coloca em outro canto da página, a ferramenta não é adequada para a educação em escala.
Controles de acesso baseados em função, criptografia em repouso e em trânsito, registro de auditoria e compromissos contratuais de conformidade com a FERPA. Se o fornecedor não puder apresentar um acordo assinado de proteção de dados da FERPA, siga em frente.
A educação é um fluxo de trabalho em lote — 200 históricos chegam juntos, não um de cada vez. A ferramenta precisa processar vários documentos simultaneamente e mesclar os resultados em uma única tabela agregada que mapeia cada valor extraído de volta a um documento específico.
Uma parte significativa dos formulários de matrícula, autorizações e registros históricos inclui entradas manuscritas. A capacidade de reconhecimento de escrita à mão da ferramenta determina diretamente se ela consegue processar esses documentos sem transcrição manual.
Exportações em CSV e JSON com campos claramente mapeados permitem que as equipes de TI criem pipelines de importação automatizados para Ellucian, Workday, PowerSchool ou outras plataformas SIS. A redigitação manual dos dados extraídos anula o propósito da automação.
Nem todos os valores extraídos são igualmente certos. Uma ferramenta que informa pontuações de confiança por campo — não apenas por documento — permite que os revisores concentrem seu esforço de verificação nos 10% dos campos que precisam disso, em vez de reconferir cada entrada.
Perguntas Frequentes
Que tipos de documentos educacionais o OCR consegue processar?
O OCR moderno com IA consegue processar históricos escolares, formulários de matrícula e registro, cartas de concessão de auxílio financeiro, relatórios de pontuação de testes padronizados (SAT, ACT, AP, IB), IEPs e documentos de educação especial, diplomas e certificados, registros de vacinação e formulários de comprovação de residência. A variável principal não é o tipo de documento, mas a qualidade da digitalização e a capacidade da ferramenta de compreender a semântica dos campos em vez de posições fixas.
Qual é a precisão do OCR para extração de GPA em históricos escolares?
A precisão depende muito de a ferramenta usar OCR baseado em posição (correspondência de modelo) ou extração semântica com IA. Sistemas baseados em modelo apresentam grande variação de precisão — de até 95% em formatos conhecidos a apenas 45% em layouts desconhecidos. Sistemas com IA que compreendem o contexto acadêmico alcançam 95-97% de precisão em nível de campo em diversos formatos de histórico escolar, sendo o principal ponto de falha os indicadores ambíguos de escala de GPA. A maioria das implantações em produção complementa a extração automatizada com uma camada de revisão humana para os campos de maior criticidade.
O uso de uma ferramenta de OCR de terceiros está em conformidade com a FERPA?
Sim, desde que a instituição e o fornecedor atendam aos requisitos da FERPA: o fornecedor deve ser contratualmente designado como "funcionário escolar" com "interesse educacional legítimo"; os dados dos alunos devem ser criptografados em repouso e em trânsito; o acesso deve ser baseado em funções; e a instituição deve manter controle direto sobre como os dados são usados e retidos. As escolas devem solicitar um acordo de conformidade com a FERPA assinado por qualquer fornecedor antes de processar registros reais de alunos.
O OCR consegue ler formulários de matrícula preenchidos à mão?
O OCR tradicional tem capacidade limitada para caligrafia — normalmente abaixo de 50% de precisão em documentos com letra cursiva ou caligrafia mista. Modelos modernos de visão com IA treinados em conjuntos de dados de caligrafia alcançam 85-95% de precisão em texto manuscrito claro e 70-80% em caligrafia desafiadora (letra ruim, tinta de baixo contraste, marcas sobrepostas). Para campos críticos como números de telefone ou nomes legais, recomenda-se uma etapa de revisão humana para conteúdo manuscrito.
Quanto custa implementar OCR para registros de alunos?
Os custos variam de mecanismos de OCR de código aberto gratuitos (com alto esforço de configuração manual e manutenção contínua de modelos) a ferramentas de extração com IA por assinatura, cobradas por página ou por documento. Para instituições de médio porte que processam de 10.000 a 50.000 documentos por ano, a extração com IA normalmente custa de $0,10 a $0,50 por página, sem taxas de configuração de modelo. Isso é vantajoso em comparação com o custo de mão de obra do processamento manual, que gira em torno de $3 a $6 por histórico apenas em tempo de equipe, considerando entrada de dados, verificação e atualizações de sistema.
Podemos digitalizar décadas de registros em papel históricos com OCR?
Sim, mas com ressalvas. Arquivos históricos em papel enfrentam desafios que os documentos recebidos atualmente não têm: papel envelhecido ou amarelado reduz o contraste, registros manuscritos de várias décadas usam instrumentos e estilos de escrita diferentes, e layouts de históricos mais antigos têm pouca semelhança com os modernos. Uma abordagem em fases — começar pelos documentos recebidos para construir o fluxo de trabalho e depois processar os arquivos históricos em lotes com uma etapa de revisão humana — é mais prática do que tentar um único projeto de digitalização em massa.
O processamento de registros educacionais não precisa ser um gargalo — nem na temporada de matrículas, nem para avaliação de históricos escolares, nem para digitalização histórica.
A diferença entre uma ferramenta que lê caracteres e uma ferramenta que entende dados acadêmicos determina se o seu escritório processa 50 documentos por dia ou 500. Com extração semântica e sem modelo, você define os campos necessários — nome do aluno, GPA, códigos de disciplinas, datas de matrícula — e a IA os localiza em qualquer formato de documento, de qualquer instituição, sem pré-configuração.
Teste nos seus próprios registros de alunos. Veja como pode ser o seu próximo ciclo de avaliação de históricos escolares.