OCR pour l'éducation :
Un guide complet sur les dossiers étudiants, les relevés de notes et les formulaires d'inscription
L'OCR pour l'éducation est l'application de la reconnaissance de caractères et de l'extraction de documents par IA aux dossiers étudiants — y compris les relevés de notes, les formulaires d'inscription, les lettres d'aide financière, les scores de tests standardisés, les IEP, les diplômes et autres documents académiques que les écoles et universités traitent par milliers à chaque cycle d'inscription. Contrairement à l'extraction de factures ou de reçus où les formats sont relativement stables, les documents éducatifs proviennent de milliers d'institutions différentes, chacune avec sa propre mise en page, son échelle de notation, son système de crédits et sa terminologie. La différence entre un outil qui lit des pixels et un outil qui comprend les structures de données académiques détermine si le bureau de votre registraire traite 50 relevés de notes par jour ou 500.
Points clés à retenir
- Une université de taille moyenne reçoit 30 000 relevés de notes à chaque cycle d'admission, et chacun exige encore 15 à 25 minutes d'attention humaine rien que pour localiser le GPA sur la page, traduire l'échelle de notation et saisir les noms des cours dans le système étudiant.
- L'OCR basé sur des modèles produit un taux d'erreur d'extraction du GPA de 55 % sur des formats inconnus, car plus de 4 000 établissements d'enseignement supérieur américains organisent chacun leurs relevés de notes différemment, et les outils qui se fient à la position des pixels plutôt qu'au sens attrapent le mauvais nombre dès que la mise en page change légèrement.
- L'IA sémantique extrait un relevé de notes en 45 secondes avec une précision de 96,7 % et pour 0,15 $ par document — car elle lit le sens au lieu des coordonnées de pixels et ne se casse pas lorsque la prochaine école d'origine place le GPA dans un coin différent de la page.
Qu'est-ce que l'OCR pour l'éducation ?
La technologie de reconnaissance optique de caractères convertit le texte scanné ou photographié en caractères lisibles par machine. Cela vaut pour tous les secteurs. Ce qui fait de l'OCR pour l'éducation une catégorie distincte, c'est la nature des documents traités et ce que les établissements scolaires doivent réellement en extraire.
Le bureau des admissions d'une université n'a pas seulement besoin de lire un relevé de notes — il doit extraire une valeur de GPA précise, vérifier qu'elle a été calculée sur une échelle de 4.0 (et non de 4.3 ou 5.0), identifier les cours transférables, déterminer si les heures de crédit sont basées sur des semestres ou des trimestres, et signaler les doublons. Un district scolaire K-12 qui traite des formulaires d'inscription doit extraire les coordonnées des responsables légaux, les dossiers scolaires antérieurs, le statut d'éducation spécialisée et l'éligibilité aux repas gratuits ou à prix réduit d'une pile de formulaires manuscrits ou photocopiés — chacun avec une mise en page différente.
L'OCR traditionnel — qui compare des motifs de pixels à une base de données de caractères — peut numériser le texte de ces documents. Mais il ne comprend pas ce que représente un GPA, ni si « 3.75 » est une moyenne générale ou un numéro de cours, ni que « 09/01/2026 » est une date d'inscription et non un montant de frais. C'est cet écart sémantique qui explique pourquoi les établissements d'enseignement vont au-delà de l'OCR traditionnel vers l'extraction de documents par IA.
Pourquoi l'éducation a besoin d'un traitement automatisé des documents
Le volume de papier qui circule dans un système scolaire moyen est difficile à surestimer. Une université publique de taille moyenne aux États-Unis traite de 20,000 à 30,000 candidatures de premier cycle par cycle d'admission. San Diego State University, par exemple, a traité plus de 93,000 candidatures pour l'automne 2018 à elle seule, et plus de 31,000 relevés de notes universitaires cette année-là — dont 18% ont nécessité un traitement OCR parce qu'ils sont arrivés sous forme de scans PDF plutôt que de données EDI structurées.
Pour les districts K-12, la charge administrative est différente mais tout aussi lourde. Une grande école publique à charte virtuelle comme Epic Charter Schools, en Oklahoma, a traité plus de 15,000 dossiers d'élèves en une seule période d'inscription grâce à un système d'IA qui a classé 65+ types de documents — réduisant le traitement par élève d'heures à secondes.
Le coût du traitement manuel se cumule sur chaque type de document que l'établissement manipule :
- Évaluation des relevés de notes — Chaque relevé de notes entrant exige qu'un membre du personnel lise les codes de cours, convertisse les notes à l'échelle de l'établissement d'accueil, vérifie l'accréditation et saisisse manuellement les résultats. À 15-25 minutes par relevé, 30,000 candidatures représentent 7,500 à 12,500 heures de travail par cycle d'admission.
- Formulaires d'inscription — Les dossiers d'inscription des nouveaux élèves contiennent généralement de 8 à 15 pages distinctes (contact d'urgence, informations de santé, justificatif de résidence, scolarité antérieure). Les taux d'erreur de saisie manuelle dans le traitement des formulaires administratifs atteignent en moyenne 18-25%, les champs les plus critiques — numéros de contact des responsables légaux et détails d'alerte médicale — présentant le coût d'erreur le plus élevé.
- Dossiers d'aide financière — La vérification des données FAFSA, des relevés fiscaux et des justificatifs de revenus est l'un des processus les plus gourmands en documents de l'enseignement supérieur, exigeant souvent plusieurs cycles d'examen des documents par étudiant.
La plupart des établissements scolaires continuent de recourir par défaut au traitement manuel pour la même raison : les formats sont trop variés pour l'OCR conventionnel basé sur des modèles, et les conséquences d'une erreur d'extraction — un GPA erroné, un crédit de cours manqué — sont plus lourdes que dans la plupart des scénarios de traitement de documents professionnels.
Types de documents dans l'éducation
Chaque type de document dans l'écosystème éducatif présente ses propres défis d'extraction. Comprendre cette diversité permet de clarifier pourquoi une approche OCR unique ne fonctionne que rarement pour les établissements scolaires.
1. Relevés de notes académiques
Les relevés de notes sont les documents éducatifs les plus complexes à traiter à grande échelle. Un seul relevé de notes d'un lycée américain comprend généralement le nom de l'élève, sa date de naissance, sa date de diplôme, sa GPA cumulative (pondérée et non pondérée), son rang de classe (le cas échéant), une liste de cours par année scolaire, les notes finales de chaque cours, les crédits obtenus, les relevés d'assiduité et les scores aux tests standardisés. Un relevé de notes international ajoute des barrières linguistiques, différentes échelles de notation (basées sur des pourcentages, des lettres, l'échelle IB de 1 à 7, les points tarifaires A-level du Royaume-Uni) et des exigences d'évaluation des diplômes.
Le défi principal de l'extraction : la GPA n'est pas une étiquette fixe. Une école l'appelle « Grade Point Average », une autre utilise « Cumulative GPA », une troisième la place dans une case intitulée « Academic Standing », et certaines affichent uniquement une GPA pondérée accompagnée d'une GPA non pondérée sans étiqueter ni l'une ni l'autre. Un système OCR basé sur des modèles nécessite une configuration distincte pour chacune de ces variations. À l'Université Stony Brook, les outils OCR hérités traitant les relevés de notes produisaient des taux d'erreur allant jusqu'à 55 % — non pas parce que l'OCR ne pouvait pas lire les caractères, mais parce qu'il ne pouvait pas identifier de manière fiable quel nombre sur la page correspondait à la GPA.
2. Formulaires d'inscription et d'enregistrement
Les formulaires d'inscription sont tout au plus semi-structurés. Les districts scolaires à travers le pays utilisent différentes mises en page de formulaires, certains générés par des systèmes d'information scolaire (SIS) comme PowerSchool ou Infinite Campus, d'autres photocopiés à partir de modèles papier. Les champs clés — nom légal de l'élève, date de naissance, coordonnées du parent/tuteur, école précédente — sont présents sur presque tous les formulaires mais positionnés différemment sur chacun.
L'élément manuscrit ajoute une difficulté supplémentaire. Les signatures des parents, les numéros de contact d'urgence manuscrits et les fiches d'informations médicales sont des sources courantes d'échec d'extraction pour l'OCR traditionnel. Les modèles d'IA entraînés à la reconnaissance de l'écriture manuscrite atteignent désormais une précision de 85 à 95 % sur des formulaires d'inscription manuscrits de qualité raisonnable, mais la variabilité au niveau des champs reste significative — un chiffre mal écrit dans un numéro de téléphone peut rendre tout le champ de contact inutilisable.
3. Lettres d'aide financière et documents d'attribution
Les lettres d'attribution d'aide financière contiennent des données financières structurées que les établissements doivent vérifier par rapport aux dossiers FAFSA/ISIR. Les montants attribués, les noms des bourses, les calendriers de décaissement et les conditions de prêt apparaissent dans des formats variés selon les établissements. Le défi d'extraction ici relève moins de la reconnaissance de caractères que du mappage sémantique — le même type d'aide (une bourse fédérale Pell) peut être désigné « Pell Grant », « Federal Pell », « PELL » ou « Pell Award » selon le modèle de l'établissement. Sans compréhension sémantique, chaque variante déclenche une décision de saisie distincte.
4. Rapports de scores aux tests standardisés
Les rapports de scores SAT, ACT, AP, IB et d'évaluations d'État ont chacun leurs propres conventions de mise en page — et, au sein de celles-ci, des variations de format selon les années. Les rapports de scores AP ont modifié leur structure de mise en page en 2023, par exemple, brisant les modèles construits sur les anciens formats. Ces documents sont généralement courts (1 à 2 pages) mais denses en champs : une seule page de rapport de scores AP répertorie plusieurs matières de test, des scores (échelle de 1 à 5) et des descripteurs de performance. Le faible nombre de pages masque une densité d'extraction élevée qui exige une précision rigoureuse au niveau des champs.
5. Programmes d'éducation individualisés (PEI) et documents d'éducation spécialisée
Les PEI comptent parmi les documents les plus sensibles sur le plan juridique dans l'éducation de la maternelle à la 12e année. Ils contiennent la classification du handicap d'un élève, ses objectifs annuels, les aménagements, les minutes de services et les données de suivi des progrès — toutes ces informations devant être transférées avec précision entre les systèmes lorsqu'un élève change de district. Contrairement aux relevés de notes qui suivent des conventions plus ou moins partagées, les structures des PEI varient considérablement selon l'État, le district et même l'école individuelle. Un PEI d'un district peut organiser les aménagements sous forme de liste à cocher, tandis qu'un autre intègre les mêmes informations dans des paragraphes narratifs.
Les règlements FERPA ajoutent une couche supplémentaire : le relevé de notes ne doit jamais indiquer qu'un élève a reçu des aménagements d'éducation spécialisée dans une classe d'enseignement général. L'Office for Civil Rights (OCR) du département de l'Éducation des États-Unis a rendu plusieurs décisions à ce sujet — ce qui signifie que le système d'extraction doit savoir quoi exclure de certains résultats, et pas seulement quoi inclure.
6. Diplômes, certificats & titres
Les diplômes et les certificats de fin d'études sont moins denses en données que les relevés de notes, mais ils présentent des enjeux de vérification élevés. Un diplôme falsifié ou une date de titre mal transcrite peut engager la responsabilité de l'établissement émetteur. L'extraction du nom du diplômé, de la date de délivrance, du type de titre et de l'autorité émettrice à partir de scans de diplômes nécessite une OCR capable de gérer les polices ornementées, le texte en dorure et les mises en page non standard — des conditions qui font échouer les moteurs d'OCR traditionnels.
Les défis uniques de l'extraction dans l'éducation
Au-delà de la variété au niveau des documents, les systèmes d'OCR dans l'éducation sont confrontés à des défis structurels qui font de l'éducation l'un des secteurs les plus difficiles pour l'extraction de documents :
Variation des formats entre établissements
Il existe plus de 4,000 établissements d'enseignement supérieur habilités à délivrer des diplômes aux États-Unis et environ 100,000 écoles publiques K-12. La grande majorité utilise des mises en page différentes pour les relevés de notes et les formulaires. Une approche d'OCR basée sur des modèles — où chaque format nécessite un modèle préconfiguré — se heurte à une charge de maintenance impossible : chaque nouvelle école d'origine, chaque refonte de format par un établissement existant et chaque relevé de notes international exige un nouveau modèle ou un repli manuel.
L'extraction par IA résout ce problème en étant indépendante du format. Au lieu d'apprendre où se trouvent les données sur une page, le modèle apprend à quoi les données ressemblent sémantiquement : il reconnaît une GPA parce que le contexte environnant indique « GPA » ou « Grade Point Average », ou parce que le nombre se trouve à côté d'un total de crédits dans une position visuelle spécifique. L'OCR traditionnelle identifie les caractères sans les comprendre ; l'extraction par IA lit le document comme le ferait un humain — de manière holistique et en contexte.
Précision de l'extraction de la GPA
La GPA est le champ le plus critique d'un relevé de notes, mais c'est aussi celui dont l'extraction automatique est la plus sujette aux erreurs. Deux problèmes se cumulent :
- Plusieurs GPA sur un même document — De nombreux relevés de notes affichent une GPA pondérée, une GPA non pondérée et parfois une GPA cumulative en plus d'une GPA de session. Extraire la mauvaise peut modifier la classification d'éligibilité à l'admission d'un étudiant.
- Ambiguïté de l'échelle — Une GPA de 4.0 sur une échelle de 4.0 ne représente pas la même réussite qu'une GPA de 4.0 sur une échelle de 5.0, mais le document ne rend souvent pas l'échelle explicite. Le système d'extraction doit déduire l'échelle du contexte ou utiliser des données de référence externes.
Un article de recherche de 2026 sur les systèmes d'IA multi-agents pour le traitement des relevés de notes du lycée a rapporté une précision de 96.7% avec un taux de complétion de 100% sur divers relevés de notes du lycée, traitant chaque relevé en 45 secondes pour un coût de $0.15. L'article a identifié l'extraction de la GPA comme le principal « signal de confiance » pour la qualité globale de l'extraction — lorsque la GPA était correcte, les autres champs étaient très probablement corrects également.
Archives papier manuscrites et documents historiques
Les établissements qui abandonnent des décennies de dossiers papier font face à un arriéré de numérisation couvrant plusieurs générations d'élèves. De nombreux formulaires d'inscription, dossiers d'éducation spécialisée et relevés de notes plus anciens n'existent qu'en version manuscrite originale ou en photocopie. La difficulté de la lecture manuscrite s'ajoute à la qualité variable de l'encre, au vieillissement du papier et au remplissage incohérent des formulaires — certaines sections remplies au stylo, d'autres au crayon, d'autres laissées vides.
C'est un scénario où l'OCR traditionnel tombe sous les seuils de précision utilisables, mais où les modèles modernes de vision-langage entraînés sur divers échantillons manuscrits peuvent extraire des données exploitables d'une plus grande proportion de documents. L'approche pratique pour les archives historiques est un pipeline de révision avec intervention humaine : l'IA effectue le premier passage, signale les champs à faible confiance, et un réviseur formé valide ou corrige ces valeurs spécifiques.
Cohérence des données entre les systèmes
Une GPA ou une date d'inscription extraite n'est utile que si elle atterrit dans le bon champ du SIS de l'établissement (Ellucian Banner, Workday Student, PowerSchool, etc.). De nombreux outils OCR extraient les données dans un tableur mais laissent l'intégration SIS comme étape manuelle. Les services informatiques éducatifs qui évaluent les outils d'extraction devraient privilégier les solutions qui exportent des données structurées CSV/JSON pour import automatisé ou se connectent directement via API à leur plateforme SIS.
Méthode traditionnelle vs extraction par IA
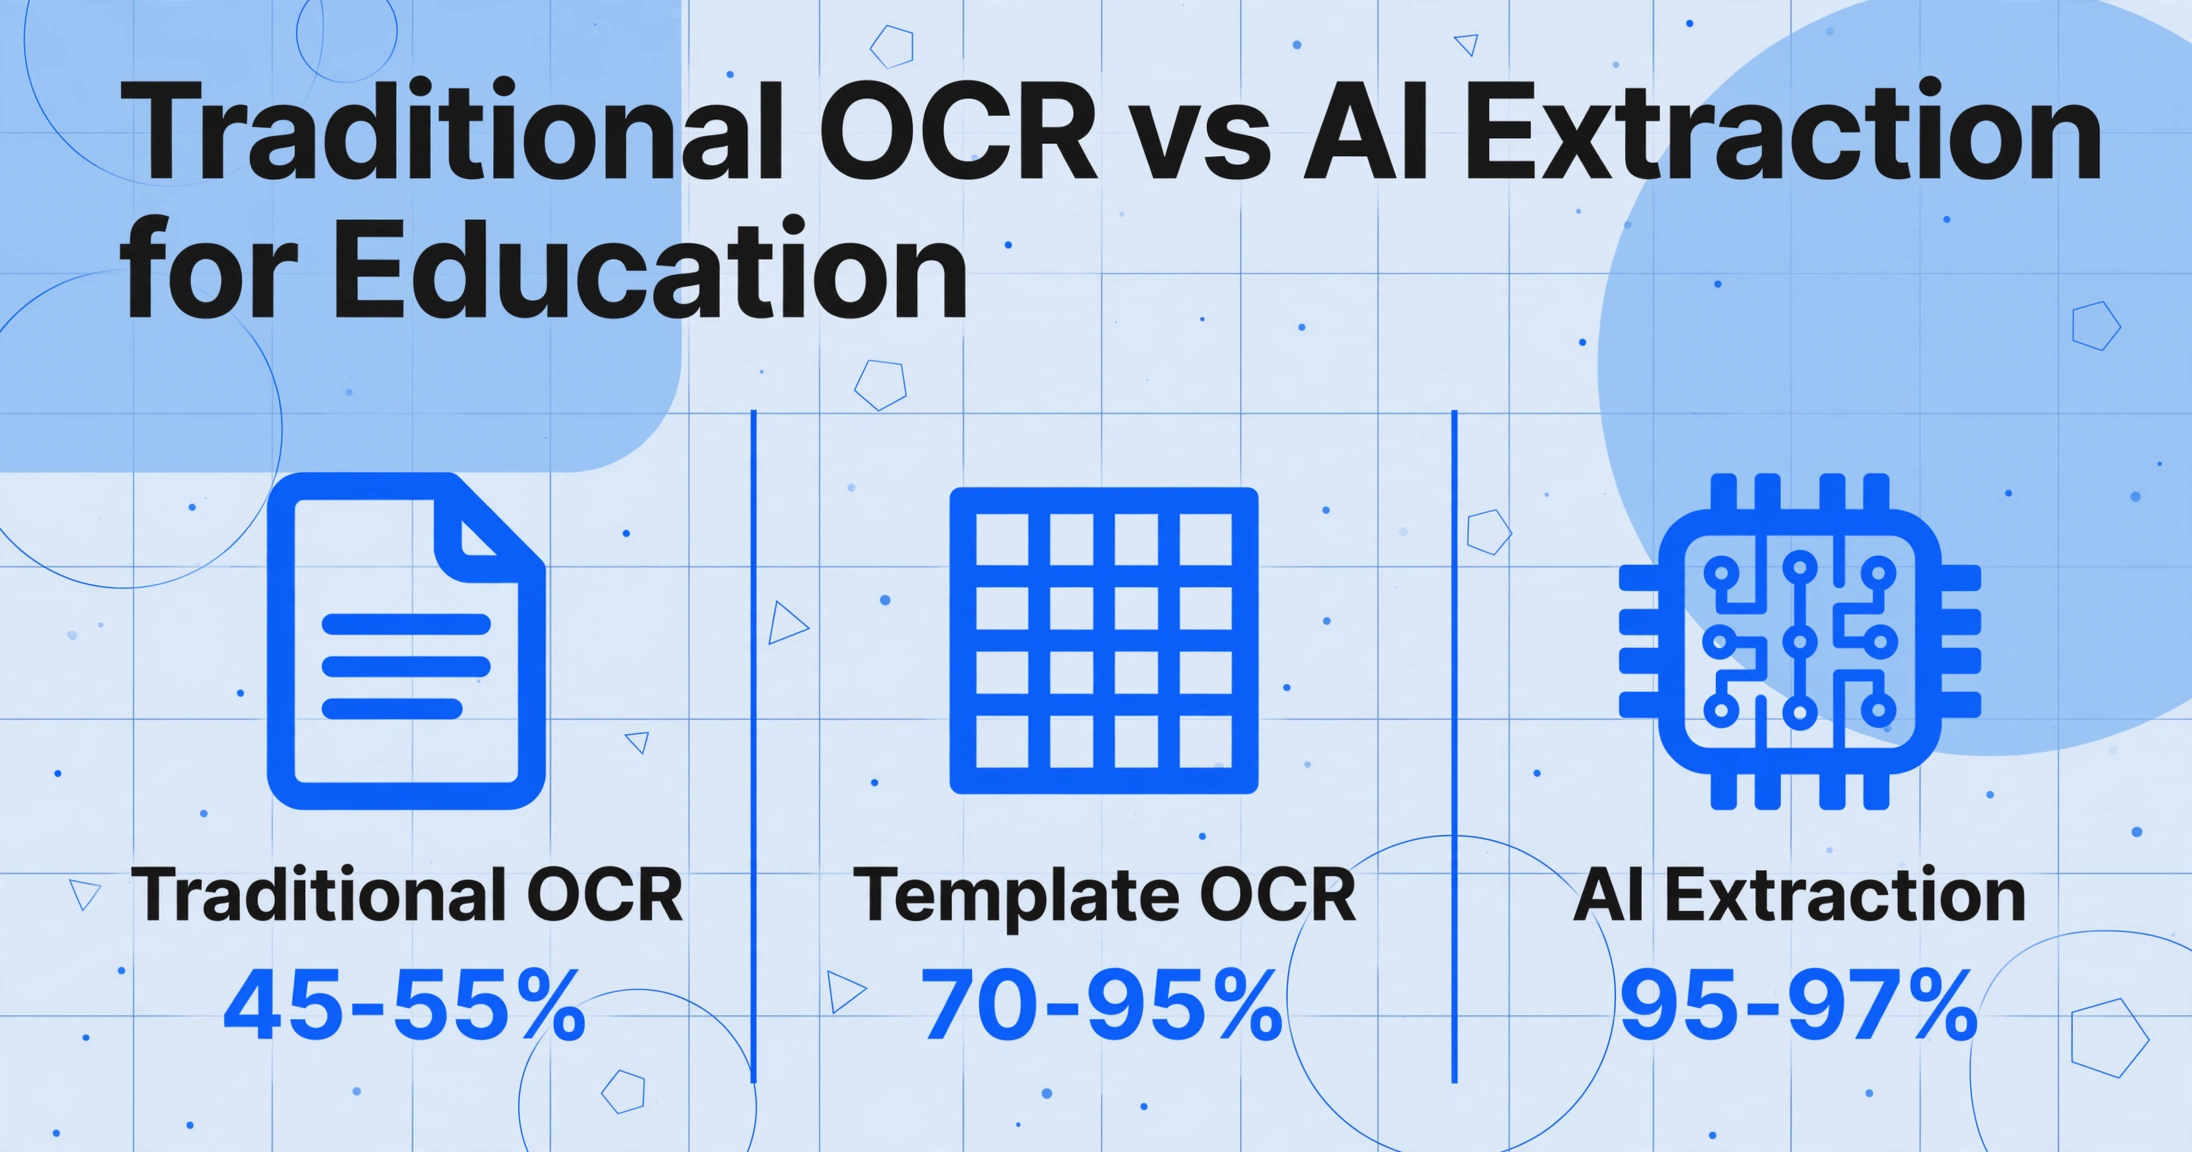
| Dimension | OCR traditionnel / approche par modèle | Extraction par IA |
|---|---|---|
| Gestion des formats | Nécessite un modèle séparé pour chaque mise en page d'établissement | Lit toute mise en page sans préconfiguration |
| Extraction de la GPA | Basée sur des zones : risque d'extraire la mauvaise GPA en cas de décalage de position | Sémantique : identifie la GPA par le sens et le contexte |
| Manuscrit | Moins de 50 % de précision sur les formulaires en cursive ou en écriture mixte | 85-95 % de précision sur une écriture de qualité raisonnable |
| Gestion des échelles | Ne peut pas distinguer les échelles GPA 4.0 vs 5.0 sans étiquetage manuel | Déduit l'échelle du contexte (ex. : cours « AP » → échelle pondérée) |
| Réponse aux changements de format | Le modèle casse ; reconfiguration manuelle nécessaire | S'adapte automatiquement ; aucune maintenance requise |
| Documents internationaux | Modèles par pays nécessaires ; échoue sur les mises en page imprévues | Gère les formats multilingues et inconnus |
| Temps de configuration | Des semaines à des mois de création et de test de modèles | Quelques minutes : téléversez un document, nommez vos champs, extrayez |
La différence essentielle : L'OCR traditionnel extrait des caractères sans les comprendre. L'extraction basée sur l'IA lit un document de manière sémantique — elle sait que « 3,75 » à côté de « GPA cumulatif » est le nombre qui détermine l'éligibilité à l'admission, alors que les trois mêmes caractères dans une colonne de code de cours représentent quelque chose d'entièrement différent.
Champs clés à extraire par type de document
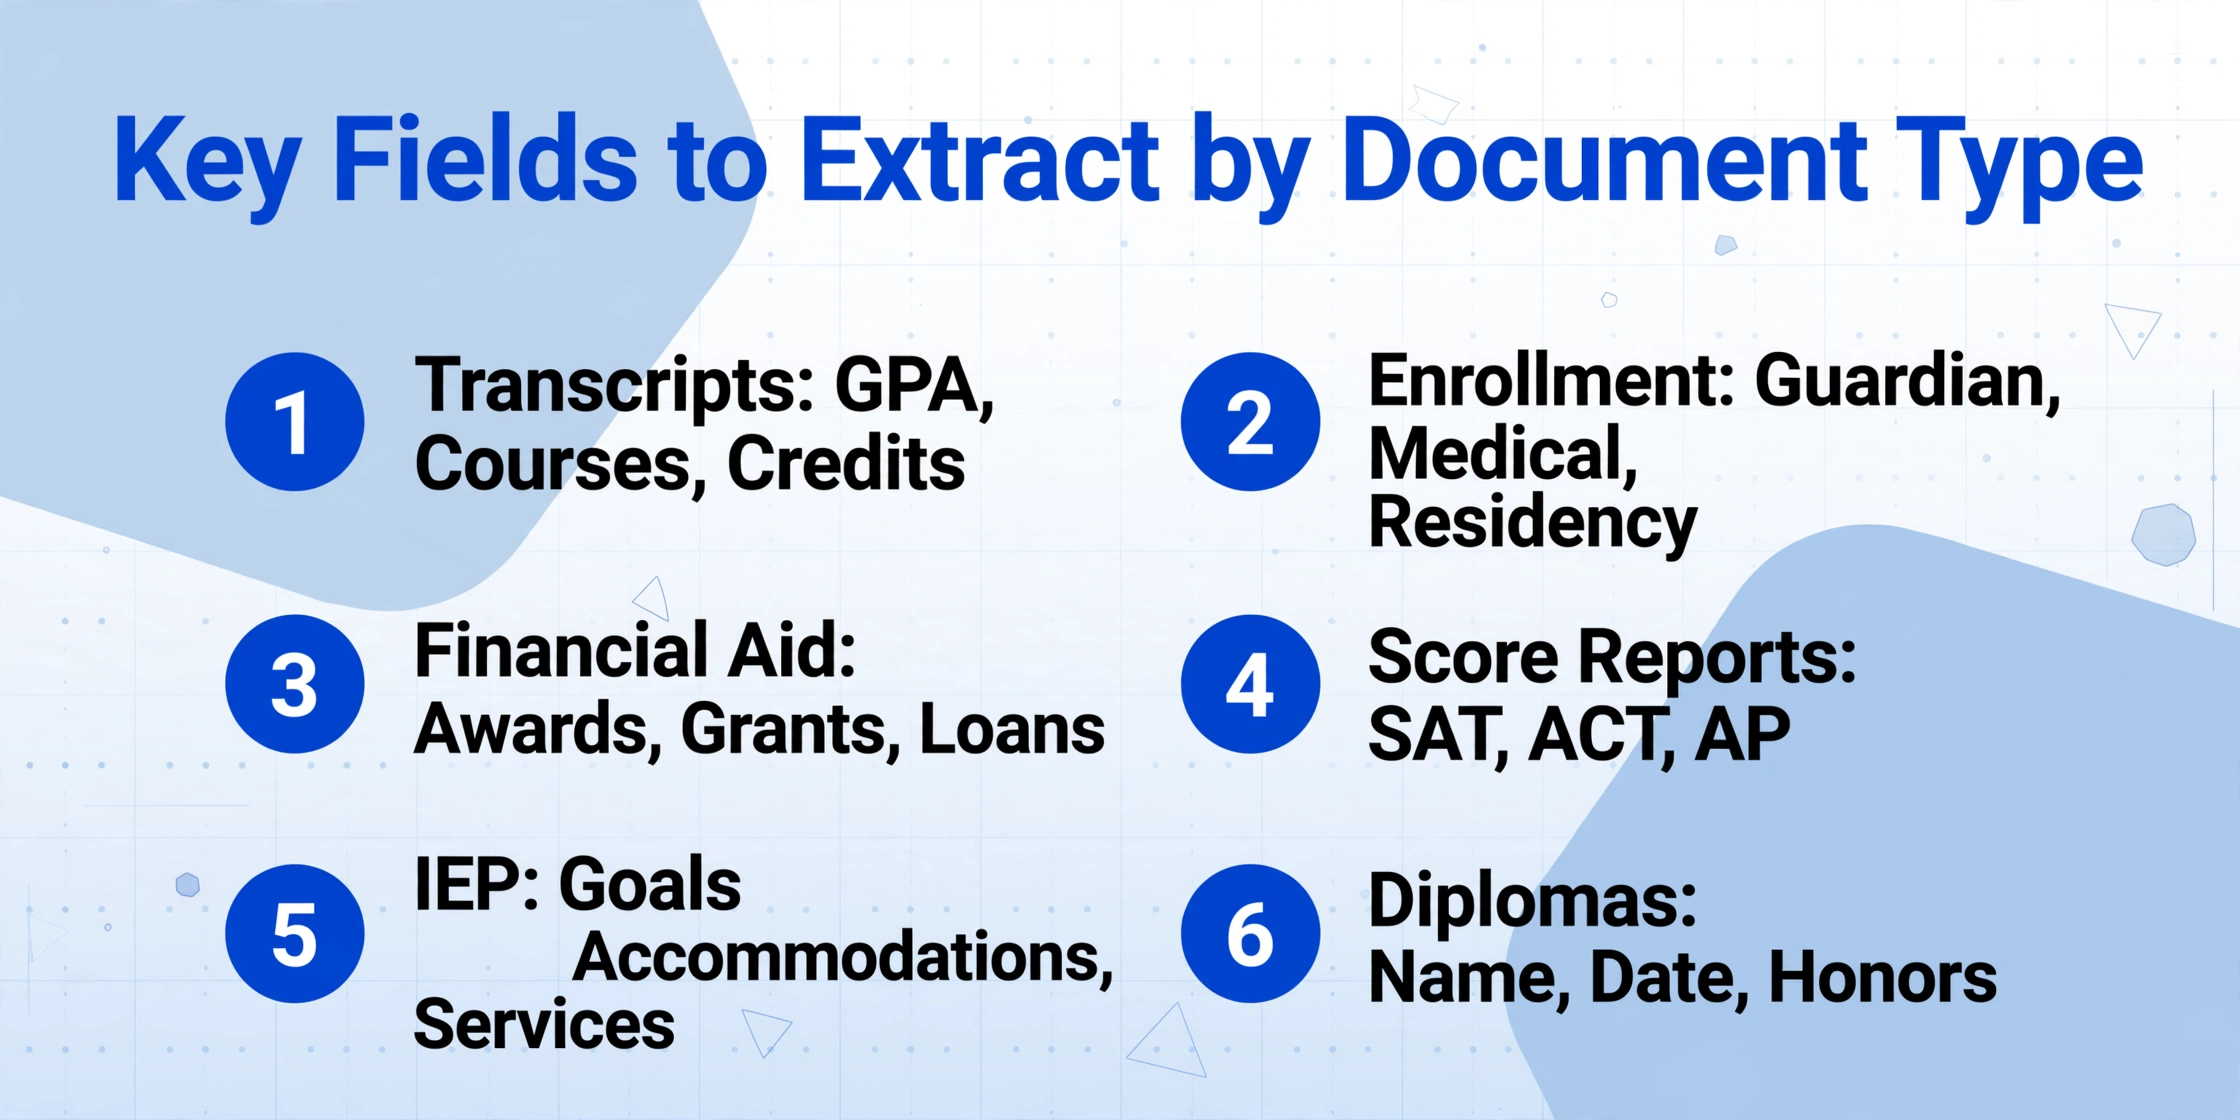
Voici un tableau de référence des champs les plus importants pour les principaux types de documents éducatifs. Les établissements qui planifient un déploiement d'extraction devraient commencer par cette liste et l'adapter à leurs besoins spécifiques.
| Type de document | Champs principaux | Défi d'extraction clé |
|---|---|---|
| Relevé de notes académique | Nom de l'étudiant, date de naissance, GPA (pondéré et non pondéré), rang de classe, liste des cours avec notes, crédits, date d'obtention du diplôme, échelle de notation | Plusieurs GPA, ambiguïté d'échelle, variation des codes de cours entre établissements |
| Formulaire d'inscription | Nom légal de l'étudiant, date de naissance, adresse, nom du parent/tuteur, coordonnées, école précédente, niveau scolaire, contacts d'urgence, alertes médicales | Champs manuscrits, mise en page semi-structurée, étiquettes de champs manquantes ou incohérentes |
| Lettre d'attribution d'aide financière | Montants attribués, noms des bourses, types de subventions (Pell, SEOG, institutionnelles), conditions de prêt, calendrier de décaissement, année académique | Conventions de dénomination incohérentes pour le même type d'aide |
| Rapport de scores SAT/ACT/AP | Nom de l'étudiant, date du test, scores par matière, score composite, rang percentile, échelle de scores | Mise en page dense multi-matières, changements de format selon les années de test |
| PEI / Document d'éducation spécialisée | Nom de l'étudiant, classification du handicap, objectifs annuels, aménagements, minutes de services, date du PEI, date de révision, gestionnaire de cas | Grande variation structurelle, formats narratifs vs. listes de contrôle, contenu sensible FERPA |
| Diplôme / Certificat | Nom du diplômé, date de remise, type de diplôme, autorité émettrice, mention honorifique | Polices ornées, feuille d'or, mise en page non standard, faible contraste de numérisation |
Pour les établissements utilisant une approche d'Extraction de colonnes personnalisées — où vous saisissez simplement les noms des champs souhaités et l'IA les localise sémantiquement — ce tableau sert également de guide de configuration. Contrairement aux outils basés sur des modèles qui exigent de délimiter des zones autour de chaque champ sur un document d'exemple, l'extraction sémantique permet d'ajouter de nouveaux champs en saisissant un nom. Lorsqu'une nouvelle école d'alimentation envoie un relevé de notes qui désigne le « GPA » comme « Indice académique », aucun nouveau modèle n'est nécessaire — l'IA déduit la correspondance à partir du contexte.
FERPA et conformité : ce que les systèmes OCR doivent traiter
La Family Educational Rights and Privacy Act (FERPA), promulguée en 1974 et codifiée au 34 CFR Part 99, régit la confidentialité des dossiers scolaires des étudiants dans tout établissement recevant un financement fédéral du ministère américain de l'Éducation. Pour les écoles qui envisagent l'OCR ou l'extraction de documents par IA, la FERPA crée des obligations spécifiques que le système d'extraction et son déploiement doivent respecter — de la même manière que l'OCR de documents juridiques doit répondre aux FRCP et aux ABA Model Rules, mais avec ses propres exigences distinctes concernant le consentement parental et le suivi des divulgations.
Ce que protège la FERPA
La FERPA définit largement les « dossiers scolaires » : tout dossier directement lié à un étudiant et conservé par un établissement d'enseignement ou son agent. Cela inclut explicitement les relevés de notes, les notes, les calculs de GPA, les emplois du temps, les dossiers disciplinaires, les dossiers d'éducation spécialisée (y compris les IEP) et les dossiers de santé/vaccination conservés par l'école. Lorsqu'une école utilise un outil d'extraction de documents tiers pour traiter ces dossiers, les exigences de la FERPA s'appliquent à l'outil et à son traitement des données comme s'il s'agissait de l'école elle-même.
Exigences clés pour les systèmes d'extraction de documents
- Contrôles d'accès — Seul le personnel ayant un « intérêt éducatif légitime » peut accéder aux dossiers des étudiants. Le système d'extraction doit appliquer des contrôles d'accès basés sur les rôles et conserver des journaux d'audit indiquant qui a consulté ou exporté chaque document.
- Suivi des divulgations — La FERPA exige que les établissements tiennent un registre de chaque demande d'accès et de chaque divulgation d'informations personnelles identifiables provenant des dossiers scolaires. La plateforme d'extraction doit journaliser toutes les exportations de données et les actions de partage par défaut.
- Droits des parents et des étudiants admissibles — Les parents d'étudiants mineurs et les étudiants admissibles (18 ans et plus ou fréquentant un établissement postsecondaire) ont le droit d'inspecter les dossiers scolaires dans les 45 jours suivant la demande. Les dossiers numérisés doivent pouvoir être récupérés et produits dans ce délai.
- Obligations des services tiers — Tout fournisseur d'extraction tiers qui stocke, traite ou transmet des dossiers scolaires doit être contractuellement tenu de respecter les restrictions d'utilisation de la FERPA. Les écoles doivent évaluer les pratiques de sécurité des données, les normes de chiffrement et les accords de sous-traitance des fournisseurs avant le déploiement.
Conservation des dossiers en vertu de la FERPA
La FERPA elle-même ne prescrit pas de durées de conservation spécifiques, mais les lois des États et les exigences d'accréditation fixent des minimums pratiques. La norme courante du secteur :
- Dossiers temporaires (données d'assiduité, listes de notes, documents de planification) — conserver pendant au moins 5 ans après le départ de l'étudiant de l'établissement.
- Dossiers permanents (relevés de notes, diplômes, résultats de tests officiels, dossiers disciplinaires définitifs) — conserver pendant au moins 60 ans.
Un système d'extraction OCR ou IA opérant dans ce cadre doit stocker les données extraites pendant une période comparable, avec des garanties d'intégrité des données et une exportabilité dans des formats standard (CSV, JSON, XLSX) afin que les dossiers restent accessibles indépendamment de l'outil d'extraction d'origine.
Considérations particulières pour les documents d'éducation spécialisée
Les PEI et les dossiers d'éducation spécialisée comportent des nuances de conformité supplémentaires. Le Bureau des droits civils du ministère de l'Éducation des États-Unis a déterminé que les relevés de notes ne peuvent pas indiquer qu'un étudiant a bénéficié d'aménagements dans une classe d'enseignement général par le biais de mentions spéciales, d'astérisques ou de symboles. Toute chaîne d'extraction qui produit des données de relevés de notes à partir du même système traitant les données des PEI doit garantir que les marqueurs liés au handicap ne sont pas transférés par inadvertance dans les champs des relevés de notes.
Il s'agit d'une exigence de conformité que les systèmes OCR basés sur des modèles peinent à satisfaire — ils extraient ce qui se trouve dans la zone, sans comprendre quel contenu est autorisé à figurer dans un résultat donné. Les systèmes d'extraction sémantique peuvent appliquer des règles de sortie : ils comprennent que « Aménagements : temps prolongé » appartient à l'ensemble de données du PEI mais doit être exclu du flux des relevés de notes.
Ce qu'il faut rechercher dans un outil OCR pour l'éducation
Tous les outils d'extraction de documents ne conviennent pas aux flux de travail éducatifs. Voici les critères spécifiques à évaluer lors du choix d'une solution pour le traitement des dossiers étudiants :
L'outil doit comprendre ce que les champs signifient, pas seulement où ils se trouvent. Si le champ GPA échoue parce qu'un relevé de notes d'un nouvel établissement d'origine le place dans un coin différent de la page, l'outil ne convient pas à l'éducation à grande échelle.
Contrôles d'accès basés sur les rôles, chiffrement au repos et en transit, journalisation d'audit et engagements contractuels de conformité FERPA. Si le fournisseur ne peut pas produire un accord de protection des données FERPA signé, passez votre chemin.
L'éducation est un flux de travail par lots — 200 relevés de notes arrivent ensemble, pas un à la fois. L'outil doit traiter plusieurs documents simultanément et fusionner les résultats dans un tableau agrégé unique qui associe chaque valeur extraite à un document spécifique.
Une part importante des formulaires d'inscription, des autorisations parentales et des dossiers historiques contient des mentions manuscrites. La capacité de reconnaissance de l'écriture manuscrite de l'outil détermine directement s'il peut traiter ces documents sans saisie manuelle.
Les exports CSV et JSON avec des champs clairement mappés permettent aux équipes informatiques de créer des pipelines d'import automatisés vers Ellucian, Workday, PowerSchool ou d'autres plateformes SIS. La ressaisie manuelle des données extraites va à l'encontre de l'automatisation.
Toutes les valeurs extraites ne sont pas également certaines. Un outil qui rapporte des scores de confiance par champ — et pas seulement par document — permet aux réviseurs de concentrer leur effort de vérification sur les 10 % de champs qui en ont besoin, plutôt que de revérifier chaque entrée.
Questions fréquemment posées
Quels types de documents éducatifs l'OCR peut-il traiter ?
L'OCR moderne basé sur l'IA peut traiter les relevés de notes académiques, les formulaires d'inscription, les lettres d'attribution d'aide financière, les rapports de scores aux tests standardisés (SAT, ACT, AP, IB), les PEI et les documents d'éducation spécialisée, les diplômes et certificats, les dossiers de vaccination et les formulaires de vérification de résidence. La variable clé n'est pas le type de document mais la qualité de la numérisation et la capacité de l'outil à comprendre la sémantique des champs plutôt que des positions fixes.
Quelle est la précision de l'OCR pour l'extraction de la GPA à partir des relevés de notes ?
La précision dépend fortement du fait que l'outil utilise une OCR basée sur la position (correspondance de modèles) ou une extraction sémantique par IA. Les systèmes basés sur des modèles montrent une grande variance de précision — allant de 95 % sur des formats connus à 45 % sur des mises en page inconnues. Les systèmes basés sur l'IA qui comprennent le contexte académique atteignent une précision de 95 à 97 % au niveau des champs sur divers formats de relevés de notes, le principal point de défaillance étant les indicateurs ambigus d'échelle de GPA. La plupart des déploiements en production complètent l'extraction automatisée par une étape de révision humaine pour les champs les plus critiques.
L'utilisation d'un outil OCR tiers est-elle conforme à la FERPA ?
Oui, à condition que l'établissement et le fournisseur respectent les exigences de la FERPA : le fournisseur doit être contractuellement désigné comme « agent scolaire » ayant un « intérêt éducatif légitime » ; les données des étudiants doivent être chiffrées au repos et en transit ; l'accès doit être basé sur les rôles ; et l'établissement doit conserver un contrôle direct sur la manière dont les données sont utilisées et conservées. Les écoles doivent demander un accord de conformité FERPA signé à tout fournisseur avant de traiter des dossiers d'étudiants réels.
L'OCR peut-il lire les formulaires d'inscription manuscrits ?
L'OCR traditionnel a une capacité limitée en matière de manuscrit — généralement inférieure à 50 % de précision sur les écritures cursives ou mixtes. Les modèles de vision par IA modernes entraînés sur des ensembles de données manuscrites atteignent une précision de 85 à 95 % sur les textes manuscrits clairs et de 70 à 80 % sur les écritures difficiles (mauvaise calligraphie, encre à faible contraste, marques qui se chevauchent). Pour les champs critiques comme les numéros de téléphone ou les noms légaux, une étape de révision avec intervention humaine est recommandée pour le contenu manuscrit.
Combien coûte la mise en œuvre de l'OCR pour les dossiers étudiants ?
Les coûts vont des moteurs OCR open source gratuits (avec un effort de configuration manuelle élevé et une maintenance continue des modèles) aux outils d'extraction IA par abonnement facturés par page ou par document. Pour les établissements de taille moyenne traitant 10 000 à 50 000 documents par an, l'extraction assistée par IA coûte généralement entre 0,10 $ et 0,50 $ par page, sans frais de configuration de modèle. Cela se compare favorablement au coût de la main-d'œuvre pour le traitement manuel, qui s'élève en moyenne à 3 $ à 6 $ par relevé de notes en temps de personnel seul, en tenant compte de la saisie des données, de la vérification et des mises à jour du système.
Pouvons-nous numériser des décennies de dossiers papier historiques avec l'OCR ?
Oui, mais avec des réserves. Les archives papier historiques présentent des défis que les documents entrants actuels ne rencontrent pas : le papier vieilli ou jauni réduit le contraste, les documents manuscrits de plusieurs décennies utilisent différents instruments et styles d'écriture, et les mises en page des anciens relevés de notes ressemblent peu aux modernes. Une approche progressive — commencer par les documents entrants pour établir le flux de travail, puis traiter les archives historiques par lots avec une étape de vérification humaine — est plus pratique que de tenter un projet de numérisation massive unique.
Le traitement des dossiers éducatifs ne doit pas être un goulot d'étranglement — ni pendant la saison des inscriptions, ni pour l'évaluation des relevés de notes, ni pour la numérisation historique.
La différence entre un outil qui lit des caractères et un outil qui comprend les données académiques détermine si votre bureau traite 50 documents par jour ou 500. Grâce à l'extraction sémantique sans modèle, vous définissez les champs dont vous avez besoin — nom de l'étudiant, GPA, codes de cours, dates d'inscription — et l'IA les localise dans n'importe quel format de document, provenant de n'importe quelle institution, sans préconfiguration.
Testez-le sur vos propres dossiers étudiants. Découvrez à quoi pourrait ressembler votre prochain cycle d'évaluation des relevés de notes.