OCR für Bildung:
Ein vollständiger Leitfaden für Schülerakten, Zeugnisse und Einschreibungsformulare
OCR für Bildung ist die Anwendung von Zeichenerkennung und KI-Dokumentextraktion auf Schülerakten — einschließlich Zeugnissen, Einschreibungsformularen, Finanzhilfeschreiben, standardisierten Testergebnissen, IEPs, Diplomen und anderen akademischen Dokumenten, die Schulen und Universitäten in jedem Einschreibungszyklus zu Tausenden verarbeiten. Anders als bei Rechnungs- oder Belegextraktion, wo die Formate relativ stabil sind, stammen Bildungsdokumente von Tausenden verschiedener Einrichtungen, jede mit eigenem Layout, Bewertungsskala, Kreditsystem und Terminologie. Der Unterschied zwischen einem Tool, das Pixel liest, und einem Tool, das akademische Datenstrukturen versteht, entscheidet, ob Ihr Registrarbüro 50 Zeugnisse pro Tag oder 500 verarbeitet.
Wichtigste Erkenntnisse
- Eine mittelgroße Universität erhält in jedem Zulassungszyklus 30.000 Zeugnisse, und jedes einzelne benötigt immer noch 15 bis 25 Minuten menschlicher Aufmerksamkeit, nur um den GPA auf der Seite zu finden, die Bewertungsskala zu übersetzen und die Kursnamen in das Studentensystem einzutippen.
- Vorlagenbasiertes OCR erzeugt eine GPA-Extraktionsfehlerquote von 55 % bei unbekannten Formaten, weil über 4.000 US-amerikanische Hochschuleinrichtungen ihre Zeugnisse jeweils unterschiedlich anordnen und Tools, die Pixelpositionen über Bedeutung stellen, bei leicht verschobenem Layout die falsche Zahl erfassen.
- Semantische KI extrahiert ein Zeugnis in 45 Sekunden mit 96,7 % Genauigkeit und $0,15 pro Dokument – weil sie Bedeutung statt Pixelkoordinaten liest und nicht versagt, wenn die nächste Zubringerschule den GPA in einer anderen Ecke der Seite platziert.
Was ist OCR für Bildungseinrichtungen?
Optische Zeichenerkennung wandelt gescannten oder fotografierten Text in maschinenlesbare Zeichen um. Das gilt für jede Branche. Was OCR für Bildungseinrichtungen zu einer eigenen Kategorie macht, ist die Art der verarbeiteten Dokumente und das, was Schulen tatsächlich daraus extrahieren müssen.
Die Zulassungsstelle einer Universität muss ein Transcript nicht nur lesen — sie muss einen bestimmten GPA-Wert extrahieren, verifizieren, dass er auf einer 4.0-Skala berechnet wurde (nicht 4.3 oder 5.0), feststellen, welche Kurse anrechenbar sind, prüfen, ob die Leistungspunkte auf Semestern oder Quartalen basieren, und Duplikate kennzeichnen. Ein K-12-Bezirk, der Einschreibungsformulare verarbeitet, muss Erziehungsberechtigten-Kontaktdaten, frühere Schulunterlagen, Sonderpädagogik-Status und Anspruch auf kostenlose/ermäßigte Mittagessen aus einem Stapel handschriftlicher oder kopierter Formulare ziehen — jedes davon anders formatiert.
Traditionelle OCR — die Pixelmuster mit einer Zeichendatenbank abgleicht — kann den Text dieser Dokumente digitalisieren. Aber sie versteht nicht, was ein GPA bedeutet, ob „3.75" ein Notendurchschnitt oder eine Kursnummer ist, oder dass „09/01/2026" ein Einschreibedatum und kein Gebührenbetrag ist. Diese semantische Lücke ist der Grund, warum Bildungseinrichtungen über traditionelle OCR hinaus zu KI-gestützter Dokumentenextraktion übergehen.
Warum Bildung automatisierte Dokumentenverarbeitung braucht
Die Papiermenge, die durch ein durchschnittliches Schulsystem fließt, ist kaum zu überschätzen. Eine einzelne mittelgroße öffentliche Universität in den USA verarbeitet 20.000 bis 30.000 Bachelor-Bewerbungen pro Zulassungszyklus. Die San Diego State University beispielsweise verarbeitete allein für Herbst 2018 mehr als 93.000 Bewerbungen und bearbeitete in diesem Jahr über 31.000 College-Transcripts — 18 % davon erforderten OCR-Verarbeitung, da sie als PDF-Scans und nicht als strukturierte EDI-Daten eintrafen.
Für K-12-Bezirke ist die Verwaltungslast anders, aber ebenso schwer. Eine große virtuelle öffentliche Charterschule wie Epic Charter Schools in Oklahoma verarbeitete über 15.000 Schülerakten in einem einzigen Einschreibezeitraum mit einem KI-System, das 65+ Dokumenttypen klassifizierte — und reduzierte die Verarbeitungszeit pro Schüler von Stunden auf Sekunden.
Die Kosten manueller Verarbeitung summieren sich über jeden Dokumenttyp, den die Einrichtung bearbeitet:
- Transcript-Bewertung — Jedes eingehende Transcript erfordert, dass ein Mitarbeiter Kurscodes liest, Noten auf die Skala der Heimatinstitution umrechnet, die Akkreditierung prüft und Ergebnisse manuell eingibt. Bei 15–25 Minuten pro Transcript entsprechen 30.000 Bewerbungen 7.500 bis 12.500 Arbeitsstunden pro Zulassungszyklus.
- Einschreibungsformulare — Anmeldepakete für neue Schüler enthalten typischerweise 8 bis 15 separate Seiten (Notfallkontakt, Gesundheitsinformationen, Wohnsitznachweis, frühere Schulbildung). Manuelle Dateneingabefehlerraten bei der Verarbeitung von Verwaltungsformularen liegen im Durchschnitt bei 18–25 %, wobei die kritischsten Felder — Kontaktnummern der Erziehungsberechtigten und medizinische Hinweise — die höchsten Fehlerkosten tragen.
- Finanzhilfe-Unterlagen — Die Verifizierung von FAFSA-Daten, Steuer-Transcripts und Einkommensnachweisen ist einer der dokumentintensivsten Arbeitsabläufe im Hochschulbereich und erfordert oft mehrere Prüfrunden pro Student.
Die meisten Schulen setzen weiterhin auf manuelle Verarbeitung, aus demselben Grund: Die Formate sind zu vielfältig für herkömmliche vorlagenbasierte OCR, und die Folgen eines Extraktionsfehlers — ein falscher GPA, eine übersehene Kursanrechnung — sind schwerwiegender als in den meisten geschäftlichen Dokumentenverarbeitungsszenarien.
Arten von Dokumenten im Bildungswesen
Jeder Dokumenttyp im Bildungswesen bringt eigene Extraktionsherausforderungen mit sich. Das Verständnis der Bandbreite verdeutlicht, warum ein Einheits-OCR-Ansatz für Schulen selten funktioniert.
1. Akademische Zeugnisse
Zeugnisse sind das komplexeste Bildungsdokument, das in großem Umfang verarbeitet werden muss. Ein einzelnes Zeugnis einer US-Highschool enthält typischerweise den Namen des Schülers, Geburtsdatum, Abschlussdatum, kumulativen GPA (gewichtet und ungewichtet), Klassenrang (falls zutreffend), eine Liste der Kurse nach Schuljahr, Endnoten für jeden Kurs, erworbene Leistungspunkte, Anwesenheitsaufzeichnungen und standardisierte Testergebnisse. Ein internationales Zeugnis fügt Sprachbarrieren, unterschiedliche Bewertungsskalen (prozentbasiert, buchstabenbasiert, IB-1-7-Skala, UK-A-Level-Tarifpunkte) und Anforderungen an die Anerkennung von Abschlüssen hinzu.
Die zentrale Extraktionsherausforderung: GPA ist keine feste Bezeichnung. Eine Schule nennt es „Grade Point Average", eine andere „Cumulative GPA", eine dritte platziert es in einem Feld mit der Bezeichnung „Academic Standing", und einige zeigen nur einen gewichteten GPA neben einem ungewichteten, ohne eines davon zu kennzeichnen. Ein vorlagenbasiertes OCR-System benötigt für jede dieser Variationen eine separate Konfiguration. An der Stony Brook University erzeugten ältere OCR-Tools bei der Verarbeitung von Zeugnissen Fehlerraten von bis zu 55 % – nicht weil die OCR die Zeichen nicht lesen konnte, sondern weil sie nicht zuverlässig erkennen konnte, welche Zahl auf der Seite der GPA war.
2. Einschreibungs- & Anmeldeformulare
Einschreibungsformulare sind bestenfalls halbstrukturiert. Schulbezirke im ganzen Land verwenden unterschiedliche Formularlayouts, einige von Schülerinformationssystemen (SIS) wie PowerSchool oder Infinite Campus generiert, andere von Papieroriginalen kopiert. Schlüsselfelder – gesetzlicher Name des Schülers, Geburtsdatum, Kontakt der Eltern/Erziehungsberechtigten, vorherige Schule – sind auf fast jedem Formular vorhanden, aber auf jedem anders positioniert.
Das handschriftliche Element erschwert die Sache zusätzlich. Unterschriften der Eltern, handschriftliche Notfallkontaktnummern und medizinische Informationsblätter sind häufige Quellen für Extraktionsfehler bei herkömmlicher OCR. KI-Modelle, die auf Handschrifterkennung trainiert sind, erreichen heute 85–95 % Genauigkeit bei angemessener Qualität handschriftlicher Einschreibungsformulare, aber die Variabilität auf Feldebene bleibt erheblich – eine schlecht geschriebene Ziffer in einer Telefonnummer kann das gesamte Kontaktfeld unbrauchbar machen.
3. Finanzhilfebescheide & Auszeichnungsdokumente
Finanzhilfebescheide enthalten strukturierte Finanzdaten, die Institutionen gegen FAFSA/ISIR-Aufzeichnungen verifizieren müssen. Förderbeträge, Stipendiennamen, Auszahlungspläne und Darlehensbedingungen erscheinen in unterschiedlichen Formaten je nach Institution. Die Herausforderung bei der Extraktion liegt hier weniger in der Zeichenerkennung als vielmehr im semantischen Mapping — dieselbe Art von Förderung (ein Federal Pell Grant) kann je nach Vorlage der Institution als „Pell Grant", „Federal Pell", „PELL" oder „Pell Award" bezeichnet werden. Ohne semantisches Verständnis löst jede Variante eine separate Dateneingabeentscheidung aus.
4. Berichte zu standardisierten Testergebnissen
SAT-, ACT-, AP-, IB- und staatliche Bewertungsberichte haben jeweils eigene Layoutkonventionen — und innerhalb dieser gibt es Formatvariationen über die Jahre hinweg. AP-Ergebnisberichte änderten beispielsweise 2023 ihre Layoutstruktur und brachen damit Vorlagen, die auf älteren Formaten basierten. Diese Dokumente sind typischerweise kurz (1–2 Seiten), aber felddicht: Eine einzelne AP-Ergebnisberichtsseite listet mehrere Testfächer, Ergebnisse (Skala 1–5) und Leistungsbeschreibungen auf. Die geringe Seitenzahl täuscht über eine hohe Extraktionsdichte hinweg, die präzise Feldgenauigkeit erfordert.
5. Individuelle Bildungsprogramme (IEPs) & Sonderpädagogische Dokumente
IEPs gehören zu den rechtlich sensibelsten Dokumenten im K-12-Bildungswesen. Sie enthalten die Behinderungsklassifikation eines Schülers, Jahresziele, Nachteilsausgleiche, Förderminuten und Fortschrittsberichtsdaten — all dies muss beim Schulwechsel eines Schülers zwischen Systemen präzise übertragen werden. Im Gegensatz zu Zeugnissen, die lose gemeinsamen Konventionen folgen, variieren IEP-Strukturen erheblich je nach Bundesstaat, Bezirk und sogar einzelner Schule. Ein IEP aus einem Bezirk könnte Nachteilsausgleiche im Checklistenformat organisieren, während ein anderer dieselben Informationen in erzählenden Absätzen einbettet.
FERPA-Vorschriften fügen eine zusätzliche Ebene hinzu: Das Zeugnis darf niemals darauf hinweisen, dass ein Schüler sonderpädagogische Nachteilsausgleiche in einem regulären Klassenzimmer erhalten hat. Das Office for Civil Rights (OCR) im US-Bildungsministerium hat mehrere Entscheidungen zu diesem Punkt erlassen — das bedeutet, dass das Extraktionssystem wissen muss, was es aus bestimmten Ausgaben ausschließen muss, nicht nur, was es einbeziehen muss.
6. Diplome, Zertifikate & Nachweise
Diplome und Abschlusszertifikate enthalten weniger Daten als Zeugnisse, haben aber ein hohes Verifikationsrisiko. Ein gefälschtes Diplom oder ein falsch übertragenes Abschlussdatum kann die ausstellende Einrichtung haftbar machen. Die Erfassung des Namens des Absolventen, des Verleihungsdatums, der Art des Nachweises und der ausstellenden Behörde aus Diplomscans erfordert eine OCR, die mit verzierten Schriftarten, Goldfolientext und unkonventionellen Layouts umgehen kann – Bedingungen, an denen herkömmliche OCR-Engines scheitern.
Besondere Herausforderungen bei der Extraktion im Bildungswesen
Über die Vielfalt der Dokumenttypen hinaus stehen OCR-Systeme im Bildungswesen vor strukturellen Herausforderungen, die Bildung zu einer der schwierigsten Branchen für die Dokumentextraktion machen:
Formatvielfalt zwischen Bildungseinrichtungen
In den Vereinigten Staaten gibt es über 4.000 Hochschulen mit Abschlussberechtigung und etwa 100.000 öffentliche K-12-Schulen. Die überwiegende Mehrheit verwendet unterschiedliche Zeugnis- und Formularlayouts. Ein vorlagenbasierter OCR-Ansatz – bei dem jedes Format eine vorkonfigurierte Vorlage erfordert – steht vor einer unmöglichen Wartungslast: Jede neue Zubringerschule, jede Formatneugestaltung einer bestehenden Schule und jedes internationale Zeugnis erfordert eine neue Vorlage oder einen manuellen Rückgriff.
KI-gestützte Extraktion löst dieses Problem, indem sie formatunabhängig arbeitet. Statt zu lernen, wo Daten auf einer Seite stehen, lernt das Modell, wie Daten semantisch aussehen: Es erkennt eine GPA, weil der umgebende Kontext „GPA" oder „Grade Point Average" sagt oder weil die Zahl neben einer Kreditpunktsumme in einer bestimmten visuellen Position steht. Herkömmliche OCR identifiziert Zeichen, ohne sie zu verstehen; KI-Extraktion liest das Dokument so, wie ein Mensch es tun würde – ganzheitlich und im Kontext.
Genauigkeit der GPA-Extraktion
Die GPA ist das wichtigste Feld auf einem Zeugnis und gleichzeitig das fehleranfälligste bei der automatischen Extraktion. Zwei Probleme kommen zusammen:
- Mehrere GPAs auf einem Dokument – Viele Zeugnisse zeigen eine gewichtete GPA, eine ungewichtete GPA und manchmal eine kumulative GPA neben einer Semester-GPA. Die Extraktion der falschen kann die Einstufung der Zulassungsberechtigung eines Studierenden verändern.
- Mehrdeutigkeit der Skala – Eine 4.0-GPA auf einer 4.0-Skala ist nicht dieselbe Leistung wie eine 4.0 auf einer 5.0-Skala, doch das Dokument macht die Skala oft nicht explizit. Das Extraktionssystem muss die Skala aus dem Kontext ableiten oder externe Referenzdaten verwenden.
Ein Forschungspapier von 2026 über Multi-Agenten-KI-Systeme zur Verarbeitung von High-School-Zeugnissen berichtete von 96,7 % Genauigkeit bei 100 % Abschlussquote bei verschiedenen High-School-Zeugnissen, wobei jedes Zeugnis in 45 Sekunden zu Kosten von $0.15 verarbeitet wurde. Das Papier identifizierte die GPA-Extraktion als primäres „Vertrauenssignal" für die gesamte Extraktionsqualität – wenn die GPA korrekt war, waren die übrigen Felder mit überwältigender Wahrscheinlichkeit ebenfalls korrekt.
Handschrift & historische Papierarchive
Schulen, die von jahrzehntelangen Papierakten umstellen, stehen vor einem Digitalisierungsrückstand, der Generationen von Schülern umfasst. Viele Anmeldeformulare, sonderpädagogische Unterlagen und ältere Zeugnisse existieren nur als handschriftliche Originale oder Fotokopien. Die Handschriftproblematik wird durch variable Tintenqualität, gealtertes Papier und uneinheitliches Ausfüllen der Formulare verstärkt – einige Abschnitte mit Kugelschreiber, andere mit Bleistift, wieder andere leer gelassen.
Dies ist ein Szenario, in dem herkömmliche OCR unter die nutzbaren Genauigkeitsschwellen fällt, moderne Vision-Language-Modelle, die mit vielfältigen Handschriftproben trainiert wurden, jedoch aus einem höheren Anteil der Dokumente nutzbare Daten extrahieren können. Der praktische Ansatz für historische Archive ist eine Human-in-the-Loop-Prüfpipeline: Die KI übernimmt den ersten Durchlauf, markiert Felder mit geringer Konfidenz, und ein geschulter Prüfer validiert oder korrigiert diese spezifischen Werte.
Datenkonsistenz über Systeme hinweg
Ein extrahierter GPA oder ein Einschreibedatum ist nur dann nützlich, wenn er im richtigen Feld des SIS der Einrichtung landet (Ellucian Banner, Workday Student, PowerSchool usw.). Viele OCR-Tools extrahieren Daten in eine Tabellenkalkulation, lassen die SIS-Integration jedoch als manuellen Schritt offen. IT-Abteilungen im Bildungswesen, die Extraktionstools evaluieren, sollten Lösungen priorisieren, die entweder strukturierte CSV/JSON-Daten für den automatisierten Import exportieren oder sich direkt über eine API mit ihrer SIS-Plattform verbinden.
Alter Weg vs. KI-gestützte Extraktion
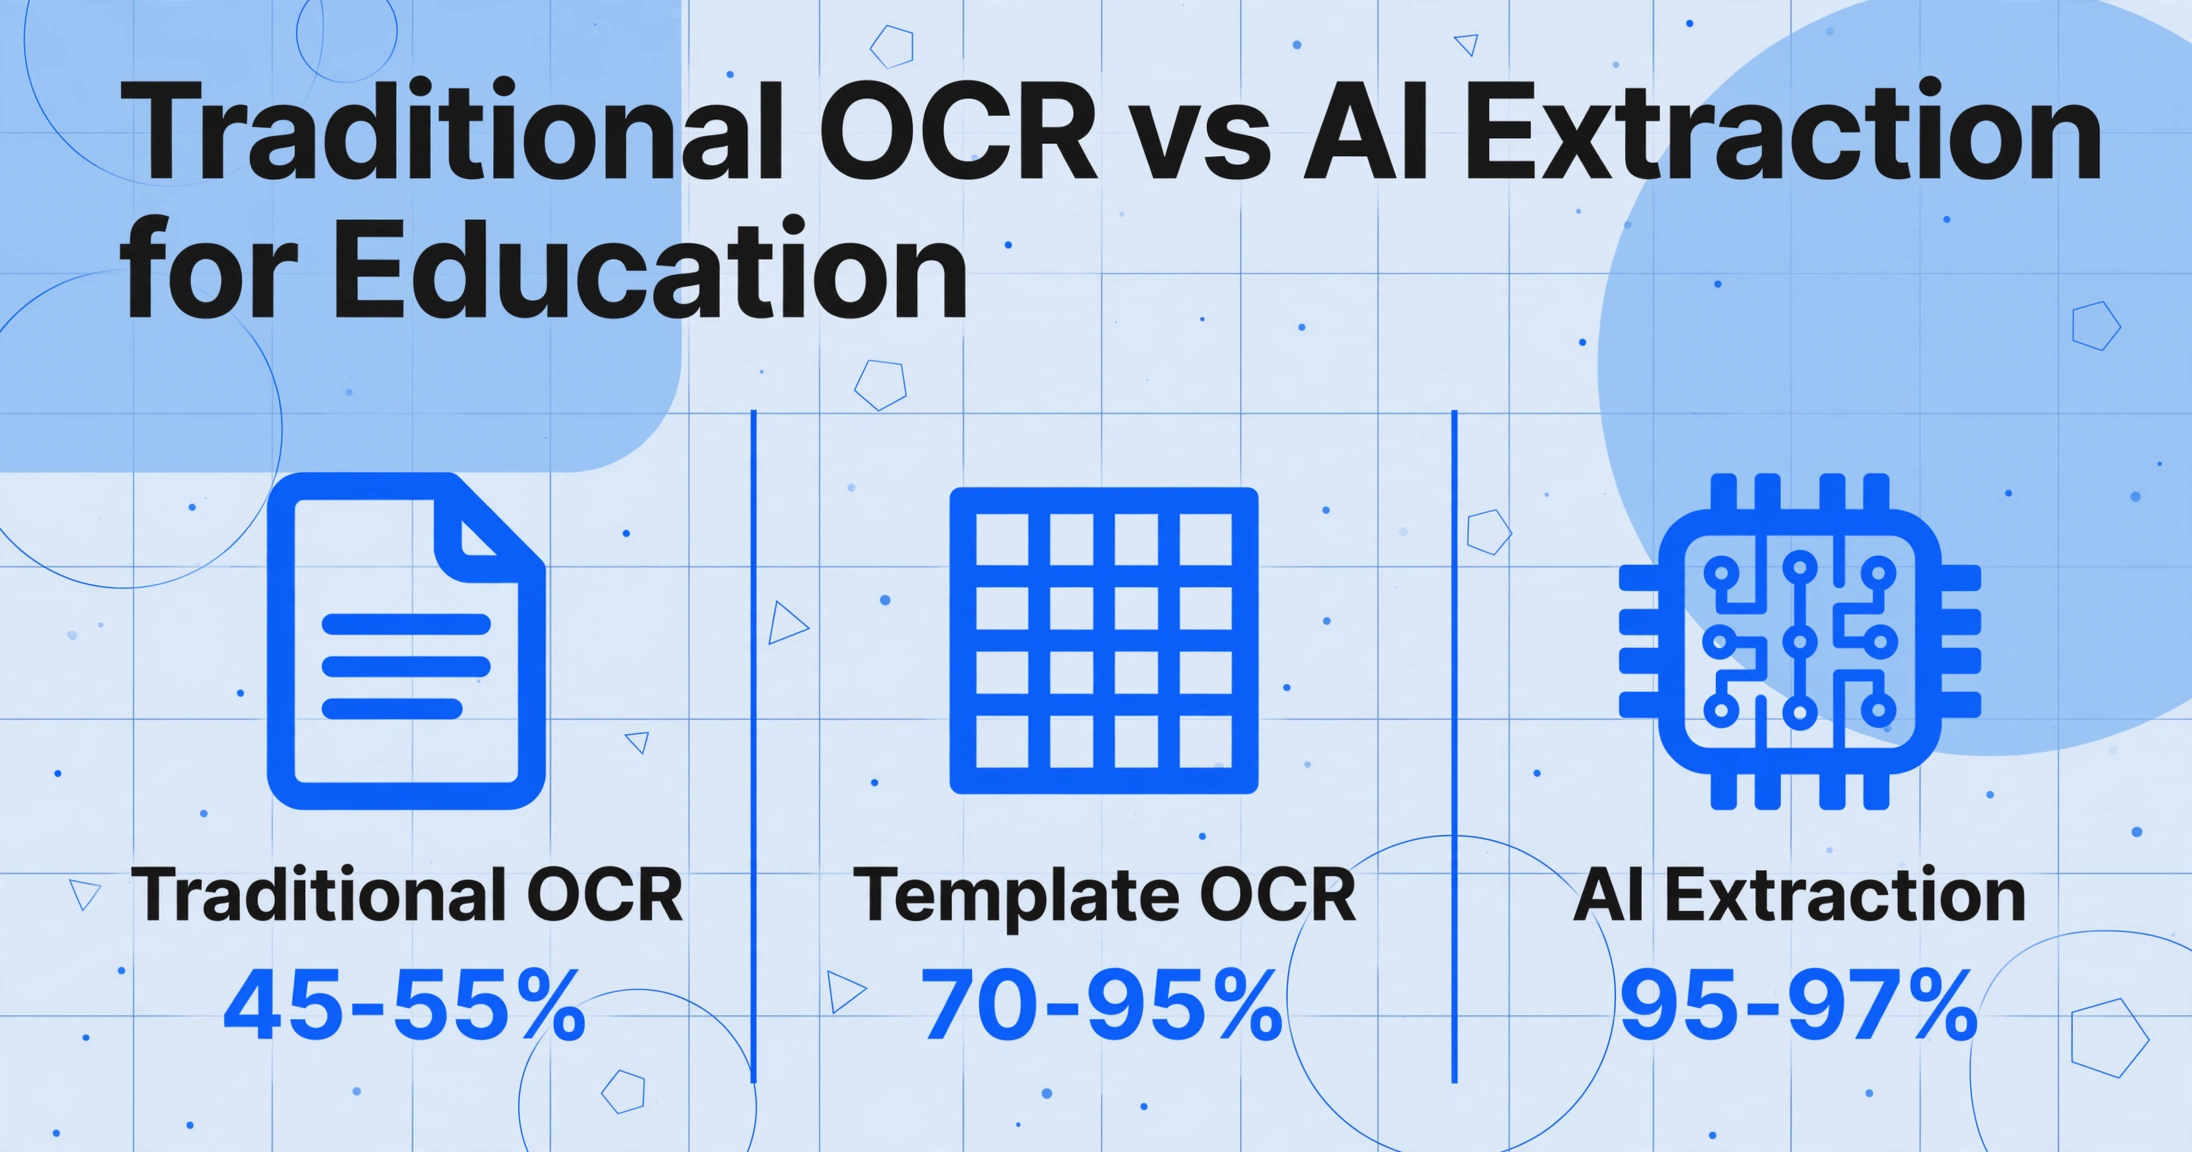
| Dimension | Traditioneller OCR-/Template-Ansatz | KI-gestützte Extraktion |
|---|---|---|
| Formatverarbeitung | Erfordert ein separates Template pro Einrichtungslayout | Liest jedes Layout ohne Vorkonfiguration |
| GPA-Extraktion | Zonenbasiert: extrahiert bei Positionsverschiebung leicht den falschen GPA | Semantisch: identifiziert GPA anhand von Bedeutung und Kontext |
| Handschrift | Unter 50 % Genauigkeit bei Schreibschrift oder gemischten Handschriftformularen | 85-95 % Genauigkeit bei Handschrift angemessener Qualität |
| Skalenverarbeitung | Kann 4.0- und 5.0-GPA-Skalen ohne manuelle Kennzeichnung nicht unterscheiden | Leitet die Skala aus dem Kontext ab (z. B. „AP“-Kurse → gewichtete Skala) |
| Reaktion auf Formatänderungen | Template bricht; manuelle Neukonfiguration erforderlich | Passt sich automatisch an; keine Wartung erforderlich |
| Internationale Dokumente | Länderspezifische Templates erforderlich; scheitert bei unerwarteten Layouts | Verarbeitet gemischtsprachige und unbekannte Formate |
| Einrichtungszeit | Wochen bis Monate für Template-Erstellung und -Tests | Minuten: Dokument hochladen, Felder benennen, extrahieren |
Der entscheidende Unterschied: Herkömmliche OCR extrahiert Zeichen, ohne sie zu verstehen. KI-gestützte Extraktion liest ein Dokument semantisch – sie weiß, dass „3.75" neben „Cumulative GPA" die Zahl ist, die über die Zulassungsberechtigung entscheidet, während dieselben drei Zeichen in einer Kurscode-Spalte etwas völlig anderes bedeuten.
Wichtige Felder nach Dokumenttyp
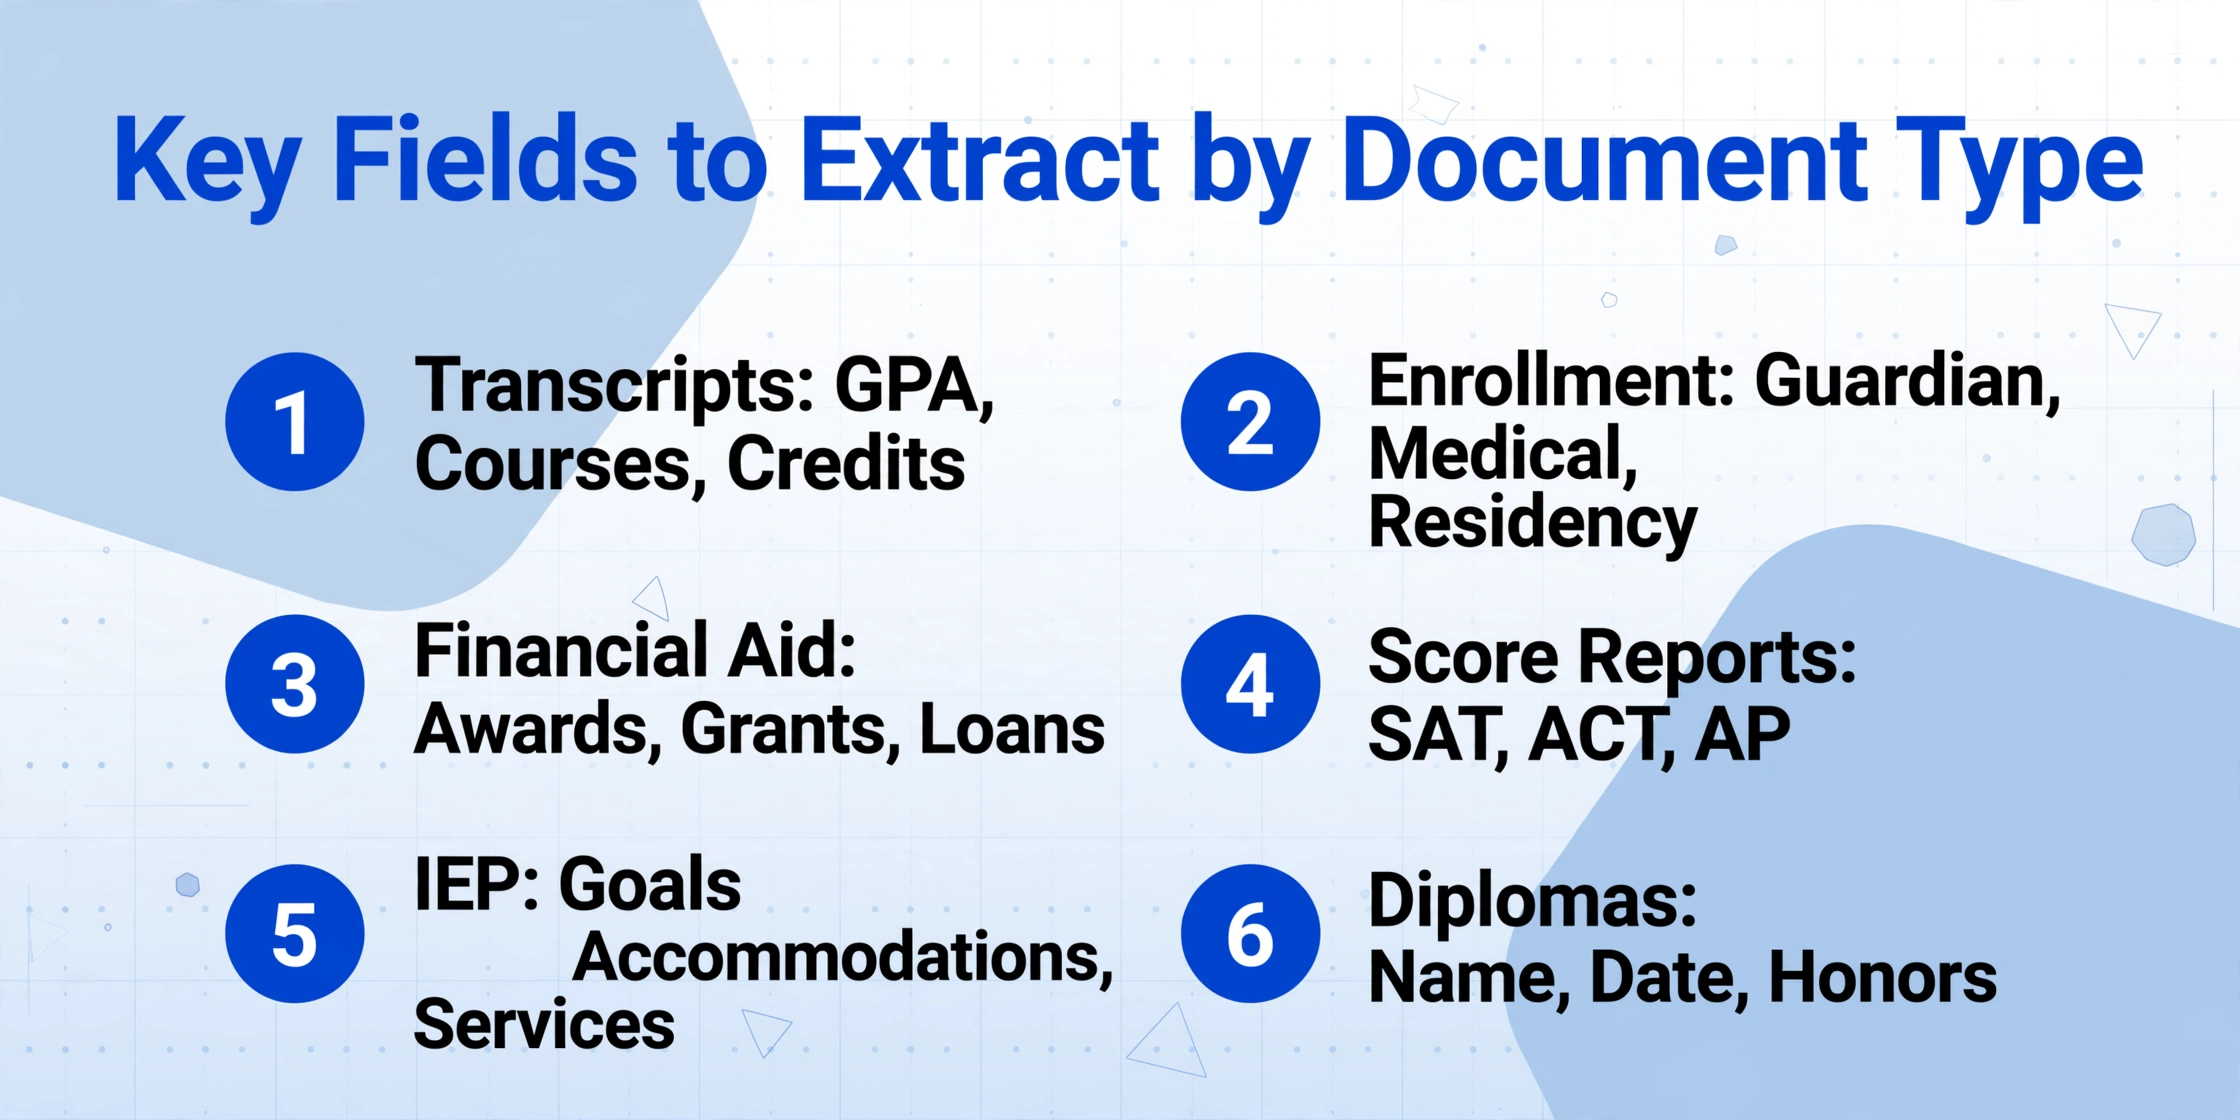
Nachfolgend finden Sie eine Referenztabelle der wichtigsten Felder der gängigsten Bildungsdokumenttypen. Institutionen, die eine Extraktionslösung planen, sollten mit dieser Liste beginnen und sie an ihre spezifischen Workflow-Anforderungen anpassen.
| Dokumenttyp | Primäre Felder | Wichtigste Extraktionsherausforderung |
|---|---|---|
| Akademisches Zeugnis | Studentenname, Geburtsdatum, GPA (gewichtet & ungewichtet), Klassenrang, Kursliste mit Noten, Leistungspunkte, Abschlussdatum, Notenskala | Mehrere GPAs, Skalen-Mehrdeutigkeit, Kurscode-Varianz zwischen Institutionen |
| Einschreibungsformular | Rechtlicher Studentenname, Geburtsdatum, Adresse, Name des Elternteils/Erziehungsberechtigten, Kontaktinformationen, vorherige Schule, Klassenstufe, Notfallkontakte, medizinische Hinweise | Handschriftliche Felder, halbstrukturiertes Layout, fehlende oder inkonsistente Feldbezeichnungen |
| Finanzhilfe-Bescheid | Förderbeträge, Stipendiennamen, Zuschussarten (Pell, SEOG, institutionell), Darlehensbedingungen, Auszahlungsplan, Studienjahr | Inkonsistente Namenskonventionen für dieselbe Förderart |
| SAT/ACT/AP-Ergebnisbericht | Studentenname, Testdatum, Fachpunktzahlen, Gesamtpunktzahl, Perzentilrang, Punkteskala | Dichtes Mehrfachfach-Layout, Formatänderungen über Testjahre hinweg |
| IEP / Sonderpädagogisches Dokument | Studentenname, Behinderungsklassifikation, Jahresziele, Nachteilsausgleiche, Förderminuten, IEP-Datum, Überprüfungsdatum, Fallmanager | Große strukturelle Varianz, narrative vs. Checklisten-Formate, FERPA-sensible Inhalte |
| Diplom / Zertifikat | Absolventenname, Verleihungsdatum, Abschlussart, ausstellende Behörde, Auszeichnungen | Verzierte Schriftarten, Goldfolie, nicht standardmäßiges Layout, geringer Scan-Kontrast |
Für Institutionen, die einen Benutzerdefinierte Spaltenextraktion-Ansatz verwenden – bei dem Sie einfach die gewünschten Feldnamen eingeben und die KI sie semantisch lokalisiert – dient diese Tabelle zugleich als Konfigurationsanleitung. Anders als vorlagenbasierte Tools, die das Einzeichnen von Zonen um jedes Feld auf einem Beispieldokument erfordern, ermöglicht die semantische Extraktion das Hinzufügen neuer Felder durch bloßes Eintippen eines Namens. Wenn eine neue Partnerschule ein Zeugnis sendet, das „GPA" als „Academic Index" bezeichnet, benötigen Sie keine neue Vorlage – die KI leitet die Übereinstimmung aus dem Kontext ab.
FERPA & Compliance: Was OCR-Systeme berücksichtigen müssen
Der Family Educational Rights and Privacy Act (FERPA), 1974 erlassen und in 34 CFR Part 99 kodifiziert, regelt den Datenschutz von Schülerbildungsunterlagen an allen Einrichtungen, die Bundesmittel vom US-Bildungsministerium erhalten. Für Schulen, die OCR- oder KI-basierte Dokumentenextraktion in Betracht ziehen, schafft FERPA spezifische Verpflichtungen, die das Extraktionssystem und sein Einsatz erfüllen müssen — ähnlich wie OCR für Rechtsdokumente die FRCP- und ABA-Modellregeln erfüllen muss, jedoch mit eigenen Anforderungen an elterliche Einwilligung und Offenlegungsverfolgung.
Was FERPA schützt
FERPA definiert „Bildungsunterlagen" weit gefasst: jede Unterlage, die sich direkt auf einen Schüler bezieht und von einer Bildungseinrichtung oder ihrem Beauftragten geführt wird. Dies umfasst ausdrücklich Zeugnisse, Noten, GPA-Berechnungen, Stundenpläne, Disziplinarakten, sonderpädagogische Unterlagen (einschließlich IEPs) sowie von der Schule geführte Gesundheits- und Impfunterlagen. Wenn eine Schule ein externes Dokumentenextraktionstool zur Verarbeitung dieser Unterlagen einsetzt, gelten die FERPA-Anforderungen für das Tool und seine Datenverarbeitung, als wäre es die Schule selbst.
Wichtige Anforderungen an Dokumentenextraktionssysteme
- Zugriffskontrollen — Nur Personal mit „berechtigtem Bildungsinteresse" darf auf Schülerunterlagen zugreifen. Das Extraktionssystem muss rollenbasierte Zugriffskontrollen durchsetzen und Prüfprotokolle darüber führen, wer jedes Dokument eingesehen oder exportiert hat.
- Offenlegungsverfolgung — FERPA verlangt von Einrichtungen, jede Anfrage auf Zugriff und jede Offenlegung personenbezogener Informationen aus Bildungsunterlagen zu protokollieren. Die Extraktionsplattform sollte standardmäßig alle Datenexporte und Freigabeaktionen protokollieren.
- Rechte der Eltern und berechtigter Schüler — Eltern minderjähriger Schüler und berechtigte Schüler (ab 18 Jahren oder an einer postsekundären Einrichtung) haben das Recht, Bildungsunterlagen innerhalb von 45 Tagen nach Antrag einzusehen. Digitalisierte Unterlagen müssen innerhalb dieser Frist abruf- und vorlegbar sein.
- Pflichten externer Dienstleister — Jeder externe Extraktionsanbieter, der Schülerbildungsunterlagen speichert, verarbeitet oder übermittelt, muss vertraglich zur Einhaltung der FERPA-Nutzungsbeschränkungen verpflichtet sein. Schulen müssen die Datensicherheitspraktiken, Verschlüsselungsstandards und Unterauftragsverhältnisse der Anbieter vor dem Einsatz bewerten.
Aufbewahrungsfristen gemäß FERPA
FERPA selbst schreibt keine bestimmten Aufbewahrungsfristen vor, aber Landesgesetze und Akkreditierungsanforderungen legen praktische Mindestfristen fest. Der gängige Industriestandard:
- Vorläufige Unterlagen (Anwesenheitsdaten, Notenlisten, Stundenplandokumente) — mindestens 5 Jahre nach dem Ausscheiden des Studierenden aus der Einrichtung aufbewahren.
- Dauerhaft aufzubewahrende Unterlagen (Transcripts, Diplome, offizielle Testergebnisse, endgültige Disziplinarakten) — mindestens 60 Jahre aufbewahren.
Ein OCR- oder KI-Extraktionssystem, das in diesem Rahmen arbeitet, muss extrahierte Daten über einen vergleichbaren Zeitraum speichern, mit Garantien für Datenintegrität und Exportierbarkeit in Standardformaten (CSV, JSON, XLSX), damit Unterlagen unabhängig vom ursprünglichen Extraktionstool zugänglich bleiben.
Besondere Überlegungen für sonderpädagogische Dokumente
IEPs und sonderpädagogische Unterlagen haben zusätzliche Compliance-Nuancen. Das Office for Civil Rights des US-Bildungsministeriums hat festgestellt, dass Transcripts nicht durch besondere Vermerke, Sternchen oder Symbole anzeigen dürfen, dass ein Studierender in einem allgemeinen Unterrichtsraum Nachteilsausgleich erhalten hat. Jede Extraktionspipeline, die Transcript-Daten aus demselben System ausgibt, das auch IEP-Daten verarbeitet, muss sicherstellen, dass behinderungsbezogene Kennzeichnungen nicht versehentlich in Transcript-Felder übernommen werden.
Dies ist eine Compliance-Anforderung, die template-basierte OCR-Systeme nur schwer erfüllen können — sie extrahieren, was in der Zone steht, ohne zu verstehen, welche Inhalte in einem bestimmten Output zulässig sind. Semantische Extraktionssysteme können Ausgaberegeln anwenden: Sie verstehen, dass „Nachteilsausgleich: Zeitverlängerung" zum IEP-Datensatz gehört, aber aus dem Transcript-Feed ausgeschlossen werden muss.
Worauf Sie bei einem OCR-Tool für Bildungseinrichtungen achten sollten
Nicht jedes Dokumentextraktionstool eignet sich für Bildungsabläufe. Hier sind die spezifischen Kriterien, die Sie bei der Auswahl einer Lösung für die Verarbeitung von Studierendendaten bewerten sollten:
Das Tool muss verstehen, was Felder bedeuten, nicht nur, wo sie sich befinden. Wenn das GPA-Feld versagt, weil ein Zeugnis einer neuen Partnerschule es in einer anderen Ecke der Seite platziert, ist das Tool für Bildung in großem Maßstab ungeeignet.
Rollenbasierte Zugriffskontrollen, Verschlüsselung im Ruhezustand und bei der Übertragung, Audit-Protokollierung und vertragliche FERPA-Compliance-Zusagen. Wenn der Anbieter keine unterzeichnete FERPA-Datenschutzvereinbarung vorlegen kann, weiterziehen.
Bildung ist ein Stapel-Workflow – 200 Zeugnisse kommen zusammen an, nicht einzeln. Das Tool muss mehrere Dokumente gleichzeitig verarbeiten und die Ergebnisse in einer einzigen aggregierten Tabelle zusammenführen, die jeden extrahierten Wert einem bestimmten Dokument zuordnet.
Ein erheblicher Teil der Einschreibungsformulare, Einverständniserklärungen und historischen Aufzeichnungen enthält handschriftliche Einträge. Die Handschrifterkennungsfähigkeit des Tools bestimmt direkt, ob es diese Dokumente ohne manuelle Transkription verarbeiten kann.
CSV- und JSON-Exporte mit klar zugeordneten Feldern ermöglichen IT-Teams, automatisierte Import-Pipelines zu Ellucian, Workday, PowerSchool oder anderen SIS-Plattformen aufzubauen. Die manuelle Neueingabe extrahierter Daten macht den Zweck der Automatisierung zunichte.
Nicht alle extrahierten Werte sind gleichermaßen sicher. Ein Tool, das Konfidenzwerte pro Feld meldet – nicht nur pro Dokument – ermöglicht es Prüfern, ihre Verifikationsbemühungen auf die 10 % der Felder zu konzentrieren, die es benötigen, statt jeden Eintrag erneut zu prüfen.
Häufig gestellte Fragen
Welche Arten von Bildungsdokumenten kann OCR verarbeiten?
Moderne KI-gestützte OCR kann akademische Zeugnisse, Einschreibungs- und Registrierungsformulare, Finanzhilfebescheide, standardisierte Testergebnisberichte (SAT, ACT, AP, IB), IEPs und sonderpädagogische Dokumente, Diplome und Zertifikate, Impfaufzeichnungen sowie Nachweise über den Wohnsitz verarbeiten. Der entscheidende Faktor ist nicht der Dokumenttyp, sondern die Qualität des Scans und die Fähigkeit des Tools, Feldsemantik statt fester Positionen zu verstehen.
Wie genau ist OCR bei der GPA-Extraktion aus Zeugnissen?
Die Genauigkeit hängt stark davon ab, ob das Tool positionsbasierte OCR (Vorlagenabgleich) oder semantische KI-Extraktion verwendet. Vorlagenbasierte Systeme zeigen eine große Genauigkeitsspanne – von bis zu 95 % bei bekannten Formaten bis zu nur 45 % bei unbekannten Layouts. KI-gestützte Systeme, die akademischen Kontext verstehen, erreichen 95–97 % Feldgenauigkeit über verschiedene Zeugnisformate hinweg, wobei der Hauptfehlerpunkt mehrdeutige GPA-Skalenangaben sind. Die meisten Produktionsumgebungen ergänzen die automatisierte Extraktion um eine menschliche Prüfebene für die kritischsten Felder.
Ist die Nutzung eines Drittanbieter-OCR-Tools FERPA-konform?
Ja, sofern die Einrichtung und der Anbieter die FERPA-Anforderungen erfüllen: Der Anbieter muss vertraglich als „Schulbeamter" mit „berechtigtem Bildungsinteresse" benannt sein; Studentendaten müssen im Ruhezustand und während der Übertragung verschlüsselt sein; der Zugriff muss rollenbasiert sein; und die Einrichtung muss die direkte Kontrolle darüber behalten, wie die Daten verwendet und aufbewahrt werden. Schulen sollten vor der Verarbeitung lebender Studentenakten von jedem Anbieter eine unterzeichnete FERPA-Konformitätsvereinbarung anfordern.
Kann OCR handschriftliche Einschreibungsformulare lesen?
Traditionelle OCR hat begrenzte Handschrifterkennungsfähigkeiten – typischerweise unter 50 % Genauigkeit bei Schreibschrift oder gemischten handschriftlichen Dokumenten. Moderne KI-Visionsmodelle, die mit Handschriftdatensätzen trainiert wurden, erreichen 85–95 % Genauigkeit bei klarer Handschrift und 70–80 % bei schwieriger Handschrift (schlechte Handschrift, kontrastarme Tinte, überlappende Markierungen). Für kritische Felder wie Telefonnummern oder rechtliche Namen wird bei handschriftlichen Inhalten ein menschlicher Prüfschritt empfohlen.
Was kostet die Implementierung von OCR für Schülerakten?
Die Kosten reichen von kostenlosen Open-Source-OCR-Engines (mit hohem manuellen Konfigurationsaufwand und laufender Vorlagenpflege) bis hin zu abonnementbasierten KI-Extraktionstools, die pro Seite oder pro Dokument abgerechnet werden. Für mittelgroße Einrichtungen, die jährlich 10.000–50.000 Dokumente verarbeiten, kostet KI-gestützte Extraktion typischerweise 0,10–0,50 $ pro Seite, ohne Einrichtungsgebühren für Vorlagen. Das schneidet günstig ab im Vergleich zu den Arbeitskosten der manuellen Verarbeitung, die im Schnitt 3–6 $ pro Zeugnis allein an Personalkosten verursacht, wenn man Datenerfassung, Prüfung und Systemaktualisierungen einrechnet.
Können wir mit OCR Jahrzehnte alte historische Papierakten digitalisieren?
Ja, aber mit Einschränkungen. Historische Papierarchive stehen vor Herausforderungen, die aktuelle eingehende Dokumente nicht haben: gealtertes oder vergilbtes Papier verringert den Kontrast, handschriftliche Aufzeichnungen aus mehreren Jahrzehnten verwenden unterschiedliche Schreibgeräte und -stile, und ältere Zeugnislayouts ähneln modernen kaum. Ein schrittweiser Ansatz – zuerst mit eingehenden Dokumenten den Workflow aufbauen, dann historische Archive in Stapeln mit einem manuellen Prüfdurchgang verarbeiten – ist praktischer als der Versuch eines einzigen Massendigitalisierungsprojekts.
Die Verarbeitung von Bildungsunterlagen muss kein Engpass sein – nicht während der Einschreibungssaison, nicht bei der Zeugnisbewertung, nicht bei der historischen Digitalisierung.
Der Unterschied zwischen einem Tool, das Zeichen liest, und einem Tool, das akademische Daten versteht, entscheidet, ob Ihr Büro 50 Dokumente pro Tag oder 500 verarbeitet. Mit vorlagenfreier, semantischer Extraktion definieren Sie die Felder, die Sie benötigen – Studentenname, GPA, Kursnummern, Einschreibungsdaten – und die KI lokalisiert sie in jedem Dokumentformat, von jeder Einrichtung, ohne Vorkonfiguration.
Testen Sie es mit Ihren eigenen Schülerakten. Sehen Sie, wie Ihr nächster Zeugnisbewertungszyklus aussehen könnte.