銀行向けOCR:
小切手処理・明細書抽出・KYC自動化
小切手、銀行明細書、KYC文書という3つの銀行文書カテゴリは、金融機関における手動データ入力時間の大部分を占めています。 連邦準備制度理事会の2026年リスク責任者報告書によると、金融機関の63%が過去12か月間に小切手詐欺の試行を報告しています。AFPの2026年決済詐欺調査では、組織の58%が小切手詐欺を報告しており、最も詐欺被害に遭いやすい決済手段となっています。一方、銀行の残高照合チームは毎月数日を費やして、スプレッドシートにきれいに整列しない明細書の取引行を手動で入力しています。また、コンプライアンス担当者はKYC文書の処理に1ファイルあたり30〜60分のサイクルタイムを費やしています。
重要ポイント
- 銀行はOCR投資を小切手処理、明細書抽出、KYC検証という3つの独立したパイプラインに注ぎ込んでいますが、そのすべてが1つの前提に依存しています。それは「文書レイアウトは変わらない」という前提です。
- 文字レベルで99%の精度を持つOCRでも、KYCページ1枚につき5文字の誤認識が発生します。パスポート番号の1桁の誤りは、監査証跡では説明できないコンプライアンス違反を意味します。
- Vision AIはピクセル座標ではなくフィールドの意味に基づいて銀行文書を抽出するため、Chaseが明細書を再設計しても、顧客がスマートフォンを回転させても、1つの列定義があらゆる銀行フォーマットで機能します。
銀行業務はドキュメントで成り立っています。しかし、請求書とは異なり、請求書は少なくともほとんどのベンダー間で大まかな構造上の共通点がありますが、銀行ドキュメントは標準化の試みすべてに抵抗します。小切手は1950年代に発明された磁気インクフォントに依存しています。Chaseの銀行明細書と地域の信用組合の明細書は、レイアウトの慣例をほぼ共有していません。KYCに使用されるパスポートはICAO基準に従いますが、運転免許証は数年ごとに変わる州レベルの規則に従います。
この記事では、銀行業務におけるOCR導入を促進する3つのドキュメントタイプを取り上げ、それぞれが提示する具体的な技術的課題を説明し、従来のOCRがどこで限界に達するか、そしてビジョンAIがどこで介入するかを示します。
OCR導入を促進する銀行業務の3つのドキュメント
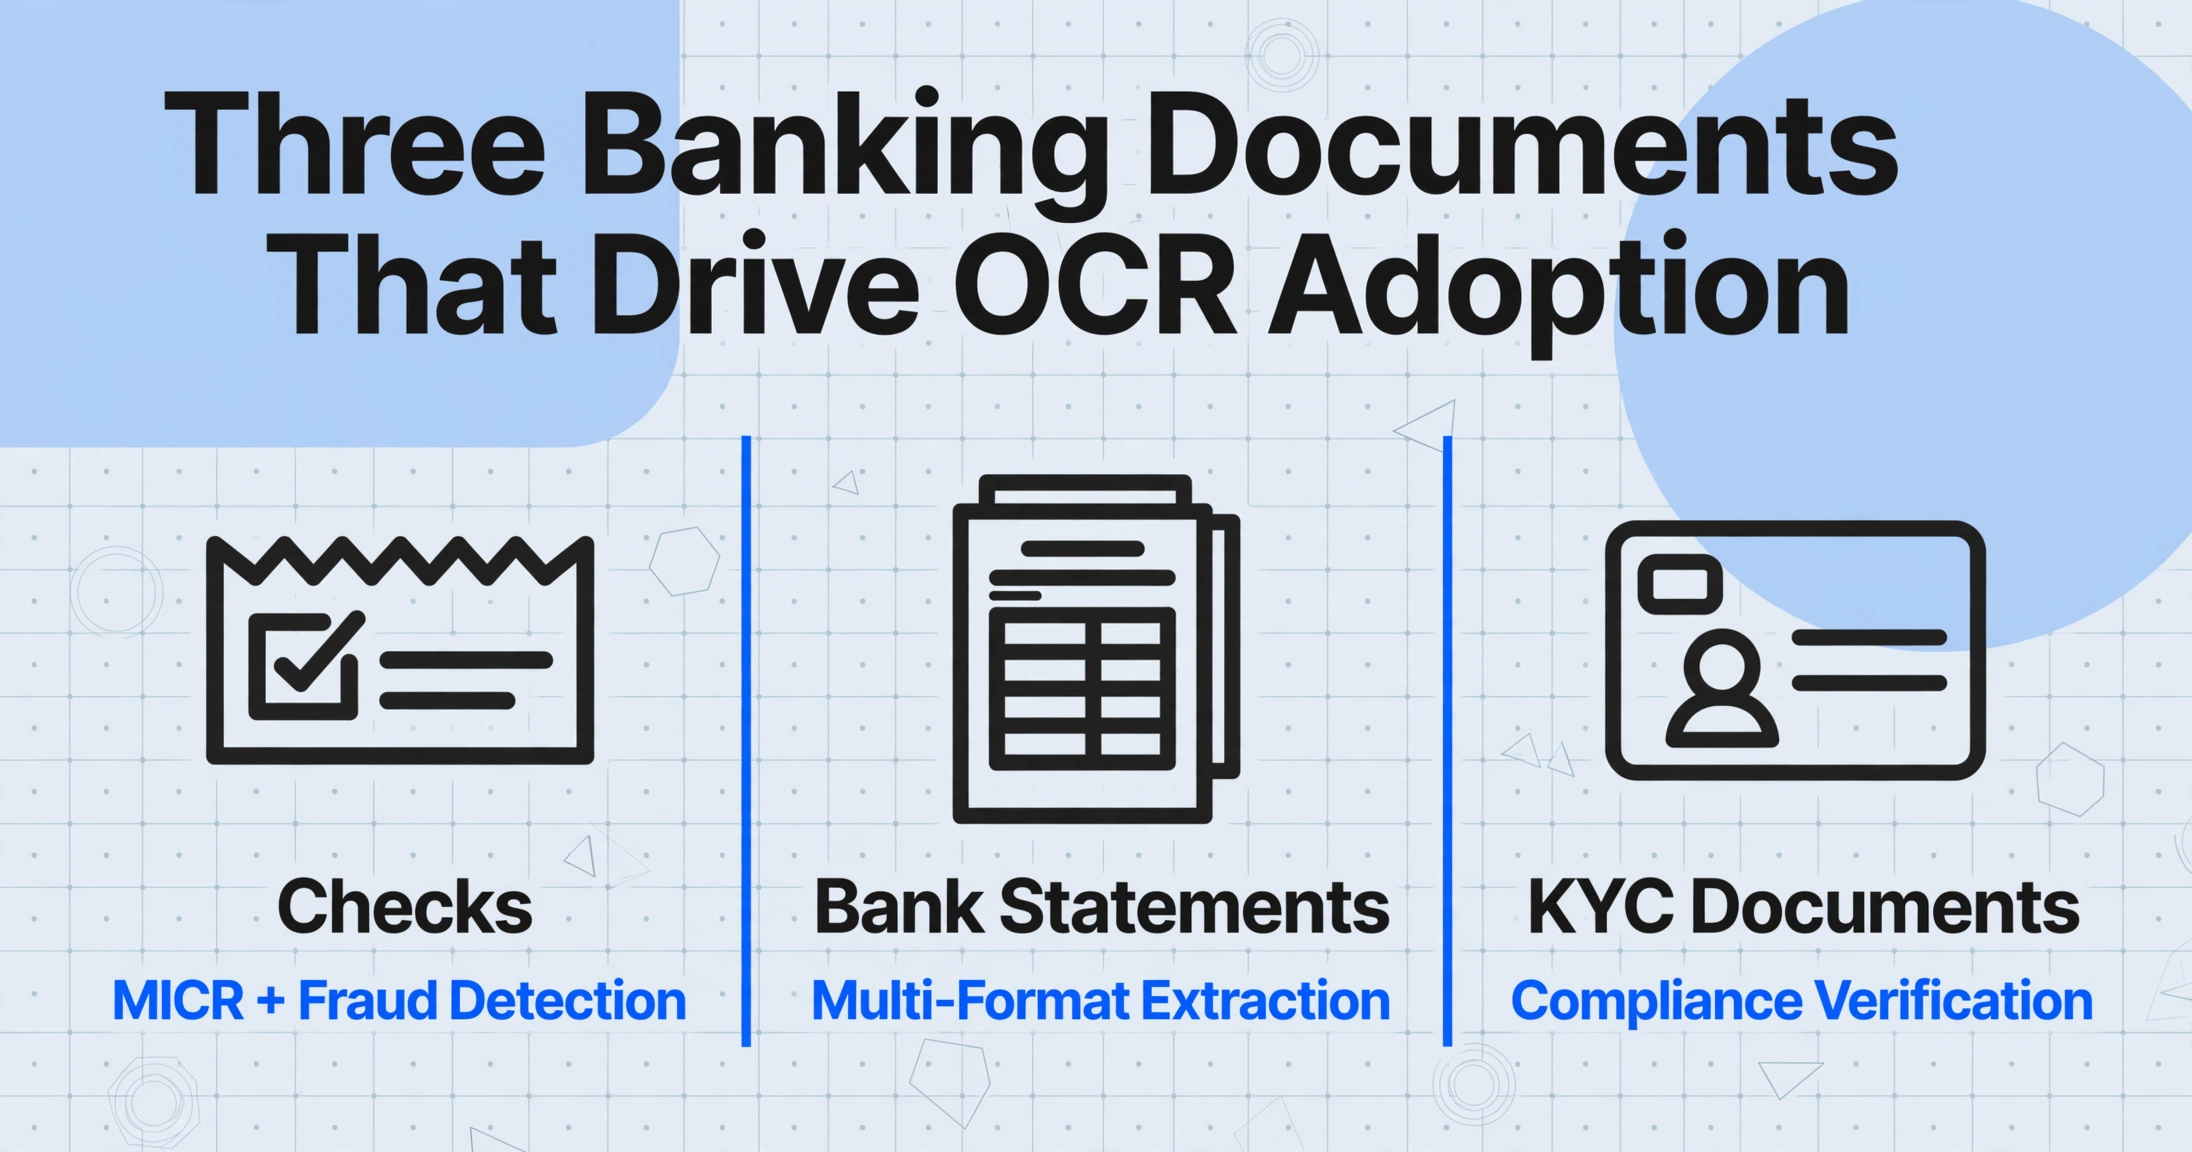
銀行業務の専門家がOCRについて話すとき、通常は3つの異なるワークフローのいずれかを指しており、それぞれに独自の技術要件、障害モード、規制上の重要性があります。
小切手・支払い処理
磁気インク文字認識(MICR)は小切手のクリアリングの基盤です。銀行は毎日数百万枚の小切手を、各小切手の下部にあるE-13Bフォント行を読み取る高速仕分け機で処理しています。課題はMICRだけにとどまりません。不正検出には、数字金額認識(CAR)と文字金額認識(LAR)領域の読み取り、裏書きパターンの検証、改ざんの検出が必要です。AFP調査によると、2025年には組織の58%が小切手詐欺を報告しています。
銀行明細書の抽出と照合
銀行ごとに明細書の形式は異なります。取引テーブルは複数の列にまたがることがあり、日付、説明、借方、貸方、残高などがあり、これらの列は同じ明細書内でもページごとに位置が変わります。残高はページをまたいで連続している必要があります。テンプレートベースのOCRはここで限界に達します。AIを活用した銀行明細書の抽出は、ピクセル座標ではなくフィールドの意味を理解することで、これらのばらつきに対応します。
KYC・ローン書類の検証
顧客オンボーディングでは、本人確認書類(パスポート、運転免許証)、住所確認(公共料金請求書、銀行明細書)、財務的証拠(給与明細、税務申告書、W-2)の検証が求められます。BSA/AML規制への準拠には、正確な抽出と監査証跡が必要です。手動のKYC処理はファイルあたり30〜60分かかりますが、OCRとAIを活用した自動化されたeKYCは、標準的な申請では5分未満に短縮されます。これはアジアおよび欧州の銀行からの公開導入データに基づいています。
これら3つのワークフローには共通点があります。いずれも半構造化または非構造化の文書画像から構造化データを抽出する作業です。しかし、一方で機能する技術的アプローチが、他のケースではしばしば失敗します。
小切手処理:OCRとMICRの融合
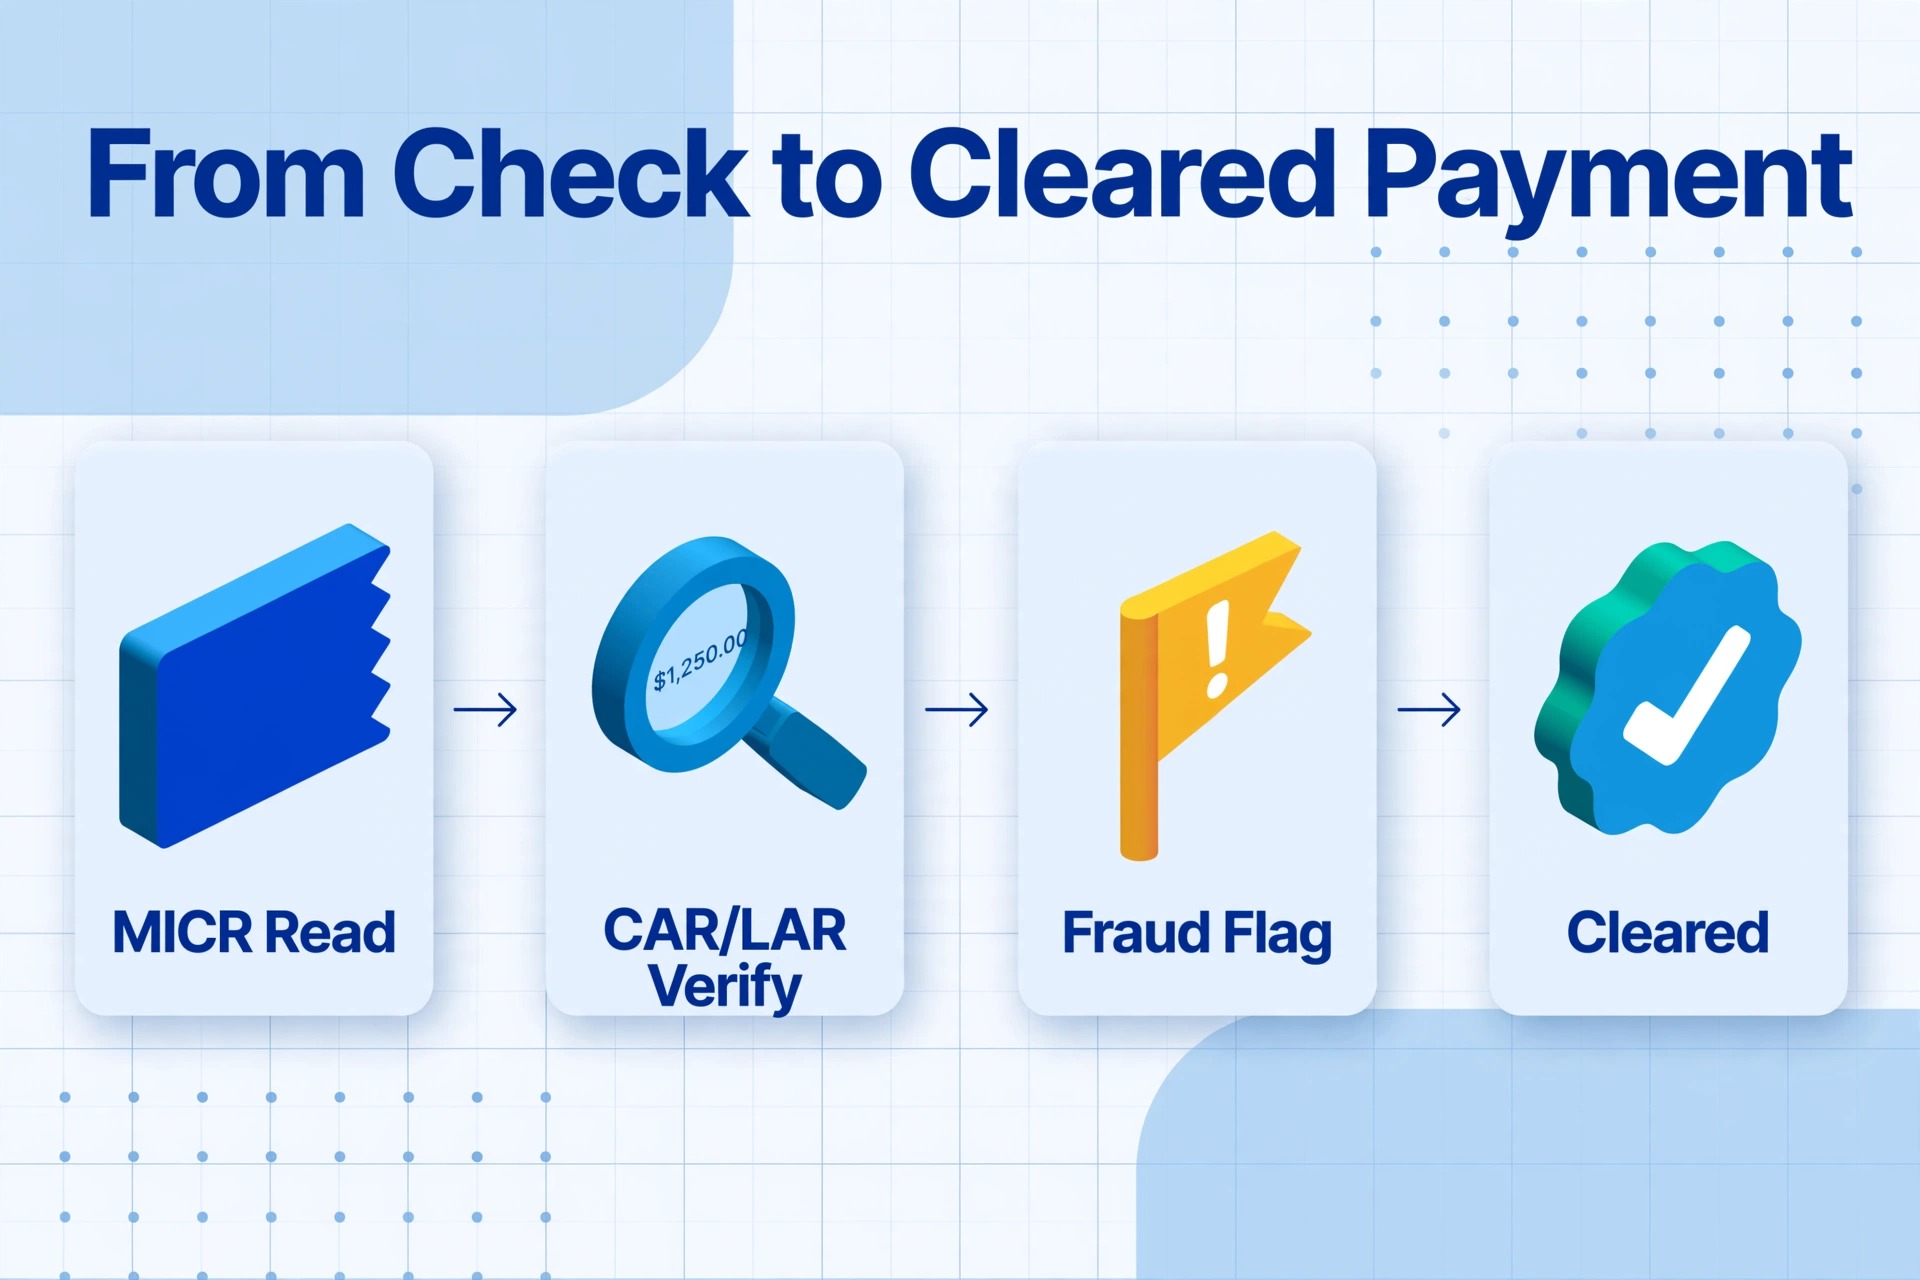
小切手処理は、OCRだけに依存しないという点でOCR分野において独特な位置を占めています。すべての小切手の重要なデータ(銀行ルーティング番号、口座番号、小切手番号)は、MICRライン(マグネティックインク文字認識)にエンコードされています。これは、スタンプやマーク、取り消し線が付けられても読み取り可能なままの特殊なフォントで、磁気インクまたはトナーで印刷されます。
MICR標準:E-13BとCMC-7
すべての小切手の下部にあるMICRラインは、2つのフォントのいずれかを使用します。米国、カナダ、英国、オーストラリア、およびアジア太平洋地域の多くの国では、E-13Bが標準であり、1958年に米国銀行協会によって採用され、後にANSI X9.27およびISO 1004:1995として標準化されました。ヨーロッパおよび一部のラテンアメリカ諸国では、同じルーティングデータをエンコードする別のフォントであるCMC-7を使用します。両方とも磁気式であり、銀行の高速小切手仕分け機は、光学認識ではなく文字の磁気信号を検出して読み取ります。これにより、折り曲げられたり、汚れたり、書き込みがあった小切手でも、MICRはほぼ完璧な読み取り率を実現します。
MICRラインには4つの情報がエンコードされています:
- ルーティング番号(米国では9桁)— 金融機関を識別します
- 口座番号 — 特定の口座を識別します
- 小切手番号 — 小切手の連番識別子です
- 金額 — 支払い提示後に追加されます(数字金額エンコーディング)
MICRがルーティングラインを処理する一方で、小切手の残りの部分(受取人名、文字金額(言葉で書かれたもの)、数字金額(数字で書かれたもの)、日付、メモ欄、署名)は、従来のOCRと画像解析に依存しています。ここに、現代のAI抽出がMICR単独では提供できない付加価値を加えるのです。
小切手詐欺検出:OCRレイヤー
小切手詐欺は、銀行業界で最も根強い文書詐欺問題です。連邦準備制度理事会の2026年リスク責任者報告書(400人以上のリスク専門家を調査)によると、金融機関の63%が前年度に小切手詐欺の試行を経験しています。具体的な攻撃手法は変化しており、回答者の32%が偽造小切手の増加、21%が小切手の洗浄(インクを消して受取人や金額を書き換える行為)、18%が受取人の署名偽造を報告しています。
現代のAIベースのAI OCRシステムは、小切手表面の画像分析を通じてこれらのパターンを検出します:
- CAR(数字金額認識)/ LAR(文字金額認識):システムは数字の金額と文字の金額の両方を読み取り、整合性を相互検証します。不一致がある場合は、手動レビュー用にフラグが立てられます。
- 署名検証:画像分析により、小切手上の署名をファイル上の参照署名と比較し、偽造や無権限の署名者を検出します。
- 改ざん検出:紙面の画像分析により、小切手洗浄の証拠(化学残留物、乱れた繊維、元の文字が消去・書き換えられたことを示すインクのにじみ)を検出します。
- 裏書分析:システムは小切手の裏面をチェックし、正当な裏書パターンを確認することで、意図された受取人またはその代理人によって預け入れられたことを保証します。
銀行は通常、これらのOCRベースの詐欺チェックを磁気MICR読み取りの上に重ね、符号化エラーと意図的な詐欺の両方を捕捉するマルチエンジン検証パイプラインを構築しています。AbrigoのCheck Image AnalysisやAdvanced Fraud SolutionsのTrueChecksなどのツールは、提示時点でこれらの複合技術を適用しています。
チェック21法(2004年施行の小切手決済近代化法)により、電子小切手処理(リモートデポジットキャプチャー(RDC)として知られる)は物理的な小切手処理と法的に同等になりました。これにより、銀行はモバイル端末や支店スキャナーで取得した小切手画像を処理でき、紙を一切扱うことなくOCRとMICR技術に完全に依存できます。
銀行明細書の抽出:マルチフォーマットの課題
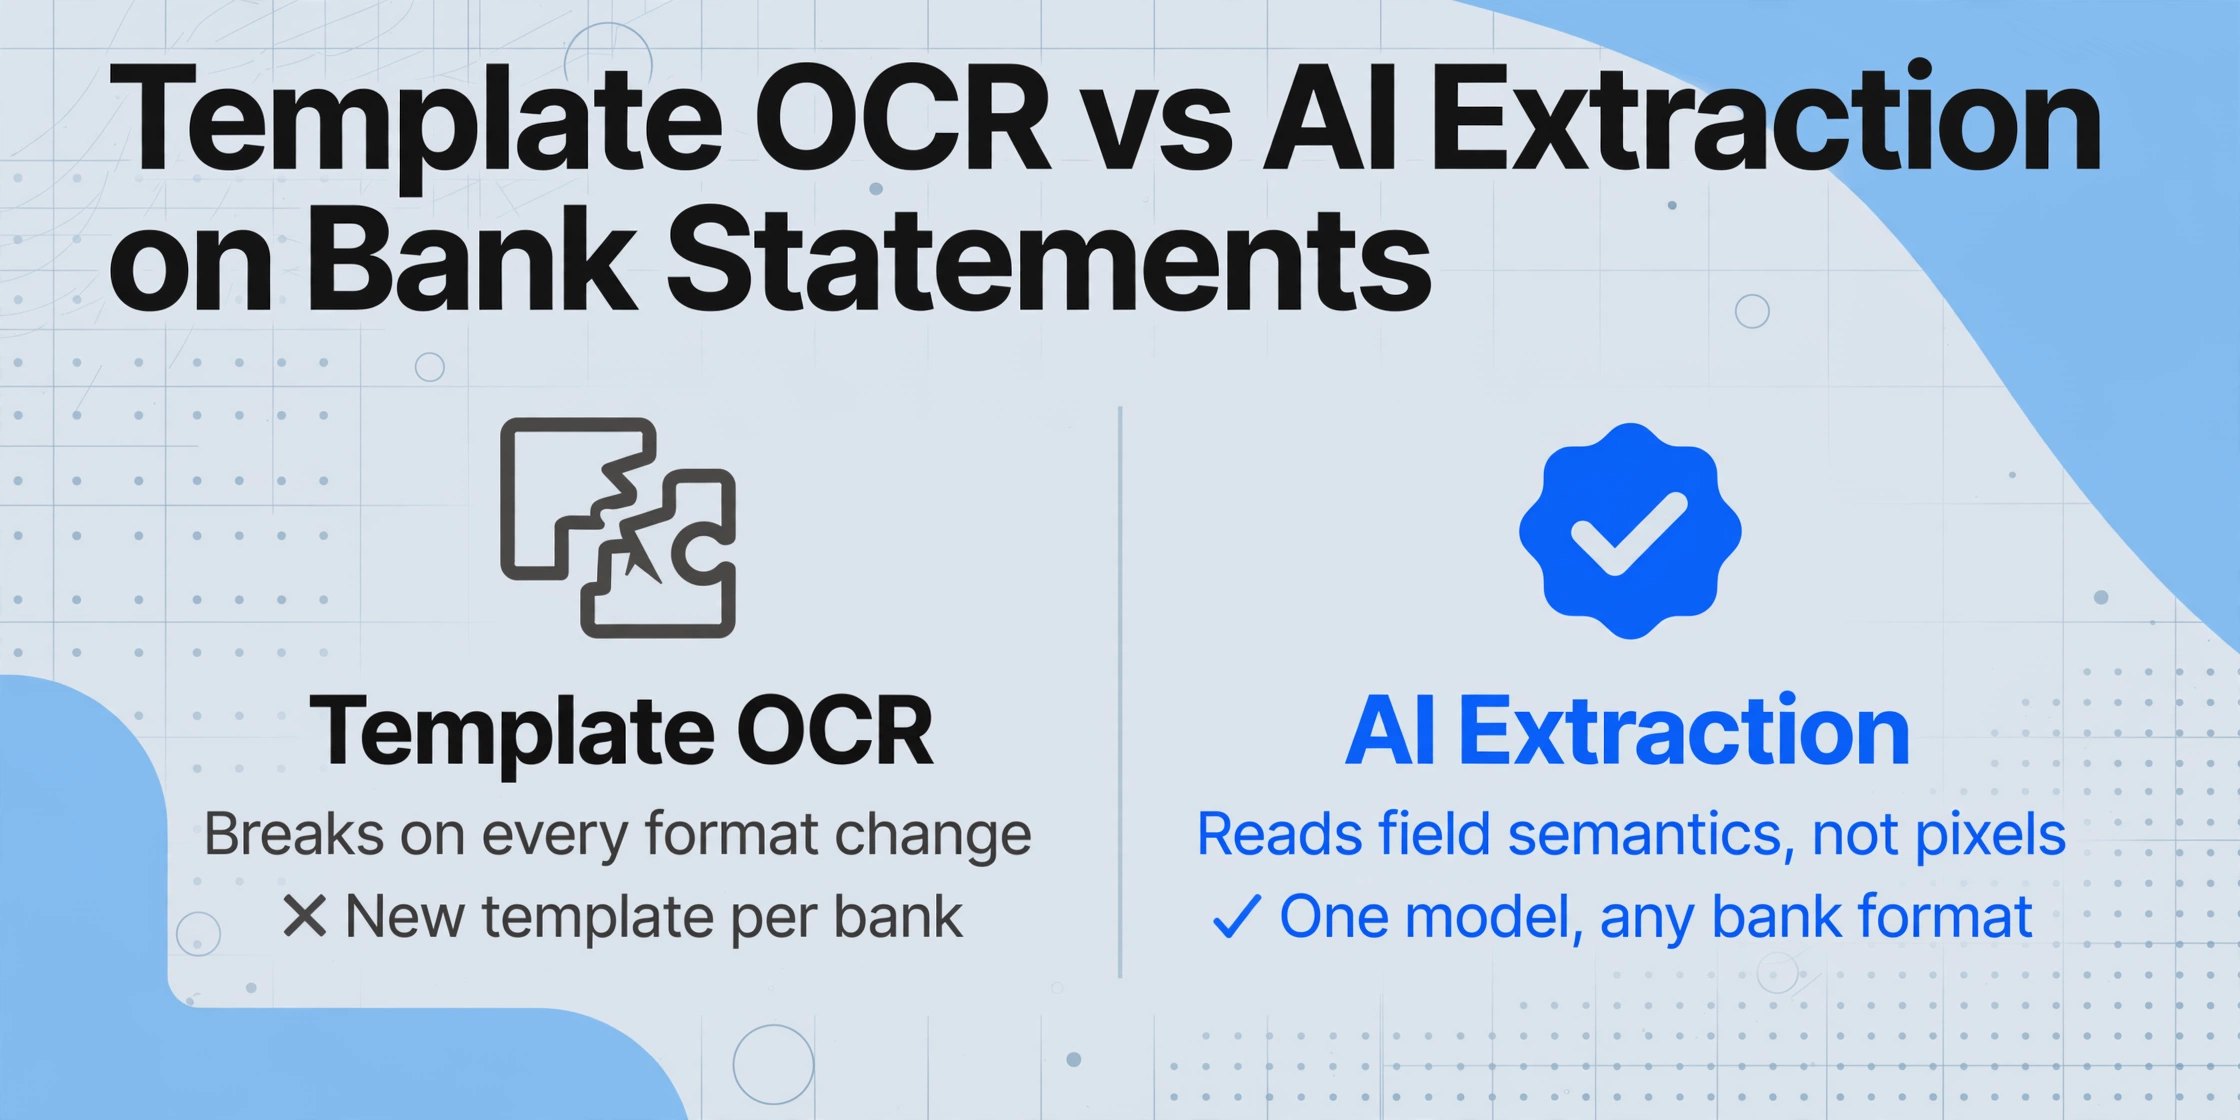
銀行明細書の抽出は、金融分野におけるOCRの中でも最も難しい一般的な課題といえます。文字の読み取りが難しいからではなく、文書構造のバリエーションが非常に大きいからです。銀行ごとに明細書のフォーマットが異なり、その違いは単なる見た目の問題ではありません。抽出システムが各ページをどのように処理するかに直接影響します。
銀行明細書のフォーマットが自動化を阻む理由
銀行明細書は単純な表ではありません。通常、以下の複数のゾーンで構成される文書です。
- 口座名義人、口座番号、明細期間、期首残高、銀行識別情報を含むヘッダー領域
- 日付、取引内容、借方金額、貸方金額、残高欄を含む取引テーブル
- 期末残高、利息、手数料、細則の免責事項を含むフッター領域
- プロモーション、口座通知、マーケティングメッセージを含むサイドコールアウト
抽出の課題となるのは、取引テーブル自体です。列のレイアウト(どのフィールドがどこに配置されるか、列ヘッダーの名称、借方と貸方が別々の列なのか単一の符号付き列なのか)は、銀行ごとの明細書デザインによってすべて異なります。また、複数ページにわたる明細書では、1ページ目のヘッダー領域(銀行ロゴと明細サマリーを含む)が2ページ目の最小限のヘッダーよりも広いため、列の境界線がページごとに数ピクセルずれることがよくあります。
テンプレートベースのOCRシステムでは、各銀行のフォーマットごとに個別のレイアウトテンプレートが必要であり、銀行が明細書のデザインを更新するたびにテンプレートの改訂も必要です。数十の銀行から明細書を処理する金融機関にとって、テンプレートのメンテナンスはフルタイムの運用負担になります。
ページ認識型抽出と残高連続性の維持
銀行明細書OCRにおける最も難しい技術的課題は、ページをまたいだデータの連続性を維持することです。1通の明細書は3ページから30ページ以上に及ぶことがあります。取引テーブルはページ境界で分割され、各新ページは「繰越残高」から始まり、各行の残高は前の行の残高に取引金額を加算または減算した値と一致しなければなりません。
抽出パイプラインが各ページを独立して処理する場合(多くの基本的なOCRツールがそうであるように)、以下の3つの障害モードが発生するリスクがあります:
- 行の欠落:ページ境界付近の取引が、テーブルの隙間を通る分割によって完全に見落とされる
- 行の重複:ページNの「繰越残高」がページN+1の取引として扱われ、ページN+1の実際の最初の取引が1行下にずれる
- 残高連続性の破綻:残高の連続性がページ境界で途切れ、照合が不可能になる
最新のビジョンAI抽出システムは、ページ認識型の状態を維持することでこの問題に対処します。つまり、ドキュメント全体を独立したページではなく、接続されたシーケンスとして読み取ります。AIが「繰越残高」の行を処理する際、それを取引ではなくページ区切りの成果物として認識し、境界をまたいで残高の連続性を維持します。
組み込みの照合機能:抽出が提供すべき成果
銀行明細書抽出の最終目標は、単なる取引の行ではなく、残高チェックに合格する照合済みデータセットです:
| 検証チェック | 確認内容 | 重要性 |
|---|---|---|
| 期首残高の一致 | 抽出された期首残高が記載された期首残高と一致する | 冒頭でページがスキップされていないことを保証 |
| 取引合計チェック | 借方と貸方の合計が記載された純変動額と一致する | 取引行の欠落や重複を検出 |
| 残高の連続検証 | 各行の残高=前の残高±取引金額 | 各行を順番に個別検証 |
| 期末残高の一致 | 最終抽出残高が記載された期末残高と一致する | ドキュメント全体のエンドツーエンドの整合性チェック |
この照合チェックを実装するツール(抽出パイプラインに自動残高検証を組み込んだものなど)は、データが会計システムに入る前にエラーを検出し、照合チームの手動QA負担を軽減します。
このパイプラインの設定手順については、会計向けOCR:銀行明細書と財務データの抽出ガイドをご覧ください。
小切手やKYCではなく、明細書からExcelへの変換に特化している場合は、銀行明細書データのExcelへの抽出チュートリアルで完全なワークフローを説明しています。また、銀行明細書からExcelへの変換ツールは、お客様自身のPDFに対して同じ抽出を自動的に実行します。
KYC・融資書類処理:コンプライアンス圧力下での精度
Know Your Customer(KYC)コンプライアンスは、OCR精度と規制リスクの交差点に位置します。身分証明書の1文字を誤読しただけで — 「0」と「O」を混同したり、旅券番号を誤読したり — OFAC(外国資産管理局)の制裁スクリーニングを通過できない顧客をオンボーディングしたり、合成ID詐欺を検出できない事態につながります。その重要性は、請求書処理とは根本的に異なります。
KYCオンボーディングにおける書類構成
標準的なKYCオンボーディングパッケージには複数の書類タイプが含まれ、それぞれに異なる抽出課題があります:
- 政府発行の写真付き身分証明書(旅券、運転免許証、国民IDカード):下部のMRZ(機械読み取り式渡航文書領域)はOCR用に設計されています — ICAO(国際民間航空機関)標準フォント、チェックディジット、固定フィールド長を使用します。しかしMRZは書類の一部に過ぎず、顔写真、署名、非MRZテキストフィールド(住所、生年月日、発行機関)の抽出には、書類全体の画像分析が必要です。この全体画像アプローチは、下流チームが常に直面する軽量なケース — スマートフォンで撮影したIDカード写真で、MRZに頼らずに氏名、生年月日、ID番号、有効期限を列に収める必要があるケース — も処理します。
- 住所証明(公共料金請求書、銀行取引明細書、税評価書):これらは身分証明に最適化された書類ではありません。任意のレイアウト、任意の品質でスキャンされ、住所が固定位置にない場合もあります。金融機関は、標準化された形式に頼ることなく、これらの書類から住所、氏名、日付(通常90日以内であることを確認するため)を抽出する必要があります。
- 財務証拠(給与明細、W-2、税務申告書、引受審査用の銀行取引明細書):融資引受審査書類には、収入、雇用履歴、資産情報のフィールドレベル抽出が必要です。商業融資申請には複数の書類タイプにわたる10〜30ページが含まれる場合があり、引受審査チームは以前、データ抽出前に書類整理だけで時間の40%を費やしていました。
KYCにおいて文字単位の精度では不十分な理由
従来のOCRベンダーは文字単位の精度(CER)を提示します。通常、鮮明な印刷文書では99%以上です。しかしKYCワークフローでは、文字単位の精度は誤解を招く指標です。パスポート1ページに500文字ある場合、CER 99%は平均して5文字が誤っていることを意味します。そのうちの1文字がパスポート番号の数字や顧客名の文字だった場合、その文書はAMLスクリーニングを通過できないか、誤った本人情報で口座が開設され、修正に数か月かかることになります。
フィールド単位の精度——文字の大部分が正しいかではなく、パスポート番号全体が正しく抽出されたか——こそがKYCにとって重要な指標です。視覚言語モデルを活用したAIベースの抽出システムは文脈を理解します。パスポート番号が特定のパターンに従うこと、検証用のチェックディジットが存在すること、誤読した文字を黙って受け入れるのではなく人によるレビューに回せることを認識します。
ベトナムの銀行におけるGreenNodeのOCR実装の公開導入データによると、OCRとAIを統合した自動KYCにより、処理時間が1ファイルあたり45分から5分未満に短縮され、標準的な申請では80〜90%のストレートスルー処理率を達成しました。残りの10〜20%は、低品質の文書、非標準形式、曖昧なフィールドなどのエッジケースとして人によるレビューが必要でした。
大量のローン申請を処理する銀行にとって、KYC文書を扱うのと同じ抽出パイプラインが、与信審査用の給与明細、税務申告書、銀行明細書も処理します。そのため、これらすべての文書タイプを処理する統合抽出プラットフォームは、プロセスの各段階に専用ツールを別々に用意するよりも、大きな運用上の優位性をもたらします。
従来のOCRとビジョンAI:銀行業務におけるテンプレート不要の重要性
銀行業界の文書処理の課題は、請求書や領収書を扱うのと同じOCRアプローチでは十分に対応できません。銀行文書は根本的により難しい問題を提示します。その理由を理解するには、2世代の抽出技術を明確に区別する必要があります。
テンプレート型OCRの限界:新しいフォーマットごとにワークフローが崩れる
従来のOCR(Tesseract、ABBYY、クラウドOCR APIを問わず)は、位置ベースのモデルで動作します。システムはページからすべてのテキストを抽出し、ルールやテンプレートマップを使って座標に基づいてフィールドを割り当てます。これは、同じドキュメント形式が繰り返し出現する場合に機能します。しかし、次のような場合には失敗します:
- 50以上の異なる銀行の明細書を処理する場合
- 銀行が明細書のレイアウトを更新する場合(これは想像以上に頻繁に発生します)
- 顧客が少し傾いた、または回転したページのスキャン明細書を提出する場合
- きれいなPDFではなく、スマートフォンの写真で撮影した明細書を受け取る場合
フォーマットが変わるたびにテンプレートの更新が必要になります。新しい銀行が増えるたびに新しいテンプレートが必要になります。テンプレート管理はドキュメントの多様性に比例して増大します——そして銀行業界は、極めて多様なドキュメントを扱う環境です。
ビジョンAI抽出がフォーマット問題を解決する仕組み
ビジョンAI抽出——大規模視覚モデル(VLM)を使用——は、この問題に異なるアプローチで取り組みます。すべてのテキストを抽出してから期待されるフィールドに位置でマッピングする代わりに、VLMは人間と同じようにドキュメントを読み取ります:全体的に、視覚的なレイアウト、各テキスト領域の意味、フィールド間の関係を理解しながら。
これは、AI OCRとは何か、従来のOCRとの違いに関するガイドで説明したものと同じ技術です——そして、銀行業界のマルチフォーマット課題を解決する鍵です。実際には、これは次のことを意味します:
- 位置ではなく出力を定義する: 「取引日」列が表示される場所にボックスを描く代わりに、取引日、説明、借方金額、貸方金額、残高を取得したいとシステムに伝えるだけです。AIは、これらのフィールドの意味を理解することで、ページ上のどこにあっても見つけ出します。
- 1つの列定義がすべてのフォーマットで機能する: 同じ列名のセットで、Chaseの明細書、Bank of Americaの明細書、信用組合の明細書からデータを抽出できます——列の順序、フィールド名、レイアウトがそれぞれ完全に異なっていてもです。
- フォーマット変更でワークフローが崩れない: 銀行が明細書のデザインを更新しても、AIは保存されたテンプレートと照合するのではなく、意味論的に新しいレイアウトを読み取るため、抽出は引き続き機能します。
このパラダイムシフト——位置ベースから意味ベースの抽出へ——こそが、銀行チームが銀行ごとのテンプレートライブラリを増やし続けることなく、数十のソースからのドキュメントを処理できるようにするものです。銀行ワークフローに適した抽出ツールの広範な比較については、カテゴリー別・ユースケース別の2026年ベストOCRソフトウェアガイドを参照してください。
よくある質問
手書きの金額や署名がある小切手でもOCRは機能しますか?
はい、ただし精度は手法によります。MICR読み取り(口座番号行)は磁気方式で、手書きの有無にかかわらずほぼ100%の読み取り率を達成します。金額(数字)と金額(英字表記)はOCR/画像解析で読み取られ、手書き小切手では通常90~97%の精度です。署名領域は文字単位のOCRではなく、パターンマッチングによる偽造検出に使用されます。最新の小切手処理システムはこれら3つの技術を組み合わせ、不一致を人間の確認に回します。
銀行取引明細書のOCRは海外の銀行にも対応できますか?
AI搭載OCRは、テンプレートの位置ではなくフィールドの意味を読み取るため、各国の銀行の明細書を処理できます。ただし、抽出精度はAIモデルが学習したフォーマットの多様性に依存します。米国、英国、カナダ、オーストラリア、および主要な欧州銀行のフォーマットは十分にサポートされています。小規模な地域銀行やデジタル化が進んでいない市場の銀行では、初回の精度が低くなる可能性がありますが、AIは新しいフォーマットごとに手動でテンプレートを作成する必要があるテンプレートベースのシステムよりも迅速に適応します。
AIによる銀行取引明細書の抽出精度は、手動データ入力と比べてどうですか?
AIによる銀行取引明細書抽出の公表精度は、クリーンなデジタルPDFで95%~99%、スキャンまたは撮影された明細書で90%~95%です。比較として、手動データ入力の典型的なエラー率は3~5%で、100キーストロークあたり約3~5文字の誤りに相当します。違いは、AIのエラーは曖昧なフィールド(ぼやけた数字、複雑な取引内容)に集中する傾向があるのに対し、手動エラーはランダムに発生することです。堅牢な抽出パイプラインには、自動照合チェック(残高の一貫性の検証)が含まれており、重大な抽出エラーのほとんどが会計システムに到達する前に検出されます。
銀行向けOCRはKYC/AML規制に準拠していますか?
コンプライアンスはOCR技術自体ではなく、OCRシステムの導入方法によって決まります。抽出されたデータは、何が、いつ、どのプロセスで抽出されたかを示す検証可能な監査証跡とともに保存される必要があります。最新のAI抽出プラットフォームのほとんどは、監査ログ、フィールドレベルの信頼度スコア(信頼度の低い抽出を確認用にフラグ付け)、およびセキュアなデータ処理(TLS暗号化、SOC 2認証)をサポートしています。BSA/AML規制(12 CFR 21.11)の下では、銀行は再現可能かつ監査可能な記録を維持する必要があります。適切なログ記録を備えたAI抽出システムは、組み込みの監査証跡がない手動データ入力よりも効果的にこの要件を満たします。
KYC OCRはアラビア語、中国語、キリル文字などの非ラテン文字をどう処理しますか?
最新のビジョンAIモデルは多言語データで学習しており、ほとんどの文字ベースおよび書記体系ベースの表記を読み取ることができます。KYC書類の場合、パスポートのMRZはICAO標準のOCR-Bフォント(ラテン文字のみ)を使用するため、機械可読ゾーンは普遍的に読み取り可能です。MRZ以外のフィールド(現地語表記の氏名、住所)には、特定言語のOCRサポートが必要です。AIベースのOCRシステムは通常30以上の言語に対応し、アラビア語、中国語(簡体字・繁体字)、キリル文字、デーヴァナーガリー文字、韓国語ハングル、日本語漢字などを処理できます。ご利用の抽出プロバイダーが処理対象の特定の文字体系をサポートしていることを必ず確認してください。
銀行取引明細書の照合にはどのフィールドを抽出すべきですか?
銀行取引明細書の照合に必要な標準フィールドは次の通りです:口座番号、明細期間(開始・終了)、期首残高、期末残高、そして各取引について—取引日、摘要、借方金額、貸方金額、残高。オプションですが便利なフィールドとして:参照番号・小切手番号、取引種別(ATM、電信送金、振替、入金、手数料)、および支払人・受取人名(利用可能な場合)があります。ほとんどのAI抽出ツールでは、これらのフィールドを列名として定義でき、システムが任意の明細書フォーマットから自動的にデータを入力します。
同じOCRツールで小切手、銀行取引明細書、KYC書類を処理できますか?
統一されたAI抽出プラットフォーム(特にビジョン言語モデルベースのもの)は、ツールを切り替えることなくこれら3種類の書類すべてを処理できます。小切手処理では、ルーティングラインにMICR、小切手表面に画像分析を使用します。銀行取引明細書では、取引テーブルにテーブル認識抽出を使用します。KYC書類では、政府発行IDにMRZ読み取り、住所証明や財務証明書類に汎用フィールド抽出を使用します。重要な要件は、ツールがカスタム列抽出をサポートしていることです:抽出したい列を定義すると、AIがフィールドの意味を理解して、書類の種類や形式に関係なく対応するデータを特定します。