OCR für Banken:
Scheckverarbeitung, Kontoauszug-Extraktion & KYC-Automatisierung
Drei Bankdokumentkategorien — Schecks, Kontoauszüge und KYC-Dokumente — verursachen den Großteil der manuellen Dateneingabestunden in Finanzinstituten. Der Risikobeauftragten-Bericht der Federal Reserve 2026 ergab, dass 63 % der Finanzinstitute in den letzten 12 Monaten Scheckbetrugsversuche meldeten. Die AFP-Zahlungsbetrugsumfrage 2026 beziffert den Anteil der Organisationen mit Scheckbetrug auf 58 % und macht Schecks damit zur betrugsanfälligsten Zahlungsmethode. Unterdessen verbringen Bankabstimmungsteams jeden Monat Tage damit, Transaktionszeilen aus Kontoauszügen manuell einzutippen, die sich nicht sauber in eine Tabelle einfügen lassen, und Compliance-Beauftragte verarbeiten KYC-Dokumente mit Durchlaufzeiten von 30–60 Minuten pro Datei.
Wichtigste Erkenntnisse
- Banken investieren in drei separate OCR-Pipelines — Scheckverarbeitung, Kontoauszug-Extraktion und KYC-Prüfung — und alle drei beruhen auf einer Annahme, die nie zutrifft: dass Dokumentlayouts gleich bleiben.
- Eine 99 % genaue OCR auf Zeichenebene macht trotzdem fünf Zeichenfehler pro KYC-Seite — und eine falsche Ziffer in einer Passnummer bedeutet einen Compliance-Fehler, den keine Prüfspur erklären kann.
- Vision-KI extrahiert Bankdokumente nach Feldbedeutung statt nach Pixelkoordinaten — eine Spaltendefinition funktioniert für jedes Bankformat, ob Chase sein Kontoauszugdesign ändert oder ein Kunde sein Telefon dreht.
Banking läuft auf Dokumenten. Aber anders als Rechnungen – die zumindest über die meisten Anbieter hinweg eine grobe strukturelle Verwandtschaft aufweisen – wehren sich Bankdokumente gegen jeden Standardisierungsversuch. Ein Scheck basiert auf einer Magnettinten-Schrift, die in den 1950er-Jahren erfunden wurde. Ein Kontoauszug von Chase und einer von einer regionalen Kreditgenossenschaft teilen praktisch keine Layout-Konventionen. Ein für KYC verwendeter Reisepass folgt ICAO-Standards, während ein Führerschein staatlichen Regeln folgt, die sich alle paar Jahre ändern.
Dieser Artikel behandelt die drei Dokumenttypen, die die OCR-Einführung im Bankwesen vorantreiben, erläutert die spezifischen technischen Herausforderungen, die jeder mit sich bringt, und zeigt, wo herkömmliche OCR an ihre Grenzen stößt – und wo Vision AI einspringt.
Die drei Bankdokumente, die die OCR-Einführung vorantreiben
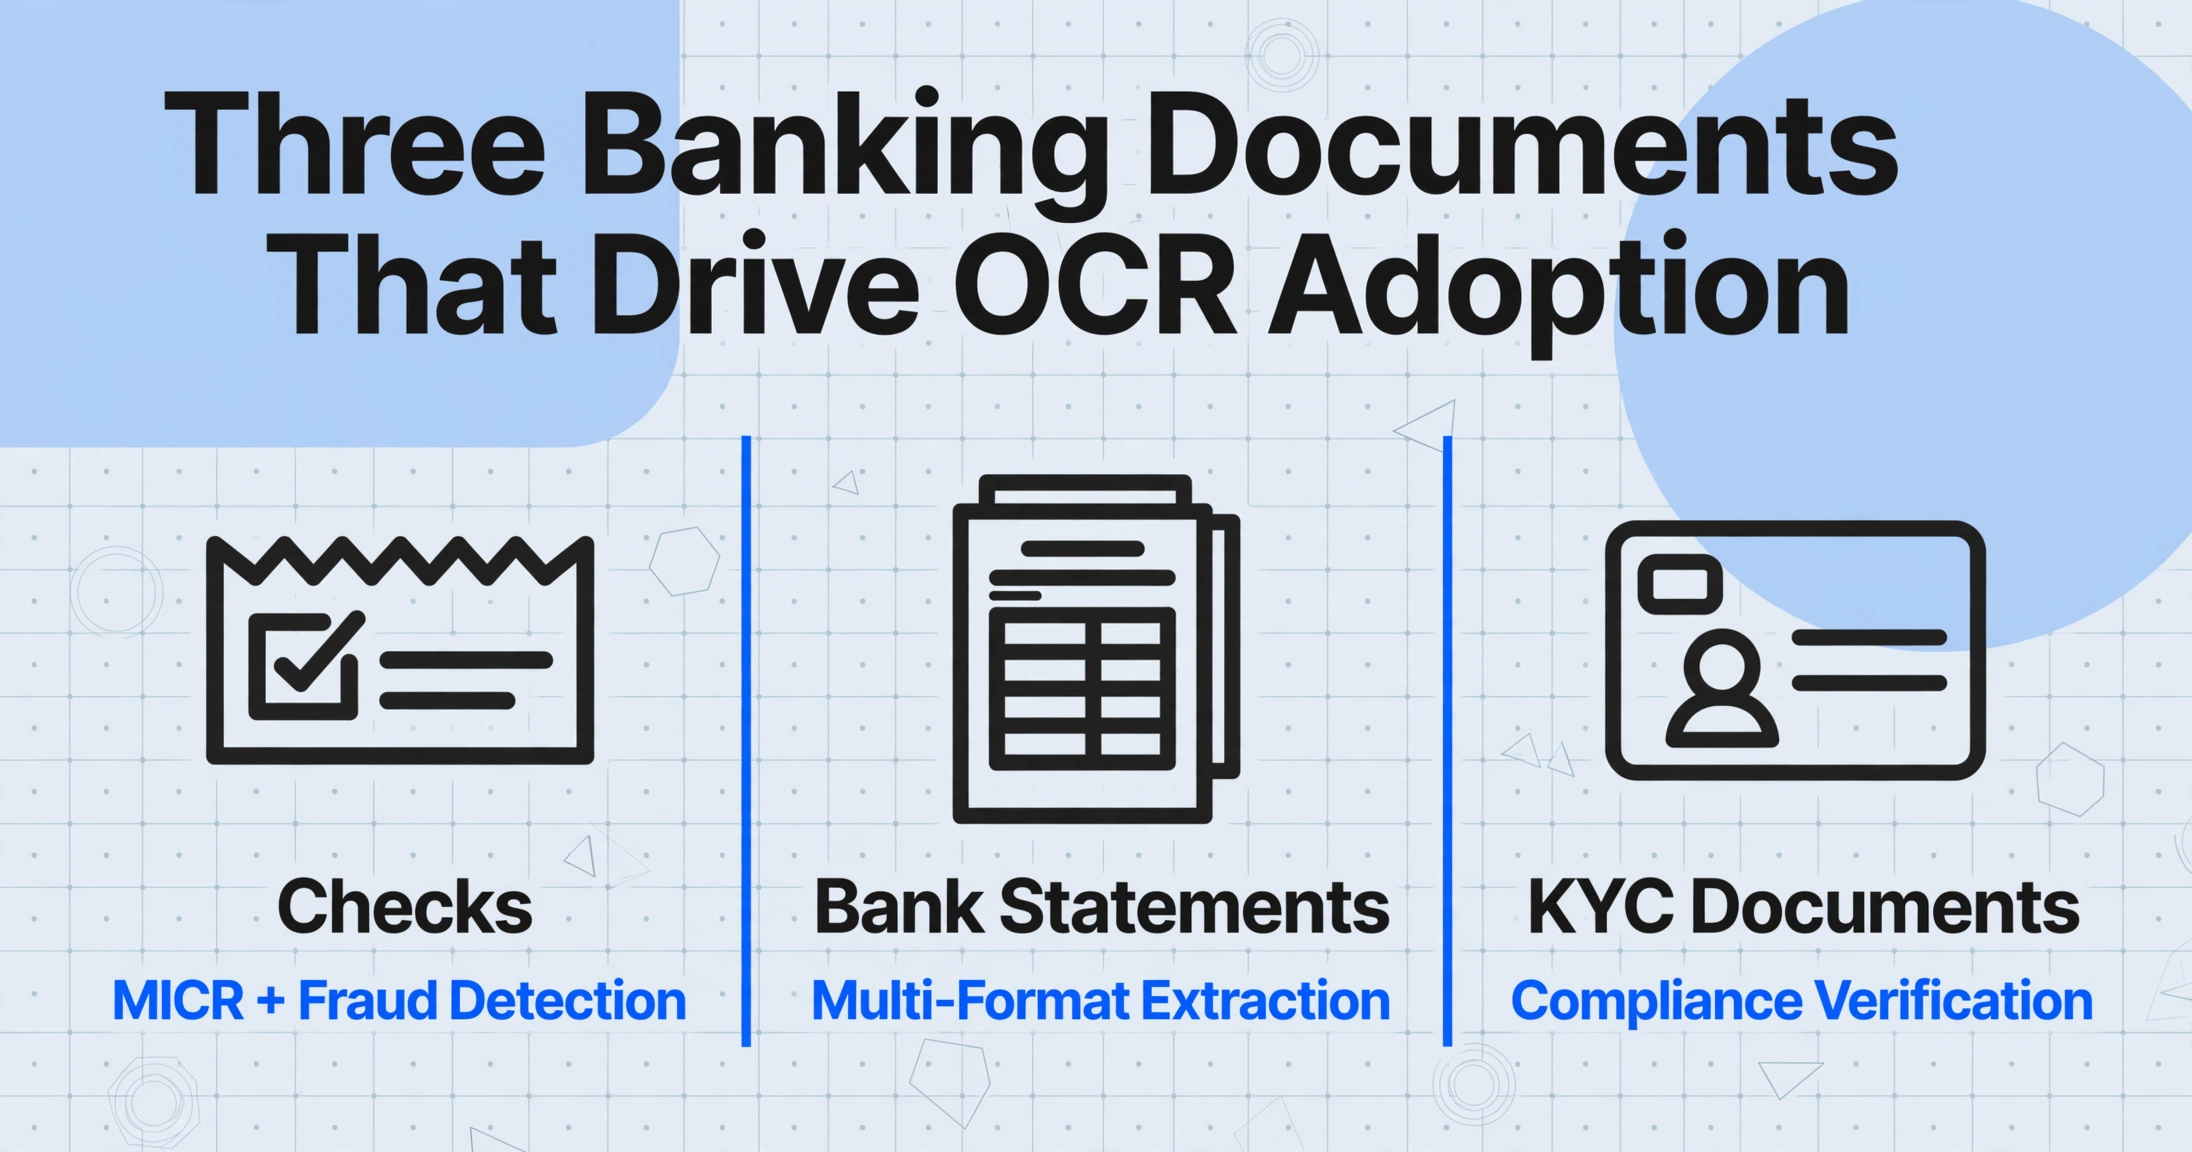
Wenn Bankfachleute über OCR sprechen, meinen sie in der Regel einen von drei unterschiedlichen Workflows, jeder mit seinen eigenen technischen Anforderungen, Fehlermodi und regulatorischen Risiken:
Scheck- und Zahlungsabwicklung
Die Magnettinten-Schrifterkennung (MICR) ist das Rückgrat des Scheckeinzugs. Banken verarbeiten täglich Millionen von Schecks über Hochgeschwindigkeits-Sortierer, die die E-13B-Schriftzeile am unteren Rand jedes Schecks lesen. Die Herausforderung geht über MICR hinaus: Die Betrugserkennung erfordert das Lesen der Betragsregionen (CAR) und des ausgeschriebenen Betrags (LAR), die Überprüfung von Indossamentmustern und die Erkennung von Veränderungen. Laut der AFP-Umfrage meldeten 58 % der Organisationen im Jahr 2025 Scheckbetrug.
Kontoauszug-Extraktion & Abstimmung
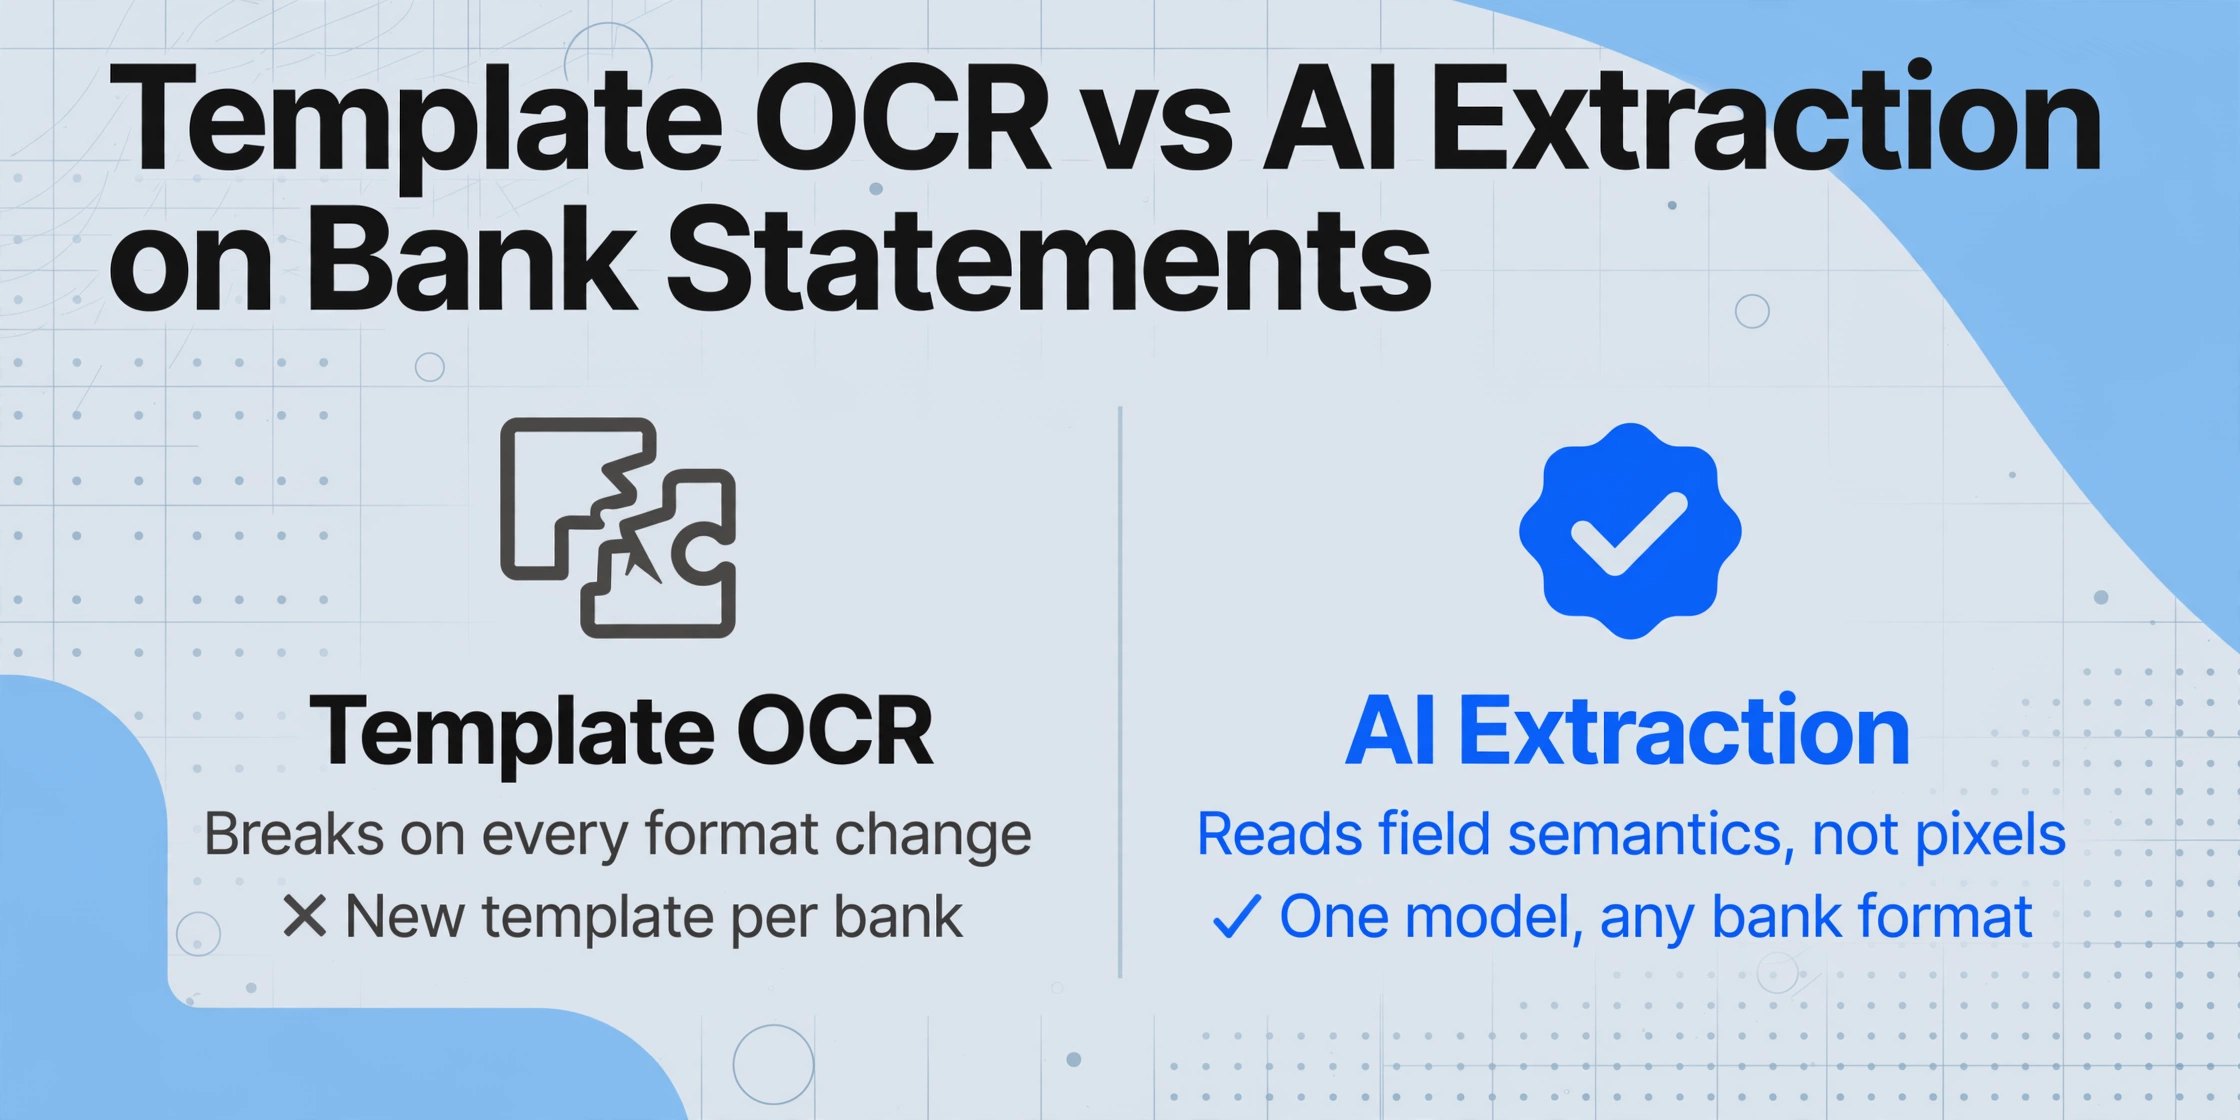
Jede Bank formatiert Kontoauszüge anders. Transaktionstabellen können sich über mehrere Spalten erstrecken – Datum, Beschreibung, Soll, Haben, laufender Saldo – und diese Spalten verschieben ihre Position von Seite zu Seite innerhalb desselben Auszugs. Der laufende Saldo muss über Seitenumbrüche hinweg kontinuierlich sein. Vorlagenbasierte OCR scheitert hier. KI-gestützte Kontoauszug-Extraktion bewältigt diese Variationen, indem sie die Semantik der Felder versteht, anstatt sich auf Pixelkoordinaten zu verlassen.
KYC- und Kreditdokument-Verifizierung
Die Kundenakquise erfordert die Verifizierung von Identitätsdokumenten (Reisepässe, Führerscheine), Adressnachweisen (Betriebskostenabrechnungen, Kontoauszüge) und finanziellen Nachweisen (Gehaltsabrechnungen, Steuererklärungen, W-2). Die Einhaltung der BSA/AML-Vorschriften erfordert eine genaue Extraktion und Prüfpfade. Die manuelle KYC-Verarbeitung dauert 30–60 Minuten pro Datei; automatisiertes eKYC mit OCR und KI reduziert dies auf unter 5 Minuten für Standardanträge, basierend auf veröffentlichten Einsatzdaten von asiatischen und europäischen Banken.
Diese drei Arbeitsabläufe haben eine Gemeinsamkeit: Sie alle extrahieren strukturierte Daten aus halbstrukturierten oder unstrukturierten Dokumentbildern. Doch die technischen Ansätze, die für einen funktionieren, scheitern häufig bei den anderen.
Scheckverarbeitung: Wo OCR auf MICR trifft
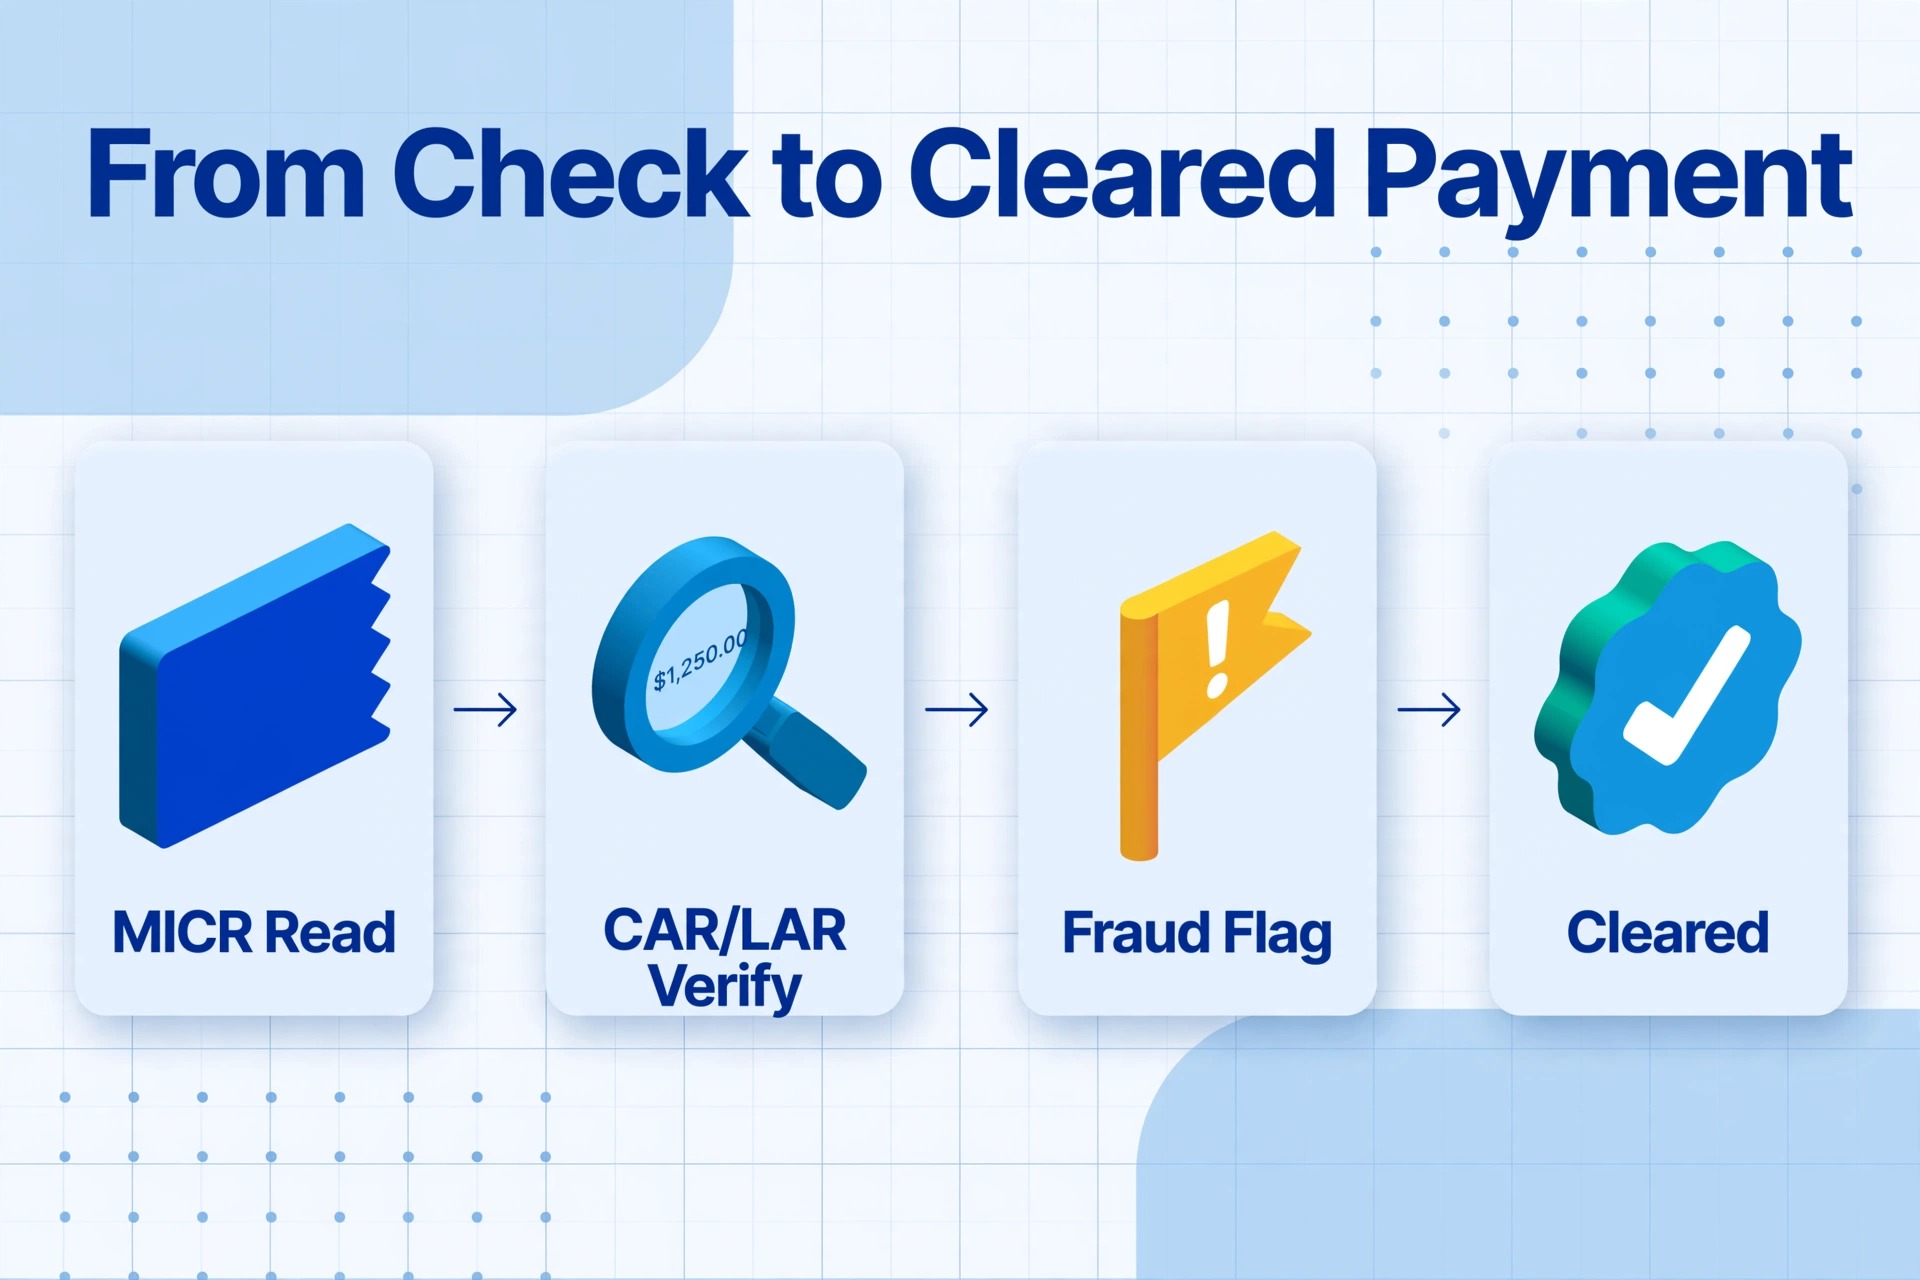
Die Scheckverarbeitung nimmt in der OCR-Landschaft eine besondere Stellung ein, da sie sich nicht allein auf OCR stützt. Die kritischen Daten auf jedem Scheck – Bankleitzahl, Kontonummer, Schecknummer – sind in der MICR-Zeile (Magnetic Ink Character Recognition) kodiert, einer speziellen Schrift, die mit magnetischer Tinte oder Toner gedruckt wird und auch nach Stempelung, Markierung oder Durchstreichung lesbar bleibt.
Der MICR-Standard: E-13B und CMC-7
Die MICR-Zeile am unteren Rand jedes Schecks verwendet eine von zwei Schriften. In den USA, Kanada, Großbritannien, Australien und weiten Teilen der Asien-Pazifik-Region ist E-13B der Standard, der 1958 von der American Bankers Association übernommen und später als ANSI X9.27 und ISO 1004:1995 standardisiert wurde. Europäische und einige lateinamerikanische Länder verwenden CMC-7, eine andere Schrift, die dieselben Leitdaten kodiert. Beide sind magnetisch – die Hochgeschwindigkeits-Schecksortierer einer Bank lesen sie durch Erkennung des magnetischen Signals der Zeichen, nicht durch optische Erkennung. Dadurch erreicht MICR nahezu perfekte Leseraten, selbst bei Schecks, die gefaltet, verschmutzt oder beschrieben wurden.
Die MICR-Zeile kodiert vier Informationen:
- Bankleitzahl (9 Ziffern in den USA) – identifiziert das Finanzinstitut
- Kontonummer – identifiziert das jeweilige Konto
- Schecknummer – fortlaufende Kennung des Schecks
- Betrag – wird nach der Einreichung zur Zahlung hinzugefügt (Kodierung des Gefälligkeitsbetrags)
Während MICR die Leitzeile übernimmt, basiert der Rest des Schecks – der Zahlungsempfängername, der Betrag in Worten, der Betrag in Ziffern, das Datum, die Verwendungszweckzeile und die Unterschrift – auf herkömmlicher OCR und Bildanalyse. Hier bietet moderne KI-Extraktion einen Mehrwert, der über MICR allein hinausgeht.
Betrugserkennung bei Schecks: Die OCR-Ebene
Scheckbetrug bleibt das hartnäckigste Dokumentbetrugsproblem im Bankwesen. Der Risikobeauftragten-Bericht der Federal Reserve von 2026, der über 400 Risikoprofis befragte, ergab, dass 63% der Finanzinstitute im Vorjahr Scheckbetrugsversuche erlebt hatten. Die spezifischen Angriffsvektoren verschieben sich: 32% der Befragten meldeten einen Anstieg bei gefälschten Schecks, 21% meldeten Scheckwäsche (Entfernen der Tinte, um Zahlungsempfänger oder Betrag neu zu schreiben), und 18% meldeten Fälschung des Zahlungsempfängers.
Moderne KI-basierte KI-OCR-Systeme erkennen diese Muster durch Bildanalyse der Scheckoberfläche:
- Erkennung des Betrags in Ziffern (CAR) / Erkennung des Betrags in Worten (LAR): Das System liest sowohl den numerischen Betrag als auch den ausgeschriebenen Betrag und gleicht sie auf Konsistenz ab. Eine Abweichung markiert den Scheck zur manuellen Prüfung.
- Signaturprüfung: Die Bildanalyse vergleicht die Unterschrift auf dem Scheck mit der hinterlegten Referenzunterschrift und erkennt Fälschungen und unbefugte Unterzeichner.
- Erkennung von Veränderungen: Die Bildanalyse der Papieroberfläche erkennt Hinweise auf Scheckwäsche – chemische Rückstände, gestörte Fasern oder Tintenverlauf, die darauf hindeuten, dass der ursprüngliche Text gelöscht und neu geschrieben wurde.
- Analyse der Indossamente: Das System prüft die Rückseite des Schecks auf gültige Indossamentmuster und stellt sicher, dass der Scheck vom vorgesehenen Zahlungsempfänger oder dessen bevollmächtigtem Vertreter eingelöst wurde.
Banken schichten diese OCR-basierten Betrugsprüfungen typischerweise auf den magnetischen MICR-Ablesevorgang, wodurch eine Multi-Engine-Validierungspipeline entsteht, die sowohl Kodierungsfehler als auch vorsätzlichen Betrug erfasst. Tools wie Abrigos Check Image Analysis und Advanced Fraud Solutions' TrueChecks wenden diese kombinierten Techniken zum Zeitpunkt der Einreichung an.
Check 21 (das Check Clearing for the 21st Century Act, in Kraft seit 2004) machte die elektronische Scheckverarbeitung – bekannt als Remote Deposit Capture oder RDC – rechtlich der physischen Scheckverarbeitung gleichgestellt. Das bedeutet, dass Banken Scheckbilder verarbeiten können, die von Mobilgeräten oder Filialscannern erfasst wurden, und sich dabei vollständig auf OCR- und MICR-Technologie verlassen, ohne das Papier jemals in die Hand zu nehmen.
Bank Statement Extraction: Die Herausforderung der Multi-Formate
Die Extraktion von Kontoauszügen ist arguably das schwierigste gängige OCR-Problem im Finanzwesen – nicht weil die Zeichen schwer zu lesen sind, sondern weil die Dokumentstruktur so variabel ist. Jede Bank formatiert Kontoauszüge anders, und diese Unterschiede sind nicht rein kosmetisch. Sie beeinflussen, wie Extraktionssysteme jede Seite verarbeiten müssen.
Warum Kontoauszugsformate die Automatisierung erschweren
Ein Kontoauszug ist keine einfache Tabelle. Es ist ein Dokument mit mehreren Zonen, das typischerweise Folgendes umfasst:
- Einen Kopfbereich mit Kontoinhabername, Kontonummer, Abrechnungszeitraum, Anfangsbestand und Bankkennung
- Eine Transaktionstabelle mit Spalten für Datum, Beschreibung, Sollbetrag, Habenbetrag und laufenden Saldo
- Fußbereiche mit Endbestand, Zinserträgen, Gebühren und Kleingedrucktem mit Haftungsausschlüssen
- Seitliche Hinweise mit Werbeangeboten, Kontobenachrichtigungen oder Marketingbotschaften
Die Transaktionstabelle selbst stellt die eigentliche Extraktionsherausforderung dar. Das Spaltenlayout – welches Feld wo steht, wie die Spaltenüberschriften heißen, ob Soll und Haben in getrennten Spalten oder in einer einzigen vorzeichenbehafteten Spalte geführt werden – variiert bei jedem Bankdesign. Und innerhalb eines mehrseitigen Kontoauszugs verschieben sich die Spaltengrenzen oft um ein paar Pixel von Seite zu Seite, weil der Kopfbereich auf Seite eins (mit Banklogo und Kontoübersicht) mehr Platz einnimmt als der minimale Kopf auf Seite zwei.
Template-basierte OCR-Systeme benötigen ein separates Layout-Template für jedes Bankformat – und ein überarbeitetes Template, sobald die Bank ihr Kontoauszugsdesign aktualisiert. Für ein Finanzinstitut, das Kontoauszüge von Dutzenden Banken verarbeitet, wird die Template-Pflege zu einer operativen Vollzeitbelastung.
Seitenbewusste Extraktion und Kontinuität des laufenden Saldos
Das schwierigste technische Problem bei der OCR von Kontoauszügen ist die Aufrechterhaltung der Datenkontinuität über Seiten hinweg. Ein einzelner Auszug kann 3 bis 30+ Seiten umfassen. Die Transaktionstabelle wird an Seitengrenzen aufgeteilt, jede neue Seite beginnt mit einem „Übertrag"-Saldo, und der laufende Saldo in jeder Zeile muss dem Saldo der vorherigen Zeile plus oder minus dem Transaktionsbetrag entsprechen.
Wenn die Extraktionspipeline jede Seite unabhängig verarbeitet – wie es die meisten einfachen OCR-Tools tun – riskiert sie drei Fehlermodi:
- Verlorene Zeilen: Transaktionen nahe der Seitengrenze werden vollständig übersehen, weil der Umbruch durch eine Lücke in der Tabelle fällt
- Doppelte Zeilen: Der „Übertrag"-Saldo von Seite N wird auf Seite N+1 als Transaktion behandelt, und die tatsächliche erste Transaktion von Seite N+1 verschiebt sich um eine Zeile nach unten
- Unterbrochene Saldokontinuität: Die Sequenz des laufenden Saldos bricht an der Seitengrenze ab, was einen Abgleich unmöglich macht
Moderne KI-Extraktionssysteme mit Vision-Technologie lösen dies, indem sie einen seitenbewussten Zustand aufrechterhalten – sie lesen das gesamte Dokument als zusammenhängende Sequenz statt als unabhängige Seiten. Wenn die KI die „Übertrag"-Zeile verarbeitet, erkennt sie diese als Paginierungsartefakt und nicht als Transaktion und erhält die Kontinuität des laufenden Saldos über die Grenze hinweg aufrecht.
Integrierter Abgleich: Was die Extraktion liefern sollte
Das Endziel der Kontoauszug-Extraktion ist nicht nur eine Zeile mit Transaktionen – es ist ein abgeglichener Datensatz, der die Saldoprüfung besteht:
| Prüfschritt | Was er bestätigt | Warum er wichtig ist |
|---|---|---|
| Übereinstimmung des Eröffnungssaldos | Der extrahierte Eröffnungssaldo entspricht dem angegebenen Eröffnungssaldo | Stellt sicher, dass am Anfang keine Seite übersprungen wurde |
| Summenprüfung der Transaktionen | Die Summe der Soll- und Haben-Buchungen entspricht der angegebenen Nettoveränderung | Erkennt fehlende oder doppelte Transaktionszeilen |
| Kaskade des laufenden Saldos | Saldo jeder Zeile = vorheriger Saldo ± Transaktionsbetrag | Validiert jede einzelne Zeile in der richtigen Reihenfolge |
| Abstimmung des Endsaldo | Der endgültig extrahierte Saldo entspricht dem angegebenen Endsaldo | Ende-zu-Ende-Integritätsprüfung für das gesamte Dokument |
Tools, die diese Abgleichsprüfung implementieren – wie solche mit automatischer Saldoverifizierung, die in die Extraktionspipeline integriert ist – erkennen Fehler, bevor die Daten in das Buchhaltungssystem gelangen, und reduzieren so den manuellen QA-Aufwand für das Abgleichsteam.
Schritt-für-Schritt-Anleitungen zum Einrichten dieser Pipeline finden Sie in unserem Leitfaden zu OCR für die Buchhaltung: Extraktion von Kontoauszügen und Finanzdokumenten.
Wenn Ihr Fokus speziell auf der Arbeit mit Auszügen in Excel liegt und nicht auf Schecks oder KYC, führt Sie unser Schritt-für-Schritt-Tutorial zum Extrahieren von Kontoauszugsdaten in Excel durch den gesamten Workflow, und das Tool für Kontoauszug zu Excel führt dieselbe Extraktion automatisch mit Ihrer eigenen PDF-Datei durch.
KYC- und Kreditdokumentverarbeitung: Genauigkeit unter Compliance-Druck
Know Your Customer (KYC)-Compliance liegt an der Schnittstelle von OCR-Genauigkeit und regulatorischem Risiko. Ein einzelnes falsch gelesenes Zeichen auf einem Identitätsdokument – etwa die Verwechslung einer '0' mit einem 'O' oder ein falsch gelesenes Passnummernfeld – kann dazu führen, dass ein Kunde onboardingt wird, der die OFAC-Sanktionsprüfung nicht besteht, oder dass ein synthetischer Identitätsbetrug unentdeckt bleibt. Die Risiken unterscheiden sich grundlegend von der Rechnungsverarbeitung.
Der Dokumentenmix beim KYC-Onboarding
Ein standardmäßiges KYC-Onboarding-Paket umfasst mehrere Dokumenttypen, die jeweils unterschiedliche Extraktionsherausforderungen mit sich bringen:
- Staatlich ausgestellte Lichtbildausweise (Reisepässe, Führerscheine, nationale Personalausweise): Die maschinenlesbare Zone (MRZ) am unteren Rand ist für OCR konzipiert – sie verwendet die ICAO-Standardschrift, Prüfziffern und feste Feldlängen. Aber die MRZ ist nur ein Teil des Dokuments; das Extrahieren des Lichtbilds, der Unterschrift und der Nicht-MRZ-Textfelder (Adresse, Geburtsdatum, ausstellende Behörde) erfordert eine Ganzdokument-Bildanalyse. Derselbe Ganzbild-Ansatz bewältigt auch den leichteren Fall, auf den nachgelagerte Teams ständig stoßen – ein Ausweisfoto, das mit dem Handy aufgenommen wurde, bei dem Name, Geburtsdatum, Ausweisnummer und Ablaufdatum in Spalten landen müssen, ohne dass eine MRZ zur Verfügung steht.
- Adressnachweis (Nebenkostenabrechnungen, Kontoauszüge, Steuerbescheide): Dies sind keine identitätsoptimierten Dokumente. Sie kommen in beliebigem Layout und in beliebiger Scanqualität an, und die Adresse befindet sich möglicherweise nicht an einer festen Position. Banken müssen die Adresse, den Namen und das Datum (zur Bestätigung der Aktualität – in der Regel innerhalb von 90 Tagen) aus diesen Dokumenten extrahieren, ohne sich auf ein standardisiertes Format stützen zu können.
- Finanznachweise (Gehaltsabrechnungen, W-2-Formulare, Steuererklärungen, Kontoauszüge für die Kreditprüfung): Kreditunterlagen für die Kreditprüfung erfordern eine feldebene Extraktion von Einkommen, Beschäftigungsverlauf und Vermögensinformationen. Ein gewerblicher Kreditantrag kann 10–30 Seiten über mehrere Dokumenttypen umfassen – und Kreditprüfungsteams verbrachten zuvor 40 % ihrer Zeit nur mit der Organisation der Dokumente, bevor sie Daten daraus extrahierten.
Warum Zeichengenauigkeit für KYC nicht ausreicht
Traditionelle OCR-Anbieter werben mit Zeichengenauigkeit (CER) – typischerweise 99 % oder höher bei sauberen, gedruckten Dokumenten. Doch in KYC-Workflows ist die Zeichengenauigkeit eine irreführende Kennzahl. Eine CER von 99 % auf einer Passseite mit 500 Zeichen bedeutet im Durchschnitt 5 falsche Zeichen. Wenn eines davon eine Ziffer in der Passnummer oder ein Buchstabe im Kundennamen ist, scheitert das Dokument am AML-Screening oder das Konto wird mit falschen Identitätsdaten eröffnet, deren Korrektur Monate dauert.
Feldebene-Genauigkeit – ob die gesamte Passnummer korrekt extrahiert wurde, nicht ob die meisten Zeichen stimmen – ist die relevante Kennzahl für KYC. KI-basierte Extraktionssysteme, die Vision-Language-Modelle nutzen, verstehen den Kontext: Sie wissen, dass eine Passnummer einem bestimmten Muster folgt, dass Prüfziffern zur Validierung existieren und dass ein falsch gelesenes Zeichen zur manuellen Prüfung markiert werden kann, statt stillschweigend akzeptiert zu werden.
Veröffentlichte Einsatzdaten aus GreenNodes OCR-Implementierung im vietnamesischen Bankwesen zeigten, dass automatisiertes KYC mit integrierter OCR und KI die Verarbeitungszeit von 45 Minuten pro Datei auf unter 5 Minuten reduzierte, mit einer Straight-Through-Processing-Rate von 80–90 % für Standardanträge. Die restlichen 10–20 % erforderten manuelle Prüfung für Sonderfälle – minderwertige Dokumente, nicht standardkonforme Formate oder mehrdeutige Felder.
Für Banken mit hohem Kreditantragsvolumen verarbeitet dieselbe Extraktionspipeline, die KYC-Dokumente abwickelt, auch Gehaltsabrechnungen, Steuererklärungen und Kontoauszüge für die Kreditprüfung – eine einheitliche Extraktionsplattform, die alle diese Dokumenttypen abdeckt, ist daher ein erheblicher operativer Vorteil gegenüber separaten Spezialwerkzeugen für jede Prozessstufe.
Traditionelle OCR vs. Vision-KI: Warum ohne Vorlage im Bankwesen zählt
Die Herausforderungen der Dokumentenverarbeitung im Bankwesen werden durch denselben OCR-Ansatz, der Rechnungen und Belege verarbeitet, nicht gut gelöst. Bankdokumente stellen eine grundlegend schwierigere Problemklasse dar. Um das zu verstehen, muss man die beiden Generationen der Extraktionstechnologie klar unterscheiden.
Die Template-OCR-Grenze: Jedes neue Format unterbricht Ihren Workflow
Traditionelle OCR — ob Tesseract, ABBYY oder Cloud-OCR-APIs — arbeitet mit einem positionsbasierten Modell. Das System extrahiert den gesamten Text einer Seite und verwendet dann Regeln oder Template-Zuordnungen, um Felder anhand ihrer Koordinaten zuzuweisen. Das funktioniert, wenn dasselbe Dokumentformat wiederholt vorkommt. Es scheitert, wenn:
- Sie Kontoauszüge von über 50 verschiedenen Banken verarbeiten
- Eine Bank ihr Kontoauszugslayout aktualisiert (was häufiger passiert, als man erwarten würde)
- Ein Kunde einen gescannten Kontoauszug in leichtem Winkel oder mit gedrehter Seite einreicht
- Sie Handyfotos von Kontoauszügen statt sauberer PDFs erhalten
Jede Formatänderung erfordert ein Template-Update. Jede neue Bank erfordert ein neues Template. Die Template-Verwaltung skaliert linear mit der Dokumentvielfalt — und das Bankwesen ist eine Umgebung mit extremer Dokumentvielfalt.
Wie Vision-AI-Extraktion das Formatproblem löst
Vision-AI-Extraktion — mit großen Vision-Modellen (VLMs) — geht das Problem anders an. Statt den gesamten Text zu extrahieren und dann positionsbasiert erwarteten Feldern zuzuordnen, liest das VLM das Dokument so, wie es ein Mensch tun würde: ganzheitlich, mit Verständnis für das visuelle Layout, die semantische Bedeutung jeder Textregion und die Beziehungen zwischen Feldern.
Dies ist dieselbe Technologie, die in unserem Leitfaden zu Was KI-OCR ist und wie es sich von traditioneller OCR unterscheidet beschrieben wird — und sie ist der Schlüssel zur Lösung der Multi-Format-Herausforderung im Bankwesen. In der Praxis bedeutet das:
- Sie definieren die Ausgabe, nicht die Position: Statt ein Feld um die Stelle zu zeichnen, an der die Spalte „Transaktionsdatum" erscheint, teilen Sie dem System einfach mit, dass Sie Transaktionsdatum, Beschreibung, Sollbetrag, Habenbetrag und Kontostand möchten. Die KI findet diese Felder überall auf der Seite, indem sie deren Bedeutung versteht.
- Eine Spaltendefinition funktioniert über alle Formate hinweg: Derselbe Satz von Spaltennamen extrahiert Daten aus einem Chase-Kontoauszug, einem Bank-of-America-Kontoauszug und einem Kreditgenossenschafts-Kontoauszug — obwohl Spaltenreihenfolge, Feldnamen und Layout bei jedem völlig unterschiedlich sind.
- Formatänderungen unterbrechen Ihren Workflow nicht: Wenn eine Bank ihr Kontoauszugdesign aktualisiert, funktioniert die Extraktion weiter, weil die KI das neue Layout semantisch liest und nicht durch Abgleich mit einem gespeicherten Template.
Dieser Paradigmenwechsel — von positionsbasierter zu semantischer Extraktion — ermöglicht es Bankteams, Dokumente aus Dutzenden von Quellen zu verarbeiten, ohne eine ständig wachsende Bibliothek bankenspezifischer Templates aufzubauen und zu pflegen. Für einen breiteren Vergleich von Extraktionstools für Bankworkflows finden Sie in unserem Leitfaden zur besten OCR-Software 2026 nach Kategorien und Anwendungsfällen.
Häufig gestellte Fragen
Funktioniert OCR auch bei Schecks mit handschriftlichen Beträgen und Unterschriften?
Ja, aber die Genauigkeit hängt vom Verfahren ab. Die MICR-Lesung (die Zeile mit der Bankleitzahl) ist magnetisch und erreicht nahezu 100 % Leserate, unabhängig von der Handschrift auf dem Scheck. Der Betrag in Ziffern und in Worten wird per OCR/Bildanalyse gelesen und erreicht bei Schecks mit Handschrift typischerweise 90–97 % Genauigkeit. Die Unterschriftenregion wird mittels Mustererkennung auf Fälschungen geprüft, nicht mittels zeichenweiser OCR. Moderne Scheckverarbeitungssysteme kombinieren alle drei Verfahren und markieren Abweichungen zur manuellen Prüfung.
Kann die OCR für Kontoauszüge auch Auslandsüberweisungen verarbeiten?
KI-gestützte OCR kann Kontoauszüge von Banken aus verschiedenen Ländern verarbeiten, da sie Feldbedeutungen statt Vorlagenpositionen liest. Die Extraktionsgenauigkeit hängt jedoch von der Vielfalt der Formate ab, mit denen das KI-Modell trainiert wurde. Formate aus den USA, Großbritannien, Kanada, Australien und großen europäischen Banken werden gut unterstützt. Kleinere Regionalbanken oder Banken in weniger digitalisierten Märkten können beim ersten Versuch eine geringere Genauigkeit aufweisen, aber die KI passt sich schneller an als vorlagenbasierte Systeme, die für jedes neue Format eine manuelle Vorlagenerstellung erfordern.
Wie genau ist die KI-basierte Extraktion von Kontoauszügen im Vergleich zur manuellen Dateneingabe?
Veröffentlichte Genauigkeitsraten für KI-gestützte Kontoauszugsextraktion liegen zwischen 95 % und 99 % bei sauberen digitalen PDFs und zwischen 90 % und 95 % bei gescannten oder fotografierten Auszügen. Zum Vergleich: Die manuelle Dateneingabe hat eine typische Fehlerrate von 3–5 %, was etwa 3–5 falschen Zeichen pro 100 Anschlägen entspricht. Der Unterschied besteht darin, dass KI-Fehler tendenziell bei mehrdeutigen Feldern (unscharfe Zahlen, komplexe Transaktionsbeschreibungen) auftreten, während manuelle Fehler zufällig sind. Eine robuste Extraktionspipeline umfasst automatisierte Abstimmungsprüfungen – die Überprüfung, ob der laufende Saldo konsistent bleibt –, wodurch die meisten schwerwiegenden Extraktionsfehler erkannt werden, bevor sie das Buchhaltungssystem erreichen.
Ist OCR für Banken konform mit KYC/AML-Vorschriften?
Die Compliance wird durch die Art und Weise bestimmt, wie das OCR-System eingesetzt wird, nicht durch die OCR-Technologie selbst. Extrahierte Daten müssen mit einem nachvollziehbaren Prüfpfad gespeichert werden, der zeigt, was, wann und von welchem Prozess extrahiert wurde. Die meisten modernen KI-Extraktionsplattformen unterstützen Prüfprotokollierung, feldbezogene Konfidenzwerte (die Extraktionen mit niedriger Konfidenz zur Überprüfung kennzeichnen) und sichere Datenverarbeitung (TLS-Verschlüsselung, SOC-2-Zertifizierung). Gemäß den BSA/AML-Vorschriften (12 CFR 21.11) müssen Banken Aufzeichnungen führen, die reproduzierbar und prüfbar sind – ein KI-Extraktionssystem mit ordnungsgemäßer Protokollierung erfüllt diese Anforderung effektiver als die manuelle Dateneingabe, die keinen integrierten Prüfpfad hat.
Wie verarbeitet KYC OCR nicht-lateinische Schriften wie Arabisch, Chinesisch oder Kyrillisch?
Moderne Vision-KI-Modelle werden mit mehrsprachigen Daten trainiert und können die meisten zeichen- und schriftbasierten Systeme lesen. Bei KYC-Dokumenten verwendet die MRZ auf Pässen die ICAO-Standardschrift OCR-B mit ausschließlich lateinischen Zeichen, sodass die maschinenlesbare Zone universell lesbar ist. Die Nicht-MRZ-Felder (Name, Adresse in lokaler Schrift) erfordern OCR-Unterstützung für die jeweilige Sprache. KI-basierte OCR-Systeme unterstützen in der Regel 30+ Sprachen und können unter anderem Arabisch, Chinesisch (vereinfacht und traditionell), Kyrillisch, Devanagari, Koreanisch (Hangul) und Japanisch (Kanji) verarbeiten. Prüfen Sie stets, ob Ihr Extraktionsanbieter die von Ihnen benötigten Schriften unterstützt.
Welche Felder sollte ich für den Kontoabgleich aus einem Kontoauszug extrahieren?
Der Standard-Feldsatz für den Kontoabgleich umfasst: Kontonummer, Abrechnungszeitraum (Start/Ende), Anfangssaldo, Endsaldo sowie für jede Transaktion – Buchungsdatum, Verwendungszweck, Sollbetrag, Habenbetrag und laufender Saldo. Optionale, aber nützliche Felder sind: Referenz-/Schecknummer, Transaktionsart (ATM, Überweisung, Gutschrift, Gebühr) und Name des Zahlungsempfängers/-pflichtigen, falls verfügbar. Die meisten KI-Extraktionstools ermöglichen es, diese Felder als Spaltennamen zu definieren; das System füllt sie automatisch aus jedem Kontoauszugsformat.
Kann dasselbe OCR-Tool Schecks, Kontoauszüge und KYC-Dokumente verarbeiten?
Eine einheitliche KI-Extraktionsplattform – insbesondere eine, die auf visuellen Sprachmodellen basiert – kann alle drei Dokumenttypen ohne Toolwechsel verarbeiten. Die Scheckverarbeitung nutzt MICR für die Bankleitzahl und Bildanalyse für die Scheckoberfläche. Kontoauszüge verwenden tabellenbewusste Extraktion für Transaktionstabellen. KYC-Dokumente nutzen MRZ-Lesen für amtliche Ausweise und allgemeine Feldextraktion für Adressnachweise und Finanzbelege. Die entscheidende Voraussetzung ist, dass das Tool benutzerdefinierte Spaltenextraktion unterstützt: Sie definieren die gewünschten Spalten, und die KI lokalisiert die entsprechenden Daten durch semantisches Feldverständnis – unabhängig von Dokumenttyp oder -format.