OCR bancaire :
Traitement des chèques, extraction de relevés et automatisation KYC
Trois catégories de documents bancaires — chèques, relevés bancaires et documents KYC — représentent la majorité des heures de saisie manuelle de données dans les établissements financiers. Le rapport 2026 Risk Officer de la Federal Reserve a révélé que 63 % des établissements financiers ont signalé des tentatives de fraude par chèque au cours des 12 derniers mois. L'enquête 2026 Payments Fraud Survey de l'AFP situe ce chiffre à 58 % d'organisations signalant une fraude par chèque, ce qui en fait le moyen de paiement le plus exposé à la fraude. Pendant ce temps, les équipes de rapprochement bancaire passent des jours chaque mois à saisir manuellement des lignes de transactions provenant de relevés qui refusent de s'aligner proprement dans une feuille de calcul, et les responsables de conformité traitent les documents KYC avec des délais de 30 à 60 minutes par dossier.
Points clés
- Les banques concentrent leurs investissements OCR sur trois pipelines distincts — traitement des chèques, extraction de relevés et vérification KYC — et ces trois pipelines reposent sur une hypothèse qui ne tient jamais : les mises en page des documents restent les mêmes.
- Une OCR au niveau des caractères avec une précision de 99 % fait encore cinq erreurs de caractères par page KYC — et un seul chiffre erroné dans un numéro de passeport entraîne un échec de conformité qu'aucune piste d'audit ne peut expliquer.
- La Vision AI extrait les documents bancaires selon le sens des champs plutôt que selon les coordonnées de pixels — une seule définition de colonne fonctionne avec tous les formats bancaires, que Chase redessine ses relevés ou qu'un client fasse pivoter son téléphone.
Le secteur bancaire repose sur des documents. Mais contrairement aux factures — qui partagent au moins une structure familiale approximative chez la plupart des fournisseurs — les documents bancaires résistent à toute tentative de normalisation. Un chèque repose sur une police à encre magnétique inventée dans les années 1950. Un relevé bancaire de Chase et celui d'une caisse populaire régionale ne partagent pratiquement aucune convention de mise en page. Un passeport utilisé pour le KYC suit les normes de l'ICAO, tandis qu'un permis de conduire suit des règles étatiques qui changent tous les quelques années.
Cet article couvre les trois types de documents qui stimulent l'adoption de l'OCR dans le secteur bancaire, explique les défis techniques spécifiques que chacun présente, et montre où l'OCR traditionnel échoue — et où l'IA visuelle intervient.
Les trois documents bancaires qui stimulent l'adoption de l'OCR
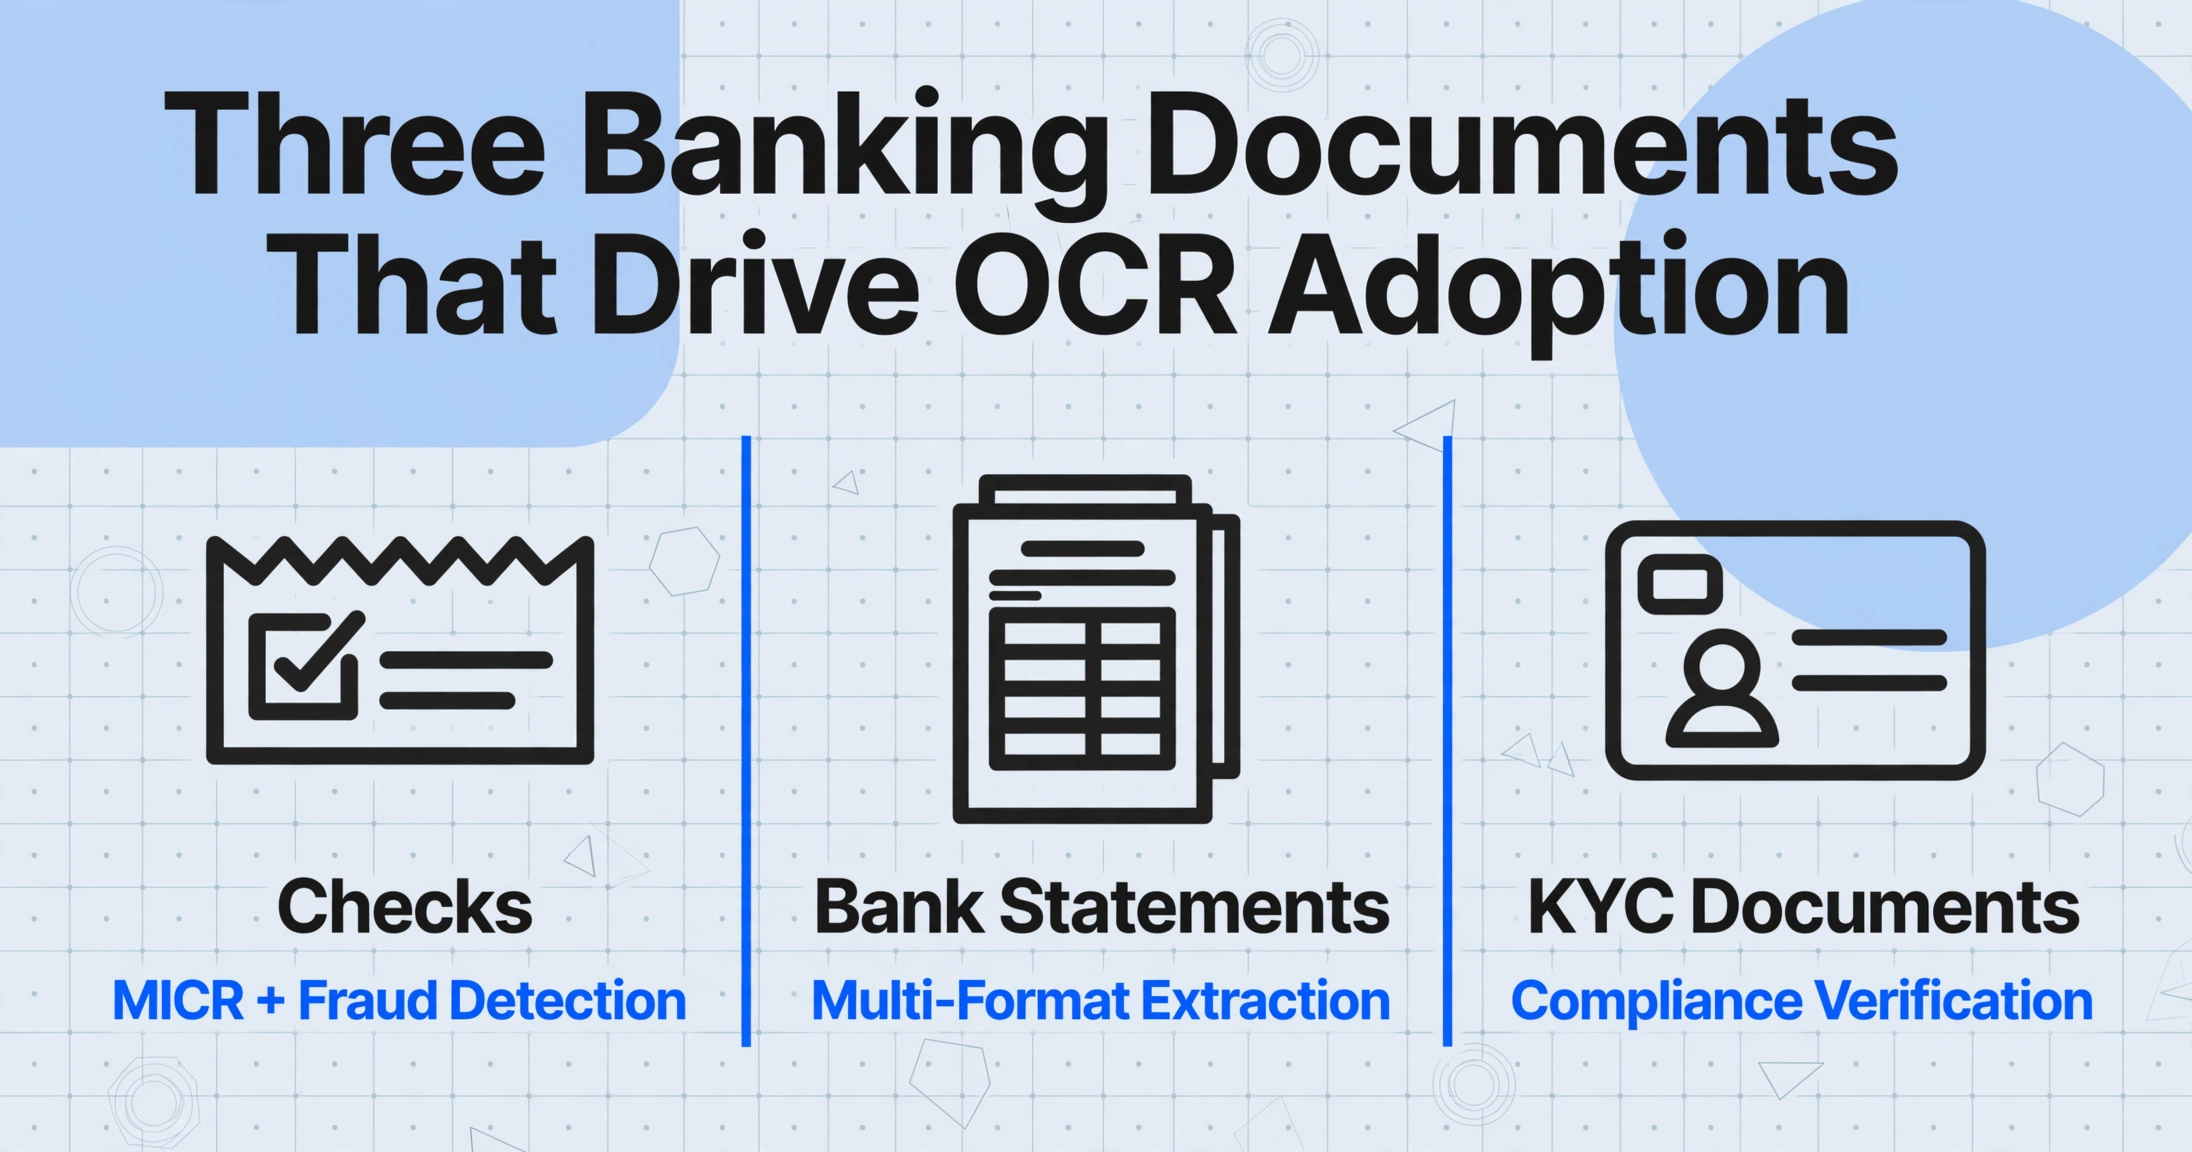
Lorsque les professionnels du secteur bancaire parlent d'OCR, ils font généralement référence à l'un de trois flux de travail distincts, chacun avec ses propres exigences techniques, modes de défaillance et enjeux réglementaires :
Traitement des chèques et des paiements
La reconnaissance de caractères à encre magnétique (MICR) est la colonne vertébrale du traitement des chèques. Les banques traitent des millions de chèques quotidiennement via des trieuses à grande vitesse qui lisent la ligne de police E-13B en bas de chaque chèque. Le défi va au-delà du MICR : la détection de fraude exige la lecture des zones de montant en chiffres (CAR) et de montant en lettres (LAR), la vérification des motifs d'endossement et la détection des altérations. 58 % des organisations ont signalé une fraude par chèque en 2025, selon l'enquête de l'AFP.
Extraction et rapprochement des relevés bancaires
Chaque banque formate ses relevés différemment. Les tableaux de transactions peuvent s'étendre sur plusieurs colonnes — date, description, débit, crédit, solde courant — et ces colonnes changent de position d'une page à l'autre au sein du même relevé. Le solde courant doit être continu à travers les sauts de page. L'OCR basé sur des modèles échoue ici. L'extraction de relevés bancaires propulsée par l'IA gère ces variations en comprenant la sémantique des champs plutôt que les coordonnées de pixels.
Vérification des documents KYC et de prêt
L'intégration des clients exige la vérification des pièces d'identité (passeports, permis de conduire), des justificatifs de domicile (factures de services publics, relevés bancaires) et des preuves financières (fiches de paie, déclarations fiscales, W-2). La conformité aux réglementations BSA/AML exige une extraction précise et des pistes d'audit. Le traitement KYC manuel prend 30 à 60 minutes par dossier ; l'eKYC automatisé avec OCR et IA réduit ce délai à moins de 5 minutes pour les demandes standard, selon les données de déploiement publiées par des banques asiatiques et européennes.
Ces trois flux de travail partagent un point commun : ils impliquent tous l’extraction de données structurées à partir d’images de documents semi-structurés ou non structurés. Mais les approches techniques qui fonctionnent pour l’un échouent souvent pour les autres.
Traitement des chèques : là où l’OCR rencontre le MICR
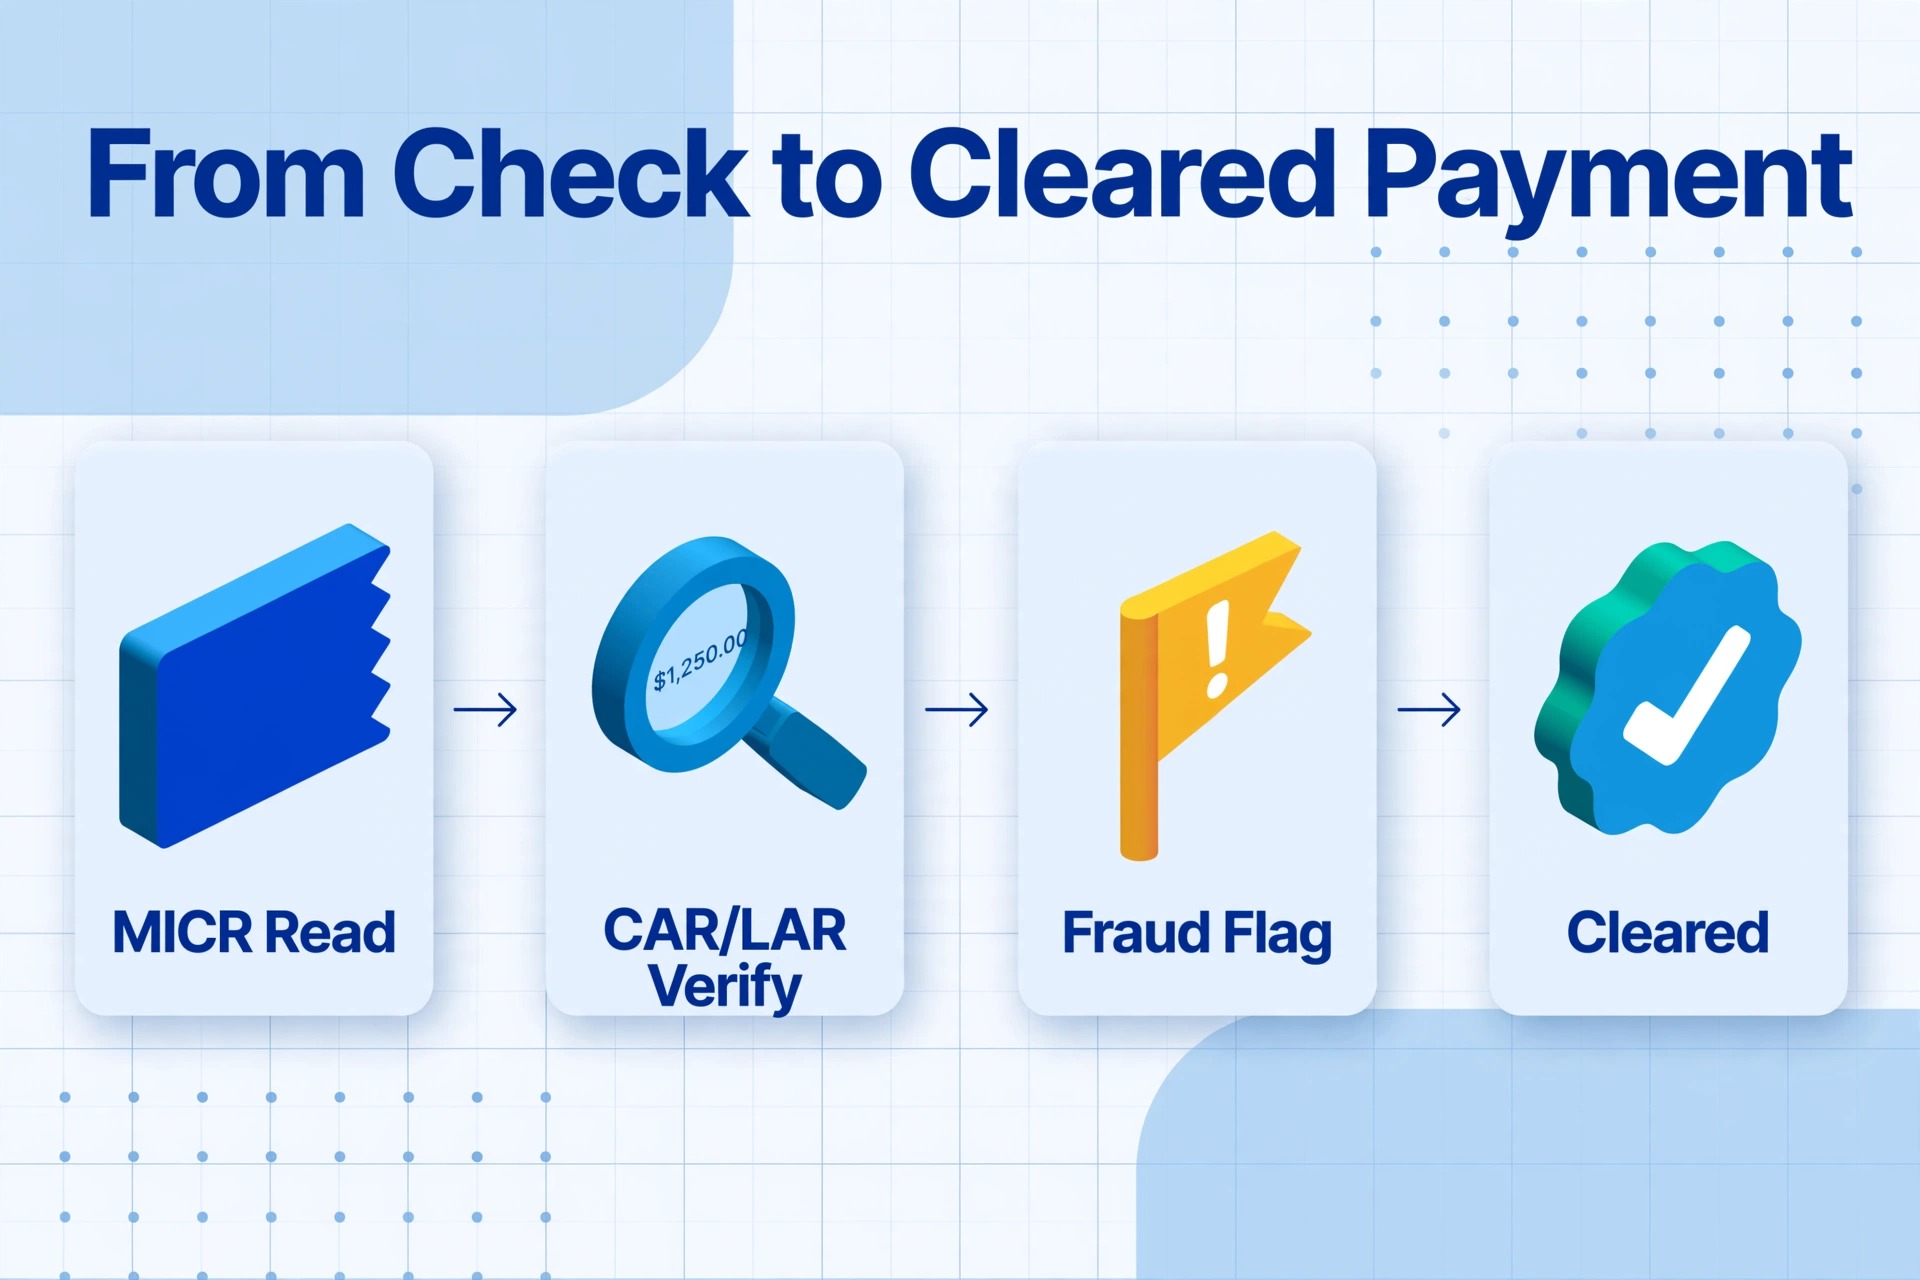
Le traitement des chèques occupe une position unique dans le paysage de l’OCR, car il ne repose pas uniquement sur l’OCR. Les données critiques de chaque chèque — numéro d’acheminement, numéro de compte, numéro de chèque — sont encodées dans la ligne MICR (reconnaissance de caractères à encre magnétique), une police spécialisée imprimée avec de l’encre ou du toner magnétique qui reste lisible même après avoir été tamponnée, marquée ou barrée.
La norme MICR : E-13B et CMC-7
La ligne MICR en bas de chaque chèque utilise l’une de deux polices. Aux États-Unis, au Canada, au Royaume-Uni, en Australie et dans une grande partie de la région Asie-Pacifique, la norme est E-13B, adoptée par l’American Bankers Association en 1958 et normalisée plus tard sous les références ANSI X9.27 et ISO 1004:1995. Les pays européens et certains pays d’Amérique latine utilisent CMC-7, une police différente qui encode les mêmes données d’acheminement. Les deux sont magnétiques — le trieur de chèques à grande vitesse d’une banque les lit en détectant le signal magnétique des caractères, et non par reconnaissance optique. Cela confère au MICR des taux de lecture quasi parfaits, même sur des chèques pliés, tachés ou annotés.
La ligne MICR encode quatre informations :
- Numéro d’acheminement (9 chiffres aux États-Unis) — identifie l’institution financière
- Numéro de compte — identifie le compte spécifique
- Numéro de chèque — identifiant séquentiel du chèque
- Montant — ajouté après la présentation du chèque pour paiement (encodage du montant de courtoisie)
Alors que le MICR gère la ligne d’acheminement, le reste du chèque — le nom du bénéficiaire, le montant en lettres, le montant en chiffres, la date, la ligne de mention et la signature — repose sur l’OCR conventionnel et l’analyse d’image. C’est là que l’extraction moderne par IA apporte une valeur ajoutée au-delà de ce que le MICR seul peut offrir.
Détection de la fraude par chèque : la couche OCR
La fraude par chèque demeure le problème de fraude documentaire le plus persistant dans le secteur bancaire. Le rapport 2026 des responsables du risque de la Réserve fédérale, qui a interrogé plus de 400 professionnels du risque, a révélé que 63 % des institutions financières avaient subi des tentatives de fraude par chèque au cours de l'année précédente. Les vecteurs d'attaque spécifiques évoluent : 32 % des répondants ont signalé une augmentation des chèques contrefaits, 21 % ont signalé le lavage de chèques (effacement de l'encre pour réécrire le bénéficiaire ou le montant) et 18 % ont signalé la falsification du bénéficiaire.
Les systèmes OCR IA modernes basés sur l'IA détectent ces schémas grâce à l'analyse d'image de la surface du chèque :
- Reconnaissance du montant en chiffres (CAR) / Reconnaissance du montant en lettres (LAR) : Le système lit à la fois le montant numérique et le montant en toutes lettres et les recoupe pour vérifier leur cohérence. Toute divergence signale le chèque pour un examen manuel.
- Vérification de la signature : L'analyse d'image compare la signature sur le chèque à la signature de référence au dossier, détectant les faux et les signataires non autorisés.
- Détection des altérations : L'analyse d'image de la surface du papier détecte les traces de lavage de chèque — résidus chimiques, fibres perturbées ou bavures d'encre indiquant que le texte original a été effacé et réécrit.
- Analyse de l'endossement : Le système vérifie le verso du chèque pour détecter des schémas d'endossement valides, garantissant que le chèque a été déposé par le bénéficiaire prévu ou son mandataire autorisé.
Les banques superposent généralement ces contrôles de fraude basés sur l'OCR à la lecture magnétique MICR, créant ainsi un pipeline de validation multi-moteurs qui détecte à la fois les erreurs d'encodage et la fraude délibérée. Des outils comme Check Image Analysis d'Abrigo et TrueChecks d'Advanced Fraud Solutions appliquent ces techniques combinées au point de présentation.
La loi Check 21 (la loi sur la compensation des chèques pour le XXIe siècle, en vigueur depuis 2004) a rendu le traitement électronique des chèques — connu sous le nom de dépôt à distance ou RDC — juridiquement équivalent au traitement physique des chèques. Cela signifie que les banques peuvent traiter les images de chèques capturées par des appareils mobiles ou des scanners de succursale, en s'appuyant entièrement sur la technologie OCR et MICR sans jamais manipuler le papier.
Extraction de relevés bancaires : le défi du multi-format
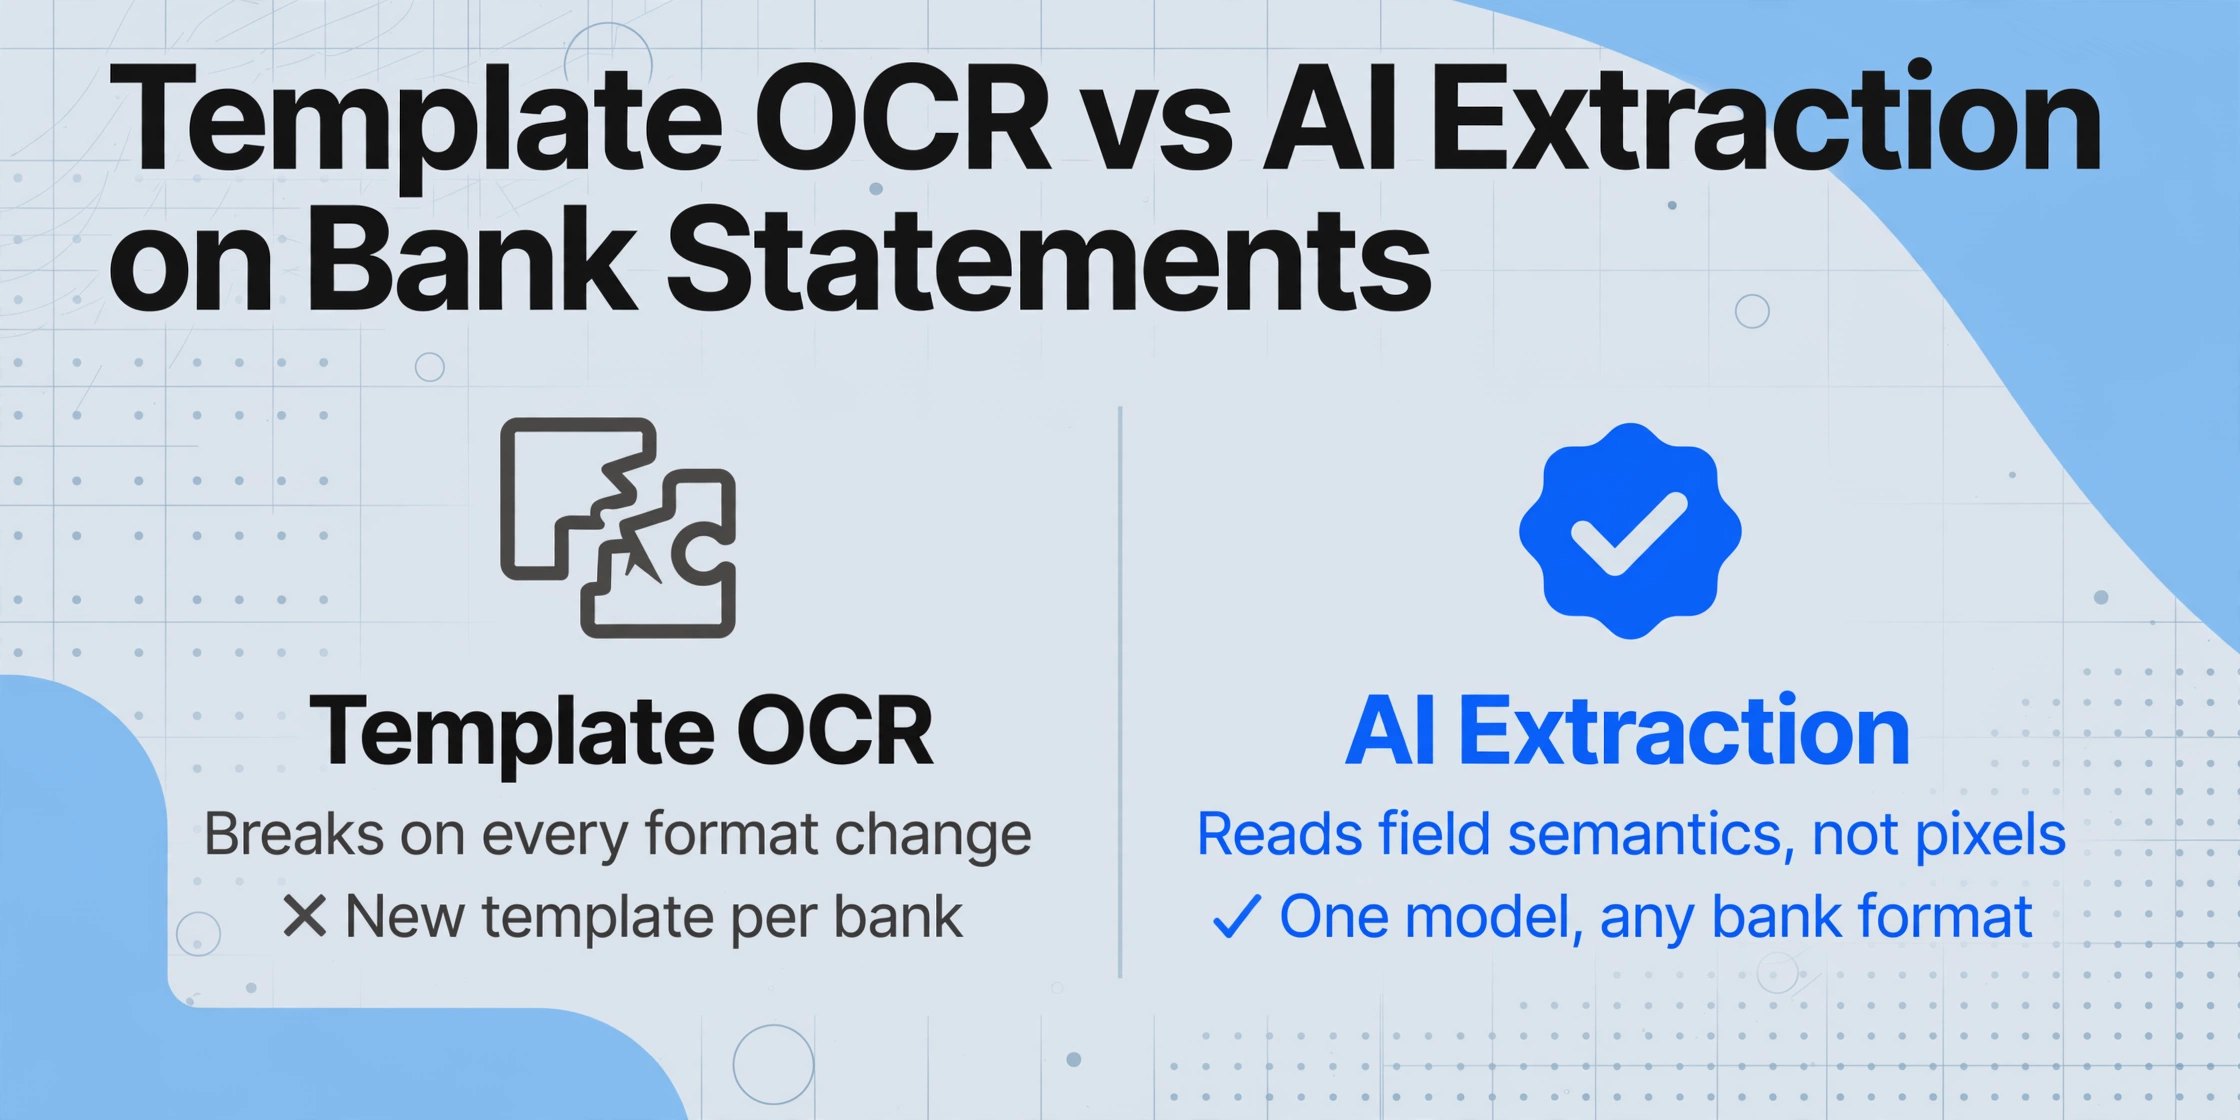
L'extraction de relevés bancaires est sans doute le problème OCR courant le plus difficile en finance — non pas parce que les caractères sont difficiles à lire, mais parce que la structure du document est si variable. Chaque banque formate ses relevés différemment, et ces différences ne sont pas cosmétiques. Elles affectent la manière dont les systèmes d'extraction doivent traiter chaque page.
Pourquoi les formats de relevés bancaires résistent à l'automatisation
Un relevé bancaire n'est pas un simple tableau. C'est un document multi-zones qui comprend généralement :
- Une zone d'en-tête avec le nom du titulaire, le numéro de compte, la période du relevé, le solde d'ouverture et l'identifiant de la banque
- Un tableau de transactions avec les colonnes date, description, montant débité, montant crédité et solde courant
- Des zones de pied de page avec le solde de clôture, les intérêts perçus, les frais prélevés et les mentions légales en petits caractères
- Des encadrés latéraux avec des offres promotionnelles, des notifications de compte ou des messages marketing
Le tableau de transactions lui-même constitue le défi de l'extraction. La disposition des colonnes — quel champ va où, comment les en-têtes de colonnes sont nommés, si les débits et crédits sont dans des colonnes séparées ou une seule colonne signée — varie selon la conception du relevé de chaque banque. Et au sein d'un même relevé multipage, les limites de colonnes dérivent souvent de quelques pixels d'une page à l'autre, car la zone d'en-tête de la première page (avec le logo de la banque et le résumé du relevé) occupe plus d'espace que l'en-tête minimal de la deuxième page.
Les systèmes OCR basés sur des modèles exigent un modèle de mise en page distinct pour chaque format de banque — et un modèle révisé à chaque fois que la banque met à jour la conception de son relevé. Pour une institution financière qui traite des relevés provenant de dizaines de banques, la maintenance des modèles devient une charge opérationnelle à temps plein.
Extraction adaptée aux pages et continuité du solde courant
Le problème technique le plus difficile en OCR de relevés bancaires est le maintien de la continuité des données entre les pages. Un relevé unique peut comporter de 3 à 30 pages ou plus. Le tableau des transactions se divise aux limites de pages, chaque nouvelle page commence par un solde « reporté », et le solde courant de chaque ligne doit être égal au solde de la ligne précédente plus ou moins le montant de la transaction.
Si le pipeline d'extraction traite chaque page indépendamment — comme le font la plupart des outils OCR de base — il risque trois types de défaillance :
- Lignes manquées : Les transactions proches de la limite de page sont entièrement omises parce que la division tombe dans un espace du tableau
- Lignes dupliquées : Le solde « reporté » de la page N est traité comme une transaction sur la page N+1, et la première transaction réelle de la page N+1 se décale d'une ligne
- Continuité du solde rompue : La séquence du solde courant se brise à la limite de page, rendant le rapprochement impossible
Les systèmes modernes d'extraction par IA de vision gèrent cela en maintenant un état adapté aux pages — ils lisent le document complet comme une séquence connectée plutôt que comme des pages indépendantes. Lorsque l'IA traite la ligne « reporté », elle la reconnaît comme un artefact de pagination plutôt que comme une transaction et maintient la continuité du solde courant à travers la limite.
Rapprochement intégré : ce que l'extraction devrait fournir
L'objectif final de l'extraction de relevés bancaires n'est pas seulement une liste de transactions — c'est un ensemble de données rapproché qui réussit le contrôle du solde :
| Contrôle de vérification | Ce qu'il confirme | Pourquoi c'est important |
|---|---|---|
| Correspondance du solde d'ouverture | Le solde d'ouverture extrait correspond au solde d'ouverture déclaré | Garantit qu'aucune page n'a été sautée au début |
| Contrôle de la somme des transactions | La somme des débits et crédits correspond à la variation nette déclarée | Détecte les lignes de transactions manquantes ou dupliquées |
| Cascade du solde courant | Le solde de chaque ligne = solde précédent ± montant de la transaction | Valide chaque ligne individuelle dans l'ordre |
| Rapprochement du solde de clôture | Le solde final extrait correspond au solde de clôture déclaré | Contrôle d'intégrité de bout en bout pour le document complet |
Les outils qui implémentent ce contrôle de rapprochement — comme ceux dotés d'une vérification automatisée du solde intégrée au pipeline d'extraction — détectent les erreurs avant que les données n'entrent dans le système comptable, réduisant ainsi la charge de contrôle qualité manuelle pour l'équipe de rapprochement.
Pour des instructions étape par étape sur la configuration de ce pipeline, consultez notre guide sur l'OCR pour la comptabilité : extraction de relevés bancaires et de documents financiers.
Si votre objectif porte spécifiquement sur le travail de relevés vers Excel plutôt que sur les chèques ou le KYC, notre tutoriel étape par étape sur l'extraction de données de relevés bancaires vers Excel présente le flux de travail complet, et l'outil de relevé bancaire vers Excel exécute la même extraction automatiquement sur votre propre PDF.
Traitement des documents KYC et de prêt : précision sous pression réglementaire
La conformité Know Your Customer se situe à l'intersection de la précision OCR et du risque réglementaire. Mal lire un seul caractère sur un document d'identité — confondre un « 0 » avec un « O », ou mal lire un numéro de passeport — peut conduire à intégrer un client qui échoue au filtrage des sanctions OFAC, ou à ne pas détecter une fraude d'identité synthétique. Les enjeux sont fondamentalement différents de ceux du traitement de factures.
Les types de documents dans l'intégration KYC
Un package d'intégration KYC standard comprend plusieurs types de documents, chacun présentant des défis d'extraction différents :
- Pièces d'identité avec photo délivrées par le gouvernement (passeports, permis de conduire, cartes d'identité nationales) : La zone à lecture optique (MRZ) en bas est conçue pour l'OCR — elle utilise la police standard de l'ICAO, des chiffres de contrôle et des longueurs de champ fixes. Mais la MRZ n'est qu'une partie du document ; extraire la photo du visage, la signature et les champs de texte hors MRZ (adresse, date de naissance, autorité de délivrance) exige une analyse d'image du document entier. Cette même approche d'image entière gère le cas plus léger que les équipes aval rencontrent constamment — une photo de carte d'identité prise avec un téléphone, où le nom, la date de naissance, le numéro d'identité et la date d'expiration doivent être placés dans des colonnes sans MRZ sur laquelle s'appuyer.
- Justificatif de domicile (factures de services publics, relevés bancaires, avis d'imposition) : Ces documents ne sont pas optimisés pour l'identité. Ils se présentent dans n'importe quelle mise en page, numérisés à n'importe quelle qualité, et l'adresse peut ne pas être dans une position fixe. Les banques doivent extraire l'adresse, le nom et la date (pour confirmer que le document est récent — généralement daté de moins de 90 jours) de ces documents sans format standardisé sur lequel s'appuyer.
- Preuves financières (fiches de paie, W-2, déclarations fiscales, relevés bancaires pour la souscription) : Les documents de souscription de prêt exigent une extraction au niveau du champ des revenus, de l'historique d'emploi et des informations sur les actifs. Une demande de prêt commercial peut inclure 10 à 30 pages couvrant plusieurs types de documents — et les équipes de souscription passaient auparavant 40 % de leur temps simplement à organiser les documents avant d'en extraire les données.
Pourquoi la précision au niveau des caractères ne suffit pas pour le KYC
Les fournisseurs d'OCR traditionnels citent la précision au niveau des caractères (CER) — généralement 99 % ou plus sur des documents imprimés propres. Mais dans les flux de travail KYC, la précision au niveau des caractères est une mesure trompeuse. Un CER de 99 % sur une page de passeport contenant 500 caractères signifie qu'en moyenne, 5 caractères sont erronés. Si l'un d'eux est un chiffre du numéro de passeport ou une lettre du nom du client, le document échoue au filtrage AML ou le compte est ouvert avec des données d'identité incorrectes qui prendront des mois à corriger.
La précision au niveau des champs — c'est-à-dire que le numéro de passeport complet est extrait correctement, et non que la plupart des caractères sont corrects — est la mesure pertinente pour le KYC. Les systèmes d'extraction basés sur l'IA qui utilisent des modèles de langage visuels comprennent le contexte : ils savent qu'un numéro de passeport suit un modèle spécifique, que des chiffres de contrôle existent pour la validation, et qu'un caractère mal lu peut être signalé pour examen humain plutôt que d'être accepté silencieusement.
Les données de déploiement publiées par la mise en œuvre OCR de GreenNode dans le secteur bancaire vietnamien ont montré que le KYC automatisé avec OCR et IA intégrés réduisait le temps de traitement de 45 minutes par dossier à moins de 5 minutes, avec un taux de traitement direct de 80 à 90 % pour les demandes standard. Les 10 à 20 % restants nécessitaient un examen humain pour les cas particuliers — documents de mauvaise qualité, formats non standard ou champs ambigus.
Pour les banques traitant de gros volumes de demandes de prêt, le même pipeline d'extraction qui gère les documents KYC traite également les fiches de paie, les déclarations fiscales et les relevés bancaires pour la souscription — ce qui fait d'une plateforme d'extraction unifiée capable de gérer tous ces types de documents un avantage opérationnel significatif par rapport à des outils distincts et spécialisés pour chaque étape du processus.
OCR traditionnel vs. IA vision : pourquoi le sans modèle est essentiel dans le secteur bancaire
Les défis de traitement documentaire du secteur bancaire ne sont pas bien servis par la même approche OCR qui gère les factures et les reçus. Les documents bancaires présentent un ensemble de problèmes fondamentalement plus difficile. Comprendre pourquoi nécessite une distinction claire entre les deux générations de technologie d'extraction.
La limite de l'OCR basé sur des modèles : chaque nouveau format perturbe votre flux de travail
L'OCR traditionnel — qu'il s'agisse de Tesseract, ABBYY ou des API OCR cloud — fonctionne sur un modèle basé sur la position. Le système extrait tout le texte d'une page, puis utilise des règles ou des cartographies de modèles pour attribuer les champs en fonction de leurs coordonnées. Cela fonctionne lorsque le même format de document apparaît de manière répétée. Cela échoue lorsque :
- Vous traitez des relevés provenant de plus de 50 banques différentes
- Une banque modifie la mise en page de ses relevés (ce qui arrive plus souvent qu'on ne le pense)
- Un client soumet un relevé scanné légèrement incliné ou avec une page pivotée
- Vous recevez des photos de relevés prises au téléphone plutôt que des PDF propres
Chaque changement de format nécessite une mise à jour du modèle. Chaque nouvelle banque exige un nouveau modèle. La gestion des modèles évolue linéairement avec la diversité des documents — et le secteur bancaire est un environnement de diversité documentaire extrême.
Comment l'extraction par IA vision résout le problème du format
L'extraction par IA vision — utilisant de grands modèles de vision (VLM) — aborde le problème différemment. Au lieu d'extraire tout le texte puis d'essayer de le faire correspondre à des champs attendus par position, le VLM lit le document comme le ferait un humain : de manière holistique, en comprenant la mise en page visuelle, la signification sémantique de chaque zone de texte et les relations entre les champs.
Il s'agit de la même technologie décrite dans notre guide sur ce qu'est l'OCR par IA et en quoi il diffère de l'OCR traditionnel — et c'est la clé pour résoudre le défi des formats multiples dans le secteur bancaire. En pratique, cela signifie :
- Vous définissez la sortie, pas la position : Au lieu de dessiner une zone autour de l'endroit où apparaît la colonne « Date de transaction », vous indiquez simplement au système que vous voulez la date de transaction, la description, le montant débité, le montant crédité et le solde courant. L'IA trouve ces champs n'importe où sur la page en comprenant leur signification.
- Une définition de colonne fonctionne pour tous les formats : Le même ensemble de noms de colonnes extrait les données d'un relevé Chase, d'un relevé Bank of America et d'un relevé de caisse d'épargne — même si l'ordre des colonnes, les noms des champs et la mise en page sont complètement différents sur chacun.
- Les changements de format ne perturbent pas votre flux de travail : Lorsqu'une banque met à jour la conception de ses relevés, l'extraction continue de fonctionner car l'IA lit la nouvelle mise en page par sémantique, et non en faisant correspondre un modèle enregistré.
Ce changement de paradigme — d'une extraction basée sur la position à une extraction basée sur la sémantique — est ce qui permet aux équipes bancaires de traiter des documents provenant de dizaines de sources sans avoir à créer et maintenir une bibliothèque toujours croissante de modèles par banque. Pour une comparaison plus large des outils d'extraction adaptés aux flux de travail bancaires, consultez notre guide des meilleurs logiciels OCR en 2026, par catégorie et par cas d'usage.
Questions fréquentes
La ROC fonctionne-t-elle sur les chèques avec montants et signatures manuscrits ?
Oui, mais la précision dépend de l'approche. La lecture MICR (ligne de routage) est magnétique et atteint des taux de lecture proches de 100 %, quelle que soit l'écriture manuscrite sur le chèque. Le montant en chiffres et le montant en lettres sont lus par ROC/analyse d'image et atteignent généralement une précision de 90 à 97 % sur les chèques manuscrits. La zone de signature est analysée pour la détection de falsification par reconnaissance de motifs, et non par ROC de caractères. Les systèmes modernes de traitement des chèques combinent ces trois techniques et signalent les divergences pour examen humain.
La ROC de relevés bancaires peut-elle traiter les relevés de banques internationales ?
La ROC basée sur l'IA peut traiter les relevés de banques de différents pays car elle lit la sémantique des champs plutôt que les positions dans un modèle. Cependant, la précision de l'extraction dépend de la variété des formats sur lesquels le modèle d'IA a été entraîné. Les formats des banques américaines, britanniques, canadiennes, australiennes et des grandes banques européennes sont bien pris en charge. Les petites banques régionales ou les banques de marchés moins numérisés peuvent montrer une précision moindre lors de la première tentative, bien que l'IA s'adapte plus rapidement que les systèmes basés sur des modèles qui nécessiteraient la création manuelle d'un modèle pour chaque nouveau format.
Quelle est la précision de l'extraction de relevés bancaires par IA par rapport à la saisie manuelle ?
Les taux de précision publiés pour l'extraction de relevés bancaires par IA vont de 95 % à 99 % sur des PDF numériques propres, et de 90 % à 95 % sur des relevés scannés ou photographiés. À titre de comparaison, la saisie manuelle a un taux d'erreur typique de 3 à 5 %, ce qui correspond à environ 3 à 5 caractères erronés pour 100 frappes. La différence est que les erreurs de l'IA ont tendance à se concentrer sur des champs ambigus (chiffres flous, descriptions de transactions complexes), tandis que les erreurs manuelles sont aléatoires. Un pipeline d'extraction robuste inclut des contrôles de rapprochement automatisés — vérifiant la cohérence du solde courant — ce qui détecte la plupart des erreurs d'extraction significatives avant qu'elles n'atteignent le système comptable.
La ROC bancaire est-elle conforme aux réglementations KYC/AML ?
La conformité est déterminée par la façon dont le système ROC est déployé, et non par la technologie ROC elle-même. Les données extraites doivent être stockées avec une piste d'audit vérifiable indiquant ce qui a été extrait, quand et par quel processus. La plupart des plateformes modernes d'extraction par IA prennent en charge la journalisation d'audit, les scores de confiance au niveau des champs (signalant les extractions de faible confiance pour examen) et le traitement sécurisé des données (chiffrement TLS, certification SOC 2). En vertu des réglementations BSA/AML (12 CFR 21.11), les banques doivent conserver des enregistrements reproductibles et auditatables — un système d'extraction par IA avec une journalisation appropriée satisfait à cette exigence plus efficacement que la saisie manuelle, qui n'a pas de piste d'audit intégrée.
Comment la ROCN KYC gère-t-elle les écritures non latines comme l'arabe, le chinois ou le cyrillique ?
Les modèles d'IA visuelle modernes sont entraînés sur des données multilingues et peuvent lire la plupart des systèmes d'écriture alphabétiques et logographiques. Pour les documents KYC, la zone MRZ des passeports utilise la police OCR-B standard ICAO avec uniquement des caractères latins, ce qui rend la zone lisible universellement. Les champs hors MRZ (nom, adresse en écriture locale) nécessitent une ROCN adaptée à la langue spécifique. Les systèmes de ROCN basés sur l'IA prennent généralement en charge plus de 30 langues et peuvent traiter l'arabe, le chinois (simplifié et traditionnel), le cyrillique, le devanagari, le hangul coréen et le kanji japonais, entre autres. Vérifiez toujours que votre fournisseur d'extraction prend en charge les écritures que vous traitez.
Quels champs extraire d'un relevé bancaire pour le rapprochement ?
L'ensemble standard de champs pour le rapprochement bancaire comprend : Numéro de compte, Début/Fin de période, Solde d'ouverture, Solde de clôture, et pour chaque transaction — Date de transaction, Description, Montant débité, Montant crédité et Solde courant. Champs facultatifs mais utiles : Numéro de référence/chèque, Type de transaction (DAB, virement, transfert, dépôt, frais) et Nom du bénéficiaire/émetteur si disponible. La plupart des outils d'extraction par IA vous permettent de définir ces champs comme noms de colonnes, et le système les remplit automatiquement depuis n'importe quel format de relevé.
Un même outil ROCN peut-il traiter les chèques, relevés bancaires et documents KYC ?
Une plateforme d'extraction IA unifiée — notamment basée sur des modèles de langage visuels — peut traiter ces trois types de documents sans changer d'outil. Le traitement des chèques utilise la reconnaissance MICR pour la ligne de routage et l'analyse d'image pour la surface du chèque. Les relevés bancaires utilisent une extraction adaptée aux tableaux pour les transactions. Les documents KYC utilisent la lecture MRZ pour les pièces d'identité officielles et l'extraction générale de champs pour les justificatifs de domicile et de revenus. La condition clé est que l'outil prenne en charge l'Extraction de colonnes personnalisées : vous définissez les colonnes souhaitées, et l'IA localise les données correspondantes en comprenant la sémantique des champs, quel que soit le type ou le format du document.