OCR para Banca:
Procesamiento de Cheques, Extracción de Estados de Cuenta y Automatización KYC
Tres categorías de documentos bancarios — cheques, estados de cuenta y documentos KYC — representan la mayoría de las horas de ingreso manual de datos en las instituciones financieras. El Informe de Oficiales de Riesgo 2026 de la Reserva Federal encontró que el 63% de las instituciones financieras reportaron intentos de fraude con cheques en los 12 meses anteriores. La Encuesta de Fraude en Pagos 2026 de AFP sitúa la cifra en el 58% de las organizaciones que reportan fraude con cheques, lo que lo convierte en el método de pago más propenso al fraude. Mientras tanto, los equipos de conciliación bancaria pasan días cada mes ingresando manualmente filas de transacciones de estados de cuenta que se niegan a alinearse limpiamente en una hoja de cálculo, y los oficiales de cumplimiento procesan documentos KYC con tiempos de ciclo que van de 30 a 60 minutos por archivo.
Conclusiones Clave
- Los bancos invierten en OCR en tres flujos separados — procesamiento de cheques, extracción de estados de cuenta y verificación KYC — y los tres dependen de una suposición que nunca se cumple: que los diseños de documentos permanecen iguales.
- Un OCR con 99% de precisión a nivel de caracteres aún comete cinco errores por página KYC — y un dígito incorrecto en un número de pasaporte significa un fallo de cumplimiento que ninguna pista de auditoría puede explicar.
- La IA de visión extrae documentos bancarios por significado de campo en lugar de coordenadas de píxeles — una definición de columna funciona en todos los formatos bancarios, ya sea que Chase rediseñe su estado de cuenta o un cliente gire su teléfono.
La banca funciona con documentos. Pero a diferencia de las facturas — que al menos comparten una estructura general similar entre la mayoría de los proveedores — los documentos bancarios resisten cualquier intento de estandarización. Un cheque depende de una fuente de tinta magnética inventada en la década de 1950. Un estado de cuenta de Chase y uno de una cooperativa de crédito regional no comparten prácticamente ninguna convención de diseño. Un pasaporte utilizado para KYC sigue los estándares de la ICAO, mientras que una licencia de conducir sigue reglas estatales que cambian cada pocos años.
Este artículo cubre los tres tipos de documentos que impulsan la adopción de OCR en la banca, explica los desafíos técnicos específicos que presenta cada uno y muestra dónde el OCR tradicional se queda corto — y dónde interviene la visión artificial.
Los Tres Documentos Bancarios Que Impulsan la Adopción de OCR
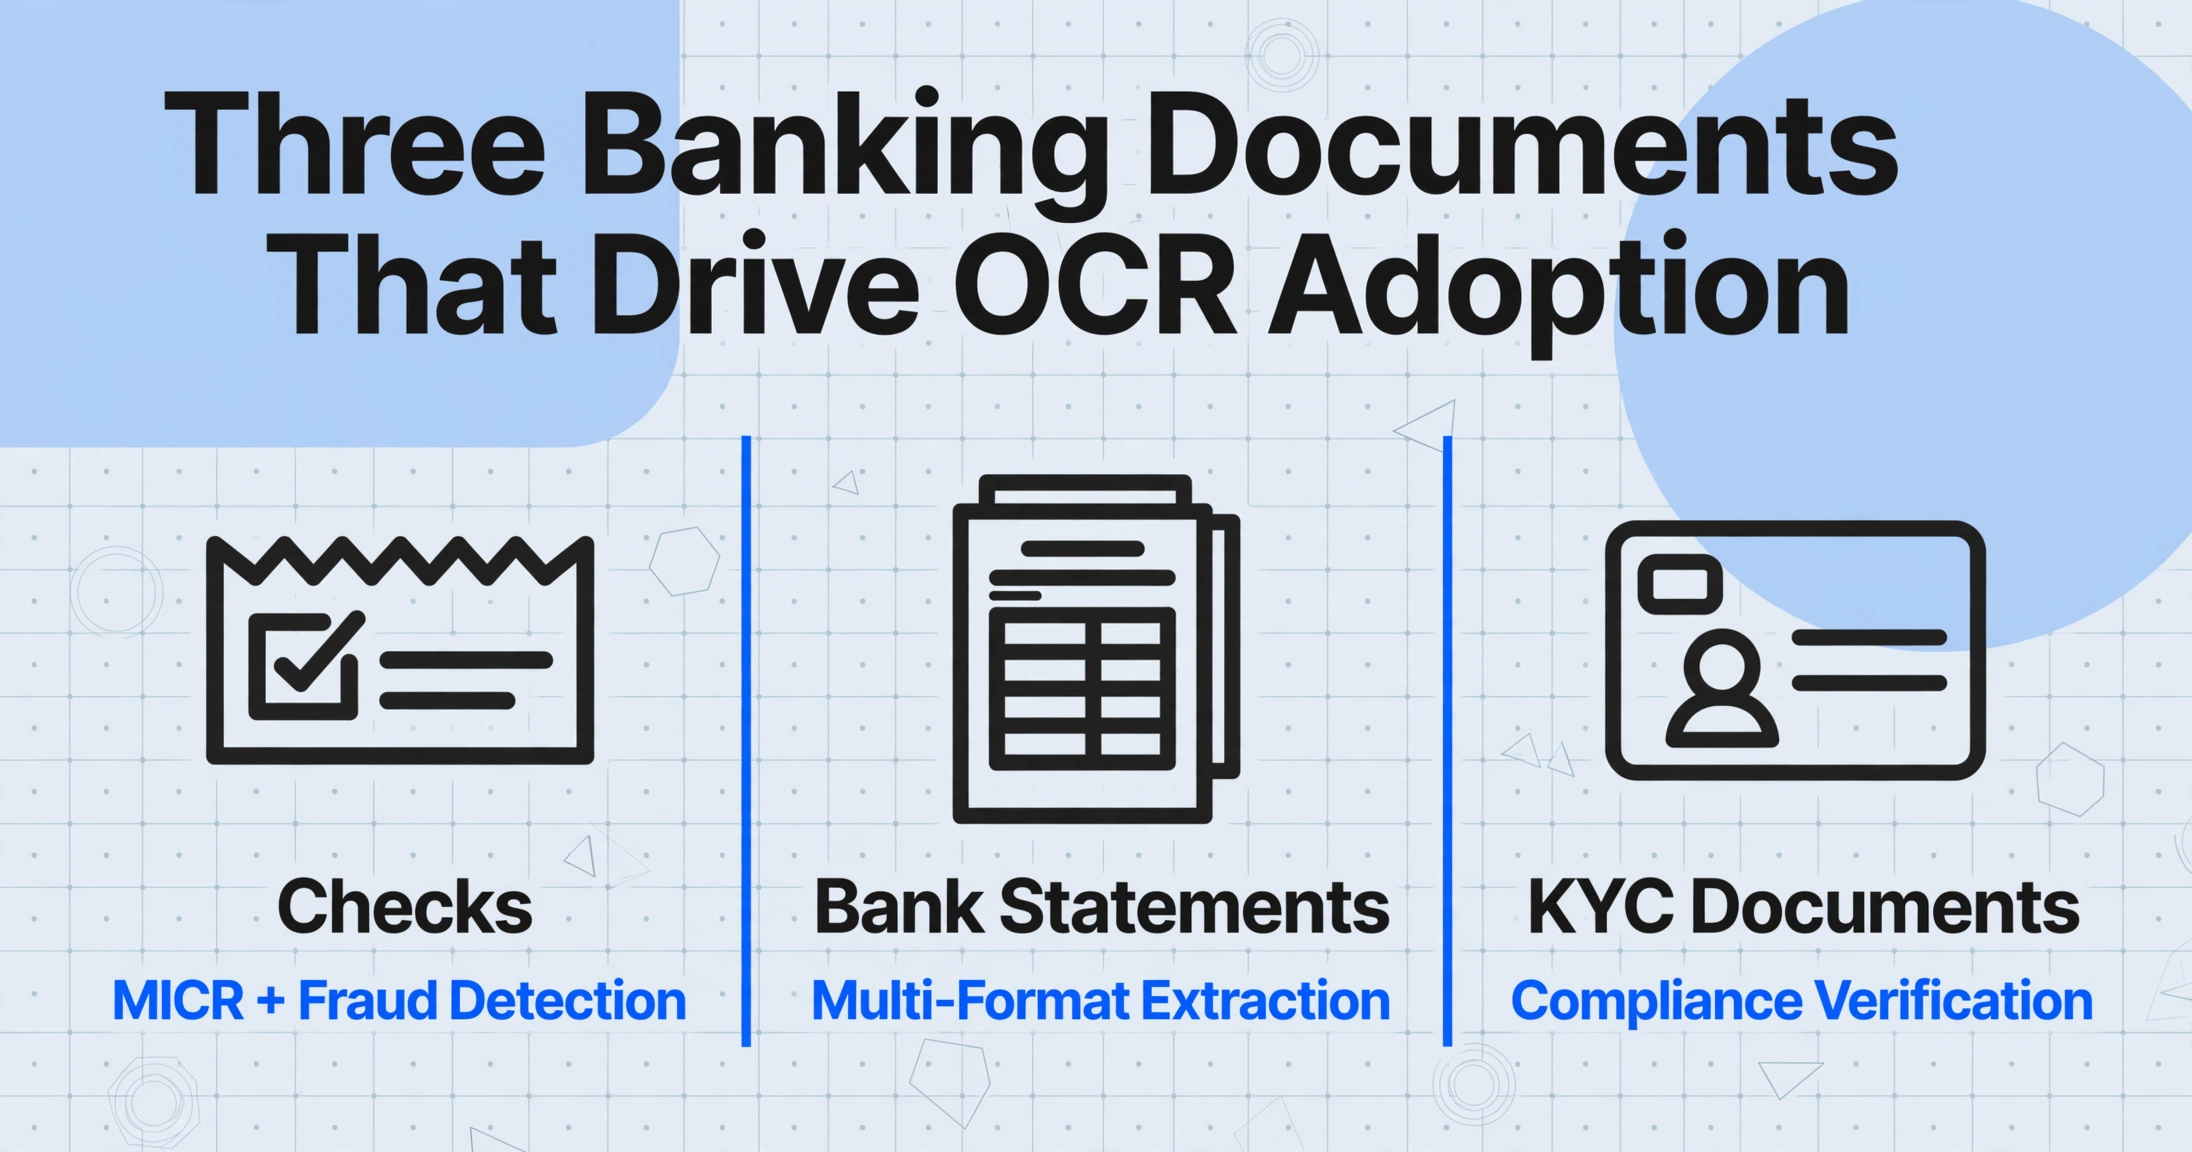
Cuando los profesionales bancarios hablan de OCR, generalmente se refieren a uno de tres flujos de trabajo distintos, cada uno con sus propios requisitos técnicos, modos de fallo y riesgos regulatorios:
Procesamiento de Cheques y Pagos
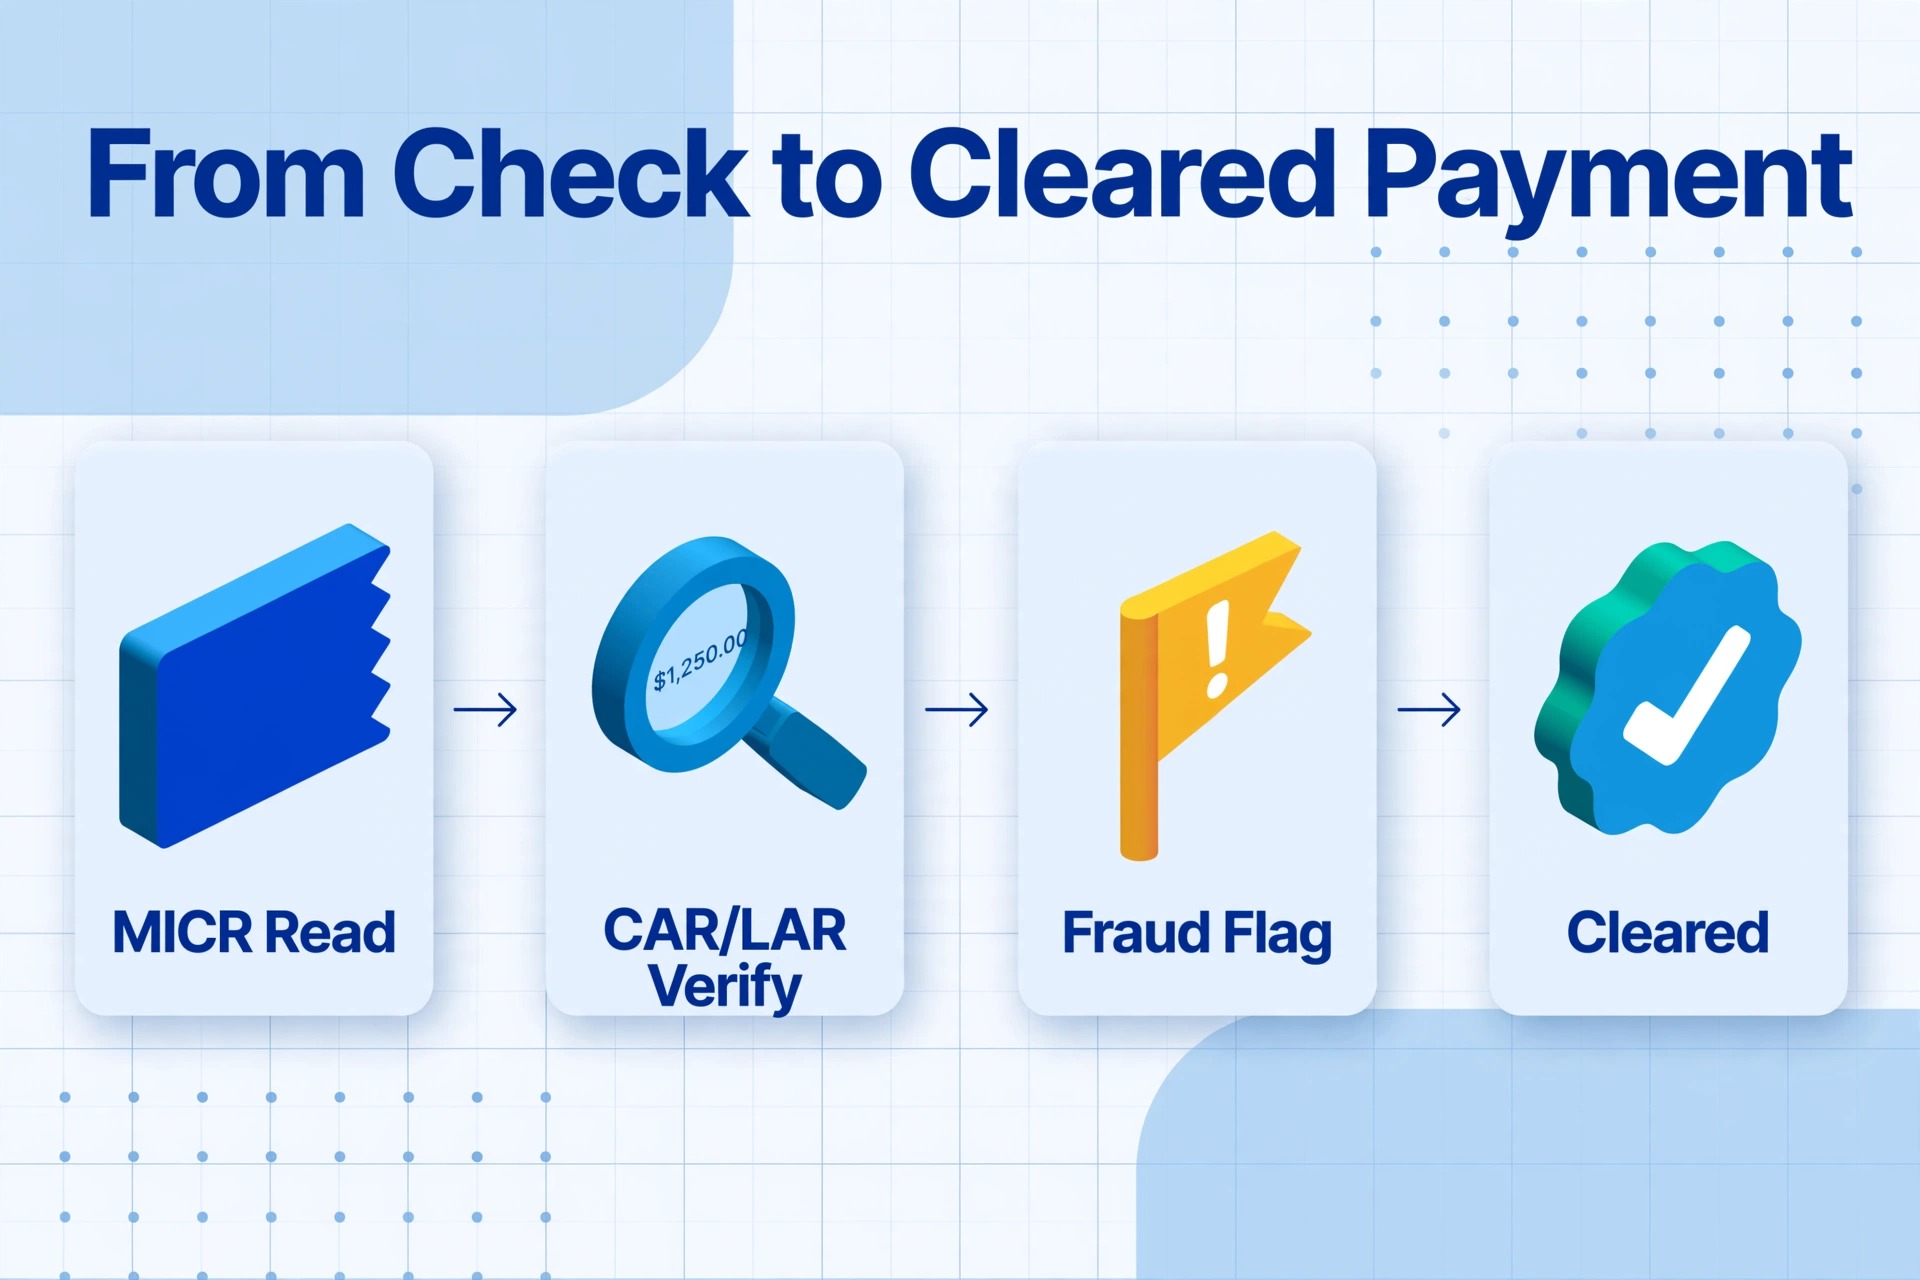
El reconocimiento de caracteres de tinta magnética (MICR) es la columna vertebral de la compensación de cheques. Los bancos procesan millones de cheques diariamente mediante clasificadoras de alta velocidad que leen la línea de fuente E-13B en la parte inferior de cada cheque. El desafío va más allá del MICR: la detección de fraude requiere leer las regiones del monto en cifras (CAR) y del monto en letras (LAR), verificar los patrones de endoso y detectar alteraciones. El 58% de las organizaciones reportó fraude con cheques en 2025, según la encuesta de AFP.
Extracción y Conciliación de Estados de Cuenta Bancarios
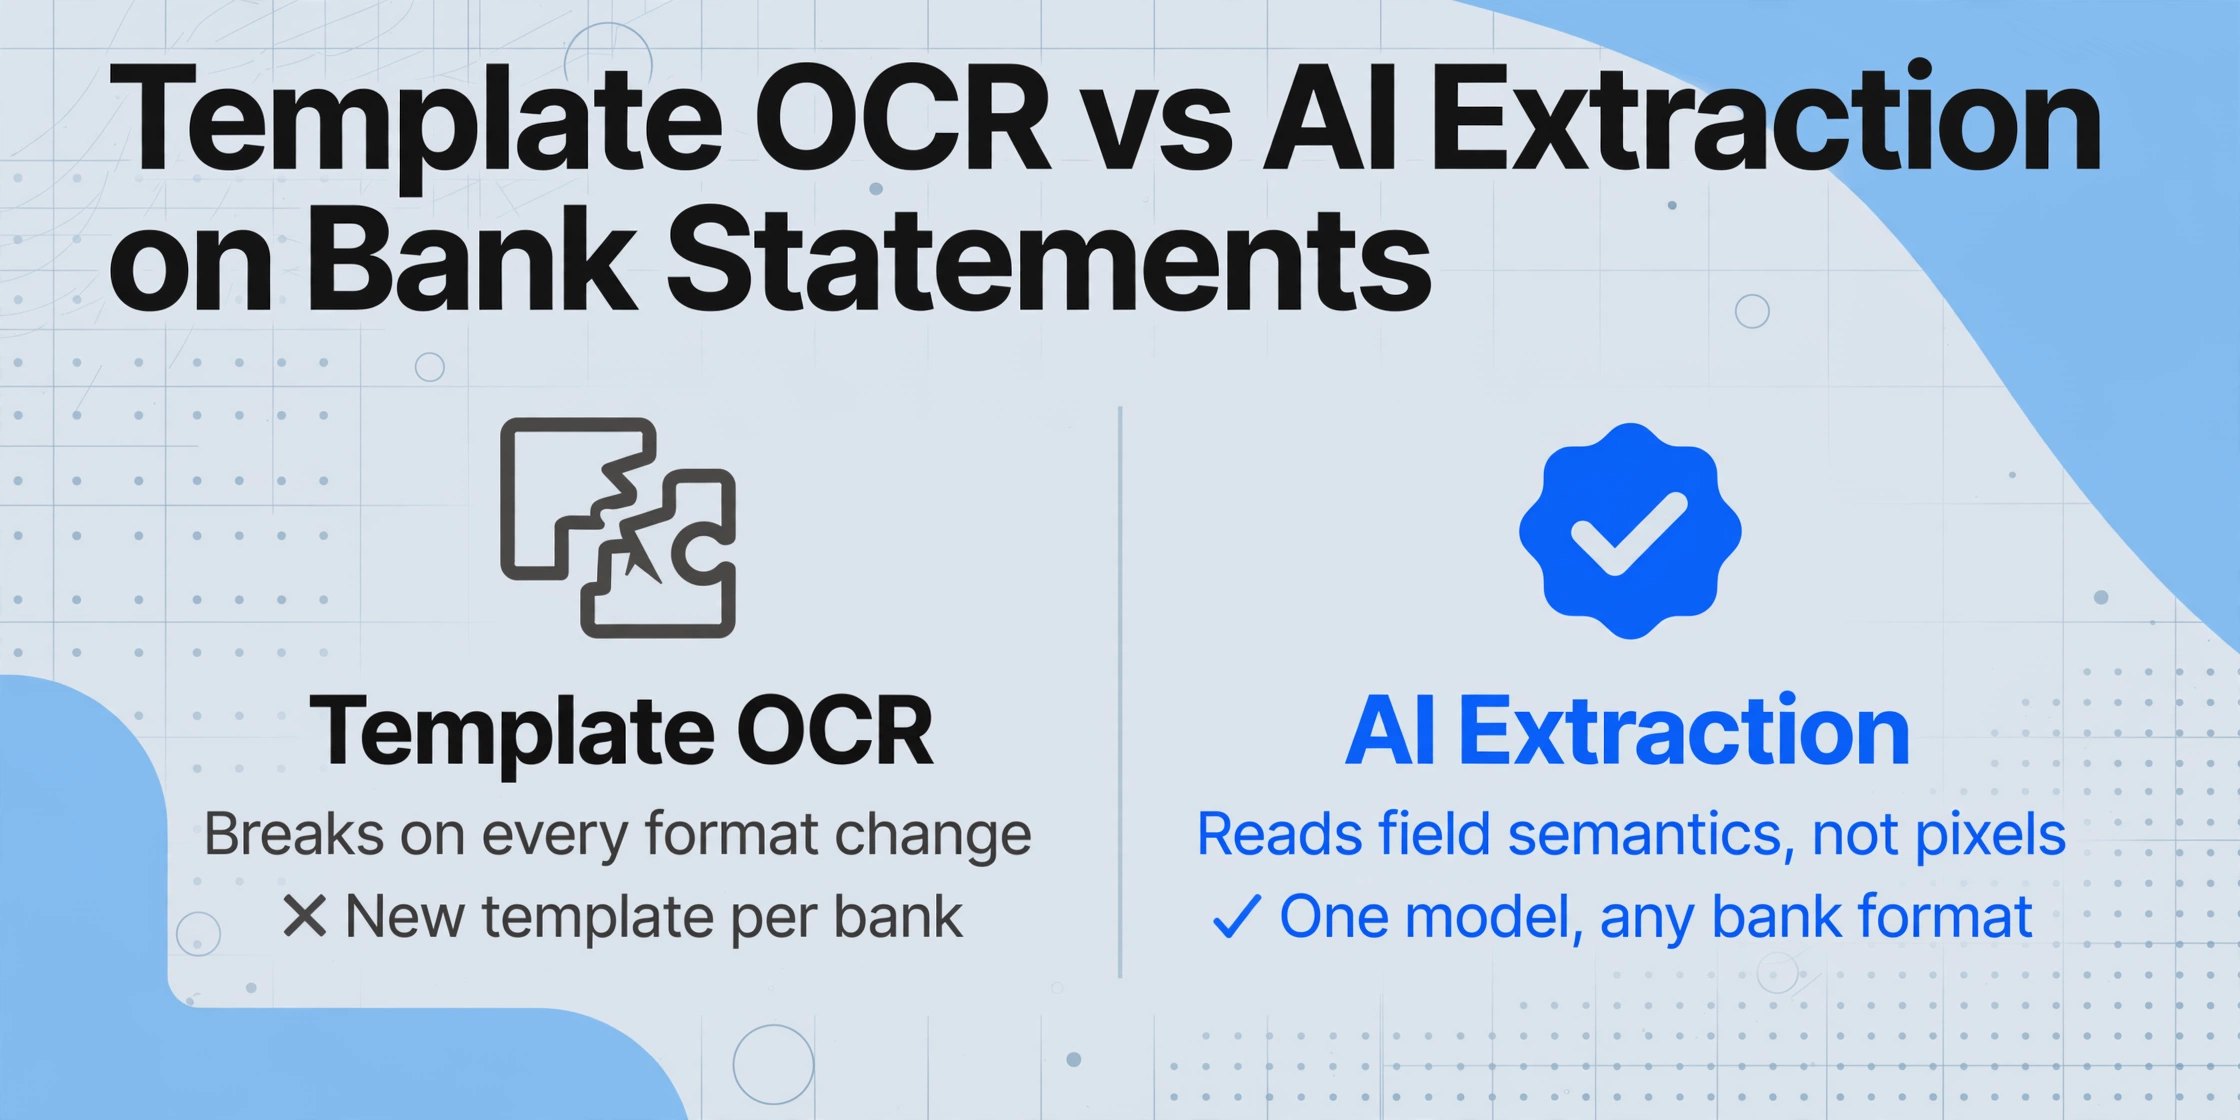
Cada banco formatea los estados de cuenta de manera diferente. Las tablas de transacciones pueden abarcar varias columnas — fecha, descripción, débito, crédito, saldo corriente — y estas columnas cambian de posición de página a página dentro del mismo estado de cuenta. El saldo corriente debe ser continuo a través de los saltos de página. El OCR basado en plantillas falla aquí. La extracción de estados de cuenta bancarios impulsada por IA maneja estas variaciones al comprender la semántica de los campos en lugar de las coordenadas de píxeles.
Verificación de Documentos KYC y de Préstamos
La incorporación de clientes exige la verificación de documentos de identidad (pasaportes, licencias de conducir), comprobantes de domicilio (facturas de servicios públicos, estados de cuenta bancarios) y evidencia financiera (recibos de nómina, declaraciones de impuestos, W-2). El cumplimiento de las regulaciones BSA/AML requiere extracción precisa y pistas de auditoría. El procesamiento manual de KYC toma 30–60 minutos por archivo; el eKYC automatizado con OCR e IA lo reduce a menos de 5 minutos para solicitudes estándar, según datos de implementación publicados por bancos asiáticos y europeos.
Estos tres flujos de trabajo comparten un hilo común: todos implican extraer datos estructurados de imágenes de documentos semiestructurados o no estructurados. Sin embargo, los enfoques técnicos que funcionan para uno con frecuencia fallan para los demás.
Procesamiento de Cheques: Donde el OCR se Encuentra con el MICR
El procesamiento de cheques ocupa una posición única en el panorama del OCR porque no depende únicamente del OCR. Los datos críticos en cada cheque (número de ruta, número de cuenta, número de cheque) están codificados en la línea MICR (Reconocimiento de Caracteres de Tinta Magnética), una fuente especializada impresa con tinta o tóner magnético que permanece legible incluso después de ser sellada, marcada o tachada.
El Estándar MICR: E-13B y CMC-7
La línea MICR en la parte inferior de cada cheque utiliza una de dos fuentes. En los Estados Unidos, Canadá, el Reino Unido, Australia y gran parte de la región de Asia-Pacífico, el estándar es E-13B, adoptado por la Asociación de Banqueros Estadounidenses en 1958 y posteriormente estandarizado como ANSI X9.27 e ISO 1004:1995. Los países europeos y algunos latinoamericanos utilizan CMC-7, una fuente diferente que codifica los mismos datos de ruta. Ambos son magnéticos: el clasificador de cheques de alta velocidad de un banco los lee detectando la señal magnética de los caracteres, no mediante reconocimiento óptico. Esto le da al MICR tasas de lectura casi perfectas incluso en cheques que han sido doblados, manchados o escritos.
La línea MICR codifica cuatro piezas de información:
- Número de ruta (9 dígitos en los EE. UU.) — identifica la institución financiera
- Número de cuenta — identifica la cuenta específica
- Número de cheque — identificador secuencial del cheque
- Monto — agregado después de que el cheque se presenta para el pago (codificación del monto de cortesía)
Mientras que el MICR maneja la línea de ruta, el resto del cheque (el nombre del beneficiario, el monto legal (escrito en palabras), el monto de cortesía (escrito en números), la fecha, la línea de memo y la firma) depende del OCR convencional y del análisis de imágenes. Aquí es donde la extracción moderna con IA agrega valor más allá de lo que el MICR solo proporciona.
Detección de Fraude en Cheques: La Capa de OCR
El fraude con cheques sigue siendo el problema de fraude documental más persistente en la banca. El Informe de Oficiales de Riesgo 2026 de la Reserva Federal, que encuestó a más de 400 profesionales de riesgo, encontró que el 63% de las instituciones financieras había experimentado intentos de fraude con cheques en el año anterior. Los vectores de ataque específicos están cambiando: el 32% de los encuestados reportó un aumento en cheques falsificados, el 21% reportó lavado de cheques (borrado de tinta para reescribir el beneficiario o el monto), y el 18% reportó falsificación del beneficiario.
Los sistemas de OCR con IA modernos detectan estos patrones mediante el análisis de imágenes de la superficie del cheque:
- Reconocimiento del Monto en Cifras (CAR) / Reconocimiento del Monto en Letras (LAR): El sistema lee tanto el monto numérico como el monto escrito y los verifica de forma cruzada para garantizar su consistencia. Una discrepancia marca el cheque para revisión manual.
- Verificación de firma: El análisis de imágenes compara la firma en el cheque con la firma de referencia archivada, detectando falsificaciones y firmantes no autorizados.
- Detección de alteraciones: El análisis de imágenes de la superficie del papel detecta evidencia de lavado de cheques — residuos químicos, fibras alteradas o sangrado de tinta que indican que el texto original fue borrado y reescrito.
- Análisis de endoso: El sistema revisa el reverso del cheque para verificar patrones de endoso válidos, asegurando que el cheque fue depositado por el beneficiario previsto o su agente autorizado.
Los bancos suelen superponer estas verificaciones de fraude basadas en OCR sobre la lectura magnética MICR, creando un proceso de validación multi-motor que detecta tanto errores de codificación como fraude deliberado. Herramientas como Check Image Analysis de Abrigo y TrueChecks de Advanced Fraud Solutions aplican estas técnicas combinadas en el punto de presentación.
La Ley Check 21 (Ley de Compensación de Cheques para el Siglo XXI, vigente desde 2004) hizo que el procesamiento electrónico de cheques — conocido como captura remota de depósitos o RDC — fuera legalmente equivalente al procesamiento físico de cheques. Esto significa que los bancos pueden procesar imágenes de cheques capturadas por dispositivos móviles o escáneres de sucursal, dependiendo completamente de la tecnología OCR y MICR sin manipular jamás el papel.
Extracción de Estados de Cuenta Bancarios: El Desafío de los Múltiples Formatos
La extracción de estados de cuenta bancarios es posiblemente el problema de OCR más difícil en el sector financiero, no porque los caracteres sean difíciles de leer, sino porque la estructura del documento es muy variable. Cada banco formatea sus estados de cuenta de manera diferente, y esas diferencias no son meramente cosméticas. Afectan la forma en que los sistemas de extracción deben procesar cada página.
Por Qué los Formatos de los Estados de Cuenta Dificultan la Automatización
Un estado de cuenta bancario no es una tabla simple. Es un documento de múltiples zonas que normalmente incluye:
- Un área de encabezado con el nombre del titular, número de cuenta, período del estado de cuenta, saldo inicial e identificador del banco
- Una tabla de transacciones con columnas de fecha, descripción, monto de débito, monto de crédito y saldo corriente
- Zonas de pie de página con saldo final, intereses devengados, comisiones cobradas y avisos en letra pequeña
- Notas laterales con ofertas promocionales, notificaciones de cuenta o mensajes de marketing
La tabla de transacciones en sí presenta el desafío de extracción. La disposición de las columnas — qué campo va dónde, cómo se nombran los encabezados de columna, si los débitos y créditos están en columnas separadas o en una sola columna con signo — varía según el diseño de cada banco. Y dentro de un mismo estado de cuenta de varias páginas, los límites de las columnas suelen desplazarse unos pocos píxeles de una página a otra porque el área de encabezado de la primera página (con el logotipo del banco y el resumen del estado de cuenta) ocupa más espacio que el encabezado mínimo de la segunda página.
Los sistemas de OCR basados en plantillas requieren una plantilla de diseño separada para el formato de cada banco, y una plantilla revisada cada vez que el banco actualiza el diseño de su estado de cuenta. Para una institución financiera que procesa estados de cuenta de docenas de bancos, el mantenimiento de plantillas se convierte en una carga operativa de tiempo completo.
Extracción consciente de páginas y continuidad del saldo corriente
El problema técnico más difícil en el OCR de estados de cuenta bancarios es mantener la continuidad de los datos entre páginas. Un solo estado de cuenta puede abarcar de 3 a más de 30 páginas. La tabla de transacciones se divide en los límites de página, cada página nueva comienza con un saldo "trasladado" y el saldo corriente en cualquier fila debe ser igual al saldo de la fila anterior más o menos el monto de la transacción.
Si el proceso de extracción procesa cada página de forma independiente — como hacen la mayoría de las herramientas básicas de OCR — se arriesga a tres modos de fallo:
- Filas omitidas: Las transacciones cerca del límite de página se pierden por completo porque la división cae en un espacio de la tabla
- Filas duplicadas: El saldo "trasladado" de la página N se trata como una transacción en la página N+1, y la primera transacción real de la página N+1 se desplaza una fila hacia abajo
- Continuidad del saldo rota: La secuencia del saldo corriente se interrumpe en el límite de página, lo que hace imposible la conciliación
Los sistemas modernos de extracción con IA de visión manejan esto manteniendo un estado consciente de la página — leen el documento completo como una secuencia conectada en lugar de páginas independientes. Cuando la IA procesa la línea de "trasladado", la reconoce como un artefacto de paginación en lugar de una transacción y mantiene la continuidad del saldo corriente a través del límite.
Conciliación integrada: lo que la extracción debe entregar
El objetivo final de la extracción de estados de cuenta bancarios no es solo una fila de transacciones — es un conjunto de datos conciliado que supera la verificación de saldo:
| Verificación de control | Lo que confirma | Por qué es importante |
|---|---|---|
| Coincidencia del saldo inicial | El saldo inicial extraído coincide con el saldo inicial declarado | Garantiza que no se haya omitido ninguna página al principio |
| Verificación de la suma de transacciones | La suma de débitos y créditos coincide con el cambio neto declarado | Detecta filas de transacciones faltantes o duplicadas |
| Cascada del saldo corriente | El saldo de cada fila = saldo anterior ± monto de la transacción | Valida cada fila individual en orden |
| Conciliación del saldo final | El saldo final extraído coincide con el saldo final declarado | Verificación de integridad de extremo a extremo para el documento completo |
Las herramientas que implementan esta verificación de conciliación — como aquellas con verificación automatizada de saldo integrada en el proceso de extracción — detectan errores antes de que los datos ingresen al sistema contable, reduciendo la carga de control de calidad manual para el equipo de conciliación.
Para instrucciones paso a paso sobre cómo configurar este proceso, consulte nuestra guía sobre OCR para contabilidad: extracción de estados de cuenta bancarios y financieros.
Si su enfoque es específicamente el trabajo de estado de cuenta a Excel en lugar de cheques o KYC, nuestro tutorial paso a paso sobre extracción de datos de estados de cuenta bancarios a Excel recorre el flujo de trabajo completo, y la herramienta de estado de cuenta bancario a Excel ejecuta la misma extracción automáticamente en su propio PDF.
Procesamiento de Documentos KYC y de Préstamos: Precisión Bajo Presión de Cumplimiento
El cumplimiento de Know Your Customer se sitúa en la intersección entre la precisión del OCR y el riesgo regulatorio. Leer mal un solo carácter en un documento de identidad — confundir una '0' con una 'O', o leer mal un número de pasaporte — puede resultar en incorporar a un cliente que no supera el filtro de sanciones OFAC, o en no detectar un fraude de identidad sintética. Lo que está en juego es fundamentalmente diferente al procesamiento de facturas.
La Mezcla de Documentos en la Incorporación KYC
Un paquete estándar de incorporación KYC incluye múltiples tipos de documentos, cada uno con diferentes desafíos de extracción:
- Documentos de identidad emitidos por el gobierno (pasaportes, licencias de conducir, tarjetas de identidad nacionales): La zona de lectura mecánica (MRZ) en la parte inferior está diseñada para OCR — utiliza la fuente estándar de la OACI, dígitos de verificación y longitudes de campo fijas. Pero la MRZ es solo parte del documento; extraer la foto del rostro, la firma y los campos de texto no-MRZ (dirección, fecha de nacimiento, autoridad emisora) requiere análisis de imagen de documento completo. Ese mismo enfoque de imagen completa maneja el caso más ligero que los equipos de operaciones enfrentan constantemente — una foto de tarjeta de identidad tomada con un teléfono, donde el nombre, la fecha de nacimiento, el número de identificación y la fecha de vencimiento deben ubicarse en columnas sin depender de una MRZ.
- Comprobante de domicilio (facturas de servicios, estados de cuenta bancarios, evaluaciones fiscales): Estos no son documentos optimizados para identidad. Vienen en cualquier formato, escaneados a cualquier calidad, y la dirección puede no estar en una posición fija. Los bancos deben extraer la dirección, el nombre y la fecha (para confirmar que es reciente — típicamente dentro de los 90 días) de estos documentos sin un formato estandarizado en el cual apoyarse.
- Evidencia financiera (recibos de nómina, formularios W-2, declaraciones de impuestos, estados de cuenta bancarios para suscripción): Los documentos de suscripción de préstamos requieren extracción a nivel de campo de ingresos, historial laboral e información de activos. Una solicitud de préstamo comercial puede incluir de 10 a 30 páginas en múltiples tipos de documentos — y los equipos de suscripción anteriormente dedicaban el 40% de su tiempo solo a organizar los documentos antes de extraer datos de ellos.
Por qué la precisión a nivel de caracteres no es suficiente para KYC
Los proveedores tradicionales de OCR citan la precisión a nivel de caracteres (CER, por sus siglas en inglés), que suele ser del 99% o superior en documentos impresos y limpios. Pero en los flujos de trabajo de KYC, la precisión a nivel de caracteres es una métrica engañosa. Un CER del 99% en una página de pasaporte con 500 caracteres significa que, en promedio, 5 caracteres son incorrectos. Si uno de ellos es un dígito del número de pasaporte o una letra del nombre del cliente, el documento falla en el filtrado AML o la cuenta se abre con datos de identidad incorrectos que tardan meses en corregirse.
La precisión a nivel de campo — si el número completo de pasaporte se extrae correctamente, no si la mayoría de los caracteres son correctos — es la métrica relevante para KYC. Los sistemas de extracción basados en IA que utilizan modelos de lenguaje de visión comprenden el contexto: saben que un número de pasaporte sigue un patrón específico, que existen dígitos de verificación para la validación y que un carácter mal leído puede marcarse para revisión humana en lugar de aceptarse silenciosamente.
Los datos de implementación publicados por la implementación de OCR de GreenNode en la banca vietnamita mostraron que el KYC automatizado con OCR e IA integrados redujo el tiempo de procesamiento de 45 minutos por archivo a menos de 5 minutos, con una tasa de procesamiento directo del 80–90% para solicitudes estándar. El 10–20% restante requirió revisión humana para casos límite: documentos de baja calidad, formatos no estándar o campos ambiguos.
Para los bancos que procesan grandes volúmenes de solicitudes de préstamos, el mismo pipeline de extracción que gestiona los documentos KYC también procesa recibos de nómina, declaraciones de impuestos y estados de cuenta bancarios para la suscripción — lo que convierte a una plataforma de extracción unificada que maneja todos estos tipos de documentos en una ventaja operativa significativa frente a herramientas separadas y especializadas para cada etapa del proceso.
OCR tradicional vs. IA de visión: por qué el enfoque sin plantilla importa en la banca
Los desafíos de procesamiento de documentos del sector bancario no se resuelven bien con el mismo enfoque de OCR que maneja facturas y recibos. Los documentos bancarios presentan un conjunto de problemas fundamentalmente más difícil. Comprender por qué requiere una distinción clara entre las dos generaciones de tecnología de extracción.
El límite de la OCR basada en plantillas: cada formato nuevo rompe su flujo de trabajo
La OCR tradicional — ya sea Tesseract, ABBYY o API de OCR en la nube — opera con un modelo basado en posiciones. El sistema extrae todo el texto de una página y luego utiliza reglas o mapas de plantilla para asignar campos según sus coordenadas. Esto funciona cuando el mismo formato de documento aparece repetidamente. Falla cuando:
- Procesa estados de cuenta de más de 50 bancos diferentes
- Un banco actualiza el diseño de sus estados de cuenta (lo cual ocurre con más frecuencia de lo que cabría esperar)
- Un cliente envía un estado de cuenta escaneado con una leve inclinación o con una página rotada
- Recibe fotos de estados de cuenta tomadas con el teléfono móvil en lugar de PDFs limpios
Cada cambio de formato requiere una actualización de plantilla. Cada banco nuevo requiere una plantilla nueva. La gestión de plantillas escala linealmente con la diversidad de documentos — y la banca es un entorno de diversidad documental extrema.
Cómo la extracción con IA de visión resuelve el problema del formato
La extracción con IA de visión — que utiliza modelos de visión de gran tamaño (VLM) — aborda el problema de manera diferente. En lugar de extraer todo el texto y luego intentar asignarlo a los campos esperados por posición, el VLM lee el documento como lo haría una persona: de forma holística, comprendiendo el diseño visual, el significado semántico de cada región de texto y las relaciones entre los campos.
Esta es la misma tecnología descrita en nuestra guía sobre qué es la OCR con IA y en qué se diferencia de la OCR tradicional — y es la clave para resolver el desafío de los múltiples formatos en la banca. En la práctica, esto significa:
- Usted define la salida, no la posición: En lugar de dibujar un recuadro alrededor de donde aparece la columna "Fecha de Transacción", simplemente le indica al sistema que desea Fecha de Transacción, Descripción, Monto del Débito, Monto del Crédito y Saldo Corriente. La IA encuentra estos campos en cualquier parte de la página al comprender qué significan.
- Una definición de columna funciona en todos los formatos: El mismo conjunto de nombres de columna extrae datos de un estado de cuenta de Chase, de Bank of America y de una cooperativa de crédito — aunque el orden de las columnas, los nombres de los campos y el diseño sean completamente diferentes en cada uno.
- Los cambios de formato no rompen su flujo de trabajo: Cuando un banco actualiza el diseño de sus estados de cuenta, la extracción continúa funcionando porque la IA lee el nuevo diseño por semántica, no comparando con una plantilla guardada.
Este cambio de paradigma — de la extracción basada en posiciones a la basada en semántica — es lo que permite a los equipos bancarios procesar documentos de docenas de fuentes sin crear y mantener una biblioteca cada vez mayor de plantillas por banco. Para una comparación más amplia de herramientas de extracción adecuadas para flujos de trabajo bancarios, consulte nuestra guía sobre el mejor software de OCR en 2026 por categorías y casos de uso.
Preguntas Frecuentes
¿El OCR funciona en cheques con montos y firmas manuscritas?
Sí, pero la precisión depende del método. La lectura MICR (línea de ruta bancaria) es magnética y logra tasas de lectura cercanas al 100% independientemente de la escritura a mano. El monto en cifras y el monto en letras se leen mediante OCR/análisis de imagen, con una precisión típica del 90–97% en cheques manuscritos. La firma se analiza para detectar falsificaciones mediante reconocimiento de patrones, no OCR de caracteres. Los sistemas modernos combinan las tres técnicas y señalan discrepancias para revisión humana.
¿El OCR de extractos bancarios funciona con bancos internacionales?
El OCR con IA puede procesar extractos de bancos de diferentes países porque lee la semántica de los campos, no posiciones fijas. Sin embargo, la precisión depende de la variedad de formatos con los que se haya entrenado el modelo. Los formatos de EE. UU., Reino Unido, Canadá, Australia y los principales bancos europeos están bien soportados. Bancos regionales más pequeños o de mercados menos digitalizados pueden mostrar menor precisión en el primer intento, aunque la IA se adapta más rápido que los sistemas basados en plantillas, que requieren creación manual para cada nuevo formato.
¿Qué precisión tiene la extracción de extractos bancarios con IA frente a la entrada manual?
Las tasas de precisión publicadas para la extracción con IA oscilan entre el 95% y el 99% en PDF digitales limpios, y entre el 90% y el 95% en extractos escaneados o fotografiados. En comparación, la entrada manual tiene una tasa de error típica del 3–5%, lo que equivale a 3–5 caracteres incorrectos por cada 100 pulsaciones. La diferencia es que los errores de la IA se concentran en campos ambiguos (números borrosos, descripciones complejas), mientras que los errores manuales son aleatorios. Un sistema robusto incluye conciliaciones automáticas que verifican la coherencia del saldo, detectando la mayoría de los errores significativos antes de que lleguen al sistema contable.
¿El OCR bancario cumple con las normativas KYC/AML?
El cumplimiento depende de cómo se implemente el sistema, no de la tecnología OCR en sí. Los datos extraídos deben almacenarse con una pista de auditoría verificable que muestre qué se extrajo, cuándo y mediante qué proceso. La mayoría de las plataformas modernas de extracción con IA admiten registro de auditoría, puntuaciones de confianza por campo (marcando extracciones de baja confianza para revisión) y manejo seguro de datos (cifrado TLS, certificación SOC 2). Según las regulaciones BSA/AML (12 CFR 21.11), los bancos deben mantener registros reproducibles y auditables: un sistema de extracción con IA con registro adecuado cumple este requisito de manera más efectiva que la entrada manual, que carece de una pista de auditoría incorporada.
¿Cómo maneja el KYC OCR escrituras no latinas como árabe, chino o cirílico?
Los modelos modernos de visión artificial están entrenados con datos multilingües y pueden leer la mayoría de los sistemas de escritura basados en caracteres y alfabetos. En los documentos KYC, la MRZ de los pasaportes usa la fuente OCR-B estándar de la OACI con solo caracteres latinos, por lo que la zona legible por máquina es universal. Los campos no MRZ (nombre, dirección en escritura local) requieren soporte OCR para el idioma específico. Los sistemas OCR basados en IA suelen admitir más de 30 idiomas y pueden procesar árabe, chino (simplificado y tradicional), cirílico, devanagari, hangul coreano y kanji japonés, entre otros. Verifique siempre que su proveedor de extracción admita las escrituras específicas que procesa.
¿Qué campos debo extraer de un extracto bancario para conciliación?
El conjunto estándar de campos para conciliación bancaria incluye: Número de Cuenta, Inicio/Fin del Período del Extracto, Saldo Inicial, Saldo Final, y por cada transacción — Fecha de Transacción, Descripción, Monto Débito, Monto Crédito y Saldo Corriente. Campos opcionales pero útiles: Número de Referencia/Cheque, Tipo de Transacción (cajero, transferencia, depósito, comisión) y Nombre del Beneficiario/Ordenante cuando esté disponible. La mayoría de las herramientas de extracción con IA permiten definir estos campos como nombres de columna, y el sistema los completa automáticamente desde cualquier formato de extracto.
¿Puede la misma herramienta OCR procesar cheques, extractos bancarios y documentos KYC?
Una plataforma unificada de extracción con IA —especialmente basada en modelos de lenguaje visual— puede manejar los tres tipos de documentos sin cambiar de herramienta. El procesamiento de cheques usa MICR para la línea de ruta y análisis de imagen para la superficie del cheque. Los extractos bancarios usan extracción con reconocimiento de tablas para las tablas de transacciones. Los documentos KYC usan lectura MRZ para identificaciones oficiales y extracción general de campos para comprobantes de domicilio y evidencia financiera. El requisito clave es que la herramienta admita Extracción de Columnas Personalizadas: usted define las columnas que desea y la IA localiza los datos correspondientes comprendiendo la semántica del campo, sin importar el tipo o formato del documento.