OCR para Bancos:
Processamento de Cheques, Extração de Extratos e Automação KYC
Três categorias de documentos bancários — cheques, extratos bancários e documentos KYC — são responsáveis pela maioria das horas de inserção manual de dados nas instituições financeiras. O Relatório de Oficiais de Risco de 2026 do Federal Reserve constatou que 63% das instituições financeiras relataram tentativas de fraude com cheques nos 12 meses anteriores. A Pesquisa de Fraude em Pagamentos de 2026 da AFP coloca o número em 58% das organizações relatando fraude com cheques, tornando-o o método de pagamento mais propenso a fraude. Enquanto isso, equipes de conciliação bancária passam dias por mês digitando manualmente linhas de transações de extratos que se recusam a se alinhar de forma limpa em uma planilha, e oficiais de conformidade processam documentos KYC com tempos de ciclo que variam de 30 a 60 minutos por arquivo.
Principais Conclusões
- Os bancos investem em OCR em três pipelines separados — processamento de cheques, extração de extratos e verificação KYC — e todos os três dependem de uma suposição que nunca se confirma: os layouts dos documentos permanecem os mesmos.
- Um OCR com precisão de 99% no nível de caractere ainda erra cinco caracteres por página KYC — e um dígito errado em um número de passaporte significa uma falha de conformidade que nenhum trilho de auditoria pode explicar.
- A Vision AI extrai documentos bancários pelo significado do campo, e não por coordenadas de pixels — uma definição de coluna funciona em todos os formatos de banco, seja quando o Chase redesenha seu extrato ou quando um cliente gira o celular.
O setor bancário funciona com base em documentos. Mas, ao contrário das faturas — que ao menos compartilham uma estrutura familiar aproximada entre a maioria dos fornecedores — os documentos bancários resistem a qualquer tentativa de padronização. Um cheque depende de uma fonte de tinta magnética inventada na década de 1950. Um extrato bancário do Chase e um de uma cooperativa de crédito regional não compartilham praticamente nenhuma convenção de layout. Um passaporte usado para KYC segue os padrões da ICAO, enquanto uma carteira de motorista segue regras estaduais que mudam a cada poucos anos.
Este artigo aborda os três tipos de documento que impulsionam a adoção de OCR no setor bancário, explica os desafios técnicos específicos de cada um e mostra onde o OCR tradicional fica aquém — e onde a IA de visão entra em ação.
Os Três Documentos Bancários Que Impulsionam a Adoção de OCR
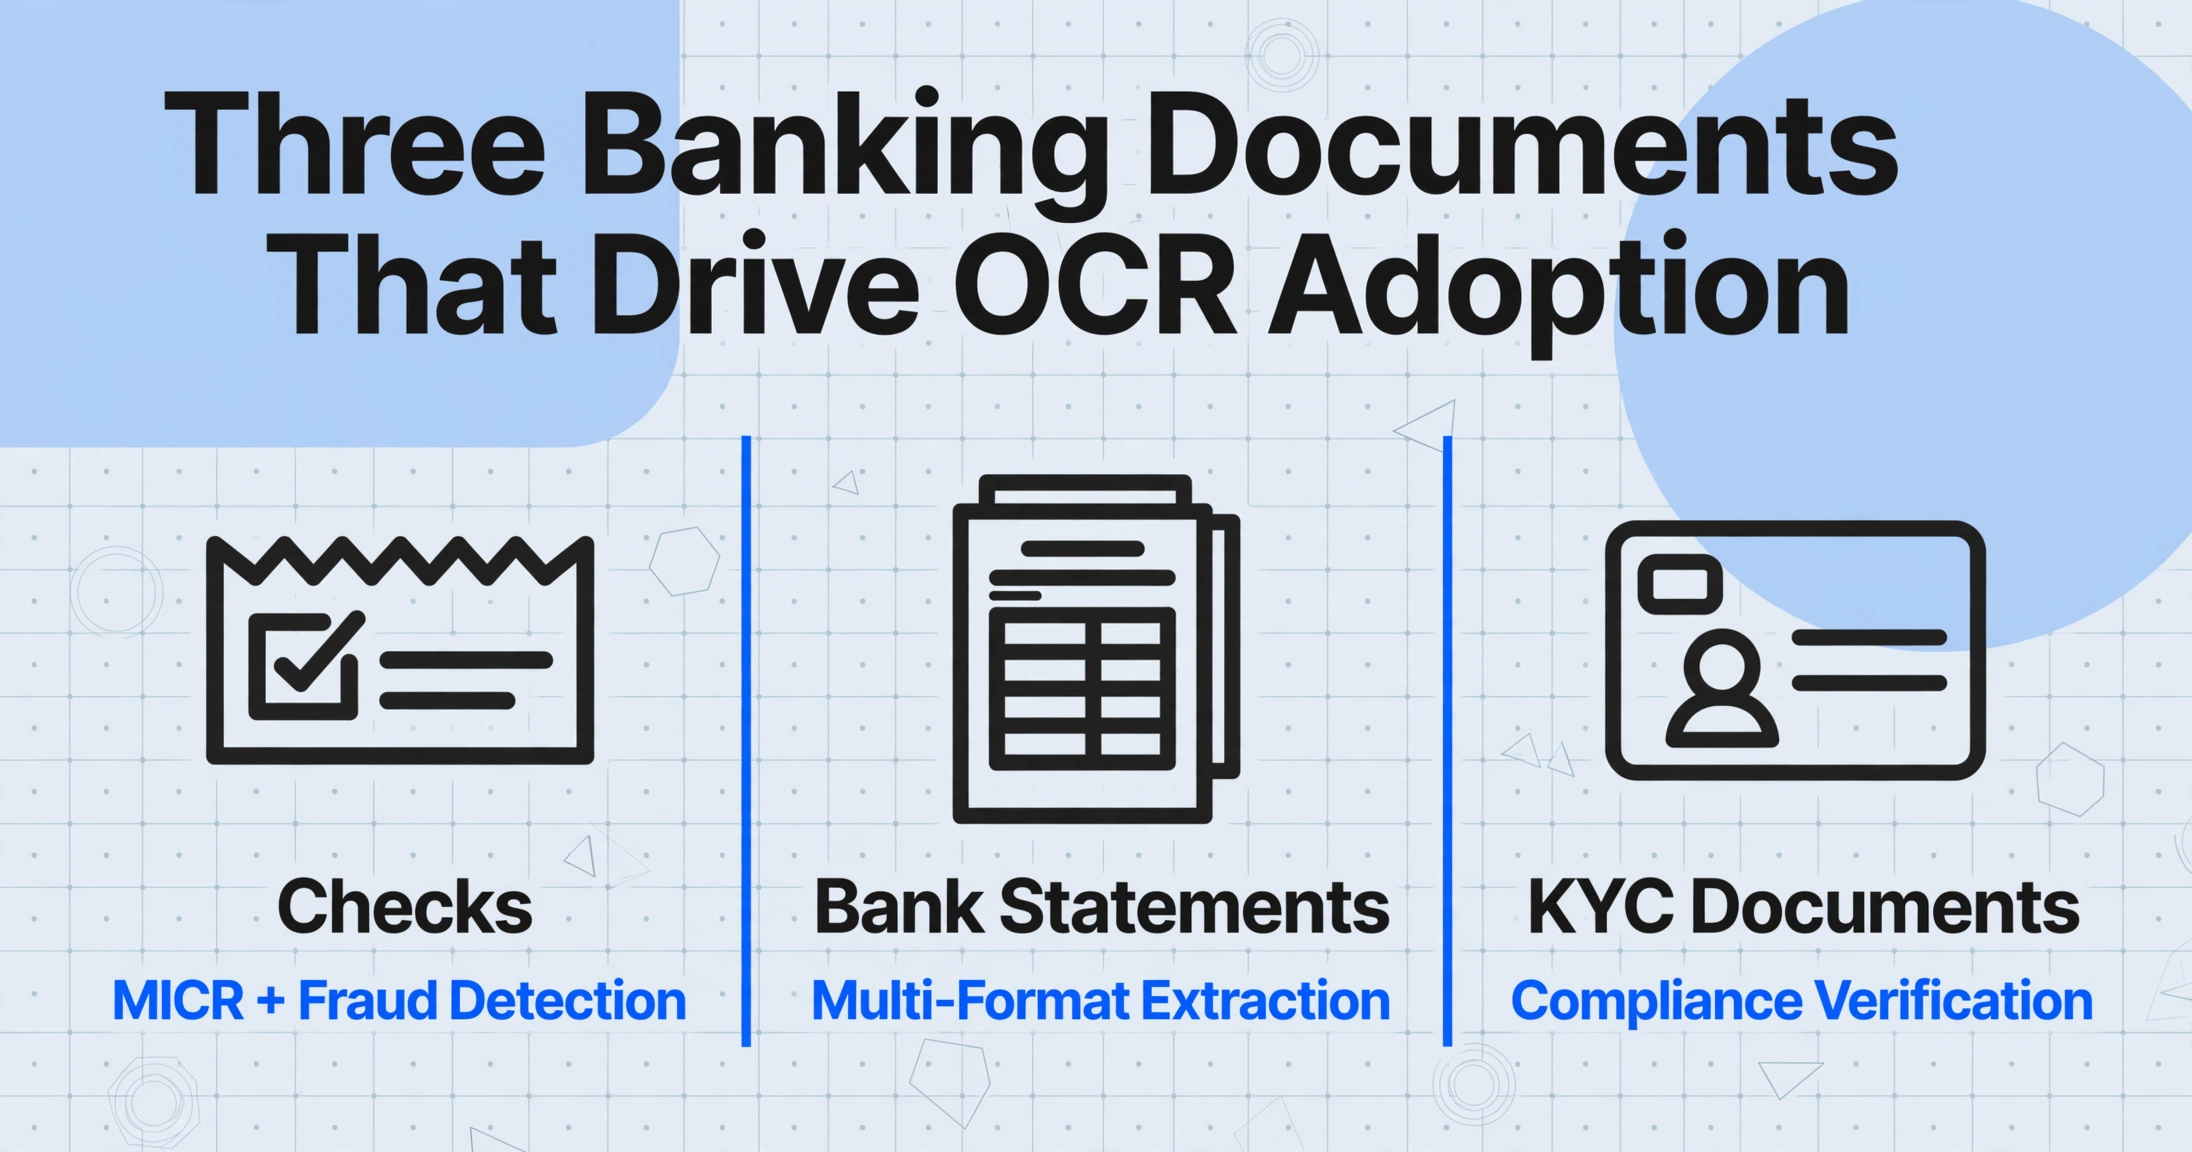
Quando profissionais do setor bancário falam sobre OCR, geralmente se referem a um de três fluxos de trabalho distintos, cada um com seus próprios requisitos técnicos, modos de falha e riscos regulatórios:
Processamento de Cheques e Pagamentos
O reconhecimento de caracteres de tinta magnética (MICR) é a espinha dorsal da compensação de cheques. Os bancos processam milhões de cheques diariamente por meio de classificadoras de alta velocidade que leem a linha de fonte E-13B na parte inferior de cada cheque. O desafio vai além do MICR: a detecção de fraudes exige a leitura das regiões de valor por extenso (LAR) e valor numérico (CAR), a verificação de padrões de endosso e a detecção de alterações. 58% das organizações relataram fraude com cheques em 2025, segundo a pesquisa da AFP.
Extração e Conciliação de Extratos Bancários
Cada banco formata extratos de maneira diferente. As tabelas de transações podem abranger várias colunas — data, descrição, débito, crédito, saldo acumulado — e essas colunas mudam de posição de página para página dentro do mesmo extrato. O saldo acumulado deve ser contínuo entre quebras de página. O OCR baseado em modelo falha aqui. A extração de extratos bancários com IA lida com essas variações compreendendo a semântica dos campos, em vez de coordenadas de pixels.
Verificação de Documentos KYC e de Empréstimos
A integração de clientes exige a verificação de documentos de identidade (passaportes, carteiras de motorista), comprovante de residência (contas de serviços públicos, extratos bancários) e evidências financeiras (holerites, declarações de imposto de renda, W-2s). A conformidade com as regulamentações BSA/AML exige extração precisa e trilhas de auditoria. O processamento manual de KYC leva de 30 a 60 minutos por arquivo; o eKYC automatizado com OCR e IA reduz isso para menos de 5 minutos em aplicações padrão, com base em dados de implantação publicados por bancos asiáticos e europeus.
Esses três fluxos de trabalho compartilham um ponto em comum: todos envolvem a extração de dados estruturados de imagens de documentos semiestruturados ou não estruturados. Mas as abordagens técnicas que funcionam para um frequentemente falham para os outros.
Processamento de Cheques: Onde o OCR Encontra o MICR
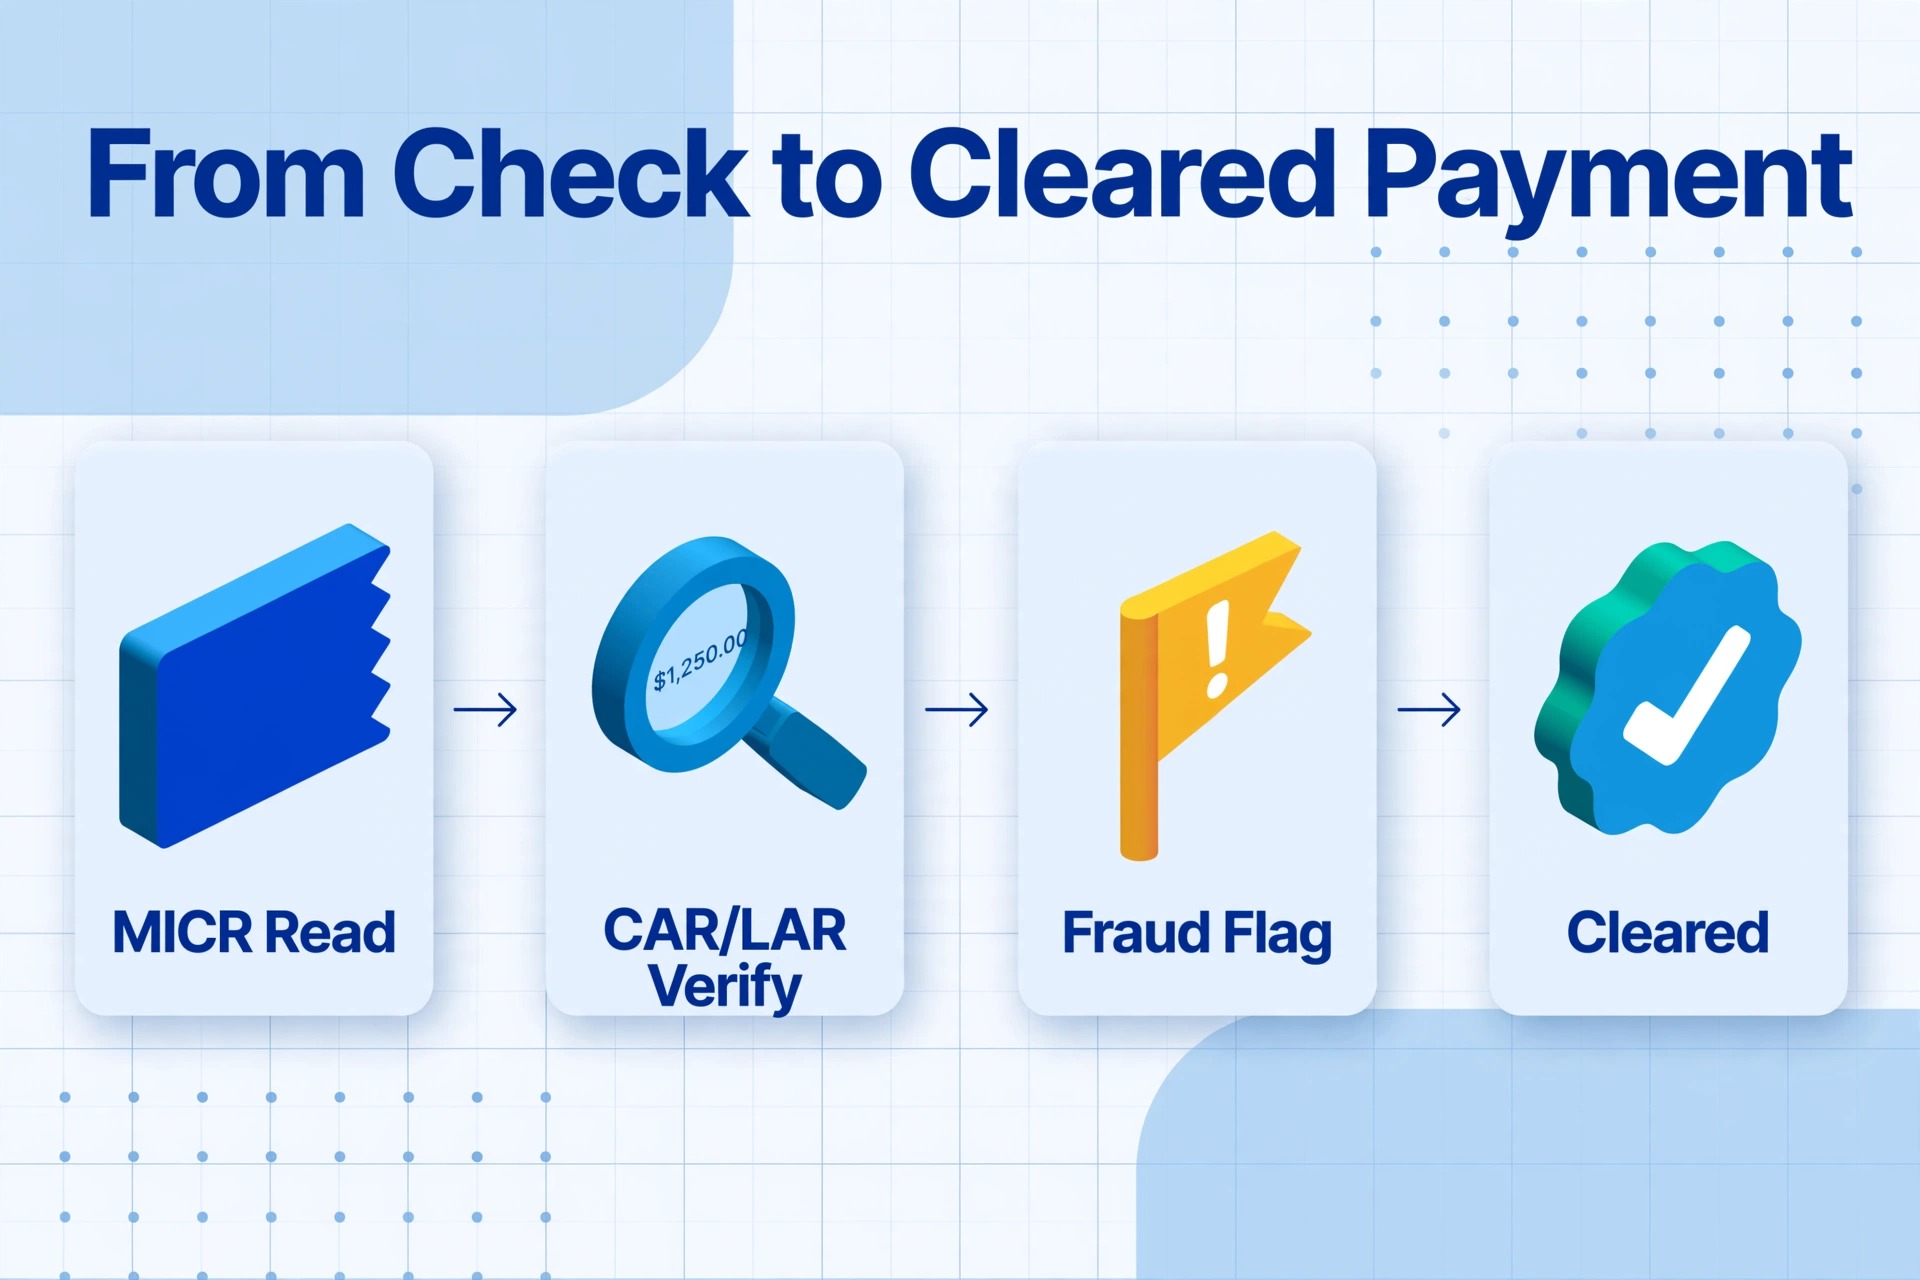
O processamento de cheques ocupa uma posição única no cenário de OCR porque não depende apenas de OCR. Os dados críticos em cada cheque — número de roteamento, número da conta, número do cheque — estão codificados na linha MICR (Reconhecimento de Caracteres com Tinta Magnética), uma fonte especializada impressa com tinta ou toner magnético que permanece legível mesmo após ser carimbada, marcada ou riscada.
O Padrão MICR: E-13B e CMC-7
A linha MICR na parte inferior de cada cheque usa uma de duas fontes. Nos Estados Unidos, Canadá, Reino Unido, Austrália e grande parte da região Ásia-Pacífico, o padrão é E-13B, adotado pela American Bankers Association em 1958 e posteriormente padronizado como ANSI X9.27 e ISO 1004:1995. Países europeus e alguns latino-americanos usam CMC-7, uma fonte diferente que codifica os mesmos dados de roteamento. Ambas são magnéticas — o classificador de cheques de alta velocidade de um banco as lê detectando o sinal magnético dos caracteres, não por reconhecimento óptico. Isso dá ao MICR taxas de leitura quase perfeitas mesmo em cheques que foram dobrados, manchados ou escritos por cima.
A linha MICR codifica quatro informações:
- Número de roteamento (9 dígitos nos EUA) — identifica a instituição financeira
- Número da conta — identifica a conta específica
- Número do cheque — identificador sequencial do cheque
- Valor — adicionado após o cheque ser apresentado para pagamento (codificação do valor por extenso)
Enquanto o MICR lida com a linha de roteamento, o restante do cheque — o nome do beneficiário, o valor por extenso (escrito em palavras), o valor numérico (escrito em algarismos), a data, a linha de memo e a assinatura — depende de OCR convencional e análise de imagem. É aqui que a extração moderna com IA agrega valor além do que o MICR oferece sozinho.
Detecção de Fraude em Cheques: A Camada de OCR
A fraude em cheques continua sendo o problema mais persistente de fraude documental no setor bancário. O Relatório de Oficiais de Risco de 2026 do Federal Reserve, que pesquisou mais de 400 profissionais de risco, constatou que 63% das instituições financeiras haviam sofrido tentativas de fraude com cheques no ano anterior. Os vetores de ataque específicos estão mudando: 32% dos entrevistados relataram aumento em cheques falsificados, 21% relataram lavagem de cheques (apagar a tinta para reescrever o beneficiário ou o valor) e 18% relataram falsificação de beneficiário.
Os sistemas de OCR com IA modernos detectam esses padrões por meio da análise de imagem da superfície do cheque:
- Reconhecimento do Valor por Extenso (CAR) / Reconhecimento do Valor Numérico (LAR): O sistema lê tanto o valor numérico quanto o valor por extenso e os cruza para verificar a consistência. Uma divergência sinaliza o cheque para revisão manual.
- Verificação de assinatura: A análise de imagem compara a assinatura no cheque com a assinatura de referência arquivada, detectando falsificações e signatários não autorizados.
- Detecção de alterações: A análise de imagem da superfície do papel detecta evidências de lavagem de cheque — resíduos químicos, fibras perturbadas ou sangramento de tinta que indicam que o texto original foi apagado e reescrito.
- Análise de endosso: O sistema verifica o verso do cheque em busca de padrões de endosso válidos, garantindo que o cheque foi depositado pelo beneficiário pretendido ou por seu agente autorizado.
Os bancos normalmente sobrepõem essas verificações de fraude baseadas em OCR à leitura magnética MICR, criando um pipeline de validação com múltiplos mecanismos que detecta tanto erros de codificação quanto fraudes deliberadas. Ferramentas como o Check Image Analysis da Abrigo e o TrueChecks da Advanced Fraud Solutions aplicam essas técnicas combinadas no ponto de apresentação.
O Check 21 (Lei de Compensação de Cheques para o Século XXI, em vigor desde 2004) tornou o processamento eletrônico de cheques — conhecido como captura remota de depósito ou RDC — legalmente equivalente ao processamento físico de cheques. Isso significa que os bancos podem processar imagens de cheques capturadas por dispositivos móveis ou scanners de agências, contando inteiramente com a tecnologia de OCR e MICR sem nunca manusear o papel.
Extração de Extratos Bancários: O Desafio dos Múltiplos Formatos
A extração de extratos bancários é, sem dúvida, o problema de OCR mais difícil na área financeira — não porque os caracteres sejam difíceis de ler, mas porque a estrutura do documento é muito variável. Cada banco formata seus extratos de maneira diferente, e essas diferenças não são meramente cosméticas. Elas afetam como os sistemas de extração devem processar cada página.
Por que os Formatos de Extratos Bancários Dificultam a Automação
Um extrato bancário não é uma tabela simples. É um documento com múltiplas zonas que normalmente inclui:
- Uma área de cabeçalho com nome do titular da conta, número da conta, período do extrato, saldo inicial e identificador do banco
- Uma tabela de transações com colunas de data, descrição, valor de débito, valor de crédito e saldo atualizado
- Zonas de rodapé com saldo final, juros auferidos, tarifas cobradas e avisos legais em letras pequenas
- Chamadas laterais com ofertas promocionais, notificações da conta ou mensagens de marketing
A própria tabela de transações apresenta o desafio da extração. O layout das colunas — qual campo vai em qual posição, como os cabeçalhos das colunas são nomeados, se débitos e créditos ficam em colunas separadas ou em uma única coluna com sinal — varia conforme o design do extrato de cada banco. E, dentro de um único extrato de várias páginas, os limites das colunas frequentemente se deslocam alguns pixels de uma página para outra, porque a área de cabeçalho na primeira página (com o logotipo do banco e o resumo do extrato) ocupa mais espaço do que o cabeçalho mínimo na segunda página.
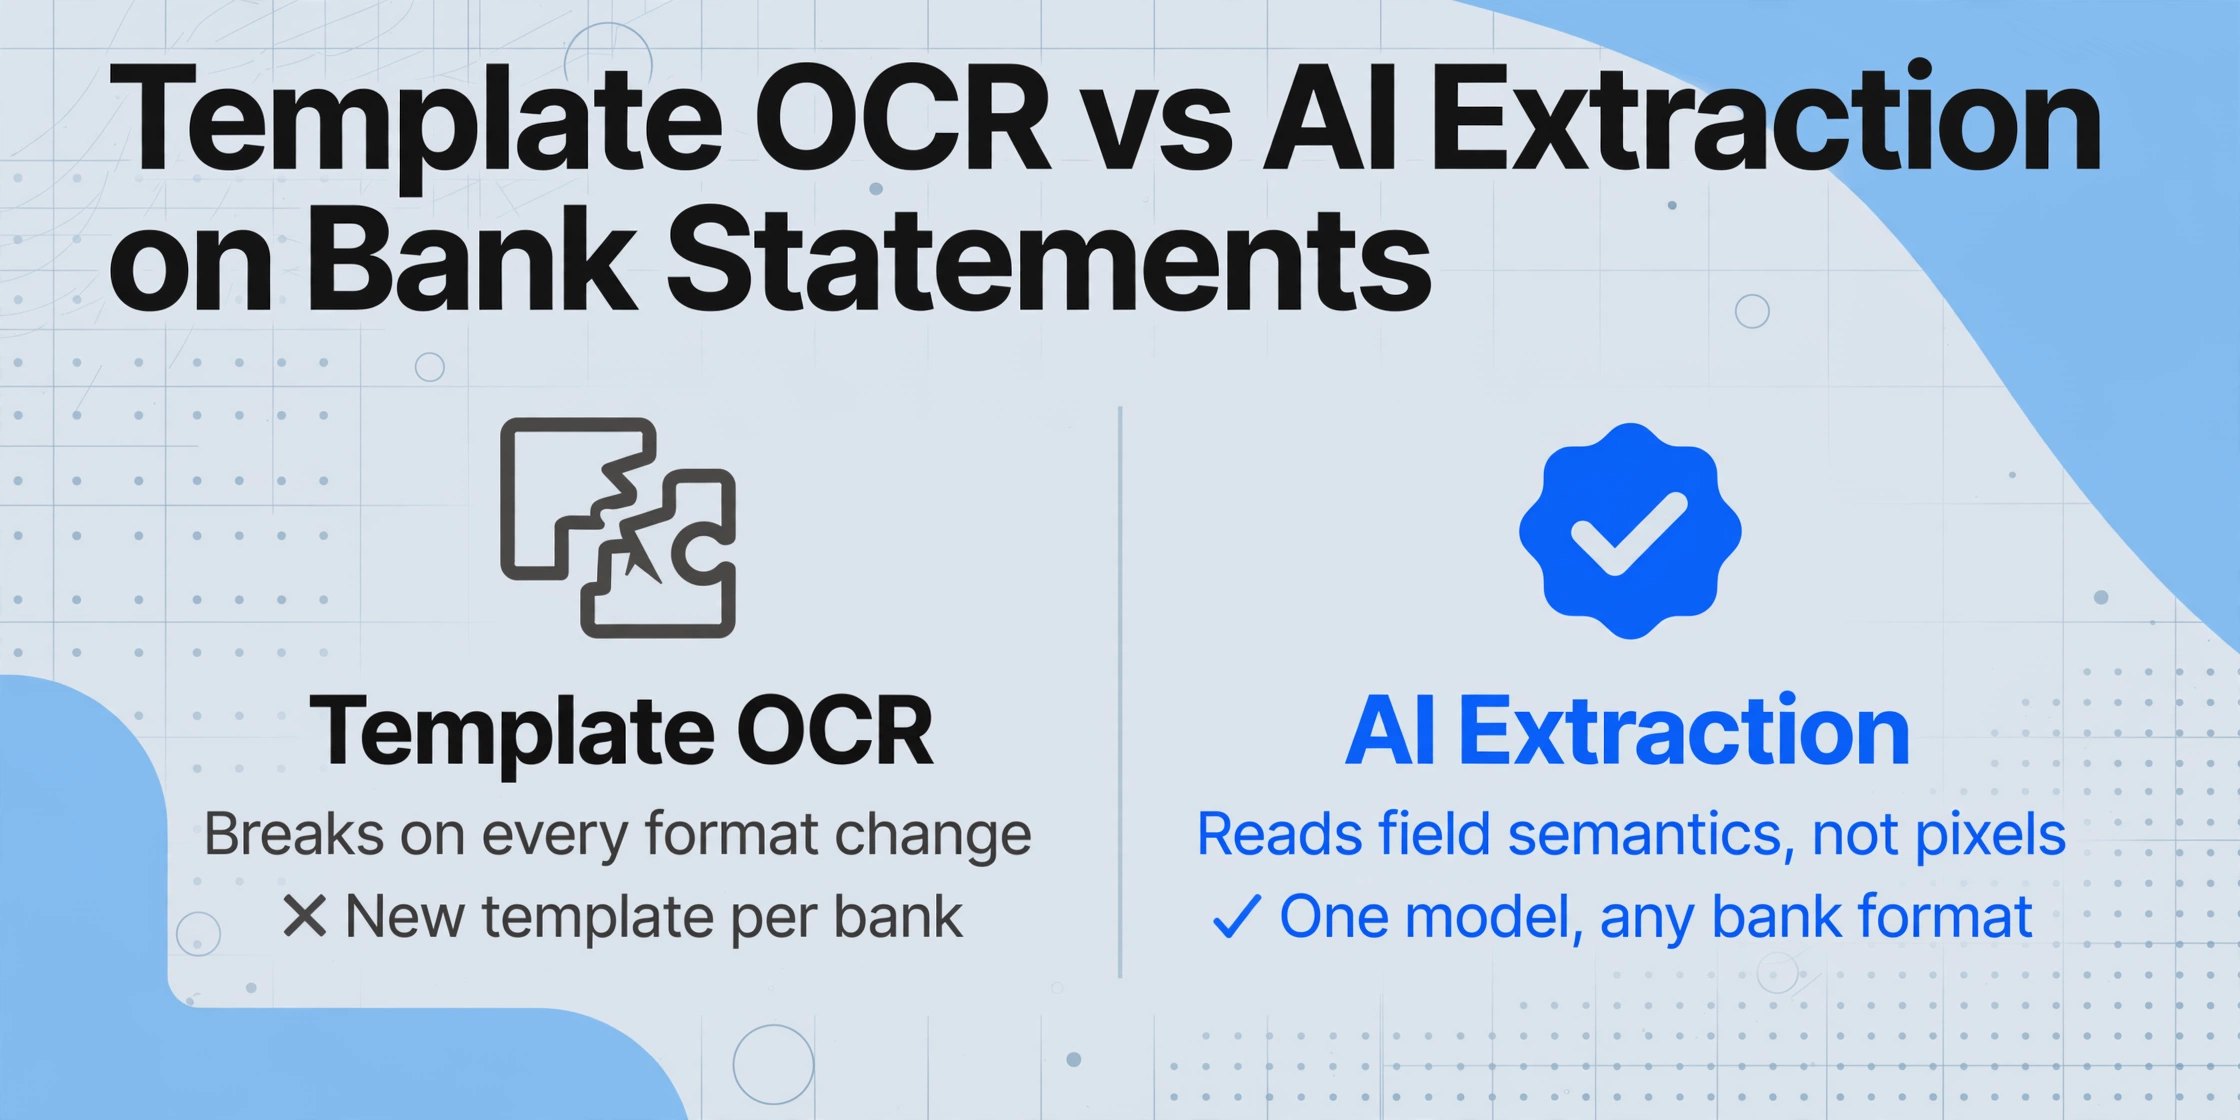
Os sistemas de OCR baseados em modelo exigem um modelo de layout separado para o formato de cada banco — e um modelo revisado sempre que o banco atualiza o design do seu extrato. Para uma instituição financeira que processa extratos de dezenas de bancos, a manutenção de modelos torna-se um fardo operacional em tempo integral.
Extração com Consciência de Página e Continuidade do Saldo Acumulado
O problema técnico mais difícil no OCR de extratos bancários é manter a continuidade dos dados entre páginas. Um único extrato pode ter de 3 a mais de 30 páginas. A tabela de transações se divide nos limites das páginas, cada nova página começa com um saldo "transportado", e o saldo acumulado em qualquer linha deve ser igual ao saldo da linha anterior mais ou menos o valor da transação.
Se o pipeline de extração processar cada página de forma independente — como fazem a maioria das ferramentas básicas de OCR — ele corre o risco de três modos de falha:
- Linhas perdidas: Transações próximas ao limite da página são completamente ignoradas porque a divisão cai em uma lacuna na tabela
- Linhas duplicadas: O saldo "transportado" da página N é tratado como uma transação na página N+1, e a primeira transação real da página N+1 desloca uma linha para baixo
- Continuidade do saldo quebrada: A sequência do saldo acumulado é interrompida no limite da página, tornando a conciliação impossível
Sistemas modernos de extração com IA de visão lidam com isso mantendo estado com consciência de página — eles leem o documento completo como uma sequência conectada, em vez de páginas independentes. Quando a IA processa a linha "transportado", ela a reconhece como um artefato de paginação, não como uma transação, e mantém a continuidade do saldo acumulado através do limite.
Conciliação Integrada: O Que a Extração Deve Entregar
O objetivo final da extração de extratos bancários não é apenas uma lista de transações — é um conjunto de dados conciliado que passa na verificação de saldo:
| Verificação | O Que Confirma | Por Que Importa |
|---|---|---|
| Conferência do saldo inicial | O saldo inicial extraído corresponde ao saldo inicial declarado | Garante que nenhuma página foi pulada no início |
| Verificação da soma das transações | A soma de débitos e créditos corresponde à variação líquida declarada | Detecta linhas de transação ausentes ou duplicadas |
| Cascata do saldo acumulado | O saldo de cada linha = saldo anterior ± valor da transação | Valida cada linha individualmente em ordem |
| Conferência do saldo final | O saldo final extraído corresponde ao saldo final declarado | Verificação de integridade de ponta a ponta do documento completo |
Ferramentas que implementam essa verificação de conciliação — como aquelas com verificação automatizada de saldo integrada ao pipeline de extração — detectam erros antes que os dados entrem no sistema contábil, reduzindo a carga de QA manual na equipe de conciliação.
Para instruções passo a passo sobre como configurar esse pipeline, consulte nosso guia sobre OCR para contabilidade: extração de extratos bancários e financeiros.
Se seu foco for especificamente o trabalho de extrato para Excel, em vez de cheques ou KYC, nosso tutorial passo a passo sobre extração de dados de extratos bancários para Excel percorre o fluxo de trabalho completo, e a ferramenta de extrato bancário para Excel executa a mesma extração automaticamente no seu próprio PDF.
Processamento de Documentos KYC e de Empréstimos: Precisão sob Pressão de Conformidade
A conformidade Know Your Customer fica na interseção entre precisão de OCR e risco regulatório. Ler incorretamente um único caractere em um documento de identidade — confundir um '0' com um 'O', ou ler incorretamente um número de passaporte — pode resultar em incorporar um cliente que falha na triagem de sanções OFAC, ou não detectar uma fraude de identidade sintética. Os riscos são fundamentalmente diferentes dos do processamento de faturas.
A Mistura de Documentos na Incorporação KYC
Um pacote padrão de incorporação KYC incluye vários tipos de documentos, cada um com desafios de extração diferentes:
- IDs com foto emitidos pelo governo (passaportes, licencias de conducir, tarjetas de identidad nacionales): La zona de lectura mecánica (MRZ) en la parte inferior está diseñada para OCR — usa la fuente estándar de ICAO, dígitos de verificación y longitudes de campo fijas. Pero la MRZ es solo parte del documento; extraer la foto del rostro, la firma y los campos de texto no MRZ (dirección, fecha de nacimiento, autoridad emisora) requiere análisis de imagen de documento completo. Ese mismo enfoque de imagen completa maneja el caso más liviano que los equipos posteriores enfrentan constantemente — una foto de tarjeta de identidad tomada con un teléfono, donde el nombre, la fecha de nacimiento, el número de ID y la fecha de vencimiento deben ubicarse en columnas sin ninguna MRZ en la que apoyarse.
- Comprobante de domicilio (facturas de servicios públicos, estados de cuenta bancarios, evaluaciones fiscales): Estos no son documentos optimizados para identidad. Vienen en cualquier diseño, escaneados a cualquier calidad, y la dirección puede no estar en una posición fija. Los bancos deben extraer la dirección, el nombre y la fecha (para confirmar que es reciente — típicamente dentro de 90 días) de estos documentos sin un formato estandarizado en el que confiar.
- Evidencia financiera (recibos de pago, W-2, declaraciones de impuestos, estados de cuenta bancarios para suscripción): Los documentos de suscripción de préstamos requieren extracción a nivel de campo de ingresos, historial de empleo e información de activos. Una solicitud de préstamo comercial puede incluir de 10 a 30 páginas en múltiples tipos de documentos — y los equipos de suscripción anteriormente gastaban el 40% de su tiempo solo organizando los documentos antes de extraer datos de ellos.
Por que a precisão em nível de caractere não é suficiente para KYC
Fornecedores tradicionais de OCR citam precisão em nível de caractere (CER) — normalmente 99% ou mais em documentos impressos e limpos. Mas em fluxos de trabalho de KYC, a precisão em nível de caractere é uma métrica enganosa. Um CER de 99% em uma página de passaporte com 500 caracteres significa que, em média, 5 caracteres estão errados. Se um deles for um dígito no número do passaporte ou uma letra no nome do cliente, o documento falha na triagem de AML ou a conta é aberta com dados de identidade incorretos que levam meses para corrigir.
A precisão em nível de campo — se o número inteiro do passaporte foi extraído corretamente, e não se a maioria dos caracteres está certa — é a métrica relevante para KYC. Sistemas de extração baseados em IA que usam modelos de linguagem de visão entendem o contexto: sabem que um número de passaporte segue um padrão específico, que dígitos verificadores existem para validação e que um caractere mal lido pode ser sinalizado para revisão humana em vez de ser aceito silenciosamente.
Dados de implantação publicados da implementação de OCR da GreenNode na banca vietnamita mostraram que o KYC automatizado com OCR e IA integrados reduziu o tempo de processamento de 45 minutos por arquivo para menos de 5 minutos, com uma taxa de processamento direto de 80–90% para aplicações padrão. Os 10–20% restantes exigiram revisão humana para casos extremos — documentos de baixa qualidade, formatos não padronizados ou campos ambíguos.
Para bancos que processam grandes volumes de pedidos de empréstimo, o mesmo pipeline de extração que lida com documentos de KYC também processa contracheques, declarações de imposto de renda e extratos bancários para subscrição — tornando uma plataforma de extração unificada que lida com todos esses tipos de documento uma vantagem operacional significativa em relação a ferramentas separadas e especializadas para cada etapa do processo.
OCR tradicional vs. IA de Visão: por que o processamento sem modelo importa na banca
Os desafios de processamento de documentos do setor bancário não são bem atendidos pela mesma abordagem de OCR que lida com faturas e recibos. Documentos bancários apresentam um conjunto fundamentalmente mais difícil de problemas. Entender por que exige uma distinção clara entre as duas gerações de tecnologia de extração.
O Limite do OCR Baseado em Modelos: Cada Novo Formato Rompe seu Fluxo de Trabalho
O OCR tradicional — seja Tesseract, ABBYY ou APIs de OCR em nuvem — opera com um modelo baseado em posição. O sistema extrae todo o texto de uma página e depois usa regras ou mapas de modelo para atribuir campos com base em suas coordenadas. Isso funciona quando o mesmo formato de documento aparece repetidamente. Falha quando:
- Você processa extratos de mais de 50 bancos diferentes
- Um banco atualiza o layout de seus extratos (o que acontece com mais frequência do que você imagina)
- Um cliente envia um extrato escaneado levemente inclinado ou com a página rotada
- Você recebe fotos tiradas com celular de extratos em vez de PDFs limpos
Cada mudança de formato exige uma atualização do modelo. Cada novo banco exige um novo modelo. A gestão de modelos cresce linearmente com a diversidade de documentos — e o setor bancário é um ambiente de extrema diversidade documental.
Como a Extração com IA de Visão Resolve o Problema de Formato
A extração com IA de visão — usando grandes modelos de visão (VLMs) — aborda o problema de forma diferente. Em vez de extraer todo o texto e depois tentar mapeá-lo aos campos esperados por posição, o VLM lê o documento como faria um humano: de forma holística, entendendo o layout visual, o significado semântico de cada região de texto e as relações entre os campos.
Esta é a mesma tecnologia descrita em nosso guia sobre o que é OCR com IA e como difere do OCR tradicional — e é a chave para resolver o desafio de múltiples formatos no setor bancário. Na prática, isso significa:
- Você define a saída, não a posição: Em vez de desenhar uma caixa ao redor de onde aparece a columna "Data da Transação", você simplesmente indica ao sistema que deseja Data da Transação, Descrição, Monto Débito, Monto Crédito e Saldo Corrente. A IA encontra esses campos em qualquer lugar da página entendendo o que significan.
- Uma definição de columna funciona em todos os formatos: O mesmo conjunto de nomes de columna extrae dados de um extrato do Chase, de um extrato do Bank of America e de um extrato de cooperativa de crédito — mesmo que a ordem das colunas, os nomes dos campos e o layout sejam completamente diferentes em cada um.
- As mudanças de formato não rompen seu fluxo de trabalho: Quando um banco atualiza o design de seus extratos, a extração continua funcionando porque a IA lê o novo layout por semántica, não por correspondência com um modelo guardado.
Este cambio de paradigma — de extração baseada em posição a extração baseada em semántica — é o que permite às equipes bancárias processar documentos de dezenas de fontes sem construir e manter uma biblioteca cada vez maior de modelos por banco. Para uma comparação mais amplia de herramientas de extração adequadas para fluxos de trabalho bancários, consulte nosso guía sobre o melhor software de OCR em 2026 por categorías e casos de uso.
Perguntas Frequentes
O OCR funciona em cheques com valores e assinaturas manuscritos?
Sim, mas a precisão depende da abordagem. A leitura MICR (linha do código de roteamento) é magnética e atinge taxas de leitura próximas a 100%, independentemente da caligrafia no cheque. O valor numérico (courtesy amount) e o valor por extenso (legal amount) são lidos por OCR/análise de imagem e geralmente alcançam 90–97% de precisão em cheques com caligrafia. A região da assinatura é analisada para detecção de falsificação usando correspondência de padrões, não OCR em nível de caractere. Sistemas modernos de processamento de cheques combinam as três técnicas e sinalizam discrepâncias para revisão humana.
O OCR de extratos bancários consegue lidar com extratos de bancos internacionais?
O OCR com IA pode processar extratos de bancos de diferentes países porque lê a semântica dos campos, e não posições de modelo. No entanto, a precisão da extração depende da variedade de formatos nos quais o modelo de IA foi treinado. Formatos de bancos dos EUA, Reino Unido, Canadá, Austrália e principais bancos europeus são bem suportados. Bancos regionais menores ou bancos em mercados menos digitalizados podem apresentar menor precisão na primeira tentativa, embora a IA se adapte mais rapidamente do que sistemas baseados em modelos, que exigiriam criação manual de modelo para cada novo formato.
Qual a precisão da extração de extratos bancários por IA comparada à digitação manual?
As taxas de precisão publicadas para extração de extratos bancários com IA variam de 95% a 99% em PDFs digitais limpos, e de 90% a 95% em extratos escaneados ou fotografados. Para comparação, a digitação manual tem uma taxa de erro típica de 3–5%, o que se traduz em cerca de 3–5 caracteres errados a cada 100 toques. A diferença é que os erros da IA tendem a se concentrar em campos ambíguos (números borrados, descrições de transações complexas), enquanto os erros manuais são aleatórios. Um pipeline de extração robusto inclui verificações de reconciliação automatizadas — verificando se o saldo corrente permanece consistente — que capturam a maioria dos erros significativos de extração antes que cheguem ao sistema contábil.
O OCR bancário está em conformidade com as regulamentações KYC/AML?
A conformidade é determinada por como o sistema OCR é implantado, não pela tecnologia OCR em si. Os dados extraídos devem ser armazenados com uma trilha de auditoria verificável mostrando o que foi extraído, quando e por qual processo. A maioria das plataformas modernas de extração com IA suporta registro de auditoria, pontuações de confiança em nível de campo (sinalizando extrações de baixa confiança para revisão) e manuseio seguro de dados (criptografia TLS, certificação SOC 2). Sob as regulamentações BSA/AML (12 CFR 21.11), os bancos devem manter registros que sejam reproduzíveis e auditáveis — um sistema de extração com IA com registro adequado atende a esse requisito de forma mais eficaz do que a digitação manual, que não possui trilha de auditoria integrada.
Como o KYC OCR lida com scripts não latinos, como árabe, chinês ou cirílico?
Modelos modernos de visão computacional são treinados com dados multilíngues e conseguem ler a maioria dos sistemas de escrita baseados em caracteres e scripts. Para documentos KYC, a MRZ em passaportes usa a fonte OCR-B padrão da ICAO apenas com caracteres latinos, tornando a zona legível por máquina universalmente compreensível. Os campos fora da MRZ (nome, endereço em script local) exigem suporte OCR para o idioma específico. Sistemas OCR baseados em IA geralmente suportam mais de 30 idiomas e podem processar árabe, chinês (simplificado e tradicional), cirílico, devanágari, hangul coreano e kanji japonês, entre outros. Sempre verifique se seu provedor de extração suporta os scripts específicos que você processa.
Quais campos devo extrair de um extrato bancário para conciliação?
O conjunto padrão de campos para conciliação de extratos bancários inclui: Número da Conta, Período do Extrato (Início/Fim), Saldo Inicial, Saldo Final e, para cada transação — Data da Transação, Descrição, Valor do Débito, Valor do Crédito e Saldo Corrente. Campos opcionais, mas úteis, incluem: Número de Referência/Cheque, Tipo de Transação (ATM, transferência, TED, depósito, tarifa) e Nome do Favorecido/Pagador, quando disponível. A maioria das ferramentas de extração por IA permite definir esses campos como nomes de colunas, e o sistema os preenche automaticamente a partir de qualquer formato de extrato.
A mesma ferramenta OCR pode lidar com cheques, extratos bancários e documentos KYC?
Uma plataforma unificada de extração por IA — especialmente baseada em modelos de linguagem visual — pode processar todos os três tipos de documentos sem trocar de ferramenta. O processamento de cheques usa MICR para a linha de roteamento e análise de imagem para a superfície do cheque. Extratos bancários usam extração com reconhecimento de tabelas para transações. Documentos KYC usam leitura de MRZ para documentos de identidade oficiais e extração geral de campos para comprovantes de residência e evidências financeiras. O requisito principal é que a ferramenta suporte Extração de Colunas Personalizadas: você define as colunas desejadas, e a IA localiza os dados correspondentes entendendo a semântica dos campos, independentemente do tipo ou formato do documento.