配送証明書(POD)データを物流業務用に
Excelへ抽出する方法
米国運輸調査研究所(ATRI)の報告によると、2025年のトラック輸送の平均運行コストは1マイルあたり$2.26に達し、燃料費以外のコストは過去最高の1マイルあたり$1.779となりました。トラック積載部門はマイナス2.3%の利益率で運営されています。利益率がこれほど薄いと、配送完了から請求書発行までの4日間のギャップは管理上の頭痛の種ではなく、あらゆる積載、毎週、毎四半期にわたって累積する売掛金回転日数(DSO)の問題です。このギャップが存在するのは、配送が完了したことを証明するデータがデータベースではなく、トラックの運転室内の紙に記載されているためです。そのデータを構造化された形式(Excel、CSV、またはTMSへの直接インポート)に抽出することは、物流業務が運送会社との関係を一切変えずに実行できる、最も効果の高い自動化施策です。
重要なポイント
- 紙で届くPODが200件あるごとに、1人が1日8.5時間の入力を続けることになり、その後の4日間の請求遅延は、毎週あらゆる積載にわたって累積するDSO問題となります。
- 4日間の請求ギャップは人員問題ではなく、署名済みの紙がトラックの運転室から机に届くまでの速さの問題であり、人員を増やしてもクリップボードが速くなることはありません。
- 抽出列をフィールドの位置ではなく意味で一度定義すれば、15社の運送会社からの200件のPODが1つのスプレッドシートに集約され、8時間かけて入力する代わりに1時間でレビューできます。
あらゆる物流業務におけるPODデータのボトルネック
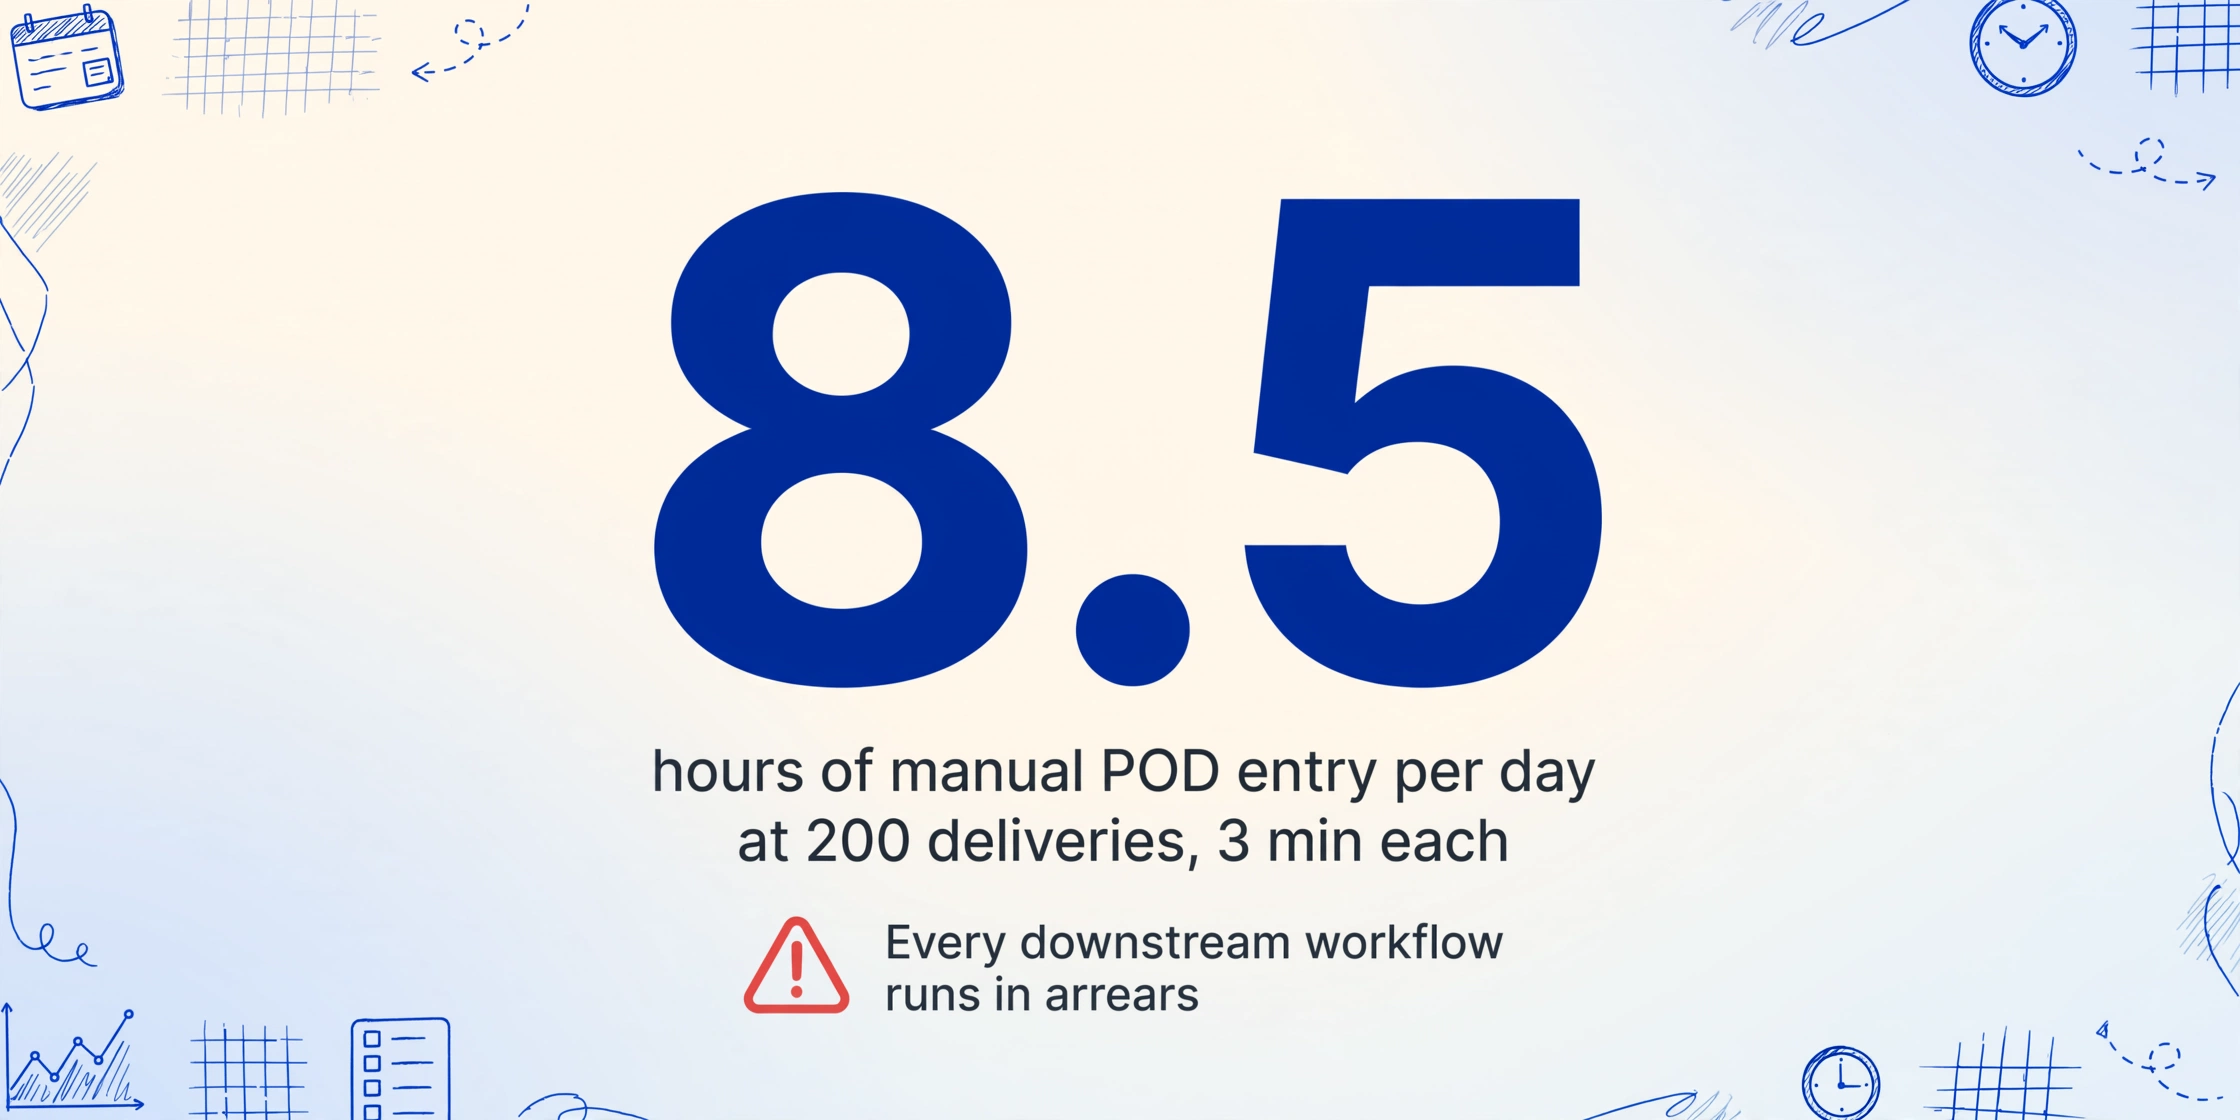
配送証明書(POD)は、同じデータに依存する4つの業務ワークフローの交差点に位置しています。請求は請求書を発行するために配達確認を必要とし、カスタマーサービスは「配達はどこですか」という問い合わせに答えるためにそれを必要とし、クレームは商品が良好な状態で到着したかを確認するためにそれを必要とし、運送会社との決済は支払いを実行するためにそれを必要とします。データソースが、請求システムに届くまでに4日かかる署名入りの紙のフォームである場合、すべての下流ワークフローは遅延して稼働することになります。
計算は単純です。1日200件の配達を処理する中規模のフレートブローカーまたは3PLは、PODを3つの形式で受け取ります。全国規模の運送会社(FedEx、UPS、DHL)からの電子PDF、地域のLTL運送会社からのスキャン画像、そして個人事業主や小規模車隊からの手書きのカーボンコピー形式です。電子PDFは全体の15%程度かもしれませんが、残りは画像や紙で届き、誰かが各フォームを確認して12〜20のフィールドを輸送管理システム(TMS)のキューに入力する必要があります。1件あたり3分の手動入力で、200件の配達に対して1日8.5時間のタイピングが必要となり、その作業を行う人は、顧客関係や運送会社との交渉に時間を費やしたいと会社が考える人物であることはほぼ間違いありません。
米国の州間輸送における運送会社の責任を規定するカーマック修正条項(49 U.S.C. §14706)は、このボトルネックにさらなる側面を加えます。カーマック修正条項の下では、運送会社は配達から最低9ヶ月以内に損害または損失のクレームに関する書面による通知を受け入れなければなりません。しかし、配達時に何が起こったかを証明することはPODに依存しています。不足配送や隠れた損傷に関する紛争が発生した場合、PODは受領内容の主要な証拠となります。PODデータが、見つけるのに2時間かかる紙のファイルに閉じ込められている場合、紛争解決のタイムラインは数時間から数日へと延びます。検索可能なPODデータベース(すべての配達日、受取人名、数量、例外メモが構造化フィールドになっているもの)があれば、その検索時間は数秒に短縮されます。
売掛金回転日数(DSO)への影響は静かに積み重なります。配達から請求まで4日かかるということは、運転資本サイクルに、支払条件の交渉では決して修正できない組み込みの遅延が含まれていることを意味します。なぜなら、その遅延は顧客の支払い行動ではなく、データパイプラインにあるからです。
PODに記載されているもの — BOLよりもデジタル化が難しい理由
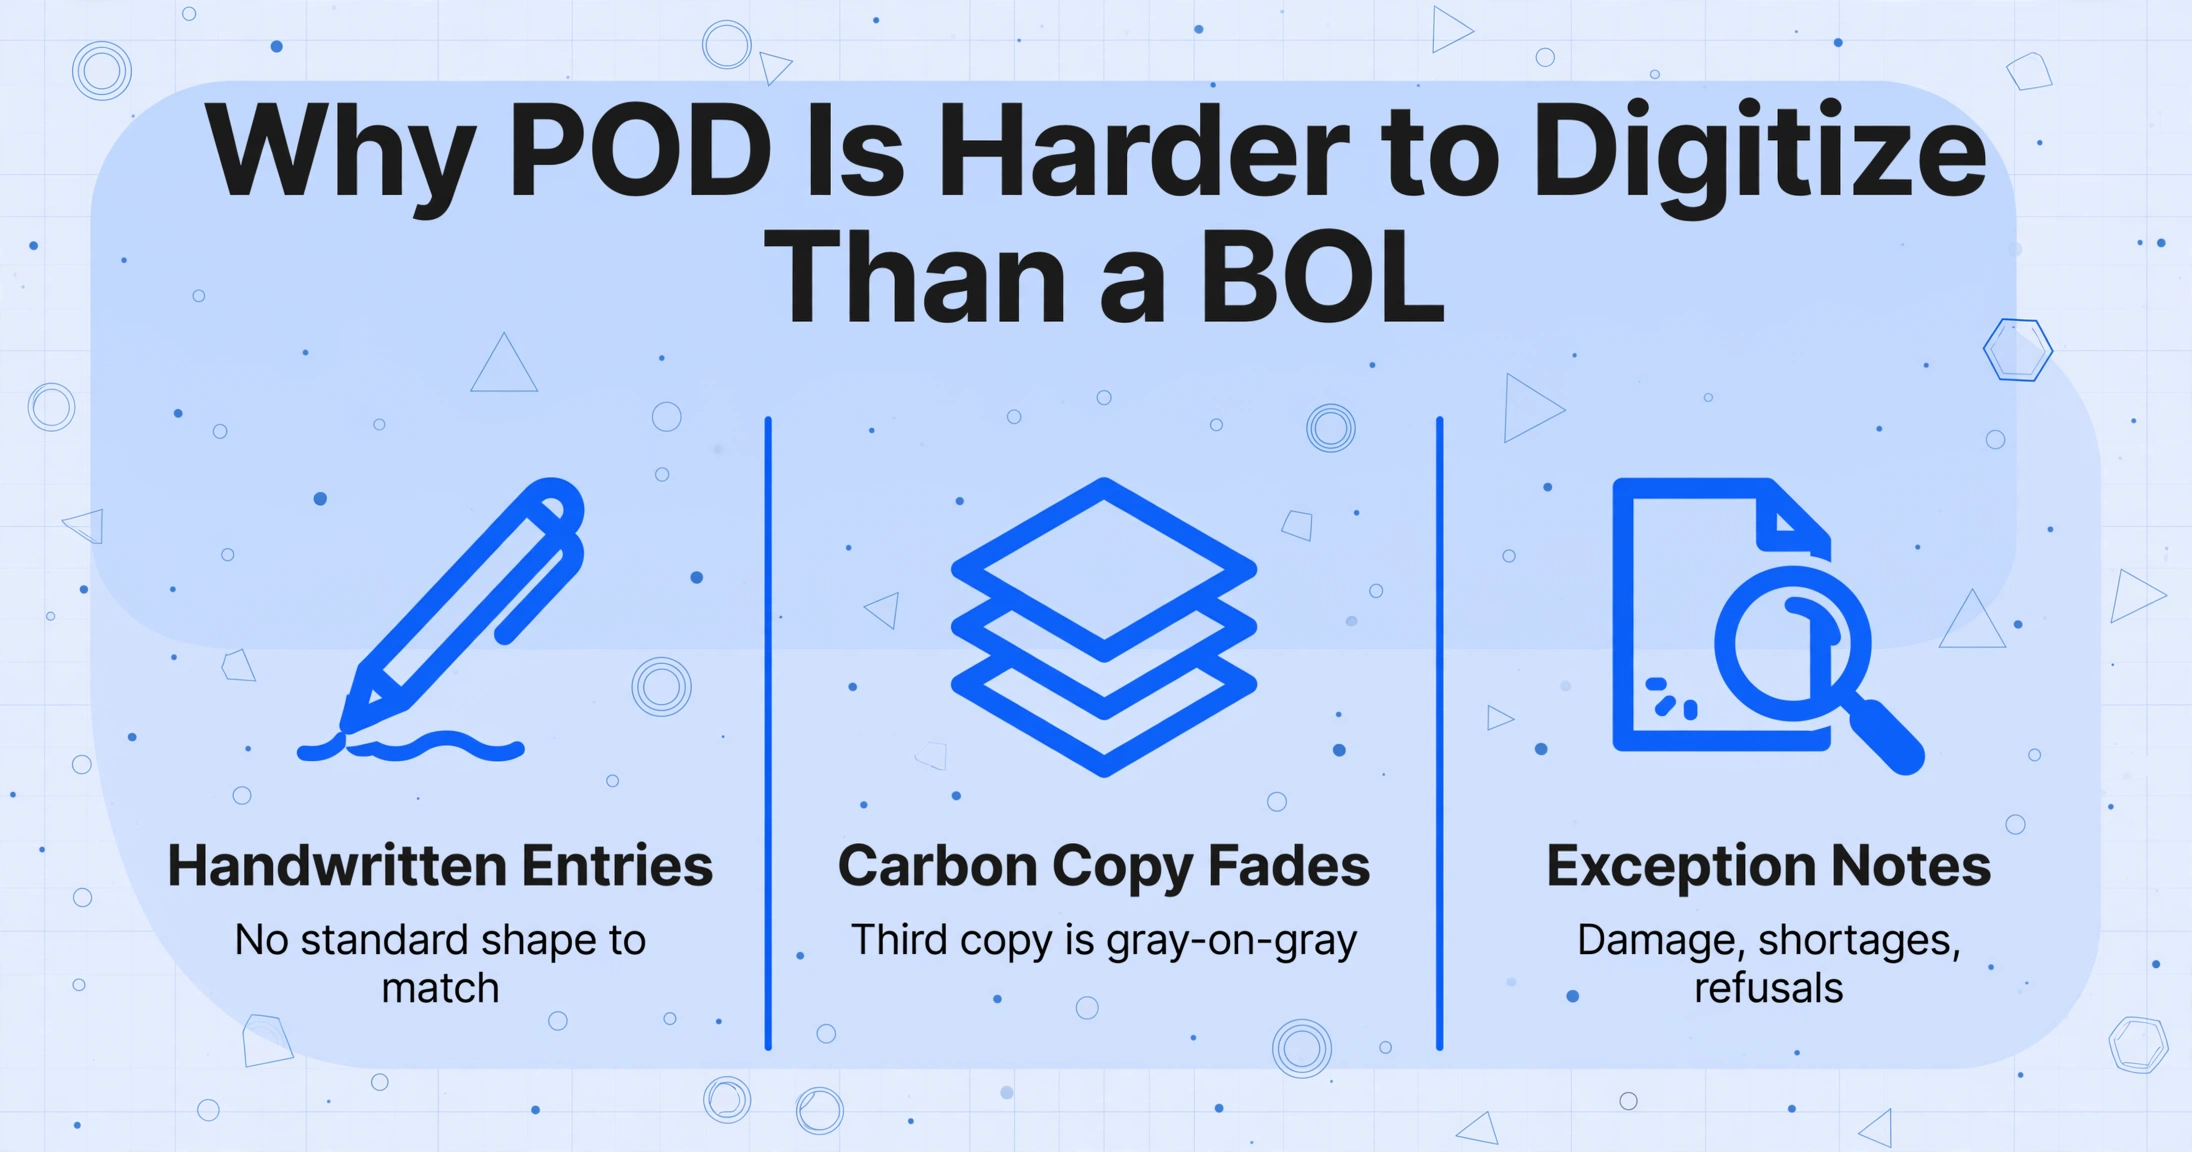
配送証明書(POD)は一見シンプルに見えます。商品が受け渡されたことを確認するいくつかの欄があるフォームです。しかし実際には、個々に難しい3つの文書処理の課題が組み合わさっており、この文書タイプに特有のものとなっています。
手書きの署名と記入。ドライバーは、配達時間、パレット数、および例外メモを手書きで記入します。多くの場合、FMCSA 49 CFR Part 395の勤務時間規則に従う14時間のシフトの後、車内でクリップボードに記入します。受取人は署名し、欄外に「12/15受領」や「段ボール1つ破損 — 受領」と書くこともあります。どちらの手書きサンプルも、最適な照明の下の机で作成されたものではありません。既知のフォントと形状を照合して印刷文字をセグメント化する従来のOCRツールは、照合する標準的な形状がないため、このようなコンテンツでは機能しません。急いで書かれた「qty 12」は、文字照合エンジンには「qty 14」と見分けがつかないことがあります。
カーボンコピーの劣化。ほとんどの紙のPODは複写式のカーボンフォームです。1枚目(白)のコピーは判読できます。2枚目(ピンクまたは黄色)のコピーは薄くなります。3枚目(青またはゴールデンロッド)になると、ペンの圧力がほとんど伝わらず、文字はゴーストイメージになります。つまり、ぼんやりとした輪郭で、ストロークが欠落し、コントラストがほぼゼロになります。3枚目のカーボンフォームの標準的なスキャンでは、ほとんどのOCRツールがテキストを抽出できないグレーオングレーの画像が生成されます。手書きはなおさらです。
非構造化された例外注記。POD上で業務上最も重要な情報は、しばしば最も構造化されていません。ドライバーは欄外に「2カートン不足」と書きます。受付係は数字を丸で囲み、「拒否 — 水濡れ」と書きます。受取人は署名欄の横に署名する代わりに「ジョン経由」と書くこともあります。これらのメモは指定された欄には表示されず、運送会社のフォームによって同じ場所に表示されることもありません。しかし、これらのメモには、荷物が受け入れられるか、異議が申し立てられるか、拒否されるかを決定する情報が含まれており、請求およびクレームのワークフローが機能するためには、これらを取得する必要があります。
複数停車地の配送マニフェスト。1枚のPODシートが、同じルート上の3〜5つの配送停車地をカバーすることがよくあります。各停車地は、同じフォーム上の別々のセクションであり、印刷された線または番号付きのセクション区切りで区切られています。抽出では、停車地1がどこで終わり、停車地2がどこから始まるかを区別する必要があります。そうしないと、出力全体が、数量を誤って帰属させた結合行に崩壊します。これは、単一のフィールドを読み取るよりも難しい問題です。フィールドレベルだけでなく、セクションレベルで文書レイアウトを理解する必要があります。
ワークフロー:ドライバーのクリップボードからTMSへのインポートまで
POD抽出が実際の物流業務にどう組み込まれるかを理解するには、現在のほとんどの貨物仲介業者や3PLで行われているエンドツーエンドのワークフローを把握すると役立ちます。
ドライバーが配送を完了 — PODを取得
ドライバーは複写式の伝票にサインをもらうか、スマートフォンで署名済みの受領書の写真を撮ります。全国規模のキャリア(FedEx、UPS)の場合、PODは電子的に取得され、数分以内にキャリアのポータルへアップロードされます。地域のLTLキャリアやオーナーオペレーターの場合、紙の伝票は運行フォルダーに保管されます。
PODがバックオフィスに届く — 遅延あり
紙のPODは、ドライバーが拠点に戻ったときにオフィスに届きます。当日中、翌朝、長距離の場合は週末です。キャリアのポータルからの電子PODはバッチでダウンロードされます。どちらも同じキュー、つまりデータ入力待ちの書類の山に置かれます。
データ入力担当者がTMSにフィールドを入力
各PODについて、担当者は配送番号、日付、受取人名、受領数量、署名状況、例外メモを読み取り、TMSの出荷記録に入力します。MercuryGate、McLeod LoadMaster、TMW Suite(Trimble)、Descartes、Turvoなどのプラットフォームは、請求処理と顧客通知のために構造化された出荷データを必要とします。POD1件あたり3分、1日200件のPODの場合、このステップだけで1日100〜120件の配送につきフルタイムの担当者が1人必要になります。
請求書の生成 — データのギャップにより遅延
TMSは、PODデータが確認された配送のみを請求できます。フィールドが入力されるまで、その配送は「確認待ち」ステータスのままです。1日200件の配送がある場合、その滞留により請求処理は2〜4日遅れます。それが毎週、毎月続きます。
クレームや紛争にはPODの照会が必要 — 多くの場合手作業
荷主がカーマック修正条項の枠組みに基づいて貨物クレームを申し立てた場合、仲介業者または3PLは配送状況を確認するためにPODを提出する必要があります。紙のファイルやスキャンしたPDFが出荷日ごとに保管されている場合、1回の照会に15〜30分のファイル検索が必要です。構造化されたデータ(各PODがスプレッドシートの1行)があれば、同じ照会は5秒で完了します。
抽出ワークフローは、ステップ3(手動データ入力)を自動抽出に置き換え、ステップ4の2〜4日の遅延を当日または翌日の請求に短縮します。重要なのは、抽出にTMSの交換、運送会社の変更、新しいハードウェアの導入が不要であることです。紙とキーボードが出会う時点で、既存のワークフローにシームレスに組み込まれます。
PODデータの抽出方法:ステップバイステップ
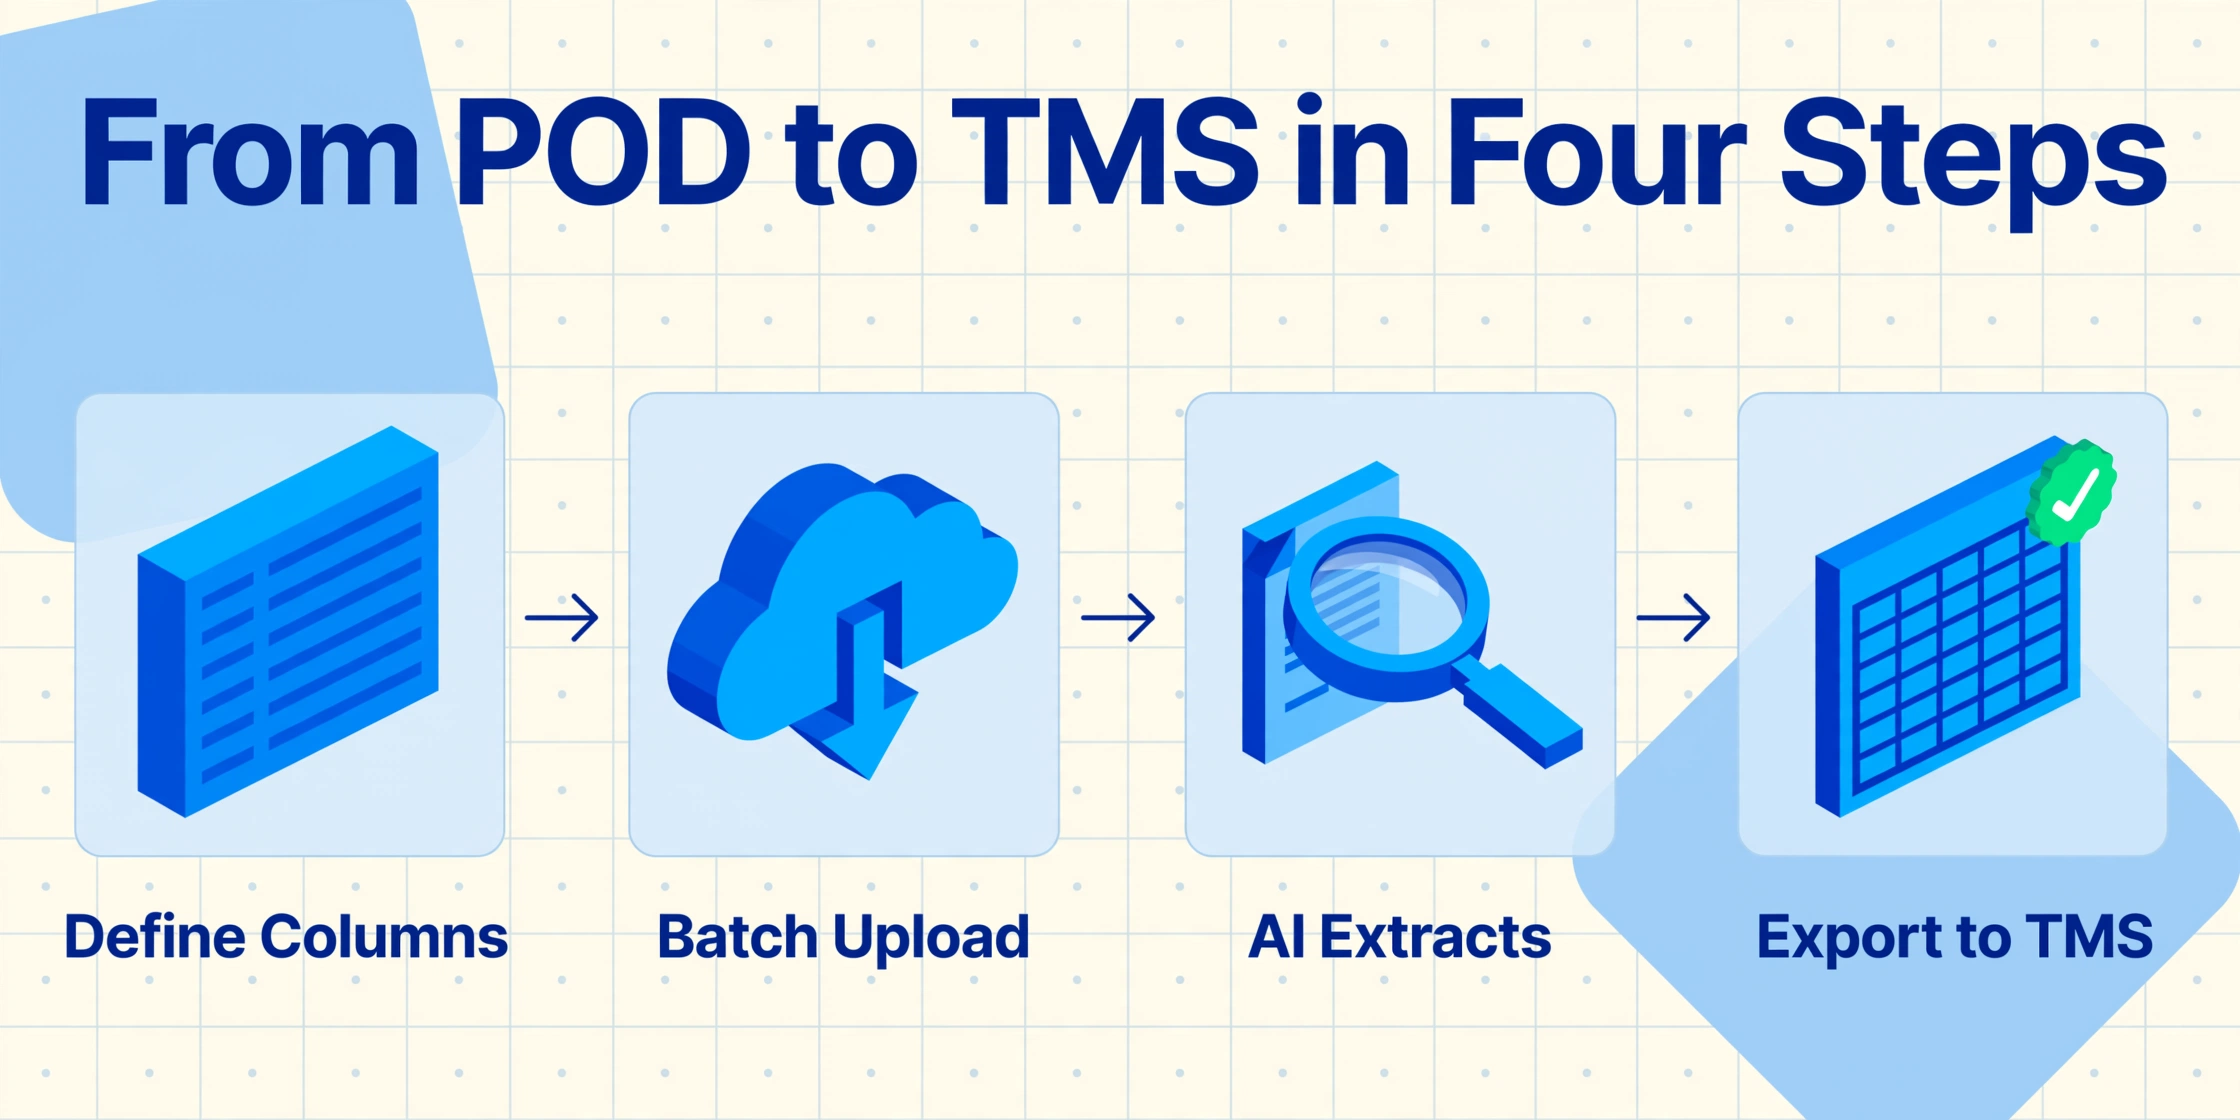
抽出プロセスは、請求書、納品書、船荷証券に適用されるノーコード一括処理ワークフローと同じ流れに従います。ただし、PODには、その独自の特性を反映した特定の列定義と形式処理が必要です。
TMSインポートテンプレートに合わせて抽出列を定義する
出力スプレッドシートに必要な列名を入力します。入力した列名は、抽出指示とスプレッドシートのヘッダーの両方になります。PODワークフローの場合、必須列はお使いのTMSが期待するものと一致します:
Delivery Number / PRO番号— TMSの出荷記録にリンクしますDelivery Date— 実際の配送日Delivery Time— 配送時刻Consignee / Recipient Name— 荷受人名Delivery Address— 実際の配送場所(BOLの住所と異なる場合があります)Quantity Shipped vs. Quantity Received— 差異の追跡用Signature Status— 署名あり / 署名なしCondition Notes / Exception Notes— 破損の記載、不足、拒否Driver Name— 配送を行ったドライバー
可能な限り、これらの列名をTMSのインポートフィールド名に合わせてください。これにより、自動化による時間短縮効果を損なう再フォーマット作業を回避できます。PRO_NUMBERのようにMercuryGateやMcLeodのインポートテンプレートに直接マッピングされる列は、再マッピングが必要な「POD ID」と呼ばれる列よりも価値があります。
その日のPODを一括アップロードする
すべてのPODファイル(スキャンしたカーボンコピー、手書き伝票のスマホ写真、キャリアポータルからのPDFダウンロード)を1つのバッチでアップロードします。AIは定義した列定義を使用してそれらを並列処理します。アップロード前にキャリアやフォームタイプで分類する必要はありません。カーボンコピーで最良の結果を得るには:3枚目のコピーには300 DPI以上のフラットベッドスキャナーを使用してください。スマホ写真は、1枚目のコピーと電子PDFには標準解像度で十分です。スキャナーを使わずに文書をデジタル化する方法については、スマホでの文書デジタル化ガイドをご覧ください。
抽出と確認
AIは各PODを読み取り、定義した列に入力します。手書きのカーボンコピーの場合、AIのビジョンモデルは文脈から文字を推測します。「QTY RCVD」の横にあるぼやけた「12」は、AIが妥当な配送数量を理解しているため、「14」ではなく「12」である可能性が高くなります。フラグが付けられた低信頼度フィールドを確認してください。鮮明な手書きのほとんどの1枚目コピーでは、85〜95%のフィールドが修正なしで正しく抽出されます。
TMSにエクスポートしてインポート
結果をExcelまたはCSVでエクスポートします。出力は、運送会社ごとでもファイルごとでもなく、PODごとに1行が割り当てられた1つのスプレッドシートで、列名はお客様が定義したものが使用されます。TMSの標準CSVインポート機能を使ってファイルをインポートしてください。MercuryGate、McLeod LoadMaster、TMW Suite、Descartes、Turvoなどのプラットフォームはすべて、列マッピング付きの構造化ファイルインポートに対応しています。インポートにかかる時間は数時間ではなく数分です。また、列名はステップ1でTMSテンプレートに合わせて設定されているため、マッピング作業は一度きりの設定で完了します。
ファイルのエクスポート・インポートサイクルを完全にスキップしたい運用では、Google Sheetsアドオンを使用すると、抽出結果をTMSインポートパイプラインや社内追跡ダッシュボードに供給するスプレッドシートに直接書き込むことができます。同じ抽出でありながら、ファイル受け渡しのステップが1つ減ります。
複数運送会社の形式でも、複数運送会社用テンプレートは不要な理由
これこそ、多くの物流チームが抽出の導入をためらう理由です。「15社の異なる運送会社からPODを受け取っていますが、それぞれフォームのレイアウトが異なります。つまり、15個のテンプレートが必要なのでしょうか?」
テンプレートベースの抽出ツール(Docparser、Parseur、およびほとんどのゾーンOCRアプローチを含む世代)の場合、答えは「はい」です。各運送会社のレイアウトには個別の解析設定が必要です。A社のフォームの配達番号フィールドの周りにボックスを描き、B社のフォームには異なるボックスを描き、運送会社がレイアウトを更新するたびにそれぞれを維持する必要があります。数十社の運送会社からPODを受け取るフレートブローカーにとって、このテンプレート保守の負担は、自動化による時間節約効果をすぐに上回ってしまいます。
列名抽出 — ImageToTable.aiが採用するアプローチ — は、これとは異なる方法で機能します。フィールドの位置を定義するのではなく、フィールドの意味を定義します。「配達日」を列名として一度入力するだけで、AIのビジョンモデルは、配達日が何であるかを理解することで、各POD上の対応する値を特定します。固定座標でテキストを探すのではありません。配達日が右上隅にあるFedEx SmartPost POD、中央ブロックに印刷されている地域LTL運送会社のフォーム、ドライバーが「DATE」の横に手書きしたオーナーオペレーターの伝票 — これらすべてが、運送会社ごとの設定ゼロで同じ列定義を通過します。これがテンプレート不要のAI抽出パターンです。抽出エンジンは位置ではなく意味で読み取ります。
物流業務への実際的な影響:20社の運送会社からの200件のPODを1回のアップロードにまとめ、列を一度定義すれば、1つの統合スプレッドシートが得られます。運送会社ごとの事前仕分けは不要。運送会社ごとのテンプレート設定も不要。運送会社がフォームデザインを更新してもメンテナンスは不要です。
複数停車地マニフェストの処理:最も難しいPODケース
3つの配送停車地をカバーする1枚のPODシートは、同じページに印刷された3つの独立したミニフォームのように見え、水平線または番号付きセクション区切りで分かれています。各停車地には独自の配送番号、受取人、数量、署名があります。抽出ではこれらのセクション境界を認識し、各行を正しい停車地に割り当てる必要があります。そうしないと、バッチ出力全体で配送が混ざり合い、使用できなくなります。
ここでセマンティック抽出が真価を発揮します。AIはレイアウトレベルで文書を読み取ります。ページ全体にわたる水平線の後に新しい「停車地2」ヘッダーが続く場合、それは書式のアーティファクトではなくセクション境界であると認識します。出力では各停車地にスプレッドシート内の独自の行が割り当てられ、フィールドは正しい配送セグメントに帰属します。これはすべての文書で完璧というわけではありません。スキャン品質が悪い、または極端に圧縮されたフォームのセクション境界は曖昧な場合がありますが、印刷された複数停車地フォームの大部分は確実に処理できます。正直な評価として、運用で複数停車地マニフェストを1枚のシートで定期的に処理する場合は、特に境界マーカーが薄い、または手書きの場合、セクション帰属に特化したレビュー時間を予算に組み込んでください。
PODデータと船荷証券・梱包明細書のクロスリンク
PODは単独では存在しません。PODは、船荷証券(ピックアップ時に発行)、梱包明細書(内容物を記載)、配送伝票(出荷に添付)、POD(配送時に署名)から始まる文書チェーンの最終リンクです。このチェーンの各文書には重複しながらも異なる情報が含まれており、それらを照合することで完全な出荷記録が作成されます。
PODを処理するのと同じ抽出ワークフローで、船荷証券と梱包明細書を別々のバッチまたは同じバッチで処理できます。リンクキーとしてPRO番号または配送番号を使用します。PODが12パレットの配送を確認しているのにBOLが14パレットの出荷を示している場合、その不一致は請求紛争になる前に構造化データポイントとして浮上します。このワークフローのBOL側の詳細については、抽出されたBOLデータがTMSにどのように取り込まれるかをご覧ください。
倉庫環境で手書きの受領文書を扱う運用の場合(ドライバーが紙の配送伝票を提示し、受領担当者が数量と状態を手書きで注記する)、POD抽出ワークフローはバッチ梱包明細書・配送伝票抽出で使用されるものと同じ列名アプローチに従います。PODを読み取るのと同じ列構成で、商品受領メモや倉庫マニフェストも読み取ることができ、配送チェーンのさまざまな時点で取得された文書から統合された受領ダッシュボードを作成できます。署名済み配送伝票の印刷された出荷データと手書きの受領マークの両方を読み取る手順については、倉庫受領における手書き配送伝票抽出ガイドをご覧ください。
配送伝票とPODの全体像(これらの文書が請求書よりも抽出が難しい理由、照合に最も重要なフィールド、ツールの評価方法)については、配送伝票・POD抽出の完全ガイドから始めてください。今すぐご自身のPODで抽出をテストするには、配送伝票Excel変換ツールをご利用ください。
精度の限界:得意な領域と人間による確認が必要な領域
どの抽出ツールにも精度の限界があり、配送証明書(POD)は他の文書タイプよりも早くその限界が顕在化します。AIが得意とする領域と不得意な領域を具体的に示すことで、正確な期待値を設定し、新たな検証負担を生むのではなく、実際に時間を節約できるワークフローを構築できます。
精度が高い領域:
- 白いカーボン複写の原本(1枚目)で、ブロック体の明確な手書き文字 — 印刷された配送番号や日付など、曖昧さのない項目では最大99%の精度に達します
- 主要キャリア(FedEx、UPS、DHL)からの電子POD — 一貫したフィールドラベルを持つ機械印字テキスト
- 署名の有無の検出 — AIが署名欄に署名マークが存在するかどうかを確認し、「署名あり」または「署名なし」を出力します
- 印刷されたフィールドラベルと事前入力されたキャリア情報
- 備考欄の標準的な例外注記(「2個不足」「1箱破損」など)— 手書き文字が判読可能な場合
人間による確認が必要な領域:
- カーボン複写の3枚目(青/黄色)— コントラストが低すぎて自動読み取りの信頼性が低く、手書きフィールドのほとんどを確認する必要があります
- 複数停車地のマニフェストにおけるセクション境界の検出 — 特に区切り線が印刷された罫線ではなく、薄い手書きのダッシュの場合
- 雨濡れやシワのあるフォーム — 環境による劣化に比例して抽出精度が低下します
- 署名の本人確認 — AIは署名の存在を確認しますが、既知のサンプルと照合して署名者の身元を検証するわけではありません
- PODに添付された損傷写真 — AIはフォーム自体からテキストを抽出しますが、添付された写真の内容を解釈することはありません
データの10%未満をチェックしながら抽出エラーの95%を検出する実用的な検証フレームワークについては、ターゲットサンプリングによる抽出結果の検証に関するガイドをご覧ください。手書き文字の抽出に関する特定の問題のトラブルシューティング(OCRやAIツールが重要なフィールドを誤読した場合の対処法を含む)については、OCRが手書き文字で失敗する理由とその修正方法に関するガイドをご覧ください。
1日あたり200件のPODを処理する物流オペレーションにおける実際の時間削減効果: すべてのフォームを1行ずつ読み、15〜20のフィールドをゼロから入力する代わりに、オペレーターは事前に入力されたテーブルを確認し、文書ごとにフラグが付けられた3〜5のフィールドを修正するだけです。これは、1日あたり3,000〜4,000の抽出フィールドのうち、約600〜1,000のフラグ付きフィールドを確認することに相当し、手動データ処理が75〜85%削減されます。つまり、6〜8時間の完全なデータ入力の代わりに、約1〜1.5時間の確認作業で済みます。
よくある質問
カーボンコピーPODの文字が薄い場合でも、AIはデータを抽出できますか?
はい、ただしコピーの種類によって精度が異なります。白(1枚目)のコピーは確実に抽出できます。ピンク(2枚目)のコピーは薄いですが、読み取り可能です。青や黄色(3枚目)のコピーはコントラストが非常に低く、ほとんどのAI抽出(ベンダーを問わず)では信頼性の低い結果になります。3枚目のコピーには、600DPIのフラットベッドスキャナーとコントラスト強調を使用し、出力結果の全量を人間が確認することをお勧めします。
キャリアごとに異なるPODフォーマット用のテンプレートが必要ですか?
テンプレート不要の抽出機能を使えば、その必要はありません。必要な列(配送番号、配送日、受取人、数量、署名状況)を一度定義するだけで、AIは各フィールドの意味を理解し、あらゆるキャリアのPODから対応する値を特定します。FedExのPOD、UPSの配送受領書、地域LTLキャリアのカーボン形式、個人事業主の手書き伝票も、すべて同じ列定義で処理できます。キャリアごとのテンプレート設定やメンテナンスは不要です。
AIはPODに署名があるかどうかを検出できますか?
はい。AIは署名欄に手書きのマークがあるかどうかを検出し、「署名あり/署名なし」のステータスを出力します。これにより、受取場所の誰かが配送を確認したことを確認でき、ほとんどの請求業務には十分です。ただし、署名者の身元確認や、署名と見本の照合は行いません。署名の検証には、別途、生体認証や鑑識プロセスが必要です。
PODの余白に損傷メモや例外事項が書かれている場合、どう処理すればよいですか?
抽出設定で「例外メモ」または「損傷メモ」という列を定義してください。AIは文書全体(余白、フォーム周辺の空きスペース、印刷フィールド横の手書き注釈を含む)をスキャンし、配送例外を説明する内容を探します。「ダンボール1つ潰れ・受取拒否」のような構造化された損傷記録も、「2個不足」のような余白の走り書きも、両方を取得します。重要なのは、AIがこのコンテンツを場所(特定の枠内のテキスト)ではなく、意味(配送例外を説明するテキスト)で検索する点です。
複数配送先を含むマルチストップPOD(1枚のシートで3~5件の配送をカバー)からデータを抽出できますか?
AI抽出は、印刷された線、区切り線、番号付きセクションヘッダーなどのセクション境界を認識し、各配送先のデータを出力の個別行に割り当てることで、マルチストップマニフェストを処理できます。これは、明確なセクションマーカーがある印刷されたマルチストップフォームで確実に機能します。セクション境界が手書きの場合や、スキャン状態の悪いページで配送先が視覚的に重なっているフォームでは、信頼性が低下します。大量のマルチストップマニフェストを処理する業務では、特にカーボン複写の3枚目や雨で損傷したフォームの場合、セクション割り当ての確認時間を予算に組み込んでください。
POD抽出は、既存のTMS(MercuryGate、McLeod、TMWなど)とどのように連携しますか?
抽出出力は、どのTMSでもインポート可能な標準のExcelまたはCSVファイルです。抽出時に定義する列名は、TMSのインポートフィールド名に合わせて設定できるため、抽出出力とTMSインポート間の手動マッピングは不要です。MercuryGate、McLeod LoadMaster、TMW Suite、Descartes、Trimble、Turvoを含むほとんどのプラットフォームは、構造化されたCSVインポートを受け入れます。この抽出により、キーボードでの手動データ入力が不要になります。TMSは、これまで通り、出荷追跡、請求、運送会社との連絡を処理します。
PODフィールドが空白の場合はどうなりますか?
AIは、出力内の空白フィールドを空のままにします。破損に関する記載がないPODの「例外メモ」セルは空になります。AIが内容を捏造したり、デフォルト値を入力したりすることはありません。これは、空白セルが列の配置と行構造を維持するため、バッチ出力において重要です。TMSにインポートする場合、空のフィールドはnull値として渡され、ほとんどのプラットフォームはエラーなく処理します。
ご自身の文書でPODデータの抽出を始める
納品から請求までの4日間のギャップは、運送会社が遅いからでも、チームの人員が不足しているからでもありません。配達が完了したことを証明するデータが紙の上にあり、それを手で読んで入力しなければならない形式だからです。この記事で説明した抽出ワークフロー(列を一度定義し、運送会社や形式を問わずすべてのPODを一括アップロードし、構造化データをTMSにエクスポートする)は、ドライバーの配達方法や運送会社の運用を変えることなく、入力作業を排除します。
すべての運送会社にePODソフトウェアを導入したり、ドライバーに新しいアプリの使い方を訓練する必要はありません。すでに受け取っている紙のPOD——運送会社のPDF、ドライバーの写真、クリップボードのカーボンコピー——は、請求書や納品書を処理するのと同じアップロードインターフェースを通じて、今日から抽出ワークフローに取り込めます。何十年も紙で届いていたデータが、請求締め前に検索可能な構造化スプレッドシートになります。
ご自身のPODでお試しください。毎日8時間のデータ入力が、1時間のレビュー作業になるかどうかをご確認ください。
サンプルのPODをアップロードしてください——運送会社や形式は問いません——数秒で抽出結果を確認できます。アカウント登録は不要です。