Cómo extraer datos de comprobantes de entrega (POD)
a Excel para operaciones logísticas
El Instituto Americano de Investigación del Transporte (ATRI) informa que el costo operativo promedio del transporte por carretera alcanzó $2.26 por milla en 2025, con los costos no relacionados con combustible alcanzando un máximo histórico de $1.779 por milla. El segmento de carga completa operó con un margen negativo del 2.3%. Cuando los márgenes son tan reducidos, una brecha de cuatro días entre la finalización de la entrega y la generación de la factura no es un problema administrativo: es un problema de días de ventas pendientes de cobro (DSO) que se acumula en cada carga, cada semana, cada trimestre. La brecha existe porque los datos que demuestran que se realizó una entrega viven en un papel dentro de la cabina del camión, no en una base de datos. Extraer esos datos a un formato estructurado (Excel, CSV o importación directa al TMS) es el movimiento de automatización de mayor apalancamiento que una operación logística puede hacer sin cambiar ni una sola relación con un transportista.
Conclusiones clave
- Cada 200 POD que llegan en papel mantienen a una persona escribiendo durante 8.5 horas al día, y el retraso de facturación de cuatro días que sigue es un problema de DSO que se acumula en cada carga, cada semana.
- Su brecha de facturación de cuatro días no es un problema de personal: es la velocidad a la que el papel firmado viaja de la cabina del camión al escritorio, y ninguna contratación hace que un portapapeles se mueva más rápido.
- Defina las columnas de extracción una vez por el significado del campo en lugar de por su posición, y 200 POD de 15 transportistas se consolidan en una sola hoja de cálculo revisada en una hora en lugar de escribirse durante ocho.
El cuello de botella de los datos POD en toda operación logística
Los comprobantes de entrega se encuentran en la intersección de cuatro flujos de trabajo operativos que dependen de los mismos datos: la facturación necesita la confirmación de entrega para generar facturas, el servicio al cliente la necesita para responder consultas de "¿dónde está mi entrega?", las reclamaciones la necesitan para verificar si las mercancías llegaron en buen estado, y la liquidación con transportistas la necesita para liberar el pago. Cuando la fuente de datos es un formulario en papel firmado que tarda cuatro días en llegar al sistema de facturación, todos los flujos de trabajo posteriores operan con retraso.
La aritmética es sencilla. Un corredor de carga o 3PL de tamaño mediano que maneja 200 entregas por día recibe POD en tres formatos: PDF electrónicos de transportistas nacionales (FedEx, UPS, DHL), imágenes escaneadas de transportistas regionales LTL y formularios manuscritos en papel carbón de propietarios-operadores y flotas pequeñas. Los PDF electrónicos podrían representar el 15% del volumen; el resto llega como imágenes y papel que requieren que alguien revise cada formulario y escriba de 12 a 20 campos en una cola del Sistema de gestión de transporte (TMS). A 3 minutos por POD de ingreso manual, eso son 8.5 horas de escritura por día para 200 entregas, y la persona que lo hace casi con certeza no es a quien la operación preferiría dedicar su tiempo a las relaciones con clientes o negociaciones con transportistas.
La Enmienda Carmack (49 U.S.C. §14706), que rige la responsabilidad del transportista por envíos interestatales en EE. UU., añade otra dimensión a este cuello de botella. Bajo Carmack, los transportistas deben aceptar avisos escritos de reclamaciones por pérdida o daño dentro de un mínimo de nueve meses desde la entrega — pero probar lo que ocurrió en la entrega depende del POD. Cuando surge una disputa por un envío incompleto o daño oculto, el POD es la evidencia principal de lo que se recibió. Si los datos del POD están bloqueados en un archivo en papel que tarda dos horas en localizarse, el plazo de resolución de disputas se extiende de horas a días. Una base de datos de POD buscable — donde cada fecha de entrega, nombre del destinatario, cantidad y nota de excepción sea un campo estructurado — reduce ese tiempo de búsqueda a segundos.
El impacto en los Días de ventas pendientes de cobro (DSO) se acumula silenciosamente. Cuatro días de la entrega a la factura significa que sus ciclos de capital de trabajo incluyen un desfase incorporado que ninguna negociación de plazos de pago puede corregir — porque el retraso está en su canal de datos, no en el comportamiento de pago de su cliente.
Qué contiene un POD — y por qué es más difícil de digitalizar que un BOL
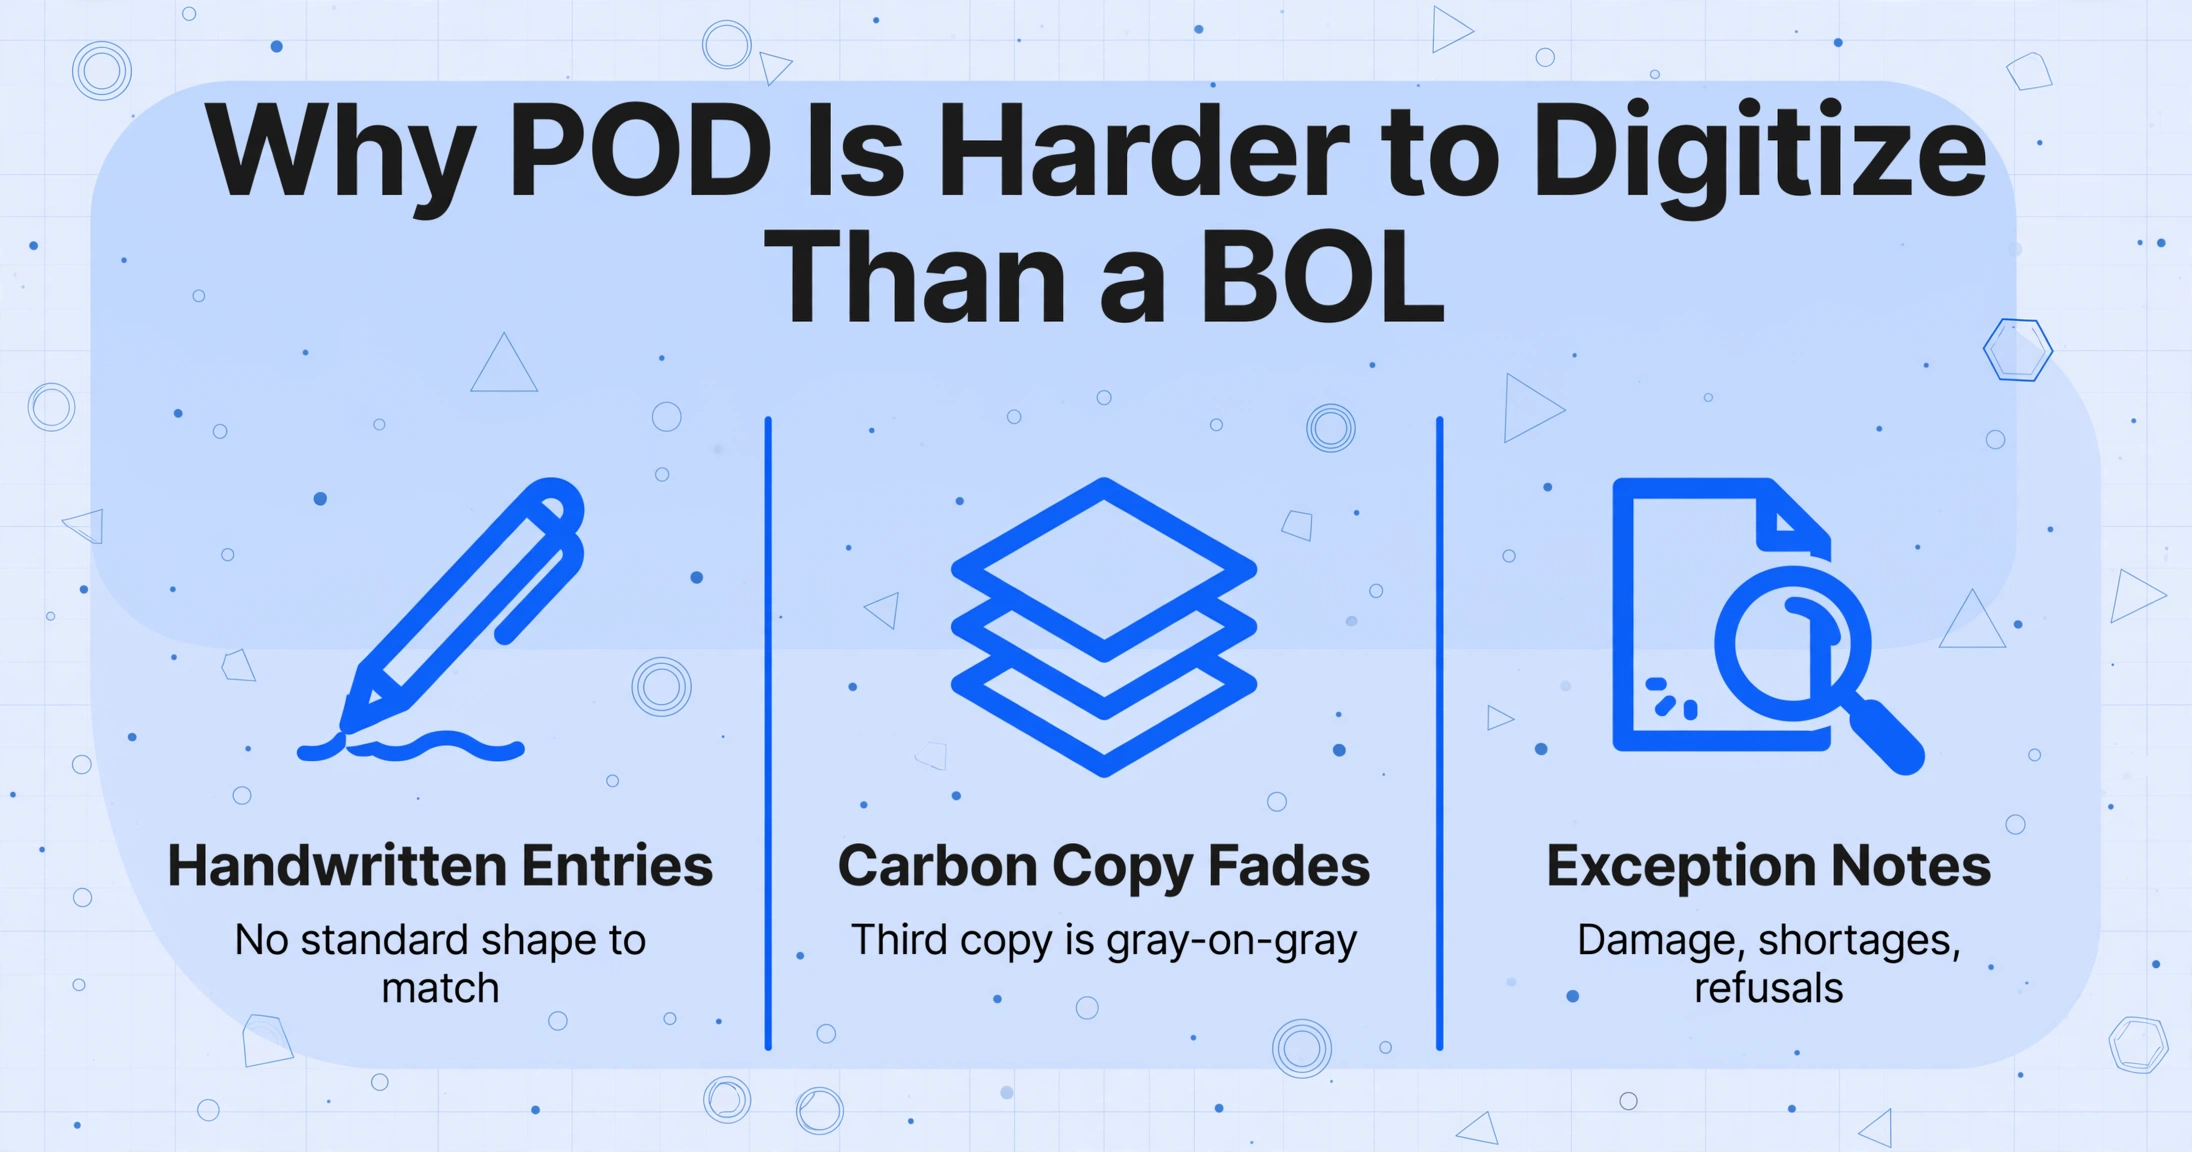
Un comprobante de entrega parece un documento simple en la superficie: un formulario con algunos campos que confirman que las mercancías cambiaron de manos. En la práctica, combina tres desafíos de procesamiento de documentos que son difíciles individualmente y que juntos son exclusivos de este tipo de documento.
Firmas y entradas manuscritas. El conductor escribe la hora de entrega, el número de pallets y cualquier nota de excepción a mano — a menudo en la cabina, sobre una tabla sujetapapeles, después de un turno de 14 horas regulado por las reglas de horas de servicio de la FMCSA 49 CFR Part 395. El receptor firma y a veces escribe "recibí 12 de 15" o "1 caja aplastada — aceptada" en el margen. Ninguna de las dos muestras de escritura se produjo en un escritorio con iluminación óptima. Las herramientas tradicionales de OCR — que segmentan caracteres impresos comparando formas con fuentes conocidas — fallan con este contenido porque no hay una forma estándar que coincida. Un "cant. 12" escrito de prisa puede parecer indistinguible de "cant. 14" para un motor de coincidencia de caracteres.
Degradación de la copia carbón. La mayoría de los POD en papel son formularios de carbón de varias partes. La copia superior (blanca) es legible. La segunda copia (rosa o amarilla) es más clara. Para la tercera copia (azul o amarillo dorado), la presión del bolígrafo apenas se transfiere y los caracteres se convierten en imágenes fantasma — contornos tenues con trazos faltantes y contraste cercano a cero. Un escaneo estándar de un formulario de carbón de tercera copia produce una imagen gris sobre gris de la que la mayoría de las herramientas de OCR no pueden extraer texto alguno, y mucho menos escritura a mano.
Anotaciones de excepción no estructuradas. La información más significativa desde el punto de vista operativo en un POD suele ser la menos estructurada. Un conductor escribe "faltan 2 cajas" en el margen. Un empleado de recepción encierra un número en un círculo y escribe "RECHAZADO — daño por agua". Un destinatario escribe "por John" junto a la línea de firma en lugar de firmar. Estas notas no aparecen en campos designados ni en la misma ubicación en los formularios de diferentes transportistas, pero contienen la información que determina si un envío se acepta, se cuestiona o se rechaza — y deben capturarse para que los flujos de facturación y reclamaciones funcionen.
Manifiestos de entrega con múltiples paradas. Una sola hoja de POD a menudo cubre de tres a cinco paradas de entrega en la misma ruta — cada parada es una sección separada en el mismo formulario, separada por una línea impresa o un salto de sección numerado. La extracción debe distinguir dónde termina la parada 1 y comienza la parada 2, o el resultado completo colapsa en filas combinadas con cantidades mal atribuidas. Este es un problema más difícil que leer cualquier campo individual: requiere comprender el diseño del documento a nivel de sección, no solo a nivel de campo.
El flujo de trabajo: del portapapeles del conductor a la importación en el TMS
Para entender cómo encaja la extracción de POD en una operación logística real, conviene trazar el flujo de trabajo de extremo a extremo que existe hoy en la mayoría de las corredurías de carga y 3PL.
El conductor completa la entrega: captura el POD
El conductor obtiene una firma en un formulario de carbono de varias copias o toma una foto del recibo firmado con su teléfono. Para los transportistas nacionales (FedEx, UPS), el POD se captura electrónicamente y se sube al portal del transportista en cuestión de minutos. Para los transportistas regionales de LTL y los propietarios-operadores, el formulario en papel va a una carpeta de viaje.
El POD llega a la oficina central, con demora
Los POD en papel llegan a la oficina cuando el conductor regresa a la base: al final del día, a la mañana siguiente o al final de la semana para los viajes de larga distancia. Los POD electrónicos de los portales de los transportistas se descargan en lotes. Ambos llegan a la misma cola: una pila de documentos que esperan el ingreso de datos.
El empleado de ingreso de datos escribe los campos en el TMS
Por cada POD, el empleado lee el número de entrega, la fecha, el nombre del destinatario, la cantidad recibida, el estado de la firma y las notas de excepción, y luego los escribe en el registro de envío del TMS. Plataformas como MercuryGate, McLeod LoadMaster, TMW Suite (Trimble), Descartes y Turvo esperan datos de envío estructurados para procesar la facturación y las notificaciones al cliente. A 3 minutos por POD y 200 POD por día, este paso consume un puesto de trabajo a tiempo completo por cada 100-120 entregas diarias.
La facturación genera facturas, demorada por la brecha de datos
El TMS solo puede facturar las entregas que tienen datos de POD confirmados. Hasta que se ingresen los campos, la entrega queda en estado de "confirmación pendiente". Con 200 entregas por día, ese atraso significa que la facturación funciona con un desfase de 2 a 4 días, todas las semanas, todos los meses.
Los reclamos y las disputas requieren la consulta del POD, a menudo manual
Cuando un embarcador presenta un reclamo de carga bajo el marco de la Enmienda Carmack, el corredor o el 3PL debe presentar el POD para verificar las condiciones de la entrega. Con archivos en papel o PDF escaneados almacenados por fecha de envío, una sola consulta toma de 15 a 30 minutos de recuperación de archivos. Con datos estructurados (cada POD como una fila en una hoja de cálculo), la misma consulta toma 5 segundos.
El flujo de extracción reemplaza el paso 3 (ingreso manual de datos) con extracción automatizada, reduciendo la demora de 2 a 4 días del paso 4 a facturación el mismo día o al día siguiente. La clave es que la extracción no requiere reemplazar el TMS, cambiar de transportistas ni implementar nuevo hardware. Se integra al flujo de trabajo existente en el punto donde el papel se encuentra con el teclado.
Cómo Extraer Datos de POD: Paso a Paso
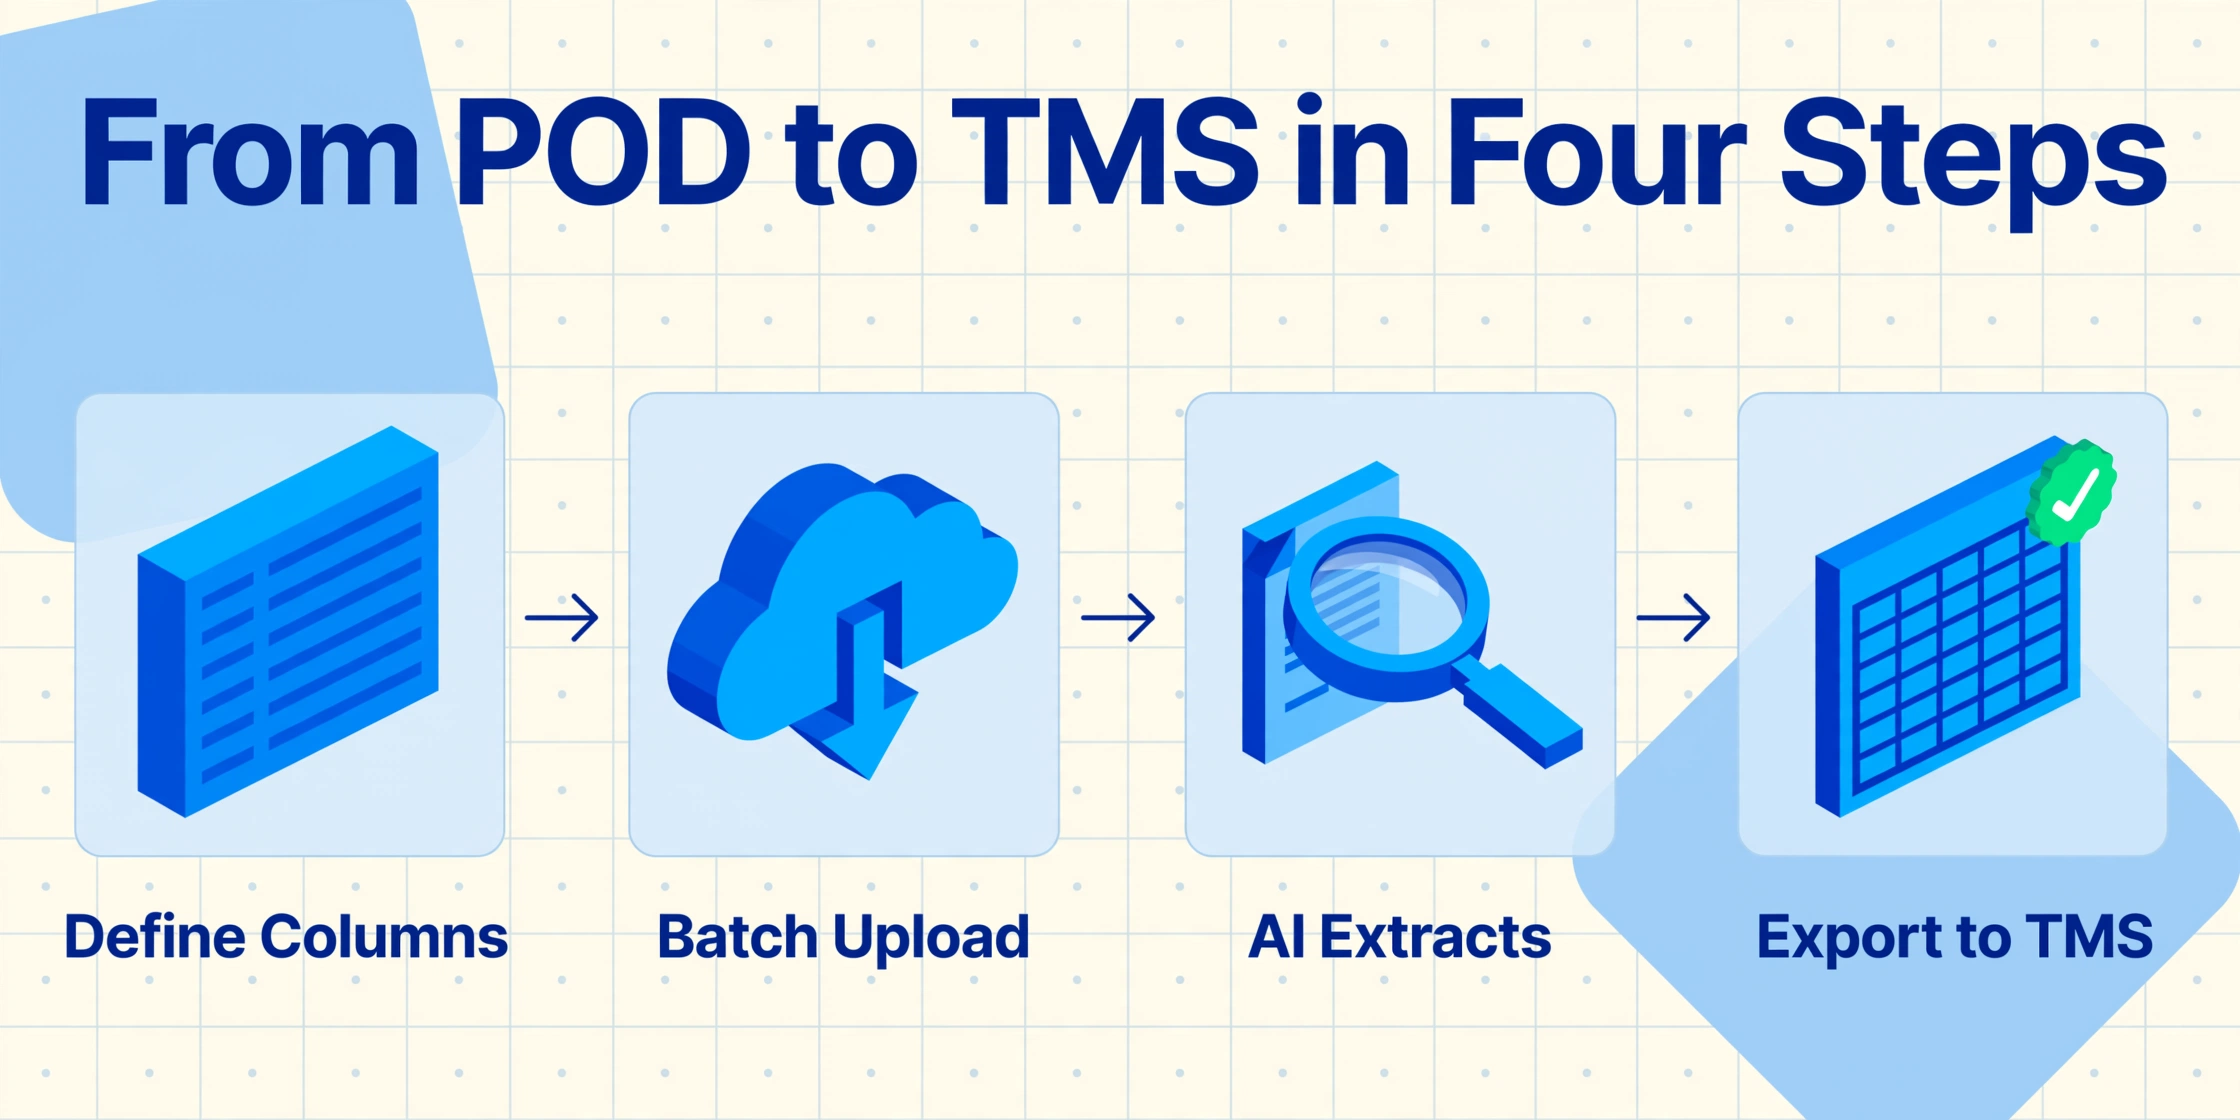
El proceso de extracción sigue el mismo flujo de procesamiento por lotes sin código que aplica a facturas, listas de empaque y conocimientos de embarque — pero los POD requieren definiciones de columnas específicas y manejo de formatos que reflejan sus características únicas.
Defina sus columnas de extracción para que coincidan con su plantilla de importación del TMS
Escriba los nombres de las columnas que desea en la hoja de cálculo de salida. Los nombres de columna que escriba se convierten tanto en las instrucciones de extracción como en los encabezados de la hoja de cálculo. Para flujos de trabajo de comprobante de entrega, las columnas esenciales coinciden con lo que su TMS espera:
Número de entrega / Número PRO— se vincula al registro de envío del TMSFecha de entrega— fecha de la entrega físicaHora de entrega— hora de la entregaConsignatario / Nombre del destinatario— quién recibió la mercancíaDirección de entrega— ubicación real de la entrega (puede diferir de la dirección del conocimiento de embarque (BOL))Cantidad enviada vs. Cantidad recibida— seguimiento de discrepanciasEstado de la firma— Firmado / No firmadoNotas de condición / Notas de excepción— anotaciones de daños, faltantes, rechazosNombre del conductor— quién realizó la entrega
Asigne a estas columnas los nombres de los campos de importación de su TMS siempre que sea posible; esto evita el paso de reformateo que consume el ahorro de tiempo de la automatización. Una columna llamada PRO_NUMBER que se asigna directamente a su plantilla de importación de MercuryGate o McLeod vale más que una llamada "ID de POD" que requiere un paso de reasignación.
Cargue los POD del día en lote
Cargue todos los archivos POD — copias carbón escaneadas, fotos de teléfono de formularios manuscritos, descargas de PDF del portal del transportista — en un solo lote. La IA los procesa en paralelo usando sus definiciones de columnas. No es necesario clasificar por transportista o tipo de formulario antes de cargar. Para obtener los mejores resultados con copias carbón: use un escáner de cama plana a 300 DPI o más para las terceras copias; las fotos de teléfono a resolución estándar son suficientes para las copias superiores y los PDF electrónicos. Para obtener más información sobre cómo capturar documentos sin escáner, consulte nuestra guía sobre digitalizar documentos con su teléfono.
Extraiga y revise
La IA lee cada POD y completa las columnas que definió. Para copias carbón manuscritas, el modelo de visión de la IA infiere caracteres a partir del contexto: un "12" borroso junto a "CANT. RECIBIDA" tiene más probabilidades de ser "12" que "14" porque la IA entiende lo que constituye una cantidad de entrega razonable. Revise los campos de baja confianza marcados; para la mayoría de las copias superiores de POD con escritura clara, el 85-95% de los campos se extraen correctamente sin corrección.
Exportar e importar en su TMS
Exporte los resultados como Excel o CSV. La salida es una hoja de cálculo con una fila por POD, no por transportista ni por archivo, con columnas que coinciden con los nombres que definió. Importe el archivo en su TMS mediante su función estándar de importación CSV. Plataformas como MercuryGate, McLeod LoadMaster, TMW Suite, Descartes y Turvo admiten la importación de archivos estructurados con asignación de columnas. La importación toma minutos en lugar de horas y, como los nombres de las columnas se configuraron para coincidir con la plantilla del TMS en el paso 1, el paso de asignación es una configuración única.
Para operaciones que quieren omitir por completo el ciclo de exportación e importación de archivos, el complemento de Google Sheets puede escribir los resultados de extracción directamente en una hoja de cálculo que alimenta un pipeline de importación al TMS o un panel de seguimiento interno — misma extracción, un paso menos de transferencia de archivos.
Por Qué los Formatos de Múltiples Transportistas No Requieren Plantillas por Transportista
Esta es la pregunta que detiene a la mayoría de los equipos de logística al considerar la extracción: "Recibimos POD de 15 transportistas diferentes, cada uno con un formato de formulario distinto. ¿Eso significa que necesitamos 15 plantillas?"
Con herramientas de extracción basadas en plantillas — la generación que incluye a Docparser, Parseur y la mayoría de los enfoques OCR zonales — la respuesta es sí. El formato de cada transportista requiere una configuración de análisis separada: dibujar recuadros alrededor del campo de número de entrega en el formulario del Transportista A, dibujar recuadros diferentes en el formulario del Transportista B, y mantener cada uno cuando el transportista actualiza su formato. Para un agente de carga que recibe POD de docenas de transportistas, esta carga de mantenimiento de plantillas supera rápidamente el ahorro de tiempo de la automatización.
Extracción por nombre de columna — el enfoque utilizado por ImageToTable.ai — funciona de manera diferente. En lugar de definir posiciones de campos, usted define significados de campos. Escribe "Fecha de Entrega" como nombre de columna una vez, y el modelo de visión de la IA localiza el valor correspondiente en cada POD al comprender qué es una fecha de entrega — no al buscar texto en una coordenada fija. Un POD de FedEx SmartPost donde la fecha de entrega está en la esquina superior derecha, un formulario de un transportista regional LTL donde se imprime en un bloque central, y un comprobante manuscrito de un propietario-operador donde el conductor la escribió junto a "FECHA" pasan todos por la misma definición de columna con cero configuración por transportista. Este es el patrón de extracción de IA sin plantilla: el motor de extracción lee por significado, no por ubicación.
El impacto práctico para operaciones de logística: puede procesar por lotes 200 POD de 20 transportistas diferentes en una sola carga, definir sus columnas una vez y obtener una hoja de cálculo consolidada. Sin clasificación previa por transportista. Sin configuración de plantillas por transportista. Sin mantenimiento cuando un transportista actualiza el diseño de su formulario.
Gestión de Manifiestos de Múltiples Paradas: El Caso de POD Más Difícil
Una hoja de POD que cubre tres paradas de entrega parece tres mini-formularios separados impresos en la misma página, divididos por una línea horizontal o una sección numerada. Cada parada tiene su propio número de entrega, destinatario, cantidad y firma. La extracción debe reconocer estos límites de sección y asignar cada fila a la parada correcta — o la salida del lote completo fusiona las entregas y se vuelve inutilizable.
Aquí es donde la extracción semántica demuestra su valor. La IA lee el documento a nivel de diseño — reconoce que una línea horizontal a lo largo de la página seguida de un nuevo encabezado "Parada 2" representa un límite de sección, no un artefacto de formato. La salida asigna a cada parada su propia fila en la hoja de cálculo, con los campos atribuidos al segmento de entrega correcto. Esto no es perfecto en todos los documentos — los límites de sección en formularios mal escaneados o extremadamente compactados pueden ser ambiguos — pero maneja de manera confiable la mayoría de los manifiestos impresos de múltiples paradas. La evaluación honesta: si su operación procesa regularmente manifiestos de múltiples paradas en una sola hoja, presupueste tiempo de revisión específicamente para la atribución de secciones, particularmente cuando los marcadores de límite están desvanecidos o escritos a mano.
Vinculación de Datos de POD con Conocimientos de Embarque y Listas de Empaque
Los POD no existen de forma aislada. Son el eslabón final en una cadena de documentos que comienza con el conocimiento de embarque (emitido en la recogida) e incluye la lista de empaque (que detalla el contenido), la nota de entrega (adjunta al envío) y el POD (firmado en la entrega). Cada documento en esta cadena contiene información superpuesta pero distinta, y emparejarlos es lo que crea un registro completo del envío.
El mismo flujo de extracción que procesa PODs puede procesar conocimientos de embarque y listas de empaque en lotes separados o en el mismo lote — usando el número PRO o el número de entrega como clave de vinculación. Cuando el POD confirma la entrega de 12 pallets pero el BOL muestra 14 enviados, la discrepancia surge como un punto de datos estructurado antes de convertirse en una disputa de facturación. Para un análisis más detallado del lado del BOL en este flujo, consulte cómo los datos extraídos del BOL se integran en su TMS.
Para operaciones que manejan documentos de recepción escritos a mano en entornos de almacén — donde el conductor presenta una nota de entrega en papel y el empleado de recepción anota manualmente cantidades y condiciones — el flujo de extracción de POD sigue el mismo enfoque de nombres de columnas que el utilizado para la extracción por lotes de listas de empaque y notas de entrega. La misma configuración de columnas que lee los POD también puede leer notas de mercancías recibidas y manifiestos de almacén, creando un panel de recepción unificado a partir de documentos capturados en diferentes puntos de la cadena de entrega. Para el paso a paso sobre cómo leer tanto los datos de envío impresos como las marcas de recepción escritas a mano en una nota de entrega firmada, consulte nuestra guía sobre extracción de notas de entrega escritas a mano en la recepción de almacén.
Para obtener la imagen completa de la nota de entrega/POD — por qué estos documentos son más difíciles de extraer que las facturas, qué campos son más importantes para la conciliación y cómo evaluar las herramientas — comience con nuestra guía completa sobre extracción de notas de entrega y POD. Para probar la extracción en su propio POD ahora mismo, use el convertidor de notas de entrega a Excel.
Dónde funciona bien — y dónde requiere revisión humana
Toda herramienta de extracción tiene límites de precisión, y los POD los exponen más rápido que la mayoría de los tipos de documentos. Ser específico sobre lo que la IA maneja bien — y lo que no — establece expectativas precisas y construye un flujo de trabajo que realmente ahorra tiempo en lugar de crear una nueva carga de verificación.
Funciona bien:
- Formularios de carbón de copia superior (blanca) con escritura a mano clara en bloques — la precisión alcanza hasta el 99% en campos inequívocos como números de entrega impresos y fechas
- PODs electrónicos de transportistas nacionales (FedEx, UPS, DHL) — texto impreso por máquina con etiquetas de campo consistentes
- Detección de presencia de firma — la IA confirma si existe una marca de firma en el campo de firma, generando "Firmado" o "No firmado"
- Etiquetas de campo impresas e información del transportista prellenada
- Anotaciones estándar de excepción ("faltan 2," "1 caja aplastada") en el área de observaciones — cuando la letra es legible
Requiere revisión humana:
- Formularios de carbón de tercera copia (azul/amarilla) — el contraste es demasiado bajo para una lectura automatizada confiable; espere revisar la mayoría de los campos escritos a mano
- Detección de límites de sección en manifiestos de múltiples paradas — particularmente cuando las líneas separadoras son guiones tenues escritos a mano en lugar de reglas impresas
- Formularios dañados por lluvia o arrugados — la degradación ambiental reduce la extracción proporcionalmente
- Identidad de la firma — la IA confirma que hay una firma presente, pero no verifica la identidad del firmante contra una muestra conocida
- Fotos de daños adjuntas al POD — la IA extrae texto del formulario en sí, pero no interpreta el contenido de las fotografías adjuntas
Para un marco práctico de verificación que detecta el 95% de los errores de extracción mientras revisa menos del 10% de sus datos, consulte nuestra guía sobre verificación de resultados de extracción con muestreo dirigido. Para solucionar problemas específicos de extracción de escritura a mano — incluyendo qué hacer cuando su herramienta de OCR o IA lee mal campos críticos — consulte nuestra guía sobre por qué el OCR falla con la escritura a mano y cómo solucionarlo.
El ahorro de tiempo práctico para una operación logística que procesa 200 PODs por día: en lugar de leer cada formulario línea por línea y escribir 15-20 campos desde cero, el operador revisa una tabla prellenada y corrige los 3-5 campos marcados por documento. Eso es aproximadamente 600-1,000 campos marcados revisados de 3,000-4,000 campos extraídos en total por día — una reducción del 75-85% en el manejo manual de datos, lo que se traduce en aproximadamente 1-1.5 horas de revisión en lugar de 6-8 horas de entrada de datos completa.
Preguntas Frecuentes
¿La IA puede extraer datos de copias al carbón de POD donde el texto es muy tenue?
Sí, pero la precisión depende de la copia. Las copias blancas (superior) se extraen de forma fiable. Las copias rosas (segunda) son más claras pero aún legibles. Las copias azules o amarillas (tercera) tienen un contraste tan bajo que la mayoría de las extracciones por IA — independientemente del proveedor — producen resultados poco fiables. Para terceras copias, use un escáner de cama plana a 600 DPI con realce de contraste y prevea una revisión humana completa del resultado.
¿Necesito una plantilla diferente para cada formato de POD de cada transportista?
No, con la extracción sin plantillas. Usted define las columnas que desea una vez — Número de Entrega, Fecha de Entrega, Destinatario, Cantidad, Estado de Firma — y la IA localiza los valores correspondientes en cualquier POD de cualquier transportista al comprender lo que cada campo significa. Un POD de FedEx, un recibo de entrega de UPS, un formulario carbón de un transportista LTL regional y un comprobante manuscrito de un propietario-operador se procesan con las mismas definiciones de columna. Sin configuración ni mantenimiento de plantillas por transportista.
¿Puede la IA detectar si un POD ha sido firmado?
Sí. La IA detecta la presencia de una marca manuscrita en el campo de firma y genera un estado "Firmado / No Firmado". Esto es suficiente para confirmar que alguien en la ubicación de recepción reconoció la entrega, lo cual es adecuado para la mayoría de los flujos de facturación. No verifica la identidad del firmante ni compara la firma con una muestra; la verificación de firmas requiere un proceso biométrico o forense independiente.
¿Cómo manejo los POD donde hay notas de daños o excepciones escritas en los márgenes?
Defina una columna llamada "Notas de Excepción" o "Notas de Daños" en su configuración de extracción. La IA escanea todo el documento — incluidos márgenes, espacios vacíos alrededor del formulario y anotaciones manuscritas junto a los campos impresos — en busca de contenido que describa excepciones de entrega. Captura tanto anotaciones de daños estructuradas ("1 caja aplastada — rechazada") como garabatos marginales no estructurados ("faltan 2"). La clave es que la IA busca este contenido por significado (texto que describe una excepción de entrega) en lugar de por ubicación (texto en un recuadro específico).
¿Puedo extraer datos de PODs con múltiples paradas donde una hoja cubre 3-5 entregas?
La extracción con IA puede manejar manifiestos de múltiples paradas reconociendo los límites de las secciones — líneas impresas, reglas separadoras o encabezados de sección numerados — y asignando los datos de cada parada a una fila separada en el resultado. Esto funciona de manera confiable en formularios impresos de múltiples paradas con marcadores de sección claros. Es menos confiable en formularios donde los límites de las secciones están escritos a mano o donde las paradas se superponen visualmente en una página mal escaneada. Para operaciones que procesan grandes volúmenes de manifiestos de múltiples paradas, presupueste tiempo de revisión para la asignación de secciones, particularmente en copias al carbón o formularios dañados por la lluvia.
¿Cómo encaja la extracción de POD con mi TMS existente (MercuryGate, McLeod, TMW, etc.)?
El resultado de la extracción es un archivo Excel o CSV estándar que cualquier TMS puede importar. Los nombres de las columnas que defina durante la extracción se pueden configurar para que coincidan con los nombres de los campos de importación de su TMS, lo que significa que no es necesario reasignar manualmente entre el resultado de la extracción y la importación del TMS. La mayoría de las plataformas, incluidas MercuryGate, McLeod LoadMaster, TMW Suite, Descartes, Trimble y Turvo, aceptan importaciones CSV estructuradas. La extracción reemplaza la entrada manual de datos en el teclado; el TMS continúa manejando el seguimiento de envíos, la facturación y la comunicación con el transportista como antes.
¿Qué sucede cuando un campo del POD está en blanco?
La IA deja los campos en blanco vacíos en el resultado. Un POD sin notas de daños tendrá una celda "Notas de Excepción" vacía; la IA no inventará contenido ni completará valores predeterminados. Esto es importante para los resultados por lotes porque las celdas en blanco preservan la alineación de las columnas y la estructura de las filas. Al importar a un TMS, los campos vacíos se transmiten como valores nulos, que la mayoría de las plataformas manejan sin errores.
Comience a Extraer Datos de POD en Sus Propios Documentos
La brecha de cuatro días entre la entrega y la factura no existe porque sus transportistas sean lentos o su equipo tenga poco personal. Existe porque los datos que demuestran que una entrega ocurrió están en papel, en un formato que debe leerse y escribirse a mano. El flujo de extracción descrito en este artículo — defina las columnas una vez, cargue por lotes todos los POD sin importar el transportador o el formato, exporte los datos estructurados a su TMS — elimina el paso de escritura sin cambiar nada sobre cómo sus conductores entregan o cómo operan sus transportadores.
No es necesario implementar software ePOD en cada transportador ni capacitar a los conductores para usar una nueva aplicación. Los POD en papel que ya recibe — PDF de transportadores, fotos de conductores, copias al carbón del portapapeles — pueden ingresar al flujo de extracción hoy mismo, a través de la misma interfaz de carga que procesa facturas y albaranes. Los datos que han llegado en papel durante décadas se convierten en una hoja de cálculo estructurada y buscable antes de que cierre la facturación del día.
Pruebe con sus propios POD. Vea si 8 horas de ingreso de datos diario se convierten en una sesión de revisión de 1 hora.
Cargue un POD de muestra — cualquier transportador, cualquier formato — y vea el resultado de la extracción en segundos. No se requiere cuenta.