Comment extraire les données de preuve de livraison (POD)
vers Excel pour les opérations logistiques
L'American Transportation Research Institute (ATRI) rapporte que le coût d'exploitation moyen du camionnage a atteint 2,26 $ par mile en 2025, avec des coûts hors carburant atteignant un niveau record de 1,779 $ par mile. Le segment du chargement complet a fonctionné avec une marge négative de 2,3 %. Lorsque les marges sont aussi minces, un délai de quatre jours entre l'achèvement de la livraison et la génération de la facture n'est pas un problème administratif — c'est un problème de délai de recouvrement des créances (DSO) qui s'aggrave à chaque chargement, chaque semaine, chaque trimestre. L'écart existe parce que les données qui prouvent qu'une livraison a eu lieu se trouvent sur une feuille de papier dans la cabine d'un camion, et non dans une base de données. Extraire ces données dans un format structuré — Excel, CSV ou import direct dans le TMS — est la mesure d'automatisation la plus rentable qu'une opération logistique puisse prendre sans modifier une seule relation avec un transporteur.
Points clés à retenir
- Chaque lot de 200 POD qui arrivent sur papier occupe une personne à la saisie pendant 8,5 heures par jour, et le retard de facturation de quatre jours qui s'ensuit est un problème de DSO qui s'aggrave à chaque chargement, chaque semaine.
- Votre écart de facturation de quatre jours n'est pas un problème d'effectifs — c'est la vitesse à laquelle le papier signé passe de la cabine du camion au bureau, et aucune embauche ne fera avancer un presse-papiers plus vite.
- Définissez les colonnes d'extraction une seule fois en fonction de la signification du champ plutôt que de sa position, et 200 POD provenant de 15 transporteurs se regroupent en une seule feuille de calcul examinée en une heure au lieu d'être saisies sur huit.
Le goulot d'étranglement des données POD dans chaque opération logistique
Les documents de preuve de livraison se situent à l'intersection de quatre flux de travail opérationnels qui dépendent tous des mêmes données : la facturation a besoin de la confirmation de livraison pour générer les factures, le service client en a besoin pour répondre aux demandes « où est ma livraison », les réclamations en ont besoin pour vérifier si les marchandises sont arrivées en bon état, et le règlement des transporteurs en a besoin pour libérer le paiement. Lorsque la source de données est un formulaire papier signé qui met quatre jours à atteindre le système de facturation, chaque flux de travail en aval fonctionne en retard.
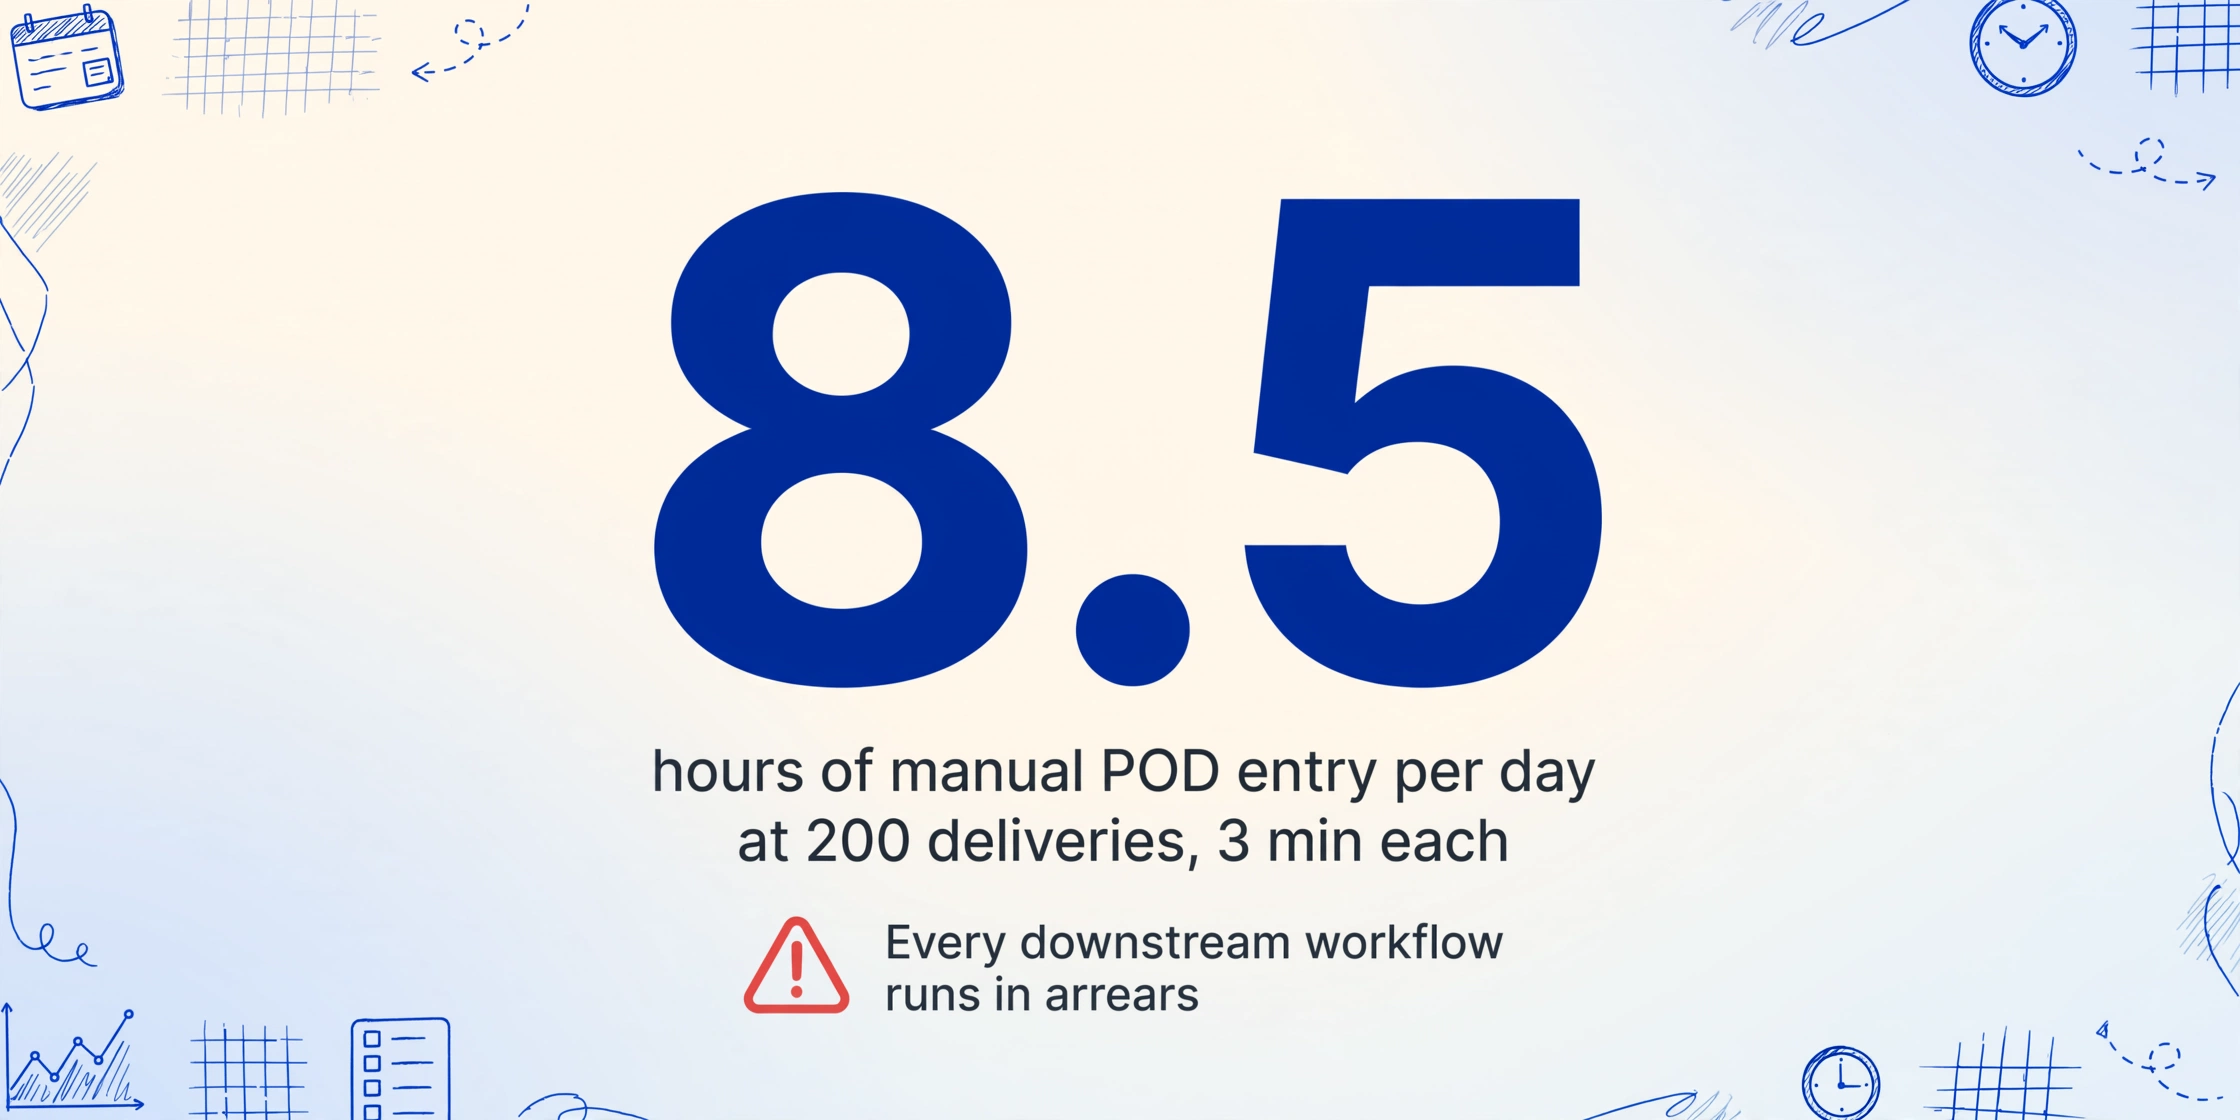
L'arithmétique est simple. Un courtier de fret ou un 3PL de taille moyenne traitant 200 livraisons par jour reçoit les POD sous trois formats : des PDF électroniques des transporteurs nationaux (FedEx, UPS, DHL), des images numérisées des transporteurs régionaux LTL, et des formulaires carbone manuscrits des propriétaires-exploitants et des petites flottes. Les PDF électroniques peuvent représenter 15 % du volume — le reste arrive sous forme d'images et de papier qui nécessitent que quelqu'un examine chaque formulaire et saisisse 12 à 20 champs dans une file d'attente du Système de gestion du transport (TMS). À 3 minutes par POD pour la saisie manuelle, cela représente 8,5 heures de frappe par jour pour 200 livraisons, et la personne qui le fait n'est presque certainement pas celle que l'opération préférerait voir consacrer son temps aux relations clients ou aux négociations avec les transporteurs.
L'Amendement Carmack (49 U.S.C. §14706), qui régit la responsabilité des transporteurs pour les expéditions interétatiques aux États-Unis, ajoute une autre dimension à ce goulot d'étranglement. En vertu de Carmack, les transporteurs doivent accepter les avis écrits de réclamation pour perte ou dommage dans un délai minimum de neuf mois après la livraison — mais prouver ce qui s'est passé à la livraison dépend du POD. Lorsqu'un litige survient concernant une expédition incomplète ou un dommage masqué, le POD est la principale preuve de ce qui a été reçu. Si les données du POD sont enfermées dans un fichier papier qui met deux heures à localiser, le délai de résolution du litige passe de quelques heures à plusieurs jours. Une base de données POD consultable — où chaque date de livraison, nom du destinataire, quantité et note d'exception est un champ structuré — réduit ce temps de recherche à quelques secondes.
L'impact sur le DSO s'accumule silencieusement. Quatre jours entre la livraison et la facture signifie que vos cycles de fonds de roulement incluent un décalage intégré qu'aucune négociation sur les délais de paiement ne peut corriger — car le retard se situe dans votre pipeline de données, pas dans le comportement de paiement de votre client.
Ce que contient une POD — et pourquoi elle est plus difficile à numériser qu'un BOL
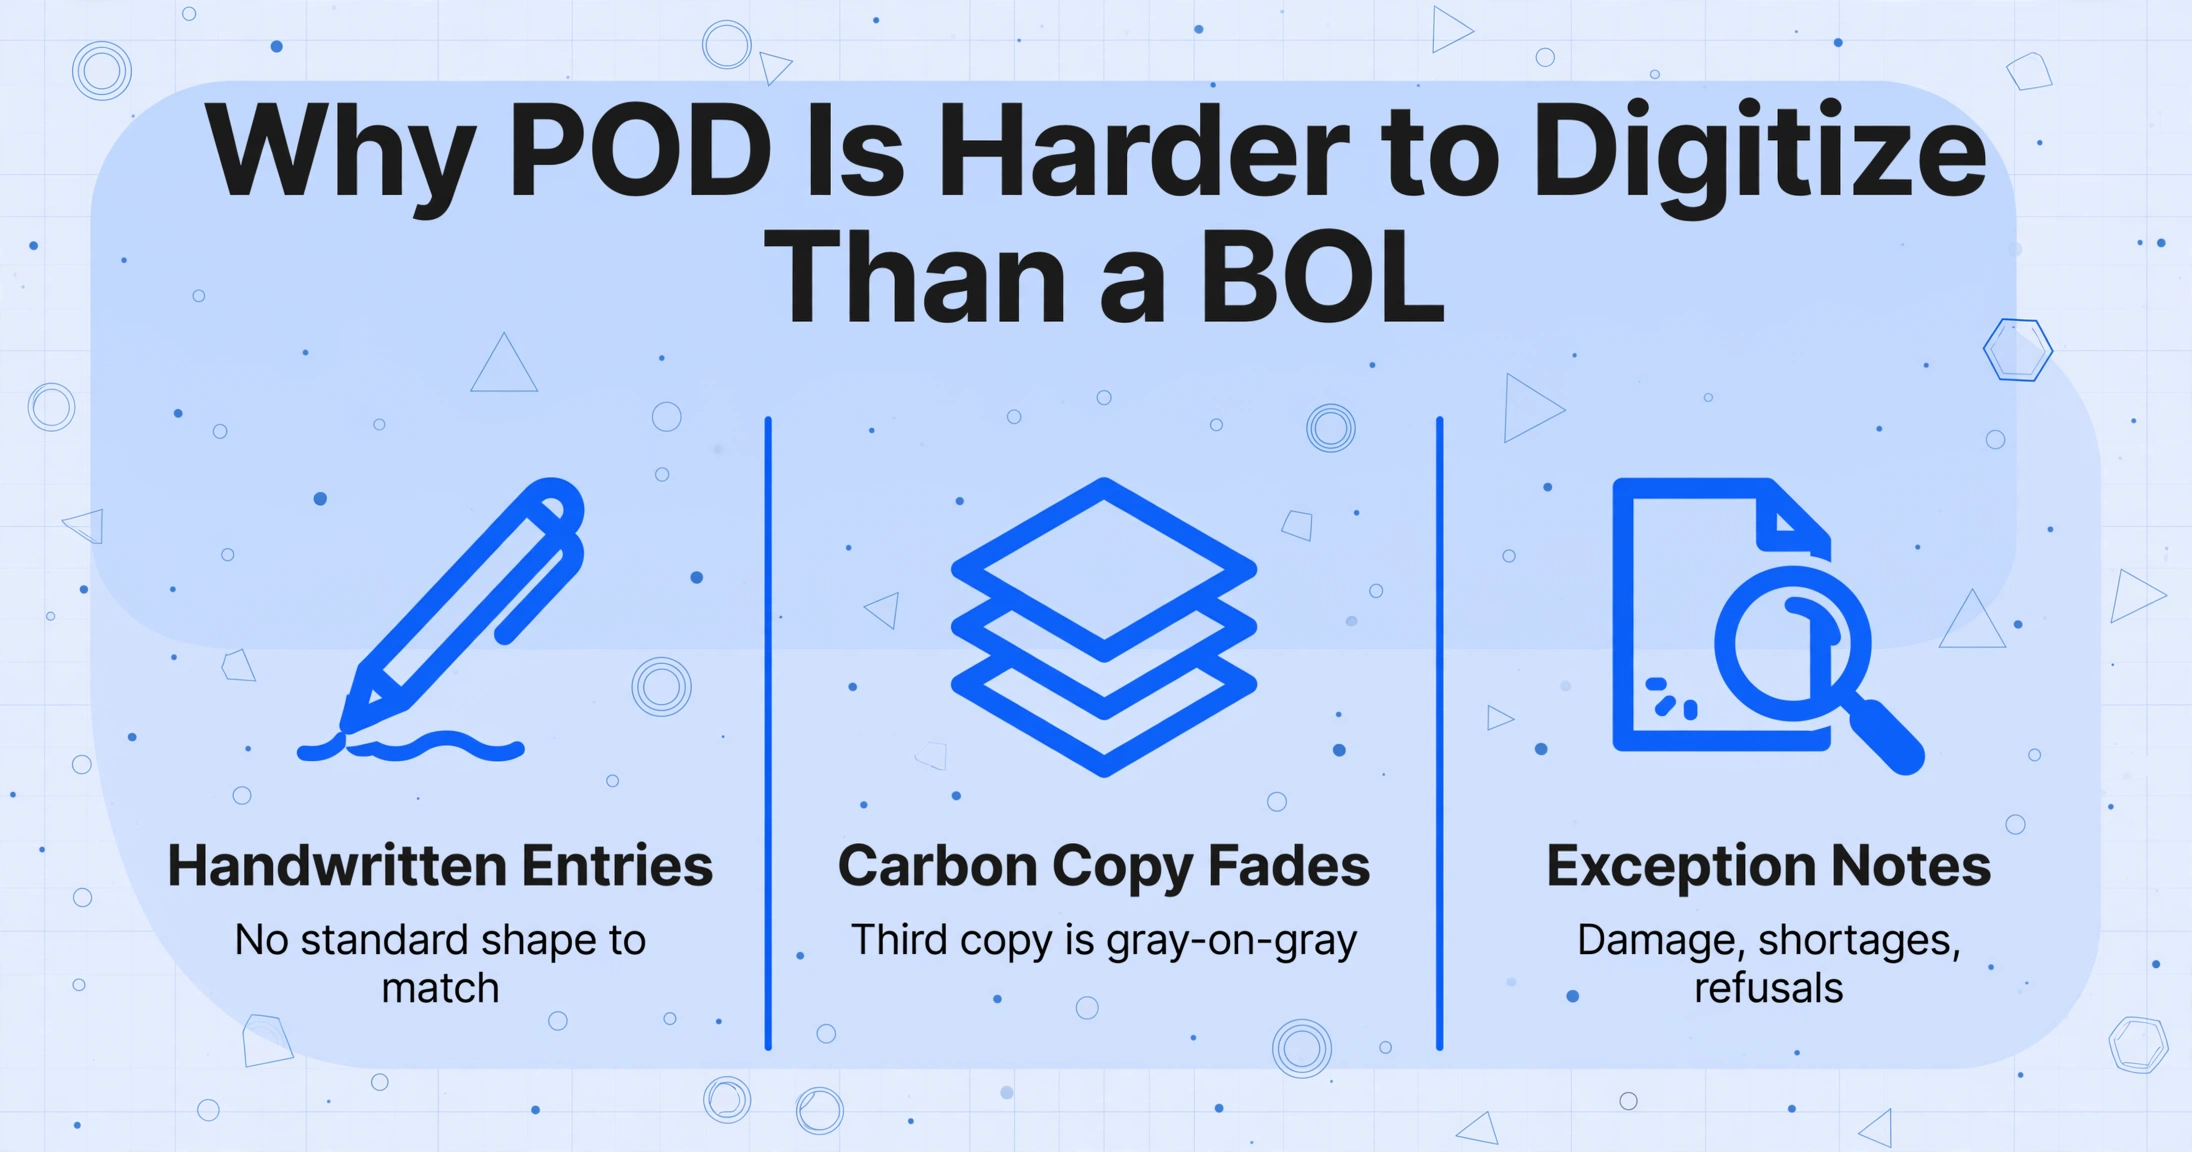
Un document de preuve de livraison semble simple en apparence — un formulaire avec quelques champs confirmant que les marchandises ont changé de mains. En pratique, il combine trois défis de traitement documentaire qui sont individuellement difficiles et, ensemble, uniques à ce type de document.
Signatures et saisies manuscrites. Le conducteur inscrit à la main l'heure de livraison, le nombre de palettes et toute note d'exception — souvent dans la cabine, sur un presse-papiers, après un quart de 14 heures régi par les règles de service de la FMCSA 49 CFR Part 395. Le destinataire signe et écrit parfois « reçu 12 sur 15 » ou « 1 carton écrasé — accepté » dans la marge. Aucun de ces échantillons d'écriture manuscrite n'a été produit à un bureau dans des conditions d'éclairage optimales. Les outils OCR traditionnels — qui segmentent les caractères imprimés en comparant leurs formes à des polices connues — échouent sur ce contenu car il n'existe aucune forme standard à comparer. Un « qté 12 » écrit à la hâte peut sembler identique à « qté 14 » pour un moteur de correspondance de caractères.
Dégradation des copies carbone. La plupart des POD papier sont des formulaires carbone multipartites. La copie supérieure (blanche) est lisible. La deuxième copie (rose ou jaune) est plus claire. Dès la troisième copie (bleue ou dorée), la pression du stylo se transmet à peine et les caractères deviennent des images fantômes — des contours pâles avec des traits manquants et un contraste proche de zéro. Un scan standard d'un formulaire carbone de troisième copie produit une image gris sur gris dont la plupart des outils OCR ne peuvent extraire aucun texte, sans parler de l'écriture manuscrite.
Annotations d'exception non structurées. L'information la plus importante sur le plan opérationnel d'une POD est souvent la moins structurée. Un conducteur écrit « manque 2 cartons » dans la marge. Un employé de réception encercle un nombre et écrit « REFUSÉ — dégâts des eaux ». Un destinataire écrit « selon John » à côté de la ligne de signature au lieu de signer. Ces notes n'apparaissent pas dans des champs désignés et ne se trouvent pas au même endroit sur les formulaires des différents transporteurs, mais elles contiennent l'information qui détermine si une expédition est acceptée, contestée ou refusée — et elles doivent être capturées pour que les flux de facturation et de réclamations fonctionnent.
Manifestes de livraison multi-arrêts. Une seule feuille POD couvre souvent trois à cinq arrêts de livraison sur le même itinéraire — chaque arrêt est une section distincte du même formulaire, séparée par une ligne imprimée ou un saut de section numéroté. L'extraction doit distinguer où l'arrêt 1 se termine et où l'arrêt 2 commence, sinon l'intégralité de la sortie s'effondre en lignes fusionnées avec des quantités mal attribuées. C'est un problème plus difficile que la lecture d'un champ unique : cela nécessite de comprendre la mise en page du document au niveau de la section, et non seulement au niveau du champ.
Le flux de travail : du presse-papiers du conducteur à l'importation dans le TMS
Pour comprendre comment l'extraction de POD s'intègre dans une opération logistique réelle, il est utile de cartographier le flux de travail de bout en bout qui existe dans la plupart des courtiers en fret et des 3PL aujourd'hui.
Le conducteur termine la livraison — capture le POD
Le conducteur obtient une signature sur un formulaire carbone multipartite ou prend une photo du reçu signé avec son téléphone. Pour les transporteurs nationaux (FedEx, UPS), le POD est capturé électroniquement et téléchargé sur le portail du transporteur en quelques minutes. Pour les transporteurs régionaux LTL et les propriétaires-exploitants, le formulaire papier est placé dans un dossier de voyage.
Le POD arrive au bureau — avec un délai
Les POD papier arrivent au bureau lorsque le conducteur revient à la base — en fin de journée, le lendemain matin, ou en fin de semaine pour le long-courrier. Les POD électroniques des portails des transporteurs sont téléchargés par lots. Les deux arrivent dans la même file d'attente : une pile de documents attendant la saisie des données.
L'agent de saisie tape les champs dans le TMS
Pour chaque POD, l'agent lit le numéro de livraison, la date, le nom du destinataire, la quantité reçue, le statut de la signature et les notes d'exception — puis les tape dans l'enregistrement d'expédition du TMS. Des plateformes comme MercuryGate, McLeod LoadMaster, TMW Suite (Trimble), Descartes et Turvo attendent toutes des données d'expédition structurées pour traiter la facturation et les notifications aux clients. À 3 minutes par POD et 200 POD par jour, cette étape consomme un poste à temps plein pour 100 à 120 livraisons quotidiennes.
La facturation génère des factures — retardée par l'écart de données
Le TMS ne peut facturer que les livraisons qui ont des données POD confirmées. Tant que les champs ne sont pas saisis, la livraison reste dans un statut « en attente de confirmation ». Sur 200 livraisons par jour, ce retard signifie que la facturation fonctionne avec un décalage de 2 à 4 jours — chaque semaine, chaque mois.
Les réclamations et litiges nécessitent une recherche de POD — souvent manuelle
Lorsqu'un expéditeur dépose une réclamation de cargaison dans le cadre de l'Amendement Carmack, le courtier ou le 3PL doit produire le POD pour vérifier les conditions de livraison. Avec des fichiers papier ou des PDF numérisés stockés par date d'expédition, une seule recherche prend 15 à 30 minutes de récupération de fichiers. Avec des données structurées — chaque POD comme une ligne dans une feuille de calcul — la même recherche prend 5 secondes.
Le flux d'extraction remplace l'étape 3 (saisie manuelle des données) par une extraction automatisée, réduisant le délai de 2 à 4 jours de l'étape 4 à une facturation le jour même ou le lendemain. L'essentiel est que l'extraction ne nécessite pas de remplacer le TMS, de changer de transporteur ou de déployer de nouveaux équipements. Elle s'intègre au flux existant au point où le papier rencontre le clavier.
Comment extraire les données POD : étape par étape
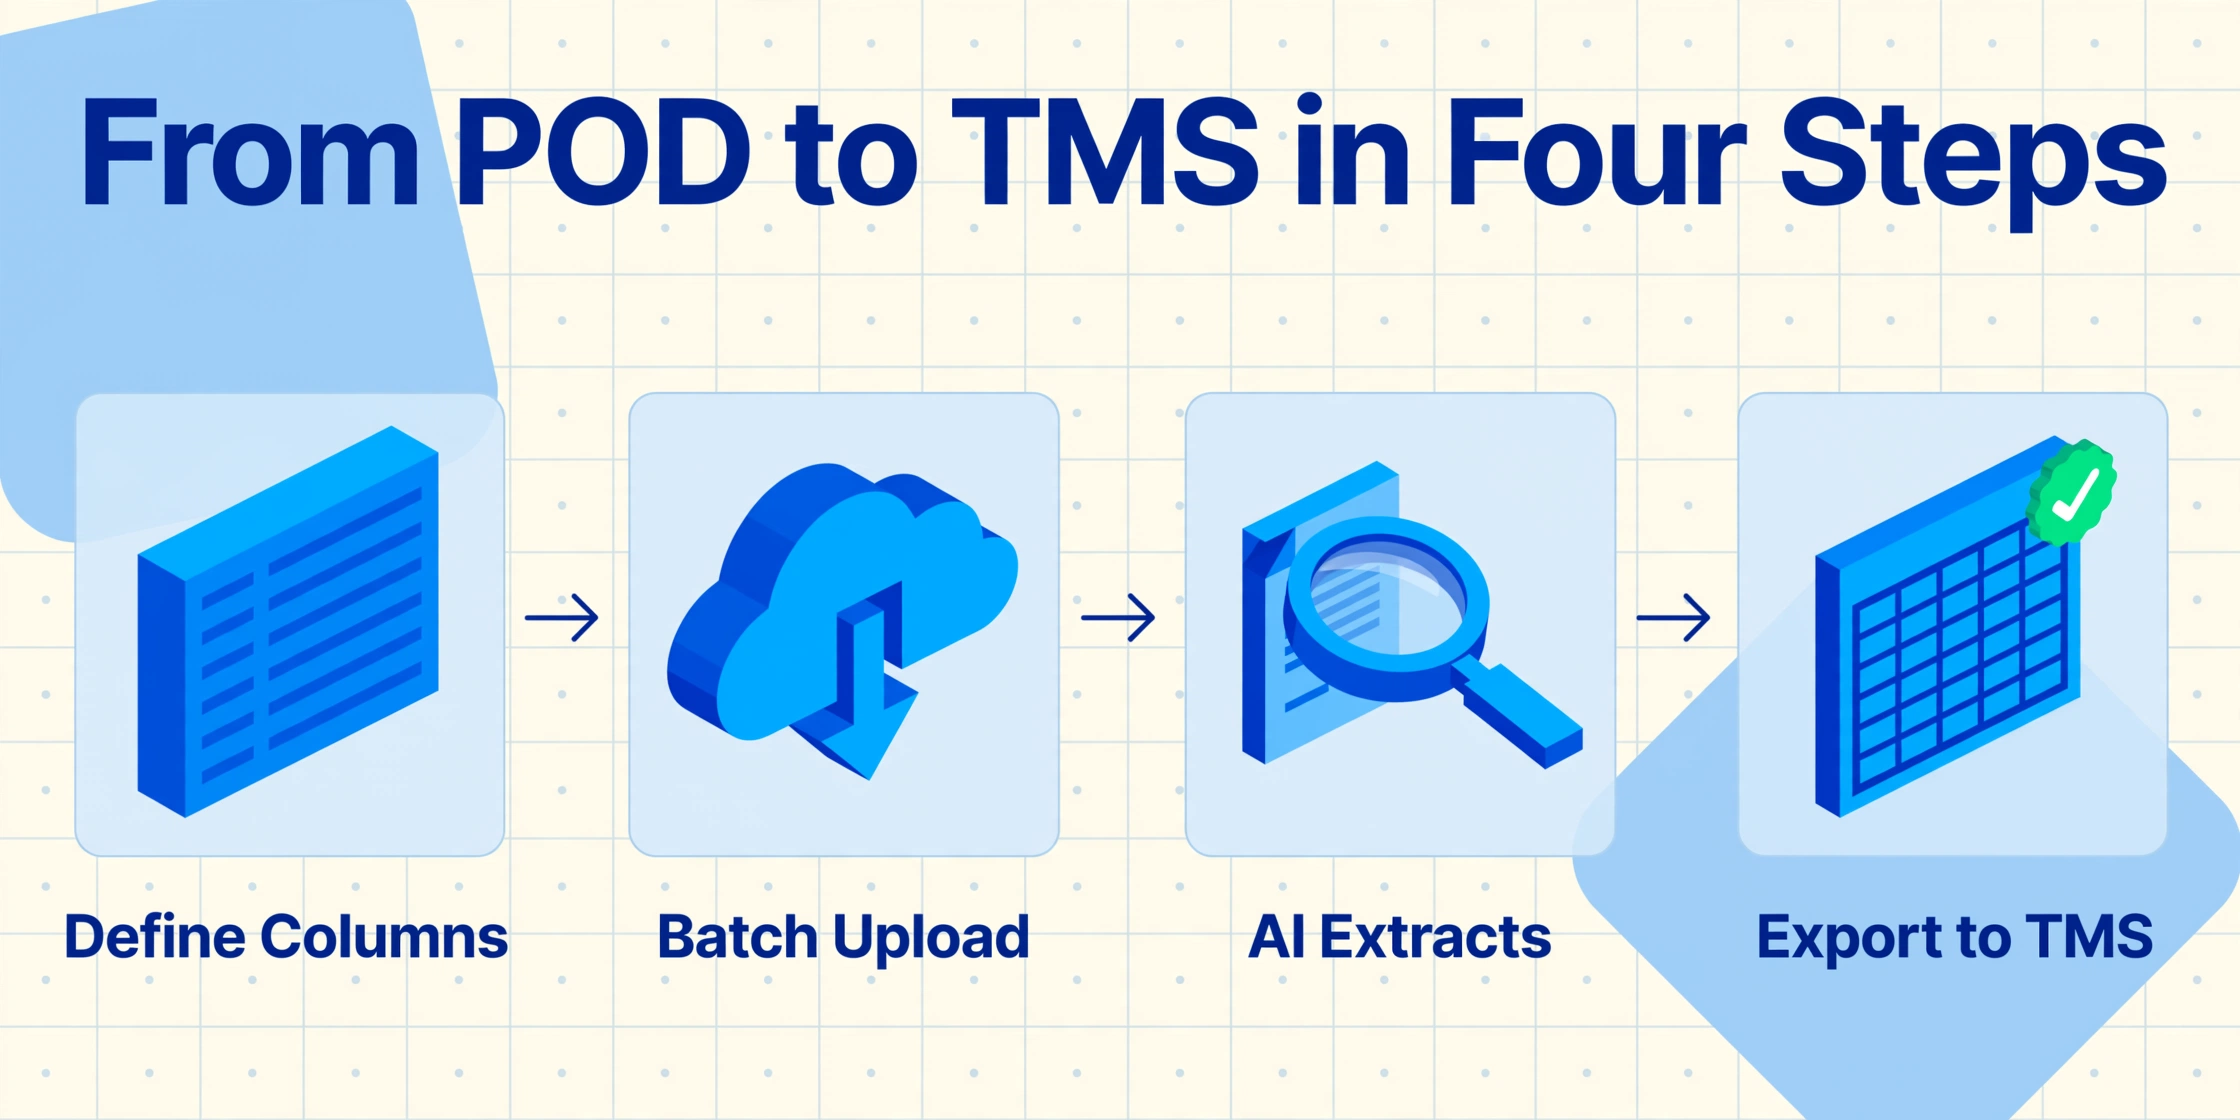
Le processus d'extraction suit le même flux de traitement par lots sans code qui s'applique aux factures, aux bordereaux d'expédition et aux connaissements — mais les POD nécessitent des définitions de colonnes et une gestion des formats spécifiques qui reflètent leurs caractéristiques uniques.
Définissez vos colonnes d'extraction pour correspondre à votre modèle d'importation TMS
Saisissez les noms de colonnes souhaités dans la feuille de calcul de sortie. Les noms de colonnes que vous saisissez deviennent à la fois les instructions d'extraction et les en-têtes de la feuille de calcul. Pour les flux de travail POD, les colonnes essentielles correspondent à ce que votre TMS attend :
Numéro de livraison / Numéro PRO— fait le lien avec l'enregistrement d'expédition du TMSDate de livraison— date de la livraison physiqueHeure de livraison— heure de la livraisonDestinataire / Nom du destinataire— qui a reçu la marchandiseAdresse de livraison— lieu de livraison réel (peut différer de l'adresse du connaissement)Quantité expédiée vs Quantité reçue— suivi des écartsStatut de la signature— Signé / Non signéNotes sur l'état / Notes d'exception— mentions de dommages, manquants, refusNom du conducteur— qui a effectué la livraison
Nommez ces colonnes pour qu'elles correspondent à vos noms de champs d'importation TMS dans la mesure du possible — cela évite l'étape de reformatage qui annule le gain de temps de l'automatisation. Une colonne nommée PRO_NUMBER qui mappe directement à votre modèle d'importation MercuryGate ou McLeod vaut plus qu'une colonne nommée « ID POD » qui nécessite une étape de remappage.
Téléversez les POD du jour par lots
Téléversez tous les fichiers POD — copies carbone scannées, photos de formulaires manuscrits prises au téléphone, téléchargements PDF depuis le portail du transporteur — en un seul lot. L'IA les traite en parallèle à l'aide de vos définitions de colonnes. Pas besoin de trier par transporteur ou par type de formulaire avant le téléversement. Pour de meilleurs résultats avec les copies carbone : utilisez un scanner à plat à 300 DPI ou plus pour les troisièmes copies ; les photos de téléphone en résolution standard suffisent pour les premières copies et les PDF électroniques. Pour en savoir plus sur la capture de documents sans scanner, consultez notre guide sur la numérisation de documents avec votre téléphone.
Extrayez et vérifiez
L'IA lit chaque POD et remplit les colonnes que vous avez définies. Pour les copies carbone manuscrites, le modèle de vision de l'IA déduit les caractères du contexte — un « 12 » flou à côté de « QTÉ REÇUE » est plus susceptible d'être « 12 » que « 14 », car l'IA comprend ce qui constitue une quantité de livraison raisonnable. Vérifiez les champs signalés comme à faible confiance ; pour la plupart des premières copies de POD avec une écriture claire, 85 à 95 % des champs sont extraits correctement sans correction.
Exporter et importer dans votre TMS
Exportez les résultats en Excel ou CSV. La sortie est une feuille de calcul avec une ligne par POD — pas par transporteur, pas par fichier — avec des colonnes correspondant aux noms que vous avez définis. Importez le fichier dans votre TMS à l'aide de sa fonction d'import CSV standard. Les plateformes comme MercuryGate, McLeod LoadMaster, TMW Suite, Descartes et Turvo prennent toutes en charge l'import de fichiers structurés avec mappage de colonnes. L'import prend des minutes au lieu d'heures, et comme les noms de colonnes ont été configurés pour correspondre au modèle TMS à l'étape 1, l'étape de mappage est une configuration unique.
Pour les opérations qui souhaitent éviter entièrement le cycle d'export-import de fichiers, le module complémentaire Google Sheets peut écrire les résultats d'extraction directement dans une feuille de calcul qui alimente un pipeline d'import TMS ou un tableau de bord de suivi interne — même extraction, une étape de transfert de fichier en moins.
Pourquoi les formats multi-transporteurs ne nécessitent pas de modèles multi-transporteurs
C'est la question qui arrête la plupart des équipes logistiques avant d'adopter l'extraction : « Nous recevons des POD de 15 transporteurs différents, chacun avec une mise en page différente. Cela signifie-t-il que nous avons besoin de 15 modèles ? »
Avec les outils d'extraction basés sur des modèles — la génération qui inclut Docparser, Parseur et la plupart des approches OCR zonales — la réponse est oui. La mise en page de chaque transporteur nécessite une configuration d'analyse distincte : dessiner des cadres autour du champ numéro de livraison sur le formulaire du transporteur A, dessiner des cadres différents sur le formulaire du transporteur B, maintenir chacun d'eux lorsque le transporteur met à jour sa mise en page. Pour un courtier en fret recevant des POD de dizaines de transporteurs, cette charge de maintenance de modèles dépasse rapidement le temps gagné grâce à l'automatisation.
Extraction par nom de colonne — l'approche utilisée par ImageToTable.ai — fonctionne différemment. Plutôt que de définir des positions de champs, vous définissez des significations de champs. Vous saisissez « Date de livraison » comme nom de colonne une seule fois, et le modèle de vision de l'IA localise la valeur correspondante sur chaque POD en comprenant ce qu'est une date de livraison — et non en cherchant du texte à une coordonnée fixe. Un POD FedEx SmartPost où la date de livraison se trouve dans le coin supérieur droit, le formulaire d'un transporteur régional LTL où elle est imprimée dans un bloc central, et le bordereau manuscrit d'un propriétaire-exploitant où le conducteur l'a écrite à côté de « DATE » passent tous par la même définition de colonne avec zéro configuration par transporteur. C'est le modèle d'extraction IA sans modèle : le moteur d'extraction lit par signification, pas par emplacement.
L'impact pratique pour les opérations logistiques : vous pouvez traiter par lots 200 POD de 20 transporteurs différents en un seul envoi, définir vos colonnes une seule fois et obtenir une feuille de calcul consolidée. Pas de pré-tri par transporteur. Pas de configuration de modèle par transporteur. Pas de maintenance lorsqu'un transporteur met à jour la conception de son formulaire.
Gestion des manifestes multi-arrêts : le cas POD le plus difficile
Une feuille POD unique couvrant trois arrêts de livraison ressemble à trois mini-formulaires distincts imprimés sur la même page, séparés par une ligne horizontale ou une section numérotée. Chaque arrêt possède son propre numéro de livraison, destinataire, quantité et signature. L'extraction doit reconnaître ces limites de section et attribuer chaque ligne au bon arrêt — sinon la sortie du lot fusionne les livraisons et devient inutilisable.
C'est ici que l'extraction sémantique démontre sa valeur. L'IA lit le document au niveau de la mise en page — elle reconnaît qu'une ligne horizontale suivie d'un nouvel en-tête « Arrêt 2 » représente une limite de section, et non un artefact de formatage. La sortie attribue à chaque arrêt sa propre ligne dans le tableur, avec les champs rattachés au bon segment de livraison. Ce n'est pas parfait sur chaque document — les limites de section sur des formulaires mal scannés ou extrêmement compacts peuvent être ambiguës — mais cela gère de manière fiable la majorité des manifestes multi-arrêts imprimés. L'évaluation honnête : si votre opération traite régulièrement des manifestes multi-arrêts sur une seule feuille, prévoyez du temps de vérification spécifiquement sur l'attribution des sections, en particulier lorsque les marqueurs de limite sont estompés ou manuscrits.
Croisement des données POD avec les connaissements et les bordereaux de colisage
Les POD n'existent pas isolément. Ils constituent le maillon final d'une chaîne documentaire qui commence avec le connaissement (émis au chargement) et inclut le bordereau de colisage (listant le contenu), le bon de livraison (joint à l'expédition) et le POD (signé à la livraison). Chaque document de cette chaîne contient des informations qui se chevauchent mais distinctes, et leur mise en correspondance crée un dossier d'expédition complet.
Le même flux d'extraction qui traite les POD peut traiter les connaissements et les bordereaux de colisage en lots séparés ou dans le même lot — en utilisant le numéro PRO ou le numéro de livraison comme clé de liaison. Lorsque le POD confirme la livraison de 12 palettes mais que le BOL en indique 14 expédiées, l'écart apparaît comme un point de données structuré avant de devenir un litige de facturation. Pour un aperçu plus détaillé du côté BOL de ce flux, voir comment les données BOL extraites alimentent votre TMS.
Pour les opérations qui gèrent des documents de réception manuscrits en entrepôt — où le conducteur présente un bon de livraison papier et le magasinier annoté manuellement les quantités et l'état — le flux d'extraction POD suit la même approche de noms de colonnes que celle utilisée pour l'extraction par lots de bordereaux de colisage et de bons de livraison. La même configuration de colonnes qui lit les POD peut également lire les bons de réception et les manifestes d'entrepôt, créant ainsi un tableau de bord de réception unifié à partir de documents capturés à différents points de la chaîne de livraison. Pour le guide pas à pas sur la lecture des données d'expédition imprimées et des marques de réception manuscrites sur un bon de livraison signé, consultez notre guide sur l'extraction de bons de livraison manuscrits en réception d'entrepôt.
Pour une vue complète du bon de livraison/POD — pourquoi ces documents sont plus difficiles à extraire que les factures, quels champs comptent le plus pour la réconciliation et comment évaluer les outils — commencez par notre guide complet sur l'extraction des bons de livraison et des POD. Pour tester l'extraction sur votre propre POD dès maintenant, utilisez le convertisseur de bons de livraison en Excel.
Où cela fonctionne bien — et où une vérification humaine est nécessaire
Chaque outil d'extraction a ses limites de précision, et les POD les révèlent plus vite que la plupart des types de documents. Être précis sur ce que l'IA gère bien — et ce qu'elle ne gère pas — permet de définir des attentes réalistes et de bâtir un flux de travail qui fait réellement gagner du temps au lieu de créer une nouvelle charge de vérification.
Fonctionne bien :
- Formulaires carbone en première copie (blanche) avec écriture manuscrite claire — la précision atteint jusqu'à 99 % sur les champs sans ambiguïté comme les numéros de livraison et les dates imprimés
- POD électroniques des transporteurs nationaux (FedEx, UPS, DHL) — texte imprimé par machine avec des libellés de champs cohérents
- Détection de la présence de signature — l'IA confirme si une marque de signature existe dans le champ de signature, en indiquant « Signé » ou « Non signé »
- Libellés de champs imprimés et informations pré-remplies du transporteur
- Annotations d'exception standard (« manque 2 », « 1 carton écrasé ») dans la zone des remarques — lorsque l'écriture est lisible
Nécessite une vérification humaine :
- Formulaires carbone en troisième copie (bleue/jaune) — le contraste est trop faible pour une lecture automatisée fiable ; prévoyez de vérifier la plupart des champs manuscrits
- Détection des limites de sections sur les manifestes multi-arrêts — en particulier lorsque les lignes de séparation sont de faibles tirets manuscrits plutôt que des règles imprimées
- Formulaires endommagés par la pluie ou froissés — la dégradation environnementale réduit l'extraction proportionnellement
- Identité de la signature — l'IA confirme qu'une signature est présente mais ne vérifie pas l'identité du signataire par rapport à un échantillon connu
- Photos de dommages jointes au POD — l'IA extrait le texte du formulaire lui-même mais n'interprète pas le contenu des photographies jointes
Pour un cadre de vérification pratique qui détecte 95 % des erreurs d'extraction tout en contrôlant moins de 10 % de vos données, consultez notre guide sur la vérification des résultats d'extraction par échantillonnage ciblé. Pour résoudre les problèmes spécifiques d'extraction d'écriture manuscrite — y compris que faire lorsque votre outil OCR ou IA lit mal les champs critiques — consultez notre guide sur pourquoi l'OCR échoue sur l'écriture manuscrite et comment y remédier.
Le gain de temps pratique pour une opération logistique traitant 200 POD par jour : au lieu de lire chaque formulaire ligne par ligne et de saisir 15 à 20 champs à partir de zéro, l'opérateur vérifie un tableau pré-rempli et corrige les 3 à 5 champs signalés par document. Cela représente environ 600 à 1 000 champs signalés vérifiés sur 3 000 à 4 000 champs extraits au total par jour — une réduction de 75 à 85 % de la saisie manuelle, soit environ 1 à 1,5 heure de vérification au lieu de 6 à 8 heures de saisie complète.
Questions fréquentes
L'IA peut-elle extraire des données de reçus carbone dont le texte est très pâle ?
Oui, mais la précision dépend de la copie. Les copies blanches (originales) sont fiables. Les copies roses (secondes) sont plus claires mais restent lisibles. Les copies bleues ou jaunes (troisièmes) ont un contraste si faible que la plupart des IA — quel que soit le fournisseur — produisent des résultats peu fiables. Pour les troisièmes copies, utilisez un scanner à plat à 600 DPI avec rehaussement de contraste, et prévoyez une relecture humaine complète des résultats.
Dois-je créer un modèle différent pour chaque format de reçu de transporteur ?
Non, grâce à l'extraction sans modèle. Vous définissez une fois les colonnes souhaitées — Numéro de livraison, Date de livraison, Destinataire, Quantité, Statut de signature — et l'IA localise les valeurs correspondantes sur n'importe quel reçu de transporteur en comprenant ce que chaque champ signifie. Un reçu FedEx, un accusé de réception UPS, un formulaire carbone d'un transporteur régional LTL et un bordereau manuscrit d'un propriétaire-exploitant sont tous traités avec les mêmes définitions de colonnes. Pas de configuration ou de maintenance de modèle par transporteur.
L'IA peut-elle détecter si un reçu a été signé ?
Oui. L'IA détecte la présence d'une marque manuscrite dans le champ de signature et indique un statut « Signé / Non signé ». Cela suffit pour confirmer qu'une personne au lieu de réception a accusé réception de la livraison — assez pour la plupart des workflows de facturation. Elle ne vérifie pas l'identité du signataire ni ne compare la signature à un échantillon ; la vérification de signature nécessite un processus biométrique ou médico-légal distinct.
Comment gérer les reçus avec des notes de dommages ou des exceptions écrites dans les marges ?
Définissez une colonne « Notes d'exception » ou « Notes de dommages » dans votre configuration d'extraction. L'IA scanne l'intégralité du document — y compris les marges, les espaces vides autour du formulaire et les annotations manuscrites à côté des champs imprimés — à la recherche de contenu décrivant des exceptions de livraison. Elle capture à la fois les notations de dommages structurées (« 1 carton écrasé — refusé ») et les gribouillis marginaux non structurés (« manque 2 »). L'essentiel est que l'IA recherche ce contenu par sens (texte décrivant une exception de livraison) plutôt que par emplacement (texte dans une case spécifique).
Puis-je extraire des données de POD multi-arrêts où une feuille couvre 3 à 5 livraisons ?
L'extraction par IA peut traiter les manifestes multi-arrêts en reconnaissant les limites de sections — lignes imprimées, filets de séparation ou en-têtes de sections numérotées — et en attribuant les données de chaque arrêt à une ligne distincte dans le fichier de sortie. Cela fonctionne de manière fiable sur les formulaires multi-arrêts imprimés avec des marqueurs de section clairs. C'est moins fiable sur les formulaires où les limites de sections sont manuscrites ou lorsque les arrêts se chevauchent visuellement sur une page mal numérisée. Pour les opérations traitant de grands volumes de manifestes multi-arrêts, prévoyez du temps de relecture pour l'attribution des sections — en particulier sur les copies carbone ou les formulaires endommagés par la pluie.
Comment l'extraction POD s'intègre-t-elle à mon TMS existant (MercuryGate, McLeod, TMW, etc.) ?
Le fichier de sortie de l'extraction est un fichier Excel ou CSV standard que tout TMS peut importer. Les noms de colonnes que vous définissez lors de l'extraction peuvent être paramétrés pour correspondre aux noms des champs d'importation de votre TMS — ce qui signifie qu'aucun remappage manuel n'est nécessaire entre la sortie de l'extraction et l'importation dans le TMS. La plupart des plateformes, y compris MercuryGate, McLeod LoadMaster, TMW Suite, Descartes, Trimble et Turvo, acceptent les importations CSV structurées. L'extraction remplace la saisie manuelle des données au clavier ; le TMS continue de gérer le suivi des expéditions, la facturation et la communication avec les transporteurs comme avant.
Que se passe-t-il lorsqu'un champ POD est vide ?
L'IA laisse les champs vides dans le fichier de sortie. Un POD sans notes de dommage aura une cellule « Notes d'exception » vide — l'IA n'inventera pas de contenu ni ne remplira de valeurs par défaut. Ceci est important pour les sorties par lots car les cellules vides préservent l'alignement des colonnes et la structure des lignes. Lors de l'importation dans un TMS, les champs vides sont transmis comme des valeurs nulles, ce que la plupart des plateformes gèrent sans erreur.
Commencez à extraire les données POD de vos propres documents
Le délai de quatre jours entre la livraison et la facturation n'existe pas parce que vos transporteurs sont lents ou que votre équipe manque d'effectifs. Il existe parce que les données prouvant qu'une livraison a eu lieu se trouvent sur papier, dans un format qui doit être lu et saisi à la main. Le flux d'extraction décrit dans cet article — définir les colonnes une fois, téléverser tous les POD en lot quel que soit le transporteur ou le format, exporter les données structurées vers votre TMS — supprime l'étape de saisie sans rien changer à la façon dont vos conducteurs livrent ou dont vos transporteurs opèrent.
Il n'est pas nécessaire de déployer un logiciel ePOD auprès de chaque transporteur ni de former les conducteurs à une nouvelle application. Les POD papier que vous recevez déjà — PDF des transporteurs, photos des conducteurs, copies carbone du presse-papiers — peuvent entrer dans le flux d'extraction dès aujourd'hui, via la même interface de téléversement qui traite les factures et les bordereaux d'expédition. Les données qui arrivent sur papier depuis des décennies deviennent une feuille de calcul structurée et consultable avant la clôture de facturation de la journée.
Testez sur vos propres POD. Voyez si 8 heures de saisie quotidienne deviennent une séance de vérification d'une heure.
Téléversez un POD d'exemple — n'importe quel transporteur, n'importe quel format — et voyez le résultat de l'extraction en quelques secondes. Aucun compte requis.