So extrahieren Sie Liefernachweis-Daten (POD)
nach Excel für Logistikabläufe
Das American Transportation Research Institute (ATRI) berichtet, dass die durchschnittlichen Betriebskosten im Lkw-Verkehr 2025 $2,26 pro Meile erreichten, wobei die Nicht-Kraftstoffkosten mit 1,779 $ pro Meile einen Allzeithoch erreichten. Das Segment der Komplettladungen arbeitete mit einer negativen Marge von 2,3 %. Wenn die Margen so dünn sind, ist eine viertägige Lücke zwischen Lieferabschluss und Rechnungserstellung kein Verwaltungsproblem – es ist ein Forderungslaufzeit-Problem (DSO), das sich über jede Ladung, jede Woche, jedes Quartal verstärkt. Die Lücke besteht, weil die Daten, die eine erfolgte Lieferung belegen, auf einem Stück Papier in einer Lkw-Kabine liegen, nicht in einer Datenbank. Diese Daten in ein strukturiertes Format zu extrahieren – Excel, CSV oder direkter TMS-Import – ist der einzelne Hebel mit der höchsten Automatisierungswirkung, den ein Logistikbetrieb nutzen kann, ohne eine einzige Spediteursbeziehung zu ändern.
Wichtigste Erkenntnisse
- Jede 200 PODs, die auf Papier eintreffen, halten eine Person 8,5 Stunden am Tag mit Tippen beschäftigt, und die daraus resultierende viertägige Rechnungsverzögerung ist ein DSO-Problem, das sich über jede Ladung jede Woche verstärkt.
- Ihre viertägige Rechnungslücke ist kein Personalproblem – sie ist die Geschwindigkeit, mit der unterschriebenes Papier von einer Lkw-Kabine zu einem Schreibtisch gelangt, und keine noch so große Einstellung bringt ein Klemmbrett dazu, sich schneller zu bewegen.
- Definieren Sie Extraktionsspalten einmal nach Feldbedeutung statt nach Feldposition, und 200 PODs von 15 Spediteuren werden zu einer einzigen Tabelle, die in einer Stunde geprüft statt über acht Stunden getippt wird.
Der POD-Datenengpass in jedem Logistikbetrieb
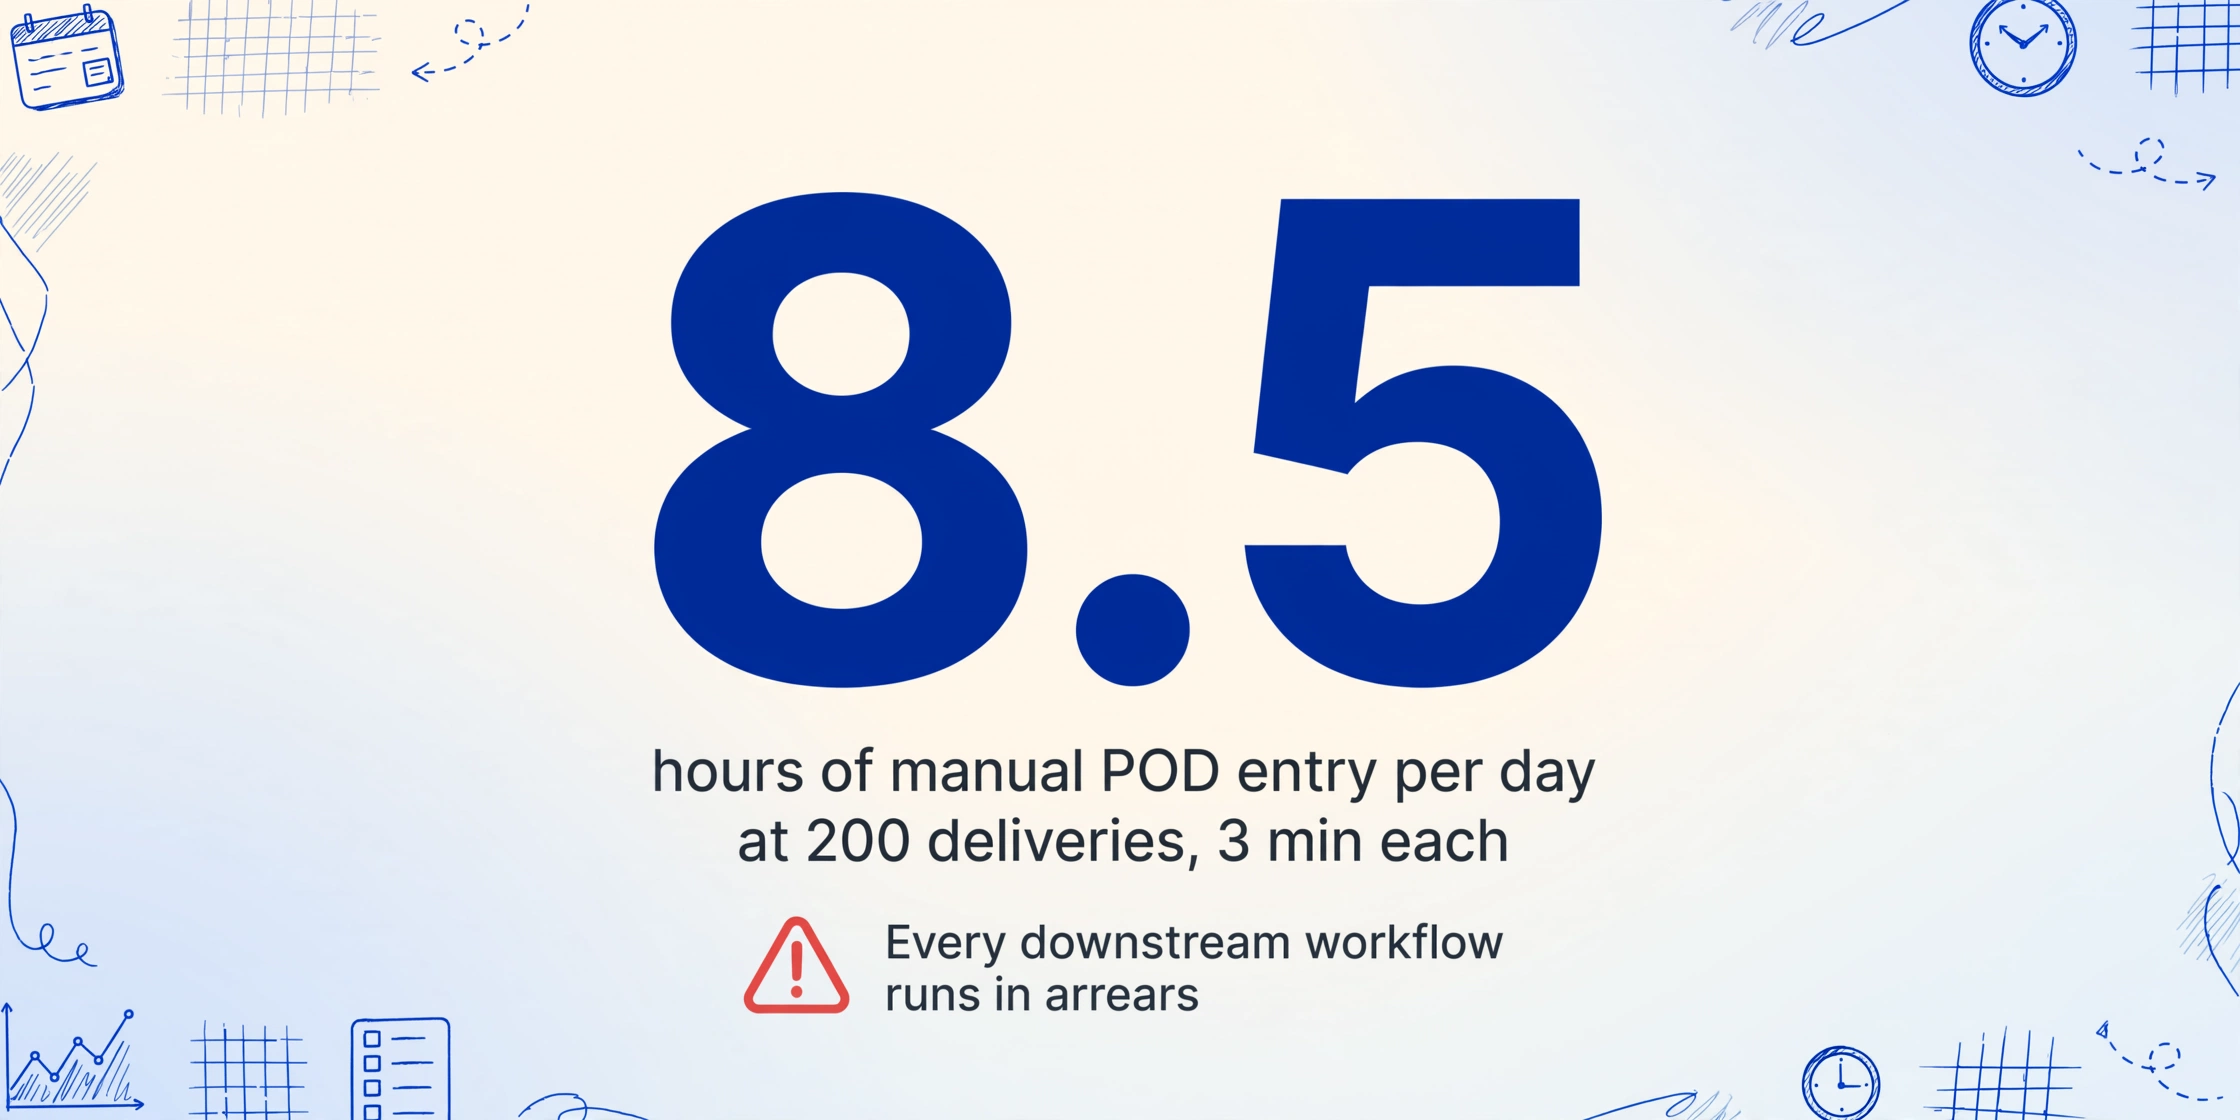
Liefernachweise liegen an der Schnittstelle von vier operativen Workflows, die alle von denselben Daten abhängen: Die Fakturierung benötigt die Lieferbestätigung, um Rechnungen zu erstellen, der Kundenservice benötigt sie, um „Wo bleibt meine Lieferung?“-Anfragen zu beantworten, Schadensfälle benötigen sie, um zu prüfen, ob die Ware in einwandfreiem Zustand angekommen ist, und die Frachtabrechnung benötigt sie, um Zahlungen freizugeben. Wenn die Datenquelle ein unterschriebenes Papierformular ist, das vier Tage braucht, um das Fakturierungssystem zu erreichen, arbeitet jeder nachgelagerte Workflow im Verzug.
Die Rechnung ist einfach. Ein mittelgroßer Frachtmakler oder 3PL mit 200 Lieferungen pro Tag erhält PODs in drei Formaten: elektronische PDFs von nationalen Spediteuren (FedEx, UPS, DHL), gescannte Bilder von regionalen LTL-Spediteuren und handschriftliche Durchschlagformulare von Einzelunternehmern und kleinen Fuhrparks. Die elektronischen PDFs machen vielleicht 15 % des Volumens aus – der Rest kommt als Bilder und Papier an und erfordert, dass jemand jedes Formular ansieht und 12 bis 20 Felder in eine Warteschlange des Transportmanagementsystems (TMS) eingibt. Bei 3 Minuten pro POD für die manuelle Erfassung sind das 8,5 Stunden Tipparbeit pro Tag für 200 Lieferungen – und die Person, die das erledigt, ist mit ziemlicher Sicherheit nicht die Person, die das Unternehmen lieber für Kundenbeziehungen oder Speditionsverhandlungen einsetzen würde.
Der Carmack Amendment (49 U.S.C. §14706), der die Haftung von Spediteuren für innerstaatliche Sendungen in den USA regelt, verschärft diesen Engpass zusätzlich. Nach Carmack müssen Spediteure schriftliche Schadensmeldungen innerhalb von mindestens neun Monaten nach Lieferung akzeptieren – aber der Nachweis dessen, was bei der Lieferung passiert ist, hängt vom POD ab. Bei Streitigkeiten über Teillieferungen oder verdeckte Schäden ist der POD das wichtigste Beweismittel für den Empfang. Wenn die POD-Daten in einer Papierakte stecken, deren Auffinden zwei Stunden dauert, verlängert sich die Streitbeilegungsdauer von Stunden auf Tage. Eine durchsuchbare POD-Datenbank – in der jedes Lieferdatum, jeder Empfängername, jede Menge und jeder Ausnahmevermerk ein strukturiertes Feld ist – verkürzt diese Suchzeit auf Sekunden.
Die Auswirkung auf die Forderungslaufzeit (DSO) wächst leise. Vier Tage von Lieferung bis Rechnung bedeuten, dass Ihre Working-Capital-Zyklen eine eingebaute Verzögerung enthalten, die keine noch so große Verhandlung über Zahlungsziele beheben kann – denn die Verzögerung liegt in Ihrer Datenpipeline, nicht im Zahlungsverhalten Ihres Kunden.
Was ein POD enthält – und warum es schwerer zu digitalisieren ist als ein BOL
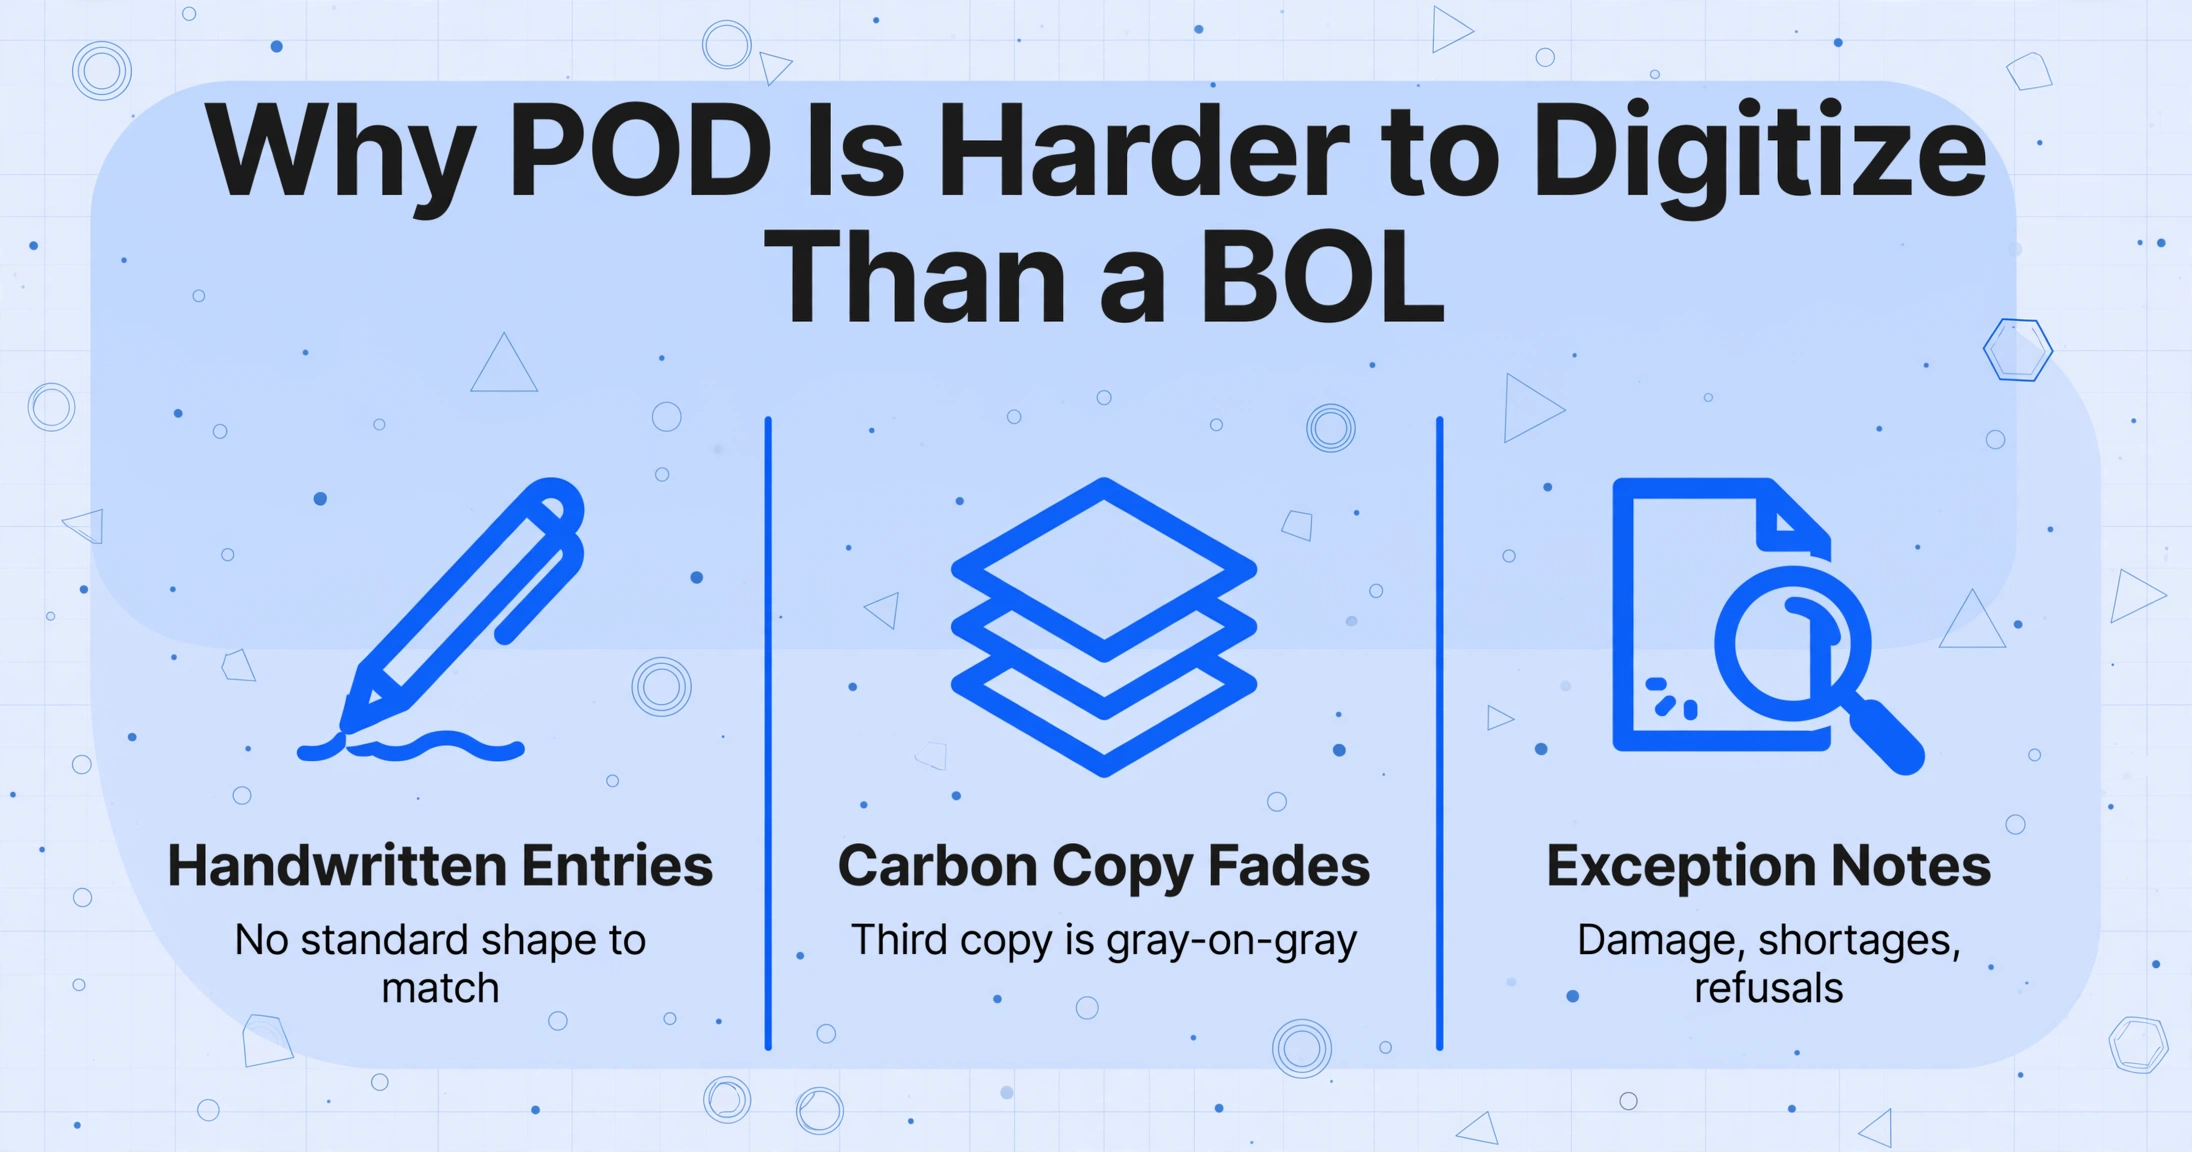
Ein Liefernachweis sieht auf den ersten Blick einfach aus – ein Formular mit einigen Feldern, die bestätigen, dass Waren den Besitzer gewechselt haben. In der Praxis vereint er drei Herausforderungen der Dokumentenverarbeitung, die einzeln schwierig sind und zusammen für diesen Dokumenttyp einzigartig sind.
Handschriftliche Unterschriften und Einträge. Der Fahrer notiert Lieferzeit, Palettenanzahl und etwaige Ausnahmevermerke von Hand – oft im Führerhaus, auf einem Klemmbrett, nach einer 14-Stunden-Schicht gemäß den Dienstzeitregeln der FMCSA 49 CFR Part 395. Der Empfänger unterschreibt und schreibt manchmal „12 von 15 erhalten“ oder „1 Karton zerdrückt – angenommen“ an den Rand. Keine der beiden Handschriftenproben wurde an einem Schreibtisch unter optimaler Beleuchtung erstellt. Herkömmliche OCR-Tools – die gedruckte Zeichen segmentieren, indem sie Formen mit bekannten Schriftarten abgleichen – scheitern an diesem Inhalt, weil es keine Standardform zum Abgleichen gibt. Ein hastig geschriebenes „Menge 12“ kann für eine Zeichenabgleich-Engine nicht von „Menge 14“ zu unterscheiden sein.
Verblassende Durchschläge. Die meisten Papier-PODs sind mehrteilige Kohlepapierformulare. Die obere (weiße) Kopie ist lesbar. Die zweite (rosa oder gelbe) Kopie ist blasser. Bei der dritten Kopie (blau oder goldgelb) überträgt sich der Stiftdruck kaum noch und Zeichen werden zu Geisterbildern – schwache Umrisse mit fehlenden Strichen und einem Kontrast nahe Null. Ein Standardscan einer dritten Durchschlagkopie erzeugt ein Grau-auf-Grau-Bild, aus dem die meisten OCR-Tools keinerlei Text extrahieren können, geschweige denn Handschrift.
Unstrukturierte Ausnahmevermerke. Die betrieblich bedeutendste Information auf einem POD ist oft am wenigsten strukturiert. Ein Fahrer schreibt „2 Kartons fehlen“ an den Rand. Ein Wareneingangsmitarbeiter kreist eine Zahl ein und schreibt „ABGELEHNT – Wasserschaden.“ Ein Empfänger schreibt „per John“ neben die Unterschriftszeile, statt zu unterschreiben. Diese Notizen erscheinen nicht in dafür vorgesehenen Feldern und nicht an derselben Stelle in den Formularen verschiedener Spediteure, aber sie enthalten die Informationen, die darüber entscheiden, ob eine Sendung angenommen, beanstandet oder abgelehnt wird – und sie müssen für Rechnungs- und Schadensbearbeitungsprozesse erfasst werden.
Liefermanifeste mit mehreren Stopps. Ein einzelnes POD-Blatt deckt oft drei bis fünf Lieferstopps auf derselben Route ab – jeder Stopp ist ein separater Abschnitt auf demselben Formular, getrennt durch eine gedruckte Linie oder einen nummerierten Abschnittsumbruch. Die Extraktion muss unterscheiden, wo Stopp 1 endet und Stopp 2 beginnt, sonst kollabiert die gesamte Ausgabe zu zusammengeführten Zeilen mit falsch zugeordneten Mengen. Dies ist ein schwierigeres Problem als das Lesen eines einzelnen Feldes: Es erfordert das Verständnis des Dokumentlayouts auf Abschnittsebene, nicht nur auf Feldebene.
Der Workflow: Vom Klemmbrett des Fahrers bis zum TMS-Import
Um zu verstehen, wie die POD-Extraktion in einen realen Logistikbetrieb passt, hilft es, den End-to-End-Workflow zu betrachten, der heute in den meisten Frachtvermittlungen und 3PLs existiert.
Fahrer schließt Lieferung ab – erfasst POD
Der Fahrer erhält eine Unterschrift auf einem mehrteiligen Kohlepapierformular oder fotografiert die unterschriebene Quittung mit seinem Telefon. Bei nationalen Spediteuren (FedEx, UPS) wird der POD elektronisch erfasst und innerhalb von Minuten im Portal des Spediteurs hochgeladen. Bei regionalen LTL-Spediteuren und Einzelunternehmern wandert das Papierformular in einen Tourenordner.
POD erreicht das Backoffice – mit Verzögerung
Papier-PODs treffen im Büro ein, wenn der Fahrer zur Basis zurückkehrt – am Tagesende, am nächsten Morgen oder bei Fernfahrten am Wochenende. Elektronische PODs aus Speditionsportalen werden in Stapeln heruntergeladen. Beide landen in derselben Warteschlange: einem Stapel Dokumente, die auf die Dateneingabe warten.
Datenerfasser tippt Felder in das TMS
Für jeden POD liest der Sachbearbeiter Liefernummer, Datum, Empfängername, empfangene Menge, Unterschriftsstatus und Ausnahmevermerke – und tippt sie dann in den TMS-Sendungsdatensatz. Plattformen wie MercuryGate, McLeod LoadMaster, TMW Suite (Trimble), Descartes und Turvo erwarten alle strukturierte Sendungsdaten, um Abrechnung und Kundenbenachrichtigungen zu verarbeiten. Bei 3 Minuten pro POD und 200 PODs pro Tag verbraucht dieser Schritt eine Vollzeitstelle pro 100–120 täglichen Lieferungen.
Abrechnung erstellt Rechnungen – verzögert durch die Datenlücke
Das TMS kann nur Lieferungen abrechnen, die bestätigte POD-Daten haben. Bis die Felder eingegeben sind, bleibt die Lieferung im Status „Bestätigung ausstehend". Bei 200 Lieferungen pro Tag bedeutet dieser Rückstau, dass die Abrechnung mit einer Verzögerung von 2–4 Tagen läuft – jede einzelne Woche, jeden einzelnen Monat.
Ansprüche und Streitfälle erfordern POD-Nachschlag – oft manuell
Wenn ein Versender einen Frachtschadenanspruch im Rahmen des Carmack Amendment geltend macht, muss der Makler oder das 3PL den POD vorlegen, um die Lieferbedingungen zu verifizieren. Bei Papierakten oder gescannten PDFs, die nach Versanddatum abgelegt sind, dauert ein einzelner Nachschlag 15–30 Minuten Dateisuche. Mit strukturierten Daten – jeder POD als Zeile in einer Tabelle – dauert derselbe Nachschlag 5 Sekunden.
Der Extraktionsworkflow ersetzt Schritt 3 (manuelle Dateneingabe) durch automatisierte Extraktion und verkürzt die Verzögerung von 2–4 Tagen in Schritt 4 auf eine Abrechnung am selben oder nächsten Tag. Entscheidend ist, dass die Extraktion keinen Austausch des TMS, keinen Wechsel der Spediteure und keine neue Hardware erfordert. Sie fügt sich an dem Punkt in den bestehenden Workflow ein, an dem Papier auf Tastatur trifft.
So extrahieren Sie POD-Daten: Schritt für Schritt
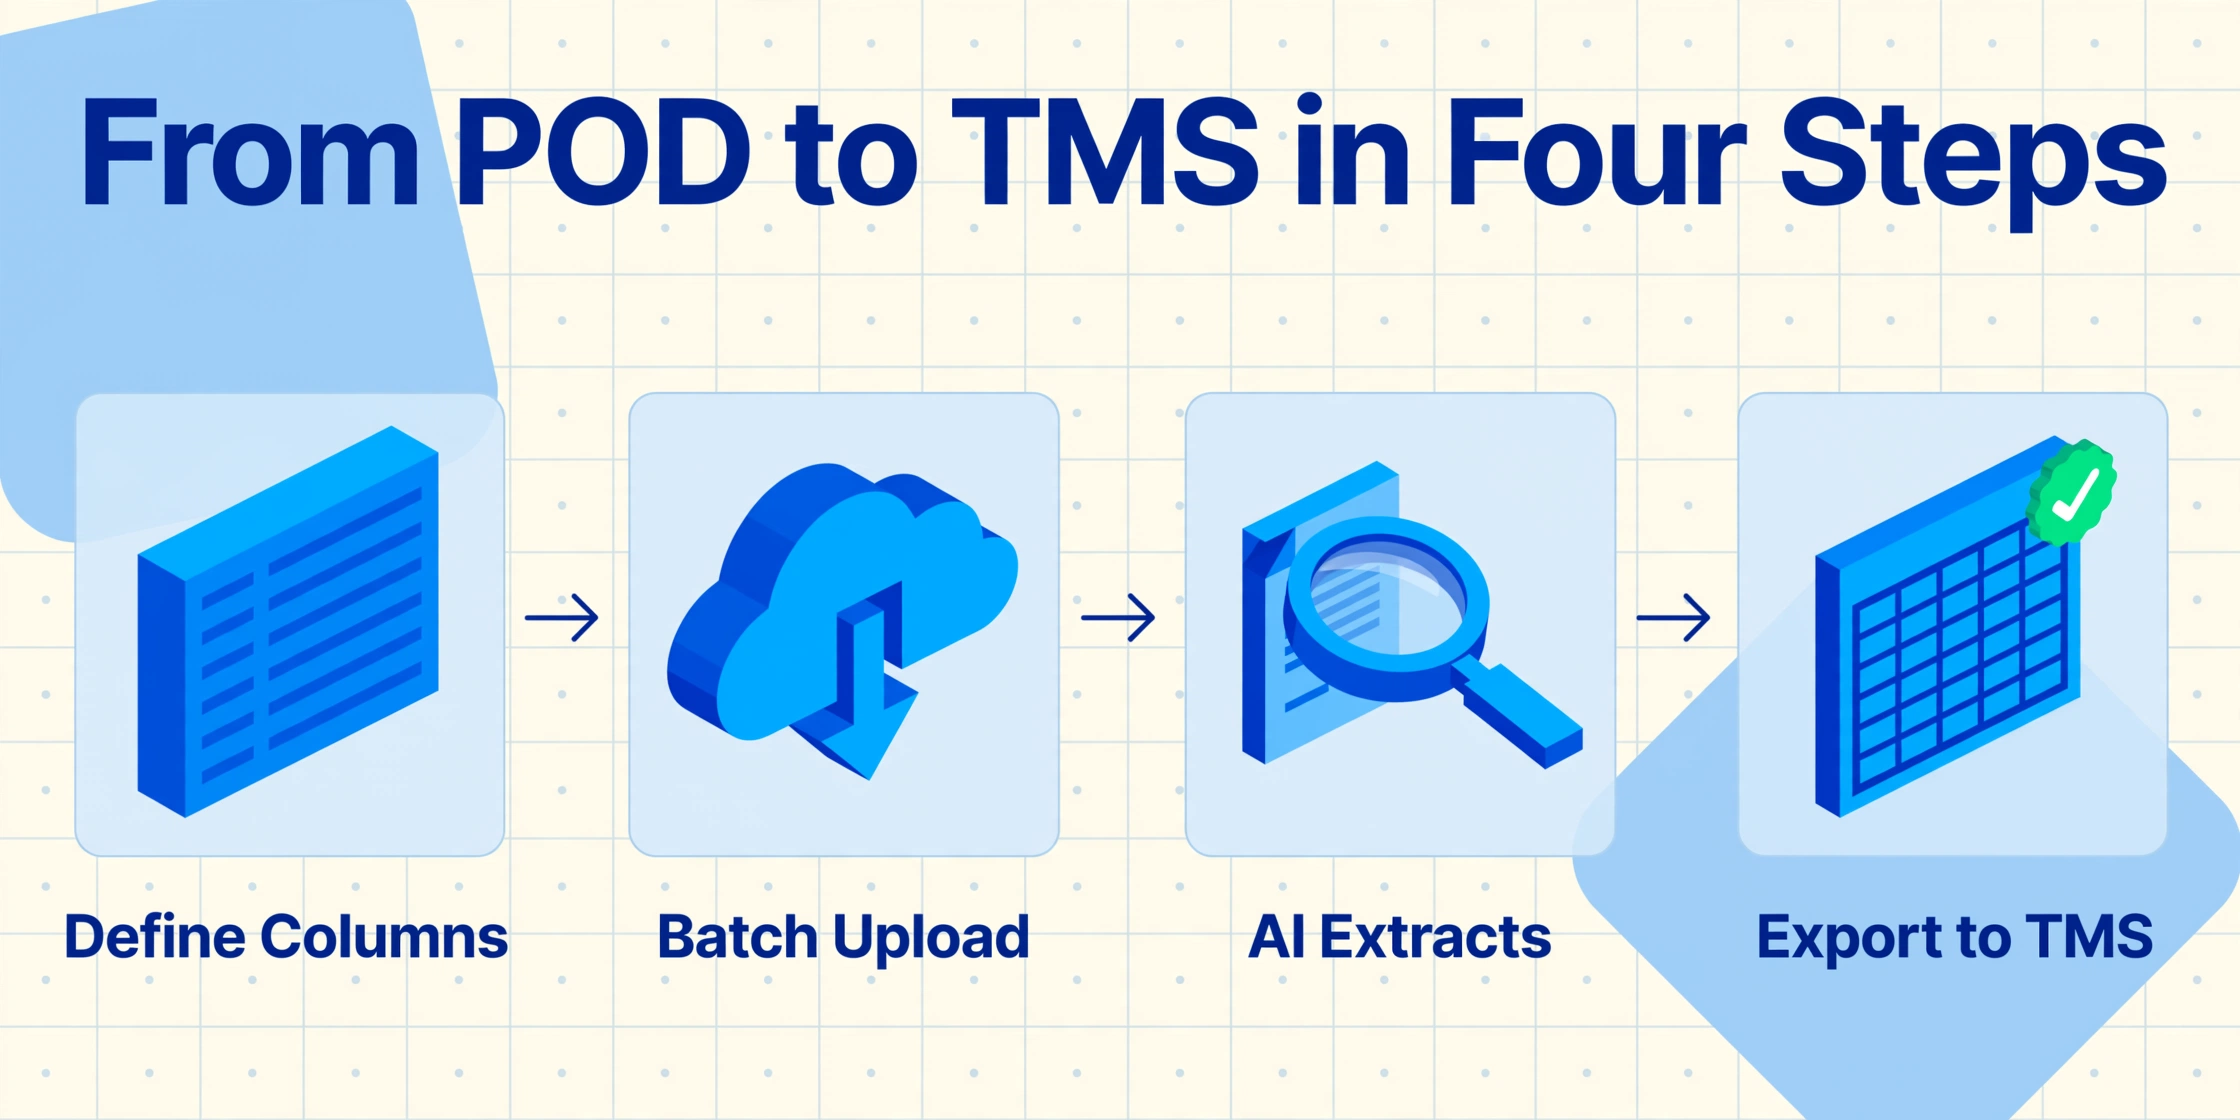
Der Extraktionsprozess folgt demselben No-Code-Batch-Verarbeitungsworkflow, der auch für Rechnungen, Lieferscheine und Frachtbriefe gilt – aber PODs erfordern spezifische Spaltendefinitionen und Formatbehandlungen, die ihre besonderen Merkmale widerspiegeln.
Definieren Sie Ihre Extraktionsspalten passend zu Ihrer TMS-Importvorlage
Geben Sie die Spaltennamen ein, die Sie in der Ausgabetabelle wünschen. Die eingegebenen Spaltennamen dienen sowohl als Extraktionsanweisungen als auch als Tabellenüberschriften. Für POD-Workflows entsprechen die wesentlichen Spalten dem, was Ihr TMS erwartet:
Delivery Number / PRO-Nummer— Verknüpfung mit dem TMS-SendungsdatensatzDelivery Date— Datum der physischen ZustellungDelivery Time— Uhrzeit der ZustellungConsignee / Recipient Name— wer die Ware empfangen hatDelivery Address— tatsächlicher Zustellort (kann von der BOL-Adresse abweichen)Quantity Shipped vs. Quantity Received— AbweichungsverfolgungSignature Status— Unterschrieben / Nicht unterschriebenCondition Notes / Exception Notes— Schadensvermerke, Fehlmengen, AnnahmeverweigerungenDriver Name— wer die Zustellung durchgeführt hat
Benennen Sie diese Spalten nach Möglichkeit passend zu den Importfeldnamen Ihres TMS – das vermeidet den Umformatierungsschritt, der die Zeitersparnis der Automatisierung zunichtemacht. Eine Spalte namens PRO_NUMBER, die direkt auf Ihre MercuryGate- oder McLeod-Importvorlage abgebildet wird, ist mehr wert als eine namens „POD ID", die einen Neuzuordnungsschritt erfordert.
Laden Sie die PODs des Tages als Stapel hoch
Laden Sie alle POD-Dateien – gescannte Durchschläge, Handyfotos handschriftlicher Belege, PDF-Downloads aus Carrier-Portalen – in einem Stapel hoch. Die KI verarbeitet sie parallel anhand Ihrer Spaltendefinitionen. Eine Sortierung nach Spediteur oder Formulartyp vor dem Hochladen ist nicht erforderlich. Für beste Ergebnisse bei Durchschlägen: Verwenden Sie einen Flachbettscanner mit 300 DPI oder mehr für dritte Durchschläge; Handyfotos in Standardauflösung sind für Originale und elektronische PDFs ausreichend. Weitere Informationen zum Erfassen von Dokumenten ohne Scanner finden Sie in unserem Leitfaden zum Digitalisieren von Dokumenten mit Ihrem Telefon.
Extrahieren und prüfen
Die KI liest jeden POD und füllt die von Ihnen definierten Spalten. Bei handschriftlichen Durchschlägen leitet das Vision-Modell der KI Zeichen aus dem Kontext ab – ein unscharfes „12" neben „QTY RCVD" ist eher eine „12" als eine „14", da die KI versteht, was eine plausible Liefermenge ist. Prüfen Sie die markierten Felder mit geringer Konfidenz; bei den meisten Original-PODs mit klarer Handschrift werden 85–95 % der Felder ohne Korrektur korrekt extrahiert.
Export und Import in Ihr TMS
Exportieren Sie die Ergebnisse als Excel oder CSV. Die Ausgabe ist eine Tabelle mit einer Zeile pro POD – nicht pro Spediteur, nicht pro Datei – mit Spalten, die den von Ihnen definierten Namen entsprechen. Importieren Sie die Datei in Ihr TMS über dessen Standard-CSV-Importfunktion. Plattformen wie MercuryGate, McLeod LoadMaster, TMW Suite, Descartes und Turvo unterstützen alle strukturierten Dateiimport mit Spaltenzuordnung. Der Import dauert Minuten statt Stunden, und da die Spaltennamen in Schritt 1 passend zur TMS-Vorlage festgelegt wurden, ist die Zuordnung nur eine einmalige Konfiguration.
Für Betriebe, die den Dateiexport-Import-Zyklus komplett überspringen möchten, kann das Google-Sheets-Add-on Extraktionsergebnisse direkt in eine Tabelle schreiben, die eine TMS-Import-Pipeline oder ein internes Tracking-Dashboard speist – gleiche Extraktion, ein Dateiübergabeschritt weniger.
Warum Multi-Carrier-Formate keine Multi-Carrier-Vorlagen erfordern
Das ist die Frage, die die meisten Logistikteams von der Einführung der Extraktion abhält: „Wir erhalten PODs von 15 verschiedenen Spediteuren, jeder mit einem anderen Formularlayout. Bedeutet das, dass wir 15 Vorlagen benötigen?"
Bei vorlagenbasierten Extraktionstools – der Generation, zu der Docparser, Parseur und die meisten Zonen-OCR-Ansätze gehören – lautet die Antwort ja. Jedes Spediteur-Layout erfordert eine separate Parsing-Konfiguration: Zeichnen Sie Boxen um das Liefernummernfeld im Formular von Spediteur A, zeichnen Sie andere Boxen im Formular von Spediteur B, und pflegen Sie jede, wenn der Spediteur sein Layout aktualisiert. Für einen Frachtvermittler, der PODs von Dutzenden Spediteuren erhält, übersteigt dieser Vorlagenwartungsaufwand schnell die Zeitersparnis durch Automatisierung.
Spaltennamensextraktion – der Ansatz von ImageToTable.ai – funktioniert anders. Statt Feldpositionen zu definieren, definieren Sie Feldbedeutungen. Sie geben „Lieferdatum" einmal als Spaltennamen ein, und das KI-Visionsmodell lokalisiert den entsprechenden Wert auf jedem POD, indem es versteht, was ein Lieferdatum ist – nicht, indem es nach Text an einer festen Koordinate sucht. Ein FedEx-SmartPost-POD, bei dem das Lieferdatum oben rechts steht, ein Formular eines regionalen LTL-Spediteurs, bei dem es in einem mittleren Block gedruckt ist, und ein handschriftlicher Zettel eines Einzelunternehmers, bei dem der Fahrer es neben „DATE" geschrieben hat – alle durchlaufen dieselbe Spaltendefinition ohne Konfiguration pro Spediteur. Dies ist das Muster der KI-Extraktion ohne Vorlage: Die Extraktionsengine liest nach Bedeutung, nicht nach Position.
Die praktische Auswirkung für Logistikbetriebe: Sie können 200 PODs von 20 verschiedenen Spediteuren in einem einzigen Upload verarbeiten, Ihre Spalten einmal definieren und eine konsolidierte Tabelle erhalten. Kein Vorsortieren nach Spediteur. Keine Vorlageneinrichtung pro Spediteur. Keine Wartung, wenn ein Spediteur sein Formulardesign aktualisiert.
Umgang mit Multi-Stop-Manifesten: Der schwierigste POD-Fall
Ein einzelnes POD-Formular, das drei Lieferstopps abdeckt, sieht aus wie drei separate Mini-Formulare auf derselben Seite, getrennt durch eine horizontale Linie oder einen nummerierten Abschnittsumbruch. Jeder Stopp hat seine eigene Liefernummer, seinen Empfänger, seine Menge und seine Unterschrift. Die Extraktion muss diese Abschnittsgrenzen erkennen und jede Zeile dem richtigen Stopp zuordnen – andernfalls werden die Lieferungen im Batch-Output zusammengeführt und unbrauchbar.
Hier zeigt sich der Wert der semantischen Extraktion. Die KI liest das Dokument auf Layout-Ebene – sie erkennt, dass eine horizontale Linie über die Seite, gefolgt von einer neuen „Stopp 2"-Überschrift, eine Abschnittsgrenze darstellt und kein Formatierungsartefakt. Der Output weist jedem Stopp eine eigene Zeile in der Tabelle zu, wobei die Felder dem korrekten Liefersegment zugeordnet werden. Dies funktioniert nicht bei jedem Dokument perfekt – Abschnittsgrenzen bei schlecht gescannten oder stark komprimierten Formularen können mehrdeutig sein –, aber es verarbeitet die Mehrheit gedruckter Mehrstopp-Formulare zuverlässig. Die ehrliche Einschätzung: Wenn Ihr Betrieb regelmäßig Mehrstopp-Manifeste auf einem einzigen Blatt verarbeitet, planen Sie Prüfzeit speziell für die Abschnittszuordnung ein, insbesondere wenn die Grenzmarkierungen verblasst oder handschriftlich sind.
Verknüpfung von POD-Daten mit Frachtbriefen und Packlisten
PODs existieren nicht isoliert. Sie sind das letzte Glied in einer Dokumentenkette, die mit dem Frachtbrief (bei Abholung ausgestellt) beginnt und die Packliste (mit Inhaltsangabe), den Lieferschein (am Versandstück befestigt) und den POD (bei Lieferung unterschrieben) umfasst. Jedes Dokument in dieser Kette enthält überlappende, aber unterschiedliche Informationen – das Zusammenführen schafft einen vollständigen Versanddatensatz.
Dieselbe Extraktions-Workflow, der PODs verarbeitet, kann auch Frachtbriefe und Packlisten in separaten Batches oder im selben Batch verarbeiten – mit der PRO-Nummer oder Liefernummer als Verknüpfungsschlüssel. Wenn der POD die Lieferung von 12 Paletten bestätigt, der BOL aber 14 versendete zeigt, wird die Abweichung als strukturierter Datenpunkt sichtbar, bevor sie zu einem Abrechnungsstreit wird. Für einen genaueren Blick auf die BOL-Seite dieses Workflows siehe wie extrahierte BOL-Daten in Ihr TMS fließen.
Für Betriebe, die handschriftliche Wareneingangsdokumente in Lagerumgebungen verarbeiten – wo der Fahrer einen Papier-Lieferschein vorlegt und der Wareneingangsmitarbeiter Mengen und Zustand handschriftlich ergänzt – folgt der POD-Extraktions-Workflow demselben Spaltennamen-Ansatz wie bei der Batch-Extraktion von Packlisten und Lieferscheinen. Dieselbe Spaltenkonfiguration, die PODs liest, kann auch Wareneingangsnotizen und Lagermanifeste lesen und so ein einheitliches Wareneingangs-Dashboard aus Dokumenten erstellen, die an verschiedenen Punkten der Lieferkette erfasst wurden. Für die Schritt-für-Schritt-Anleitung zum Lesen sowohl der gedruckten Versanddaten als auch der handschriftlichen Empfangsvermerke auf einem unterschriebenen Lieferschein siehe unseren Leitfaden zur handschriftlichen Lieferscheinextraktion im Wareneingang.
Für das vollständige Bild zu Lieferschein/POD – warum diese Dokumente schwieriger zu extrahieren sind als Rechnungen, welche Felder für den Abgleich am wichtigsten sind und wie Sie Tools bewerten – beginnen Sie mit unserem vollständigen Leitfaden zur Lieferschein- & POD-Extraktion. Um die Extraktion jetzt mit Ihrem eigenen POD zu testen, nutzen Sie den Lieferschein-zu-Excel-Konverter.
Wo es gut funktioniert – und wo menschliche Prüfung nötig ist
Jedes Extraktionstool hat Genauigkeitsgrenzen, und PODs machen diese schneller sichtbar als die meisten Dokumenttypen. Klar zu benennen, was die KI gut verarbeitet – und was nicht – schafft realistische Erwartungen und einen Workflow, der tatsächlich Zeit spart, statt eine neue Prüfbelastung zu erzeugen.
Funktioniert gut:
- Kohlepapierformulare (weißes Original) mit klarer Blockschrift – Genauigkeit bis zu 99 % bei eindeutigen Feldern wie gedruckten Liefernummern und Daten
- Elektronische PODs nationaler Spediteure (FedEx, UPS, DHL) – maschinengedruckter Text mit konsistenten Feldbezeichnungen
- Erkennung des Vorhandenseins einer Unterschrift – die KI bestätigt, ob im Unterschriftsfeld eine Signatur vorhanden ist, und gibt „Signiert" oder „Nicht signiert" aus
- Gedruckte Feldbezeichnungen und vorausgefüllte Spediteursinformationen
- Standardmäßige Ausnahmevermerke („2 fehlen", „1 Karton zerquetscht") im Bemerkungsfeld – wenn die Handschrift lesbar ist
Erfordert menschliche Prüfung:
- Kohlepapierformulare (blaue/gelbe Durchschläge) – der Kontrast ist für zuverlässiges automatisiertes Lesen zu gering; rechnen Sie damit, die meisten handschriftlichen Felder zu prüfen
- Erkennung von Abschnittsgrenzen bei Manifesten mit mehreren Stopps – insbesondere wenn Trennlinien schwache handschriftliche Striche statt gedruckter Linien sind
- Regen- oder knittergeschädigte Formulare – Umweltschäden reduzieren die Extraktionsqualität proportional
- Identität der Unterschrift – die KI bestätigt, dass eine Unterschrift vorhanden ist, prüft aber nicht die Identität des Unterzeichners gegen eine bekannte Probe
- Schadensfotos am POD – die KI extrahiert Text vom Formular selbst, interpretiert aber nicht den Inhalt beigefügter Fotos
Für einen praktischen Prüfrahmen, der 95 % der Extraktionsfehler erkennt und dabei weniger als 10 % Ihrer Daten prüft, lesen Sie unseren Leitfaden zu Verifizierung von Extraktionsergebnissen durch gezielte Stichproben. Zur Fehlerbehebung bei spezifischen Handschrift-Extraktionsproblemen – einschließlich der Frage, was zu tun ist, wenn Ihr OCR- oder KI-Tool kritische Felder falsch liest – lesen Sie unseren Leitfaden zu warum OCR bei Handschrift versagt und wie Sie das beheben.
Der praktische Zeitgewinn für einen Logistikbetrieb mit 200 PODs pro Tag: Statt jedes Formular Zeile für Zeile zu lesen und 15–20 Felder von Grund auf einzutippen, prüft der Bearbeiter eine vorausgefüllte Tabelle und korrigiert die 3–5 markierten Felder pro Dokument. Das sind etwa 600–1.000 markierte Felder, die täglich geprüft werden, von insgesamt 3.000–4.000 extrahierten Feldern – eine Reduzierung der manuellen Datenerfassung um 75–85 %, was etwa 1–1,5 Stunden Prüfzeit statt 6–8 Stunden vollständiger Dateneingabe entspricht.
Häufig gestellte Fragen
Kann KI Daten aus Durchschlag-Lieferscheinen extrahieren, wenn der Text sehr blass ist?
Ja, aber die Genauigkeit hängt von der Kopie ab. Weiße (erste) Kopien lassen sich zuverlässig extrahieren. Rosa (zweite) Kopien sind blasser, aber noch lesbar. Blaue oder gelbe (dritte) Kopien haben einen so geringen Kontrast, dass die meisten KI-Extraktionen – unabhängig vom Anbieter – unzuverlässige Ergebnisse liefern. Verwenden Sie für dritte Kopien einen Flachbettscanner mit 600 DPI und Kontrastverstärkung und planen Sie eine vollständige manuelle Überprüfung der Ausgabe ein.
Brauche ich für jedes Speditions-POD-Format eine andere Vorlage?
Nicht bei vorlagenfreier Extraktion. Sie definieren die gewünschten Spalten einmal – Liefernummer, Lieferdatum, Empfänger, Menge, Unterschriftsstatus – und die KI findet die entsprechenden Werte auf jedem Speditions-POD, indem sie versteht, was jedes Feld bedeutet. Ein FedEx-POD, eine UPS-Lieferquittung, ein Kohlepapier-Formular eines regionalen LTL-Spediteurs und ein handschriftlicher Beleg eines Einzelunternehmers werden alle mit denselben Spaltendefinitionen verarbeitet. Keine einrichtung oder Wartung von Vorlagen pro Spediteur.
Kann die KI erkennen, ob ein POD unterschrieben wurde?
Ja. Die KI erkennt das Vorhandensein einer handschriftlichen Markierung im Unterschriftsfeld und gibt den Status "Unterschrieben / Nicht unterschrieben" aus. Dies reicht aus, um zu bestätigen, dass jemand am Empfangsort die Lieferung quittiert hat – ausreichend für die meisten Abrechnungsworkflows. Sie überprüft nicht die Identität des Unterzeichners oder gleicht die Unterschrift mit einer Vorlage ab; die Unterschriftsverifizierung erfordert einen separaten biometrischen oder forensischen Prozess.
Wie gehe ich mit PODs um, bei denen Schadensvermerke oder Ausnahmen in den Randbereich geschrieben wurden?
Definieren Sie in Ihrer Extraktionseinrichtung eine Spalte namens "Ausnahmevermerke" oder "Schadensvermerke". Die KI scannt das gesamte Dokument – einschließlich Ränder, Leerräume um das Formular und handschriftliche Anmerkungen neben gedruckten Feldern – nach Inhalten, die Lieferausnahmen beschreiben. Sie erfasst sowohl strukturierte Schadensvermerke ("1 Karton zerdrückt – verweigert") als auch unstrukturierte Randnotizen ("fehlen 2"). Der Schlüssel liegt darin, dass die KI nach Inhalten sucht, die bedeutungsmäßig eine Lieferausnahme beschreiben, und nicht nach der Position (Text in einem bestimmten Feld).
Kann ich Daten aus mehrstopp-Lieferscheinen extrahieren, bei denen ein Blatt 3–5 Lieferungen abdeckt?
Die KI-Extraktion verarbeitet mehrstopp-Manifeste, indem sie Abschnittsgrenzen erkennt – gedruckte Linien, Trennlinien oder nummerierte Abschnittsüberschriften – und die Daten jedes Stopps einer separaten Zeile in der Ausgabe zuordnet. Dies funktioniert zuverlässig bei gedruckten Mehrstopp-Formularen mit klaren Abschnittsmarkierungen. Weniger zuverlässig ist es bei handschriftlichen Abschnittsgrenzen oder wenn Stopps auf schlecht gescannten Seiten visuell überlappen. Bei der Verarbeitung großer Mengen mehrstopp-Manifeste sollte Zeit für die Überprüfung der Abschnittszuordnung eingeplant werden – insbesondere bei Durchschlägen oder regenbeschädigten Formularen.
Wie passt die POD-Extraktion zu meinem bestehenden TMS (MercuryGate, McLeod, TMW usw.)?
Die Extraktionsausgabe ist eine Standard-Excel- oder CSV-Datei, die jedes TMS importieren kann. Die von Ihnen während der Extraktion definierten Spaltennamen können an die Importfeldnamen Ihres TMS angepasst werden – kein manuelles Neuzuordnen zwischen Extraktionsausgabe und TMS-Import erforderlich. Die meisten Plattformen, darunter MercuryGate, McLeod LoadMaster, TMW Suite, Descartes, Trimble und Turvo, akzeptieren strukturierte CSV-Importe. Die Extraktion ersetzt die manuelle Dateneingabe; das TMS übernimmt weiterhin Sendungsverfolgung, Abrechnung und Kommunikation mit Spediteuren wie bisher.
Was passiert, wenn ein POD-Feld leer ist?
Die KI lässt leere Felder in der Ausgabe leer. Ein Lieferschein ohne Schadensvermerke erhält eine leere Zelle „Ausnahmevermerke“ – die KI erfindet keine Inhalte oder füllt Standardwerte ein. Dies ist wichtig für Batch-Ausgaben, da leere Zellen die Spaltenausrichtung und Zeilenstruktur erhalten. Beim Import in ein TMS werden leere Felder als Nullwerte übergeben, was die meisten Plattformen fehlerfrei verarbeiten.
POD-Daten aus Ihren eigenen Dokumenten extrahieren
Die viertägige Lücke zwischen Lieferung und Rechnung besteht nicht, weil Ihre Spediteure langsam sind oder Ihr Team unterbesetzt ist. Sie besteht, weil die Daten, die eine erfolgte Lieferung belegen, auf Papier in einem Format vorliegen, das von Hand gelesen und abgetippt werden muss. Der in diesem Artikel beschriebene Extraktionsworkflow — Spalten einmal definieren, alle PODs unabhängig von Spediteur oder Format im Batch hochladen, strukturierte Daten in Ihr TMS exportieren — entfernt den Abtippschritt, ohne etwas daran zu ändern, wie Ihre Fahrer liefern oder wie Ihre Spediteure arbeiten.
Es ist nicht erforderlich, ePOD-Software bei jedem Spediteur einzuführen oder Fahrer im Umgang mit einer neuen App zu schulen. Die Papier-PODs, die Sie bereits erhalten — Spediteur-PDFs, Fahrerfotos, Durchschläge vom Klemmbrett — können noch heute in den Extraktionsworkflow einfließen, über dieselbe Upload-Oberfläche, die auch Rechnungen und Lieferscheine verarbeitet. Die Daten, die seit Jahrzehnten auf Papier ankommen, werden zu einer durchsuchbaren, strukturierten Tabelle, bevor die Abrechnung für den Tag abgeschlossen wird.
Testen Sie es mit Ihren eigenen PODs. Sehen Sie, ob 8 Stunden tägliche Datenerfassung zu einer 1-stündigen Prüfsitzung werden.
Laden Sie einen Beispiel-POD hoch — jeder Spediteur, jedes Format — und sehen Sie das Extraktionsergebnis in Sekunden. Kein Konto erforderlich.