How to Extract Proof of Delivery (POD) Data
to Excel for Logistics Operations
The American Transportation Research Institute (ATRI) reports that trucking's average operating cost reached $2.26 per mile in 2025, with non-fuel costs hitting an all-time high of $1.779 per mile. The truckload segment operated at a negative 2.3% margin. When margins are that thin, a four-day gap between delivery completion and invoice generation is not an admin headache — it is a days sales outstanding (DSO) problem that compounds across every load, every week, every quarter. The gap exists because the data that proves a delivery happened lives on a piece of paper in a truck cab, not in a database. Extracting that data into a structured format — Excel, CSV, or direct TMS import — is the single highest-leverage automation move a logistics operation can make without changing a single carrier relationship.
핵심 요점
- 종이로 도착하는 POD 200건마다 하루 8.5시간 동안 한 명이 입력 작업을 해야 하며, 그 뒤에 발생하는 4일간의 청구 지연은 매주 모든 화물에 걸쳐 누적되는 매출채권 회수 기간(DSO) 문제입니다.
- 4일간의 청구 공백은 인력 문제가 아니라 서명된 종이가 트럭 운전실에서 사무실 책상까지 이동하는 속도 문제이며, 아무리 많은 인력을 고용해도 클립보드가 더 빨리 움직이게 할 수는 없습니다.
- 필드 위치가 아닌 필드 의미를 기준으로 추출 열을 한 번 정의하면, 15개 운송사의 POD 200건이 8시간에 걸쳐 입력하는 대신 1시간 안에 검토되는 단일 스프레드시트로 통합됩니다.
모든 물류 운영에서 발생하는 POD 데이터 병목 현상
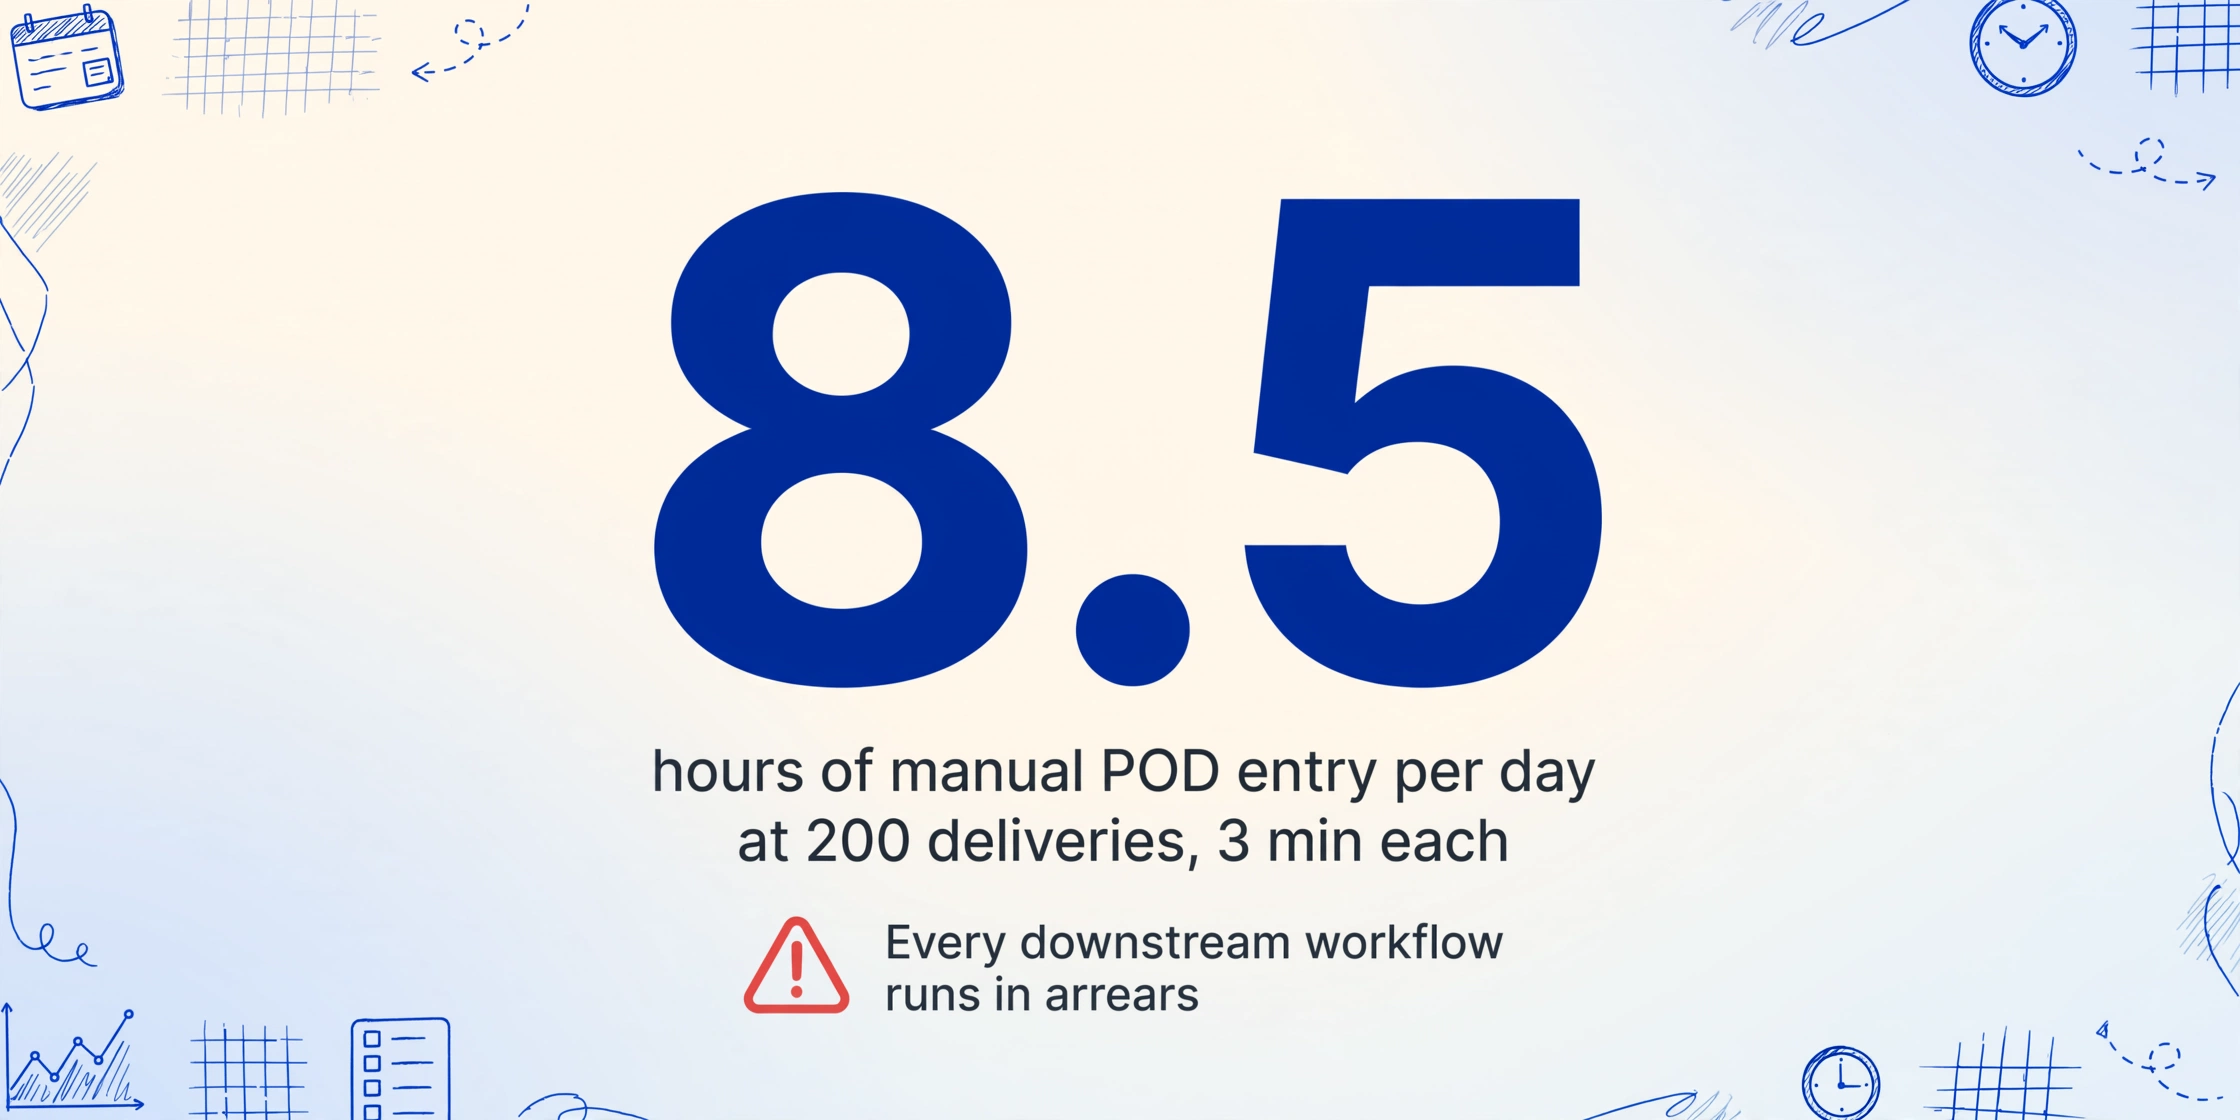
배송 증명서(POD) 문서는 모두 동일한 데이터에 의존하는 네 가지 운영 워크플로우의 교차점에 있습니다. 청구는 송장 발행을 위해 배송 확인이 필요하고, 고객 서비스는 "내 배송물이 어디 있나요?" 문의에 답하기 위해 필요하며, 클레임은 상품이 양호한 상태로 도착했는지 확인하기 위해 필요하고, 운송사 정산은 지불을 승인하기 위해 필요합니다. 서명된 종이 양식이 청구 시스템에 도달하는 데 4일이 걸리는 데이터 소스라면, 모든 하류 워크플로우는 지연된 상태로 운영됩니다.
계산은 간단합니다. 하루 200건의 배송을 처리하는 중간 규모의 화물 중개업체나 3PL은 세 가지 형식으로 POD를 받습니다: 전국 운송사(FedEx, UPS, DHL)의 전자 PDF, 지역 LTL 운송사의 스캔 이미지, 그리고 소규모 차주 및 영세 운송업체의 손으로 쓴 카본지 양식입니다. 전자 PDF는 전체 물량의 15%에 불과할 수 있습니다 — 나머지는 이미지와 종이로 도착하며, 누군가 각 양식을 보고 12~20개 필드를 운송 관리 시스템(TMS) 대기열에 입력해야 합니다. POD 1건당 수작업 입력에 3분이 걸린다면, 하루 200건 배송 기준으로 8.5시간의 타이핑이 필요하며, 이 작업을 하는 사람은 고객 관계나 운송사 협상에 시간을 쓰는 것이 더 바람직한 인력일 가능성이 높습니다.
Carmack Amendment(49 U.S.C. §14706)는 미국 내 주간 운송에서 운송사의 책임을 규율하며, 이 병목 현상에 또 다른 차원을 더합니다. Carmack에 따라 운송사는 배송 후 최소 9개월 이내에 손실 또는 손상 클레임에 대한 서면 통지를 접수해야 합니다 — 그러나 배송 시점에 무슨 일이 있었는지를 입증하는 것은 POD에 달려 있습니다. 부족 배송이나 숨은 손상에 대한 분쟁이 발생하면, POD가 수령 내용의 주요 증거입니다. POD 데이터가 찾는 데 2시간이 걸리는 종이 파일에 묶여 있다면, 분쟁 해결 기간은 몇 시간에서 며칠로 늘어납니다. 검색 가능한 POD 데이터베이스 — 모든 배송 날짜, 수령인 이름, 수량, 예외 메모가 구조화된 필드로 저장된 — 는 검색 시간을 몇 초로 단축합니다.
DSO 영향은 조용히 누적됩니다. 배송 후 송장 발행까지 4일이 걸린다면, 운전자본 순환에는 어떤 지불 조건 협상으로도 해결할 수 없는 고정 지연이 포함됩니다 — 지연이 고객의 지불 행동이 아니라 데이터 파이프라인에 있기 때문입니다.
POD에 포함된 정보 — BOL보다 디지털화가 어려운 이유
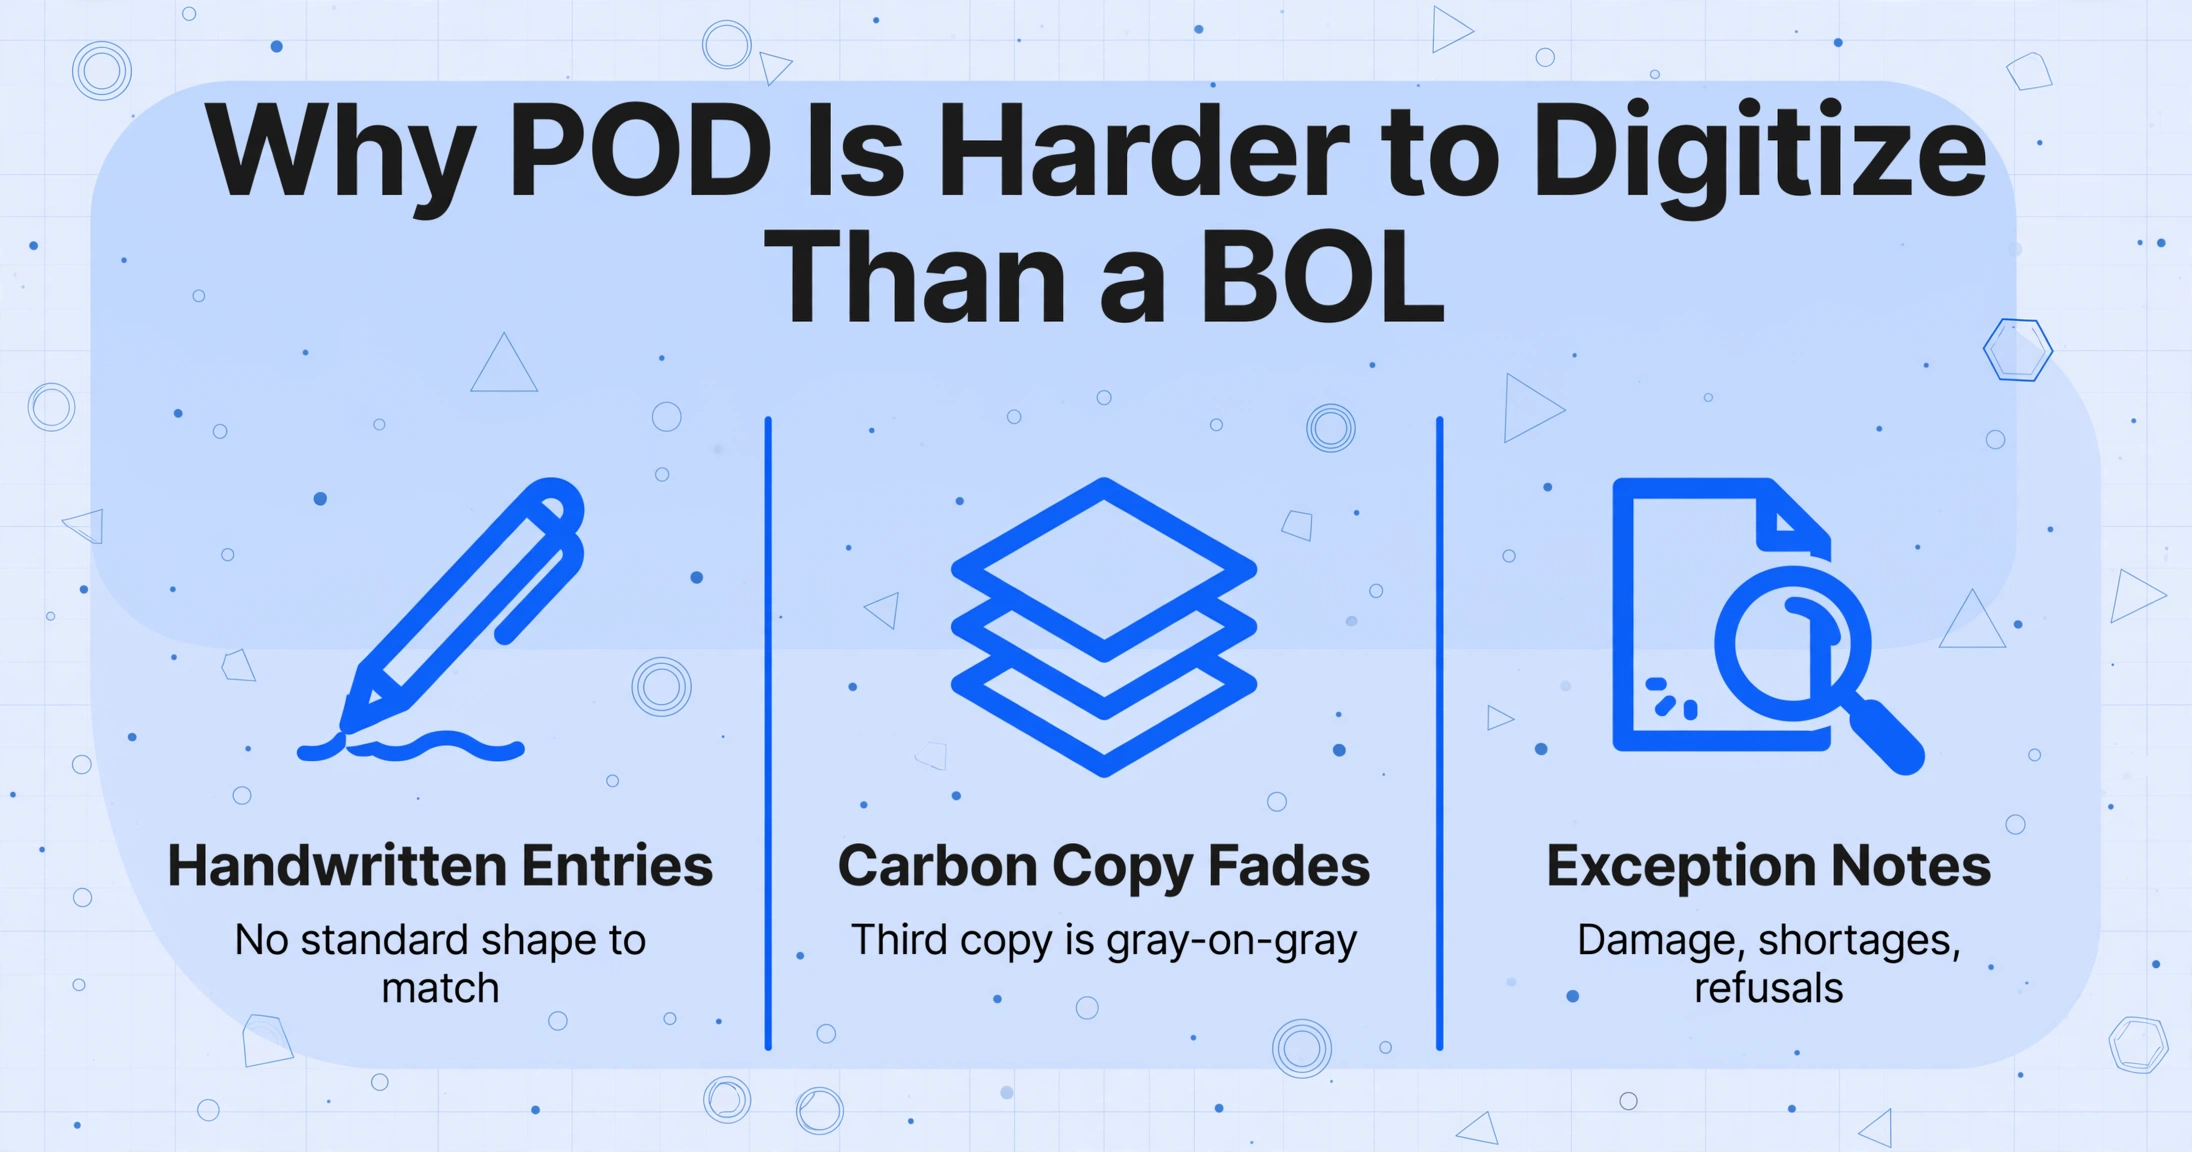
배송 증명서(POD) 문서는 표면적으로 단순해 보입니다. 상품이 인도되었음을 확인하는 몇 개의 필드가 있는 양식일 뿐입니다. 그러나 실제로는 각각 개별적으로도 어렵고, 함께 결합되면 이 문서 유형에만 고유한 세 가지 문서 처리 과제가 결합되어 있습니다.
손으로 쓴 서명과 항목. 운전기사는 배송 시간, 팔레트 수, 예외 메모를 손으로 작성합니다. 종종 FMCSA 49 CFR Part 395 운행 시간 규정에 따라 14시간 교대 근무 후, 차량 안에서 클립보드에 적습니다. 수령인은 서명하고 때로는 여백에 "12개 중 15개 수령" 또는 "1개 상자 파손 — 수락"이라고 적습니다. 두 필적 모두 최적의 조명 아래 책상에서 작성된 것이 아닙니다. 인쇄된 문자를 알려진 글꼴과 모양을 대조하여 분할하는 기존 OCR 도구는 표준 모양이 없기 때문에 이러한 내용을 처리하지 못합니다. 서둘러 쓴 "qty 12"는 문자 일치 엔진에 "qty 14"와 구분할 수 없게 보일 수 있습니다.
카본 사본의 열화. 대부분의 종이 POD는 여러 부로 구성된 카본 양식입니다. 첫 번째 사본은 읽을 수 있습니다. 두 번째 사본은 더 옅습니다. 세 번째 사본에 이르면 펜 압력이 거의 전달되지 않아 문자가 유령 이미지가 됩니다. 획이 누락되고 대비가 거의 0에 가까운 희미한 윤곽선입니다. 세 번째 카본 사본의 표준 스캔은 회색 위에 회색 이미지를 생성하며, 대부분의 OCR 도구는 필기체는커녕 어떤 텍스트도 추출할 수 없습니다.
비정형 예외 주석. POD에서 운영상 가장 중요한 정보는 종종 가장 구조화되지 않은 경우가 많습니다. 운전기사는 여백에 "2개 상자 부족"이라고 씁니다. 수령 담당자는 숫자에 동그라미를 치고 "거부 — 수해 손상"이라고 씁니다. 수령인은 서명란 옆에 서명 대신 "John에게"라고 씁니다. 이러한 메모는 지정된 필드에 나타나지 않으며 운송업체 양식마다 동일한 위치에 나타나지 않지만, 화물이 수락, 이의 제기 또는 거부되는지 여부를 결정하는 정보를 포함하며, 청구 및 클레임 워크플로우가 작동하려면 반드시 캡처되어야 합니다.
다중 정차 배송 명세서. 단일 POD 시트는 종종 동일한 경로의 3~5개 배송 정차를 포함합니다. 각 정차는 인쇄된 선이나 번호가 매겨진 섹션 구분으로 분리된 동일한 양식의 별도 섹션입니다. 추출은 정차 1이 끝나고 정차 2가 시작되는 지점을 구분해야 합니다. 그렇지 않으면 전체 출력이 잘못 귀속된 수량으로 병합된 행으로 붕괴됩니다. 이는 단일 필드를 읽는 것보다 더 어려운 문제입니다. 필드 수준이 아닌 섹션 수준에서 문서 레이아웃을 이해해야 하기 때문입니다.
워크플로우: 운전자 클립보드에서 TMS 가져오기까지
POD 추출이 실제 물류 운영에서 어떻게 활용되는지 이해하려면, 오늘날 대부분의 화물 중개업체와 3PL에서 존재하는 종단 간 워크플로우를 파악하는 것이 도움이 됩니다.
운전자가 배송을 완료하고 POD를 확보합니다
운전자는 다중 사본 탄소지 양식에 서명을 받거나, 휴대폰으로 서명된 영수증 사진을 촬영합니다. 국가 대형 운송사(FedEx, UPS)의 경우 POD가 전자적으로 캡처되어 몇 분 내에 운송사 포털에 업로드됩니다. 지역 LTL 운송사와 오너-오퍼레이터의 경우, 종이 양식은 운송 폴더에 보관됩니다.
POD가 지연된 채 백오피스에 도착합니다
종이 POD는 운전자가 기지로 복귀할 때 사무실에 도착합니다 — 당일 업무 종료 시, 다음 날 아침, 또는 장거리 운송의 경우 주말에 도착합니다. 운송사 포털의 전자 POD는 일괄 다운로드됩니다. 두 경우 모두 동일한 대기열, 즉 데이터 입력을 기다리는 문서 더미에 쌓입니다.
데이터 입력 담당자가 TMS에 필드를 입력합니다
담당자는 각 POD에 대해 배송 번호, 날짜, 수령인 이름, 수령 수량, 서명 상태, 예외 메모를 읽고 이를 TMS 선적 기록에 입력합니다. MercuryGate, McLeod LoadMaster, TMW Suite(Trimble), Descartes, Turvo와 같은 플랫폼은 청구 및 고객 알림 처리를 위해 구조화된 선적 데이터를 요구합니다. POD 1건당 3분, 하루 200건의 POD를 처리할 경우, 이 단계는 일일 100~120건 배송당 정규직 1명의 인력을 소모합니다.
청구가 인보이스를 생성하지만 데이터 공백으로 지연됩니다
TMS는 확인된 POD 데이터가 있는 배송에 대해서만 인보이스를 발행할 수 있습니다. 필드가 입력될 때까지 해당 배송은 "확인 대기 중" 상태로 남아 있습니다. 하루 200건의 배송을 기준으로, 이 백로그는 매주, 매월 청구가 2~4일 지연됨을 의미합니다.
클레임 및 분쟁에는 POD 조회가 필요하며, 종종 수동으로 처리됩니다
화주가 Carmack Amendment 체계에 따라 화물 클레임을 제기하면, 중개업체나 3PL은 배송 상태를 확인하기 위해 POD를 제시해야 합니다. 종이 파일이나 선적 날짜별로 스캔된 PDF를 사용하는 경우, 단일 조회에 파일 검색에 15~30분이 소요됩니다. 구조화된 데이터를 사용하면 동일한 조회에 5초밖에 걸리지 않습니다.
추출 워크플로는 3단계를 자동 추출로 대체하여, 4단계의 2~4일 지연을 당일 또는 익일 청구로 단축합니다. 핵심은 추출이 TMS 교체, 운송업체 변경, 또는 새 하드웨어 배포를 요구하지 않는다는 점입니다. 종이가 키보드를 만나는 지점에서 기존 워크플로에 통합됩니다.
POD 데이터 추출 방법: 단계별 가이드
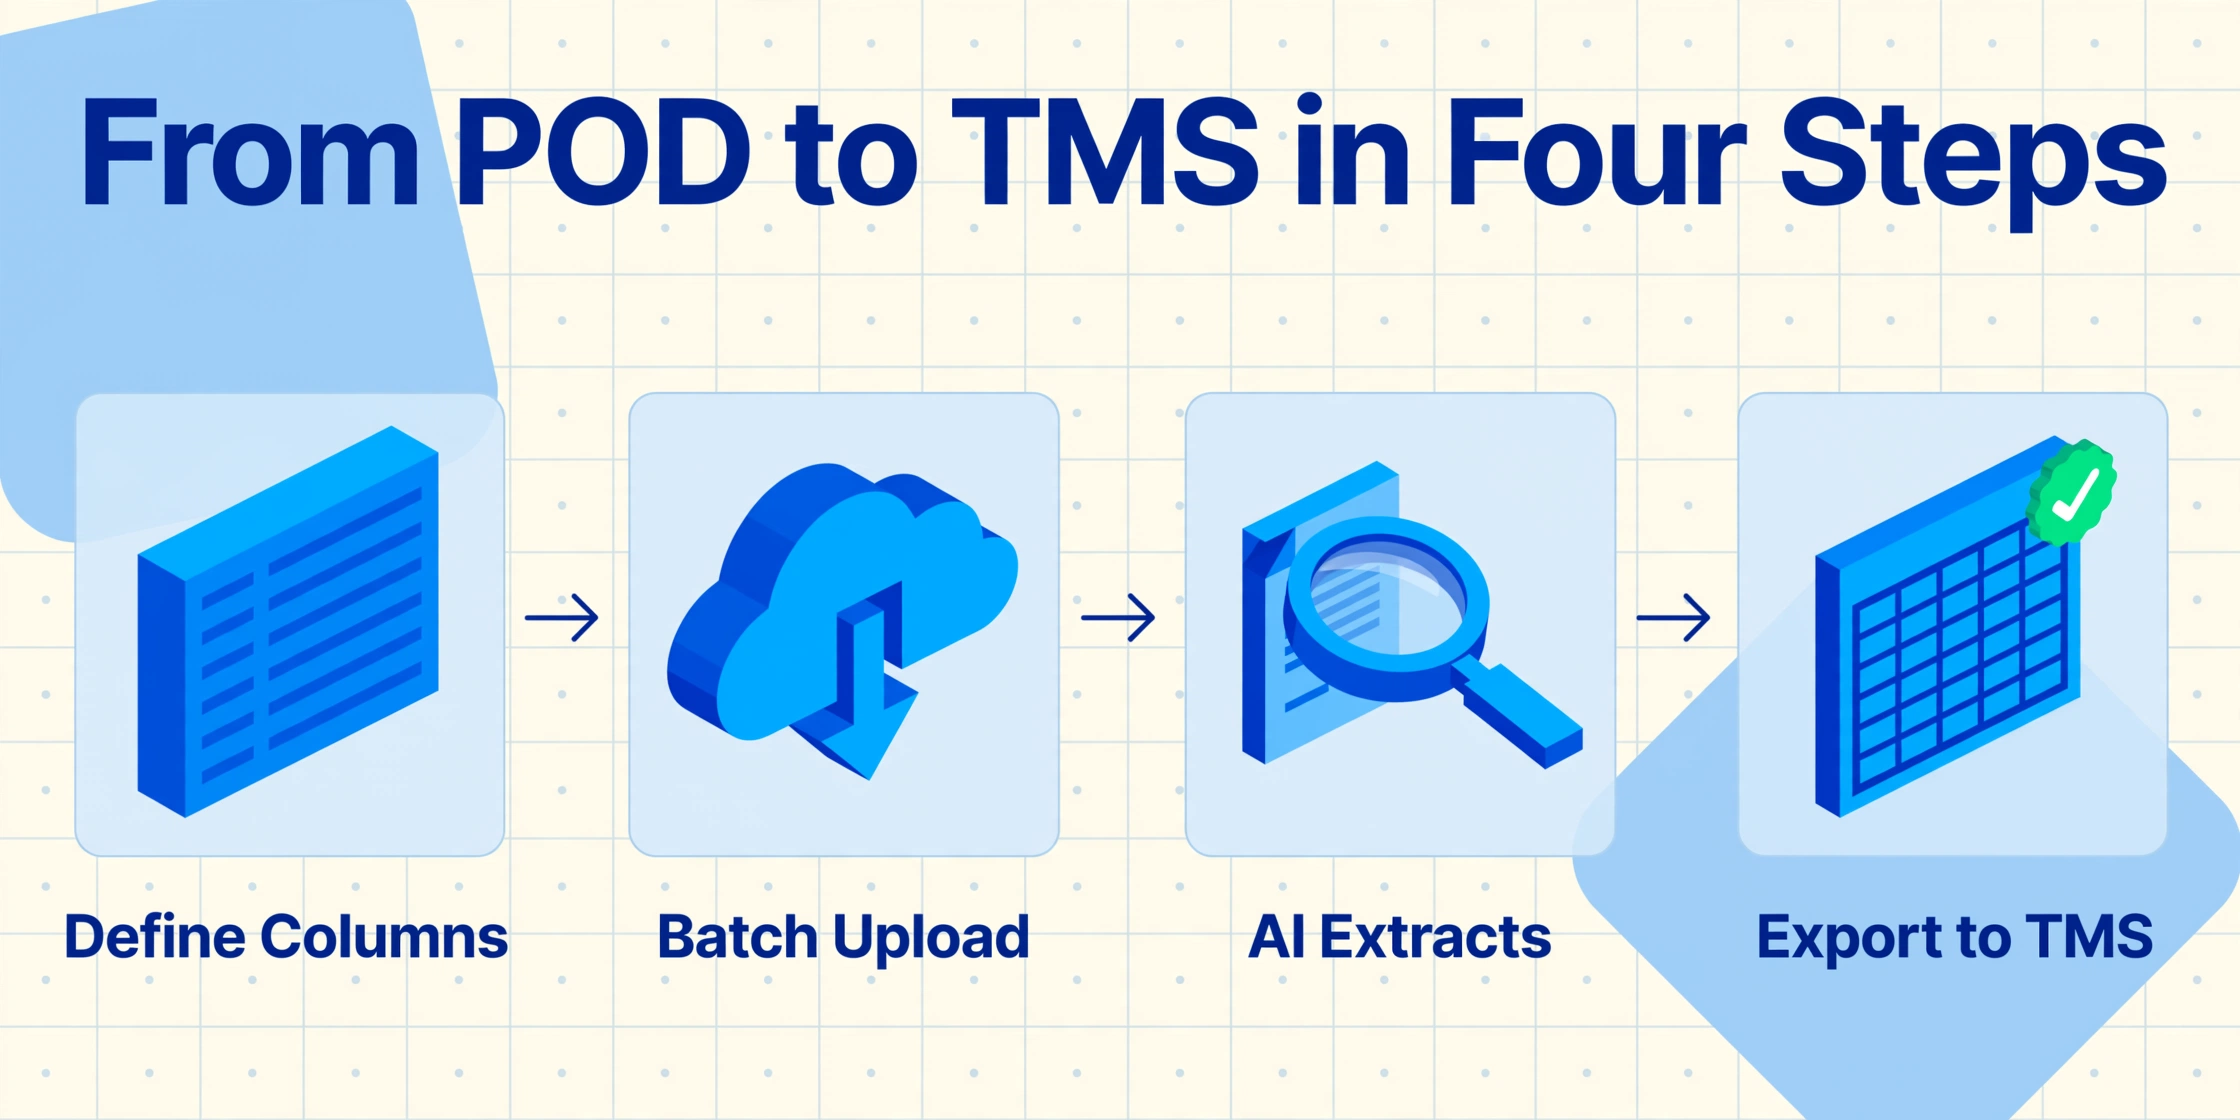
추출 프로세스는 송장, 포장 명세서, 선하증권에 적용되는 것과 동일한 노코드 일괄 처리 워크플로를 따르지만, POD는 고유한 특성을 반영한 특정 열 정의와 형식 처리가 필요합니다.
TMS 가져오기 템플릿에 맞게 추출 열을 정의하세요
출력 스프레드시트에 원하는 열 이름을 입력하세요. 입력한 열 이름은 추출 지침이자 스프레드시트 헤더가 됩니다. POD 워크플로의 경우 필수 열은 TMS가 기대하는 형식과 일치해야 합니다:
Delivery Number / PRO Number— TMS 화물 기록에 연결Delivery Date— 실제 배송 날짜Delivery Time— 배송 시간Consignee / Recipient Name— 화물을 수령한 사람Delivery Address— 실제 배송지Quantity Shipped vs. Quantity Received— 불일치 추적Signature Status— 서명됨 / 서명 안 됨Condition Notes / Exception Notes— 손상 표기, 부족, 거부 사항Driver Name— 배송을 수행한 기사
가능하면 TMS 가져오기 필드 이름과 일치하도록 열 이름을 지정하세요. 이렇게 하면 자동화로 절약한 시간을 다시 소모하는 재구성 단계를 피할 수 있습니다. MercuryGate 또는 McLeod 가져오기 템플릿에 직접 매핑되는 PRO_NUMBER 열이 재매핑 단계가 필요한 "POD ID" 열보다 더 가치 있습니다.
당일 POD를 일괄 업로드하세요
스캔한 카본 사본, 손으로 쓴 전표의 휴대폰 사진, 캐리어 포털 PDF 다운로드 등 모든 POD 파일을 한 번에 업로드하세요. AI는 정의된 열 구성을 사용하여 병렬로 처리합니다. 업로드 전에 캐리어나 양식 유형별로 분류할 필요가 없습니다. 카본 사본의 최상의 결과를 위해: 3부 사본은 300 DPI 이상의 평판 스캐너를 사용하고, 원본과 전자 PDF는 표준 해상도의 휴대폰 사진으로 충분합니다. 스캐너 없이 문서를 캡처하는 방법에 대한 자세한 내용은 휴대폰으로 문서 디지털화하기 가이드를 참조하세요.
추출 및 검토
AI가 각 POD를 읽고 정의한 열을 채웁니다. 손으로 쓴 카본 사본의 경우 AI의 비전 모델이 문맥에서 문자를 추론합니다. "QTY RCVD" 옆의 흐릿한 "12"는 AI가 합리적인 배송 수량이 무엇인지 이해하므로 "14"보다 "12"일 가능성이 높습니다. 낮은 신뢰도로 표시된 필드를 검토하세요. 대부분의 선명한 필체의 원본 POD의 경우 85-95%의 필드가 수정 없이 정확하게 추출됩니다.
TMS로 내보내기 및 가져오기
결과를 Excel 또는 CSV로 내보내십시오. 출력은 POD당 한 행씩 — 운송사별도, 파일별도 아닌 — 사용자가 정의한 열 이름과 일치하는 하나의 스프레드시트입니다. 표준 CSV 가져오기 기능을 사용하여 파일을 TMS로 가져오십시오. MercuryGate, McLeod LoadMaster, TMW Suite, Descartes, Turvo와 같은 플랫폼은 모두 열 매핑이 포함된 구조화된 파일 가져오기를 지원합니다. 가져오기는 몇 시간이 아닌 몇 분이 소요되며, 1단계에서 열 이름이 TMS 템플릿과 일치하도록 설정되었으므로 매핑 단계는 일회성 구성입니다.
파일 내보내기-가져오기 주기를 완전히 건너뛰고자 하는 운영의 경우, Google Sheets 애드온이 추출 결과를 TMS 가져오기 파이프라인이나 내부 추적 대시보드에 공급하는 스프레드시트에 직접 작성할 수 있습니다 — 동일한 추출, 파일 핸드오프 한 단계 감소.
다중 운송업체 형식이 다중 운송업체 템플릿을 요구하지 않는 이유
이것이 대부분의 물류 팀이 추출 도입을 망설이게 만드는 질문입니다: "우리는 15개 다른 운송업체로부터 POD를 받는데, 각각 다른 양식 레이아웃을 사용합니다. 그렇다면 15개의 템플릿이 필요한가요?"
템플릿 기반 추출 도구를 사용하는 경우, 대답은 '예'입니다. 각 운송업체의 레이아웃에는 별도의 파싱 구성이 필요합니다: 운송업체 A의 양식에 배송 번호 필드 주위에 상자를 그리고, 운송업체 B의 양식에는 다른 상자를 그리며, 운송업체가 레이아웃을 업데이트할 때마다 각각을 유지 관리해야 합니다. 수십 개 운송업체로부터 POD를 받는 화물 중개인의 경우, 이러한 템플릿 유지 관리 부담은 자동화로 절약되는 시간을 빠르게 초과합니다.
열 이름 추출 — ImageToTable.ai가 사용하는 접근 방식 — 은 다르게 작동합니다. 필드 위치를 정의하는 대신 필드 의미를 정의합니다. "배송 날짜"를 열 이름으로 한 번 입력하면, AI의 비전 모델이 배송 날짜가 무엇인지 이해하여 각 POD에서 해당 값을 찾습니다 — 고정 좌표에서 텍스트를 찾는 것이 아닙니다. 배송 날짜가 오른쪽 상단에 있는 FedEx SmartPost POD, 중앙 블록에 인쇄된 지역 LTL 운송업체의 양식, 운전자가 "DATE" 옆에 직접 적은 개인 사업자(owner-operator)의 손글씨 전표 모두 운송업체별 구성 없이 동일한 열 정의를 통과합니다. 이것이 템플릿 불필요 AI 추출 패턴입니다: 추출 엔진은 위치가 아닌 의미로 읽습니다.
물류 운영에 대한 실질적 영향: 20개 다른 운송업체의 POD 200장을 단일 업로드로 일괄 처리하고, 열을 한 번 정의하면 통합 스프레드시트 하나를 얻을 수 있습니다. 운송업체별 사전 분류 불필요. 운송업체별 템플릿 설정 불필요. 운송업체가 양식 디자인을 업데이트해도 유지 관리 불필요.
다중 정차 화물 명세서 처리: 가장 까다로운 POD 사례
세 번의 배송 정차를 포함하는 단일 POD 시트는 같은 페이지에 인쇄된 세 개의 별도 미니 양식처럼 보이며, 가로선이나 번호가 매겨진 구역 구분선으로 나뉩니다. 각 정차마다 고유한 배송 번호, 수령인, 수량, 서명이 있습니다. 추출 과정에서 이러한 구역 경계를 인식하고 각 행을 올바른 정차에 할당해야 합니다. 그렇지 않으면 전체 배치 출력이 배송을 합쳐 버려 사용할 수 없게 됩니다.
이것이 바로 의미론적 추출의 가치가 발휘되는 지점입니다. AI는 레이아웃 수준에서 문서를 읽습니다. 페이지를 가로지르는 가로선 뒤에 새 "Stop 2" 헤더가 오는 것을 서식상의 단순한 요소가 아닌 구역 경계로 인식합니다. 출력은 각 정차를 스프레드시트의 자체 행에 할당하고, 필드는 올바른 배송 구간에 귀속됩니다. 모든 문서에서 완벽하지는 않습니다. 스캔 품질이 낮거나 극도로 밀집된 양식의 구역 경계는 모호할 수 있지만, 인쇄된 대부분의 다중 정차 양식은 안정적으로 처리합니다. 솔직한 평가: 정기적으로 단일 시트에서 다중 정차 화물리스트를 처리한다면, 특히 경계 표시가 희미하거나 손으로 작성된 경우 구역 귀속에 대한 검토 시간을 예산에 반영하십시오.
POD 데이터를 선하증권 및 포장 명세서와 상호 연결
POD는 단독으로 존재하지 않습니다. POD는 픽업 시 발행되는 선하증권(BOL)으로 시작하여 포장 명세서, 배송 명세서, POD(배송 시 서명)를 포함하는 문서 체인의 최종 연결 고리입니다. 이 체인의 각 문서는 중복되지만 서로 다른 정보를 포함하며, 이를 서로 연결하는 것이 완전한 배송 기록을 만드는 방법입니다.
POD를 처리하는 동일한 추출 워크플로우는 PRO 번호 또는 배송 번호를 연결 키로 사용하여 선하증권과 포장 명세서를 별도의 배치 또는 동일한 배치에서 처리할 수 있습니다. POD가 12개 팔레트 배송을 확인하지만 BOL이 14개 출하를 표시하면, 이 불일치는 청구 분쟁이 되기 전에 구조화된 데이터 포인트로 표면화됩니다. 이 워크플로우의 BOL 측면에 대한 자세한 내용은 추출된 BOL 데이터가 TMS에 공급되는 방법을 참조하십시오.
창고 환경에서 손으로 작성된 수령 문서를 처리하는 운영의 경우 — 운전자가 종이 배송 명세서를 제시하고 수령 담당자가 수량과 상태를 손으로 주석 처리하는 경우 — POD 추출 워크플로우는 배치 포장 명세서 및 배송 명세서 추출에 사용된 것과 동일한 열 이름 접근 방식을 따릅니다. POD를 읽는 동일한 열 구성은 상품 수령 확인서와 창고 화물리스트도 읽을 수 있어 배송 체인의 다양한 지점에서 캡처된 문서로 통합 수령 대시보드를 만듭니다. 인쇄된 배송 데이터와 서명된 배송 명세서의 손으로 작성된 수령 표시를 모두 읽는 단계별 방법은 창고 수령에서 손으로 작성된 배송 명세서 추출 가이드를 참조하십시오.
전체 배송 명세서/POD 그림 — 이러한 문서가 인보이스보다 추출하기 어려운 이유, 조정에 가장 중요한 필드, 도구 평가 방법 — 에 대한 내용은 배송 명세서 및 POD 추출 완전 가이드에서 시작하십시오. 지금 바로 자체 POD에서 추출을 테스트하려면 배송 명세서를 Excel로 변환기를 사용하십시오.
정확도가 높은 영역 — 사람의 검토가 필요한 영역
모든 추출 도구에는 정확도 한계가 있으며, POD는 대부분의 문서 유형보다 그 한계를 더 빨리 드러냅니다. AI가 잘 처리하는 부분과 그렇지 않은 부분을 구체적으로 설명하면 정확한 기대치를 설정하고, 새로운 검증 부담을 만들기보다 실제로 시간을 절약하는 워크플로우를 구축할 수 있습니다.
잘 처리하는 영역:
- 명확한 블록체 필체가 있는 원본 카본지 양식 — 인쇄된 배송 번호 및 날짜와 같은 명확한 필드에서 최대 99% 정확도 달성
- 국내 운송업체(FedEx, UPS, DHL)의 전자 POD — 일관된 필드 라벨이 있는 기계 인쇄 텍스트
- 서명 존재 감지 — AI가 서명 필드에 서명 표시가 있는지 확인하여 "서명됨" 또는 "서명 안 됨"으로 출력
- 인쇄된 필드 라벨 및 사전 입력된 운송업체 정보
- 비고란의 표준 예외 주석 — 필체가 읽을 수 있는 경우
사람의 검토가 필요한 영역:
- 제3원본 카본지 양식 — 대비가 낮아 자동 판독이 어렵습니다. 대부분의 필기 필드를 검토해야 합니다.
- 다중 정차 운송장의 구역 경계 감지 — 특히 구분선이 인쇄된 규칙이 아닌 희미한 필기 대시인 경우
- 비에 손상되거나 구겨진 양식 — 환경적 손상에 비례하여 추출 정확도가 감소합니다.
- 서명자 신원 — AI는 서명이 있는지 확인하지만 알려진 샘플과 대조하여 서명자의 신원을 확인하지는 않습니다.
- POD에 첨부된 손상 사진 — AI는 양식 자체의 텍스트를 추출하지만 첨부된 사진의 내용을 해석하지는 않습니다.
데이터의 10% 미만을 확인하면서 추출 오류의 95%를 포착하는 실용적인 검증 프레임워크는 표적 샘플링을 통한 추출 결과 검증 가이드를 참조하세요. 특정 필기 추출 문제를 해결하려면 — OCR 또는 AI 도구가 중요한 필드를 잘못 읽는 경우를 포함하여 — 필기에서 OCR이 실패하는 이유와 해결 방법 가이드를 참조하세요.
하루 200건의 POD를 처리하는 물류 운영의 실질적인 시간 절감 효과: 모든 양식을 한 줄씩 읽고 15-20개 필드를 처음부터 입력하는 대신, 운영자는 미리 채워진 테이블을 검토하고 문서당 3-5개의 플래그된 필드만 수정합니다. 이는 하루 총 추출 필드 3,000-4,000개 중 약 600-1,000개의 플래그된 필드를 검토하는 것을 의미하며, 수동 데이터 처리량이 75-85% 감소하여 전체 데이터 입력 6-8시간 대신 약 1-1.5시간의 검토 시간으로 단축됩니다.
자주 묻는 질문
AI가 글씨가 매우 희미한 카본 카피 POD에서도 데이터를 추출할 수 있나요?
가능하지만, 정확도는 카본 사본 종류에 따라 다릅니다. 흰색 사본은 안정적으로 추출됩니다. 분홍색 사본은 더 흐리지만 여전히 읽을 수 있습니다. 파란색 또는 노란색 사본은 대비가 너무 낮아 공급업체에 관계없이 대부분의 AI 추출이 신뢰할 수 없는 결과를 생성합니다. 세 번째 사본의 경우, 600 DPI 평판 스캐너와 대비 향상 기능을 사용하고, 출력물에 대한 전체 수동 검토를 예산에 포함하세요.
각 운송사 POD 형식에 대해 다른 템플릿이 필요한가요?
템플릿 없는 추출 방식이라면 그렇지 않습니다. 배송 번호, 배송 날짜, 수령인, 수량, 서명 상태 등 원하는 열을 한 번만 정의하면 AI가 각 필드의 의미를 이해하여 모든 운송사의 POD에서 해당 값을 찾습니다. FedEx POD, UPS 배송 영수증, 지역 LTL 운송사의 카본 양식, 자영업자의 수기 전표 모두 동일한 열 정의로 처리됩니다. 운송사별 템플릿 설정이나 유지보수가 필요 없습니다.
AI가 POD에 서명이 있는지 감지할 수 있나요?
네, 가능합니다. AI는 서명란에 필기된 표시의 존재를 감지하여 "서명됨 / 서명 안 됨" 상태를 출력합니다. 이는 수령지에서 누군가가 배송을 확인했음을 확인하기에 충분하며, 대부분의 청구 워크플로우에 적합합니다. 서명자의 신원을 확인하거나 샘플과 서명을 대조하지는 않습니다. 서명 확인을 위해서는 별도의 생체 인식 또는 법의학적 절차가 필요합니다.
여백에 손상 메모나 예외 사항이 적힌 POD는 어떻게 처리하나요?
추출 설정에서 "예외 메모" 또는 "손상 메모"라는 열을 정의하세요. AI는 문서 전체를 스캔하여 배송 예외를 설명하는 내용을 찾습니다. 구조화된 손상 표기와 비구조적인 여백 낙서를 모두 캡처합니다. 핵심은 AI가 특정 위치가 아닌 의미를 기준으로 이 콘텐츠를 검색한다는 점입니다.
여러 정류장을 포함하는 POD에서 데이터를 추출할 수 있나요?
AI 추출은 인쇄된 선, 구분선, 또는 번호가 매겨진 섹션 제목 등 섹션 경계를 인식하여 여러 정류장 명세서를 처리할 수 있으며, 각 정류장의 데이터를 출력의 별도 행에 할당합니다. 이는 명확한 섹션 표시가 있는 인쇄된 다중 정류장 양식에서 안정적으로 작동합니다. 섹션 경계가 손으로 작성되었거나, 스캔 상태가 좋지 않아 정류장이 시각적으로 겹치는 양식에서는 신뢰성이 떨어집니다. 다중 정류장 명세서를 대량으로 처리하는 운영의 경우, 특히 세 번째 복사본이나 빗물에 손상된 양식의 경우 섹션 할당에 검토 시간을 확보하세요.
POD 추출을 기존 TMS와 어떻게 연동하나요?
추출 결과물은 모든 TMS에서 가져올 수 있는 표준 Excel 또는 CSV 파일입니다. 추출 시 정의하는 열 이름을 TMS의 가져오기 필드 이름과 일치하도록 설정할 수 있으므로, 추출 결과와 TMS 가져오기 간에 수동으로 다시 매핑할 필요가 없습니다. MercuryGate, McLeod LoadMaster, TMW Suite, Descartes, Trimble, Turvo를 포함한 대부분의 플랫폼은 구조화된 CSV 가져오기를 지원합니다. 이 추출은 키보드를 통한 수동 데이터 입력을 대체하며, TMS는 이전과 같이 화물 추적, 청구, 운송사 커뮤니케이션을 계속 처리합니다.
POD 필드가 비어 있으면 어떻게 되나요?
AI는 출력에서 빈 필드를 그대로 비워둡니다. 손상 메모가 없는 POD는 "예외 메모" 셀이 비어 있으며, AI는 내용을 임의로 생성하거나 기본값을 채우지 않습니다. 이는 빈 셀이 열 정렬과 행 구조를 유지하기 때문에 일괄 출력에 중요합니다. TMS로 가져올 때 빈 필드는 null 값으로 전달되며, 대부분의 플랫폼에서 오류 없이 처리됩니다.
자신의 문서에서 POD 데이터 추출 시작하기
배송과 청구 사이의 4일 간격은 운송사가 느리거나 팀 인력이 부족해서 생기는 것이 아닙니다. 배송이 완료되었음을 증명하는 데이터가 손으로 읽고 입력해야 하는 종이 형식으로 존재하기 때문입니다. 이 문서에서 설명하는 추출 워크플로우 — 열을 한 번 정의하고, 운송사나 형식에 관계없이 모든 POD를 일괄 업로드하고, 구조화된 데이터를 TMS로 내보내기 — 는 운전자의 배송 방식이나 운송사의 운영 방식을 바꾸지 않으면서 입력 단계를 제거합니다.
모든 운송사에 ePOD 소프트웨어를 배포하거나 운전자에게 새 앱 사용법을 교육할 필요가 없습니다. 이미 받고 있는 종이 POD — 운송사 PDF, 운전자 사진, 클립보드의 카본 사본 — 는 오늘 바로 인보이스와 포장 명세서를 처리하는 동일한 업로드 인터페이스를 통해 추출 워크플로우에 들어올 수 있습니다. 수십 년간 종이로 도착하던 데이터는 청구 마감 전에 검색 가능한 구조화된 스프레드시트가 됩니다.
자신의 POD로 테스트해 보세요. 하루 8시간의 데이터 입력이 1시간의 검토 세션으로 바뀌는지 확인해 보세요.
샘플 POD를 업로드하세요 — 운송사, 형식 무관 — 몇 초 안에 추출 결과를 확인할 수 있습니다. 계정이 필요 없습니다.