紙の書類からSIS対応の行データへ:
K-12(幼稚園~高校)入学フォーム抽出の完全ガイド
毎年8月、約4,900万人の米国の公立学校の生徒が教室に戻ります(全米教育統計センター、2024~25年)。今も紙の書類で入学手続きや更新を行うご家族にとって、手書きの氏名、チェックボックスの選択、医療メモのすべてを、授業開始前に生徒情報管理システム(SIS)へ入力する必要があります。一般的なK-12(幼稚園~高校)の入学書類は、12のセクションにわたり15~25ページに及びます。生徒の基本情報、保護者・緊急連絡先(複数フィールドの関係性を含む)、病歴、予防接種記録、通学手段の希望、複数の同意書などです。各セクションは異なるデータ形式を使用します。活字体、筆記体、チェックボックス、丸で囲む選択肢、自由記述欄などです。それぞれが従来のOCR(光学文字認識)では異なる形で失敗します。
重要なポイント
- 多くの学区は、オンライン登録ポータルがあればデータ入力の負担がなくなると考えています。しかし実際には、毎年8月に紙の書類を提出するご家族は今も多く、15~25ページの書類の山が事務室に届きます。
- テンプレートOCRはこの問題を解決するはずでしたが、入学フォームを特徴づける3つの要素で失敗します。同じページに混在する手書きと印刷、自由記述欄と並ぶチェックボックスのグリッド、そして緊急連絡先のように1つのレコードとしてグループ化されなければならない複数フィールドの関係性です。
- セマンティックAIはこの3つすべてに対応します。28フィールドの列セットを一度定義し、レイアウトに関係なく各学校の書類を1つのバッチでアップロードし、エラーが実際に影響を及ぼすフィールド(緊急連絡先と医療データ)に検証の焦点を絞ります。
生徒登録フォーム抽出とは?
生徒登録フォームのデータ抽出とは、K-12(幼稚園~高校)の学校登録書類一式(手書きまたは印刷された氏名、生年月日、保護者の連絡先、医療情報、チェックボックスの選択)からデータを読み取り、生徒情報管理システム(SIS)にインポートできる構造化されたスプレッドシートの行に変換する自動化プロセスです。これはAIデータ抽出の専門的な応用であり、登録フォームの混在フォーマットに対応します。あらかじめ印刷されたラベルと手書きの回答が共存し、チェックボックスは署名欄の隣にあり、自由記述の医療情報は構造化された住所ブロックと同じページにあります。
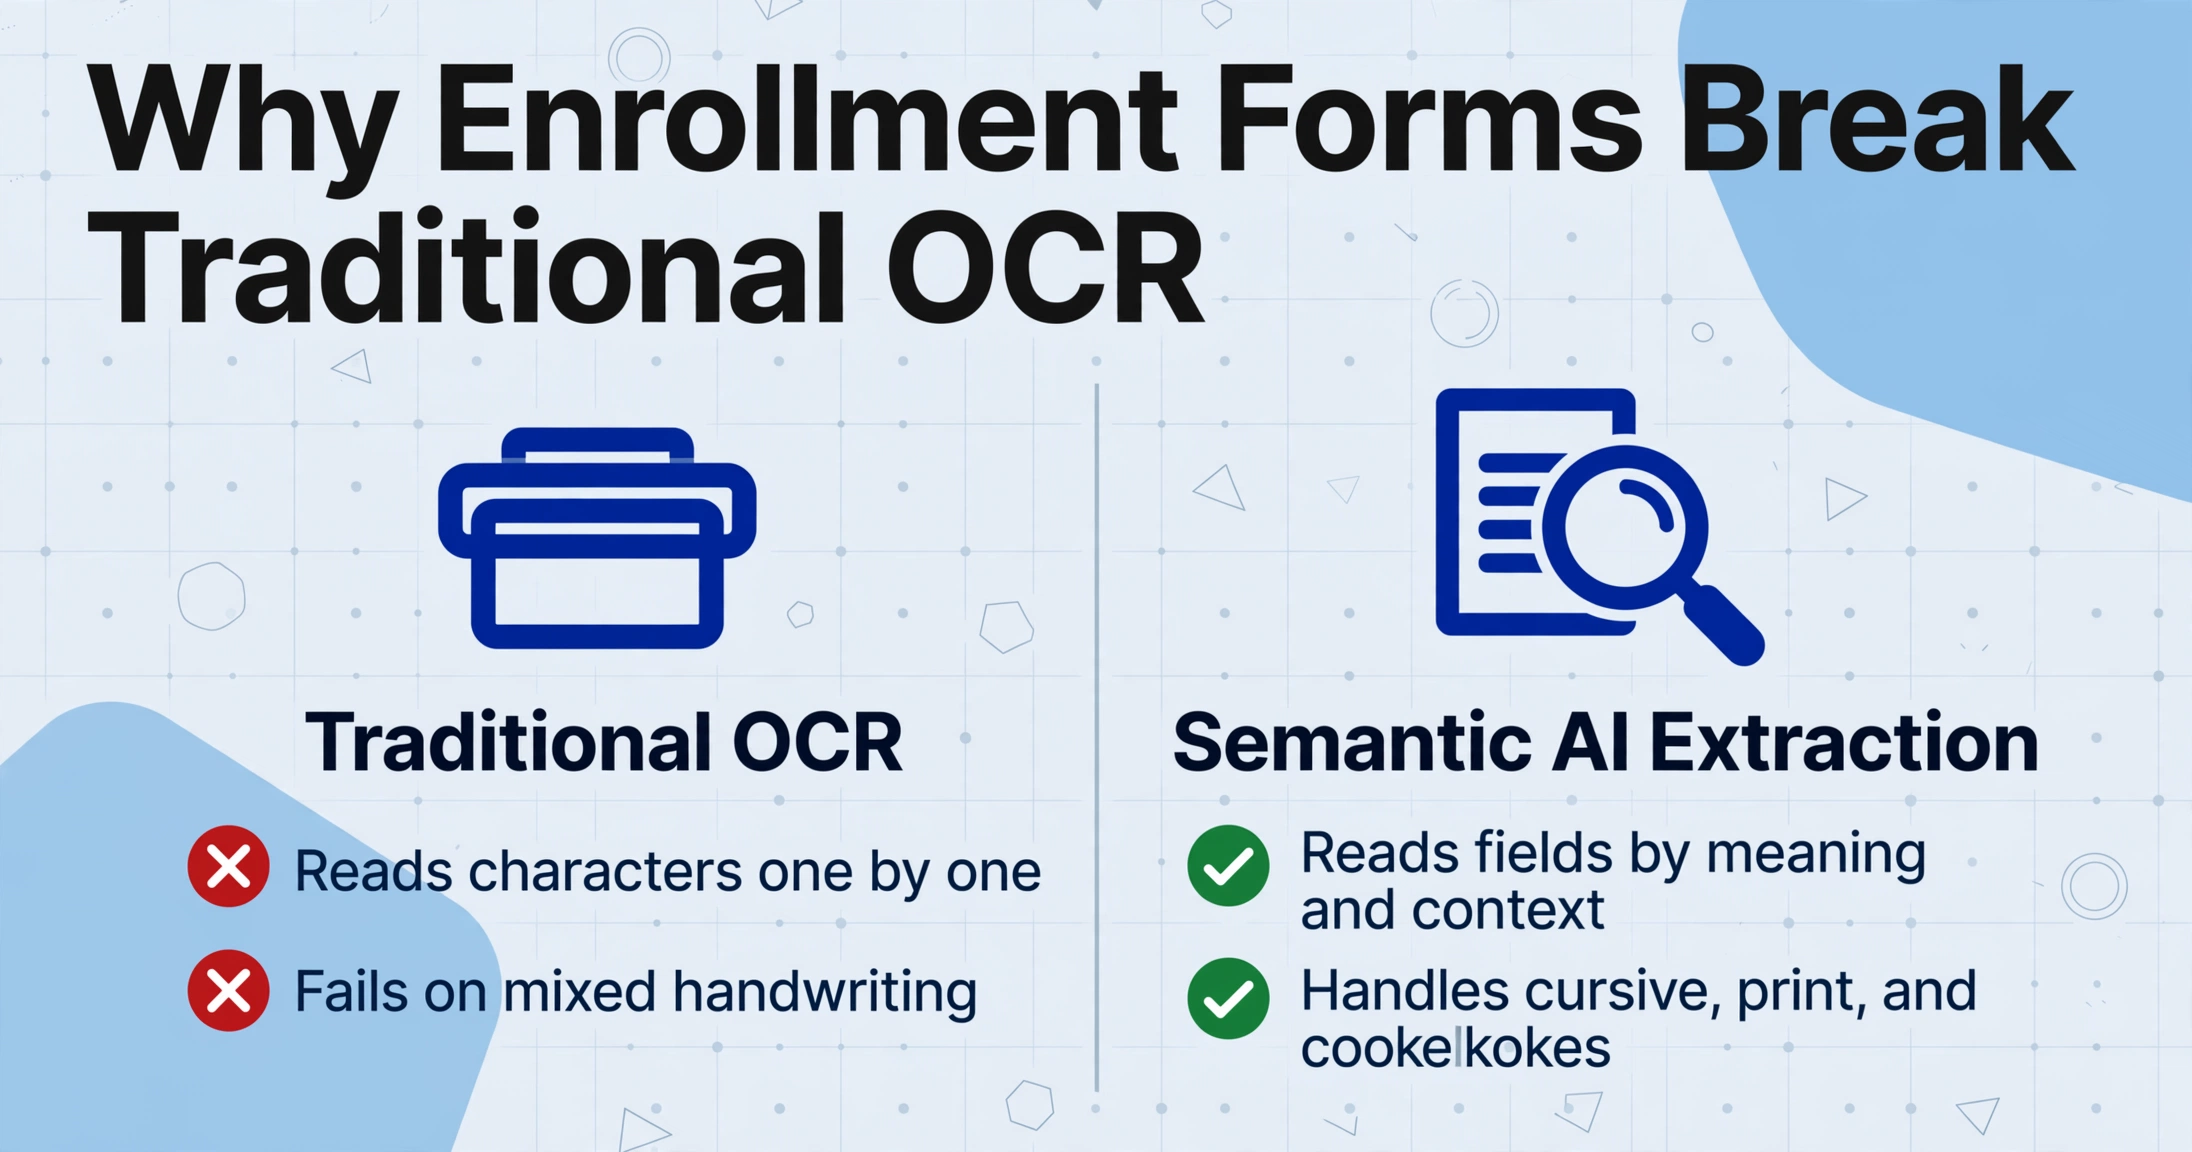
文字を一つずつ読み取るだけで意味を理解しない従来のOCR(光学文字認識)とは異なり、セマンティックAI抽出はフィールドをその意味と文脈によって識別します。これはImageToTable.aiなどの最新ツールで採用されているアプローチです。「緊急連絡先 — 氏名」というラベルのセクションに遭遇すると、AIはその領域から人物の氏名を抽出することを認識します。たとえ筆記体で全ての文字がつながっていてもです。このセマンティックな理解こそが、登録フォーム抽出を実用的な規模で機能させる理由です。なぜなら、学区ごとに登録書類の形式が異なり、保護者が同じ書き方をするとも限らないからです。
このガイドでは全体像を解説します。登録フォーム特有の課題(請求書や銀行明細書とは異なる)、紙の書類からSISインポートまでのエンドツーエンドのワークフロー、フィールドごとの抽出戦略、8月から9月の登録ピーク期のバッチ処理、子どもごとに別々の書類がある複数児童世帯の処理、FERPA(家庭教育の権利およびプライバシー法)への準拠、そして現在学区が選択できる3つのアプローチ(手動データ入力、テンプレートベースのOCR、セマンティックAI抽出)の比較です。
入学フォームが異なる抽出課題である理由
学校の入学書類一式は、単一のドキュメントタイプではありません。異なる構造を持つ十数種類のドキュメントが束ねられたものであり、それぞれが抽出ツールで処理される際に異なる挙動を示します。これらの構造上の現実を理解することが、大規模に機能するワークフローを構築するための前提条件です。
同じページに手書きと印刷テキストが混在する
入学フォームには通常、標準的な書体の印刷済みラベル(「生徒の法的姓 __________」)と、空欄に記入された手書きの回答があります。1ページに、丁寧な活字体で記入した保護者の印刷されたブロック体、急いで書いた別の保護者の筆記体、そして活字体でも筆記体でもない走り書きのチェックマークが混在する場合があります。従来のOCRは、きれいな背景上の均一な印刷テキスト用に設計されており、認識モードは1つだけ、つまり文字単位のデコードです。そのため、この混在入力では失敗します。セマンティックAIは各フィールドを個別に処理し、印刷されたラベルが提供するコンテキストをアンカーとして、手書きコンテンツの抽出を固定します。同じメカニズムが一般的な手書きフォーム抽出の基盤となっており、入学書類一式はその中でも難しいケースの1つです。
チェックボックスと自由記入欄が隣り合う
入学フォームには、「お子様にアレルギーはありますか? ☐ はい ☐ いいえ」のような二者択一の質問が密集しており、その直後には詳細を求める自由記入欄が続きます。保護者はアレルギーの質問に「はい」とチェックを入れ、下のテキスト欄に「ペニシリン — 発疹が出る」と書くかもしれません。抽出ツールは、二者択一のシグナル(どのボックスにマークが付いているか)と、叙述テキスト(保護者が実際に書いた内容)を、2つの別個でありながら関連するデータポイントとして読み取る必要があります。この組み合わせは、ドキュメント全体を読むセマンティックAIモデルにとっては簡単です。しかし、チェックボックス領域とテキスト領域に別々のルールを必要とし、両者を関連付ける方法がないテンプレートOCRにとっては、驚くほど困難です。
複数フィールドの関連構造
入学フォームの緊急連絡先セクションは、学生フォームが一般的なビジネス文書よりも複雑である理由を示しています。1つのフォームに「緊急連絡先1 — 氏名、続柄、電話番号」と「緊急連絡先2 — 氏名、続柄、電話番号」が求められる場合があります。各連絡先の3つのフィールドは、同じ人物参照にリンクされています。抽出ツールは、「John Smith」「Father」「555-123-4567」が同じ緊急連絡先レコードに属し、「Mary Jones」「Aunt」「555-987-6543」が別の連絡先に属することを認識する必要があります。スプレッドシート出力では、これは学生1人につき1行で、6つの緊急連絡先列(氏名1、続柄1、電話番号1、氏名2、続柄2、電話番号2)を持つことを意味し、AIはページ上の印刷されたラベルの隣にある位置を理解することで、各データを正しい列にマッピングする必要があります。
8月から9月の入学ピーク
タイミングの制約は、運用上最も重要な要素です。米国のほとんどの学区では、新規入学の大部分が7月中旬から9月上旬の4〜6週間の期間に集中し、在校生の更新(緊急連絡先の変更、新しい医療情報、同意書の更新)も同じスケジュールで発生します。5,000人の生徒がいる学区で、約1,000件の新規・更新入学パケットを処理する場合、6週間で15,000〜25,000ページのフォームになります。2〜3人のフロントオフィススタッフからなるデータ入力チームでは、残業やバックログ、エラーなしにこの量を入力することはできません。入学データが学校開始前に準備できるかどうかを決定するのは、抽出ツールの処理能力であり、ページごとの精度ではありません。
関連記事AIは学生の入学フォームを抽出できるか?では、フィールドごとの精度の推定値について詳しく説明しています。AIが得意とする分野(印刷テキスト、チェックボックス、バッチ処理)と、人間による検証が依然として必要な分野(手書きの電話番号、自由記述の医療メモ)の両方を含みます。
完全なワークフロー:紙の書類からSISレコードまで
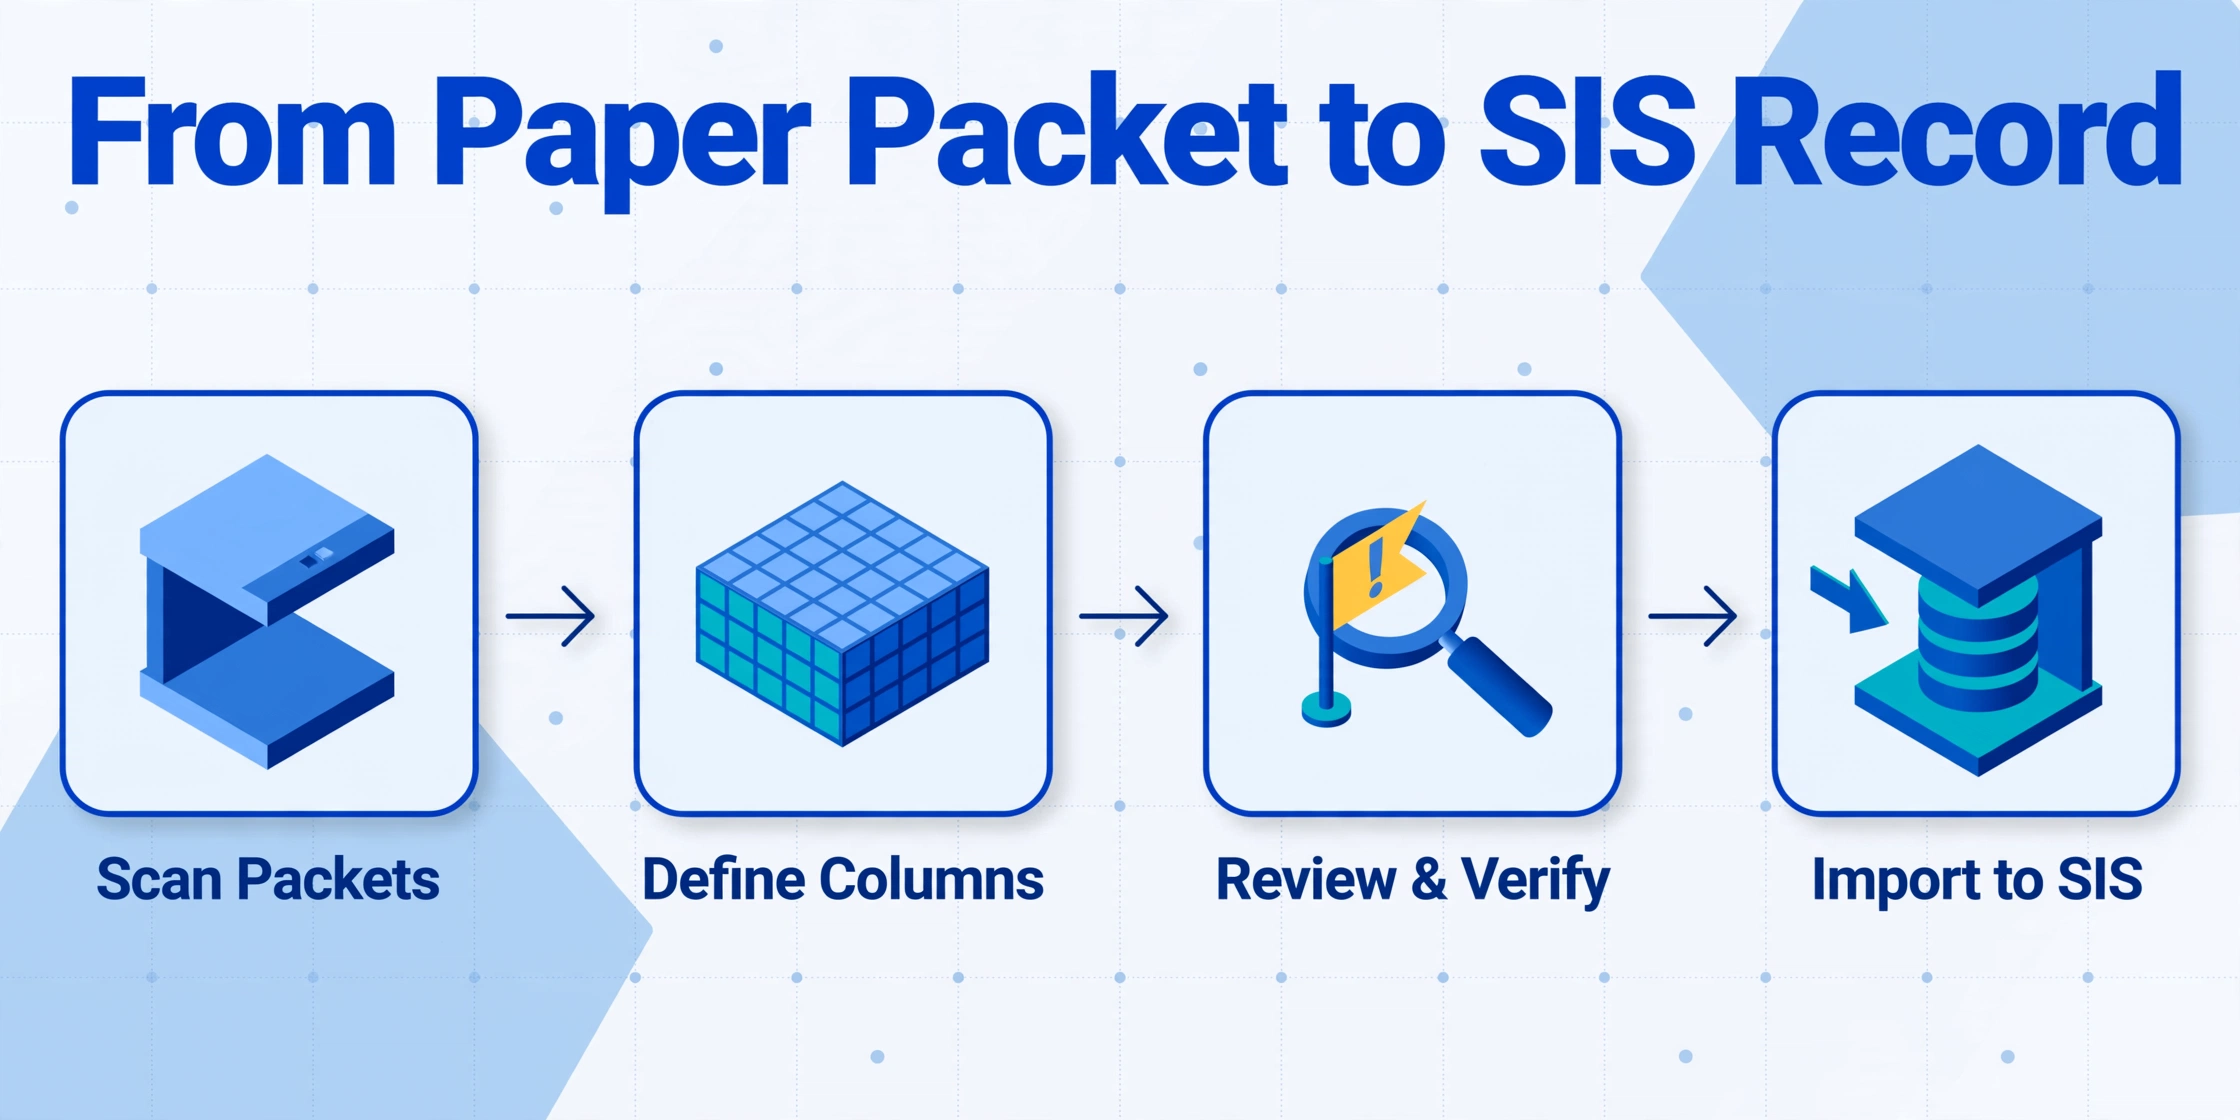
抽出ワークフローには4つのフェーズがあります。各フェーズは、ITサポートなしでフロントオフィススタッフや入学コーディネーターが実行できる特定の運用ステップに対応しています。
入学書類をスキャンして準備する
各生徒の書類一式を1つのマルチページPDFとしてスキャンします。スキャナーは300 DPIのグレースケールに設定してください。カラーはファイルサイズを増やすだけで、ほとんどの入学フォームのレイアウトでは精度向上につながりません。一方、白黒では鉛筆でチェックされたチェックボックスと用紙の背景を区別する微妙なコントラストが失われます。各ファイルには一貫した命名規則を使用してください: [学年]_[姓]_[名].pdf。この命名パターンにより、検証時に抽出データを元のドキュメントと照合でき、個々のPDFをすべて開く必要がなくなります。
フォームが種類別に事前分類されて届く場合(医療フォームをまとめて、交通フォームをまとめてなど)、異なる照合ワークフローが必要になります。実際には、K-12(幼稚園~高校)の入学書類の大半は生徒ごとに整理されて届きます。各家庭が子1人につきフォルダまたは束を1つ提出し、各束にはその生徒に必要なフォーム一式が含まれています。
出力列を定義する
これは抽出をプログラムするステップです。セマンティックAIツールでは、必要な列名をリストアップすることで出力を定義します。その名前は、AIがフォーム上のデータを特定するための指示であると同時に、最終的なスプレッドシートの列ヘッダーにもなります。列セットはSISインポートテンプレートに合わせる必要があります。典型的なK-12(幼稚園~高校)の入学書類一式に必要な完全なセットは約28フィールドで、生徒の基本情報、保護者情報、緊急連絡先、医療データ、交通手段、同意ステータスをカバーします。
具体的な列リストと設計根拠(姓名を分ける理由、バイナリフィールドに推論列を使用する方法、SISフィールド名をヒントとして含める場所など)については、関連ガイドSISインポート用に入学フォームデータをExcelへ抽出する方法で詳しく説明しています。その記事では実際のフィールド例を使って列の設定を解説しています。
バッチを処理する
スキャンしたすべてのPDFを1つのバッチでアップロードします。AIツールは1つのフォームずつではなく、すべてのフォームからすべてのフィールドを並行して抽出し、結果を1つのスプレッドシートに結合します。各行が1人の生徒レコードになります。処理時間はファイル数に比例しますが、ファイルあたりのページ数には比例しません。20ページの書類一式も2ページのフォームも、AIがドキュメント全体を1つの意味的単位として読み取るため、1ドキュメントあたりの処理時間はほぼ同じです。
各28フィールドの入学書類200件(合計5,600の個別データポイント)の場合、抽出は約15〜20分で完了します。手動データ入力の約67時間と比較してください。出力はSISインポート用のExcelファイル1つです。
検証してSISにインポート
出力結果を元のドキュメントと照合してスポットチェックを行います。検証作業は、エラーが運用コストに最も大きな影響を与えるフィールドに集中させてください。緊急連絡先の電話番号、病歴の転記、アレルギー表記などが該当します。ほとんどの入学バッチでは、これらの高リスクフィールドは抽出データ全体の5〜10%を占めます。残りの90〜95%(印字フィールド、チェックボックスの選択、同意ステータス)は、サンプル検証後にバッチレベルで承認できます。
検証済みのスプレッドシートを.xlsxまたはCSVとしてエクスポートし、SISの標準データインポートツールを使用してインポートします。PowerSchool、Infinite Campus、Skywardはいずれも、生徒の基本情報レコードの一括CSVインポートに対応しています。SISのインポートツールで最初の列マッピング設定を一度行えば、以降の入学バッチは同じテンプレートに従います。
項目別抽出戦略
入学フォームのすべての項目を同じ方法で抽出すべきではありません。以下の表は、最も一般的な入学フォームの項目を抽出アプローチ別にグループ化しています:直接抽出、推論分類、計算による導出です。また、各項目の期待される精度レベルも示しています。このガイドの精度範囲と検証率は、第三者ベンチマークではなく、スキャンしたK-12(幼稚園~高校)の書類に対する当社独自のテストに基づいています。そのため、スキャン品質や手書き文字によって変動する可能性があります。
| フィールドグループ | フィールド例 | 抽出方法 | 検証優先度 |
|---|---|---|---|
| 生徒の基本情報 | 氏名、生年月日、性別、学年、住所 | 直接抽出 — AIが対応するラベルの横に書かれた手書きまたは印刷された値を読み取ります | 中 — 生年月日の形式の曖昧さと住所の行分割が一般的な失敗ポイントです |
| 保護者/後見人情報 | 氏名、続柄、電話番号、メールアドレス、勤務先 | 複数フィールドのグループ化による直接抽出 — AIが「父」を同じ欄に書かれた電話番号やメールアドレスと関連付けます | 中〜高 — 電話番号は脆弱なフィールドです。連絡先情報に冗長性がない場合は検証してください |
| 緊急連絡先 | 氏名、続柄、電話番号(2〜3件) | リレーショナルマッピングによる直接抽出 — AIが各連絡先の3点セット(氏名+続柄+電話番号)を正しい番号付きスロットに割り当てます | 高 — 最も重要度の高いフィールドグループです。緊急連絡先のインデックス誤り(連絡先2を連絡先1と誤ってラベル付け)は緊急時の連絡手段を損なう恐れがあります |
| 病歴・健康状態 | アレルギー、服薬、慢性疾患、担当医名、保険会社 | 自由記述の手書き文字の直接抽出 | 最優先 — 安全に関わるデータです。すべての医療フィールドはSISへのインポート前に人間による検証を行うべきです |
| 予防接種記録 | ワクチン名、接種日、実施機関 | テーブル抽出 — AIが予防接種テーブルを構造化グリッドとして読み取ります(行=ワクチン、列=接種回数/日付) | 中 — 州の予防接種フォームは一貫したテーブルレイアウトです。規制遵守のため日付を検証してください |
| 通学手段 | バス / 車送迎 / 徒歩、バス路線番号、AM/PMスケジュール | 推論による分類 — AIがチェックボックスの選択を読み取り、ラベルテキストを出力します(「☐」文字ではなく「バス」) | 低 — 視覚的に明確な二択です。バッチレベルでスポットチェックしてください |
| 同意チェックボックス | 写真公開、テクノロジー利用規約、ハンドブックの確認、ランチプログラム | 推論による分類 — AIがチェックボックスの状態に基づいて「はい」または「いいえ」を出力し、任意で3番目の列として「保護者の署名あり」を出力します | 低 — 95〜98%の精度を持つ二値シグナルです。バッチレベルの検証で十分です |
| 家庭言語調査 | 第一言語、追加言語、保護者の希望言語 | 短い手書きテキストまたはチェックボックス選択の直接抽出 | 低〜中 — 言語名は語彙が限られた短いフィールドです。一般的でない言語名を検証してください |
パターンは明確です。二値または閉じた語彙のコンテンツ(チェックボックス、同意フォーム、言語選択)を持つフィールドは、最小限の検証で受け入れることができます。手書きの自由記述で意味的な冗長性がないフィールド、特に電話番号や医療記述は、人間によるレビューが必要です。検証の労力をすべてのフィールドに均等に割り当てるのではなく、それに応じて配分してください。
入学シーズンの規模に対応するバッチ処理
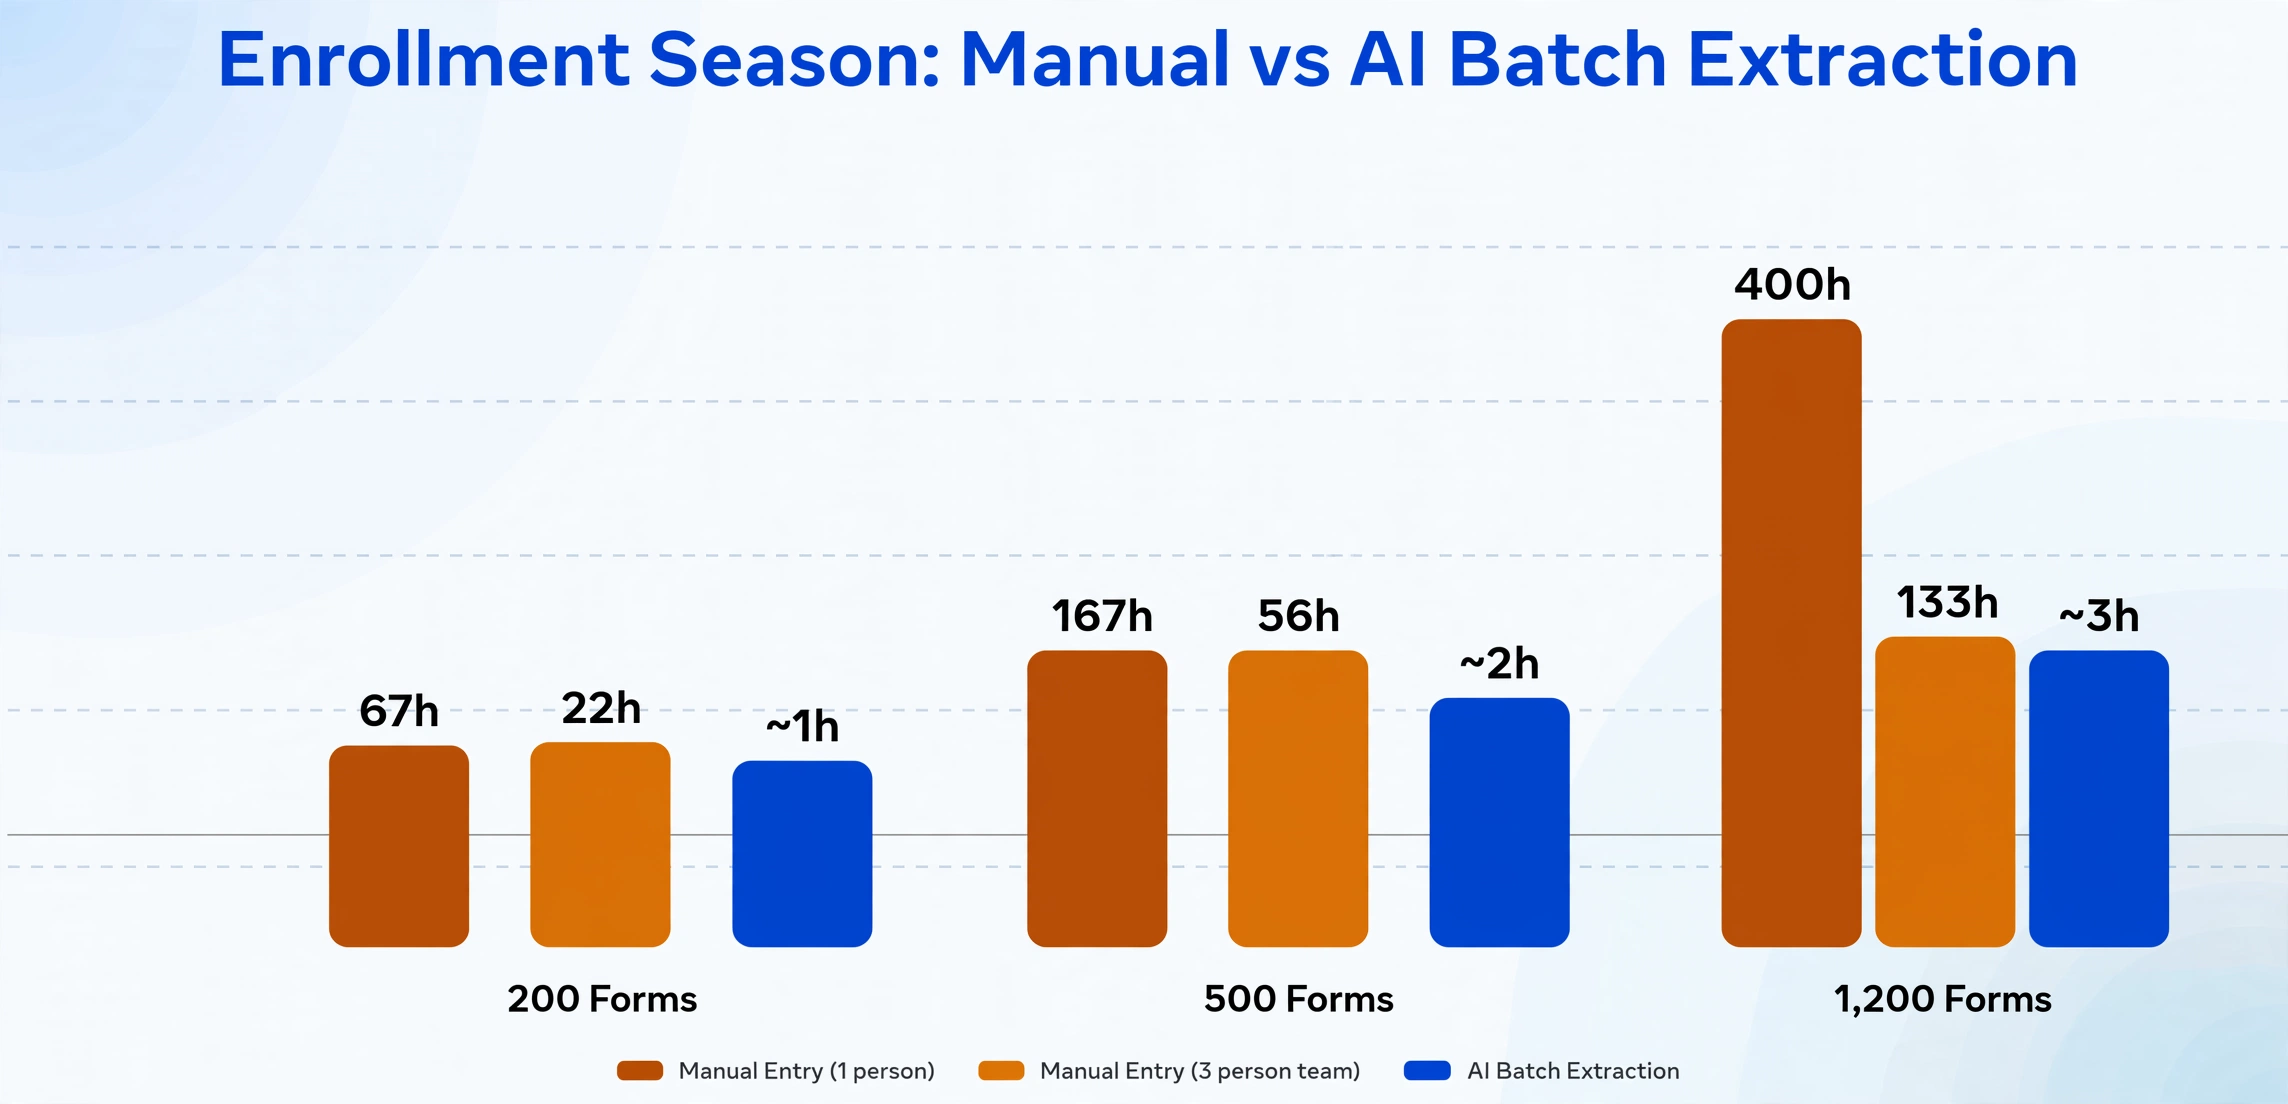
AI抽出の運用上の利点は、単一のフォームをより速く処理することではありません。1人が1冊の申込書を手入力するのとほぼ同じ時間で、200件のフォームを処理できることです。以下の表は、測定された手動入力速度(1冊あたり約20分)と単一オペレーターによるAIワークフローを用いて、3つの一般的な入学申込件数におけるこの違いを示しています。
| 入学申込件数 | 手動入力(1名) | 手動入力(3名チーム) | AIバッチ抽出 |
|---|---|---|---|
| 200件(小規模な小学校) | 約67時間(1.7週間) | 約22時間(3日間) | 抽出に約15〜20分+検証に30〜45分 |
| 500件(中規模のK-12(幼稚園〜高校)) | 約167時間(4.2週間) | 約56時間(1.4週間) | 抽出に約25〜40分+検証に60〜90分 |
| 1,200件(大規模な高校または学区バッチ) | 約400時間(10週間) | 約133時間(3.3週間) | 抽出に約45〜75分+検証に2〜3時間 |
検証時間は、緊急連絡先と医療データという優先度の高いフィールドのみを対象とした確認と、残りのフィールドの5%の無作為サンプル確認を想定しています。これが重要なワークフローのポイントです。目標は人間による確認をなくすことではなく、検証対象を全フィールド(手動で入力するすべての文字)から10〜15%のフィールド(最も重要度の高いデータのみ)に減らすことです。
抽出ツールのバッチアーキテクチャも、ワークフローの信頼性に重要です。バッチファースト処理用に設計されたクラウドベースのシステムは、200件の同時ファイルアップロードを、キューイングやファイルごとの処理遅延なしに処理できます。処理能力の制約となるのは、アップロード帯域幅と検証ステップであり、AIモデルの推論能力ではありません。バッチ処理ワークフローの詳細な手順(正確なアップロードフローや、SIS(生徒情報管理システム)インポート用のExcel出力の構成方法を含む)については、関連するハウツーガイド「生徒入学フォームデータをExcelに抽出して学校区のSIS(生徒情報管理システム)に取り込む方法」を参照してください。
品質保証:何を検証し、何を信頼すべきか
すべての抽出ワークフローには品質保証のステップが必要です。そのステップの設計次第で、ワークフローが時間を節約するのか、単にデータ作業の種類を別のものに置き換えるだけなのかが決まります。ここでは、入学フォーム処理向けに設計された実践的なQAフレームワークを紹介します。
ティア1 — バッチレベルで信頼(フィールドの70〜80%)。印刷フィールド(フォームラベル、入力可能なPDFからの事前入力済みの生徒情報)、チェックボックスの選択、同意ステータスは十分に高い精度(95〜99%)を持つため、バッチレベルのサンプルチェックで十分です。これらのフィールドタイプについては行の5%を検証してください。サンプルのエラー率が2%を超える場合は、フィールド単位のレビューにエスカレーションします。
ティア2 — フォームごとにスポットチェック(フィールドの15〜20%)。保護者名、生徒の住所、学年、医師名がこのカテゴリに該当します。これらのフィールドは手書きですが、予測可能なパターンに従います。名前は命名規則に従い、住所には番地/市区町村/都道府県/郵便番号の構造が含まれます。バッチの最初の10フォームでこれらのフィールドの100%をスポットチェックしてベースラインのエラー率を確立し、ベースラインがクリーンであればフォームの20%のスポットチェックに削減します。
ティア3 — すべてのレコードを検証(フィールドの5〜10%)。緊急連絡先の電話番号、アレルギー/病状の説明、予防接種日は、すべてのレコードでフィールド単位の検証が必要です。エラーの影響が大きすぎて統計的サンプリングを受け入れられません。学校の危機時に間違った緊急連絡先番号、投薬時に誤読されたアレルギー表記などです。これらのフィールドだけが100%の人的レビューを受けるべきです。
抽出ツールが抽出値ごとに信頼スコアを提供する場合(ほとんどのセマンティックAIツールが提供します)、それを使用して検証の優先順位を付けます。出力スプレッドシートを信頼スコアの昇順で並べ替え、低信頼度のレコードのみをレビューします。これにより、すべての高優先度フィールドを直接レビューする場合と比較して、検証作業量が通常さらに30〜50%削減されます。
信頼スコアはどこを見るべきかを示しますが、AIが実際に何を読んだかは示しません。すべてのレコードで検証する安全上重要なフィールドについては、抽出された各セルをページ上の位置にリンクするレビューインターフェースがそのギャップを埋めます。電話番号やアレルギー欄をクリックすると、元のスキャン画像がその値の由来となった領域をハイライトします。画像上の領域をクリックすると、対応するセルにジャンプします。ImageToTable.aiでは、これはバウンディングボックス支援検証を備えたレビューモードであり、「この値は正しいか?」という確認を、パケット全体を読み直す代わりに数秒の視覚的確認に変えます。
実践的な結論:入学フォーム用に適切に設計されたQAフレームワークは、緊急連絡先と医療フィールドの100%を検証し、保護者の人口統計データの20%をスポットチェックし、チェックボックス/同意フィールドはバッチレベルで信頼します。この3層アプローチは、エラーが実際の結果に影響するフィールドを捕捉しながら、すべての抽出値を同等に誤っている可能性があるかのようにレビューする罠を回避します。
複数フォームの家族への対応
3人の子どもを入学させる家族は、子ども1人につき1つの入学書類パケットを、合計3つ提出します。各パケットには、家族共通の基本情報(保護者名、自宅住所、緊急連絡先、保険会社)と、子ども固有のデータ(学年、病歴、希望する教師、通学バス路線)が含まれています。3つのパケットはそれぞれ独立したPDFですが、含まれるデータは大きく重複しています。
抽出ツールは各パケットを個別に処理しますが、これは正しい動作です。SIS内の各子どもの記録は自己完結している必要があるためです。バッチ出力には、子どもごとに1行、合計3行が含まれ、家族共通のデータは各行に繰り返し表示されます。PowerSchoolやInfinite Campusにインポートすると、各行がそれぞれの保護者連絡先と緊急連絡先フィールドを持つ個別の生徒記録を作成します。
複数フォームの家族に関する運用上の考慮事項は2つあります。
整合性チェック。抽出後、兄弟の行間で保護者連絡先フィールドを比較してください。同じ保護者が同じ日に両方のフォームに記入したにもかかわらず、子どもAと子どもBで異なる保護者の電話番号が抽出された場合、どちらかの値は抽出エラーの可能性が高いです。これらの不一致をレビュー用にフラグ付けしてください。この行間検証により、単一行のレビューでは見逃される抽出エラーを検出できます。
一括更新と子ども固有データ。入学パケットの一部のフィールド(自宅住所、保護者の電話番号、保険会社など)は、すべての兄弟に同一に適用される家族レベルのデータです。一方、学年、担当教師、病歴などのフィールドは子ども固有であり、行間でコピーしてはなりません。抽出列の設計はこの区別を反映する必要があります。「自宅住所」というラベルの列は、3人の子どもすべてに同じ値(保護者が各フォームに記入した住所)を生成します。「担当教師名」というラベルの列は、子どもごとに異なる値を生成します。列が適切な粒度で定義されている限り、抽出ツールはこれを正しく処理します。
FERPA(家庭教育の権利およびプライバシー法)に準拠した入学フォームのデータ抽出
スキャンされた入学フォームが第三者製のAI抽出ツールにアップロードされた時点で、学区はFERPA(家庭教育の権利およびプライバシー法、20 U.S.C. § 1232g、34 CFR Part 99)に基づく教育記録から個人を特定できる情報を開示したことになります。生徒の氏名、生年月日、住所、保護者の連絡先を含む入学フォームは、§ 99.3の定義における教育記録に該当します。その開示には保護者の同意または適用可能な例外が必要であり、文書抽出において適用可能な例外は、§ 99.31(a)(1)(i)(B)に基づく学校関係者例外です(米国教育省のFERPAに基づくクラウドコンピューティングに関するPTACガイダンスを参照)。
学校関係者例外を適用するには、3つの要件を満たす必要があります。第一に、抽出プロバイダーが機関サービスを提供することです。入学フォームからのデータ抽出は、学区が自らの職員で行う業務です。第二に、プロバイダーが学区の直接的な管理下で運営されることです。これは、生徒データの使用方法と保持方法を制限する書面による契約によって確立されます。第三に、プロバイダーが§ 99.33(a)の再開示制限の対象となることです。つまり、学区の承認なしに抽出した生徒データをサブプロセッサーや他の当事者と共有することはできません。
ほとんどの学区が見落としている重要な運用要件は、書面による契約が、抽出プロバイダーがアップロードされた生徒文書をAIモデルのトレーニングに使用することを明示的に禁止しなければならないことです。生徒の入学フォームを抽出エンジンの改善に使用するプロバイダーは、承認されたサービス以外の目的でデータを使用しており、その二次的な使用は学校関係者例外の対象外です。これは、現在のK-12(幼稚園~高校)学区の抽出ワークフローにおける最も一般的なコンプライアンス上のギャップです。
完全な規制分析(文書が教育記録に該当するかどうかの判断方法、学校関係者例外が実際に要求する内容、契約に含めるべき事項、保持および削除の要件、州の生徒データプライバシー法とFERPAの関係など)については、関連記事FERPAに準拠した生徒データ抽出:入学担当者向けガイドで詳しく説明しています。そのガイドには、各要件を特定の規制参照に対応付ける7段階のコンプライアンスチェックリストが含まれています。
選択肢の比較:手動入力 vs テンプレートOCR vs セマンティックAI
入学フォームを処理する学区には、3つのアプローチがあります。それぞれコスト構造、セットアップ時間、精度プロファイル、拡張性が異なります。以下の表は、入学シーズンに最も重要な観点でこれらを比較したものです。
| 観点 | 手動データ入力 | テンプレートOCR(例:Docparser、ABBYY) | セマンティックAI(例:ImageToTable.ai) |
|---|---|---|---|
| セットアップ時間 | 不要 — どのスタッフでも入力可能 | フォームレイアウトごとに1〜3時間 — 各学校の書類ごとに抽出ゾーンの定義が必要 | 15〜30分 — 列名を一度設定すれば全学校で利用可能 |
| 500フォーム時の1件あたりコスト | スタッフ時間で約$2.00〜$3.00 | 約$0.20〜$0.50(ソフトウェア+テンプレート設定を償却) | 1ページあたり約$0.10〜$0.25 |
| 手書き文字対応 | 人間がどんな手書きでも読める | 不十分 — 筆記体の文字レベルOCRは通常60%未満の精度に低下 | 良好(85〜92%)— 文脈に基づく読み取りが構造化フォームで向上 |
| チェックボックス検出 | 人間がチェック状態を読み取る | 限定的 — チェックボックスの位置ごとにゾーンベースのルールが必要 | 強力(95〜98%)— ラベルの文脈でチェックボックスを読み取る |
| 複数フィールドの関連付け | 人間は関係性を自然に理解する | 非対応 — 各ゾーンが独立したデータポイントを生成 | 対応 — AIが氏名+続柄+電話番号を1つの連絡先レコードとして関連付ける |
| 複数フォームレイアウトへの対応 | 人間が各レイアウトに適応 | レイアウトごとに個別テンプレートが必要 — 5校=5テンプレート | 1つの列セットで任意のレイアウトに対応 — AIは位置ではなく意味で読み取る |
| 拡張性(200→1,000フォーム) | 線形 — 5倍の量=5倍のスタッフ時間 | 準線形だが、レイアウトの多様性に応じてテンプレート保守が増加 | 準線形 — 5倍の量で処理時間は約30分増加 |
| FERPA(家庭教育の権利およびプライバシー法)コンプライアンス基準 | 外部データ転送なし — FERPA開示なし | 学校関係者例外に基づくプロバイダー契約が必要 | 学校関係者例外に基づくプロバイダー契約が必要 |
選択は2つの質問に集約されます。学区で年間100件未満の入学フォームを処理し、フォームが主に印刷物(手書きではない)である場合、手動入力が最もシンプルな選択肢です。その量では自動化システムのセットアップに投資する時間が回収できないためです。200件以上を処理する場合、またはフォームに手書き、チェックボックス、異なる学校からの複数レイアウトが含まれる場合、セマンティックAIが精度対労力の最良の比率を提供します。テンプレートOCRはますます狭まる中間領域に位置します。印刷フォームを規模に応じて処理できますが、手書き、チェックボックス、レイアウトの多様性には対応できません。これらはK-12(幼稚園~高校)の入学書類を特徴づける3つの特性です。
よくある質問
オンライン登録ポータルがあれば抽出は不要になるのではありませんか?
オンラインポータル(PowerSchool Enrollment、SchoolMint、LINQ)は、ポータルを通じて完全に完了する新規登録を処理します。実際には紙のフォームをなくすわけではありません。なぜなら、かなりの割合の家庭が依然として紙の書類を提出し、その割合は学区や学年によって異なるからです。対面での登録イベントに参加した家庭、自宅に安定したブロードバンドがない家庭、ポータルの全機能が対応していない言語を第一言語とする家庭、ポータルのアカウントが失効していたり作成されていなかったりする既存家庭などです。抽出は、オンラインポータルの存在に関係なく届く紙の書類に対する解決策です。
手書きの登録フォーム欄における実際的な精度の限界はどの程度ですか?
明確な欄ラベルと欄境界がある構造化された登録フォームでは、手書き抽出は通常、氏名と住所で85〜92%の精度を達成し、自由記述の医療情報では75〜85%です。これらの数値は、適切なスキャン品質(300 DPI、良好なコントラスト)と標準的な手書きを前提としています。すべて大文字のブロック体で記入されたフォームは95%に近い精度に達しますが、筆記体と略語が混ざると75%まで低下します。精度の上限はAIモデルではなく、人間の読者でも時折意見が分かれる手書き固有の曖昧さにあります。AIによるものであれ、そうでないものであれ、手書きの医療欄を人間による検証なしに信頼して読み取るべき抽出システムはありません。
来年、学区が登録パケットを再設計した場合はどうなりますか?
セマンティックAI抽出では、何も変わりません。列名は同じまま(生徒氏名、生年月日、保護者連絡先、緊急連絡先電話番号、アレルギー)で、AIは欄ラベルを読み取ることで新しいフォームレイアウト上の対応するデータを特定します。ゾーン、テンプレート、ルールを再設定する必要はありません。これがテンプレートOCRに対するセマンティック抽出の決定的な利点です。AIは座標ではなくコンテンツを読み取るため、フォームレイアウトは抽出ロジックにとって無関係です。
抽出したデータを直接SISに入力できますか、それともミドルウェアが必要ですか?
ほとんどのK-12(幼稚園~高校)のSISプラットフォーム(PowerSchool、Infinite Campus、Skyward、Ellucian Banner)は、生徒の人口統計情報レコードの一括CSVまたはExcelインポートに対応しています。抽出ツールがSISのインポートテンプレートに一致する列を持つスプレッドシートを生成した後、SISの標準インポート機能を使用してデータをアップロードします。ミドルウェアは不要です。SISインポートツールでの最初の列マッピング設定が1回必要で、以降のバッチは同じマッピングに従います。
スペイン語や他の言語の入学フォームでも抽出は機能しますか?
はい。AIは、最も一般的な言語の手書きおよび印刷テキストを読み取ります。スペイン語は、米国のK-12(幼稚園~高校)入学フォームで最も頻繁に使用される英語以外の言語であり、抽出は個別の設定なしで処理します。列名は、SISが期待する言語(通常、米国の学区では英語)で定義する必要があります。AIはフォームからスペイン語のテキストを抽出し、対応する英語名の列に配置します。複数の言語(英語、スペイン語、ベトナム語、中国語、アラビア語)で入学パケットを提供する学区の場合、1つの列セットですべてを処理します。
入学フォームの医療欄にはHIPAA要件が適用されますか、それともFERPAが適用されますか?
学校が管理する生徒の健康情報には、HIPAAではなくFERPAが適用されます。HIPAAのプライバシールールは、「FERPAの対象となる教育記録」を保護対象医療情報の定義から除外しています(45 CFR § 160.103)。つまり、入学フォームの病状、アレルギー情報、予防接種記録は、学校が教育記録として管理する限り、HIPAAではなくFERPAに基づいて保護されます。実際的な意味合いとしては、FERPAコンプライアンスフレームワーク(学校職員の例外、書面による契約、モデルトレーニングなし)が、人口統計情報フィールドと同様に医療フィールドもカバーします。入学フォームの抽出について別途HIPAA分析は不要ですが、一部の州では追加の生徒の健康プライバシー法が適用される場合があります。
ホームスクーリングや学区外の書類を含む複数ページのスキャン一式として届く入学フォームはどのように処理すればよいですか?
スキャンにすべてのページ(居住証明書、住所証明書類、ホームスクーリング届出書、親権命令書)を含め、生徒ごとに同じ複数ページのPDFとしてまとめてください。抽出AIは、定義した列名に一致するページとフィールドのみを読み取り、入学データのないページはスキップします。一致しないページは抽出出力では無視されますが、ドキュメントの記録としては残ります。特定のページを抽出対象として指定する場合(例:「15ページのパケットのうち、1〜4ページのみを抽出」)は、ほとんどのセマンティックAIツールでは、列定義レベルで処理されます。
生徒登録フォームの抽出は、単なる技術的な判断ではありません。スキャン、列設計、バッチ処理、検証、SISインポート、コンプライアンス文書にわたるワークフローの変革です。
スキャン、列の定義、バッチ処理、検証とインポートという4段階のワークフローにより、8月の紙の書類の山が、PowerSchoolやInfinite Campusにそのまま取り込める構造化されたスプレッドシートに変わります。QAフレームワークでは、すべてのレコードで検証すべきフィールド(緊急連絡先、医療データ)と、バッチレベルで信頼できるフィールド(チェックボックス、同意書)を明確にします。FERPA(家庭教育の権利およびプライバシー法)への準拠は、後付けではなく前提条件です。抽出プロバイダーとの署名済み機関契約、モデル学習の禁止を明記した書面、そして文書化された保存スケジュールが必要です。
今年の登録書類から10枚の登録フォームを使ってワークフローをテストしてください。精度プロファイルがここで説明した内容と一致すれば、今後毎年の登録シーズンに使えるテンプレートとなります。
サインアップ不要で無料でお試しいただけます。ファイルは一時的に処理され、保存されることはありません。学区向けのFERPA準拠の機関契約についてはお問い合わせください。