De pacotes em papel a linhas prontas para o SIS:
O guia completo para extração de formulários de matrícula K-12 (do ensino fundamental ao médio)
Todo mês de agosto, cerca de 49 milhões de estudantes de escolas públicas dos EUA voltam às aulas (National Center for Education Statistics, 2024–25). Para as famílias que ainda se matriculam ou entregam pacotes atualizados em papel, cada nome manuscrito, caixa de seleção marcada e observação médica precisa ser digitado em um sistema de informações estudantis (SIS) antes do início das aulas. Um pacote de matrícula K-12 (do ensino fundamental ao médio) típico tem de 15 a 25 páginas distribuídas em uma dúzia de seções: dados demográficos do aluno, contatos dos pais e responsáveis, contatos de emergência com relacionamentos de vários campos, condições médicas, registros de vacinação, preferências de transporte e vários formulários de consentimento. Cada seção usa um formato de dados diferente: letras de forma impressas, cursiva, caixas de seleção, opções circuladas, narrativas em texto livre. Cada uma falha de maneira diferente quando processada por OCR (reconhecimento óptico de caracteres) tradicional.
Principais conclusões
- A maioria dos distritos escolares presume que um portal de matrícula on-line elimina a carga de digitação de dados. Na prática, muitas famílias ainda entregam pacotes em papel todo mês de agosto, e essas pilhas de formulários de 15 a 25 páginas chegam à secretaria.
- O OCR com modelo deveria resolver isso, mas falha nas três características que definem os formulários de matrícula: manuscrito e impresso misturados na mesma página, grades de caixas de seleção ao lado de campos de texto livre e relacionamentos de vários campos, como contatos de emergência, que precisam permanecer agrupados como um único registro.
- A IA semântica dá conta dos três: defina seu conjunto de 28 colunas uma vez, envie os pacotes de todas as escolas em um único lote independentemente do layout e concentre a verificação nos campos em que erros têm consequências reais: contatos de emergência e dados médicos.
O que é Extração de Formulários de Matrícula Escolar?
A extração de dados de formulários de matrícula escolar é o processo automatizado de ler dados de pacotes de registro escolar K-12 (do ensino fundamental ao médio) preenchidos (nomes manuscritos ou impressos, datas de nascimento, dados de contato dos pais, informações médicas e seleções de caixas de seleção) e convertê-los em linhas estruturadas de planilha que podem ser importadas para um sistema de informações estudantis (SIS). É uma aplicação especializada de extração de dados por IA que lida com a realidade de formatos mistos dos formulários de matrícula: rótulos pré-impressos coexistem com respostas manuscritas, caixas de seleção ficam ao lado de linhas de assinatura, e narrativas médicas em texto livre compartilham a mesma página que blocos de endereço estruturados.
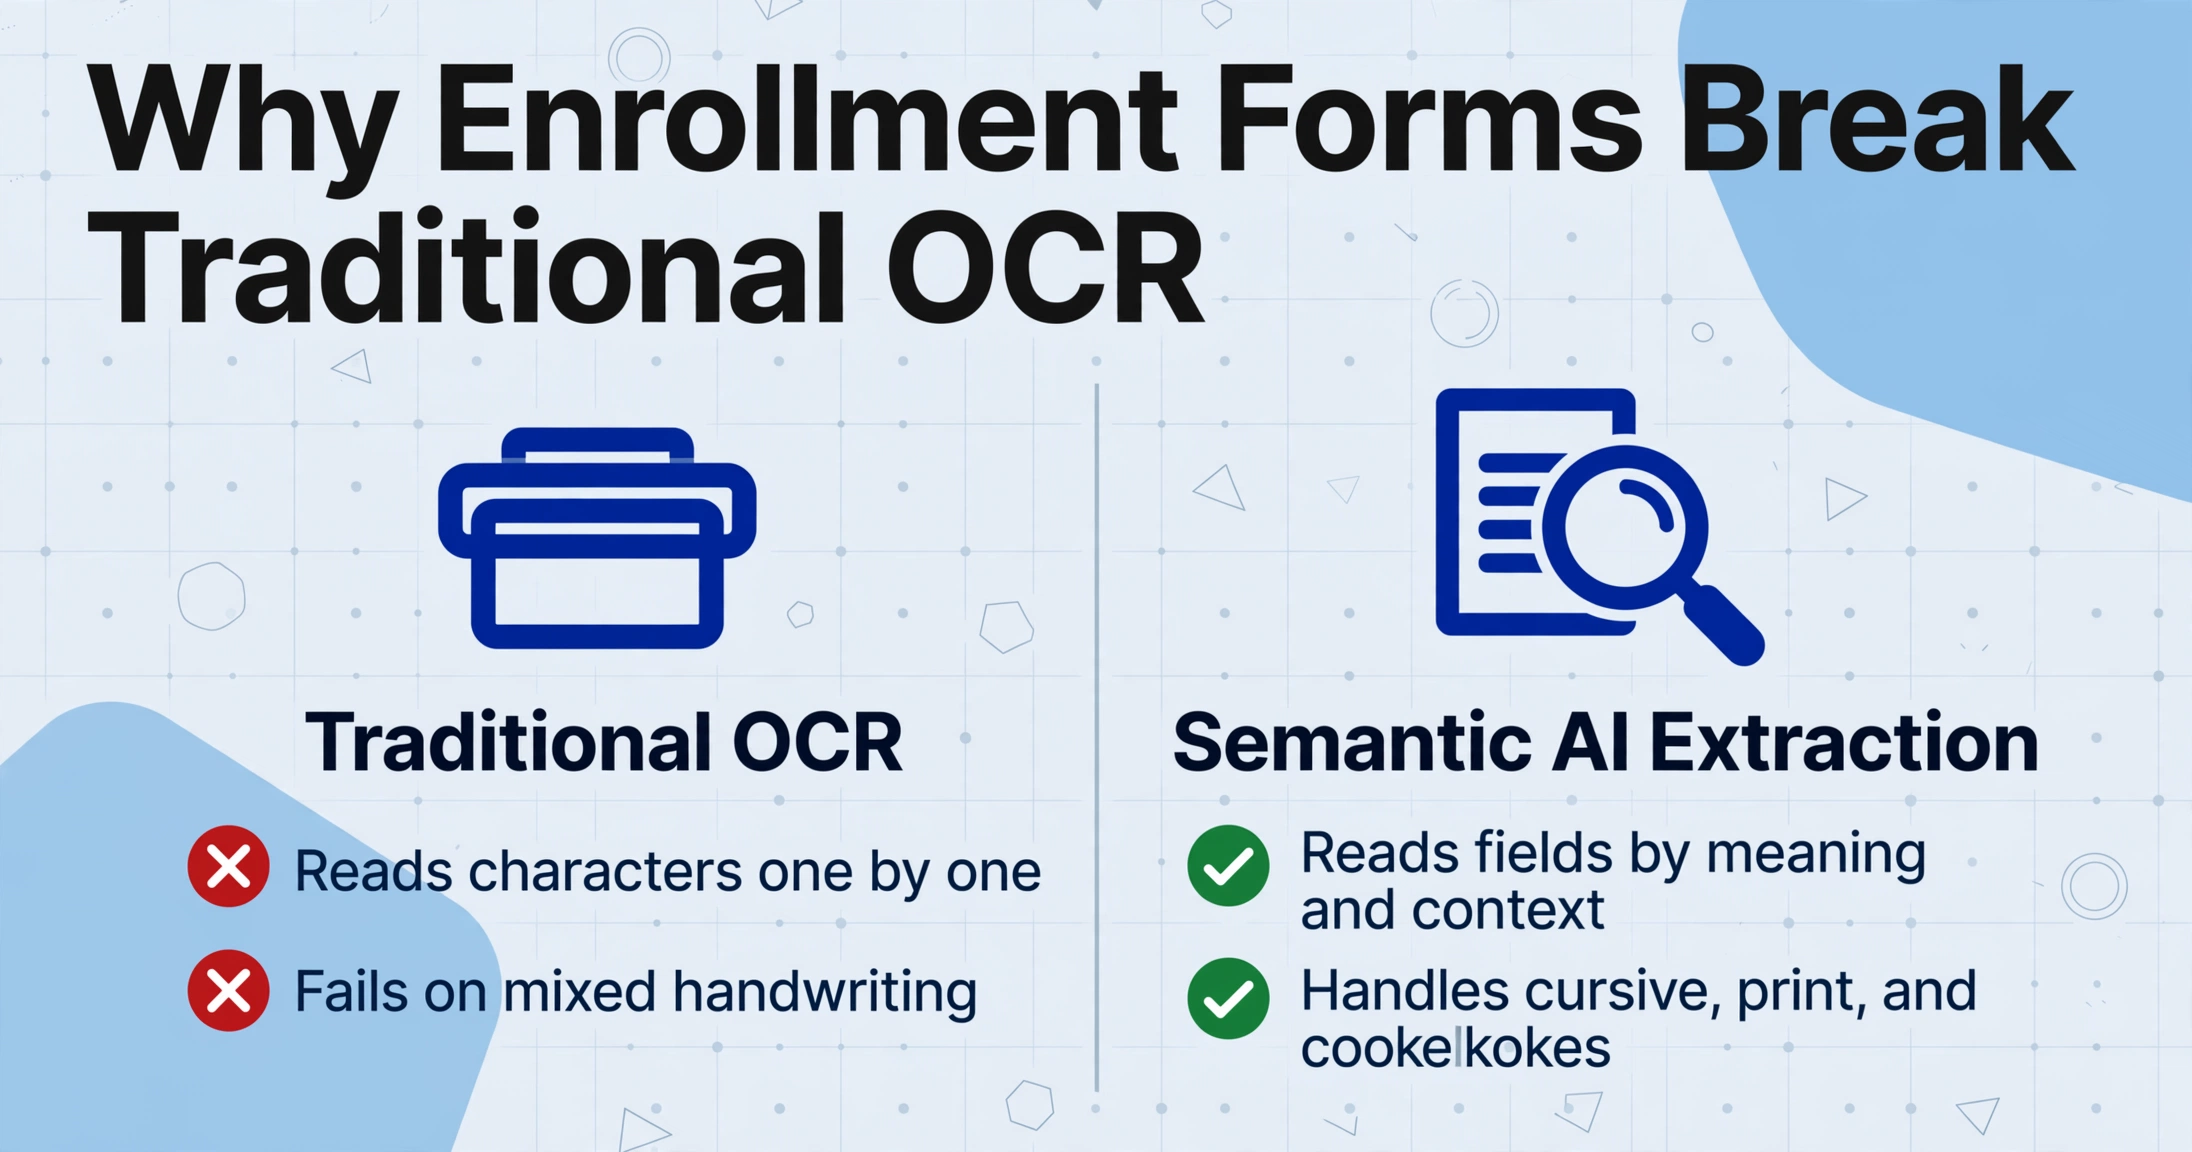
Diferentemente do OCR (reconhecimento óptico de caracteres) tradicional, que lê caracteres um a um sem entender o que significam, a extração semântica por IA identifica campos pelo seu significado e contexto. Essa é a abordagem usada por ferramentas modernas como o ImageToTable.ai. Quando a IA encontra uma seção rotulada "Contato de Emergência — Nome", ela sabe que deve extrair o nome de uma pessoa daquela área, mesmo que a caligrafia conecte todas as letras em cursivo. Essa compreensão semântica é o que faz a extração de formulários de matrícula funcionar em escala prática, porque não existem dois distritos escolares que imprimam seus pacotes de registro da mesma forma, e os pais não os preenchem da mesma maneira duas vezes.
Este guia cobre o quadro completo: os desafios únicos que os formulários de matrícula apresentam (eles não são faturas nem extratos bancários), o fluxo de trabalho de ponta a ponta, do pacote em papel à importação no SIS, estratégias de extração campo a campo, processamento em lote para o pico de matrículas de agosto a setembro, o tratamento de famílias com vários formulários em que cada criança tem um pacote separado, a conformidade com a FERPA (Lei de Direitos e Privacidade Educacional da Família) e uma comparação das três abordagens disponíveis para os distritos escolares hoje: entrada manual de dados, OCR baseado em modelo e extração semântica por IA.
Por que os formulários de matrícula são um problema de extração diferente
Um pacote de matrícula escolar não é um único tipo de documento. São uma dúzia de estruturas de documentos diferentes unidas, e cada uma se comporta de maneira diferente quando processada por uma ferramenta de extração. Entender essas realidades estruturais é o pré-requisito para construir um fluxo de trabalho que funcione em escala.
Manuscrito e texto impresso na mesma página
Um formulário de matrícula normalmente tem rótulos pré-impressos em uma fonte padrão ("Sobrenome Legal do Aluno __________") e respostas manuscritas nos espaços em branco. Uma única página pode conter letras de forma impressas por um pai que preencheu o formulário com cuidado, cursiva de outro pai que escreveu rapidamente, e uma marca de caixa de seleção que não é nem impressa nem cursiva, mas um rabisco. O OCR tradicional é projetado para texto impresso uniforme em fundos limpos, e tem um único modo de reconhecimento: decodificação caractere por caractere. É por isso que ele falha nessa entrada mista. A IA semântica processa cada campo independentemente, usando o contexto fornecido pelos rótulos impressos para ancorar a extração do conteúdo manuscrito. O mesmo mecanismo está por trás da extração de formulários manuscritos em geral, e os pacotes de matrícula são um de seus casos mais difíceis.
Caixas de seleção e campos de texto livre lado a lado
Os formulários de matrícula são densos em escolhas binárias como "Seu filho tem alguma alergia? ☐ Sim ☐ Não", seguidos imediatamente por campos de texto livre solicitando detalhes. Um pai pode marcar "Sim" para a pergunta sobre alergias e escrever "Penicilina — causa erupção cutânea" no campo de texto abaixo. A ferramenta de extração deve ler o sinal binário (qual caixa está marcada) e o texto narrativo (o que o pai realmente escreveu) como dois pontos de dados separados, mas relacionados. Esse pareamento é trivial para um modelo de IA semântica que lê o documento como um todo. É surpreendentemente difícil para o OCR de modelo, que normalmente exige regras separadas para zonas de caixas de seleção e zonas de texto e não tem como vincular as duas.
Estruturas de relacionamento entre vários campos
A seção de contato de emergência de um formulário de matrícula ilustra a complexidade relacional que torna os formulários de alunos mais difíceis do que a maioria dos documentos comerciais. Um único formulário pode pedir "Contato de Emergência 1 — Nome, Parentesco, Telefone" e "Contato de Emergência 2 — Nome, Parentesco, Telefone". Três campos por contato estão vinculados à mesma referência de pessoa. A ferramenta de extração precisa saber que "John Smith", "Pai" e "555-123-4567" pertencem ao mesmo registro de contato de emergência, enquanto "Mary Jones", "Tia" e "555-987-6543" pertencem a um contato diferente. Em uma saída de planilha, isso significa uma linha por aluno com seis colunas de contato de emergência (Nome 1, Parentesco 1, Telefone 1, Nome 2, Parentesco 2, Telefone 2), e a IA deve mapear cada dado para a coluna correta entendendo ao lado de qual rótulo impresso ele está na página.
O pico de matrículas de agosto a setembro
A restrição de tempo é o fator que mais importa operacionalmente. Na maioria dos distritos escolares dos EUA, o grosso das novas matrículas chega em uma janela de quatro a seis semanas entre meados de julho e o início de setembro, e as atualizações de alunos que retornam chegam no mesmo ritmo: mudanças de contato de emergência, novas informações médicas, renovações de consentimento. Para um distrito de 5.000 alunos processando cerca de 1.000 pacotes de matrícula novos e de retorno, isso representa de 15.000 a 25.000 páginas de formulários em seis semanas. Uma equipe de digitação de dois ou três funcionários da recepção não consegue digitar esse volume sem horas extras, atrasos ou erros. O que determina se os dados de matrícula estarão prontos antes do início das aulas é a capacidade de processamento da ferramenta de extração, não sua precisão por página.
O artigo complementar A IA consegue extrair formulários de matrícula de alunos? aborda as estimativas de precisão campo a campo em detalhes, incluindo onde a IA tem bom desempenho (texto impresso, caixas de seleção, taxa de transferência em lote) e onde ainda precisa de verificação humana (números de telefone manuscritos, observações médicas em texto livre).
O Fluxo Completo: Do Pacote em Papel ao Registro no SIS
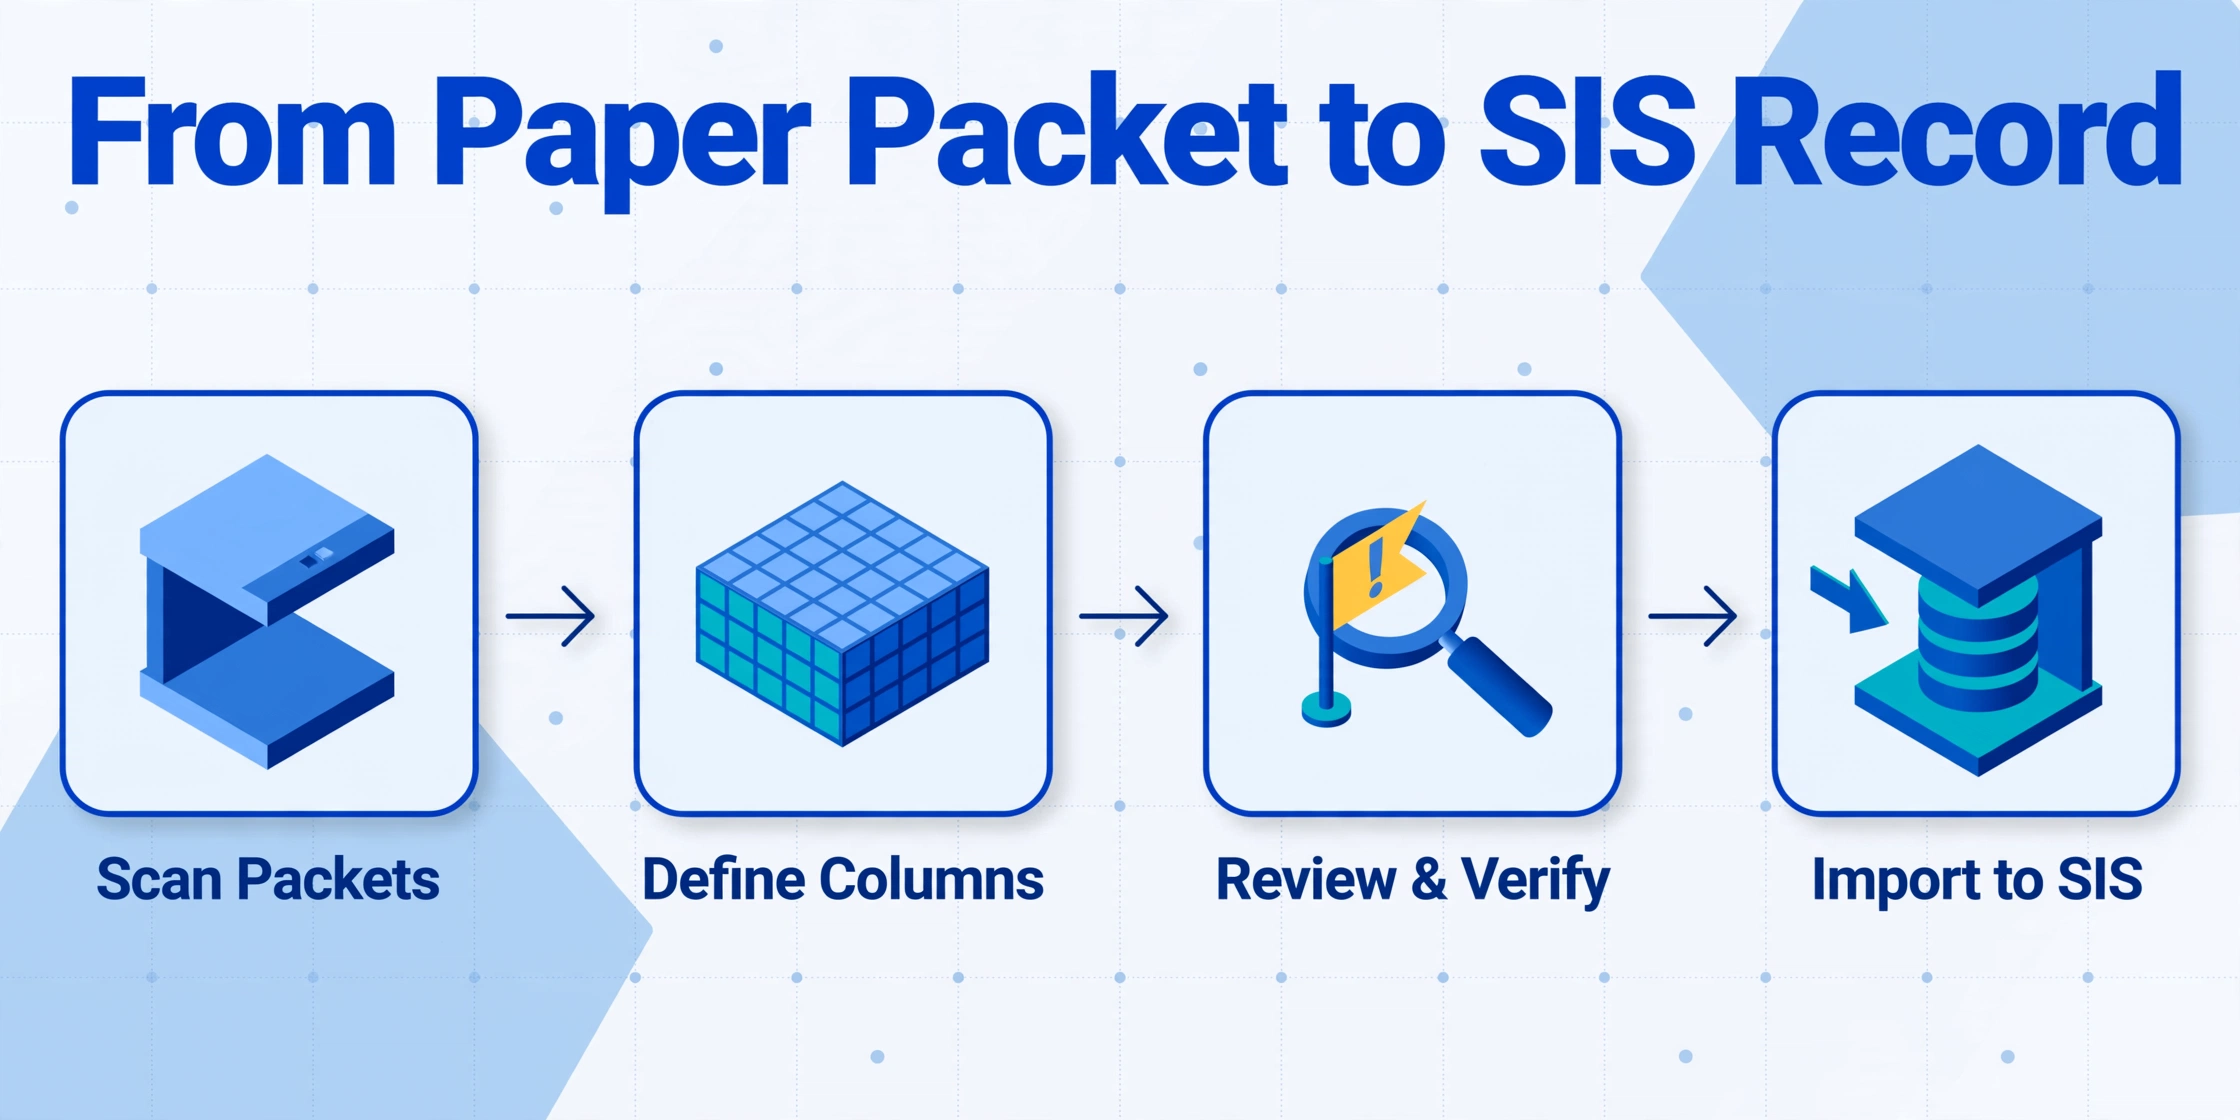
O fluxo de extração tem quatro fases. Cada fase corresponde a uma etapa operacional específica que um membro da equipe da recepção ou um coordenador de matrículas pode executar sem suporte de TI.
Digitalize e prepare os pacotes de matrícula
Digitalize o pacote completo de cada aluno como um único PDF de várias páginas. Configure o scanner para 300 DPI em escala de cinza. A cor aumenta o tamanho do arquivo sem ganhos de precisão para a maioria dos layouts de formulários de matrícula, enquanto o preto e branco perde o contraste sutil que separa uma caixa marcada a lápis do fundo do papel. Nomeie cada arquivo usando uma convenção consistente: [Série]_[Sobrenome]_[Nome].pdf. Esse padrão de nomenclatura permite cruzar os dados extraídos com o documento de origem durante a verificação sem abrir cada PDF individualmente.
Se os formulários chegarem pré-separados por tipo (todos os formulários médicos juntos, todos os formulários de transporte juntos), você precisará de um fluxo de trabalho de agrupamento diferente. Na prática, a maioria dos pacotes de matrícula K-12 (do ensino fundamental ao médio) chega organizada por aluno: cada família envia uma pasta ou pilha por criança, e cada pilha contém o conjunto completo de formulários necessários para aquele aluno.
Defina as colunas de saída
Esta é a etapa que programa a extração. Em uma ferramenta de IA semântica, você define sua saída listando os nomes das colunas desejadas. Esses nomes se tornam tanto as instruções que a IA usa para localizar dados nos formulários quanto os cabeçalhos das colunas na planilha final. O conjunto de colunas deve espelhar seu modelo de importação do SIS. Um conjunto completo para um pacote típico de matrícula K-12 (do ensino fundamental ao médio) tem aproximadamente 28 campos, cobrindo dados demográficos do aluno, informações de pais/responsáveis, contatos de emergência, dados médicos, transporte e status de consentimento.
A lista específica de colunas e a lógica de design, incluindo por que separar nomes e sobrenomes, como usar colunas inferidas para campos binários e onde incluir nomes de campos do SIS como dicas, está detalhada no guia complementar Como Extrair Dados de Formulários de Matrícula de Alunos para o Excel para Importação no SIS. Esse artigo percorre a configuração das colunas com exemplos reais de campos.
Processe o lote
Envie todos os PDFs digitalizados em um único lote. A ferramenta de IA extrai cada campo de cada formulário em paralelo, não um formulário por vez, e mescla os resultados em uma planilha onde cada linha é um registro de aluno. O tempo de processamento escala com o número de arquivos, mas não com a contagem de páginas por arquivo; um pacote de 20 páginas e um formulário de 2 páginas são concluídos em aproximadamente o mesmo tempo por documento, porque a IA lê o documento inteiro como uma única unidade semântica.
Para 200 pacotes de matrícula com 28 campos cada, ou 5.600 pontos de dados individuais, a extração é concluída em aproximadamente 15 a 20 minutos de tempo real, em comparação com cerca de 67 horas de entrada manual de dados. A saída é um arquivo Excel pronto para importação no SIS.
Verifique e importe para o SIS
Confira por amostragem o resultado em relação aos documentos de origem. Concentre o esforço de verificação nos campos em que erros têm o maior custo operacional: telefones de contato de emergência, transcrições de condições médicas e anotações de alergias. Na maioria dos lotes de matrícula, esses campos de alto risco representam 5–10% do total de dados extraídos. Os 90–95% restantes (campos impressos, seleções de caixas de seleção, status de consentimento) podem ser aceitos no nível do lote após verificar uma amostra.
Exporte a planilha verificada como .xlsx ou CSV e importe para o seu SIS usando a ferramenta padrão de importação de dados dele. PowerSchool, Infinite Campus e Skyward oferecem suporte à importação em massa de CSV para registros demográficos de alunos. Após uma configuração inicial de mapeamento de colunas na ferramenta de importação do SIS, os lotes de matrícula seguintes seguem o mesmo modelo.
Estratégia de Extração Campo a Campo
Nem todos os campos de um formulário de matrícula devem ser extraídos da mesma forma. A tabela abaixo agrupa os campos mais comuns de formulários de matrícula por abordagem de extração: extração direta, classificação inferida ou derivação calculada. Ela também indica o nível de precisão esperado para cada um. Os intervalos de precisão e as taxas de verificação neste guia vêm dos nossos próprios testes em pacotes K-12 (do ensino fundamental ao médio) digitalizados, não de um benchmark de terceiros, então a qualidade da digitalização e a caligrafia vão alterá-los.
| Grupo de campos | Campos de exemplo | Abordagem de extração | Prioridade de verificação |
|---|---|---|---|
| Dados demográficos do aluno | Nome completo, data de nascimento, gênero, série, endereço | Extração direta — a IA lê o valor manuscrito ou impresso ao lado do rótulo correspondente | Média — a ambiguidade no formato da data de nascimento e a quebra de linhas do endereço são os pontos de falha comuns |
| Informações dos pais/responsáveis | Nome, parentesco, telefone, e-mail, empregador | Extração direta com agrupamento de vários campos — a IA associa "Pai" ao telefone e ao e-mail escritos na mesma seção | Média-Alta — os números de telefone são o campo frágil; verifique se as informações de contato não têm redundância |
| Contatos de emergência | Nome, parentesco, telefone (2–3 contatos) | Extração direta com mapeamento relacional — a IA atribui cada tríade de contato (nome + parentesco + telefone) ao espaço numerado correto | Alta — grupo de campos de maior risco; um contato de emergência com índice errado (rotular o contato 2 como contato 1) compromete a acessibilidade em emergências |
| Condições médicas | Alergias, medicamentos, condições crônicas, nome do médico, operadora do plano de saúde | Extração direta de texto manuscrito livre | Altíssima — dados críticos para a segurança; todo campo médico deve ser verificado por uma pessoa antes da importação para o SIS |
| Registros de vacinação | Nome da vacina, data de aplicação, prestador | Extração de tabela — a IA lê a tabela de vacinas como uma grade estruturada (linhas = vacinas, colunas = doses/datas) | Média — os formulários de imunização estaduais têm layout de tabela consistente; verifique as datas para conformidade regulatória |
| Transporte | Ônibus / carro / a pé, número da linha de ônibus, horário AM/PM | Classificação inferida — a IA lê a seleção da caixa de seleção e gera o texto do rótulo ("Ônibus", não o caractere "☐") | Baixa — escolhas binárias com sinal visual claro; verificação por amostragem no nível do lote |
| Caixas de seleção de consentimento | Autorização de uso de imagem, acordo de tecnologia, ciência do manual, programa de alimentação | Classificação inferida — a IA gera "Sim" ou "Não" com base no estado da caixa de seleção, com coluna opcional para "Assinatura dos pais presente" | Baixa — sinal binário com 95–98% de precisão; verificação no nível do lote é suficiente |
| Pesquisa de idioma em casa | Idioma principal, idiomas adicionais, idioma preferido dos pais | Extração direta de texto manuscrito curto ou seleção de caixa de seleção | Baixa-Média — nomes de idiomas são campos curtos com vocabulário limitado; verifique nomes de idiomas incomuns |
O padrão é claro: campos com conteúdo binário ou de vocabulário fechado (caixas de seleção, formulários de consentimento, seleções de idioma) podem ser aceitos com verificação mínima. Campos com texto manuscrito livre e sem redundância semântica, especialmente números de telefone e descrições médicas, precisam de revisão humana. Planeje seu esforço de verificação de acordo, e não de forma uniforme em todos os campos.
Processamento em Lote na Escala da Temporada de Matrículas
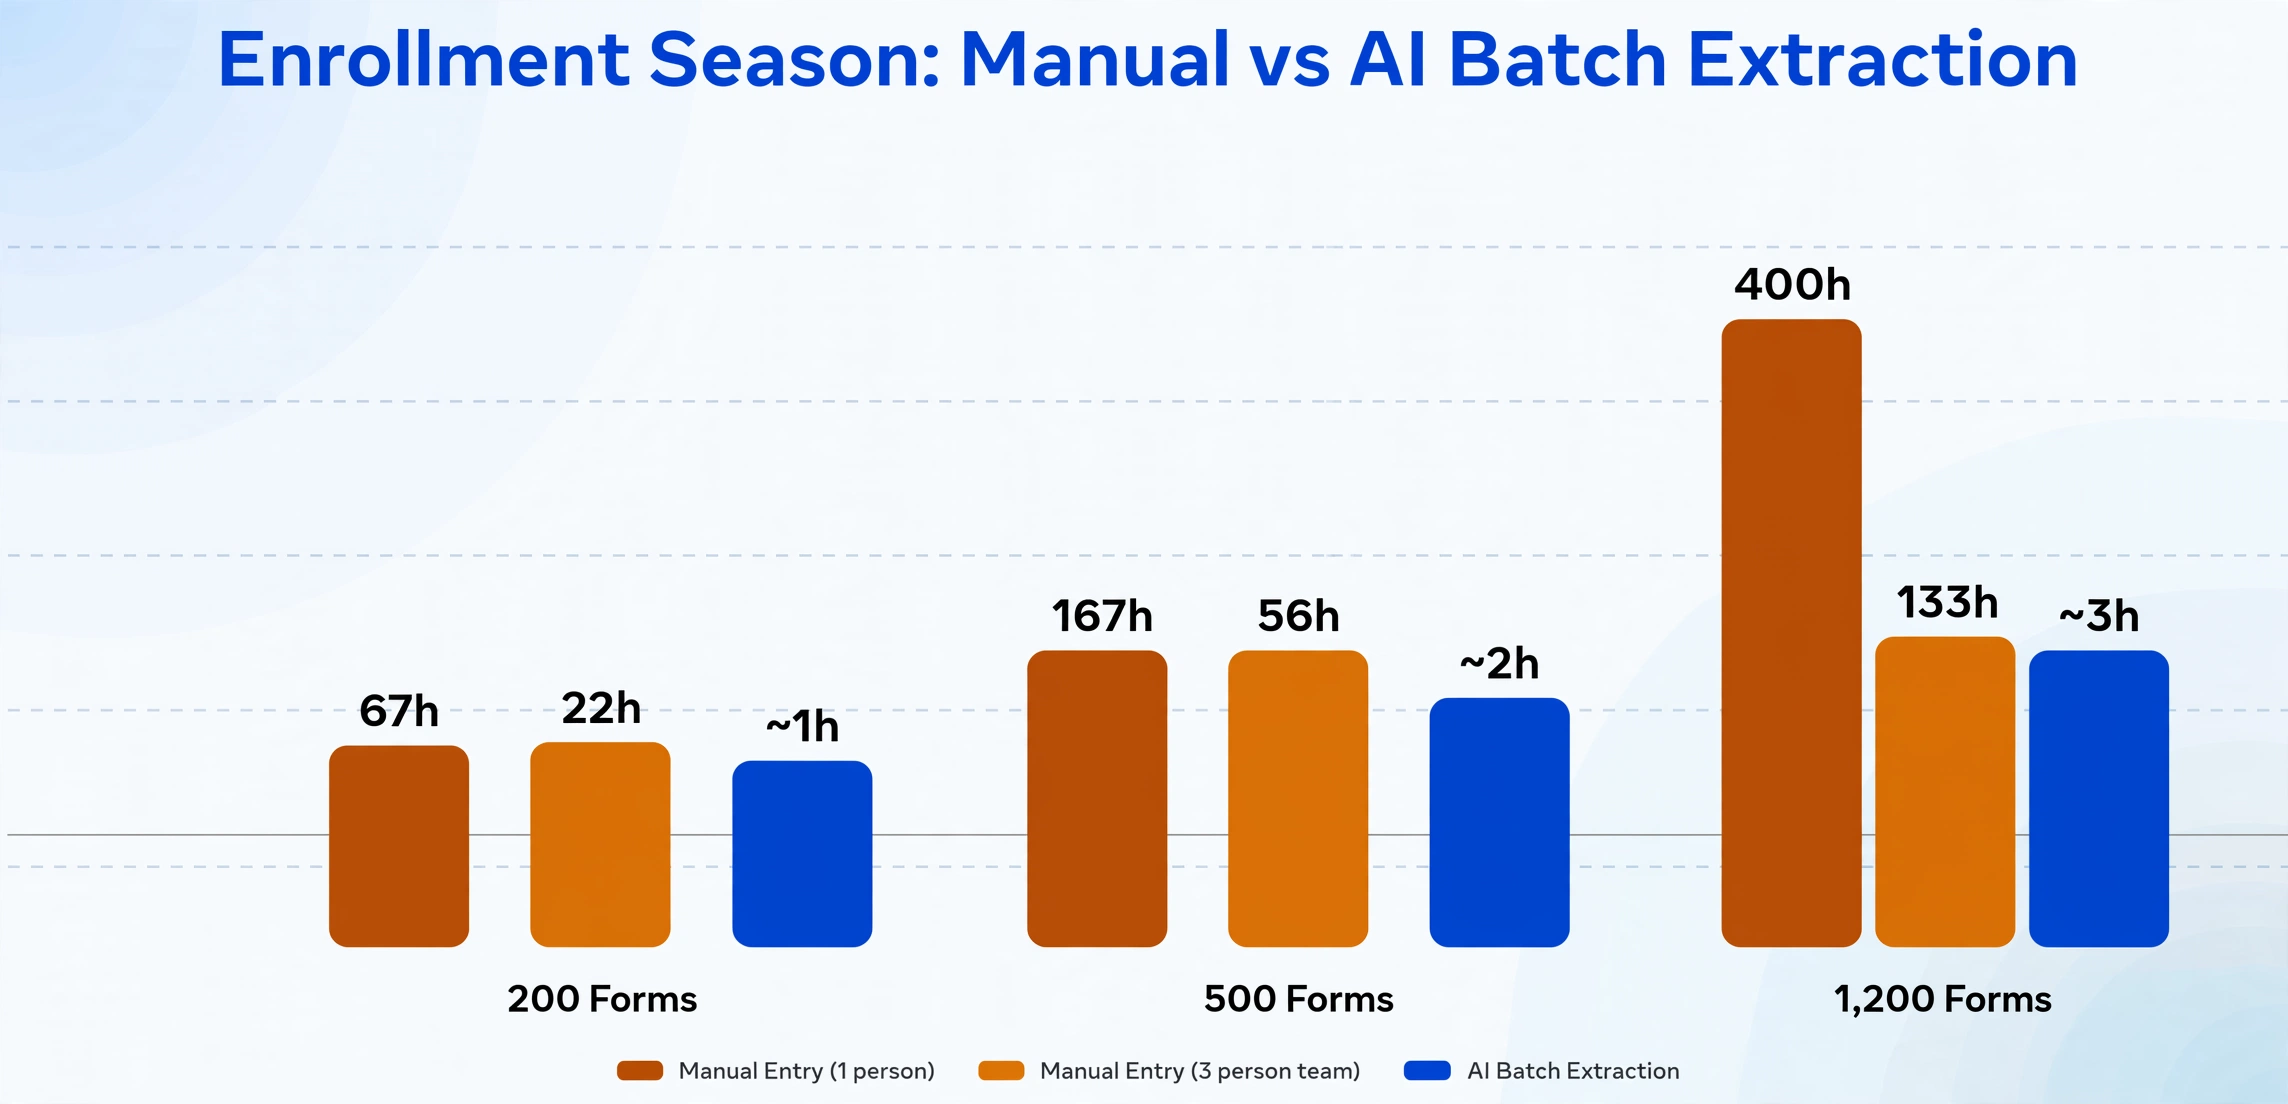
A vantagem operacional da extração com IA não está em processar um único formulário mais rápido. Está em processar 200 formulários no tempo que uma pessoa leva para digitar um único pacote. A tabela abaixo mostra o que isso significa em três volumes comuns de matrícula, usando uma taxa de digitação manual medida de cerca de 20 minutos por pacote e um fluxo de trabalho de IA com um único operador.
| Volume de Matrículas | Digitação Manual (1 pessoa) | Digitação Manual (equipe de 3 pessoas) | Extração em Lote com IA |
|---|---|---|---|
| 200 formulários (escola fundamental pequena) | ~67 horas (1,7 semanas) | ~22 horas (3 dias) | ~15–20 min de extração + 30–45 min de verificação |
| 500 formulários (K-8 (do ensino fundamental ao médio) de porte médio) | ~167 horas (4,2 semanas) | ~56 horas (1,4 semanas) | ~25–40 min de extração + 60–90 min de verificação |
| 1.200 formulários (escola de ensino médio grande ou lote de distrito) | ~400 horas (10 semanas) | ~133 horas (3,3 semanas) | ~45–75 min de extração + 2–3 h de verificação |
O tempo de verificação pressupõe uma revisão direcionada apenas dos campos de alta prioridade, ou seja, contatos de emergência e dados médicos, além de uma amostra aleatória de 5% dos campos restantes. Esse é o insight crítico do fluxo de trabalho: o objetivo não é eliminar a revisão humana, mas reduzir a superfície de verificação de 100% dos campos (cada caractere digitado manualmente) para 10–15% dos campos (apenas os dados de maior risco).
A arquitetura de lote da ferramenta de extração também importa para a confiabilidade do fluxo de trabalho. Um sistema baseado em nuvem projetado para Processamento Prioritário em Lote lida com 200 uploads de arquivos simultâneos sem enfileiramento ou atrasos de processamento por arquivo. A restrição de throughput passa a ser a largura de banda de upload e a etapa de verificação, não a capacidade de inferência do modelo de IA. Para um passo a passo detalhado do fluxo de trabalho de processamento em lote, incluindo o fluxo exato de upload e como a saída do Excel é estruturada para importação no SIS, consulte o guia prático complementar Como Extrair Dados de Formulários de Matrícula de Alunos para o Excel para o SIS do Distrito Escolar.
Garantia de Qualidade: O Que Verificar e O Que Confiar
Todo fluxo de extração precisa de uma etapa de garantia de qualidade. O design dessa etapa determina se o fluxo economiza tempo ou simplesmente substitui um tipo de trabalho de dados por outro. Aqui está um framework prático de QA projetado para o processamento de formulários de matrícula:
Nível 1 — Confiar no nível do lote (70–80% dos campos). Campos impressos (rótulos de formulário, informações do estudante pré-preenchidas em PDFs preenchíveis), seleções de caixas de seleção e status de consentimento têm precisão alta o suficiente (95–99%) para que uma verificação por amostragem no nível do lote seja suficiente. Verifique 5% das linhas para esses tipos de campo. Se a taxa de erro na amostra exceder 2%, escale para revisão campo a campo.
Nível 2 — Verificação pontual por formulário (15–20% dos campos). Nomes dos pais, endereços dos estudantes, séries escolares e nomes de médicos se enquadram nessa categoria. Esses campos são manuscritos, mas seguem padrões previsíveis: nomes seguem convenções de nomenclatura, e endereços incluem estruturas de rua/cidade/estado/CEP. Verifique pontualmente 100% desses campos nos primeiros 10 formulários de um lote para estabelecer uma taxa de erro de referência, depois reduza para verificação pontual de 20% dos formulários se a referência estiver limpa.
Nível 3 — Verificar cada registro (5–10% dos campos). Números de telefone de contato de emergência, descrições de alergias/condições médicas e datas de vacinação exigem verificação campo a campo em cada registro. A consequência de um erro é alta demais para aceitar amostragem estatística: um número de contato de emergência errado durante uma crise escolar, uma anotação de alergia lida incorretamente durante a administração de medicamentos. Esses campos devem ser os únicos que recebem 100% de revisão humana.
Quando a ferramenta de extração fornece uma pontuação de confiança para cada valor extraído (a maioria das ferramentas de IA semântica fornece), use-a para priorizar a verificação: ordene a planilha de saída pela pontuação de confiança em ordem crescente e revise apenas os registros de baixa confiança. Isso normalmente reduz a carga de verificação em 30–50% adicionais em comparação com a revisão de todos os campos de alta prioridade diretamente.
As pontuações de confiança dizem onde procurar; elas não mostram o que a IA realmente leu. Para os campos críticos de segurança que você verifica em cada registro, uma interface de revisão que vincula cada célula extraída de volta à sua posição na página fecha essa lacuna. Clique em um número de telefone ou em uma anotação de alergia e o scan original destaca a região de onde aquele valor veio; clique em uma região na imagem e ela salta de volta para a célula correspondente. No ImageToTable.ai isso é o Review Mode com verificação assistida por bbox, e transforma "esse valor está certo?" em alguns segundos de confirmação visual em vez de uma releitura do pacote.
O resultado prático: Um framework de QA bem projetado para formulários de matrícula verifica 100% dos contatos de emergência e campos médicos, faz verificação pontual de 20% dos dados demográficos dos pais e confia nos campos de caixa de seleção/consentimento no nível do lote. Essa abordagem de três níveis captura os campos onde os erros têm consequências reais, evitando a armadilha de revisar cada valor extraído como se fosse igualmente provável de estar errado.
Lidando com famílias com vários formulários
Uma família que matricula três crianças envia três pacotes de matrícula separados, um por criança. Cada pacote contém as informações demográficas compartilhadas da família (nomes dos pais, endereço residencial, contatos de emergência, operadora do plano de saúde) além dos dados específicos da criança (série, condições médicas, preferência de professor, rota do ônibus). Os três pacotes são PDFs independentes, mas os dados que contêm se sobrepõem bastante.
A ferramenta de extração processa cada pacote de forma independente, o que é o comportamento correto: o registro de cada criança no SIS deve ser autossuficiente. A saída do lote conterá três linhas, uma por criança, com os dados compartilhados da família repetidos entre as linhas. Ao importar para o PowerSchool ou o Infinite Campus, cada linha cria um registro de aluno separado com seus próprios campos de contato dos pais e contato de emergência.
Duas considerações operacionais para famílias com vários formulários:
Verificação de consistência. Após a extração, compare os campos de contato dos pais entre as linhas dos irmãos. Se a extração produzir números de telefone diferentes para os pais da Criança A e da Criança B (quando o mesmo pai ou mãe preencheu os dois formulários no mesmo dia), um dos valores provavelmente é um erro de extração. Sinalize essas discrepâncias para revisão. Essa validação entre linhas detecta erros de extração que uma revisão de uma única linha deixaria passar.
Atualização em massa vs. dados por criança. Alguns campos do pacote de matrícula, como endereço residencial, números de telefone dos pais e operadora do plano de saúde, são dados no nível da família que se aplicam de forma idêntica a todos os irmãos. Outros campos, como série, atribuição de professor e condições médicas, são específicos da criança e nunca devem ser copiados entre linhas. O design das suas colunas de extração deve refletir essa distinção. Uma coluna rotulada "Endereço Residencial" produz o mesmo valor para as três crianças (o endereço que o pai ou a mãe escreveu em cada formulário). Uma coluna rotulada "Nome do Professor" produz um valor diferente para cada criança. A ferramenta de extração lida com isso corretamente desde que as colunas sejam definidas na granularidade certa.
Conformidade com a FERPA para Extração de Formulários de Matrícula
No momento em que um formulário de matrícula digitalizado é enviado a uma ferramenta de extração por IA de terceiros, o distrito escolar realizou uma divulgação de informações de identificação pessoal de um registro educacional sob a Lei de Direitos e Privacidade Educacional da Família (FERPA, 20 U.S.C. § 1232g; 34 CFR Parte 99). Um formulário de matrícula contendo o nome completo do aluno, data de nascimento, endereço e informações de contato dos pais atende à definição do § 99.3 de registro educacional. Essa divulgação exige consentimento dos pais ou uma exceção aplicável, e para extração de documentos a exceção aplicável é a exceção do funcionário escolar sob o § 99.31(a)(1)(i)(B) (consulte a orientação do PTAC sobre computação em nuvem sob a FERPA do Departamento de Educação dos EUA).
Três requisitos devem ser atendidos para que a exceção do funcionário escolar se aplique. Primeiro, o provedor de extração deve realizar um serviço institucional: extrair dados de formulários de matrícula é uma função que o distrito realizaria de outra forma com sua própria equipe. Segundo, o provedor deve operar sob o controle direto do distrito, estabelecido por meio de um contrato escrito que restrinja como os dados dos alunos podem ser usados e mantidos. Terceiro, o provedor deve estar sujeito às restrições de redivulgação do § 99.33(a), o que significa que não pode compartilhar dados extraídos dos alunos com subprocessadores ou outras partes sem a autorização do distrito.
O requisito operacional crítico que a maioria dos distritos ignora: o contrato escrito deve proibir especificamente que o provedor de extração use documentos de alunos enviados para treinar seus modelos de IA. Um provedor que usa formulários de matrícula de alunos para melhorar seu mecanismo de extração está usando os dados para uma finalidade além do serviço autorizado, e esse uso secundário não é coberto pela exceção do funcionário escolar. Esta é a lacuna de conformidade mais comum nos fluxos de trabalho de extração de distritos K-12 (do ensino fundamental ao médio) hoje.
A análise regulatória completa, incluindo como determinar se um documento se qualifica como registro educacional, o que a exceção do funcionário escolar exige na prática, o que o contrato deve incluir, requisitos de retenção e exclusão, e como as leis estaduais de privacidade de dados de alunos interagem com a FERPA, é abordada em detalhes no artigo complementar Extração de Dados de Alunos em Conformidade com a FERPA: Um Guia para Admissões. Esse guia inclui uma lista de verificação de conformidade em sete etapas que mapeia cada requisito para uma referência regulatória específica.
Comparando suas opções: entrada manual vs. OCR com modelo vs. IA semântica
Distritos escolares que processam formulários de matrícula têm três abordagens disponíveis. Cada uma tem uma estrutura de custos, tempo de configuração, perfil de precisão e comportamento de escalabilidade diferentes. A tabela abaixo as compara nas dimensões que mais importam para a temporada de matrículas.
| Dimensão | Entrada manual de dados | OCR com modelo (ex.: Docparser, ABBYY) | IA semântica (ex.: ImageToTable.ai) |
|---|---|---|---|
| Tempo de configuração | Nenhum — qualquer funcionário pode digitar | 1–3 horas por layout de formulário — exige definir zonas de extração para o pacote de cada escola | 15–30 minutos — defina os nomes das colunas uma vez para todas as escolas |
| Custo por formulário com 500 formulários | ~$2,00–$3,00 em tempo de funcionários | ~$0,20–$0,50 (software + configuração de modelo amortizados) | ~$0,10–$0,25 por página |
| Suporte a manuscrito | Humano lê qualquer manuscrito | Ruim — OCR em nível de caractere em cursivo geralmente cai abaixo de 60% de precisão | Bom (85–92%) — a leitura contextual melhora em formulários estruturados |
| Detecção de caixas de seleção | Humano lê o estado da caixa de seleção | Limitada — exige regras baseadas em zonas para cada posição de caixa de seleção | Forte (95–98%) — lê a caixa de seleção no contexto do seu rótulo |
| Mapeamento de relações entre múltiplos campos | Humano entende as relações naturalmente | Não suportado — cada zona produz um dado independente | Suportado — a IA associa nome + parentesco + telefone como um único registro de contato |
| Lidar com múltiplos layouts de formulário | Humano se adapta a cada layout | Exige modelo separado por layout — 5 escolas = 5 modelos | Um conjunto de colunas lida com qualquer layout — a IA lê pelo significado, não pela posição |
| Escalabilidade (200→1.000 formulários) | Linear — 5x o volume = 5x o tempo de funcionários | Sublinear, mas a manutenção de modelos cresce com a variedade de layouts | Sublinear — 5x o volume adiciona ~30 min ao tempo de processamento |
| Base de conformidade com FERPA (Lei de Direitos e Privacidade Educacional da Família) | Nenhuma transferência externa de dados — nenhuma divulgação sob FERPA | Exige contrato com fornecedor com exceção de funcionário escolar | Exige contrato com fornecedor com exceção de funcionário escolar |
A escolha se resume a duas perguntas. Se o seu distrito processa menos de 100 formulários de matrícula por ano e os formulários são predominantemente impressos (não manuscritos), a entrada manual pode ser a opção mais simples, porque o investimento de tempo para configurar qualquer sistema automatizado não compensa nesse volume. Se você processa 200 formulários ou mais, ou se seus formulários contêm manuscrito, caixas de seleção ou múltiplos layouts de diferentes escolas, a IA semântica oferece a melhor relação precisão-esforço. O OCR com modelo ocupa um meio-termo cada vez mais estreito: lida com formulários impressos em escala, mas falha em manuscrito, caixas de seleção e variedade de layouts: as três características que definem os pacotes de matrícula K-12 (do ensino fundamental ao médio).
Perguntas Frequentes
Um portal de matrícula online não elimina a necessidade de extração?
Portais online (PowerSchool Enrollment, SchoolMint, LINQ) cuidam de novas matrículas feitas inteiramente pelo portal. Na prática, eles não eliminam os formulários em papel porque uma parcela considerável das famílias ainda entrega pacotes em papel, e essa parcela varia por distrito e série: famílias que participaram de eventos de matrícula presencial, famílias sem banda larga residencial confiável, famílias cujo idioma principal não é suportado pelo fluxo completo do portal e famílias que já estudavam na rede e cujas contas do portal expiraram ou nunca foram criadas. A extração é a solução para o papel que chega independentemente da existência do portal online.
Qual é o limite prático de precisão para campos manuscritos em formulários de matrícula?
Em formulários de matrícula estruturados, com rótulos e limites de campo claros, a extração de manuscritos normalmente alcança 85–92% de precisão para nomes e endereços, e 75–85% para narrativas médicas em texto livre. Esses números pressupõem qualidade de digitalização razoável (300 DPI, bom contraste) e caligrafia padrão. Formulários preenchidos com letras de forma maiúsculas chegam a 95% de precisão; a cursiva com abreviações cai para perto de 75%. O teto de precisão não é o modelo de IA, mas a ambiguidade inerente da caligrafia, sobre a qual até leitores humanos às vezes discordam. Nenhum sistema de extração, com IA ou não, deve ser considerado confiável para ler campos médicos manuscritos sem verificação humana.
O que acontece quando nosso distrito redesenhar o pacote de matrícula no ano que vem?
Com a extração semântica por IA, nada muda. Os nomes das colunas permanecem os mesmos (Nome do Aluno, Data de Nascimento, Contato dos Pais, Telefone de Emergência, Alergias), e a IA localiza os dados correspondentes no novo layout do formulário lendo os rótulos dos campos. Você não precisa reconfigurar zonas, modelos ou regras. Essa é a vantagem decisiva da extração semântica sobre o OCR (reconhecimento óptico de caracteres) baseado em modelo: o layout do formulário é irrelevante para a lógica de extração porque a IA lê o conteúdo, não as coordenadas.
Os dados extraídos podem ir diretamente para o nosso SIS, ou precisamos de middleware?
A maioria das plataformas SIS K-12 (do ensino fundamental ao médio) (PowerSchool, Infinite Campus, Skyward, Ellucian Banner) aceita importação em massa de CSV ou Excel para registros demográficos de alunos. Depois que a ferramenta de extração gera uma planilha com colunas que correspondem ao modelo de importação do seu SIS, você usa a função de importação padrão do SIS para enviar os dados. Nenhum middleware é necessário. É preciso fazer uma configuração inicial de mapeamento de colunas na ferramenta de importação do SIS, e os lotes seguintes seguem o mesmo mapeamento.
A extração funciona em formulários de matrícula em espanhol ou outros idiomas?
Sim. A IA lê texto manuscrito e impresso na maioria dos idiomas comuns. O espanhol é o idioma não inglês mais frequente nos formulários de matrícula K-12 (do ensino fundamental ao médio) nos EUA, e a extração lida com ele sem configuração separada. Os nomes das colunas devem ser definidos no idioma que o seu SIS espera (normalmente inglês para distritos dos EUA); a IA extrai o texto em espanhol do formulário e o coloca na coluna correspondente com nome em inglês. Para distritos que fornecem pacotes de matrícula em vários idiomas (inglês, espanhol, vietnamita, mandarim, árabe), um único conjunto de colunas processa todos eles.
Os requisitos da HIPAA se aplicam aos campos médicos dos formulários de matrícula, ou a FERPA (Lei de Direitos e Privacidade Educacional da Família) cobre esses campos?
A FERPA (Lei de Direitos e Privacidade Educacional da Família), e não a HIPAA, rege as informações de saúde do aluno mantidas por uma escola. A Regra de Privacidade da HIPAA exclui "registros educacionais cobertos pela FERPA" de sua definição de informações de saúde protegidas (45 CFR § 160.103). Isso significa que as condições médicas, descrições de alergias e registros de imunização em um formulário de matrícula são protegidos pela FERPA (Lei de Direitos e Privacidade Educacional da Família), e não pela HIPAA, desde que a escola os mantenha como registros educacionais. A implicação prática: o framework de conformidade com a FERPA (exceção do funcionário escolar, contrato por escrito, sem treinamento de modelo) cobre tanto os campos médicos quanto os demográficos. Você não precisa de uma análise separada da HIPAA para a extração de formulários de matrícula, embora alguns estados tenham leis adicionais de privacidade de saúde do aluno que podem se aplicar.
Como lidamos com formulários de matrícula que chegam como conjuntos de digitalizações de várias páginas com documentação de ensino domiciliar ou de fora do distrito?
Inclua todas as páginas na digitalização (declarações de residência, comprovantes de endereço, formulários de notificação de ensino domiciliar, ordens de guarda) como parte do mesmo PDF de várias páginas por aluno. A IA de extração lê apenas as páginas e os campos que correspondem aos nomes de coluna definidos por você, ignorando páginas sem dados de matrícula. Páginas que não correspondem são ignoradas no resultado da extração, mas permanecem como parte do registro do documento. A sinalização de páginas específicas para extração (por exemplo, "extrair apenas das páginas 1 a 4 de um pacote de 15 páginas") é tratada no nível de definição de coluna na maioria das ferramentas de IA semântica.
A extração de formulários de matrícula de alunos não é uma decisão sobre uma única tecnologia. É uma transformação de fluxo de trabalho que envolve digitalização, design de colunas, processamento em lote, verificação, importação para o SIS e documentação de conformidade.
O fluxo de trabalho em quatro fases — digitalizar, definir colunas, processar lote e verificar e importar — transforma a pilha de pacotes de papel de agosto em uma planilha estruturada pronta para o PowerSchool ou o Infinite Campus. A estrutura de QA indica quais campos verificar em cada registro (contatos de emergência, dados médicos) e quais campos confiar no nível do lote (caixas de seleção, formulários de consentimento). A conformidade com a FERPA (Lei de Direitos e Privacidade Educacional da Família) é um pré-requisito, não uma reflexão tardia: um acordo institucional assinado com seu fornecedor de extração, uma proibição por escrito de treinamento de modelos e um cronograma de retenção documentado.
Teste o fluxo de trabalho em dez formulários de matrícula da inscrição deste ano. Se o perfil de precisão corresponder ao descrito aqui, você tem seu modelo para todas as temporadas de matrícula que virão.
Grátis para testar, sem cadastro. Os arquivos são processados de forma transitória e não são retidos. Pergunte sobre acordos institucionais compatíveis com a FERPA para o seu distrito.