Des dossiers papier aux lignes prêtes pour le SIS :
Le guide complet de l'extraction de formulaires d'inscription K-12 (maternelle à terminale)
Chaque année en août, environ 49 millions d'élèves des écoles publiques américaines retournent en classe (National Center for Education Statistics, 2024–25). Pour les familles qui inscrivent encore leurs enfants ou fournissent des dossiers papier à jour, chaque nom manuscrit, chaque case cochée et chaque note médicale doit être saisi dans un système d'information sur les élèves (SIS) avant le début des cours. Un dossier type d'inscription K-12 (maternelle à terminale) compte 15 à 25 pages réparties sur une douzaine de sections : données démographiques des élèves, contacts des parents et tuteurs, contacts d'urgence avec relations multi-champs, conditions médicales, carnets de vaccination, préférences de transport et multiples formulaires de consentement. Chaque section utilise un format de données différent : lettres capitales imprimées, écriture cursive, cases à cocher, options encerclées, textes libres. Chacun de ces formats échoue différemment lorsqu'il est traité par l'OCR (reconnaissance optique de caractères) traditionnelle.
Points clés
- La plupart des districts scolaires supposent qu'un portail d'inscription en ligne élimine le travail de saisie. En pratique, de nombreuses familles remettent encore des dossiers papier chaque année en août, et ces piles de formulaires de 15 à 25 pages atterrissent au bureau d'accueil.
- L'OCR (reconnaissance optique de caractères) basée sur des modèles était censée résoudre ce problème, mais elle échoue sur les trois caractéristiques qui définissent les formulaires d'inscription : le mélange d'écriture manuscrite et de texte imprimé sur la même page, les grilles de cases à cocher à côté de champs de texte libre, et les relations multi-champs comme les contacts d'urgence qui doivent rester groupés en un seul enregistrement.
- L'IA sémantique gère les trois : définissez une fois votre jeu de 28 colonnes, téléversez les dossiers de chaque école en un seul lot quelle que soit la mise en page, et concentrez la vérification sur les champs où les erreurs ont de réelles conséquences : les contacts d'urgence et les données médicales.
Qu'est-ce que l'extraction de formulaires d'inscription d'élèves ?
L'extraction de données de formulaires d'inscription d'élèves est le processus automatisé de lecture des données contenues dans les dossiers d'inscription K-12 (maternelle à terminale) remplis (noms manuscrits ou imprimés, dates de naissance, coordonnées des parents, informations médicales et cases à cocher) et de leur conversion en lignes structurées de tableur pouvant être importées dans un système d'information sur les élèves (SIS). Il s'agit d'une application spécialisée de l'extraction de données par IA qui gère la réalité multi-format des formulaires d'inscription : les étiquettes pré-imprimées côtoient les réponses manuscrites, les cases à cocher se trouvent à côté des lignes de signature, et les récits médicaux en texte libre partagent la même page que les blocs d'adresse structurés.
Contrairement à la reconnaissance optique de caractères (OCR) traditionnelle, qui lit les caractères un par un sans comprendre leur signification, l'extraction sémantique par IA identifie les champs selon leur sens et leur contexte. C'est l'approche utilisée par les outils modernes tels que ImageToTable.ai. Lorsque l'IA rencontre une section intitulée « Contact d'urgence — Nom », elle sait qu'elle doit extraire le nom d'une personne de cette zone, même si l'écriture relie toutes les lettres en cursive. Cette compréhension sémantique est ce qui rend l'extraction de formulaires d'inscription fonctionnelle à grande échelle, car aucun district scolaire n'imprime ses dossiers d'inscription de la même manière, et les parents ne les remplissent jamais deux fois de la même façon.
Ce guide couvre l'ensemble du tableau : les défis uniques que présentent les formulaires d'inscription (ce ne sont ni des factures ni des relevés bancaires), le flux de travail de bout en bout, du dossier papier à l'importation dans le SIS, les stratégies d'extraction champ par champ, le traitement par lots pour le pic d'inscriptions d'août à septembre, la gestion des familles avec plusieurs formulaires où chaque enfant a son propre dossier, la conformité FERPA (Family Educational Rights and Privacy Act), et une comparaison des trois approches disponibles aujourd'hui pour les districts scolaires : la saisie manuelle des données, l'OCR basée sur des modèles et l'extraction sémantique par IA.
Pourquoi les formulaires d'inscription posent un problème d'extraction différent
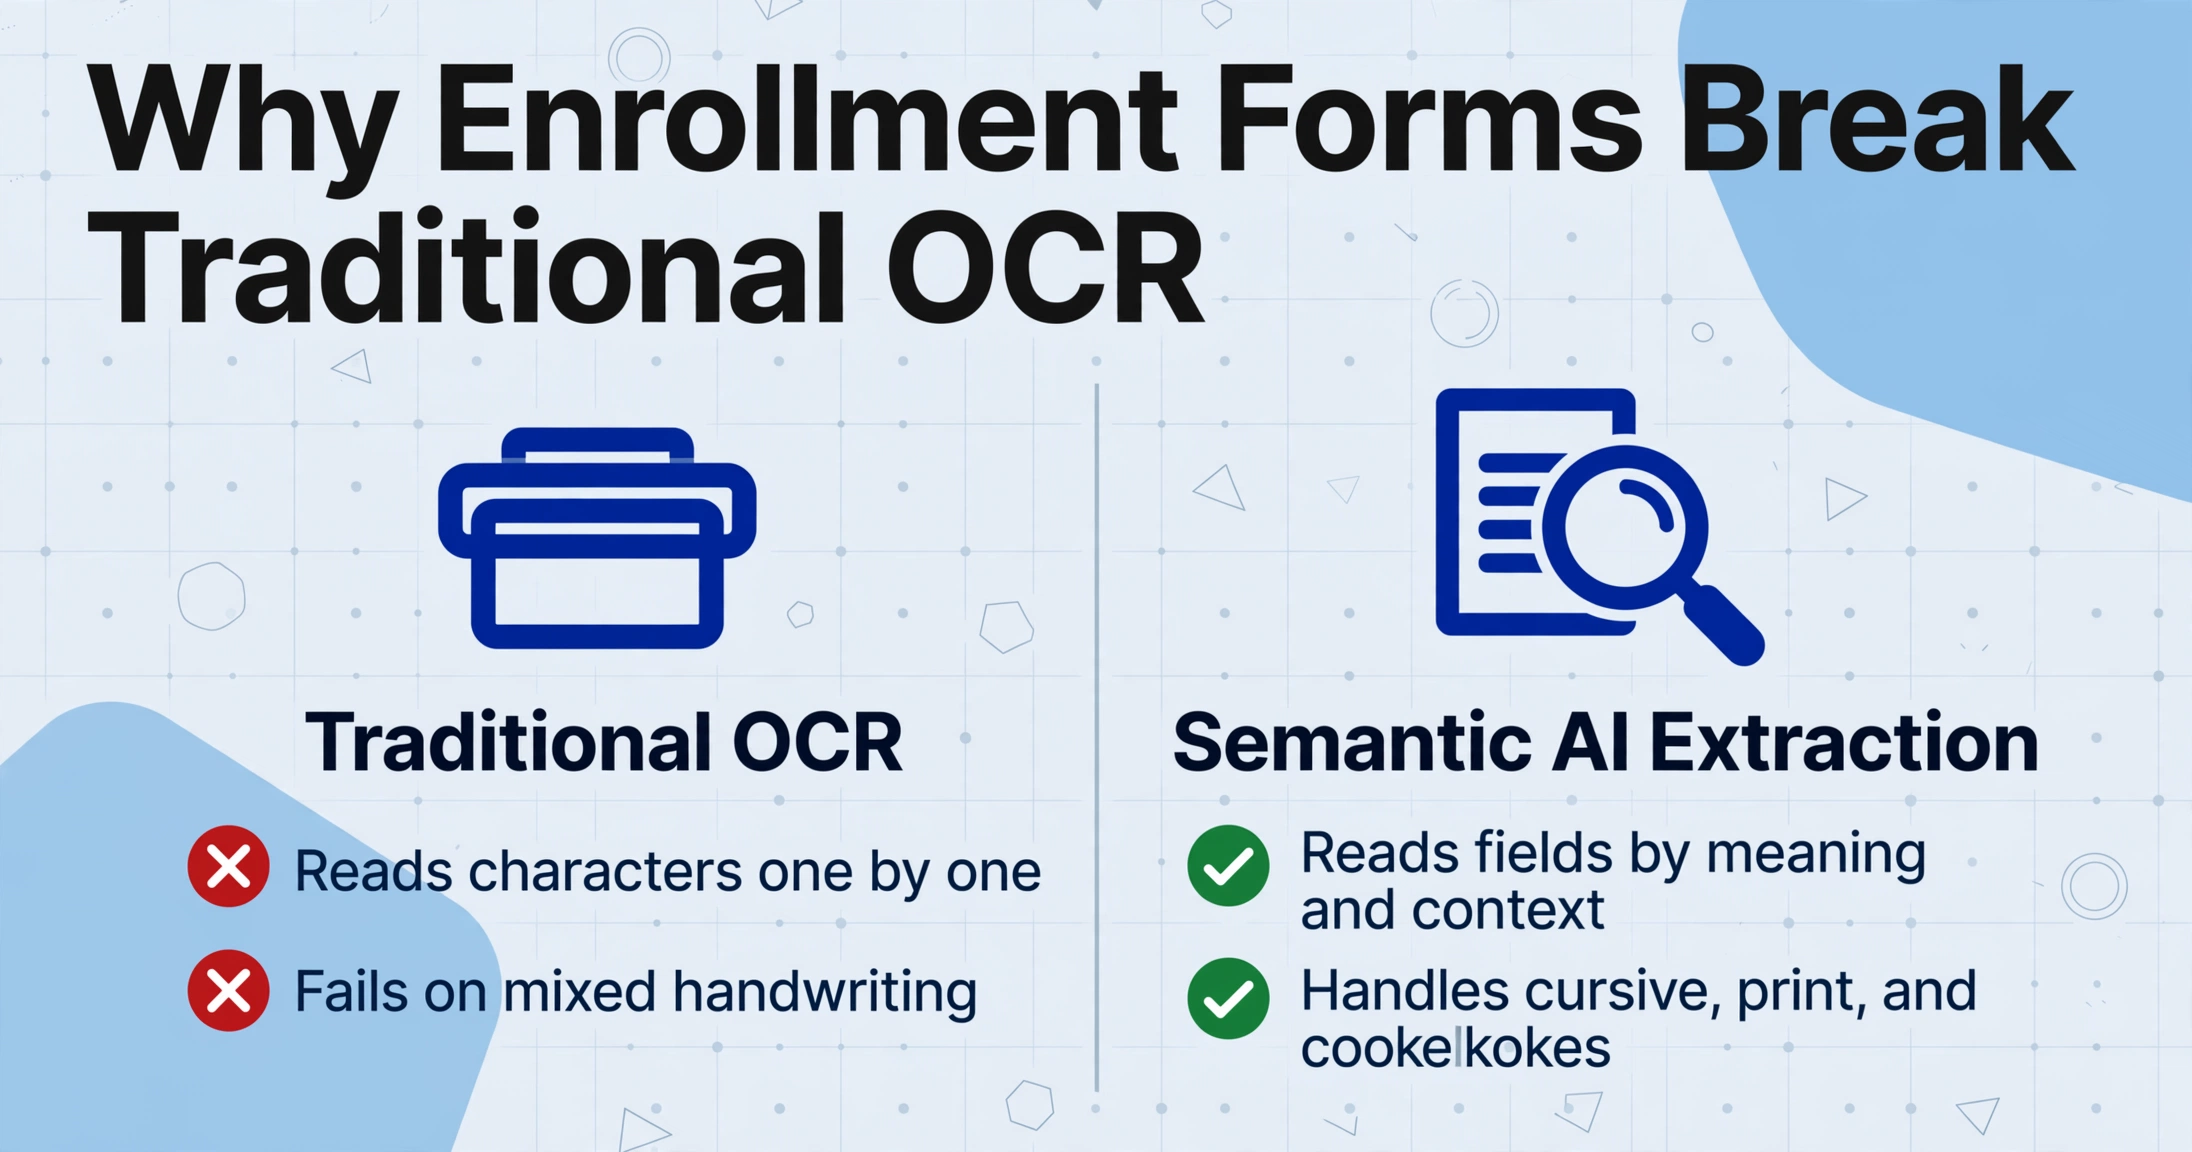
Un dossier d'inscription scolaire n'est pas un seul type de document. C'est une douzaine de structures documentaires différentes reliées entre elles, et chacune se comporte différemment lorsqu'elle est traitée par un outil d'extraction. Comprendre ces réalités structurelles est le prérequis pour bâtir un flux de travail qui fonctionne à grande échelle.
Écriture manuscrite et texte imprimé sur la même page
Un formulaire d'inscription comporte généralement des étiquettes pré-imprimées dans une police standard (« Nom légal de l'élève __________ ») et des réponses manuscrites dans les espaces vides. Une seule page peut contenir des lettres majuscules imprimées d'un parent qui a rempli le formulaire avec soin, une écriture cursive d'un autre parent qui a écrit rapidement, et une coche qui n'est ni de l'écriture imprimée ni de la cursive, mais un gribouillis. L'OCR traditionnel est conçu pour du texte imprimé uniforme sur des fonds propres, et il n'a qu'un seul mode de reconnaissance : le décodage caractère par caractère. C'est pourquoi il échoue sur cette saisie mixte. L'IA sémantique traite chaque champ indépendamment, en utilisant le contexte fourni par les étiquettes imprimées pour ancrer l'extraction du contenu manuscrit. Le même mécanisme sous-tend l'extraction de formulaires manuscrits en général, et les dossiers d'inscription en sont l'un des cas les plus difficiles.
Cases à cocher et champs de texte libre côte à côte
Les formulaires d'inscription regorgent de choix binaires tels que « Votre enfant a-t-il des allergies ? ☐ Oui ☐ Non », suivis immédiatement de champs de texte libre demandant des détails. Un parent peut cocher « Oui » à la question sur les allergies et écrire « Pénicilline — provoque une éruption cutanée » dans le champ de texte ci-dessous. L'outil d'extraction doit lire le signal binaire (quelle case est cochée) et le texte narratif (ce que le parent a réellement écrit) comme deux points de données distincts mais liés. Ce couplage est trivial pour un modèle d'IA sémantique qui lit le document dans son ensemble. Il est étonnamment difficile pour un OCR basé sur des modèles, qui exige généralement des règles distinctes pour les zones de cases à cocher et les zones de texte, et qui n'a aucun moyen de relier les deux.
Structures de relations multi-champs
La section des contacts d'urgence d'un formulaire d'inscription illustre la complexité relationnelle qui rend les formulaires étudiants plus difficiles à traiter que la plupart des documents professionnels. Un seul formulaire peut demander « Contact d'urgence 1 — Nom, Lien, Téléphone » et « Contact d'urgence 2 — Nom, Lien, Téléphone ». Trois champs par contact sont liés à la même référence de personne. L'outil d'extraction doit savoir que « John Smith », « Père » et « 555-123-4567 » appartiennent au même dossier de contact d'urgence, tandis que « Mary Jones », « Tante » et « 555-987-6543 » appartiennent à un autre contact. Dans un export vers un tableur, cela signifie une ligne par élève avec six colonnes de contact d'urgence (Nom 1, Lien 1, Téléphone 1, Nom 2, Lien 2, Téléphone 2), et l'IA doit mapper chaque donnée à la bonne colonne en comprenant quelle étiquette imprimée se trouve à côté sur la page.
Le pic d'inscriptions d'août à septembre
La contrainte de calendrier est le facteur le plus important sur le plan opérationnel. Dans la plupart des districts scolaires américains, la majorité des nouvelles inscriptions arrivent dans une fenêtre de quatre à six semaines entre la mi-juillet et le début septembre, et les mises à jour des élèves déjà inscrits suivent le même calendrier : changements de contacts d'urgence, nouvelles informations médicales, renouvellements de consentements. Pour un district de 5 000 élèves traitant environ 1 000 dossiers d'inscription nouveaux et de réinscription, cela représente 15 000 à 25 000 pages de formulaires en six semaines. Une équipe de saisie de deux ou trois employés de bureau ne peut pas saisir ce volume sans heures supplémentaires, retards ou erreurs. Ce qui détermine si les données d'inscription sont prêtes avant la rentrée, c'est la capacité de traitement de l'outil d'extraction, pas sa précision par page.
L'article complémentaire Can AI Extract Student Enrollment Forms? couvre en détail les estimations de précision champ par champ, y compris là où l'IA performe bien (texte imprimé, cases à cocher, débit par lot) et là où elle nécessite encore une vérification humaine (numéros de téléphone manuscrits, notes médicales en texte libre).
Le flux de travail complet : du dossier papier à l'enregistrement SIS
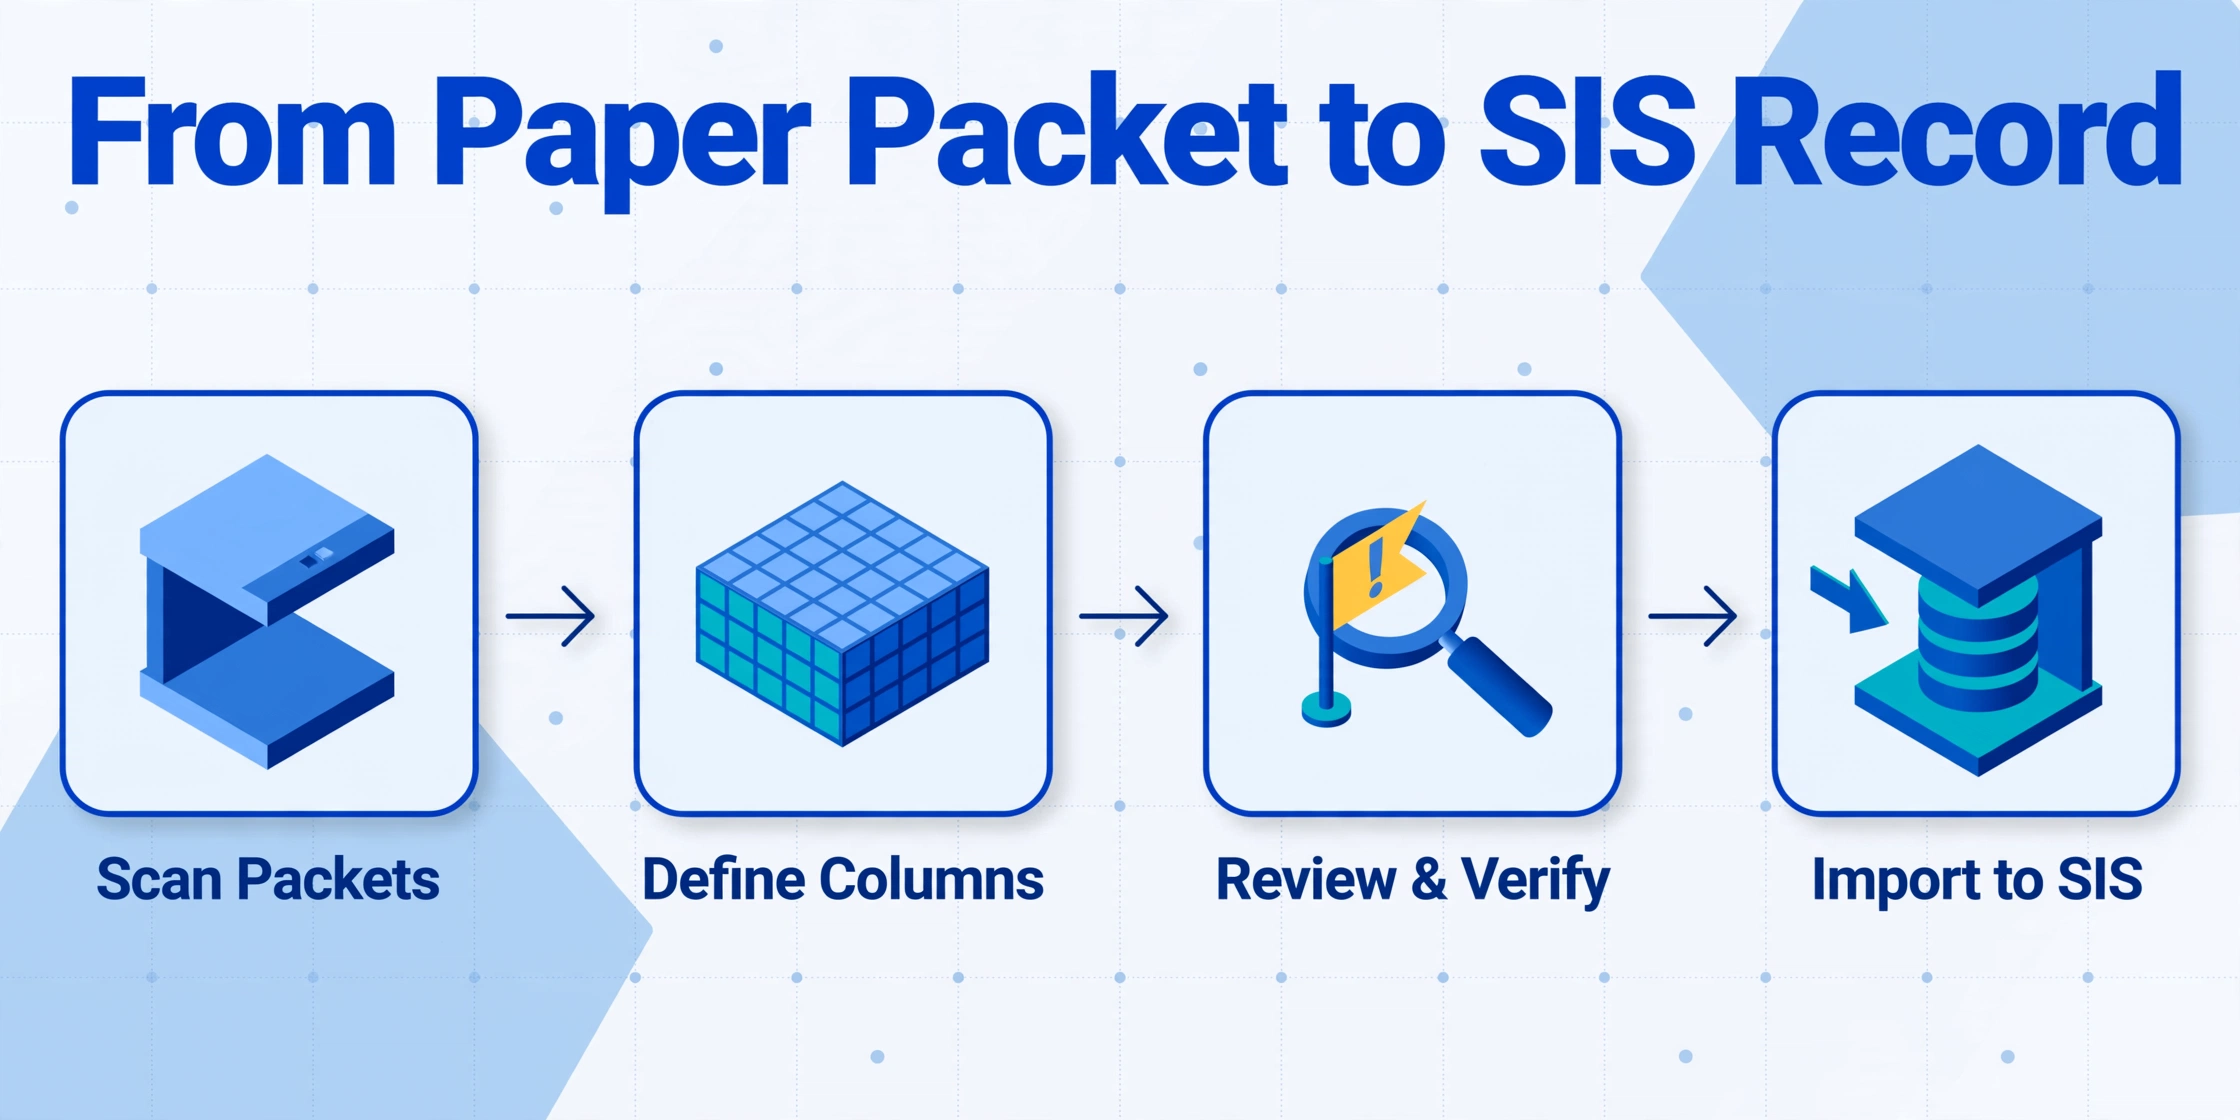
Le flux de travail d'extraction comporte quatre phases. Chaque phase correspond à une étape opérationnelle spécifique qu'un membre du personnel de la réception ou un coordonnateur des inscriptions peut exécuter sans assistance informatique.
Numériser et préparer les dossiers d'inscription
Numérisez le dossier complet de chaque élève sous forme d'un seul PDF multipage. Réglez le scanner sur 300 DPI en niveaux de gris. La couleur alourdit les fichiers sans améliorer la précision pour la plupart des formulaires d'inscription, tandis que le noir et blanc perd le contraste subtil qui distingue une case cochée au crayon du fond du papier. Nommez chaque fichier selon une convention cohérente : [Grade]_[Nom]_[Prénom].pdf. Ce modèle de nommage vous permet de recouper les données extraites avec le document source lors de la vérification, sans avoir à ouvrir chaque PDF individuellement.
Si les formulaires arrivent pré-triés par type (tous les formulaires médicaux ensemble, tous les formulaires de transport ensemble), vous aurez besoin d'un flux de travail de regroupement différent. En pratique, la majorité des dossiers d'inscription K-12 (maternelle à terminale) arrivent organisés par élève : chaque famille soumet un dossier ou une pile par enfant, et chaque pile contient l'ensemble complet des formulaires requis pour cet élève.
Définir les colonnes de sortie
C'est l'étape qui programme l'extraction. Dans un outil d'IA sémantique, vous définissez votre sortie en listant les noms de colonnes souhaités. Ces noms servent à la fois d'instructions pour que l'IA localise les données sur les formulaires et d'en-têtes de colonnes dans le tableur final. L'ensemble des colonnes doit refléter votre modèle d'import SIS. Un ensemble complet pour un dossier d'inscription K-12 (maternelle à terminale) type compte environ 28 champs, couvrant les données démographiques de l'élève, les informations sur les parents/tuteurs, les contacts d'urgence, les données médicales, le transport et les statuts de consentement.
La liste spécifique des colonnes et la logique de conception, notamment pourquoi séparer le prénom et le nom, comment utiliser les colonnes inférées pour les champs binaires et où inclure les noms de champs SIS comme indices, sont détaillées dans le guide complémentaire Comment extraire les données des formulaires d'inscription des élèves vers Excel pour l'import SIS. Cet article présente la configuration des colonnes avec des exemples concrets de champs.
Traiter le lot
Téléversez tous les PDF numérisés en un seul lot. L'outil d'IA extrait chaque champ de chaque formulaire en parallèle, et non un formulaire à la fois, puis fusionne les résultats dans un seul tableur où chaque ligne correspond à un enregistrement d'élève. Le temps de traitement augmente avec le nombre de fichiers, mais pas avec le nombre de pages par fichier ; un dossier de 20 pages et un formulaire de 2 pages se terminent à peu près dans le même temps par document, car l'IA lit le document entier comme une seule unité sémantique.
Pour 200 dossiers d'inscription avec 28 champs chacun, soit 5 600 points de données individuels, l'extraction prend environ 15 à 20 minutes de temps réel, contre environ 67 heures de saisie manuelle. Le résultat est un fichier Excel prêt pour l'import SIS.
Vérifier et importer dans le SIS
Vérifiez ponctuellement la sortie par rapport aux documents sources. Concentrez l'effort de vérification sur les champs où les erreurs ont le coût opérationnel le plus élevé : numéros de téléphone d'urgence, transcriptions des conditions médicales et notations d'allergies. Pour la plupart des lots d'inscription, ces champs à haut risque représentent 5 à 10 % du total des points de données extraits. Les 90 à 95 % restants (champs imprimés, sélections de cases à cocher, statuts de consentement) peuvent être acceptés au niveau du lot après vérification d'un échantillon.
Exportez le tableur vérifié au format .xlsx ou CSV et importez-le dans votre SIS à l'aide de son outil d'importation de données standard. PowerSchool, Infinite Campus et Skyward prennent tous en charge l'importation CSV en masse pour les dossiers démographiques des élèves. Après une configuration initiale de correspondance des colonnes dans l'outil d'importation du SIS, les lots d'inscription suivants suivent le même modèle.
Stratégie d'extraction champ par champ
Les champs d'un formulaire d'inscription ne doivent pas tous être extraits de la même manière. Le tableau ci-dessous regroupe les champs de formulaire d'inscription les plus courants selon l'approche d'extraction : extraction directe, classification inférée ou dérivation calculée. Il indique également le niveau de précision attendu pour chacun. Les fourchettes de précision et les taux de vérification de ce guide proviennent de nos propres tests sur des dossiers K-12 (maternelle à terminale) numérisés, et non d'un benchmark tiers ; la qualité de numérisation et l'écriture manuscrite peuvent donc les faire varier.
| Groupe de champs | Exemples de champs | Méthode d'extraction | Priorité de vérification |
|---|---|---|---|
| Données démographiques de l'élève | Nom complet, date de naissance, sexe, niveau scolaire, adresse | Extraction directe — L'IA lit la valeur manuscrite ou imprimée à côté de l'étiquette correspondante | Moyenne — L'ambiguïté du format de date de naissance et les sauts de ligne dans l'adresse sont les points de défaillance courants |
| Informations sur le parent/tuteur | Nom, lien de parenté, téléphone, e-mail, employeur | Extraction directe avec regroupement multi-champs — L'IA associe « Père » au téléphone et à l'e-mail écrits dans la même section | Moyenne-Élevée — Les numéros de téléphone sont le champ fragile ; vérifiez si les coordonnées ne présentent aucune redondance |
| Contacts d'urgence | Nom, lien de parenté, téléphone (2 à 3 contacts) | Extraction directe avec mise en correspondance relationnelle — L'IA attribue chaque trio de contact (nom + lien de parenté + téléphone) au bon emplacement numéroté | Élevée — Groupe de champs le plus critique ; un contact d'urgence mal indexé (étiqueter le contact 2 comme contact 1) compromet la joignabilité en cas d'urgence |
| Conditions médicales | Allergies, médicaments, maladies chroniques, nom du médecin, assureur | Extraction directe de l'écriture manuscrite en texte libre | La plus élevée — Données critiques pour la sécurité ; chaque champ médical doit être vérifié par un humain avant l'importation dans le SIS |
| Registres de vaccination | Nom du vaccin, date d'administration, professionnel de santé | Extraction de tableau — L'IA lit le tableau des vaccins comme une grille structurée (lignes = vaccins, colonnes = doses/dates) | Moyenne — Les formulaires de vaccination des États ont une structure de tableau cohérente ; vérifiez les dates pour la conformité réglementaire |
| Transport | Bus / voiture / marcheur, numéro de ligne de bus, horaires AM/PM | Classification inférée — L'IA lit la sélection de la case à cocher et génère le texte de l'étiquette (« Bus » et non le caractère « ☐ ») | Faible — Choix binaires avec signal visuel clair ; contrôle ponctuel au niveau du lot |
| Cases à cocher de consentement | Autorisation photo, accord technologique, accusé de réception du manuel, programme de cantine | Classification inférée — L'IA génère « Oui » ou « Non » en fonction de l'état de la case, avec une troisième colonne facultative pour « Signature du parent présente » | Faible — Signal binaire avec une précision de 95 à 98 % ; une vérification au niveau du lot est suffisante |
| Enquête sur la langue parlée à la maison | Langue principale, langues supplémentaires, langue préférée des parents | Extraction directe de texte manuscrit court ou de sélection de case à cocher | Faible-Moyenne — Les noms de langues sont des champs courts avec un vocabulaire limité ; vérifiez les noms de langues peu courants |
Le schéma est clair : les champs au contenu binaire ou à vocabulaire fermé (cases à cocher, formulaires de consentement, sélections de langue) peuvent être acceptés avec une vérification minimale. Les champs en écriture manuscrite libre sans redondance sémantique, en particulier les numéros de téléphone et les descriptions médicales, nécessitent une relecture humaine. Répartissez votre effort de vérification en conséquence, et non uniformément sur tous les champs.
Traitement par lots à l'échelle de la saison d'inscription
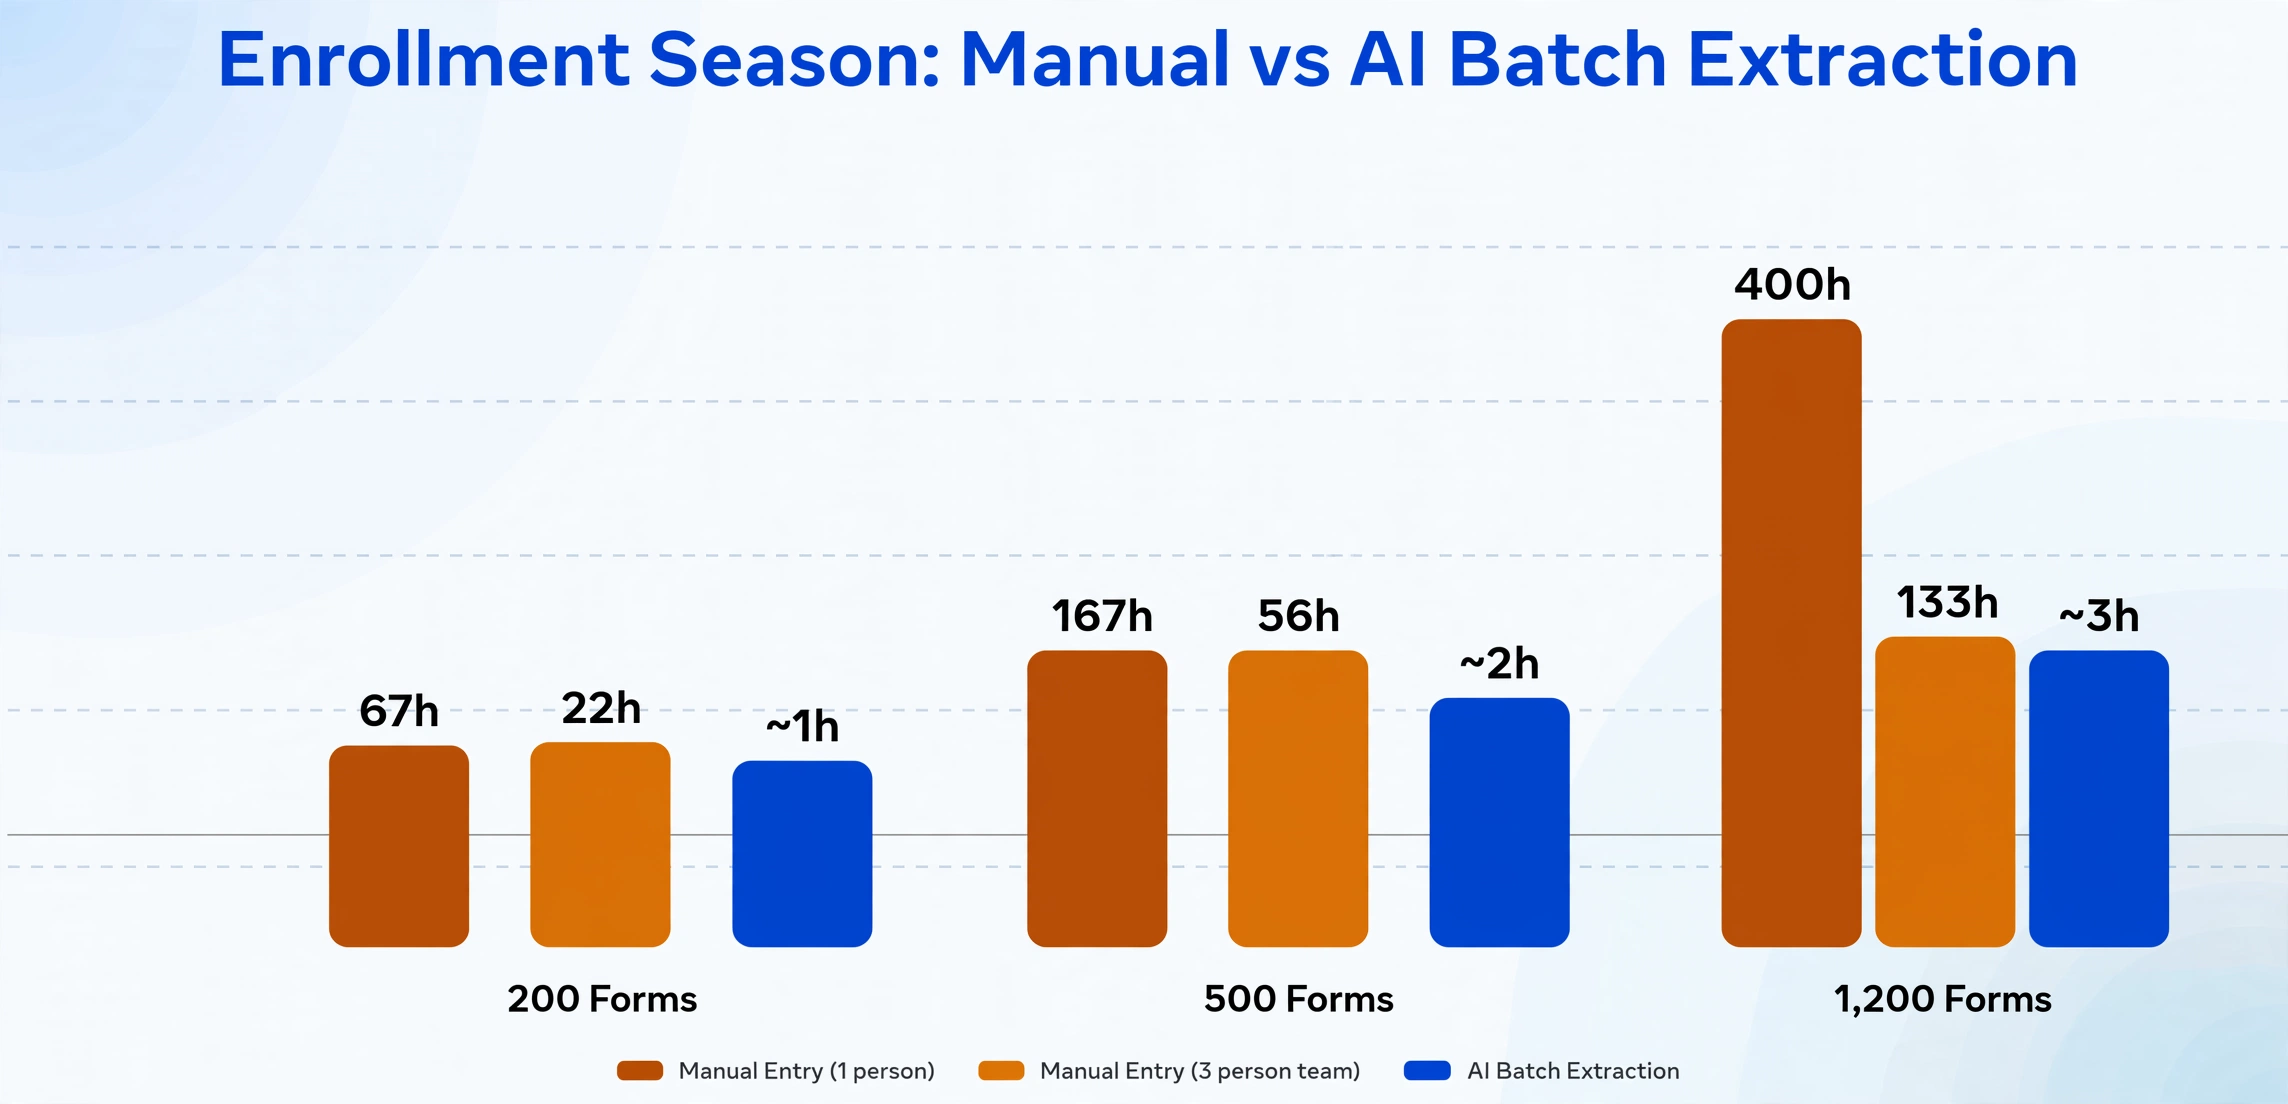
L'avantage opérationnel de l'extraction par IA ne réside pas dans le fait qu'elle traite un formulaire plus rapidement. Il réside dans le fait qu'elle traite 200 formulaires à peu près dans le temps qu'une personne met à saisir un seul dossier. Le tableau ci-dessous montre ce que cela signifie pour trois volumes d'inscription courants, sur la base d'un taux de saisie manuelle mesuré d'environ 20 minutes par dossier et d'un flux de travail IA à opérateur unique.
| Volume d'inscriptions | Saisie manuelle (1 personne) | Saisie manuelle (équipe de 3 personnes) | Extraction IA par lots |
|---|---|---|---|
| 200 formulaires (petite école élémentaire) | ~67 heures (1,7 semaine) | ~22 heures (3 jours) | ~15 à 20 min d'extraction + 30 à 45 min de vérification |
| 500 formulaires (école moyenne K-8) | ~167 heures (4,2 semaines) | ~56 heures (1,4 semaine) | ~25 à 40 min d'extraction + 60 à 90 min de vérification |
| 1 200 formulaires (grand lycée ou lot de district) | ~400 heures (10 semaines) | ~133 heures (3,3 semaines) | ~45 à 75 min d'extraction + 2 à 3 h de vérification |
Le temps de vérification suppose un examen ciblé des champs hautement prioritaires uniquement, à savoir les contacts d'urgence et les données médicales, plus un échantillon aléatoire de 5 % des champs restants. C'est l'information clé du flux de travail : l'objectif n'est pas d'éliminer l'examen humain, mais de réduire la surface de vérification de 100 % des champs (chaque caractère saisi manuellement) à 10 à 15 % des champs (uniquement les données les plus sensibles).
L'architecture par lots de l'outil d'extraction compte également pour la fiabilité du flux de travail. Un système basé sur le cloud, conçu pour un traitement par lots en priorité, gère 200 téléversements simultanés de fichiers sans file d'attente ni délais de traitement par fichier. La contrainte de débit devient la bande passante de téléversement et l'étape de vérification, et non la capacité d'inférence du modèle d'IA. Pour une procédure détaillée du flux de travail de traitement par lots, y compris le flux de téléversement exact et la structure de la sortie Excel pour l'importation dans le SIS, consultez le guide pratique complémentaire Comment extraire les données des formulaires d'inscription des élèves vers Excel pour le SIS d'un district scolaire.
Assurance qualité : ce qu'il faut vérifier et ce qu'il faut approuver
Chaque flux d'extraction nécessite une étape d'assurance qualité. La conception de cette étape détermine si le flux fait gagner du temps ou remplace simplement un type de travail sur les données par un autre. Voici un cadre pratique d'AQ conçu pour le traitement des formulaires d'inscription :
Niveau 1 — Confiance au niveau du lot (70 à 80 % des champs). Les champs imprimés (étiquettes de formulaire, informations pré-remplies sur les élèves provenant de PDF interactifs), les cases à cocher et les statuts de consentement ont une précision suffisamment élevée (95 à 99 %) pour qu'un contrôle par échantillonnage au niveau du lot soit suffisant. Vérifiez 5 % des lignes pour ces types de champs. Si le taux d'erreur de l'échantillon dépasse 2 %, passez à un examen champ par champ.
Niveau 2 — Contrôle ponctuel par formulaire (15 à 20 % des champs). Les noms des parents, les adresses des élèves, les niveaux scolaires et les noms des médecins entrent dans cette catégorie. Ces champs sont manuscrits mais suivent des schémas prévisibles : les noms respectent les conventions d'usage et les adresses incluent des structures rue/ville/État/CP. Contrôlez 100 % de ces champs dans les 10 premiers formulaires d'un lot pour établir un taux d'erreur de référence, puis réduisez le contrôle à 20 % des formulaires si la référence est propre.
Niveau 3 — Vérification de chaque enregistrement (5 à 10 % des champs). Les numéros de téléphone des contacts d'urgence, les descriptions d'allergies/conditions médicales et les dates de vaccination exigent une vérification champ par champ sur chaque enregistrement. La conséquence d'une erreur est trop grave pour accepter un échantillonnage statistique : un mauvais numéro de contact d'urgence en cas de crise scolaire, une notation d'allergie mal lue lors de l'administration de médicaments. Ces champs devraient être les seuls à bénéficier d'un examen humain à 100 %.
Lorsque l'outil d'extraction fournit un score de confiance pour chaque valeur extraite (la plupart des outils d'IA sémantique le font), utilisez-le pour prioriser la vérification : triez le tableur de sortie par score de confiance croissant et examinez uniquement les enregistrements à faible confiance. Cela réduit généralement la charge de vérification de 30 à 50 % supplémentaires par rapport à l'examen direct de tous les champs hautement prioritaires.
Les scores de confiance vous indiquent où regarder ; ils ne montrent pas ce que l'IA a réellement lu. Pour les champs critiques pour la sécurité que vous vérifiez sur chaque enregistrement, une interface de révision qui relie chaque cellule extraite à sa position sur la page comble cette lacune. Cliquez sur un numéro de téléphone ou une note d'allergie et le scan original met en évidence la région d'où provient cette valeur ; cliquez sur une région de l'image et elle revient à la cellule correspondante. Dans ImageToTable.ai, il s'agit du mode de révision avec vérification assistée par bbox, et cela transforme « cette valeur est-elle correcte ? » en quelques secondes de confirmation visuelle au lieu d'une relecture du dossier.
Le résultat pratique : Un cadre d'AQ bien conçu pour les formulaires d'inscription vérifie 100 % des contacts d'urgence et des champs médicaux, contrôle 20 % des données démographiques des parents et fait confiance aux champs de cases à cocher/consentement au niveau du lot. Cette approche à trois niveaux capture les champs où les erreurs ont de réelles conséquences tout en évitant le piège de l'examen de chaque valeur extraite comme si elle avait autant de chances d'être erronée.
Gestion des familles à formulaires multiples
Une famille qui inscrit trois enfants soumet trois dossiers d'inscription distincts, un par enfant. Chaque dossier contient les informations démographiques partagées de la famille (noms des parents, adresse du domicile, contacts d'urgence, assureur) ainsi que des données spécifiques à l'enfant (niveau scolaire, conditions médicales, préférence d'enseignant, itinéraire de bus). Les trois dossiers sont des PDF indépendants, mais les données qu'ils contiennent se recoupent largement.
L'outil d'extraction traite chaque dossier indépendamment, ce qui est le comportement correct : le dossier de chaque enfant dans le SIS doit être autonome. La sortie du lot contiendra trois lignes, une par enfant, avec les données familiales partagées répétées sur chaque ligne. Lors de l'importation dans PowerSchool ou Infinite Campus, chaque ligne crée un dossier d'élève distinct avec ses propres champs de contact parent et de contact d'urgence.
Deux considérations opérationnelles pour les familles à formulaires multiples :
Vérification de cohérence. Après l'extraction, comparez les champs de contact parent entre les lignes des fratries. Si l'extraction produit des numéros de téléphone parent différents pour l'enfant A et l'enfant B (alors que le même parent a rempli les deux formulaires le même jour), l'une des valeurs est probablement une erreur d'extraction. Signalez ces écarts pour examen. Cette validation inter-lignes détecte des erreurs d'extraction qu'un examen ligne par ligne manquerait.
Mise à jour groupée vs. données par enfant. Certains champs du dossier d'inscription, comme l'adresse du domicile, les numéros de téléphone des parents et l'assureur, sont des données au niveau familial qui s'appliquent à tous les frères et sœurs. D'autres champs, comme le niveau scolaire, l'affectation de l'enseignant et les conditions médicales, sont spécifiques à l'enfant et ne doivent jamais être copiés entre les lignes. La conception de vos colonnes d'extraction doit refléter cette distinction. Une colonne intitulée « Adresse du domicile » produit la même valeur pour les trois enfants (l'adresse que le parent a écrite sur chaque formulaire). Une colonne intitulée « Nom de l'enseignant » produit une valeur différente pour chaque enfant. L'outil d'extraction gère cela correctement tant que les colonnes sont définies au bon niveau de granularité.
Conformité FERPA pour l'extraction de formulaires d'inscription
Dès qu'un formulaire d'inscription scanné est téléversé vers un outil d'extraction IA tiers, le district scolaire a effectué une divulgation d'informations personnelles identifiables issues d'un dossier d'éducation en vertu de la FERPA (Family Educational Rights and Privacy Act, 20 U.S.C. § 1232g ; 34 CFR Part 99). Un formulaire d'inscription contenant le nom complet d'un élève, sa date de naissance, son adresse et les coordonnées des parents répond à la définition de dossier d'éducation au sens du § 99.3. Cette divulgation exige soit le consentement parental, soit une exception applicable, et pour l'extraction de documents, l'exception applicable est celle du « school official » prévue au § 99.31(a)(1)(i)(B) (voir les orientations PTAC sur l'informatique en nuage en vertu de la FERPA du ministère américain de l'Éducation).
Trois exigences doivent être satisfaites pour que l'exception du « school official » s'applique. Premièrement, le fournisseur d'extraction doit effectuer un service institutionnel : l'extraction de données à partir de formulaires d'inscription est une fonction que le district effectuerait autrement avec son propre personnel. Deuxièmement, le fournisseur doit opérer sous le contrôle direct du district, établi par un contrat écrit qui restreint la manière dont les données des élèves peuvent être utilisées et conservées. Troisièmement, le fournisseur doit être soumis aux restrictions de rediffusion du § 99.33(a), ce qui signifie qu'il ne peut pas partager les données extraites des élèves avec des sous-traitants ou d'autres parties sans l'autorisation du district.
L'exigence opérationnelle critique que la plupart des districts négligent : le contrat écrit doit spécifiquement interdire au fournisseur d'extraction d'utiliser les documents d'élèves téléversés pour entraîner ses modèles d'IA. Un fournisseur qui utilise les formulaires d'inscription des élèves pour améliorer son moteur d'extraction utilise les données à des fins allant au-delà du service autorisé, et cette utilisation secondaire n'est pas couverte par l'exception du « school official ». C'est la lacune de conformité la plus courante dans les flux de travail d'extraction des districts K-12 (maternelle à terminale) aujourd'hui.
L'analyse réglementaire complète, y compris la manière de déterminer si un document constitue un dossier d'éducation, ce que l'exception du « school official » exige en pratique, ce que le contrat doit inclure, les exigences de conservation et de suppression, et la manière dont les lois d'État sur la confidentialité des données des élèves interagissent avec la FERPA, est traitée en détail dans l'article complémentaire FERPA-Compliant Student Data Extraction: A Guide for Admissions. Ce guide comprend une liste de contrôle de conformité en sept étapes qui fait correspondre chaque exigence à une référence réglementaire spécifique.
Comparer vos options : saisie manuelle, OCR à modèle et IA sémantique
Les districts scolaires qui traitent les formulaires d'inscription disposent de trois approches. Chacune présente une structure de coûts, un temps de configuration, un profil de précision et un comportement de mise à l'échelle différents. Le tableau ci-dessous les compare selon les critères les plus importants pour la saison des inscriptions.
| Critère | Saisie manuelle des données | OCR à modèle (ex. : Docparser, ABBYY) | IA sémantique (ex. : ImageToTable.ai) |
|---|---|---|---|
| Temps de configuration | Aucun — tout membre du personnel peut saisir | 1 à 3 heures par gabarit de formulaire — nécessite de définir des zones d'extraction pour chaque dossier d'école | 15 à 30 minutes — configurer les noms de colonnes une fois pour toutes les écoles |
| Coût par formulaire pour 500 formulaires | ~2,00 $ à 3,00 $ en temps de personnel | ~0,20 $ à 0,50 $ (logiciel + configuration du modèle amortie) | ~0,10 $ à 0,25 $ par page |
| Prise en charge de l'écriture manuscrite | Un humain lit toute écriture manuscrite | Faible — l'OCR au niveau des caractères sur l'écriture cursive tombe généralement sous 60 % de précision | Bonne (85 à 92 %) — la lecture contextuelle améliore les formulaires structurés |
| Détection des cases à cocher | Un humain lit l'état des cases | Limitée — nécessite des règles basées sur les zones pour chaque position de case | Forte (95 à 98 %) — lit la case dans le contexte de son libellé |
| Mise en relation de plusieurs champs | Un humain comprend naturellement les relations | Non prise en charge — chaque zone produit un point de données indépendant | Prise en charge — l'IA associe nom + lien de parenté + téléphone comme un seul enregistrement de contact |
| Gestion de plusieurs gabarits de formulaires | Un humain s'adapte à chaque gabarit | Nécessite un modèle distinct par gabarit — 5 écoles = 5 modèles | Un ensemble de colonnes gère tout gabarit — l'IA lit par le sens, pas par la position |
| Évolutivité (200 à 1 000 formulaires) | Linéaire — 5 fois le volume = 5 fois le temps de personnel | Sub-linéaire, mais la maintenance des modèles augmente avec la variété des gabarits | Sub-linéaire — 5 fois le volume ajoute ~30 minutes au temps de traitement |
| Conformité FERPA (Family Educational Rights and Privacy Act) de base | Aucun transfert externe de données — aucune divulgation FERPA | Nécessite un contrat avec le fournisseur incluant l'exception du responsable scolaire | Nécessite un contrat avec le fournisseur incluant l'exception du responsable scolaire |
Le choix se résume à deux questions. Si votre district traite moins de 100 formulaires d'inscription par an et que les formulaires sont principalement imprimés (non manuscrits), la saisie manuelle peut être l'option la plus simple, car l'investissement en temps pour configurer un système automatisé n'est pas rentabilisé à ce volume. Si vous traitez 200 formulaires ou plus, ou si vos formulaires contiennent de l'écriture manuscrite, des cases à cocher ou plusieurs gabarits de formulaires provenant de différentes écoles, l'IA sémantique offre le meilleur rapport précision/effort. L'OCR à modèle occupe une place médiane de plus en plus étroite : il traite les formulaires imprimés à grande échelle, mais échoue sur l'écriture manuscrite, les cases à cocher et la variété des gabarits — les trois caractéristiques qui définissent les dossiers d'inscription K-12 (maternelle à terminale).
Questions fréquemment posées
Un portail d'inscription en ligne ne rend-il pas l'extraction inutile ?
Les portails en ligne (PowerSchool Enrollment, SchoolMint, LINQ) gèrent les nouvelles inscriptions entièrement réalisées via le portail. Ils n'éliminent pas pour autant les formulaires papier dans la pratique, car une part considérable des familles soumet encore des dossiers papier, et cette part varie selon le district et le niveau scolaire : les familles ayant participé aux événements d'inscription en personne, les familles sans connexion haut débit fiable à domicile, les familles dont la langue principale n'est pas prise en charge par l'ensemble du flux du portail, et les familles de retour dont les comptes portail ont expiré ou n'ont jamais été créés. L'extraction est la solution pour le papier qui arrive, quel que soit l'existence du portail en ligne.
Quelle est la limite pratique de précision pour les champs de formulaires d'inscription manuscrits ?
Sur des formulaires d'inscription structurés avec des libellés et des limites de champs clairs, l'extraction manuscrite atteint généralement une précision de 85 à 92 % pour les noms et adresses, et de 75 à 85 % pour les récits médicaux en texte libre. Ces chiffres supposent une qualité de numérisation raisonnable (300 DPI, bon contraste) et une écriture standard. Les formulaires remplis en lettres capitales approchent une précision de 95 % ; l'écriture cursive avec abréviations descend vers 75 %. Le plafond de précision n'est pas le modèle d'IA mais l'ambiguïté inhérente à l'écriture manuscrite, sur laquelle même les lecteurs humains s'accordent parfois difficilement. Aucun système d'extraction, IA ou autre, ne doit être utilisé pour lire des champs médicaux manuscrits sans vérification humaine.
Que se passe-t-il lorsque notre district redessine le dossier d'inscription l'année prochaine ?
Avec l'extraction IA sémantique, rien ne change. Les noms de colonnes restent les mêmes (Student Name, DOB, Parent Contact, Emergency Phone, Allergies), et l'IA localise les données correspondantes sur la nouvelle mise en page du formulaire en lisant les libellés des champs. Vous n'avez pas besoin de reconfigurer les zones, les modèles ou les règles. C'est l'avantage déterminant de l'extraction sémantique par rapport à l'OCR basé sur des modèles : la mise en page du formulaire est sans importance pour la logique d'extraction, car l'IA lit le contenu, pas les coordonnées.
Les données extraites peuvent-elles aller directement dans notre SIS, ou faut-il un middleware ?
La plupart des plateformes SIS K-12 (PowerSchool, Infinite Campus, Skyward, Ellucian Banner) acceptent l'importation en masse de fichiers CSV ou Excel pour les dossiers démographiques des élèves. Une fois que l'outil d'extraction produit un tableur avec des colonnes correspondant à votre modèle d'importation SIS, vous utilisez la fonction d'importation standard du SIS pour téléverser les données. Aucun middleware n'est requis. Une configuration initiale de correspondance des colonnes dans l'outil d'importation SIS est nécessaire, et les lots suivants suivent la même correspondance.
L'extraction fonctionne-t-elle sur des formulaires d'inscription en espagnol ou dans d'autres langues ?
Oui. L'IA lit le texte manuscrit et imprimé dans la plupart des langues courantes. L'espagnol est la langue non anglaise la plus fréquente sur les formulaires d'inscription K-12 aux États-Unis, et l'extraction le gère sans configuration séparée. Les noms de colonnes doivent être définis dans la langue attendue par votre SIS (généralement l'anglais pour les districts américains) ; l'IA extrait le texte espagnol du formulaire et le place dans la colonne nommée en anglais correspondante. Pour les districts qui fournissent des dossiers d'inscription en plusieurs langues (anglais, espagnol, vietnamien, mandarin, arabe), un seul ensemble de colonnes traite toutes ces langues.
Les exigences HIPAA s'appliquent-elles aux champs médicaux des formulaires d'inscription, ou FERPA les couvre-t-elle ?
FERPA, et non HIPAA, régit les informations de santé des élèves détenues par une école. La règle de confidentialité de HIPAA exclut les « dossiers scolaires couverts par FERPA » de sa définition des informations de santé protégées (45 CFR § 160.103). Cela signifie que les conditions médicales, les descriptions d'allergies et les dossiers de vaccination sur un formulaire d'inscription sont protégés par FERPA plutôt que par HIPAA, tant que l'école les conserve comme dossiers scolaires. L'implication pratique : le cadre de conformité FERPA (exception pour les agents scolaires, contrat écrit, pas de formation de modèle) couvre les champs médicaux ainsi que les champs démographiques. Vous n'avez pas besoin d'une analyse HIPAA séparée pour l'extraction des formulaires d'inscription, bien que certains États aient des lois supplémentaires sur la confidentialité des données de santé des élèves qui peuvent s'appliquer.
Comment gérons-nous les formulaires d'inscription qui arrivent sous forme de scans multipages avec des documents de scolarisation à domicile ou hors district ?
Incluez toutes les pages du scan (attestations de résidence, justificatifs d'adresse, formulaires de notification de scolarisation à domicile, ordonnances de garde) dans le même PDF multipage par élève. L'IA d'extraction ne lit que les pages et les champs qui correspondent aux noms de colonnes que vous avez définis, en ignorant les pages sans données d'inscription. Les pages non correspondantes sont ignorées dans le résultat d'extraction mais restent dans le dossier documentaire. Le fait de signaler des pages spécifiques pour l'extraction (par exemple, « n'extraire que les pages 1 à 4 d'un dossier de 15 pages ») est géré au niveau de la définition des colonnes dans la plupart des outils d'IA sémantique.
L'extraction des formulaires d'inscription des élèves n'est pas une simple décision technologique. C'est une transformation du flux de travail qui touche à la numérisation, à la conception des colonnes, au traitement par lots, à la vérification, à l'importation dans le SIS et à la documentation de conformité.
Le flux de travail en quatre phases — numériser, définir les colonnes, traiter le lot, puis vérifier et importer — transforme la pile de dossiers papier du mois d'août en un tableur structuré prêt pour PowerSchool ou Infinite Campus. Le cadre d'assurance qualité vous indique quels champs vérifier sur chaque enregistrement (contacts d'urgence, données médicales) et quels champs approuver au niveau du lot (cases à cocher, formulaires de consentement). La conformité FERPA est un prérequis, pas une réflexion après coup : un accord institutionnel signé avec votre fournisseur d'extraction, une interdiction écrite de formation de modèles et un calendrier de conservation documenté.
Testez le flux de travail sur dix formulaires d'inscription de l'inscription de cette année. Si le profil de précision correspond à ce qui est décrit ici, vous avez votre modèle pour toutes les saisons d'inscription à venir.
Gratuit à essayer, sans inscription. Les fichiers sont traités de manière transitoire et ne sont pas conservés. Renseignez-vous sur les accords institutionnels conformes à la FERPA pour votre district.