Von Papierpaketen zu SIS-bereiten Zeilen:
Der vollständige Leitfaden zur Extraktion von K-12-Anmeldeformularen
Jeden August kehren rund 49 Millionen US-amerikanische Schüler öffentlicher Schulen in den Unterricht zurück (National Center for Education Statistics, 2024–25). Für Familien, die ihre Anmeldung oder aktualisierten Unterlagen noch auf Papier einreichen, müssen jeder handschriftliche Name, jede Auswahl in Kontrollkästchen und jede medizinische Notiz in ein Schülerverwaltungssystem (SIS) eingegeben werden, bevor der Unterricht beginnt. Ein typisches K-12-Anmeldepaket umfasst 15 bis 25 Seiten mit einem Dutzend Abschnitten: Schülermerkmale, Kontakte von Eltern und Erziehungsberechtigten, Notfallkontakte mit Beziehungen zu mehreren Feldern, medizinische Bedingungen, Impfaufzeichnungen, Transportpräferenzen und mehrere Einwilligungsformulare. Jeder Abschnitt verwendet ein anderes Datenformat: gedruckte Blockschrift, Schreibschrift, Kontrollkästchen, eingekreiste Optionen, Freitext. Jedes Format scheitert anders bei der Verarbeitung durch herkömmliche OCR (Optical Character Recognition).
Wichtigste Erkenntnisse
- Die meisten Schulbezirke gehen davon aus, dass ein Online-Anmeldeportal den Dateneingabeaufwand eliminiert. In der Praxis geben viele Familien jeden August weiterhin Papierpakete ab, und diese Stapel von 15 bis 25 Seiten langen Formularen landen im Sekretariat.
- Vorlagen-OCR sollte dieses Problem lösen, scheitert jedoch an den drei Merkmalen, die Anmeldeformulare auszeichnen: gemischte Handschrift und Druckschrift auf derselben Seite, Kontrollkästchenraster neben Freitextfeldern und Beziehungen mit mehreren Feldern wie Notfallkontakte, die als ein Datensatz gruppiert bleiben müssen.
- Semantische KI bewältigt alle drei: Definieren Sie Ihren 28-Felder-Spaltensatz einmal, laden Sie die Pakete jeder Schule in einem einzigen Batch unabhängig vom Layout hoch und konzentrieren Sie die Überprüfung auf die Felder, in denen Fehler echte Konsequenzen haben: Notfallkontakte und medizinische Daten.
Was ist die Extraktion aus Schüleranmeldeformularen?
Die Datenextraktion aus Schüleranmeldeformularen ist der automatisierte Prozess, bei dem Daten aus ausgefüllten K-12 (Kindergarten bis 12. Klasse) Schulregistrierungspaketen gelesen werden (handschriftliche oder gedruckte Namen, Geburtsdaten, Kontaktdaten der Eltern, medizinische Informationen und Auswahlfelder) und in strukturierte Tabellenkalkulationszeilen umgewandelt werden, die in ein Schülerverwaltungssystem (SIS) importiert werden können. Es ist eine spezialisierte Anwendung der KI-Datenextraktion, die die gemischten Formate von Anmeldeformularen bewältigt: Vorgedruckte Beschriftungen koexistieren mit handschriftlichen Antworten, Kontrollkästchen stehen neben Unterschriftenzeilen, und freie medizinische Texte teilen sich dieselbe Seite wie strukturierte Adressblöcke.
Im Gegensatz zur herkömmlichen OCR (Optical Character Recognition), die Zeichen einzeln liest, ohne deren Bedeutung zu verstehen, identifiziert die semantische KI-Extraktion Felder anhand ihrer Bedeutung und ihres Kontexts. Dieser Ansatz wird von modernen Tools wie ImageToTable.ai verwendet. Wenn die KI auf einen Abschnitt mit der Bezeichnung „Notfallkontakt – Name“ stößt, erkennt sie, dass aus diesem Bereich ein Personenname extrahiert werden muss, selbst wenn die Handschrift jeden Buchstaben in Schreibschrift verbindet. Dieses semantische Verständnis macht die Extraktion aus Anmeldeformularen in der Praxis funktionsfähig, denn keine zwei Schulbezirke drucken ihre Registrierungspakete auf dieselbe Weise, und Eltern füllen sie nicht zweimal auf dieselbe Weise aus.
Dieser Leitfaden deckt das Gesamtbild ab: die besonderen Herausforderungen, die Anmeldeformulare darstellen (sie sind keine Rechnungen oder Kontoauszüge), den End-to-End-Workflow vom Papierpaket bis zum SIS-Import, feldweise Extraktionsstrategien, Batch-Verarbeitung für die Einschreibungsspitze von August bis September, die Verarbeitung von Familien mit mehreren Formularen, bei denen jedes Kind ein eigenes Paket hat, FERPA (Family Educational Rights and Privacy Act)-Konformität sowie einen Vergleich der drei Ansätze, die Schulbezirken heute zur Verfügung stehen: manuelle Dateneingabe, vorlagenbasierte OCR und semantische KI-Extraktion.
Warum Anmeldeformulare ein anderes Extraktionsproblem darstellen
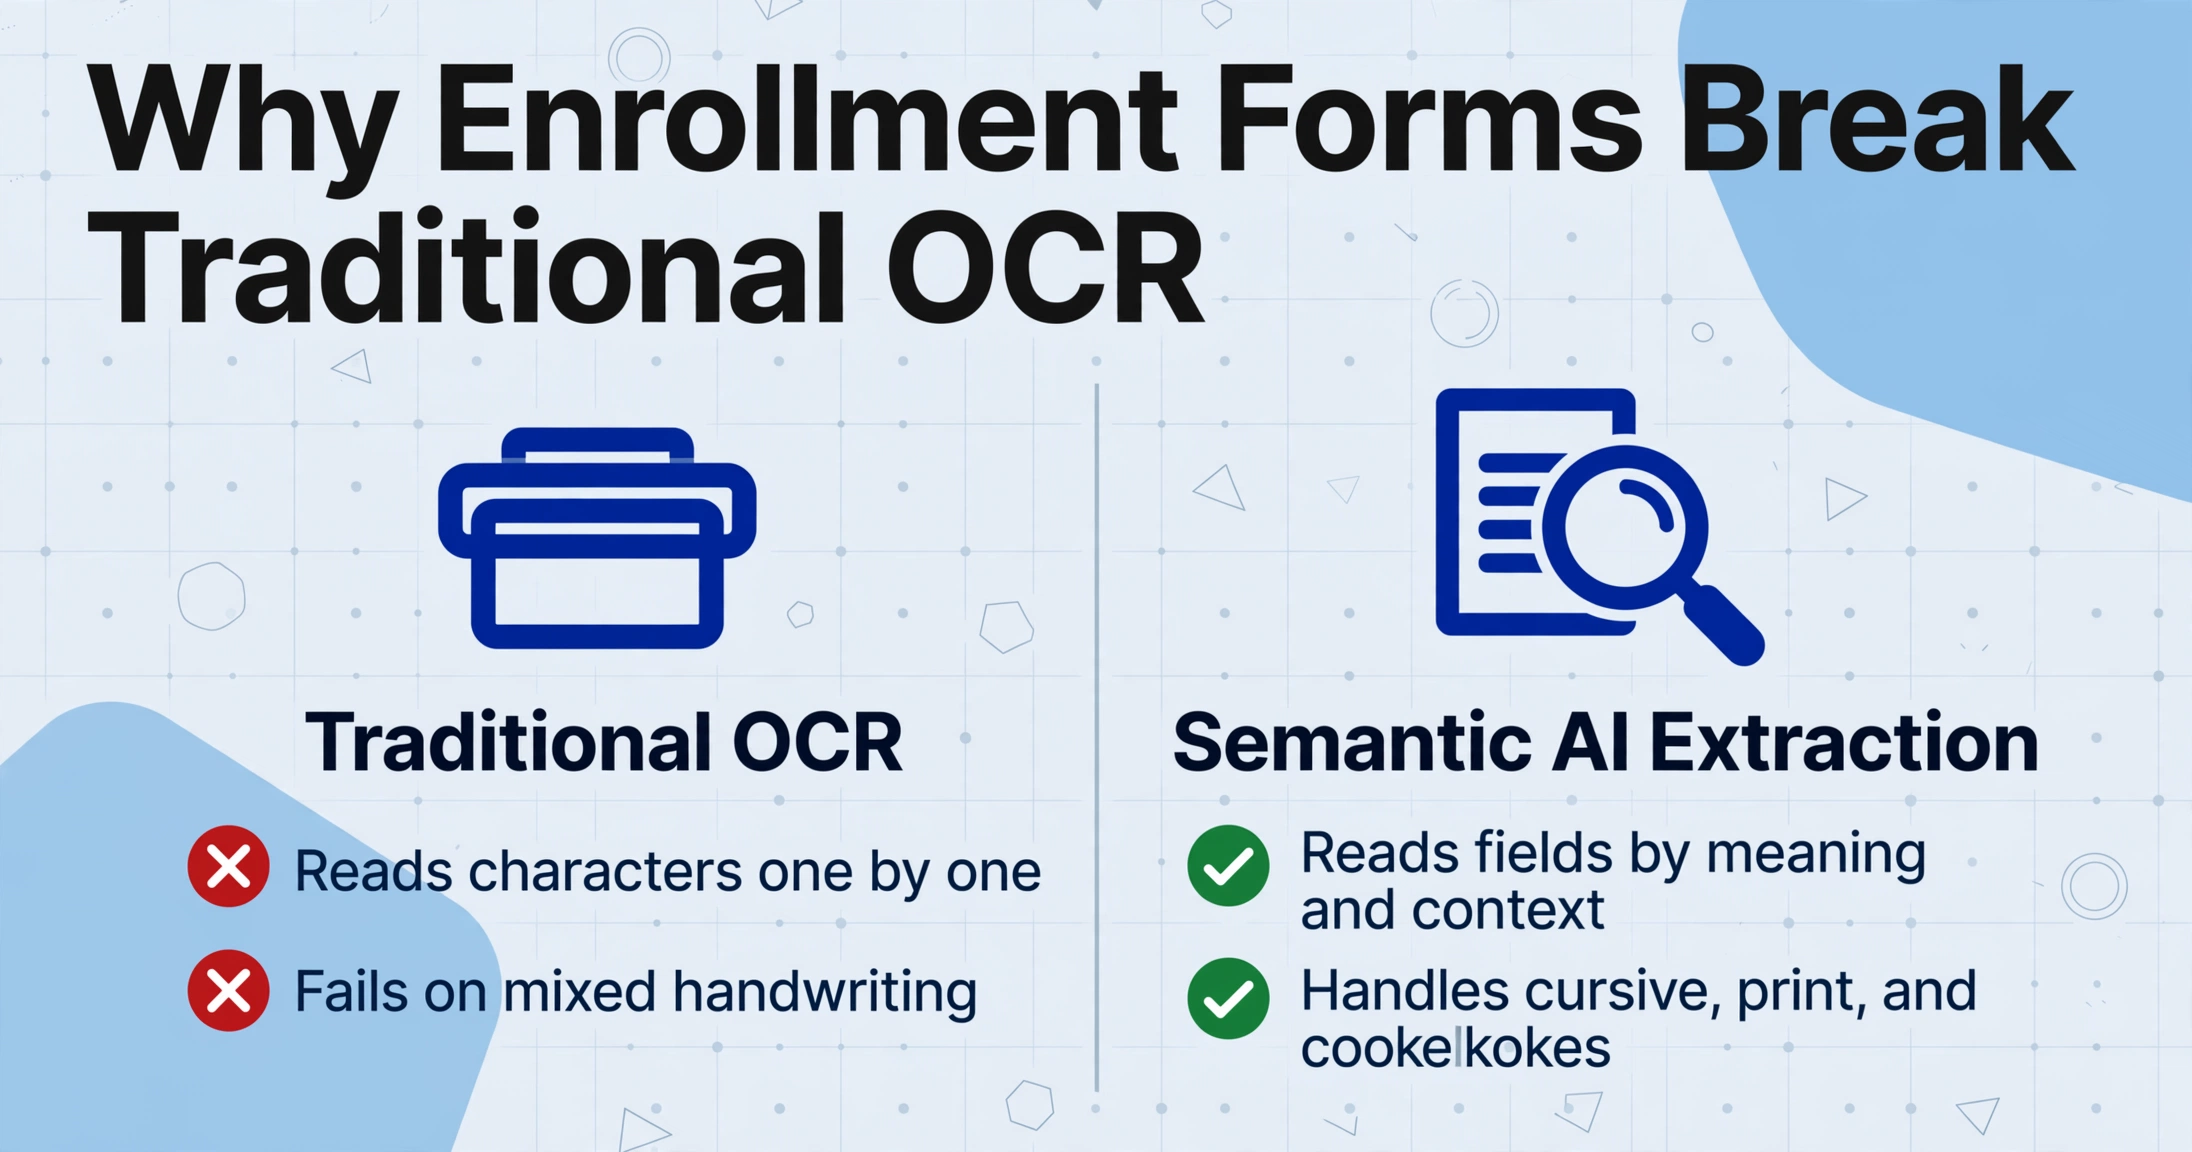
Ein Schul-Anmeldepaket ist kein einzelner Dokumenttyp. Es ist ein Dutzend verschiedener Dokumentstrukturen, die zusammengebunden sind, und jede verhält sich bei der Verarbeitung durch ein Extraktionstool anders. Diese strukturellen Gegebenheiten zu verstehen, ist die Voraussetzung für die Erstellung eines Workflows, der im großen Maßstab funktioniert.
Handschrift und gedruckter Text auf derselben Seite
Ein Anmeldeformular enthält typischerweise vorgedruckte Beschriftungen in einer Standardschriftart („Gesetzlicher Nachname des Schülers __________“) und handschriftliche Antworten in den Leerfeldern. Eine einzelne Seite kann gedruckte Blockschrift eines Elternteils enthalten, der das Formular sorgfältig ausgefüllt hat, Schreibschrift eines anderen Elternteils, der schnell geschrieben hat, und ein Häkchen, das weder Druck- noch Schreibschrift ist, sondern ein Gekritzel. Herkömmliche OCR ist für einheitlichen gedruckten Text auf sauberem Hintergrund ausgelegt und hat nur einen Erkennungsmodus: die zeichenweise Dekodierung. Deshalb scheitert sie an dieser gemischten Eingabe. Semantische KI verarbeitet jedes Feld unabhängig und nutzt den Kontext der gedruckten Beschriftungen, um die Extraktion der handschriftlichen Inhalte zu verankern. Derselbe Mechanismus liegt der Extraktion handschriftlicher Formulare im Allgemeinen zugrunde, und Anmeldepakete gehören zu den schwierigeren Fällen.
Kontrollkästchen und Freitextfelder nebeneinander
Anmeldeformulare sind voll von binären Entscheidungen wie „Hat Ihr Kind Allergien? ☐ Ja ☐ Nein“, gefolgt von Freitextfeldern, die nach Details fragen. Ein Elternteil könnte bei der Allergiefrage „Ja“ ankreuzen und „Penicillin – verursacht Hautausschlag“ in das Textfeld darunter schreiben. Das Extraktionstool muss das binäre Signal (welches Kästchen markiert ist) und den erzählenden Text (was der Elternteil tatsächlich geschrieben hat) als zwei getrennte, aber zusammenhängende Datenpunkte lesen. Diese Paarung ist für ein semantisches KI-Modell, das das Dokument als Ganzes liest, trivial. Für eine Vorlagen-OCR ist sie überraschend schwierig, da diese in der Regel separate Regeln für Kontrollkästchen- und Textzonen benötigt und keine Möglichkeit hat, die beiden zu verknüpfen.
Strukturen mit Mehrfeld-Beziehungen
Der Notfallkontakt-Bereich eines Anmeldeformulars veranschaulicht die relationale Komplexität, die Schülerformulare schwieriger macht als die meisten Geschäftsdokumente. Ein einzelnes Formular könnte nach „Notfallkontakt 1 – Name, Beziehung, Telefon" und „Notfallkontakt 2 – Name, Beziehung, Telefon" fragen. Drei Felder pro Kontakt sind mit derselben Personenreferenz verknüpft. Das Extraktionstool muss wissen, dass „John Smith", „Vater" und „555-123-4567" zum selben Notfallkontakt-Datensatz gehören, während „Mary Jones", „Tante" und „555-987-6543" zu einem anderen Kontakt gehören. In einer Tabellenkalkulationsausgabe bedeutet dies eine Zeile pro Schüler mit sechs Notfallkontakt-Spalten (Name 1, Beziehung 1, Telefon 1, Name 2, Beziehung 2, Telefon 2), und die KI muss jedes Datenelement der richtigen Spalte zuordnen, indem sie erkennt, welches gedruckte Etikett daneben auf der Seite steht.
Die Einschreibungsspitze von August bis September
Der zeitliche Faktor ist der Aspekt, der betrieblich am meisten zählt. In den meisten US-Schulbezirken trifft der Großteil der neuen Einschreibungen in einem Zeitfenster von vier bis sechs Wochen zwischen Mitte Juli und Anfang September ein, und Aktualisierungen bestehender Schüler folgen demselben Zeitplan: Änderungen bei Notfallkontakten, neue medizinische Informationen, Einwilligungsverlängerungen. Für einen Bezirk mit 5.000 Schülern, der etwa 1.000 neue und wiederkehrende Einschreibungsunterlagen verarbeitet, sind das 15.000 bis 25.000 Formularseiten in sechs Wochen. Ein Datenerfassungsteam aus zwei oder drei Mitarbeitern im Front Office kann diese Menge nicht ohne Überstunden, Rückstände oder Fehler abtippen. Was darüber entscheidet, ob die Einschreibungsdaten vor Schulbeginn bereit sind, ist die Verarbeitungskapazität des Extraktionstools, nicht seine Genauigkeit pro Seite.
Der Begleitartikel Kann KI Schüleranmeldeformulare extrahieren? behandelt die feldgenauen Genauigkeitsschätzungen im Detail, einschließlich der Bereiche, in denen KI gut abschneidet (gedruckter Text, Kontrollkästchen, Batch-Durchsatz) und wo sie noch menschliche Überprüfung benötigt (handgeschriebene Telefonnummern, Freitext-Notizen zu medizinischen Angaben).
Der vollständige Workflow: Vom Papierpaket zum SIS-Datensatz
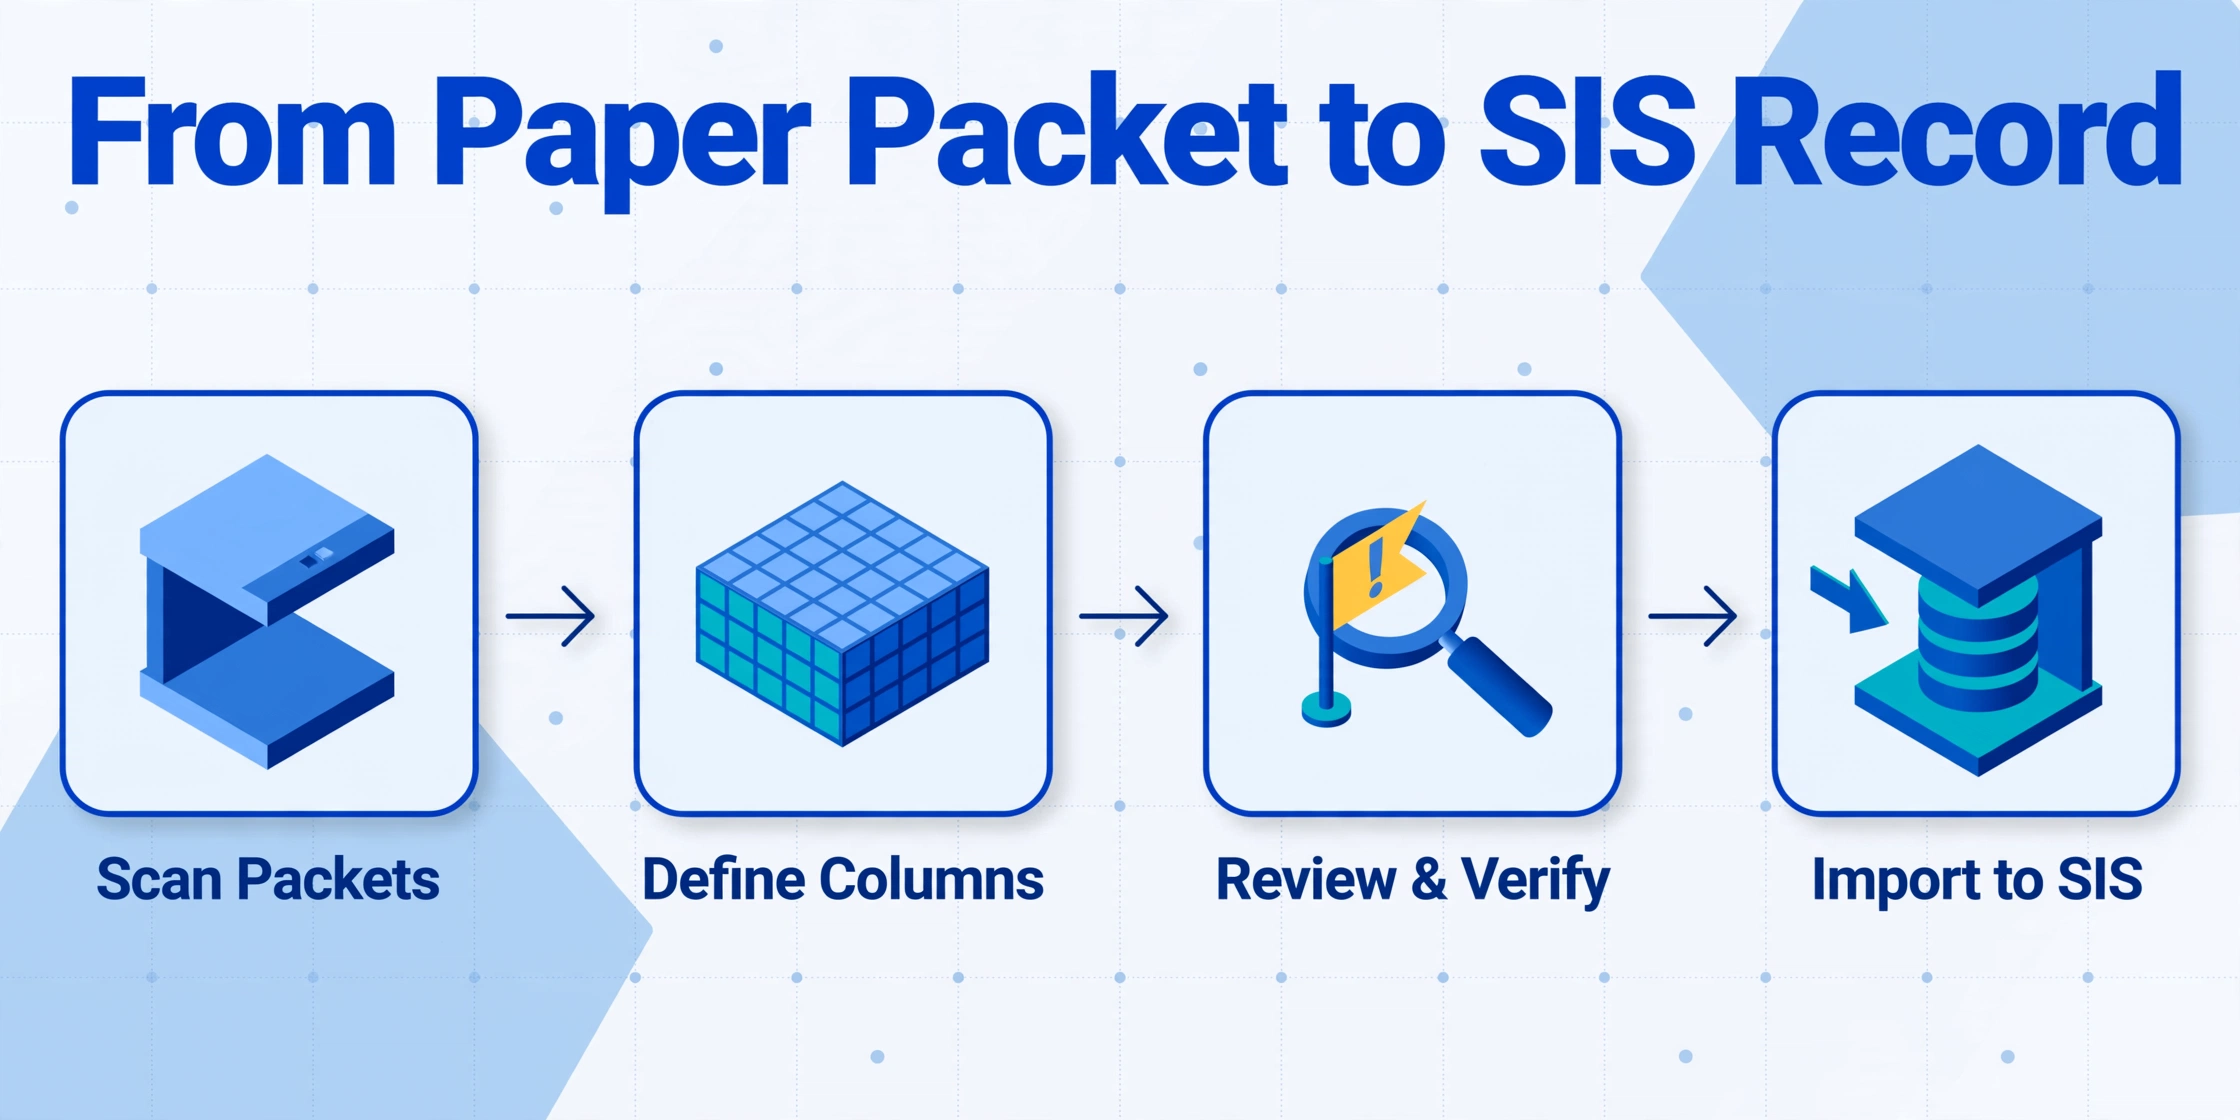
Der Extraktionsworkflow umfasst vier Phasen. Jede Phase entspricht einem spezifischen operativen Schritt, den ein Mitarbeiter im Front Office oder ein Einschreibungskoordinator ohne IT-Unterstützung ausführen kann.
Einscannen und Vorbereiten der Einschreibungsunterlagen
Scannen Sie die vollständigen Unterlagen jedes Schülers als einzelne mehrseitige PDF-Datei. Stellen Sie den Scanner auf 300 DPI Graustufen ein. Farbe erhöht die Dateigröße, ohne die Genauigkeit bei den meisten Einschreibungsformular-Layouts zu verbessern, während Schwarz-Weiß den feinen Kontrast verliert, der ein mit Bleistift angekreuztes Kontrollkästchen vom Papierhintergrund unterscheidet. Benennen Sie jede Datei nach einer einheitlichen Konvention: [Klasse]_[Nachname]_[Vorname].pdf. Dieses Benennungsmuster ermöglicht es Ihnen, extrahierte Daten während der Überprüfung mit dem Quelldokument abzugleichen, ohne jede PDF-Datei einzeln öffnen zu müssen.
Wenn Formulare nach Typ vorsortiert eintreffen (alle medizinischen Formulare zusammen, alle Transportformulare zusammen), benötigen Sie einen anderen Sortier-Workflow. In der Praxis kommen die meisten K-12 (Kindergarten bis 12. Klasse)-Einschreibungsunterlagen nach Schüler organisiert an: Jede Familie reicht einen Ordner oder Stapel pro Kind ein, und jeder Stapel enthält den vollständigen Satz an Formularen, der für diesen Schüler benötigt wird.
Ausgabespalten definieren
Dies ist der Schritt, der die Extraktion programmiert. In einem semantischen KI-Tool definieren Sie Ihre Ausgabe, indem Sie die gewünschten Spaltennamen auflisten. Diese Namen dienen sowohl als Anweisungen, die die KI verwendet, um Daten auf den Formularen zu lokalisieren, als auch als Spaltenüberschriften in der endgültigen Tabellenkalkulation. Der Spaltensatz sollte Ihrer SIS-Importvorlage entsprechen. Ein vollständiger Satz für ein typisches K-12 (Kindergarten bis 12. Klasse)-Einschreibungspaket umfasst etwa 28 Felder, die demografische Schülerdaten, Eltern-/Erziehungsberechtigten-Informationen, Notfallkontakte, medizinische Daten, Transport und Einwilligungsstatus abdecken.
Die spezifische Spaltenliste und die Design-Grundlagen, einschließlich der Frage, warum Vor- und Nachnamen getrennt werden sollten, wie abgeleitete Spalten für binäre Felder verwendet werden und wo SIS-Feldnamen als Hinweise eingefügt werden sollten, sind im Begleitleitfaden So extrahieren Sie Schüler-Einschreibungsformulardaten in Excel für den SIS-Import detailliert beschrieben. Dieser Artikel erläutert die Spalteneinrichtung anhand realer Feldbeispiele.
Batch verarbeiten
Laden Sie alle gescannten PDFs in einem einzigen Batch hoch. Das KI-Tool extrahiert jedes Feld aus jedem Formular parallel, nicht ein Formular nach dem anderen, und führt die Ergebnisse in einer Tabellenkalkulation zusammen, in der jede Zeile einen Schülerdatensatz darstellt. Die Verarbeitungszeit skaliert mit der Anzahl der Dateien, nicht jedoch mit der Seitenzahl pro Datei; ein 20-seitiges Paket und ein 2-seitiges Formular benötigen ungefähr die gleiche Zeit pro Dokument, da die KI das gesamte Dokument als eine einzige semantische Einheit liest.
Für 200 Einschreibungspakete mit jeweils 28 Feldern, also 5.600 einzelnen Datenpunkten, ist die Extraktion in etwa 15 bis 20 Minuten Wanduhrzeit abgeschlossen, verglichen mit etwa 67 Stunden manueller Dateneingabe. Die Ausgabe ist eine Excel-Datei, die für den SIS-Import bereit ist.
Prüfen und in das SIS importieren
Vergleichen Sie die Ausgabe stichprobenartig mit den Quelldokumenten. Konzentrieren Sie die Prüfung auf die Felder, bei denen Fehler die höchsten operativen Kosten verursachen: Notfallkontakt-Telefonnummern, Übertragungen von medizinischen Angaben und Allergievermerke. Bei den meisten Einschreibungs-Batches machen diese risikoreichen Felder 5–10 % der gesamten extrahierten Datenpunkte aus. Die restlichen 90–95 % (gedruckte Felder, Checkbox-Auswahlen, Einwilligungsstatus) können nach Prüfung einer Stichprobe auf Batch-Ebene akzeptiert werden.
Exportieren Sie die geprüfte Tabellenkalkulation als .xlsx oder CSV und importieren Sie sie mit dem Standard-Importtool in Ihr SIS. PowerSchool, Infinite Campus und Skyward unterstützen alle den CSV-Massenimport für Schülerdemografiedaten. Nach einer einmaligen Spaltenzuordnung im SIS-Importtool folgen nachfolgende Einschreibungs-Batches derselben Vorlage.
Feldweise Extraktionsstrategie
Nicht alle Felder eines Einschreibungsformulars sollten auf dieselbe Weise extrahiert werden. Die folgende Tabelle gruppiert die gängigsten Einschreibungsformularfelder nach Extraktionsansatz: direkte Extraktion, abgeleitete Klassifizierung oder berechnete Ableitung. Sie vermerkt auch die erwartete Genauigkeitsstufe für jedes Feld. Die Genauigkeitsspannen und Verifizierungsraten in diesem Leitfaden stammen aus unseren eigenen Tests mit gescannten K-12-Paketen, nicht aus einem Drittanbieter-Benchmark, daher können Scanqualität und Handschrift sie beeinflussen.
| Feldgruppe | Beispielfelder | Extraktionsansatz | Verifizierungspriorität |
|---|---|---|---|
| Schülerdemografische Daten | Vollständiger Name, Geburtsdatum, Geschlecht, Klassenstufe, Adresse | Direkte Extraktion — KI liest den handschriftlichen oder gedruckten Wert neben dem entsprechenden Label | Mittel — Geburtsdatumsformat-Mehrdeutigkeit und Adresszeilenumbrüche sind die häufigen Fehlerquellen |
| Informationen zu Eltern/Erziehungsberechtigten | Name, Beziehung, Telefon, E-Mail, Arbeitgeber | Direkte Extraktion mit Mehrfeld-Gruppierung — KI ordnet "Vater" der Telefonnummer und E-Mail zu, die im selben Abschnitt geschrieben wurden | Mittel-Hoch — Telefonnummern sind das fragile Feld; verifizieren Sie, wenn Kontaktinformationen keine Redundanz aufweisen |
| Notfallkontakte | Name, Beziehung, Telefon (2–3 Kontakte) | Direkte Extraktion mit relationalem Mapping — KI weist jedem Kontakt-Trio (Name + Beziehung + Telefon) den korrekten nummerierten Platz zu | Hoch — Feldgruppe mit höchster Priorität; ein falsch indexierter Notfallkontakt (Kontakt 2 als Kontakt 1 kennzeichnen) gefährdet die Erreichbarkeit im Notfall |
| Medizinische Erkrankungen | Allergien, Medikamente, chronische Erkrankungen, Arztname, Versicherungsträger | Direkte Extraktion von freiem handschriftlichem Text | Höchste — sicherheitskritische Daten; jedes medizinische Feld sollte vor dem SIS-Import von einem Menschen verifiziert werden |
| Impfaufzeichnungen | Impfstoffname, Verabreichungsdatum, Anbieter | Tabellenextraktion — KI liest die Impfstofftabelle als strukturiertes Raster (Zeilen = Impfstoffe, Spalten = Dosen/Daten) | Mittel — staatliche Impfformulare haben ein konsistentes Tabellenlayout; verifizieren Sie Daten für die regulatorische Einhaltung |
| Transport | Bus / Autofahrer / Fußgänger, Busroutennummer, AM/PM-Zeitplan | Abgeleitete Klassifizierung — KI liest die Kontrollkästchen-Auswahl und gibt den Labeltext aus ("Bus" nicht das „☐"-Zeichen) | Niedrig — binäre Auswahl mit klarem visuellem Signal; Stichprobenprüfung auf Batch-Ebene |
| Einwilligungs-Kontrollkästchen | Foto-Freigabe, Technologievereinbarung, Handbuch-Bestätigung, Essensprogramm | Abgeleitete Klassifizierung — KI gibt basierend auf dem Kontrollkästchen-Status "Ja" oder "Nein" aus, mit optionaler dritter Spalte für "Unterschrift der Eltern vorhanden" | Niedrig — binäres Signal mit 95–98 % Genauigkeit; Verifizierung auf Batch-Ebene ausreichend |
| Umfrage zur Muttersprache | Primärsprache, weitere Sprachen, bevorzugte Sprache der Eltern | Direkte Extraktion von kurzem handschriftlichem Text oder Kontrollkästchen-Auswahl | Niedrig-Mittel — Sprachnamen sind kurze Felder mit begrenztem Vokabular; verifizieren Sie ungewöhnliche Sprachnamen |
Das Muster ist klar: Felder mit binärem oder geschlossenem Vokabular (Kontrollkästchen, Einwilligungsformulare, Sprachauswahl) können mit minimaler Verifizierung akzeptiert werden. Felder mit freiem handschriftlichem Text ohne semantische Redundanz, insbesondere Telefonnummern und medizinische Beschreibungen, benötigen eine menschliche Überprüfung. Budgetieren Sie Ihren Verifizierungsaufwand entsprechend, nicht gleichmäßig über alle Felder.
Batch-Verarbeitung im Maßstab der Einschreibesaison
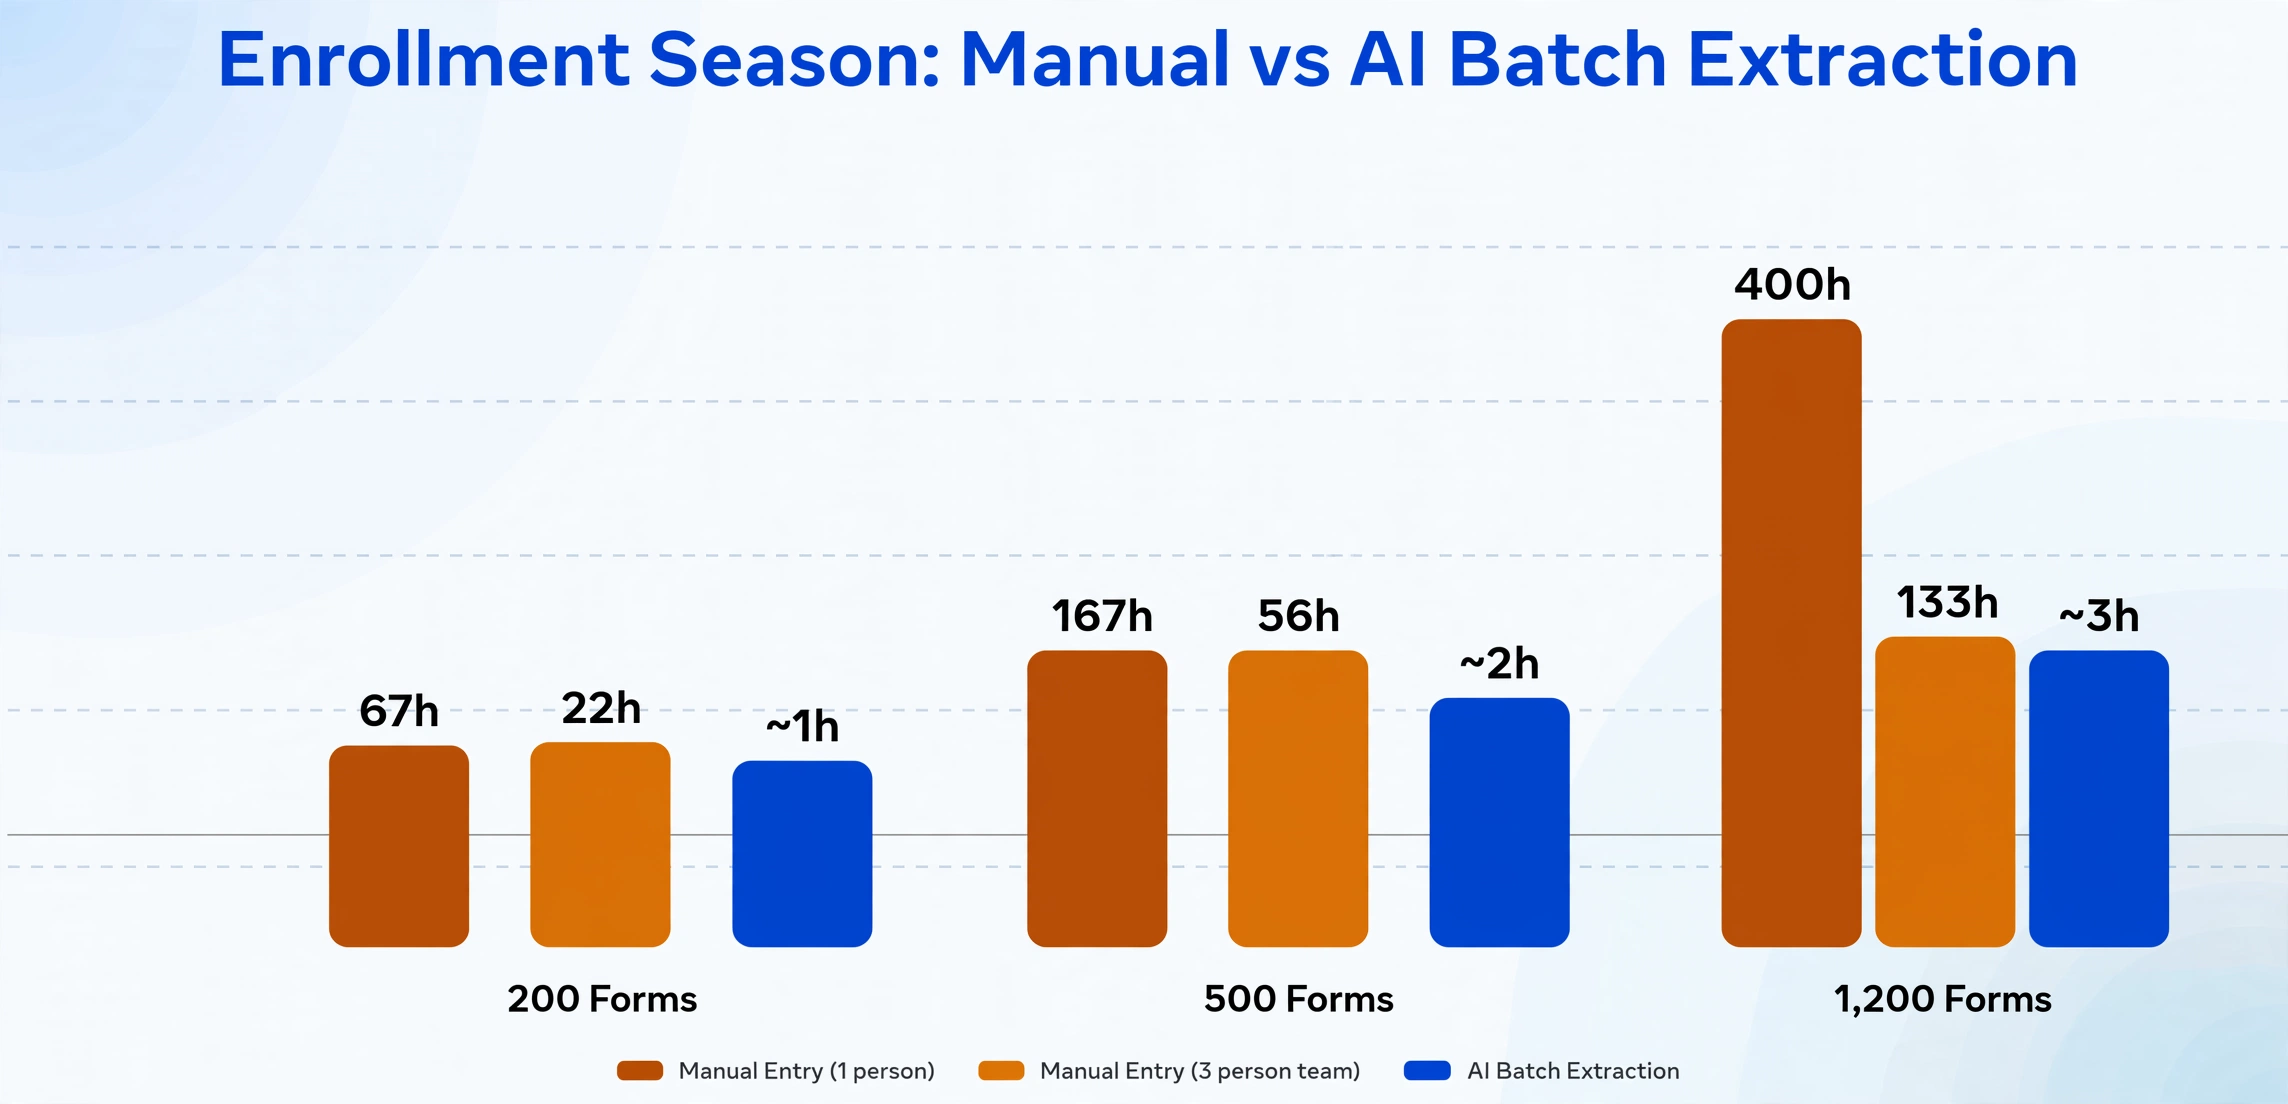
Der operative Vorteil der KI-Extraktion liegt nicht darin, dass sie ein einzelnes Formular schneller verarbeitet. Sondern darin, dass sie 200 Formulare in ungefähr der Zeit verarbeitet, die eine Person für die manuelle Eingabe eines einzigen Pakets benötigt. Die folgende Tabelle zeigt, was dies bei drei gängigen Einschreibevolumina bedeutet, basierend auf einer gemessenen manuellen Eingaberate von etwa 20 Minuten pro Paket und einem KI-Workflow mit einer einzelnen Bedienperson.
| Einschreibevolumen | Manuelle Eingabe (1 Person) | Manuelle Eingabe (3-Personen-Team) | KI-Batch-Extraktion |
|---|---|---|---|
| 200 Formulare (kleine Grundschule) | ~67 Stunden (1,7 Wochen) | ~22 Stunden (3 Tage) | ~15–20 Min. Extraktion + 30–45 Min. Verifizierung |
| 500 Formulare (mittelgroße K-8-Schule) | ~167 Stunden (4,2 Wochen) | ~56 Stunden (1,4 Wochen) | ~25–40 Min. Extraktion + 60–90 Min. Verifizierung |
| 1.200 Formulare (große High School oder Bezirks-Batch) | ~400 Stunden (10 Wochen) | ~133 Stunden (3,3 Wochen) | ~45–75 Min. Extraktion + 2–3 Std. Verifizierung |
Die Verifizierungszeit geht von einer gezielten Überprüfung nur der priorisierten Felder aus, nämlich Notfallkontakte und medizinische Daten, sowie einer Zufallsstichprobe von 5 % der übrigen Felder. Dies ist die entscheidende Workflow-Erkenntnis: Das Ziel ist nicht, die menschliche Überprüfung abzuschaffen, sondern die Verifizierungsfläche von 100 % der Felder (jedes Zeichen manuell eingegeben) auf 10–15 % der Felder (nur die kritischsten Daten) zu reduzieren.
Die Batch-Architektur des Extraktionstools ist auch für die Workflow-Zuverlässigkeit entscheidend. Ein cloudbasiertes System, das für die Batch-First-Verarbeitung konzipiert ist, verarbeitet 200 gleichzeitige Dateiuploads ohne Warteschlangen oder Verzögerungen bei der Einzeldateiverarbeitung. Der Engpass wird zur Upload-Bandbreite und zum Verifizierungsschritt, nicht zur Inferenzkapazität des KI-Modells. Für eine detaillierte Anleitung zum Batch-Verarbeitungsworkflow, einschließlich des genauen Upload-Ablaufs und der Struktur der Excel-Ausgabe für den SIS-Import, siehe den begleitenden How-to-Leitfaden So extrahieren Sie Daten aus Schüleranmeldeformularen nach Excel für das Schulbezirks-Schülerverwaltungssystem (SIS).
Qualitätssicherung: Was Sie prüfen und was Sie vertrauen sollten
Jeder Extraktions-Workflow benötigt einen Qualitätssicherungsschritt. Die Gestaltung dieses Schritts entscheidet darüber, ob der Workflow Zeit spart oder lediglich eine Art von Datenarbeit durch eine andere ersetzt. Hier ist ein praktischer QA-Rahmen für die Verarbeitung von Anmeldeformularen:
Stufe 1 — Vertrauen auf Batchebene (70–80 % der Felder). Gedruckte Felder (Formularbeschriftungen, vorausgefüllte Schülerinformationen aus ausfüllbaren PDFs), Kontrollkästchen-Auswahlen und Einwilligungsstatus weisen eine ausreichend hohe Genauigkeit (95–99 %) auf, sodass eine Stichprobenprüfung auf Batchebene ausreichend ist. Verifizieren Sie 5 % der Zeilen für diese Feldtypen. Wenn die Fehlerquote in der Stichprobe 2 % übersteigt, eskalieren Sie zur Einzelfeldprüfung.
Stufe 2 — Stichprobenprüfung pro Formular (15–20 % der Felder). Elterliche Namen, Schüleradressen, Klassenstufen und Name der Ärzte fallen in diese Kategorie. Diese Felder sind handschriftlich ausgefüllt, folgen jedoch vorhersehbaren Mustern: Namen folgen Namenskonventionen, und Adressen enthalten Straße/Stadt/Bundesstaat/PLZ-Strukturen. Prüfen Sie 100 % dieser Felder in den ersten 10 Formularen eines Batches, um eine Basis-Fehlerquote zu ermitteln, und reduzieren Sie dann auf eine Stichprobenprüfung von 20 % der Formulare, wenn die Basis sauber ist.
Stufe 3 — Jeden Datensatz verifizieren (5–10 % der Felder). Notfallkontakt-Telefonnummern, Beschreibungen von Allergien/medizinischen Zuständen und Impfdaten erfordern eine Einzelfeldverifizierung bei jedem Datensatz. Die Folge eines Fehlers ist zu schwerwiegend, um statistische Stichproben zu akzeptieren: eine falsche Notfallkontaktnummer während einer Schulkrise, eine fehlgelesene Allergieangabe während der Medikamentenvergabe. Diese Felder sollten die einzigen sein, die zu 100 % von Menschen überprüft werden.
Wenn das Extraktionstool für jeden extrahierten Wert einen Konfidenzwert bereitstellt (die meisten semantischen KI-Tools tun dies), nutzen Sie diesen, um die Verifizierung zu priorisieren: Sortieren Sie die Ausgabe-Tabellenkalkulation nach Konfidenzwert aufsteigend und überprüfen Sie nur die Datensätze mit niedrigem Konfidenzwert. Dies reduziert typischerweise den Verifizierungsaufwand um weitere 30–50 % im Vergleich zur Überprüfung aller hochpriorisierten Felder direkt.
Konfidenzwerte zeigen Ihnen, wo Sie suchen sollten; sie zeigen nicht, was die KI tatsächlich gelesen hat. Für die sicherheitskritischen Felder, die Sie bei jedem Datensatz verifizieren, schließt eine Prüfungsschnittstelle, die jede extrahierte Zelle mit ihrer Position auf der Seite verknüpft, diese Lücke. Klicken Sie auf eine Telefonnummer oder eine Allergieangabe, und der ursprüngliche Scan hebt die Region hervor, aus der dieser Wert stammt; klicken Sie auf eine Region im Bild, und es springt zur passenden Zelle zurück. In ImageToTable.ai ist dies der Review-Modus mit bbox-gestützter Verifizierung, und er verwandelt „Ist dieser Wert richtig?" in wenige Sekunden visueller Bestätigung statt eines erneuten Lesens des Pakets.
Das praktische Ergebnis: Ein gut gestalteter QA-Rahmen für Anmeldeformulare verifiziert 100 % der Notfallkontakte und medizinischen Felder, stichprobenprüft 20 % der demografischen Elterndaten und vertraut auf Kontrollkästchen-/Einwilligungsfelder auf Batchebene. Dieser dreistufige Ansatz erfasst die Felder, in denen Fehler echte Konsequenzen haben, und vermeidet gleichzeitig die Falle, jeden extrahierten Wert zu überprüfen, als ob er gleich wahrscheinlich falsch wäre.
Umgang mit Familien mit mehreren Formularen
Eine Familie, die drei Kinder anmeldet, reicht drei separate Anmeldepakete ein – eines pro Kind. Jedes Paket enthält die gemeinsamen demografischen Daten der Familie (Namen der Eltern, Heimatadresse, Notfallkontakte, Versicherungsträger) sowie kinderspezifische Daten (Klassenstufe, medizinische Bedingungen, Lehrerpräferenz, Busroute). Die drei Pakete sind unabhängige PDFs, aber die darin enthaltenen Daten überschneiden sich erheblich.
Das Extraktionstool verarbeitet jedes Paket unabhängig, was das korrekte Verhalten ist: Jeder Datensatz des Kindes im Schülerverwaltungssystem (SIS) muss in sich abgeschlossen sein. Die Batch-Ausgabe enthält drei Zeilen – eine pro Kind – wobei die gemeinsamen Familiendaten über die Zeilen hinweg wiederholt werden. Wenn Sie in PowerSchool oder Infinite Campus importieren, erstellt jede Zeile einen separaten Schülerdatensatz mit eigenen Elternteil-Kontakt- und Notfallkontaktfeldern.
Zwei betriebliche Überlegungen für Familien mit mehreren Formularen:
Konsistenzprüfung. Vergleichen Sie nach der Extraktion die Elternteil-Kontaktfelder über die Geschwisterzeilen hinweg. Wenn die Extraktion unterschiedliche Telefonnummern der Eltern für Kind A und Kind B erzeugt (wobei derselbe Elternteil beide Formulare am selben Tag ausgefüllt hat), ist einer der Werte wahrscheinlich ein Extraktionsfehler. Markieren Sie diese Abweichungen zur Überprüfung. Diese zeilenübergreifende Validierung erkennt Extraktionsfehler, die eine Einzelzeilenprüfung übersehen würde.
Massenaktualisierung vs. kinderspezifische Daten. Einige Felder im Anmeldepaket, wie Heimatadresse, Telefonnummern der Eltern und Versicherungsträger, sind Familiendaten, die für alle Geschwister identisch gelten. Andere Felder, wie Klassenstufe, Lehrerzuweisung und medizinische Bedingungen, sind kinderspezifisch und sollten niemals über Zeilen hinweg kopiert werden. Ihr Spaltendesign für die Extraktion sollte diese Unterscheidung widerspiegeln. Eine Spalte mit der Bezeichnung „Heimatadresse“ erzeugt für alle drei Kinder denselben Wert (die Adresse, die der Elternteil auf jedem Formular angegeben hat). Eine Spalte mit der Bezeichnung „Lehrername“ erzeugt für jedes Kind einen anderen Wert. Das Extraktionstool verarbeitet dies korrekt, solange die Spalten auf der richtigen Granularitätsebene definiert sind.
FERPA-Konformität bei der Extraktion von Anmeldeformularen
In dem Moment, in dem ein gescanntes Anmeldeformular in ein KI-Extraktionstool eines Drittanbieters hochgeladen wird, hat der Schulbezirk eine Offenlegung personenbezogener Informationen aus einem Bildungsdatensatz gemäß dem Family Educational Rights and Privacy Act (FERPA (Family Educational Rights and Privacy Act), 20 U.S.C. § 1232g; 34 CFR Part 99) vorgenommen. Ein Anmeldeformular mit dem vollständigen Namen, Geburtsdatum, Adresse und Kontaktdaten der Eltern eines Schülers erfüllt die Definition eines Bildungsdatensatzes gemäß § 99.3. Diese Offenlegung erfordert entweder die Einwilligung der Eltern oder eine anwendbare Ausnahme. Für die Dokumentextraktion ist die anwendbare Ausnahme die Ausnahme für Schulbeamte gemäß § 99.31(a)(1)(i)(B) (siehe die PTAC-Leitlinien des US-Bildungsministeriums zu Cloud-Computing unter FERPA).
Drei Anforderungen müssen erfüllt sein, damit die Ausnahme für Schulbeamte greift. Erstens muss der Extraktionsanbieter eine institutionelle Dienstleistung erbringen: Das Extrahieren von Daten aus Anmeldeformularen ist eine Funktion, die der Bezirk andernfalls mit eigenem Personal durchführen würde. Zweitens muss der Anbieter unter der direkten Kontrolle des Bezirks arbeiten, die durch einen schriftlichen Vertrag festgelegt wird, der beschränkt, wie Schülerdaten verwendet und aufbewahrt werden dürfen. Drittens muss der Anbieter den Weiterverbreitungsbeschränkungen gemäß § 99.33(a) unterliegen, was bedeutet, dass er extrahierte Schülerdaten nicht ohne Genehmigung des Bezirks an Unterauftragsverarbeiter oder andere Parteien weitergeben darf.
Die kritische betriebliche Anforderung, die die meisten Bezirke übersehen: Der schriftliche Vertrag muss den Extraktionsanbieter ausdrücklich daran hindern, hochgeladene Schülerdokumente zum Trainieren seiner KI-Modelle zu verwenden. Ein Anbieter, der Schüleranmeldeformulare zur Verbesserung seiner Extraktions-Engine verwendet, nutzt die Daten für einen Zweck, der über den autorisierten Dienst hinausgeht, und diese sekundäre Nutzung ist nicht durch die Ausnahme für Schulbeamte abgedeckt. Dies ist heute die häufigste Compliance-Lücke in Extraktions-Workflows von K-12 (Kindergarten bis 12. Klasse)-Bezirken.
Die vollständige regulatorische Analyse, einschließlich der Frage, wie festzustellen ist, ob ein Dokument als Bildungsdatensatz gilt, was die Ausnahme für Schulbeamte in der Praxis erfordert, was der Vertrag enthalten muss, Aufbewahrungs- und Löschungsanforderungen sowie wie staatliche Datenschutzgesetze für Schülerdaten mit FERPA (Family Educational Rights and Privacy Act) interagieren, wird ausführlich im Begleitartikel FERPA-Compliant Student Data Extraction: A Guide for Admissions behandelt. Dieser Leitfaden enthält eine siebenstufige Compliance-Checkliste, die jede Anforderung einer spezifischen regulatorischen Referenz zuordnet.
Ihre Optionen im Vergleich: Manuelle Eingabe vs. Template-OCR vs. Semantische KI
Schulbezirke, die Anmeldeformulare verarbeiten, haben drei Ansätze zur Auswahl. Jeder hat eine andere Kostenstruktur, Einrichtungszeit, Genauigkeitsprofil und Skalierungsverhalten. Die folgende Tabelle vergleicht sie anhand der Dimensionen, die für die Anmeldesaison am wichtigsten sind.
| Dimension | Manuelle Dateneingabe | Template-OCR (z. B. Docparser, ABBYY) | Semantische KI (z. B. ImageToTable.ai) |
|---|---|---|---|
| Einrichtungszeit | Keine – jedes Personalmitglied kann tippen | 1–3 Stunden pro Formularlayout – erfordert die Definition von Extraktionszonen für jedes Schulpaket | 15–30 Minuten – Spaltennamen einmalig für alle Schulen einrichten |
| Kosten pro Formular bei 500 Formularen | ~$2.00–$3.00 an Personalzeit | ~$0.20–$0.50 (Software + amortisierte Template-Einrichtung) | ~$0.10–$0.25 pro Seite |
| Handschriftunterstützung | Menschen lesen jede Handschrift | Schwach – zeichenbasierte OCR bei Schreibschrift fällt typischerweise unter 60 % Genauigkeit | Gut (85–92 %) – kontextuelles Lesen verbessert die Ergebnisse bei strukturierten Formularen |
| Kontrollkästchen-Erkennung | Menschen lesen den Zustand des Kontrollkästchens | Begrenzt – erfordert zonenbasierte Regeln für jede Kontrollkästchen-Position | Stark (95–98 %) – liest Kontrollkästchen im Kontext seiner Beschriftung |
| Zuordnung mehrerer Felder | Menschen verstehen Beziehungen natürlich | Nicht unterstützt – jede Zone erzeugt einen unabhängigen Datenpunkt | Unterstützt – KI verknüpft Name + Beziehung + Telefon als einen Kontaktdatensatz |
| Umgang mit mehreren Formularlayouts | Menschen passen sich jedem Layout an | Erfordert separates Template pro Layout – 5 Schulen = 5 Templates | Ein Spaltensatz verarbeitet jedes Layout – KI liest nach Bedeutung, nicht nach Position |
| Skalierbarkeit (200→1.000 Formulare) | Linear – 5-faches Volumen = 5-fache Personalzeit | Unterlinear, aber der Template-Wartungsaufwand wächst mit der Layout-Vielfalt | Unterlinear – 5-faches Volumen addiert ~30 Min. Verarbeitungszeit |
| FERPA-Compliance-Baseline | Keine externe Datenübertragung – keine FERPA-Offenlegung | Erfordert Anbietervertrag mit Ausnahme für Schulbeamte | Erfordert Anbietervertrag mit Ausnahme für Schulbeamte |
Die Wahl reduziert sich auf zwei Fragen. Wenn Ihr Bezirk weniger als 100 Anmeldeformulare pro Jahr verarbeitet und die Formulare überwiegend gedruckt (nicht handschriftlich) sind, ist die manuelle Eingabe möglicherweise die einfachste Option, da sich der Zeitaufwand für die Einrichtung eines automatisierten Systems bei diesem Volumen nicht amortisiert. Wenn Sie 200 Formulare oder mehr verarbeiten oder wenn Ihre Formulare Handschrift, Kontrollkästchen oder mehrere Formularlayouts verschiedener Schulen enthalten, bietet semantische KI das beste Verhältnis von Genauigkeit zu Aufwand. Template-OCR nimmt einen zunehmend schmalen Mittelweg ein: Es verarbeitet gedruckte Formulare in großem Umfang, scheitert jedoch an Handschrift, Kontrollkästchen und Layout-Vielfalt – genau den drei Merkmalen, die K-12 (Kindergarten bis 12. Klasse)-Anmeldepakete ausmachen.
Häufig gestellte Fragen
Macht ein Online-Registrierungsportal die Extraktion überflüssig?
Online-Portale (PowerSchool Enrollment, SchoolMint, LINQ) verarbeiten Neuanmeldungen, die vollständig über das Portal abgewickelt werden. Sie beseitigen Papierformulare in der Praxis nicht, da ein erheblicher Teil der Familien weiterhin Papierpakete einreicht – und dieser Anteil variiert je nach Bezirk und Klassenstufe: Familien, die an Präsenz-Registrierungsveranstaltungen teilgenommen haben, Familien ohne zuverlässiges Breitband zu Hause, Familien, deren Muttersprache vom vollständigen Portal-Workflow nicht unterstützt wird, sowie wiederkehrende Familien, deren Portal-Konten abgelaufen sind oder nie erstellt wurden. Die Extraktion ist die Lösung für das Papier, das unabhängig von der Existenz des Online-Portals ankommt.
Was ist die praktische Genauigkeitsgrenze für handschriftliche Anmeldeformularfelder?
Bei strukturierten Anmeldeformularen mit klaren Feldbeschriftungen und Feldgrenzen erreicht die Handschriftextraktion typischerweise 85–92 % Genauigkeit bei Namen und Adressen und 75–85 % bei Freitext-Erzählungen im medizinischen Bereich. Diese Zahlen setzen eine angemessene Scanqualität (300 DPI, guter Kontrast) und normale Handschrift voraus. Formulare, die in Großbuchstaben ausgefüllt werden, nähern sich 95 % Genauigkeit; Schreibschrift mit Abkürzungen fällt auf etwa 75 %. Die Genauigkeitsgrenze liegt nicht am KI-Modell, sondern an der inhärenten Mehrdeutigkeit der Handschrift, über die sich selbst menschliche Leser gelegentlich uneinig sind. Kein Extraktionssystem, ob KI-basiert oder nicht, sollte handschriftliche medizinische Felder ohne menschliche Überprüfung lesen.
Was passiert, wenn unser Bezirk das Anmeldepaket nächstes Jahr neu gestaltet?
Mit semantischer KI-Extraktion ändert sich nichts. Die Spaltennamen bleiben gleich (Schülername, Geburtsdatum, Elternteil-Kontakt, Notrufnummer, Allergien), und die KI findet die entsprechenden Daten im neuen Formularlayout, indem sie die Feldbeschriftungen liest. Sie müssen keine Zonen, Vorlagen oder Regeln neu konfigurieren. Dies ist der entscheidende Vorteil der semantischen Extraktion gegenüber der Template-OCR: Das Formularlayout ist für die Extraktionslogik irrelevant, da die KI Inhalte liest, nicht Koordinaten.
Können extrahierte Daten direkt in unser SIS übertragen werden, oder benötigen wir Middleware?
Die meisten K-12 (Kindergarten bis 12. Klasse) SIS-Plattformen (PowerSchool, Infinite Campus, Skyward, Ellucian Banner) akzeptieren den Bulk-Import von CSV- oder Excel-Dateien für Schülerdemografiedaten. Nachdem das Extraktionstool eine Tabellenkalkulation mit Spalten erstellt hat, die Ihrer SIS-Importvorlage entsprechen, nutzen Sie die Standard-Importfunktion des SIS, um die Daten hochzuladen. Middleware ist nicht erforderlich. Ein einmaliges Einrichten der Spaltenzuordnung im SIS-Importtool ist nötig; nachfolgende Batches folgen derselben Zuordnung.
Funktioniert die Extraktion auch bei Anmeldeformularen auf Spanisch oder in anderen Sprachen?
Ja. Die KI liest handschriftliche und gedruckte Texte in den meisten gängigen Sprachen. Spanisch ist die häufigste nicht-englische Sprache auf K-12-Anmeldeformularen in den USA, und die Extraktion verarbeitet sie ohne separate Konfiguration. Die Spaltennamen sollten in der Sprache definiert sein, die Ihr SIS erwartet (in der Regel Englisch für US-Bezirke); die KI extrahiert den spanischen Text aus dem Formular und platziert ihn in der entsprechenden englisch benannten Spalte. Für Bezirke, die Anmeldepakete in mehreren Sprachen (Englisch, Spanisch, Vietnamesisch, Mandarin, Arabisch) bereitstellen, verarbeitet ein einziges Spaltenset alle davon.
Gelten HIPAA-Anforderungen für medizinische Felder auf Anmeldeformularen oder deckt FERPA (Family Educational Rights and Privacy Act) sie ab?
FERPA, nicht HIPAA, regelt Gesundheitsdaten von Schülern, die von einer Schule verwaltet werden. Die HIPAA-Datenschutzregel schließt „Bildungsunterlagen, die unter FERPA fallen" von ihrer Definition geschützter Gesundheitsinformationen aus (45 CFR § 160.103). Das bedeutet, dass medizinische Zustände, Allergiebeschreibungen und Impfaufzeichnungen auf einem Anmeldeformular unter FERPA und nicht unter HIPAA geschützt sind, solange die Schule sie als Bildungsunterlagen führt. Die praktische Konsequenz: Der FERPA-Compliance-Rahmen (Ausnahme für Schulbeamte, schriftlicher Vertrag, kein Modelltraining) deckt sowohl die medizinischen als auch die demografischen Felder ab. Eine separate HIPAA-Analyse für die Extraktion von Anmeldeformularen ist nicht erforderlich, obwohl einige Bundesstaaten zusätzliche Gesetze zum Schutz der Gesundheitsdaten von Schülern haben, die gelten können.
Wie gehen wir mit Anmeldeformularen um, die als mehrseitige Scan-Sets mit Homeschool- oder Außerschulbezirks-Unterlagen eintreffen?
Nehmen Sie alle Seiten in den Scan auf (Aufenthaltserklärungen, Adressnachweise, Homeschool-Mitteilungsformulare, Sorgerechtsbeschlüsse) als Teil desselben mehrseitigen PDFs pro Schüler. Die Extraktions-KI liest nur die Seiten und Felder, die Ihren definierten Spaltennamen entsprechen, und überspringt Seiten ohne Anmeldedaten. Nicht übereinstimmende Seiten werden in der Extraktionsausgabe ignoriert, bleiben aber Teil des Dokumentdatensatzes. Das Kennzeichnen bestimmter Seiten für die Extraktion (z. B. „nur aus Seiten 1–4 eines 15-seitigen Pakets extrahieren") wird auf der Ebene der Spaltendefinition in den meisten semantischen KI-Tools behandelt.
Die Extraktion aus Schüleranmeldeformularen ist keine einzelne Technologieentscheidung. Es ist eine Workflow-Transformation, die Scannen, Spaltendesign, Batch-Verarbeitung, Verifizierung, SIS-Import und Compliance-Dokumentation umfasst.
Der vierteilige Workflow aus Scannen, Spalten definieren, Batch verarbeiten und Verifizieren-und-Importieren verwandelt den Stapel Papierpakete im August in eine strukturierte Tabellenkalkulation, die für PowerSchool oder Infinite Campus bereit ist. Das QA-Framework zeigt Ihnen, welche Felder Sie bei jedem Datensatz prüfen müssen (Notfallkontakte, medizinische Daten) und welche Felder Sie auf Batch-Ebene vertrauen können (Kontrollkästchen, Einwilligungsformulare). FERPA (Family Educational Rights and Privacy Act)-Compliance ist eine Voraussetzung, kein nachträglicher Gedanke: eine unterzeichnete institutionelle Vereinbarung mit Ihrem Extraktionsanbieter, ein schriftliches Verbot des Modelltrainings und ein dokumentierter Aufbewahrungsplan.
Testen Sie den Workflow mit zehn Anmeldeformularen aus der diesjährigen Registrierung. Wenn das Genauigkeitsprofil dem hier Beschriebenen entspricht, haben Sie Ihre Vorlage für jede kommende Anmeldesaison.
Kostenlos testen, ohne Anmeldung. Dateien werden transient verarbeitet und nicht gespeichert. Fragen Sie nach FERPA-konformen institutionellen Vereinbarungen für Ihren Bezirk.