De paquetes de papel a filas listas para SIS:
La guía completa para la extracción de formularios de inscripción K-12 (desde preescolar hasta secundaria)
Cada agosto, aproximadamente 49 millones de estudiantes de escuelas públicas de EE. UU. regresan a clases (Centro Nacional de Estadísticas Educativas, 2024–25). Para las familias que aún se inscriben o envían paquetes actualizados en papel, cada nombre escrito a mano, selección de casilla y nota médica debe escribirse en un sistema de información estudiantil (SIS) antes de que comiencen las clases. Un paquete de inscripción K-12 (desde preescolar hasta secundaria) típico tiene de 15 a 25 páginas en una docena de secciones: datos demográficos del estudiante, contactos de padres y tutores, contactos de emergencia con relaciones de múltiples campos, condiciones médicas, registros de vacunación, preferencias de transporte y múltiples formularios de consentimiento. Cada sección utiliza un formato de datos diferente: letras de molde impresas, cursiva, casillas de verificación, opciones circuladas, narrativas de texto libre. Cada una falla de manera diferente cuando se procesa con OCR (reconocimiento óptico de caracteres) tradicional.
Conclusiones clave
- La mayoría de los distritos escolares asumen que un portal de inscripción en línea elimina la carga de entrada de datos. En la práctica, muchas familias aún entregan paquetes en papel cada agosto, y esas pilas de formularios de 15 a 25 páginas llegan a la oficina principal.
- El OCR con plantilla se suponía que resolvería esto, pero falla en las tres características que definen los formularios de inscripción: escritura mixta a mano e impresa en la misma página, cuadrículas de casillas junto a campos de texto libre, y relaciones de múltiples campos como contactos de emergencia que deben permanecer agrupados como un solo registro.
- La IA semántica maneja las tres: defina su conjunto de 28 campos de columna una vez, cargue los paquetes de cada escuela en un solo lote independientemente del diseño, y enfoque la verificación en los campos donde los errores tienen consecuencias reales: contactos de emergencia y datos médicos.
¿Qué es la extracción de formularios de inscripción estudiantil?
La extracción de datos de formularios de inscripción estudiantil es el proceso automatizado de leer datos de paquetes de registro escolar K-12 (preescolar hasta secundaria) completados (nombres escritos a mano o impresos, fechas de nacimiento, datos de contacto de los padres, información médica y selecciones de casillas) y convertirlos en filas estructuradas de hoja de cálculo que pueden importarse a un sistema de información estudiantil (SIS). Es una aplicación especializada de extracción de datos con IA que maneja la realidad de formatos mixtos de los formularios de inscripción: las etiquetas preimpresas coexisten con respuestas escritas a mano, las casillas están junto a las líneas de firma, y las narrativas médicas de texto libre comparten la misma página que los bloques de direcciones estructurados.
A diferencia del reconocimiento óptico de caracteres (OCR) tradicional, que lee caracteres uno por uno sin comprender su significado, la extracción semántica con IA identifica los campos por su significado y contexto. Este es el enfoque utilizado por herramientas modernas como ImageToTable.ai. Cuando la IA encuentra una sección etiquetada como "Contacto de emergencia — Nombre", sabe extraer el nombre de una persona de esa área, incluso si la escritura conecta cada letra en cursiva. Esta comprensión semántica es lo que hace que la extracción de formularios de inscripción funcione a escala práctica, porque no hay dos distritos escolares que impriman sus paquetes de registro de la misma manera, y los padres no los llenan de la misma manera dos veces.
Esta guía cubre el panorama completo: los desafíos únicos que presentan los formularios de inscripción (no son facturas ni estados de cuenta bancarios), el flujo de trabajo integral desde el paquete en papel hasta la importación al SIS, estrategias de extracción campo por campo, procesamiento por lotes para el pico de inscripciones de agosto a septiembre, manejo de familias con múltiples formularios donde cada hijo tiene un paquete separado, cumplimiento de FERPA (Ley de Derechos y Privacidad Educativa de la Familia), y una comparación de los tres enfoques disponibles hoy para los distritos escolares: ingreso manual de datos, OCR basado en plantillas y extracción semántica con IA.
Por qué los formularios de inscripción son un problema de extracción diferente
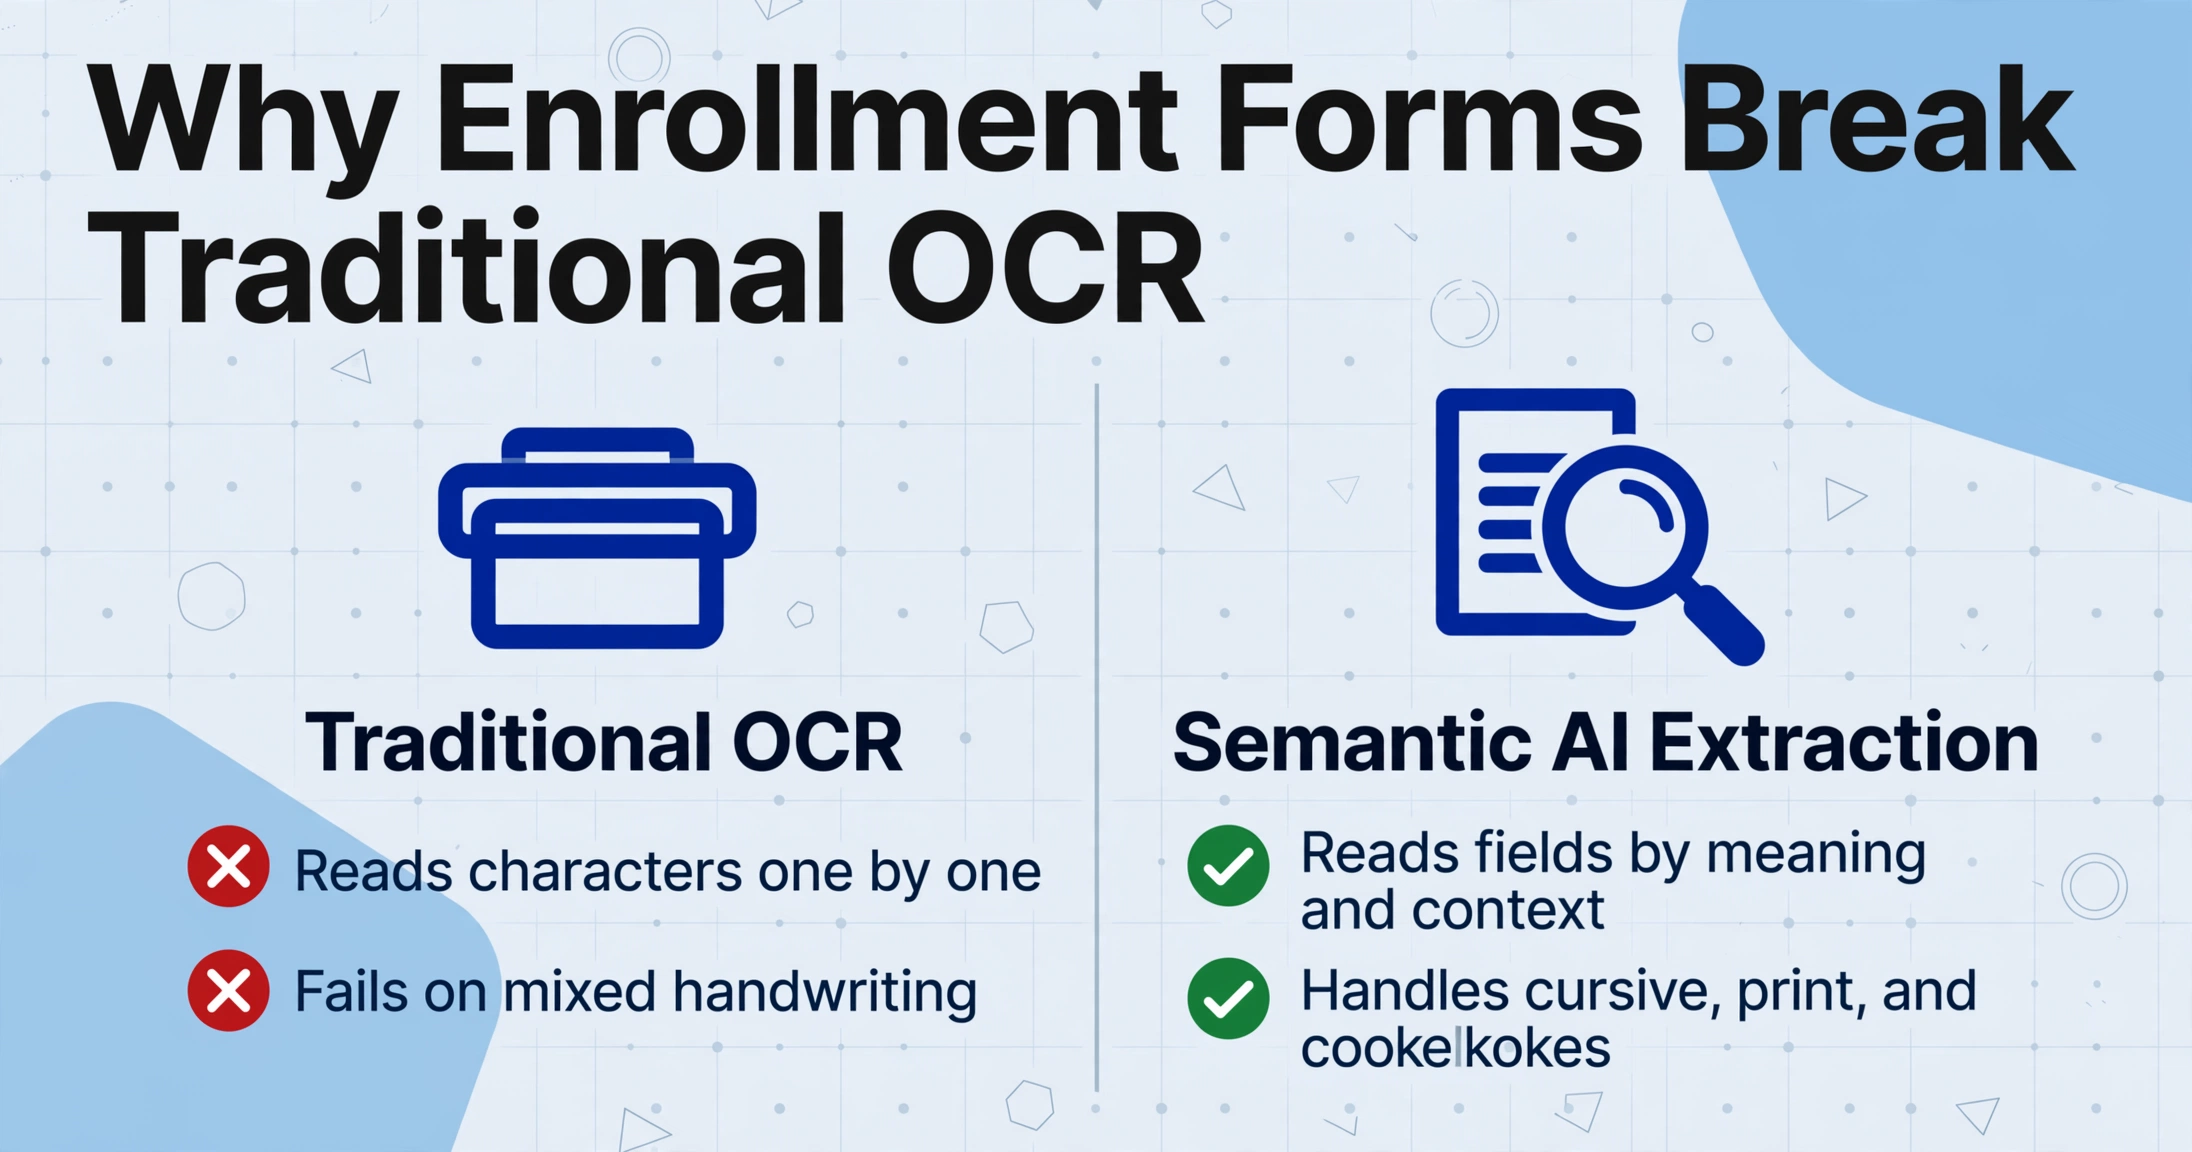
Un paquete de inscripción escolar no es un solo tipo de documento. Son una docena de estructuras documentales distintas unidas, y cada una se comporta de manera diferente al procesarse con una herramienta de extracción. Comprender estas realidades estructurales es el requisito previo para crear un flujo de trabajo que funcione a escala.
Escritura a mano y texto impreso en la misma página
Un formulario de inscripción típicamente tiene etiquetas preimpresas en una tipografía estándar ("Apellido legal del estudiante __________") y respuestas escritas a mano en los espacios en blanco. Una sola página puede contener letras de molde impresas de un padre que llenó el formulario con escritura cuidadosa, cursiva de otro padre que escribió rápido, y una marca de casilla que no es ni molde ni cursiva sino un garabato. El OCR tradicional está diseñado para texto impreso uniforme sobre fondos limpios y tiene un solo modo de reconocimiento: decodificación carácter por carácter. Por eso falla con esta entrada mixta. La IA semántica procesa cada campo de forma independiente, usando el contexto que brindan las etiquetas impresas para anclar la extracción del contenido escrito a mano. El mismo mecanismo sustenta la extracción de formularios escritos a mano en general, y los paquetes de inscripción son uno de sus casos más difíciles.
Casillas de verificación y campos de texto libre lado a lado
Los formularios de inscripción están llenos de opciones binarias como "¿Su hijo tiene alguna alergia? ☐ Sí ☐ No," seguidas inmediatamente de campos de texto libre que piden detalles. Un padre podría marcar "Sí" a la pregunta de alergias y escribir "Penicilina: causa sarpullido" en el campo de texto inferior. La herramienta de extracción debe leer la señal binaria (qué casilla está marcada) y el texto narrativo (lo que el padre realmente escribió) como dos puntos de datos separados pero relacionados. Este emparejamiento es trivial para un modelo de IA semántica que lee el documento como un todo. Es sorprendentemente difícil para el OCR basado en plantillas, que típicamente requiere reglas separadas para zonas de casillas y zonas de texto y no tiene forma de vincular las dos.
Estructuras de relaciones de múltiples campos
La sección de contacto de emergencia de un formulario de inscripción ilustra la complejidad relacional que hace que los formularios estudiantiles sean más difíciles de procesar que la mayoría de los documentos comerciales. Un solo formulario puede solicitar "Contacto de emergencia 1 — Nombre, Parentesco, Teléfono" y "Contacto de emergencia 2 — Nombre, Parentesco, Teléfono". Tres campos por contacto están vinculados a la misma referencia de persona. La herramienta de extracción debe saber que "John Smith", "Padre" y "555-123-4567" pertenecen al mismo registro de contacto de emergencia, mientras que "Mary Jones", "Tía" y "555-987-6543" pertenecen a un contacto diferente. En una salida de hoja de cálculo, esto significa una fila por estudiante con seis columnas de contacto de emergencia (Nombre 1, Parentesco 1, Teléfono 1, Nombre 2, Parentesco 2, Teléfono 2), y la IA debe asignar cada dato a la columna correcta comprendiendo junto a qué etiqueta impresa se encuentra en la página.
El pico de inscripciones de agosto a septiembre
La restricción de tiempo es el factor que más importa a nivel operativo. En la mayoría de los distritos escolares de EE. UU., la mayor parte de las nuevas inscripciones llegan en una ventana de cuatro a seis semanas entre mediados de julio y principios de septiembre, y las actualizaciones de estudiantes que regresan siguen el mismo calendario: cambios de contacto de emergencia, nueva información médica, renovaciones de consentimiento. Para un distrito de 5,000 estudiantes que procesa aproximadamente 1,000 paquetes de inscripción nuevos y de retorno, eso equivale a 15,000 a 25,000 páginas de formularios en seis semanas. Un equipo de captura de datos de dos o tres empleados de oficina no puede escribir ese volumen sin horas extra, acumulación de trabajo o errores. Lo que determina si los datos de inscripción están listos antes de que comiencen las clases es la capacidad de procesamiento de la herramienta de extracción, no su precisión por página.
El artículo complementario ¿Puede la IA extraer formularios de inscripción estudiantil? cubre las estimaciones de precisión campo por campo en detalle, incluyendo dónde la IA se desempeña bien (texto impreso, casillas de verificación, rendimiento por lotes) y dónde aún necesita verificación humana (números de teléfono manuscritos, notas médicas de texto libre).
El Flujo de Trabajo Completo: Del Paquete de Papel al Registro SIS
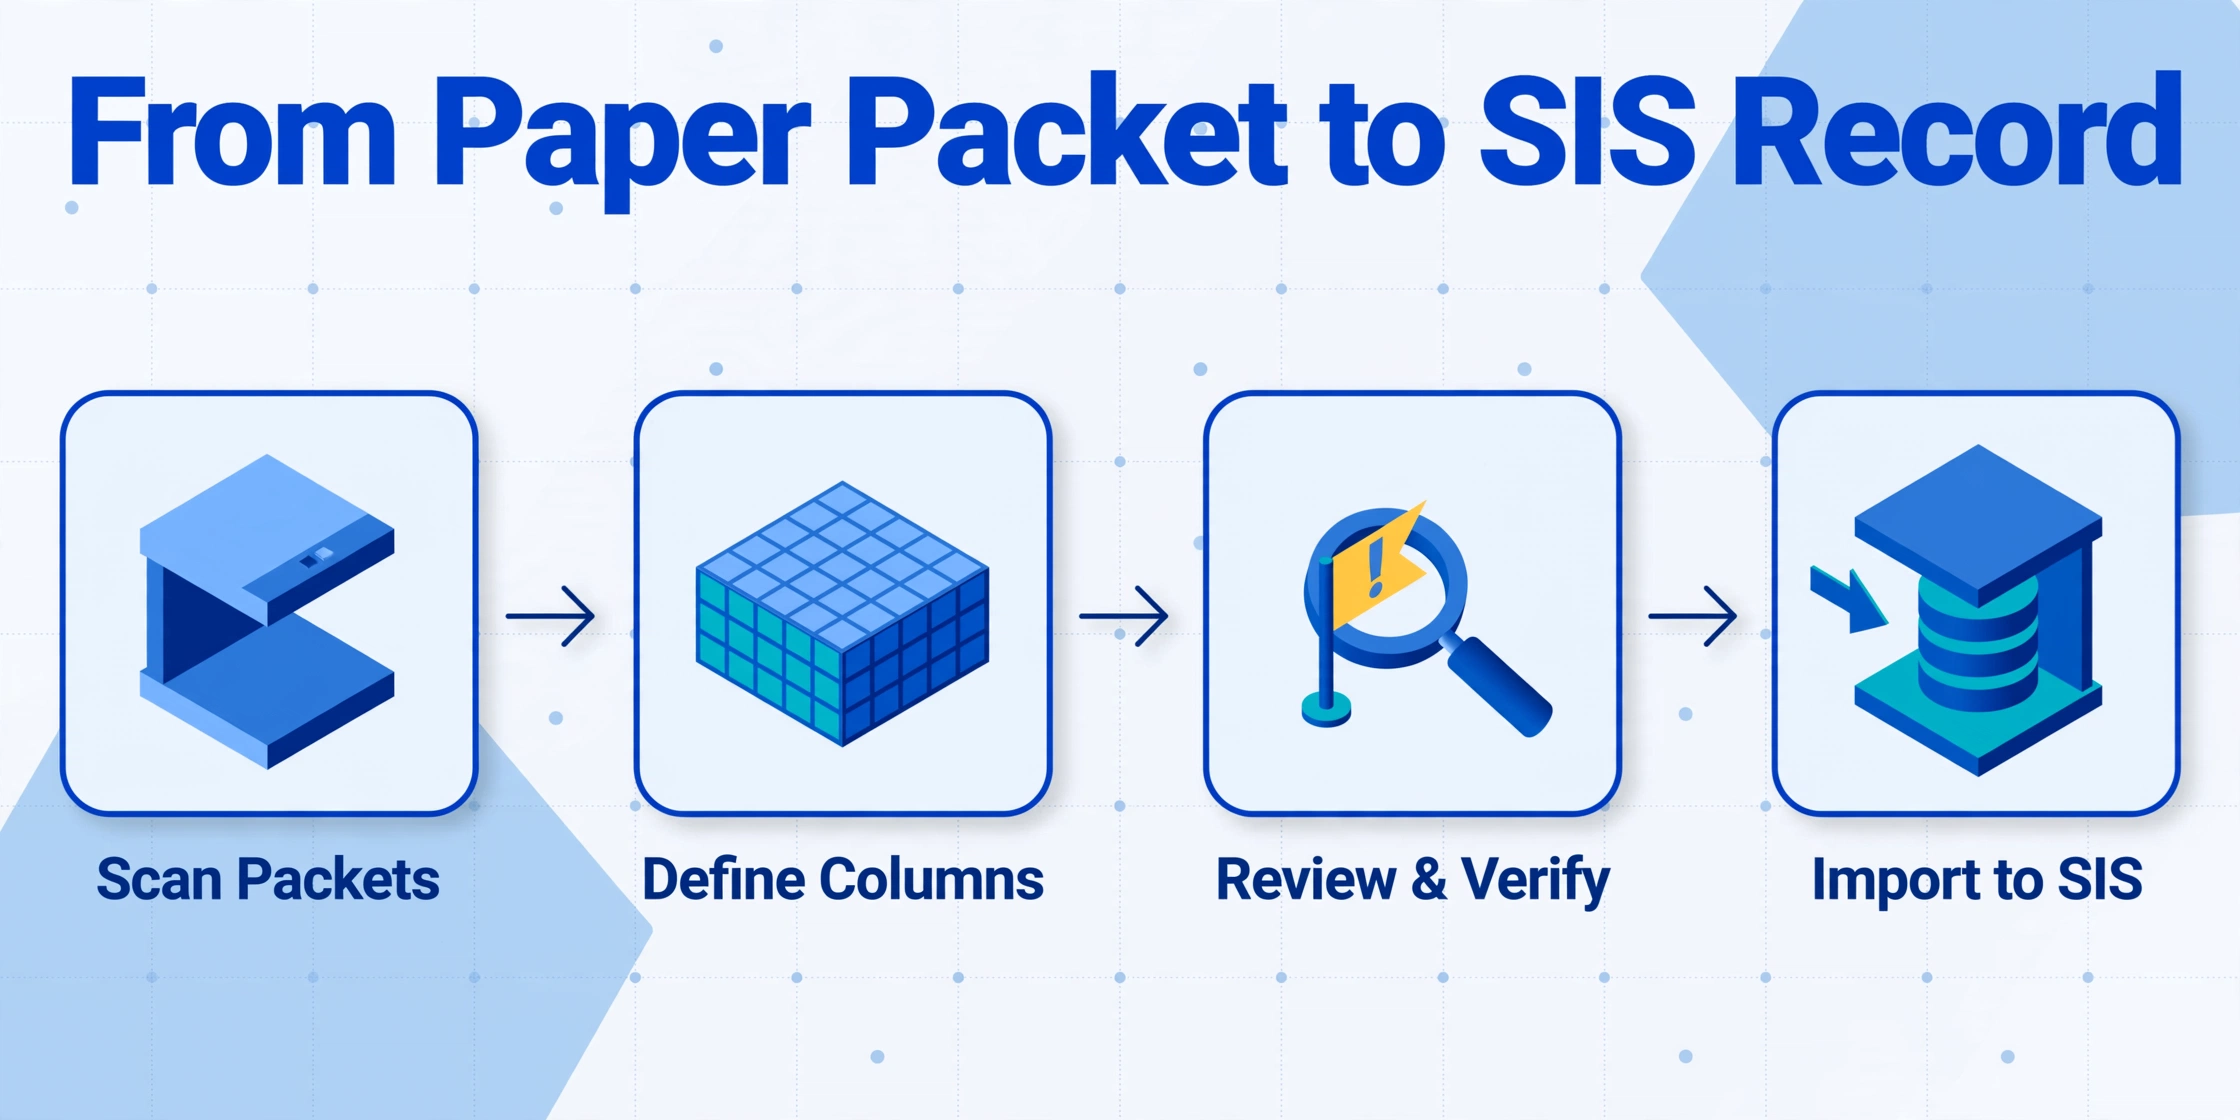
El flujo de trabajo de extracción tiene cuatro fases. Cada fase corresponde a un paso operativo específico que un miembro del personal de recepción o un coordinador de inscripción puede ejecutar sin soporte de TI.
Escanee y prepare los paquetes de inscripción
Escanee el paquete completo de cada estudiante como un único PDF de varias páginas. Configure el escáner a 300 DPI en escala de grises. El color aumenta el tamaño del archivo sin mejorar la precisión en la mayoría de los formatos de formularios de inscripción, mientras que el blanco y negro pierde el contraste sutil que separa una casilla marcada con lápiz del fondo del papel. Nombre cada archivo con una convención coherente: [Grade]_[LastName]_[FirstName].pdf. Este patrón de nombres le permite cotejar los datos extraídos con el documento fuente durante la verificación, sin tener que abrir cada PDF individualmente.
Si los formularios llegan preclasificados por tipo (todos los formularios médicos juntos, todos los de transporte juntos), necesitará un flujo de trabajo de recopilación diferente. En la práctica, la mayoría de los paquetes de inscripción K-12 (desde preescolar hasta secundaria) llegan organizados por estudiante: cada familia presenta una carpeta o pila por hijo, y cada pila contiene el conjunto completo de formularios necesarios para ese estudiante.
Defina las columnas de salida
Este es el paso que programa la extracción. En una herramienta de IA semántica, usted define la salida enumerando los nombres de las columnas que desea. Esos nombres se convierten tanto en las instrucciones que la IA usa para localizar los datos en los formularios como en los encabezados de columna en la hoja de cálculo final. El conjunto de columnas debe reflejar su plantilla de importación del SIS. Un conjunto completo para un paquete típico de inscripción K-12 (desde preescolar hasta secundaria) abarca aproximadamente 28 campos, que cubren datos demográficos del estudiante, información de padres/tutores, contactos de emergencia, datos médicos, transporte y estados de consentimiento.
La lista específica de columnas y la justificación del diseño, incluido por qué dividir nombres y apellidos, cómo usar columnas inferidas para campos binarios y dónde incluir los nombres de campos del SIS como pistas, se detalla en la guía complementaria How to Extract Student Enrollment Form Data to Excel for SIS Import. Ese artículo explica la configuración de columnas con ejemplos reales de campos.
Procese el lote
Sube todos los PDF escaneados en un solo lote. La herramienta de IA extrae cada campo de cada formulario en paralelo, no un formulario a la vez, y fusiona los resultados en una sola hoja de cálculo donde cada fila es un registro de estudiante. El tiempo de procesamiento escala con el número de archivos, pero no con la cantidad de páginas por archivo; un paquete de 20 páginas y un formulario de 2 páginas se completan aproximadamente en el mismo tiempo por documento, porque la IA lee el documento completo como una sola unidad semántica.
Para 200 paquetes de inscripción con 28 campos cada uno, o 5,600 puntos de datos individuales, la extracción se completa en aproximadamente 15 a 20 minutos de tiempo real, en comparación con unas 67 horas de ingreso manual de datos. El resultado es un archivo Excel listo para la importación al SIS.
Verifique e importe al SIS
Verifique los resultados comparándolos con los documentos de origen. Centre el esfuerzo de verificación en los campos donde los errores tienen el mayor costo operativo: números de teléfono de contacto de emergencia, transcripciones de condiciones médicas y anotaciones de alergias. Para la mayoría de los lotes de inscripción, estos campos de alto riesgo representan entre el 5 y el 10 % del total de datos extraídos. El 90–95 % restante (campos impresos, selecciones de casillas, estados de consentimiento) puede aceptarse a nivel de lote después de verificar una muestra.
Exporte la hoja de cálculo verificada como .xlsx o CSV e impórtela a su SIS mediante su herramienta estándar de importación de datos. PowerSchool, Infinite Campus y Skyward admiten la importación masiva de CSV para registros demográficos de estudiantes. Después de una configuración inicial de mapeo de columnas en la herramienta de importación del SIS, los lotes de inscripción posteriores siguen la misma plantilla.
Estrategia de Extracción Campo por Campo
No todos los campos de un formulario de inscripción deben extraerse de la misma manera. La tabla a continuación agrupa los campos de formulario de inscripción más comunes según el enfoque de extracción: extracción directa, clasificación inferida o derivación calculada. También indica el nivel de precisión esperado para cada uno. Los rangos de precisión y las tasas de verificación en esta guía provienen de nuestras propias pruebas con paquetes K-12 escaneados, no de un punto de referencia de terceros, por lo que la calidad del escaneo y la escritura a mano pueden variarlos.
| Grupo de campos | Campos de ejemplo | Enfoque de extracción | Prioridad de verificación |
|---|---|---|---|
| Datos demográficos del estudiante | Nombre completo, fecha de nacimiento, género, grado, dirección | Extracción directa: la IA lee el valor manuscrito o impreso junto a la etiqueta correspondiente | Media: la ambigüedad del formato de la fecha de nacimiento y las divisiones de líneas de dirección son los puntos de fallo más comunes |
| Información del padre/tutor | Nombre, relación, teléfono, correo electrónico, empleador | Extracción directa con agrupación de múltiples campos: la IA asocia "Padre" con el teléfono y el correo electrónico escritos en la misma sección | Media-Alta: los números de teléfono son el campo frágil; verifique si la información de contacto no tiene redundancia |
| Contactos de emergencia | Nombre, relación, teléfono (2–3 contactos) | Extracción directa con mapeo relacional: la IA asigna cada tríada de contacto (nombre + relación + teléfono) a la ranura numerada correcta | Alta: el grupo de campos de mayor riesgo; un contacto de emergencia mal indexado (etiquetar el contacto 2 como contacto 1) compromete la capacidad de localización en emergencias |
| Condiciones médicas | Alergias, medicamentos, condiciones crónicas, nombre del médico, aseguradora | Extracción directa de escritura manuscrita de texto libre | Máxima: datos críticos para la seguridad; cada campo médico debe ser verificado por un humano antes de la importación al SIS |
| Registros de vacunación | Nombre de la vacuna, fecha de administración, proveedor | Extracción de tablas: la IA lee la tabla de vacunas como una cuadrícula estructurada (filas = vacunas, columnas = dosis/fechas) | Media: los formularios estatales de vacunación tienen un diseño de tabla consistente; verifique las fechas para el cumplimiento normativo |
| Transporte | Autobús / automóvil / caminante, número de ruta de autobús, horario AM/PM | Clasificación inferida: la IA lee la selección de la casilla y genera el texto de la etiqueta ("Autobús", no el carácter "☐") | Baja: opciones binarias con señal visual clara; verificación por muestreo a nivel de lote |
| Casillas de consentimiento | Autorización de fotos, acuerdo tecnológico, reconocimiento del manual, programa de almuerzo | Clasificación inferida: la IA genera "Sí" o "No" según el estado de la casilla, con una tercera columna opcional para "Firma del padre presente" | Baja: señal binaria con 95–98% de precisión; la verificación a nivel de lote es suficiente |
| Encuesta de idioma del hogar | Idioma principal, idiomas adicionales, idioma preferido de los padres | Extracción directa de texto manuscrito corto o selección de casilla | Baja-Media: los nombres de idiomas son campos cortos con vocabulario limitado; verifique los nombres de idiomas poco comunes |
El patrón es claro: los campos con contenido binario o de vocabulario cerrado (casillas, formularios de consentimiento, selecciones de idioma) pueden aceptarse con verificación mínima. Los campos con escritura manuscrita de texto libre y sin redundancia semántica, especialmente números de teléfono y descripciones médicas, necesitan revisión humana. Distribuya su esfuerzo de verificación en consecuencia, no de manera uniforme en todos los campos.
Procesamiento por lotes a escala de temporada de inscripción
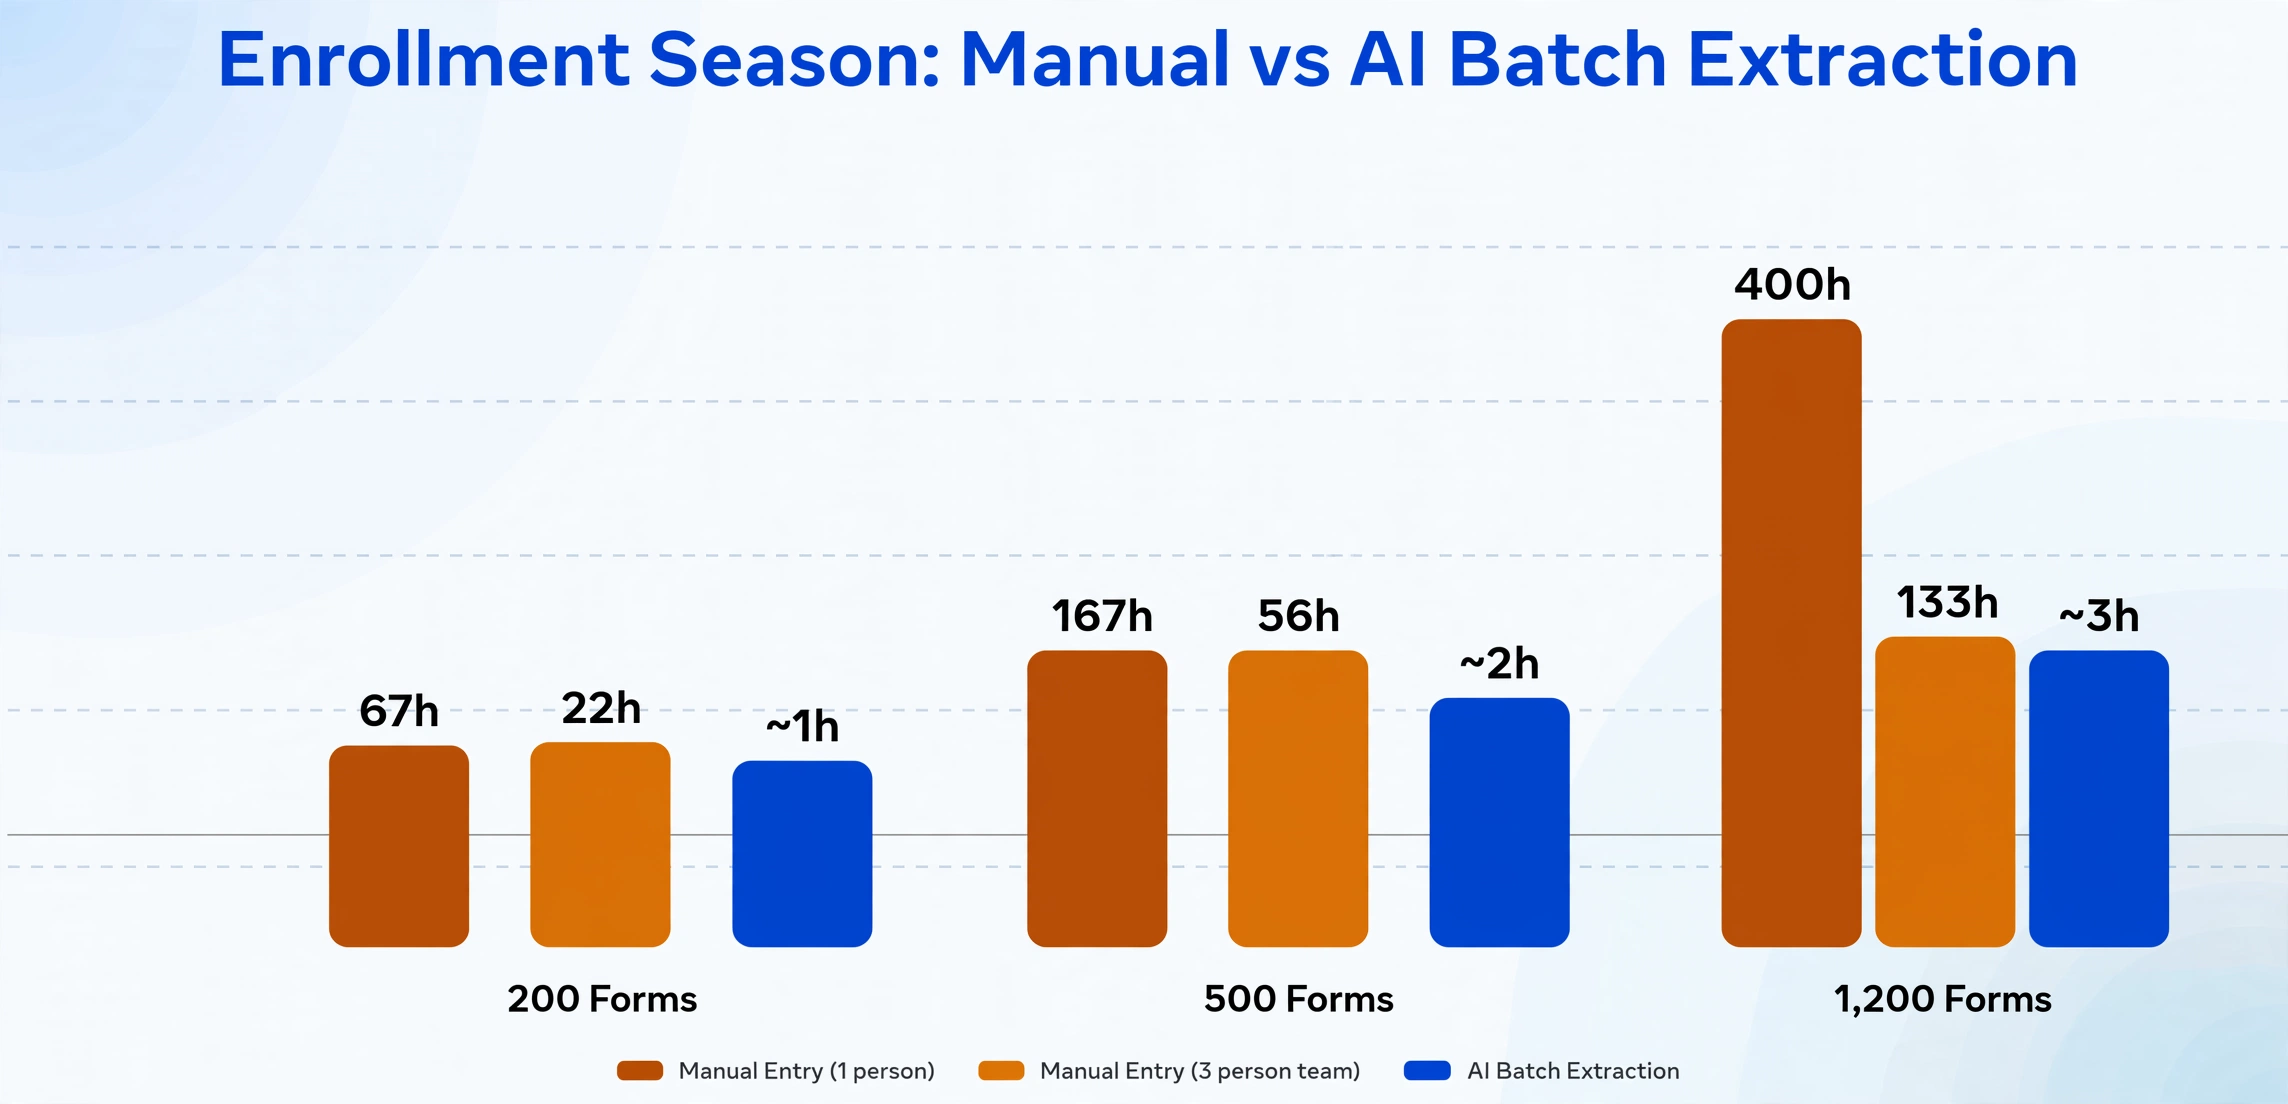
La ventaja operativa de la extracción con IA no es que procese un solo formulario más rápido. Es que procesa 200 formularios en aproximadamente el tiempo que una persona tarda en ingresar un paquete. La tabla siguiente muestra lo que esto significa en tres volúmenes de inscripción comunes, utilizando una tasa de entrada manual medida de unos 20 minutos por paquete y un flujo de trabajo de IA de un solo operador.
| Volumen de inscripción | Entrada manual (1 persona) | Entrada manual (equipo de 3 personas) | Extracción por lotes con IA |
|---|---|---|---|
| 200 formularios (escuela primaria pequeña) | ~67 horas (1.7 semanas) | ~22 horas (3 días) | ~15–20 min de extracción + 30–45 min de verificación |
| 500 formularios (K-8 (desde preescolar hasta secundaria) de tamaño mediano) | ~167 horas (4.2 semanas) | ~56 horas (1.4 semanas) | ~25–40 min de extracción + 60–90 min de verificación |
| 1,200 formularios (escuela secundaria grande o lote de distrito) | ~400 horas (10 semanas) | ~133 horas (3.3 semanas) | ~45–75 min de extracción + 2–3 h de verificación |
El tiempo de verificación supone una revisión específica solo de los campos de alta prioridad, es decir, contactos de emergencia y datos médicos, además de una muestra aleatoria del 5% de los campos restantes. Esta es la idea clave del flujo de trabajo: el objetivo no es eliminar la revisión humana, sino reducir la superficie de verificación del 100% de los campos (cada carácter escrito manualmente) al 10–15% de los campos (solo los datos de mayor riesgo).
La arquitectura de procesamiento por lotes de la herramienta de extracción también es importante para la fiabilidad del flujo de trabajo. Un sistema basado en la nube diseñado para un Procesamiento por lotes prioritario maneja 200 cargas simultáneas de archivos sin colas ni demoras de procesamiento por archivo. La limitación de rendimiento pasa a ser el ancho de banda de carga y el paso de verificación, no la capacidad de inferencia del modelo de IA. Para obtener un recorrido detallado del flujo de trabajo de procesamiento por lotes, incluido el flujo de carga exacto y cómo se estructura la salida de Excel para la importación en el SIS, consulte la guía práctica complementaria Cómo extraer datos de formularios de inscripción de estudiantes a Excel para el SIS del distrito escolar.
Aseguramiento de Calidad: Qué Verificar y en Qué Confiar
Todo flujo de extracción necesita un paso de aseguramiento de calidad. El diseño de ese paso determina si el flujo ahorra tiempo o simplemente reemplaza un tipo de trabajo con datos por otro. Aquí tiene un marco práctico de aseguramiento de calidad diseñado para el procesamiento de formularios de inscripción:
Nivel 1 — Confianza a nivel de lote (70–80% de los campos). Los campos impresos (etiquetas de formularios, información estudiantil prellenada desde PDFs rellenables), las selecciones de casillas y los estados de consentimiento tienen una precisión suficientemente alta (95–99%) como para que una verificación por muestreo a nivel de lote sea suficiente. Verifique el 5% de las filas para estos tipos de campo. Si la tasa de error en la muestra supera el 2%, escale a revisión campo por campo.
Nivel 2 — Verificación puntual por formulario (15–20% de los campos). Los nombres de los padres, las direcciones de los estudiantes, los grados escolares y los nombres de los médicos pertenecen a esta categoría. Estos campos están escritos a mano pero siguen patrones predecibles: los nombres siguen convenciones de nomenclatura y las direcciones incluyen estructuras de calle/ciudad/estado/Código Postal. Verifique el 100% de estos campos en los primeros 10 formularios de un lote para establecer una tasa de error base, y luego reduzca a verificar el 20% de los formularios si la base es limpia.
Nivel 3 — Verificar cada registro (5–10% de los campos). Los números de teléfono de contacto de emergencia, las descripciones de alergias/condiciones médicas y las fechas de inmunización requieren verificación campo por campo en cada registro. La consecuencia de un error es demasiado alta para aceptar un muestreo estadístico: un número de contacto de emergencia equivocado durante una crisis escolar, una notación de alergia mal leída durante la administración de medicamentos. Estos campos deben ser los únicos que reciban revisión humana al 100%.
Cuando la herramienta de extracción proporciona una puntuación de confianza para cada valor extraído (la mayoría de las herramientas de IA semántica lo hacen), úsela para priorizar la verificación: ordene la hoja de cálculo de salida por puntuación de confianza ascendente y revise solo los registros de baja confianza. Esto normalmente reduce la carga de verificación en un 30–50% adicional en comparación con revisar todos los campos de alta prioridad directamente.
Las puntuaciones de confianza le indican dónde mirar; no le muestran lo que la IA realmente leyó. Para los campos críticos de seguridad que verifica en cada registro, una interfaz de revisión que vincule cada celda extraída de vuelta a su posición en la página cierra esa brecha. Haga clic en un número de teléfono o en una nota de alergia y el escaneo original resalta la región de donde proviene ese valor; haga clic en una región de la imagen y salta de vuelta a la celda correspondiente. En ImageToTable.ai esto es el Modo de Revisión con verificación asistida por bbox, y convierte "¿este valor es correcto?" en unos segundos de confirmación visual en lugar de una relectura del paquete.
La conclusión práctica: Un marco de aseguramiento de calidad bien diseñado para formularios de inscripción verifica el 100% de los contactos de emergencia y campos médicos, verifica puntualmente el 20% de los datos demográficos de los padres, y confía en los campos de casillas/consentimiento a nivel de lote. Este enfoque de tres niveles captura los campos donde los errores tienen consecuencias reales mientras evita la trampa de revisar cada valor extraído como si tuviera la misma probabilidad de estar equivocado.
Gestión de Familias con Múltiples Formularios
Una familia que inscribe a tres hijos envía tres paquetes de inscripción separados, uno por cada hijo. Cada paquete contiene la información demográfica compartida de la familia (nombres de los padres, dirección del hogar, contactos de emergencia, aseguradora) más datos específicos del hijo (nivel de grado, condiciones médicas, preferencia de maestro, ruta de autobús). Los tres paquetes son PDFs independientes, pero los datos que contienen se superponen en gran medida.
La herramienta de extracción procesa cada paquete de forma independiente, lo cual es el comportamiento correcto: el registro de cada hijo en el SIS debe ser autónomo. La salida del lote contendrá tres filas, una por cada hijo, con los datos familiares compartidos repetidos en las filas. Al importar en PowerSchool o Infinite Campus, cada fila crea un registro de estudiante separado con sus propios campos de contacto de padres y contacto de emergencia.
Dos consideraciones operativas para familias con múltiples formularios:
Verificación de consistencia. Después de la extracción, compare los campos de contacto de los padres en las filas de hermanos. Si la extracción produce números de teléfono de padres diferentes para el Hijo A y el Hijo B (cuando el mismo padre completó ambos formularios el mismo día), es probable que uno de los valores sea un error de extracción. Marque estas discrepancias para revisión. Esta validación entre filas detecta errores de extracción que una revisión de una sola fila pasaría por alto.
Actualización masiva vs. datos por hijo. Algunos campos del paquete de inscripción, como la dirección del hogar, los números de teléfono de los padres y la aseguradora, son datos a nivel familiar que se aplican de manera idéntica a todos los hermanos. Otros campos, como el nivel de grado, la asignación de maestro y las condiciones médicas, son específicos de cada hijo y nunca deben copiarse entre filas. El diseño de sus columnas de extracción debe reflejar esta distinción. Una columna etiquetada como "Dirección del Hogar" produce el mismo valor para los tres hijos (la dirección que el padre escribió en cada formulario). Una columna etiquetada como "Nombre del Maestro" produce un valor diferente para cada hijo. La herramienta de extracción maneja esto correctamente siempre que las columnas estén definidas con la granularidad adecuada.
Cumplimiento de FERPA para la extracción de formularios de inscripción
En el momento en que un formulario de inscripción escaneado se sube a una herramienta de extracción de IA de terceros, el distrito escolar ha realizado una divulgación de información de identificación personal de un registro educativo según la Ley de Derechos y Privacidad Educativa de la Familia (FERPA, 20 U.S.C. § 1232g; 34 CFR Parte 99). Un formulario de inscripción que contenga el nombre completo de un estudiante, fecha de nacimiento, dirección e información de contacto de los padres cumple con la definición de registro educativo según § 99.3. Esa divulgación requiere el consentimiento de los padres o una excepción aplicable, y para la extracción de documentos, la excepción aplicable es la excepción de funcionario escolar según § 99.31(a)(1)(i)(B) (consulte la guía de PTAC sobre computación en la nube bajo FERPA del Departamento de Educación de EE. UU.).
Se deben cumplir tres requisitos para que aplique la excepción de funcionario escolar. Primero, el proveedor de extracción debe realizar un servicio institucional: extraer datos de formularios de inscripción es una función que el distrito realizaría de otro modo con su propio personal. Segundo, el proveedor debe operar bajo el control directo del distrito, establecido mediante un contrato escrito que restrinja cómo se pueden usar y mantener los datos de los estudiantes. Tercero, el proveedor debe estar sujeto a las restricciones de redivulgación de § 99.33(a), lo que significa que no puede compartir datos extraídos de estudiantes con subprocesadores u otras partes sin la autorización del distrito.
El requisito operativo crítico que la mayoría de los distritos pasan por alto: el contrato escrito debe prohibir específicamente que el proveedor de extracción use documentos de estudiantes subidos para entrenar sus modelos de IA. Un proveedor que usa formularios de inscripción de estudiantes para mejorar su motor de extracción está usando los datos para un propósito más allá del servicio autorizado, y ese uso secundario no está cubierto por la excepción de funcionario escolar. Esta es la brecha de cumplimiento más común en los flujos de trabajo de extracción de distritos K-12 (desde preescolar hasta secundaria) en la actualidad.
El análisis regulatorio completo, incluido cómo determinar si un documento califica como registro educativo, qué requiere la excepción de funcionario escolar en la práctica, qué debe incluir el contrato, los requisitos de retención y eliminación, y cómo las leyes estatales de privacidad de datos de estudiantes interactúan con FERPA, se cubre en detalle en el artículo complementario FERPA-Compliant Student Data Extraction: A Guide for Admissions. Esa guía incluye una lista de verificación de cumplimiento de siete pasos que asigna cada requisito a una referencia regulatoria específica.
Comparación de sus opciones: ingreso manual vs. OCR con plantillas vs. IA semántica
Los distritos escolares que procesan formularios de inscripción tienen tres enfoques disponibles. Cada uno tiene una estructura de costos, tiempo de configuración, perfil de precisión y comportamiento de escalamiento diferentes. La tabla a continuación los compara en las dimensiones que más importan para la temporada de inscripción.
| Dimensión | Ingreso manual de datos | OCR con plantillas (p. ej., Docparser, ABBYY) | IA semántica (p. ej., ImageToTable.ai) |
|---|---|---|---|
| Tiempo de configuración | Ninguno: cualquier miembro del personal puede escribir | De 1 a 3 horas por diseño de formulario: requiere definir zonas de extracción para el paquete de cada escuela | De 15 a 30 minutos: configure los nombres de las columnas una vez para todas las escuelas |
| Costo por formulario en 500 formularios | Aprox. $2.00–$3.00 en tiempo del personal | Aprox. $0.20–$0.50 (software + configuración de plantilla amortizada) | Aprox. $0.10–$0.25 por página |
| Soporte de escritura a mano | Un humano lee cualquier escritura a mano | Deficiente: el OCR a nivel de caracteres en letra cursiva suele caer por debajo del 60 % de precisión | Bueno (85–92 %): la lectura contextual mejora en formularios estructurados |
| Detección de casillas de verificación | Un humano lee el estado de la casilla | Limitada: requiere reglas basadas en zonas para cada posición de casilla | Fuerte (95–98 %): lee la casilla en el contexto de su etiqueta |
| Mapeo de relaciones entre múltiples campos | Un humano comprende las relaciones de forma natural | No compatible: cada zona produce un punto de datos independiente | Compatible: la IA asocia nombre + relación + teléfono como un solo registro de contacto |
| Manejo de múltiples diseños de formularios | Un humano se adapta a cada diseño | Requiere una plantilla separada por diseño: 5 escuelas = 5 plantillas | Un conjunto de columnas maneja cualquier diseño: la IA lee por significado, no por posición |
| Escalabilidad (200→1,000 formularios) | Lineal: 5 veces el volumen = 5 veces el tiempo del personal | Sublineal, pero el mantenimiento de plantillas crece con la variedad de diseños | Sublineal: 5 veces el volumen agrega ~30 minutos al tiempo de procesamiento |
| Línea base de cumplimiento FERPA | Sin transferencia de datos externa: sin divulgación FERPA | Requiere contrato con el proveedor con la excepción del funcionario escolar | Requiere contrato con el proveedor con la excepción del funcionario escolar |
La elección se reduce a dos preguntas. Si su distrito procesa menos de 100 formularios de inscripción al año y los formularios son predominantemente impresos (no escritos a mano), el ingreso manual puede ser la opción más sencilla, porque la inversión de tiempo en configurar cualquier sistema automatizado no se recupera a ese volumen. Si procesa 200 formularios o más, o si sus formularios contienen escritura a mano, casillas de verificación o múltiples diseños de formularios de diferentes escuelas, la IA semántica ofrece la mejor relación precisión-esfuerzo. El OCR con plantillas ocupa un punto medio cada vez más reducido: maneja formularios impresos a escala, pero falla con la escritura a mano, las casillas de verificación y la variedad de diseños: las tres características que definen los paquetes de inscripción K-12 (desde preescolar hasta secundaria).
Preguntas frecuentes
¿Un portal de registro en línea no elimina la necesidad de extracción?
Los portales en línea (PowerSchool Enrollment, SchoolMint, LINQ) gestionan las inscripciones nuevas que se completan íntegramente a través del portal. En la práctica, no eliminan los formularios en papel porque una parte considerable de las familias sigue enviando paquetes en papel, y esa proporción varía según el distrito y el nivel de grado: familias que asistieron a eventos de inscripción presenciales, familias sin banda ancha confiable en el hogar, familias cuyo idioma principal no está soportado por el flujo de trabajo completo del portal, y familias que regresan cuyas cuentas del portal caducaron o nunca se crearon. La extracción es la solución para el papel que llega independientemente de la existencia del portal en línea.
¿Cuál es el límite práctico de precisión para los campos manuscritos de los formularios de inscripción?
En formularios de inscripción estructurados con etiquetas y límites de campo claros, la extracción de escritura manuscrita suele alcanzar una precisión del 85–92 % para nombres y direcciones, y del 75–85 % para narrativas médicas de texto libre. Estas cifras suponen una calidad de escaneo razonable (300 DPI, buen contraste) y escritura estándar. Los formularios completados en letras mayúsculas se acercan al 95 % de precisión; la escritura cursiva con abreviaturas desciende hacia el 75 %. El límite de precisión no es el modelo de IA, sino la ambigüedad inherente de la escritura manuscrita, sobre la que incluso los lectores humanos discrepan ocasionalmente. Ningún sistema de extracción, de IA o de otro tipo, debe utilizarse para leer campos médicos manuscritos sin verificación humana.
¿Qué sucede cuando nuestro distrito rediseña el paquete de inscripción el próximo año?
Con la extracción semántica por IA, nada cambia. Los nombres de las columnas siguen siendo los mismos (Student Name, DOB, Parent Contact, Emergency Phone, Allergies), y la IA localiza los datos correspondientes en el nuevo diseño del formulario leyendo las etiquetas de los campos. No es necesario reconfigurar zonas, plantillas ni reglas. Esta es la ventaja definitoria de la extracción semántica sobre el OCR basado en plantillas: el diseño del formulario es irrelevante para la lógica de extracción porque la IA lee el contenido, no las coordenadas.
¿Pueden los datos extraídos ir directamente a nuestro SIS, o necesitamos middleware?
La mayoría de las plataformas SIS de K-12 (desde preescolar hasta secundaria) (PowerSchool, Infinite Campus, Skyward, Ellucian Banner) aceptan importación masiva de CSV o Excel para registros demográficos de estudiantes. Después de que la herramienta de extracción produce una hoja de cálculo con columnas que coinciden con su plantilla de importación del SIS, usted utiliza la función de importación estándar del SIS para cargar los datos. No se requiere middleware. Se necesita una configuración inicial de mapeo de columnas en la herramienta de importación del SIS, y los lotes posteriores siguen el mismo mapeo.
¿Funciona la extracción en formularios de inscripción en español u otros idiomas?
Sí. La IA lee texto manuscrito e impreso en la mayoría de los idiomas comunes. El español es el idioma no inglés más frecuente en los formularios de inscripción de K-12 (desde preescolar hasta secundaria) en EE. UU., y la extracción lo maneja sin configuración adicional. Los nombres de las columnas deben definirse en el idioma que su SIS espera (normalmente inglés para distritos de EE. UU.); la IA extrae el texto en español del formulario y lo coloca en la columna correspondiente con nombre en inglés. Para distritos que proporcionan paquetes de inscripción en varios idiomas (inglés, español, vietnamita, mandarín, árabe), un solo conjunto de columnas procesa todos ellos.
¿Se aplican los requisitos de HIPAA a los campos médicos de los formularios de inscripción, o los cubre FERPA?
FERPA, no HIPAA, rige la información de salud de los estudiantes que mantiene una escuela. La Regla de Privacidad de HIPAA excluye los "registros educativos cubiertos por FERPA" de su definición de información de salud protegida (45 CFR § 160.103). Esto significa que las condiciones médicas, las descripciones de alergias y los registros de inmunización en un formulario de inscripción están protegidos bajo FERPA en lugar de HIPAA, siempre que la escuela los mantenga como registros educativos. La implicación práctica: el marco de cumplimiento de FERPA (excepción de funcionario escolar, contrato escrito, sin entrenamiento de modelos) cubre tanto los campos médicos como los demográficos. Usted no necesita un análisis separado de HIPAA para la extracción de formularios de inscripción, aunque algunos estados tienen leyes adicionales de privacidad de salud estudiantil que pueden aplicarse.
¿Cómo manejamos los formularios de inscripción que llegan como conjuntos de escaneos de varias páginas con documentación de educación en el hogar o fuera del distrito?
Incluya todas las páginas del escaneo (declaraciones juradas de residencia, documentos de comprobante de domicilio, formularios de notificación de educación en el hogar, órdenes de custodia) como parte del mismo PDF de varias páginas por estudiante. La IA de extracción lee únicamente las páginas y los campos que coinciden con los nombres de columna que usted definió, omitiendo las páginas sin datos de inscripción. Las páginas que no coinciden se ignoran en el resultado de la extracción, pero permanecen como parte del registro del documento. Marcar páginas específicas para la extracción (por ejemplo, "extraer solo de las páginas 1 a 4 de un paquete de 15 páginas") se gestiona a nivel de la definición de columnas en la mayoría de las herramientas de IA semántica.
La extracción de formularios de inscripción de estudiantes no es una decisión tecnológica única. Es una transformación del flujo de trabajo que abarca el escaneo, el diseño de columnas, el procesamiento por lotes, la verificación, la importación al SIS y la documentación de cumplimiento.
El flujo de trabajo de cuatro fases —escanear, definir columnas, procesar el lote y verificar e importar— convierte la pila de paquetes de papel de agosto en una hoja de cálculo estructurada lista para PowerSchool o Infinite Campus. El marco de control de calidad le indica qué campos verificar en cada registro (contactos de emergencia, datos médicos) y qué campos confiar a nivel de lote (casillas de verificación, formularios de consentimiento). El cumplimiento de FERPA (Ley de Derechos Educativos y Privacidad de la Familia) es un requisito previo, no una ocurrencia tardía: un acuerdo institucional firmado con su proveedor de extracción, una prohibición por escrito del entrenamiento de modelos y un calendario de retención documentado.
Pruebe el flujo de trabajo con diez formularios de inscripción de la registración de este año. Si el perfil de precisión coincide con lo descrito aquí, usted tiene su plantilla para cada temporada de inscripción futura.
Gratis para probar sin necesidad de registrarse. Los archivos se procesan de forma transitoria y no se conservan. Pregunte por los acuerdos institucionales compatibles con FERPA para su distrito.