Comment lire une promesse de
précision OCR : 5 questions à poser avant d'acheter
Chaque semaine, quelqu'un qui évalue des outils d'extraction de documents lit la promesse de « précision de 99 % » d'un fournisseur, s'inscrit, téléverse son premier lot de vrais documents — et découvre que la précision réelle est plus proche de 85 %. Il n'a pas été trompé par un mensonge. Il a été trompé par un chiffre qui n'a jamais été conçu pour répondre à la question qu'il se posait vraiment : « Cet outil fonctionnera-t-il sur mes documents ? » L'écart entre la précision annoncée par le fournisseur et les performances réelles n'est pas un accident — c'est le résultat prévisible de la façon dont les promesses de précision sont construites. Et une fois qu'on sait quoi demander, l'écart devient visible avant même d'acheter.
Points clés à retenir
- Les promesses de précision de 99 % excluent les documents désordonnés que vous traitez réellement, car elles sont mesurées sur des scans propres et parfaits dont tous les cas difficiles ont été retirés au préalable.
- La précision au niveau caractère masque le fait que sur une extraction de champs réelle, votre outil pourrait être de 10 à 15 points en dessous du chiffre annoncé.
- Testez 20 de vos propres documents ce soir sur chaque outil présélectionné, car le seul chiffre de précision qui vaut la peine de guider une décision est celui que vous mesurez vous-même.
Pourquoi 99 % signifie moins que ce que vous pensez
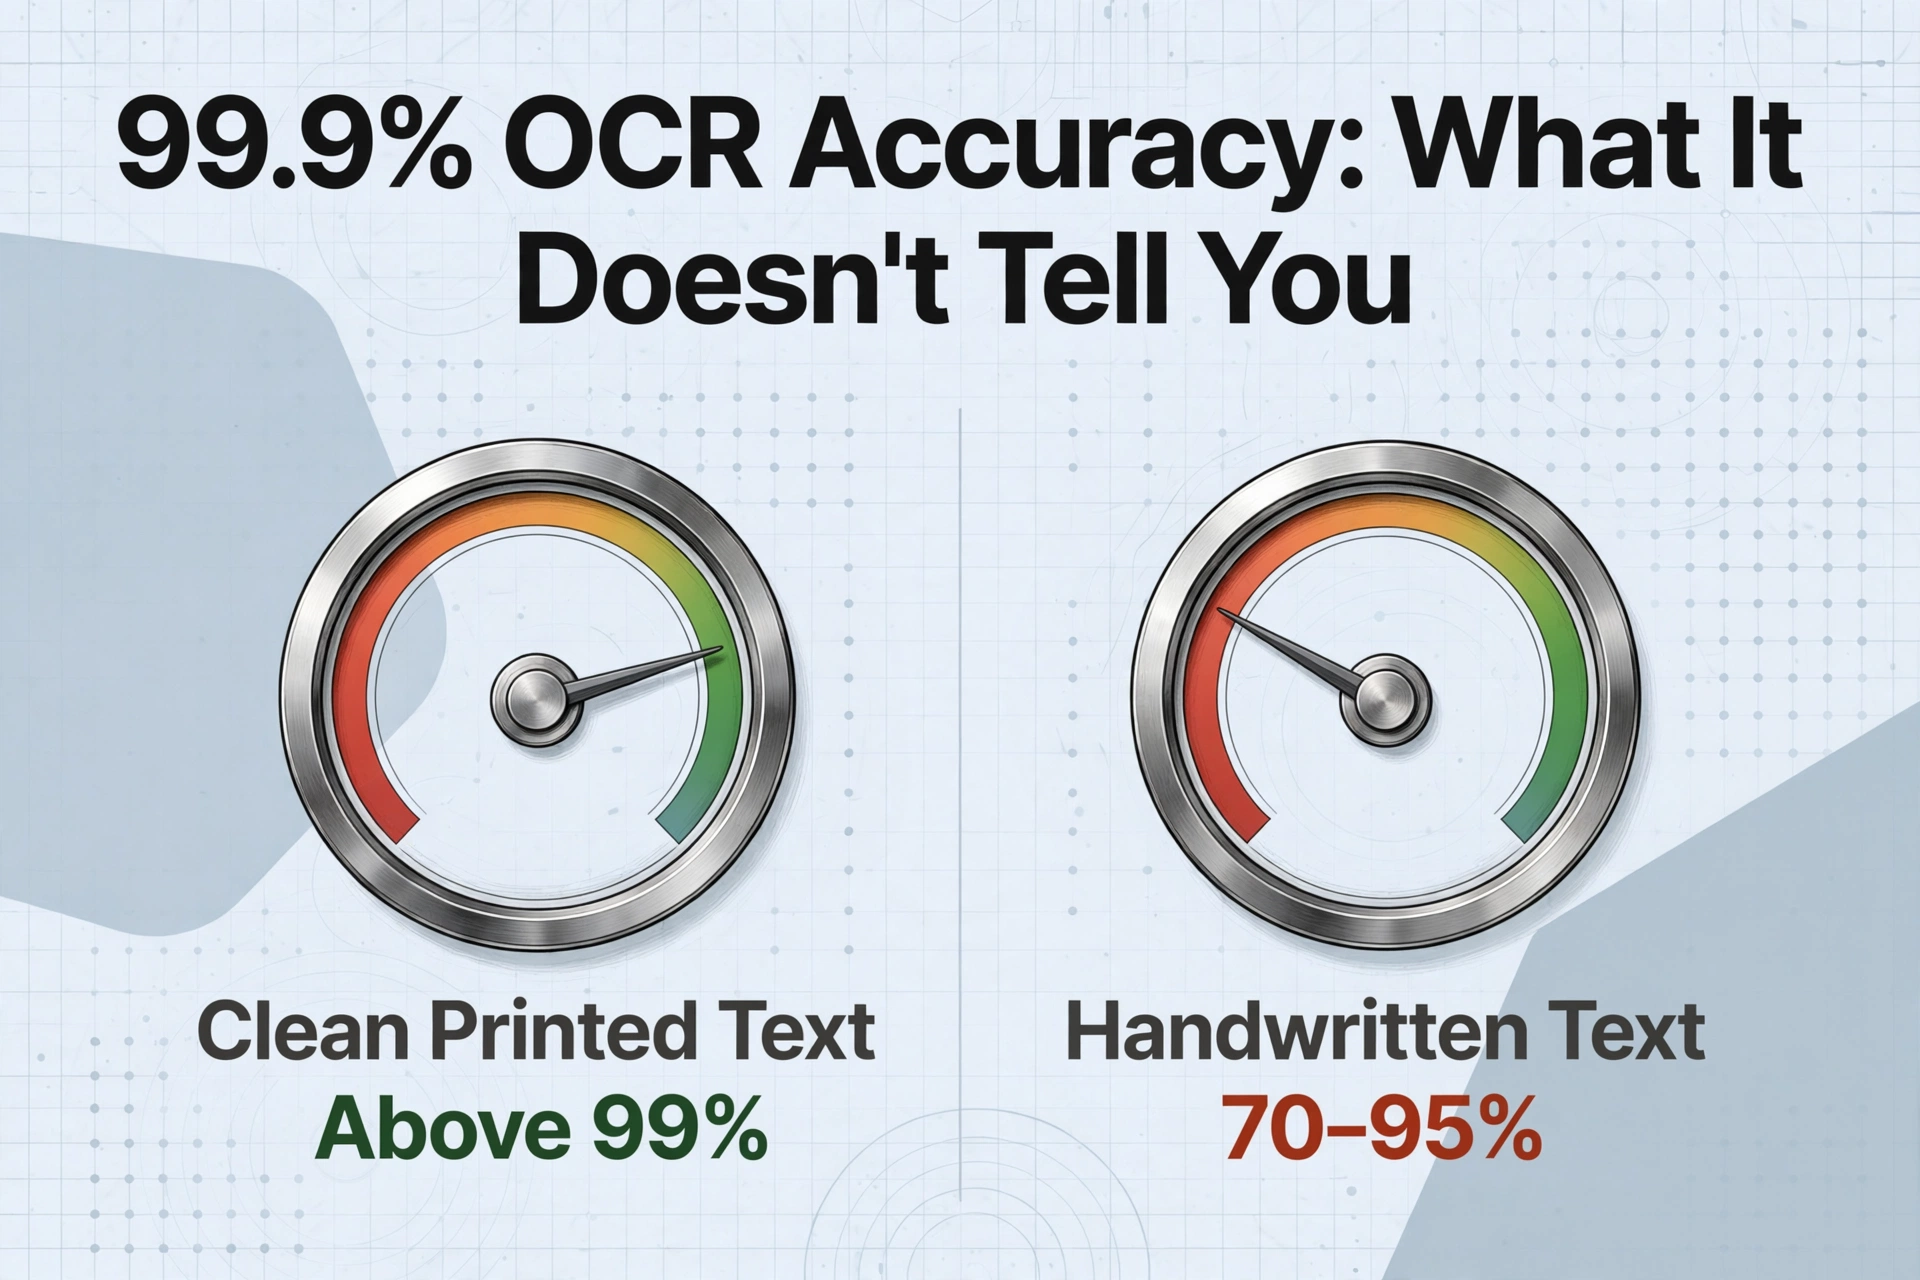
Une page d'accueil typique d'un outil d'extraction de documents pourrait afficher : « Précision OCR de 99,9 % sur les factures. » Le chiffre apparaît à côté d'une icône de coche. Cela ressemble à une preuve. Cela semble de niveau ingénierie. Mais voici ce que cela ne vous dit pas : si ce 99,9 % a été mesuré sur des scans de qualité parfaite issus d'un modèle unique, s'il concerne des caractères ou des champs, et si l'ensemble de test excluait les types de documents que vous traitez réellement.
Des benchmarks indépendants issus du benchmark OCR 2026 d'AIMultiple illustrent l'écart : les principaux services API atteignent plus de 99 % sur du texte imprimé propre, mais chutent à environ 70–95 % sur l'écriture manuscrite selon le moteur — une fourchette assez large pour que deux outils revendiquant 99 % au global puissent différer de 25 points de pourcentage sur vos documents réels. Le chiffre principal ne vous dit pas dans quel camp se trouve un fournisseur, car ce chiffre n'a jamais été conçu pour cela.
Les cinq questions ci-dessous transforment une revendication de précision vague en une évaluation concrète. Posez-les avant d'évaluer, et vous verrez quels fournisseurs ont effectué de vrais tests — et lesquels espèrent que vous ne poserez pas la question.
Q1 : Testé sur quels documents ?
La précision n'est pas une propriété d'un outil. C'est une propriété d'un outil sur un ensemble spécifique de documents. Changez l'ensemble et le chiffre change — parfois radicalement. Un fournisseur qui teste sur des factures uniformes, haute résolution et monolingues rapportera une précision plus élevée qu'un fournisseur qui teste sur un corpus mixte de formulaires manuscrits, de photocopies délavées et de reçus pris en photo avec un téléphone. Les deux chiffres peuvent être vrais. Un seul prédit ce que vous vivrez.
Demandez la composition exacte de l'ensemble de test : combien de documents, de combien de sources, dans combien de langues, à quelle plage de résolution. Si le fournisseur ne peut pas produire cette répartition, le chiffre de précision n'a aucun ancrage. C'est une affirmation sur un ensemble de données inconnu appliquée à un document inconnu — autrement dit, ce n'est pas utile.
C'est aussi le bon moment pour vérifier si l'outil repose sur la correspondance de modèles ou l'OCR zonal, qui échoue lorsque les mises en page varient. Comme nous le détaillons dans ce que signifie réellement la précision OCR, les systèmes basés sur des modèles peuvent bien performer dans leur format entraîné et échouer complètement en dehors — une chose qu'un simple chiffre « 99 % » ne révélera jamais.
Q2 : À quel niveau — caractère, mot ou champ ?
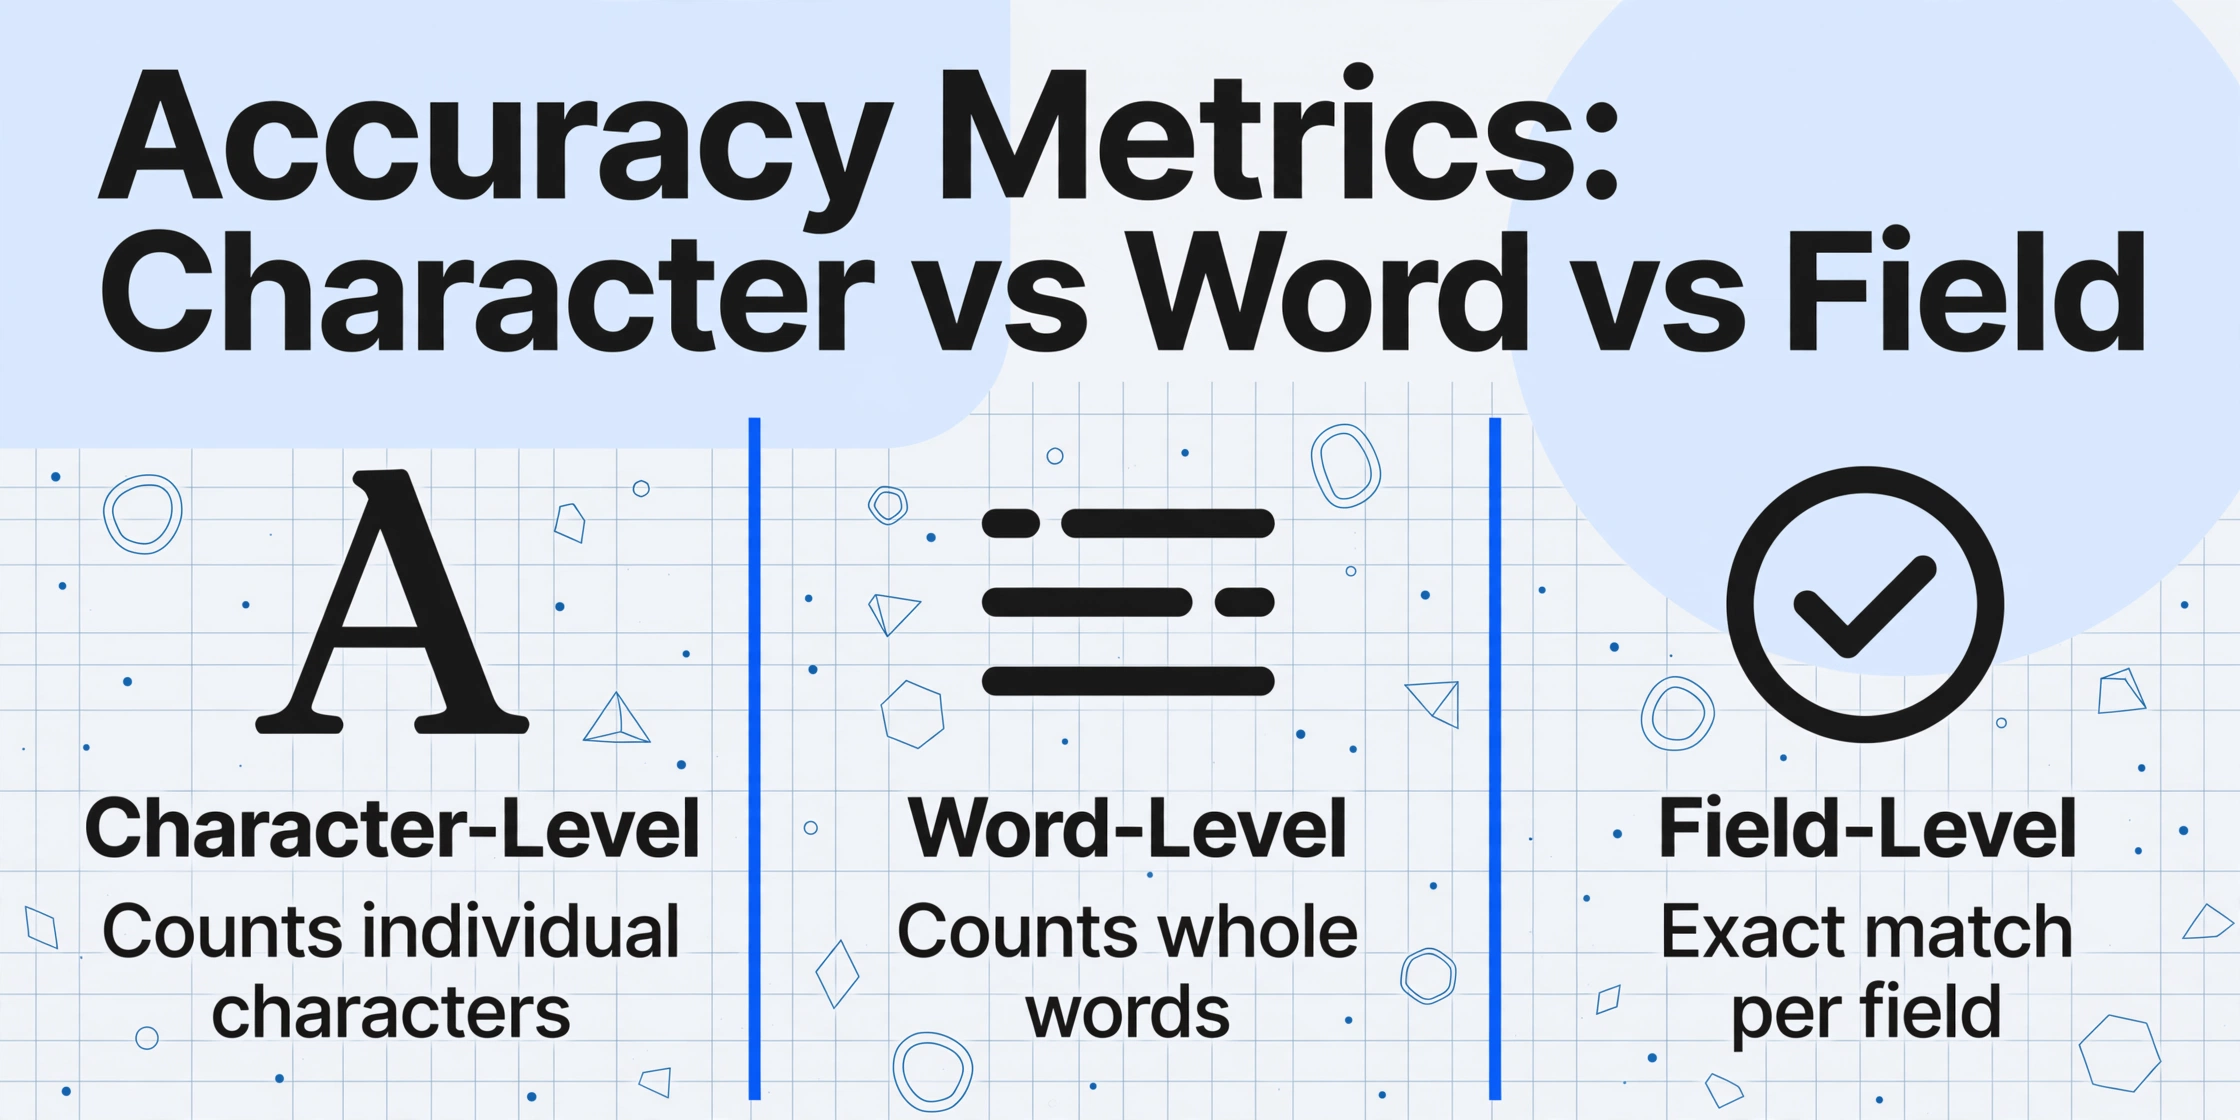
La précision peut être mesurée à trois niveaux, et les fournisseurs ont tendance à rapporter celui qui produit le chiffre le plus élevé.
La précision au niveau caractère (CER) compte combien de caractères individuels le moteur lit correctement. Si un document contient 1 000 caractères et que 990 sont corrects, cela donne 99 % de CER. Ça semble impressionnant. C'est aussi la métrique la moins utile pour toute tâche réelle, car un seul caractère erroné peut détruire la valeur d'un champ entier. Un total de facture de 1 429,50 $ que l'OCR lit comme 1 429,50 $ donne 7 caractères corrects sur 8 — 87,5 % de précision au niveau caractère — mais le champ est complètement faux. Si c'est le total que votre système AP paie, l'erreur coûte de l'argent, peu importe la propreté des autres caractères.
La précision au niveau champ (aussi appelée précision sémantique ou correspondance exacte) mesure si chaque donnée complète — numéro de facture, date d'échéance, montant de ligne — est extraite parfaitement. Un champ est soit correct, soit incorrect. Un seul chiffre mal lu fait échouer tout le champ. C'est la métrique qui correspond aux résultats métier réels. Un benchmark 2026 de l'analyse de précision OCR de LlamaIndex fixe le seuil de précision au niveau champ pour le traitement direct à 99,9 % — soit une erreur pour mille champs. En dessous, la vérification manuelle est inévitable.
La différence entre la précision au niveau caractère et au niveau champ n'est pas théorique. Un outil qui annonce 99 % de précision au niveau caractère peut offrir une précision au niveau champ inférieure à 90 % sur les mêmes documents. Comme nous l'explorons dans pourquoi la précision OCR chute selon le type de document, l'écart se creuse davantage sur les mises en page complexes où une seule limite de tableau mal interprétée brouille tous les champs d'une ligne.
Lorsqu'un fournisseur cite un chiffre de précision, votre première question devrait être : « Est-ce au niveau caractère, mot ou champ ? Et pouvez-vous partager les résultats au niveau champ ventilés par type de document ? »
Q3 : Qu'est-ce qui a été exclu de l'ensemble de test ?
Le document de méthodologie de test d'un fournisseur — celui qu'il publie sur son blog ou inclut dans un livre blanc — contient souvent plus d'informations utiles dans ses critères d'exclusion que dans ses chiffres de précision. Qu'ont-ils délibérément laissé de côté ?
Les exclusions courantes incluent : le texte manuscrit, les documents avec des tampons ou des logos chevauchant les champs de données, les PDF multipages, les photos basse résolution prises au téléphone, les langues autres que l'anglais, et tout document comportant des annotations ou des corrections dans les marges. Chaque exclusion réduit l'applicabilité de la précision annoncée. Un chiffre de 99 % qui exclut l'écriture manuscrite n'apporte rien si votre flux de travail inclut des bons de livraison manuscrits — et comme nous le détaillons dans la réalité de la précision OCR sur l'écriture manuscrite, l'écart entre la précision sur texte imprimé et sur texte manuscrit peut atteindre 20 points de pourcentage ou plus sur un même moteur. Un benchmark qui exclut les documents multilingues ne vous apprend rien sur la façon dont l'outil gérera une facture bilingue.
Une exclusion particulièrement importante concerne le traitement des images pivotées, inclinées ou à faible contraste. Les moteurs OCR traditionnels sont fragiles sur ces entrées. Comme le note notre comparaison des logiciels OCR 2026, certains outils appliquent des pipelines de prétraitement qui normalisent la qualité de l'image avant la reconnaissance — mais beaucoup ne le font pas, et leurs affirmations de précision supposent implicitement que l'entrée est déjà propre.
Demandez directement : « Quels types de documents, niveaux de qualité et conditions avez-vous exclus, et pouvez-vous partager les résultats de précision spécifiquement sur les types de documents que vous avez exclus ? » La réponse vous en apprendra plus que le chiffre principal.
Q4 : Quelle tolérance d'erreur a été appliquée ?
Même au niveau champ, il existe une variable moins évidente : à quel point une valeur doit-elle être proche pour être considérée comme « correcte » ? Certains fournisseurs comptent un champ comme précis si la valeur extraite correspond après une normalisation de formatage mineure — suppression de la ponctuation, standardisation des formats de date, ignorance des zéros non significatifs. C'est raisonnable. Mais d'autres vont plus loin : compter un champ numérique comme correct s'il se situe dans un certain pourcentage de la vérité terrain, accepter un champ si une sous-chaîne correspond, ou traiter un nombre écrit en toutes lettres comme équivalent à sa forme numérique.
Ces tolérances ne sont pas nécessairement mauvaises. Certaines applications ne se soucient vraiment pas de savoir si une date est formatée MM/JJ/AAAA ou AAAA-MM-JJ. Le problème est que la tolérance n'est presque jamais divulguée en même temps que le chiffre de précision. Un chiffre de 98 % au niveau champ qui autorise une variance de 5 % sur les montants en dollars signifie quelque chose de très différent d'un chiffre de 98 % qui exige une correspondance exacte caractère par caractère sur chaque champ.
C'est particulièrement pertinent pour les champs numériques comme les totaux, les quantités et les montants de taxe — les champs où la précision compte le plus et où un seul chiffre erroné crée un casse-tête de rapprochement. Si un outil annonce 99 % de précision au niveau champ sur les totaux de factures mais considère 1 429,50 $ et 1 429,00 $ comme une correspondance parce que la différence se situe dans une bande de tolérance de 1 %, alors la précision réelle de correspondance exacte est inférieure à ce qui est annoncé.
Demandez : « Qu'est-ce qui compte exactement comme une extraction correcte ? Les correspondances approximatives sont-elles comptées comme correctes ? À quel seuil ? »
Q5 : Quelle est la précision sur des documents similaires aux vôtres ?
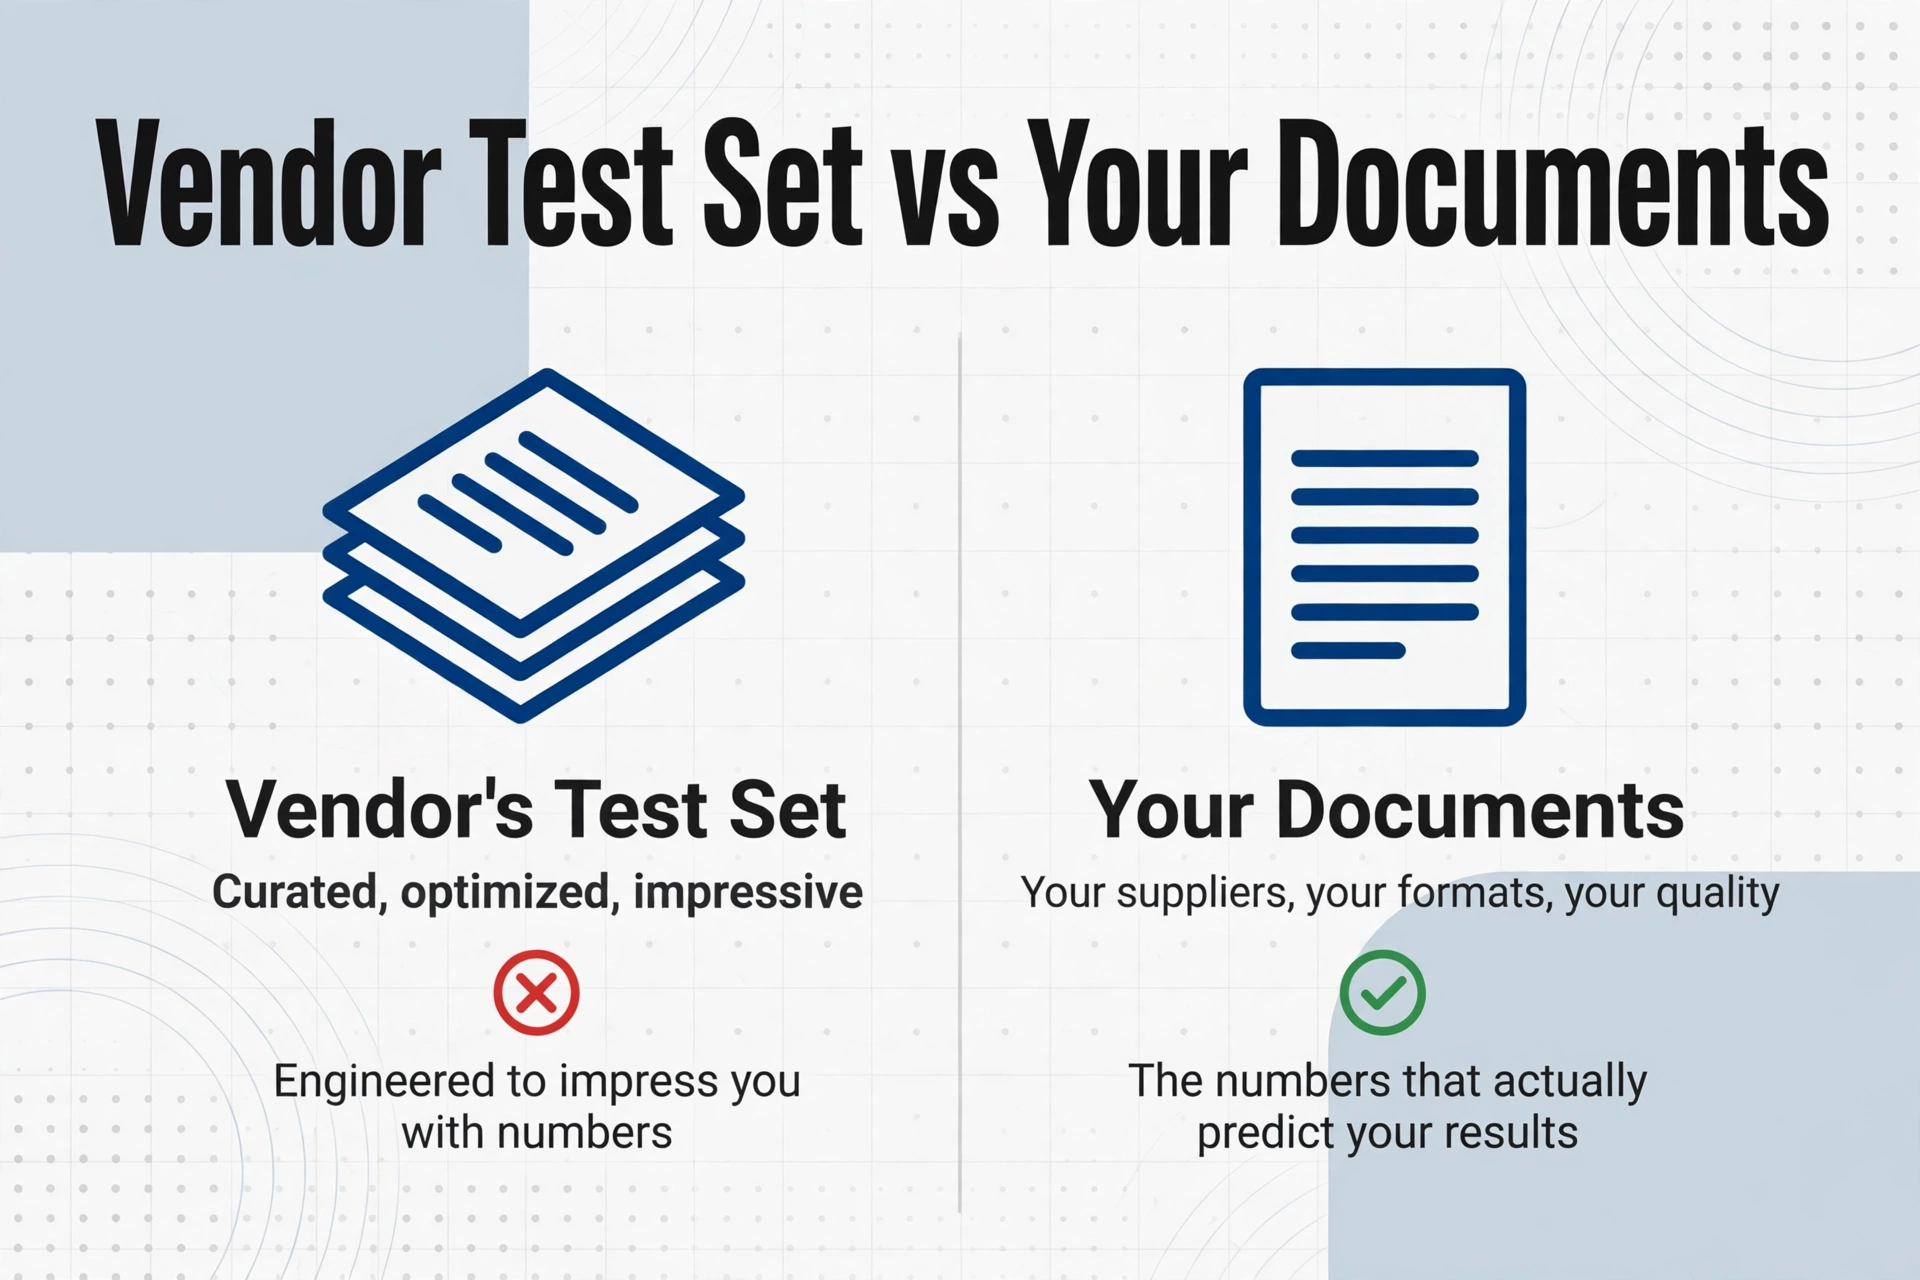
C'est la seule question qui compte vraiment, et c'est celle que la plupart des acheteurs sautent. Le jeu de test d'un fournisseur contient ses documents — ceux qu'il a choisis, organisés et optimisés. Vos documents contiennent vos fournisseurs, vos clients, vos formats, votre qualité d'image, vos types de champs. Ce sont des choses différentes.
Voici un test pratique : préparez un échantillon de 20 à 50 documents représentant la gamme de qualité et de variété que votre équipe rencontre réellement. Envoyez le même ensemble à chaque fournisseur que vous évaluez. Mesurez la précision au niveau champ sur les champs spécifiques qui vous intéressent — total de facture, numéro de bon de commande, descriptions de lignes — et non sur du texte sans rapport avec votre flux de travail. Comparez les résultats côte à côte.
Tout fournisseur qui refuse une évaluation en aveugle sur vos documents, ou qui propose uniquement une démo organisée avec ses propres échantillons, vous donne un chiffre conçu pour impressionner — pas pour prédire votre résultat. Un fournisseur qui accueille votre jeu de test et partage où son outil réussit et où il échoue vous dit la vérité.
C'est aussi là que le paradigme d'extraction sous-jacent compte. Les outils OCR traditionnels et les systèmes basés sur des modèles exigent que vous les entraîniez ou les configuriez pour chaque nouveau format. Les outils basés sur des modèles de vision-langage comme ImageToTable.ai sont sans modèle et indépendants du format : ils lisent les documents en comprenant la signification des champs plutôt que leur position sur la page, ce qui signifie qu'une seule configuration fonctionne sur toutes les mises en page. La précision que vous mesurez sur votre échantillon de test est celle que vous obtiendrez en production — aucun réglage spécifique au format requis.
FAQ
Quel est un bon taux de précision OCR ?
Un bon taux dépend de ce que vous extrayez et de ce que vous considérez comme une erreur. Pour du texte imprimé propre, une précision au niveau champ supérieure à 97 % est réalisable avec la plupart des outils modernes. Pour des documents manuscrits, une précision au niveau champ de 90 à 95 % est réaliste avec les meilleurs moteurs. La réponse la plus honnête : testez sur vos documents et fixez votre propre référence. Il n'existe pas de taux « bon » universel.
Pourquoi les fournisseurs utilisent-ils la précision au niveau caractère si elle est trompeuse ?
Parce que c'est le chiffre le plus élevé qu'ils peuvent produire. La précision au niveau caractère profite de la moyenne : un chiffre erroné sur un total de 8 caractères plus une lettre erronée dans un code devise de 4 caractères donne une précision caractère de 84 % sur ces deux champs. Mais si vous tenez à ce que le total et le code devise soient corrects, les deux champs sont faux à 100 %. Les fournisseurs rapportent la métrique qui fait le mieux paraître leur produit — et la pression des acheteurs ne les a pas encore forcés à standardiser sur le reporting au niveau champ.
Puis-je faire confiance aux benchmarks OCR indépendants ?
Oui, avec une réserve : assurez-vous que le benchmark a testé des types de documents similaires aux vôtres. Un benchmark indépendant comme le DeltOCR Bench d'AIMultiple ou l'OCRBench open-source fournit des comparaisons neutres, mais la combinaison de documents peut ne pas correspondre à votre flux de travail. Utilisez les benchmarks comme filtre de présélection, puis testez les finalistes sur vos propres documents.
Une précision plus élevée signifie-t-elle toujours un meilleur outil ?
Non. La précision n'est qu'une dimension. Un outil qui atteint 99,5 % de précision au niveau champ sur les factures mais qui exige dix échantillons d'entraînement par modèle, casse quand un fournisseur change sa mise en page et nécessite une maintenance continue par un ingénieur d'intégration peut être moins précieux en pratique qu'un outil qui offre 97 % de précision dès le premier jour sur tous les formats sans configuration. L'effort de mise en place, le coût de maintenance et l'étendue du support documentaire comptent souvent plus que les deux derniers points de pourcentage de précision.
Que faire ensuite
Les affirmations de précision ne sont pas inutiles — elles sont simplement incomplètes. Un fournisseur qui répond clairement aux cinq questions, partage des résultats au niveau champ par type de document, divulgue les exclusions et tolérances et vous invite à tester sur vos propres documents est un fournisseur à prendre au sérieux. Un fournisseur qui esquive, vous redirige vers une étude de cas ou n'offre qu'une démo sélectionnée vous dit aussi quelque chose — écoutez-le.
Prenez l'heure qui vient pour rassembler un échantillon des documents que votre équipe traite le plus souvent. Passez-les dans les outils de votre liste restreinte. Mesurez la précision au niveau champ sur les champs qui comptent pour votre flux de travail — pas sur chaque caractère de la page. Le chiffre que vous obtiendrez sera inférieur à l'affirmation marketing. Mais ce sera votre chiffre, et c'est le seul qui vaille la peine de prendre une décision.