OCR精度の
主張の読み方:購入前に確認すべき5つの質問
毎週、文書抽出ツールを評価している誰かが、ベンダーの「99%精度」という主張を読み、サインアップし、実際の文書の最初のバッチをアップロードして、実際の精度が85%に近いことに気づきます。 彼らは嘘に惑わされたのではありません。彼らが実際に問いかけていた質問「このツールは私の文書で機能するのか?」に答えるために設計されたことのない数字に惑わされたのです。ベンダーが報告する精度と実際のパフォーマンスのギャップは偶然ではありません。それは精度の主張がどのように構築されるかの予測可能な結果です。そして、何を尋ねるべきかを知れば、購入前にそのギャップが見えるようになります。
重要なポイント
- 99%の精度の主張は、難しいケースをすべて事前に除外した完璧なクリーンなスキャンで測定されているため、あなたが実際に処理する複雑な文書を除外しています。
- 文字レベル精度は、実際のフィールド抽出では、見出しの数字より10〜15ポイント低くなる可能性があるという事実を隠しています。
- 今夜、候補に挙がったすべてのツールで、あなた自身の文書を20件テストしてください。意思決定に値する唯一の精度の数字は、あなた自身が測定したものだからです。
99%が思うほど意味を持たない理由
ドキュメント抽出ツールの典型的なランディングページには「請求書のOCR精度99.9%」と書かれているかもしれません。その数字はチェックマークアイコンの隣に表示されています。証拠のように見えます。エンジニアリング品質のように見えます。しかし、そこからわからないのは次のことです:その99.9%が単一テンプレートの完璧な品質のスキャンで測定されたものなのか、文字を指すのかフィールドを指すのか、そしてテストセットから実際に処理するドキュメントタイプが除外されていないかどうか。
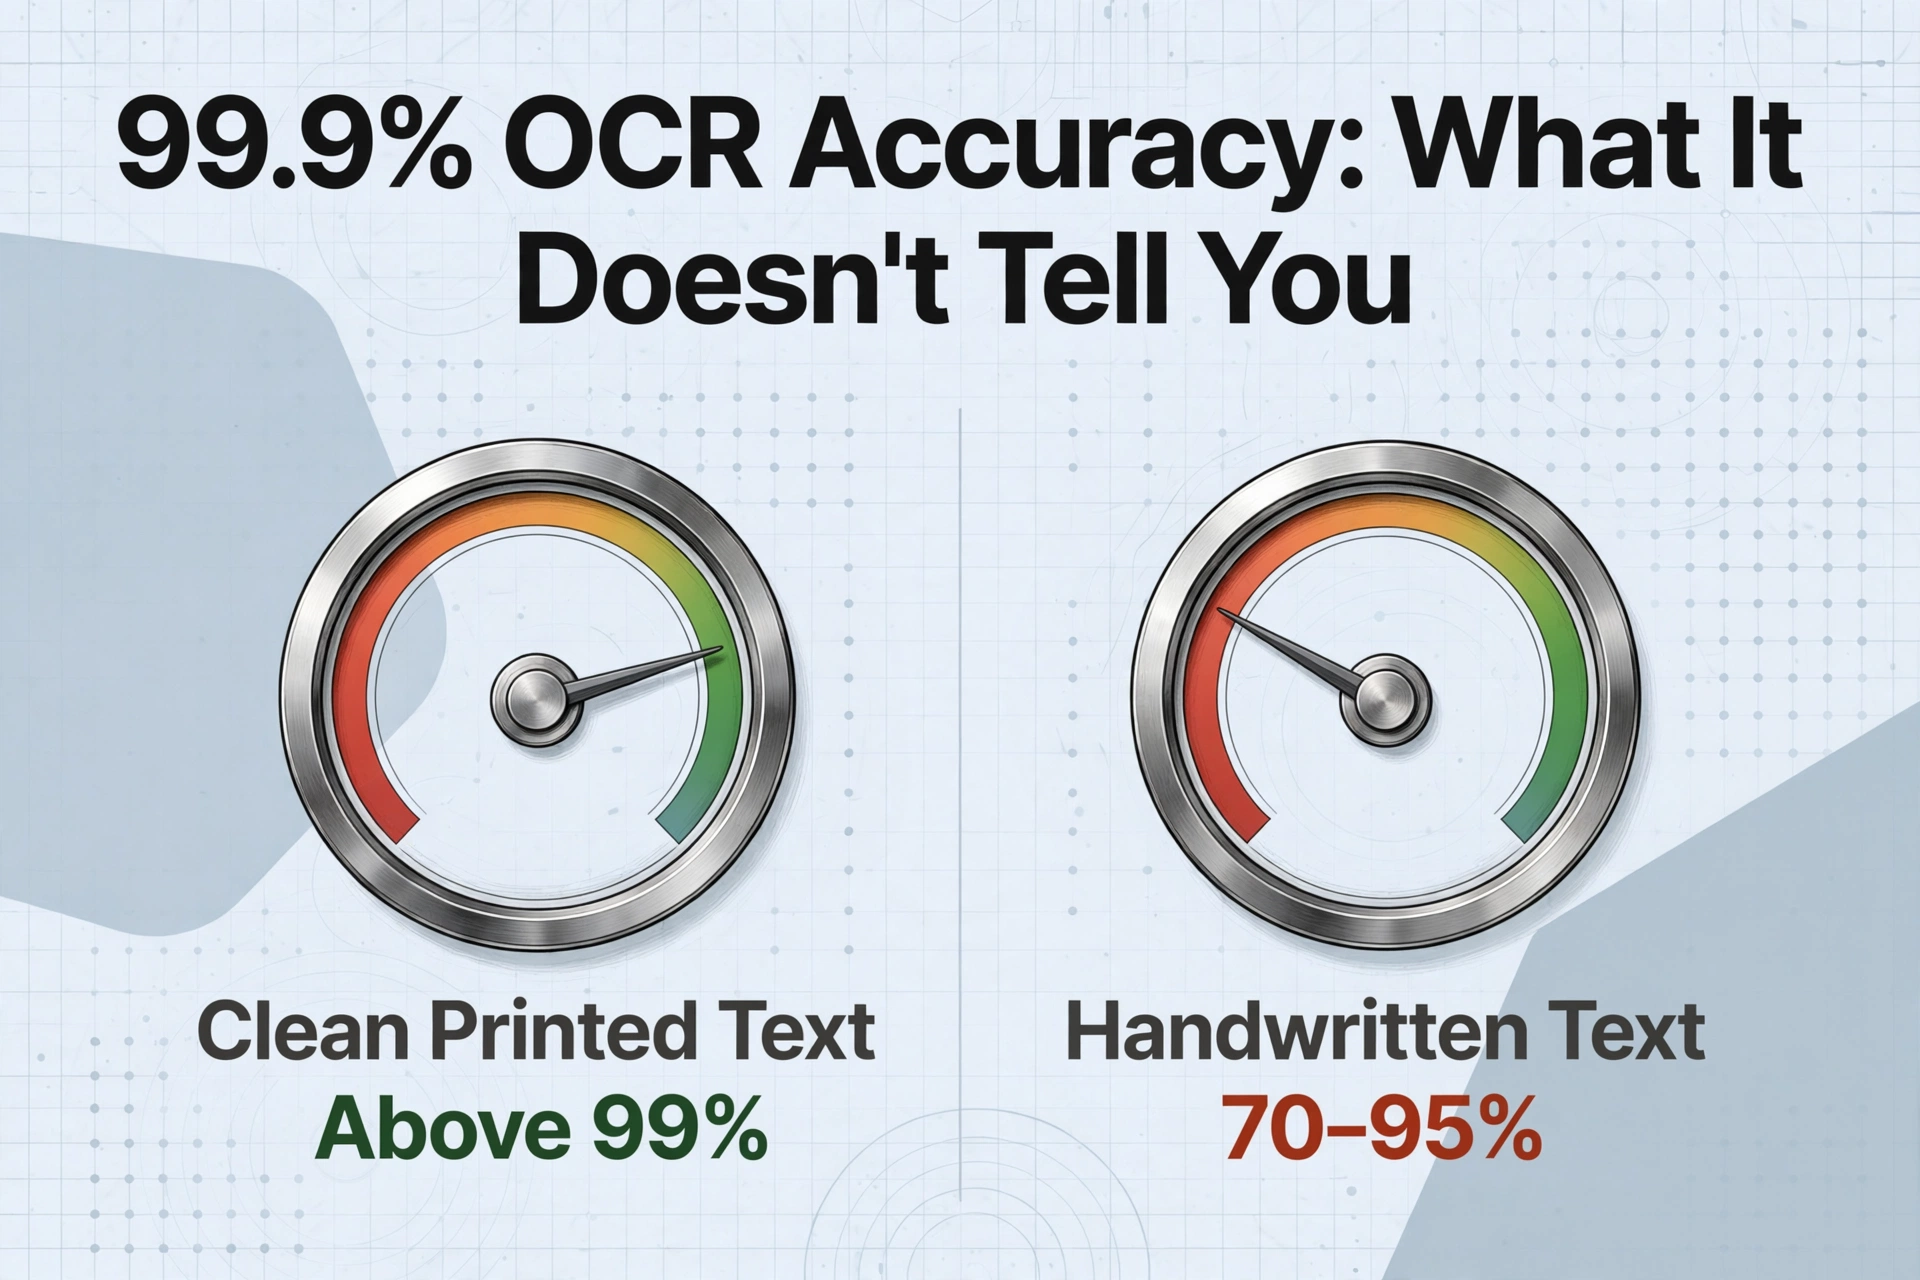
AIMultipleの2026年OCRベンチマークによる独立した評価はそのギャップを示しています:主要なAPIサービスはクリーンな印刷テキストでは99%以上を達成しますが、手書きではエンジンによって約70〜95%に低下します。これは、全体で99%を主張する2つのツールが、実際のドキュメントでは25パーセントポイントも異なる可能性があるほど広い範囲です。見出しの数字は、ベンダーがどちらの陣営に属するかを教えてくれません。なぜなら、その見出しの数字はそもそもそのために作られたものではないからです。
以下の5つの質問は、曖昧な精度の主張を具体的な評価に変えます。評価する前にそれらを尋ねれば、どのベンダーが実際のテストを行っているか、そしてどれがあなたに質問してほしくないと思っているかがわかります。
Q1: どのドキュメントでテストされたか?
精度はツールの特性ではありません。それは特定のドキュメントセットに対するツールの特性です。セットを変えれば数字も変わります—時には劇的に。均一で高解像度の単一言語の請求書でテストするベンダーは、手書きフォーム、色あせたコピー、スマホカメラで撮影したレシートの混在コーパスでテストするベンダーよりも高い精度を報告します。両方の数字が真実であり得ます。あなたが経験することを予測するのは片方だけです。
テストセットの正確な構成を尋ねてください:ドキュメント数、ソース数、言語数、解像度の範囲。ベンダーがこの内訳を提示できない場合、精度の数字には根拠がありません。それは未知のデータセットに適用された未知のドキュメントに関する主張であり、つまり役に立たないのです。
これはまた、ツールがテンプレートマッチングやゾーンOCRに依存していないかを確認する適切なタイミングでもあります。レイアウトが変わるとそれらは機能しなくなります。OCR精度が実際に何を意味するかで説明しているように、テンプレートベースのシステムはトレーニングされた形式内では良好に機能しますが、その外では完全に失敗します—単一の「99%」という数字では決して明らかにならないことです。
Q2: どのレベルで評価するのか — 文字、単語、それともフィールド?
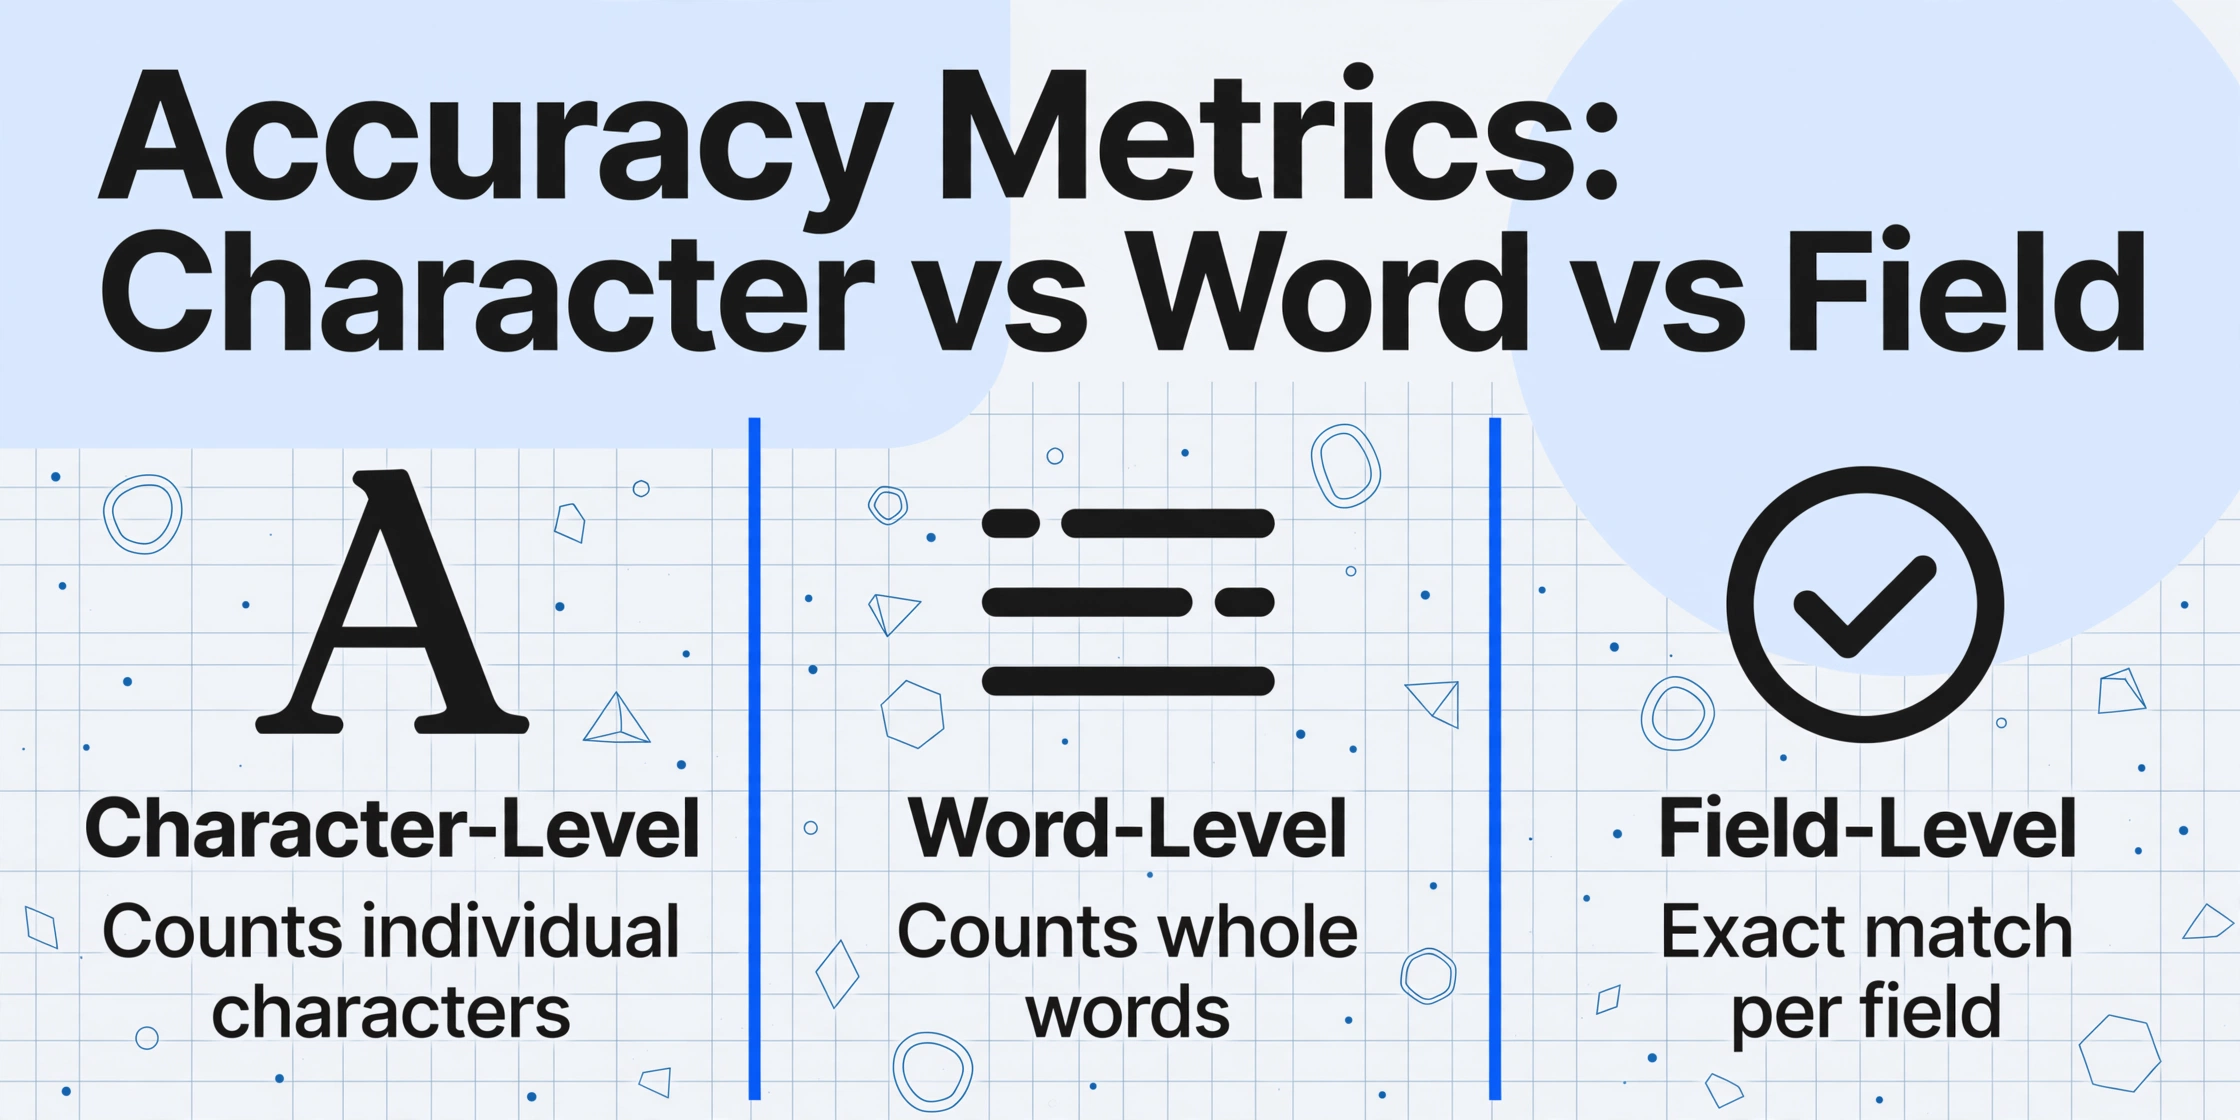
精度は3つのレベルで測定でき、ベンダーは最も高い数値が出るものを報告する傾向があります。
文字レベル精度 (CER) は、エンジンが正しく読み取った個々の文字数を数えます。ドキュメントに1,000文字あり、990文字が正しければ、CERは99%です。印象的に聞こえますが、実際の業務においては最も役に立たない指標でもあります。なぜなら、1文字の誤りがフィールド全体の価値を損なう可能性があるからです。請求書の合計金額 $1,429.50 を OCR が $1,429.50 と読み取った場合、8文字中7文字が正しい — 文字精度87.5% — ですが、フィールドは完全に間違っています。それがあなたのAPシステムが支払う合計金額であれば、他の文字がどれだけ正確でも、その誤りはコストになります。
フィールドレベル精度(セマンティック精度または完全一致精度とも呼ばれます)は、請求書番号、期日、明細金額などの各データポイント全体が完全に抽出されるかどうかを測定します。フィールドは正しいか正しくないかのどちらかです。1桁の読み間違いでフィールド全体が失敗します。これが実際のビジネス成果に直結する指標です。LlamaIndexのOCR精度分析による2026年のベンチマークでは、ストレートスルー処理のフィールドレベル精度の閾値を99.9% — つまりフィールド1,000件あたり1件の誤り — としています。これを下回ると、手動レビューが避けられません。
文字レベル精度とフィールドレベル精度の違いは理論上の話ではありません。文字精度99%を報告するツールでも、同じドキュメントではフィールド精度が90%を下回る場合があります。OCR精度がドキュメントタイプによって低下する理由で詳しく説明するように、複雑なレイアウトでは、テーブル境界の1つの誤解釈が行内のすべてのフィールドを混乱させ、その差はさらに広がります。
ベンダーが精度の数値を提示した場合、最初に確認すべきことは次のとおりです。「それは文字レベル、単語レベル、それともフィールドレベルですか?また、ドキュメントタイプ別のフィールドレベル結果を共有していただけますか?」
Q3: テストセットから除外されたものは?
ベンダーのテスト方法論ドキュメント(ブログやホワイトペーパーに掲載されるもの)には、精度の数値よりも除外基準に有用な情報が含まれていることがよくあります。彼らは意図的に何を除外したのでしょうか?
一般的な除外項目には、手書き文字、データフィールドに重なるスタンプやロゴのあるドキュメント、マルチページPDF、低解像度の携帯電話写真、非英語言語、余白に注釈や修正のあるドキュメントが含まれます。それぞれの除外は、報告された精度の適用範囲を狭めます。手書きを除外した99%という数値は、あなたのワークフローに手書きの納品書が含まれる場合には意味がありません。OCR手書き精度の現実で詳述しているように、同じエンジンでも印刷文字と手書き文字の精度差は20ポイント以上になることがあります。多言語ドキュメントを除外したベンチマークは、ツールがバイリンガル請求書をどう処理するかについて何も教えてくれません。
特に重要な除外項目は、回転、傾き、低コントラストの画像の扱いです。従来のOCRエンジンはこれらの入力に弱いです。2026年OCRソフトウェア比較で指摘しているように、一部のツールは認識前に画像品質を正規化する前処理パイプラインを適用しますが、多くは適用せず、その精度の主張は入力がすでにクリーンであることを暗黙に前提としています。
直接尋ねてください:「どのドキュメントタイプ、品質レベル、条件を除外しましたか?また、除外したドキュメントタイプに特化した精度結果を共有できますか?」その答えは、見出しの数字よりも多くのことを教えてくれます。
Q4: どのようなエラートレランスが適用されたか?
フィールドレベルでも、あまり明らかでない変数があります:値が「正しい」とみなされるにはどの程度近い必要があるのでしょうか?一部のベンダーは、軽微なフォーマット正規化(句読点の除去、日付形式の標準化、先頭のゼロの無視)後に抽出値が一致すればフィールドを正確と数えます。それは合理的です。しかし、さらに進むベンダーもいます:数値フィールドがグラウンドトゥルースの一定割合以内であれば正しいと数えたり、部分文字列が一致すればフィールドを受け入れたり、数字のスペルアウト形式を数字形式と同等とみなしたりします。
これらのトレランスは必ずしも間違っていません。日付がMM/DD/YYYYかYYYY-MM-DDか気にしないアプリケーションもあります。問題は、トレランスが精度の数値と一緒に開示されることがほとんどないことです。ドル金額に5%の変動を許容する98%のフィールドレベル精度は、すべてのフィールドで文字単位の完全一致を要求する98%とは大きく異なる意味を持ちます。
これは、合計、数量、税額などの数値フィールドで特に重要です。精度が最も重要で、1桁の誤りでも照合の頭痛の種になるフィールドです。ツールが請求書合計で99%のフィールド精度を報告しているが、$1,429.50と$1,429.00を1%のトレランス帯内の差として一致と数えている場合、実際の完全一致精度は宣伝されているものより低くなります。
尋ねてください:「正確な抽出とみなされるものは具体的に何ですか?近似一致は正しいと数えられますか?そのしきい値は何ですか?」
Q5: あなたの書類に似た書類での精度は?
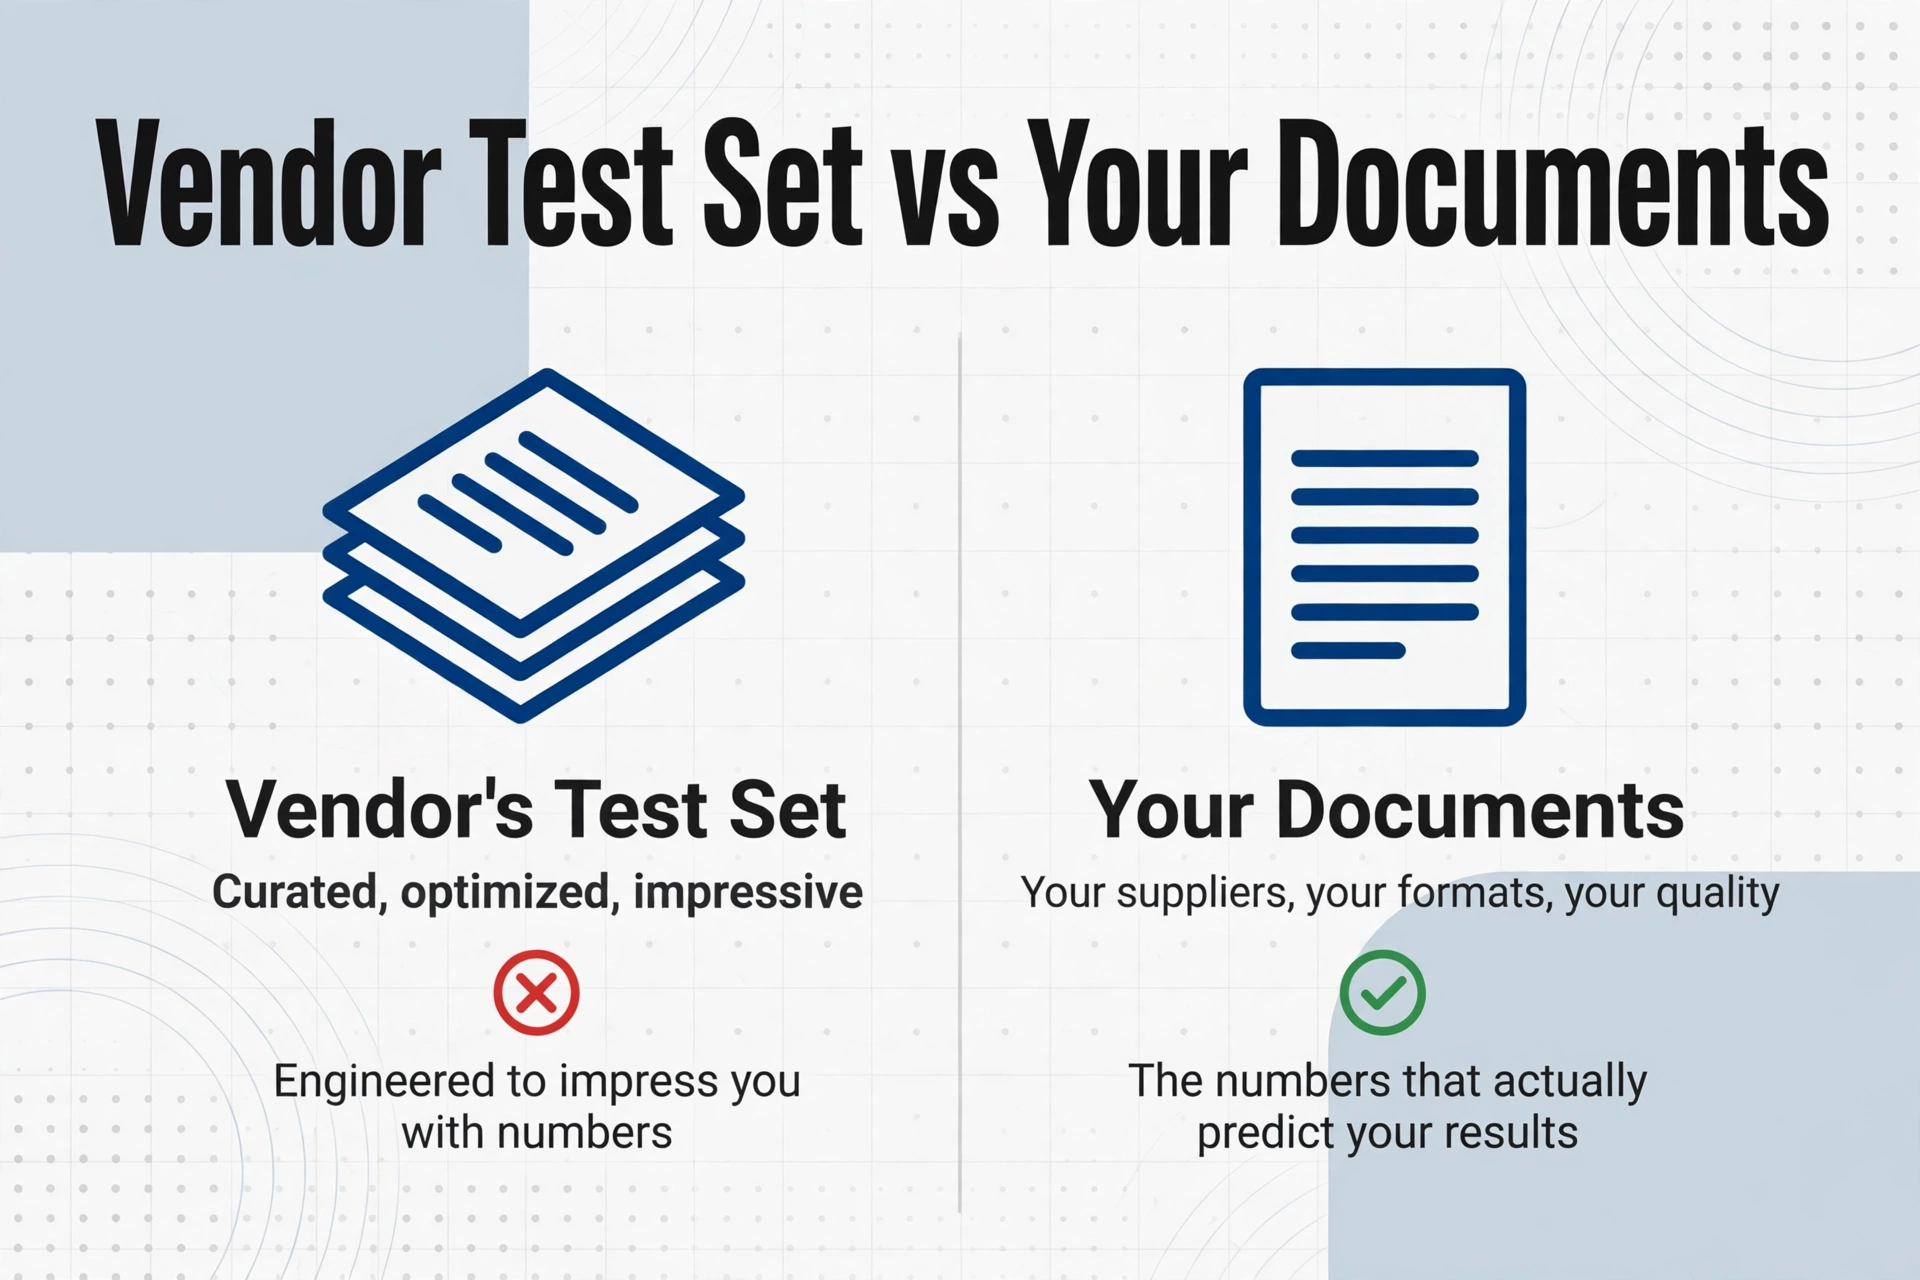
これは最終的に最も重要となる唯一の質問であり、ほとんどの購入者が飛ばしてしまう質問でもあります。ベンダーのテストセットには、彼らが選び、厳選し、最適化した自社の書類が含まれています。あなたの書類には、あなたの取引先、顧客、フォーマット、画像品質、フィールドタイプが含まれています。これらは別物です。
実用的なテストをご紹介します。あなたのチームが実際に遭遇する品質と多様性の範囲を代表する20〜50件の書類サンプルを用意してください。同じセットを評価中のすべてのベンダーに送信してください。請求書合計、発注書番号、明細項目の説明など、あなたのワークフローに関連する特定のフィールドについてフィールドレベル精度を測定してください。ワークフローに関係のないテキストではなく、です。結果を並べて比較してください。
あなたの書類でのブラインド評価を拒否するベンダー、または自社サンプルを使った厳選デモのみを提供するベンダーは、あなたの成果を予測するために設計された数字ではなく、印象づけるために作られた数字を提供しているのです。あなたのテストセットを歓迎し、自社ツールが得意な点と苦手な点を共有するベンダーは、真実を伝えています。
ここで、基盤となる抽出パラダイムが重要になります。従来のOCRツールやテンプレートベースのシステムでは、新しいフォーマットごとにトレーニングや設定が必要です。ImageToTable.aiのようなビジョン言語モデルベースのツールはテンプレート不要でフォーマット非依存です。ページ上の位置ではなくフィールドの意味を理解して書類を読み取るため、単一の設定でさまざまなレイアウトに対応できます。テストサンプルで測定した精度が、本番環境で得られる精度です。フォーマット固有の調整は不要です。
よくある質問
良いOCR精度の数値とはどのくらいですか?
良い数値は、何を抽出しているか、何をエラーとみなすかによって異なります。きれいな印刷テキストの場合、フィールドレベル精度97%以上が最新のツールの多くで達成可能です。手書き文書の場合、トップエンジンでフィールドレベル精度90〜95%が現実的です。最も正直な答えは、あなたの文書でテストし、独自の基準を設定することです。普遍的な「良い」数値は存在しません。
なぜベンダーは誤解を招く文字レベル精度を使用するのですか?
それが彼らが提示できる最大の数値だからです。文字レベル精度は平均化の恩恵を受けます。8文字の合計の1桁の誤りと4文字の通貨コードの1文字の誤りで、これら2つのフィールドの文字精度は84%になります。しかし、合計と通貨コードが正しいことを重視するなら、両方のフィールドは100%間違っています。ベンダーは自社製品を最も良く見せる指標を報告します。そして、購入者からの圧力がフィールドレベル報告への標準化をまだ強制していないのです。
独立したOCRベンチマークを信頼できますか?
はい、ただし1つの注意点があります。ベンチマークがあなたの文書タイプに類似した文書タイプでテストされていることを確認してください。AIMultipleのDeltOCR BenchやオープンソースのOCRBenchのような独立したベンチマークは中立的な比較を提供しますが、文書の構成があなたのワークフローと一致しない場合があります。ベンチマークを候補絞り込みのフィルターとして使用し、最終候補をあなた自身の文書でテストしてください。
精度が高いほど常に優れたツールですか?
いいえ。精度は一つの側面にすぎません。請求書でフィールド精度99.5%を達成するが、テンプレートごとに10個のトレーニングサンプルを必要とし、サプライヤーがレイアウトを変更すると壊れ、統合エンジニアによる継続的なメンテナンスが必要なツールは、初日からあらゆるフォーマットでセットアップ不要で97%の精度を提供するツールよりも実際には価値が低い場合があります。セットアップの手間、メンテナンスコスト、文書サポートの幅は、最後の2パーセントポイントの精度よりも重要であることが多いです。
次のステップ
精度の主張は役に立たないわけではありません。ただ不完全なだけです。5つの質問すべてに明確に答え、文書タイプ別のフィールドレベル結果を共有し、除外事項と許容範囲を開示し、あなた自身の文書でテストするよう招待するベンダーは、真剣に検討する価値があります。回避したり、ケーススタディに誘導したり、厳選されたデモのみを提供するベンダーも何かを伝えています。それに耳を傾けてください。
次の1時間で、あなたのチームが最も頻繁に処理する文書のサンプルセットをまとめてください。候補リストのツールでそれらを実行してください。ワークフローに重要なフィールドでフィールドレベル精度を測定してください。ページ上のすべての文字ではなく。得られる数値はマーケティングの主張よりも低くなるでしょう。しかし、それはあなたの数値であり、意思決定に値する唯一のものです。