So lesen Sie eine OCR
Genauigkeitsangabe: 5 Fragen vor dem Kauf
Jede Woche liest jemand, der Dokumentextraktions-Tools evaluiert, die Angabe „99 % Genauigkeit" eines Anbieters, meldet sich an, lädt seinen ersten Stapel echter Dokumente hoch – und stellt fest, dass die tatsächliche Genauigkeit eher bei 85 % liegt. Diese Person wurde nicht durch eine Lüge getäuscht, sondern durch eine Zahl, die nie dafür gedacht war, die Frage zu beantworten, die sie eigentlich stellte: „Funktioniert dieses Tool mit meinen Dokumenten?" Die Kluft zwischen der vom Anbieter angegebenen Genauigkeit und der realen Leistung ist kein Zufall – sie ist das vorhersehbare Ergebnis davon, wie Genauigkeitsangaben konstruiert werden. Und sobald Sie wissen, was Sie fragen müssen, wird diese Kluft sichtbar, bevor Sie kaufen.
Die wichtigsten Erkenntnisse
- Angaben von 99 % Genauigkeit schließen die unordentlichen Dokumente aus, die Sie tatsächlich verarbeiten, weil sie an sauberen, perfekten Scans gemessen werden, aus denen zuvor alle schwierigen Fälle entfernt wurden.
- Die Genauigkeit auf Zeichenebene verschleiert die Tatsache, dass Ihr Tool bei der realen Feldextraktion 10 bis 15 Prozentpunkte unter der Schlagzeilenzahl liegen kann.
- Testen Sie noch heute Abend 20 Ihrer eigenen Dokumente mit jedem in die engere Wahl gezogenen Tool, denn die einzige Genauigkeitszahl, auf deren Grundlage Sie eine Entscheidung treffen sollten, ist die, die Sie selbst messen.
Warum 99 % weniger aussagen, als Sie denken
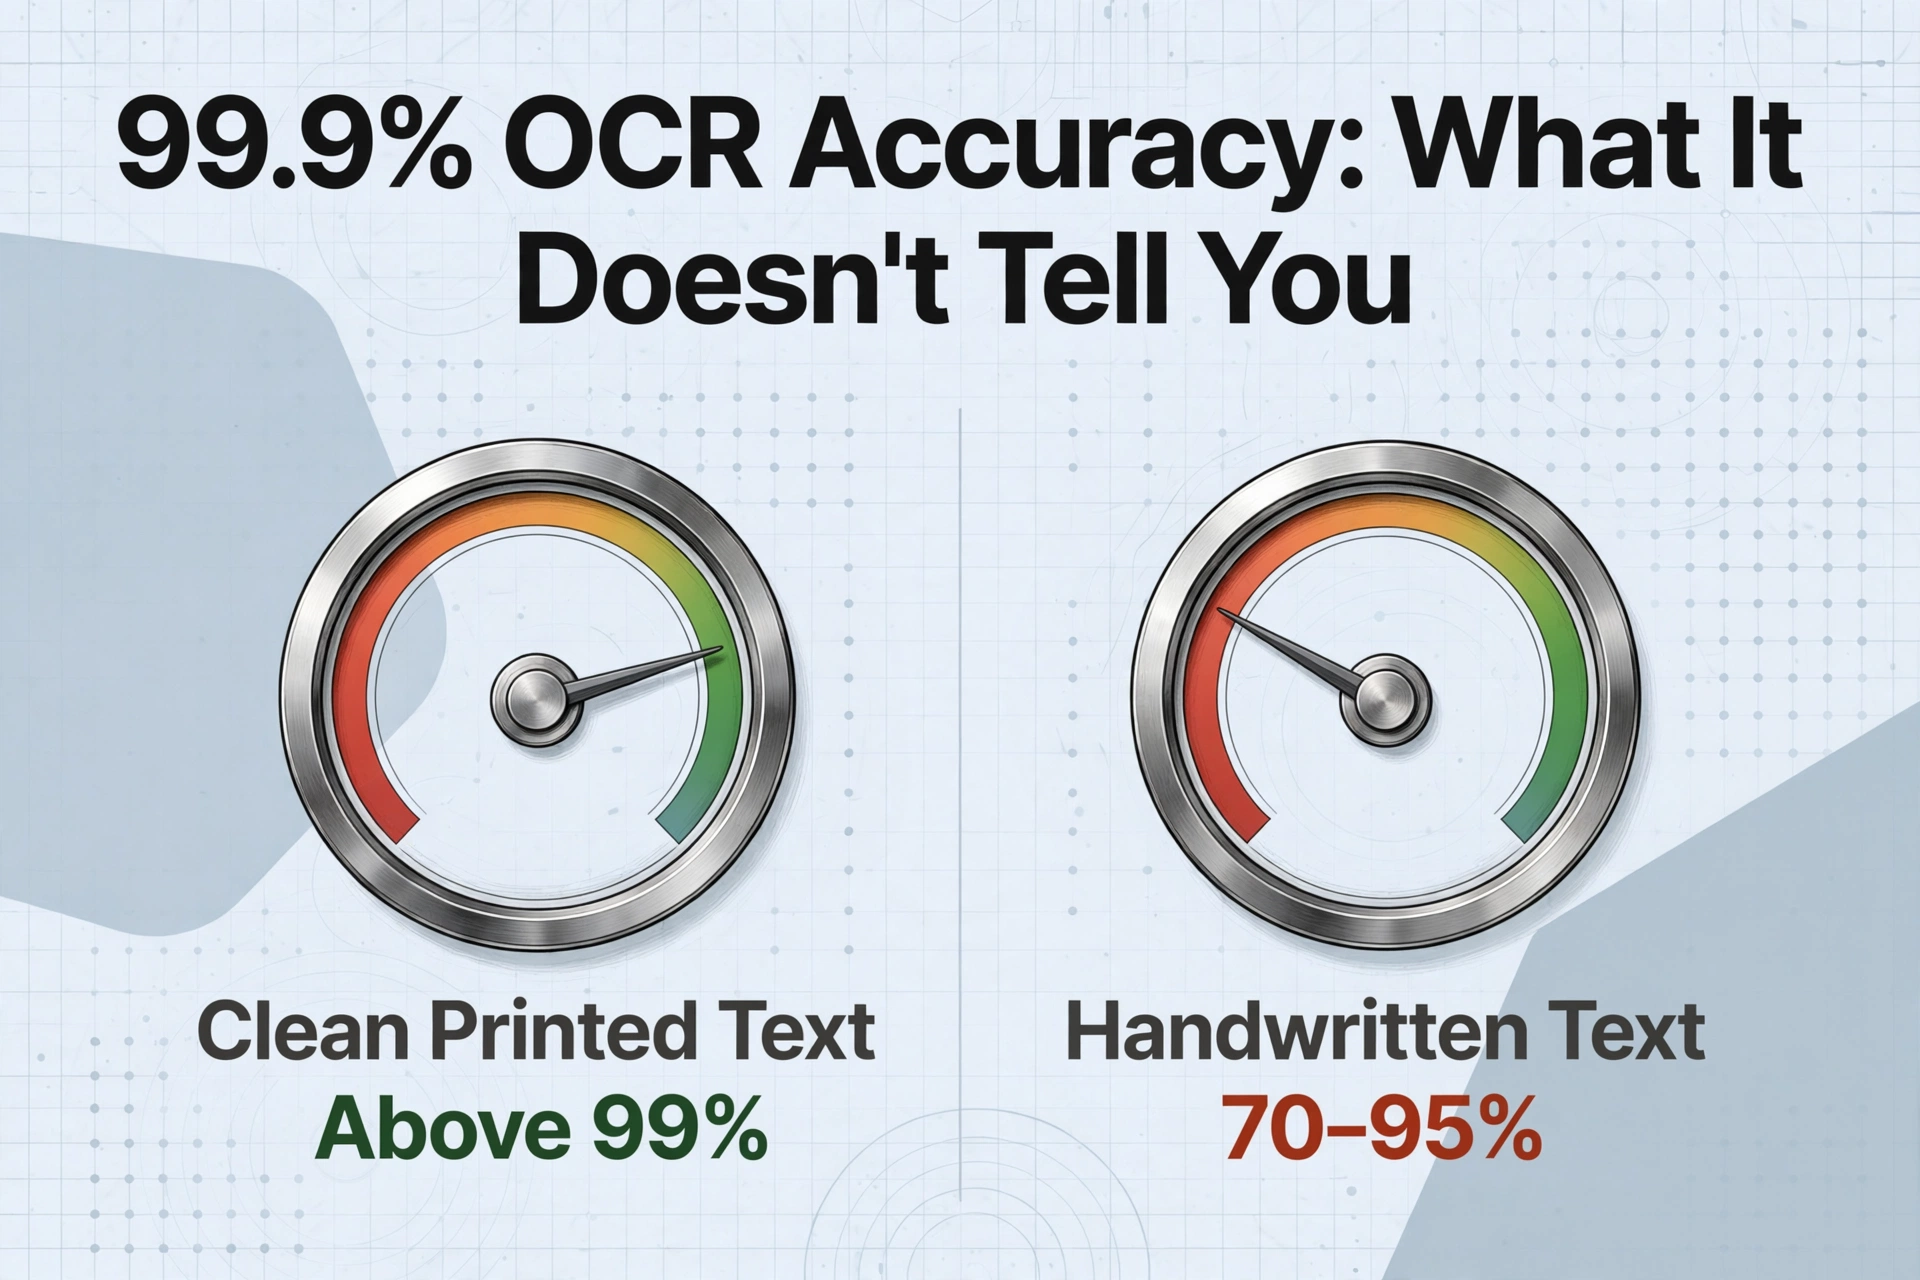
Auf einer typischen Landingpage eines Dokumentextraktionstools könnte stehen: „99,9 % OCR-Genauigkeit bei Rechnungen.“ Die Zahl erscheint neben einem Häkchen-Symbol. Sie wirkt wie ein Beleg. Sie wirkt technisch fundiert. Aber was sie Ihnen nicht verrät: ob diese 99,9 % an perfekt gescannten Dokumenten einer einzigen Vorlage gemessen wurden, ob sie sich auf Zeichen oder Felder bezieht und ob der Testsatz genau die Dokumenttypen ausgeschlossen hat, die Sie tatsächlich verarbeiten.
Unabhängige Benchmarks aus AIMultiple's OCR-Benchmark 2026 verdeutlichen die Kluft: Führende API-Dienste erreichen über 99 % bei sauberem gedrucktem Text, fallen aber je nach Engine auf etwa 70–95 % bei Handschrift zurück – eine Spanne, die groß genug ist, dass zwei Tools, die beide 99 % insgesamt behaupten, bei Ihren tatsächlichen Dokumenten um 25 Prozentpunkte auseinanderliegen können. Die Schlagzeilenzahl verrät Ihnen nicht, in welchem Lager ein Anbieter steht, denn die Schlagzeilenzahl war nie dafür gedacht.
Die fünf Fragen unten verwandeln eine vage Genauigkeitsbehauptung in eine konkrete Bewertung. Stellen Sie sie, bevor Sie evaluieren, und Sie werden sehen, welche Anbieter echte Tests durchgeführt haben – und welche hoffen, dass Sie nicht fragen.
F1: Auf welchen Dokumenten getestet?
Genauigkeit ist keine Eigenschaft eines Tools. Sie ist eine Eigenschaft eines Tools auf einer bestimmten Dokumentmenge. Ändern Sie die Menge, ändert sich die Zahl – manchmal dramatisch. Ein Anbieter, der auf einheitlichen, hochauflösenden, einsprachigen Rechnungen testet, wird eine höhere Genauigkeit angeben als einer, der auf einem gemischten Korpus aus handschriftlichen Formularen, verblassten Fotokopien und Handykamera-Belegen testet. Beide Zahlen können wahr sein. Nur eine sagt voraus, was Sie erleben werden.
Fragen Sie nach der genauen Zusammensetzung des Testsatzes: wie viele Dokumente, aus wie vielen Quellen, in wie vielen Sprachen, in welchem Auflösungsbereich. Wenn der Anbieter diese Aufschlüsselung nicht liefern kann, hat die Genauigkeitszahl keinen Anker. Sie ist eine Behauptung über einen unbekannten Datensatz, angewendet auf ein unbekanntes Dokument – das heißt, sie ist nicht brauchbar.
Dies ist auch der richtige Moment zu prüfen, ob das Tool auf Vorlagenabgleich oder Zonen-OCR setzt, was bei variierenden Layouts versagt. Wie wir in was OCR-Genauigkeit wirklich bedeutet behandeln, können vorlagenbasierte Systeme innerhalb ihres trainierten Formats gut abschneiden und außerhalb davon völlig versagen – etwas, das eine einzelne „99 %“-Zahl nie offenbaren wird.
F2: Auf welcher Ebene — Zeichen, Wort oder Feld?
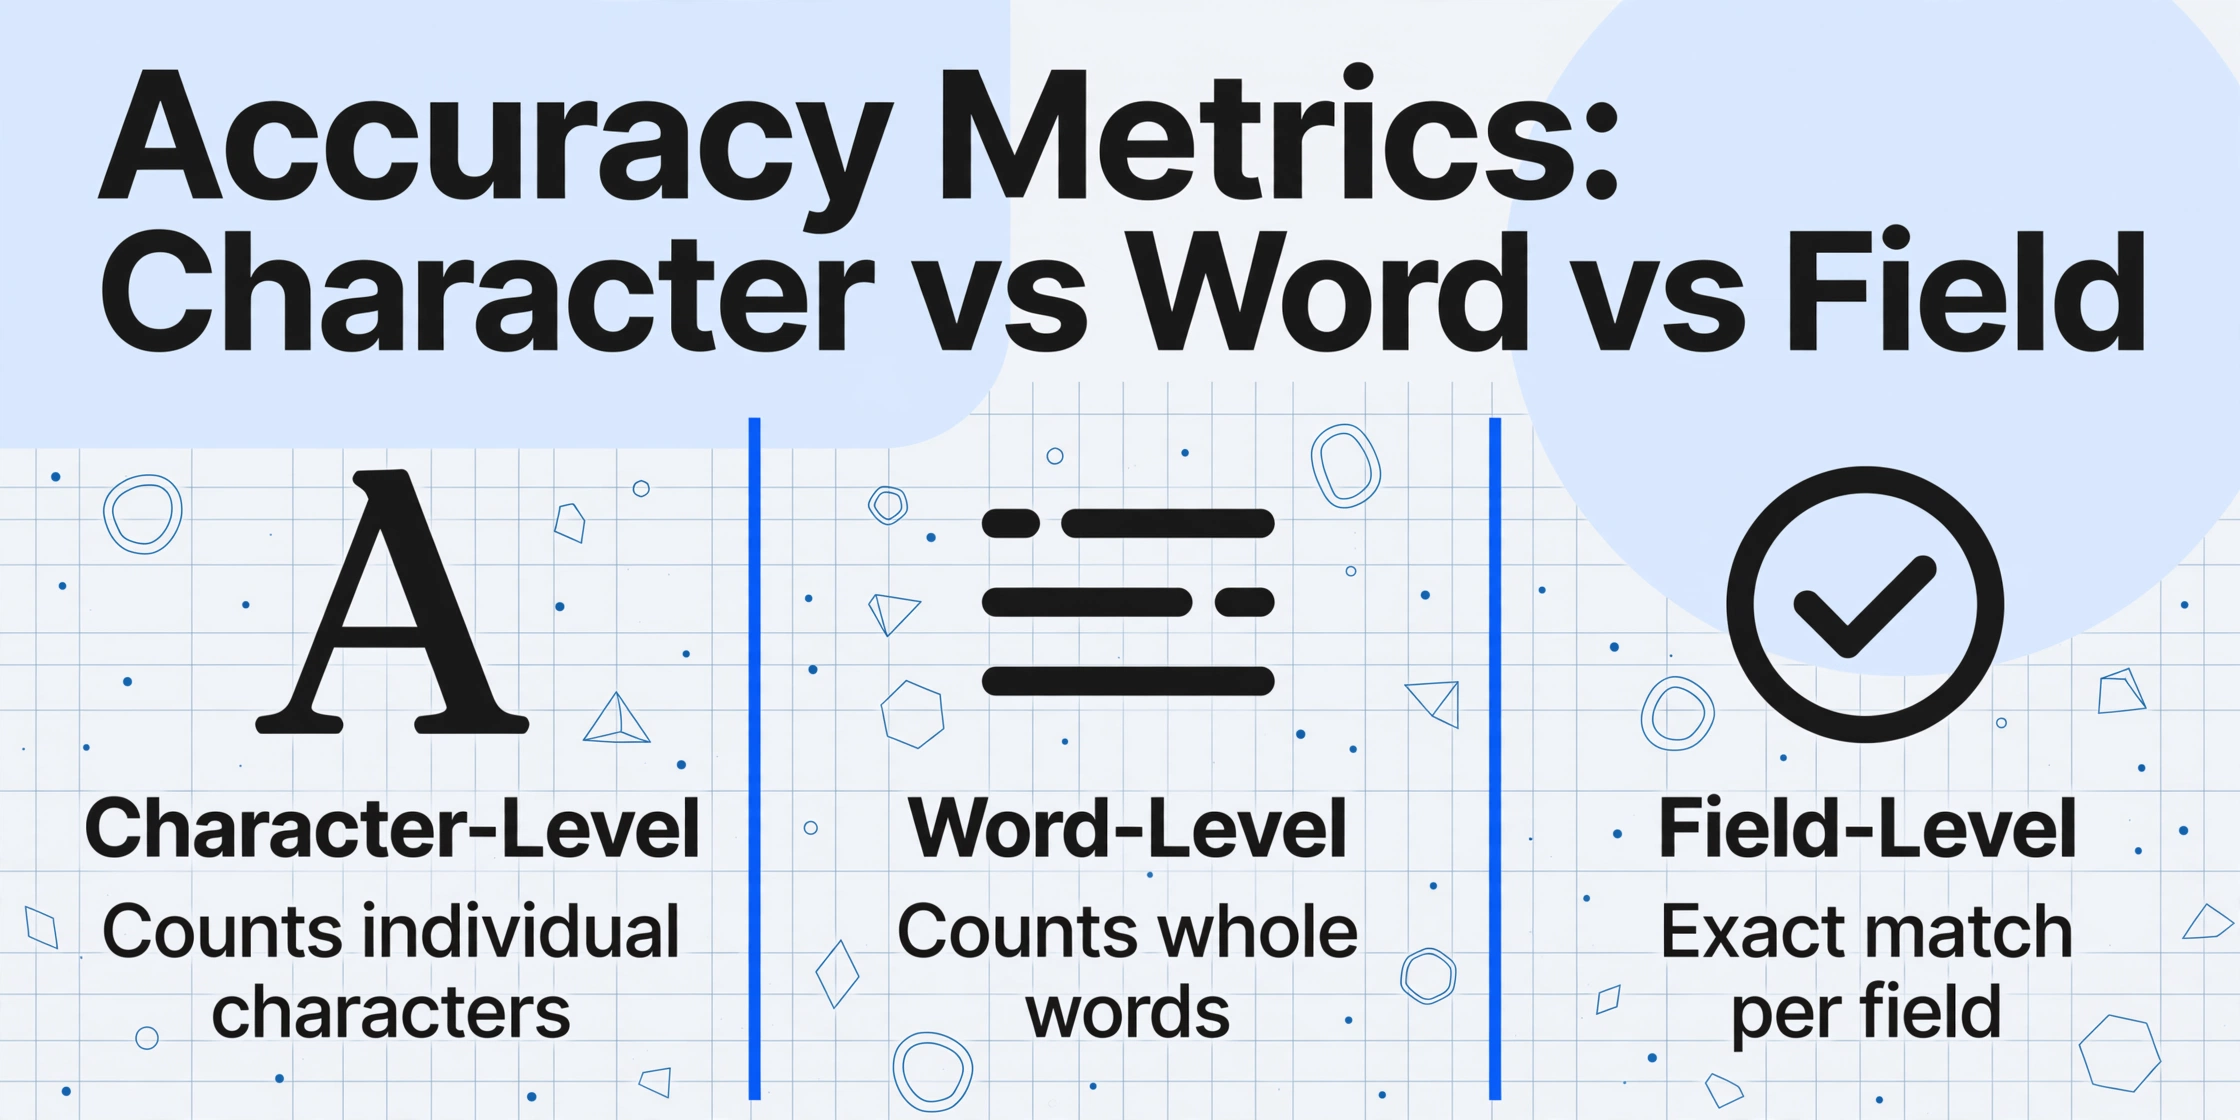
Die Genauigkeit kann auf drei Ebenen gemessen werden, und Anbieter neigen dazu, diejenige zu melden, die die höchste Zahl ergibt.
Genauigkeit auf Zeichenebene (CER) zählt, wie viele einzelne Zeichen die Engine korrekt liest. Wenn ein Dokument 1.000 Zeichen hat und 990 korrekt sind, ergibt das eine CER von 99 %. Das klingt beeindruckend. Es ist aber auch die am wenigsten nützliche Kennzahl für jede reale Aufgabe, denn ein einziges falsches Zeichen kann den Wert eines gesamten Feldes zerstören. Eine Rechnungssumme von 1.429,50 $, die die OCR als 1,429,50 $ liest, ist 7 von 8 Zeichen korrekt — 87,5 % Zeichengenauigkeit — aber das Feld ist völlig falsch. Wenn das der Betrag ist, den Ihr AP-System zahlt, kostet der Fehler Geld, egal wie sauber die übrigen Zeichen waren.
Feldgenauigkeit (auch semantische Genauigkeit oder Exakt-Übereinstimmungs-Genauigkeit genannt) misst, ob jeder vollständige Datenpunkt — Rechnungsnummer, Fälligkeitsdatum, Positionsbetrag — perfekt extrahiert wird. Ein Feld ist entweder korrekt oder nicht. Eine einzelne falsch gelesene Ziffer lässt das gesamte Feld durchfallen. Dies ist die Kennzahl, die sich auf reale Geschäftsergebnisse abbilden lässt. Ein Benchmark aus dem Jahr 2026 von LlamaIndex' OCR-Genauigkeitsanalyse setzt die Feldgenauigkeitsschwelle für die vollautomatische Verarbeitung (Straight-Through Processing) auf 99,9 % — also ein Fehler pro tausend Feldern. Darunter ist eine manuelle Prüfung unvermeidbar.
Der Unterschied zwischen Zeichen- und Feldgenauigkeit ist nicht akademisch. Ein Tool, das 99 % Zeichengenauigkeit meldet, kann bei denselben Dokumenten eine Feldgenauigkeit von unter 90 % liefern. Wie wir in warum die OCR-Genauigkeit je nach Dokumenttyp sinkt untersuchen, vergrößert sich die Lücke bei komplexen Layouts weiter, wo eine einzige falsch interpretierte Tabellengrenze jedes Feld in einer Zeile durcheinanderbringt.
Wenn ein Anbieter eine Genauigkeitszahl nennt, sollte Ihre erste Rückfrage lauten: „Ist das Zeichen-, Wort- oder Feldgenauigkeit? Und können Sie die Feldgenauigkeit nach Dokumenttyp aufgeschlüsselt teilen?"
F3: Was wurde aus dem Testsatz ausgeschlossen?
Das Testmethodik-Dokument eines Anbieters – dasjenige, das sie auf ihrem Blog veröffentlichen oder in ein Whitepaper aufnehmen – enthält in seinen Ausschlusskriterien oft mehr nützliche Informationen als in seinen Genauigkeitszahlen. Was haben sie bewusst weggelassen?
Häufige Ausschlüsse umfassen: handschriftlichen Text, Dokumente mit Stempeln oder Logos, die Datenfelder überlagern, mehrseitige PDFs, Fotos mit niedriger Auflösung von Mobiltelefonen, nicht-englische Sprachen sowie Dokumente mit Anmerkungen oder Korrekturen an den Rändern. Jeder Ausschluss schränkt die Anwendbarkeit der berichteten Genauigkeit ein. Eine 99-%-Angabe, die Handschrift ausschließt, ist nicht aussagekräftig, wenn Ihr Workflow handschriftliche Lieferscheine umfasst – und wie wir in OCR-Handschrift-Genauigkeit in der Praxis ausführen, kann die Lücke zwischen gedruckter und handschriftlicher Genauigkeit bei derselben Engine 20 Prozentpunkte oder mehr betragen. Ein Benchmark, der mehrsprachige Dokumente ausschließt, sagt Ihnen nichts darüber, wie das Tool mit einer zweisprachigen Rechnung umgeht.
Ein besonders wichtiger Ausschluss ist die Behandlung von gedrehten, verkippten oder kontrastarmen Bildern. Herkömmliche OCR-Engines sind bei diesen Eingaben spröde. Wie unser OCR-Software-Vergleich 2026 anmerkt, wenden einige Tools Vorverarbeitungspipelines an, die die Bildqualität vor der Erkennung normalisieren – viele tun dies jedoch nicht, und ihre Genauigkeitsangaben setzen implizit voraus, dass die Eingabe bereits sauber ist.
Fragen Sie direkt: „Welche Dokumenttypen, Qualitätsstufen und Bedingungen haben Sie ausgeschlossen, und können Sie Genauigkeitsergebnisse speziell für die ausgeschlossenen Dokumenttypen teilen?“ Die Antwort verrät Ihnen mehr als die Schlagzeilenzahl.
F4: Welche Fehlertoleranz wurde angewendet?
Selbst auf Feldebene gibt es eine weniger offensichtliche Variable: Wie nah muss ein Wert am Sollwert liegen, um als „korrekt“ zu gelten? Einige Anbieter zählen ein Feld als genau, wenn der extrahierte Wert nach geringfügiger Formatnormalisierung übereinstimmt – Entfernen von Satzzeichen, Standardisieren von Datumsformaten, Ignorieren führender Nullen. Das ist vernünftig. Andere gehen jedoch weiter: Sie zählen ein numerisches Feld als korrekt, wenn es innerhalb eines bestimmten Prozentsatzes der Ground Truth liegt, akzeptieren ein Feld, wenn ein beliebiger Teilstring übereinstimmt, oder behandeln eine ausgeschriebene Zahl als äquivalent zu ihrer Ziffernform.
Diese Toleranzen sind nicht unbedingt falsch. Einige Anwendungen kümmern sich wirklich nicht darum, ob ein Datum als MM/TT/JJJJ oder JJJJ-MM-TT formatiert ist. Das Problem ist, dass die Toleranz fast nie zusammen mit der Genauigkeitszahl offengelegt wird. Eine 98-%-Angabe auf Feldebene, die eine Abweichung von 5 % bei Dollar-Beträgen zulässt, bedeutet etwas ganz anderes als eine 98-%-Angabe, die eine exakte zeichenweise Übereinstimmung bei jedem Feld erfordert.
Dies ist besonders relevant für numerische Felder wie Summen, Mengen und Steuerbeträge – die Felder, bei denen Genauigkeit am wichtigsten ist und bei denen bereits eine einzelne falsche Ziffer einen Abstimmungskopfschmerz verursacht. Wenn ein Tool eine Feldgenauigkeit von 99 % bei Rechnungssummen meldet, aber 1.429,50 $ und 1.429,00 $ als Übereinstimmung zählt, weil die Differenz innerhalb eines Toleranzbands von 1 % liegt, dann ist die tatsächliche Exakt-Übereinstimmungs-Genauigkeit niedriger als beworben.
Fragen Sie: „Was gilt genau als korrekte Extraktion? Werden Näherungswerte als korrekt gezählt? Bei welchem Schwellenwert?“
F5: Wie genau ist die Erkennung bei Dokumenten, die wie Ihre aussehen?
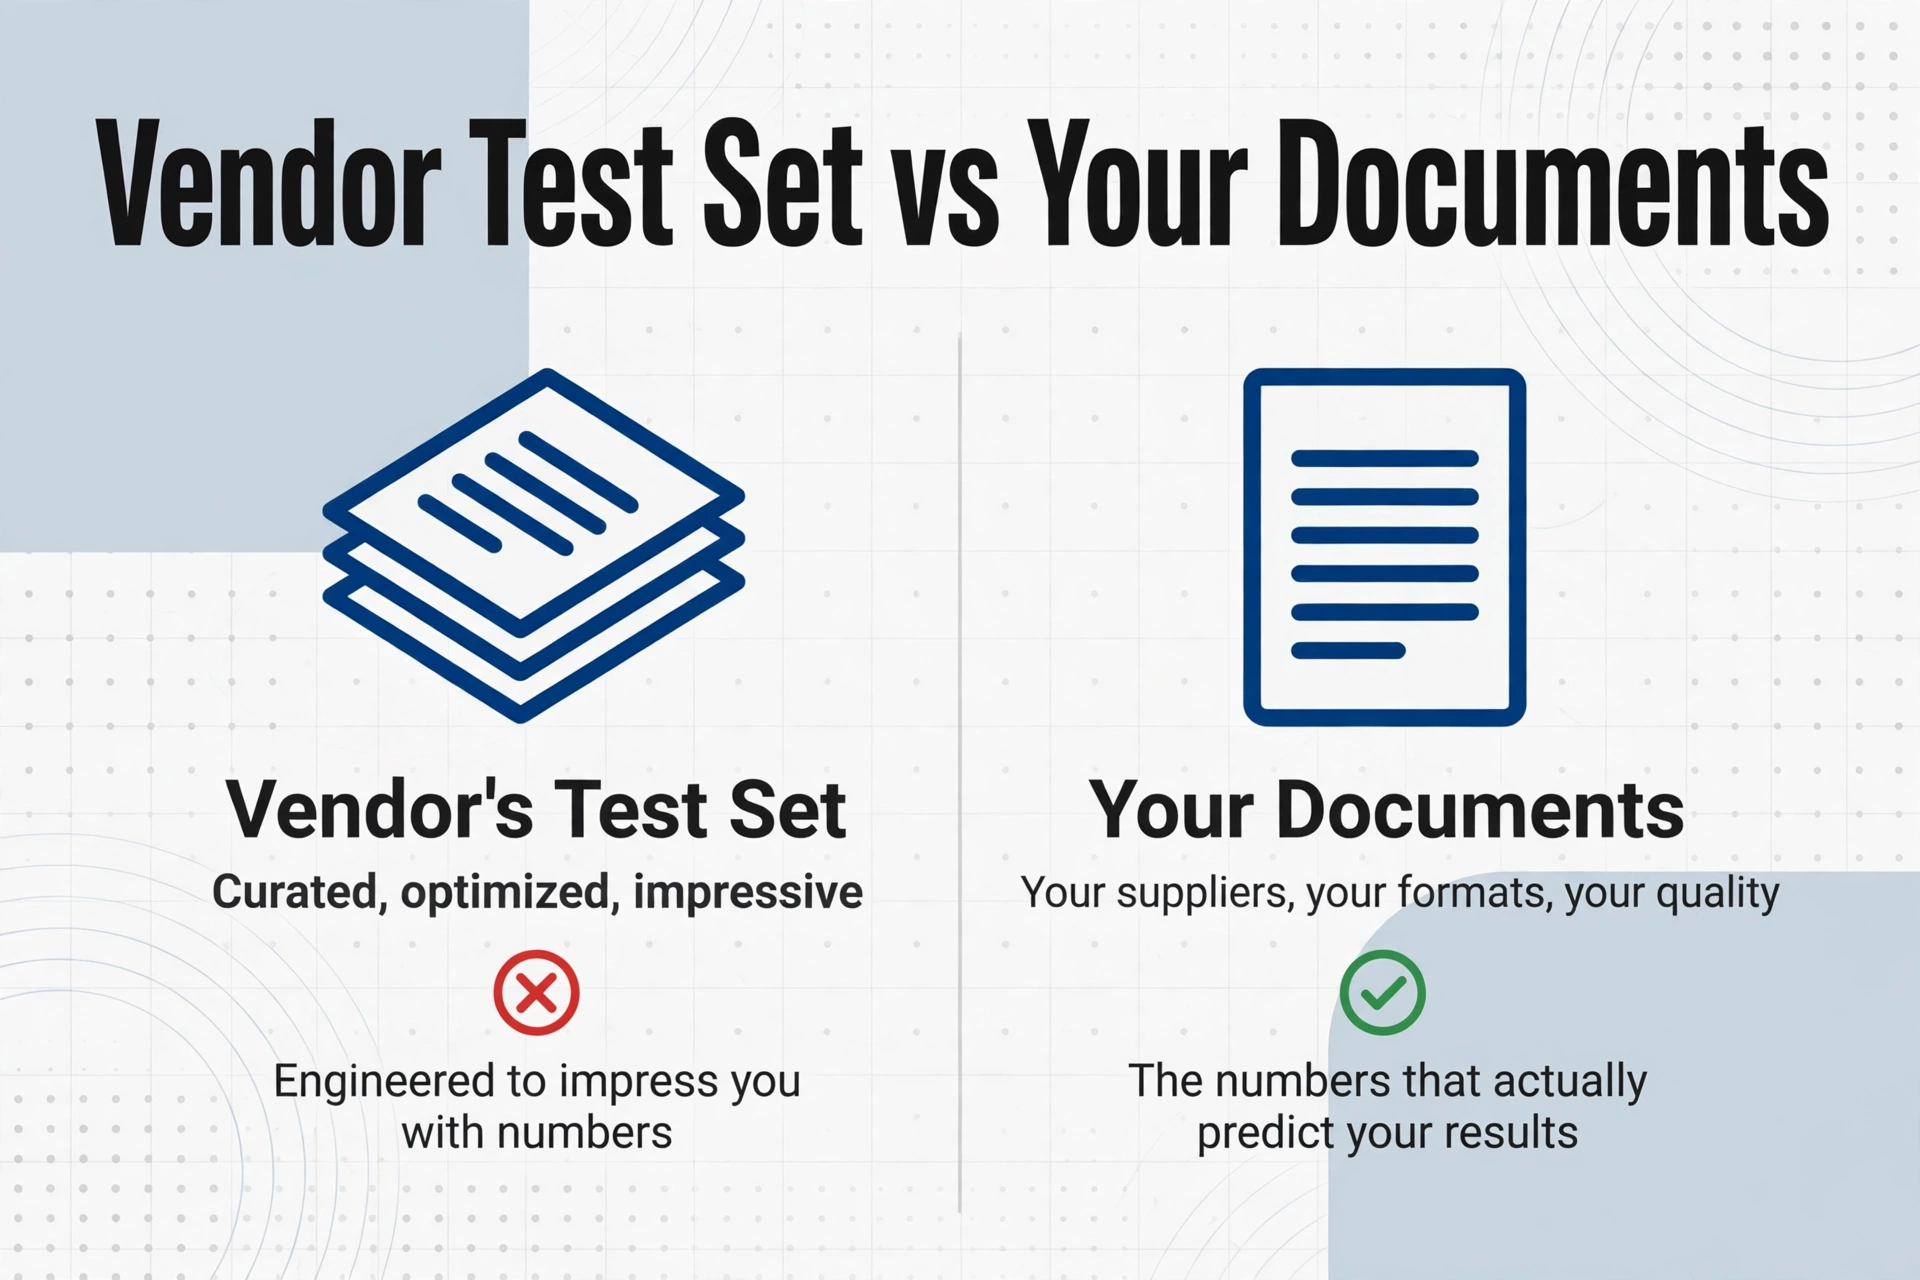
Dies ist die einzige Frage, die letztlich zählt – und genau die, die die meisten Käufer überspringen. Der Testdatensatz eines Anbieters enthält dessen Dokumente – diejenigen, die er ausgewählt, kuratiert und optimiert hat. Ihre Dokumente enthalten Ihre Lieferanten, Ihre Kunden, Ihre Formate, Ihre Bildqualität, Ihre Feldtypen. Das sind verschiedene Dinge.
Hier ist ein praktischer Test: Bereiten Sie eine Stichprobe von 20 bis 50 Dokumenten vor, die die Bandbreite an Qualität und Vielfalt repräsentiert, auf die Ihr Team tatsächlich trifft. Senden Sie denselben Satz an jeden Anbieter, den Sie bewerten. Messen Sie die Feldgenauigkeit bei den spezifischen Feldern, die für Sie relevant sind – Rechnungssumme, Bestellnummer, Positionsbeschreibungen – nicht bei Text, der für Ihren Workflow irrelevant ist. Vergleichen Sie die Ergebnisse direkt nebeneinander.
Jeder Anbieter, der eine Blindauswertung mit Ihren Dokumenten verweigert oder nur eine kuratierte Demo mit eigenen Beispielen anbietet, liefert Ihnen eine Zahl, die dazu entwickelt wurde, zu beeindrucken – nicht dazu, Ihr Ergebnis vorherzusagen. Ein Anbieter, der Ihren Testdatensatz begrüßt und offenlegt, wo sein Tool erfolgreich ist und wo es Schwierigkeiten hat, sagt Ihnen die Wahrheit.
Hier spielt auch das zugrunde liegende Extraktionsparadigma eine Rolle. Herkömmliche OCR-Tools und templatebasierte Systeme erfordern, dass Sie sie für jedes neue Format trainieren oder konfigurieren. Tools auf Basis von Vision-Language-Modellen wie ImageToTable.ai sind ohne Vorlage und formatunabhängig: Sie lesen Dokumente, indem sie die Bedeutung von Feldern verstehen, statt ihre Position auf der Seite – das bedeutet, dass eine einzige Konfiguration über verschiedene Layouts hinweg funktioniert. Die Genauigkeit, die Sie an Ihrer Teststichprobe messen, ist die Genauigkeit, die Sie in der Produktion erhalten – ohne formatspezifische Anpassung.
FAQ
Was ist eine gute OCR-Genauigkeitszahl?
Eine gute Zahl hängt davon ab, was Sie extrahieren und was Sie als Fehler betrachten. Bei sauberem gedrucktem Text ist eine Feldgenauigkeit von über 97 % mit den meisten modernen Tools erreichbar. Bei handschriftlichen Dokumenten sind 90–95 % Feldgenauigkeit mit Top-Engines realistisch. Die ehrlichste Antwort: Testen Sie es an Ihren Dokumenten und legen Sie Ihren eigenen Maßstab fest. Es gibt keine universelle „gute" Zahl.
Warum verwenden Anbieter zeichengenaue Genauigkeit, wenn sie irreführend ist?
Weil es die höchste Zahl ist, die sie produzieren können. Die zeichengenaue Genauigkeit profitiert von der Mittelwertbildung: Eine falsche Ziffer in einer 8-stelligen Gesamtsumme plus ein falscher Buchstabe in einem 4-stelligen Währungscode ergibt 84 % Zeichengenauigkeit bei diesen beiden Feldern. Aber wenn es Ihnen darauf ankommt, dass die Gesamtsumme und der Währungscode stimmen, sind beide Felder zu 100 % falsch. Anbieter berichten die Kennzahl, die ihr Produkt am besten aussehen lässt – und der Druck der Käufer hat sie noch nicht gezwungen, auf feldgenaue Berichterstattung zu standardisieren.
Kann ich unabhängigen OCR-Benchmarks vertrauen?
Ja, mit einer Einschränkung: Stellen Sie sicher, dass der Benchmark Dokumenttypen getestet hat, die Ihren ähnlich sind. Ein unabhängiger Benchmark wie AIMultiple's DeltOCR Bench oder der Open-Source-OCRBench bietet neutrale Vergleiche, aber die Dokumentmischung entspricht möglicherweise nicht Ihrem Workflow. Nutzen Sie Benchmarks als Filter für die Shortlist und testen Sie dann die Finalisten mit Ihren eigenen Dokumenten.
Bedeutet höhere Genauigkeit immer ein besseres Tool?
Nein. Genauigkeit ist eine Dimension. Ein Tool, das 99,5 % Feldgenauigkeit bei Rechnungen erreicht, aber zehn Trainingsbeispiele pro Vorlage benötigt, bei Layoutänderungen eines Lieferanten versagt und laufende Wartung durch einen Integrationsingenieur erfordert, kann in der Praxis weniger wertvoll sein als ein Tool, das am ersten Tag 97 % Genauigkeit über jedes Format hinweg ohne Einrichtung liefert. Einrichtungsaufwand, Wartungskosten und die Breite der Dokumentunterstützung sind oft wichtiger als die letzten zwei Prozentpunkte Genauigkeit.
Was Sie als Nächstes tun sollten
Genauigkeitsbehauptungen sind nicht nutzlos – sie sind nur unvollständig. Ein Anbieter, der alle fünf Fragen klar beantwortet, feldgenaue Ergebnisse nach Dokumenttyp teilt, Ausschlüsse und Toleranzen offenlegt und Sie einlädt, auf Ihren eigenen Dokumenten zu testen, ist ein Anbieter, den man ernst nehmen sollte. Ein Anbieter, der ausweicht, auf eine Fallstudie verweist oder nur eine kuratierte Demo anbietet, sagt Ihnen auch etwas – hören Sie darauf.
Nehmen Sie sich die nächste Stunde Zeit, um eine Stichprobe der Dokumente zusammenzustellen, die Ihr Team am häufigsten verarbeitet. Lassen Sie sie durch die Tools auf Ihrer Shortlist laufen. Messen Sie die Feldgenauigkeit bei den Feldern, die für Ihren Workflow wichtig sind – nicht bei jedem Zeichen auf der Seite. Die Zahl, die Sie zurückbekommen, wird niedriger sein als die Marketingbehauptung. Aber es wird Ihre Zahl sein, und das ist die einzige, auf deren Grundlage Sie eine Entscheidung treffen sollten.