Como Ler uma Alegação de
Precisão de OCR: 5 Perguntas Antes de Comprar
Toda semana, alguém avaliando ferramentas de extração de documentos lê a alegação de "99% de precisão" de um fornecedor, se cadastra, envia seu primeiro lote de documentos reais — e descobre que a precisão real é mais próxima de 85%. Essa pessoa não foi enganada por uma mentira. Foi enganada por um número que nunca foi feito para responder à pergunta que ela realmente estava fazendo: "Essa ferramenta vai funcionar com meus documentos?" A diferença entre a precisão informada pelo fornecedor e o desempenho no mundo real não é um acidente — é o resultado previsível de como as alegações de precisão são construídas. E quando você sabe o que perguntar, essa diferença fica visível antes de você comprar.
Principais Conclusões
- Alegações de 99% de precisão excluem os documentos bagunçados que você realmente processa, porque são medidas em digitalizações limpas e perfeitas, com todos os casos difíceis removidos primeiro.
- A precisão em nível de caractere esconde o fato de que, na extração de campos do mundo real, sua ferramenta pode ficar de 10 a 15 pontos abaixo do número principal.
- Teste 20 dos seus próprios documentos hoje à noite em cada ferramenta pré-selecionada, porque o único número de precisão que vale para tomar uma decisão é aquele que você mesmo mede.
Por que 99% Significa Menos do Que Você Pensa
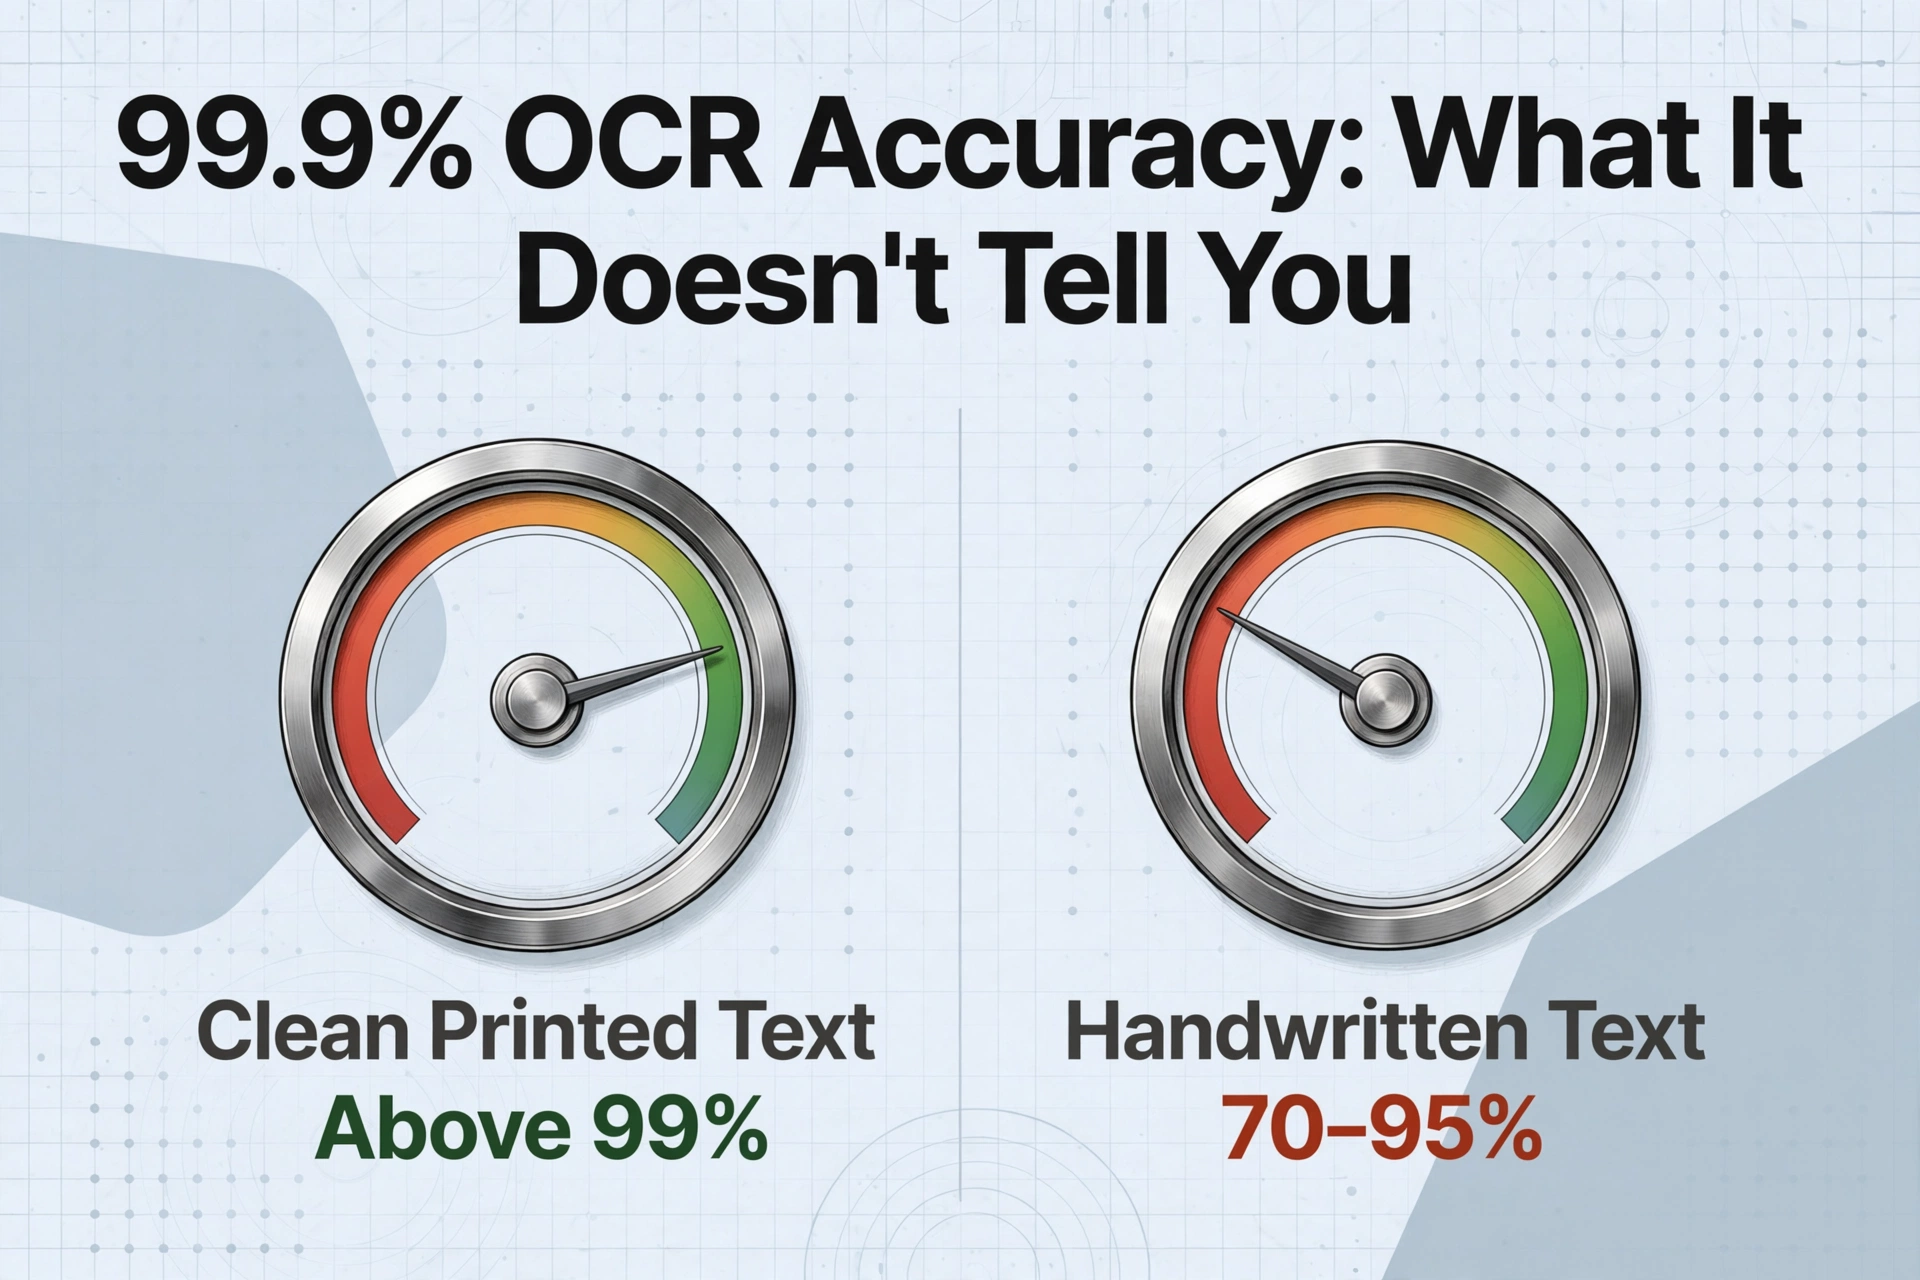
Uma landing page típica de uma ferramenta de extração de documentos pode dizer: "99,9% de precisão de OCR em notas fiscais." O número aparece ao lado de um ícone de visto. Parece evidência. Parece nível de engenharia. Mas o que ela não te conta é: se esses 99,9% foram medidos em digitalizações de qualidade perfeita de um único modelo, se se refere a caracteres ou campos, e se o conjunto de testes excluiu os tipos de documento que você realmente processa.
Benchmarks independentes do benchmark de OCR 2026 da AIMultiple ilustram a lacuna: os principais serviços de API alcançam acima de 99% em texto impresso limpo, mas caem para cerca de 70–95% em manuscritos, dependendo do mecanismo — uma faixa ampla o suficiente para que duas ferramentas que afirmam 99% no geral possam diferir em 25 pontos percentuais nos seus documentos reais. O número de destaque não te diz em qual campo um fornecedor se encaixa porque o número de destaque nunca foi feito para isso.
As cinco perguntas abaixo transformam uma alegação vaga de precisão em uma avaliação concreta. Faça-as antes de avaliar, e você verá quais fornecedores fizeram testes reais — e quais estão torcendo para você não perguntar.
P1: Testado em Quais Documentos?
Precisão não é uma propriedade de uma ferramenta. É uma propriedade de uma ferramenta em um conjunto específico de documentos. Mude o conjunto e o número muda — às vezes drasticamente. Um fornecedor que testa em notas fiscais uniformes, de alta resolução e em um único idioma relatará precisão maior do que um que testa em um corpus misto de formulários manuscritos, fotocópias desbotadas e recibos tirados com câmera de celular. Ambos os números podem ser verdadeiros. Apenas um prevê o que você vai experimentar.
Peça a composição exata do conjunto de testes: quantos documentos, de quantas fontes, em quantos idiomas, em que faixa de resolução. Se o fornecedor não conseguir produzir esse detalhamento, o número de precisão não tem âncora. É uma alegação sobre um conjunto de dados desconhecido aplicada a um documento desconhecido — ou seja, não é útil.
Este também é o momento certo para verificar se a ferramenta depende de correspondência de modelo ou OCR zonal, que quebra quando os layouts variam. Como abordamos em o que a precisão de OCR realmente significa, sistemas baseados em modelo podem ter bom desempenho dentro do formato treinado e falhar completamente fora dele — algo que um único número "99%" nunca vai revelar.
P2: Em que nível — caractere, palavra ou campo?
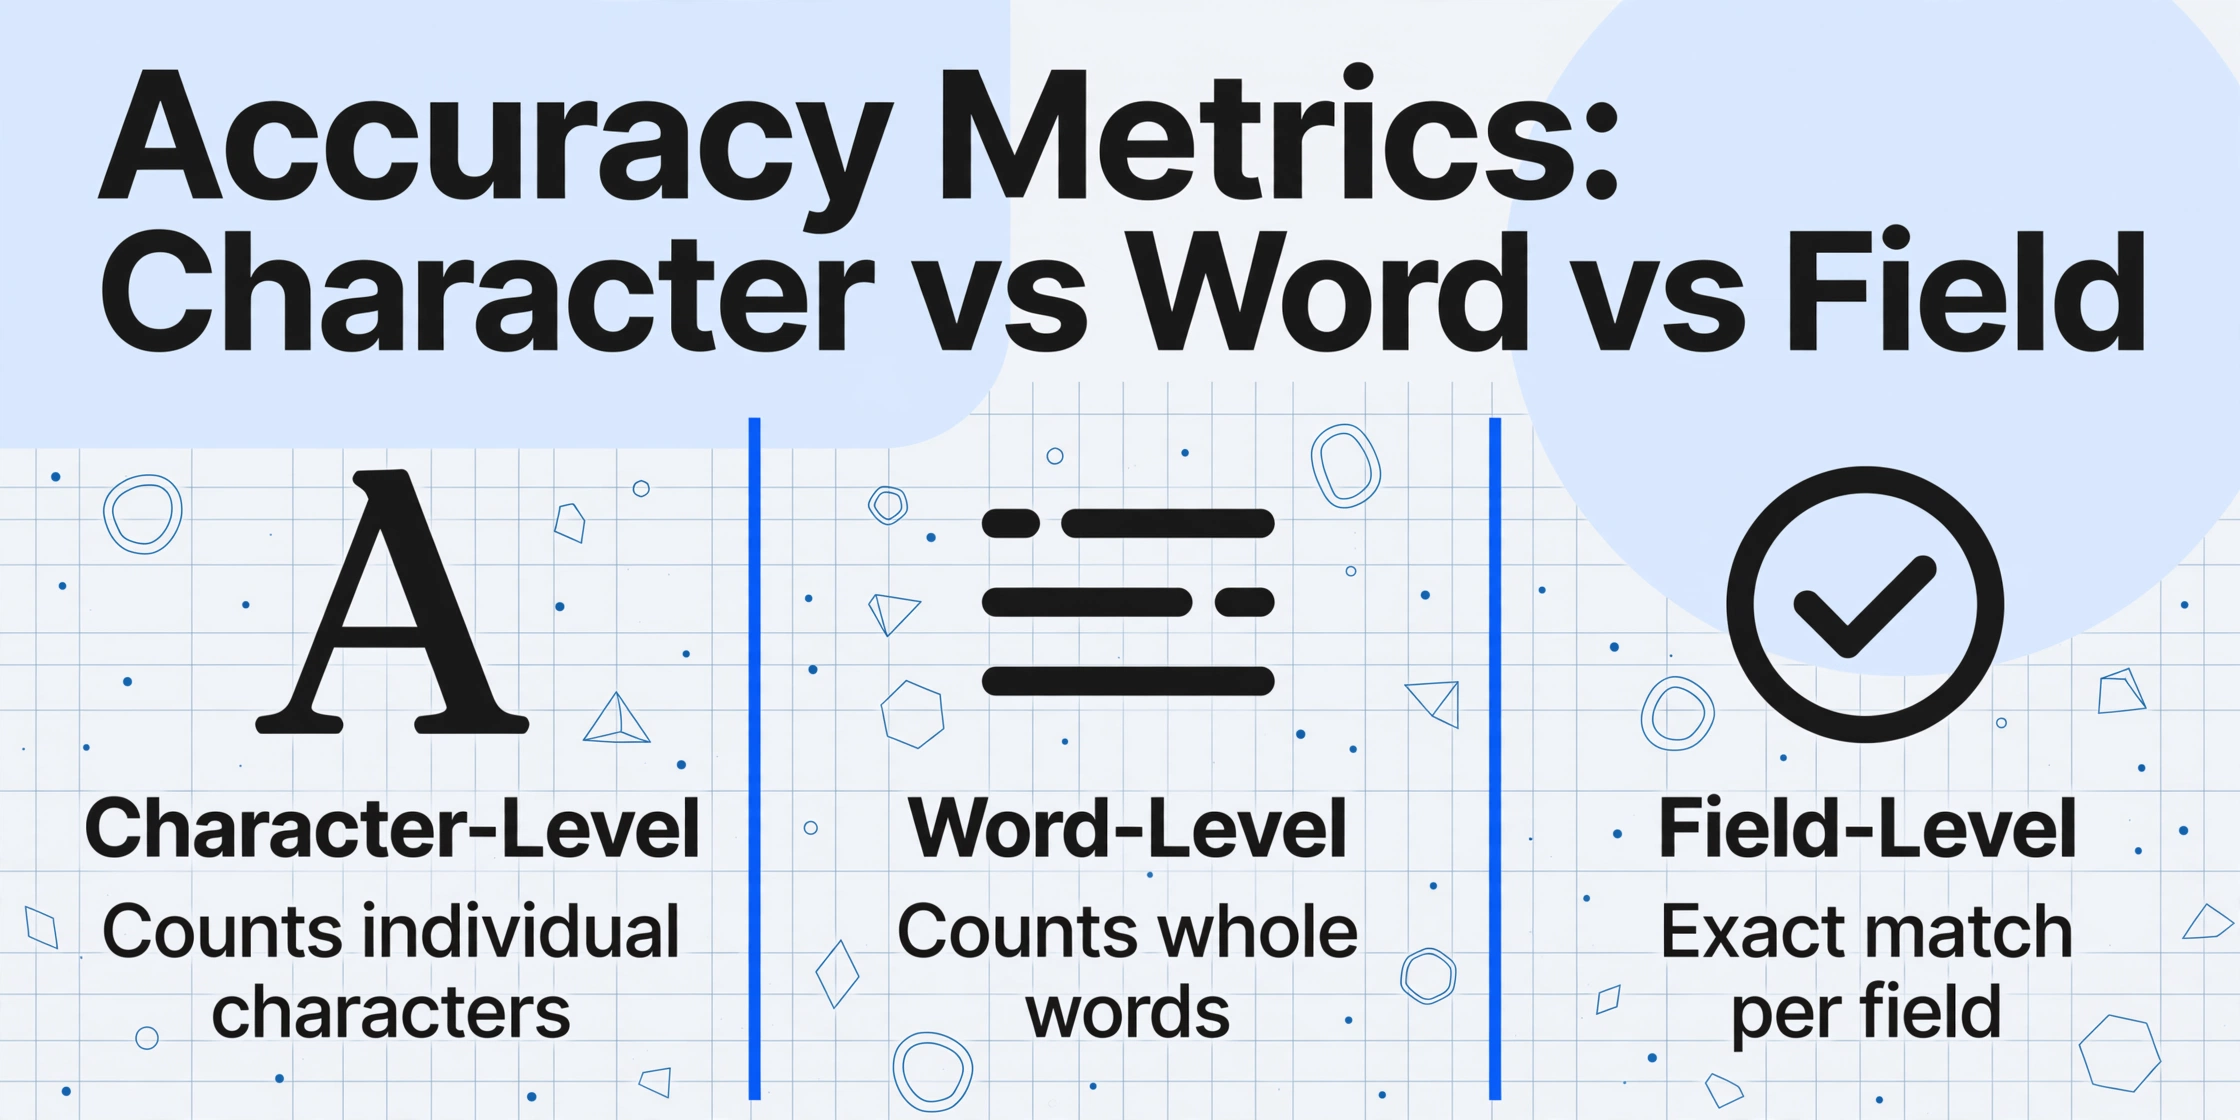
A precisão pode ser medida em três níveis, e os fornecedores tendem a relatar aquele que produz o maior número.
Precisão em nível de caractere (CER) conta quantos caracteres individuais o mecanismo lê corretamente. Se um documento tem 1.000 caracteres e 990 estão corretos, isso é 99% de CER. Parece impressionante. Também é a métrica menos útil para qualquer tarefa do mundo real, porque um único caractere errado pode destruir o valor de um campo inteiro. Um total de fatura de $1.429,50 que o OCR lê como $1,429,50 tem 7 de 8 caracteres corretos — 87,5% de precisão de caracteres — mas o campo está completamente errado. Se esse é o total que o sistema de AP paga, o erro custa dinheiro, independentemente de quão limpos estavam os demais caracteres.
Precisão em nível de campo (também chamada de precisão semântica ou de correspondência exata) mede se cada ponto de dados completo — número da fatura, data de vencimento, valor do item de linha — é extraído perfeitamente. Um campo está correto ou não está. Um único dígito lido incorretamente falha o campo inteiro. Essa é a métrica que se alinha aos resultados reais de negócios. Um benchmark de 2026 da análise de precisão de OCR da LlamaIndex define o limite de precisão em nível de campo para processamento direto em 99,9% — ou seja, um erro por mil campos. Abaixo disso, a revisão manual é inevitável.
A diferença entre precisão em nível de caractere e em nível de campo não é acadêmica. Uma ferramenta que relata 99% de precisão de caracteres pode entregar precisão de campo abaixo de 90% nos mesmos documentos. Como exploramos em por que a precisão do OCR cai por tipo de documento, a lacuna aumenta ainda mais em layouts complexos, onde um único limite de tabela mal interpretado embaralha todos os campos de uma linha.
Quando um fornecedor cita um número de precisão, sua primeira pergunta de acompanhamento deve ser: "Isso é em nível de caractere, palavra ou campo? E você pode compartilhar resultados em nível de campo divididos por tipo de documento?"
P3: O Que Foi Excluído do Conjunto de Teste?
O documento de metodologia de teste de um fornecedor — aquele que eles publicam no blog ou incluem em um whitepaper — geralmente contém informações mais úteis nos critérios de exclusão do que nos números de precisão. O que eles deliberadamente deixaram de fora?
Exclusões comuns incluem: texto manuscrito, documentos com carimbos ou logotipos sobrepostos aos campos de dados, PDFs de várias páginas, fotos de celular de baixa resolução, idiomas que não sejam inglês e qualquer documento com anotações ou correções nas margens. Cada exclusão reduz a aplicabilidade da precisão relatada. Um índice de 99% que exclui manuscritos é inútil se o seu fluxo de trabalho inclui notas de entrega manuscritas — e, como detalhamos em realidade da precisão de OCR para manuscritos, a diferença entre a precisão de texto impresso e manuscrito pode ser de 20 pontos percentuais ou mais no mesmo mecanismo. Um benchmark que exclui documentos multilíngues não diz nada sobre como a ferramenta lidará com uma fatura bilíngue.
Uma exclusão particularmente importante é o tratamento de imagens rotacionadas, inclinadas ou de baixo contraste. Os mecanismos de OCR tradicionais são frágeis nessas entradas. Como nossa comparação de software de OCR de 2026 observa, algumas ferramentas aplicam pipelines de pré-processamento que normalizam a qualidade da imagem antes do reconhecimento — mas muitas não fazem isso, e suas alegações de precisão presumem implicitamente que a entrada já está limpa.
Pergunte diretamente: "Quais tipos de documento, níveis de qualidade e condições vocês excluíram, e vocês podem compartilhar resultados de precisão especificamente sobre os tipos de documentos que excluíram?" A resposta dirá mais do que o número de destaque.
P4: Qual Tolerância a Erros Foi Aplicada?
Mesmo no nível de campo, há uma variável menos óbvia: quão próximo um valor precisa estar para ser considerado "correto"? Alguns fornecedores consideram um campo preciso se o valor extraído corresponder após uma normalização leve de formatação — removendo pontuação, padronizando formatos de data, ignorando zeros à esquerda. Isso é razoável. Mas outros vão além: considerar um campo numérico correto se estiver dentro de uma certa porcentagem do valor de referência, ou aceitar um campo se qualquer substring corresponder, ou tratar um número por extenso como equivalente à sua forma numérica.
Essas tolerâncias não são necessariamente erradas. Alguns aplicativos realmente não se importam se uma data está formatada como MM/DD/AAAA ou AAAA-MM-DD. O problema é que a tolerância quase nunca é divulgada junto com o número de precisão. Um índice de 98% em nível de campo que permite uma variação de 5% em valores monetários significa algo muito diferente de um índice de 98% que exige correspondência exata caractere por caractere em todos os campos.
Isso é especialmente relevante para campos numéricos como totais, quantidades e valores de impostos — os campos onde a precisão mais importa e onde até um único dígito errado cria uma dor de cabeça de conciliação. Se uma ferramenta relata 99% de precisão de campo em totais de faturas, mas considera $1.429,50 e $1.429,00 uma correspondência porque a diferença está dentro de uma faixa de tolerância de 1%, então a precisão real de correspondência exata é menor do que o anunciado.
Pergunte: "O que exatamente qualifica como uma extração correta? Correspondências aproximadas são contadas como corretas? Em qual limite?"
Q5: Qual é a precisão em documentos parecidos com os seus?
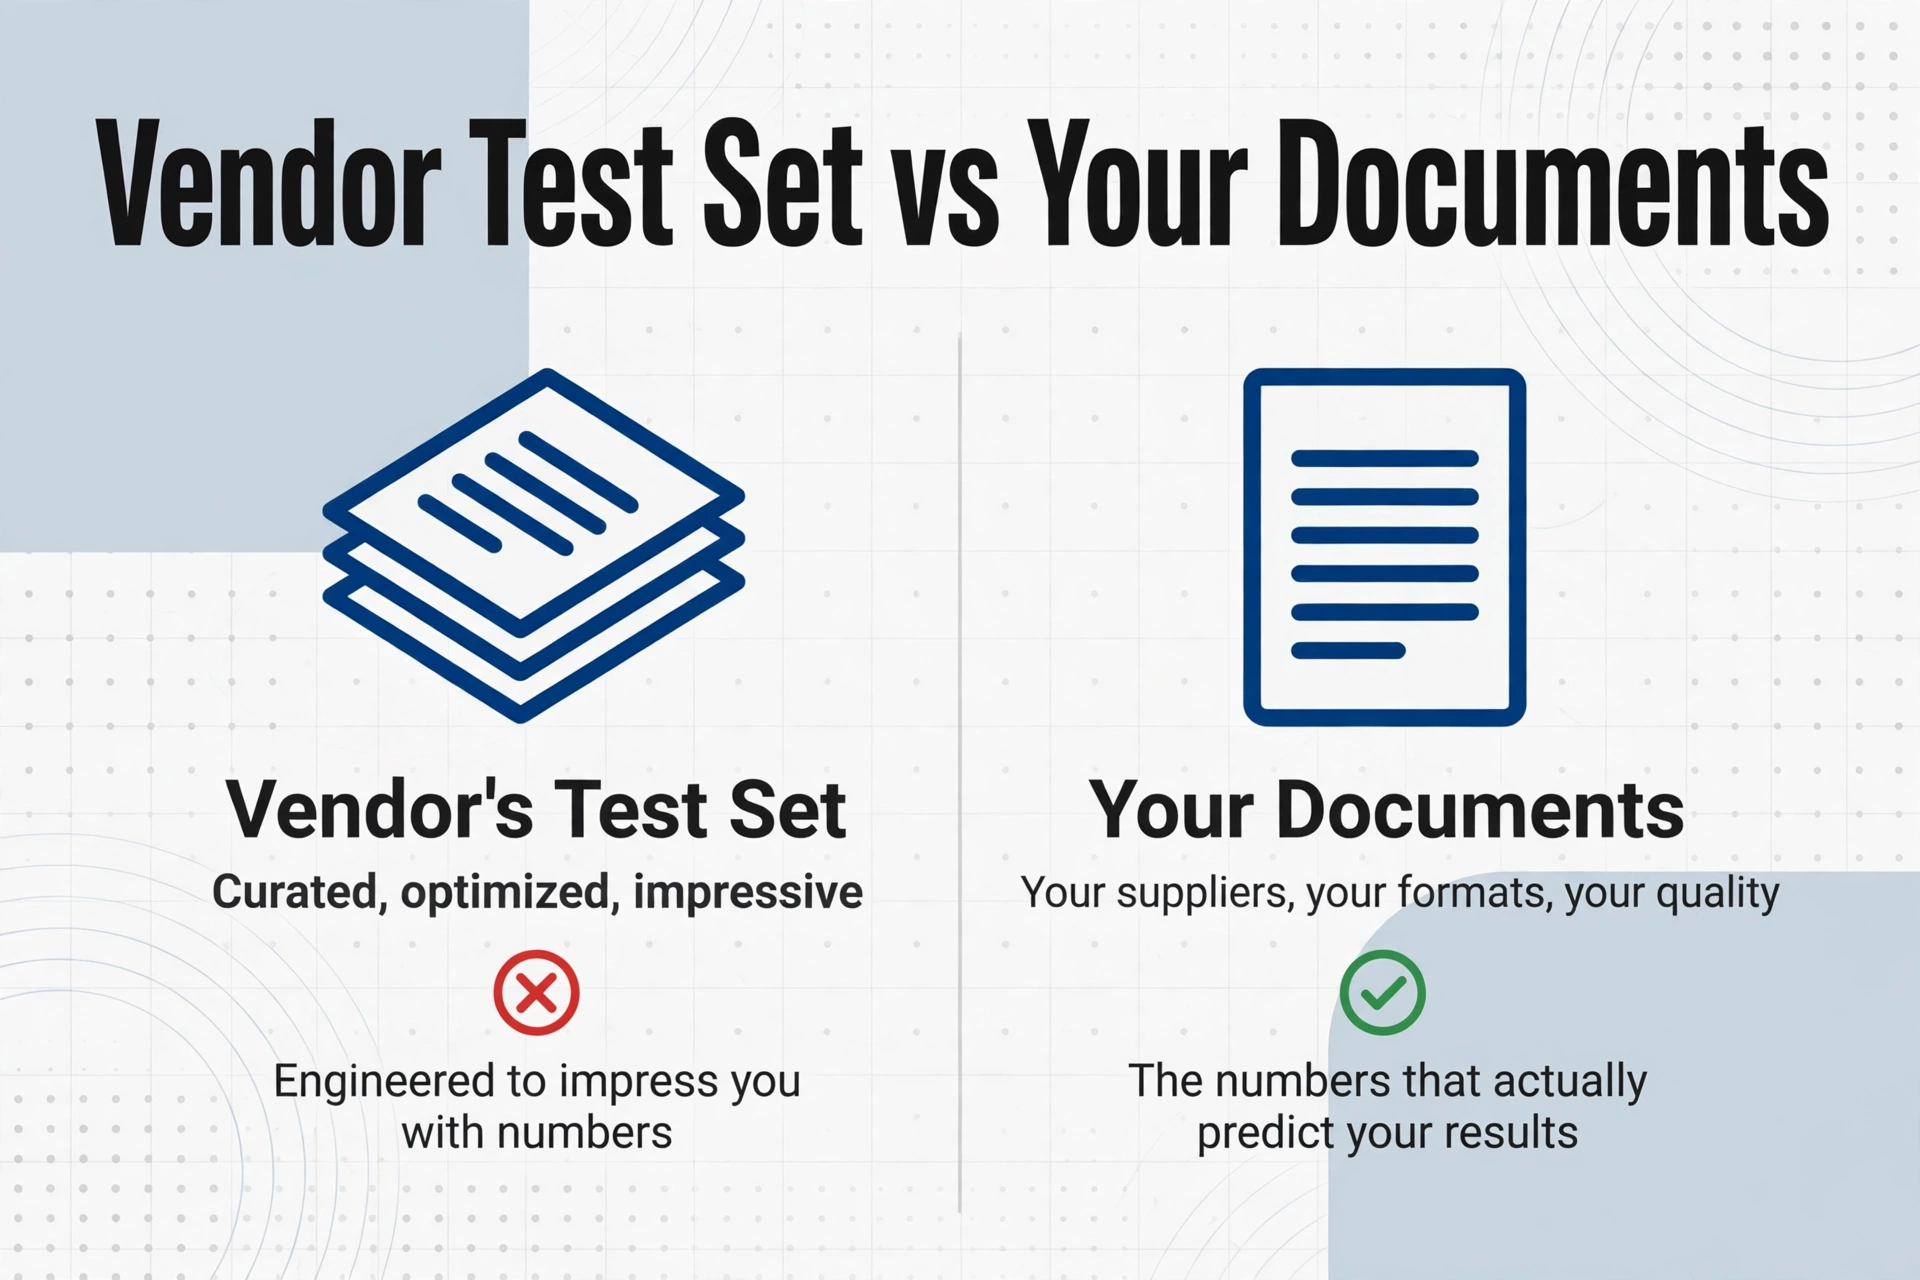
Esta é a única pergunta que realmente importa, e é a que a maioria dos compradores ignora. O conjunto de teste de um fornecedor contém os documentos deles — aqueles que eles escolheram, selecionaram e otimizaram. Seus documentos contêm seus fornecedores, seus clientes, seus formatos, sua qualidade de imagem, seus tipos de campo. São coisas diferentes.
Aqui está um teste prático: prepare uma amostra de 20 a 50 documentos que representem a variedade e a qualidade que sua equipe realmente encontra. Envie o mesmo conjunto para cada fornecedor que você está avaliando. Meça a precisão em nível de campo nos campos específicos que importam para você — total da fatura, número do pedido de compra, descrições de itens — não em texto irrelevante para seu fluxo de trabalho. Compare os resultados lado a lado.
Qualquer fornecedor que recusar uma avaliação cega com seus documentos, ou que oferecer apenas uma demonstração selecionada com amostras próprias, está lhe dando um número criado para impressionar — não para prever seu resultado. Um fornecedor que aceita seu conjunto de teste e compartilha onde a ferramenta dele acerta e onde tem dificuldades está lhe dizendo a verdade.
É aqui também que o paradigma de extração subjacente importa. Ferramentas tradicionais de OCR e sistemas baseados em modelos exigem que você treine ou configure cada novo formato. Ferramentas baseadas em modelos de visão-linguagem, como ImageToTable.ai, são sem modelo e independentes de formato: elas leem documentos entendendo o significado dos campos, não a posição deles na página, o que significa que uma única configuração funciona em vários layouts. A precisão que você mede na sua amostra de teste é a precisão que você terá em produção — sem ajuste específico de formato.
Perguntas Frequentes
O que é um bom número de precisão de OCR?
Um bom número depende do que você está extraindo e do que considera um erro. Para texto impresso limpo, precisão em nível de campo acima de 97% é alcançável com a maioria das ferramentas modernas. Para documentos manuscritos, 90–95% de precisão em nível de campo é realista com os melhores mecanismos. A resposta mais honesta: teste em seus documentos e defina seu próprio padrão. Não existe um número "bom" universal.
Por que os fornecedores usam precisão em nível de caractere se é enganosa?
Porque é o maior número que conseguem produzir. A precisão em nível de caractere se beneficia da média: um dígito errado em um total de 8 caracteres mais uma letra errada em um código de moeda de 4 caracteres resulta em 84% de precisão de caracteres nesses dois campos. Mas se você se importa que o total e o código de moeda estejam corretos, ambos os campos estão 100% errados. Os fornecedores relatam a métrica que faz seu produto parecer melhor — e a pressão dos compradores ainda não os forçou a padronizar a divulgação em nível de campo.
Posso confiar em benchmarks independentes de OCR?
Sim, com uma ressalva: certifique-se de que o benchmark testou tipos de documentos semelhantes aos seus. Um benchmark independente como o DeltOCR Bench da AIMultiple ou o OCRBench de código aberto fornece comparações neutras, mas a mistura de documentos pode não corresponder ao seu fluxo de trabalho. Use benchmarks como filtro de lista preliminar e depois teste os finalistas com seus próprios documentos.
Maior precisão sempre significa uma ferramenta melhor?
Não. Precisão é uma dimensão. Uma ferramenta que alcança 99,5% de precisão em nível de campo em faturas, mas exige dez amostras de treinamento por modelo, quebra quando um fornecedor muda o layout e precisa de manutenção contínua de um engenheiro de integração pode ser menos valiosa na prática do que uma ferramenta que entrega 97% de precisão no primeiro dia em todos os formatos, sem configuração. Esforço de configuração, custo de manutenção e amplitude de suporte a documentos muitas vezes importam mais do que os últimos dois pontos percentuais de precisão.
O Que Fazer em Seguida
Afirmações de precisão não são inúteis — apenas incompletas. Um fornecedor que responde claramente às cinco perguntas, compartilha resultados em nível de campo por tipo de documento, divulga exclusões e tolerâncias e convida você a testar em seus próprios documentos é um fornecedor que vale a pena levar a sério. Um fornecedor que se esquiva, redireciona para um estudo de caso ou oferece apenas uma demonstração selecionada também está lhe dizendo algo — ouça.
Aproveite a próxima hora para reunir um conjunto de amostras dos documentos que sua equipe processa com mais frequência. Execute-os nas ferramentas da sua lista preliminar. Meça a precisão em nível de campo nos campos que importam para seu fluxo de trabalho — não em cada caractere da página. O número que você obtiver será menor do que a alegação de marketing. Mas será o seu número, e é o único que vale a pena usar para tomar uma decisão.