Cómo leer una afirmación de precisión de OCR
de OCR: 5 preguntas que hacer antes de comprar
Cada semana, alguien que evalúa herramientas de extracción de documentos lee la afirmación de "99% de precisión" de un proveedor, se registra, sube su primer lote de documentos reales y descubre que la precisión real se acerca más al 85%. No les engañó una mentira. Les engañó un número que nunca se diseñó para responder a la pregunta que realmente hacían: "¿Funcionará esta herramienta con mis documentos?" La brecha entre la precisión reportada por el proveedor y el rendimiento en el mundo real no es un accidente: es el resultado predecible de cómo se construyen las afirmaciones de precisión. Y una vez que sabes qué preguntar, la brecha se vuelve visible antes de comprar.
Puntos clave
- Las afirmaciones de 99% de precisión excluyen los documentos desordenados que realmente procesas porque se miden en escaneos limpios y perfectos con todos los casos difíciles eliminados primero.
- La precisión a nivel de caracteres oculta el hecho de que en la extracción de campos del mundo real tu herramienta podría estar de 10 a 15 puntos por debajo del número destacado.
- Prueba 20 de tus propios documentos esta noche en cada herramienta preseleccionada porque el único número de precisión que vale para decidir es el que mides tú mismo.
Por qué el 99 % significa menos de lo que crees
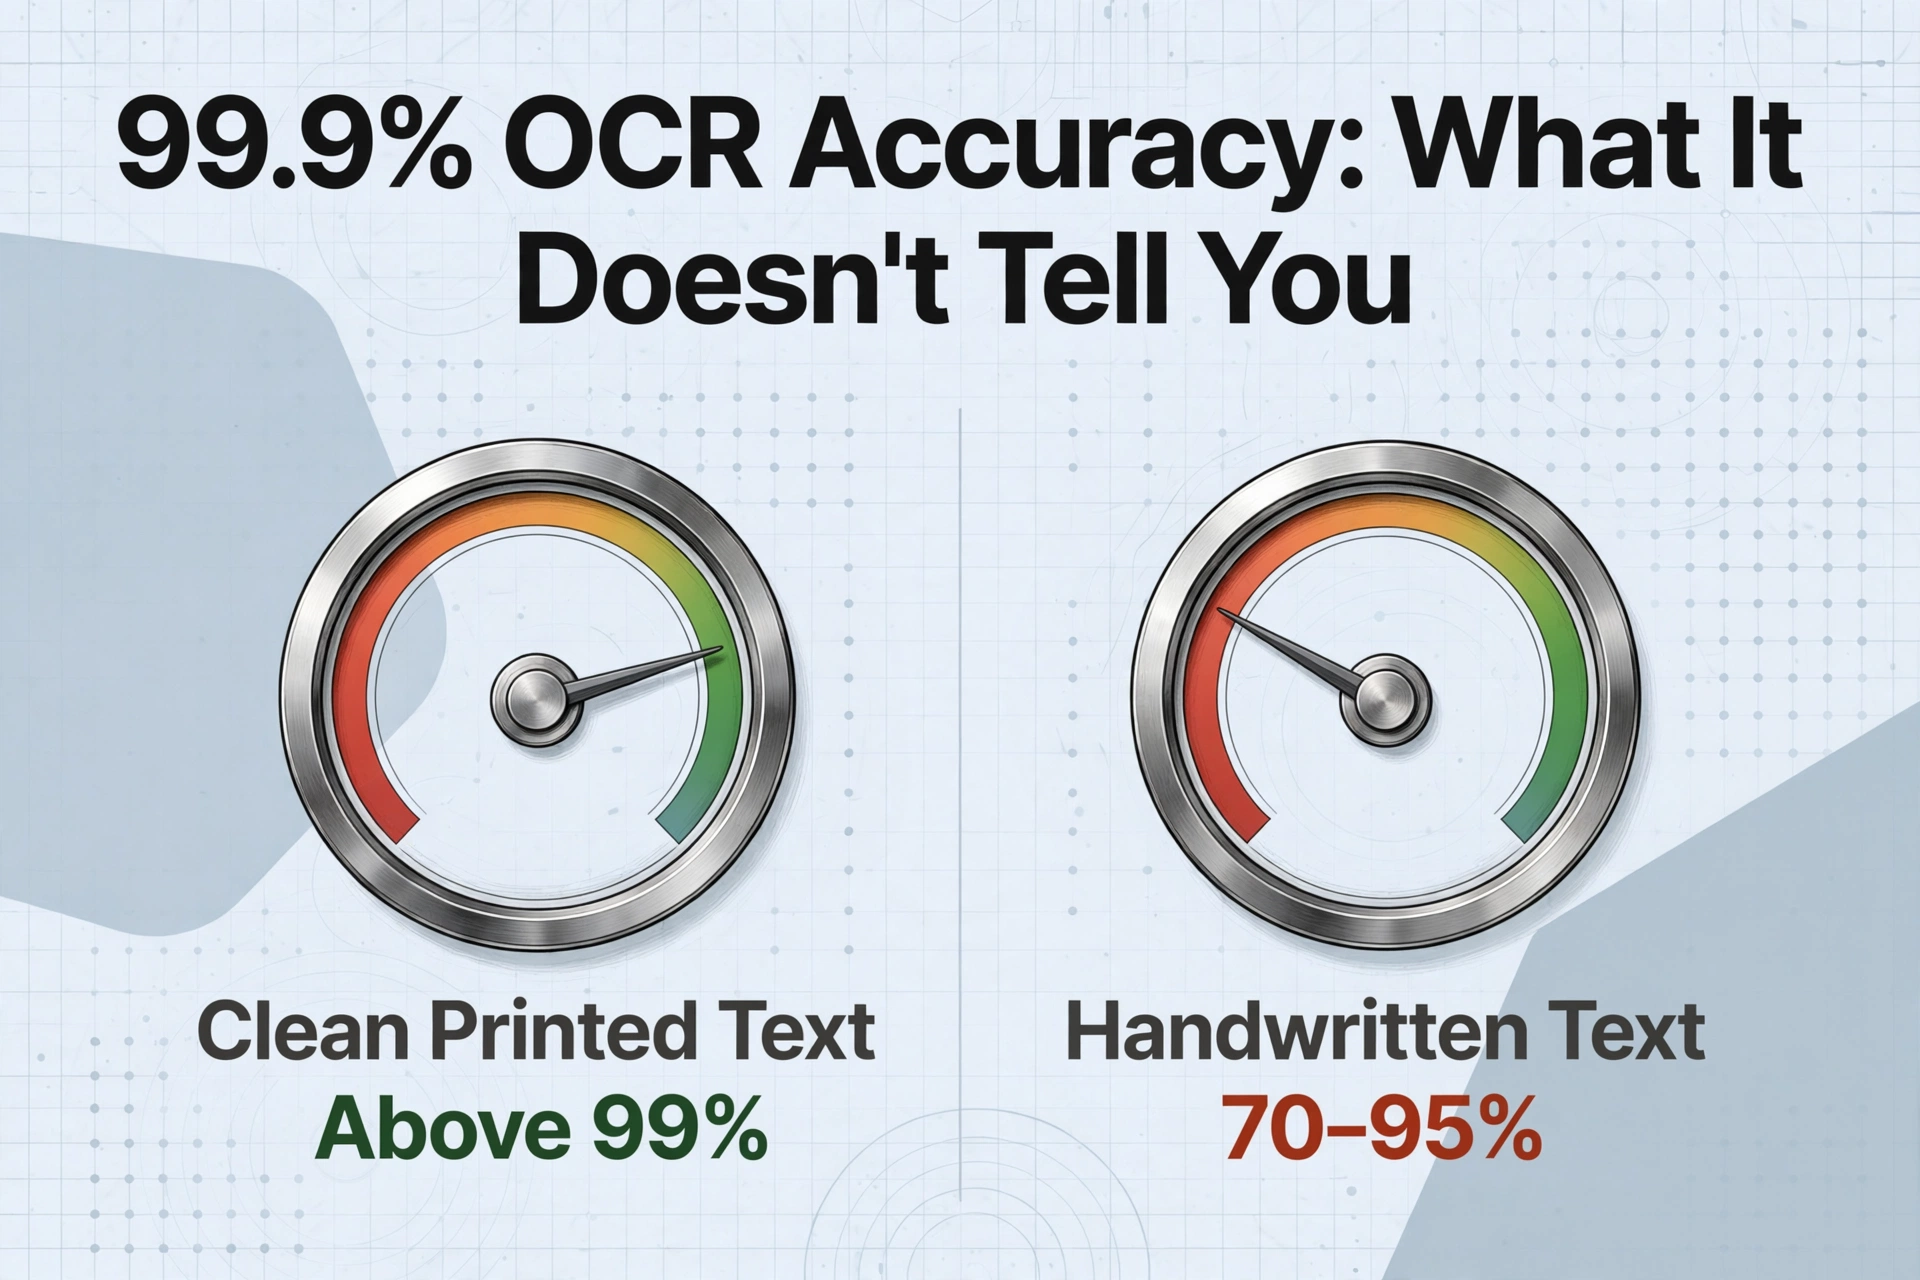
Una página de inicio típica de una herramienta de extracción de documentos podría decir: «99,9 % de precisión OCR en facturas». El número aparece junto a un icono de verificación. Parece una prueba. Parece de nivel ingenieril. Pero esto es lo que no te dice: si ese 99,9 % se midió en escaneos de calidad perfecta de una sola plantilla, si se refiere a caracteres o a campos, y si el conjunto de prueba excluyó los tipos de documento que tú procesas realmente.
Los benchmarks independientes del benchmark de OCR de AIMultiple de 2026 ilustran la brecha: los servicios de API líderes superan el 99 % en texto impreso nítido, pero bajan a alrededor del 70–95 % en escritura a mano según el motor — un rango lo bastante amplio como para que dos herramientas que afirman un 99 % global difieran en 25 puntos porcentuales en tus documentos reales. El número destacado no te dice en qué grupo cae un proveedor porque nunca estuvo pensado para eso.
Las cinco preguntas siguientes convierten una afirmación vaga de precisión en una evaluación concreta. Hazlas antes de evaluar y verás qué proveedores han hecho pruebas reales — y cuáles esperan que no preguntes.
P1: ¿Probado con qué documentos?
La precisión no es una propiedad de una herramienta. Es una propiedad de una herramienta sobre un conjunto específico de documentos. Cambia el conjunto y el número cambia — a veces drásticamente. Un proveedor que prueba con facturas uniformes, de alta resolución y en un solo idioma reportará mayor precisión que uno que prueba con un corpus mixto de formularios manuscritos, fotocopias desvaídas y recibos fotografiados con el móvil. Ambos números pueden ser ciertos. Solo uno predice lo que vas a experimentar.
Pide la composición exacta del conjunto de prueba: cuántos documentos, de cuántas fuentes, en cuántos idiomas, en qué rango de resolución. Si el proveedor no puede dar este desglose, la cifra de precisión no tiene anclaje. Es una afirmación sobre un conjunto de datos desconocido aplicada a un documento desconocido — es decir, no es útil.
Este también es el momento adecuado para comprobar si la herramienta se basa en coincidencia de plantillas u OCR por zonas, que se rompe cuando los diseños varían. Como explicamos en qué significa realmente la precisión OCR, los sistemas basados en plantillas pueden rendir bien dentro de su formato entrenado y fallar por completo fuera de él — algo que un único número del «99 %» nunca revelará.
P2: ¿A qué nivel: carácter, palabra o campo?
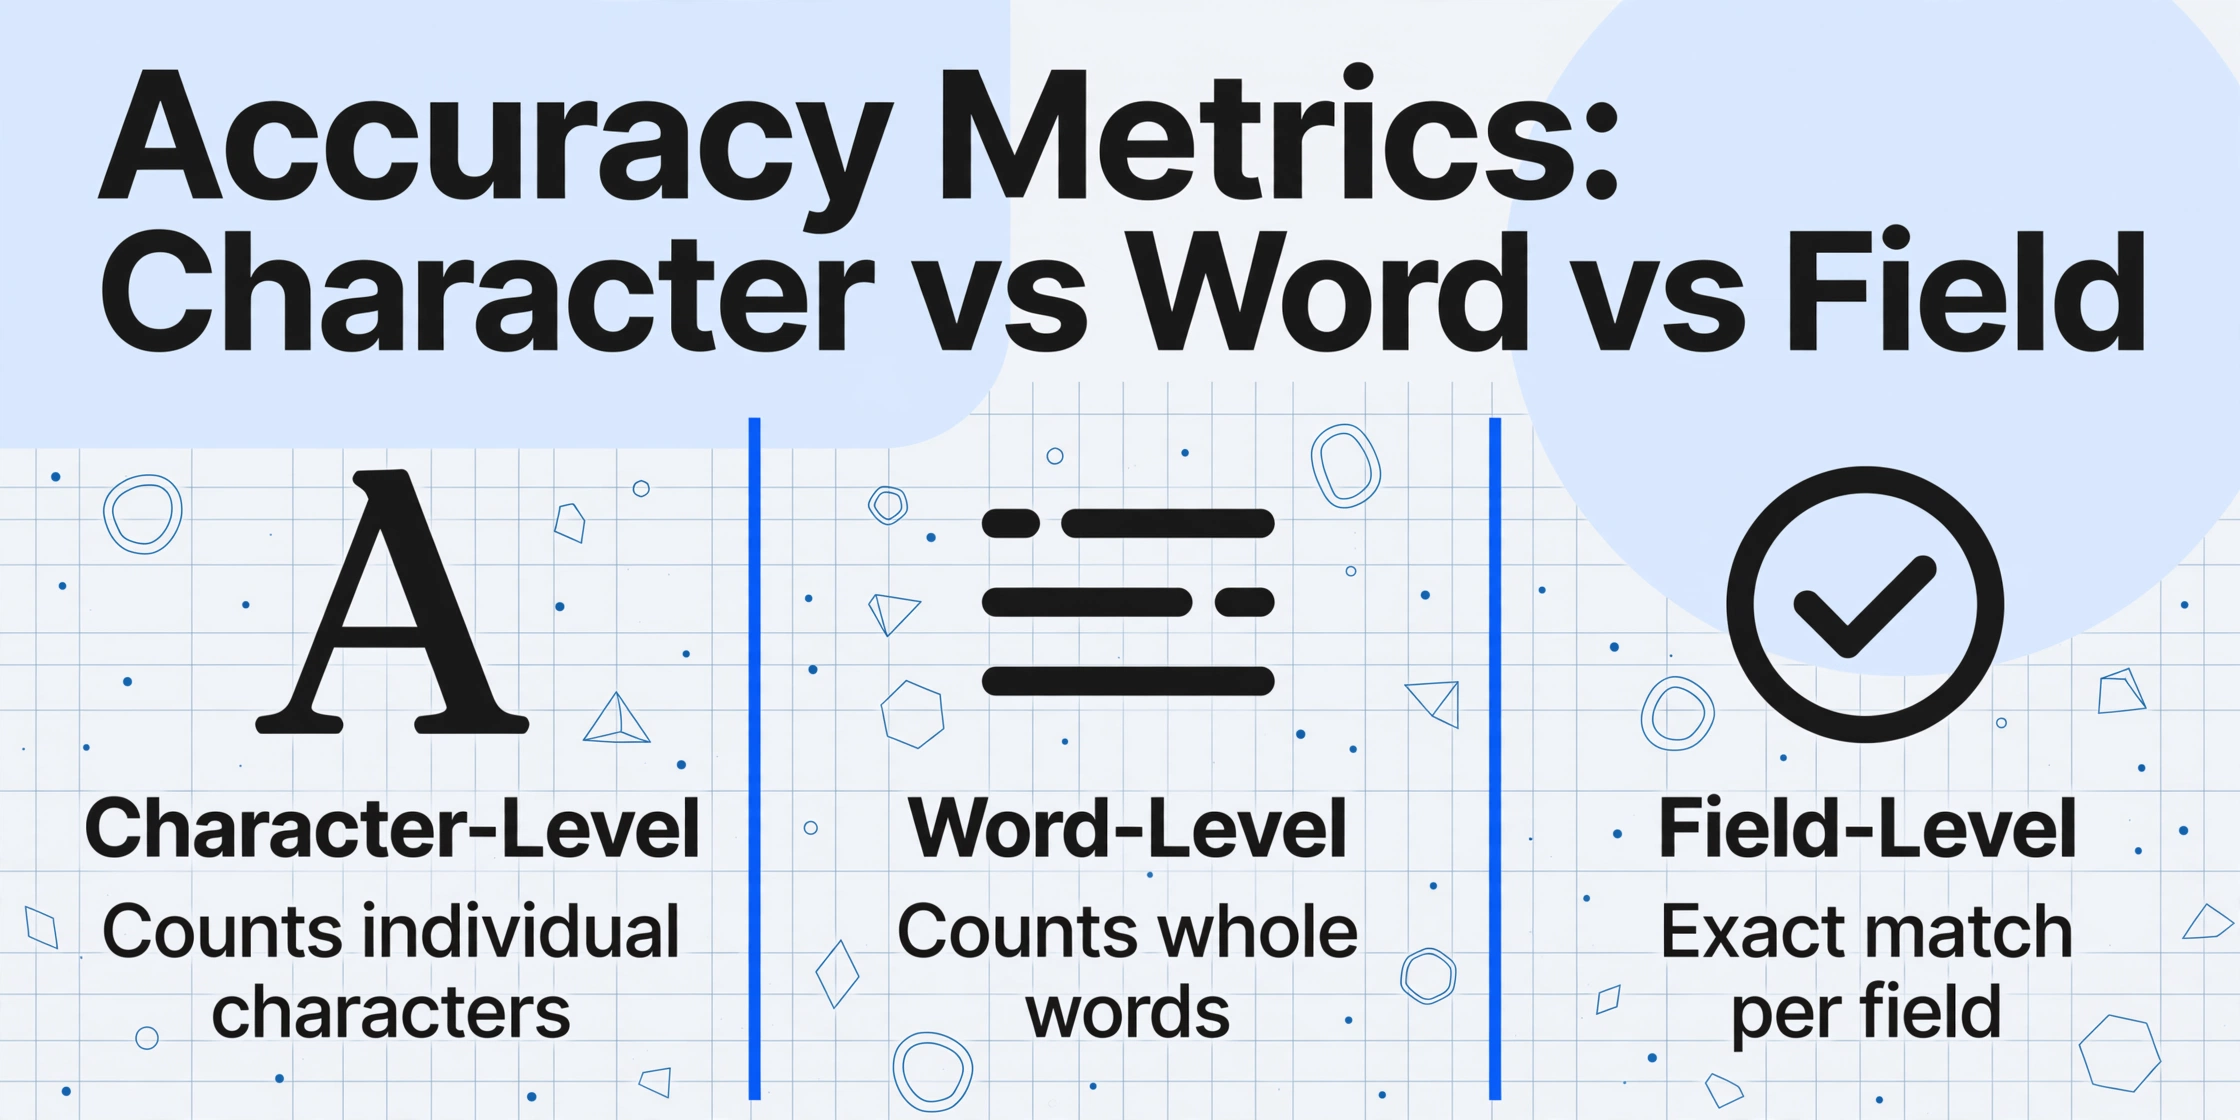
La precisión se puede medir en tres niveles, y los proveedores tienden a reportar el que produce el número más alto.
La precisión a nivel de carácter (CER) cuenta cuántos caracteres individuales lee correctamente el motor. Si un documento tiene 1.000 caracteres y 990 son correctos, eso es un 99% de CER. Suena impresionante. También es la métrica menos útil para cualquier tarea del mundo real, porque un solo carácter erróneo puede destruir el valor de un campo entero. Un total de factura de $1,429.50 que el OCR lee como $1,429.50 tiene 7 de 8 caracteres correctos — 87,5% de precisión de caracteres — pero el campo está completamente mal. Si ese es el total que paga tu sistema de cuentas por pagar, el error cuesta dinero sin importar lo limpios que estuvieran el resto de los caracteres.
La precisión a nivel de campo (también llamada semántica o de coincidencia exacta) mide si cada dato completo — número de factura, fecha de vencimiento, importe de la línea — se extrae perfectamente. Un campo o es correcto o no lo es. Un solo dígito mal leído hace fallar todo el campo. Esta es la métrica que se corresponde con resultados empresariales reales. Un benchmark de 2026 del análisis de precisión de OCR de LlamaIndex fija el umbral de precisión a nivel de campo para el procesamiento directo en 99,9% — es decir, un error por cada mil campos. Por debajo de eso, la revisión manual es inevitable.
La diferencia entre la precisión a nivel de carácter y a nivel de campo no es académica. Una herramienta que reporta 99% de precisión de caracteres puede ofrecer una precisión de campo inferior al 90% en los mismos documentos. Como exploramos en por qué baja la precisión del OCR según el tipo de documento, la brecha se amplía aún más en diseños complejos, donde un solo límite de tabla mal interpretado desordena todos los campos de una fila.
Cuando un proveedor cita una cifra de precisión, tu primera pregunta de seguimiento debería ser: "¿Es a nivel de carácter, de palabra o de campo? ¿Y puedes compartir los resultados a nivel de campo desglosados por tipo de documento?"
P3: ¿Qué se excluyó del conjunto de pruebas?
El documento de metodología de pruebas de un proveedor — el que publica en su blog o incluye en un whitepaper — a menudo contiene información más útil en sus criterios de exclusión que en sus cifras de precisión. ¿Qué dejaron fuera deliberadamente?
Las exclusiones habituales incluyen: texto manuscrito, documentos con sellos o logotipos que se superponen a los campos de datos, PDF de varias páginas, fotos de móvil de baja resolución, idiomas distintos del inglés y cualquier documento con anotaciones o correcciones en los márgenes. Cada exclusión reduce la aplicabilidad de la precisión declarada. Una cifra del 99% que excluye la escritura a mano no aporta nada si tu flujo de trabajo incluye albaranes manuscritos — y como detallamos en la realidad de la precisión del OCR con escritura a mano, la diferencia entre la precisión de texto impreso y manuscrito puede ser de 20 puntos porcentuales o más en el mismo motor. Un benchmark que excluye documentos multilingües no te dice nada sobre cómo manejará la herramienta una factura bilingüe.
Una exclusión especialmente importante es el tratamiento de imágenes rotadas, inclinadas o de bajo contraste. Los motores OCR tradicionales son frágiles con estas entradas. Como señala nuestra comparativa de software OCR de 2026, algunas herramientas aplican pipelines de preprocesamiento que normalizan la calidad de la imagen antes del reconocimiento — pero muchas no lo hacen, y sus afirmaciones de precisión asumen implícitamente que la entrada ya está limpia.
Pregunta directamente: "¿Qué tipos de documentos, niveles de calidad y condiciones excluiste, y puedes compartir resultados de precisión específicamente en los tipos de documentos que excluiste?" La respuesta te dirá más que la cifra destacada.
P4: ¿Qué tolerancia de error se aplicó?
Incluso a nivel de campo, hay una variable menos obvia: ¿qué tan cerca debe estar un valor para contar como "correcto"? Algunos proveedores cuentan un campo como preciso si el valor extraído coincide tras una normalización de formato menor — eliminar puntuación, estandarizar formatos de fecha, ignorar ceros iniciales. Eso es razonable. Pero otros van más allá: cuentan un campo numérico como correcto si está dentro de cierto porcentaje del valor de referencia, o aceptan un campo si coincide cualquier subcadena, o tratan un número escrito con letras como equivalente a su forma en dígitos.
Estas tolerancias no son necesariamente incorrectas. Algunas aplicaciones realmente no les importa si una fecha está formateada como MM/DD/AAAA o AAAA-MM-DD. El problema es que la tolerancia casi nunca se divulga junto con la cifra de precisión. Una cifra del 98% a nivel de campo que permite una variación del 5% en importes monetarios significa algo muy distinto de una cifra del 98% que exige coincidencia exacta carácter por carácter en cada campo.
Esto es especialmente relevante para campos numéricos como totales, cantidades e importes de impuestos — los campos donde la precisión más importa y donde incluso un solo dígito erróneo crea un dolor de cabeza de conciliación. Si una herramienta reporta 99% de precisión a nivel de campo en totales de facturas pero cuenta $1,429.50 y $1,429.00 como coincidencia porque la diferencia está dentro de una banda de tolerancia del 1%, entonces la precisión real de coincidencia exacta es menor que la anunciada.
Pregunta: "¿Qué califica exactamente como una extracción correcta? ¿Se cuentan las coincidencias aproximadas como correctas? ¿Con qué umbral?"
P5: ¿Cuál es la precisión en documentos similares a los tuyos?
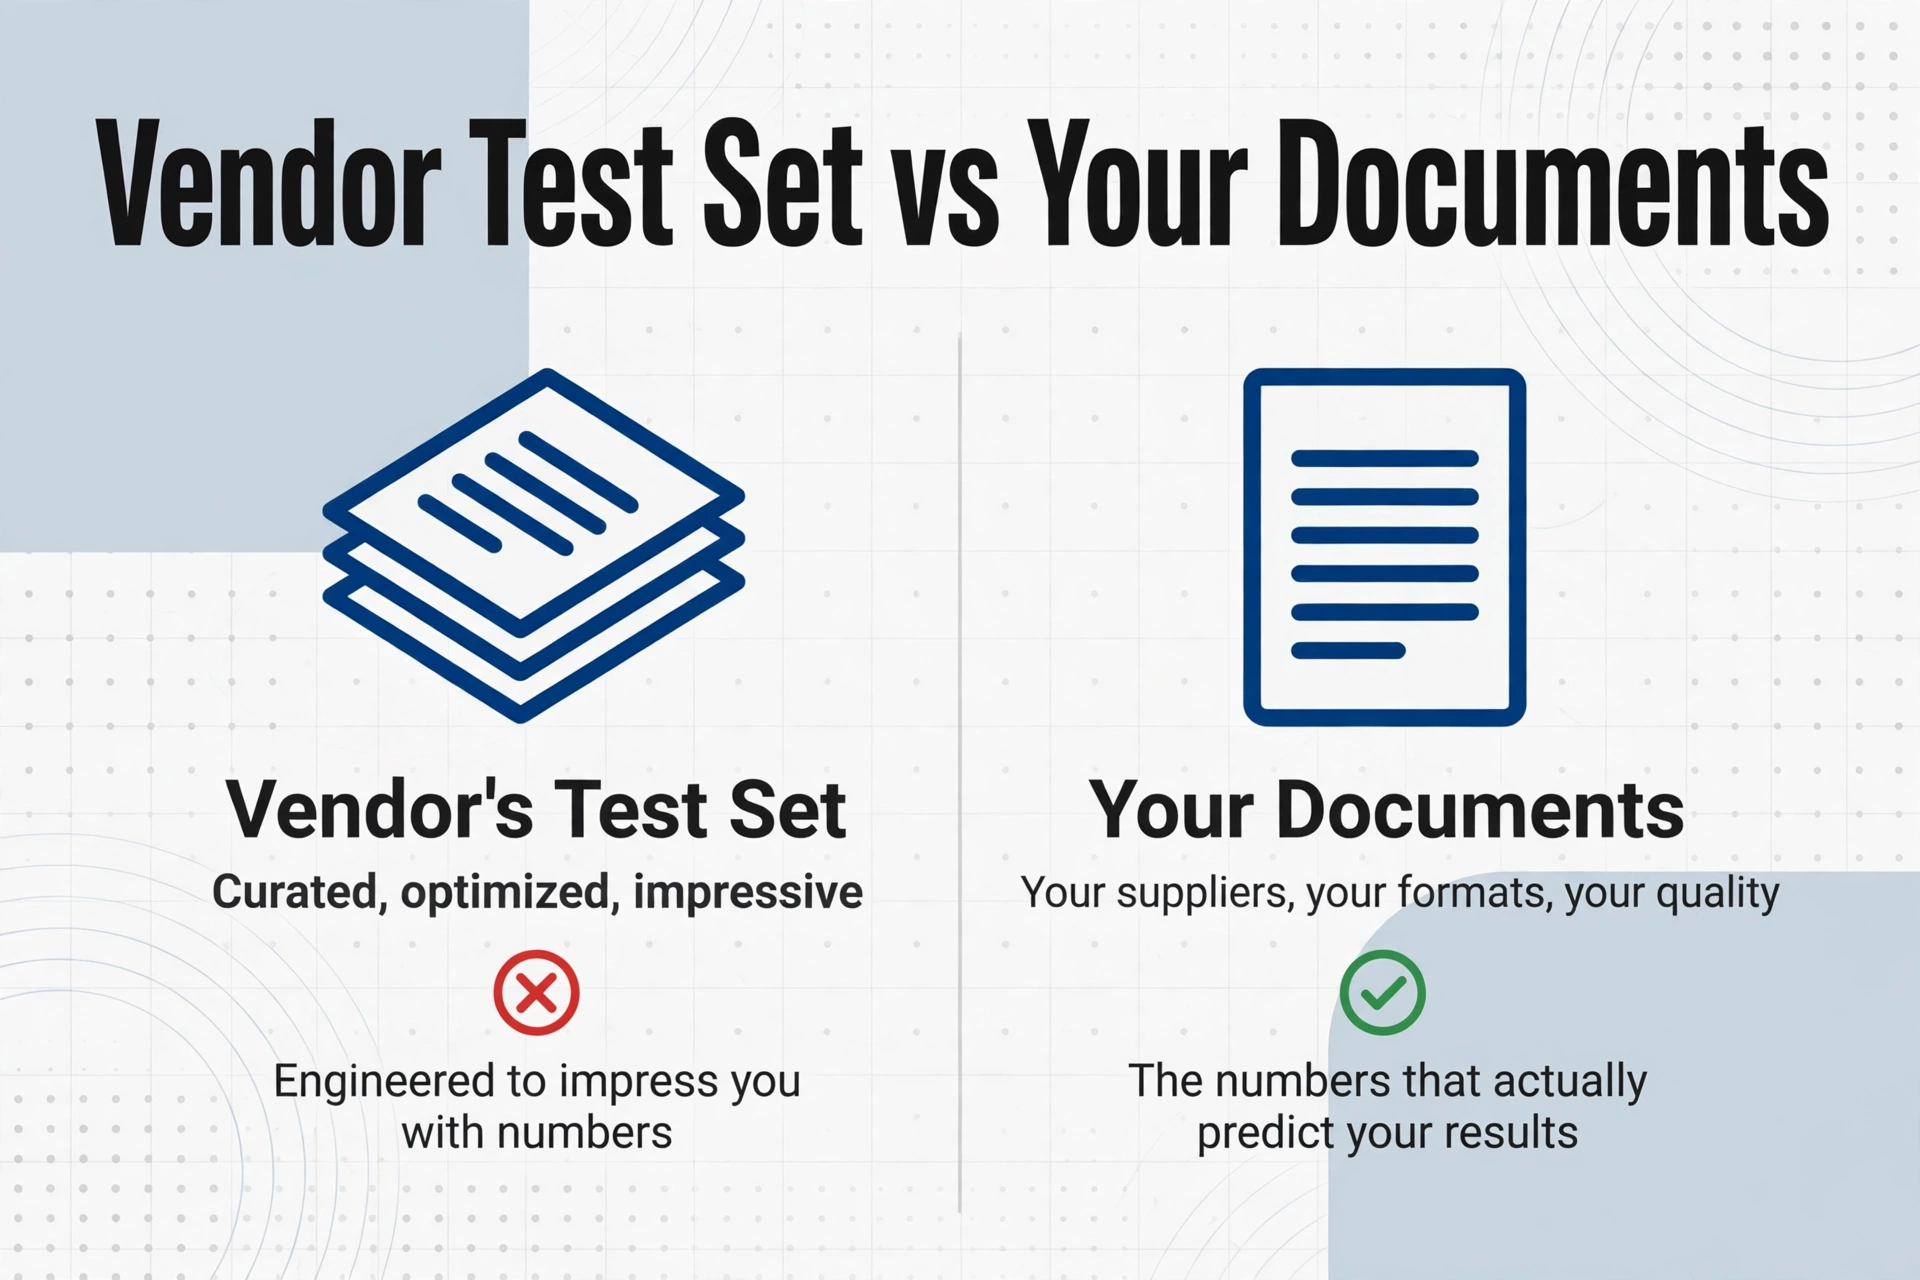
Esta es la única pregunta que realmente importa, y es la que la mayoría de los compradores omite. El conjunto de prueba de un proveedor contiene sus documentos: los que eligió, curó y optimizó. Tus documentos contienen tus proveedores, tus clientes, tus formatos, tu calidad de imagen, tus tipos de campos. Son cosas diferentes.
Aquí tienes una prueba práctica: prepara una muestra de 20 a 50 documentos que representen el rango de calidad y variedad que tu equipo encuentra realmente. Envía el mismo conjunto a cada proveedor que estés evaluando. Mide la precisión a nivel de campo en los campos específicos que te importan —total de factura, número de orden de compra, descripciones de líneas de detalle—, no en texto irrelevante para tu flujo de trabajo. Compara los resultados lado a lado.
Cualquier proveedor que rechace una evaluación a ciegas con tus documentos, u ofrezca solo una demo curada con sus propias muestras, te está dando un número diseñado para impresionar, no para predecir tu resultado. Un proveedor que acepta tu conjunto de prueba y comparte dónde su herramienta tiene éxito y dónde falla te está diciendo la verdad.
Aquí también importa el paradigma de extracción subyacente. Las herramientas de OCR tradicionales y los sistemas basados en plantillas requieren que los entrenes o configures para cada nuevo formato. Las herramientas basadas en modelos de visión-lenguaje como ImageToTable.ai son sin plantilla e independientes del formato: leen los documentos entendiendo el significado de los campos en lugar de su posición en la página, lo que significa que una sola configuración funciona en todos los diseños. La precisión que mides en tu muestra de prueba es la precisión que obtendrás en producción, sin necesidad de ajustes específicos por formato.
Preguntas frecuentes
¿Qué es una buena cifra de precisión OCR?
Una buena cifra depende de lo que estés extrayendo y de lo que consideres un error. Para texto impreso limpio, una precisión a nivel de campo superior al 97% es alcanzable con la mayoría de las herramientas modernas. Para documentos manuscritos, una precisión a nivel de campo del 90–95% es realista con los mejores motores. La respuesta más honesta: prueba con tus documentos y establece tu propio punto de referencia. No existe una cifra "buena" universal.
¿Por qué los proveedores usan la precisión a nivel de carácter si es engañosa?
Porque es la cifra más alta que pueden producir. La precisión a nivel de carácter se beneficia del promedio: un dígito incorrecto en un total de 8 caracteres más una letra incorrecta en un código de moneda de 4 caracteres produce una precisión de caracteres del 84% en esos dos campos. Pero si te importa que el total y el código de moneda sean correctos, ambos campos están 100% mal. Los proveedores reportan la métrica que hace que su producto se vea mejor, y la presión de los compradores aún no los ha obligado a estandarizar el reporte a nivel de campo.
¿Puedo confiar en los benchmarks independientes de OCR?
Sí, con una advertencia: asegúrate de que el benchmark se haya probado con tipos de documentos similares a los tuyos. Un benchmark independiente como DeltOCR Bench de AIMultiple o el OCRBench de código abierto ofrece comparaciones neutrales, pero la mezcla de documentos puede no coincidir con tu flujo de trabajo. Usa los benchmarks como filtro para hacer una lista corta y luego prueba a los finalistas con tus propios documentos.
¿Una mayor precisión siempre significa una mejor herramienta?
No. La precisión es solo una dimensión. Una herramienta que logra un 99,5% de precisión a nivel de campo en facturas pero requiere diez muestras de entrenamiento por plantilla, se rompe cuando un proveedor cambia su diseño y necesita mantenimiento continuo de un ingeniero de integración puede ser menos valiosa en la práctica que una herramienta que ofrece un 97% de precisión desde el primer día en todos los formatos y sin configuración. El esfuerzo de configuración, el costo de mantenimiento y la amplitud de soporte de documentos suelen importar más que los últimos dos puntos porcentuales de precisión.
Qué hacer a continuación
Las afirmaciones de precisión no son inútiles, solo son incompletas. Un proveedor que responde claramente las cinco preguntas, comparte resultados a nivel de campo por tipo de documento, revela exclusiones y tolerancias, y te invita a probar con tus propios documentos es un proveedor que vale la pena tomar en serio. Un proveedor que evade, redirige a un caso de éxito o solo ofrece una demo seleccionada también te está diciendo algo: escúchalo.
Dedica la próxima hora a reunir un conjunto de muestra de los documentos que tu equipo procesa con más frecuencia. Pásalos por las herramientas de tu lista corta. Mide la precisión a nivel de campo en los campos que importan a tu flujo de trabajo, no en cada carácter de la página. La cifra que obtengas será más baja que la promesa de marketing. Pero será tu cifra, y es la única sobre la que vale la pena tomar una decisión.