Le guide complet de
l'extraction de données EOB (2026)
L'enquête 2023 de la HFMA (Healthcare Financial Management Association) a révélé que 35 % des organismes de santé signalent des erreurs liées à la saisie manuelle des données EOB, et que 43 % subissent des retards de paiement en conséquence directe. Ces chiffres décrivent l'écart entre ce qu'une déclaration de prestations (EOB) indique et ce qui est réellement saisi dans un système de facturation — un écart qui persiste non pas parce que le personnel est négligent, mais parce que le secteur demande aux gens de faire quelque chose de fondamentalement contre nature avec ces documents : traiter la mise en page de chaque payeur comme si elle était identique, alors qu'aucune ne l'est.
Points clés à retenir
- 35 % des prestataires signalent des erreurs de saisie de données EOB — non pas parce que votre équipe de facturation est négligente, mais parce qu'aucun humain ne peut lire le même champ de données sur 6 000 mises en page de payeurs différentes sans commettre d'erreur.
- Les 2 500 $ par mois que vous voyez en main-d'œuvre de transcription doublent lorsque vous ajoutez les corrections d'erreurs, les litiges de facturation des patients et les sous-paiements manqués enfouis dans des lignes budgétaires distinctes — des coûts qu'aucun rapport unique ne totalise jamais.
- La mesure qui compte n'est pas les minutes par EOB — c'est la récupération de 100 heures par mois pour que votre équipe de facturation puisse arrêter de taper des chiffres et commencer à traquer les sous-paiements et les refus qui font réellement bouger les revenus.
Qu'est-ce que l'extraction de données EOB ?
L'extraction de données EOB est le processus automatisé de lecture des champs clés d'une demande d'assurance à partir d'un document EOB (Explanation of Benefits) — nom du patient, prestataire, dates de service, codes de procédure CPT, montants facturés, montants autorisés, paiements d'assurance, ajustements, répartition de la responsabilité du patient, et codes de refus ou de remarque — et de leur conversion en données structurées qu'un système de facturation ou un tableur peut ingérer.
Le document lui-même, la déclaration de prestations, est envoyé par un assureur santé après l'adjudication d'une demande. Ce n'est pas une facture. C'est un relevé de ce que le prestataire a facturé, de ce que l'assureur a autorisé selon le régime, de ce qui a été payé au prestataire ou au patient, et de ce que le patient doit encore. Pour une introduction plus approfondie au concept, consultez notre article dédié sur ce qu'est l'extraction de données EOB et comment elle fonctionne.
Ce qui distingue l'extraction EOB des autres tâches d'extraction documentaire, c'est la relation entre les champs de données. La valeur d'un EOB ne réside pas dans un seul chiffre — elle réside dans la façon dont le montant facturé, le montant autorisé, le paiement du régime, la franchise, le coassurance, le ticket modérateur et la responsabilité du patient s'articulent ensemble. Extraire ces chiffres correctement mais perdre l'arithmétique qui les relie donne un résultat techniquement exact mais pratiquement inutile pour le rapprochement de facturation.
Pourquoi le traitement manuel des EOB coûte plus cher que vous ne le pensez
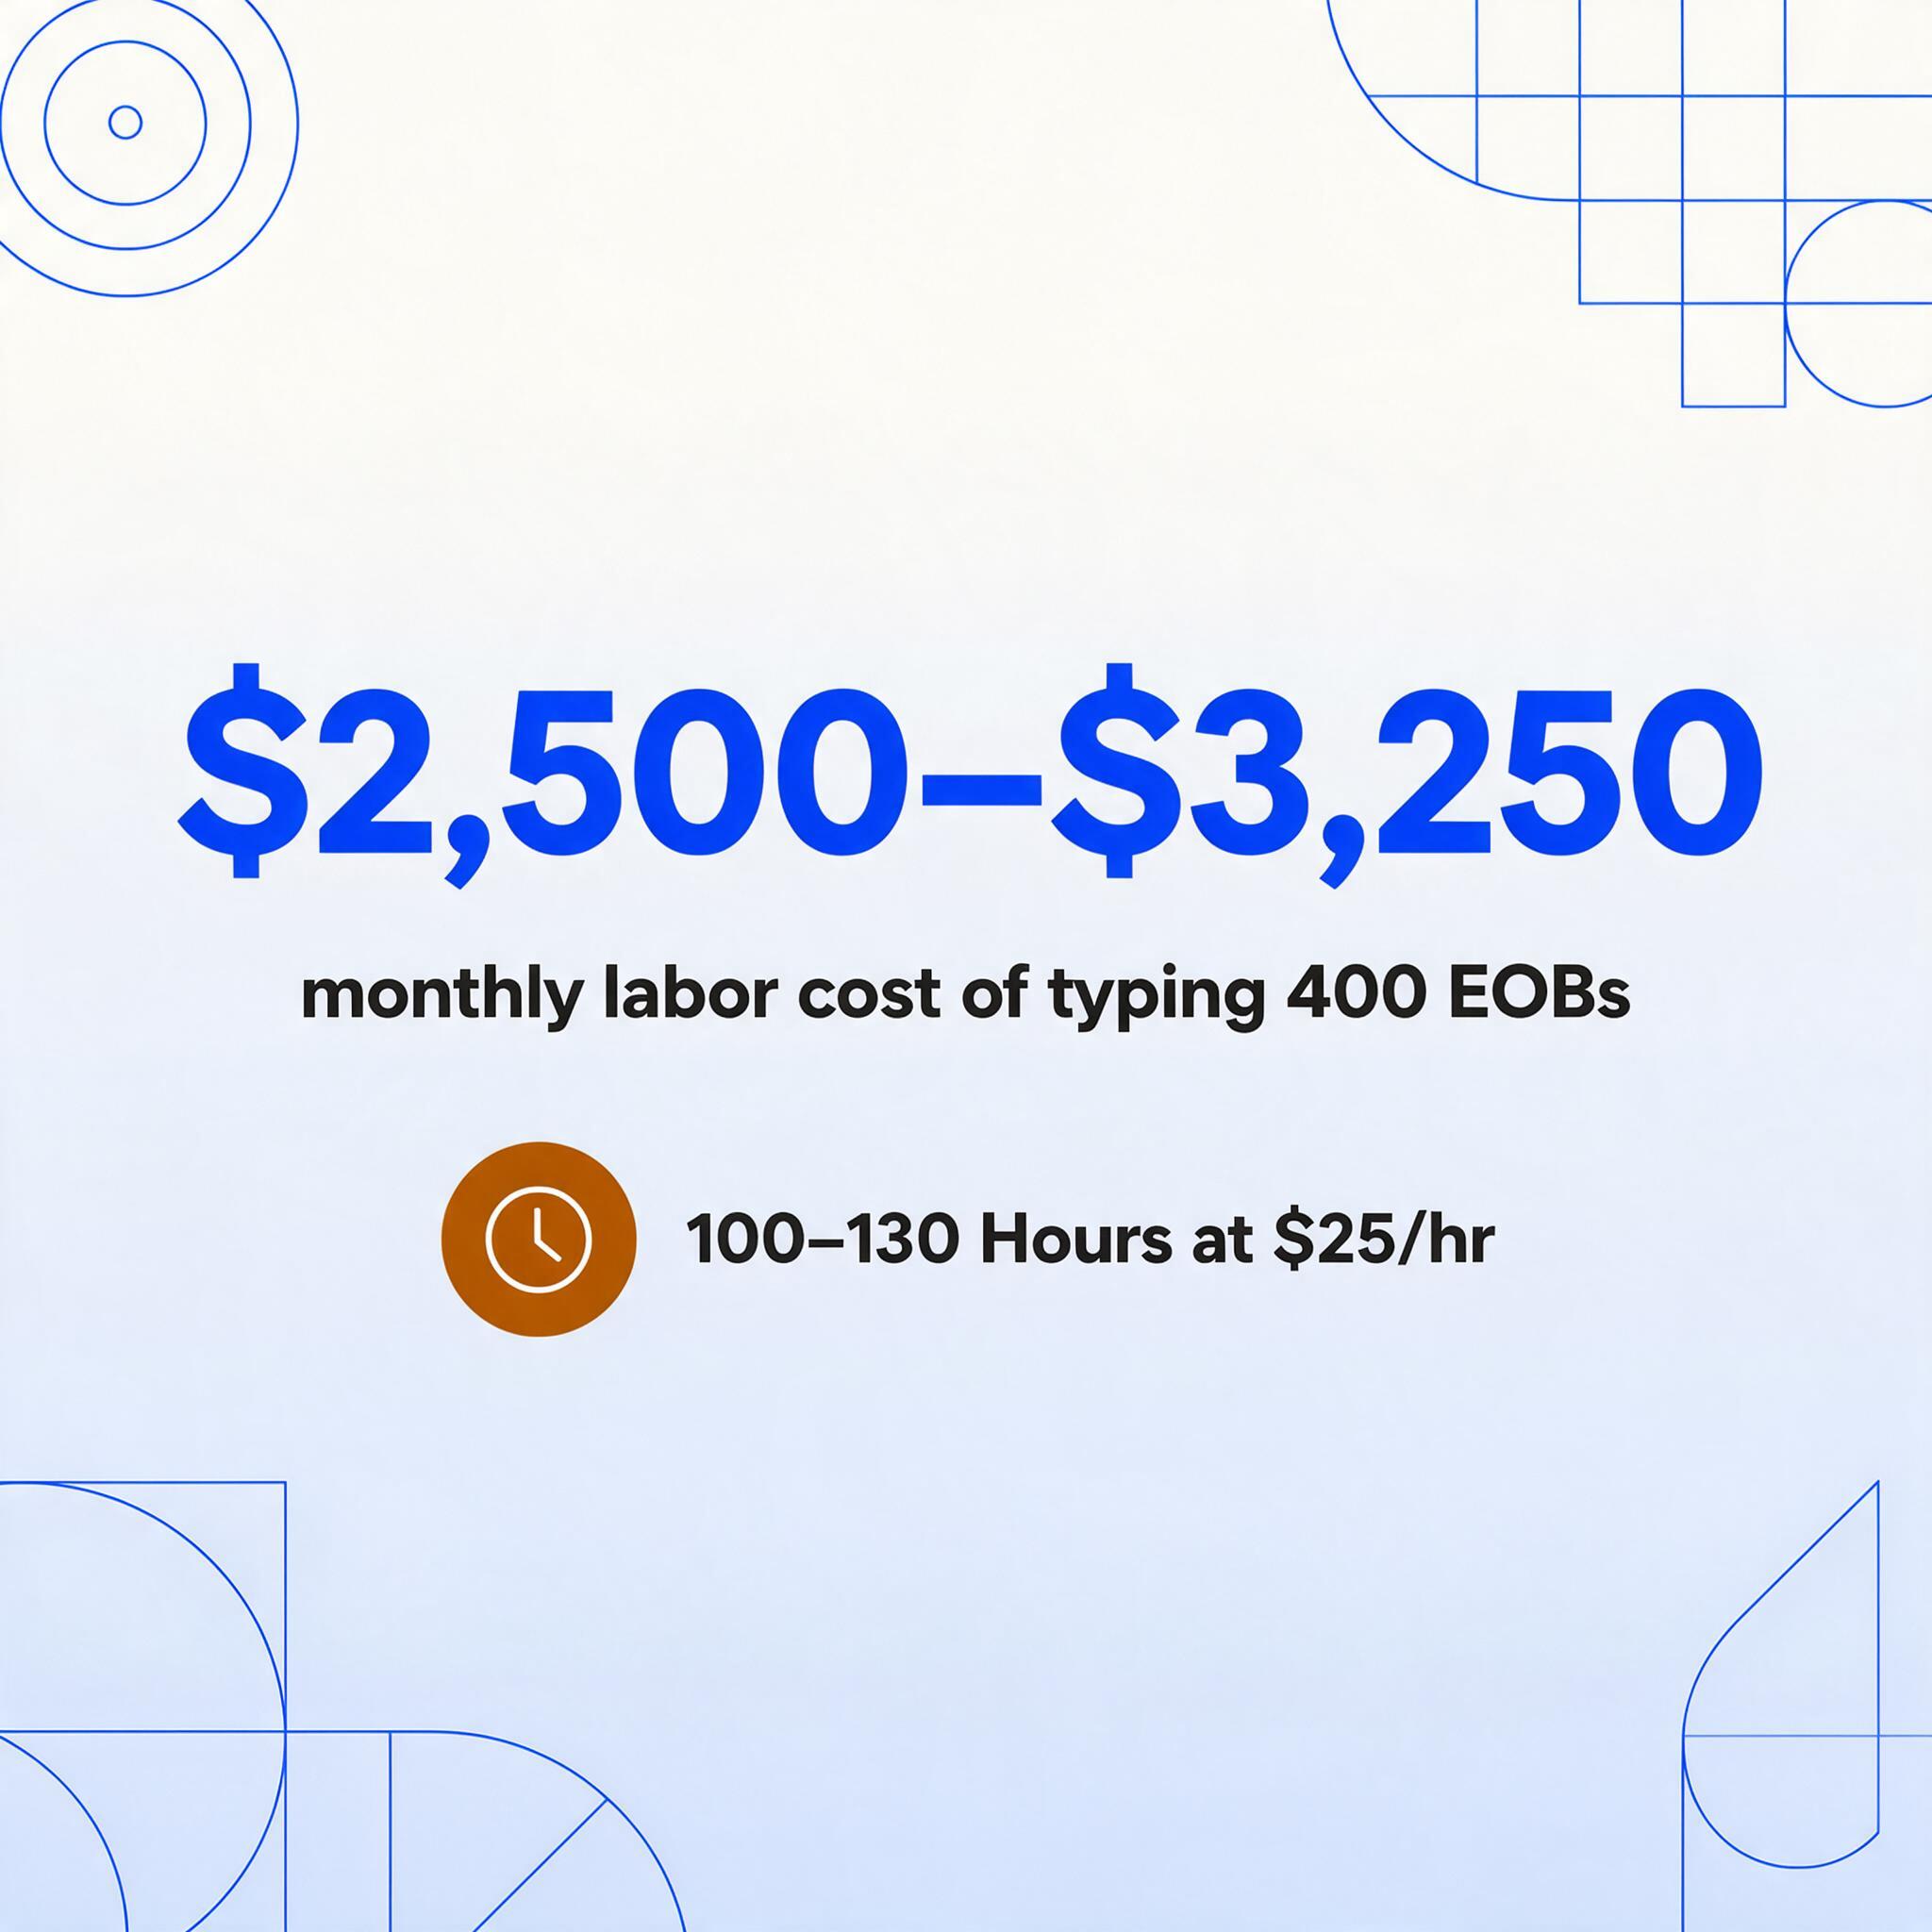
Le traitement manuel des EOB semble peu coûteux sur le papier — un spécialiste de la facturation saisissant des données d'un PDF dans un tableur ou un système de gestion de cabinet, champ par champ, à environ 25 $ de l'heure. Le coût réel arrive par quatre canaux distincts que la plupart des cabinets ne voient que lorsqu'ils s'additionnent à la fin du mois.
Le travail de transcription. Un cabinet de taille moyenne traitant 400 EOB par mois consacre environ 100 à 130 heures à la seule saisie de données, en supposant 15 à 20 minutes par document pour lire, localiser les bons champs, saisir et vérifier. À 25 $ de l'heure, cela représente 2 500 $ à 3 250 $ de coût de main-d'œuvre directe chaque mois — avant même toute correction d'erreurs. C'est le coût visible. Le coût invisible, c'est ce que ce spécialiste de la facturation ne fait pas : contester les refus, suivre les sous-paiements, rapprocher les écarts ou analyser les tendances des payeurs. Pour une ventilation ligne par ligne du coût complet par demande — main-d'œuvre, frais logiciels, reprise des erreurs et sous-paiements non recouvrés — consultez notre analyse des coûts de saisie manuelle des données EOB.
La taxe sur les erreurs. Le taux d'erreur de 8 à 12 % considéré comme normal dans la saisie manuelle de données se traduit directement par des demandes rejetées, des paiements mal appliqués et un travail de rapprochement qui prend plus de temps que la saisie initiale. Un seul chiffre inversé dans un montant autorisé ou un code CPT saisi incorrectement peut générer un refus qui prend 30 minutes à rechercher et à contester. Les données du secteur suggèrent que les erreurs de saisie de données EOB représentent à elles seules environ un quart des refus de demandes évitables. Chaque demande refusée coûte en moyenne 118 $ à retraiter, et ce coût est rarement suivi comme un coût de traitement EOB — il est enfoui dans le budget de gestion des refus.
Confusion liée à la facturation des patients. Lorsque la responsabilité du patient est calculée de manière incorrecte — une franchise appliquée à la mauvaise ligne, une quote-part mal interprétée comme une coassurance — le patient reçoit un relevé qui ne correspond pas à l'EOB (Explanation of Benefits). Cela génère des appels téléphoniques, des contestations, des retards de paiement et, dans les pires cas, des plaintes auprès des régulateurs d'assurance des États. Le coût de ces appels est rarement mesuré, mais quiconque a géré un bureau de facturation médicale sait qu'une seule contestation de facturation peut consommer 45 minutes réparties entre plusieurs membres du personnel.
Lenteur du rapprochement des réclamations. Le rapprochement du paiement imputé à la réclamation avec le remboursement attendu est censé détecter les sous-paiements. Lorsque les données utilisées pour ce rapprochement sont elles-mêmes sujettes aux erreurs, la comparaison produit des faux positifs (des alertes qui s'avèrent être des erreurs de saisie, et non de véritables sous-paiements) et des faux négatifs (de véritables sous-paiements qui passent inaperçus parce que le nombre extrait correspond par hasard à la mauvaise réclamation). Une enquête HFMA (Healthcare Financial Management Association) de 2023 a révélé que 43 % des prestataires subissent des retards de paiement spécifiquement dus à des erreurs de traitement manuel des EOB.
Ces quatre coûts sont additifs, pas alternatifs. Un cabinet qui paie 2 500 $ par mois en main-d'œuvre de transcription perd probablement un montant équivalent en correction d'erreurs, en contestations de facturation des patients et en sous-paiements manqués. Le coût réel du traitement manuel des EOB est environ le double de la ligne de main-d'œuvre visible.
Le vrai défi : plus de 6 000 formats de payeurs
La raison pour laquelle le traitement manuel des EOB est si sujet aux erreurs n'est pas que les personnes qui le font ne sont pas formées. C'est qu'il existe plus de 6 000 formats d'EOB distincts parmi les payeurs aux États-Unis. Chaque assureur — UnitedHealthcare, Aetna, Cigna, Humana, Blue Cross Blue Shield (chaque plan d'État indépendamment), Medicare, Medicaid managed care organizations, les assureurs d'indemnisation des travailleurs — organise les mêmes points de données différemment.
Certains payeurs présentent le résumé de la réclamation dans un tableau horizontal avec des colonnes pour les dates, les codes de procédure, le montant facturé, le montant autorisé et la responsabilité du patient. D'autres utilisent une disposition verticale empilée où chaque ligne de service est un bloc de champs étiquetés. Certains répartissent la franchise, la coassurance et la quote-part dans des sous-colonnes séparées ; d'autres condensent tout dans une seule ligne « Patient Owes ». Certains changent même de disposition au sein d'un même EOB — utilisant un format pour les réclamations payées et un autre pour les réclamations refusées sur le même PDF.
Reconnaissance des codes CPT et ICD. Les codes de procédure (CPT/HCPCS) et les codes de diagnostic (ICD-10) qui apparaissent sur un EOB sont les champs les plus sensibles du document. Une seule erreur de saisie d'un code CPT — 99213 tapé comme 99214 — signifie que la réclamation concernait un niveau de service différent. Le système de facturation imputera le mauvais paiement, le payeur pourra refuser la différence lors d'un audit, et le prestataire devra peut-être rembourser le trop-perçu des mois plus tard. Ces codes sont densément regroupés, souvent collés sans délimiteurs clairs, et parfois tronqués lorsqu'ils dépassent la largeur du champ sur l'EOB imprimé.
La ventilation financière. Un EOB montre généralement le montant facturé (ce que le prestataire a facturé), le montant autorisé (ce que l'assureur considère comme raisonnable), le montant payé par le régime et la responsabilité du patient — qui est elle-même une combinaison de la franchise appliquée, du pourcentage de coassurance, du montant de la quote-part et des montants non couverts. Chaque payeur répartit ces sous-composants différemment. Sur un EOB UnitedHealthcare, la franchise peut apparaître dans une colonne séparée. Sur un EOB Blue Cross, elle peut être intégrée dans une ligne d'ajustement avec un code de remarque. La méthode d'extraction doit comprendre quel sous-total contient quel composant, pas seulement localiser les signes dollar.
Codes de remarque. Les codes CARC (Claim Adjustment Reason Codes) et RARC (Remittance Advice Remark Codes) expliquent pourquoi un ajustement a été appliqué ou une réclamation refusée — par exemple, CO-45 (obligation contractuelle — le montant dépasse le barème de remboursement) ou PR-1 (responsabilité du patient — montant de la franchise). Il existe des centaines de codes actifs gérés par l'organisation de normes X12, et les payeurs les appliquent de manière incohérente. Un code sur l'EOB (Explanation of Benefits) d'un payeur peut apparaître en texte brut sur celui d'un autre. Extraire ces codes avec précision nécessite de les lire par contexte, et non par position.
Ces quatre niveaux de complexité — variabilité de la mise en page, densité des codes médicaux, calculs financiers et codes d'ajustement — font de l'extraction d'EOB un problème fondamentalement différent de l'extraction d'une facture standard. Et c'est la raison pour laquelle les outils OCR traditionnels basés sur des modèles, qui s'appuient sur des positions de champs fixes, échouent sur les EOB.
Traitement traditionnel vs. extraction par IA
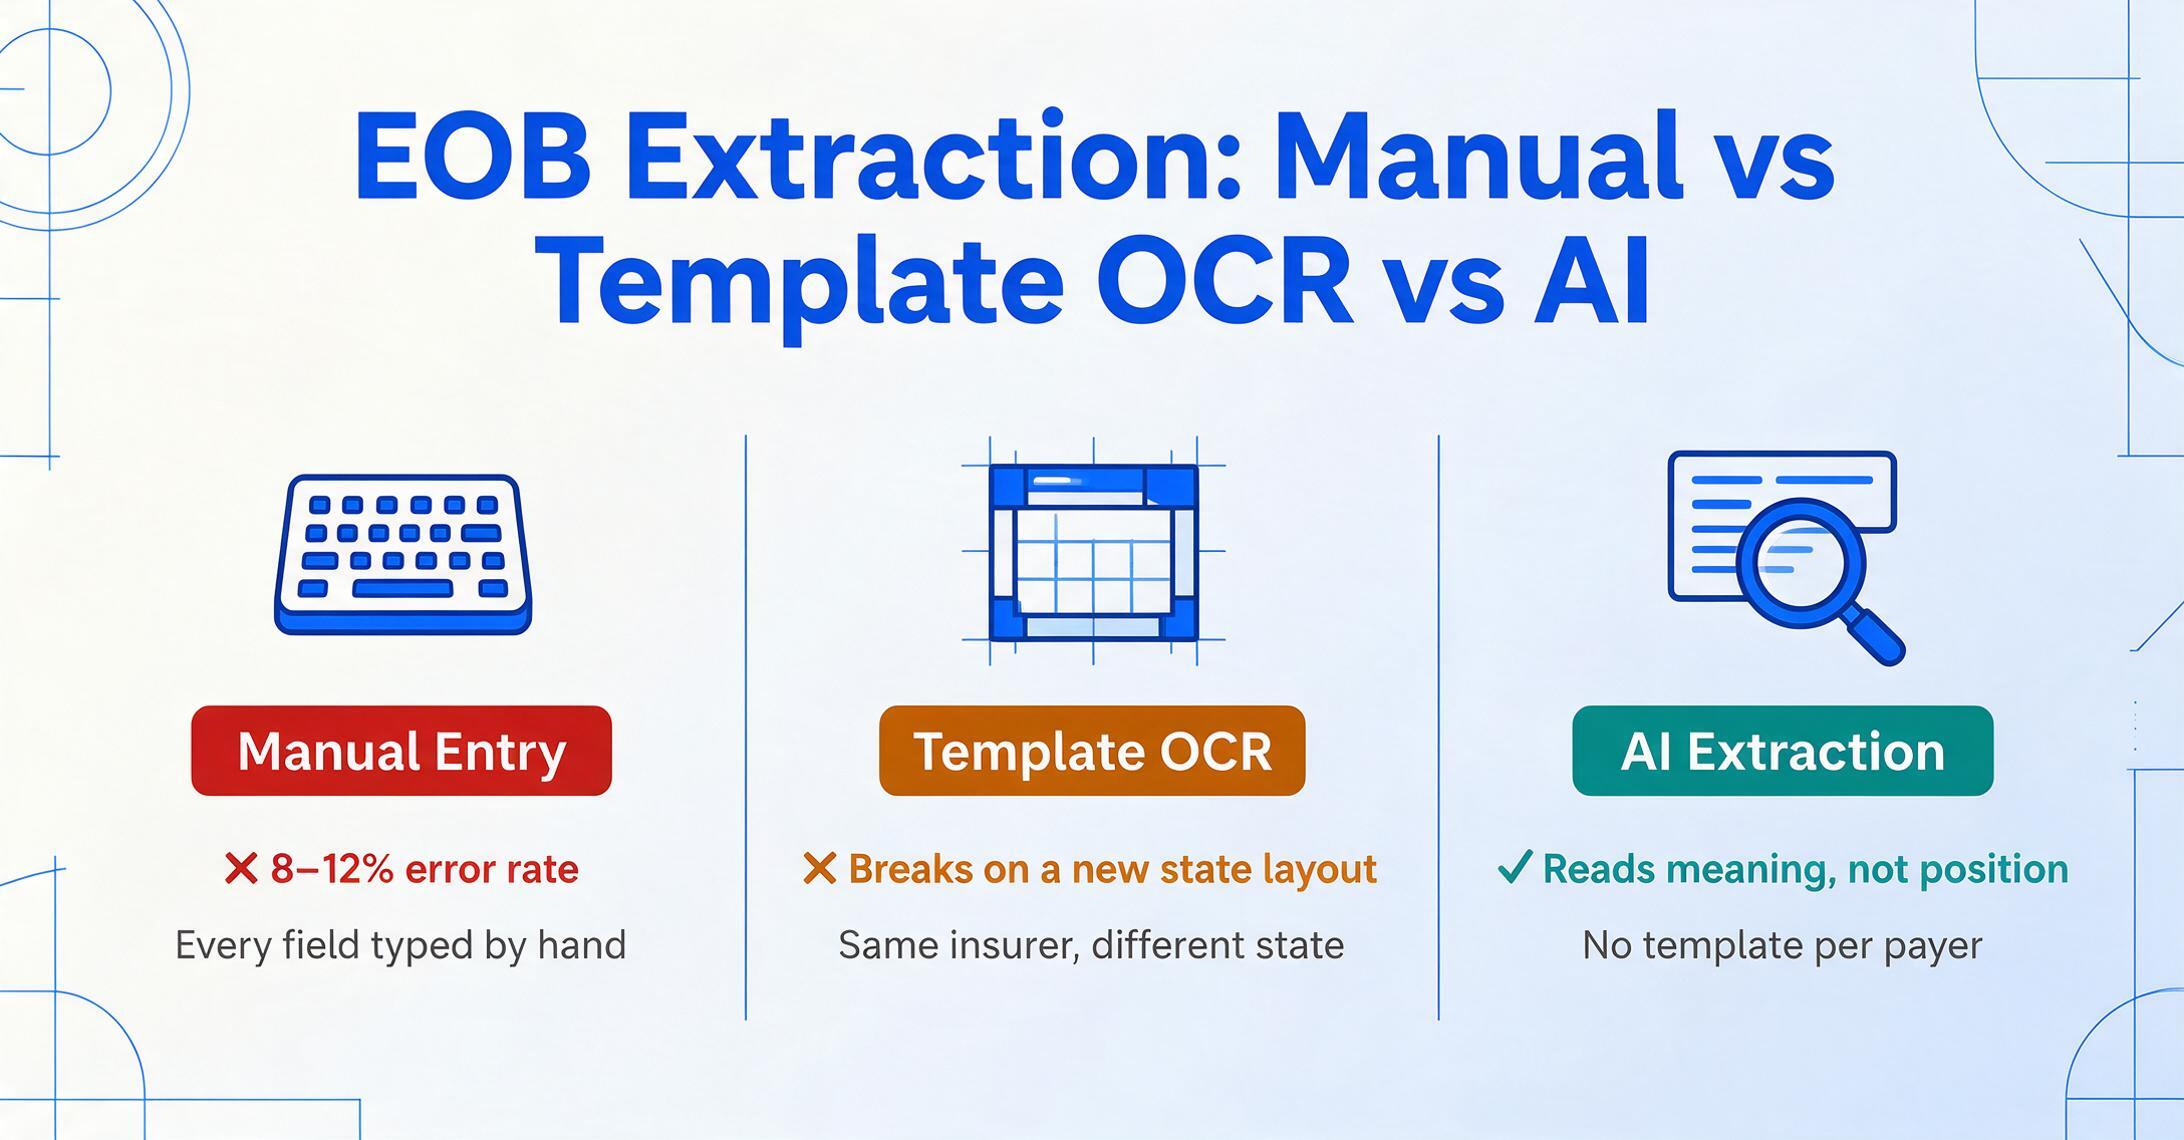
L'approche conventionnelle du traitement des EOB a deux variantes : la saisie manuelle des données et l'OCR basé sur des modèles. Les deux partagent la même limitation fondamentale — elles traitent l'EOB comme un document à la mise en page prévisible, ce qu'il n'est pas.
L'OCR basé sur des modèles fonctionne bien lorsque le même formulaire arrive à chaque fois : le champ « Montant autorisé » est toujours dans la même colonne sur la même page, et le logiciel peut être configuré pour chercher exactement à cet endroit. Les EOB violent cette hypothèse. Un modèle configuré pour un EOB Blue Cross de Floride échouera sur un EOB Blue Cross de l'Illinois — même assureur, état différent, mise en page différente.
L'extraction par IA, en revanche, lit le document en comprenant ce que chaque donnée signifie, et non où elle se trouve. La technologie derrière cela est un VLM (modèle de vision et de langage) — la même classe de modèles qui peut regarder une photographie et décrire ce qui s'y passe. Appliqué à un EOB, le modèle voit le document dans son ensemble, identifie les en-têtes de sections (« Responsabilité du patient », « Montant payé », « Description du service ») et localise les valeurs correspondantes par leur relation sémantique avec ces en-têtes, et non par leurs coordonnées de pixels.
C'est la différence clé. Une approche basée sur des modèles demande « Où est la franchise ? » et la cherche à une coordonnée fixe. Une approche basée sur l'IA demande « Quelle est la franchise pour cette ligne de service ? » et lit le document jusqu'à trouver la réponse.
| Dimension | Saisie manuelle | OCR basé sur modèle | Extraction par IA |
|---|---|---|---|
| Couverture des formats payeurs | Humain lit tout format | Modèles préconfigurés uniquement | Tout format, dès le premier envoi |
| Configuration par payeur | Aucune (lecture visuelle) | Création + test du modèle par mise en page | Aucune — zéro configuration |
| Temps de traitement par EOB | 15–20 minutes | 2–5 minutes | 5–10 secondes |
| Taux d'erreur typique | 8–12 % | 5–8 % (casse en cas de changement de format) | Moins de 2 % |
| Extraction codes CPT/CIM | Sujette aux fautes de frappe | Dépend de la zone correcte | Lecture contextuelle |
| Lot multi-payeurs | Séquentiel — un à la fois | EOB de même mise en page uniquement | Payeurs mélangés dans un seul lot |
| Résistance aux changements de format | N/A (l'humain s'adapte) | Casse jusqu'à mise à jour du modèle | Gère automatiquement les nouvelles mises en page |
Le résultat n'est pas seulement un traitement plus rapide. C'est un flux de travail fondamentalement différent : au lieu qu'un spécialiste de la facturation ouvre chaque EOB, le lise et saisisse les valeurs dans un système, l'IA lit l'intégralité du lot et le spécialiste ne révise que les exceptions — écarts signalés, codes inhabituels ou montants hors des plages attendues.
Le changement n'est pas la vitesse. Le changement est la répartition de l'attention. Une équipe de facturation qui passe 100 heures sur la saisie de données n'a presque pas de temps pour l'analyse des refus ou la négociation avec les payeurs. Une équipe dont la saisie de données est gérée par l'IA récupère ces 100 heures pour le travail qui améliore réellement la performance du cycle de revenus.
Essayez par vous-même : téléchargez un EOB et voyez les résultats
La démo intégrée ci-dessous vous permet de télécharger un document EOB — un PDF, une image scannée, ou même une photo prise avec votre téléphone — et de voir ce que l'extraction par IA produit en quelques secondes. Pas d'inscription, pas de configuration, pas de création de modèle.
Les fichiers sont traités en toute sécurité et ne sont pas stockés après l'extraction.
Champs essentiels dans chaque EOB
Bien que chaque assureur formate ces champs différemment, les données dont une équipe de facturation a besoin d'un EOB sont remarquablement cohérentes chez tous les assureurs. Le défi n'est pas de savoir quoi extraire — c'est de configurer la méthode d'extraction pour localiser chaque champ correctement dans une mise en page jamais vue auparavant.
| Champ | Pourquoi c'est important | Libellés courants des assureurs |
|---|---|---|
| Identifiant Patient/Membre | Relie l'EOB au bon dossier patient et à la bonne réclamation | ID Membre, ID Abonné, ID Patient, N° ID |
| Nom du Patient | Vérification de l'identité du patient | Nom Patient, Nom Membre, Abonné |
| Nom du Prestataire / NPI | Garantit que le paiement est crédité au bon prestataire | Prestataire, Prestataire Traitant, Prestataire Facturant, NPI |
| Date de Service | Détermine la période de prestation et les conditions contractuelles applicables | DOS, Date de Service, Du–Au, Date de Prestation |
| Code CPT / HCPCS | Identifie la procédure spécifique effectuée — le champ le plus sensible aux erreurs | CPT, Code Procédure, Code, HCPCS, Code Service |
| Code Diagnostic CIM-10 | Justification de la nécessité médicale — des codes incorrects entraînent des refus | Code Diagnostic, CIM-10, DX, Diagnostic Principal |
| Montant Facturé | Ce que le prestataire a facturé — utilisé pour les calculs d'ajustement contractuel | Facturé, Honoraires, Montant Soumis, Montant Facturé |
| Montant Autorisé | Le tarif négocié par l'assureur — la base de tous les calculs de paiement en aval | Autorisé, Montant Couvert, Approuvé, Allocation du Régime |
| Paiement du Régime | Ce que l'assureur a réellement payé — le montant qui doit correspondre au chèque ou au virement | Payé par le Régime, Paiement Assurance, Régime Payé, Montant du Chèque |
| Franchise Appliquée | Part du montant autorisé imputée à la franchise annuelle du patient | Franchise, Appliqué à la Franchise, Franchise Patient |
| Coassurance | Part du patient en pourcentage du montant autorisé après franchise | Coassurance, Coassurance Patient, Co-ass % |
| Ticket Modérateur | Frais fixes du patient par service (souvent distinct de la coassurance) | Ticket Modérateur, Co-Paiement, Ticket Consultation, Ticket Médicament |
| Part du patient (Total) | Somme de la franchise + coassurance + copaiement + montants non couverts — ce qui est facturé au patient | Montant dû par le patient, Part patient, Somme due, Total patient |
| Montant de l'ajustement / du refus | Réductions appliquées par le payeur — contractuelles ou non couvertes | Ajustement, Montant refusé, Remise, Non couvert |
| Codes de remarque CARC / RARC | Expliquent pourquoi un ajustement ou un refus a été appliqué — essentiel pour les recours | Code motif d'ajustement, Code remarque, Remarque, CARC, RARC |
| Numéro de réclamation / ICN | Identifiant unique de la réclamation — relie le DBR à la soumission 837 d'origine | N° réclamation, ICN, Numéro de contrôle interne, ID réclamation |
Avec un outil d'extraction basé sur l'IA qui prend en charge l'Extraction de colonnes personnalisées, vous saisissez les noms de champs dont vous avez besoin — « Nom du patient », « Code CPT », « Montant facturé », « Responsabilité du patient » — et l'IA localise chaque valeur par sa signification sémantique dans la mise en page de n'importe quel assureur. Vous définissez la sortie ; l'IA lit le document. Pour un guide pas à pas sur la configuration de ces colonnes et l'exécution de votre première extraction, consultez notre guide pratique pour l'extraction d'EOB par lots.
Des EOB par lots au relevé de facturation patient
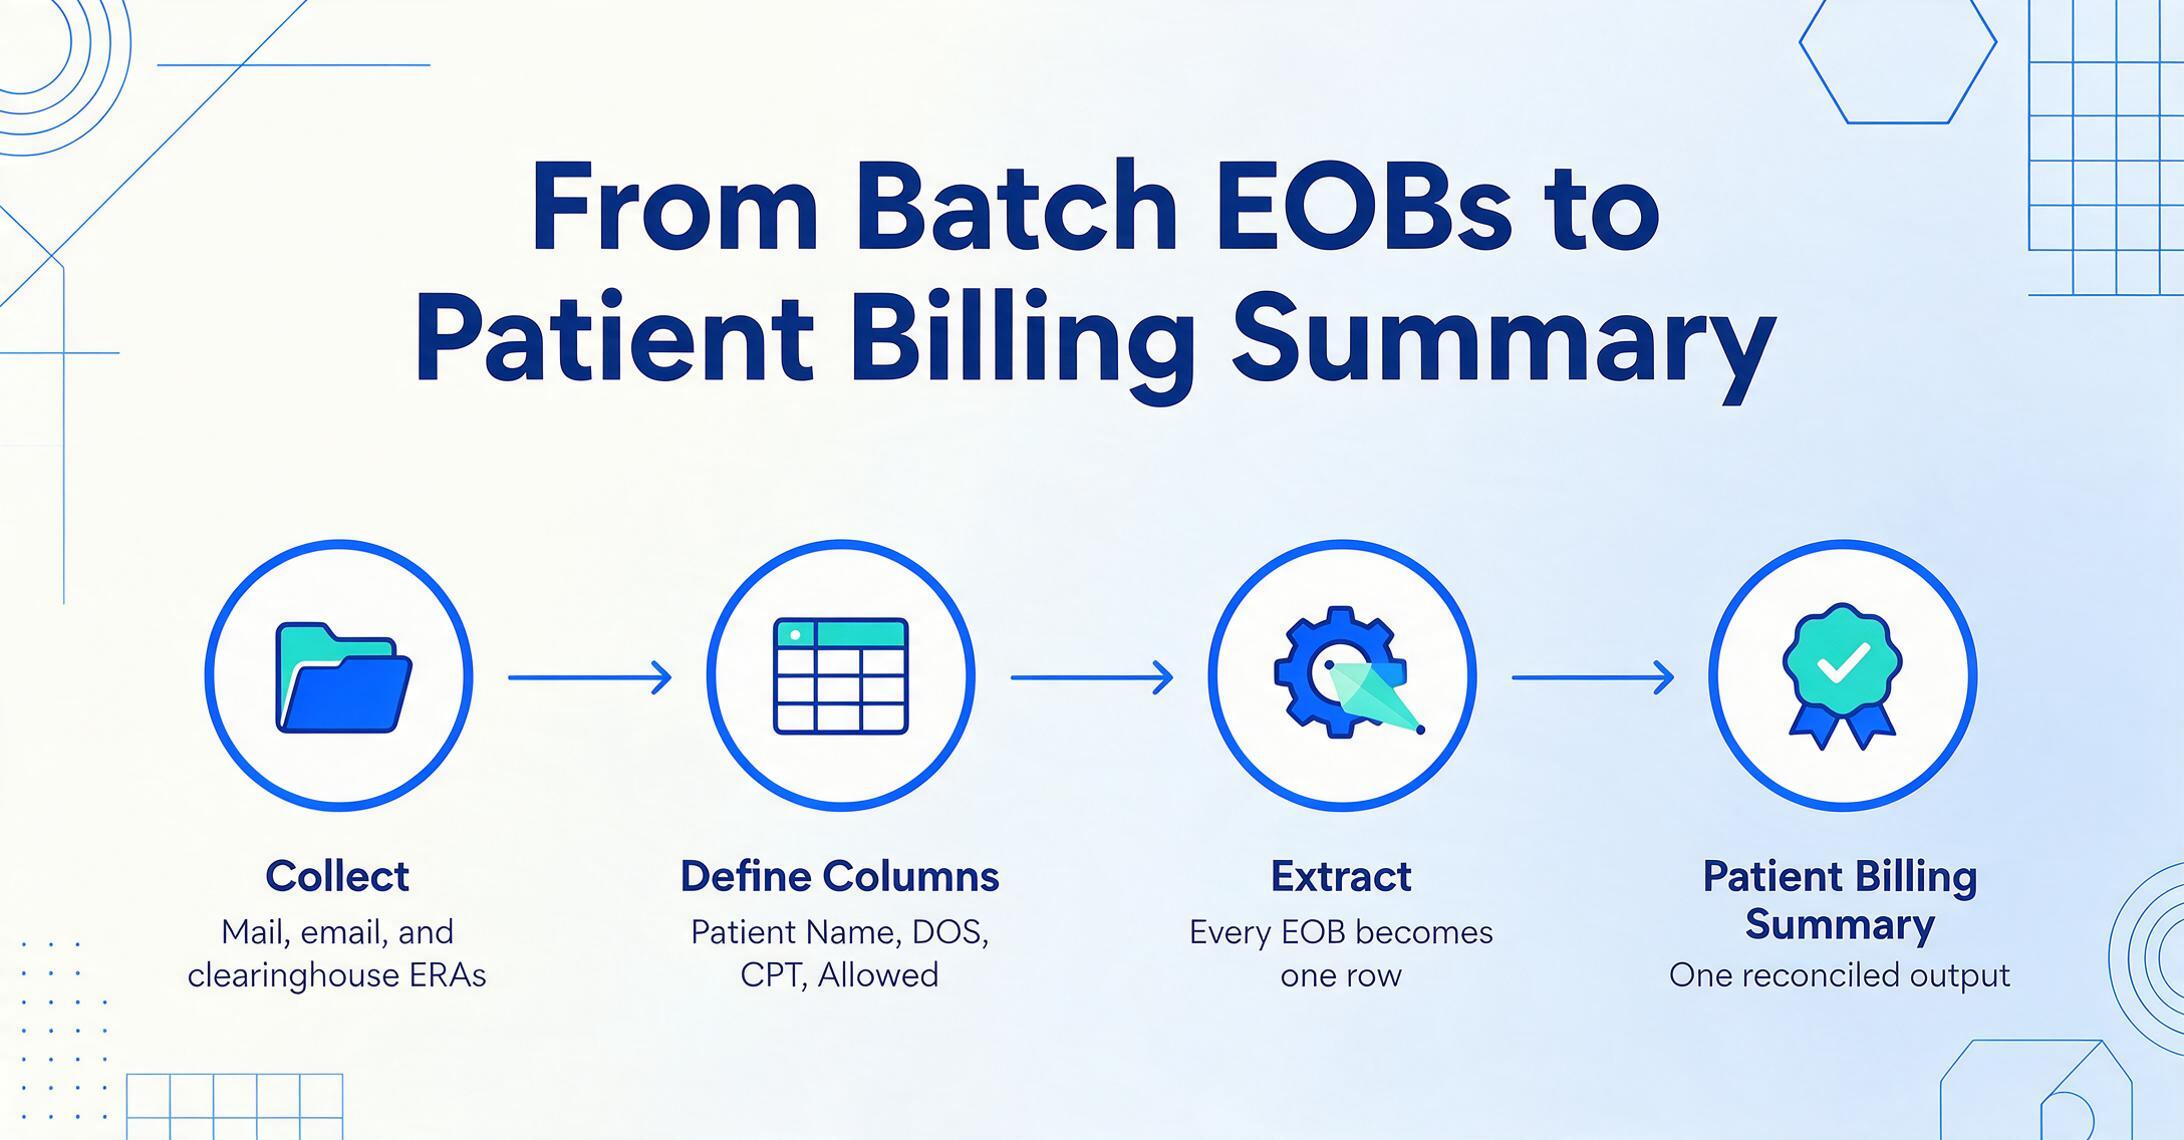
La véritable puissance de l'extraction automatisée des EOB (Explanation of Benefits) ne consiste pas à traiter un document plus rapidement — elle consiste à traiter un lot de documents provenant de différents assureurs comme un seul groupe et à produire une sortie consolidée qui regroupe toutes les données dans un relevé de facturation patient.
Voici comment une équipe type de facturation médicale passe d'une pile d'EOB à un relevé de facturation patient rapproché grâce à l'extraction IA par lots :
Collectez les EOB de chaque assureur.
Certains arrivent par courrier sous forme de documents papier. D'autres arrivent en pièces jointes PDF par e-mail. Certains cabinets utilisent un clearinghouse qui achemine les ERA (Electronic Remittance Advice au format X12 835) pour certains assureurs mais reçoit des EOB PDF d'autres. Chaque PDF ou scan va dans un seul dossier — quel que soit l'assureur qui l'a émis, quelle que soit la mise en page.
Téléchargez le lot et définissez les colonnes de sortie.
Téléchargez le lot entier — il peut contenir des EOB de Blue Cross, Aetna, UnitedHealthcare, Medicare et Cigna mélangés. Définissez vos noms de colonnes : « Patient Name », « Member ID », « DOS », « CPT Code », « Billed », « Allowed », « Plan Paid », « Deductible », « Coinsurance », « Copay », « Patient Responsibility ». L'IA lit chaque document et mappe ces champs par compréhension sémantique, et non par correspondance de modèles.
L'IA traite chaque EOB en quelques secondes par page.
L'extraction s'exécute sur le lot de manière séquentielle ou parallèle selon l'outil. Chaque EOB produit une ligne dans le tableau de sortie. Comme l'IA lit par contexte, un EOB de Blue Cross et un avis de paiement de Medicare dans le même lot produisent tous deux des données dans la même structure de colonnes — aucune configuration par assureur requise.
Examinez et rapprochez les exceptions signalées.
L'équipe de facturation examine uniquement les éléments que l'IA signale — les montants hors des plages attendues, la part patient qui ne correspond pas au calcul attendu, les codes d'ajustement qui suggèrent un refus. Tout le reste est déjà saisi dans la sortie. L'examen qui prenait 15 à 20 minutes par EOB prend désormais quelques minutes pour l'ensemble du lot.
Produisez le récapitulatif de facturation patient.
La sortie consolidée — une ligne par ligne de service, avec la part patient décomposée en franchise, coinsurance, copaiement et total dû — devient la source de vérité pour les relevés patients. Avec les colonne calculée, vous pouvez même définir des calculs supplémentaires directement dans l'extraction : par exemple, une colonne qui calcule « Remaining Balance = Patient Responsibility — Payments Received » sans quitter l'outil d'extraction. Pour aller plus loin sur les flux de travail multipaiements, consultez notre article sur comment les équipes de facturation médicale extraient par lots des données de centaines d'EOB.
Pour les cabinets qui doivent collecter des EOB de plusieurs prestataires ou sites sans donner à tous un accès au compte principal, ImageToTable.ai propose une fonctionnalité Lien de collecte : générez une URL partageable, envoyez-la aux prestataires ou au personnel terrain, et ils peuvent téléverser des EOB directement dans votre file de traitement — sans inscription requise.
Export et intégration
Les données EOB (Explanation of Benefits) extraites ne sont utiles que si elles parviennent au système où s'effectuent la facturation et le rapprochement. Les besoins en aval varient selon les cabinets, et le bon outil d'extraction doit prendre en charge les destinations les plus courantes.
Excel ou Google Sheets. C'est la destination la plus courante pour les petits et moyens cabinets. Un seul lot d'extraction produit une feuille de calcul structurée avec tous les champs essentiels — nom du patient, codes CPT, montants facturés, montants autorisés, paiements du régime, ventilation de la part du patient — dans des colonnes étiquetées. La feuille de calcul est prête à être importée dans le système de gestion du cabinet ou à servir de registre de rapprochement. Pour les équipes utilisant Google Sheets, le module complémentaire ImageToTable.ai pour Google Sheets envoie les données extraites directement dans la feuille de calcul active, sans quitter Sheets.
Systèmes de gestion de cabinet et DSE. Les cabinets utilisant Epic, Cerner, Meditech, AdvancedMD, Kareo, NextGen, athenahealth ou eClinicalWorks exportent généralement les données structurées et les mappent dans le module de saisie des paiements de leur système. L'exigence clé est que les données exportées contiennent les mêmes champs dans un schéma cohérent — les en-têtes de colonnes ne changent pas entre les lots, et les variations propres à chaque payeur sont normalisées afin que l'import en aval voie une structure de données uniforme, quel que soit le payeur ayant émis l'EOB.
Facturation du portail patient. Une fois la part du patient calculée et vérifiée, le montant destiné au patient alimente le portail patient ou le système de relevés de facturation. Une part du patient précise — la répartition correcte entre franchise, quote-part et ticket modérateur — est essentielle ici, car un relevé qui ne correspond pas à l'EOB génère des appels et des contestations.
Comment choisir un outil d'extraction d'EOB
Tous les outils d'extraction de documents ne conviennent pas aux EOB. Les caractéristiques spécifiques de ces documents — variabilité des formats entre payeurs, codage médical dense, champs financiers à composantes multiples — réduisent considérablement le champ des options. Voici les critères les plus importants pour évaluer une solution d'extraction d'EOB.
Précision multi-payeurs dès la première utilisation. Le test le plus important est simple : téléversez un EOB Blue Cross, un EOB Aetna, un avis de remboursement Medicare et un EOB Cigna dans un seul lot et voyez si la même configuration d'extraction produit des données précises pour les quatre. Si l'outil exige un modèle distinct par payeur ou doit être entraîné sur des documents d'exemple pour chaque format, l'avantage de l'extraction est considérablement réduit. L'approche sans modèle d'ImageToTable.ai signifie aucune configuration par payeur — l'IA lit chaque document en comprenant ce que signifie chaque champ, où qu'il apparaisse sur la page.
Précision de reconnaissance des codes CPT/ICD. Les codes de procédure et de diagnostic sont les champs les plus sensibles aux erreurs dans un EOB. Recherchez un outil capable de lire des codes densément regroupés — y compris des codes qui se touchent sans séparation visuelle claire, des codes tronqués qui continuent sur une deuxième ligne, et des codes intégrés dans des en-têtes de section plutôt que dans une colonne dédiée.
Prise en charge du calcul de la part du patient. Les meilleurs outils d'extraction ne se contentent pas de cracher des champs individuels et de vous laisser faire les calculs. La fonctionnalité colonne calculée d'ImageToTable.ai vous permet de définir le calcul de la part du patient dans le cadre de l'extraction : spécifiez « Total patient = Franchise + Quote-part + Ticket modérateur + Non couvert » comme colonne calculée, et l'IA le calcule pour chaque ligne pendant l'extraction. Cela élimine une étape de vérification manuelle qui est elle-même sujette aux erreurs.
Considérations relatives à la conformité HIPAA. Les EOB (Explanation of Benefits) contiennent des informations de santé protégées (PHI) — noms de patients, identifiants de membres, codes de diagnostic et autres identifiants relevant des règles de confidentialité et de sécurité HIPAA. Tout outil traitant des données EOB doit offrir des garanties appropriées. Lors de l'évaluation d'un outil, vérifiez qu'il prend en charge la transmission sécurisée des données (chiffrement AES-256 en transit et au repos), la suppression automatique des données après traitement, et un contrat de sous-traitance (BAA) si les PHI sont stockées ou transmises via l'infrastructure du fournisseur. Ceci est une description du contexte de conformité, pas un avis juridique. Consultez le responsable de la conformité ou le conseiller juridique de votre organisation pour connaître vos obligations HIPAA spécifiques.
Traitement par lots et gestion de formats mixtes. Si votre cabinet traite des EOB provenant de plus de trois ou quatre payeurs — ce qui est le cas de la plupart — l'outil doit gérer des lots de formats mixtes. Pouvoir déposer un dossier de PDF provenant de dix payeurs différents dans un seul téléversement et obtenir une seule feuille de calcul en retour, c'est la différence entre un outil qui fait gagner du temps et un outil qui crée plus de travail.
Pour une comparaison plus large des outils d'extraction de documents dans les cas d'usage de la santé, consultez notre sélection des meilleurs outils d'extraction de documents pour la santé en 2026.
Questions fréquentes sur l'extraction de données EOB
L'IA peut-elle extraire des données d'EOB qui incluent plusieurs patients sur un seul document ?
Oui. Les EOB multipatients — où un seul document liste les réclamations de plusieurs patients regroupées par le payeur — sont une source courante d'erreurs d'extraction manuelle. L'extraction basée sur l'IA lit le document dans son ensemble et identifie quelles lignes de services appartiennent à quel patient grâce à la relation contextuelle entre les identifiants du patient et les détails des procédures, les séparant en lignes de sortie distinctes. C'est nettement plus fiable que le tri manuel, qui est sujet aux erreurs d'attribution.
L'outil doit-il être entraîné sur le format d'EOB de chaque assureur avant de fonctionner ?
Non. ImageToTable.ai extrait les données des EOB (Explanation of Benefits) grâce à une compréhension sémantique, et non à une correspondance de modèles. Le premier EOB de n'importe quel assureur — qu'il s'agisse d'un grand assureur national comme UnitedHealthcare ou d'un petit régime régional — est traité avec la même configuration. Il n'y a pas de phase d'entraînement, pas de collecte d'échantillons et pas de création de modèle par assureur.
Que se passe-t-il si un assureur modifie la mise en page de ses EOB ?
L'extraction continue de fonctionner. Comme l'IA lit les données par leur signification plutôt que par leur position, un changement de mise en page — colonnes réorganisées, en-têtes de sections déplacés, en-têtes redessinés — ne casse pas l'extraction. C'est un avantage fondamental par rapport aux outils OCR basés sur des modèles, qui nécessitent une reconfiguration à chaque fois qu'un assureur modifie son formulaire.
L'outil peut-il extraire des EOB scannés à partir de copies papier ?
Oui. L'IA traite les images scannées et les photos d'EOB imprimés, pas seulement les PDF numériques. Les scénarios courants incluent les EOB papier reçus par courrier de petits assureurs, les copies faxées par les prestataires référents et les EOB photographiés que les patients soumettent pour remboursement. La précision de l'extraction dépend de la qualité de l'image — des scans clairs à 200 DPI ou plus donnent les meilleurs résultats — mais le VLM (modèle de vision et de langage) est conçu pour gérer la dégradation typique des documents scannés.
Comment l'outil gère-t-il les codes de remarque CARC et RARC sur les EOB ?
L'IA lit les codes de motif d'ajustement et les codes de remarque sur l'EOB et les génère comme champs extraits. Comme certains assureurs intègrent ces codes en texte brut tandis que d'autres utilisent des valeurs numériques, l'extraction capture à la fois le code et tout texte d'explication associé lorsqu'il est disponible. La sortie peut ensuite être utilisée pour catégoriser les refus et les ajustements pour le reporting et le suivi des recours.
L'outil est-il conforme à la HIPAA ?
ImageToTable.ai traite les documents avec un chiffrement en transit (TLS) et au repos (AES-256). Les fichiers téléchargés par les utilisateurs anonymes sont automatiquement supprimés après le traitement, et les fichiers des utilisateurs connectés ne sont conservés que pendant la durée de la période de conservation du plan, puis définitivement supprimés. Un contrat d'associé commercial (BAA) est disponible pour les prestataires qui doivent documenter leur conformité à la HIPAA dans leurs flux de travail d'extraction de documents. Comme pour tout outil de traitement de données de santé, vous devez examiner la documentation spécifique de sécurité et de conformité par rapport aux politiques de votre organisation et consulter votre responsable de la conformité.
Quelle est la différence entre l'extraction d'un EOB et d'un ERA ?
L'ERA (Electronic Remittance Advice) est la transaction électronique standard HIPAA (ASC X12 835) qui contient les mêmes informations de paiement de réclamation qu'un EOB, mais dans un format lisible par machine. Les ERA peuvent être automatiquement enregistrés dans les systèmes de gestion de cabinet avec une intervention manuelle minimale. Les EOB sont généralement des documents papier ou PDF destinés à l'explication fournie au patient ou au prestataire. L'extraction est la façon de faire en sorte que les EOB PDF se comportent comme des ERA — en convertissant leurs données visuelles en sortie structurée et lisible par machine. La plupart des cabinets reçoivent un mélange d'ERA des principaux payeurs et d'EOB PDF des autres, donc un flux de travail complet du cycle de revenus doit gérer les deux.
Combien d'EOB par mois rendent l'extraction automatisée rentable ?
Pour les cabinets qui traitent plus de 200 EOB par mois, les économies de main-d'œuvre liées à l'extraction automatisée couvrent généralement le coût de l'outil dès le premier mois. En dessous de ce seuil, les économies sont plus faibles, mais le temps gagné peut rester significatif pour une petite équipe de facturation — 200 EOB à 15 minutes chacun représentent 50 heures de saisie de données par mois qui pourraient être redirigées vers un travail à plus forte valeur ajoutée.
L'outil s'intègre-t-il avec Epic, AdvancedMD ou Kareo ?
ImageToTable.ai exporte les données au format Excel qui peuvent être importées dans tout système de gestion de cabinet ou DSE qui accepte des données de paiement structurées. Une intégration API directe est disponible pour les équipes qui ont besoin d'un enregistrement automatisé. Pour un flux de travail sans code complet, le module complémentaire Google Sheets permet aux résultats d'extraction d'atterrir directement dans une feuille de calcul qui alimente votre système de facturation.
L'outil peut-il extraire les EOB des assureurs d'indemnisation des accidents du travail ?
Oui. Les EOB d'indemnisation des accidents du travail utilisent un ensemble de règles de facturation différent et incluent souvent des ajustements de barèmes de frais médicaux spécifiques à chaque État. L'IA lit ces EOB de la même manière qu'elle lit les documents des assureurs commerciaux — en comprenant les champs sémantiquement. La même configuration d'extraction qui traite un EOB de UnitedHealthcare traite également un EOB d'indemnisation des accidents du travail provenant d'un assureur spécifique à un État.
La prochaine étape : du manuel au structuré
L'arithmétique du traitement des EOB est simple, mais facile à ignorer car les coûts sont répartis sur plusieurs lignes budgétaires — main-d'œuvre, correction d'erreurs, gestion des litiges patients et rapprochement — dont aucune n'est assez importante en soi pour déclencher un changement de processus. Ensemble, ils représentent une ponction significative sur la performance du cycle de revenus.
Le passage de la saisie manuelle à l'extraction assistée par IA ne nécessite pas le remplacement complet d'une plateforme de cycle de revenus, un nouveau système EHR, ni l'intervention de l'informatique. Cela commence par un lot : téléchargez les EOB que vous avez traités hier, définissez les colonnes que vous souhaiteriez avoir, et voyez si le résultat correspond à ce que votre équipe a saisi. Si le résultat est plus propre et plus rapide, le cas se généralise à partir de là.
Cet écart entre ce que dit l'EOB et ce qui entre dans votre système de facturation — le taux d'erreur de 35 % de l'enquête HFMA — n'est pas un problème de personnel. C'est un problème de processus avec une solution technique simple.