O Guia Completo de
Extração de Dados de EOB (2026)
A pesquisa de 2023 da HFMA (Healthcare Financial Management Association) descobriu que 35% das organizações de saúde relatam erros na entrada manual de dados de EOB, e 43% sofrem atrasos de pagamento como resultado direto. Esses números descrevem a lacuna entre o que uma declaração de benefícios (Explanation of Benefits) diz e o que realmente é inserido em um sistema de faturamento — uma lacuna que persiste não porque a equipe é descuidada, mas porque o setor pede que as pessoas façam algo fundamentalmente não natural com esses documentos: tratar o layout de cada pagadora como se fosse o mesmo, quando não há dois iguais.
Principais Conclusões
- 35% dos prestadores relatam erros de entrada de dados de EOB — não porque sua equipe de faturamento é descuidada, mas porque nenhum humano consegue ler o mesmo campo de dados em mais de 6.000 layouts diferentes de pagadoras sem errar.
- Os $2.500 por mês que você vê em mão de obra de transcrição dobram quando você soma as correções de erros, disputas de cobrança de pacientes e subpagamentos perdidos escondidos em linhas orçamentárias separadas — custos que nenhum relatório individual soma.
- A métrica que importa não é minutos por EOB — é recuperar 100 horas por mês para que sua equipe de faturamento possa parar de digitar números e começar a perseguir os subpagamentos e negativas que realmente movem a receita.
O que é a Extração de Dados de EOB?
A extração de dados de EOB é o processo automatizado de leitura dos principais campos de sinistros de seguro de um documento EOB (Explanation of Benefits) — nome do paciente, prestador, datas do serviço, códigos de procedimento CPT, valores cobrados, valores permitidos, pagamentos do seguro, ajustes, detalhamento da responsabilidade do paciente e códigos de negação ou observação — e a conversão deles em dados estruturados que um sistema de faturamento ou planilha possa processar.
O documento em si, a declaração de benefícios, é enviado pela seguradora de saúde após a liquidação de um sinistro. Não é uma conta. É um demonstrativo do que o prestador cobrou, do que a seguradora permitiu conforme o plano, do que foi pago ao prestador ou ao paciente e do que o paciente ainda deve. Para uma introdução mais aprofundada ao conceito, consulte nosso artigo dedicado sobre o que é a extração de dados de EOB e como ela funciona.
O que torna a extração de EOB distinta de outras tarefas de extração de documentos é a relação entre os campos de dados. O valor de um EOB não está em um único número — está em como o valor cobrado, o valor permitido, o pagamento do plano, a franquia, o copagamento e a responsabilidade do paciente se encaixam. Extrair esses números corretamente, mas perder a aritmética que os conecta, resulta em uma saída tecnicamente precisa, porém praticamente inútil para a conciliação de faturamento.
Por que o Processamento Manual de EOB Custa Mais do que Você Imagina
O processamento manual de EOB parece barato no papel — um especialista em faturamento digitando dados de um PDF em uma planilha ou sistema de gestão de consultório, campo por campo, a cerca de $25 por hora. O custo real chega por quatro canais separados que a maioria dos consultórios só percebe quando soma tudo no final do mês.
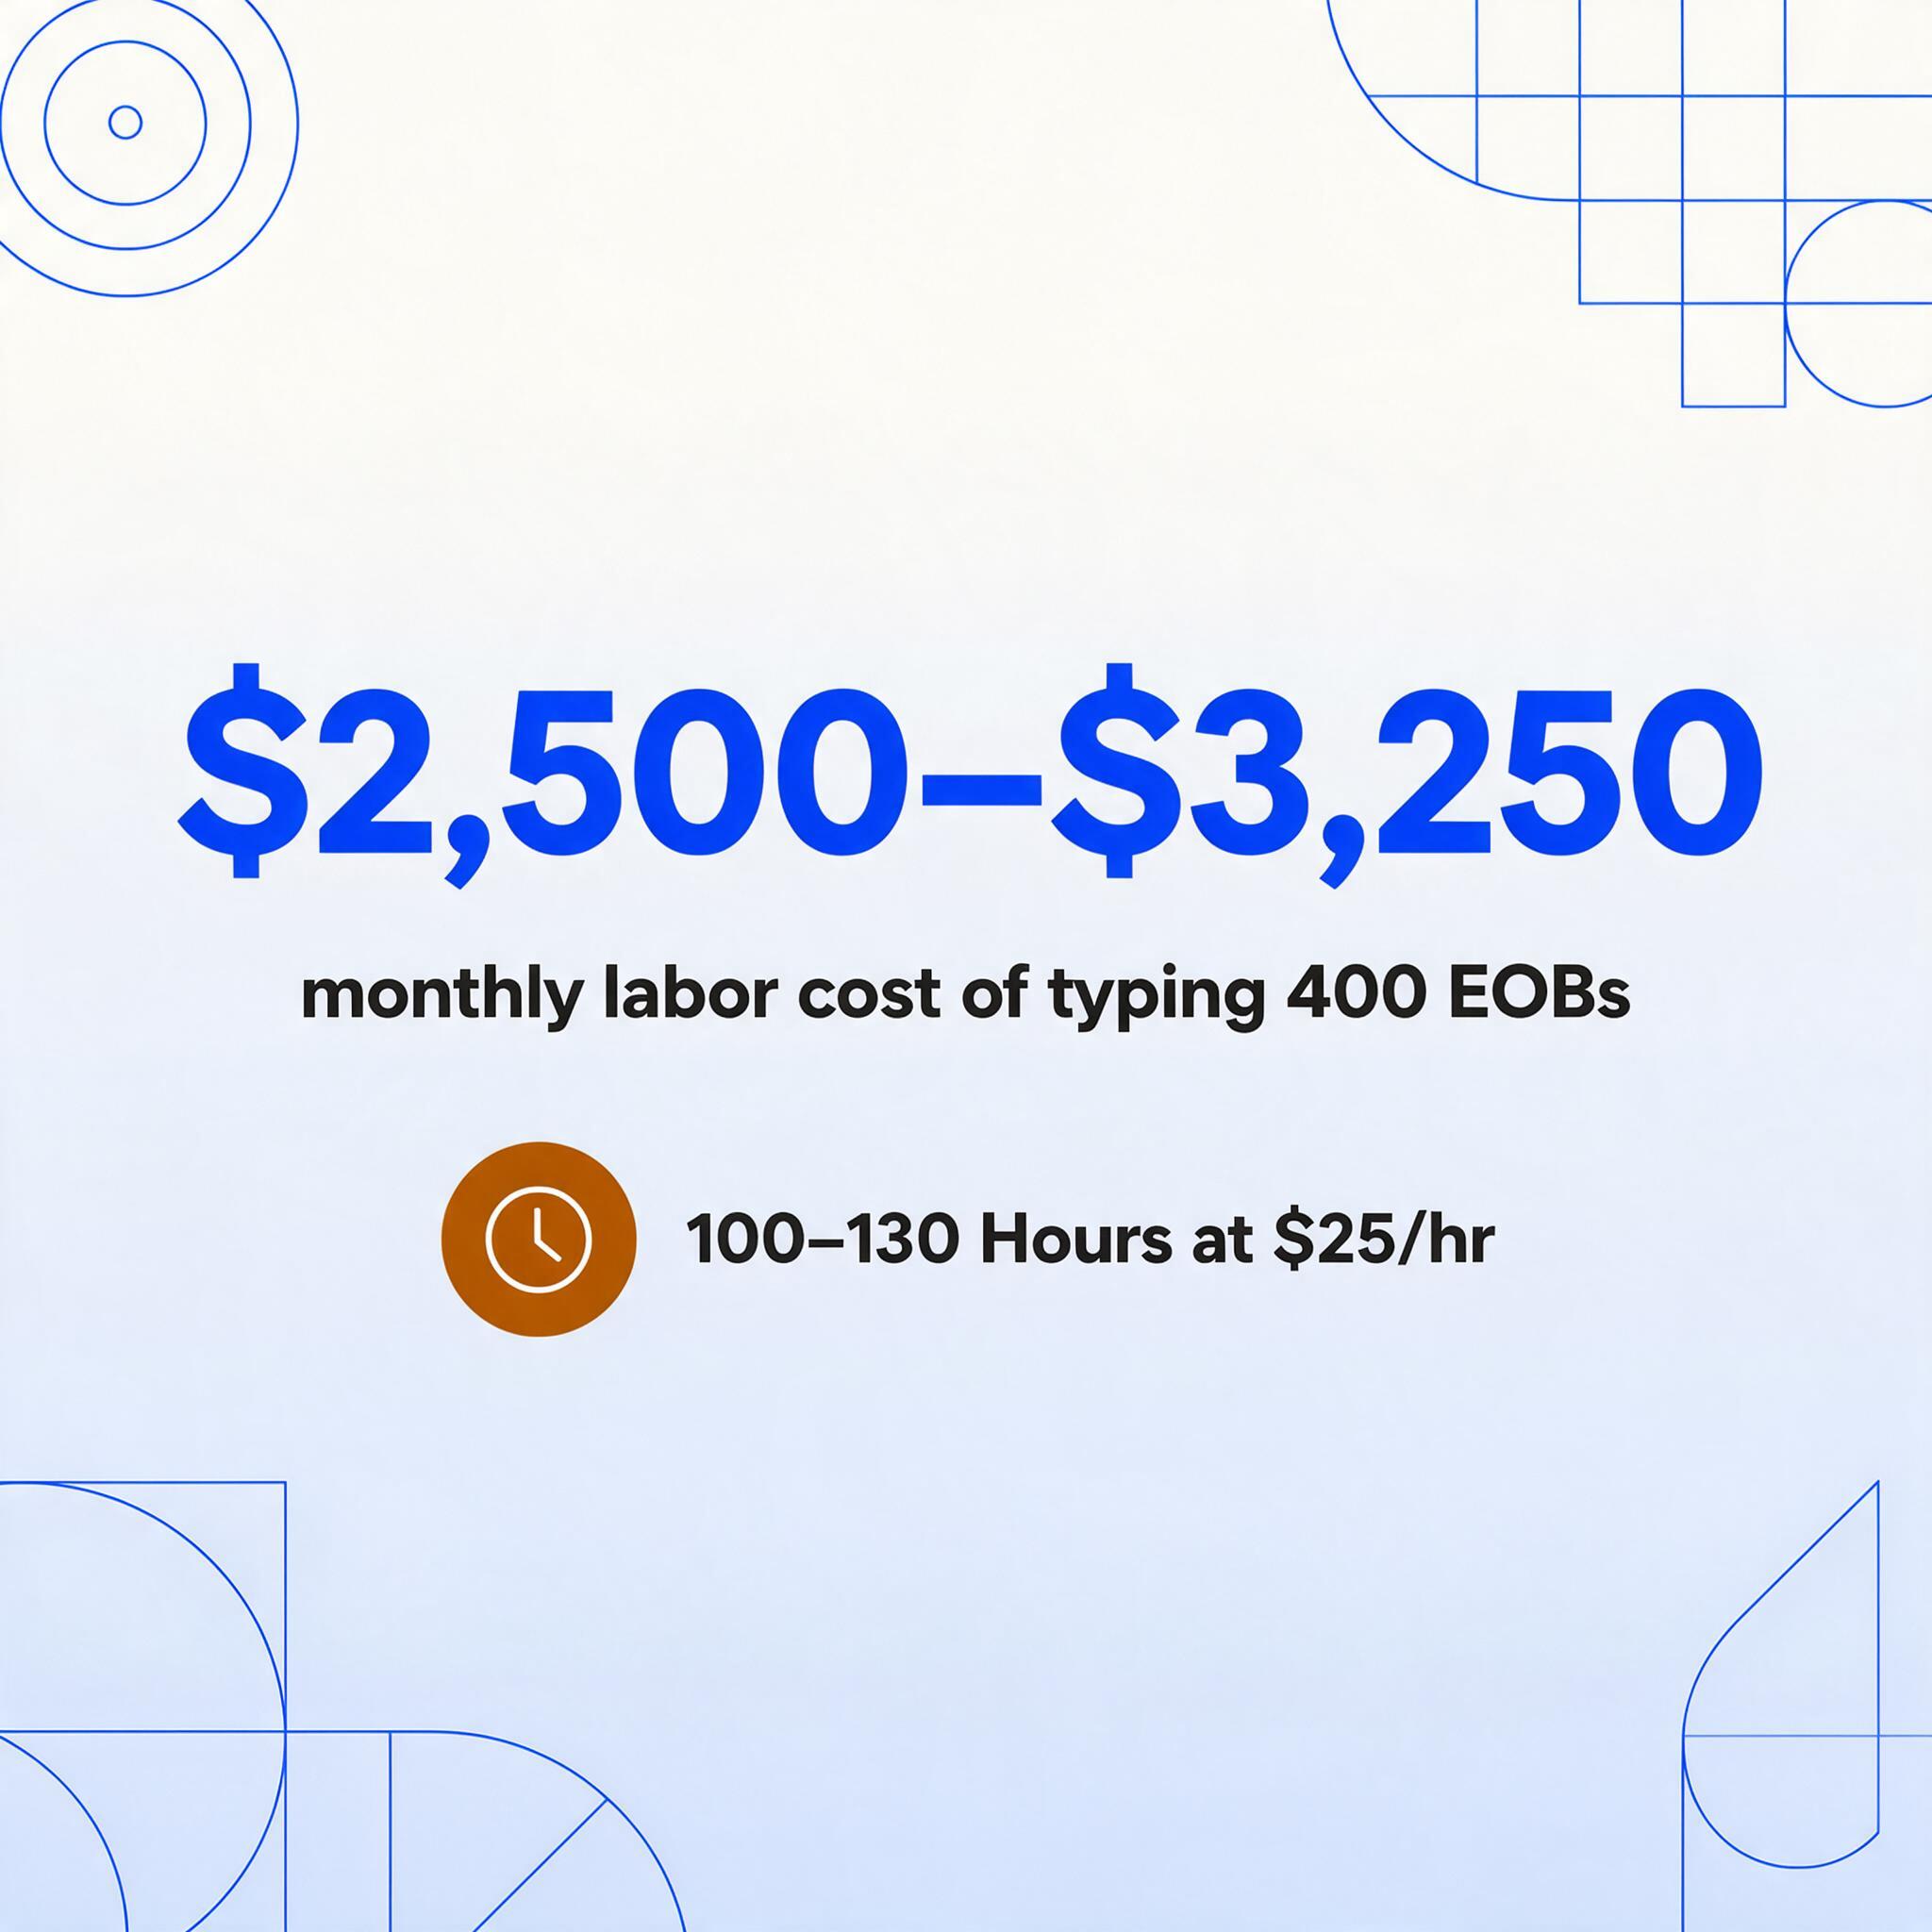
A mão de obra da transcrição. Um consultório de médio porte que processa 400 EOBs por mês gasta aproximadamente 100 a 130 horas apenas com entrada de dados, considerando 15 a 20 minutos por documento para leitura, localização dos campos corretos, digitação e verificação. A $25 por hora, isso representa $2.500 a $3.250 em custo direto de mão de obra todo mês — antes de qualquer correção de erros. Esse é o custo visível. O invisível é o que esse especialista em faturamento não está fazendo: recorrer de negações, acompanhar pagamentos a menor, conciliar discrepâncias ou analisar tendências das seguradoras. Para uma análise item por item do custo total por sinistro — mão de obra, despesas de software, retrabalho por erros e pagamentos a menor não recuperados — consulte nossa análise de custo da entrada manual de dados de EOB.
O imposto dos erros. A taxa de erro de 8–12% considerada normal na entrada manual de dados se traduz diretamente em sinistros rejeitados, pagamentos aplicados incorretamente e trabalho de conciliação que leva mais tempo do que a digitação original. Um único dígito trocado em um valor permitido ou um código CPT inserido incorretamente pode gerar uma negação que leva 30 minutos para pesquisar e recorrer. Dados do setor sugerem que erros apenas na entrada de dados de EOB respondem por cerca de um quarto das negações de sinistros evitáveis. Cada sinistro negado custa em média $118 para retrabalhar, e esse custo raramente é rastreado como um custo de processamento de EOB — ele está embutido no orçamento de gerenciamento de negações.
Confusão na cobrança ao paciente. Quando a responsabilidade do paciente é calculada incorretamente — uma franquia aplicada à linha errada, um copagamento interpretado como cosseguro — o paciente recebe uma declaração que não corresponde ao EOB (Explanation of Benefits). Isso gera ligações, disputas, atrasos nos pagamentos e, nos piores casos, reclamações aos órgãos reguladores de seguros estaduais. O custo dessas ligações raramente é medido, mas qualquer pessoa que já gerenciou um setor de cobrança médica sabe que uma única disputa de cobrança pode consumir 45 minutos envolvendo vários membros da equipe.
Demora na conciliação de sinistros. Comparar o pagamento lançado ao sinistro com o reembolso esperado serve para identificar subpagamentos. Quando os dados usados nessa conciliação são, eles próprios, propensos a erros, a comparação gera falsos positivos (alertas que na verdade são erros de digitação, não subpagamentos reais) e falsos negativos (subpagamentos reais que passam despercebidos porque o número extraído coincide com o sinistro errado). Uma pesquisa da HFMA (Healthcare Financial Management Association) de 2023 constatou que 43% dos prestadores enfrentam atrasos nos pagamentos especificamente por causa de erros manuais no processamento de EOBs.
Esses quatro custos são cumulativos, não alternativos. Uma clínica que gasta US$ 2.500 por mês com mão de obra de transcrição provavelmente também perde um valor equivalente com correção de erros, disputas de cobrança de pacientes e subpagamentos não identificados. O custo real do processamento manual de EOBs é aproximadamente o dobro do item visível de mão de obra.
O Verdadeiro Desafio: Mais de 6.000 Layouts de Seguradoras
A razão pela qual o processamento manual de EOBs é tão propenso a erros não é falta de treinamento das pessoas que o fazem. É que existem mais de 6.000 layouts distintos de EOB entre as seguradoras nos Estados Unidos. Cada seguradora — UnitedHealthcare, Aetna, Cigna, Humana, Blue Cross Blue Shield (cada plano estadual de forma independente), Medicare, Medicaid managed care organizations, seguradoras de compensação trabalhista — organiza os mesmos dados de maneiras diferentes.
Algumas seguradoras apresentam o resumo do sinistro em uma tabela horizontal com colunas para datas, códigos de procedimento, valor cobrado, valor permitido e responsabilidade do paciente. Outras usam um layout vertical empilhado, em que cada linha de serviço é um bloco de campos rotulados. Algumas dividem a franquia, o cosseguro e o copagamento em subcolunas separadas; outras condensam tudo em uma única linha "Paciente deve". Algumas até mudam o layout dentro de um mesmo EOB — usando um formato para sinistros pagos e outro para sinistros negados no mesmo PDF.
Reconhecimento de códigos CPT e ICD. Os códigos de procedimento (CPT/HCPCS) e códigos de diagnóstico (ICD-10) que aparecem em um EOB são os campos mais sensíveis do documento. Um único código CPT digitado errado — 99213 em vez de 99214 — significa que o sinistro era para um nível diferente de serviço. O sistema de cobrança lançará o pagamento errado, a seguradora pode negar a diferença em uma auditoria, e o prestador pode ter que reembolsar o pagamento em excesso meses depois. Esses códigos são densamente agrupados, frequentemente aparecem juntos sem delimitadores claros e às vezes são truncados quando excedem a largura do campo no EOB impresso.
O detalhamento financeiro. Um EOB normalmente mostra o valor cobrado (o que o prestador cobrou), o valor permitido (o que a seguradora considera razoável), o valor pago pelo plano e a responsabilidade do paciente — que é, por sua vez, uma composição de franquia aplicada, percentual de cosseguro, valor de copagamento e quaisquer valores não cobertos. Cada seguradora divide esses subcomponentes de forma diferente. Em um EOB da UnitedHealthcare, a franquia pode aparecer em uma coluna separada. Em um EOB da Blue Cross, ela pode estar embutida em uma linha de ajuste com um código de observação. O método de extração precisa entender qual subtotal contém qual componente, não apenas localizar os cifrões.
Códigos de observação. Os Códigos de Motivo de Ajuste de Reivindicação (CARC) e os Códigos de Observação de Aviso de Remessa (RARC) explicam por que um ajuste foi aplicado ou uma reivindicação foi negada — por exemplo, CO-45 (obrigação contratual — valor excede a tabela de honorários) ou PR-1 (responsabilidade do paciente — valor da franquia). Existem centenas de códigos ativos mantidos pela organização de padrões X12, e os pagadores os aplicam de forma inconsistente. Um código no EOB (Explanation of Benefits) de um pagador pode aparecer em texto simples no de outro. Extrair esses códigos com precisão exige lê-los pelo contexto, não pela posição.
Essas quatro camadas de complexidade — variabilidade de layout, densidade de códigos médicos, cálculos financeiros e códigos de ajuste — são o que tornam a extração de EOB um problema fundamentalmente diferente da extração de uma fatura padrão. E são a razão pela qual as ferramentas tradicionais de OCR baseadas em modelos, que dependem de posições fixas de campos, falham em EOBs.
Processamento Tradicional vs. Extração com IA
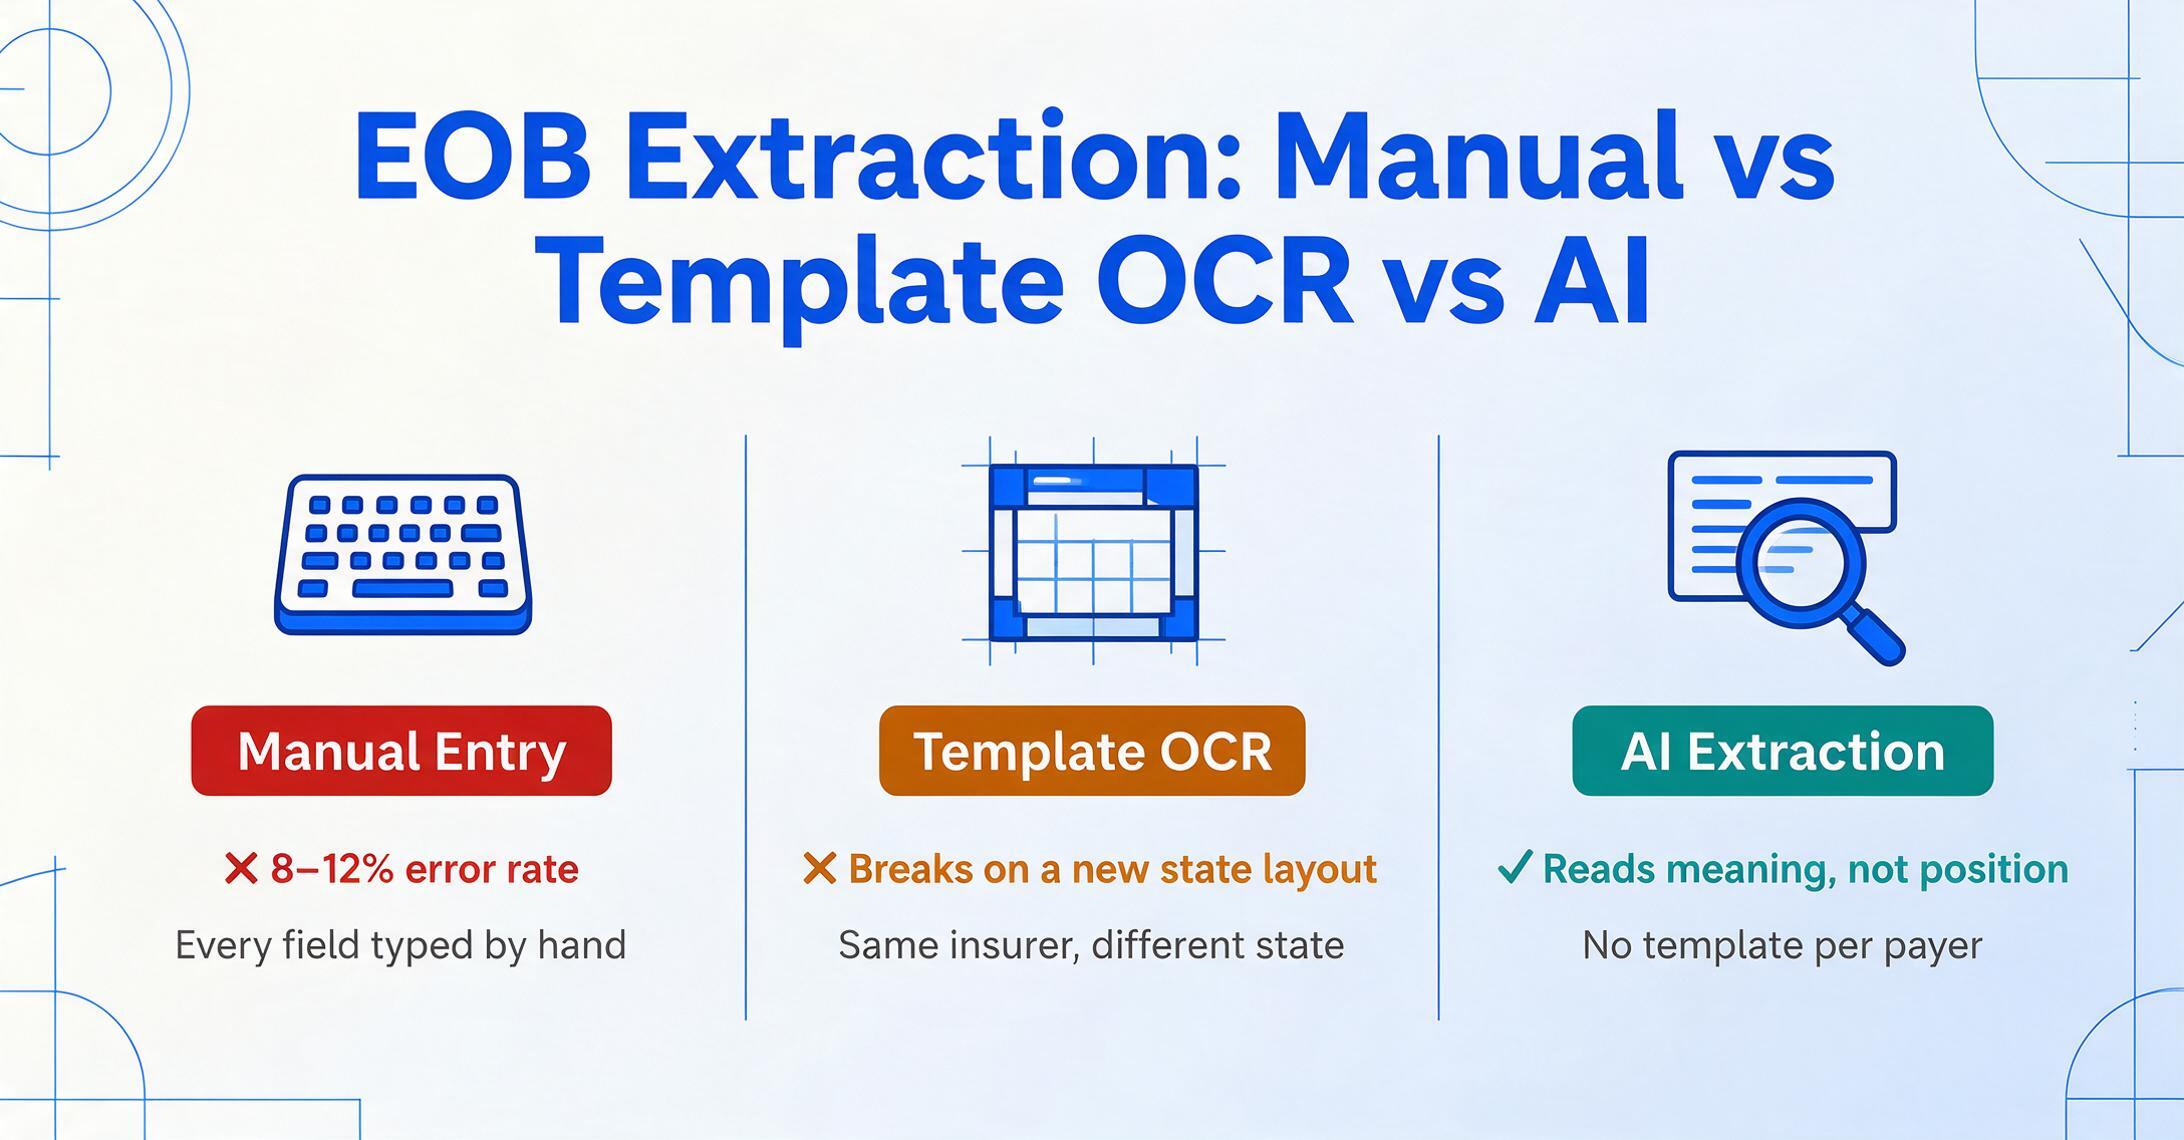
A abordagem convencional para processamento de EOB tem duas variantes: entrada manual de dados e OCR baseado em modelos. Ambas compartilham a mesma limitação fundamental — tratam o EOB como um documento com layout previsível, o que ele não é.
O OCR baseado em modelos funciona bem quando o mesmo formulário chega toda vez: o campo "Valor Permitido" está sempre na mesma coluna da mesma página, e o software pode ser configurado para procurar exatamente ali. Os EOBs violam essa premissa. Um modelo configurado para um EOB da Blue Cross da Flórida falhará em um EOB da Blue Cross de Illinois — mesma seguradora, estado diferente, layout diferente.
A extração com IA, por outro lado, lê o documento entendendo o que cada dado significa, não onde está. A tecnologia por trás disso é um VLM (modelo de visão e linguagem) — a mesma classe de modelo que pode olhar uma fotografia e descrever o que está acontecendo nela. Quando aplicado a um EOB, o modelo vê o documento como um todo, identifica os cabeçalhos das seções ("Responsabilidade do Paciente", "Valor Pago", "Descrição do Serviço") e localiza os valores correspondentes pela relação semântica com esses cabeçalhos, não pelas coordenadas de pixels.
Essa é a diferença fundamental. Uma abordagem baseada em modelos pergunta "Onde está a franquia?" e procura em uma coordenada fixa. Uma abordagem baseada em IA pergunta "Qual é a franquia para esta linha de serviço?" e lê o documento até encontrar a resposta.
| Dimensão | Entrada Manual | OCR Baseado em Modelo | Extração com IA |
|---|---|---|---|
| Cobertura de formato do pagador | Humano lê qualquer formato | Apenas modelos pré-configurados | Qualquer formato, primeiro upload |
| Configuração por pagador | Nenhuma (humano lê visualmente) | Criação + teste de modelo por layout | Nenhuma — configuração zero |
| Tempo de processamento por EOB | 15–20 minutos | 2–5 minutos | 5–10 segundos |
| Taxa de erro típica | 8–12% | 5–8% (falha em mudanças de formato) | Abaixo de 2% |
| Extração de códigos CPT/ICD | Propensa a erros de digitação | Depende da zona correta | Leitura contextual |
| Lote multi-pagador | Sequencial — um de cada vez | Apenas EOBs do mesmo layout | Pagadores mistos em um lote |
| Resiliência a mudanças de formato | N/A (humano se adapta) | Falha até o modelo ser atualizado | Lida com novos layouts automaticamente |
O resultado não é apenas um processamento mais rápido. É um fluxo de trabalho fundamentalmente diferente: em vez de um especialista em faturamento abrir cada EOB, lê-lo e digitar valores em um sistema, a IA lê o lote inteiro e o especialista revisa apenas as exceções — discrepâncias sinalizadas, códigos incomuns ou valores fora das faixas esperadas.
A mudança não é velocidade. A mudança é alocação de atenção. Uma equipe de faturamento que gasta 100 horas em entrada de dados quase não tem tempo para análise de negações ou negociação com pagadores. Uma equipe cuja entrada de dados é feita pela IA recupera essas 100 horas para o trabalho que realmente melhora o desempenho do ciclo de receita.
Experimente Você Mesmo: Envie um EOB e Veja os Resultados
A demonstração integrada abaixo permite que você envie um documento EOB — um PDF, uma imagem escaneada ou até uma foto tirada do seu celular — e veja o que a extração com IA produz em segundos. Sem cadastro, sem configuração, sem criação de modelos.
Os arquivos são processados com segurança e não são armazenados após a extração.
Campos Críticos em Todo EOB
Embora cada pagador formate esses campos de maneira diferente, os dados que uma equipe de cobrança precisa de um EOB são notavelmente consistentes entre todos os pagadores. O desafio não é saber o que extrair — é configurar o método de extração para localizar cada campo corretamente em um layout que nunca viu antes.
| Campo | Por Que É Importante | Rótulos Comuns dos Pagadores |
|---|---|---|
| ID do Paciente/Membro | Vincula o EOB ao registro correto do paciente e à reclamação | ID do Membro, ID do Segurado, ID do Paciente, ID# |
| Nome do Paciente | Verificação da identidade do paciente | Nome do Paciente, Nome do Membro, Segurado |
| Nome do Prestador / NPI | Garante que o pagamento seja creditado ao prestador correto | Prestador, Prestador Executante, Prestador Faturante, NPI |
| Data do Atendimento | Determina o período de benefício e os termos contratuais aplicáveis | DATA, Data do Serviço, De–Até, Data do Atendimento |
| Código CPT / HCPCS | Identifica o procedimento específico realizado — o campo mais suscetível a erros | CPT, Código do Procedimento, Código, HCPCS, Código do Serviço |
| Código de Diagnóstico CID-10 | Justificativa de necessidade médica — códigos incorretos geram negativas | Código de Diagnóstico, CID-10, DX, Diagnóstico Principal |
| Valor Cobrado | O que o prestador cobrou — usado para cálculos de ajuste contratual | Cobrado, Encargos, Valor Enviado, Valor Faturado |
| Valor Permitido | A taxa negociada pelo pagador — base para todos os cálculos de pagamento subsequentes | Permitido, Valor Coberto, Aprovado, Abono do Plano |
| Pagamento do Plano | O que a seguradora efetivamente pagou — valor que deve corresponder ao cheque ou TED | Pago pelo Plano, Pagamento do Seguro, Plano Pagou, Valor do Cheque |
| Franquia Aplicada | Parte do valor permitido aplicada à franquia anual do paciente | Franquia, Aplicado à Franquia, Franquia do Paciente |
| Cosseguro | Participação percentual do paciente no valor permitido após a franquia | Cosseguro, Cosseguro do Paciente, % de Coparticipação |
| Coparticipação | Taxa fixa do paciente por serviço (geralmente aparece separada do cosseguro) | Coparticipação, Co-Pagamento, Copagamento de Consulta, Copagamento de Receita |
| Responsabilidade do Paciente (Total) | Soma de franquia + coparticipação + copagamento + valores não cobertos — o que cobrar do paciente | Paciente Deve, Responsabilidade do Paciente, Valor Devido, Total do Paciente |
| Valor de Ajuste / Negativa | Reduções aplicadas pela operadora — contratuais ou não cobertas | Ajuste, Valor Negado, Desconto, Não Coberto |
| Códigos de Observação CARC / RARC | Explicam por que um ajuste ou negativa foi aplicado — essencial para recursos | Código de Motivo de Ajuste, Código de Observação, Observação, CARC, RARC |
| Número do Sinistro / ICN | Identificador único do sinistro — vincula o EOB ao envio 837 original | Nº do Sinistro, ICN, Número de Controle Interno, ID do Sinistro |
Com uma ferramenta de extração baseada em IA que suporta Extração de Colunas Personalizadas, você digita os nomes dos campos necessários — "Nome do Paciente," "Código CPT," "Valor Cobrado," "Responsabilidade do Paciente" — e a IA localiza cada valor pelo seu significado semântico em qualquer layout de pagador. Você define a saída; a IA lê o documento. Para um passo a passo detalhado de como configurar essas colunas e executar sua primeira extração, consulte nosso guia prático para extração em lote de EOB.
De EOBs em Lote para o Resumo de Cobrança do Paciente
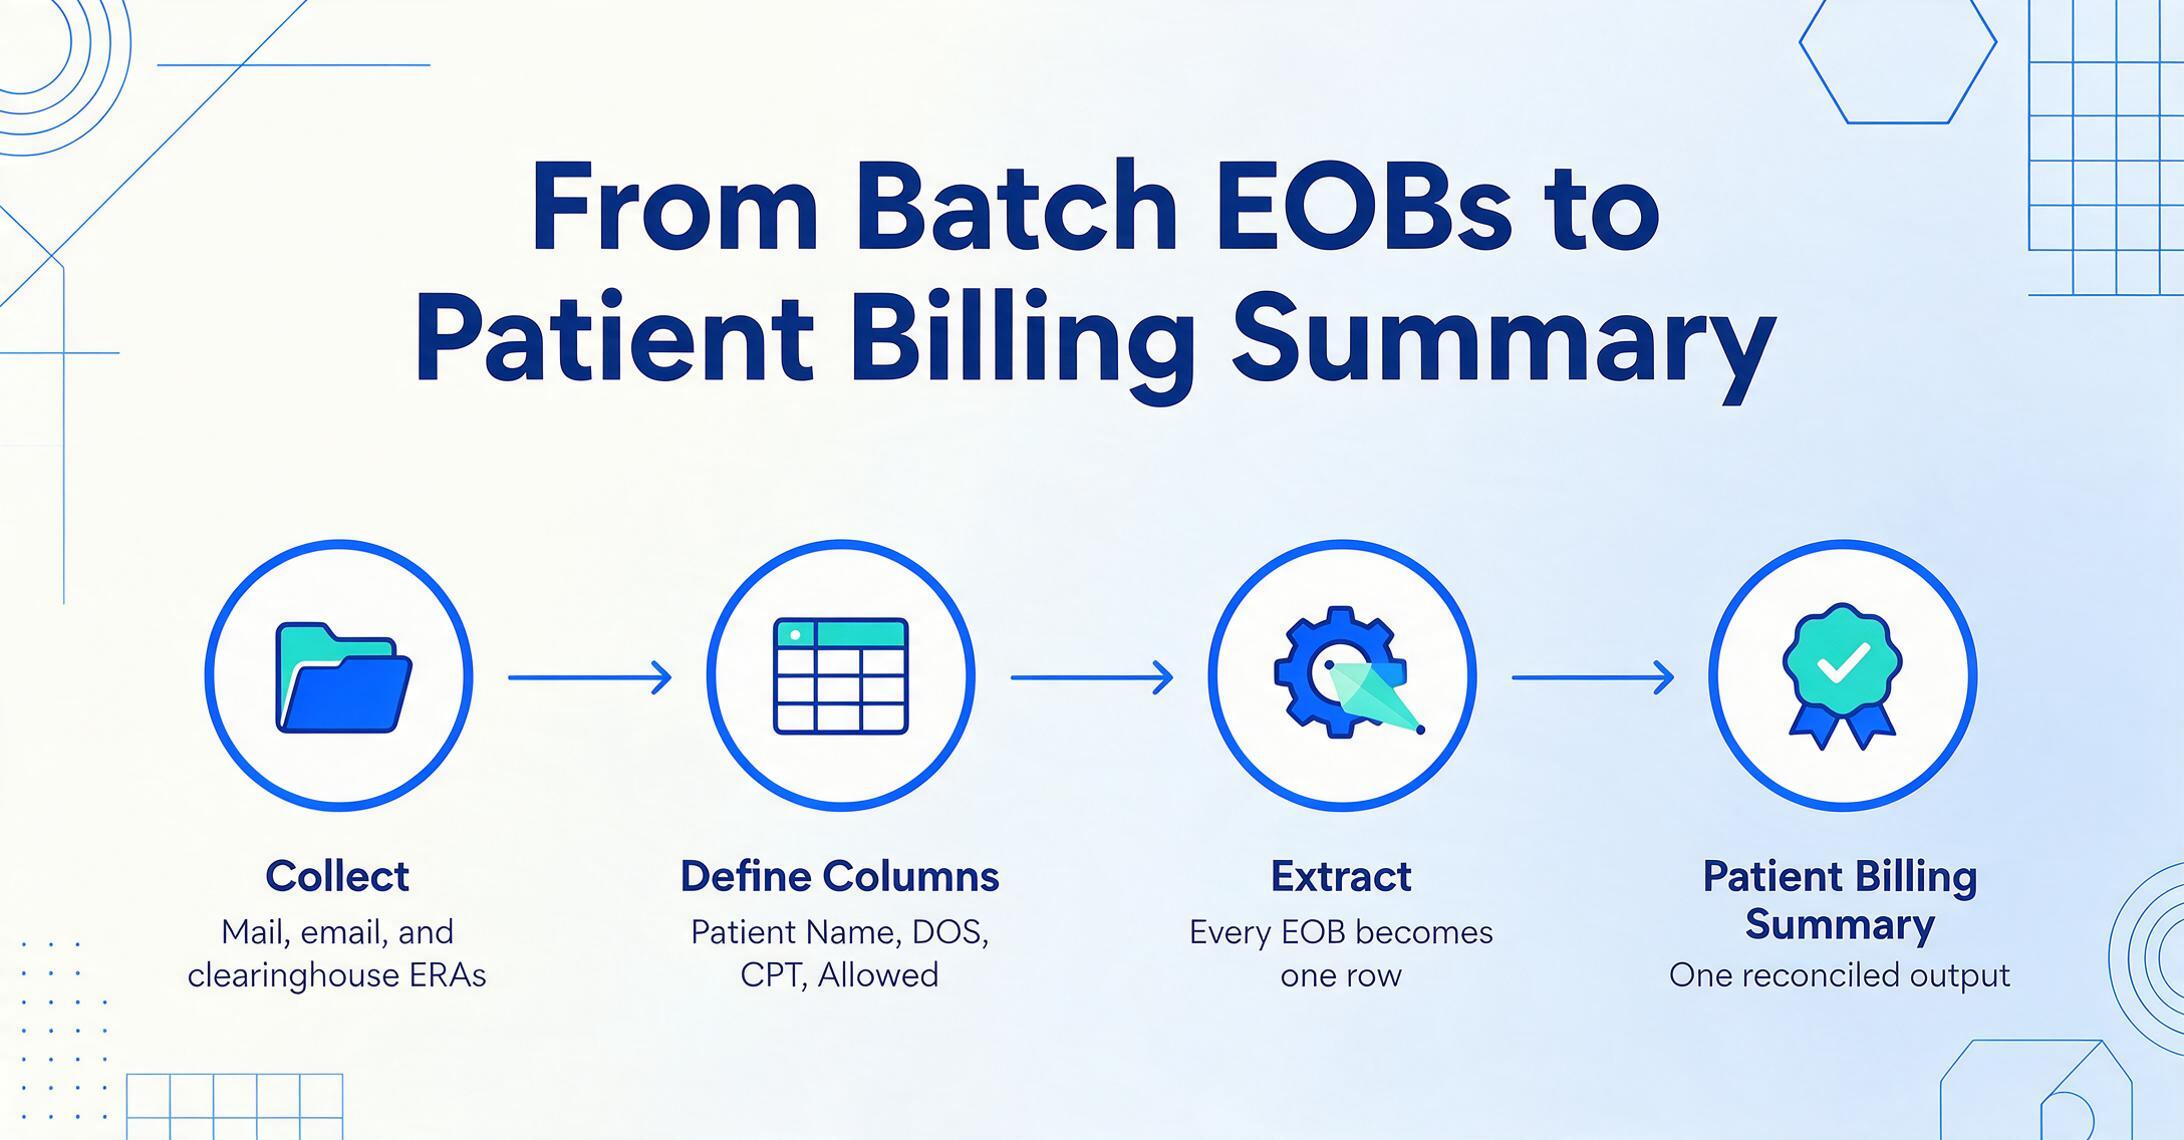
O verdadeiro poder da extração automatizada de EOB (Explanation of Benefits) não está em processar um documento mais rápido — está em processar um lote de documentos de diferentes seguradoras como um único grupo e produzir uma saída consolidada que reúne todos os dados em um resumo de cobrança do paciente.
Veja como uma equipe típica de cobrança médica passa de uma pilha de EOBs para um resumo de cobrança do paciente conciliado usando extração em lote com IA:
Colete os EOBs (Explanation of Benefits) de cada pagadora.
Alguns chegam pelo correio como documentos impressos. Outros chegam como anexos em PDF por e-mail. Alguns consultórios usam uma clearinghouse que encaminha ERA (Electronic Remittance Advice no formato X12 835) para algumas pagadoras, mas recebe EOBs em PDF de outras. Cada PDF ou digitalização vai para uma única pasta — independentemente de qual pagadora emitiu, independentemente do layout.
Envie o lote e defina as colunas de saída.
Envie o lote inteiro — ele pode conter EOBs da Blue Cross, Aetna, UnitedHealthcare, Medicare e Cigna misturados. Defina os nomes das colunas: "Patient Name", "Member ID", "DOS", "CPT Code", "Billed", "Allowed", "Plan Paid", "Deductible", "Coinsurance", "Copay", "Patient Responsibility". A IA lê cada documento e mapeia esses campos por compreensão semântica, não por correspondência de modelo.
A IA processa cada EOB em segundos por página.
A extração percorre o lote sequencialmente ou em paralelo, dependendo da ferramenta. Cada EOB gera uma linha na tabela de saída. Como a IA lê pelo contexto, um EOB da Blue Cross e um aviso de remessa da Medicare no mesmo lote produzem dados na mesma estrutura de colunas — sem configuração por pagadora.
Revise e reconcilie exceções sinalizadas.
A equipe de faturamento revisa apenas os itens que a IA sinaliza — valores fora das faixas esperadas, responsabilidade do paciente que não corresponde ao cálculo esperado, códigos de ajuste que sugerem negação. Todo o resto já está lançado na saída. A revisão que costumava levar 15–20 minutos por EOB agora leva alguns minutos para o lote inteiro.
Produza o resumo de cobrança do paciente.
A saída consolidada — uma linha por item de serviço, com a responsabilidade do paciente dividida em dedutível, coparticipação, copagamento e total devido — torna-se a fonte de verdade para os extratos do paciente. Com Computed Columns, você pode até definir cálculos adicionais diretamente na extração: por exemplo, uma coluna que calcula "Remaining Balance = Patient Responsibility — Payments Received" sem sair da ferramenta de extração. Para um mergulho mais profundo em fluxos de trabalho em lote com múltiplas pagadoras, consulte nosso artigo sobre como equipes de faturamento médico extraem dados em lote de centenas de EOBs.
Para consultórios que precisam coletar EOBs de vários provedores ou locais sem dar a todos acesso à conta principal, o ImageToTable.ai oferece um recurso de Link de Coleta: gere um URL compartilhável, envie-o para provedores ou equipe de campo, e eles podem enviar EOBs diretamente para sua fila de processamento — sem necessidade de cadastro.
Exportação e Integração
Os dados extraídos do EOB (Explanation of Benefits) só são úteis se chegarem ao sistema onde o faturamento e a conciliação acontecem. Diferentes consultórios têm necessidades distintas a jusante, e a ferramenta de extração certa deve suportar os destinos mais comuns.
Excel ou Google Sheets. Este é o destino mais comum para pequenos e médios consultórios. Um único lote de extração produz uma planilha estruturada com todos os campos críticos — nome do paciente, códigos CPT, valores cobrados, valores permitidos, pagamentos do plano, detalhamento da responsabilidade do paciente — em colunas rotuladas. A planilha está pronta para importação no sistema de gestão do consultório ou para uso como livro de conciliação. Para equipes que usam o Google Sheets, o complemento ImageToTable.ai para Google Sheets envia os dados extraídos diretamente para a planilha ativa sem sair do Sheets.
Sistemas de gestão de consultório e EHR. Consultórios que usam Epic, Cerner, Meditech, AdvancedMD, Kareo, NextGen, athenahealth ou eClinicalWorks normalmente exportam os dados estruturados e os mapeiam no módulo de lançamento de pagamentos do seu sistema. O requisito principal é que os dados exportados contenham os mesmos campos em um esquema consistente — os cabeçalhos das colunas não mudam entre lotes, e as variações específicas de cada pagador são normalizadas para que a importação a jusante veja uma estrutura de dados uniforme, independentemente de qual pagador emitiu o EOB.
Faturamento no portal do paciente. Uma vez que a responsabilidade do paciente é calculada e verificada, o valor voltado ao paciente alimenta o portal do paciente ou o sistema de declaração de cobrança. A responsabilidade precisa do paciente — a divisão correta entre franquia, cosseguro e copagamento — é essencial aqui, porque uma declaração que não corresponde ao EOB gera ligações e disputas.
Como Escolher uma Ferramenta de Extração de EOB
Nem todas as ferramentas de extração de documentos são adequadas para EOBs. As características específicas desses documentos — variabilidade de formato entre pagadores, codificação médica densa, campos financeiros multicomponentes — reduzem significativamente o campo de opções. Aqui estão os critérios que mais importam ao avaliar uma solução de extração de EOB.
Precisão multi-pagador no primeiro uso. O teste mais importante é simples: carregue um EOB da Blue Cross, um EOB da Aetna, um aviso de remessa do Medicare e um EOB da Cigna em um único lote e veja se a mesma configuração de extração produz dados precisos para todos os quatro. Se a ferramenta exigir um modelo separado por pagador ou precisar ser treinada com documentos de amostra para cada formato, o benefício da extração é significativamente reduzido. A abordagem sem modelo do ImageToTable.ai significa nenhuma configuração por pagador — a IA lê cada documento entendendo o que cada campo significa, independentemente de onde ele aparece na página.
Precisão no reconhecimento de códigos CPT/ICD. Os códigos de procedimento e diagnóstico são os campos mais sensíveis a erros em um EOB. Procure uma ferramenta que demonstre capacidade de ler códigos densamente agrupados — incluindo códigos que aparecem juntos sem separação visual clara, códigos truncados que continuam em uma segunda linha e códigos embutidos em cabeçalhos de seção em vez de uma coluna dedicada.
Suporte ao cálculo da responsabilidade do paciente. As melhores ferramentas de extração não apenas geram campos individuais e deixam a matemática para você. O recurso de coluna calculada do ImageToTable.ai permite definir o cálculo da responsabilidade do paciente como parte da extração: especifique "Total do Paciente = Franquia + Cosseguro + Copagamento + Não Coberto" como uma coluna calculada, e a IA calcula para cada linha durante a extração. Isso elimina uma etapa de verificação manual que é, por si só, propensa a erros.
Considerações de conformidade com a HIPAA. Os EOB (Explanation of Benefits) contêm informações de saúde protegidas (PHI) — nomes de pacientes, IDs de membros, códigos de diagnóstico e outros identificadores que se enquadram nas Regras de Privacidade e Segurança da HIPAA. Qualquer ferramenta que processe dados de EOB deve oferecer salvaguardas adequadas. Ao avaliar uma ferramenta, confirme se ela suporta transmissão segura de dados (criptografia AES-256 em trânsito e em repouso), exclusão automática de dados após o processamento e um Contrato de Associado de Negócios (BAA) se a PHI for armazenada ou transmitida pela infraestrutura do fornecedor. Esta é uma descrição do contexto de conformidade, não um aconselhamento jurídico. Consulte o responsável pela conformidade ou o departamento jurídico da sua organização para obrigações específicas da HIPAA.
Processamento em lote e manuseio de formatos mistos. Se o seu consultório processa EOBs de mais de três ou quatro pagadores — e a maioria processa — a ferramenta deve lidar com lotes de formatos mistos. A capacidade de enviar uma pasta de PDFs de dez pagadores diferentes em um único upload e receber de volta uma única planilha é a diferença entre uma ferramenta que economiza tempo e uma que gera mais trabalho.
Para uma comparação mais ampla de ferramentas de extração de documentos em casos de uso de saúde, veja nossa seleção de as melhores ferramentas de extração de documentos para saúde em 2026.
Perguntas Frequentes Sobre Extração de Dados de EOB
A IA consegue extrair dados de EOBs que incluem vários pacientes em um único documento?
Sim. EOBs de múltiplos pacientes — quando um único documento lista reivindicações de vários pacientes agrupados pelo pagador — são uma fonte comum de erros manuais de extração. A extração baseada em IA lê o documento como um todo e identifica quais linhas de serviço pertencem a qual paciente pela relação contextual entre identificadores de paciente e detalhes do procedimento, separando-os em linhas de saída distintas. Isso é significativamente mais confiável do que a triagem manual, que está sujeita a erros de alocação.
A ferramenta precisa ser treinada no formato de EOB de cada pagador antes de funcionar?
Não. O ImageToTable.ai extrai dados de EOBs usando compreensão semântica, não correspondência de modelos. O primeiro EOB de qualquer pagador — seja uma grande operadora nacional como a UnitedHealthcare ou um plano regional pequeno — é processado com a mesma configuração. Não há fase de treinamento, coleta de amostras ou criação de modelos por pagador.
O que acontece se um pagador alterar o layout do EOB?
A extração continua funcionando. Como a IA lê os dados pelo significado, e não pela posição, uma alteração no layout — colunas reordenadas, cabeçalhos de seção movidos, cabeçalhos redesenhados — não interrompe a extração. Essa é uma vantagem fundamental sobre as ferramentas de OCR baseadas em modelos, que exigem reconfiguração sempre que um pagador modifica seu formulário.
A ferramenta consegue extrair EOBs digitalizados de cópias impressas?
Sim. A IA processa imagens digitalizadas e fotos de EOBs impressos, não apenas PDFs digitais. Cenários comuns incluem EOBs em papel recebidos pelo correio de seguradoras menores, cópias enviadas por fax de provedores de referência e EOBs fotografados que os pacientes enviam para reembolso. A precisão da extração depende da qualidade da imagem — digitalizações nítidas a 200 DPI ou mais produzem os melhores resultados — mas o VLM (modelo de visão e linguagem) é projetado para lidar com a degradação típica de documentos digitalizados.
Como a ferramenta lida com os códigos de observação CARC e RARC nos EOBs?
A IA lê os códigos de motivo de ajuste e os códigos de observação do EOB e os gera como campos extraídos. Como alguns pagadores incorporam esses códigos em texto simples enquanto outros usam valores numéricos de código, a extração captura tanto o código quanto qualquer texto explicativo acompanhante, quando disponível. A saída pode então ser usada para categorizar negativas e ajustes para relatórios e acompanhamento de apelações.
A ferramenta está em conformidade com a HIPAA?
O ImageToTable.ai processa documentos com criptografia em trânsito (TLS) e em repouso (AES-256). Arquivos enviados por usuários anônimos são excluídos automaticamente após o processamento, e os arquivos de usuários logados são retidos apenas pelo período de retenção do plano e depois excluídos permanentemente. Um Contrato de Parceiro de Negócios (BAA) está disponível para provedores que precisam documentar a conformidade com a HIPAA em seus fluxos de trabalho de extração de documentos. Como em qualquer ferramenta de processamento de dados de saúde, você deve revisar a documentação específica de segurança e conformidade em relação às políticas da sua organização e consultar seu responsável pela conformidade.
Qual é a diferença entre extrair um EOB e um ERA?
O ERA (Electronic Remittance Advice) é a transação eletrônica padrão da HIPAA (ASC X12 835) que contém as mesmas informações de pagamento de sinistros que um EOB, mas em formato legível por máquina. Os ERAs podem ser lançados automaticamente em sistemas de gestão de consultórios com intervenção manual mínima. EOBs geralmente são documentos em papel ou PDF destinados à explicação para o paciente ou provedor. A extração é a forma de fazer com que EOBs em PDF se comportem como ERAs — convertendo seus dados visuais em saída estruturada e legível por máquina. A maioria dos consultórios recebe uma combinação de ERAs de grandes pagadores e EOBs em PDF de outros, portanto, um fluxo de trabalho completo de ciclo de receita precisa lidar com ambos.
Quantos EOBs por mês tornam a extração automatizada viável em termos de custo?
Para consultórios que processam mais de 200 EOBs por mês, a economia de mão de obra com a extração automatizada normalmente cobre o custo da ferramenta já no primeiro mês. Abaixo desse limite, a economia é menor, mas o tempo poupado ainda pode ser significativo para uma pequena equipe de faturamento — 200 EOBs a 15 minutos cada representam 50 horas de entrada de dados por mês que poderiam ser direcionadas para um trabalho mais valioso.
A ferramenta integra com Epic, AdvancedMD ou Kareo?
O ImageToTable.ai exporta dados em formato Excel que podem ser importados para qualquer sistema de gestão de consultórios ou EHR que aceite dados de pagamento estruturados. A integração direta via API está disponível para equipes que precisam de lançamento automatizado. Para um fluxo de trabalho completo sem código, o complemento do Google Sheets permite que os resultados da extração cheguem diretamente em uma planilha que alimenta seu sistema de faturamento.
A ferramenta consegue extrair EOBs de seguradoras de acidentes de trabalho?
Sim. EOBs de acidentes de trabalho usam um conjunto diferente de regras de cobrança e frequentemente incluem ajustes de tabela de honorários médicos específicos para o sistema de acidentes de trabalho de cada estado. A IA lê esses EOBs da mesma forma que lê documentos de pagadores comerciais — compreendendo os campos semanticamente. A mesma configuração de extração que processa um EOB da UnitedHealthcare também processa um EOB de acidentes de trabalho de uma seguradora específica do estado.
O Próximo Passo: Do Manual ao Estruturado
A aritmética do processamento de EOBs é direta, mas fácil de ignorar porque os custos estão distribuídos em várias linhas orçamentárias — mão de obra, correção de erros, tratamento de disputas de pacientes e conciliação — nenhuma delas grande o suficiente por si só para desencadear uma mudança de processo. Juntas, elas representam um dreno significativo no desempenho do ciclo de receita.
A transição da digitação manual para a extração com IA não exige a substituição completa da plataforma de ciclo de receita, um novo sistema de prontuário eletrônico ou envolvimento de TI. Ela começa com um lote: envie os EOBs que você processou ontem, defina as colunas que você gostaria de ter e veja se a saída corresponde ao que sua equipe digitou. Se o resultado for mais limpo e rápido, o caso se expande a partir daí.
Essa lacuna entre o que o EOB diz e o que entra no seu sistema de cobrança — a taxa de erro de 35% da pesquisa da HFMA — não é um problema de pessoas. É um problema de processo com uma solução técnica direta.