La guía completa de
Extracción de datos EOB (2026)
La encuesta de 2023 de la HFMA (Healthcare Financial Management Association) encontró que el 35% de las organizaciones de salud reportan errores en la entrada manual de datos de EOB, y el 43% experimenta retrasos en los pagos como resultado directo. Esas cifras describen la brecha entre lo que dice una explicación de beneficios y lo que realmente se introduce en un sistema de facturación: una brecha que persiste no porque el personal sea descuidado, sino porque la industria pide a las personas hacer algo fundamentalmente antinatural con estos documentos: tratar el diseño de cada aseguradora como si fuera el mismo, cuando no hay dos iguales.
Conclusiones clave
- El 35% de los proveedores reporta errores de entrada de datos de EOB, no porque tu equipo de facturación sea descuidado, sino porque ningún humano puede leer el mismo campo de datos en 6.000 diseños de aseguradora diferentes sin cometer errores.
- Los $2.500 al mes que ves en mano de obra de transcripción se duplican cuando sumas las correcciones de errores, las disputas de facturación de pacientes y los pagos insuficientes no detectados ocultos en líneas presupuestarias separadas: costos que ningún informe individual suma jamás.
- La métrica que importa no son los minutos por EOB, sino recuperar 100 horas al mes para que tu equipo de facturación deje de escribir números y comience a perseguir los pagos insuficientes y las denegaciones que realmente mueven los ingresos.
¿Qué es la extracción de datos de EOB?
La extracción de datos de EOB es el proceso automatizado de leer los campos clave de reclamaciones de seguro de un documento de EOB (Explanation of Benefits) — nombre del paciente, proveedor, fechas de servicio, códigos de procedimiento CPT, montos facturados, montos permitidos, pagos del seguro, ajustes, desglose de responsabilidad del paciente y códigos de denegación o comentarios — y convertirlos en datos estructurados que un sistema de facturación u hoja de cálculo pueda procesar.
El documento en sí, la explicación de beneficios, lo envía la aseguradora de salud después de que se adjudica una reclamación. No es una factura. Es un desglose de lo que el proveedor facturó, lo que la aseguradora permitió según el plan, lo que se pagó al proveedor o al paciente, y lo que el paciente aún debe. Para una introducción más profunda al concepto, consulta nuestro artículo dedicado sobre qué es la extracción de datos de EOB y cómo funciona.
Lo que distingue la extracción de EOB de otras tareas de extracción de documentos es la relación entre los campos de datos. El valor de un EOB no está en ningún número individual — está en cómo encajan el monto facturado, el monto permitido, el pago del plan, el deducible, el coseguro, el copago y la responsabilidad del paciente. Extrae esos números correctamente pero pierde la aritmética que los conecta, y el resultado es técnicamente preciso pero prácticamente inútil para la conciliación de facturación.
Por qué el procesamiento manual de EOB cuesta más de lo que crees
El procesamiento manual de EOB parece económico sobre el papel — un especialista en facturación escribiendo datos de un PDF a una hoja de cálculo o sistema de gestión de práctica, campo por campo, a aproximadamente $25 por hora. El costo real llega a través de cuatro canales separados que la mayoría de las prácticas solo ven cuando los suman al final del mes.
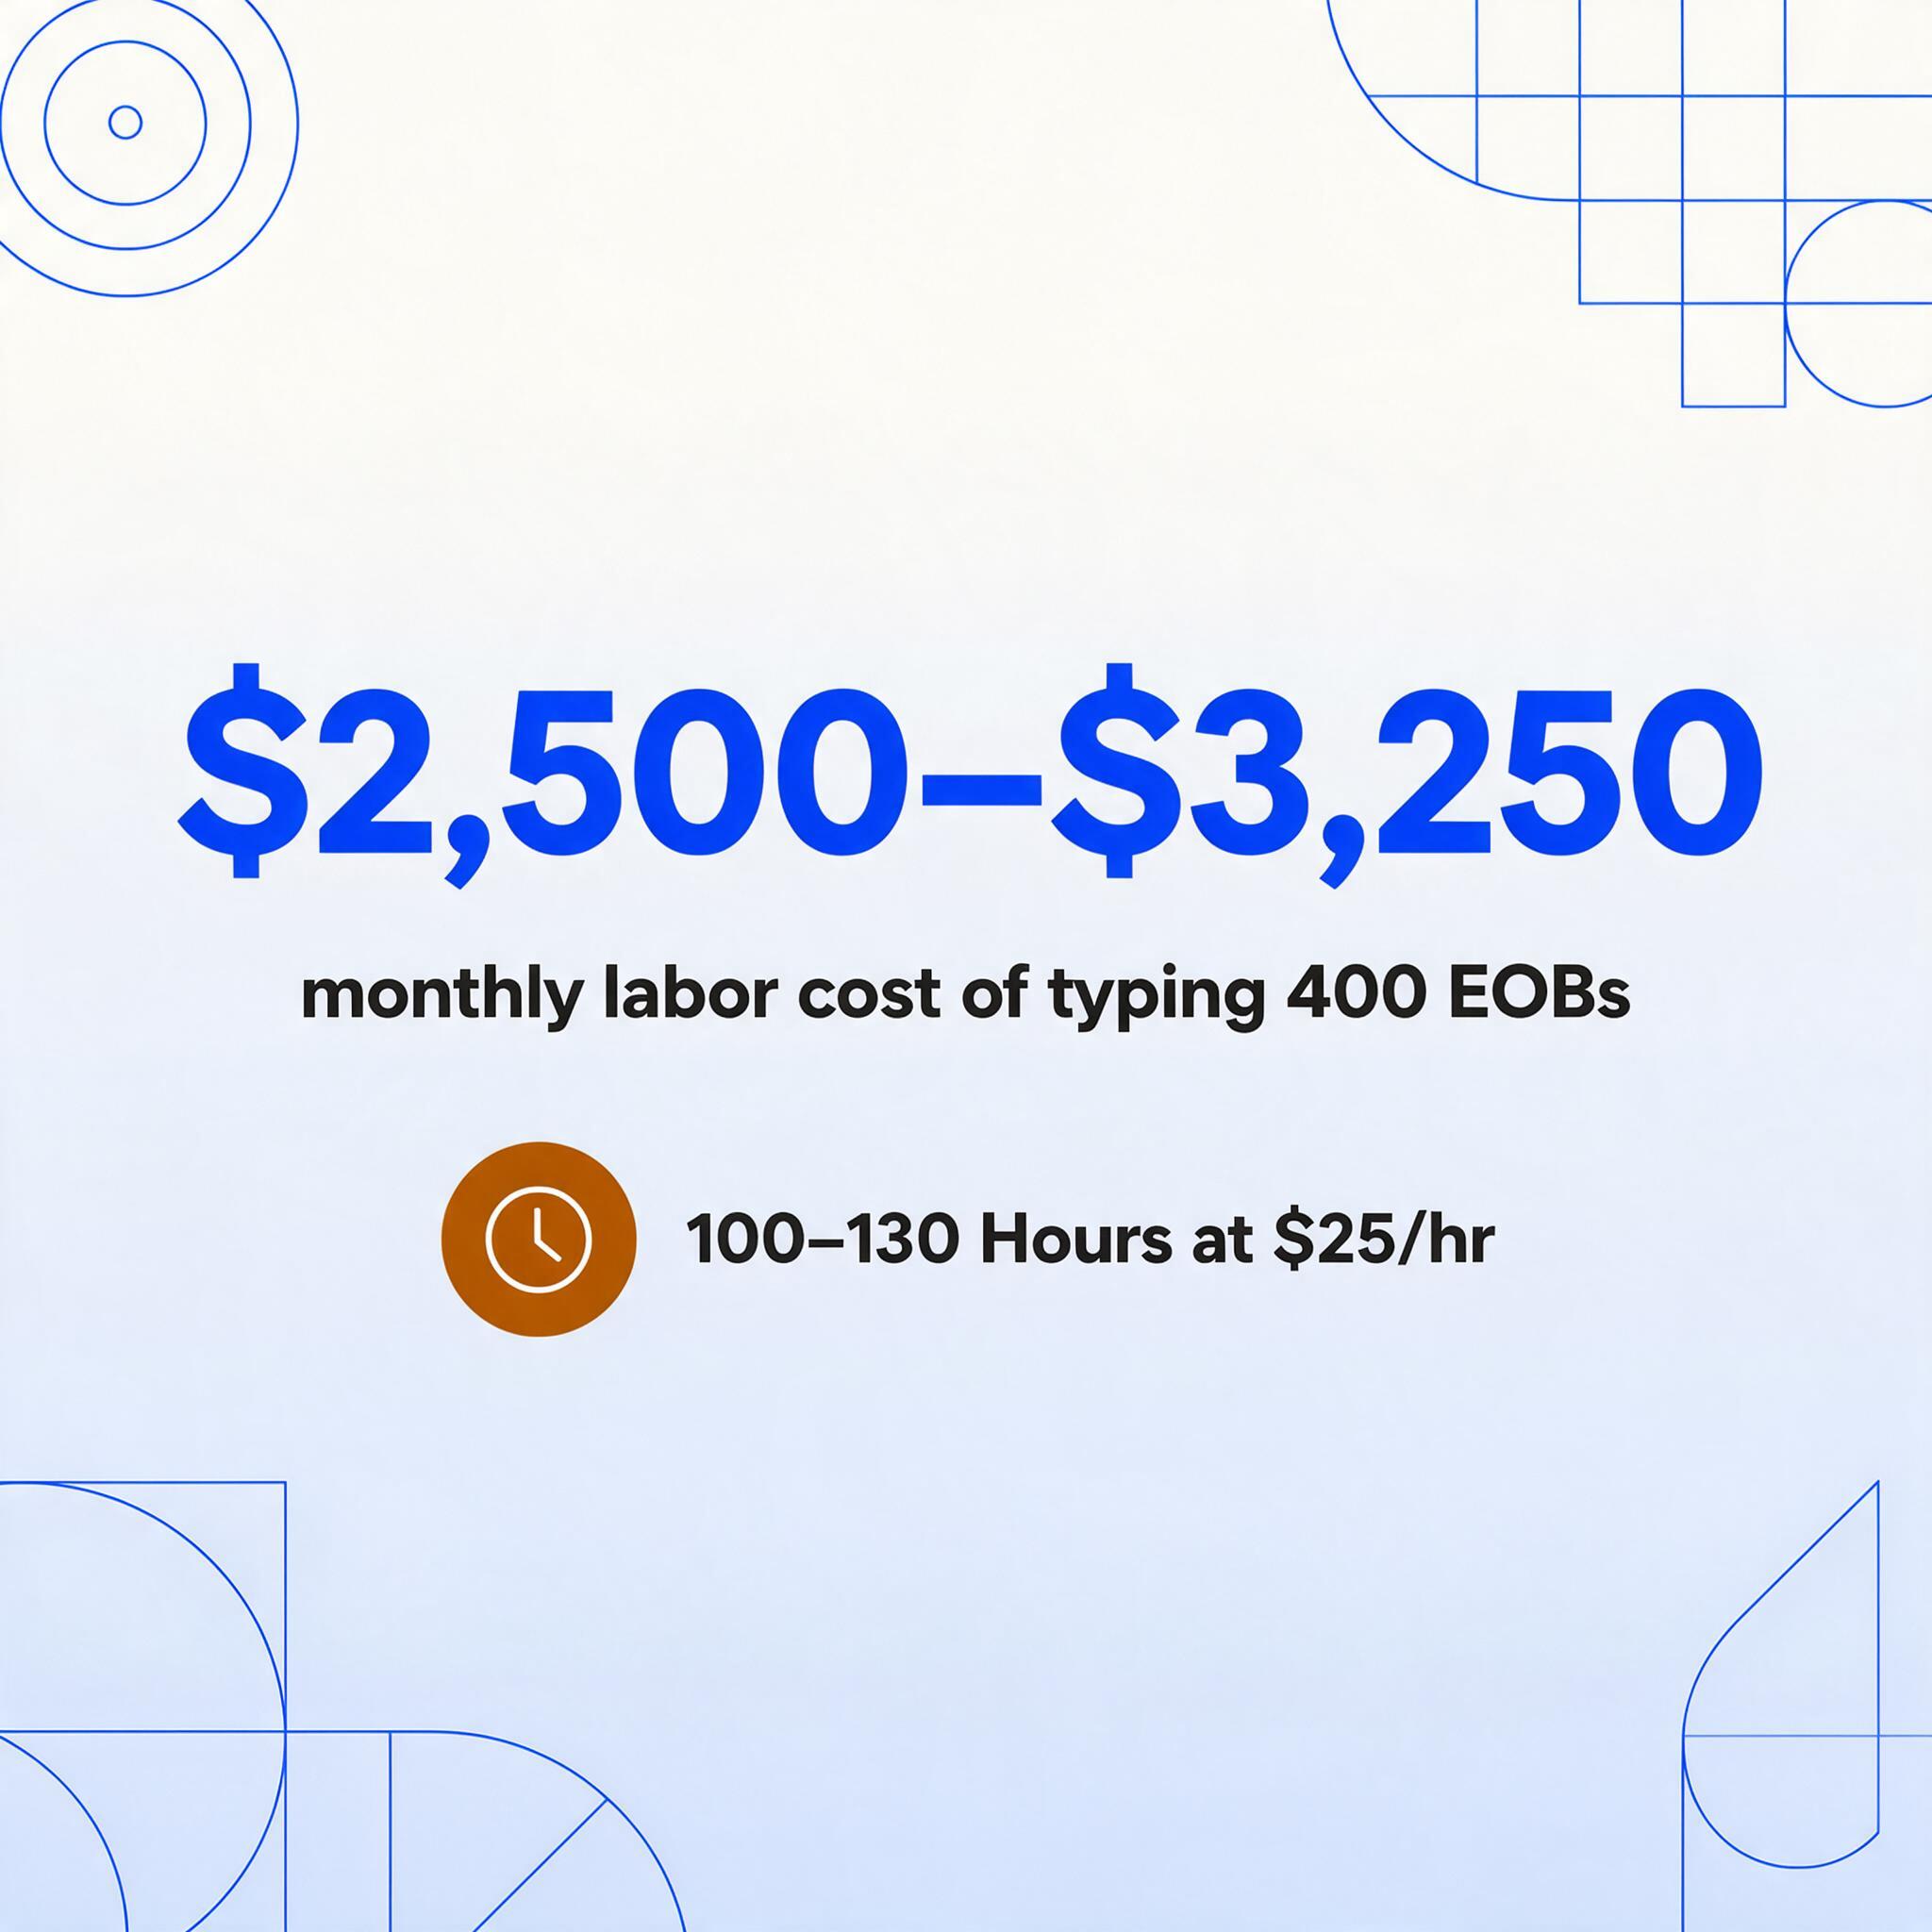
La mano de obra de transcripción. Una práctica de tamaño mediano que procesa 400 EOB por mes dedica aproximadamente de 100 a 130 horas solo a la entrada de datos, asumiendo de 15 a 20 minutos por documento para leer, localizar los campos correctos, escribir y verificar. A $25 por hora, eso es de $2,500 a $3,250 en costo laboral directo cada mes — antes de corregir cualquier error. Ese es el costo visible. El invisible es lo que ese especialista en facturación no está haciendo: apelar denegaciones, dar seguimiento a pagos insuficientes, conciliar discrepancias o analizar tendencias de pagadores. Para un desglose línea por línea del costo total por reclamación — mano de obra, gastos generales de software, retrabajo por errores y pagos insuficientes no recuperados — consulta nuestro análisis de costos de entrada manual de datos de EOB.
El impuesto por errores. La tasa de error del 8–12% que se considera normal en la entrada manual de datos se traduce directamente en reclamaciones rechazadas, pagos mal aplicados y trabajo de conciliación que toma más tiempo que la escritura original. Un solo dígito transpuesto en un monto permitido o un código CPT ingresado incorrectamente puede generar una denegación que toma 30 minutos investigar y apelar. Los datos de la industria sugieren que los errores solo en la entrada de datos de EOB representan aproximadamente una cuarta parte de las denegaciones de reclamaciones prevenibles. Cada reclamación denegada cuesta un promedio de $118 de retrabajo, y ese costo rara vez se rastrea como un costo de procesamiento de EOB — está enterrado en el presupuesto de gestión de denegaciones.
Confusión en la facturación del paciente. Cuando la responsabilidad del paciente se calcula incorrectamente — un deducible aplicado a la línea equivocada, un copago mal interpretado como coseguro — el paciente recibe un estado de cuenta que no coincide con el EOB (Explanation of Benefits). Eso genera llamadas telefónicas, disputas, pagos retrasados y, en los peores casos, quejas ante los reguladores estatales de seguros. El costo de esas llamadas rara vez se mide, pero cualquiera que haya gestionado un mostrador de facturación médica sabe que una sola disputa de facturación puede consumir 45 minutos entre varios miembros del personal.
Retraso en la conciliación de reclamaciones. Cotejar el pago registrado en la reclamación contra el reembolso esperado debería detectar pagos insuficientes. Cuando los datos que alimentan esa conciliación son propensos a errores, la comparación produce falsos positivos (alertas que resultan ser errores de captura de datos, no pagos insuficientes reales) y falsos negativos (pagos insuficientes reales que pasan desapercibidos porque el número extraído coincide por casualidad con la reclamación equivocada). Una encuesta de HFMA (Healthcare Financial Management Association) de 2023 encontró que el 43% de los proveedores experimenta retrasos en los pagos específicamente por errores en el procesamiento manual de EOB.
Estos cuatro costos son aditivos, no alternativas. Una práctica que paga $2,500 al mes en mano de obra de transcripción probablemente también pierde una cantidad equivalente en corrección de errores, disputas de facturación de pacientes y pagos insuficientes no detectados. El costo real del procesamiento manual de EOB es aproximadamente el doble de la partida visible de mano de obra.
El verdadero desafío: más de 6,000 formatos de aseguradoras
La razón por la que el procesamiento manual de EOB es tan propenso a errores no es que quienes lo hacen no estén capacitados. Es que hay más de 6,000 formatos distintos de EOB entre las aseguradoras en Estados Unidos. Cada aseguradora — UnitedHealthcare, Aetna, Cigna, Humana, Blue Cross Blue Shield (cada plan estatal de forma independiente), Medicare, Medicaid, organizaciones de atención administrada, aseguradoras de compensación laboral — organiza los mismos datos de manera diferente.
Algunas aseguradoras presentan el resumen de la reclamación en una tabla horizontal con columnas para fechas, códigos de procedimiento, monto facturado, monto permitido y responsabilidad del paciente. Otras usan un formato vertical apilado donde cada línea de servicio es un bloque de campos etiquetados. Algunas separan el deducible, el coseguro y el copago en subcolumnas distintas; otras condensan todo en una sola línea de «El paciente debe». Algunas incluso cambian de formato dentro de un mismo EOB — usando un formato para reclamaciones pagadas y otro para reclamaciones denegadas en el mismo PDF.
Reconocimiento de códigos CPT e ICD. Los códigos de procedimiento (CPT/HCPCS) y los códigos de diagnóstico (ICD-10) que aparecen en un EOB son los campos más sensibles del documento. Un solo código CPT mal escrito — 99213 escrito como 99214 — significa que la reclamación era para un nivel de servicio diferente. El sistema de facturación registrará el pago incorrecto, la aseguradora puede denegar la diferencia en una auditoría y el proveedor puede tener que reembolsar el sobrepago meses después. Estos códigos están densamente empaquetados, a menudo se presentan juntos sin delimitadores claros y a veces se truncan cuando exceden el ancho del campo en el EOB impreso.
El desglose financiero. Un EOB normalmente muestra el monto facturado (lo que cobró el proveedor), el monto permitido (lo que la aseguradora considera razonable), el monto pagado por el plan y la responsabilidad del paciente — que a su vez es un compuesto del deducible aplicado, el porcentaje de coseguro, el monto del copago y cualquier monto no cubierto. Cada aseguradora divide estos subcomponentes de manera diferente. En un EOB de UnitedHealthcare, el deducible puede aparecer en una columna separada. En un EOB de Blue Cross, puede estar incrustado en una fila de ajuste con un código de observación. El método de extracción debe entender qué subtotal contiene qué componente, no solo localizar los signos de dólar.
Códigos de remesa. Los códigos de razón de ajuste de reclamaciones (CARC) y los códigos de aviso de remesa (RARC) explican por qué se aplicó un ajuste o se denegó una reclamación; por ejemplo, CO-45 (obligación contractual: el cargo supera la tarifa pactada) o PR-1 (responsabilidad del paciente: monto del deducible). Hay cientos de códigos activos mantenidos por la organización de estándares X12, y los pagadores los aplican de forma inconsistente. Un código en el EOB (explicación de beneficios) de un pagador puede aparecer en texto plano en el de otro. Extraer estos códigos con precisión requiere leerlos por contexto, no por posición.
Estas cuatro capas de complejidad —variabilidad del diseño, densidad de códigos médicos, cálculos financieros y códigos de ajuste— son lo que hace que la extracción de EOB sea un problema fundamentalmente distinto a extraer una factura estándar. Y son la razón por la que las herramientas OCR tradicionales basadas en plantillas, que dependen de posiciones fijas de campos, fallan con los EOB.
Procesamiento tradicional vs. extracción con IA
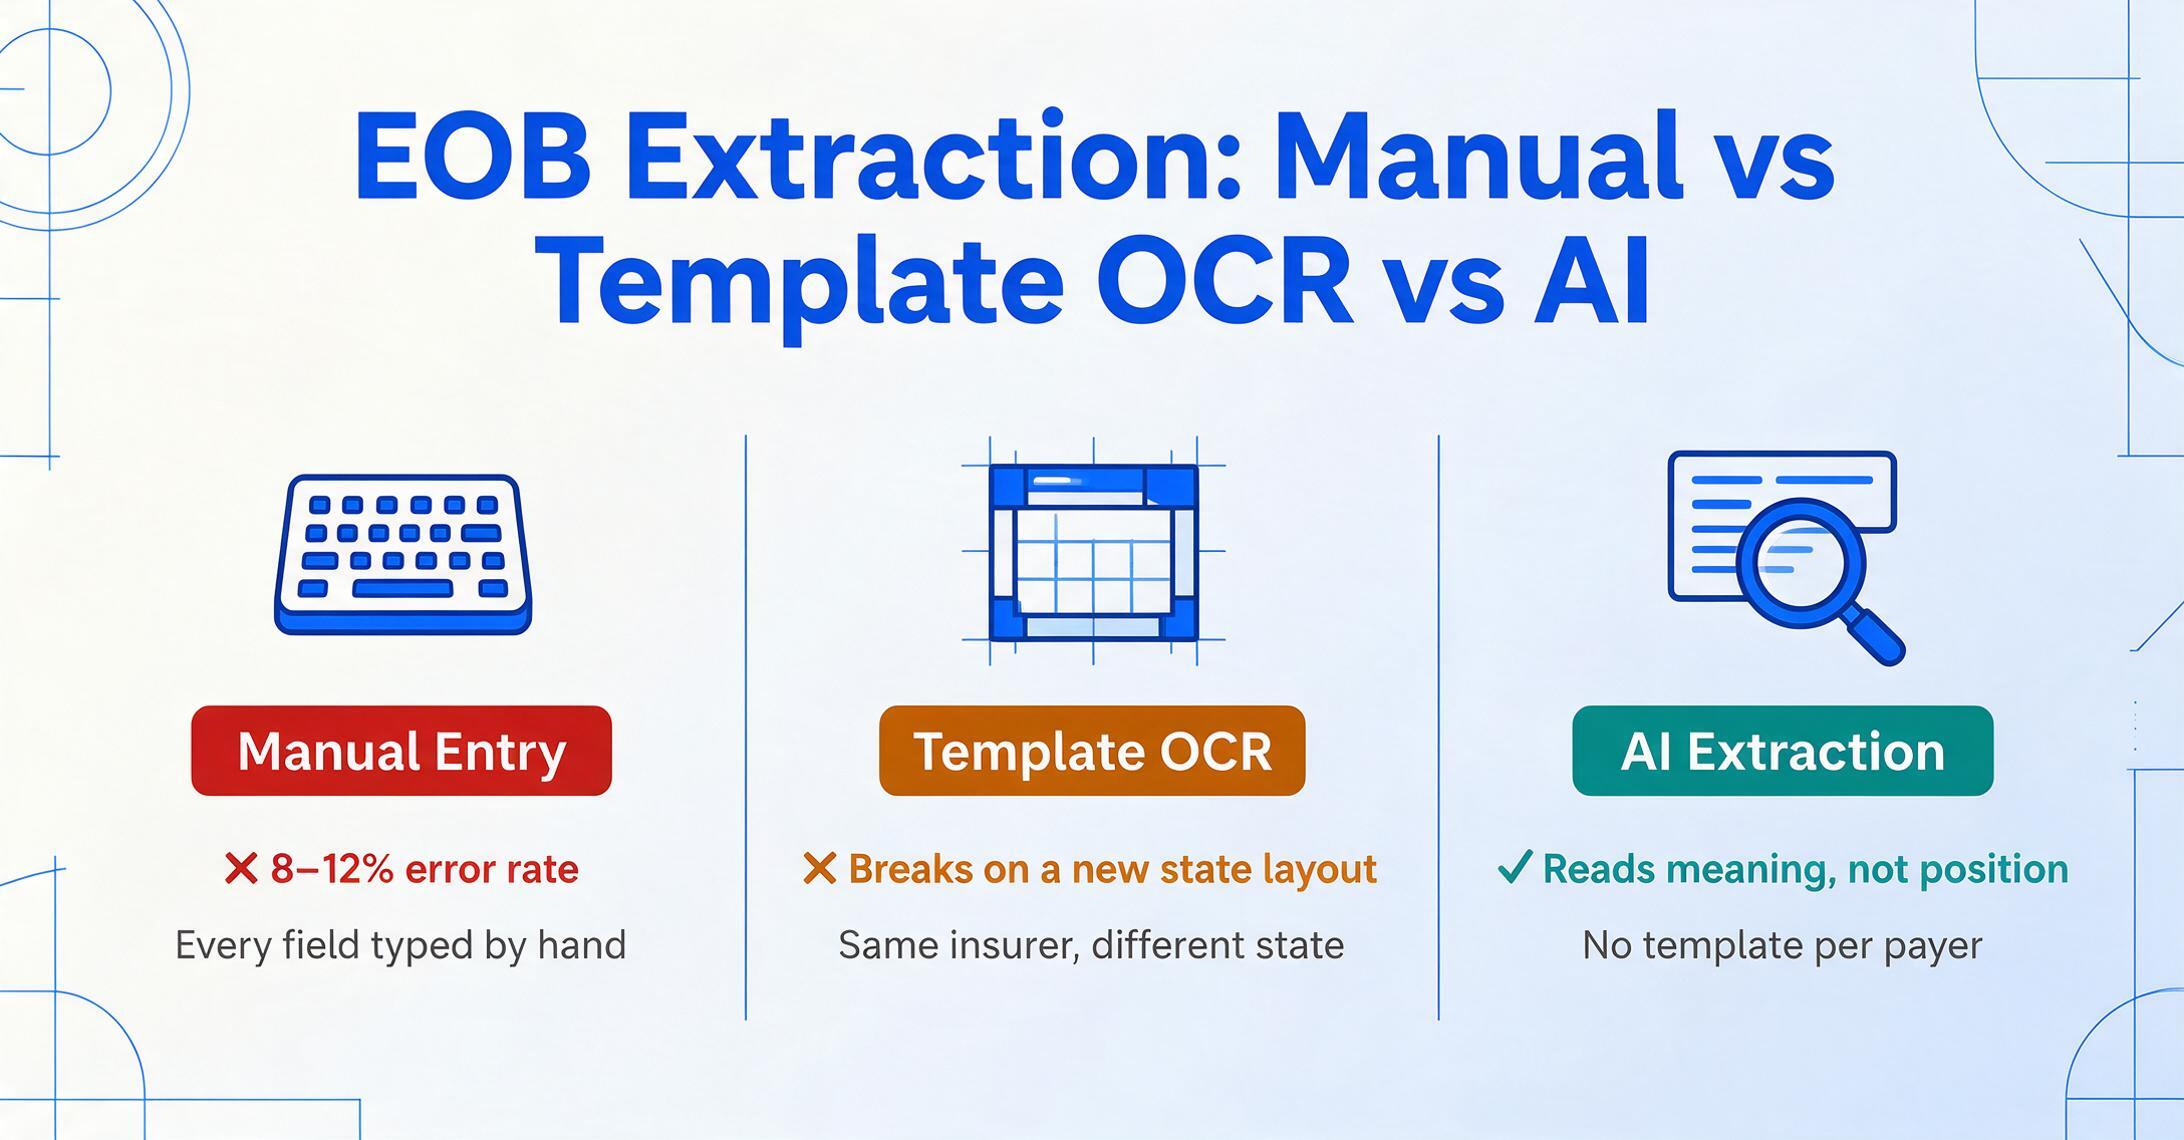
El enfoque convencional para el procesamiento de EOB tiene dos variantes: entrada manual de datos y OCR basado en plantillas. Ambas comparten la misma limitación fundamental: tratan el EOB como un documento con un diseño predecible, que no lo es.
El OCR basado en plantillas funciona bien cuando llega siempre el mismo formulario: el campo de «Monto permitido» está siempre en la misma columna de la misma página, y el software puede configurarse para buscar exactamente ahí. Los EOB violan esa suposición. Una plantilla configurada para un EOB de Blue Cross de Florida fallará con un EOB de Blue Cross de Illinois: misma aseguradora, diferente estado, diferente diseño.
La extracción con IA, en cambio, lee el documento comprendiendo qué significa cada dato, no dónde se encuentra. La tecnología detrás de esto es un VLM (modelo de visión y lenguaje), la misma clase de modelo que puede mirar una fotografía y describir lo que ocurre en ella. Al aplicarse a un EOB, el modelo ve el documento como un todo, identifica los encabezados de sección («Responsabilidad del paciente», «Monto pagado», «Descripción del servicio») y localiza los valores correspondientes por su relación semántica con esos encabezados, no por sus coordenadas de píxeles.
Esta es la diferencia clave. Un enfoque basado en plantillas pregunta «¿Dónde está el deducible?» y lo busca en una coordenada fija. Un enfoque basado en IA pregunta «¿Cuál es el deducible para esta línea de servicio?» y lee el documento hasta encontrar la respuesta.
| Dimensión | Ingreso manual | OCR basado en plantillas | Extracción con IA |
|---|---|---|---|
| Cobertura de formatos de pagador | Humano lee cualquier formato | Solo plantillas preconfiguradas | Cualquier formato, primera carga |
| Configuración por pagador | Ninguna (humano lee visualmente) | Creación de plantilla + pruebas por diseño | Ninguna — configuración cero |
| Tiempo de procesamiento por EOB | 15–20 minutos | 2–5 minutos | 5–10 segundos |
| Tasa de error típica | 8–12% | 5–8% (falla con cambios de formato) | Menos del 2% |
| Extracción de códigos CPT/ICD | Propenso a errores tipográficos | Depende de la zona correcta | Lectura contextual |
| Lote multipagador | Secuencial — uno a la vez | Solo EOB del mismo diseño | Pagadores mixtos en un lote |
| Resistencia a cambios de formato | N/A (humano se adapta) | Falla hasta actualizar plantilla | Maneja nuevos diseños automáticamente |
El resultado no es solo un procesamiento más rápido. Es un flujo de trabajo fundamentalmente diferente: en lugar de que un especialista en facturación abra cada EOB, lo lea y escriba valores en un sistema, la IA lee todo el lote y el especialista revisa solo las excepciones — discrepancias marcadas, códigos inusuales o montos fuera de los rangos esperados.
El cambio no es la velocidad. El cambio es la asignación de atención. Un equipo de facturación que dedica 100 horas a la entrada de datos casi no tiene tiempo para análisis de denegaciones o negociación con pagadores. Un equipo cuya entrada de datos es manejada por IA recupera esas 100 horas para el trabajo que realmente mejora el rendimiento del ciclo de ingresos.
Pruébalo tú mismo: sube un EOB y ve los resultados
La siguiente demo integrada te permite subir un documento EOB — un PDF, una imagen escaneada o incluso una foto tomada con tu teléfono — y ver qué produce la extracción impulsada por IA en segundos. Sin registro, sin configuración, sin creación de plantillas.
Los archivos se procesan de forma segura y no se almacenan después de la extracción.
Campos críticos en cada EOB
Aunque cada aseguradora formatea estos campos de manera diferente, los datos que un equipo de facturación necesita de un EOB son notablemente consistentes en todas las aseguradoras. El desafío no es saber qué extraer — es configurar el método de extracción para localizar cada campo correctamente a partir de un diseño que nunca ha visto antes.
| Campo | Por qué es importante | Etiquetas comunes de la aseguradora |
|---|---|---|
| ID del Paciente/Afiliado | Vincula el EOB con el registro y reclamo correctos del paciente | ID del Afiliado, ID del Suscriptor, ID del Paciente, ID# |
| Nombre del Paciente | Verificación de la identidad del paciente | Nombre del Paciente, Nombre del Afiliado, Suscriptor |
| Nombre del Proveedor / NPI | Asegura que el pago se acredite al proveedor correcto | Proveedor, Proveedor Tratante, Proveedor Facturador, NPI |
| Fecha del Servicio | Determina el período de beneficios y los términos del contrato aplicables | FDS, Fecha del Servicio, Desde–Hasta, Fecha del Servicio |
| Código CPT / HCPCS | Identifica el procedimiento específico realizado — el campo más propenso a errores | CPT, Código de Procedimiento, Código, HCPCS, Código de Servicio |
| Código de Diagnóstico ICD-10 | Justificación de necesidad médica — códigos incorrectos generan denegaciones | Código de Diagnóstico, ICD-10, DX, Diagnóstico Principal |
| Monto Facturado | Lo que cobró el proveedor — se usa para calcular ajustes contractuales | Facturado, Cargos, Monto Presentado, Monto Facturado |
| Monto Permitido | La tarifa negociada del pagador — base para todos los cálculos de pago posteriores | Permitido, Monto Cubierto, Aprobado, Asignación del Plan |
| Pago del Plan | Lo que realmente pagó el asegurador — el monto que debe coincidir con el cheque o la transferencia | Pagado por el Plan, Pago del Seguro, Pagado por el Plan, Monto del Cheque |
| Deducible Aplicado | Parte del monto permitido aplicada al deducible anual del paciente | Deducible, Aplicado al Deducible, Deducible del Paciente |
| Coseguro | Porcentaje del monto permitido que paga el paciente después del deducible | Coseguro, Coseguro del Paciente, % de Coseguro |
| Copago | Tarifa fija del paciente por servicio (a menudo aparece separada del coseguro) | Copago, Co-Pago, Copago de Consulta, Copago de Receta |
| Responsabilidad del Paciente (Total) | Suma del deducible + coseguro + copago + montos no cubiertos — lo que se factura al paciente | Deuda del Paciente, Responsabilidad del Paciente, Monto que Usted Debe, Total Paciente |
| Monto de Ajuste / Denegación | Reducciones aplicadas por el pagador — contractuales o no cubiertas | Ajuste, Monto Denegado, Descuento, No Cubierto |
| Códigos CARC / RARC | Explican por qué se aplicó un ajuste o denegación — crítico para apelaciones | Código de Razón de Ajuste, Código de Observación, Observación, CARC, RARC |
| Número de Reclamación / ICN | Identificador único de la reclamación — vincula el EOB con la presentación 837 original | N.º de Reclamación, ICN, Número de Control Interno, ID de Reclamación |
Con una herramienta de extracción basada en IA que admite Extracción de Columnas Personalizadas, escribes los nombres de los campos que necesitas — "Nombre del paciente", "Código CPT", "Monto facturado", "Responsabilidad del paciente" — y la IA localiza cada valor por su significado semántico en el diseño de cualquier aseguradora. Tú defines la salida; la IA lee el documento. Para un recorrido paso a paso sobre cómo configurar estas columnas y ejecutar tu primera extracción, consulta nuestra guía práctica para la extracción de EOB por lotes.
De EOB por Lote a Resumen de Facturación del Paciente
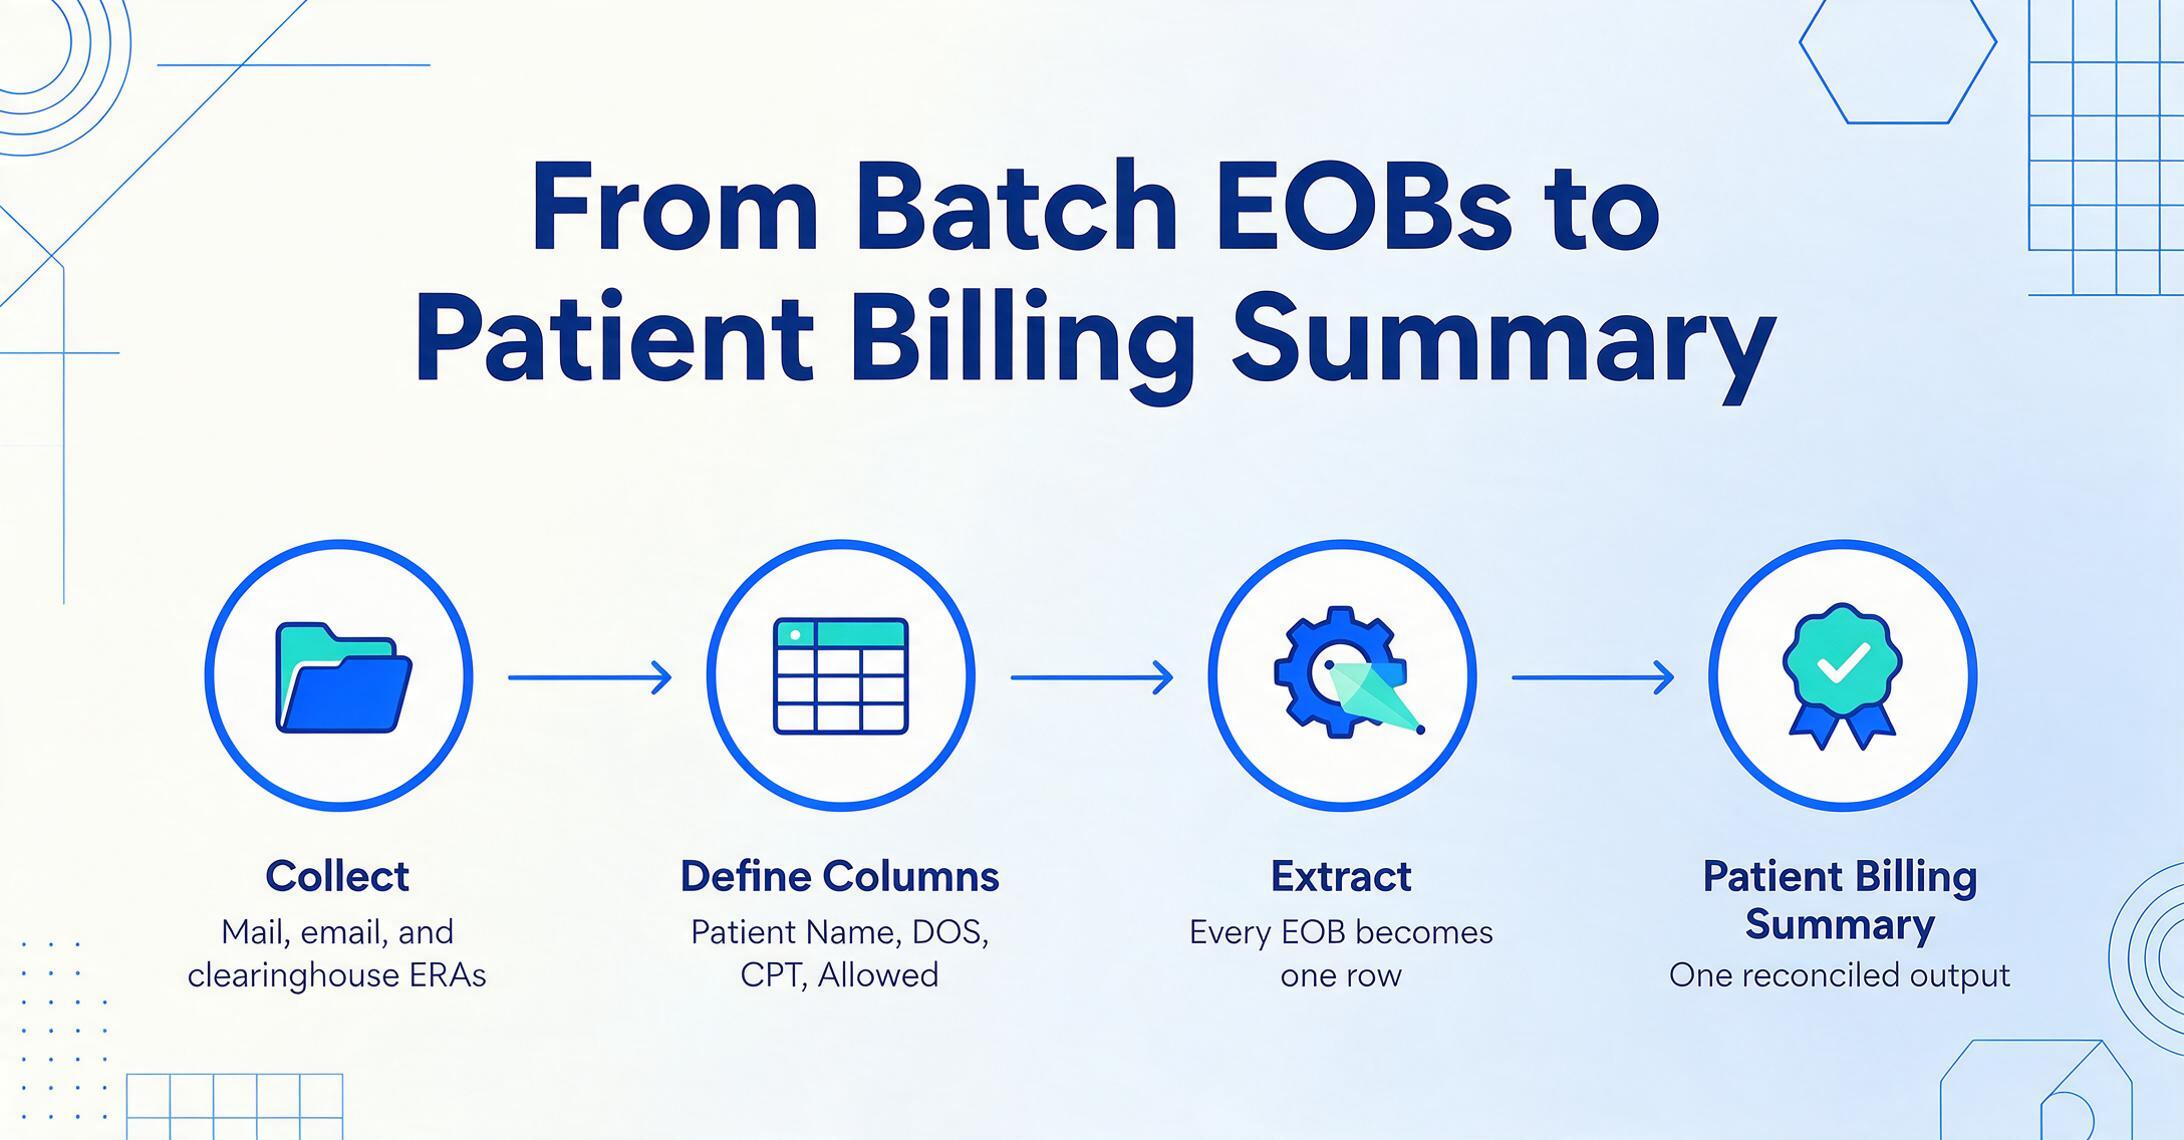
El verdadero poder de la extracción automatizada de EOB (Explanation of Benefits) no es procesar un documento más rápido, sino procesar un lote de documentos de diferentes aseguradoras como un solo grupo y producir una salida consolidada que agrupe todos los datos en un resumen de facturación del paciente.
Así es como un equipo típico de facturación médica pasa de una pila de EOB a un resumen de facturación del paciente conciliado mediante extracción por IA por lotes:
Recopila los EOB (Explanation of Benefits) de cada aseguradora.
Algunos llegan por correo como documentos en papel. Otros llegan como archivos PDF adjuntos al correo electrónico. Algunas consultas usan una cámara de compensación que envía ERA (aviso electrónico de remesa en formato X12 835) para algunas aseguradoras, pero recibe PDF de EOB de otras. Cada PDF o escaneo va a una sola carpeta, sin importar qué aseguradora lo emitió ni el diseño.
Sube el lote y define las columnas de salida.
Sube el lote completo: puede contener EOB de Blue Cross, Aetna, UnitedHealthcare, Medicare y Cigna mezclados. Define los nombres de tus columnas: «Patient Name», «Member ID», «DOS», «CPT Code», «Billed», «Allowed», «Plan Paid», «Deductible», «Coinsurance», «Copay», «Patient Responsibility». La IA lee cada documento y asigna estos campos mediante comprensión semántica, no mediante coincidencia de plantillas.
La IA procesa cada EOB en segundos por página.
La extracción procesa el lote de forma secuencial o en paralelo según la herramienta. Cada EOB genera una fila en la tabla de salida. Como la IA lee por contexto, un EOB de Blue Cross y un aviso de remesa de Medicare en el mismo lote producen datos en la misma estructura de columnas, sin necesidad de configuración por aseguradora.
Revisa y concilia las excepciones marcadas.
El equipo de facturación revisa solo los elementos que la IA marca: montos fuera de los rangos esperados, responsabilidad del paciente que no coincide con el cálculo esperado, códigos de ajuste que sugieren una denegación. Todo lo demás ya está registrado en la salida. La revisión que solía tomar 15–20 minutos por EOB ahora toma unos minutos para todo el lote.
Genera el resumen de facturación al paciente.
La salida consolidada —una fila por línea de servicio, con la responsabilidad del paciente desglosada en deducible, coseguro, copago y total adeudado— se convierte en la fuente de verdad para los estados de cuenta del paciente. Con las columnas calculadas, incluso puedes definir cálculos adicionales directamente en la extracción: por ejemplo, una columna que calcule «Remaining Balance = Patient Responsibility — Payments Received» sin salir de la herramienta de extracción. Para profundizar en los flujos de trabajo por lotes con múltiples aseguradoras, consulta nuestro artículo sobre cómo los equipos de facturación médica extraen datos por lotes de cientos de EOB.
Para las consultas que necesitan recopilar EOB de múltiples proveedores o ubicaciones sin dar acceso a la cuenta principal a todos, ImageToTable.ai ofrece la función Enlace de Recopilación: genera una URL compartible, envíala a proveedores o personal de campo, y ellos pueden subir EOB directamente a tu cola de procesamiento, sin necesidad de registro.
Exportación e Integración
Los datos extraídos de los EOB (Explanation of Benefits) solo son útiles si llegan al sistema donde ocurren la facturación y la conciliación. Diferentes prácticas tienen diferentes necesidades posteriores, y la herramienta de extracción adecuada debería admitir los destinos más comunes.
Excel o Google Sheets. Este es el destino más común para prácticas pequeñas y medianas. Un solo lote de extracción produce una hoja de cálculo estructurada con todos los campos críticos — nombre del paciente, códigos CPT, montos facturados, montos permitidos, pagos del plan, desglose de responsabilidad del paciente — en columnas etiquetadas. La hoja de cálculo está lista para importar al sistema de gestión de la práctica o para usarse como libro de conciliación. Para equipos que usan Google Sheets, el complemento de ImageToTable.ai para Google Sheets envía los datos extraídos directamente a la hoja de cálculo activa sin salir de Sheets.
Sistemas de gestión de prácticas y EHR. Las prácticas que usan Epic, Cerner, Meditech, AdvancedMD, Kareo, NextGen, athenahealth o eClinicalWorks generalmente exportan los datos estructurados y los mapean en el módulo de publicación de pagos de su sistema. El requisito clave es que los datos exportados contengan los mismos campos en un esquema consistente — los encabezados de columna no cambian entre lotes, y las variaciones específicas del pagador se normalizan para que la importación posterior vea una estructura de datos uniforme sin importar qué pagador emitió el EOB.
Facturación del portal del paciente. Una vez que se calcula y verifica la responsabilidad del paciente, el monto visible para el paciente se envía al portal del paciente o al sistema de estados de cuenta. Una responsabilidad precisa del paciente — la división correcta entre deducible, coseguro y copago — es esencial aquí porque un estado de cuenta que no coincida con el EOB genera llamadas telefónicas y disputas.
Cómo Elegir una Herramienta de Extracción de EOB
No todas las herramientas de extracción de documentos son adecuadas para EOB. Las características específicas de estos documentos — variabilidad de formato entre pagadores, codificación médica densa, campos financieros de múltiples componentes — reducen significativamente el campo. Aquí están los criterios que más importan al evaluar una solución de extracción de EOB.
Precisión multi-pagador desde el primer uso. La prueba más importante es simple: sube un EOB de Blue Cross, un EOB de Aetna, un aviso de remesa de Medicare y un EOB de Cigna en un solo lote y observa si la misma configuración de extracción produce datos precisos para los cuatro. Si la herramienta requiere una plantilla separada por pagador o necesita ser entrenada con documentos de muestra para cada formato, el beneficio de la extracción se reduce significativamente. El enfoque sin plantilla de ImageToTable.ai significa que no hay configuración por pagador — la IA lee cada documento entendiendo qué significa cada campo, sin importar dónde aparezca en la página.
Precisión de reconocimiento de códigos CPT/ICD. Los códigos de procedimiento y diagnóstico son los campos más sensibles a errores en un EOB. Busca una herramienta que demuestre la capacidad de leer códigos densamente empaquetados — incluidos códigos que se ejecutan juntos sin separación visual clara, códigos truncados que continúan en una segunda línea y códigos incrustados en encabezados de sección en lugar de en una columna dedicada.
Soporte para el cálculo de responsabilidad del paciente. Las mejores herramientas de extracción no solo escupen campos individuales y te dejan las matemáticas a ti. La función de columna calculada de ImageToTable.ai te permite definir el cálculo de responsabilidad del paciente como parte de la extracción: especifica "Total del Paciente = Deducible + Coseguro + Copago + No Cubierto" como una columna calculada, y la IA lo calcula para cada fila durante la extracción. Esto elimina un paso de verificación manual que en sí mismo es propenso a errores.
Consideraciones de cumplimiento de HIPAA. Los EOB (Explanation of Benefits) contienen información de salud protegida (PHI, por sus siglas en inglés) — nombres de pacientes, identificadores de miembros, códigos de diagnóstico y otros identificadores que están sujetos a las Reglas de Privacidad y Seguridad de HIPAA. Cualquier herramienta que procese datos de EOB debe ofrecer salvaguardas adecuadas. Al evaluar una herramienta, confirma que admita transmisión segura de datos (cifrado AES-256 en tránsito y en reposo), eliminación automática de datos después del procesamiento y un Acuerdo de Asociado Comercial (BAA, por sus siglas en inglés) si la PHI se almacenará o transmitirá a través de la infraestructura del proveedor. Esta es una descripción del contexto de cumplimiento, no asesoría legal. Consulta al oficial de cumplimiento o al asesor legal de tu organización para conocer las obligaciones específicas de HIPAA.
Procesamiento por lotes y manejo de formatos mixtos. Si tu consultorio procesa EOB de más de tres o cuatro aseguradoras — y la mayoría lo hace — la herramienta debe manejar lotes de formatos mixtos. La capacidad de arrastrar una carpeta de PDF de diez aseguradoras diferentes a una sola carga y obtener una sola hoja de cálculo de vuelta es la diferencia entre una herramienta que ahorra tiempo y una que crea más trabajo.
Para una comparación más amplia de herramientas de extracción de documentos en casos de uso de atención médica, consulta nuestro resumen de las mejores herramientas de extracción de documentos para atención médica en 2026.
Preguntas Frecuentes Sobre la Extracción de Datos de EOB
¿Puede la IA extraer datos de EOB que incluyen múltiples pacientes en un solo documento?
Sí. Los EOB con múltiples pacientes — donde un solo documento lista reclamaciones para varios pacientes agrupados por la aseguradora — son una fuente común de errores de extracción manual. La extracción basada en IA lee el documento como un todo e identifica qué líneas de servicio pertenecen a qué paciente mediante la relación contextual entre los identificadores del paciente y los detalles del procedimiento, separándolos en filas de salida distintas. Esto es significativamente más confiable que la clasificación manual, que es propensa a una asignación incorrecta.
¿Es necesario entrenar la herramienta con el formato de EOB de cada aseguradora antes de que funcione?
No. ImageToTable.ai extrae datos de los EOB (Explanation of Benefits) mediante comprensión semántica, no mediante coincidencia de plantillas. El primer EOB de cualquier aseguradora — ya sea una gran aseguradora nacional como UnitedHealthcare o un plan regional pequeño — se procesa con la misma configuración. No hay fase de entrenamiento, ni recopilación de muestras, ni creación de plantillas por aseguradora.
¿Qué ocurre si una aseguradora cambia el diseño de su EOB?
La extracción sigue funcionando. Como la IA lee los datos por significado y no por posición, un cambio de diseño — columnas reordenadas, encabezados de sección movidos, cabeceras rediseñadas — no interrumpe la extracción. Esta es una ventaja fundamental frente a las herramientas OCR basadas en plantillas, que requieren reconfiguración cada vez que una aseguradora modifica su formulario.
¿Puede la herramienta extraer EOB escaneados de copias en papel?
Sí. La IA procesa imágenes escaneadas y fotos de EOB impresos, no solo PDF digitales. Los escenarios comunes incluyen EOB en papel recibidos por correo de aseguradoras más pequeñas, copias enviadas por fax desde proveedores remitentes y EOB fotografiados que los pacientes presentan para reembolso. La precisión de la extracción depende de la calidad de la imagen — los escaneos nítidos a 200 DPI o más producen los mejores resultados — pero el VLM (modelo de visión y lenguaje) está diseñado para manejar la degradación típica de los documentos escaneados.
¿Cómo maneja la herramienta los códigos de observación CARC y RARC en los EOB?
La IA lee los códigos de motivo de ajuste y los códigos de observación del EOB y los genera como campos extraídos. Como algunas aseguradoras incorporan estos códigos en texto plano mientras que otras usan valores numéricos, la extracción captura tanto el código como cualquier texto explicativo adjunto cuando esté disponible. El resultado puede usarse luego para categorizar denegaciones y ajustes para informes y seguimiento de apelaciones.
¿La herramienta cumple con HIPAA?
ImageToTable.ai procesa documentos con cifrado en tránsito (TLS) y en reposo (AES-256). Los archivos subidos por usuarios anónimos se eliminan automáticamente después del procesamiento, y los archivos de usuarios registrados se conservan solo durante el período de retención del plan y luego se eliminan permanentemente. Hay disponible un Acuerdo de Asociado Comercial (BAA) para los proveedores que necesitan documentar el cumplimiento de HIPAA en sus flujos de trabajo de extracción de documentos. Como con cualquier herramienta de procesamiento de datos de atención médica, debes revisar la documentación específica de seguridad y cumplimiento según las políticas de tu organización y consultar con tu oficial de cumplimiento.
¿Cuál es la diferencia entre extraer un EOB y un ERA?
ERA (Electronic Remittance Advice) es la transacción electrónica estándar de HIPAA (ASC X12 835) que contiene la misma información de pago de reclamos que un EOB, pero en un formato legible por máquina. Los ERA se pueden publicar automáticamente en los sistemas de gestión de práctica con una intervención manual mínima. Los EOB suelen ser documentos en papel o PDF destinados a la explicación para el paciente o el proveedor. La extracción es la forma de hacer que los EOB en PDF se comporten como los ERA: convirtiendo sus datos visuales en resultados estructurados y legibles por máquina. La mayoría de las prácticas reciben una combinación de ERA de los principales pagadores y EOB en PDF de otros, por lo que un flujo de trabajo completo del ciclo de ingresos debe manejar ambos.
¿Cuántos EOB por mes hacen que la extracción automatizada valga la pena?
Para prácticas que procesan más de 200 EOB por mes, el ahorro de mano de obra de la extracción automatizada generalmente cubre el costo de la herramienta en el primer mes. Por debajo de ese umbral, los ahorros son menores, pero el tiempo ahorrado aún puede ser significativo para un equipo de facturación pequeño: 200 EOB a 15 minutos cada uno son 50 horas de entrada de datos por mes que podrían redirigirse a un trabajo más valioso.
¿La herramienta se integra con Epic, AdvancedMD o Kareo?
ImageToTable.ai exporta datos en formato Excel que se pueden importar a cualquier sistema de gestión de práctica o EHR que acepte datos de pago estructurados. La integración directa con API está disponible para equipos que necesitan publicación automatizada. Para un flujo de trabajo completo sin código, el complemento de Google Sheets permite que los resultados de extracción lleguen directamente a una hoja de cálculo que alimenta tu sistema de facturación.
¿Puede la herramienta extraer EOBs de aseguradoras de compensación laboral?
Sí. Los EOBs de compensación laboral utilizan un conjunto diferente de reglas de facturación y, a menudo, incluyen ajustes de la tabla de tarifas médicas específicos para el sistema de compensación laboral de cada estado. La IA lee estos EOBs de la misma manera que lee los documentos de pagadores comerciales: comprendiendo los campos semánticamente. La misma configuración de extracción que maneja un EOB de UnitedHealthcare también procesa un EOB de compensación laboral de una aseguradora específica del estado.
El Siguiente Paso: De Manual a Estructurado
La aritmética del procesamiento de EOBs es sencilla, pero es fácil de ignorar porque los costos se distribuyen en múltiples partidas presupuestarias (mano de obra, corrección de errores, gestión de disputas de pacientes y conciliación), ninguna de las cuales es lo suficientemente grande por sí sola como para provocar un cambio de proceso. En conjunto, representan una pérdida significativa para el rendimiento del ciclo de ingresos.
El cambio de la captura manual a la extracción impulsada por IA no requiere reemplazar toda la plataforma del ciclo de ingresos, un nuevo sistema de historia clínica electrónica (EHR) ni la participación de TI. Comienza con un lote: sube los EOBs que procesaste ayer, define las columnas que desearías tener y observa si el resultado coincide con lo que tu equipo escribió. Si el resultado es más limpio y rápido, el caso se escala desde ahí.
Esa brecha entre lo que dice el EOB y lo que ingresa en tu sistema de facturación —la tasa de error del 35% de la encuesta de HFMA— no es un problema de personas. Es un problema de proceso con una solución técnica directa.