Der vollständige Leitfaden zur
EOB-Datenextraktion (2026)
Die Umfrage der HFMA (Healthcare Financial Management Association) aus dem Jahr 2023 ergab, dass 35 % der Gesundheitsorganisationen Fehler bei der manuellen EOB-Dateneingabe melden und 43 % dadurch direkte Zahlungsverzögerungen erleben. Diese Zahlen beschreiben die Kluft zwischen dem, was eine Leistungsübersicht (EOB, Explanation of Benefits) aussagt, und dem, was tatsächlich in ein Abrechnungssystem eingegeben wird – eine Kluft, die nicht besteht, weil das Personal nachlässig ist, sondern weil die Branche von den Mitarbeitern etwas grundlegend Unnatürliches mit diesen Dokumenten verlangt: jedes Payer-Layout so zu behandeln, als wäre es gleich, obwohl keine zwei identisch sind.
Wichtige Erkenntnisse
- 35 % der Anbieter melden Fehler bei der EOB-Dateneingabe – nicht weil Ihr Abrechnungsteam nachlässig ist, sondern weil kein Mensch dasselbe Datenfeld über 6.000 verschiedene Payer-Layouts hinweg fehlerfrei lesen kann.
- Die 2.500 $ pro Monat, die Sie an Transkriptionsarbeit sehen, verdoppeln sich, wenn Sie Fehlerkorrekturen, Streitigkeiten mit Patienten über Rechnungen und übersehene Unterzahlungen hinzurechnen, die in separaten Budgetposten versteckt sind – Kosten, die kein einziger Bericht je zusammenfasst.
- Die Kennzahl, die zählt, sind nicht Minuten pro EOB – es geht darum, 100 Stunden pro Monat zurückzugewinnen, damit Ihr Abrechnungsteam aufhören kann, Zahlen zu tippen, und stattdessen die Unterzahlungen und Ablehnungen verfolgen kann, die den Umsatz tatsächlich bewegen.
Was ist EOB-Datenextraktion?
EOB-Datenextraktion ist der automatisierte Prozess, bei dem wichtige Versicherungsanspruchsfelder aus einem EOB-Dokument (Explanation of Benefits) gelesen werden – Patientenname, Leistungserbringer, Leistungsdaten, CPT-Verfahrenscodes, abgerechnete Beträge, zugelassene Beträge, Versicherungszahlungen, Anpassungen, Aufschlüsselung der Patientenzahlungspflicht sowie Ablehnungs- oder Hinweiscodes – und in strukturierte Daten umgewandelt werden, die ein Abrechnungssystem oder eine Tabellenkalkulation verarbeiten kann.
Das Dokument selbst, die Leistungsübersicht (Explanation of Benefits), wird von einer Krankenversicherung nach der Bearbeitung eines Anspruchs versendet. Es ist keine Rechnung. Es ist eine Abrechnung darüber, was der Leistungserbringer in Rechnung gestellt hat, was die Versicherung im Rahmen des Plans zugelassen hat, was an den Leistungserbringer oder Patienten gezahlt wurde und was der Patient noch schuldet. Für eine tiefergehende Einführung in das Konzept lesen Sie unseren ausführlichen Artikel darüber, was EOB-Datenextraktion ist und wie sie funktioniert.
Was die EOB-Extraktion von anderen Dokumentextraktionsaufgaben unterscheidet, ist die Beziehung zwischen den Datenfeldern. Der Wert einer EOB liegt nicht in einer einzelnen Zahl – er liegt darin, wie abgerechneter Betrag, zugelassener Betrag, Planzahlung, Selbstbehalt, Zuzahlung, Kostenbeteiligung und Patientenzahlungspflicht zusammenpassen. Diese Zahlen korrekt zu extrahieren, aber die Arithmetik zu verlieren, die sie verbindet, ergibt eine technisch korrekte, aber praktisch nutzlose Ausgabe für den Abrechnungsabgleich.
Warum manuelle EOB-Verarbeitung mehr kostet, als Sie denken
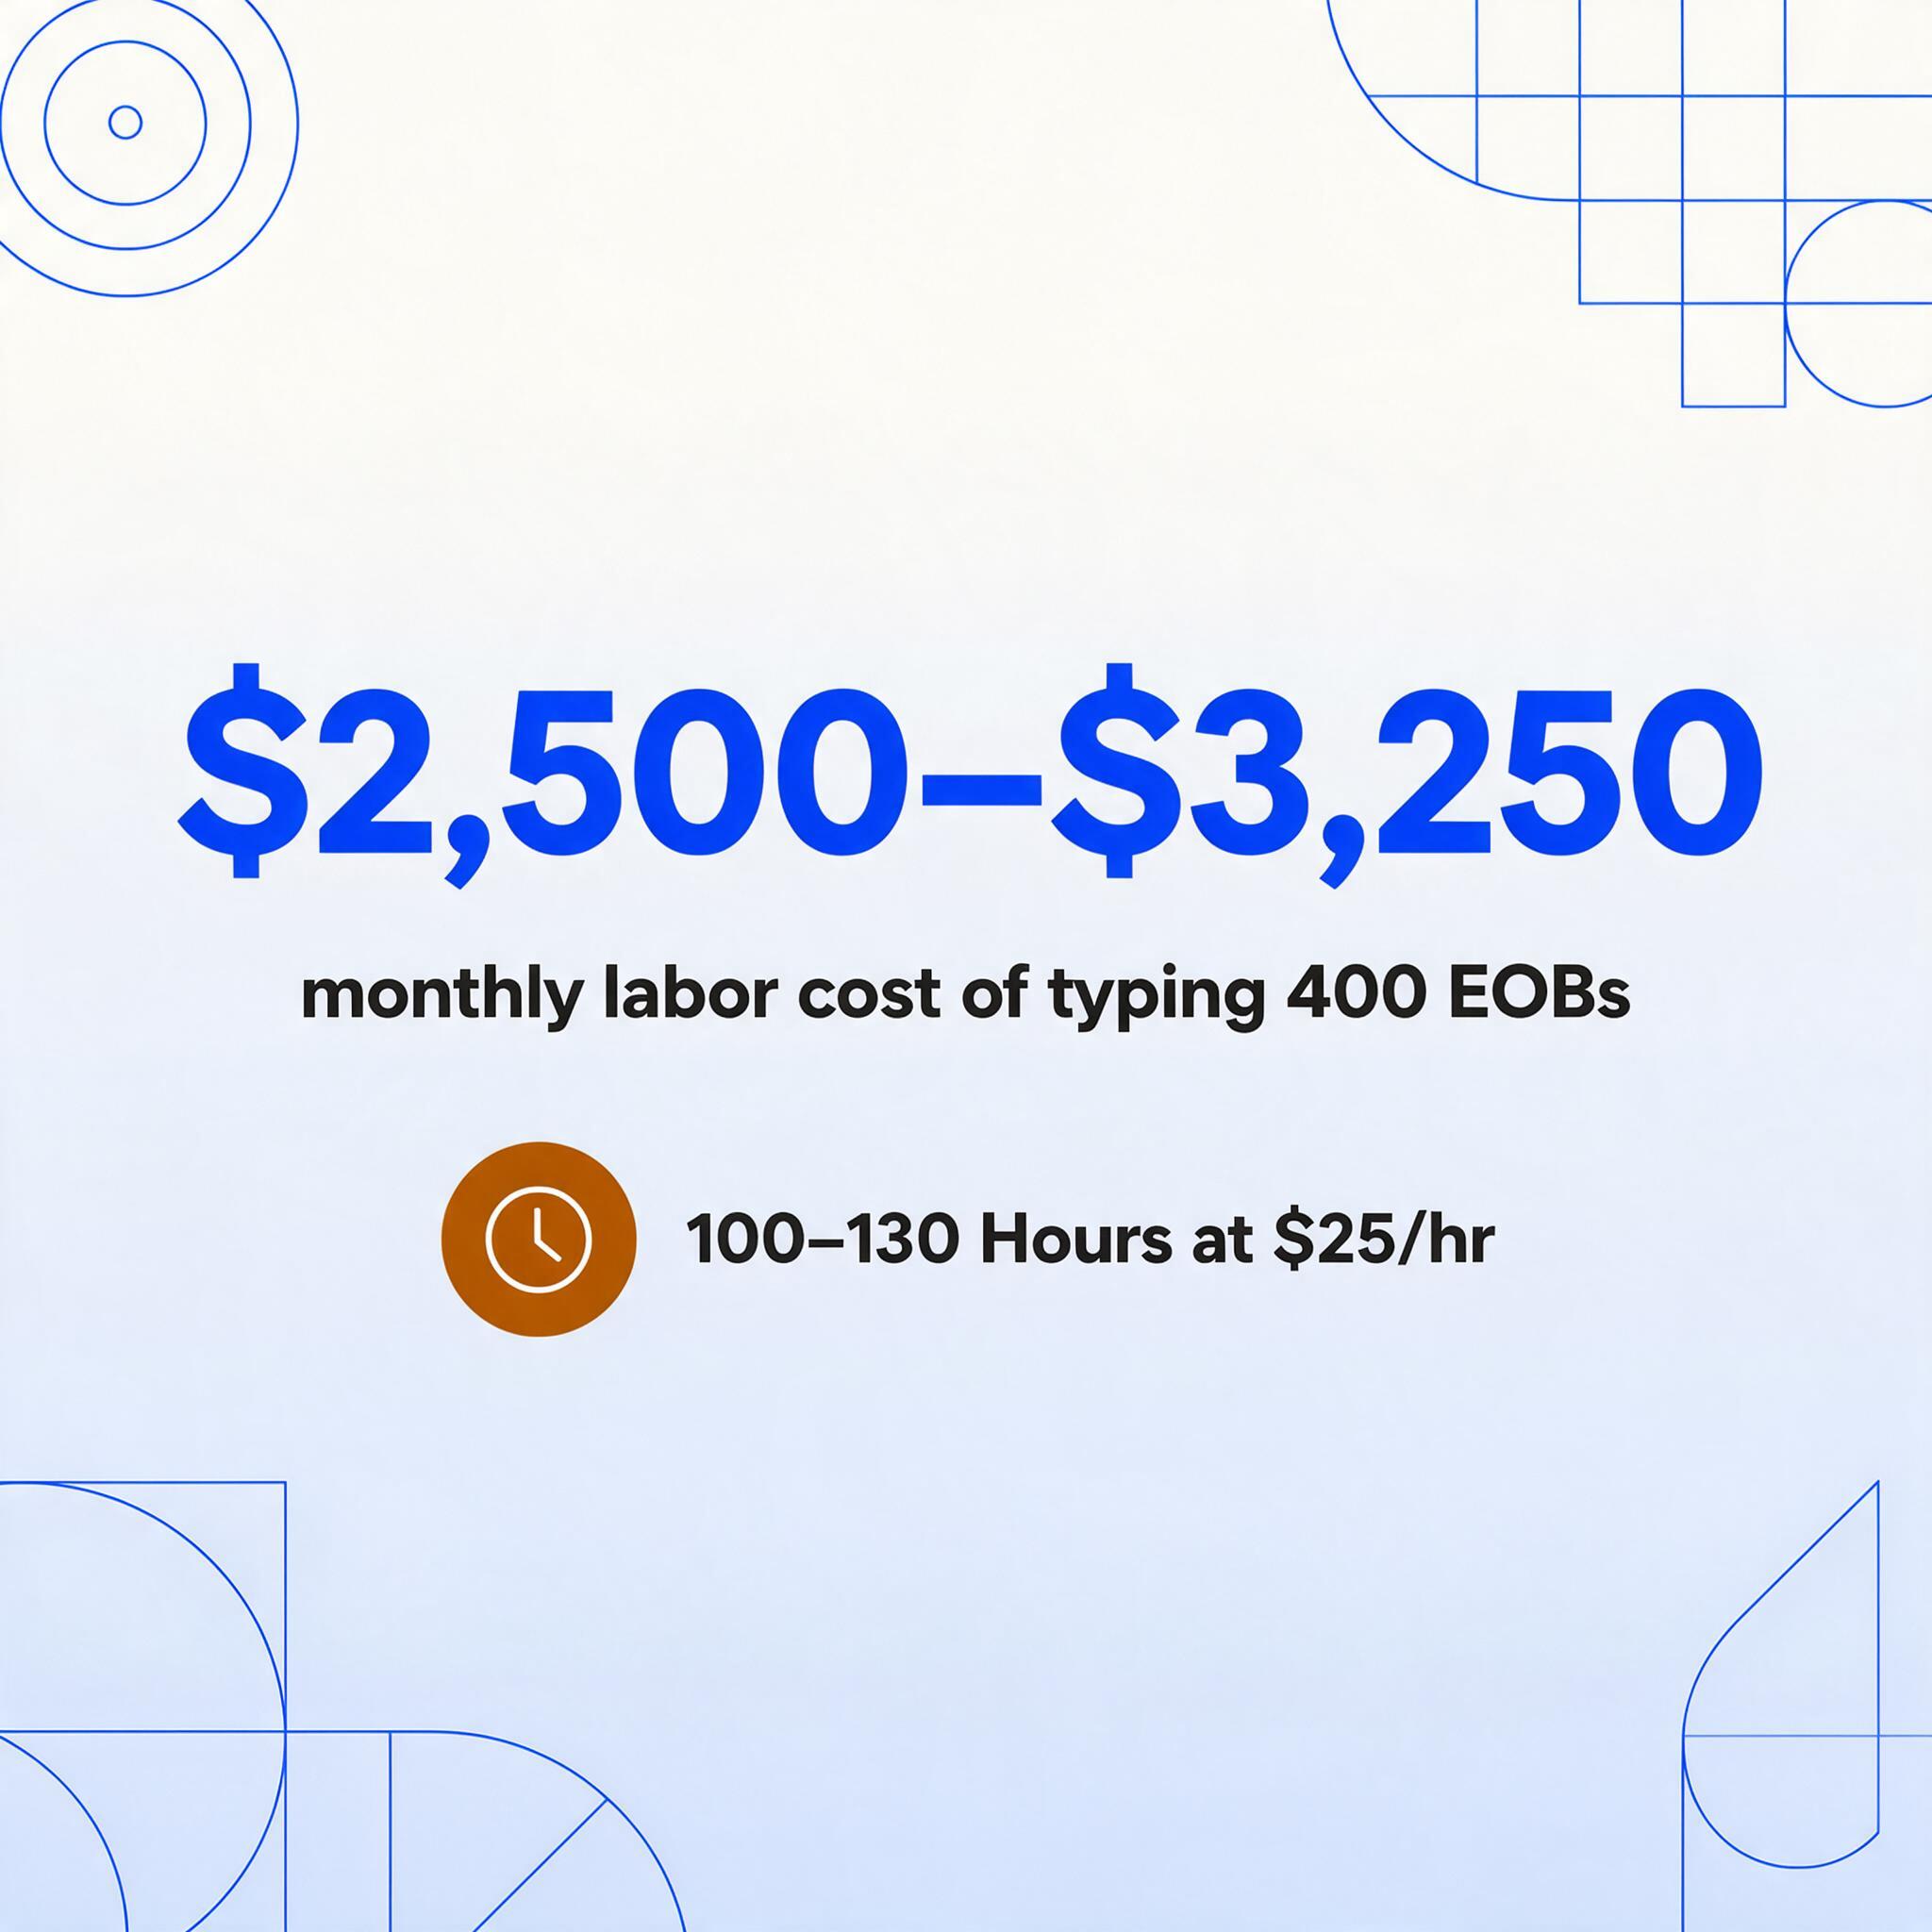
Manuelle EOB-Verarbeitung wirkt auf dem Papier kostengünstig – ein Abrechnungsspezialist tippt Daten aus einer PDF-Datei in eine Tabellenkalkulation oder ein Praxismanagementsystem, Feld für Feld, bei etwa $25 pro Stunde. Die tatsächlichen Kosten entstehen über vier separate Kanäle, die die meisten Praxen erst sehen, wenn sie am Monatsende zusammengerechnet werden.
Der Arbeitsaufwand der Transkription. Eine mittelgroße Praxis, die 400 EOBs pro Monat verarbeitet, verbringt etwa 100 bis 130 Stunden allein mit der Dateneingabe, bei 15 bis 20 Minuten pro Dokument für Lesen, Auffinden der richtigen Felder, Tippen und Überprüfen. Bei $25 pro Stunde sind das $2.500 bis $3.250 an direkten Arbeitskosten pro Monat – bevor Fehler korrigiert werden. Das sind die sichtbaren Kosten. Die unsichtbaren Kosten sind das, was der Abrechnungsspezialist nicht tut: Ablehnungen anfechten, Unterzahlungen nachgehen, Unstimmigkeiten abgleichen oder Versicherertrends analysieren. Für eine detaillierte Aufschlüsselung der vollständigen Kosten pro Anspruch – Arbeit, Software-Overhead, Fehlerkorrekturen und nicht eingetriebene Unterzahlungen – lesen Sie unsere Kostenanalyse der manuellen EOB-Dateneingabe.
Die Fehlersteuer. Die Fehlerquote von 8–12 %, die bei manueller Dateneingabe als normal gilt, führt direkt zu abgelehnten Ansprüchen, falsch zugeordneten Zahlungen und Abgleicharbeiten, die länger dauern als das ursprüngliche Tippen. Eine einzelne vertauschte Ziffer bei einem zugelassenen Betrag oder ein falsch eingegebener CPT-Code kann eine Ablehnung erzeugen, deren Recherche und Anfechtung 30 Minuten dauert. Branchendaten deuten darauf hin, dass Fehler allein bei der EOB-Dateneingabe etwa ein Viertel der vermeidbaren Anspruchsablehnungen ausmachen. Jeder abgelehnte Anspruch kostet durchschnittlich $118 für die Nachbearbeitung, und diese Kosten werden selten als EOB-Verarbeitungskosten erfasst – sie sind im Budget für das Ablehnungsmanagement versteckt.
Verwirrung bei der Patientenabrechnung. Wenn die Eigenverantwortung des Patienten falsch berechnet wird – ein Selbstbehalt auf die falsche Zeile angewendet, ein Zuzahlungsbetrag fälschlich als Kostenbeteiligung interpretiert – erhält der Patient eine Abrechnung, die nicht mit der EOB (Explanation of Benefits, Leistungsübersicht) übereinstimmt. Das führt zu Anrufen, Streitigkeiten, Zahlungsverzögerungen und im schlimmsten Fall zu Beschwerden bei den staatlichen Versicherungsaufsichtsbehörden. Die Kosten dieser Anrufe werden selten gemessen, aber jeder, der eine medizinische Abrechnungsstelle geleitet hat, weiß, dass ein einziger Abrechnungsstreit 45 Minuten und mehrere Mitarbeiter binden kann.
Verzögerung beim Abgleich von Zahlungsansprüchen. Der Abgleich der auf dem Anspruch verbuchten Zahlung mit der erwarteten Erstattung soll Unterzahlungen aufdecken. Wenn die Daten, die in diesen Abgleich einfließen, selbst fehleranfällig sind, erzeugt der Vergleich falsch-positive Ergebnisse (Warnungen, die sich als Dateneingabefehler herausstellen, nicht als tatsächliche Unterzahlungen) und falsch-negative Ergebnisse (echte Unterzahlungen, die unbemerkt bleiben, weil die extrahierte Zahl zufällig mit dem falschen Anspruch übereinstimmt). Eine HFMA-Umfrage aus dem Jahr 2023 ergab, dass 43 % der Leistungserbringer Zahlungsverzögerungen speziell aufgrund manueller EOB-Verarbeitungsfehler erleben.
Diese vier Kostenfaktoren addieren sich, sie schließen sich nicht gegenseitig aus. Eine Praxis, die 2.500 $ pro Monat für Transkriptionsarbeit ausgibt, verliert wahrscheinlich einen ähnlichen Betrag durch Fehlerkorrektur, Streitigkeiten bei der Patientenabrechnung und übersehene Unterzahlungen. Die tatsächlichen Kosten der manuellen EOB-Verarbeitung sind ungefähr doppelt so hoch wie der sichtbare Arbeitsaufwand.
Die eigentliche Herausforderung: Über 6.000 Zahlergestaltungen
Der Grund, warum die manuelle EOB-Verarbeitung so fehleranfällig ist, liegt nicht darin, dass die ausführenden Personen ungeschult sind. Es gibt über 6.000 verschiedene EOB-Layouts bei den Zahlern in den Vereinigten Staaten. Jeder Versicherer – UnitedHealthcare, Aetna, Cigna, Humana, Blue Cross Blue Shield (jeder Bundesstaat plant unabhängig), Medicare, Medicaid Managed Care Organizations, Arbeitnehmerentschädigungsträger – organisiert dieselben Datenpunkte unterschiedlich.
Einige Zahler präsentieren die Anspruchszusammenfassung in einer horizontalen Tabelle mit Spalten für Daten, Verfahrenscodes, abgerechnete Beträge, zulässige Beträge und Eigenverantwortung des Patienten. Andere verwenden ein vertikales, gestapeltes Layout, bei dem jede Leistungszeile ein Block mit beschrifteten Feldern ist. Einige unterteilen den Selbstbehalt, die Kostenbeteiligung und den Zuzahlungsbetrag in separate Unterspalten; andere fassen alles in einer einzigen Zeile „Patient schuldet“ zusammen. Einige ändern sogar das Layout innerhalb einer einzigen EOB – sie verwenden ein Format für bezahlte Ansprüche und ein anderes für abgelehnte Ansprüche auf derselben PDF.
CPT- und ICD-Code-Erkennung. Die Verfahrenscodes (CPT/HCPCS) und Diagnosecodes (ICD-10), die auf einer EOB erscheinen, sind die sensibelsten Felder im Dokument. Ein einziger falsch getippter CPT-Code – 99213 statt 99214 – bedeutet, dass der Anspruch für eine andere Leistungsstufe war. Das Abrechnungssystem verbucht die falsche Zahlung, der Zahler kann die Differenz bei einer Prüfung ablehnen, und der Leistungserbringer muss die Überzahlung Monate später möglicherweise zurückerstatten. Diese Codes sind dicht gepackt, laufen oft ohne klare Trennzeichen zusammen und werden manchmal abgeschnitten, wenn sie die Feldbreite auf der gedruckten EOB überschreiten.
Die finanzielle Aufschlüsselung. Eine EOB zeigt typischerweise den abgerechneten Betrag (was der Leistungserbringer in Rechnung gestellt hat), den zulässigen Betrag (was der Versicherer für angemessen hält), den vom Plan gezahlten Betrag und die Eigenverantwortung des Patienten – die selbst eine Zusammensetzung aus angewendetem Selbstbehalt, Kostenbeteiligungsprozentsatz, Zuzahlungsbetrag und nicht abgedeckten Beträgen ist. Jeder Zahler teilt diese Unterkomponenten anders auf. Auf einer UnitedHealthcare-EOB kann der Selbstbehalt in einer separaten Spalte erscheinen. Auf einer Blue-Cross-EOB kann er in einer Anpassungszeile mit einem Bemerkungscode eingebettet sein. Die Extraktionsmethode muss verstehen, welche Zwischensumme welche Komponente enthält, nicht nur die Dollarzeichen lokalisieren.
Hinweiscodes. Claim Adjustment Reason Codes (CARC) und Remittance Advice Remark Codes (RARC) erklären, warum eine Anpassung vorgenommen oder ein Anspruch abgelehnt wurde – zum Beispiel CO-45 (vertragliche Verpflichtung – Betrag übersteigt die Gebührenordnung) oder PR-1 (Patientenverantwortung – Selbstbehalt). Es gibt Hunderte aktive Codes, die von der X12-Standardorganisation gepflegt werden, und die Kostenträger wenden sie uneinheitlich an. Ein Code auf der EOB (Explanation of Benefits) eines Kostenträgers kann auf der eines anderen als Klartext erscheinen. Um diese Codes genau zu extrahieren, müssen sie kontextuell gelesen werden, nicht positionsbasiert.
Diese vier Komplexitätsebenen – Layout-Variabilität, medizinische Codedichte, finanzielle Berechnungen und Anpassungscodes – machen die EOB-Extraktion zu einem grundlegend anderen Problem als die Extraktion einer Standardrechnung. Und sie sind der Grund, warum herkömmliche, vorlagenbasierte OCR-Tools, die auf feste Feldpositionen angewiesen sind, bei EOBs versagen.
Herkömmliche Verarbeitung vs. KI-gestützte Extraktion
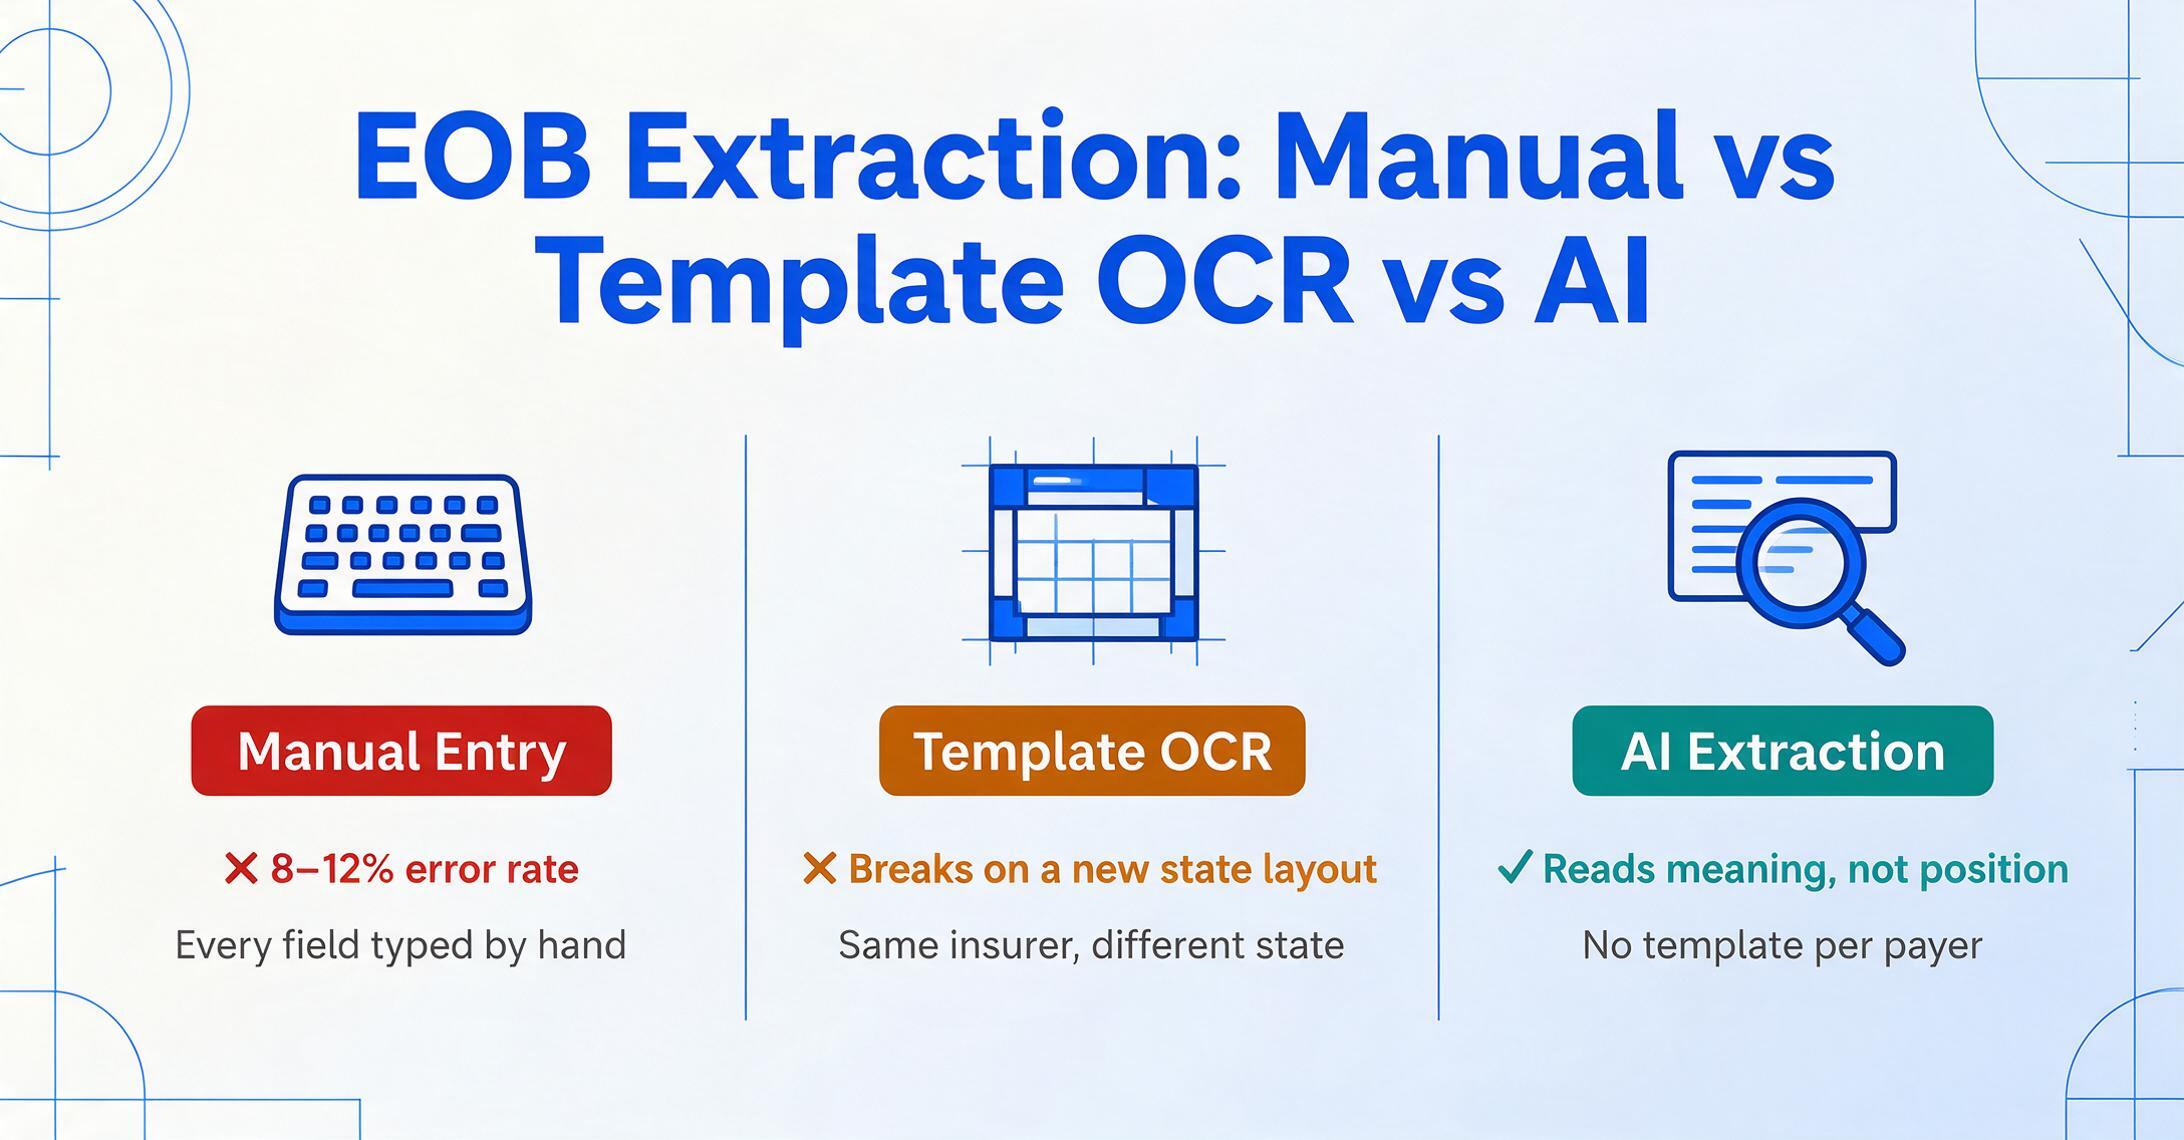
Der herkömmliche Ansatz zur EOB-Verarbeitung hat zwei Varianten: manuelle Dateneingabe und vorlagenbasierte OCR. Beide teilen dieselbe grundlegende Einschränkung – sie behandeln die EOB als ein Dokument mit einem vorhersehbaren Layout, was sie nicht ist.
Vorlagenbasierte OCR funktioniert gut, wenn jedes Mal dasselbe Formular eintrifft: Das Feld für „Allowed Amount“ (zulässiger Betrag) befindet sich immer in derselben Spalte auf derselben Seite, und die Software kann so konfiguriert werden, dass sie genau dort sucht. EOBs verletzen diese Annahme. Eine Vorlage, die für eine Blue-Cross-EOB aus Florida konfiguriert wurde, wird bei einer Blue-Cross-EOB aus Illinois versagen – gleicher Versicherer, anderer Bundesstaat, anderes Layout.
KI-gestützte Extraktion hingegen liest das Dokument, indem sie versteht, was jeder Datenpunkt bedeutet, nicht wo er steht. Die Technologie dahinter ist ein VLM (Vision Language Model) – dieselbe Modellklasse, die ein Foto betrachten und beschreiben kann, was darauf zu sehen ist. Wenn es auf eine EOB angewendet wird, sieht das Modell das Dokument als Ganzes, identifiziert die Abschnittsüberschriften („Patient Responsibility“ (Patientenverantwortung), „Amount Paid“ (gezahlter Betrag), „Service Description“ (Leistungsbeschreibung)) und findet die entsprechenden Werte über ihre semantische Beziehung zu diesen Überschriften, nicht über ihre Pixelkoordinaten.
Das ist der entscheidende Unterschied. Ein vorlagenbasierter Ansatz fragt: „Wo ist der Selbstbehalt?“ und sucht an einer festen Koordinate. Ein KI-basierter Ansatz fragt: „Wie hoch ist der Selbstbehalt für diese Leistungsposition?“ und liest das Dokument, bis er die Antwort findet.
| Dimension | Manuelle Eingabe | Vorlagenbasierte OCR | KI-gestützte Extraktion |
|---|---|---|---|
| Abdeckung der Zahlstellenformate | Mensch liest jedes Format | Nur vorkonfigurierte Vorlagen | Jedes Format, ab erstem Upload |
| Einrichtung pro Zahlstelle | Keine (Mensch liest visuell) | Vorlagenerstellung + Test pro Layout | Keine – null Konfiguration |
| Verarbeitungszeit pro EOB | 15–20 Minuten | 2–5 Minuten | 5–10 Sekunden |
| Typische Fehlerquote | 8–12 % | 5–8 % (bricht bei Formatänderungen) | Unter 2 % |
| CPT-/ICD-Code-Extraktion | Anfällig für Tippfehler | Abhängig von korrekter Zone | Kontextbezogenes Lesen |
| Batch-Verarbeitung mehrerer Zahlstellen | Sequenziell – einzeln nacheinander | Nur EOBs mit gleichem Layout | Gemischte Zahlstellen in einem Batch |
| Widerstandsfähigkeit bei Formatänderungen | Nicht zutreffend (Mensch passt sich an) | Bricht, bis Vorlage aktualisiert wird | Handhabt neue Layouts automatisch |
Das Ergebnis ist nicht nur eine schnellere Verarbeitung. Es ist ein grundlegend anderer Arbeitsablauf: Statt dass ein Abrechnungsspezialist jede EOB öffnet, liest und Werte in ein System eingibt, liest die KI den gesamten Batch und der Spezialist prüft nur die Ausnahmen – markierte Abweichungen, ungewöhnliche Codes oder Beträge außerhalb der erwarteten Spannen.
Der Wandel ist nicht Geschwindigkeit. Der Wandel ist Aufmerksamkeitslenkung. Ein Abrechnungsteam, das 100 Stunden mit Dateneingabe verbringt, hat kaum Zeit für Ablehnungsanalysen oder Zahlstellenverhandlungen. Ein Team, dessen Dateneingabe von der KI übernommen wird, hat diese 100 Stunden zurück für die Arbeit, die die Leistung des Revenue Cycles tatsächlich verbessert.
Probieren Sie es selbst aus: EOB hochladen und Ergebnisse ansehen
Die folgende eingebettete Demo ermöglicht es Ihnen, ein EOB-Dokument hochzuladen — eine PDF-Datei, einen gescannten Bild oder sogar ein Foto von Ihrem Telefon — und zu sehen, was KI-gestützte Extraktion in Sekundenschnelle produziert. Keine Anmeldung, keine Konfiguration, keine Vorlagenerstellung.
Dateien werden sicher verarbeitet und nach der Extraktion nicht gespeichert.
Kritische Felder in jeder EOB
Während jeder Zahler diese Felder unterschiedlich formatiert, sind die Daten, die ein Abrechnungsteam aus einer EOB benötigt, bemerkenswert konsistent über alle Zahler hinweg. Die Herausforderung besteht nicht darin zu wissen, was extrahiert werden soll — sondern darin, die Extraktionsmethode so zu konfigurieren, dass jedes Feld korrekt aus einem Layout lokalisiert wird, das sie noch nie zuvor gesehen hat.
| Feld | Warum es wichtig ist | Häufige Zahlerbezeichnungen |
|---|---|---|
| Patienten-/Mitglieds-ID | Verknüpft die EOB mit dem korrekten Patientendatensatz und Anspruch | Mitglieds-ID, Versicherten-ID, Patienten-ID, ID-Nr. |
| Patientenname | Überprüfung der Patientenidentität | Patientenname, Mitgliedsname, Versicherter |
| Leistungserbringer / NPI | Stellt sicher, dass die Zahlung dem richtigen Leistungserbringer gutgeschrieben wird | Leistungserbringer, behandelnder Leistungserbringer, abrechnender Leistungserbringer, NPI |
| Leistungsdatum | Bestimmt den geltenden Leistungszeitraum und Vertragsbedingungen | LD, Leistungsdatum, Von–Bis, Datum der Leistung |
| CPT / HCPCS-Code | Identifiziert die durchgeführte Prozedur – das fehleranfälligste Feld | CPT, Prozedurencode, Code, HCPCS, Leistungscode |
| ICD-10-Diagnosecode | Medizinische Notwendigkeit – falsche Codes führen zu Ablehnungen | Diagnosecode, ICD-10, DX, Hauptdiagnose |
| Berechneter Betrag | Vom Leistungserbringer in Rechnung gestellt – Grundlage für vertragliche Anpassungen | Berechnet, Gebühren, Eingereichter Betrag, Rechnungsbetrag |
| Zugelassener Betrag | Der ausgehandelte Satz des Zahlungspflichtigen – Basis aller nachgelagerten Zahlungsberechnungen | Zugelassen, Gedeckter Betrag, Genehmigt, Planvergütung |
| Zahlung des Plans | Was der Versicherer tatsächlich gezahlt hat – muss mit Scheck oder Überweisung übereinstimmen | Vom Plan gezahlt, Versicherungszahlung, Plan gezahlt, Scheckbetrag |
| Angewandter Selbstbehalt | Anteil des zugelassenen Betrags, der auf den jährlichen Selbstbehalt des Patienten angerechnet wird | Selbstbehalt, Auf Selbstbehalt angerechnet, Patientenselbstbehalt |
| Kostenbeteiligung | Prozentualer Anteil des Patienten am zugelassenen Betrag nach Selbstbehalt | Kostenbeteiligung, Patienten-Kostenbeteiligung, Kostenbeteiligung in % |
| Zuzahlung | Feste Patientengebühr pro Leistung (oft getrennt von der Kostenbeteiligung) | Zuzahlung, Praxisgebühr, Rezeptgebühr |
| Patientenanteil (Gesamt) | Summe aus Selbstbehalt + Zuzahlung + Kostenbeteiligung + nicht gedeckten Beträgen – was dem Patienten in Rechnung gestellt wird | Patient schuldet, Patientenanteil, Ihr Anteil, Gesamtpatient |
| Kürzungs-/Ablehnungsbetrag | Vom Kostenträger vorgenommene Kürzungen – vertraglich oder nicht gedeckt | Kürzung, abgelehnter Betrag, Rabatt, nicht gedeckt |
| CARC-/RARC-Bemerkungscodes | Erklären, warum eine Kürzung oder Ablehnung erfolgte – entscheidend für Widersprüche | Kürzungsgrundcode, Bemerkungscode, Bemerkung, CARC, RARC |
| Abrechnungsnummer / ICN | Eindeutige Kennung der Abrechnung – verknüpft den EOB mit der ursprünglichen 837-Übermittlung | Abrechnungsnr., ICN, interne Kontrollnummer, Abrechnungs-ID |
Mit einem KI-basierten Extraktionstool, das die Benutzerdefinierte Spaltenextraktion unterstützt, geben Sie die benötigten Feldnamen ein — „Patientenname", „CPT-Code", „Abgerechneter Betrag", „Patientenverantwortung" — und die KI lokalisiert jeden Wert anhand seiner semantischen Bedeutung in jedem Zahlerlayout. Sie definieren die Ausgabe; die KI liest das Dokument. Eine Schritt-für-Schritt-Anleitung zum Einrichten dieser Spalten und zur Durchführung Ihrer ersten Extraktion finden Sie in unserem Leitfaden zur Batch-EOB-Extraktion.
Von Batch-EOBs zur Patientenabrechnungsübersicht
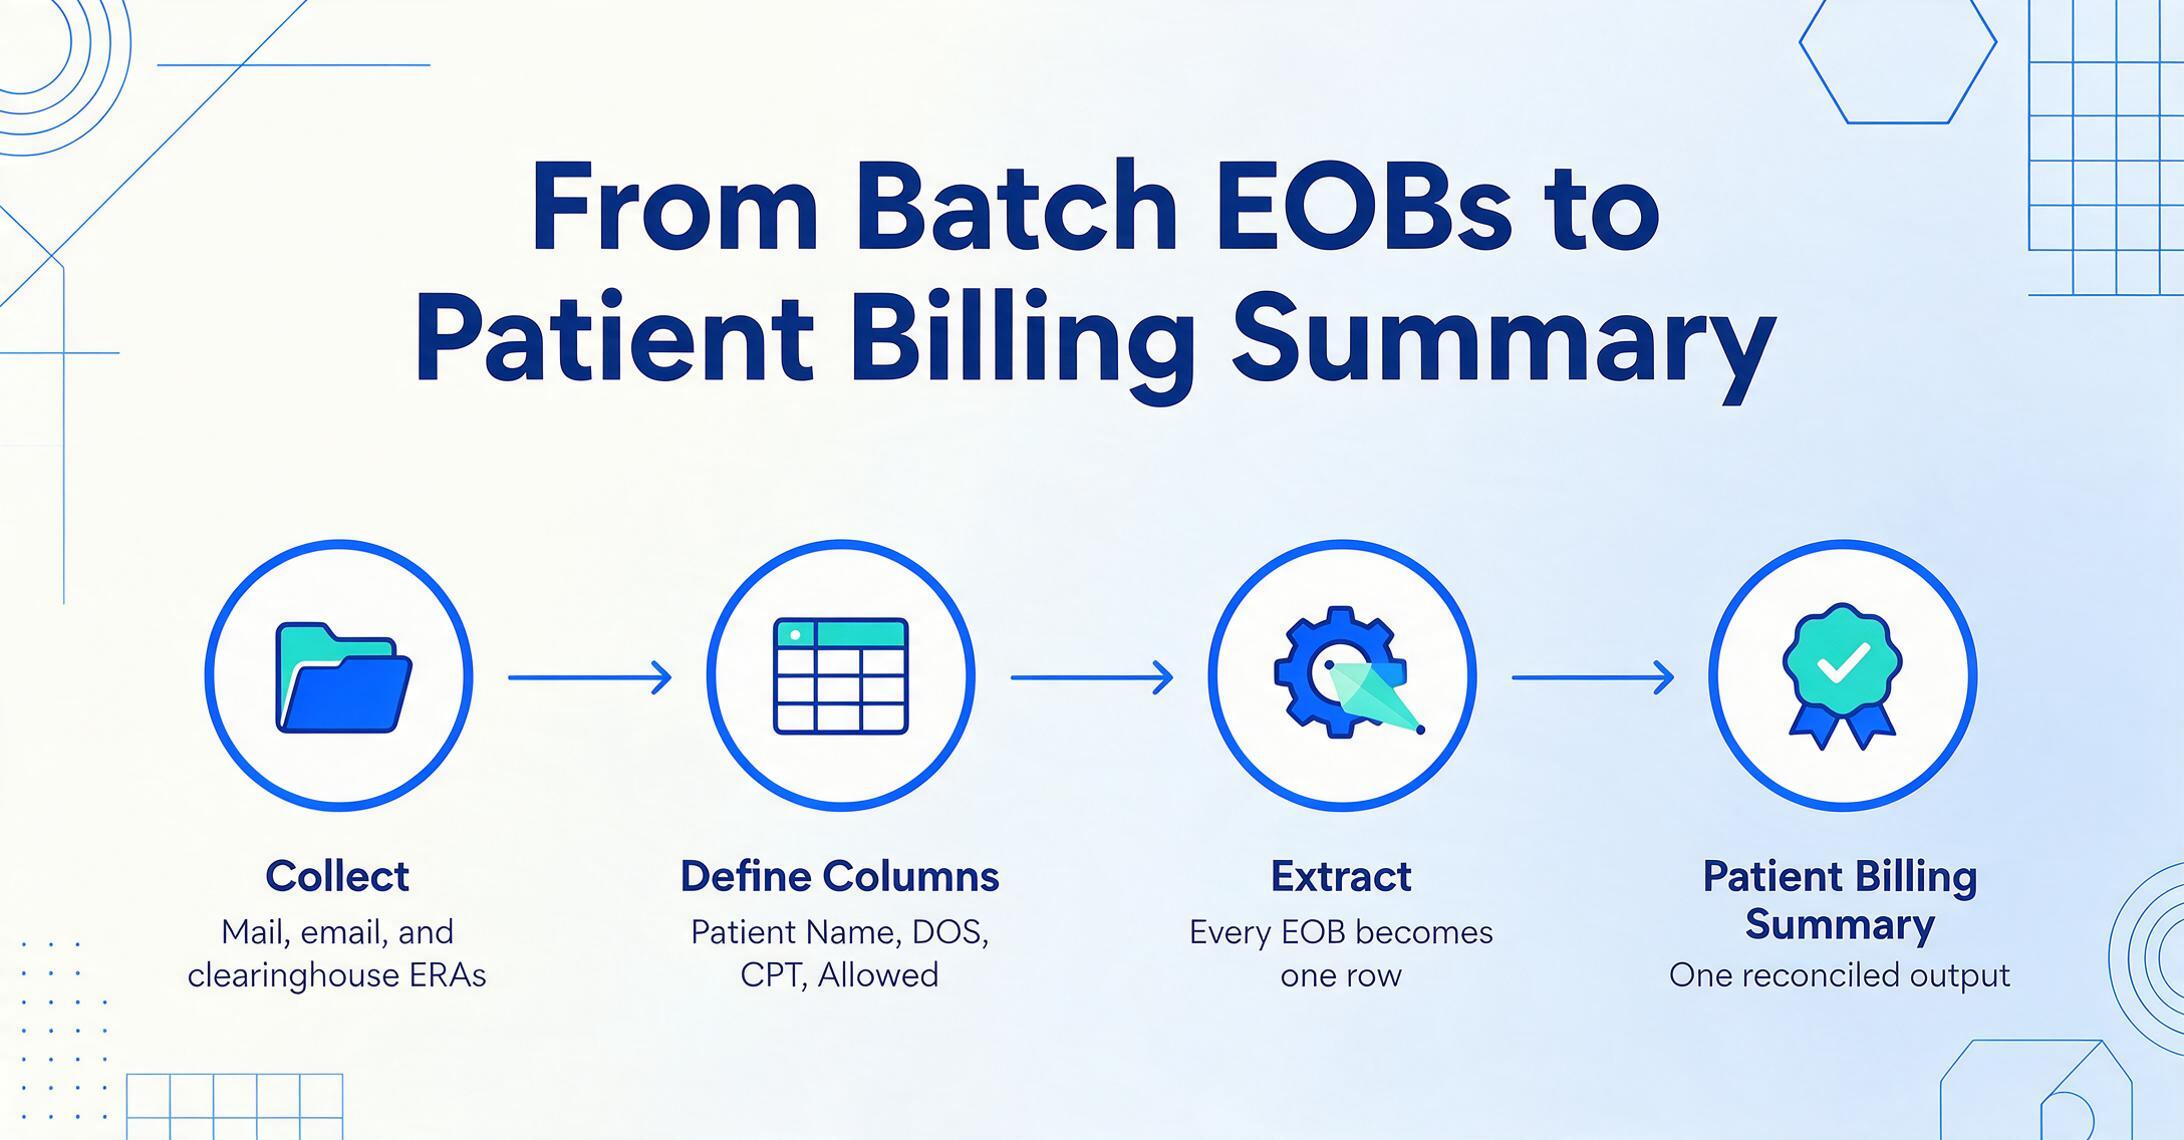
Die eigentliche Stärke der automatisierten EOB-Extraktion liegt nicht darin, ein einzelnes Dokument schneller zu verarbeiten – sondern darin, einen Stapel von Dokumenten verschiedener Versicherer als eine Gruppe zu verarbeiten und eine konsolidierte Ausgabe zu erzeugen, die alle Daten in einer Patientenabrechnungsübersicht zusammenführt.
So arbeitet ein typisches medizinisches Abrechnungsteam mit Batch-KI-Extraktion von einem Stapel EOBs zu einer abgeglichenen Patientenabrechnungsübersicht:
Sammeln Sie die EOBs von jedem Kostenträger.
Einige kommen per Post als Papierdokumente. Andere kommen als PDF-Anhänge per E-Mail. Manche Praxen nutzen eine Clearingstelle, die für einige Kostenträger ERA (Electronic Remittance Advice im X12-835-Format) weiterleitet, von anderen jedoch PDF-EOBs erhält. Jedes PDF oder jeder Scan kommt in einen einzigen Ordner – unabhängig davon, welcher Kostenträger es ausgestellt hat, unabhängig vom Layout.
Laden Sie den Batch hoch und definieren Sie Ausgabespalten.
Laden Sie den gesamten Batch hoch – er kann Blue Cross-, Aetna-, UnitedHealthcare-, Medicare- und Cigna-EOBs gemischt enthalten. Definieren Sie Ihre Spaltennamen: „Patient Name“, „Member ID“, „DOS“, „CPT Code“, „Billed“, „Allowed“, „Plan Paid“, „Deductible“, „Coinsurance“, „Copay“, „Patient Responsibility“. Die KI liest jedes Dokument und ordnet diese Felder durch semantisches Verständnis zu, nicht durch Vorlagenabgleich.
Die KI verarbeitet jede EOB in Sekunden pro Seite.
Die Extraktion läuft je nach Tool sequenziell oder parallel durch den Batch. Jede EOB erzeugt eine Zeile in der Ausgabetabelle. Da die KI kontextbasiert liest, erzeugen eine Blue-Cross-EOB und eine Medicare-Leistungsübersicht im selben Batch Daten in derselben Spaltenstruktur – keine Einrichtung pro Kostenträger erforderlich.
Prüfen und klären Sie gekennzeichnete Ausnahmen.
Das Abrechnungsteam prüft nur die Positionen, die die KI kennzeichnet – Beträge außerhalb der erwarteten Spannen, Patientenzahlungen, die nicht der erwarteten Berechnung entsprechen, Anpassungscodes, die auf eine Ablehnung hindeuten. Alles andere wird bereits in die Ausgabe übernommen. Die Prüfung, die früher 15–20 Minuten pro EOB dauerte, dauert jetzt nur noch wenige Minuten für den gesamten Batch.
Erstellen Sie die Patientenabrechnungsübersicht.
Die konsolidierte Ausgabe – eine Zeile pro Leistungsposition, mit der Patientenzahlung aufgeschlüsselt nach Selbstbeteiligung, Zuzahlung, Eigenanteil und Gesamtbetrag – wird zur Grundlage für Patientenabrechnungen. Mit Computed Columns können Sie zusätzliche Berechnungen direkt in der Extraktion definieren: zum Beispiel eine Spalte, die „Restbetrag = Patientenzahlung – erhaltene Zahlungen“ berechnet, ohne das Extraktionstool zu verlassen. Für einen tieferen Einblick in Multi-Payer-Batch-Workflows lesen Sie unseren Artikel über wie Abrechnungsteams Daten aus Hunderten von EOBs per Batch extrahieren.
Für Praxen, die EOBs von mehreren Anbietern oder Standorten sammeln müssen, ohne jedem Zugriff auf das Hauptkonto zu geben, bietet ImageToTable.ai eine Sammellink-Funktion: Generieren Sie eine teilbare URL, senden Sie sie an Anbieter oder Außendienstmitarbeiter, und diese können EOBs direkt in Ihre Verarbeitungswarteschlange hochladen – ohne Registrierung.
Export und Integration
Extrahierte EOB-Daten sind nur dann nützlich, wenn sie das System erreichen, in dem Abrechnung und Abstimmung stattfinden. Verschiedene Praxen haben unterschiedliche Anforderungen an die Weiterverarbeitung, und das richtige Extraktionstool sollte die gängigsten Zielsysteme unterstützen.
Excel oder Google Sheets. Dies ist das häufigste Ziel für kleine und mittlere Praxen. Ein einzelner Extraktionsdurchlauf erzeugt eine strukturierte Tabelle mit allen wichtigen Feldern – Patientenname, CPT-Codes, abgerechnete Beträge, zugelassene Beträge, Zahlungen der Versicherung, Aufschlüsselung der Patientenzahlung – in beschrifteten Spalten. Die Tabelle ist bereit für den Import in das Praxisverwaltungssystem oder als Abstimmungsprotokoll. Für Teams, die Google Sheets verwenden, überträgt das ImageToTable.ai-Add-on für Google Sheets extrahierte Daten direkt in die aktive Tabelle, ohne Sheets verlassen zu müssen.
Praxisverwaltungs- und EHR-Systeme. Praxen, die Epic, Cerner, Meditech, AdvancedMD, Kareo, NextGen, athenahealth oder eClinicalWorks verwenden, exportieren die strukturierten Daten in der Regel und ordnen sie dem Zahlungsbuchungsmodul ihres Systems zu. Die wichtigste Anforderung ist, dass die exportierten Daten dieselben Felder in einem konsistenten Schema enthalten – Spaltenüberschriften ändern sich nicht zwischen den Durchläufen, und versichererspezifische Abweichungen werden normalisiert, sodass der nachgelagerte Import unabhängig vom ausstellenden Versicherer eine einheitliche Datenstruktur sieht.
Patientenportal-Abrechnung. Sobald der Patientenzahlungsanteil berechnet und verifiziert ist, fließt der patientenbezogene Betrag in das Patientenportal oder das Abrechnungssystem. Ein korrekter Patientenzahlungsanteil – die richtige Aufteilung zwischen Selbstbehalt, Zuzahlung und Eigenanteil – ist hier entscheidend, denn eine Abrechnung, die nicht mit der EOB übereinstimmt, führt zu Anrufen und Streitigkeiten.
So wählen Sie ein EOB-Extraktionstool
Nicht alle Dokumentextraktionstools eignen sich für EOBs. Die spezifischen Merkmale dieser Dokumente – Formatunterschiede zwischen Versicherern, dichte medizinische Kodierung, mehrteilige Finanzfelder – grenzen das Feld erheblich ein. Hier sind die Kriterien, die bei der Bewertung einer EOB-Extraktionslösung am wichtigsten sind.
Genauigkeit bei mehreren Versicherern ab der ersten Nutzung. Der wichtigste Test ist einfach: Laden Sie eine Blue-Cross-EOB, eine Aetna-EOB, eine Medicare-Zahlungsmitteilung und eine Cigna-EOB in einen einzigen Durchlauf und prüfen Sie, ob dieselbe Extraktionskonfiguration für alle vier genaue Daten erzeugt. Wenn das Tool eine separate Vorlage pro Versicherer erfordert oder für jedes Format mit Beispieldokumenten trainiert werden muss, verringert sich der Nutzen der Extraktion erheblich. Der ohne Vorlage arbeitende Ansatz von ImageToTable.ai bedeutet keine Einrichtung pro Versicherer – die KI liest jedes Dokument, indem sie versteht, was jedes Feld bedeutet, unabhängig davon, wo es auf der Seite erscheint.
Erkennungsgenauigkeit für CPT-/ICD-Codes. Prozedur- und Diagnosecodes sind die fehleranfälligsten Felder in einer EOB. Achten Sie auf ein Tool, das dicht gepackte Codes lesen kann – einschließlich Codes ohne klare visuelle Trennung, abgeschnittener Codes, die in einer zweiten Zeile fortgesetzt werden, und Codes in Abschnittsüberschriften statt in einer eigenen Spalte.
Unterstützung bei der Berechnung des Patientenzahlungsanteils. Die besten Extraktionstools geben nicht nur einzelne Felder aus und überlassen Ihnen die Mathematik. Mit der Funktion berechnete Spalte von ImageToTable.ai können Sie die Berechnung des Patientenzahlungsanteils als Teil der Extraktion definieren: Geben Sie „Patient Total = Deductible + Coinsurance + Copay + Non-Covered“ als berechnete Spalte an, und die KI berechnet sie für jede Zeile während der Extraktion. Das eliminiert einen manuellen Verifizierungsschritt, der selbst fehleranfällig ist.
Hinweise zur HIPAA-Konformität. EOBs (Explanation of Benefits) enthalten geschützte Gesundheitsinformationen (PHI) – Patientennamen, Mitglieds-IDs, Diagnosecodes und andere Identifikatoren, die unter die HIPAA-Datenschutz- und Sicherheitsregeln fallen. Jedes Tool, das EOB-Daten verarbeitet, sollte angemessene Schutzmaßnahmen bieten. Prüfen Sie bei der Bewertung eines Tools, ob es sichere Datenübertragung (AES-256-Verschlüsselung während der Übertragung und im Ruhezustand), automatische Datenlöschung nach der Verarbeitung und eine Business Associate Agreement (BAA) unterstützt, falls PHI über die Infrastruktur des Anbieters gespeichert oder übertragen wird. Dies ist eine Beschreibung des Compliance-Kontexts, keine Rechtsberatung. Wenden Sie sich für spezifische HIPAA-Pflichten an den Compliance-Beauftragten oder die Rechtsabteilung Ihrer Organisation.
Batch-Verarbeitung und Umgang mit gemischten Formaten. Wenn Ihre Praxis EOBs von mehr als drei oder vier Zahlern verarbeitet – und die meisten tun das – muss das Tool gemischte Format-Batches verarbeiten können. Die Möglichkeit, einen Ordner mit PDFs von zehn verschiedenen Zahlern in einem einzigen Upload abzulegen und eine einzige Tabelle zurückzuerhalten, ist der Unterschied zwischen einem Tool, das Zeit spart, und einem, das mehr Arbeit schafft.
Für einen breiteren Vergleich von Dokumentextraktions-Tools im Gesundheitswesen finden Sie in unserer Übersicht die besten Dokumentextraktions-Tools für das Gesundheitswesen 2026.
Häufig gestellte Fragen zur EOB-Datenextraktion
Kann KI Daten aus EOBs extrahieren, die mehrere Patienten auf einem Dokument enthalten?
Ja. EOBs mit mehreren Patienten – bei denen ein einzelnes Dokument Ansprüche für mehrere Patienten auflistet, die vom Zahler gruppiert wurden – sind eine häufige Quelle manueller Extraktionsfehler. KI-basierte Extraktion liest das Dokument als Ganzes und identifiziert anhand der kontextuellen Beziehung zwischen Patientenidentifikatoren und Verfahrensdetails, welche Leistungszeilen zu welchem Patienten gehören, und trennt sie in separate Ausgabezeilen. Dies ist deutlich zuverlässiger als manuelles Sortieren, das anfällig für Fehlzuordnungen ist.
Muss das Tool für jedes EOB-Format der einzelnen Kostenträger trainiert werden, bevor es funktioniert?
Nein. ImageToTable.ai extrahiert Daten aus EOBs mithilfe semantischen Verständnisses, nicht durch Vorlagenabgleich. Das erste EOB eines beliebigen Kostenträgers – ob ein großer nationaler Versicherer wie UnitedHealthcare oder ein kleiner regionaler Plan – wird mit derselben Konfiguration verarbeitet. Es gibt keine Trainingsphase, keine Mustersammlung und keine Erstellung von Vorlagen pro Kostenträger.
Was passiert, wenn ein Kostenträger sein EOB-Layout ändert?
Die Extraktion funktioniert weiterhin. Da die KI Daten nach Bedeutung statt nach Position liest, führt eine Layoutänderung – neu angeordnete Spalten, verschobene Abschnittsüberschriften, neu gestaltete Kopfzeilen – nicht zum Abbruch der Extraktion. Dies ist ein grundlegender Vorteil gegenüber vorlagenbasierten OCR-Tools, die bei jeder Änderung des Formulars durch einen Kostenträger neu konfiguriert werden müssen.
Kann das Tool EOBs extrahieren, die von Papierkopien gescannt wurden?
Ja. Die KI verarbeitet gescannte Bilder und Fotos von gedruckten EOBs, nicht nur digitale PDFs. Häufige Szenarien sind per Post erhaltene Papier-EOBs von kleineren Versicherern, per Fax übermittelte Kopien von überweisenden Leistungserbringern und fotografierte EOBs, die Patienten zur Erstattung einreichen. Die Extraktionsgenauigkeit hängt von der Bildqualität ab – klare Scans mit 200 DPI oder höher liefern die besten Ergebnisse – aber das VLM (Vision Language Model) ist darauf ausgelegt, die typische Qualitätsminderung gescannter Dokumente zu bewältigen.
Wie verarbeitet das Tool CARC- und RARC-Bemerkungscodes auf EOBs?
Die KI liest Anpassungsgrundcodes und Bemerkungscodes aus dem EOB und gibt sie als extrahierte Felder aus. Da einige Kostenträger diese Codes im Klartext einbetten, während andere numerische Codewerte verwenden, erfasst die Extraktion sowohl den Code als auch, sofern verfügbar, den zugehörigen Erklärungstext. Die Ausgabe kann anschließend verwendet werden, um Ablehnungen und Anpassungen für Berichte und das Einspruchsverfolgung zu kategorisieren.
Ist das Tool HIPAA-konform?
ImageToTable.ai verarbeitet Dokumente mit Verschlüsselung während der Übertragung (TLS) und im Ruhezustand (AES-256). Von anonymen Benutzern hochgeladene Dateien werden nach der Verarbeitung automatisch gelöscht, und Dateien angemeldeter Benutzer werden nur für die Dauer des Aufbewahrungszeitraums des Tarifs aufbewahrt und anschließend dauerhaft gelöscht. Eine Business-Associate-Vereinbarung (BAA) ist für Anbieter verfügbar, die die HIPAA-Konformität ihrer extrahierten Dokumenten-Workflows dokumentieren müssen. Wie bei jedem Tool zur Verarbeitung von Gesundheitsdaten sollten Sie die spezifischen Sicherheits- und Compliance-Unterlagen mit den Richtlinien Ihrer Organisation abgleichen und Ihren Compliance-Beauftragten konsultieren.
Was ist der Unterschied zwischen der Extraktion einer EOB und einer ERA?
ERA (Electronic Remittance Advice) ist die HIPAA-Standard-Transaktion (ASC X12 835), die dieselben Zahlungsinformationen zu Ansprüchen wie eine EOB, jedoch in einem maschinenlesbaren Format, überträgt. ERAs können mit minimalem manuellem Aufwand automatisch in Praxisverwaltungssysteme eingebucht werden. EOBs sind in der Regel Papier- oder PDF-Dokumente, die zur Erläuterung für Patienten oder Anbieter bestimmt sind. Die Extraktion ist der Weg, um PDF-EOBs wie ERAs zu behandeln – indem ihre visuellen Daten in strukturierte, maschinenlesbare Ausgaben umgewandelt werden. Die meisten Praxen erhalten eine Mischung aus ERAs von großen Zahlern und PDF-EOBs von anderen, daher muss ein vollständiger Revenue-Cycle-Workflow beide Formate verarbeiten können.
Ab wie vielen EOBs pro Monat lohnt sich die automatisierte Extraktion?
Für Praxen mit mehr als 200 EOBs pro Monat decken die Arbeitseinsparungen durch automatisierte Extraktion in der Regel die Tool-Kosten bereits im ersten Monat. Unterhalb dieser Schwelle sind die Einsparungen geringer, aber die gesparte Zeit kann für ein kleines Abrechnungsteam dennoch erheblich sein – 200 EOBs à 15 Minuten ergeben 50 Stunden Dateneingabe pro Monat, die für wertvollere Aufgaben genutzt werden könnten.
Integriert sich das Tool in Epic, AdvancedMD oder Kareo?
ImageToTable.ai exportiert Daten im Excel-Format, die in jedes Praxisverwaltungs- oder EHR-System importiert werden können, das strukturierte Zahlungsdaten akzeptiert. Eine direkte API-Integration ist für Teams verfügbar, die eine automatisierte Buchung benötigen. Für einen vollständigen Workflow ohne Code ermöglicht das Google-Sheets-Add-on, dass Extraktionsergebnisse direkt in einer Tabelle landen, die in Ihr Abrechnungssystem eingespeist wird.
Kann das Tool EOBs von Trägern der Arbeiterunfallversicherung extrahieren?
Ja. EOBs der Arbeiterunfallversicherung (Explanation of Benefits) verwenden ein anderes Set an Abrechnungsregeln und enthalten oft Anpassungen der medizinischen Gebührenordnung, die für das jeweilige Arbeitnehmerentschädigungssystem des Bundesstaates spezifisch sind. Die KI liest diese EOBs auf dieselbe Weise wie Dokumente kommerzieller Kostenträger – indem sie die Felder semantisch versteht. Dieselbe Extraktionskonfiguration, die eine UnitedHealthcare-EOB verarbeitet, verarbeitet auch eine EOB der Arbeiterunfallversicherung von einem bundesstaatspezifischen Träger.
Der nächste Schritt: Von manuell zu strukturiert
Die Arithmetik der EOB-Verarbeitung ist unkompliziert, aber leicht zu ignorieren, da die Kosten über mehrere Budgetposten verteilt sind – Arbeitsaufwand, Fehlerkorrektur, Bearbeitung von Patienteneinwänden und Abstimmung – von denen keiner allein groß genug ist, um eine Prozessänderung auszulösen. Zusammen summieren sie sich zu einer erheblichen Belastung der Leistung des Revenue Cycle.
Der Wechsel von manueller Eingabe zu KI-gestützter Extraktion erfordert keinen vollständigen Austausch der Revenue-Cycle-Plattform, kein neues EHR-System und keine IT-Beteiligung. Es beginnt mit einem Batch: Laden Sie die EOBs hoch, die Sie gestern verarbeitet haben, definieren Sie die Spalten, die Sie sich gewünscht hätten, und prüfen Sie, ob die Ausgabe dem entspricht, was Ihr Team eingegeben hat. Wenn das Ergebnis sauberer und schneller ist, lässt sich der Fall von dort aus skalieren.
Diese Lücke zwischen dem, was die EOB aussagt, und dem, was in Ihr Abrechnungssystem gelangt – die 35 % Fehlerquote der HFMA-Umfrage – ist kein Personalproblem. Es ist ein Prozessproblem mit einer unkomplizierten technischen Lösung.