The Complete Guide to
EOB Data Extraction (2026)
HFMA(Healthcare Financial Management Association)の2023年の調査によると、医療機関の35%が手作業によるEOB(給付明細書)データ入力のエラーを報告しており、43%がその直接的な結果として支払いの遅延を経験しています。これらの数字が示しているのは、給付明細書に記載されている内容と、実際に請求システムに入力される内容との間のギャップです。このギャップが続くのは、スタッフの不注意が原因ではなく、業界がこれらの文書に対して根本的に不自然なことを人々に求めているからです。つまり、どの保険者のレイアウトも同じように扱うこと。しかし実際には、2つのレイアウトが同じであることはありません。
重要なポイント
- 医療機関の35%がEOBデータ入力エラーを報告しています。請求チームの不注意ではなく、6,000種類もの異なる保険者レイアウトをまたいで同じデータ項目をエラーなく読める人間は存在しないからです。
- 毎月2,500ドルの転記作業費は、エラー修正、患者からの請求紛争、別の予算項目に埋もれた過少支払いの見落としを加えると2倍になります。これらはどの単一のレポートにも合算されていません。
- 重要な指標は1枚あたりの処理分数ではなく、毎月100時間を取り戻して、請求チームが数字の入力ではなく、実際に収益を動かす過少支払いや拒否の追跡に集中できるようにすることです。
EOBデータ抽出とは?
EOBデータ抽出とは、給付明細書(Explanation of Benefits)から患者名、医療提供者、サービス提供日、CPT処置コード、請求額、承認額、保険支払額、調整額、患者負担額の内訳、拒否・備考コードなどの主要な保険請求項目を自動で読み取り、請求システムやスプレッドシートが取り込める構造化データに変換するプロセスです。
給付明細書自体は、保険請求が審査された後に保険者から送付される書類です。これは請求書ではありません。医療提供者が請求した金額、プランに基づいて保険者が承認した金額、医療提供者または患者に支払われた金額、患者がまだ負担すべき金額の明細を示すものです。この概念のより詳しい紹介については、EOBデータ抽出の仕組みとその概要に関する専用記事をご覧ください。
EOB抽出を他の文書抽出タスクと区別するのは、データ項目同士の関係性です。EOBの価値は単一の数字にあるのではなく、請求額、承認額、プラン支払額、自己負担額(デダクタブル)、共同保険、定額自己負担、患者負担額がどのように組み合わさっているかにあります。これらの数字を正しく抽出しても、それらを結びつける計算関係を失ってしまえば、技術的には正確でも、請求照合の実務には役に立たない出力になってしまいます。
手動EOB処理が思っている以上にコストがかかる理由
手動のEOB処理は、書面上では安価に見えます。請求担当者がPDFからスプレッドシートや診療管理システムへ、1フィールドずつ、およそ時給$25でデータを入力していく作業です。実際のコストは、月末に合算してみて初めて明らかになる4つの別々の経路を通じて発生します。
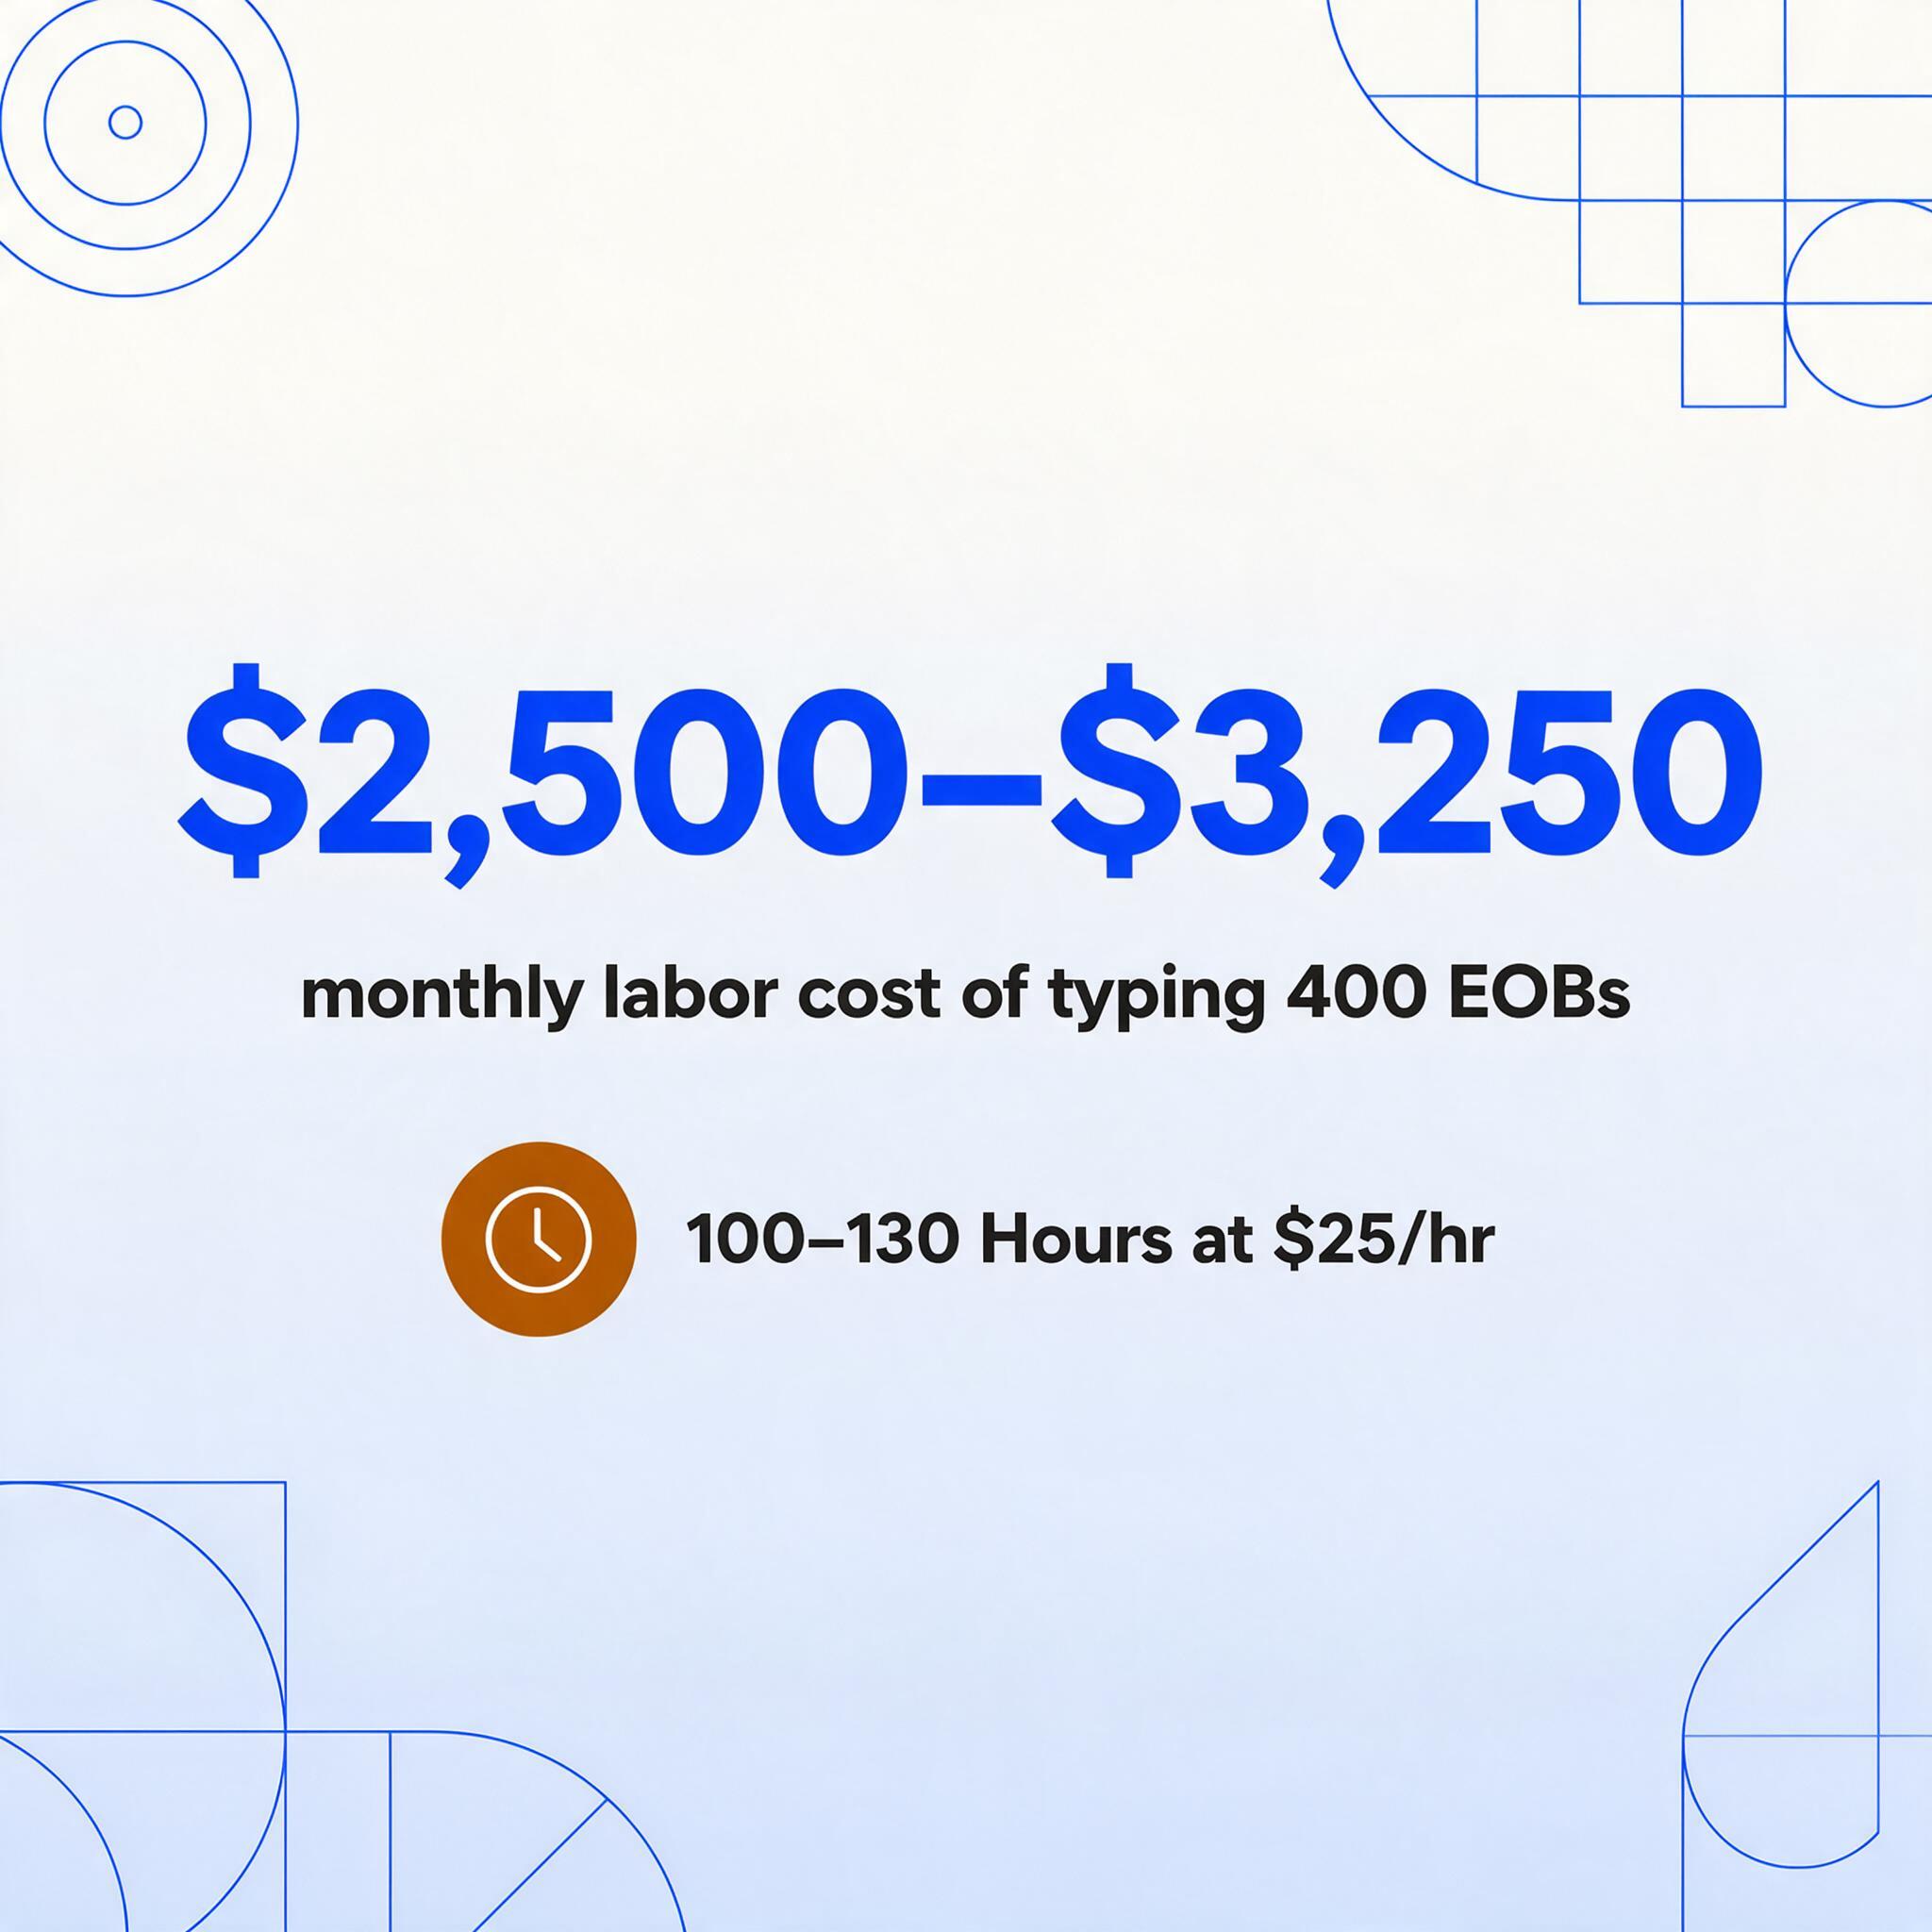
転記の労力。月に400件のEOBを処理する中規模の診療所では、1件あたり15〜20分(読み取り、正しいフィールドの特定、入力、確認)を想定すると、データ入力だけで毎月およそ100〜130時間を費やします。時給$25で計算すると、これは月に$2,500〜$3,250の直接人件費となり、エラー修正の前の段階です。これが目に見えるコストです。目に見えないコストは、その請求担当者ができていないこと、つまり拒否への不服申し立て、過少支払いの追跡、不一致の照合、保険者動向の分析です。請求1件あたりの全コスト(人件費、ソフトウェア間接費、エラー修正、回収不能な過少支払い)の項目別内訳については、手動EOBデータ入力のコスト分析をご覧ください。
エラーによる税金。手動データ入力で標準とされる8〜12%のエラー率は、そのまま請求の却下、支払いの誤適用、そして当初の入力作業よりも時間がかかる照合作業に直結します。承認額の数字が1桁ずれるだけでも、CPTコードの入力ミスでも、調査と不服申し立てに30分かかる拒否が発生する可能性があります。業界データによると、EOBデータ入力のエラーだけで、防止可能な請求拒否のおよそ4分の1を占めるとされています。拒否された請求1件の修正には平均$118かかりますが、このコストがEOB処理コストとして追跡されることはほとんどなく、拒否管理予算の中に埋もれてしまいます。
患者請求の混乱。患者負担額が誤って計算されると、控除額が誤った明細行に適用されたり、自己負担金(コペイ)が併行保険(コインシュアランス)と誤読されたりして、患者はEOB(給付明細書)と一致しない明細書を受け取ることになります。これにより電話問い合わせ、紛争、支払い遅延が発生し、最悪の場合には州の保険規制当局への苦情につながります。その電話対応のコストが測定されることはほとんどありませんが、医療請求窓口を管理した経験のある人なら誰でも、1件の請求紛争が複数のスタッフを巻き込んで45分を消費し得ることを知っています。
請求照合の停滞。請求に計上された支払いを期待される償還額と照合することは、過少支払いを検出するためのものです。その照合に使われるデータ自体がエラーを起こしやすい場合、比較結果は偽陽性(実際の過少支払いではなくデータ入力ミスであることが判明するアラート)と偽陰性(抽出された数字がたまたま誤った請求と一致するため、実際の過少支払いが見逃される)を生み出します。2023年のHFMA(Healthcare Financial Management Association)調査によると、プロバイダーの43%が、手動EOB処理エラーが原因で支払い遅延を経験しています。
これら4つのコストは代替ではなく累積的なものです。毎月2,500ドルを文字起こし作業に費やしている診療所は、エラー修正、患者請求紛争、過少支払いの見逃しにも同額を失っている可能性が高いです。手動EOB処理の実際のコストは、目に見える人件費項目のおよそ2倍になります。
本当の課題:6,000以上の支払者レイアウト
手動EOB処理がこれほどエラーを起こしやすい理由は、担当者の訓練不足ではありません。米国の支払者全体で6,000以上の異なるEOBレイアウトが存在するからです。すべての保険者(UnitedHealthcare、Aetna、Cigna、Humana、Blue Cross Blue Shield(各州プランは独立)、Medicare、Medicaid managed care組織、労災保険者)が、同じデータ項目を異なる方法で整理しています。
一部の支払者は、日付、手技コード、請求額、許容額、患者負担額の列を持つ横型テーブルで請求サマリーを表示します。他の支払者は、各サービス明細行がラベル付きフィールドのブロックとなる縦型の積み上げレイアウトを使用します。控除額、併行保険、自己負担金を別々のサブ列に分割する支払者もいれば、すべてを単一の「患者負担額」行にまとめる支払者もいます。さらに、単一のEOB内でレイアウトを変更する支払者もいます。同じPDF内で、支払い済み請求には1つの形式、拒否された請求には別の形式を使用します。
CPTおよびICDコードの認識。EOBに表示される手技コード(CPT/HCPCS)と診断コード(ICD-10)は、文書内で最も重要なフィールドです。CPTコードが1文字でも誤って入力された場合(99213が99214と入力された場合)、請求は異なるレベルのサービスに対するものになります。請求システムは誤った支払いを計上し、支払者は監査時に差額を拒否する可能性があり、プロバイダーは数か月後に過払い金を返金しなければならない場合があります。これらのコードは密集しており、明確な区切りなしに連続していることが多く、印刷されたEOBのフィールド幅を超えると切り詰められることもあります。
内訳の明細。EOBには通常、請求額(プロバイダーが請求した金額)、許容額(保険者が妥当と判断する金額)、プランが支払った金額、および患者負担額が表示されます。患者負担額自体は、適用された控除額、併行保険の割合、自己負担金の金額、および非対象の金額の複合体です。各支払者はこれらのサブ要素を異なる方法で分割します。UnitedHealthcareのEOBでは、控除額が別の列に表示される場合があります。Blue CrossのEOBでは、リマークコード付きの調整行に埋め込まれている場合があります。抽出方法は、ドル記号を見つけるだけでなく、どのサブ合計にどの要素が含まれているかを理解する必要があります。
リマークコード。クレーム調整理由コード(CARC)と送金通知リマークコード(RARC)は、調整が適用された理由やクレームが拒否された理由を説明します。例えば、CO-45(契約上の義務—料金が料金表を超えている)やPR-1(患者負担—免責金額)などです。X12標準化団体が管理するコードは数百種類あり、保険者によって適用方法は一貫していません。ある保険者のEOB(給付明細書)に記載されているコードが、別の保険者ではプレーンテキストで表示されることもあります。これらのコードを正確に抽出するには、位置ではなく文脈で読み取る必要があります。
レイアウトの多様性、医療コードの密度、金銭計算、調整コードという4つの複雑さが、EOB抽出を標準的な請求書の抽出とは根本的に異なる問題にしています。そして、固定フィールド位置に依存する従来のテンプレートベースのOCRツールがEOBで失敗する理由でもあります。
従来の処理とAI搭載抽出の比較
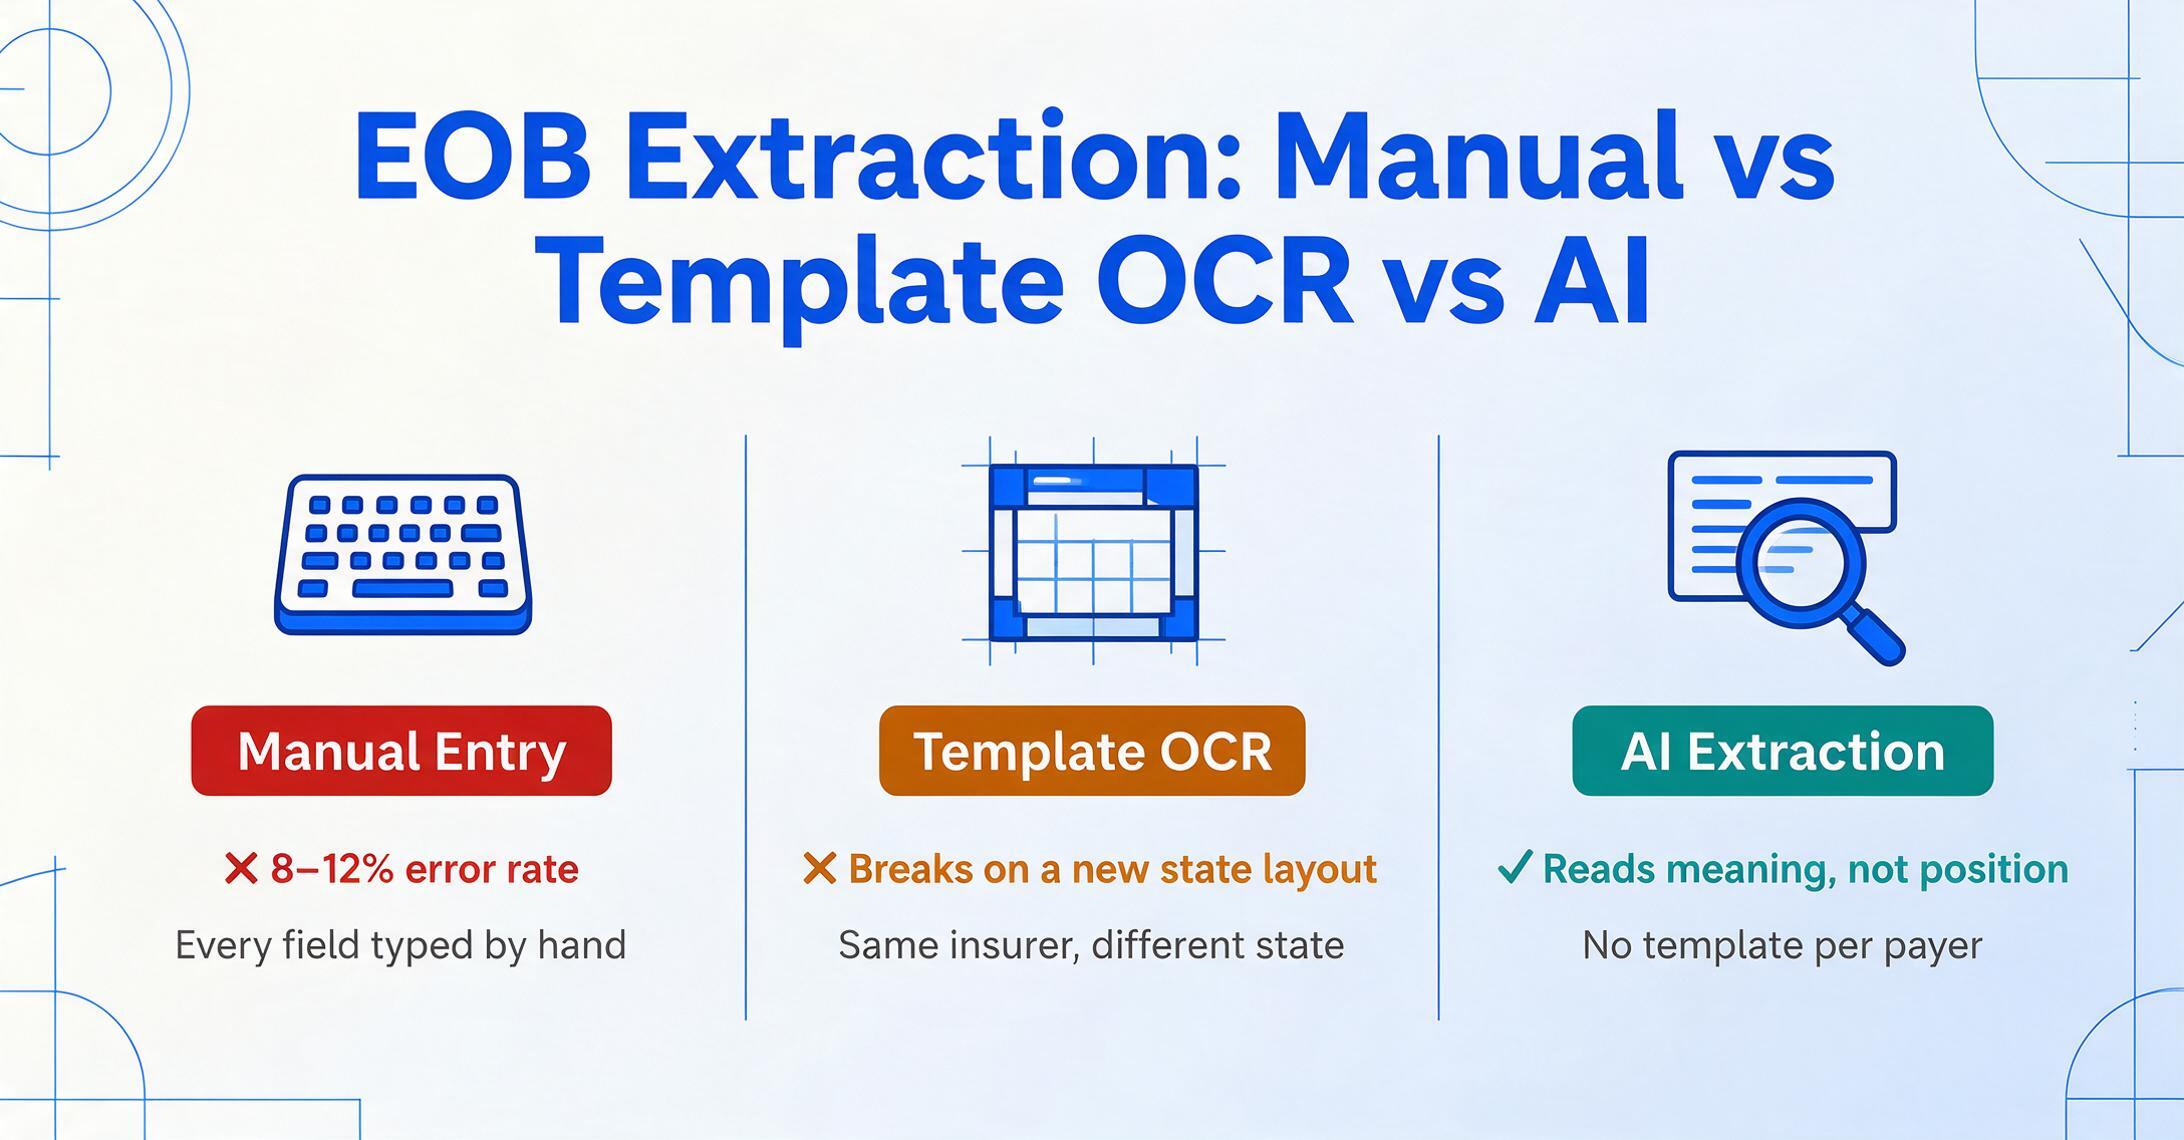
EOB処理の従来のアプローチには、手動データ入力とテンプレートベースのOCRの2つの方法があります。どちらも同じ根本的な限界を共有しています。それは、EOBを予測可能なレイアウトを持つ文書として扱うことですが、実際はそうではありません。
テンプレートベースのOCRは、毎回同じフォームが届く場合にうまく機能します。「許可額」のフィールドが常に同じページの同じ列にあり、ソフトウェアをその場所を正確に探すように設定できる場合です。EOBはその前提を覆します。フロリダのBlue Cross EOB用に設定されたテンプレートは、イリノイのBlue Cross EOBでは失敗します。同じ保険者でも、州が異なればレイアウトも異なるのです。
一方、AI搭載の抽出は、各データポイントがどこにあるかではなく、何を意味するかを理解して文書を読み取ります。この背後にある技術はVLM(視覚言語モデル)です。これは、写真を見て何が起こっているかを説明できるモデルと同じクラスです。EOBに適用すると、モデルは文書全体を認識し、セクションヘッダー(「患者負担」「支払額」「サービス説明」)を特定し、ピクセル座標ではなく、それらのヘッダーとの意味的な関係によって対応する値を特定します。
これが重要な違いです。テンプレートベースのアプローチは「免責金額はどこか?」と問い、固定座標で探します。AIベースのアプローチは「このサービスラインの免責金額はいくらか?」と問い、答えが見つかるまで文書を読み取ります。
| 比較項目 | 手動入力 | テンプレートOCR | AI抽出 |
|---|---|---|---|
| 支払者フォーマット対応 | 人間が読める形式なら何でも | 事前設定済みテンプレートのみ | 初回アップロードで全形式対応 |
| 支払者ごとの設定 | 不要(人間が目視) | レイアウトごとにテンプレート作成+テスト | 不要 — 設定ゼロ |
| EOBあたりの処理時間 | 15~20分 | 2~5分 | 5~10秒 |
| 標準エラー率 | 8~12% | 5~8%(フォーマット変更で破綻) | 2%未満 |
| CPT/ICDコード抽出 | タイポが発生しやすい | 正しい領域に依存 | 文脈に基づく読み取り |
| 複数支払者の一括処理 | 順次 — 一度に1件 | 同一レイアウトのEOBのみ | 異なる支払者を一括処理 |
| フォーマット変更への耐性 | 該当なし(人間が適応) | テンプレート更新まで破綻 | 新レイアウトを自動処理 |
結果として得られるのは、単なる処理速度の向上ではありません。根本的に異なるワークフローです。請求担当者が各EOBを開き、読み取り、システムに入力する代わりに、AIがバッチ全体を読み取り、担当者はフラグが立った例外(不一致、異常なコード、想定範囲外の金額)のみを確認します。
変わるのは速度ではありません。変わるのは注意の配分です。データ入力に100時間を費やす請求チームには、否認分析や支払者交渉の時間はほとんど残りません。データ入力をAIに任せたチームは、その100時間を、実際に収益サイクルのパフォーマンスを向上させる業務に充てることができます。
実際に試す:EOBをアップロードして結果を確認する
以下の埋め込みデモでは、EOB(給付明細書)文書 — PDF、スキャン画像、スマートフォンで撮影した写真など — をアップロードすると、AIによる抽出が数秒で完了します。サインアップも設定もテンプレート作成も不要です。
ファイルは安全に処理され、抽出後は保存されません。
すべてのEOBに含まれる重要項目
保険者ごとにこれらの項目の形式は異なりますが、請求チームがEOBから必要とするデータは、すべての保険者で驚くほど一貫しています。課題は何を抽出するかではなく、これまで見たことのないレイアウトから各項目を正しく特定できる抽出方法を設定することです。
| 項目 | 重要な理由 | 一般的な保険者のラベル |
|---|---|---|
| 患者/会員ID | EOBを正しい患者記録と請求に紐づける | 会員ID、加入者ID、患者ID、ID番号 |
| 患者名 | 患者本人確認 | 患者名、会員名、加入者 |
| 提供者名/NPI | 支払いが正しい提供者に計上されることを保証 | 提供者、実施提供者、請求提供者、NPI |
| サービス日 | 該当する給付期間と契約条件を決定 | DOS、サービス日、From–To、サービス日付 |
| CPT/HCPCSコード | 実施された特定の処置を識別 — 最もエラーが発生しやすい項目 | CPT、処置コード、コード、HCPCS、サービスコード |
| ICD-10診断コード | 医学的必要性の根拠 — 誤ったコードは拒否の原因に | 診断コード、ICD-10、DX、主診断 |
| 請求額 | 提供者が請求した金額 — 契約調整額の計算に使用 | 請求額、料金、提出額、請求金額 |
| 許容額 | 支払者の交渉済み料率 — 以降の支払計算の基礎 | 許容額、対象額、承認額、プラン許容額 |
| プラン支払額 | 保険者が実際に支払った金額 — 小切手またはEFTと一致する必要あり | プラン支払額、保険支払額、プラン支払、小切手金額 |
| 自己負担額(控除対象) | 許容額のうち患者の年間免責金額に充当された部分 | 免責額、免責充当額、患者免責額 |
| 共同保険 | 免責額適用後の許容額に対する患者負担割合 | 共同保険、患者共同保険、共同保険率 |
| 自己負担金(定額) | サービスごとの患者定額負担(共同保険とは別に表示されることが多い) | 自己負担金、Co-Pay、診察自己負担金、処方自己負担金 |
| 患者負担額(合計) | 自己負担額+保険適用外額の合計 — 患者に請求する金額 | 患者負担額、自己負担額、支払額、患者合計 |
| 調整/拒否額 | 支払者による減額 — 契約上または非適用 | 調整額、拒否額、割引、非適用 |
| CARC/RARC備考コード | 調整・拒否の理由を説明 — 異議申立に重要 | 調整理由コード、備考コード、備考、CARC、RARC |
| 請求番号/ICN | 請求の一意識別子 — EOBを元の837送信に紐付け | 請求番号、ICN、内部管理番号、請求ID |
AIベースの抽出ツールでカスタム列抽出に対応しているものを使えば、「患者名」「CPTコード」「請求額」「患者負担額」など、必要な項目名を入力するだけで、AIが意味的に各値をあらゆる保険者のレイアウトから特定します。出力を定義するのはあなた、文書を読み取るのはAIです。これらの列の設定と初回抽出の実行手順については、EOB一括抽出のハウツーガイドをご覧ください。
バッチEOBから患者請求サマリーへ
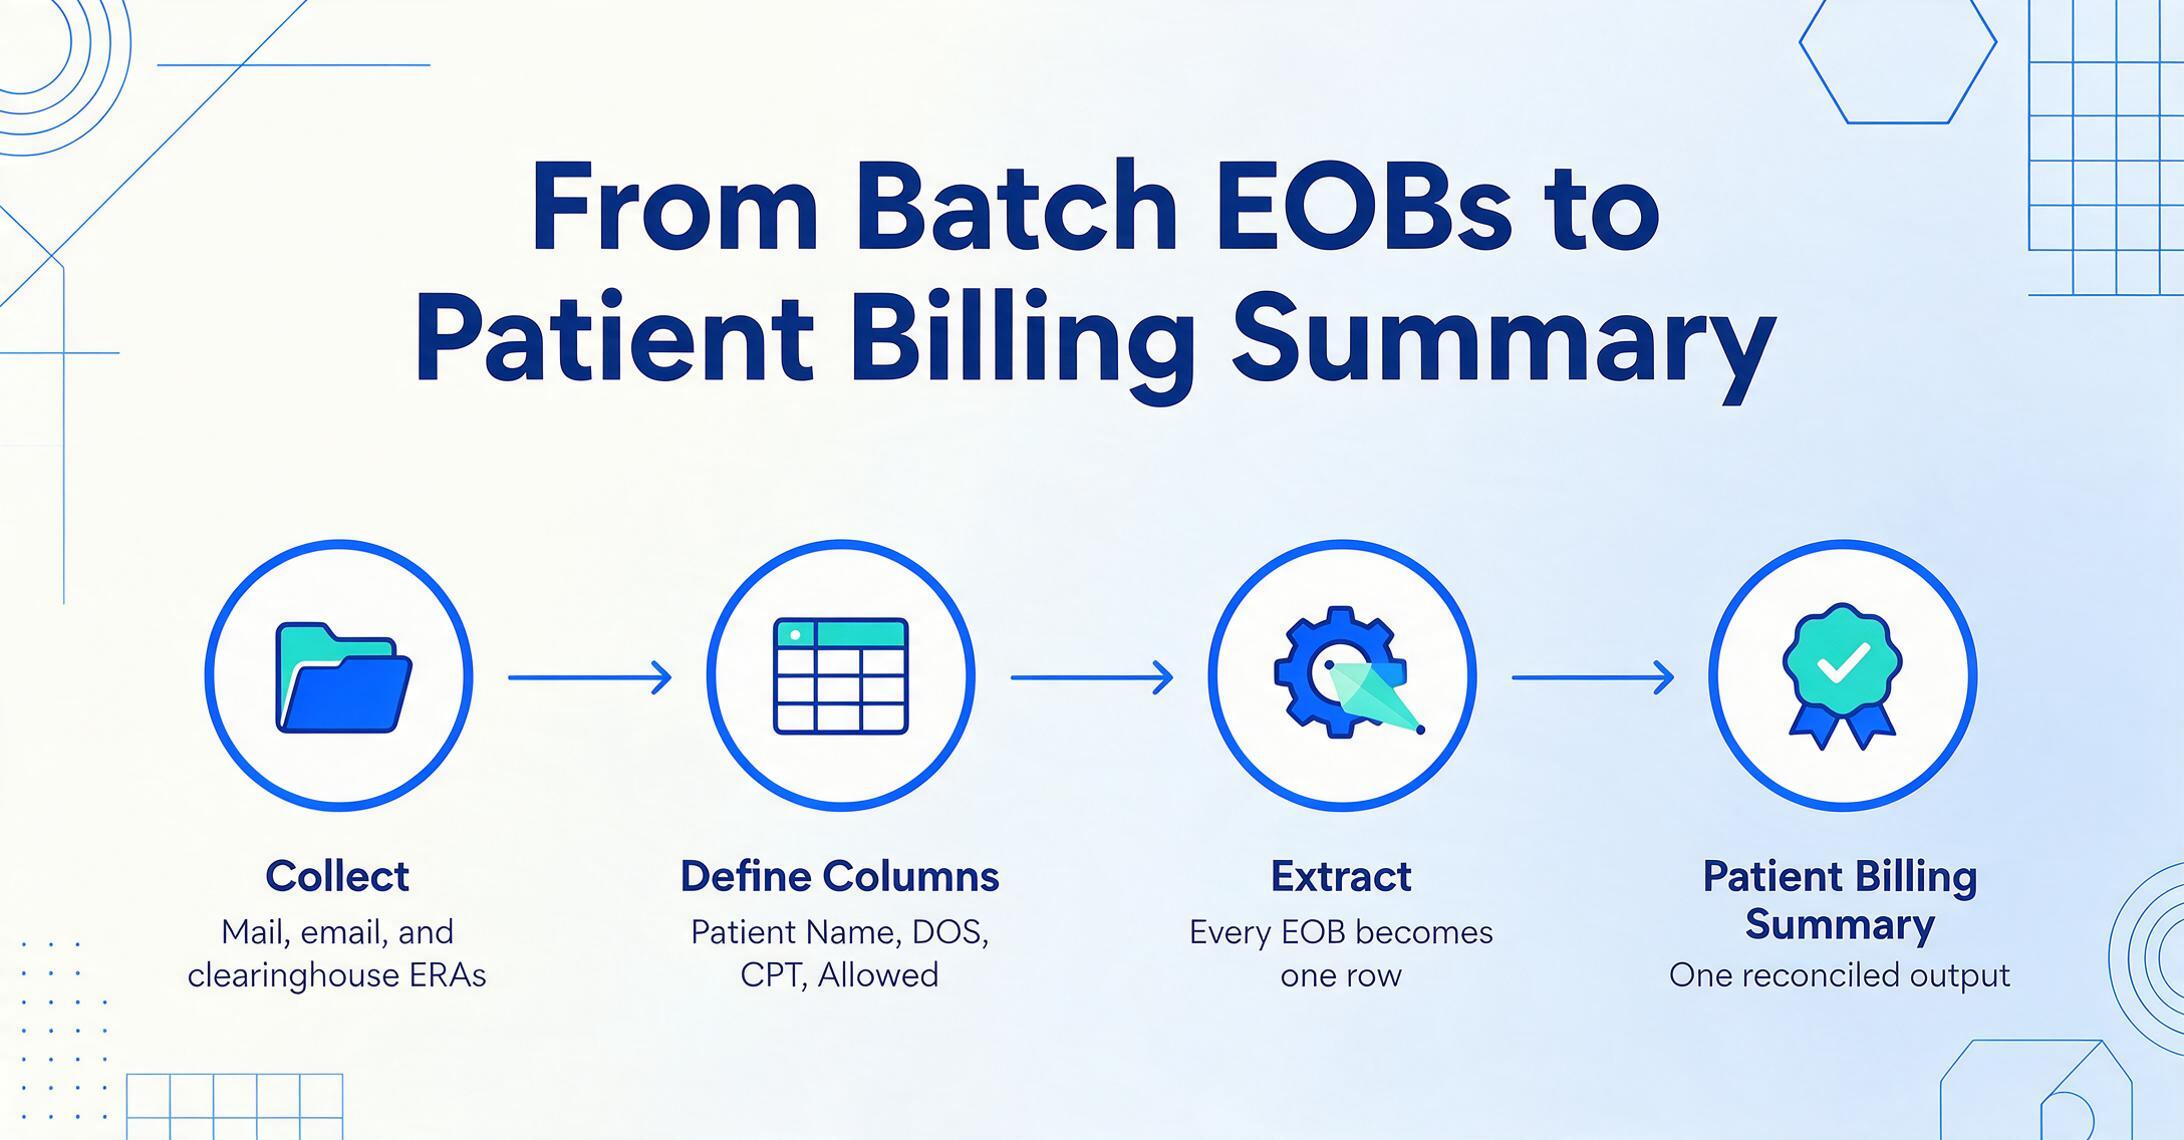
自動化されたEOB(給付明細書)抽出の真の力は、1枚の書類を速く処理することではありません。異なる保険者からの書類のバッチを1つのグループとして処理し、すべてのデータを患者請求サマリーに集約した統合出力を生成することにあります。
典型的な医療請求チームが、EOB(給付明細書)の山から照合済みの患者請求サマリーに至るまで、バッチAI抽出をどのように活用するかをご紹介します。
すべての保険者からEOB(給付明細書)を収集します。
郵送で紙のドキュメントとして届くものもあります。メールにPDF添付されて届くものもあります。一部の診療所では、クリアリングハウスを利用して、一部の保険者からはX12 835形式のERA(電子送金明細)を受け取り、他の保険者からはPDFのEOBを受け取っています。各PDFやスキャンは、発行元の保険者やレイアウトに関係なく、1つのフォルダに保存します。
バッチをアップロードし、出力する列を定義します。
バッチ全体をアップロードします。Blue Cross、Aetna、UnitedHealthcare、Medicare、CignaのEOBが混在していても構いません。列名を定義します。「患者名」「会員ID」「DOS」「CPTコード」「請求額」「許容額」「保険支払額」「免責額」「共同保険」「自己負担額」「患者負担額」。AIが各ドキュメントを読み取り、テンプレート照合ではなく意味理解によってこれらのフィールドをマッピングします。
AIがページごとに秒単位で各EOBを処理します。
抽出はツールに応じてバッチ内で順次または並行して実行されます。各EOBは出力テーブルの1行になります。AIは文脈を読むため、同じバッチ内のBlue Cross EOBとMedicareの送金明細はどちらも同じ列構造でデータを生成します。保険者ごとの設定は不要です。
フラグが付けられた例外をレビューして照合します。
請求チームはAIがフラグを付けた項目のみをレビューします。想定範囲外の金額、期待される計算と一致しない患者負担額、拒否を示唆する調整コードなどです。それ以外はすべて出力に反映済みです。以前はEOB1件につき15〜20分かかっていたレビューが、今ではバッチ全体で数分で完了します。
患者請求サマリーを作成します。
統合された出力(サービスラインごとに1行、患者負担額を免責額・共同保険・自己負担額・合計負担額に分類)が、患者明細書の信頼できる情報源になります。計算列を使用すると、抽出ツール内で追加の計算を直接定義することもできます。たとえば、「残高=患者負担額-受領済み支払額」を計算する列などです。複数保険者のバッチワークフローについて詳しくは、医療請求チームが数百件のEOBからデータをバッチ抽出する方法に関する記事をご覧ください。
複数のプロバイダーや拠点からEOBを収集する必要があり、メインアカウントへのアクセスを全員に付与したくない診療所向けに、ImageToTable.aiはコレクションリンク機能を提供しています。共有可能なURLを生成し、プロバイダーや現場スタッフに送信すると、登録なしで直接処理キューにEOBをアップロードできます。
エクスポートと統合
抽出したEOB(給付明細書)データは、請求と照合が行われるシステムに届いて初めて役立ちます。診療所によってダウンストリームのニーズは異なり、適切な抽出ツールは最も一般的な送信先をサポートする必要があります。
ExcelまたはGoogle Sheets。 これは中小規模の診療所で最も一般的な送信先です。1回の抽出バッチで、患者名、CPTコード、請求額、許容額、保険会社支払額、患者負担額の内訳など、すべての重要フィールドがラベル付きの列にまとめられた構造化スプレッドシートが生成されます。このスプレッドシートは診療管理システムへのインポートや照合台帳としてすぐに使用できます。Google Sheetsを使用するチームには、ImageToTable.ai Google Sheetsアドオンがあり、Sheetsから離れることなく抽出データをアクティブなスプレッドシートに直接取り込めます。
診療管理システムおよびEHRシステム。 Epic、Cerner、Meditech、AdvancedMD、Kareo、NextGen、athenahealth、eClinicalWorksを使用する診療所は、通常、構造化データをエクスポートして、各システムの支払い転記モジュールにマッピングします。重要な要件は、エクスポートされたデータが一貫したスキーマで同じフィールドを含むことです。つまり、列ヘッダーがバッチ間で変わらず、保険者ごとの差異が正規化され、どの保険者がEOB(給付明細書)を発行したかに関係なく、ダウンストリームのインポートが統一されたデータ構造を認識できるようにすることです。
患者ポータル請求。 患者負担額が計算・検証されると、患者向けの金額が患者ポータルまたは請求明細システムに送られます。正確な患者負担額(自己負担金、コインシュアランス、コペイの正しい配分)はここで不可欠です。EOB(給付明細書)と一致しない請求明細は電話や問い合わせの原因になるためです。
EOB抽出ツールの選び方
すべての文書抽出ツールがEOB(給付明細書)に適しているわけではありません。これらの文書の特有の特性(保険者間のフォーマットのばらつき、密集した医療コード、複数要素からなる財務フィールド)により、候補は大幅に絞り込まれます。EOB抽出ソリューションを評価する際に最も重要な基準は以下のとおりです。
初回使用時のマルチペイヤー精度。 最も重要なテストはシンプルです。Blue CrossのEOB、AetnaのEOB、Medicareのリマittanceアドバイス、CignaのEOBを1つのバッチにアップロードし、同じ抽出設定で4つすべてに対して正確なデータが生成されるかを確認します。保険者ごとに個別のテンプレートが必要な場合や、各フォーマットのサンプル文書でトレーニングが必要なツールでは、抽出の利点が大幅に減少します。ImageToTable.aiのテンプレート不要のアプローチは、保険者ごとの設定が不要です。AIが各フィールドの意味を理解して文書を読み取るため、ページ上のどこに表示されていても問題ありません。
CPT/ICDコード認識精度。 手技コードと診断コードは、EOBの中で最もエラーが発生しやすいフィールドです。明確な視覚的区切りなしに連続するコード、2行目に続く切り詰められたコード、専用列ではなくセクションヘッダーに埋め込まれたコードなど、密集したコードを読み取る能力を実証しているツールを探してください。
患者負担額計算のサポート。 優れた抽出ツールは、個々のフィールドを出力するだけで計算をユーザーに任せることはありません。ImageToTable.aiの計算列機能を使用すると、患者負担額の計算を抽出の一部として定義できます。「患者合計 = 自己負担金 + コインシュアランス + コペイ + 非適用額」を計算列として指定すると、AIが抽出中にすべての行で計算します。これにより、それ自体がエラーを起こしやすい手動検証ステップが不要になります。
HIPAAコンプライアンスに関する考慮事項。EOB(給付明細書)には保護健康情報(PHI)が含まれています。患者名、会員ID、診断コード、その他HIPAAプライバシー規則およびセキュリティ規則の対象となる識別子です。EOBデータを処理するツールには、適切な保護措置が備わっている必要があります。ツールを評価する際は、安全なデータ送信(転送中および保存中のAES-256暗号化)、処理後の自動データ削除、PHIがベンダーのインフラストラクチャを通じて保存または送信される場合のビジネスアソシエイト契約(BAA)への対応を確認してください。これはコンプライアンス状況の説明であり、法的助言ではありません。特定のHIPAA義務については、組織のコンプライアンス責任者または法務部門にご相談ください。
バッチ処理と混在フォーマットへの対応。貴院が3社または4社以上の保険者からEOBを処理している場合(多くの医療機関が該当します)、ツールは混在フォーマットのバッチに対応する必要があります。10社の異なる保険者からのPDFフォルダを1回のアップロードで処理し、1つのスプレッドシートとして結果を得られるかどうかが、時間を節約できるツールと、さらなる作業を生むツールの違いです。
医療ユースケースにおける文書抽出ツールの広範な比較については、2026年に向けた医療向け文書抽出ツールのまとめをご覧ください。
EOBデータ抽出に関するよくある質問
1つの文書に複数患者が含まれるEOBからAIでデータを抽出できますか?
はい。複数患者が含まれるEOB(保険者が複数患者の請求を1つの文書にまとめたもの)は、手動抽出エラーの一般的な原因です。AIベースの抽出は文書全体を読み取り、患者識別子と診療明細の文脈上の関係に基づいて、どのサービス行がどの患者に属するかを特定し、それらを個別の出力行に分離します。これは、誤った割り当てが発生しやすい手動仕分けよりもはるかに信頼性が高くなります。
各保険者のEOB形式ごとにツールのトレーニングが必要ですか?
いいえ。ImageToTable.aiはテンプレートマッチングではなく、意味理解に基づいてEOBからデータを抽出します。UnitedHealthcareのような大手の全国保険者であれ、小規模な地域保険者であれ、どの保険者の最初のEOBも同じ設定で処理されます。トレーニングフェーズも、サンプル収集も、保険者ごとのテンプレート作成も一切不要です。
保険者がEOBのレイアウトを変更した場合はどうなりますか?
抽出は引き続き機能します。AIは位置ではなく意味によってデータを読み取るため、列の並べ替え、セクション見出しの移動、ヘッダーの再設計などのレイアウト変更があっても、抽出が壊れることはありません。これは、保険者がフォームを変更するたびに再設定が必要なテンプレートベースのOCRツールに対する根本的な利点です。
紙のコピーからスキャンされたEOBも抽出できますか?
はい。AIはデジタルPDFだけでなく、スキャンされた画像や印刷されたEOBの写真も処理します。一般的なケースとしては、小規模な保険者から郵送で届く紙のEOB、紹介元プロバイダーからファックスで送られるコピー、患者が払い戻し申請のために撮影したEOBの写真などがあります。抽出精度は画像品質に依存します(200 DPI以上の鮮明なスキャンが最良の結果をもたらします)が、VLM(視覚言語モデル)はスキャン文書の一般的な劣化に対応できるよう設計されています。
EOBのCARCおよびRARCリマークコードはどのように処理されますか?
AIはEOBから調整理由コードとリマークコードを読み取り、抽出フィールドとして出力します。一部の保険者はこれらのコードを平文で埋め込む一方、他の保険者は数値コード値を使用するため、抽出ではコードと、利用可能な場合には付随する説明テキストの両方を取得します。出力は、拒否と調整を分類してレポートや不服申し立ての追跡に使用できます。
このツールはHIPAA準拠ですか?
ImageToTable.aiは、転送中(TLS)および保存時(AES-256)の暗号化で文書を処理します。匿名ユーザーがアップロードしたファイルは処理後に自動的に削除され、ログインユーザーのファイルはプランの保持期間中のみ保持された後、完全に削除されます。抽出された文書ワークフローでHIPAA準拠を文書化する必要がある医療提供者向けに、ビジネスアソシエイト契約(BAA)もご利用いただけます。医療データ処理ツール全般に言えることですが、組織のポリシーに照らして特定のセキュリティおよびコンプライアンス文書を確認し、コンプライアンス責任者にご相談ください。
EOB(給付明細書)とERAの抽出の違いは何ですか?
ERA(電子送金通知)は、HIPAA標準の電子取引(ASC X12 835)であり、EOBと同じ保険金支払い情報を機械可読形式で伝えます。ERAは、最小限の手動作業で診療管理システムに自動転記できます。EOBは通常、患者または医療提供者向けの紙またはPDF文書です。抽出は、PDFのEOBをERAのように動作させる方法です。つまり、視覚的なデータを構造化された機械可読な出力に変換します。ほとんどの診療所では、主要な保険者からのERAと、その他の保険者からのPDFのEOBを混在して受け取るため、完全な収益サイクルワークフローでは両方に対応する必要があります。
自動抽出のコストに見合うEOBの月間処理数はどのくらいですか?
月間200件以上のEOBを処理する診療所では、自動抽出による人件費削減で、通常は最初の月にツールコストを回収できます。その閾値を下回る場合、削減額は小さくなりますが、少人数の請求チームにとって節約できる時間は依然として重要です。200件のEOBを1件あたり15分で処理すると、月50時間のデータ入力作業に相当し、その時間をより価値の高い業務に振り向けることができます。
このツールはEpic、AdvancedMD、Kareoと連携しますか?
ImageToTable.aiは、構造化された支払いデータを受け入れる任意の診療管理システムまたはEHRシステムにインポートできるExcel形式でデータをエクスポートします。自動転記が必要なチーム向けには、直接API統合も利用可能です。完全なノーコードワークフローには、Google Sheetsアドオンを使用すると、抽出結果を請求システムに取り込むスプレッドシートに直接反映できます。
労災保険の保険者からEOB(給付明細書)を抽出できますか?
はい、できます。労災保険のEOB(給付明細書)は異なる請求ルールを使用し、各州の労災制度に固有の医療費スケジュール調整が含まれることがよくあります。AIは商業保険者のドキュメントと同じ方法でこれらのEOB(給付明細書)を読み取ります。つまり、フィールドを意味的に理解します。UnitedHealthcareのEOB(給付明細書)を処理するのと同じ抽出設定で、州固有の保険者からの労災EOB(給付明細書)も処理できます。
次のステップ:手作業から構造化へ
EOB(給付明細書)処理の計算は単純ですが、コストが人件費、エラー修正、患者からの問い合わせ対応、照合など複数の予算項目に分散しているため、見落とされがちです。どの項目も単独ではプロセス変更を促すほど大きくありません。しかし、これらを合わせると、収益サイクルのパフォーマンスに大きな負担をかけています。
手動入力からAI搭載の抽出への移行には、収益サイクルプラットフォームの全面交換、新しいEHRシステム、IT部門の関与は必要ありません。1つのバッチから始まります。昨日処理したEOB(給付明細書)をアップロードし、あればいいのにと思う列を定義し、出力がチームが入力した内容と一致するかを確認します。結果がよりきれいで速ければ、そこからケースは拡大していきます。
EOB(給付明細書)に記載されている内容と請求システムに入力される内容とのギャップ — HFMA(Healthcare Financial Management Association)の調査による35%のエラー率 — は、人の問題ではありません。それは、明確な技術的解決策があるプロセスの問題です。