So extrahieren Sie Daten aus Schüleranmeldeformularen
in Excel für Schülerinformationssysteme von Schulbezirken
Jeden August kommt das Papier. Ein mittelgroßer K-12-Bezirk mit 5.000 Schülern erhält Anmeldepakete für etwa 20 % seiner Bevölkerung – Familien, die sich persönlich angemeldet haben, Formulare bei Sommer-Registrierungsveranstaltungen eingereicht haben oder deren Muttersprache vom Online-Portal nicht unterstützt wird. Jedes Paket umfasst 15 bis 25 Seiten: Schülerdemografie, Kontaktdaten der Eltern, Notfallkontakte, medizinische Angaben, Impfbescheinigungen, Busbeförderungsanträge, Foto-Einwilligungen, Technologienutzungsvereinbarungen, Handbuch-Bestätigungen. Multipliziert man das mit tausend Schülern, wird die Rechnung im Sekretariat einfach: Tausende Seiten, jede einzelne erfordert, dass ein Mensch jedes Feld liest, die Handschrift entziffert, die Kästchen ankreuzt und alles in PowerSchool, Infinite Campus oder Skyward eintippt.
Der Engpass liegt nicht darin, dass die Daten nicht existieren. Sondern darin, dass die Daten auf Papier in einem Dutzend verschiedener Feldformate vorliegen – und Ihr SIS sie als strukturierte Zeilen benötigt. Dieser Leitfaden beschreibt einen praktischen Workflow, der diese Lücke schließt: Formulare scannen, Ausgabespalten einmal definieren und semantische KI jeden Feldtyp in eine Tabellenkalkulation extrahieren lassen, die für den SIS-Import bereit ist.
Wichtigste Erkenntnisse
- 333 Stunden – so viel kostet das Abtippen von tausend Papieranmeldepaketen in PowerSchool Ihren Bezirk jeden August.
- Herkömmliche OCR liest Handschrift Zeichen für Zeichen, kann aber nicht erkennen, ob eine Telefonnummer zum Notfallkontakt oder zum Elternteil gehört – die einzige Unterscheidung, die Ihr SIS tatsächlich benötigt.
- Definieren Sie 28 Spaltennamen einmal, scannen Sie 200 Pakete als einen Stapel und erhalten Sie eine fertige Tabellenkalkulation für den Import – Ihr Personal wechselt vom erneuten Abtippen jedes Feldes zur Stichprobenprüfung nur der risikoreichsten Zeilen.
Das Papier-Anmeldeformular bleibt – und das hat seine Gründe
Online-Portale gibt es. PowerSchool Enrollment – in über 3.500 Schulbezirken im Einsatz – bietet mobile Formulare, Bedingungslogik, automatische Übernahme von Geschwisterdaten und direkte SIS-Synchronisation. Infinite Campus Online Registration verspricht „keine Dateneingabe – nur noch Klicken zum Bestätigen". Die Botschaft der Anbieter ist einheitlich: Weg mit dem Papier, und das Problem der Dateneingabe löst sich von selbst.
Diese Botschaft übersieht, wie die Anmeldung in der Praxis tatsächlich abläuft. Ein erheblicher Teil der Familien in jedem Bezirk füllt Papierformulare aus – und die Gründe dafür sind struktureller Natur, nicht vorübergehend.
Sprachbarrieren. PowerSchool Enrollment unterstützt mehrere Sprachen, aber der gesamte Anmelde-Workflow – von der Portalnavigation über das Ausfüllen der Formulare bis zum Hochladen von Dokumenten – setzt ein Maß an digitaler Kompetenz und Englischkenntnissen voraus, das nicht jede Familie mitbringt. In Bezirken, in denen 15 % oder mehr der Familien zu Hause eine andere Sprache als Englisch sprechen, bleiben Papierformulare, die mit Hilfe zweisprachiger Mitarbeiter im Schulsekretariat ausgefüllt werden, der zugänglichste Weg.
Persönliche Anmeldeveranstaltungen. Der „Anmeldetag" in der Turnhalle – Tische, Stapel leerer Pakete, Familien, die im Stehen Formulare ausfüllen – findet in Hunderten von Bezirken jeden August immer noch statt. Für Familien, die ohne Gerät, ohne Internetverbindung oder einfach deshalb kommen, weil sie über den Sommer in den Bezirk gezogen sind und das Online-Portal noch nicht auf dem neuesten Stand ist, ist Papier der universelle Notfallplan.
Digitale Zugangslücken. Laut dem National Center for Education Statistics waren im Herbst 2023 etwa 49,5 Millionen Schüler an öffentlichen K-12-Schulen in den USA eingeschrieben. Bei Haushalten mit schulpflichtigen Kindern haben schätzungsweise 5 % bis 8 % keinen zuverlässigen Breitbandzugang zu Hause. Wenn der einzige Weg, eine Anmeldefrist einzuhalten, darin besteht, ein Papierpaket im Bezirksbüro auszufüllen, dann tun die Familien das.
Aktualisierungen für wiederkehrende Schüler. Online-Portale bewältigen die Anmeldung neuer Schüler gut. Was sie weniger gut bewältigen, sind die jährlichen Aktualisierungsformulare, die jede wiederkehrende Familie ausfüllen muss – aktualisierte Notfallkontakte, neue medizinische Informationen, erneute Einwilligungen für Foto- und Medienfreigaben. Viele Bezirke verschicken diese als Papierpakete, weil der Workflow für wiederkehrende Schüler im SIS-Portal umständlich ist, ein Elternkonto erfordert, das viele Familien nie angelegt haben, oder in älteren SIS-Versionen, die in kleineren Bezirken noch laufen, schlichtweg nicht existiert.
Das Ergebnis: Selbst Bezirke, die in Online-Anmeldung investiert haben, verarbeiten jeden August immer noch Papierformulare. Die Frage ist nicht „wie schaffen wir das Papier ab" – sondern „wie bekommen wir die Daten effizient vom Papier, sobald es da ist."
Was in einem K-12-Anmeldepaket steckt – und warum jeder Abschnitt eine eigene Extraktionsherausforderung darstellt
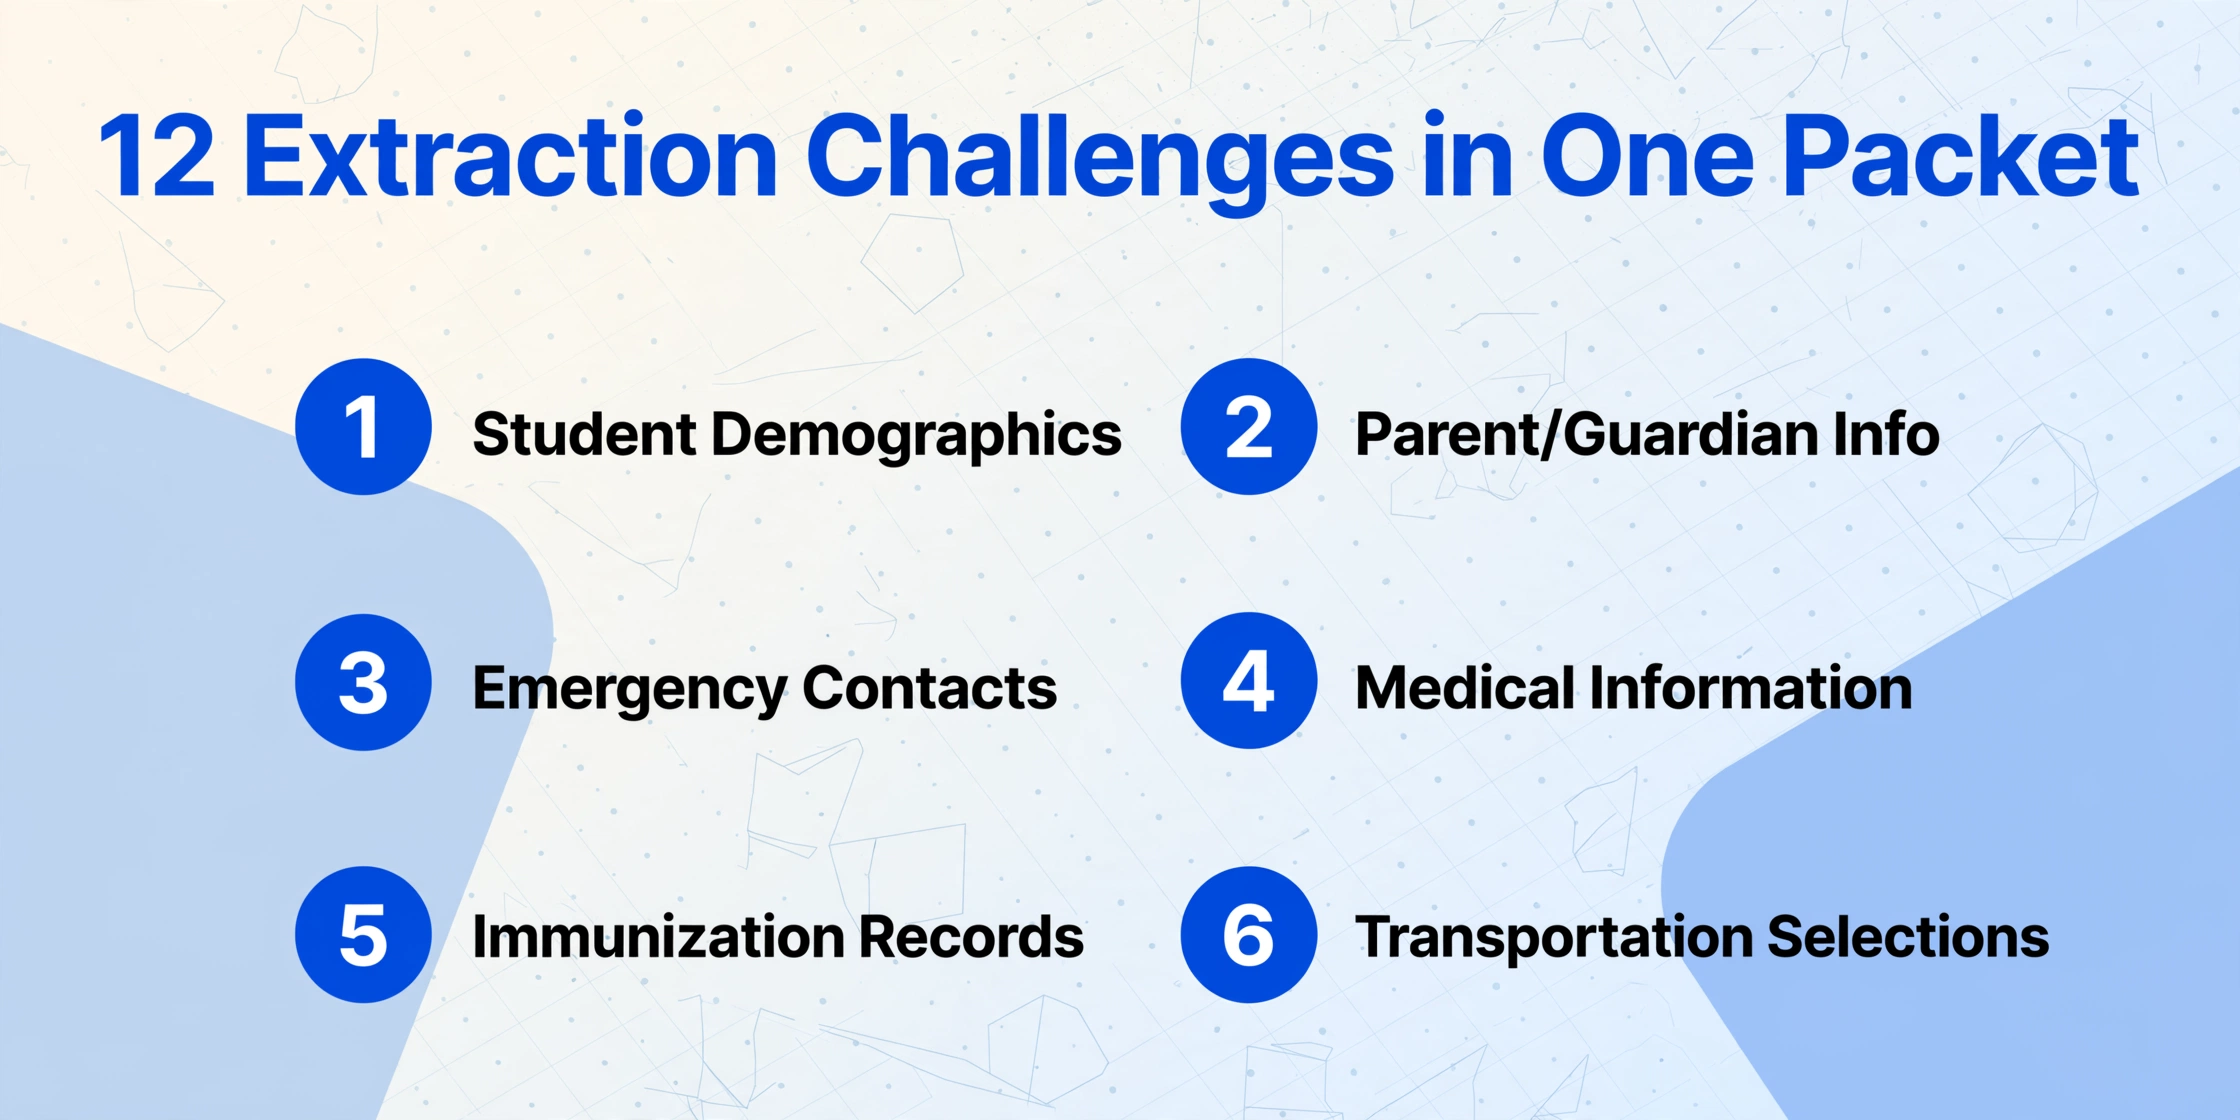
Ein einzelnes Schüleranmeldepaket ist kein einziges Datenextraktionsproblem. Es sind zwölf verschiedene Extraktionsprobleme, jeweils mit einem anderen Feldformat, auf Seiten, die dafür konzipiert wurden, in einer überfüllten Turnhalle von Hand ausgefüllt zu werden. Die Feldtypen zu verstehen – und warum jeder einzelne die traditionelle OCR überfordert – ist die Voraussetzung für die Einrichtung eines funktionierenden Extraktionsworkflows.
| Abschnitt | Typische Felder | Feldformat | OCR-Schwierigkeit |
|---|---|---|---|
| Schülermerkmale | Vollständiger Name, Geburtsdatum, Geschlecht, eintretende Klassenstufe, Wohnadresse | Gedruckt oder handschriftlich in Textfeldern | Mittel – handschriftliches Geburtsdatum und Adresse sind die häufigsten Fehlerquellen |
| Eltern/Erziehungsberechtigte 1 & 2 | Name, Beziehung, Telefon, E-Mail, Arbeitgeber, Arbeitstelefon | Gedruckter/handschriftlicher Text, mehrzeilige Blöcke | Mittel – mehrere Kontakte auf einem Formular erfordern Feldzuordnung |
| Notfallkontakte | Name, Beziehung, primäre Telefonnummer, alternative Telefonnummer (2–3 Kontakte) | Handschriftlicher Text, oft abgekürzt | Hoch – abgekürzte Beziehungsbezeichnungen und handschriftliche Telefonnummern verwirren die zeichenbasierte OCR |
| Medizinische Informationen | Allergien, Medikamente, chronische Erkrankungen, Name/Telefon des Arztes, Krankenhauspräferenz | Handschriftlich in narrativen Blöcken | Hoch – Freitext zu medizinischen Zuständen ohne einheitlichen Wortschatz |
| Impfaufzeichnungen | Impfstofftyp, Verabreichungsdatum, Anbieter (oft ein Scan eines separaten staatlichen Formulars) | Strukturierte Tabelle auf einem staatlichen Formular | Hoch – kleiner Tabellentext, manchmal ein Scan einer Kopie |
| Transport | Bus-/Autofahrer-/Fußgängerauswahl, Busroutennummer, AM/PM-Zeitplan | Kontrollkästchen + gedruckte Routennummern | Mittel – Kontrollkästchenerkennung + Feldzuordnung über Spalten hinweg |
| Mittagsprogramm | Antrag auf Berechtigung für kostenlose/ermäßigte Mahlzeiten, Haushaltseinkommen, Fallnummer | Kontrollkästchen + handschriftliche Einkommensfelder | Hoch – vertrauliche Finanzdaten mit Einträgen in kleinen Feldern |
| Nutzungsvereinbarung für Technologie | Schülername, Elternname, Datum, Unterschrift der Eltern | Gedruckter Text + handschriftliche Unterschriftszeile | Niedrig – hauptsächlich Kontrollkästchen und Unterschrift, minimale strukturierte Daten zu extrahieren |
| Foto-/Medienfreigabe | Opt-in/Opt-out-Kontrollkästchen, Schülername, Unterschrift der Eltern, Datum | Kontrollkästchen + Unterschriften | Niedrig – binäre Einwilligung, geringe Extraktionslast |
| Bestätigung des Handbuchs | Schülername, Klassenstufe, Elternname, Unterschrift, Datum | Gedruckt + Unterschrift | Niedrig – nur Bestätigung, keine strukturierten Daten |
| Umfrage zur häuslichen Sprache | Primäre zu Hause gesprochene Sprache, weitere Sprachen, bevorzugte Sprache der Eltern | Handschriftliche Einträge + Kontrollkästchenauswahl | Mittel – Sprachnamen sind kurze Felder, aber oft handschriftlich |
Was ein Anmeldeformular für herkömmliche OCR besonders schwierig macht, ist die Mischung verschiedener Feldtypen auf einer einzigen Seite. Auf einem Blatt finden Sie möglicherweise gedruckten Text (die eigenen Beschriftungen des Formulars), handschriftliche Antworten in Druckschrift, handschriftliche Antworten in Schreibschrift, angekreuzte Kästchen, eingekreiste Optionen und eine Unterschrift – alles nur wenige Zentimeter voneinander entfernt. Herkömmliche OCR liest Zeichen. Sie versteht nicht, dass eine Telefonnummer, die im Feld „Notfallkontakt-Telefon“ eingetragen ist, zum Notfallkontakt gehört und nicht zu den Eltern – und diese Unterscheidung ist wichtig, wenn die Daten in einem SIS landen, das für jeden Eintrag separate Datenbankfelder hat.
Semantische KI-Extraktion schließt diese Lücke, indem sie versteht, was jedes Feld bedeutet, nicht nur, was es sagt. Wenn Sie eine Spalte namens „Notfallkontakt 1 – Telefonnummer“ definieren, sucht die KI im Notfallkontakt-Abschnitt des Formulars nach einer Telefonnummer und ordnet sie dem ersten Kontakt zu, nicht der Arbeitsnummer der Eltern zwei Abschnitte weiter oben. Dies ist der grundlegende Unterschied zwischen Zeichenerkennung und Dokumentverständnis – und der Grund, warum Anmeldeformulare vom semantischen Ansatz mehr profitieren als die meisten Dokumenttypen. Für einen tieferen Einblick, wie FERPA den Moment regelt, in dem Schülerdaten in eine KI-Verarbeitungspipeline gelangen, lesen Sie unseren FERPA-Compliance-Leitfaden zur Dokumentextraktion im Zulassungsverfahren.
Vom Papierpaket zur SIS-bereiten Tabelle: Der 3-Schritte-Workflow
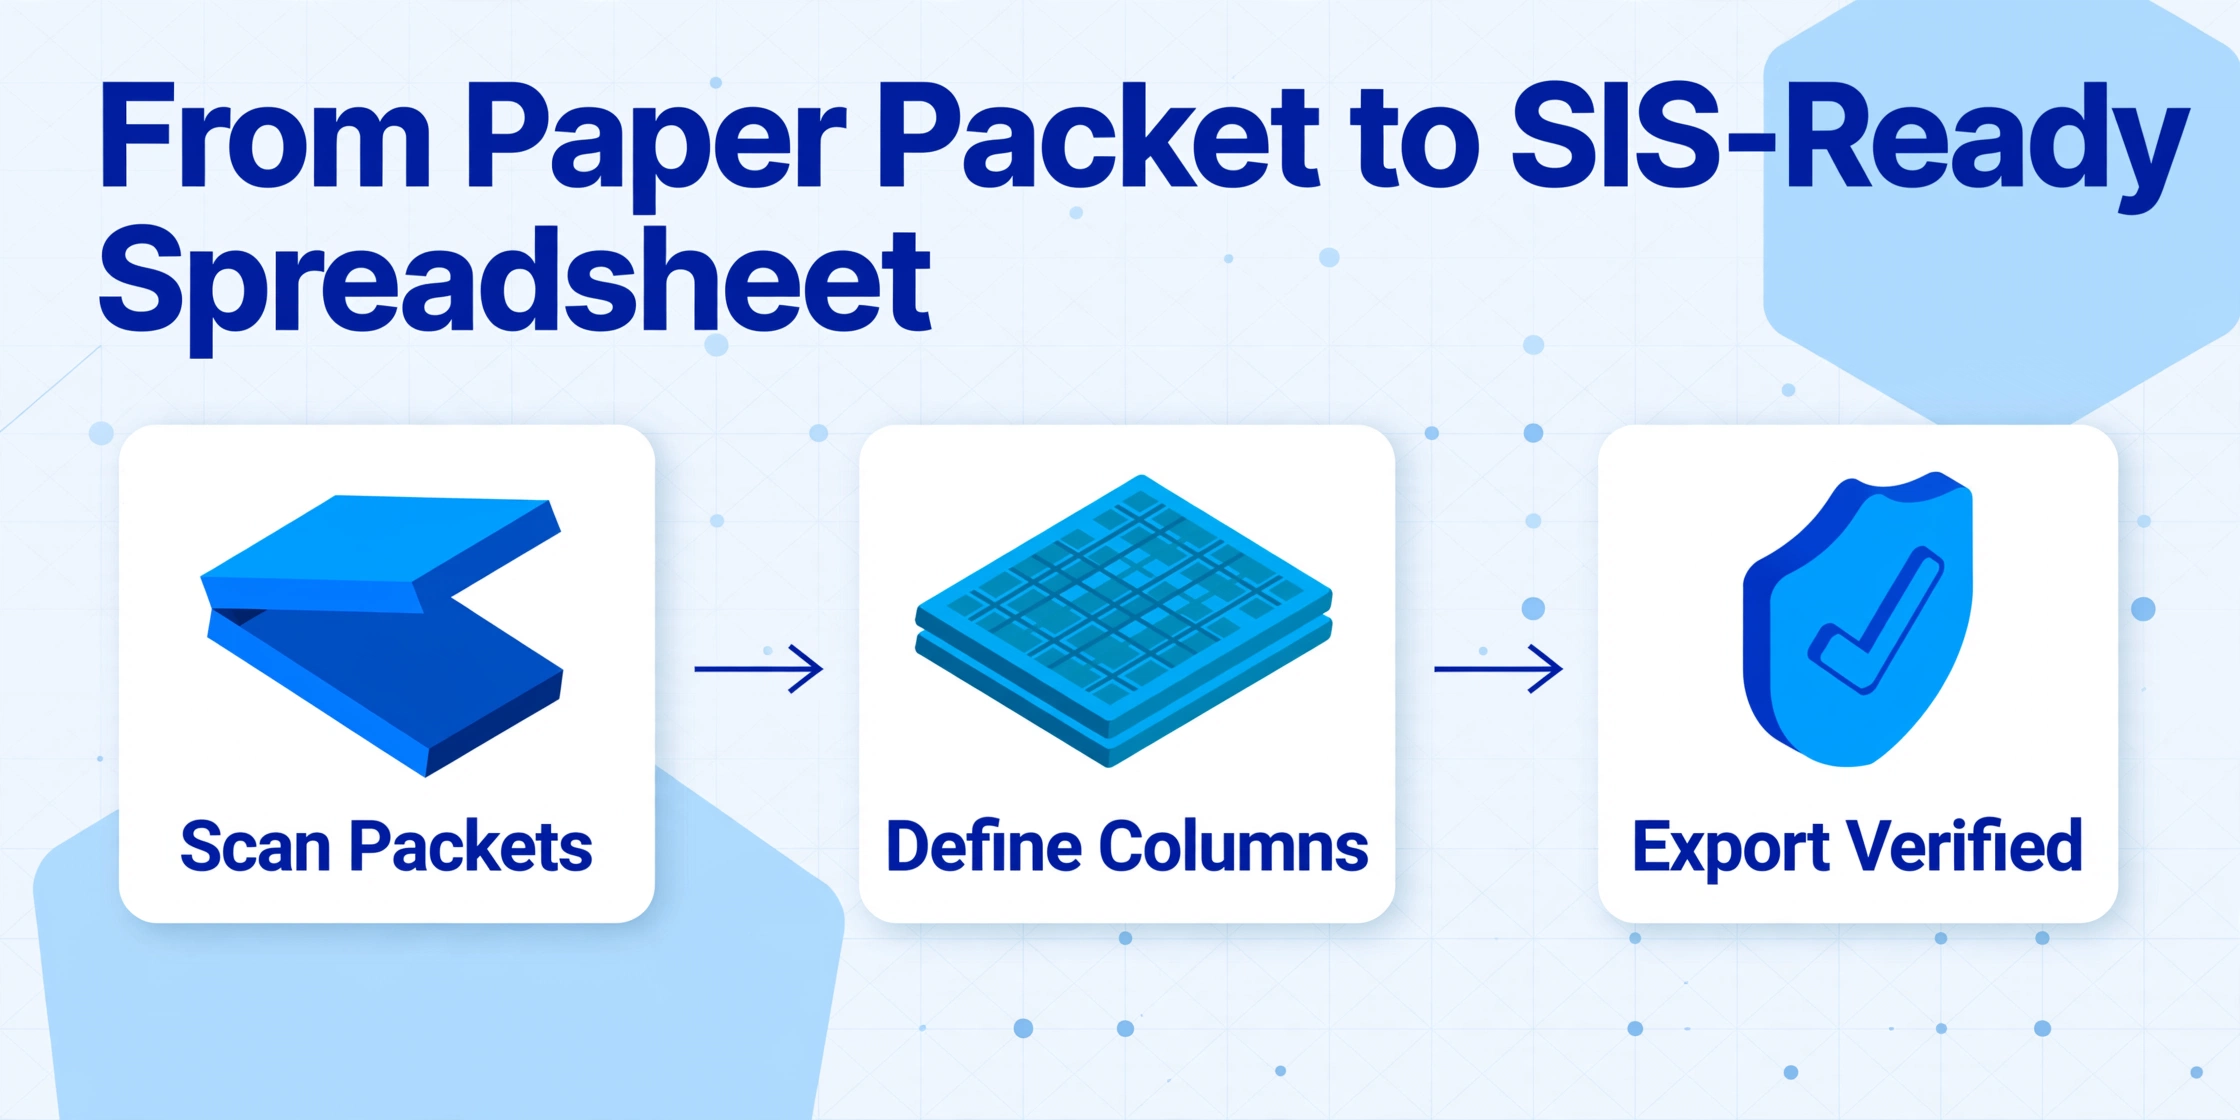
Der Kern-Workflow ist so unkompliziert, dass ihn ein Mitarbeiter im Front Office ohne IT-Unterstützung durchführen kann. Die meiste Überlegung erfordert die Spalteneinrichtung – wenn diese stimmt, läuft die Extraktion von selbst.
Schritt 1: Einscannen der Anmeldepakete
Scannen Sie alle Seiten des Pakets jedes Schülers in ein einzelnes mehrseitiges PDF pro Schüler. Stellen Sie den Scanner auf 300 DPI Graustufen ein – Farbe erhöht die Dateigröße ohne nennenswerte Genauigkeitsvorteile bei den meisten Anmeldeformular-Layouts, während Schwarzweiß den feinen Kontrast verliert, der ein Kontrollkästchen von einem Fleck unterscheidet.
Die Benennungskonvention ist wichtig. Benennen Sie jede Datei [Grade]_[LastName]_[FirstName].pdf. Dieses Benennungsmuster dient zwei Zwecken: Es liefert eine eindeutige Kennung für jede Datei und ermöglicht es Ihnen später, extrahierte Daten bei Stichprobenprüfungen mit dem Quelldokument abzugleichen, ohne jedes PDF öffnen zu müssen.
Wenn Formulare bereits geheftet als ein Paket pro Schüler eintreffen, scannen Sie die Unterlagen jedes Schülers als ein Dokument. Wenn der Bezirk Formulare nach Typ organisiert – alle medizinischen Formulare zusammen, alle Transportformulare zusammen – benötigen Sie einen anderen Arbeitsablauf, aber dieses Muster ist bei der K-12-Anmeldung selten, wo das Paket nach Schüler und nicht nach Formulartyp organisiert ist.
Schritt 2: Definieren Sie Ihre Ausgabespalten
Hier wird das Verhalten des Extraktionstools programmiert – nicht mit Code oder Vorlagen, sondern indem Sie genau festlegen, welche Felder Sie in Ihrer endgültigen Tabelle möchten. Die Spaltennamen, die Sie eingeben, werden sowohl zu den Anweisungen für die KI als auch zu den Kopfzeilen Ihrer Ausgabetabelle.
Für ein K-12-Anmeldeformular sieht ein praktischer Spaltensatz wie folgt aus:
Empfohlener Spaltensatz für K-12-Anmeldeformulare
Student Last Name
Student First Name
Student Date of Birth
Grade Entering
Home Street Address
Home City
Home State
Home ZIP
Parent/Guardian 1 Full Name
Parent/Guardian 1 Relationship
Parent/Guardian 1 Primary Phone
Parent/Guardian 1 Email
Parent/Guardian 2 Full Name
Parent/Guardian 2 Relationship
Parent/Guardian 2 Primary Phone
Emergency Contact 1 Name
Emergency Contact 1 Relationship
Emergency Contact 1 Phone
Emergency Contact 2 Name
Emergency Contact 2 Relationship
Emergency Contact 2 Phone
Medical Conditions / Allergies
Primary Care Physician Name
Primary Care Physician Phone
Transportation Method (Bus / Car Rider / Walker)
Bus Route Number (if applicable)
Photo/Media Consent (Yes / No)
Technology Use Agreement Signed (Yes / No)
Handbook Acknowledgment Signed (Yes / No)
Einige Hinweise zur Spaltengestaltung für Anmeldeformulare:
Trennen Sie Vor- und Nachnamen. SIS-Plattformen speichern Schülernamen in separaten Feldern. Extrahieren Sie sie von Anfang an getrennt, und Sie vermeiden einen manuellen Trennungsschritt in Excel – ein Schritt, der fehlschlägt, wenn Sie auf Bindestrich-Nachnamen, in das Vornamenfeld geschriebene Mittelnamen oder kulturelle Namenskonventionen stoßen, die nicht der westlichen Reihenfolge Vor- und Nachname folgen.
Verwenden Sie abgeleitete Spalte für binäre Felder. Für Einwilligungskontrollkästchen – Foto-Freigabe, Technologienutzungsvereinbarung, Handbuch-Bestätigung – definieren Sie Ihre Spalte mit den Optionen in Klammern: Photo/Media Consent (Yes / No). Die KI liest den Kontrollkästchenstatus auf dem Formular und gibt entsprechend „Ja“ oder „Nein“ aus. Sie müssen keine Kontrollkästchen-Koordinaten extrahieren oder eine Pixel-für-Pixel-Erkennung versuchen – die KI liest die Bedeutung des Formulars, nicht seine Pixel.
Fügen Sie den SIS-Feldnamen als Hinweis hinzu. Wenn Ihr Bezirk PowerSchool verwendet, lautet das Feld für Bustransport oft „Transportation Method“ im Dropdown-Menü. Wenn Sie Ihre Spalte Transportation Method (Bus / Car Rider / Walker) benennen, geben Sie der KI sowohl das semantische Ziel als auch die gültigen Optionen. Es bedeutet auch, dass die Spaltenüberschrift in Ihrer Ausgabe-Excel-Datei mit der Feldbezeichnung in Ihrer SIS-Importvorlage übereinstimmt – ein Schritt weniger beim Hochladen.
Eine ausführliche Anleitung zum Definieren von Extraktionsspalten für jeden Dokumenttyp finden Sie in unserem Leitfaden zum Extrahieren von Schülerzeugnissen in Excel, der Spaltendesign-Muster abdeckt, die gleichermaßen für Anmeldeformulare gelten.
Schritt 3: Verarbeiten und Exportieren ins SIS
Laden Sie alle gescannten PDFs in einem Batch hoch. Das Tool verarbeitet jede Datei anhand Ihrer Spaltendefinitionen – extrahiert Schülernamen, Kontaktdaten, medizinische Informationen, Einwilligungsstatus – und führt die Ausgabe in einer einzigen Tabelle zusammen, in der jede Zeile einem Schüler entspricht.
Das Ausgabeformat, das für den SIS-Import relevant ist, ist Excel (.xlsx), das PowerSchool, Infinite Campus und Skyward alle nativ akzeptieren. Wenn Ihr SIS CSV mit einer bestimmten Spaltenreihenfolge erfordert, exportieren Sie als CSV und ordnen Sie die Spalten in der Oberfläche des Tools neu an, bevor Sie sie herunterladen.
Überprüfen Sie die ersten fünf Zeilen stichprobenartig anhand der Original-PDFs. Achten Sie besonders auf Notfallkontakt-Telefonnummern – eine vertauschte Ziffer in einem Notfallkontaktfeld ist der Fehler mit dem höchsten Risiko im gesamten Anmeldeablauf. Wenn Ihr Tool es Ihnen ermöglicht, jede Datei mit der Schülerkennung zu benennen, bietet die Dateinamensspalte in der Ausgabe für jede Zeile einen Ein-Klick-Verweis zurück zum Quelldokument.
Handschrift, Kontrollkästchen und Unterschriften: Die drei Formularelemente, die herkömmliche OCR überfordern
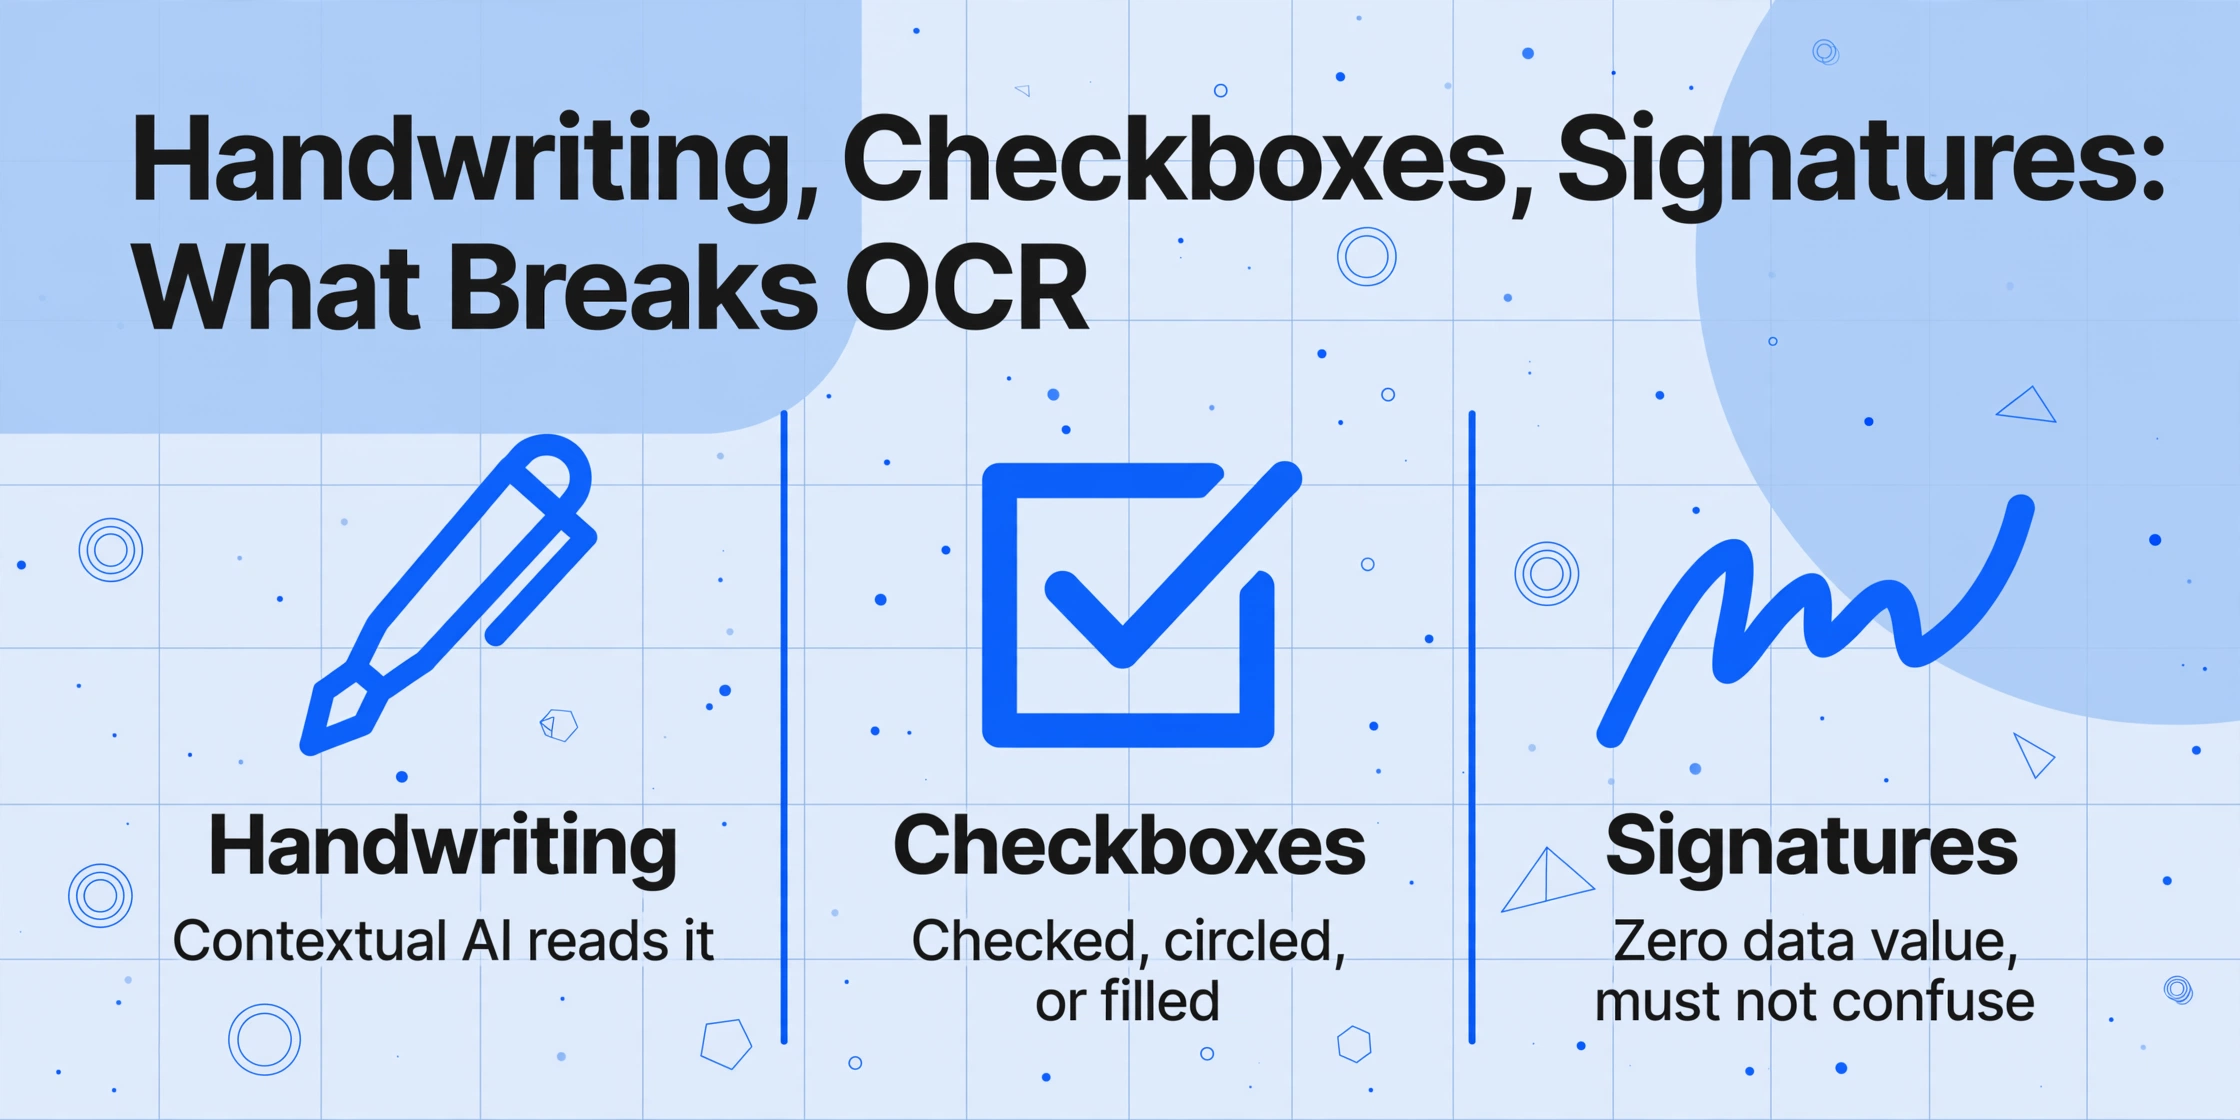
Die meisten OCR-Tools wurden für gedruckten Text auf sauberem weißem Hintergrund entwickelt. K-12-Anmeldeformulare werden von Eltern ausgefüllt, die mit einem Klemmbrett in einer Turnhalle stehen – die Handschrift ist uneinheitlich, Kontrollkästchen sind manchmal angekreuzt, manchmal eingekreist, manchmal vollständig ausgefüllt, und jede Seite enthält mindestens eine Unterschrift, die keinen extrahierbaren Datenwert hat, aber das Tool nicht dazu verleiten darf, Unsinn auszugeben.
Handschriftliche Felder. Die Felder mit der höchsten Handschriftquote auf Anmeldeformularen – Telefonnummern der Eltern, Namen von Notfallkontakten, medizinische Bedingungen – sind auch die Felder, in denen ein Fehler die schwerwiegendsten Folgen hat. Eine falsch getippte Telefonnummer eines Elternteils bedeutet, dass die Schule die Familie im Notfall nicht erreichen kann. Eine falsch gelesene Allergieangabe hat medizinische Auswirkungen.
Semantische KI verarbeitet Handschrift anders als OCR auf Zeichenebene. Statt zu versuchen, jede Buchstabenform unabhängig zu identifizieren und zu Wörtern zusammenzusetzen – der Ansatz, der aus einem handschriftlichen „Amy" ein „Emily" macht, wenn die Anfangsbuchstabenschleife mehrdeutig ist – liest die KI den visuellen Kontext des gesamten Felds. Sie erkennt einen Block handschriftlichen Texts im Abschnitt „Name des Notfallkontakts" und versteht, dass dieser Block einen Personennamen in dem Format ergeben sollte, das der Elternteil beabsichtigt hat, wobei die umgebenden gedruckten Feldbeschriftungen als semantische Anker dienen, um unklare Handschrift zu disambiguieren.
Dieses kontextuelle Lesen macht den Unterschied zwischen 70 % Handschriftgenauigkeit bei isolierten Textblöcken und über 95 % bei Formularfeldern mit klarem semantischem Kontext. Weitere Informationen zu den Genauigkeitsfaktoren bei der KI-Extraktion finden Sie in unserem praktischen Leitfaden zur Verbesserung der OCR-Genauigkeit.
Kontrollkästchen. Anmeldeformulare enthalten zwischen 5 und 15 Kontrollkästchen – Auswahl der Transportmethode, Berechtigung für das Mittagsprogramm, Foto-Einwilligung, Technologievereinbarung, Handbuch-Bestätigung. Herkömmliche OCR ignoriert Kontrollkästchen entweder vollständig oder erzeugt „☐"-Zeichen, die in einer Tabelle bedeutungslos sind.
Semantische KI liest Kontrollkästchen als binäre Zustände, indem sie deren Position relativ zu beschrifteten Optionen versteht. Wenn das Formular „Transportation: ☐ Bus ☐ Car Rider ☐ Walker" angibt und ein Kästchen markiert ist, erkennt die KI, welche Beschriftung dem markierten Kästchen entspricht, und gibt den Beschriftungstext aus — „Bus" — nicht ein Kontrollkästchenzeichen.
Unterschriften. Jedes Anmeldepaket enthält die Unterschriften der Eltern für die Technologievereinbarung, die Medienfreigabe und die Bestätigung des Handbuchs. Unterschriften enthalten keine extrahierbaren Daten — der Name eines Elternteils sollte aus dem Feld für den gedruckten Namen extrahiert werden, nicht aus einem kursiven Gekritzel. Traditionelle OCR erzeugt jedoch oft eine verstümmelte Zeichenfolge aus der Unterschriftszeile.
Die praktische Lösung: Definieren Sie Ihre Spalten so, dass der Name des Elternteils aus dem demografischen Abschnitt extrahiert wird, nicht aus der Unterschriftszeile. Wenn Sie bestätigen müssen, dass ein Formular unterschrieben wurde, definieren Sie eine binäre Spalte wie Parent Signature Present (Yes / No) — die KI kann das Vorhandensein einer Unterschrift erkennen, ohne sie zu lesen. So erhalten Sie den Prüfpfad ohne Extraktionsrauschen.
Verarbeitung der Anmeldeformulare einer gesamten Klassenstufe als ein Batch
Der eigentliche Effizienzgewinn liegt nicht darin, ein Anmeldeformular schneller zu extrahieren — sondern darin, hundert Anmeldeformulare zu extrahieren und eine einzige Tabelle zu erhalten.
In einem traditionellen Dateneingabe-Workflow wird jedes Paket unabhängig verarbeitet: PowerSchool öffnen, einen neuen Schülerdatensatz anlegen, die demografischen Felder eingeben, die Elternteilkontakte eingeben, die Notfallkontakte eingeben, die medizinischen Informationen eingeben, die Einwilligungskästchen ankreuzen, speichern, zum nächsten Paket wechseln. Bei einem gemessenen Tempo von 20 Minuten pro Paket — jede Zeile auf Genauigkeit prüfen, die handschriftlichen Felder gegenprüfen, den unvermeidlichen Tippfehler korrigieren — sind tausend Pakete 333 Mitarbeiterstunden.
Die Batch-Extraktion kehrt dies um. Sie erledigen die Papierarbeit einmal — alle Pakete scannen — und die Extraktion läuft über alle als ein einziger Auftrag. Das Ergebnis ist eine Tabelle mit tausend Zeilen, jede Zeile ein vollständiger Schüleranmeldedatensatz. Die Mitarbeiterzeit verlagert sich von der Dateneingabe zur Datenprüfung: Tabelle öffnen, die Notfallkontaktfelder stichprobenartig prüfen, die medizinischen Kennzeichnungen verifizieren und alle Zeilen markieren, die vor dem SIS-Import eine menschliche Prüfung benötigen.
Dieser Workflow spiegelt wider, wie Zulassungsstellen Transkripte in großem Umfang verarbeiten. Für das vollständige Bild, wie Batch-Verarbeitung im Bildungskontext funktioniert, lesen Sie unseren Leitfaden zur Batch-Verarbeitung von Transkripten in eine Zulassungsdatenbank — die Pipeline-Architektur ist dieselbe, nur mit Anmeldedaten statt Kursnoten.
Häufig gestellte Fragen
Funktioniert das mit Formularen, die in anderen Sprachen als Englisch ausgefüllt werden?
Ja, mit einer wichtigen Einschränkung. Die KI liest handschriftliche und gedruckte Texte in den meisten gängigen Sprachen, einschließlich Spanisch – der häufigsten nicht-englischen Sprache auf US-amerikanischen K-12-Einschreibungsformularen. Die Spaltennamen, die Sie definieren, sollten jedoch auf Englisch sein, wenn Ihr SIS englische Feldbezeichnungen erwartet. Die KI extrahiert den spanischen handschriftlichen Text und platziert ihn in der entsprechenden englischen Spalte – „Nombre del Estudiante" auf dem Formular wird zu „Student First Name" in Ihrer Tabelle.
Für Bezirke, die Einschreibungsformulare in mehreren Sprachen anbieten: Definieren Sie Ihre Spalten einmal in der Sprache, die Ihr SIS erwartet, und die Extraktion funktioniert unabhängig davon, welche Sprachversion des Formulars jede Familie ausgefüllt hat.
Was ist, wenn ein Schüler mehr als zwei Notfallkontakte hat, die wir als Spalten definiert haben?
Definieren Sie so viele Notfallkontakt-Spalten, wie das Maximum in Ihren Formularen vorkommt. Wenn die meisten Pakete zwei Notfallkontakte haben, einige aber drei, definieren Sie drei Sätze von Notfallkontakt-Spalten — Name, Beziehung und Telefon für jeden. Die KI lässt die Felder des dritten Kontakts für Pakete mit nur zwei Kontakten leer. Sie müssen den Batch nicht erneut verarbeiten oder aufteilen.
Wie genau ist die Handschrifterkennung bei Anmeldeformularen?
Gedruckter Text auf Anmeldeformularen — die eigenen Beschriftungen des Formulars, ausgefüllte Felder in ausfüllbaren PDFs — erreicht eine Genauigkeit von nahezu 99 %. Handschriftliche Felder hängen von der Lesbarkeit der Handschrift ab, aber bei strukturierten Formularen mit klaren Feldgrenzen (wie Anmeldepaketen) übersteigt die Handschrifterkennung typischerweise 90 % Genauigkeit. Die fehleranfälligsten Felder sind Telefonnummern ohne Trennzeichen — „5551234567“ vs. „555-123-4567“ — sowie abgekürzte medizinische Begriffe in enger Handschrift. Genau diese Felder sollten Sie bei Ihrer Stichprobenprüfung priorisieren.
Das Tool garantiert keine 100-prozentige Genauigkeit bei handschriftlichen Feldern, und kein Extraktionssystem kann das. Gestalten Sie Ihren Prüfworkflow so, dass die wichtigsten Felder erfasst werden — Notfallkontakte und medizinische Informationen — und akzeptieren Sie, dass weniger kritische Felder wie Bestätigungsdaten für Handbuch-Empfangsbestätigungen eine Prüfrate vertragen, die eher einer Stichprobenprüfung als einer zeilenweisen Verifizierung entspricht.
Kann ich Daten aus dem staatlichen Impfformular extrahieren, das am Anmeldepaket angetackert ist?
Ja, wenn Sie es in den Scan einbeziehen. Das staatliche Impfformular ist eine strukturierte Tabelle — Impfstoffnamen in Zeilen, Daten in Spalten — und die KI liest es als Tabelle, nicht als Fließtext. Definieren Sie Spalten für die spezifischen Impfstoffe, die Ihr Bundesstaat für den Schuleintritt verlangt — DTaP, Polio, MMR, Hepatitis B, Varicella — und die Extraktion zieht die Daten aus den entsprechenden Zellen. Wenn Ihr SIS Impfdaten in einem separaten Modul speichert, exportieren Sie die Impfspalten in eine separate CSV-Datei für den Import in dieses Modul.
Wie gilt FERPA für diesen Arbeitsablauf?
Das Hochladen von Schüleranmeldeformularen in ein externes Extraktionstool stellt eine Offenlegung von personenbezogenen Informationen aus Bildungsunterlagen gemäß FERPA (34 CFR § 99.30) dar. Bevor Sie Formulare verarbeiten, stellen Sie sicher, dass Ihr Extraktionsanbieter eine institutionelle Vereinbarung unterzeichnet, die Dateneigentum, Beschränkungen der Weitergabe, Löschung bei Vertragsende, Benachrichtigung bei Datenschutzverletzungen und Prüfrechte abdeckt – und dass Schülerdokumente niemals zum Trainieren der KI-Modelle des Anbieters verwendet werden. Den vollständigen Compliance-Rahmen finden Sie in unserem FERPA-Compliance-Leitfaden für die Extraktion von Schülerdaten.
Das Ziel der Extraktion von Anmeldeformularen ist nicht, die menschliche Überprüfung zu eliminieren. Es geht darum, den Menschen von der Rolle des Datenerfassungsoperateurs – der Handschrift liest und Zeichen für Zeichen eintippt – in die Rolle des Datenprüfers zu versetzen, der verifiziert, dass die KI-Ausgabe mit dem Quelldokument in den Feldern übereinstimmt, in denen ein Fehler reale Konsequenzen hat. Diese Umstellung über tausend Anmeldepakete hinweg verwandelt mehrere Wochen Tipparbeit in ein oder zwei Tage Verifikation.
Testen Sie den Arbeitsablauf mit den Anmeldeformularen dieses Jahres. Definieren Sie einen Spaltensatz, der Ihren SIS-Feldern entspricht. Verarbeiten Sie einen Stapel von zehn Paketen und prüfen Sie die Ausgabe stichprobenartig. Wenn die Genauigkeit hält – und bei strukturierten Formularen mit klaren Feldbeschriftungen tut sie das in der Regel – haben Sie Ihren August-Arbeitsablauf für nächstes Jahr und jedes Jahr danach.