Como Extrair Dados de Formulários de Matrícula de Alunos
para o Excel para os Sistemas de Informação de Alunos do Distrito Escolar
Todo mês de agosto, o papel chega. Um distrito de K-12 de porte médio com 5.000 alunos recebe pacotes de matrícula de aproximadamente 20% de sua população — famílias que se matricularam presencialmente, entregaram formulários durante eventos de registro de verão, ou cujo idioma principal não é suportado pelo portal online. Cada pacote tem de 15 a 25 páginas: dados demográficos do aluno, detalhes de contato dos pais, contatos de emergência, condições médicas, registros de vacinação, solicitações de transporte escolar, consentimento de uso de imagem, termos de uso de tecnologia, ciência do manual. Multiplique por mil alunos, e a matemática da recepção se torna simples: milhares de páginas, cada uma exigindo que uma pessoa leia cada campo, decifre a caligrafia, marque as caixas e digite tudo no PowerSchool, Infinite Campus ou Skyward.
O gargalo não é que os dados não existam. É que os dados vivem no papel em uma dúzia de formatos de campo diferentes — e seu SIS precisa deles como linhas estruturadas. Este guia aborda um fluxo de trabalho prático que fecha essa lacuna: digitalize os formulários, defina as colunas de saída uma vez e deixe a IA semântica extrair cada tipo de campo em uma planilha pronta para importação no SIS.
Principais Conclusões
- 333 horas — é o que mil pacotes de matrícula em papel custam ao seu distrito para digitar no PowerSchool todo mês de agosto.
- O OCR tradicional lê a caligrafia caractere por caractere, mas não tem como saber se um número de telefone pertence ao contato de emergência ou ao pai — a única distinção que seu SIS realmente precisa.
- Defina 28 nomes de colunas uma vez, digitalize 200 pacotes como um único lote e obtenha uma planilha completa pronta para importação — sua equipe deixa de redigitar cada campo para verificar apenas as linhas de maior risco.
O Formulário de Matrícula em Papel Não Vai Desaparecer — Veja Por Quê
Portais de matrícula online existem. O PowerSchool Enrollment — implantado em mais de 3.500 distritos — oferece formulários compatíveis com dispositivos móveis, lógica condicional, preenchimento automático de dados de irmãos e sincronização direta com o SIS. O Infinite Campus Online Registration promete "nenhuma digitação de dados — basta clicar para aprovar". O discurso dos fornecedores é consistente: elimine o papel e o problema da digitação de dados desaparece.
O discurso ignora como a matrícula realmente funciona na prática. Uma parcela significativa das famílias em cada distrito preenche formulários em papel — e os motivos são estruturais, não temporários.
Barreiras linguísticas. O PowerSchool Enrollment oferece suporte a vários idiomas, mas todo o fluxo de matrícula — desde a navegação no portal até o preenchimento do formulário e o envio de documentos — pressupõe um nível de letramento digital e proficiência em inglês que nem toda família possui. Em distritos onde 15% ou mais das famílias falam outro idioma além do inglês em casa, os formulários em papel preenchidos com a ajuda de um funcionário bilíngue da recepção continuam sendo o caminho mais acessível.
Eventos de matrícula presencial. O cenário de "dia de matrícula" no ginásio — mesas, pilhas de formulários em branco, famílias preenchendo documentos em pé — ainda acontece em centenas de distritos todo mês de agosto. Para as famílias que aparecem sem um dispositivo, sem conexão à internet, ou simplesmente porque se mudaram para o distrito durante o verão e o portal online ainda não foi atualizado, o papel é o recurso universal.
Lacunas de acesso digital. Segundo o National Center for Education Statistics, aproximadamente 49,5 milhões de estudantes estavam matriculados nas escolas públicas de ensino fundamental e médio dos EUA no outono de 2023. Entre as famílias com crianças em idade escolar, estima-se que 5% a 8% não têm acesso residencial confiável à banda larga. Quando a única forma de cumprir o prazo de matrícula é preencher um formulário em papel no escritório do distrito, as famílias o fazem.
Atualizações de alunos veteranos. Os portais online lidam bem com a matrícula de novos alunos. O que eles lidam menos bem são os formulários de atualização anual que toda família de aluno veterano precisa preencher — contatos de emergência atualizados, novas informações médicas, novo consentimento para divulgação de fotos e mídia. Muitos distritos enviam esses formulários em papel pelo correio porque o fluxo de trabalho para alunos veteranos no portal do SIS é complicado, exige uma conta de responsável que muitas famílias nunca criaram, ou simplesmente não existe em versões mais antigas do SIS ainda em uso em distritos menores.
O resultado: mesmo os distritos que investiram em matrícula online ainda processam formulários em papel todo mês de agosto. A questão não é "como eliminamos o papel" — é "como tiramos os dados do papel com eficiência depois que ele chega aqui".
O que Contém um Pacote de Matrícula K-12 — e Por Que Cada Seção É um Desafio de Extração Diferente
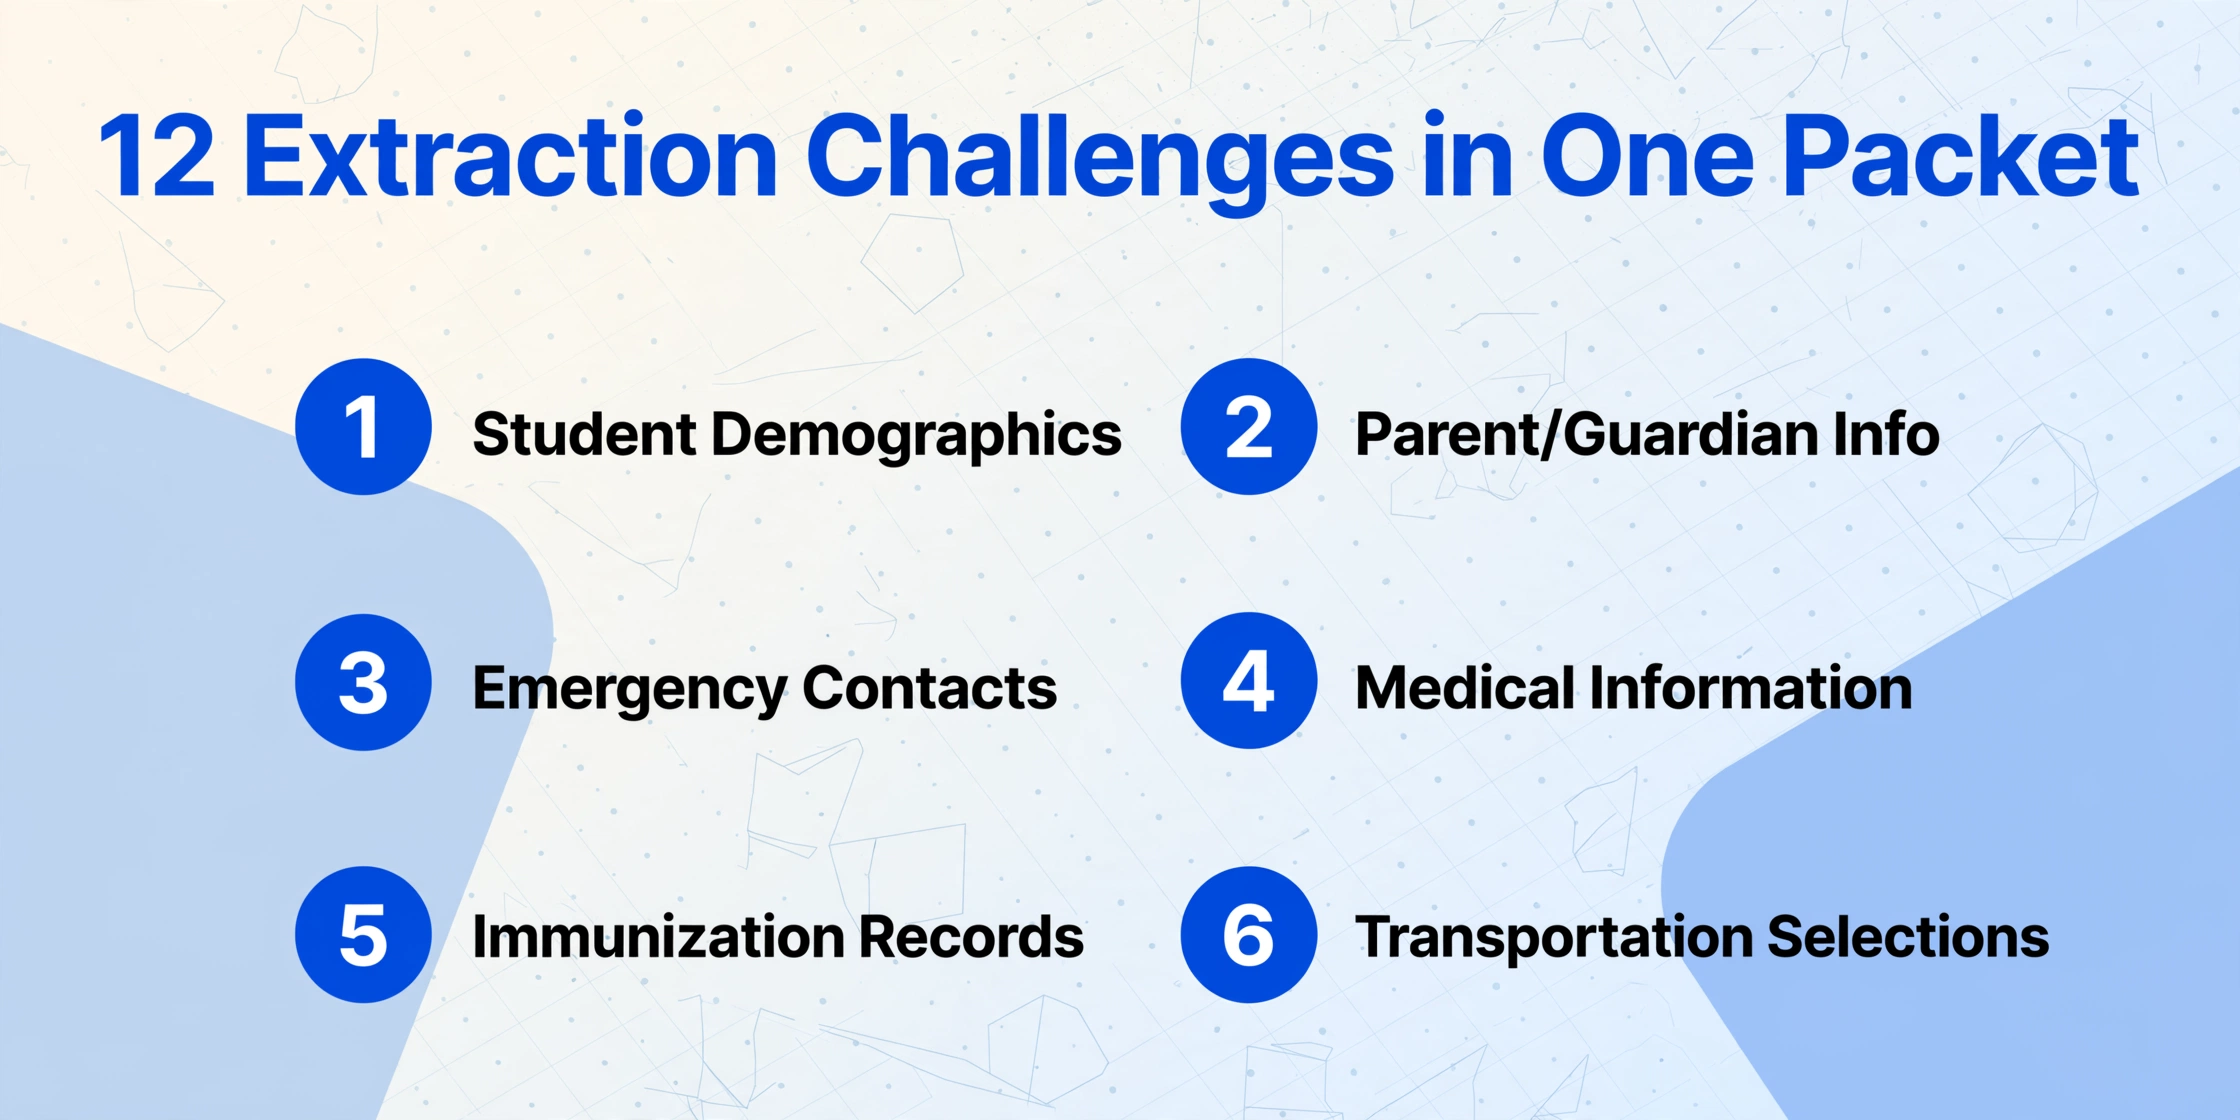
Um único pacote de matrícula de aluno não é um problema de extração de dados. São doze problemas de extração diferentes, cada um com um formato de campo distinto, em páginas projetadas para serem preenchidas à mão em um ginásio lotado. Entender os tipos de campo — e por que cada um quebra o OCR tradicional — é o pré-requisito para configurar um fluxo de trabalho de extração funcional.
| Seção | Campos Típicos | Formato do Campo | Dificuldade de OCR |
|---|---|---|---|
| Dados Demográficos do Aluno | Nome completo, data de nascimento, gênero, série de ingresso, endereço residencial | Impresso ou manuscrito em caixas de texto | Moderada — data de nascimento e endereço manuscritos são os pontos de falha comuns |
| Pais/Responsáveis 1 e 2 | Nome, parentesco, telefone, e-mail, empregador, telefone comercial | Texto impresso/manuscrito, blocos de várias linhas | Moderada — vários contatos em um único formulário exigem associação de campos |
| Contatos de Emergência | Nome, parentesco, telefone principal, telefone alternativo (2-3 contatos) | Texto manuscrito, frequentemente abreviado | Alta — rótulos de parentesco abreviados e números de telefone manuscritos confundem o OCR em nível de caractere |
| Informações Médicas | Alergias, medicamentos, condições crônicas, nome/telefone do médico, preferência de hospital | Manuscrito em blocos narrativos | Alta — condições médicas em texto livre sem vocabulário consistente |
| Registros de Vacinação | Tipo de vacina, data de aplicação, prestador (frequentemente uma digitalização de um formulário estadual separado) | Tabela estruturada em um formulário emitido pelo estado | Alta — texto de tabela pequeno, às vezes uma cópia digitalizada de uma cópia |
| Transporte | Seleção de ônibus / carro / a pé, número da rota do ônibus, horário AM/PM | Caixas de seleção + números de rota impressos | Moderada — detecção de caixas de seleção + associação de campos entre colunas |
| Programa de Alimentação | Candidatura para elegibilidade gratuita/reduzida, renda familiar, número do processo | Caixas de seleção + campos de renda manuscritos | Alta — dados financeiros confidenciais com entradas em campos pequenos |
| Termo de Uso de Tecnologia | Nome do aluno, nome do responsável, data, assinatura do responsável | Texto impresso + linha de assinatura manuscrita | Baixa — principalmente caixa de seleção e assinatura, dados estruturados mínimos a extrair |
| Autorização de Foto/Mídia | Caixa de seleção de adesão/recusa, nome do aluno, assinatura do responsável, data | Caixa de seleção + assinaturas | Baixa — consentimento binário, carga de extração leve |
| Ciência do Manual | Nome do aluno, série, nome do responsável, assinatura, data | Impresso + assinatura | Baixa — apenas ciência, sem dados estruturados |
| Pesquisa de Idioma em Casa | Idioma principal falado em casa, idiomas adicionais, idioma preferido do responsável | Entradas manuscritas + seleção de caixa de seleção | Moderada — nomes de idiomas são campos curtos, mas frequentemente manuscritos |
O que torna um pacote de matrícula exclusivamente difícil para o OCR tradicional é a mistura de tipos de campo em uma única página. Em uma mesma folha, você pode encontrar texto impresso (os próprios rótulos do formulário), respostas manuscritas em letra de forma, respostas manuscritas em cursivo, caixas marcadas, opções circuladas e uma assinatura — tudo a poucos centímetros de distância um do outro. O OCR tradicional lê caracteres. Ele não entende que um número de telefone escrito na caixa "Telefone do Contato de Emergência" pertence ao contato de emergência, e não ao pai ou responsável — e essa distinção importa quando os dados chegam a um SIS que tem campos de banco de dados separados para cada um.
A extração semântica por IA fecha essa lacuna ao entender o que cada campo significa, não apenas o que ele diz. Quando você define uma coluna chamada "Contato de Emergência 1 — Número de Telefone", a IA procura um número de telefone na seção de contato de emergência do formulário e o associa ao primeiro contato, não ao telefone comercial do pai ou responsável duas seções acima. Essa é a diferença fundamental entre reconhecimento de caracteres e compreensão de documentos — e é por isso que os formulários de matrícula recompensam a abordagem semântica mais do que a maioria dos tipos de documento. Para uma análise mais aprofundada de como a FERPA rege o momento em que os dados do aluno entram em um pipeline de processamento de IA, consulte nosso guia de conformidade com a FERPA para extração de documentos de admissão.
Do Pacote em Papel à Planilha Pronta para o SIS: O Fluxo de Trabalho em 3 Etapas
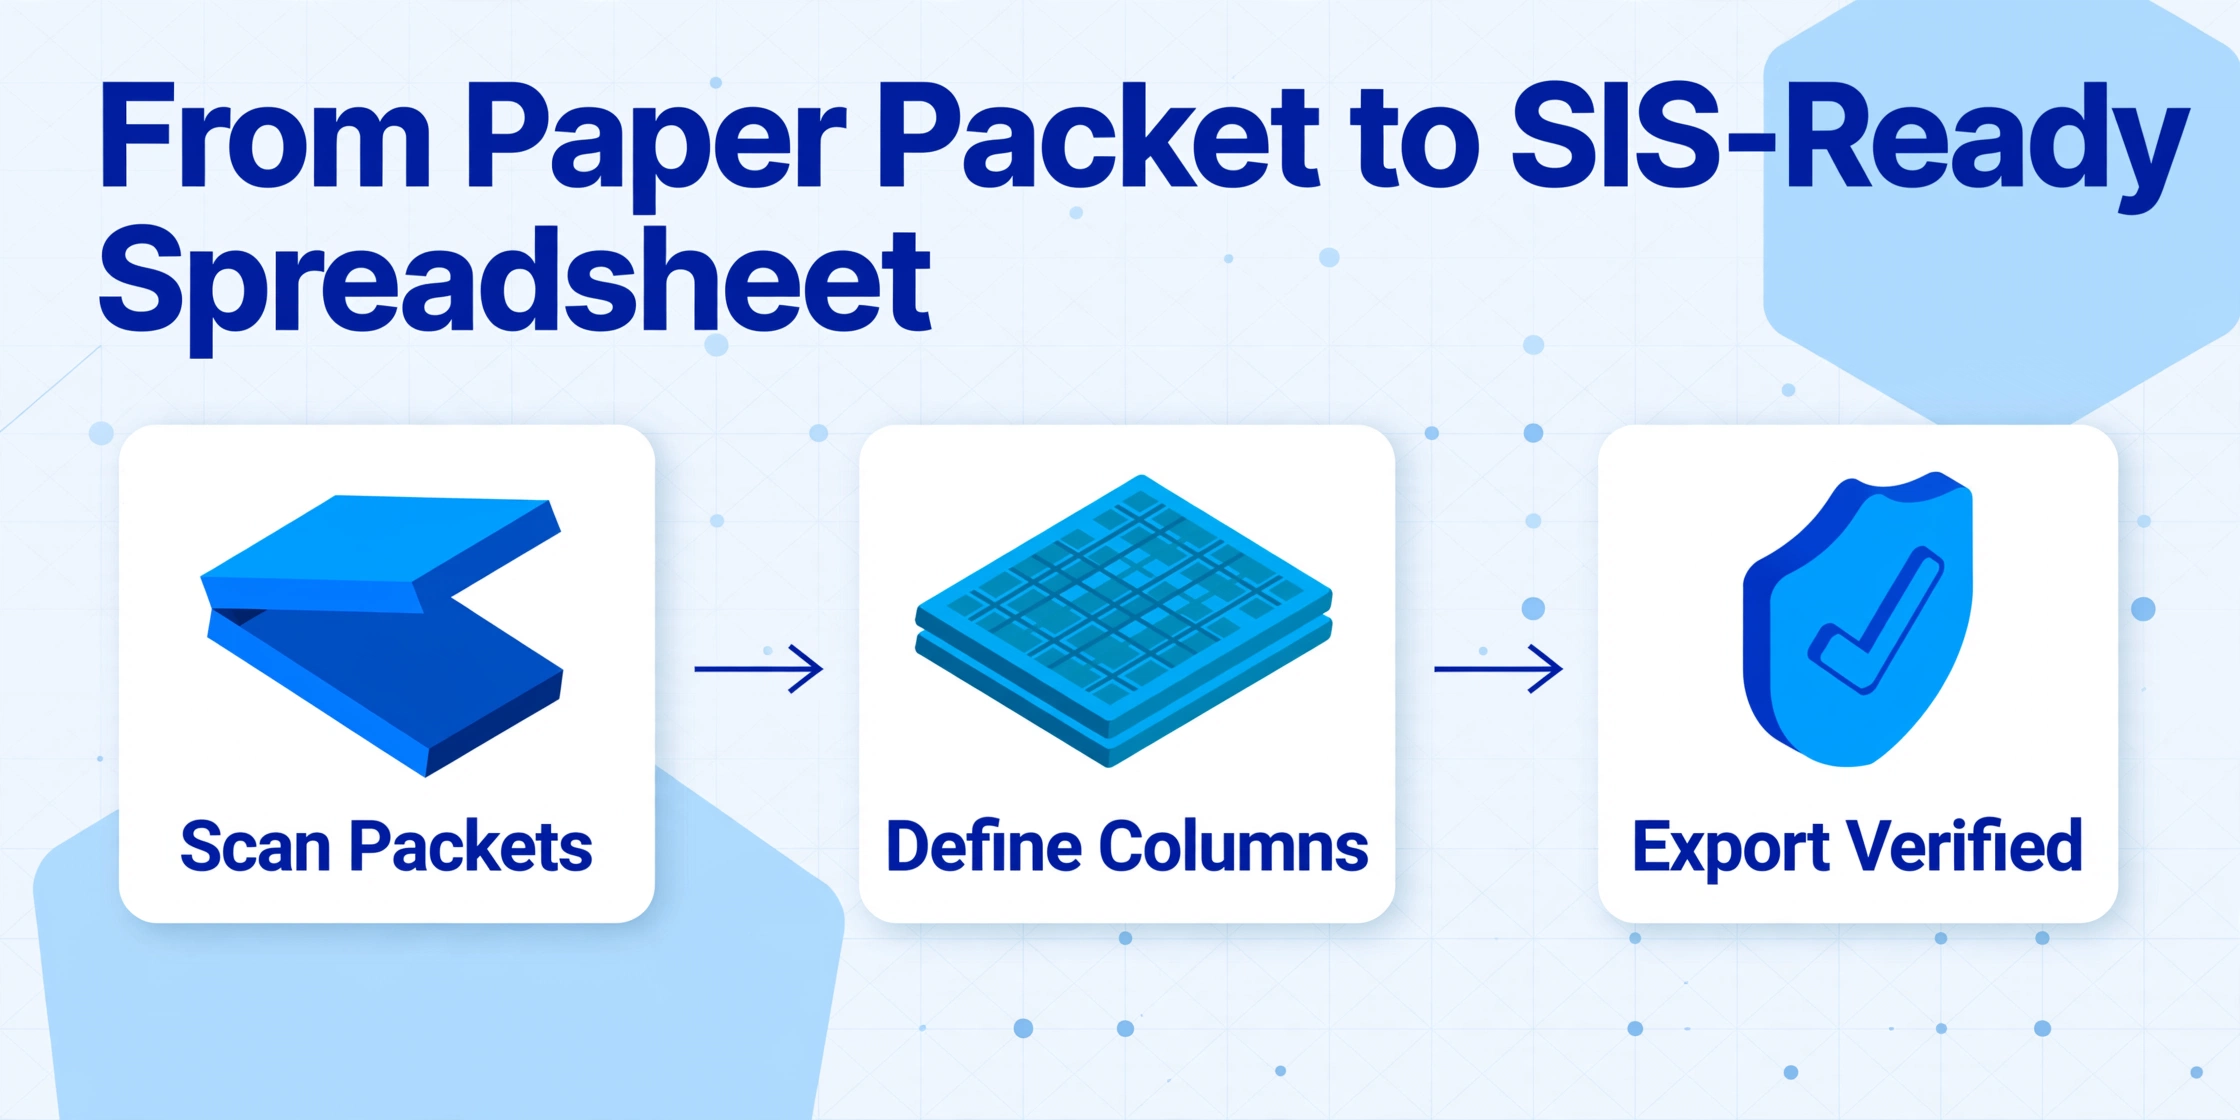
O fluxo de trabalho principal é simples o suficiente para que um membro da equipe da recepção possa executá-lo sem suporte de TI. O que exige mais reflexão é a configuração das colunas — acerte isso, e a extração funciona sozinha.
Etapa 1: Digitalize os Pacotes de Matrícula
Digitalize todas as páginas do pacote de cada aluno em um único PDF de várias páginas por aluno. Configure o scanner para 300 DPI em escala de cinza — a cor aumenta o tamanho do arquivo sem ganhos significativos de precisão para a maioria dos layouts de formulários de matrícula, mas o preto e branco perde o contraste sutil que distingue uma caixa de seleção de um borrão.
A convenção de nomenclatura importa. Nomeie cada arquivo como [Série]_[Sobrenome]_[Nome].pdf. Esse padrão de nomenclatura serve a dois propósitos: fornece um identificador único para cada arquivo e permite cruzar posteriormente os dados extraídos com o documento de origem durante verificações pontuais, sem abrir cada PDF.
Se os formulários chegarem grampeados como um único pacote por aluno, digitalize o conjunto de cada aluno como um documento. Se o distrito organiza os formulários por tipo — todos os formulários médicos juntos, todos os formulários de transporte juntos — você precisará de um fluxo de trabalho diferente, mas esse padrão é raro na matrícula do ensino fundamental e médio, onde o pacote é organizado por aluno, não por tipo de formulário.
Etapa 2: Defina as Colunas de Saída
É aqui que o comportamento da ferramenta de extração é programado — não com código ou modelos, mas listando exatamente quais campos você deseja na planilha final. Os nomes das colunas que você digita se tornam tanto as instruções para a IA quanto os cabeçalhos da sua tabela de saída.
Para um formulário de matrícula do ensino fundamental e médio, um conjunto prático de colunas é assim:
Conjunto de Colunas Recomendado para Formulários de Matrícula do Ensino Fundamental e Médio
Sobrenome do Aluno
Nome do Aluno
Data de Nascimento do Aluno
Série de Ingresso
Endereço Residencial
Cidade
Estado
CEP
Nome Completo do Pai/Mãe/Responsável 1
Parentesco do Pai/Mãe/Responsável 1
Telefone Principal do Pai/Mãe/Responsável 1
E-mail do Pai/Mãe/Responsável 1
Nome Completo do Pai/Mãe/Responsável 2
Parentesco do Pai/Mãe/Responsável 2
Telefone Principal do Pai/Mãe/Responsável 2
Nome do Contato de Emergência 1
Parentesco do Contato de Emergência 1
Telefone do Contato de Emergência 1
Nome do Contato de Emergência 2
Parentesco do Contato de Emergência 2
Telefone do Contato de Emergência 2
Condições Médicas / Alergias
Nome do Médico de Atenção Primária
Telefone do Médico de Atenção Primária
Método de Transporte (Ônibus / Carro / A pé)
Número da Rota do Ônibus (se aplicável)
Consentimento de Foto/Mídia (Sim / Não)
Termo de Uso de Tecnologia Assinado (Sim / Não)
Ciência do Manual Assinada (Sim / Não)
Algumas observações sobre o design das colunas para formulários de matrícula:
Separe nome e sobrenome. As plataformas SIS armazenam nomes de alunos em campos separados. Extraia-os separadamente desde o início e você evita uma etapa manual de divisão no Excel — uma etapa que falha quando você encontra sobrenomes com hífen, nomes do meio escritos no campo do nome ou convenções de nomenclatura culturais que não seguem a ordem ocidental de nome-sobrenome.
Use colunas inferidas para campos binários. Para caixas de seleção de consentimento — autorização de foto, termo de uso de tecnologia, ciência do manual — defina sua coluna com as opções entre parênteses: Consentimento de Foto/Mídia (Sim / Não). A IA lerá o estado da caixa de seleção no formulário e gerará "Sim" ou "Não" conforme o caso. Você não precisa extrair coordenadas da caixa de seleção nem tentar detecção pixel a pixel — a IA lê o significado do formulário, não seus pixels.
Inclua o nome do campo do SIS como dica. Se o seu distrito usa PowerSchool, o campo para transporte de ônibus geralmente é "Transportation Method" na lista suspensa. Nomear sua coluna como Método de Transporte (Ônibus / Carro / A pé) dá à IA tanto o alvo semântico quanto as opções válidas. Também faz com que o cabeçalho da coluna no Excel de saída corresponda ao rótulo do campo no modelo de importação do seu SIS — uma etapa de mapeamento a menos durante o upload.
Para um passo a passo detalhado sobre como definir colunas de extração em qualquer tipo de documento, consulte nosso guia para extrair dados de históricos escolares para o Excel, que aborda padrões de design de colunas que se aplicam igualmente a formulários de matrícula.
Etapa 3: Processar e exportar para o SIS
Faça upload de todos os PDFs digitalizados em um único lote. A ferramenta processa cada arquivo com base nas suas definições de colunas — extraindo nomes de alunos, dados de contato, informações médicas, status de consentimento — e mescla a saída em uma única planilha, onde cada linha corresponde a um aluno.
O formato de saída que importa para a importação no SIS é o Excel (.xlsx), que PowerSchool, Infinite Campus e Skyward aceitam nativamente. Se o seu SIS exigir CSV com uma ordem específica de colunas, exporte como CSV e reordene as colunas na interface da ferramenta antes de baixar.
Confira por amostragem as cinco primeiras linhas em relação aos PDFs originais. Preste atenção especial aos telefones de contato de emergência — um dígito transposto em um campo de contato de emergência é o erro de maior gravidade em todo o fluxo de trabalho de matrícula. Se a sua ferramenta permitir nomear cada arquivo com o identificador do aluno, a coluna de nome do arquivo na saída oferece uma referência com um clique de volta ao documento de origem para cada linha.
Manuscrito, caixas de seleção e assinaturas: os três elementos de formulário que quebram o OCR tradicional
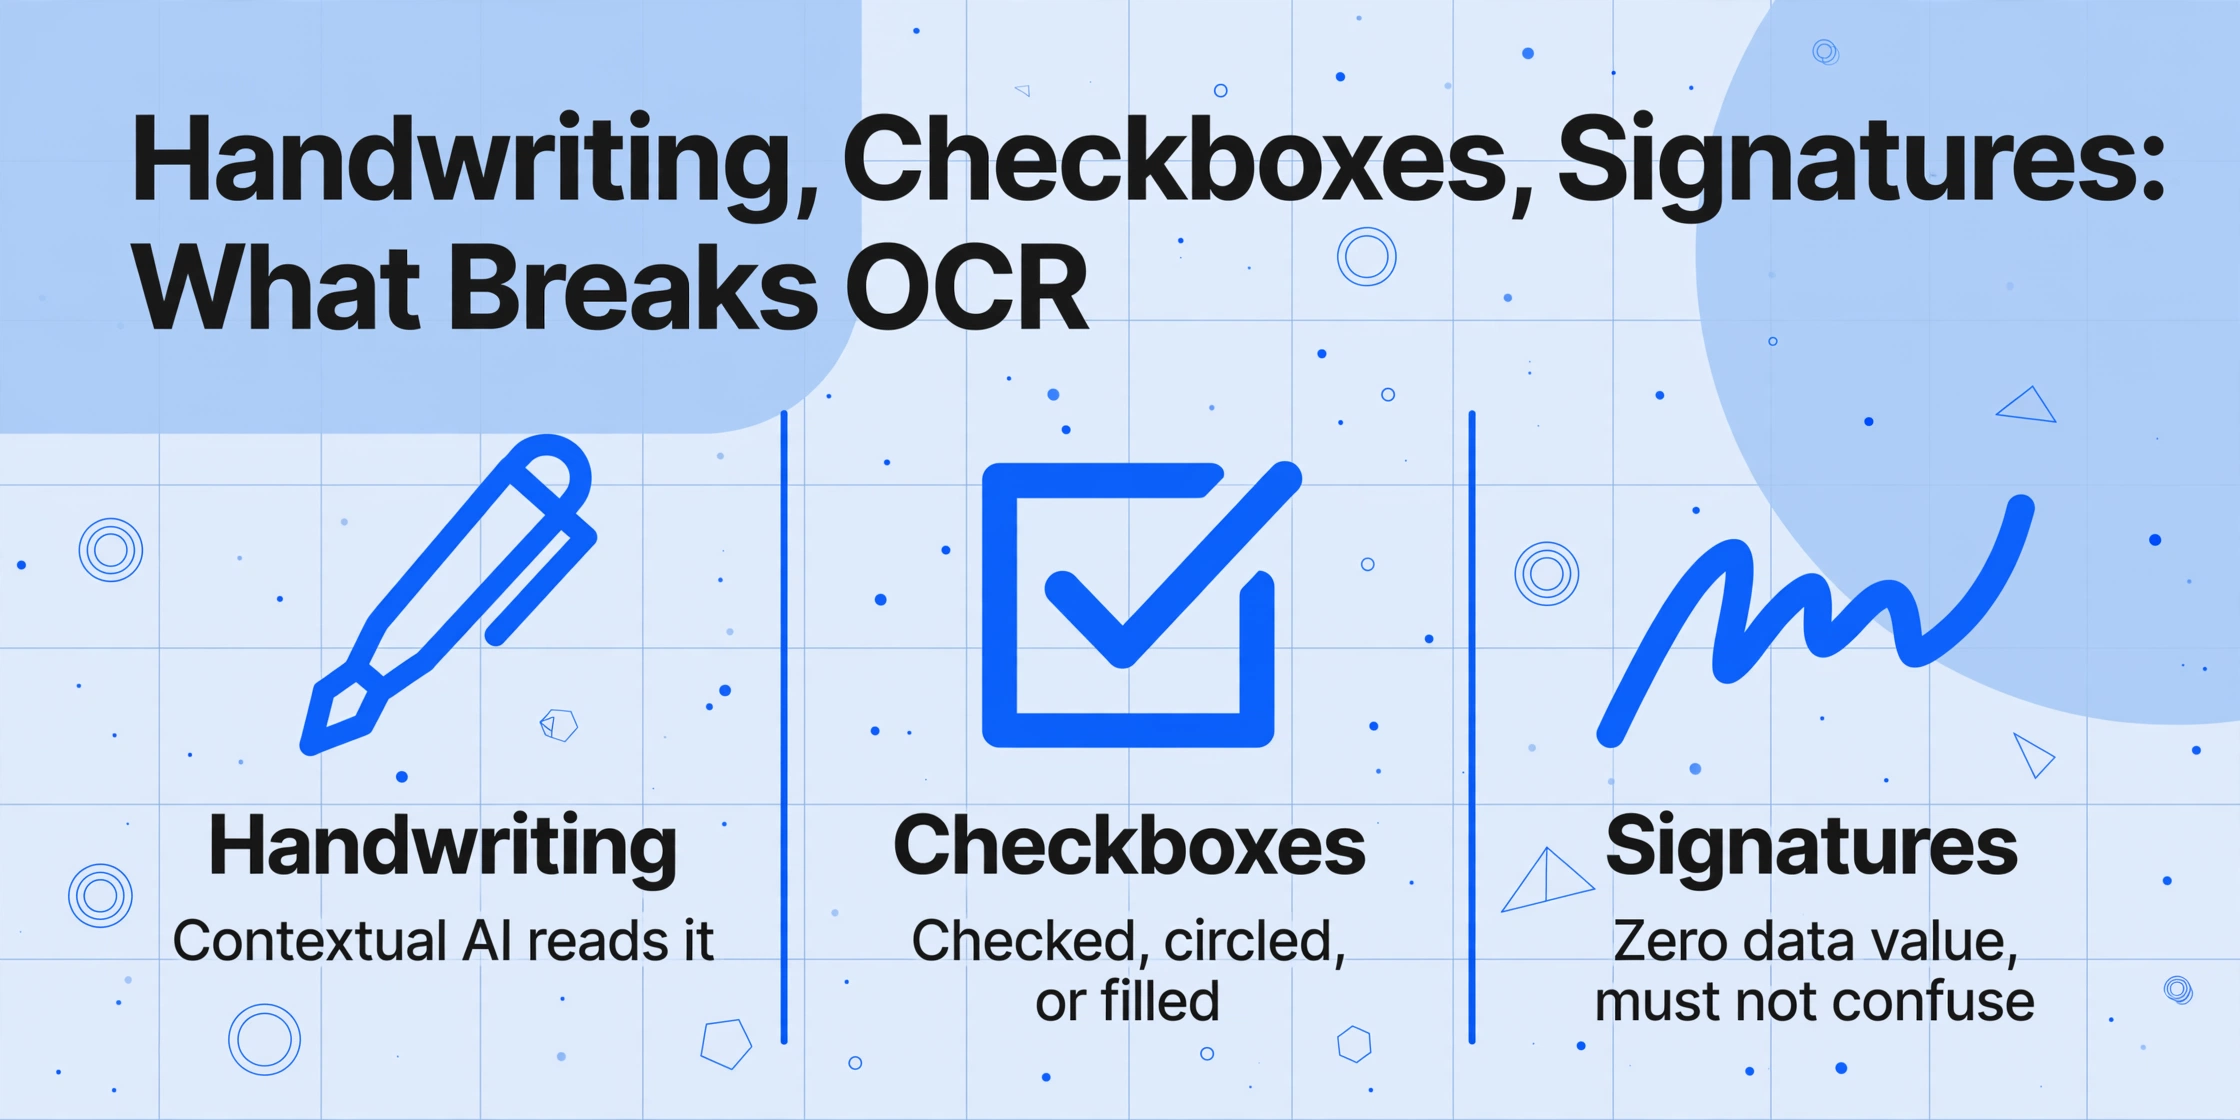
A maioria das ferramentas de OCR foi criada para texto impresso em fundos brancos e limpos. Os formulários de matrícula da educação básica são preenchidos por pais em pé em um ginásio com uma prancheta — a caligrafia é inconsistente, as caixas de seleção às vezes são marcadas, às vezes circuladas, às vezes preenchidas completamente, e cada página tem pelo menos uma assinatura que não carrega nenhum valor de dado extraível, mas não pode confundir a ferramenta a ponto de gerar resultados sem sentido.
Campos manuscritos. Os campos com maior taxa de manuscrito nos formulários de matrícula — telefones dos pais, nomes de contatos de emergência, condições médicas — também são os campos em que um erro tem a maior consequência. Um telefone de pai digitado incorretamente significa que a escola não consegue contatar a família em uma emergência. Uma anotação de alergia lida incorretamente tem implicações médicas.
A IA semântica lida com manuscrito de forma diferente do OCR em nível de caractere. Em vez de tentar identificar cada formato de letra individualmente e montá-los em palavras — a abordagem que produz "Emily" a partir de um "Amy" manuscrito quando o laço inicial é ambíguo —, a IA lê o contexto visual de todo o campo. Ela vê um bloco de texto manuscrito na seção "Nome do Contato de Emergência" e entende que esse bloco deve produzir o nome de uma pessoa, no formato pretendido pelo pai, usando os rótulos impressos dos campos ao redor como âncoras semânticas para desambiguar caligrafia pouco clara.
Essa leitura contextual é o que faz a diferença entre 70% de precisão em manuscrito em blocos de texto isolados e 95%+ em campos de formulário com contexto semântico claro. Para saber mais sobre os fatores de precisão na extração por IA, consulte nosso guia prático para melhorar a precisão do OCR.
Caixas de seleção. Os formulários de matrícula contêm de 5 a 15 caixas de seleção — escolha do meio de transporte, elegibilidade para o programa de alimentação, consentimento de uso de imagem, acordo de tecnologia, ciência do manual. O OCR tradicional ou ignora completamente as caixas de seleção ou produz caracteres "☐" que não significam nada em uma planilha.
O AI semântico lê caixas de seleção como estados binários ao entender sua posição em relação às opções rotuladas. Quando o formulário diz "Transportation: ☐ Bus ☐ Car Rider ☐ Walker" e uma caixa está marcada, o AI identifica qual rótulo corresponde à caixa marcada e gera o texto do rótulo — "Bus" — não um caractere de caixa de seleção.
Assinaturas. Todo pacote de matrícula tem assinaturas dos pais no acordo de tecnologia, autorização de mídia e ciência do manual. Assinaturas não carregam dados extraíveis — o nome de um pai deve ser extraído do campo de nome impresso, não de um rabisco cursivo. Mas o OCR tradicional frequentemente produz uma sequência de caracteres embaralhada a partir da linha de assinatura.
A solução prática: defina suas colunas para extrair o nome do pai da seção demográfica, não da linha de assinatura. Se você precisar confirmar que um formulário foi assinado, defina uma coluna binária como Parent Signature Present (Yes / No) — o AI pode detectar a presença de uma assinatura sem tentar lê-la. Isso fornece a trilha de auditoria sem o ruído de extração.
Processando os Formulários de Matrícula de Todo um Ano Escolar como um Único Lote
O verdadeiro ganho de eficiência não é extrair um formulário de matrícula mais rápido — é extrair cem formulários de matrícula e obter uma planilha.
Em um fluxo de trabalho tradicional de entrada de dados, cada pacote é processado independentemente: abrir o PowerSchool, criar um novo registro de aluno, digitar os campos demográficos, digitar os contatos dos pais, digitar os contatos de emergência, digitar as informações médicas, marcar as caixas de consentimento, salvar, passar para o próximo pacote. A um ritmo medido de 20 minutos por pacote — verificando cada linha quanto à precisão, fazendo referência cruzada aos campos manuscritos, corrigindo o inevitável erro de digitação — mil pacotes equivalem a 333 horas de trabalho da equipe.
A extração em lote inverte isso. Você faz o manuseio da papelada uma vez — digitaliza todos os pacotes — e a extração é executada em todos eles como um único trabalho. A saída é uma planilha com mil linhas, cada linha um registro completo de matrícula de aluno. O tempo da equipe muda da entrada de dados para a revisão de dados: abrir a planilha, verificar por amostragem os campos de contato de emergência, validar os sinalizadores médicos e marcar quaisquer linhas que precisem de revisão humana antes da importação no SIS.
Esse fluxo de trabalho espelha o que os escritórios de admissão fazem com o processamento de históricos escolares em escala. Para o panorama completo de como o processamento em lote funciona em um contexto educacional, consulte nosso guia para processar históricos escolares em lote em um banco de dados de admissões — a arquitetura do pipeline é a mesma, apenas com dados de matrícula em vez de notas de cursos.
Perguntas Frequentes
Isso funciona com formulários preenchidos em idiomas diferentes do inglês?
Sim, com uma ressalva importante. A IA lê texto manuscrito e impresso na maioria dos idiomas comuns, incluindo espanhol — que é o idioma não inglês mais frequente nos formulários de matrícula do ensino fundamental e médio nos EUA. No entanto, os nomes das colunas que você define devem estar em inglês se o seu SIS espera rótulos de campo em inglês. A IA extrairá o texto manuscrito em espanhol e o colocará na coluna em inglês correspondente — "Nombre del Estudiante" no formulário se torna "Student First Name" na sua planilha.
Para distritos que fornecem formulários de matrícula em vários idiomas, defina suas colunas uma vez no idioma que o seu SIS espera, e a extração funcionará independentemente de qual versão do formulário em cada idioma cada família preencheu.
E se um aluno tiver vários contatos de emergência além dos dois que definimos como colunas?
Defina tantas colunas de contato de emergência quanto o máximo que seus formulários contiverem. Se a maioria dos pacotes tiver dois contatos de emergência, mas alguns tiverem três, defina três conjuntos de colunas de contato de emergência — Nome, Parentesco e Telefone para cada um. A IA deixará os campos do terceiro contato em branco para pacotes com apenas dois contatos. Você não precisa reprocessar nem dividir o lote.
Qual é a precisão da extração de manuscritos em formulários de matrícula?
Texto impresso em formulários de matrícula — os próprios rótulos do formulário, campos digitados em PDFs preenchíveis — chega a quase 99% de precisão. Campos manuscritos dependem da clareza da caligrafia, mas em formulários estruturados com limites de campo claros (como pacotes de matrícula), a extração de manuscritos normalmente ultrapassa 90% de precisão. Os campos mais propensos a erro são números de telefone escritos sem separadores — "5551234567" vs "555-123-4567" — e termos médicos abreviados escritos com caligrafia apertada. Esses são exatamente os campos que você deve priorizar na sua verificação por amostragem.
A ferramenta não garante 100% de precisão em campos manuscritos, e nenhum sistema de extração consegue. Projete seu fluxo de revisão para capturar os campos de maior risco — contatos de emergência e informações médicas — e aceite que campos de menor risco, como datas de reconhecimento do manual, podem tolerar uma taxa de revisão mais próxima de amostragem do que de verificação linha por linha.
Posso extrair dados do formulário estadual de imunização que está grampeado ao pacote de matrícula?
Sim, se você incluí-lo na digitalização. O formulário estadual de imunização é uma tabela estruturada — nomes de vacinas em linhas, datas em colunas — e a IA o lê como uma tabela, não como texto narrativo. Defina colunas para as vacinas específicas exigidas pelo seu estado para entrada na escola — DTaP, Poliomielite, MMR, Hepatite B, Varicela — e a extração puxará as datas das células correspondentes. Se o seu SIS armazena dados de imunização em um módulo separado, exporte as colunas de imunização para um CSV separado para importação nesse módulo.
Como o FERPA se aplica a este fluxo de trabalho?
Carregar formulários de matrícula de alunos em uma ferramenta de extração de terceiros constitui uma divulgação de informações de identificação pessoal contidas em registros educacionais sob o FERPA (34 CFR § 99.30). Antes de processar qualquer formulário, confirme que seu fornecedor de extração assina um acordo institucional que abrange propriedade dos dados, restrições de redivulgação, exclusão ao término do contrato, notificação de violações e direitos de auditoria — e que os documentos dos alunos nunca são usados para treinar os modelos de IA do fornecedor. Para o framework de conformidade completo, consulte nosso guia de conformidade com o FERPA para extração de dados de alunos.
O objetivo da extração de formulários de matrícula não é eliminar a revisão humana. É mover o humano da função de operador de entrada de dados — lendo caligrafia e digitando caractere por caractere — para a função de revisor de dados, verificando se a saída da IA corresponde ao documento de origem nos campos em que um erro tem consequências reais. Essa mudança, em mil pacotes de matrícula, transforma várias semanas de digitação em um ou dois dias de verificação.
Teste o fluxo de trabalho nos formulários de matrícula deste ano. Defina um conjunto de colunas que corresponda aos campos do seu SIS. Processe um lote de dez pacotes e faça uma verificação por amostragem da saída. Se a precisão se mantiver — e em formulários estruturados com rótulos de campo claros, normalmente se mantém — você tem seu fluxo de trabalho de agosto para o próximo ano e para todos os anos seguintes.