学生登録フォームデータをExcelに抽出する方法
— 学区の学生情報システム向け
毎年8月、紙の書類が届きます。生徒数5,000人の中規模K-12学区では、人口の約20%分の登録パケットを受け取ります。対面で登録した家庭、夏の登録イベントでフォームを提出した家庭、オンラインポータルが対応していない言語を第一言語とする家庭などです。各パケットは15〜25ページに及びます。生徒の基本情報、保護者の連絡先、緊急連絡先、病歴、予防接種記録、スクールバスの利用申請、写真使用の同意書、テクノロジー利用規約、ハンドブックの受領確認。これに生徒1,000人分を掛け合わせると、事務所の計算は単純になります。数千ページの書類があり、それぞれのフィールドを人間が読み、手書きを解読し、チェックボックスを確認し、すべてをPowerSchool、Infinite Campus、Skywardに入力する必要があります。
ボトルネックは、データが存在しないことではありません。データが十数種類の異なるフィールド形式で紙の上にあり、SISが構造化された行として必要としていることです。このガイドでは、そのギャップを埋める実践的なワークフローを紹介します。フォームをスキャンし、出力列を一度定義すれば、セマンティックAIがあらゆるフィールドタイプを抽出して、SISにインポートできるスプレッドシートを作成します。
重要なポイント
- 333時間 — 毎年8月に1,000件の紙の登録パケットをPowerSchoolに入力するために学区が費やす時間です。
- 従来のOCRは手書きを文字単位で読み取りますが、電話番号が緊急連絡先のものか保護者のものかを判断する方法がありません。SISが実際に必要とするのは、まさにこの区別です。
- 28の列名を一度定義し、200件のパケットを一括スキャンすれば、インポート可能な完成済みスプレッドシートが1つ作成されます。スタッフの作業は、全フィールドの再入力から、最重要行のスポットチェックだけに変わります。
紙の登録フォームはなくならない——その理由
オンライン登録ポータルは存在する。PowerSchool Enrollmentは3,500以上の学区で導入され、モバイル対応フォーム、条件分岐ロジック、兄弟姉妹データの事前入力、SISとの直接連携を提供する。Infinite Campus Online Registrationは「データ入力不要——承認するだけ」を謳う。ベンダーの主張は一貫している:紙をなくせば、データ入力の問題も消える、と。
しかし、この主張は現場の実態を見落としている。どの学区でも、かなりの割合の家庭が紙のフォームを記入している——その理由は一時的なものではなく、構造的なものだ。
言語の壁。 PowerSchool Enrollmentは複数言語に対応しているが、登録の全フロー——ポータル操作からフォーム記入、書類アップロードまで——は、すべての家庭が備えているとは限らないデジタルリテラシーと英語力を前提としている。家庭で英語以外の言語を話す割合が15%以上の学区では、バイリンガルの事務スタッフの助けを借りて記入する紙のフォームが、最もアクセスしやすい手段であり続けている。
対面登録イベント。 体育館に机を並べ、未記入の用紙を積み、家族が立ちながらフォームを記入する「登録日」の光景は、今でも毎年8月に何百もの学区で見られる。端末もインターネット接続もない家庭、あるいは夏休み中に転入してきてオンラインポータルが追いついていない家庭にとって、紙は普遍的な代替手段だ。
デジタルアクセス格差。 全米教育統計センターによると、2023年秋の米国公立K-12学校の在籍者数は約4,950万人。学齢期の子どもがいる世帯のうち、推定5~8%が自宅で安定したブロードバンド回線を利用できない。登録期限に間に合う唯一の方法が学区事務所で紙の用紙を記入することなら、家族はそうする。
在校生の更新手続き。 オンラインポータルは新入生の登録には適している。しかし、すべての在校生家庭が毎年完了しなければならない更新フォーム——緊急連絡先の更新、新しい医療情報、写真・メディア公開の再同意——にはあまり適していない。多くの学区では、SISポータルの在校生向けワークフローが使いづらかったり、多くの家庭が作成していない保護者アカウントが必要だったり、あるいは小規模学区でまだ稼働している旧バージョンのSISにはそもそも機能が存在しないため、これらのフォームを紙のパケットとして郵送している。
結果として、オンライン登録に投資した学区でさえ、毎年8月には紙のフォームを処理している。問題は「どうやって紙をなくすか」ではなく、「紙が来たときに、どう効率的にデータを取得するか」だ。
K-12入学書類パケットの中身 — 各セクションが異なる抽出課題となる理由
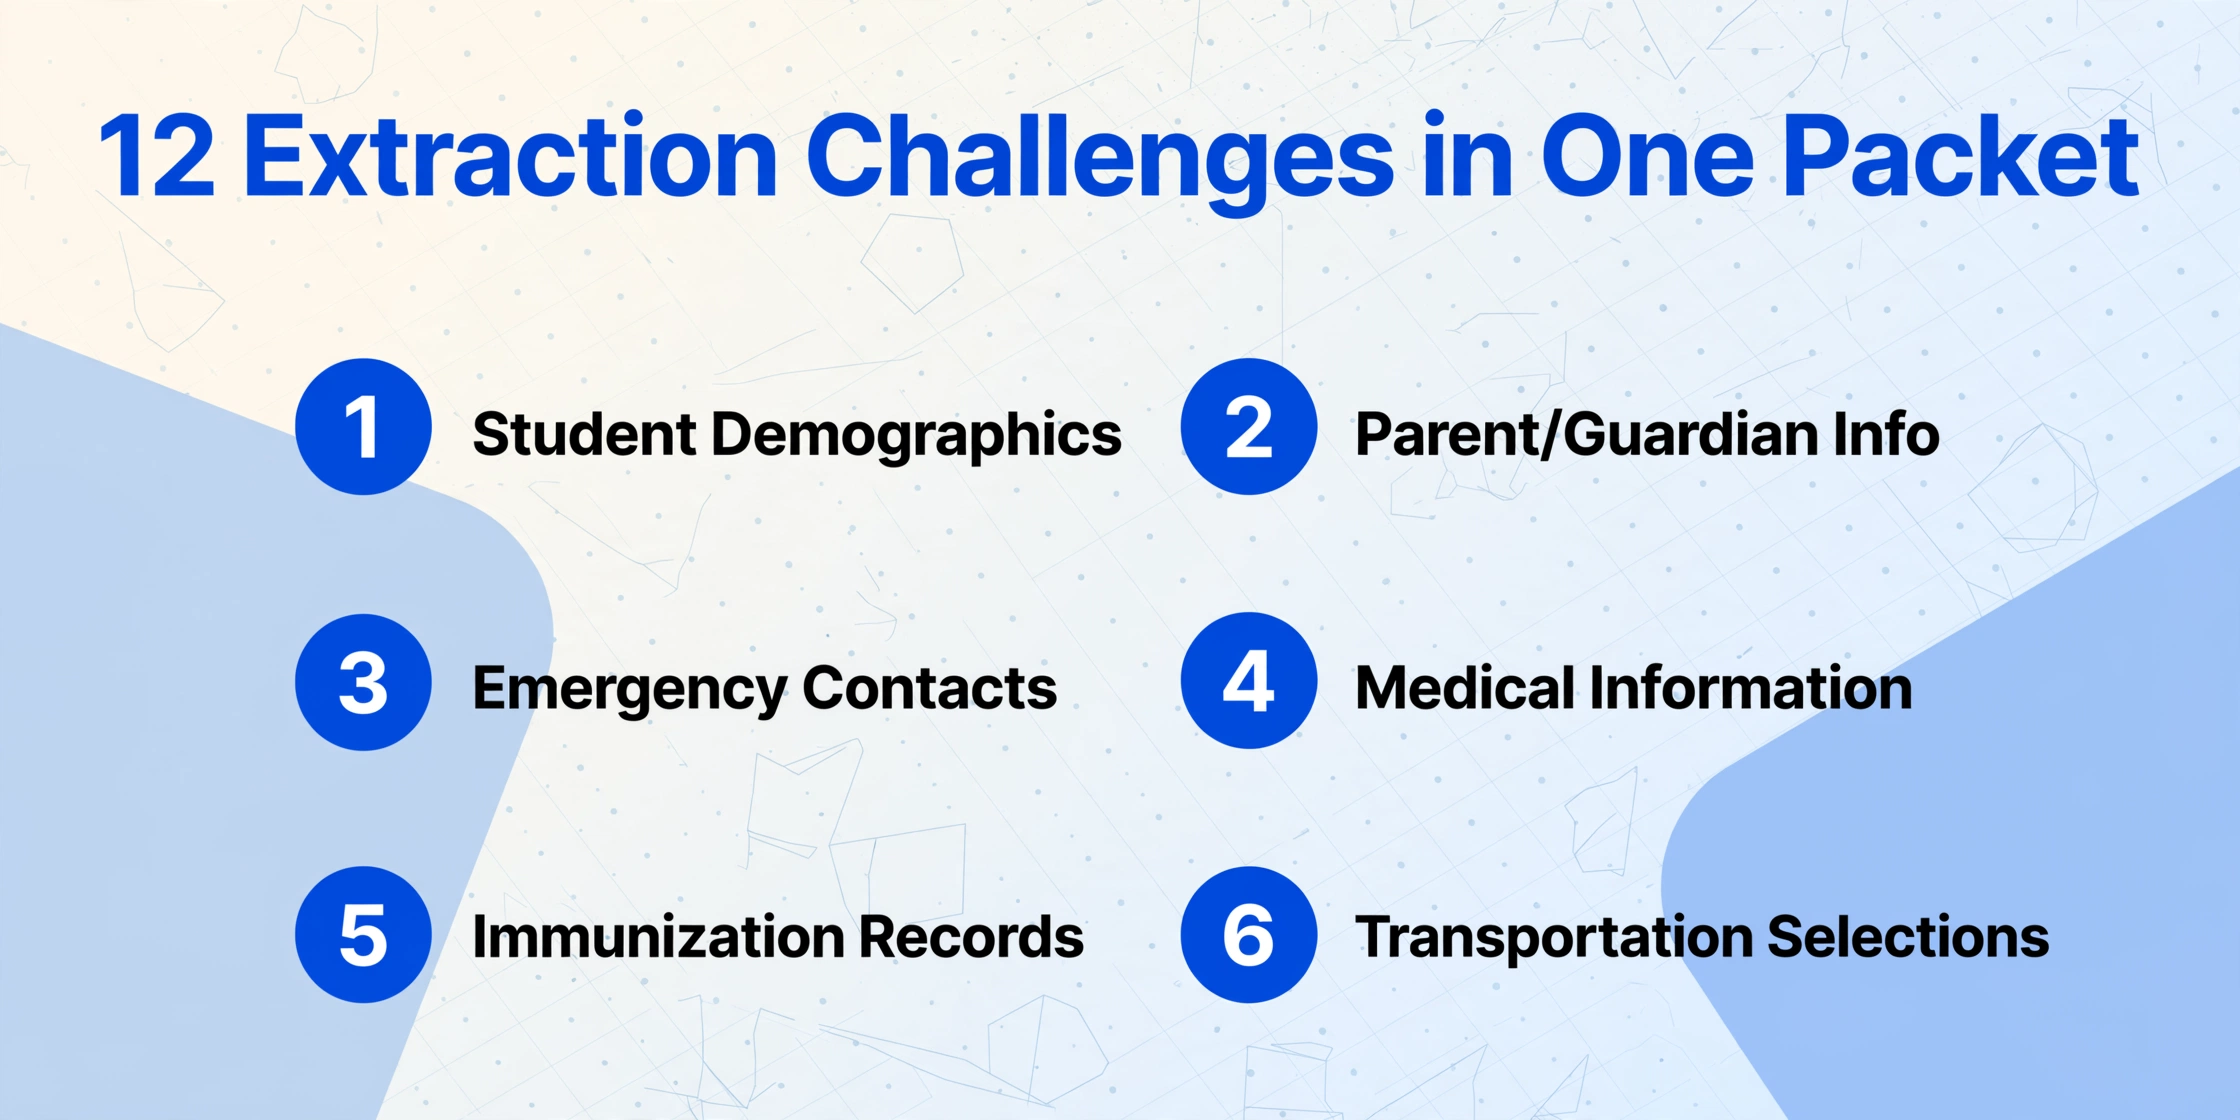
1つの生徒入学書類パケットは、1つのデータ抽出問題ではありません。それは12の異なる抽出問題であり、それぞれ異なるフィールド形式を持ち、混雑した体育館で手書きで記入されるように設計されたページです。フィールドの種類を理解すること — そして、それぞれが従来のOCRをなぜ失敗させるのかを理解すること — は、機能する抽出ワークフローを構築するための前提条件です。
| セクション | 一般的なフィールド | フィールド形式 | OCRの難易度 |
|---|---|---|---|
| 生徒基本情報 | 氏名、生年月日、性別、入学学年、自宅住所 | テキストボックスへの印字または手書き | 中 — 手書きの生年月日と住所がよくある失敗ポイントです |
| 保護者/後見人1 & 2 | 氏名、続柄、電話番号、メールアドレス、勤務先、勤務先電話番号 | 印字/手書きテキスト、複数行ブロック | 中 — 1つのフォームに複数の連絡先があり、フィールドの関連付けが必要です |
| 緊急連絡先 | 氏名、続柄、主電話番号、予備電話番号(2〜3名の連絡先) | 手書きテキスト、略語が多い | 高 — 略された続柄ラベルと手書きの電話番号が文字レベルOCRを混乱させます |
| 医療情報 | アレルギー、服用中の薬、慢性疾患、担当医名/電話番号、希望病院 | 記述ブロックへの手書き | 高 — 一貫した語彙のない自由記述の病状 |
| 予防接種記録 | ワクチン種類、接種日、提供者(州発行の別フォームのスキャンであることが多い) | 州発行フォーム上の構造化テーブル | 高 — 小さなテーブル文字、時にはコピーのコピーのスキャン |
| 交通手段 | バス/車送迎/徒歩の選択、バス路線番号、午前/午後のスケジュール | チェックボックス + 印字された路線番号 | 中 — チェックボックス検出 + 列をまたぐフィールド関連付け |
| 昼食プログラム | 無料・割引対象申請、世帯収入、ケース番号 | チェックボックス + 手書きの収入フィールド | 高 — 機密性の高い財務データと小さなフィールドへの記入 |
| テクノロジー利用同意書 | 生徒氏名、保護者氏名、日付、保護者署名 | 印字テキスト + 手書き署名欄 | 低 — 主にチェックボックスと署名で、抽出する構造化データは最小限です |
| 写真/メディア公開承諾書 | 同意/不同意チェックボックス、生徒氏名、保護者署名、日付 | チェックボックス + 署名 | 低 — 二択の同意、抽出負荷は軽いです |
| ハンドブック確認書 | 生徒氏名、学年、保護者氏名、署名、日付 | 印字 + 署名 | 低 — 確認のみで、構造化データはありません |
| 家庭言語調査 | 家庭での主言語、その他の言語、保護者の希望言語 | 手書き記入 + チェックボックス選択 | 中 — 言語名は短いフィールドですが、手書きであることが多いです |
従来のOCRにとって入学書類パケットが特に難しいのは、1枚のページにさまざまな種類のフィールドが混在していることです。1枚の用紙に、印刷されたテキスト(フォーム自体のラベル)、ブロック体の手書き回答、筆記体の手書き回答、チェックされたボックス、丸で囲まれた選択肢、そして署名が、わずか数センチの範囲にすべて収まっていることもあります。従来のOCRは文字を読み取りますが、「緊急連絡先電話番号」の欄に書かれた電話番号が保護者ではなく緊急連絡先のものであることを理解しません。そして、それぞれに別々のデータベースフィールドを持つSISにデータが入る際には、この区別が重要になります。 セマンティックAI抽出は、各フィールドが「何を言っているか」だけでなく「何を意味するか」を理解することで、このギャップを埋めます。「緊急連絡先1 — 電話番号」という列を定義すると、AIはフォームの緊急連絡先セクションで電話番号を探し、2セクション上にある保護者の勤務先電話番号ではなく、最初の連絡先に関連付けます。これが文字認識と文書理解の根本的な違いであり、入学フォームが他のほとんどの文書タイプよりもセマンティックなアプローチに適している理由です。学生データがAI処理パイプラインに入る瞬間にFERPAがどのように適用されるかについて詳しくは、入学書類抽出のFERPAコンプライアンスガイドをご覧ください。
紙のパケットからSIS対応スプレッドシートへ:3ステップのワークフロー
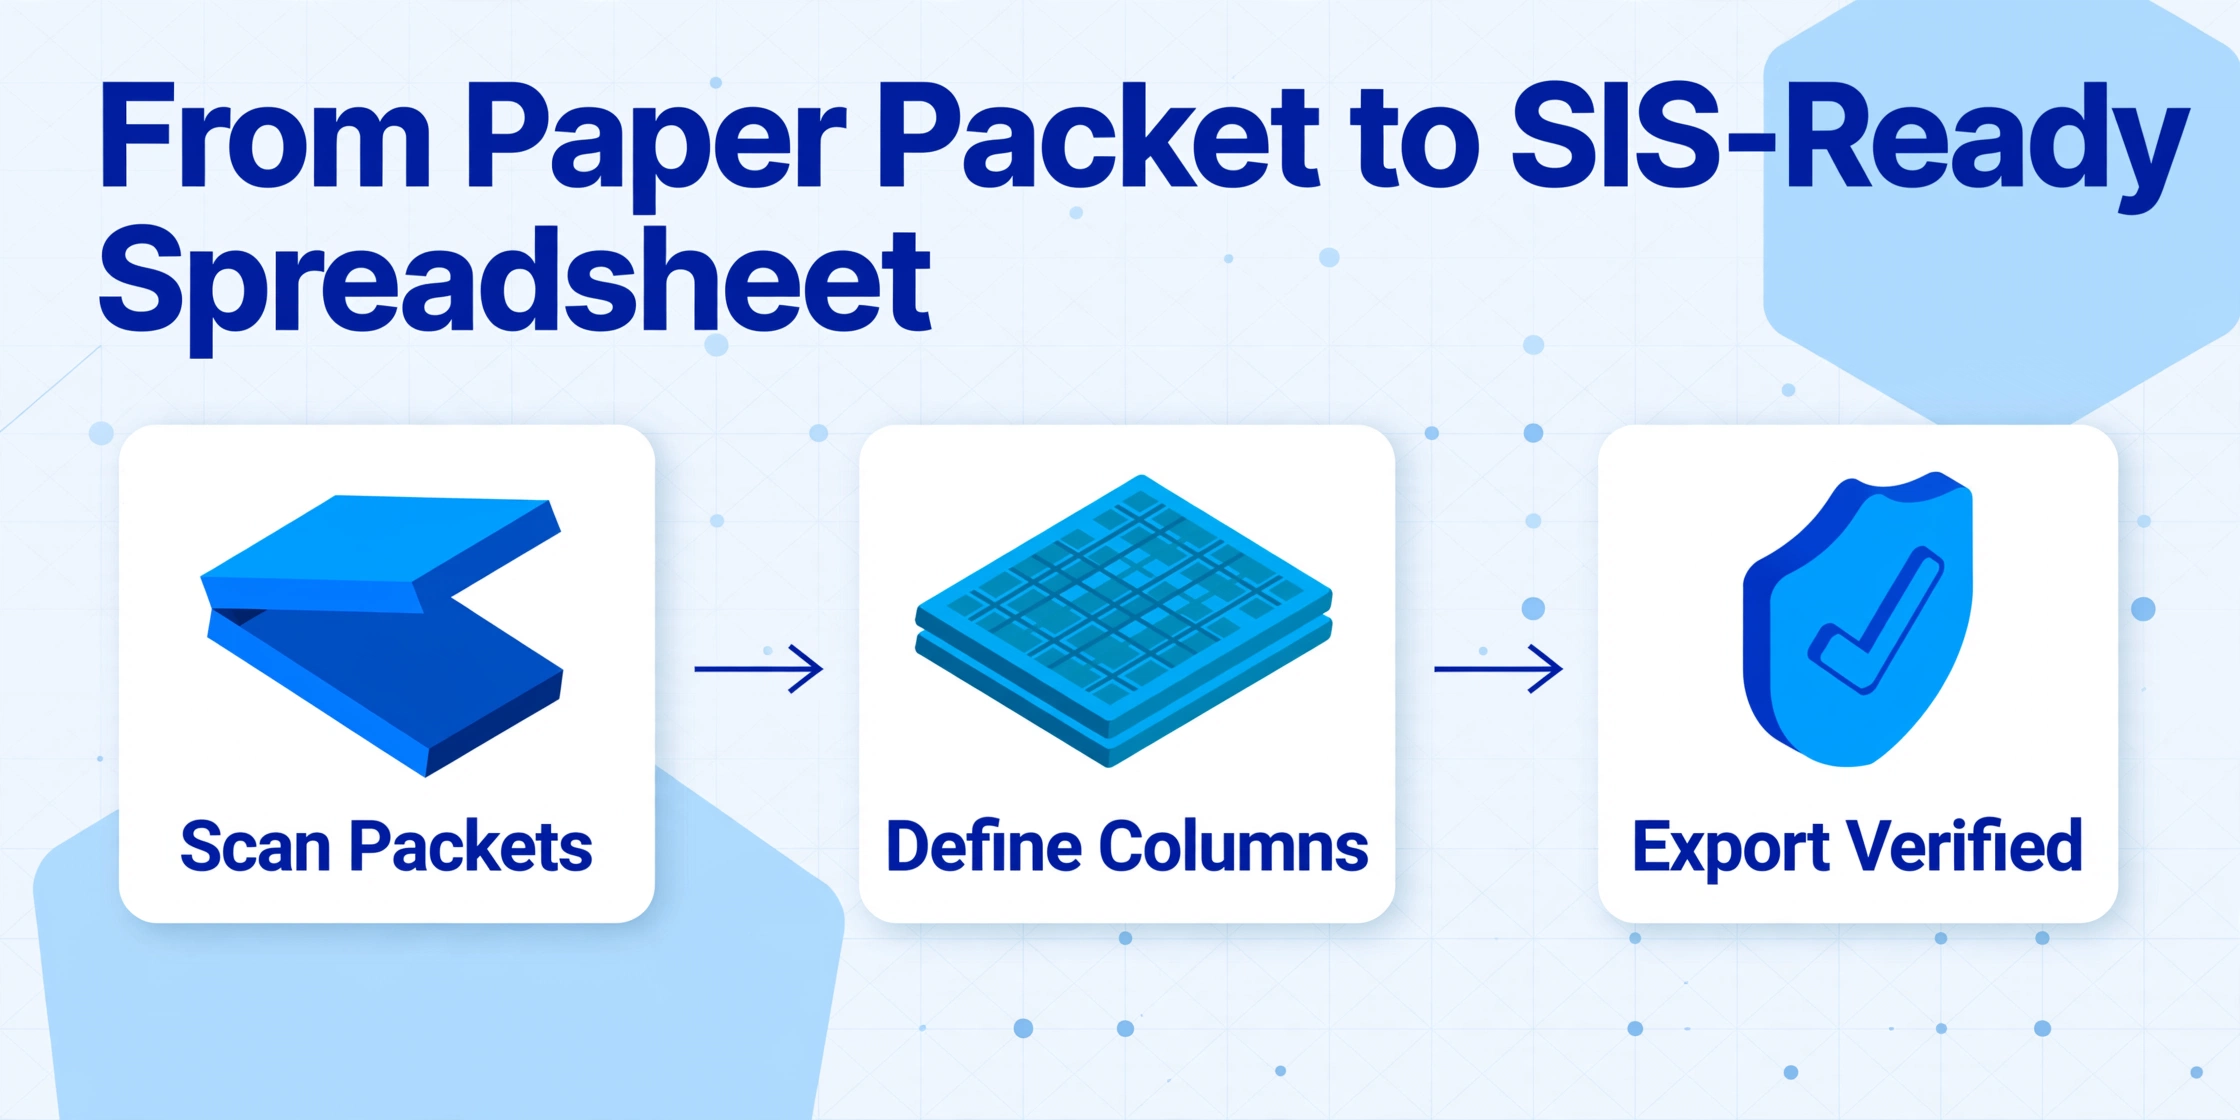
このコアワークフローは、ITサポートなしでも窓口のスタッフが実行できるほどシンプルです。最も考慮が必要なのは列の設定です。これを正しく行えば、抽出は自動で実行されます。
ステップ1:入学書類をスキャンする
各生徒の書類一式の全ページを、生徒ごとに1つのマルチページPDFとしてスキャンしてください。スキャナーは300 DPIのグレースケールに設定してください。カラーはファイルサイズを増やすだけで、ほとんどの入学フォームのレイアウトでは精度向上にあまりつながりません。一方、白黒ではチェックボックスと汚れを区別する微妙なコントラストが失われます。
ファイル名の規則は重要です。各ファイルを[学年]_[姓]_[名].pdfという形式で命名してください。この命名パターンには2つの目的があります。各ファイルに一意の識別子を付与することと、後で抽出データを元の文書と照合する際に、すべてのPDFを開かずにクロスチェックできることです。
フォームが生徒ごとに1つの書類として事前にホチキス留めされている場合は、各生徒の一式を1つの文書としてスキャンしてください。学区がフォームの種類ごとに整理している場合(すべての医療フォームをまとめる、すべての交通フォームをまとめるなど)は、別のワークフローが必要になりますが、K-12の登録では書類が生徒ごとに整理され、フォームの種類ごとではないため、そのパターンは稀です。
ステップ2:出力列を定義する
ここで抽出ツールの動作がプログラムされます。コードやテンプレートではなく、最終的なスプレッドシートに必要なフィールドを正確に列挙することで設定します。入力する列名は、AIへの指示であると同時に、出力テーブルのヘッダーにもなります。
K-12の入学フォームでは、実用的な列セットは次のようになります:
K-12入学フォームの推奨列セット
生徒の姓
生徒の名
生徒の生年月日
入学学年
自宅の番地
自宅の市区町村
自宅の都道府県
自宅の郵便番号
保護者1のフルネーム
保護者1の続柄
保護者1の主な電話番号
保護者1のメールアドレス
保護者2のフルネーム
保護者2の続柄
保護者2の主な電話番号
緊急連絡先1の氏名
緊急連絡先1の続柄
緊急連絡先1の電話番号
緊急連絡先2の氏名
緊急連絡先2の続柄
緊急連絡先2の電話番号
病状・アレルギー
かかりつけ医の氏名
かかりつけ医の電話番号
通学方法(バス/車送迎/徒歩)
バス路線番号(該当する場合)
写真・メディア使用同意(はい/いいえ)
テクノロジー利用規約への同意(はい/いいえ)
ハンドブックの確認書への署名(はい/いいえ)
入学フォームの列設計に関するいくつかの注意点:
姓と名を分けてください。SISプラットフォームは生徒の氏名を別々のフィールドに保存します。最初から分けて抽出すれば、Excelでの手動分割ステップを回避できます。この分割は、ハイフン付きの姓、名の欄に書かれたミドルネーム、西洋式の名前の順序に従わない文化的な命名規則に遭遇すると失敗します。
2値フィールドには推論列を使用してください。同意チェックボックス(写真公開、テクノロジー利用規約、ハンドブック確認書)については、括弧内に選択肢を入れて列を定義してください:写真・メディア使用同意(はい/いいえ)。AIはフォーム上のチェックボックスの状態を読み取り、それに応じて「はい」または「いいえ」を出力します。チェックボックスの座標を抽出したり、ピクセル単位の検出を試みる必要はありません。AIはフォームの意味を読み取るのであって、ピクセルを読み取るわけではありません。
SISのフィールド名をヒントとして含めてください。学区がPowerSchoolを使用している場合、バス通学のフィールドはドロップダウンで「Transportation Method」となっていることがよくあります。列をTransportation Method (Bus / Car Rider / Walker)と命名することで、AIに意味的なターゲットと有効な選択肢の両方を提供できます。また、出力Excelの列ヘッダーがSISインポートテンプレートのフィールドラベルと一致するため、アップロード時のマッピングステップが1つ減ります。
各文書タイプで抽出列を定義する詳細な手順については、学生の成績データをExcelに抽出するガイドをご覧ください。このガイドでは、入学フォームにも同様に適用できる列設計パターンについて説明しています。
ステップ3:処理してSISにエクスポート
スキャンしたPDFをすべて1つのバッチでアップロードします。ツールは定義した列定義に基づいてすべてのファイルを処理し、学生名、連絡先情報、医療情報、同意状況を抽出して、1つのスプレッドシートに統合します。各行が1人の学生に対応します。
SISインポートに重要な出力形式はExcel(.xlsx)で、PowerSchool、Infinite Campus、Skywardはすべてネイティブで受け入れます。SISが特定の列順序のCSVを必要とする場合は、CSVとしてエクスポートし、ダウンロード前にツールのインターフェースで列を並べ替えてください。
最初の5行を元のPDFと照合して確認してください。特に緊急連絡先の電話番号に注意してください。緊急連絡先フィールドの数字の入れ違いは、入学ワークフロー全体で最も重大なエラーです。ツールで各ファイルに学生IDを付けて名前を付けられる場合は、出力のファイル名列から各レコードの元の文書にワンクリックで参照できます。
手書き、チェックボックス、署名:従来のOCRを破綻させる3つのフォーム要素
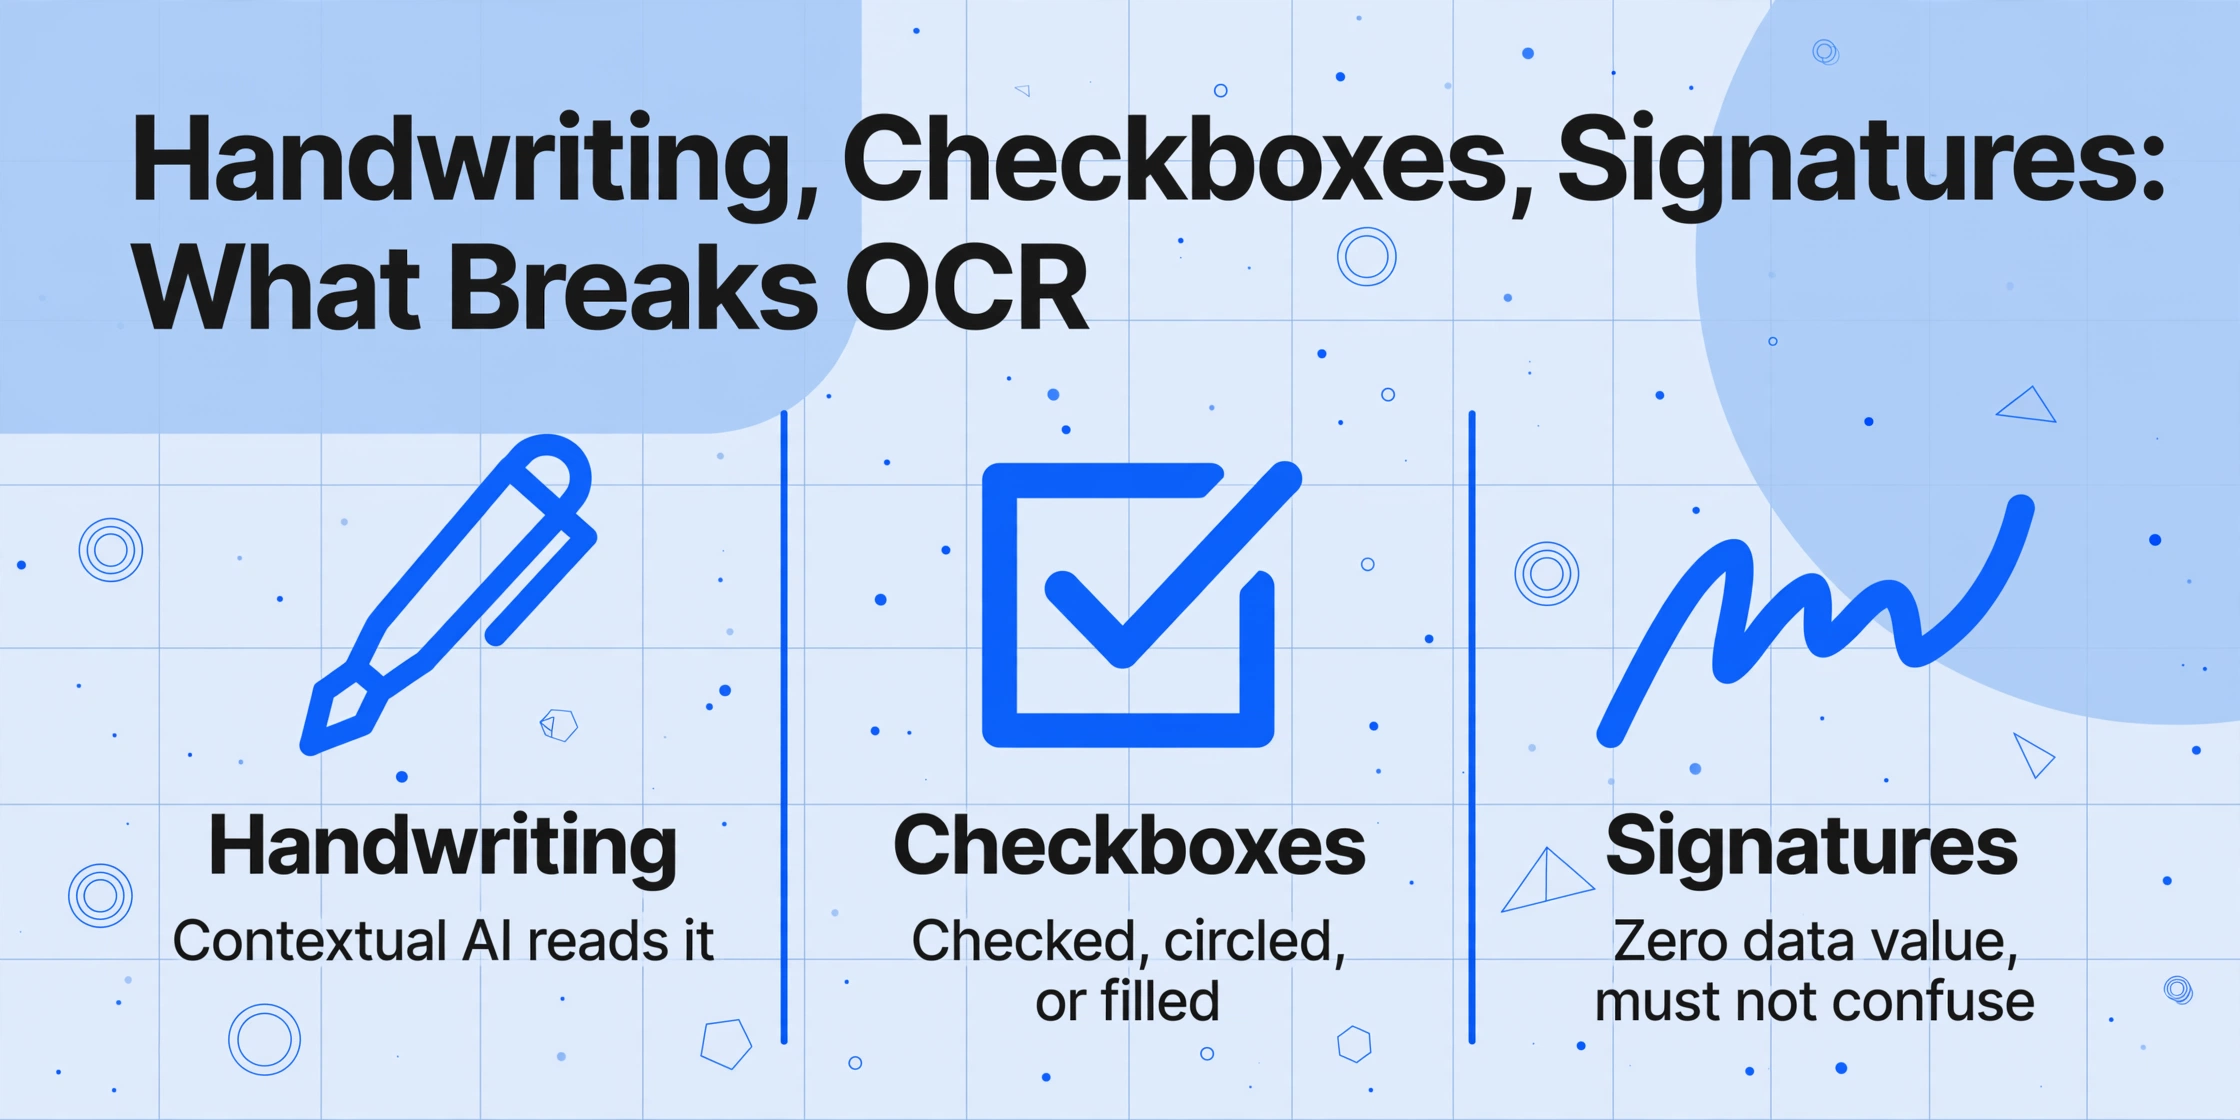
ほとんどのOCRツールは、きれいな白い背景の印刷テキスト用に作られています。K-12の入学フォームは、体育館でクリップボードを持った保護者が記入するものです。手書きは一貫性がなく、チェックボックスはチェックされたり、丸で囲まれたり、完全に塗りつぶされたりします。また、どのページにも少なくとも1つの署名があり、抽出可能なデータ価値はゼロですが、ツールが誤った出力をしないように注意する必要があります。
手書きフィールド。入学フォームで手書き率が最も高いフィールド(保護者の電話番号、緊急連絡先の氏名、病歴など)は、エラーが発生した場合の影響が最も大きいフィールドでもあります。保護者の電話番号の入力ミスは、緊急時に学校が家族に連絡できないことを意味します。アレルギー表記の読み間違いは医療上の影響があります。
セマンティックAIは、文字レベルのOCRとは異なる方法で手書きを処理します。個々の文字の形を独立して識別し、それらを組み合わせて単語にするアプローチ(最初のループが曖昧な場合に手書きの「Amy」から「Emily」を生成するアプローチ)ではなく、AIはフィールド全体の視覚的文脈を読み取ります。「緊急連絡先氏名」セクションの手書きテキストのブロックを認識し、このブロックが保護者の意図した形式で人名を生成すべきであると理解し、周囲の印刷されたフィールドラベルを意味的アンカーとして使用して、不明瞭な手書きを曖昧さなく解釈します。
この文脈に基づく読み取りこそが、孤立したテキストブロックでの手書き精度70%と、明確な意味的文脈を持つフォームフィールドでの95%以上の差を生み出します。AI抽出の精度要因の詳細については、OCR精度向上の実践ガイドをご覧ください。
チェックボックス。入学フォームには5〜15個のチェックボックスがあります。交通手段の選択、ランチプログラムの対象資格、写真撮影の同意、テクノロジー同意書、ハンドブックの確認などです。従来のOCRはチェックボックスを完全に無視するか、スプレッドシートでは意味をなさない「☐」文字を出力します。
Semantic AIは、チェックボックスをラベル付きオプションとの位置関係を理解することでバイナリ状態として読み取ります。フォームに「交通手段:☐ バス ☐ 自家用車送迎 ☐ 徒歩」とあり、1つのボックスに印が付いている場合、AIは印が付いたボックスに対応するラベルを特定し、チェックボックス文字ではなく「バス」というラベルテキストを出力します。
署名。すべての入学書類には、テクノロジー同意書、メディア公開承諾書、ハンドブック確認書に対する保護者の署名があります。署名には抽出可能なデータはありません。保護者の名前は、走り書きの署名ではなく、印刷された名前欄から抽出する必要があります。しかし、従来のOCRは署名欄から文字化けした文字列を生成することがよくあります。
実用的な解決策:保護者の名前を署名欄ではなく、基本情報セクションから抽出するように列を定義します。フォームに署名されたことを確認する必要がある場合は、保護者の署名あり(はい/いいえ)のようなバイナリ列を定義します。AIは署名を読み取ろうとせずに、その存在を検出できます。これにより、抽出ノイズなしで監査証跡を得られます。
学年全体の入学フォームを1つのバッチとして処理する
本当の効率向上は、1枚の入学フォームをより速く抽出することではなく、100枚の入学フォームを抽出して1つのスプレッドシートを得ることです。
従来のデータ入力ワークフローでは、各書類は個別に処理されます。PowerSchoolを開き、新しい生徒レコードを作成し、基本情報欄を入力し、保護者連絡先を入力し、緊急連絡先を入力し、医療情報を入力し、同意ボックスにチェックを入れ、保存して次の書類に進みます。1枚あたり20分のペースで、各行の正確性を確認し、手書き欄を照合し、避けられないタイプミスを修正しながら進めると、1,000枚で333人時になります。
バッチ抽出はこれを逆転させます。書類処理は一度だけ行います(全書類をスキャン)。抽出は1つのジョブとして全書類に対して実行されます。出力は1,000行のスプレッドシートで、各行が完全な生徒入学レコードです。スタッフの時間はデータ入力からデータレビューへと移行します。スプレッドシートを開き、緊急連絡先欄をスポットチェックし、医療フラグを確認し、SISインポート前に人間のレビューが必要な行にフラグを立てます。
このワークフローは、入学事務局が大規模な成績証明書処理で行うことと似ています。教育現場でのバッチ処理の全体像については、成績証明書を入学データベースにバッチ処理するガイドをご覧ください。パイプラインのアーキテクチャは同じで、コースの成績ではなく入学データを使用するだけです。
よくある質問
英語以外の言語で記入されたフォームでも機能しますか?
はい、ただし重要な注意点があります。AIはスペイン語を含むほとんどの一般的な言語の手書き文字と印刷文字を読み取ります。スペイン語は米国のK-12入学フォームで最も頻繁に使用される英語以外の言語です。ただし、SISが英語のフィールドラベルを想定している場合は、定義する列名は英語にする必要があります。AIはスペイン語の手書きテキストを抽出し、対応する英語の列に配置します。フォームの「Nombre del Estudiante」は、スプレッドシートでは「Student First Name」になります。
複数の言語で入学フォームを提供している学区では、SISが想定する言語で列を一度定義すれば、各家庭がどの言語版のフォームを記入したかに関係なく、抽出は機能します。
2人を超える緊急連絡先が生徒にいる場合はどうすればよいですか?
フォームに含まれる最大数に合わせて、緊急連絡先用の列を定義してください。ほとんどの書類に緊急連絡先が2人分しかない場合でも、3人分あるものがあるなら、緊急連絡先用の列を3セット定義します(それぞれに氏名、続柄、電話番号)。AIは、緊急連絡先が2人分しかない書類については、3人目の欄を空白のままにします。バッチを再処理したり分割したりする必要はありません。
入学フォームの手書き文字の抽出精度はどのくらいですか?
入学フォームの印刷テキスト(フォーム自体のラベル、入力可能なPDFの入力済みフィールド)は、99%に近い精度です。手書きフィールドは文字の明瞭さに依存しますが、フィールド境界が明確な構造化フォーム(入学書類など)では、手書き抽出の精度は通常90%を超えます。エラーが発生しやすいフィールドは、区切り記号なしで書かれた電話番号(「5551234567」と「555-123-4567」の違い)や、詰まった手書きで書かれた略語の医療用語です。これらこそ、スポットチェックで優先的に確認すべきフィールドです。
このツールは手書きフィールドで100%の精度を保証するものではなく、どの抽出システムでもそれは不可能です。最重要フィールド(緊急連絡先と医療情報)を確実にチェックできるようにレビューワークフローを設計し、重要度の低いフィールド(ハンドブック受領確認日など)は、行ごとの完全検証ではなくサンプリングに近いレビュー率で許容してください。
入学書類にホチキス留めされた州の予防接種フォームからデータを抽出できますか?
はい、スキャンに含めれば可能です。州の予防接種フォームは構造化された表(ワクチン名が行、日付が列)であり、AIはこれを文章ではなく表として読み取ります。州が学校入学時に義務付ける特定のワクチン(DTaP、ポリオ、MMR、B型肝炎、水痘)の列を定義すれば、対応するセルから日付が抽出されます。SISが予防接種データを別モジュールに保存している場合は、予防接種の列を別のCSVにエクスポートして、そのモジュールにインポートしてください。
FERPAはこのワークフローにどのように適用されますか?
学生の入学フォームを第三者抽出ツールにアップロードすることは、FERPA(34 CFR § 99.30)に基づく教育記録からの個人識別情報の開示に該当します。フォームを処理する前に、抽出プロバイダーがデータ所有権、再開示制限、契約終了時の削除、違反通知、監査権をカバーする機関契約に署名していることを確認し、学生の文書がプロバイダーのAIモデルのトレーニングに使用されることがないようにしてください。完全なコンプライアンスフレームワークについては、学生データ抽出のためのFERPAコンプライアンスガイドをご覧ください。
入学フォーム抽出の目的は、人間によるレビューを排除することではありません。データ入力オペレーターの役割(手書きを読み取り、文字ごとに入力する)から、データレビュアーの役割(AIの出力がソース文書と一致しているかを、エラーが実際に影響を及ぼすフィールドで検証する)へと人間を移行させることです。この移行により、1,000件の入学パケット全体で、数週間の入力作業が1〜2日の検証作業に変わります。
今年の入学フォームでワークフローをテストしてください。SISフィールドに一致する列セットを定義します。10パケットのバッチを処理し、出力をスポットチェックします。精度が維持される場合(明確なフィールドラベルを持つ構造化フォームでは通常維持されます)、来年以降の8月のワークフローが確立されます。