Comment extraire les données des formulaires d'inscription des élèves
vers Excel pour les systèmes d'information des élèves des districts scolaires
Chaque mois d'août, le papier arrive. Un district K-12 de taille moyenne comptant 5 000 élèves reçoit des dossiers d'inscription pour environ 20 % de sa population — des familles qui se sont inscrites en personne, ont soumis des formulaires lors des événements d'inscription d'été, ou dont la langue principale n'est pas prise en charge par le portail en ligne. Chaque dossier compte 15 à 25 pages : données démographiques des élèves, coordonnées des parents, contacts d'urgence, conditions médicales, dossiers de vaccination, demandes de transport scolaire, consentement photo, accords d'utilisation de la technologie, accusé de réception du manuel. Multipliez par mille élèves, et le calcul pour le bureau d'accueil devient simple : des milliers de pages, chacune exigeant qu'une personne lise chaque champ, déchiffre l'écriture manuscrite, coche les cases et saisisse le tout dans PowerSchool, Infinite Campus ou Skyward.
Le goulot d'étranglement n'est pas que les données n'existent pas. C'est que les données vivent sur papier dans une douzaine de formats de champs différents — et votre SIS en a besoin sous forme de lignes structurées. Ce guide couvre un flux de travail pratique qui comble cet écart : numérisez les formulaires, définissez les colonnes de sortie une seule fois, et laissez l'IA sémantique extraire chaque type de champ dans une feuille de calcul prête pour l'importation dans le SIS.
Points clés à retenir
- 333 heures — c'est ce que coûtent mille dossiers d'inscription papier à saisir dans PowerSchool chaque mois d'août pour votre district.
- L'OCR traditionnel lit l'écriture manuscrite caractère par caractère mais n'a aucun moyen de savoir si un numéro de téléphone appartient au contact d'urgence ou au parent — la seule distinction dont votre SIS a réellement besoin.
- Définissez 28 noms de colonnes une seule fois, numérisez 200 dossiers en un seul lot, et obtenez une feuille de calcul complète prête pour l'importation — votre personnel passe de la ressaisie de chaque champ à la vérification ponctuelle des lignes les plus critiques uniquement.
Le formulaire d'inscription papier ne disparaît pas — voici pourquoi
Les portails d'inscription en ligne existent. PowerSchool Enrollment — déployé dans plus de 3 500 districts — propose des formulaires adaptés aux mobiles, une logique conditionnelle, le préremplissage des fratries et une synchronisation directe avec le SIS. Infinite Campus Online Registration promet « aucune saisie de données — il suffit de cliquer pour approuver ». Le discours des fournisseurs est constant : éliminez le papier, et le problème de saisie disparaît.
Ce discours oublie comment l'inscription fonctionne réellement sur le terrain. Une part importante des familles de chaque district remplit des formulaires papier — et les raisons sont structurelles, pas temporaires.
Barrières linguistiques. PowerSchool Enrollment prend en charge plusieurs langues, mais le parcours d'inscription complet — de la navigation sur le portail à la soumission du formulaire en passant par le téléchargement de documents — suppose un niveau de littératie numérique et de maîtrise de l'anglais que toutes les familles n'ont pas. Dans les districts où 15 % ou plus des familles parlent une autre langue que l'anglais à la maison, les formulaires papier remplis avec l'aide d'un membre du personnel bilingue restent la voie la plus accessible.
Événements d'inscription en personne. Le dispositif « jour d'inscription » dans le gymnase — tables, piles de dossiers vierges, familles remplissant des formulaires debout — a toujours lieu dans des centaines de districts chaque mois d'août. Pour les familles qui se présentent sans appareil, sans connexion internet, ou simplement parce qu'elles ont emménagé dans le district pendant l'été et que le portail en ligne n'a pas suivi, le papier est le recours universel.
Fracture numérique. Selon le National Center for Education Statistics, environ 49,5 millions d'élèves étaient inscrits dans les écoles publiques américaines de la maternelle à la terminale à l'automne 2023. Parmi les foyers avec enfants d'âge scolaire, on estime que 5 % à 8 % n'ont pas d'accès fiable au haut débit à domicile. Quand le seul moyen de respecter une date limite d'inscription est de remplir un dossier papier au bureau du district, les familles le font.
Mises à jour des élèves déjà inscrits. Les portails en ligne gèrent bien l'inscription des nouveaux élèves. Ce qu'ils gèrent moins bien, ce sont les formulaires de mise à jour annuels que chaque famille doit remplir — contacts d'urgence actualisés, nouvelles informations médicales, nouveau consentement pour la photo et la diffusion médiatique. De nombreux districts les envoient par courrier sous forme de dossiers papier parce que le flux de travail du portail SIS pour les élèves déjà inscrits est maladroit, nécessite un compte parent que beaucoup de familles n'ont jamais créé, ou tout simplement n'existe pas dans les versions plus anciennes du SIS encore utilisées dans les petits districts.
Résultat : même les districts qui ont investi dans l'inscription en ligne traitent encore des formulaires papier chaque mois d'août. La question n'est pas « comment éliminer le papier » — c'est « comment récupérer efficacement les données du papier une fois qu'il est là ».
Contenu d'un dossier d'inscription K-12 — et pourquoi chaque section représente un défi d'extraction différent
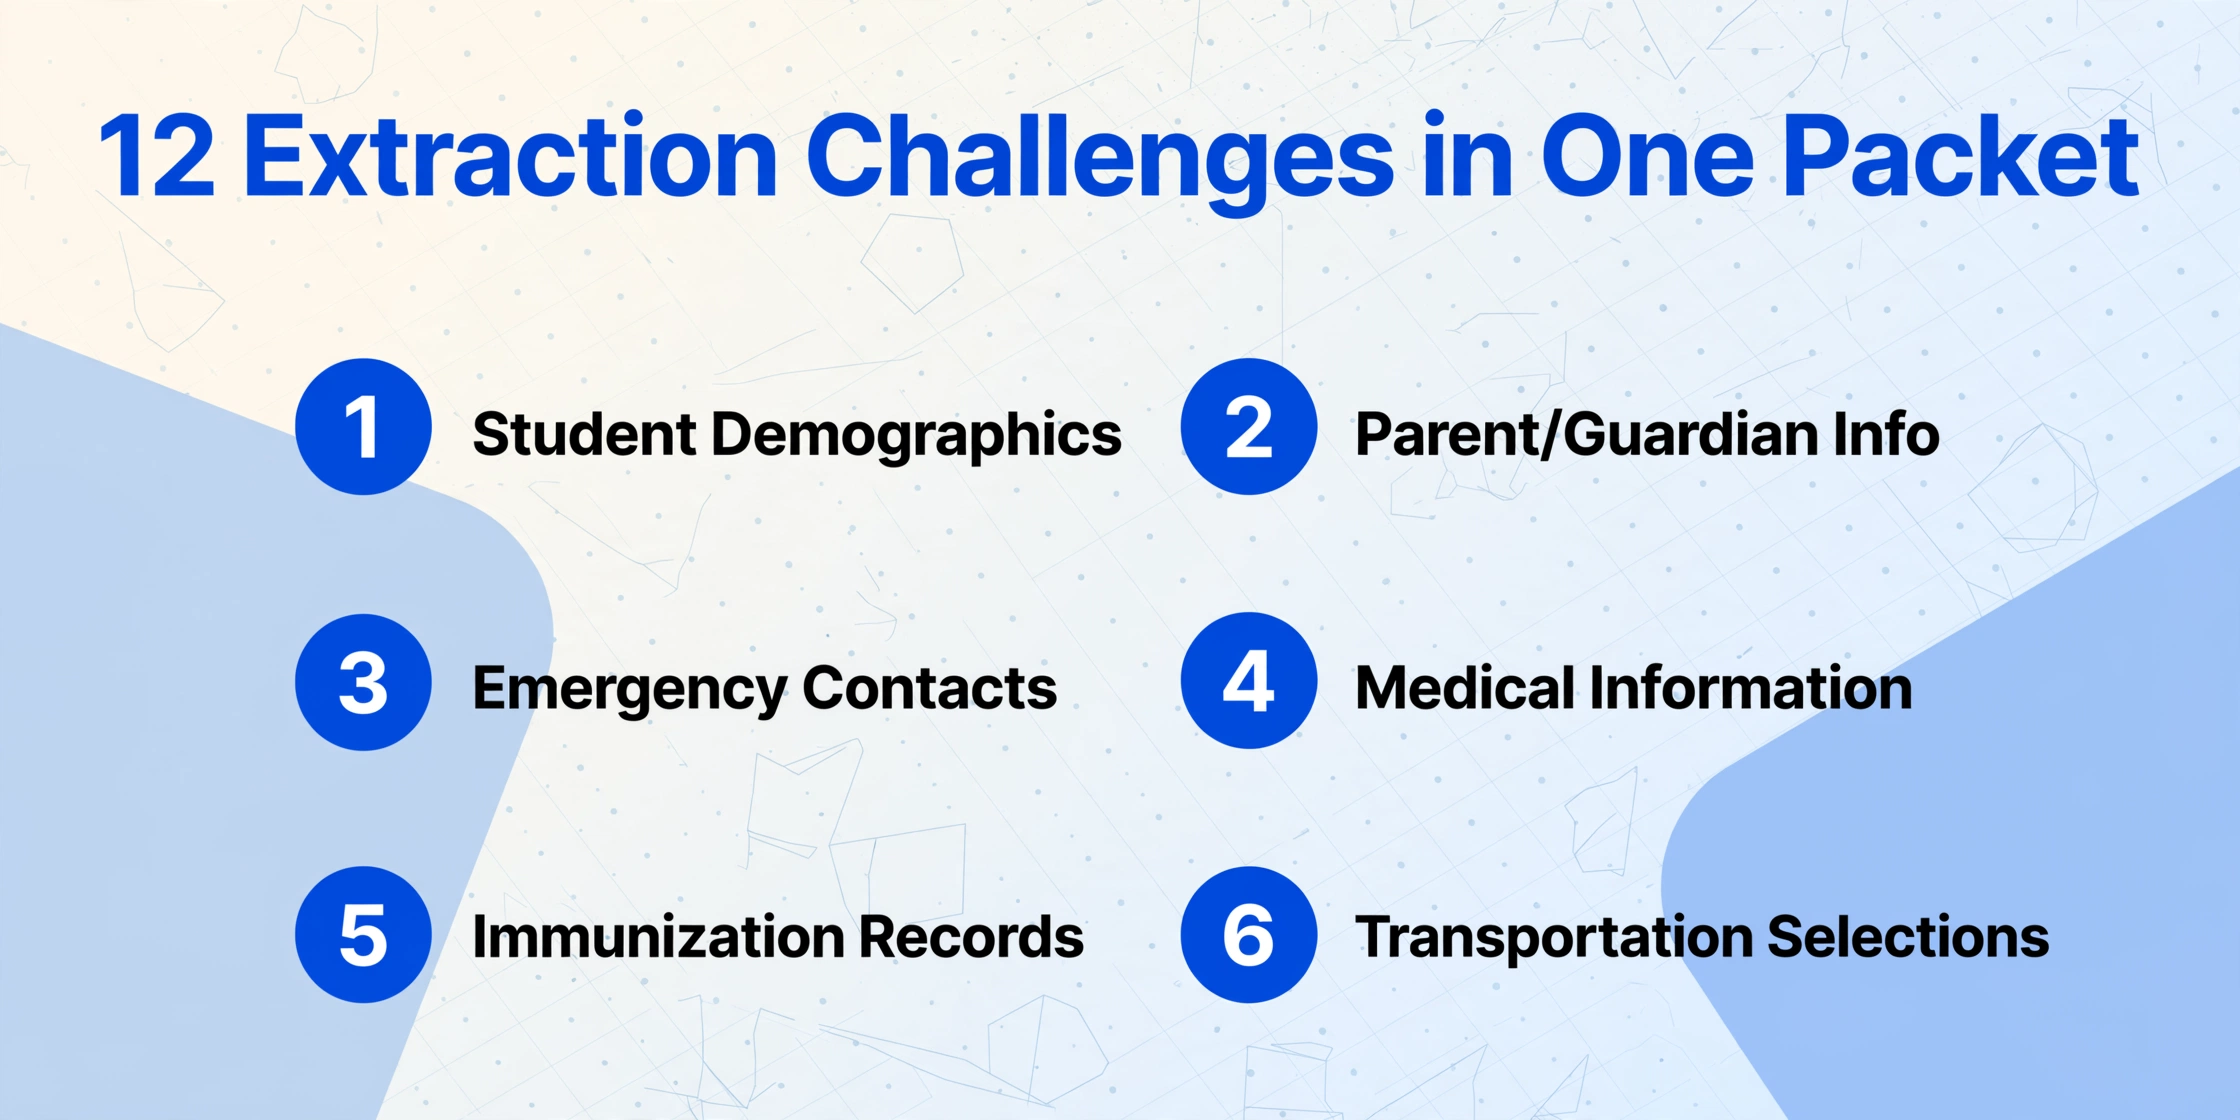
Un dossier d'inscription d'élève n'est pas un seul problème d'extraction de données. C'est douze problèmes d'extraction différents, chacun avec un format de champ différent, sur des pages conçues pour être remplies à la main dans un gymnase bondé. Comprendre les types de champs — et pourquoi chacun d'eux fait échouer l'OCR traditionnel — est la condition préalable à la mise en place d'un flux de travail d'extraction fonctionnel.
| Section | Champs typiques | Format de règle | Difficulté OCR |
|---|---|---|---|
| Données démographiques de l'élève | Nom complet, date de naissance, sexe, niveau d'entrée, adresse du domicile | Texte imprimé ou manuscrit dans des zones de saisie | Modérée — la date de naissance et l'adresse manuscrites sont les points de défaillance courants |
| Parent/Tuteur 1 et 2 | Nom, lien de parenté, téléphone, courriel, employeur, téléphone professionnel | Texte imprimé/manuscrit, blocs multilignes | Modérée — plusieurs contacts sur un même formulaire nécessitent une association de champs |
| Contacts d'urgence | Nom, lien de parenté, téléphone principal, téléphone secondaire (2 à 3 contacts) | Texte manuscrit, souvent abrégé | Élevée — les abréviations de lien de parenté et les numéros de téléphone manuscrits perturbent l'OCR au niveau des caractères |
| Informations médicales | Allergies, médicaments, maladies chroniques, nom/téléphone du médecin, hôpital préféré | Texte manuscrit dans des blocs narratifs | Élevée — conditions médicales en texte libre sans vocabulaire cohérent |
| Carnets de vaccination | Type de vaccin, date d'administration, prestataire (souvent un scan d'un formulaire d'État séparé) | Tableau structuré sur un formulaire émis par l'État | Élevée — petit texte de tableau, parfois une copie scannée d'une copie |
| Transport | Sélection bus / voiture / marcheur, numéro de ligne de bus, horaire AM/PM | Cases à cocher + numéros de ligne imprimés | Modérée — détection des cases à cocher + association de champs entre colonnes |
| Programme de cantine | Demande d'éligibilité gratuite/à tarif réduit, revenu du ménage, numéro de dossier | Cases à cocher + champs de revenu manuscrits | Élevée — données financières confidentielles avec des champs de petite taille |
| Accord d'utilisation des technologies | Nom de l'élève, nom du parent, date, signature du parent | Texte imprimé + ligne de signature manuscrite | Faible — principalement cases à cocher et signature, données structurées minimales à extraire |
| Autorisation photo/médias | Case à cocher d'accord/refus, nom de l'élève, signature du parent, date | Case à cocher + signatures | Faible — consentement binaire, charge d'extraction légère |
| Accusé de réception du manuel | Nom de l'élève, niveau, nom du parent, signature, date | Imprimé + signature | Faible — simple accusé de réception, aucune donnée structurée |
| Enquête sur la langue parlée à la maison | Langue principale parlée à la maison, langues supplémentaires, langue préférée du parent | Saisies manuscrites + sélection par cases à cocher | Modérée — les noms de langues sont des champs courts mais souvent manuscrits |
Ce qui rend un dossier d'inscription particulièrement difficile pour l'OCR traditionnel, c'est le mélange de types de champs sur une seule page. Sur une même feuille, vous pouvez trouver du texte imprimé (les étiquettes du formulaire lui-même), des réponses manuscrites en lettres capitales, des réponses manuscrites en cursive, des cases cochées, des options encerclées et une signature — le tout à quelques centimètres les uns des autres. L'OCR traditionnel lit les caractères. Il ne comprend pas qu'un numéro de téléphone écrit dans la case « Téléphone du contact d'urgence » appartient au contact d'urgence, et non au parent — et cette distinction compte lorsque les données arrivent dans un SIS qui possède des champs de base de données distincts pour chacun.
L'extraction sémantique par IA comble cette lacune en comprenant ce que chaque champ signifie, et non seulement ce qu'il indique. Lorsque vous définissez une colonne intitulée « Contact d'urgence 1 — Numéro de téléphone », l'IA recherche un numéro de téléphone dans la section du contact d'urgence du formulaire et l'associe au premier contact, et non au téléphone professionnel du parent situé deux sections plus haut. C'est la différence fondamentale entre la reconnaissance de caractères et la compréhension de documents — et c'est pourquoi les formulaires d'inscription bénéficient davantage de l'approche sémantique que la plupart des types de documents. Pour un aperçu plus approfondi de la manière dont la FERPA régit le moment où les données des élèves entrent dans un pipeline de traitement par IA, consultez notre guide de conformité FERPA pour l'extraction de documents d'admission.
Du dossier papier à la feuille de calcul prête pour le SIS : le processus en 3 étapes
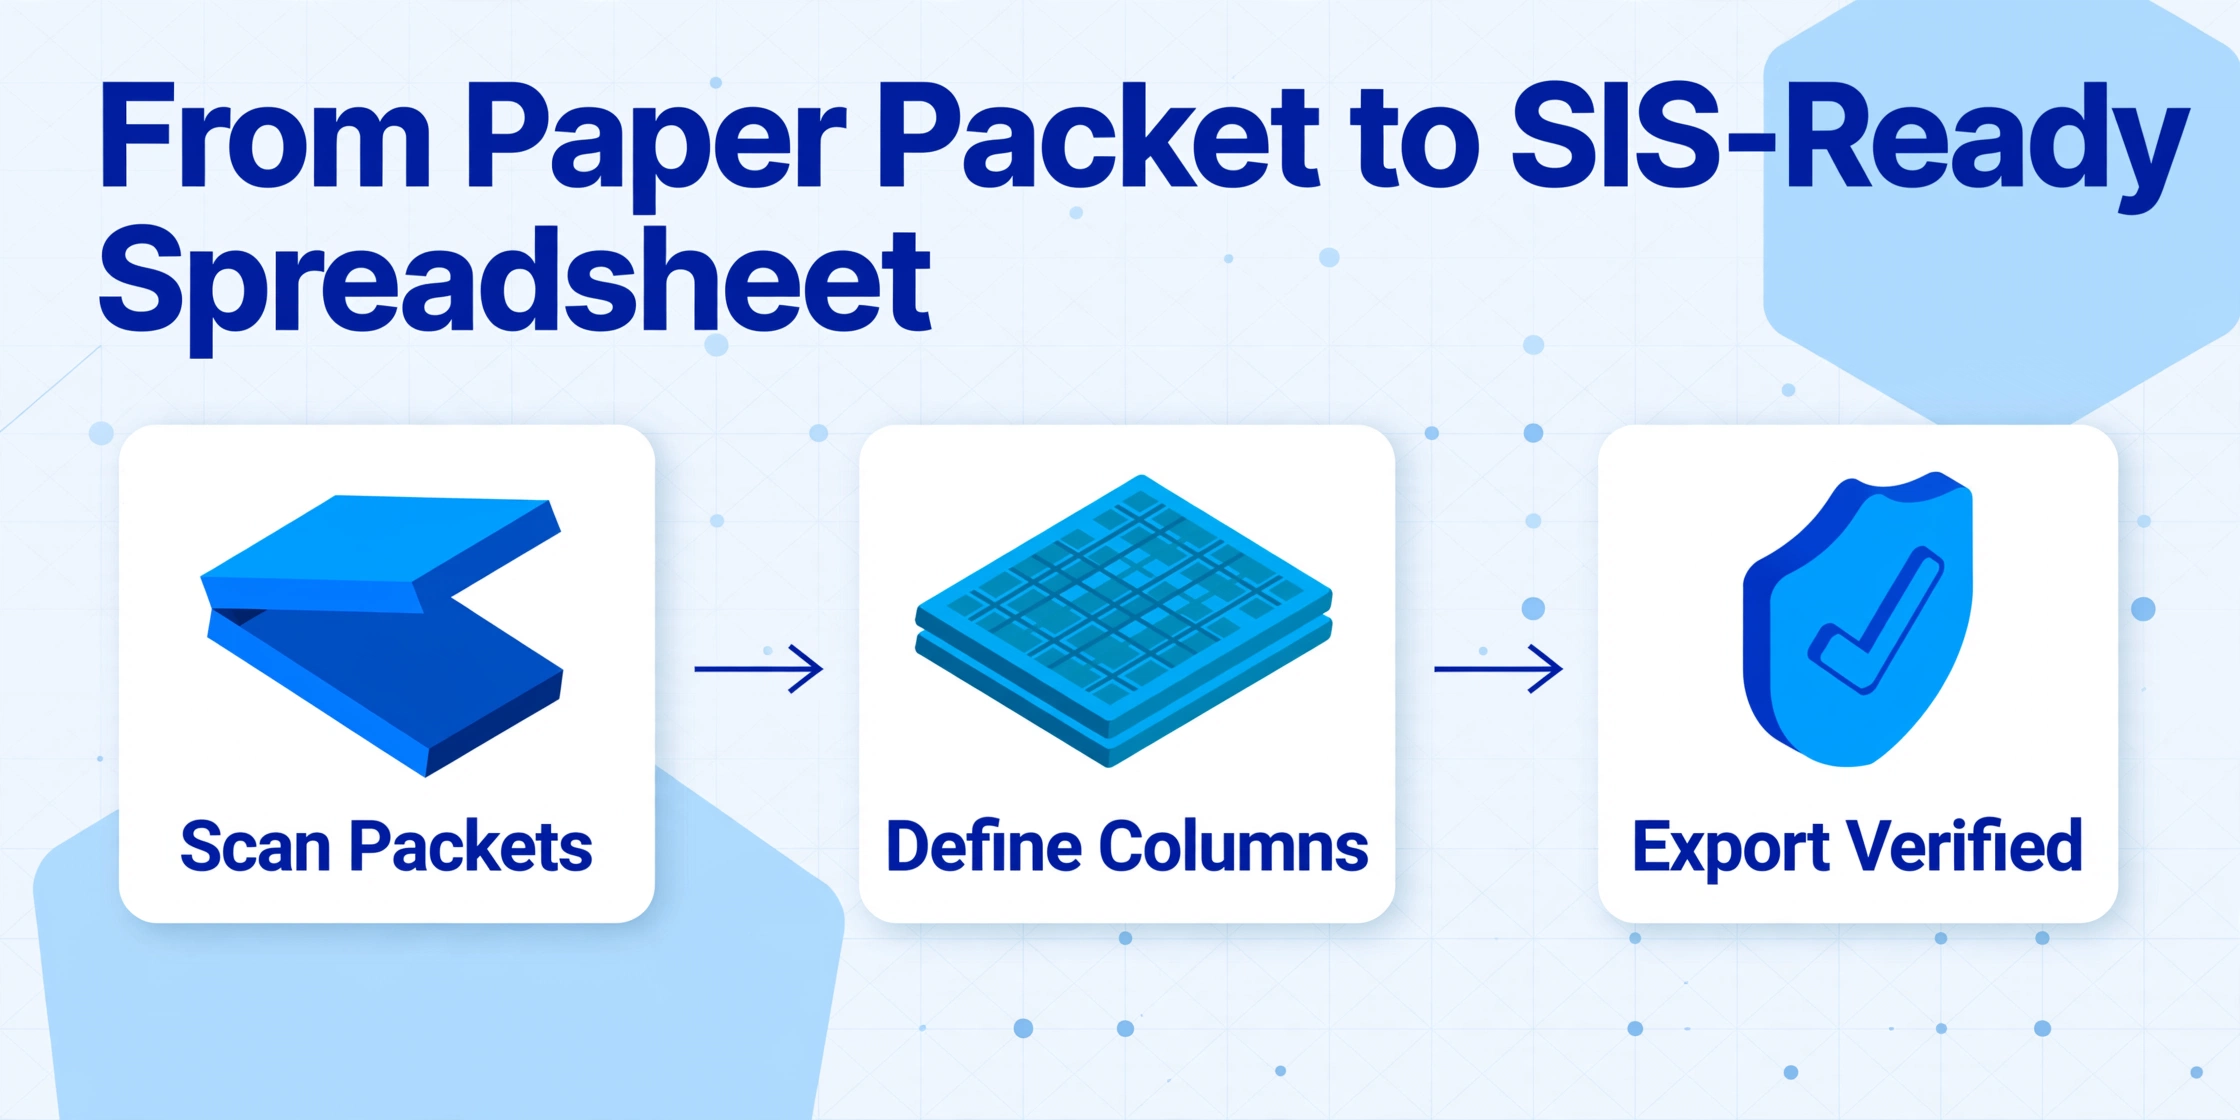
Le processus principal est suffisamment simple pour qu'un membre du personnel de la réception puisse l'exécuter sans soutien informatique. Ce qui demande le plus de réflexion, c'est la configuration des colonnes — si vous la faites correctement, l'extraction se déroule d'elle-même.
Étape 1 : Numériser les dossiers d'inscription
Numérisez toutes les pages du dossier de chaque élève en un seul PDF multipage par élève. Réglez votre scanner sur 300 DPI en niveaux de gris — la couleur alourdit la taille des fichiers sans gain de précision significatif pour la plupart des formulaires d'inscription, mais le noir et blanc perd le contraste subtil qui distingue une case à cocher d'une tache.
La convention de nommage est importante. Nommez chaque fichier [Grade]_[Nom]_[Prénom].pdf. Ce modèle de nommage sert deux objectifs : il fournit un identifiant unique pour chaque fichier et permet de recouper ultérieurement les données extraites avec le document source lors des vérifications ponctuelles, sans ouvrir chaque PDF.
Si les formulaires arrivent déjà agrafés en un seul dossier par élève, numérisez l'ensemble de chaque élève comme un seul document. Si le district organise les formulaires par type — tous les formulaires médicaux ensemble, tous les formulaires de transport ensemble — vous aurez besoin d'un flux de travail différent, mais ce modèle est rare dans l'inscription de la maternelle à la 12e année, où le dossier est organisé par élève et non par type de formulaire.
Étape 2 : Définir vos colonnes de sortie
C'est ici que le comportement de l'outil d'extraction est programmé — non pas avec du code ou des modèles, mais en listant exactement les champs que vous souhaitez dans votre feuille de calcul finale. Les noms de colonnes que vous saisissez deviennent à la fois les instructions pour l'IA et les en-têtes de votre tableau de sortie.
Pour un formulaire d'inscription de la maternelle à la 12e année, un ensemble de colonnes pratique ressemble à ceci :
Ensemble de colonnes recommandé pour les formulaires d'inscription de la maternelle à la 12e année
Nom de famille de l'élève
Prénom de l'élève
Date de naissance de l'élève
Niveau d'entrée
Adresse municipale
Ville
État
Code postal
Nom complet du parent/tuteur 1
Lien de parenté du parent/tuteur 1
Téléphone principal du parent/tuteur 1
Courriel du parent/tuteur 1
Nom complet du parent/tuteur 2
Lien de parenté du parent/tuteur 2
Téléphone principal du parent/tuteur 2
Nom du contact d'urgence 1
Lien de parenté du contact d'urgence 1
Téléphone du contact d'urgence 1
Nom du contact d'urgence 2
Lien de parenté du contact d'urgence 2
Téléphone du contact d'urgence 2
Problèmes de santé / Allergies
Nom du médecin traitant
Téléphone du médecin traitant
Mode de transport (Autobus / Voiture / Piéton)
Numéro de ligne d'autobus (si applicable)
Consentement photo/médias (Oui / Non)
Accord d'utilisation de la technologie signé (Oui / Non)
Accusé de réception du manuel signé (Oui / Non)
Quelques remarques sur la conception des colonnes pour les formulaires d'inscription :
Séparez le nom et le prénom. Les plateformes SIS stockent les noms des élèves dans des champs distincts. Extrayez-les séparément dès le départ et vous éviterez une étape de séparation manuelle dans Excel — une étape qui échoue face aux noms de famille composés, aux prénoms inscrits dans le champ du nom de famille, ou aux conventions de nommage culturelles qui ne suivent pas l'ordre occidental prénom-nom.
Utilisez des colonnes inférées pour les champs binaires. Pour les cases de consentement — autorisation photo, accord d'utilisation de la technologie, accusé de réception du manuel — définissez votre colonne avec les options entre parenthèses : Consentement photo/médias (Oui / Non). L'IA lira l'état de la case sur le formulaire et affichera « Oui » ou « Non » en conséquence. Vous n'avez pas besoin d'extraire les coordonnées des cases à cocher ni de tenter une détection pixel par pixel — l'IA lit le sens du formulaire, pas ses pixels.
Incluez le nom du champ SIS comme indication. Si votre district utilise PowerSchool, le champ pour le transport par autobus est souvent « Transportation Method » dans le menu déroulant. Nommer votre colonne Mode de transport (Autobus / Voiture / Piéton) donne à l'IA à la fois la cible sémantique et les options valides. Cela signifie également que l'en-tête de colonne dans votre Excel de sortie correspond au libellé du champ dans votre modèle d'importation SIS — une étape de correspondance en moins lors du téléchargement.
Pour une présentation détaillée de la définition des colonnes d'extraction sur tout type de document, consultez notre guide d'extraction des données de relevés de notes étudiants vers Excel, qui couvre les modèles de conception de colonnes applicables également aux formulaires d'inscription.
Étape 3 : Traiter et exporter vers le SIS
Téléversez tous les PDF numérisés en un seul lot. L'outil traite chaque fichier selon vos définitions de colonnes — extrayant les noms des étudiants, les coordonnées, les informations médicales, les statuts de consentement — et fusionne la sortie dans une seule feuille de calcul où chaque ligne correspond à un étudiant.
Le format de sortie qui importe pour l'importation SIS est Excel (.xlsx), que PowerSchool, Infinite Campus et Skyward acceptent tous nativement. Si votre SIS exige un CSV avec un ordre de colonnes spécifique, exportez en CSV et réorganisez les colonnes dans l'interface de l'outil avant le téléchargement.
Vérifiez les cinq premières lignes par rapport aux PDF originaux. Portez une attention particulière aux numéros de téléphone des contacts d'urgence — un chiffre inversé dans un champ de contact d'urgence est l'erreur la plus critique de tout le flux d'inscription. Si votre outil vous permet de nommer chaque fichier avec l'identifiant de l'étudiant, la colonne de nom de fichier dans la sortie vous donne une référence en un clic vers le document source pour chaque ligne.
Écriture manuscrite, cases à cocher et signatures : les trois éléments de formulaire qui brisent l'OCR traditionnel
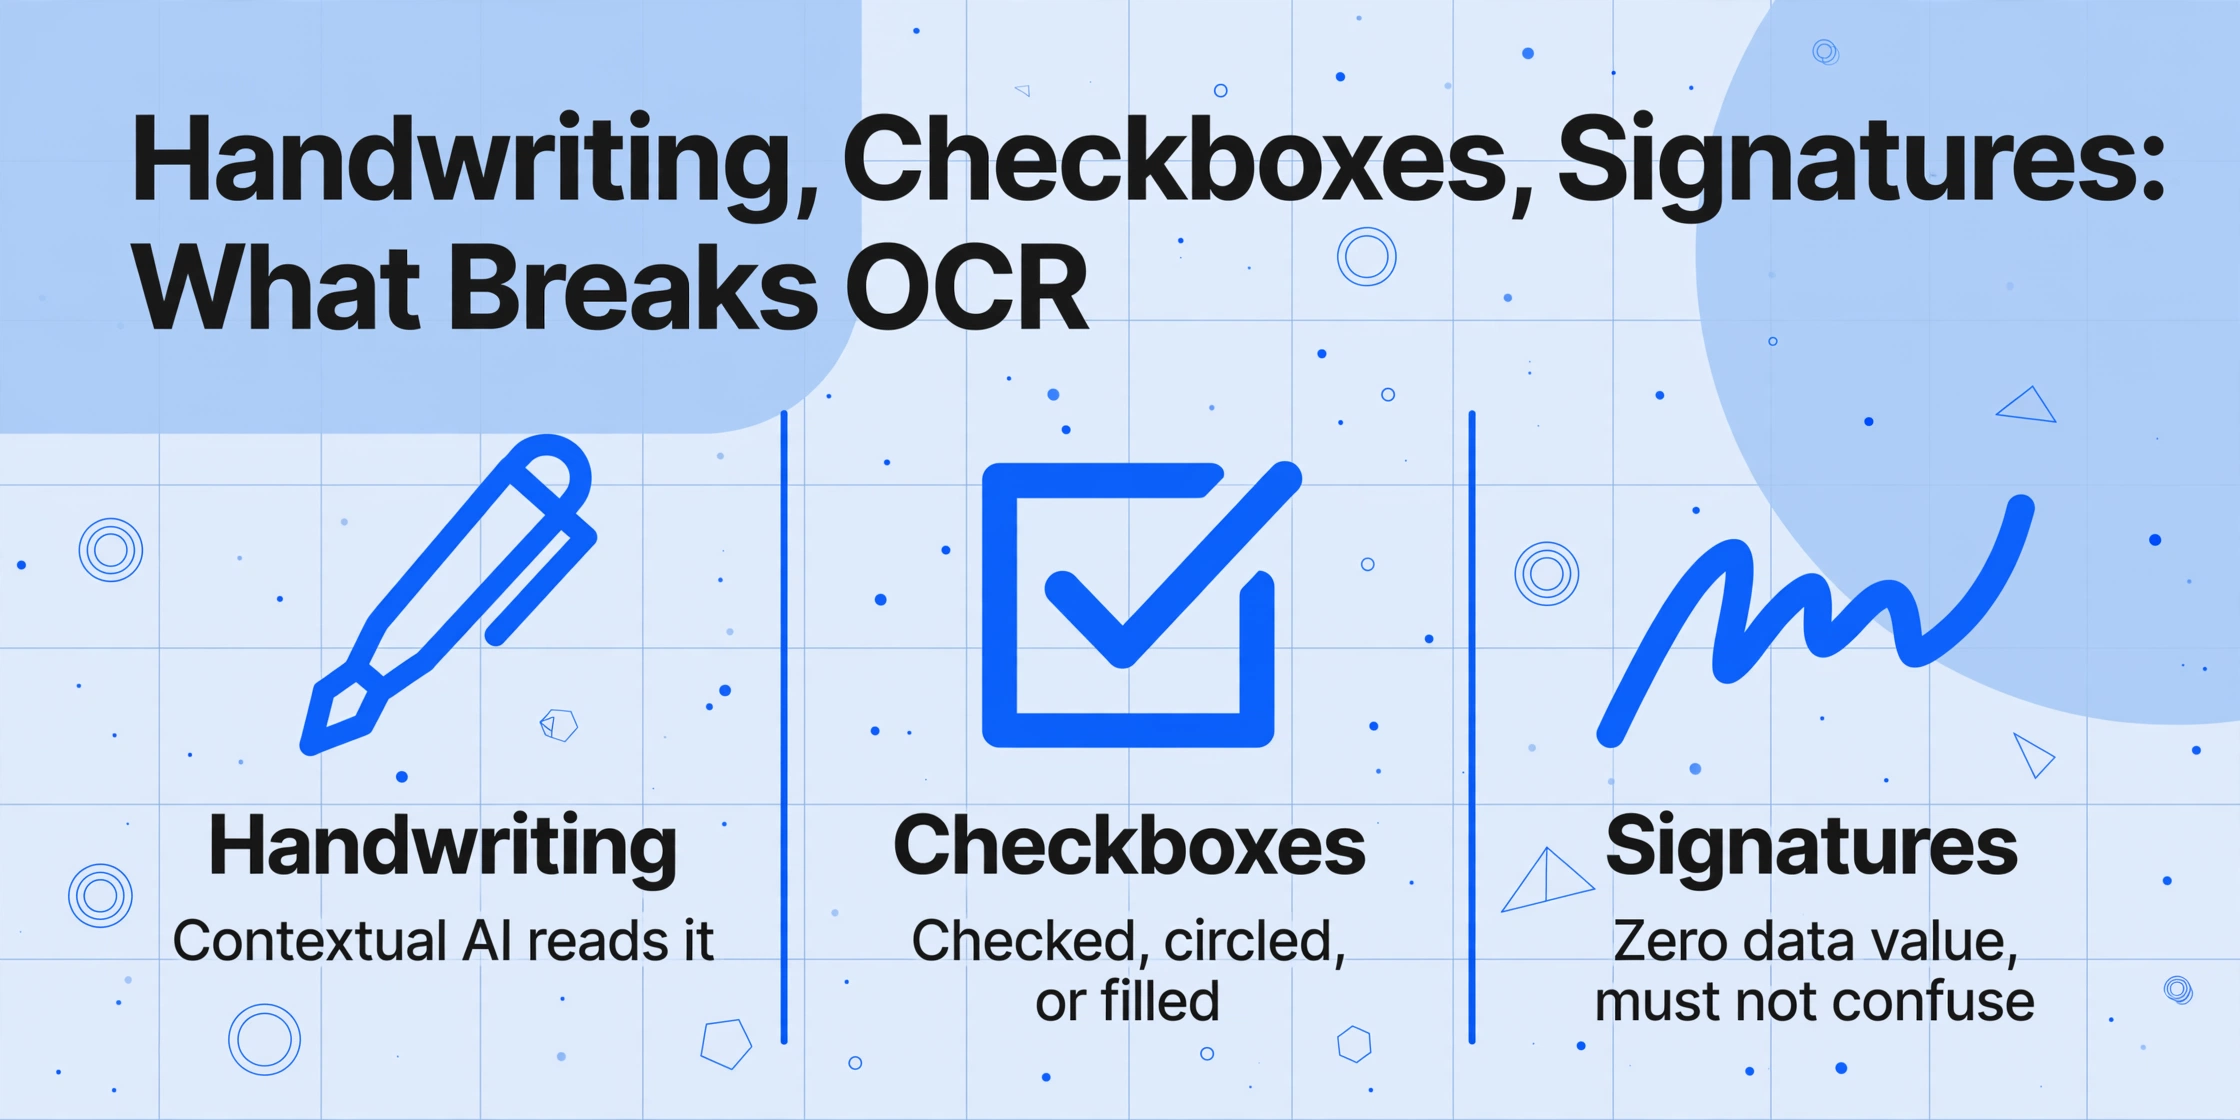
La plupart des outils OCR ont été conçus pour du texte imprimé sur fond blanc propre. Les formulaires d'inscription K-12 sont remplis par des parents debout dans un gymnase avec un presse-papiers — l'écriture manuscrite est incohérente, les cases à cocher sont parfois cochées, parfois entourées, parfois entièrement remplies, et chaque page comporte au moins une signature qui n'apporte aucune valeur de données extractible mais ne doit pas perturber l'outil au point de produire des résultats erronés.
Champs manuscrits. Les champs avec le taux d'écriture manuscrite le plus élevé sur les formulaires d'inscription — numéros de téléphone des parents, noms des contacts d'urgence, conditions médicales — sont aussi ceux où une erreur a les conséquences les plus graves. Un numéro de téléphone parental mal saisi signifie que l'école ne peut pas joindre la famille en cas d'urgence. Une notation d'allergie mal lue a des implications médicales.
L'IA sémantique traite l'écriture manuscrite différemment de l'OCR au niveau des caractères. Au lieu d'essayer d'identifier chaque forme de lettre indépendamment et de les assembler en mots — l'approche qui produit « Emily » à partir d'un « Amy » manuscrit lorsque la boucle initiale est ambiguë — l'IA lit le contexte visuel de l'ensemble du champ. Elle voit un bloc de texte manuscrit dans la section « Nom du contact d'urgence » et comprend que ce bloc doit produire un nom de personne, au format que le parent a voulu, en utilisant les étiquettes de champs imprimées environnantes comme ancres sémantiques pour lever l'ambiguïté de l'écriture manuscrite.
Cette lecture contextuelle fait la différence entre une précision de 70 % sur l'écriture manuscrite de blocs de texte isolés et de 95 %+ sur les champs de formulaire avec un contexte sémantique clair. Pour en savoir plus sur les facteurs de précision dans l'extraction par IA, consultez notre guide pratique pour améliorer la précision de l'OCR.
Cases à cocher. Les formulaires d'inscription contiennent de 5 à 15 cases à cocher — choix du mode de transport, éligibilité au programme de repas, consentement photo, accord technologique, accusé de réception du manuel. L'OCR traditionnel ignore complètement les cases à cocher ou produit des caractères « ☐ » qui ne signifient rien dans une feuille de calcul.
L'IA sémantique lit les cases à cocher comme des états binaires en comprenant leur position par rapport aux options libellées. Lorsque le formulaire indique « Transport : ☐ Bus ☐ Voiture ☐ Piéton » et qu'une case est cochée, l'IA identifie quel libellé correspond à la case cochée et génère le texte du libellé — « Bus » — et non un caractère de case à cocher.
Signatures. Chaque dossier d'inscription contient les signatures des parents sur l'accord technologique, l'autorisation de diffusion et l'accusé de réception du manuel. Les signatures ne contiennent aucune donnée extractible — le nom d'un parent doit être extrait du champ de nom imprimé, et non d'une écriture cursive. Mais l'OCR traditionnel produit souvent une chaîne de caractères illisible à partir de la ligne de signature.
La solution pratique : définissez vos colonnes pour extraire le nom du parent de la section démographique, et non de la ligne de signature. Si vous devez confirmer qu'un formulaire a été signé, définissez une colonne binaire comme Signature du parent présente (Oui / Non) — l'IA peut détecter la présence d'une signature sans tenter de la lire. Cela vous donne la piste d'audit sans le bruit d'extraction.
Traiter les formulaires d'inscription de tout un niveau scolaire en un seul lot
Le véritable gain d'efficacité ne consiste pas à extraire un formulaire d'inscription plus rapidement — c'est d'extraire une centaine de formulaires d'inscription et d'obtenir une seule feuille de calcul.
Dans un flux de travail de saisie de données traditionnel, chaque dossier est traité indépendamment : ouvrir PowerSchool, créer un nouvel enregistrement d'élève, saisir les champs démographiques, saisir les contacts des parents, saisir les contacts d'urgence, saisir les informations médicales, cocher les cases de consentement, enregistrer, passer au dossier suivant. À un rythme mesuré de 20 minutes par dossier — en vérifiant chaque ligne pour l'exactitude, en recoupant les champs manuscrits, en corrigeant l'inévitable faute de frappe — mille dossiers représentent 333 heures de travail du personnel.
L'extraction par lots inverse ce processus. Vous gérez la paperasse une seule fois — numérisez tous les dossiers — et l'extraction s'exécute sur l'ensemble comme une seule tâche. Le résultat est une feuille de calcul avec mille lignes, chaque ligne étant un enregistrement complet d'inscription d'élève. Le temps du personnel passe de la saisie de données à la vérification des données : ouvrir la feuille de calcul, vérifier les champs de contacts d'urgence, valider les indicateurs médicaux et signaler les lignes nécessitant un examen humain avant l'importation dans le SIS.
Ce flux de travail reflète ce que font les bureaux des admissions avec le traitement des relevés de notes à grande échelle. Pour une vue complète du fonctionnement du traitement par lots dans un contexte éducatif, consultez notre guide sur le traitement par lots des relevés de notes dans une base de données d'admissions — l'architecture du pipeline est la même, avec des données d'inscription au lieu de notes de cours.
Questions fréquentes
Est-ce que cela fonctionne avec des formulaires remplis dans d'autres langues que l'anglais ?
Oui, avec une réserve importante. L'IA lit les textes manuscrits et imprimés dans la plupart des langues courantes, y compris l'espagnol — qui est la langue non anglaise la plus fréquente sur les formulaires d'inscription K-12 aux États-Unis. Toutefois, les noms de colonnes que vous définissez doivent être en anglais si votre SIS attend des libellés de champs en anglais. L'IA extraira le texte manuscrit espagnol et le placera dans la colonne anglaise correspondante — « Nombre del Estudiante » sur le formulaire devient « Student First Name » dans votre feuille de calcul.
Pour les districts qui fournissent des formulaires d'inscription en plusieurs langues, définissez vos colonnes une seule fois dans la langue attendue par votre SIS, et l'extraction fonctionnera quelle que soit la version linguistique du formulaire rempli par chaque famille.
Que faire si un élève a plusieurs contacts d'urgence au-delà des deux que nous avons définis comme colonnes ?
Définissez autant de colonnes de contacts d'urgence que le maximum contenu dans vos formulaires. Si la plupart des dossiers comportent deux contacts d'urgence mais que certains en ont trois, définissez trois ensembles de colonnes de contacts d'urgence — Nom, Lien et Téléphone pour chacun. L'IA laissera les champs du troisième contact vides pour les dossiers ne comportant que deux contacts. Vous n'avez pas besoin de retraiter ni de diviser le lot.
Quelle est la précision de l'extraction manuscrite sur les formulaires d'inscription ?
Le texte imprimé sur les formulaires d'inscription — les libellés du formulaire lui-même, les champs saisis sur les PDF remplissables — approche une précision de 99 %. Les champs manuscrits dépendent de la clarté de l'écriture, mais sur les formulaires structurés avec des limites de champs claires (comme les dossiers d'inscription), l'extraction manuscrite dépasse généralement 90 % de précision. Les champs les plus sujets aux erreurs sont les numéros de téléphone écrits sans séparateurs — « 5551234567 » au lieu de « 555-123-4567 » — et les termes médicaux abrégés écrits en écriture serrée. Ce sont précisément les champs que vous devez prioriser lors de vos vérifications ponctuelles.
L'outil ne garantit pas une précision de 100 % sur les champs manuscrits, et aucun système d'extraction ne le peut. Concevez votre flux de travail de vérification pour détecter les champs les plus critiques — contacts d'urgence et informations médicales — et acceptez que les champs à faible enjeu, comme les dates d'accusé de réception du manuel, puissent tolérer un taux de vérification plus proche de l'échantillonnage que d'une vérification ligne par ligne.
Puis-je extraire des données du formulaire de vaccination de l'État agrafé au dossier d'inscription ?
Oui, si vous l'incluez dans la numérisation. Le formulaire de vaccination de l'État est un tableau structuré — les noms des vaccins en lignes, les dates en colonnes — et l'IA le lit comme un tableau, et non comme un texte narratif. Définissez des colonnes pour les vaccins spécifiques que votre État exige pour l'entrée à l'école — DTaP, Polio, ROR, Hépatite B, Varicelle — et l'extraction récupérera les dates des cellules correspondantes. Si votre SIS stocke les données de vaccination dans un module séparé, exportez les colonnes de vaccination vers un CSV distinct pour les importer dans ce module.
Comment FERPA s'applique-t-il à ce flux de travail ?
Le téléchargement de formulaires d'inscription d'élèves vers un outil d'extraction tiers constitue une divulgation d'informations personnelles identifiables issues de dossiers scolaires au titre de la FERPA (34 CFR § 99.30). Avant de traiter tout formulaire, assurez-vous que votre fournisseur d'extraction signe un accord institutionnel couvrant la propriété des données, les restrictions de rediffusion, la suppression à la fin du contrat, la notification en cas de violation et les droits d'audit — et que les documents des élèves ne sont jamais utilisés pour entraîner les modèles d'IA du fournisseur. Pour le cadre de conformité complet, consultez notre guide de conformité FERPA pour l'extraction de données d'élèves.
L'objectif de l'extraction de formulaires d'inscription n'est pas d'éliminer la vérification humaine. Il s'agit de faire passer l'humain du rôle d'opérateur de saisie — lisant l'écriture manuscrite et la tapant caractère par caractère — au rôle de vérificateur de données, confirmant que la sortie de l'IA correspond au document source dans les champs où une erreur a des conséquences réelles. Ce changement, sur un millier de dossiers d'inscription, transforme plusieurs semaines de saisie en un jour ou deux de vérification.
Testez le flux de travail sur les formulaires d'inscription de cette année. Définissez un ensemble de colonnes correspondant à vos champs SIS. Traitez un lot de dix dossiers et vérifiez par sondage la sortie. Si la précision se maintient — et sur des formulaires structurés avec des étiquettes de champs claires, c'est généralement le cas — vous avez votre flux de travail d'août pour l'année prochaine et toutes les suivantes.