Cómo extraer datos de formularios de inscripción de estudiantes
a Excel para los sistemas de información estudiantil del distrito escolar
Cada agosto, llega el papel. Un distrito de K-12 de tamaño medio con 5,000 estudiantes recibe paquetes de inscripción de aproximadamente el 20% de su población: familias que se inscribieron en persona, entregaron formularios durante los eventos de registro de verano, o cuyo idioma principal no es compatible con el portal en línea. Cada paquete tiene de 15 a 25 páginas: datos demográficos del estudiante, datos de contacto de los padres, contactos de emergencia, condiciones médicas, registros de vacunación, solicitudes de transporte en autobús, consentimiento de fotografías, acuerdos de uso de tecnología, acuse de recibo del manual. Multiplique por mil estudiantes y las cuentas de la oficina principal se vuelven simples: miles de páginas, cada una requiere que una persona lea cada campo, descifre la letra, marque las casillas y lo escriba todo en PowerSchool, Infinite Campus o Skyward.
El cuello de botella no es que los datos no existan. Es que los datos viven en papel en una docena de formatos de campo diferentes, y su SIS los necesita como filas estructuradas. Esta guía cubre un flujo de trabajo práctico que cierra esa brecha: escanee los formularios, defina las columnas de salida una vez y deje que la IA semántica extraiga cada tipo de campo a una hoja de cálculo lista para la importación al SIS.
Puntos clave
- 333 horas: eso es lo que le cuesta a su distrito teclear mil paquetes de inscripción en papel en PowerSchool cada agosto.
- El OCR tradicional lee la escritura a mano carácter por carácter, pero no tiene forma de saber si un número de teléfono pertenece al contacto de emergencia o al padre; la única distinción que su SIS realmente necesita.
- Defina 28 nombres de columnas una vez, escanee 200 paquetes como un solo lote y obtenga una hoja de cálculo completa lista para importar: su personal pasa de teclear cada campo a revisar solo las filas de mayor riesgo.
El formulario de inscripción en papel no va a desaparecer: he aquí por qué
Los portales de registro en línea existen. PowerSchool Enrollment —implementado en más de 3,500 distritos— ofrece formularios adaptados a dispositivos móviles, lógica condicional, prellenado de hermanos y sincronización directa con el SIS. Infinite Campus Online Registration promete "sin entrada de datos: solo haga clic para aprobar". El argumento del proveedor es consistente: elimine el papel y el problema de la entrada de datos desaparece.
El argumento pasa por alto cómo funciona realmente la inscripción sobre el terreno. Una fracción significativa de las familias de cada distrito llena formularios en papel, y las razones son estructurales, no temporales.
Barreras idiomáticas. PowerSchool Enrollment admite varios idiomas, pero el flujo completo de inscripción —desde la navegación por el portal hasta la cumplimentación del formulario y la carga de documentos— presupone un nivel de alfabetización digital y dominio del inglés que no todas las familias tienen. En los distritos donde el 15% o más de las familias habla un idioma distinto del inglés en casa, los formularios en papel cumplimentados con la ayuda de un miembro bilingüe del personal de oficina siguen siendo la vía más accesible.
Eventos de inscripción presencial. La instalación del gimnasio para el "día de inscripción" —mesas, pilas de paquetes en blanco, familias llenando formularios de pie— sigue ocurriendo en cientos de distritos cada agosto. Para las familias que se presentan sin un dispositivo, sin conexión a internet, o simplemente porque se mudaron al distrito durante el verano y el portal en línea aún no se ha actualizado, el papel es el recurso universal.
Brechas de acceso digital. Según el National Center for Education Statistics, aproximadamente 49.5 millones de estudiantes estaban matriculados en escuelas públicas K-12 de EE. UU. en el otoño de 2023. Entre los hogares con niños en edad escolar, un 5% a 8% estimado carece de acceso confiable a banda ancha en casa. Cuando la única forma de cumplir con una fecha límite de inscripción es llenar un paquete en papel en la oficina del distrito, las familias lo hacen.
Actualizaciones de estudiantes que regresan. Los portales en línea gestionan bien la inscripción de estudiantes nuevos. Lo que gestionan menos bien son los formularios de actualización anual que toda familia que regresa debe completar: contactos de emergencia actualizados, nueva información médica, nuevo consentimiento para la publicación de fotos y medios. Muchos distritos los envían por correo como paquetes en papel porque el flujo de trabajo para estudiantes que regresan del portal del SIS es engorroso, requiere una cuenta de padre que muchas familias nunca crearon, o simplemente no existe en versiones más antiguas del SIS que aún se ejecutan en distritos más pequeños.
El resultado: incluso los distritos que invirtieron en el registro en línea siguen procesando formularios en papel cada agosto. La pregunta no es "cómo eliminamos el papel", sino "cómo sacamos los datos del papel de manera eficiente una vez que están aquí".
Qué contiene un paquete de inscripción de K-12 — y por qué cada sección es un desafío de extracción diferente
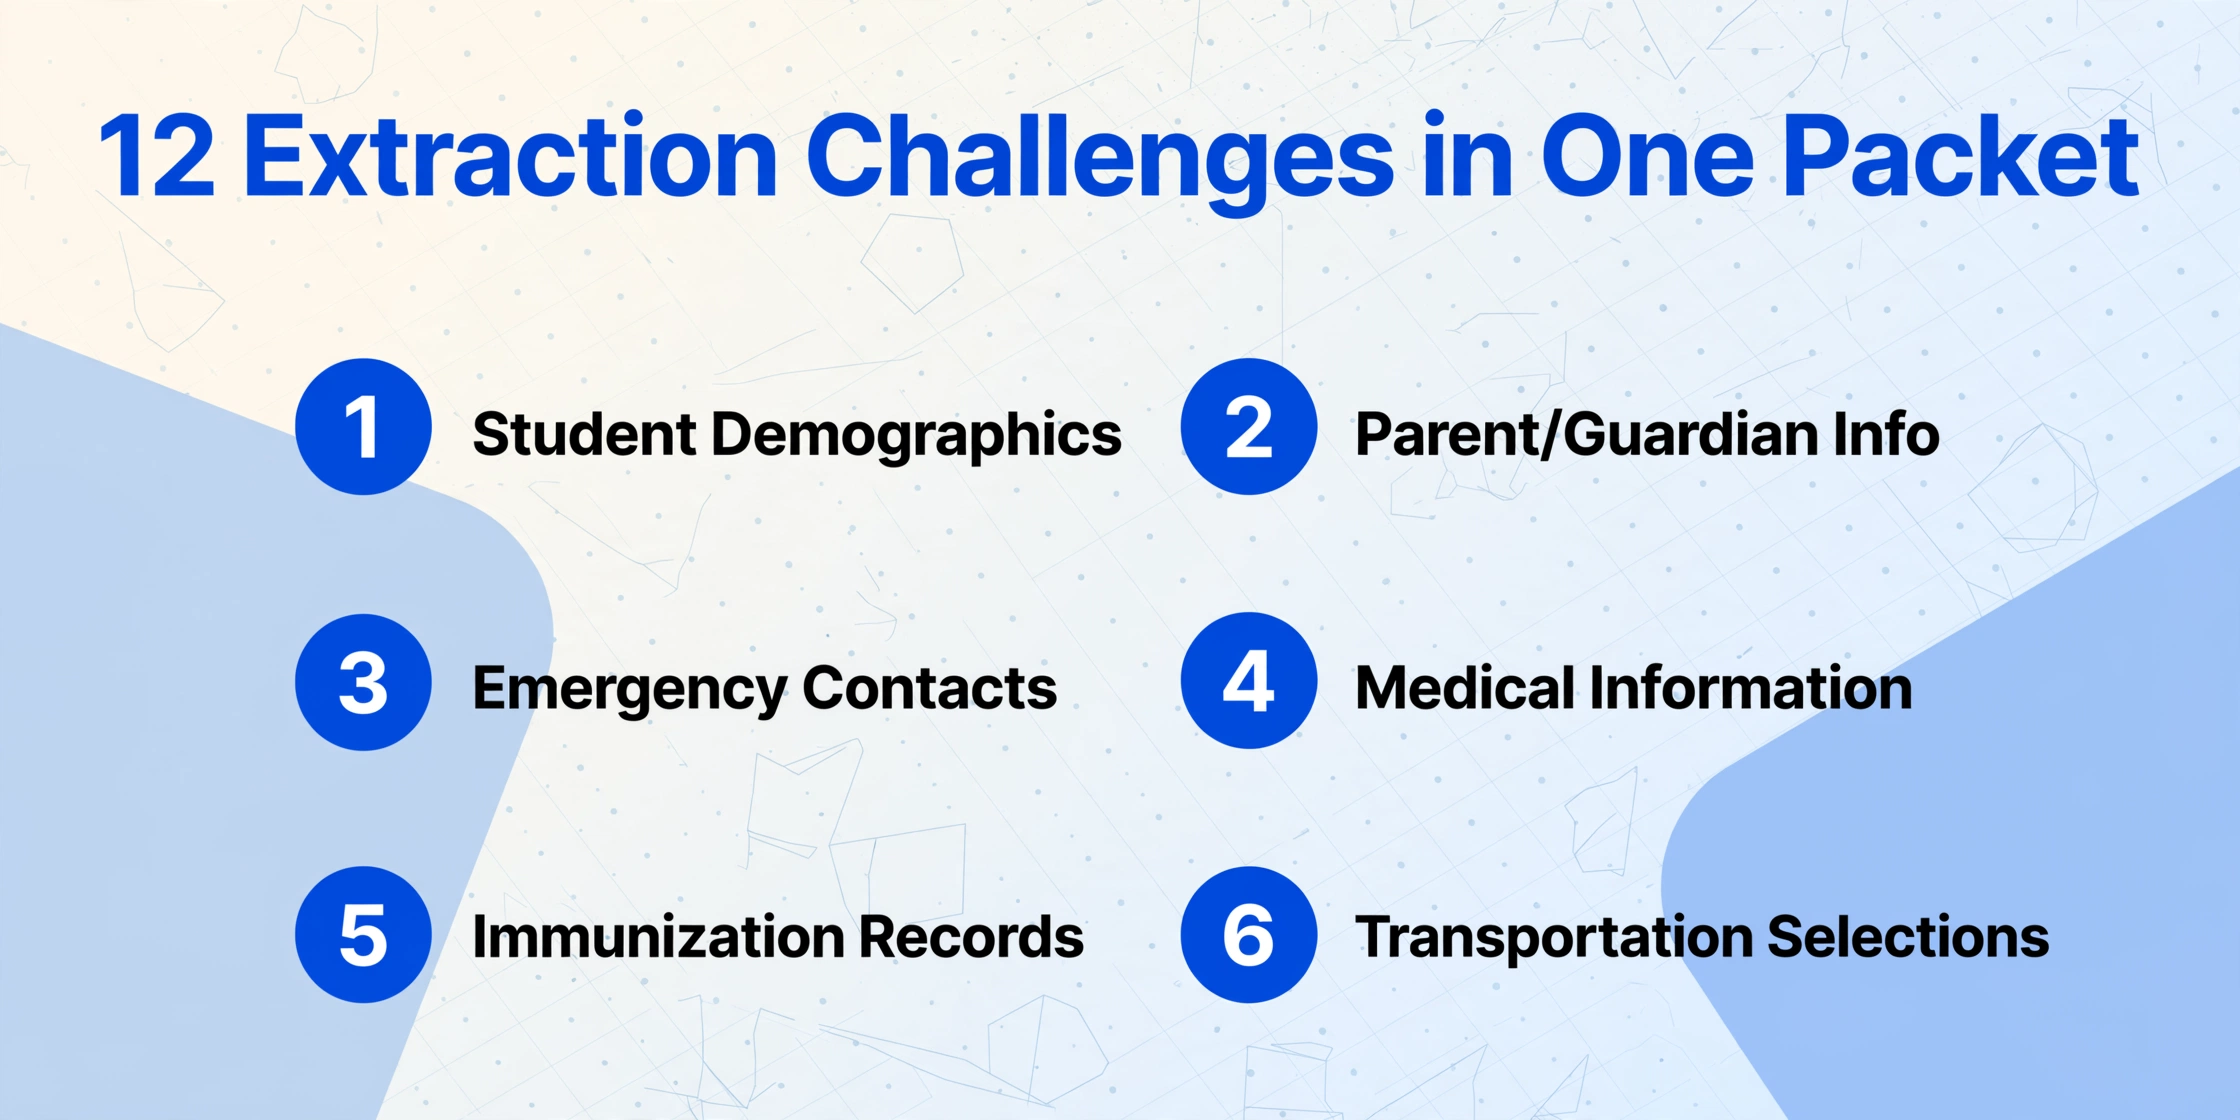
Un solo paquete de inscripción estudiantil no es un único problema de extracción de datos. Son doce problemas de extracción diferentes, cada uno con un formato de campo distinto, en páginas diseñadas para completarse a mano en un gimnasio abarrotado. Comprender los tipos de campo — y por qué cada uno rompe el OCR tradicional — es el requisito previo para configurar un flujo de trabajo de extracción funcional.
| Sección | Campos típicos | Formato del campo | Dificultad de OCR |
|---|---|---|---|
| Datos demográficos del estudiante | Nombre completo, fecha de nacimiento, género, grado al ingresar, dirección particular | Impreso o manuscrito en cuadros de texto | Moderada — la fecha de nacimiento y la dirección manuscritas son los puntos de falla comunes |
| Padre/Tutor 1 y 2 | Nombre, parentesco, teléfono, correo electrónico, empleador, teléfono del trabajo | Texto impreso/manuscrito, bloques de varias líneas | Moderada — varios contactos en un mismo formulario requieren asociación de campos |
| Contactos de emergencia | Nombre, parentesco, teléfono principal, teléfono alternativo (2-3 contactos) | Texto manuscrito, a menudo abreviado | Alta — las etiquetas de parentesco abreviadas y los números de teléfono manuscritos confunden el OCR a nivel de carácter |
| Información médica | Alergias, medicamentos, afecciones crónicas, nombre/teléfono del médico, hospital de preferencia | Manuscrito en bloques narrativos | Alta — afecciones médicas en texto libre sin vocabulario consistente |
| Registros de vacunación | Tipo de vacuna, fecha de administración, proveedor (a menudo un escaneo de un formulario estatal aparte) | Tabla estructurada en un formulario emitido por el estado | Alta — texto de tabla pequeño, a veces una copia escaneada de una copia |
| Transporte | Selección de autobús / automóvil / caminante, número de ruta del autobús, horario AM/PM | Casillas de verificación + números de ruta impresos | Moderada — detección de casillas + asociación de campos entre columnas |
| Programa de almuerzo | Solicitud de elegibilidad gratuita/reducida, ingreso del hogar, número de caso | Casillas de verificación + campos de ingreso manuscritos | Alta — datos financieros confidenciales con entradas en campos pequeños |
| Acuerdo de uso de tecnología | Nombre del estudiante, nombre del padre, fecha, firma del padre | Texto impreso + línea de firma manuscrita | Baja — principalmente casilla de verificación y firma, datos estructurados mínimos para extraer |
| Autorización de foto/medios | Casilla de aceptación/rechazo, nombre del estudiante, firma del padre, fecha | Casilla de verificación + firmas | Baja — consentimiento binario, carga de extracción ligera |
| Acuse de recibo del manual | Nombre del estudiante, grado, nombre del padre, firma, fecha | Impreso + firma | Baja — solo acuse de recibo, sin datos estructurados |
| Encuesta de idioma en el hogar | Idioma principal hablado en casa, idiomas adicionales, idioma preferido del padre | Entradas manuscritas + selección de casilla de verificación | Moderada — los nombres de idiomas son campos cortos pero a menudo manuscritos |
Lo que hace que un paquete de inscripción sea especialmente difícil para el OCR tradicional es la combinación de tipos de campos en una sola página. En una misma hoja puede encontrar texto impreso (las propias etiquetas del formulario), respuestas manuscritas en letra de molde, respuestas manuscritas en cursiva, casillas marcadas, opciones rodeadas con un círculo y una firma, todo a pocos centímetros de distancia. El OCR tradicional lee caracteres. No entiende que un número de teléfono escrito en la casilla «Teléfono del contacto de emergencia» pertenece al contacto de emergencia, no al padre o tutor, y esa distinción importa cuando los datos llegan a un SIS que tiene campos de base de datos separados para cada uno.
La extracción semántica con IA cierra esta brecha al comprender qué significa cada campo, no solo qué dice. Cuando usted define una columna llamada «Contacto de emergencia 1 — Número de teléfono», la IA busca un número de teléfono en la sección de contacto de emergencia del formulario y lo asocia con el primer contacto, no con el teléfono del trabajo del padre o tutor que está dos secciones más arriba. Esta es la diferencia fundamental entre el reconocimiento de caracteres y la comprensión de documentos, y es la razón por la que los formularios de inscripción se benefician del enfoque semántico más que la mayoría de los tipos de documentos. Para un análisis más profundo de cómo FERPA rige el momento en que los datos de los estudiantes entran en un flujo de procesamiento de IA, consulte nuestra guía de cumplimiento de FERPA para la extracción de documentos de admisión.
De paquete en papel a hoja de cálculo lista para el SIS: el flujo de trabajo en 3 pasos
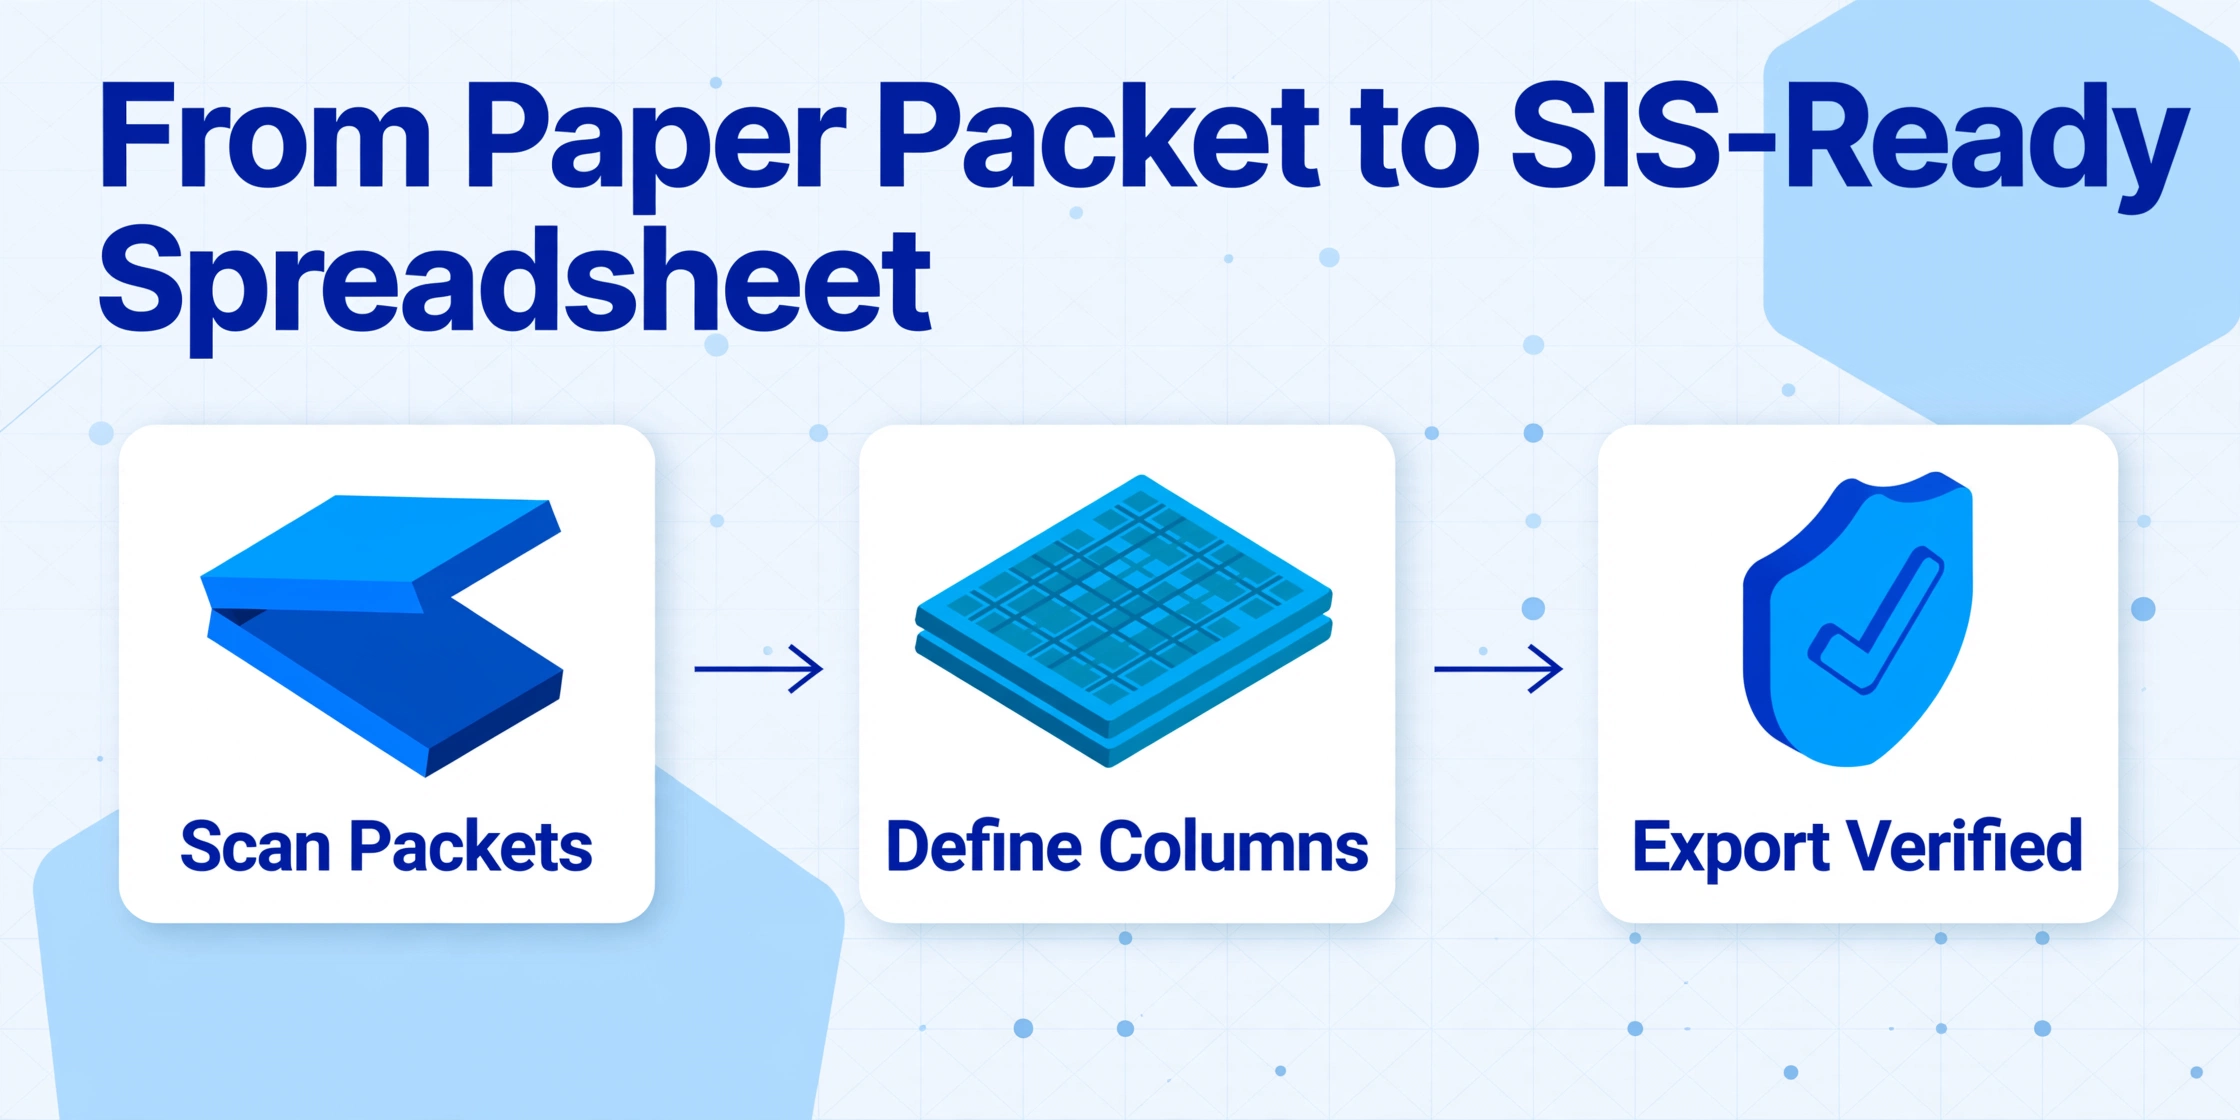
El flujo de trabajo principal es lo bastante sencillo como para que un miembro del personal de oficina pueda ejecutarlo sin apoyo de TI. Lo que requiere más reflexión es la configuración de las columnas: hágalo bien y la extracción se ejecuta sola.
Paso 1: Escanee los paquetes de inscripción
Escanee todas las páginas del paquete de cada estudiante en un solo PDF de varias páginas por estudiante. Configure su escáner a 300 DPI en escala de grises: el color aumenta el tamaño del archivo sin mejoras significativas de precisión para la mayoría de los diseños de formularios de inscripción, pero el blanco y negro pierde el contraste sutil que distingue una casilla de verificación de una mancha.
La convención de nombres es importante. Nombre cada archivo [Grado]_[Apellido]_[Nombre].pdf. Este patrón de nombres cumple dos propósitos: le da un identificador único a cada archivo y le permite luego cotejar los datos extraídos con el documento de origen durante las verificaciones puntuales sin abrir cada PDF.
Si los formularios llegan engrapados previamente como un solo paquete por estudiante, escanee el conjunto de cada estudiante como un solo documento. Si el distrito organiza los formularios por tipo —todos los formularios médicos juntos, todos los formularios de transporte juntos— necesitará un flujo de trabajo diferente, pero ese patrón es poco común en la inscripción de K-12, donde el paquete se organiza por estudiante, no por tipo de formulario.
Paso 2: Defina sus columnas de salida
Aquí es donde se programa el comportamiento de la herramienta de extracción, no con código ni plantillas, sino enumerando exactamente qué campos desea en su hoja de cálculo final. Los nombres de columna que escriba se convierten tanto en las instrucciones para la IA como en los encabezados de su tabla de salida.
Para un formulario de inscripción de K-12, un conjunto práctico de columnas se ve así:
Conjunto de columnas recomendado para formularios de inscripción de K-12
Apellido del estudiante
Nombre del estudiante
Fecha de nacimiento del estudiante
Grado al que ingresa
Dirección particular (calle)
Ciudad
Estado
Código postal
Nombre completo del padre/madre/tutor 1
Parentesco del padre/madre/tutor 1
Teléfono principal del padre/madre/tutor 1
Correo electrónico del padre/madre/tutor 1
Nombre completo del padre/madre/tutor 2
Parentesco del padre/madre/tutor 2
Teléfono principal del padre/madre/tutor 2
Nombre del contacto de emergencia 1
Parentesco del contacto de emergencia 1
Teléfono del contacto de emergencia 1
Nombre del contacto de emergencia 2
Parentesco del contacto de emergencia 2
Teléfono del contacto de emergencia 2
Condiciones médicas / Alergias
Nombre del médico de atención primaria
Teléfono del médico de atención primaria
Método de transporte (Autobús / Automóvil particular / A pie)
Número de ruta del autobús (si corresponde)
Consentimiento de foto/medios (Sí / No)
Acuerdo de uso de tecnología firmado (Sí / No)
Acuse de recibo del manual firmado (Sí / No)
Algunas notas sobre el diseño de columnas para formularios de inscripción:
Separe el nombre y el apellido. Las plataformas SIS almacenan los nombres de los estudiantes en campos separados. Extráigalos por separado desde el principio y evitará un paso de división manual en Excel, un paso que falla cuando se encuentra con apellidos compuestos, nombres de pila escritos en el campo del apellido o convenciones culturales de nombres que no siguen el orden occidental de nombre-apellido.
Use columnas inferidas para campos binarios. Para las casillas de consentimiento —autorización de fotos, acuerdo de uso de tecnología, acuse de recibo del manual— defina su columna con las opciones entre paréntesis: Consentimiento de foto/medios (Sí / No). La IA leerá el estado de la casilla en el formulario y generará "Sí" o "No" según corresponda. No necesita extraer las coordenadas de las casillas ni intentar una detección píxel por píxel: la IA lee el significado del formulario, no sus píxeles.
Incluya el nombre del campo del SIS como sugerencia. Si su distrito usa PowerSchool, el campo para el transporte en autobús suele ser "Transportation Method" en el menú desplegable. Nombrar su columna Método de transporte (Autobús / Automóvil particular / A pie) le da a la IA tanto el objetivo semántico como las opciones válidas. También significa que el encabezado de la columna en su Excel de salida coincide con la etiqueta del campo en su plantilla de importación del SIS: un paso de mapeo menos durante la carga.
Para obtener una guía detallada sobre cómo definir columnas de extracción en cualquier tipo de documento, consulte nuestra guía para extraer datos de expedientes académicos a Excel, que cubre patrones de diseño de columnas que se aplican igualmente a los formularios de inscripción.
Paso 3: Procesar y exportar al SIS
Cargue todos los PDF escaneados en un solo lote. La herramienta procesa cada archivo según sus definiciones de columnas —extrayendo nombres de estudiantes, datos de contacto, información médica, estados de consentimiento— y fusiona el resultado en una única hoja de cálculo donde cada fila es un estudiante.
El formato de salida que importa para la importación al SIS es Excel (.xlsx), que PowerSchool, Infinite Campus y Skyward aceptan de forma nativa. Si su SIS requiere CSV con un orden específico de columnas, exporte como CSV y reordene las columnas en la interfaz de la herramienta antes de descargar.
Verifique las primeras cinco filas contra los PDF originales. Preste especial atención a los números de teléfono de contacto de emergencia: un dígito transpuesto en un campo de contacto de emergencia es el error de mayor riesgo en todo el flujo de trabajo de inscripción. Si su herramienta le permite nombrar cada archivo con el identificador del estudiante, la columna de nombre de archivo en el resultado le ofrece una referencia con un solo clic al documento de origen para cada fila.
Escritura a mano, casillas de verificación y firmas: los tres elementos de formulario que rompen el OCR tradicional
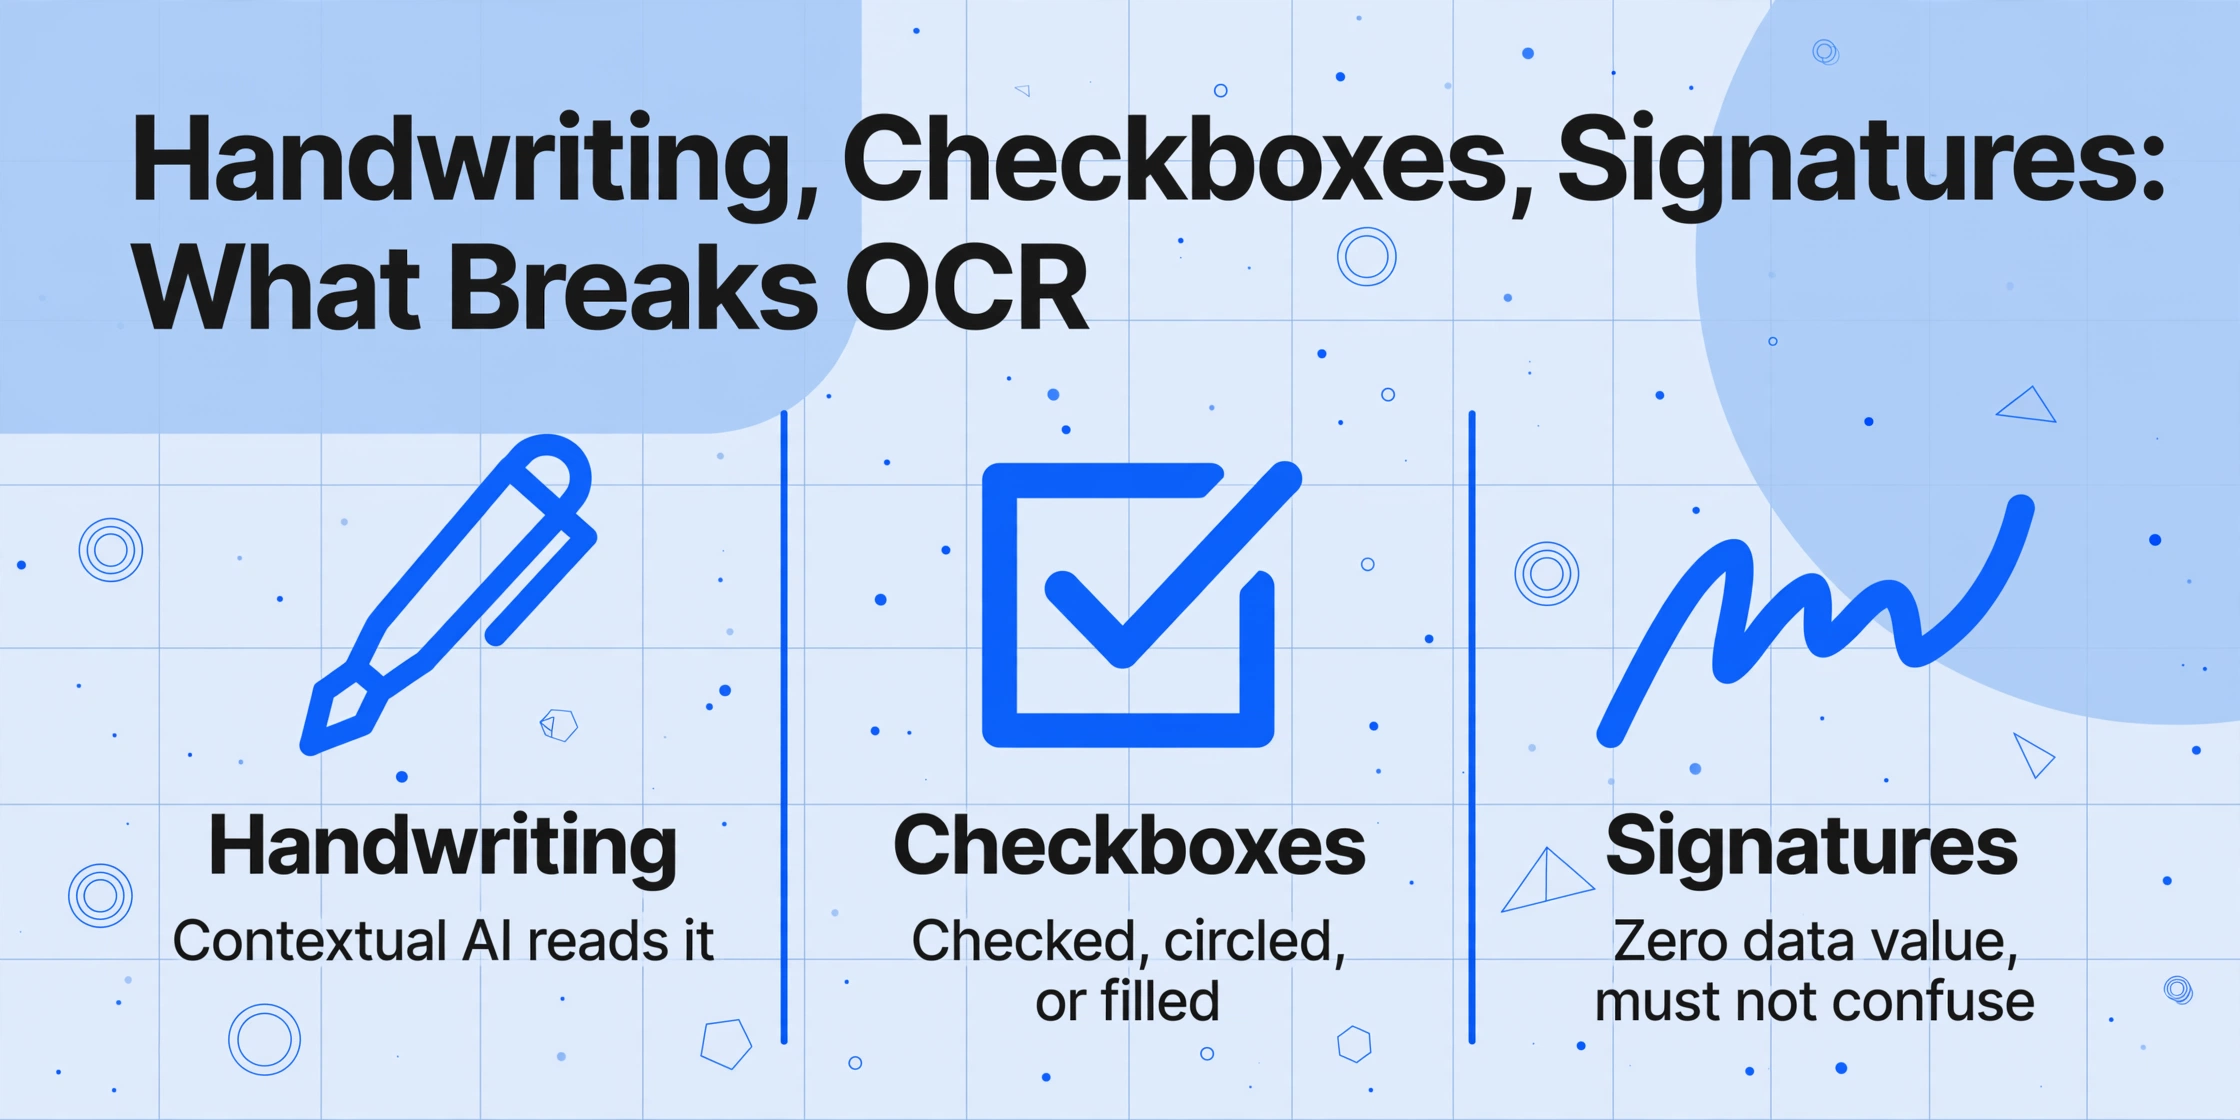
La mayoría de las herramientas de OCR se crearon para texto impreso sobre fondos blancos limpios. Los formularios de inscripción de K-12 los llenan los padres de pie en un gimnasio con un portapapeles: la escritura a mano es inconsistente, las casillas de verificación a veces están marcadas, a veces rodeadas con un círculo, a veces rellenadas por completo, y cada página tiene al menos una firma que no aporta ningún valor de datos extraíble pero que no debe confundir a la herramienta para que genere resultados sin sentido.
Campos escritos a mano. Los campos con mayor proporción de escritura a mano en los formularios de inscripción —números de teléfono de los padres, nombres de contactos de emergencia, condiciones médicas— son también los campos donde un error tiene la mayor consecuencia. Un número de teléfono de los padres mal escrito significa que la escuela no puede localizar a la familia en una emergencia. Una notación de alergia mal leída tiene implicaciones médicas.
La IA semántica maneja la escritura a mano de forma distinta al OCR a nivel de carácter. En lugar de intentar identificar la forma de cada letra de forma independiente y ensamblarlas en palabras —el enfoque que produce «Emily» a partir de un «Amy» escrito a mano cuando el bucle inicial es ambiguo—, la IA lee el contexto visual de todo el campo. Ve un bloque de texto manuscrito en la sección «Nombre del contacto de emergencia» y entiende que este bloque debe producir el nombre de una persona, en el formato que pretendía el padre, usando las etiquetas impresas de los campos circundantes como anclas semánticas para desambiguar la escritura poco clara.
Esta lectura contextual es lo que marca la diferencia entre un 70 % de precisión en escritura a mano en bloques de texto aislados y un 95 % o más en campos de formulario con un contexto semántico claro. Para obtener más información sobre los factores de precisión en la extracción con IA, consulte nuestra guía práctica para mejorar la precisión del OCR.
Casillas de verificación. Los formularios de inscripción contienen entre 5 y 15 casillas de verificación: selección del método de transporte, elegibilidad para el programa de almuerzos, consentimiento para fotografías, acuerdo tecnológico, reconocimiento del manual. El OCR tradicional ignora por completo las casillas de verificación o genera caracteres «☐» que no significan nada en una hoja de cálculo.
La IA semántica lee las casillas de verificación como estados binarios al comprender su posición respecto a las opciones etiquetadas. Cuando el formulario dice "Transportation: ☐ Bus ☐ Car Rider ☐ Walker" y una casilla está marcada, la IA identifica qué etiqueta corresponde a la casilla marcada y genera el texto de la etiqueta — "Bus" — no un carácter de casilla de verificación.
Firmas. Todo paquete de inscripción tiene firmas de los padres en el acuerdo de tecnología, la autorización de medios y el acuse de recibo del manual. Las firmas no contienen datos extraíbles — el nombre de un padre debe extraerse del campo de nombre impreso, no de un garabato cursivo. Pero el OCR tradicional a menudo produce una cadena de caracteres ilegible a partir de la línea de firma.
La solución práctica: defina sus columnas para extraer el nombre del padre de la sección demográfica, no de la línea de firma. Si necesita confirmar que un formulario fue firmado, defina una columna binaria como Parent Signature Present (Yes / No) — la IA puede detectar la presencia de una firma sin intentar leerla. Esto le da la pista de auditoría sin el ruido de extracción.
Procesar los formularios de inscripción de todo un grado escolar como un solo lote
La verdadera ganancia de eficiencia no es extraer un formulario de inscripción más rápido — es extraer cien formularios de inscripción y obtener una sola hoja de cálculo.
En un flujo de trabajo tradicional de ingreso de datos, cada paquete se procesa de forma independiente: abrir PowerSchool, crear un nuevo registro de estudiante, escribir los campos demográficos, escribir los contactos de los padres, escribir los contactos de emergencia, escribir la información médica, marcar las casillas de consentimiento, guardar, pasar al siguiente paquete. A un ritmo medido de 20 minutos por paquete — revisando cada línea para verificar su exactitud, cotejando los campos escritos a mano, corrigiendo el error tipográfico inevitable — mil paquetes son 333 horas de personal.
La extracción por lotes invierte esto. Usted realiza el manejo del papeleo una vez — escanea todos los paquetes — y la extracción se ejecuta en todos ellos como un solo trabajo. El resultado es una hoja de cálculo con mil filas, cada fila un registro completo de inscripción de estudiante. El tiempo del personal pasa del ingreso de datos a la revisión de datos: abrir la hoja de cálculo, verificar por muestreo los campos de contacto de emergencia, verificar los indicadores médicos y marcar cualquier fila que necesite revisión humana antes de la importación al SIS.
Este flujo de trabajo refleja lo que hacen las oficinas de admisiones con el procesamiento de expedientes académicos a escala. Para ver el panorama completo de cómo funciona el procesamiento por lotes en un contexto educativo, consulte nuestra guía para procesar expedientes académicos por lotes en una base de datos de admisiones — la arquitectura del proceso es la misma, solo que con datos de inscripción en lugar de calificaciones de cursos.
Preguntas frecuentes
¿Funciona con formularios completados en idiomas distintos del inglés?
Sí, con una advertencia importante. La IA lee texto manuscrito e impreso en la mayoría de los idiomas comunes, incluido el español, que es el idioma no inglés más frecuente en los formularios de inscripción de K-12 en EE. UU. Sin embargo, los nombres de las columnas que defina deben estar en inglés si su SIS espera etiquetas de campo en inglés. La IA extraerá el texto manuscrito en español y lo colocará en la columna en inglés correspondiente: "Nombre del Estudiante" en el formulario se convierte en "Student First Name" en su hoja de cálculo.
Para los distritos que ofrecen formularios de inscripción en varios idiomas, defina sus columnas una sola vez en el idioma que espera su SIS, y la extracción funcionará independientemente de la versión del formulario que haya completado cada familia.
¿Qué pasa si un estudiante tiene múltiples contactos de emergencia además de los dos que definimos como columnas?
Defina tantas columnas de contacto de emergencia como el máximo que contengan sus formularios. Si la mayoría de los paquetes tienen dos contactos de emergencia pero algunos tienen tres, defina tres conjuntos de columnas de contacto de emergencia — Nombre, Parentesco y Teléfono para cada uno. La IA dejará en blanco los campos del tercer contacto en los paquetes que solo tengan dos contactos. No necesita reprocesar ni dividir el lote.
¿Qué tan precisa es la extracción de texto manuscrito en los formularios de inscripción?
El texto impreso en los formularios de inscripción — las etiquetas propias del formulario, los campos escritos a máquina en PDF rellenables — alcanza una precisión cercana al 99%. Los campos manuscritos dependen de la claridad de la letra, pero en formularios estructurados con límites de campo claros (como los paquetes de inscripción), la extracción de texto manuscrito suele superar el 90% de precisión. Los campos más propensos a errores son los números de teléfono escritos sin separadores — "5551234567" frente a "555-123-4567" — y los términos médicos abreviados escritos con letra apretada. Estos son exactamente los campos que debe priorizar en su verificación puntual.
La herramienta no garantiza una precisión del 100% en los campos manuscritos, y ningún sistema de extracción puede hacerlo. Diseñe su flujo de revisión para detectar los campos de mayor riesgo — contactos de emergencia e información médica — y acepte que los campos de menor riesgo, como las fechas de acuse de recibo del manual, pueden tolerar una tasa de revisión más cercana al muestreo que a la verificación línea por línea.
¿Puedo extraer datos del formulario estatal de vacunación que está grapado al paquete de inscripción?
Sí, si lo incluye en el escaneo. El formulario estatal de vacunación es una tabla estructurada — nombres de vacunas en filas, fechas en columnas — y la IA lo lee como una tabla, no como texto narrativo. Defina columnas para las vacunas específicas que su estado exige para el ingreso escolar — DTaP, Polio, MMR, Hepatitis B, Varicela — y la extracción tomará las fechas de las celdas correspondientes. Si su SIS almacena los datos de vacunación en un módulo separado, exporte las columnas de vacunación a un CSV aparte para importarlo en ese módulo.
¿Cómo se aplica FERPA a este flujo de trabajo?
Cargar formularios de inscripción de estudiantes en una herramienta de extracción de terceros constituye una divulgación de información de identificación personal contenida en los expedientes educativos según FERPA (34 CFR § 99.30). Antes de procesar cualquier formulario, confirme que su proveedor de extracción firme un acuerdo institucional que cubra la propiedad de los datos, las restricciones de redivulgación, la eliminación al finalizar el contrato, la notificación de brechas y los derechos de auditoría, y que los documentos de los estudiantes nunca se utilicen para entrenar los modelos de IA del proveedor. Para conocer el marco de cumplimiento completo, consulte nuestra guía de cumplimiento de FERPA para la extracción de datos de estudiantes.
El objetivo de la extracción de formularios de inscripción no es eliminar la revisión humana. Es pasar a la persona del rol de operador de ingreso de datos —leer escritura a mano y teclearla carácter por carácter— al rol de revisor de datos, verificando que la salida de la IA coincida con el documento de origen en los campos donde un error tiene consecuencias reales. Ese cambio, a lo largo de mil paquetes de inscripción, convierte varias semanas de tecleo en uno o dos días de verificación.
Pruebe el flujo de trabajo con los formularios de inscripción de este año. Defina un conjunto de columnas que coincida con los campos de su SIS. Procese un lote de diez paquetes y verifique una muestra de la salida. Si la precisión se mantiene —y en formularios estructurados con etiquetas de campo claras, por lo general así ocurre—, tendrá su flujo de trabajo de agosto para el próximo año y para todos los años siguientes.