Por que seu OCR falha em fundos coloridos
e marcas d'água — 4 causas e correções
Você enviou um lote de faturas, executou a ferramenta de OCR e recebeu planilhas cheias de texto corrompido — ou pior, campos que voltaram completamente vazios. Se seus documentos têm fundos coloridos, marcas d'água ou seções destacadas, não há nada de errado com seu scanner ou suas configurações. O problema é que esses elementos visuais quebram ativamente a forma como o reconhecimento de caracteres funciona nos bastidores.
Principais conclusões
- Toda vez que o OCR trava em um cabeçalho de fatura colorido, o problema não são as configurações do seu scanner — a binarização tradicional foi criada para uma única premissa, tinta preta em papel branco, e essa premissa falha silenciosamente em todo o resto.
- Marcas d'água não apenas reduzem a legibilidade — os mecanismos de OCR não têm noção da intenção do documento, então DRAFT e CONFIDENTIAL se misturam aos seus totais extraídos como se fossem dados reais, contaminando números sem aviso.
- A extração semântica por IA ignora completamente a binarização — ela lê documentos como você, entendendo o layout e a intenção em vez de classificar cada pixel, o que significa que fundos coloridos e marcas d'água deixam de ser obstáculos.
O OCR tradicional foi projetado com base em uma premissa simples: texto preto sobre fundo branco. A maioria dos mecanismos de OCR — Tesseract, ABBYY FineReader, o OCR integrado do Adobe Acrobat — converte a imagem em uma representação binária em preto e branco (uma etapa chamada binarização) e depois compara as regiões escuras restantes com formatos de caracteres. No momento em que o fundo introduz cor, textura ou texto semitransparente, essa premissa deixa de funcionar.
Este é um dos desafios mais persistentes na extração automatizada de documentos. Não existe uma solução única que resolva todos os casos. Mas entender por que isso falha oferece uma vantagem prática: você pode diagnosticar a causa específica no seu documento, aplicar a correção certa e saber quando a limitação está na ferramenta — e não no documento.
Aqui estão as quatro formas mais comuns pelas quais fundos coloridos e marcas d'água causam falhas na extração por OCR, e o que fazer em cada caso.
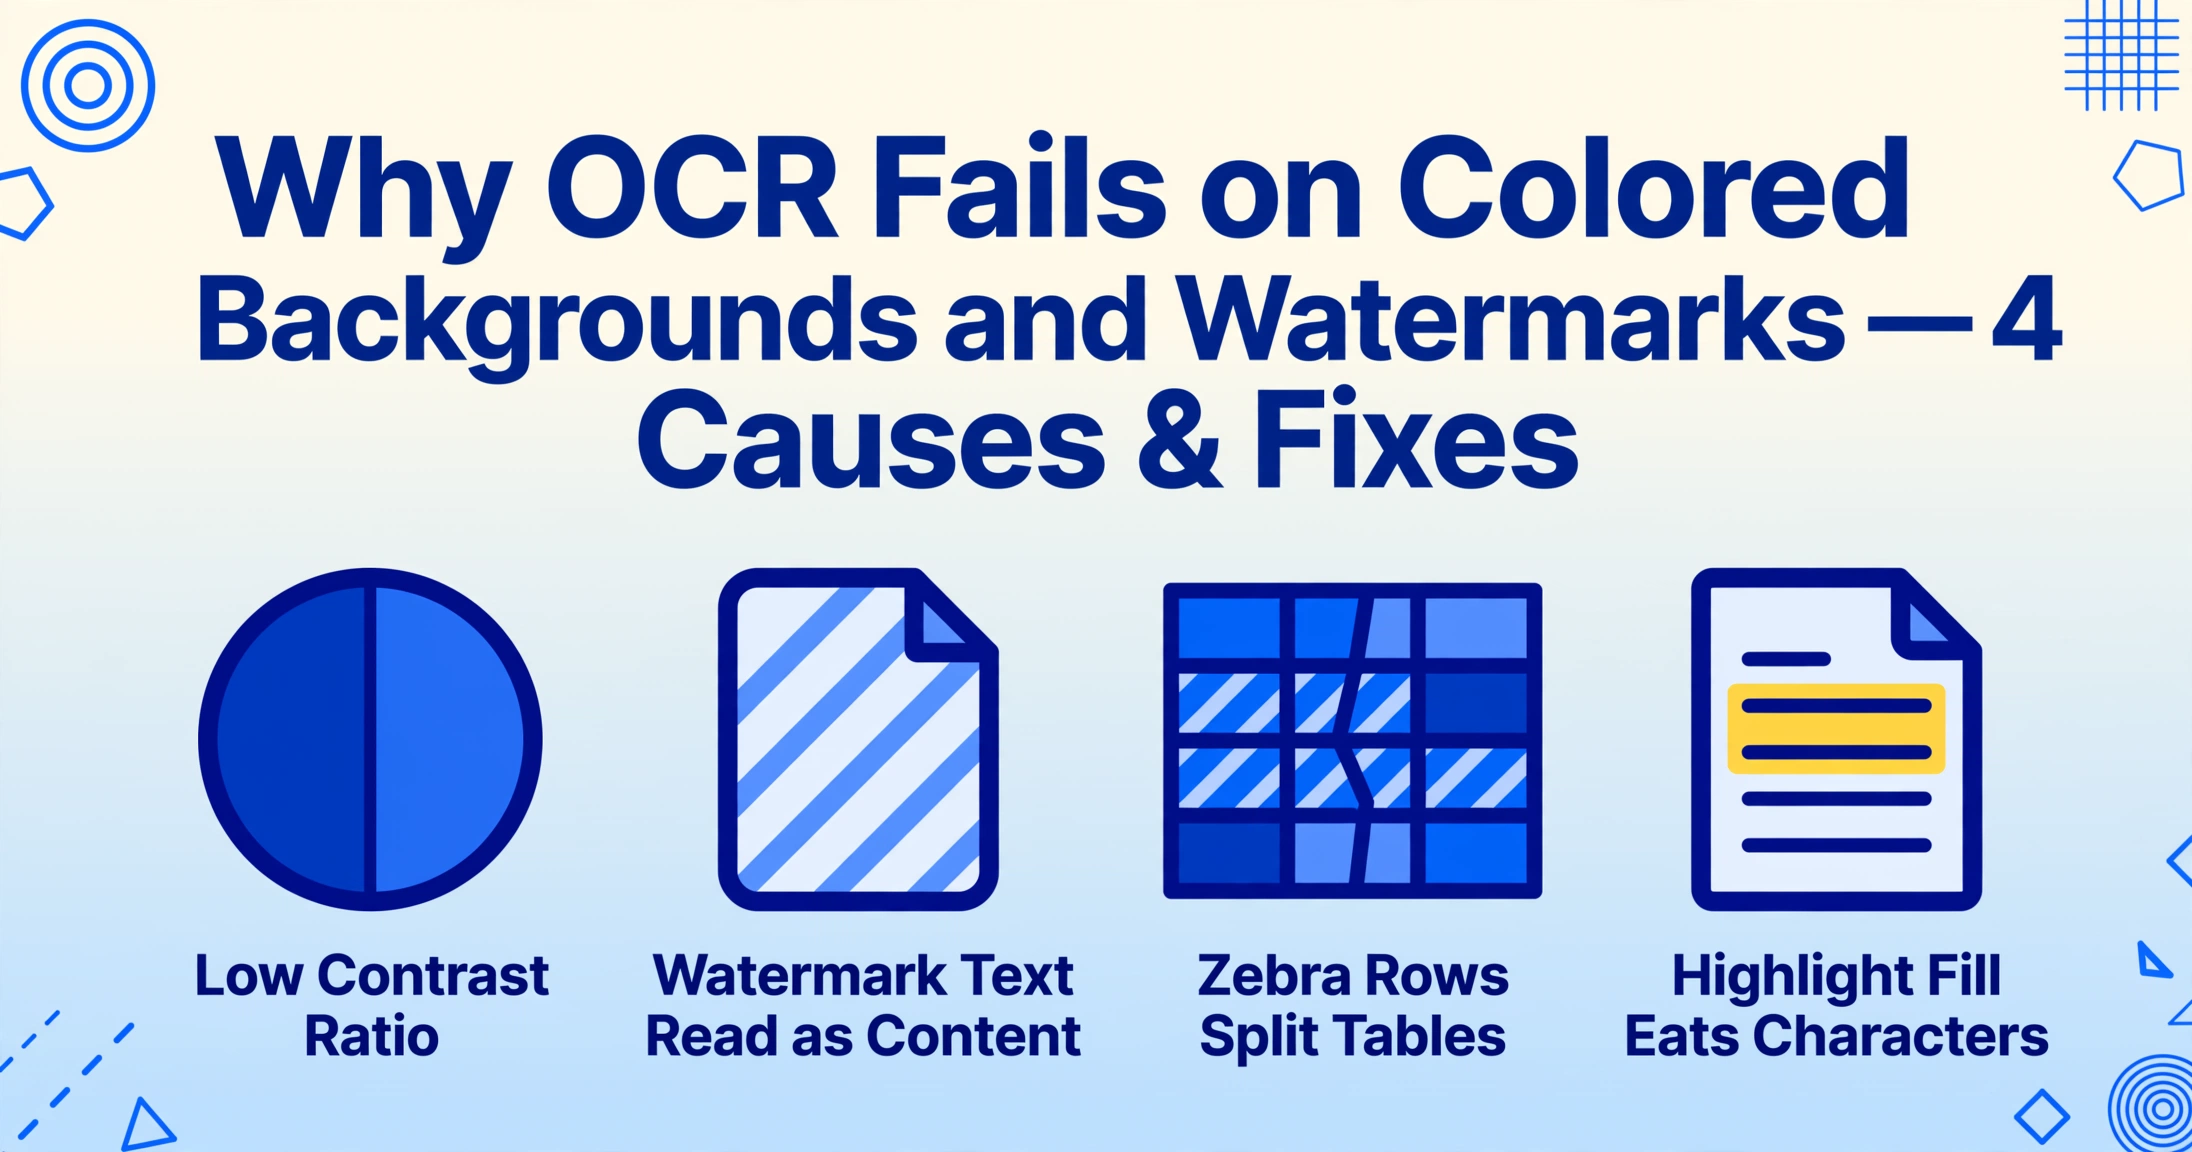
Causa 1: Baixa Taxa de Contraste — Quando o Texto se Mistura ao Fundo
A binarização é a primeira coisa que a maioria dos mecanismos de OCR faz: converte cada pixel em preto ou branco, usando um valor de limiar. Qualquer pixel mais escuro que o limiar se torna um candidato a caractere; qualquer coisa mais clara se torna fundo. Isso funciona perfeitamente quando você tem tinta preta intensa sobre papel branco brilhante. Falha quando a diferença entre a cor do texto e a cor do fundo fica abaixo de uma determinada taxa.
Exemplo concreto: Uma fatura de fornecedor com uma barra de cabeçalho azul-marinho e texto branco lendo "INVOICE" e "Net 30 Terms." O cabeçalho é azul-escuro — digamos RGB (20, 40, 100). O texto é branco — RGB (255, 255, 255). Para o olho humano, o contraste é excelente. Para um algoritmo de binarização, o fundo azul-escuro fica de um lado do limiar e o texto branco fica do outro — muitas vezes ambos são classificados como "não escuro o suficiente". O texto desaparece.
O mesmo problema ocorre com texto cinza-claro sobre qualquer fundo, texto branco em caixas de cores pastel (comum em modelos de fatura modernos) e texto sobreposto a cabeçalhos de tabela com preenchimento em gradiente. O problema estrutural é o mesmo: os pixels dos caracteres e os pixels do fundo estão muito próximos em luminância para que o limiar consiga separá-los.
Como diagnosticar: Abra a imagem digitalizada em qualquer editor de fotos e aplique um filtro de escala de cinza. Se o texto que o OCR está perdendo se tornar difícil de ler a olho nu, a binarização é quase certamente a causa.
Causa 2: Marcas d'água semitransparentes — DRAFT, CONFIDENTIAL e SAMPLE lidos como conteúdo real
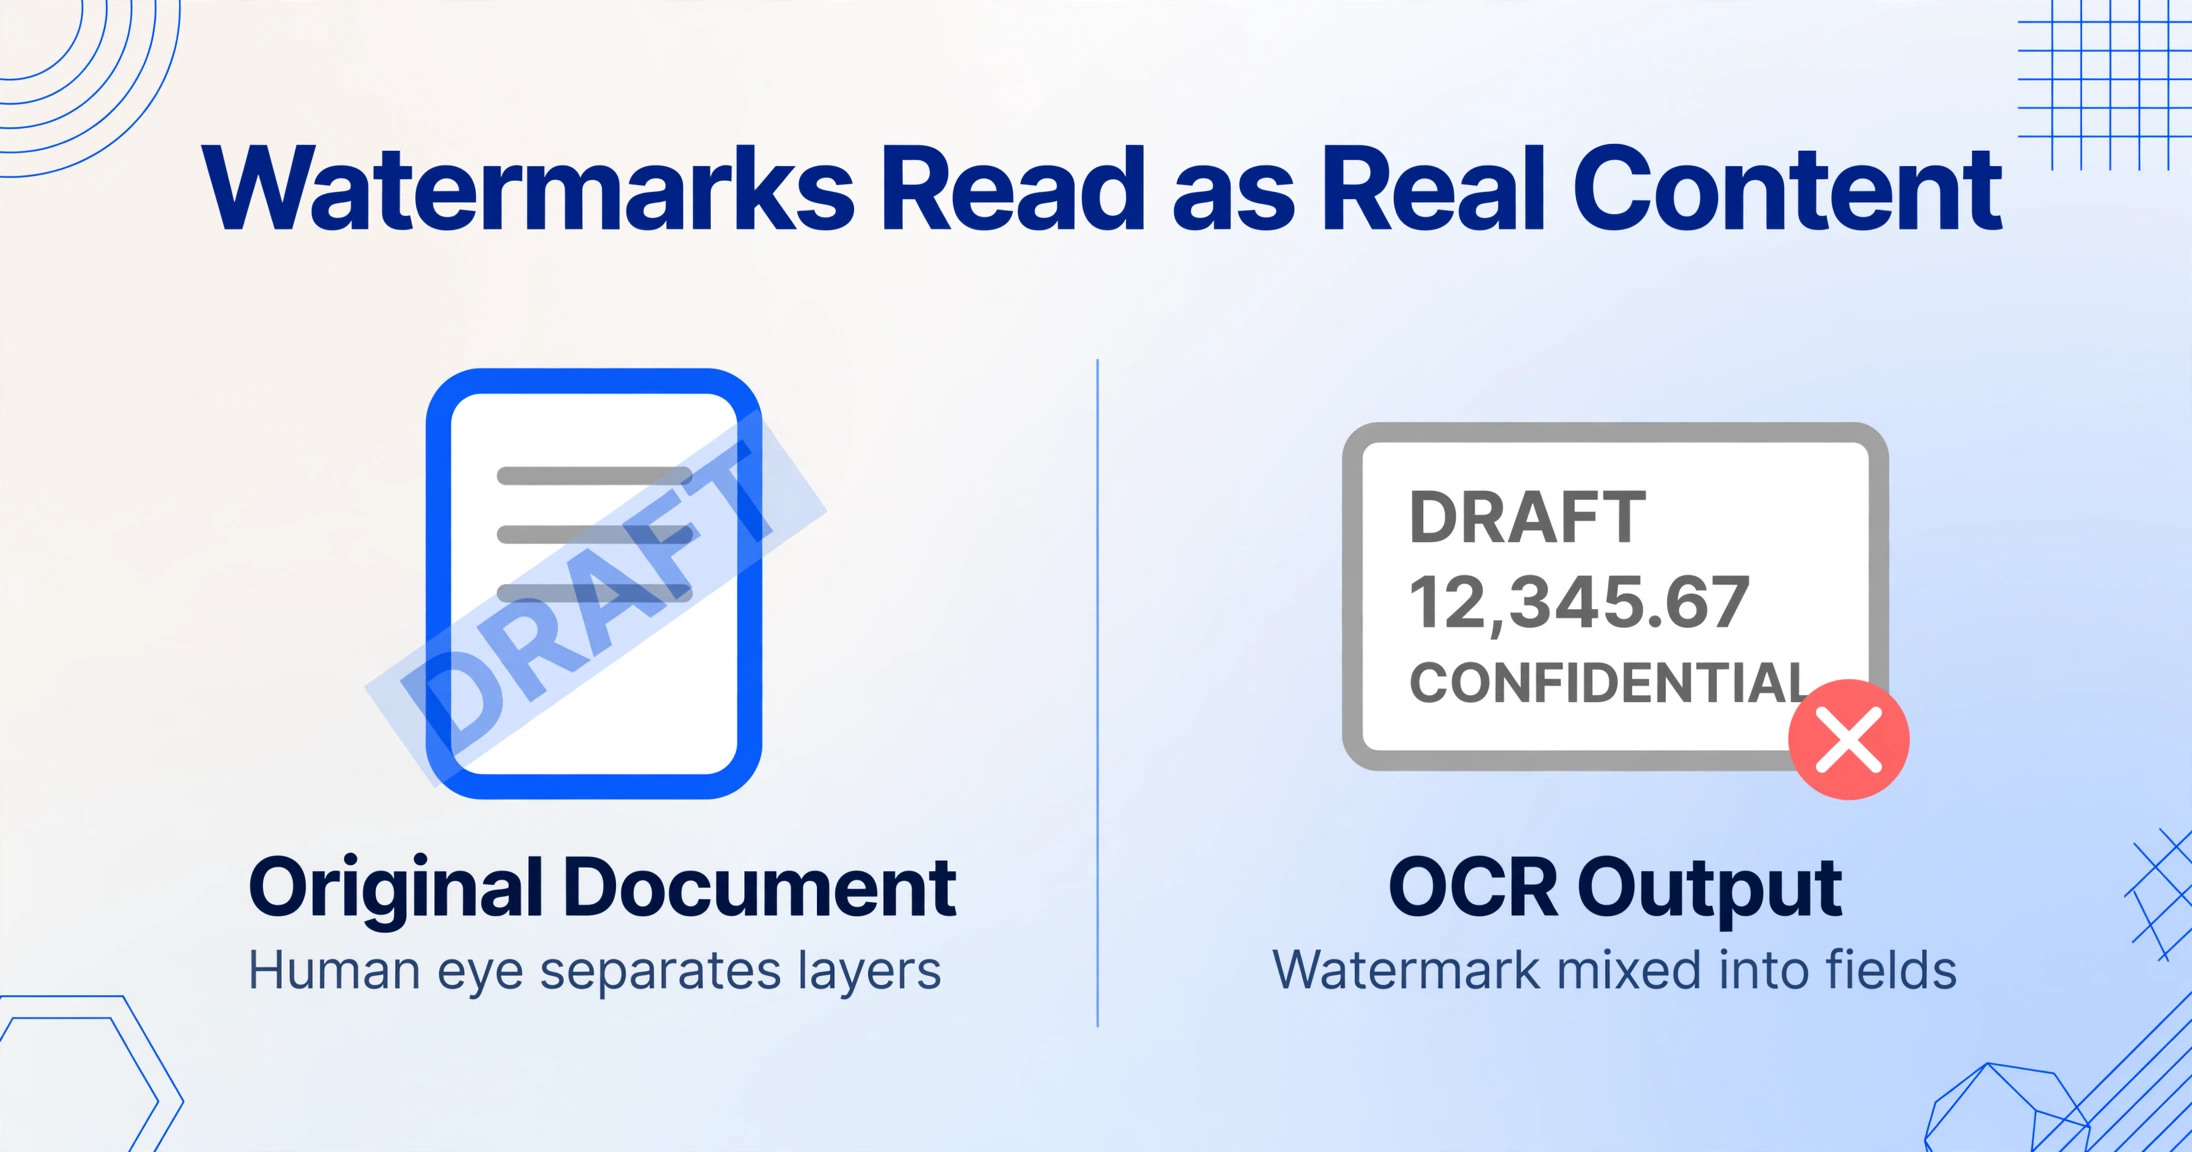
As marcas d'água são projetadas para serem visíveis ao olho humano sem bloquear o conteúdo subjacente. Isso as torna úteis para a segurança de documentos — e desastrosas para o OCR. O texto semitransparente cria valores de pixel que ficam na zona de "talvez texto, talvez fundo" do limiar de binarização.
O resultado é imprevisível e varia conforme o mecanismo. Algumas ferramentas de OCR tratam os pixels da marca d'água como parte do fundo e os descartam — mas os caracteres subjacentes também são descartados, produzindo campos vazios. Outras tratam a marca d'água como texto principal e geram algo como DRAFT 12,345.67 CONFIDENTIAL em vez do total real da fatura. No fórum do Azure AI Document Intelligence da Microsoft, usuários relataram que sequências de marca d'água como "SAMPLE" ou "VOID" se misturam aos valores de campo extraídos, inflando a contagem de caracteres e quebrando regras de validação posteriores.
A questão central é que o OCR tradicional não tem o conceito de intenção. Ele não consegue distinguir entre "DRAFT" impresso como sobreposição de segurança e "DRAFT" impresso como rótulo de versão de contrato. Ambos são apenas padrões de pixels que correspondem a um conjunto de caracteres.
Como diagnosticar: Verifique se a saída extraída contém palavras extras como "DRAFT", "CONFIDENTIAL", "SAMPLE" ou "COPY" que não correspondem a nenhum campo real do seu documento. Se essas palavras aparecerem repetidamente em documentos da mesma origem, uma marca d'água é a culpada.
Causa 3: Linhas alternadas com cores — confusão na análise de layout
Cores alternadas nas linhas — frequentemente chamadas de zebra striping — melhoram a legibilidade para os olhos humanos. Para a análise de layout do OCR, elas criam um pesadelo de segmentação. O mecanismo de layout divide a página em regiões de texto, tabelas e blocos com base em uma estrutura visual consistente. Quando a cor de fundo de cada duas linhas muda de branco para azul-claro ou cinza, o mecanismo pode interpretar cada linha como um bloco de texto separado, em vez de parte de uma tabela contínua.
Isso normalmente se manifesta como tabelas extraídas em que as linhas aparecem na ordem errada, algumas linhas estão totalmente ausentes ou a tabela é dividida em várias tabelas separadas para linhas pares e ímpares. A etapa de análise de layout — que é executada antes do reconhecimento de caracteres — toma uma decisão antecipada sobre onde estão os limites da tabela, e as linhas coloridas fazem com que ela crie limites demais.
O problema é particularmente comum com extratos bancários, relatórios financeiros e relatórios de contas a receber vencidas, nos quais o zebra striping é prática padrão. Um layout de extrato que parece limpo e organizado para uma pessoa produz uma extração fragmentada que exige uma limpeza manual significativa.
Como diagnosticar: Compare a ordem das linhas na saída extraída com o documento original. Se cada duas linhas aparecerem em uma tabela separada ou a saída alternar entre dois blocos de tabela, você está vendo uma falha na análise de layout causada por cores alternadas.
Causa 4: Texto destacado — quando o preenchimento de fundo engole caracteres
Marca-texto amarelo sobre texto preto é um clássico da revisão de documentos. Para o OCR, isso cria uma situação em que o contraste efetivo entre texto e fundo cai significativamente — não porque o texto esteja apagado, mas porque o destaque preenche o espaço negativo dentro e ao redor de cada caractere.
Os mecanismos de OCR dependem do espaço vazio entre os traços dos caracteres para determinar onde um caractere termina e o próximo começa. Quando esse espaço negativo é preenchido com uma cor brilhante — amarelo, verde, rosa —, a detecção de bordas que separa, por exemplo, um n de um h perde o sinal. Caracteres adjacentes parecem se fundir, produzindo erros de substituição: "Confirm" vira "C0nfi rm", valores em dólar perdem dígitos e números de fatura voltam parcialmente legíveis na melhor das hipóteses.
Destaques digitais em PDFs são ainda mais problemáticos do que marca-texto físico no papel, porque a camada de destaque é renderizada como uma sobreposição semitransparente que fica entre a camada de texto e a imagem digitalizada, criando um problema de transparência de três camadas que a binarização nunca foi projetada para lidar.
Como diagnosticar: Observe o documento original. Se algum texto tiver um destaque de fundo colorido — seja amarelo de um marca-texto de revisor ou colorido de uma anotação digital — e a saída extraída para esses campos específicos contiver caracteres fundidos ou dígitos ausentes, o texto destacado é a sua causa.
Como Corrigir Falhas de OCR com Fundo Colorido e Marca d'Água
Nenhuma técnica isolada corrige todas as quatro causas. Aqui estão cinco abordagens práticas, ordenadas da mais simples à mais eficaz, junto com a causa que cada uma resolve.
1. Conversão para Escala de Cinza + Melhoria de Contraste
Antes de enviar um documento para OCR, converta a imagem para escala de cinza e ajuste o contraste manualmente. Isso elimina a cor como variável — o mecanismo de OCR recebe uma imagem apenas de luminância, na qual a separação entre texto e fundo se baseia puramente no brilho. A maioria dos softwares de digitalização para desktop e ferramentas de PDF (Adobe Acrobat, NAPS2, VueScan) tem uma opção "escala de cinza" ou "remover cor". Aplique-a antes do OCR, não depois. Esta correção é mais eficaz para as Causas 1 e 4 (baixo contraste e texto destacado).
2. Limiarização Adaptativa
A binarização padrão aplica um único limiar à página inteira. A limiarização adaptativa calcula um limiar local para cada região, de modo que um documento que tenha tanto uma área de cabeçalho azul-escuro quanto uma área de corpo branca recebe limiares diferentes em cada zona. Algumas ferramentas de OCR expõem isso como uma opção de binarização "adaptativa" ou "local". O Tesseract oferece suporte a isso por meio dos sinalizadores --psm e --oem combinados com o pré-processamento da imagem. Esta correção ajuda nas Causas 1 e 4 — qualquer caso em que o contraste varia entre diferentes regiões da mesma página.
3. Opção "Remover Fundo" na Digitalização
Muitos scanners corporativos e pacotes profissionais de OCR (ABBYY FineReader, Adobe Acrobat Pro) incluem um filtro de pré-processamento "remover fundo" ou "remoção de fundo". Esse filtro tenta identificar e eliminar fundos coloridos uniformes antes da binarização. Funciona bem em documentos com cabeçalhos ou fundos de coluna de cor sólida (Causa 1), mas normalmente falha em marcas d'água (Causa 2), porque as marcas d'água não são uniformes o suficiente para que o filtro as reconheça como "fundo".
4. Extração Semântica por IA (Processamento com Reconhecimento de Marca d'Água)
Modelos de visão-linguagem (VLMs) — a tecnologia por trás das ferramentas modernas de extração por IA — não dependem da binarização. Eles leem o documento como uma imagem e compreendem o significado semântico de cada região de texto. Um VLM frequentemente consegue identificar que "DRAFT CONFIDENTIAL" exibido na diagonal em uma página é uma marca d'água, não um campo de dados, e o exclui do resultado extraído. Da mesma forma, os VLMs lidam com fundos coloridos e tabelas com linhas zebradas de forma mais eficaz, pois analisam o contexto completo do layout em vez de tomar decisões binárias de primeiro plano e fundo.
Isso não é uma solução milagrosa — até os melhores VLMs podem ser confundidos por marcas d'água densas ou texto de contraste extremamente baixo. Mas para as Causas 2 e 3 (marcas d'água e linhas alternadas), mudar de um mecanismo de OCR tradicional para uma ferramenta de extração baseada em VLM é o passo mais eficaz que você pode dar. Essa é a abordagem usada pelo ImageToTable.ai em seu modo Para Tabela, em que o modelo interpreta a intenção do documento em vez de seus valores de pixel.
5. Filtragem de Palavras-Chave Pós-Extração
Se seus documentos têm marcas d'água consistentes (como "SAMPLE" em todas as faturas de demonstração ou "CONFIDENTIAL" em contratos em rascunho), um script simples de pós-processamento pode remover essas strings conhecidas dos campos extraídos. Isso é um paliativo, não uma correção — funciona apenas quando você sabe exatamente qual é o texto indesejado e não ajuda com os dados ausentes causados pelo baixo contraste. Mas é rápido, não exige mudanças de ferramenta e limpa de forma confiável a Causa 2 (texto de marca d'água) em documentos previsíveis.
Quando Escalar: Reconhecendo Documentos Além do OCR Tradicional
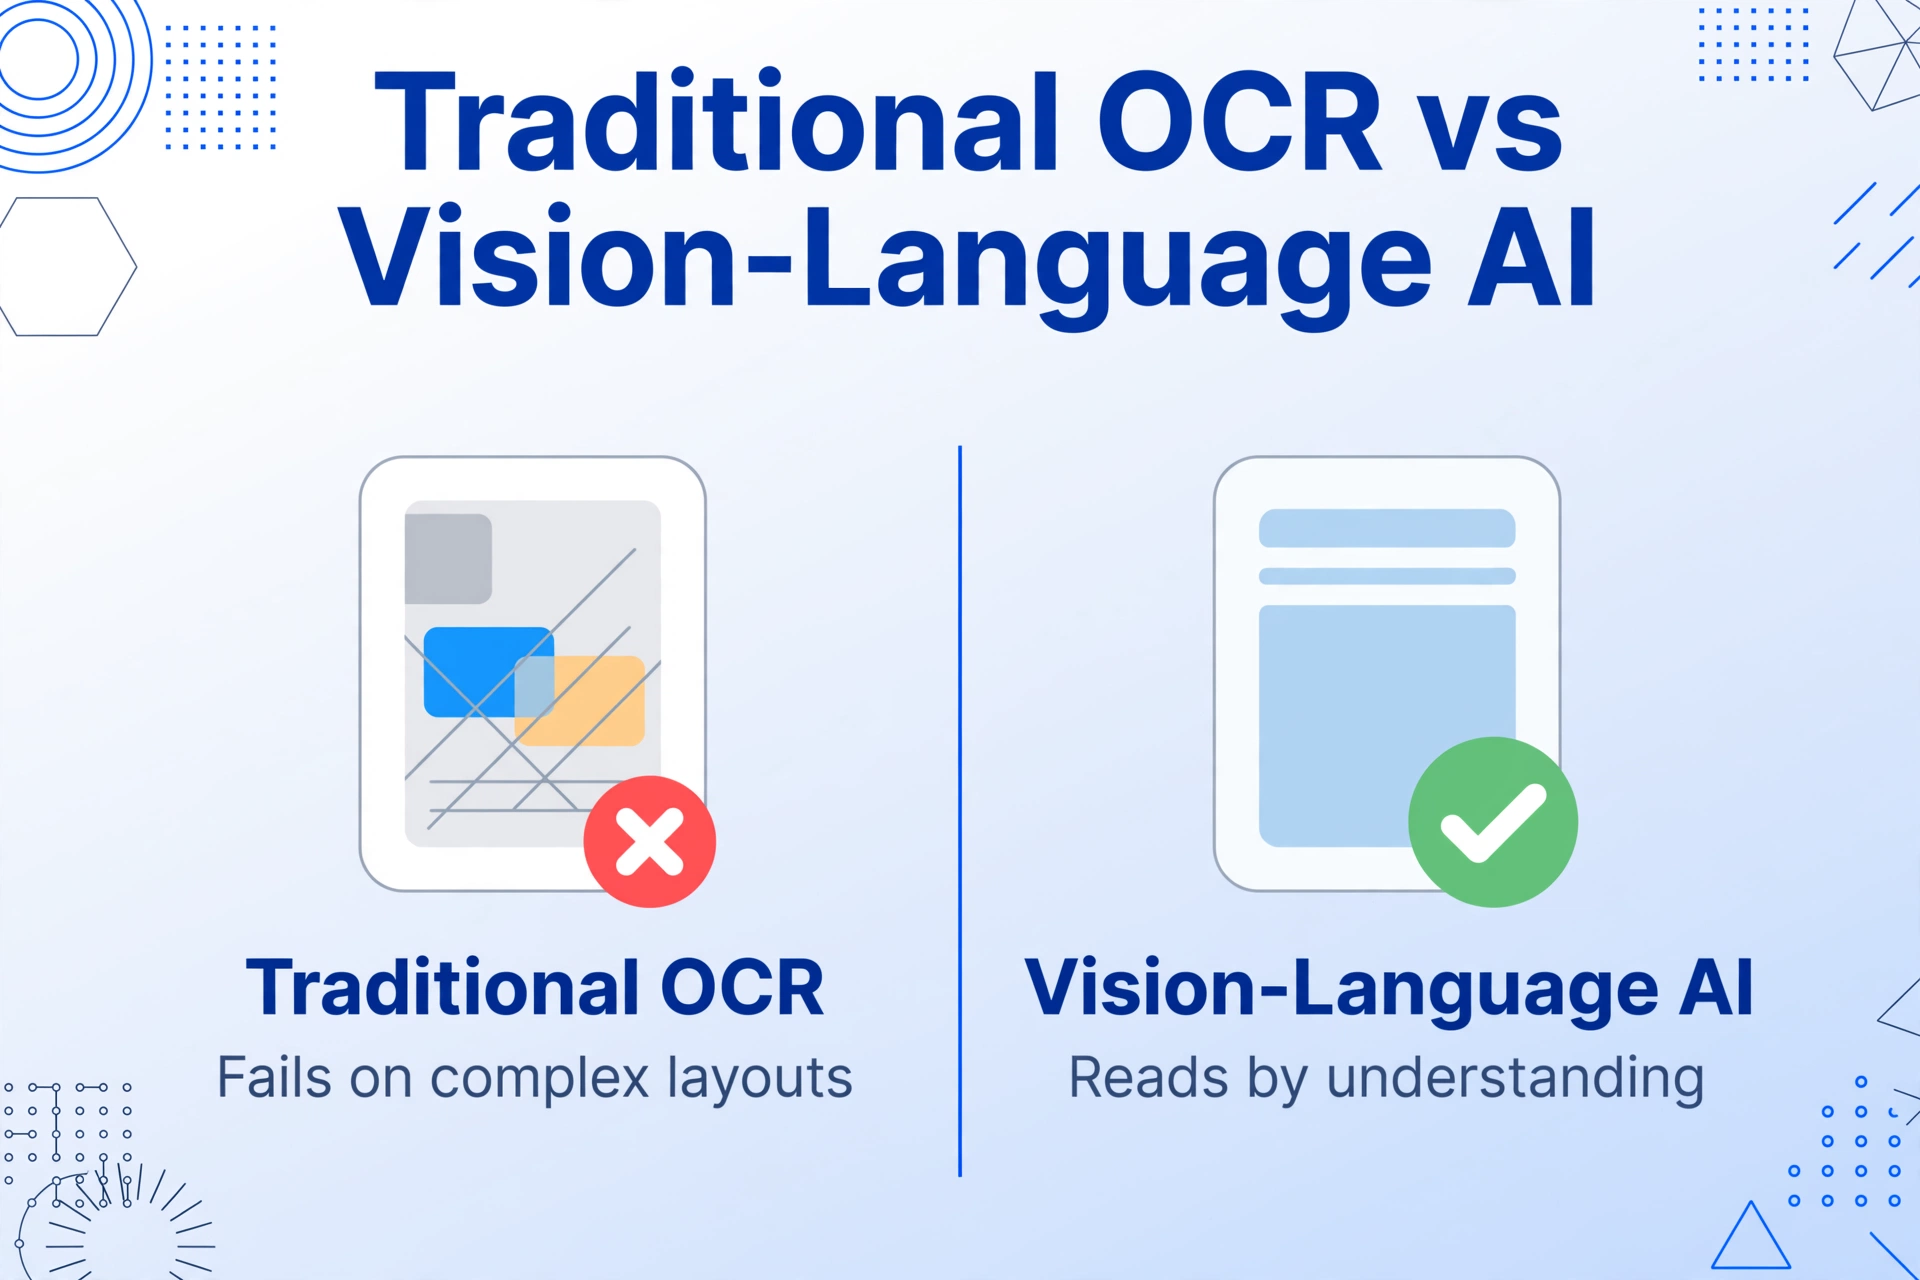
Alguns documentos estão fundamentalmente fora das capacidades do OCR tradicional — não porque a tecnologia seja falha, mas porque a própria abordagem de extração é a ferramenta errada.
Se seus documentos exibem consistentemente qualquer uma destas características, ajustes de pré-processamento nunca resolverão o problema por completo:
- Múltiplos elementos visuais sobrepostos: Marca d'água + cabeçalho colorido + tabela na mesma página. Cada elemento degrada o sinal de forma independente, e o efeito cumulativo excede o que a limiarização ou a remoção de fundo conseguem recuperar.
- Fundos não uniformes entre páginas: Algumas páginas são brancas simples, outras têm cabeçalhos azul-claros, outras têm sombras cinzas digitalizadas. Um único pipeline de pré-processamento não consegue se adaptar aos três casos.
- Densidade de marca d'água que cobre 30%+ da página: Marcas d'água densas significam que, mesmo que o texto da marca d'água seja filtrado, os pixels sob ela foram alterados o suficiente para que as formas originais dos caracteres não sejam mais recuperáveis.
- A extração já está falhando em documentos simples do mesmo tipo: Se a ferramenta perde campos até em faturas de fundo branco limpo, o problema não é o fundo — é a ferramenta. Adicionar cor ao documento só vai aumentar a diferença.
Nesses casos, a escalada correta não é um pré-processamento melhor — é uma arquitetura de extração fundamentalmente diferente. Modelos de visão-linguagem que extraem por compreensão em vez de limiarização representam o próximo passo. E para documentos com layouts excepcionalmente complexos, optar por um guia de pré-processamento estruturado combinado com uma ferramenta moderna de extração por IA oferece a melhor chance de resultados limpos.
Entender por que a precisão cai em diferentes estilos de documento é abordado em profundidade em nosso artigo sobre por que a precisão do OCR varia por tipo de documento, e a solução de problemas de extração de tabelas especificamente é tratada em nosso guia sobre como corrigir problemas de extração de células mescladas.
Perguntas Frequentes
Digitalizar em escala de cinza em vez de colorido resolve problemas de OCR com fundos coloridos?
Parcialmente. A digitalização em escala de cinza elimina a cor como variável, o que ajuda com fundos de cores claras (Causa 1). No entanto, não resolve a interferência de marca d'água (Causa 2), porque o texto da marca d'água ainda aparece na saída em escala de cinza. Para marcas d'água, você precisa de filtragem semântica ou extração baseada em IA que entenda a marca d'água como uma camada visual separada.
O OCR consegue ler texto branco em fundo escuro se eu aumentar o brilho?
Às vezes, mas não de forma confiável. Aumentar o brilho torna o fundo escuro mais claro, o que aproxima tanto o fundo quanto o texto da extremidade branca do limiar. O que você realmente quer é o aumento de contraste, não o ajuste de brilho — aumentar a diferença entre a luminância do texto e do fundo, não mover ambos na mesma direção. Ferramentas como Limiarização Adaptativa ou CLAHE (Equalização de Histograma Adaptativa com Contraste Limitado) fazem isso de forma mais eficaz do que simples controles deslizantes de brilho.
Por que minha ferramenta de OCR lê o texto da marca d'água em alguns documentos, mas não em outros?
Diferentes mecanismos de OCR usam diferentes algoritmos de binarização. Alguns mecanismos (como o Tesseract com configurações padrão) são mais agressivos ao tratar tudo como texto em potencial, o que os torna mais propensos a ler marcas d'água. Outros (como o ABBYY FineReader) aplicam mais pré-processamento para suprimir elementos de fundo antes da binarização. A mesma marca d'água pode produzir resultados de extração completamente diferentes entre ferramentas, porque o pipeline de pré-processamento — não o mecanismo de reconhecimento de caracteres — determina se a marca d'água sobrevive até a etapa de reconhecimento.
A extração com IA resolverá completamente os problemas de fundo colorido e marca d'água?
Os modelos de visão de IA são significativamente mais tolerantes a fundos coloridos e marcas d'água do que o OCR tradicional — eles lidam com as Causas 2, 3 e com a maior parte da Causa 1 muito melhor porque não dependem da binarização. No entanto, não são perfeitos. Contraste extremamente baixo (texto branco sobre um fundo esbranquiçado), marcas d'água densas que cobrem grandes porções do documento e realces digitais intensos ainda podem confundir os VLMs. A resposta honesta é que este continua sendo um dos problemas mais difíceis na extração de documentos, mas as ferramentas modernas de IA reduziram substancialmente essa lacuna — de "falha na maioria dos documentos coloridos" para "tem sucesso na maioria, mas enfrenta dificuldades em casos extremos".
Posso remover uma marca d'água de um PDF antes de executar o OCR?
As marcas d'água de PDF às vezes estão em uma camada de renderização separada que pode ser removida com ferramentas de edição de PDF como Adobe Acrobat Pro, PDFpen ou ferramentas de linha de comando como qpdf ou cpdf. No entanto, marcas d'água que foram achatadas na imagem (rasterizadas durante a criação ou digitalização do PDF) não podem ser removidas — elas estão permanentemente incorporadas aos valores dos pixels. Para marcas d'água achatadas, a correção deve ocorrer no nível da extração, não no nível do documento.
Teste seus documentos com fundos coloridos em um extrator moderno de IA
Envie uma imagem ou PDF — veja se a extração semântica lida melhor com sua marca d'água ou layout colorido do que o OCR tradicional.
Experimente agora →Sem necessidade de cadastro. Resultados em 10 segundos.