Por qué su OCR falla en fondos de color
y marcas de agua: 4 causas y soluciones
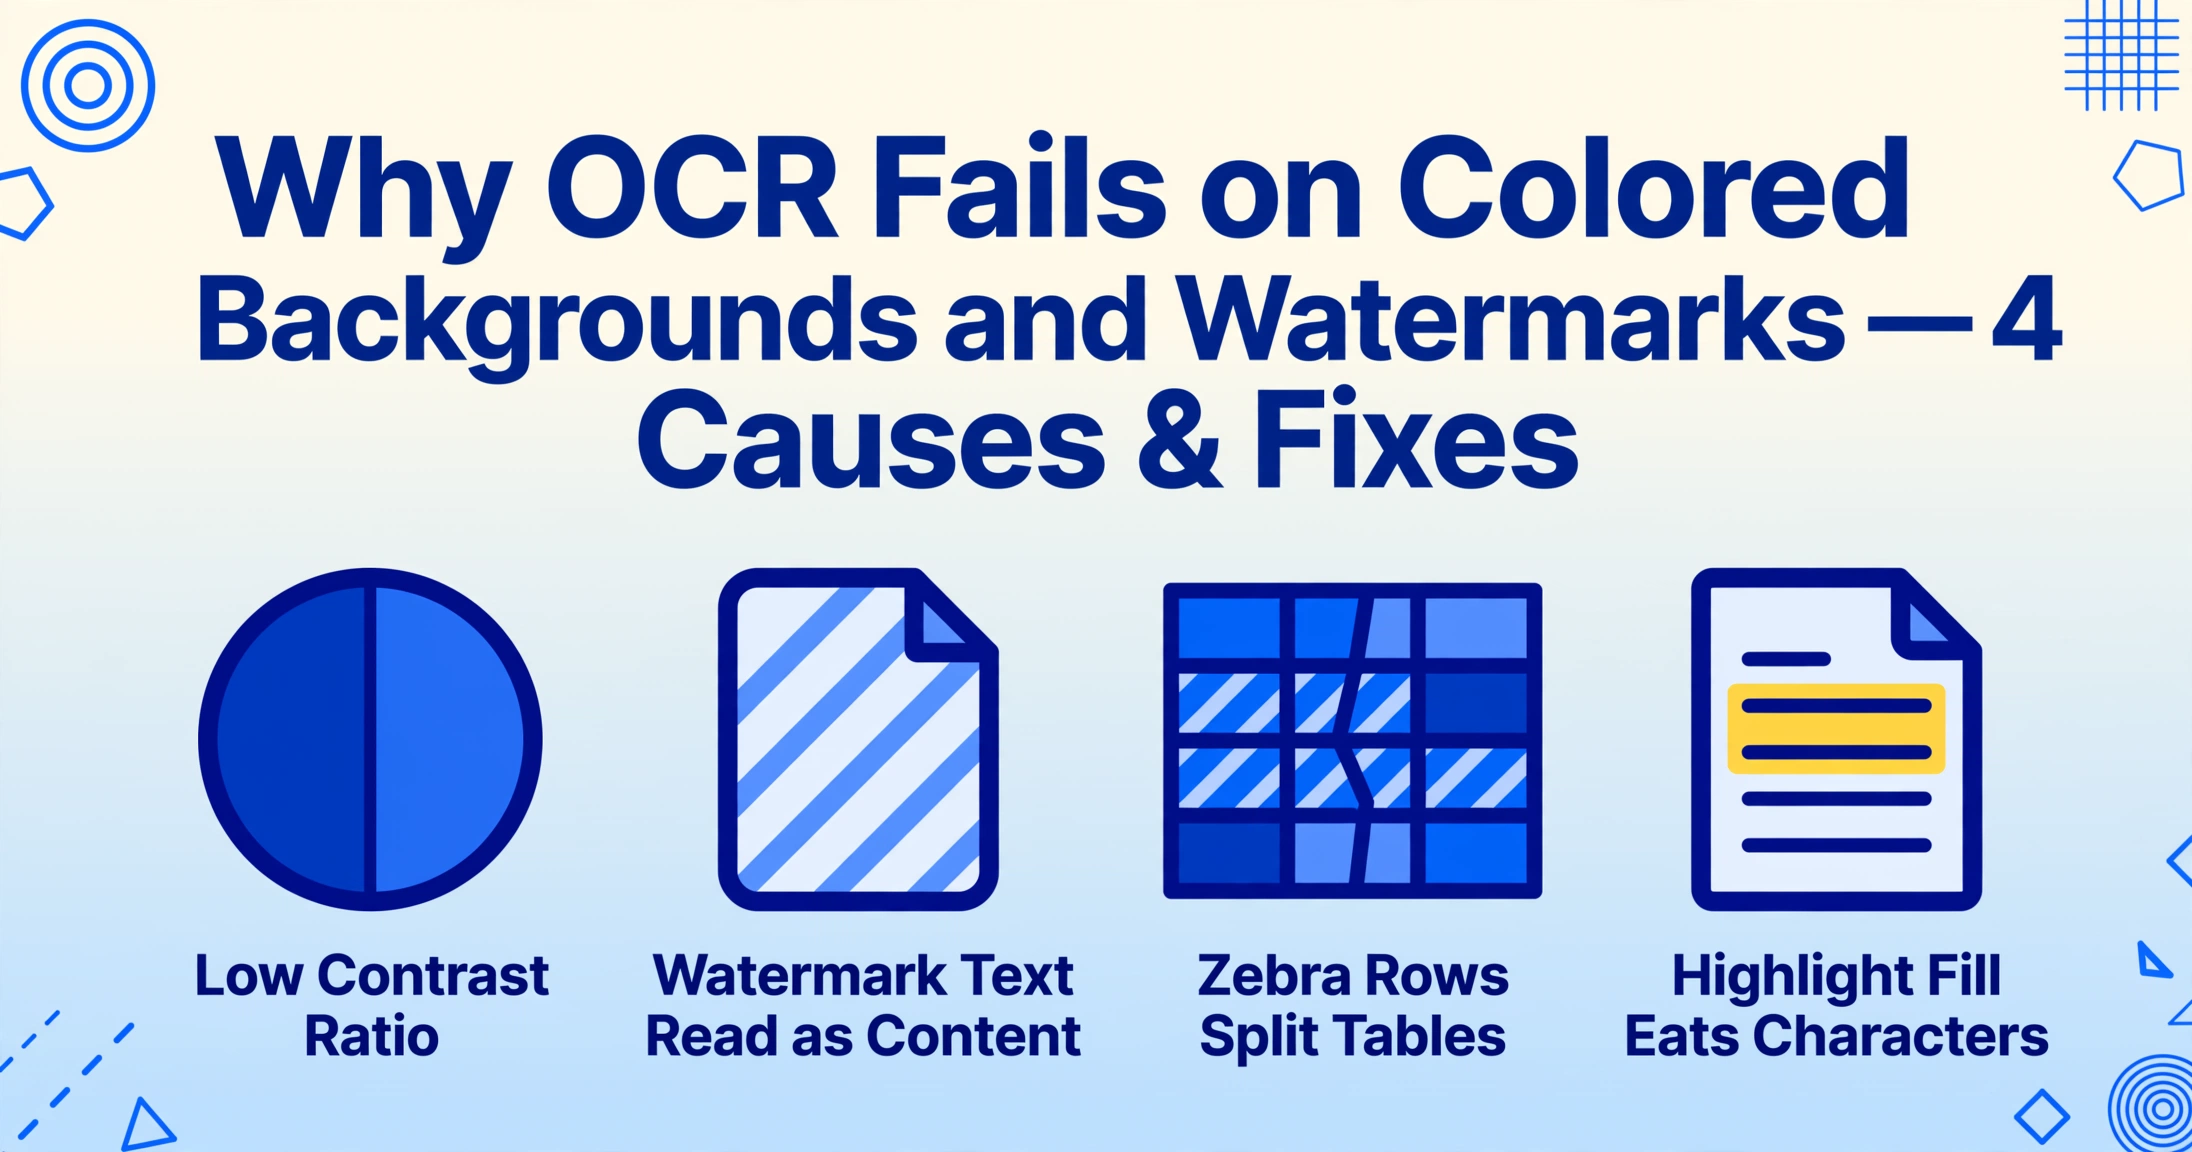
Usted cargó un lote de facturas, ejecutó la herramienta de OCR y obtuvo hojas de cálculo llenas de texto ilegible, o peor aún, campos que volvieron completamente vacíos. Si sus documentos tienen fondos de color, marcas de agua o secciones resaltadas, no hay nada malo con su escáner ni con su configuración. El problema es que estos elementos visuales rompen activamente la forma en que el reconocimiento de caracteres funciona internamente.
Conclusiones clave
- Cada vez que el OCR falla con un encabezado de factura de color, el problema no es la configuración de su escáner: la binarización tradicional se creó para una sola suposición, tinta negra sobre papel blanco, y esa suposición falla silenciosamente en todo lo demás.
- Las marcas de agua no solo reducen la legibilidad: los motores de OCR no tienen concepto de la intención del documento, por lo que BORRADOR y CONFIDENCIAL se mezclan con sus totales extraídos como si fueran datos reales, contaminando los números sin aviso.
- La extracción semántica con IA omite la binarización por completo: lee los documentos como lo haría usted, comprendiendo el diseño y la intención en lugar de clasificar cada píxel, lo que significa que los fondos de color y las marcas de agua dejan de ser obstáculos.
El OCR tradicional se diseñó bajo una premisa simple: texto negro sobre fondo blanco. La mayoría de los motores de OCR (Tesseract, ABBYY FineReader, el OCR integrado de Adobe Acrobat) convierten la imagen a una representación binaria en blanco y negro (un paso llamado binarización) y luego comparan las regiones oscuras restantes con formas de caracteres. En cuanto el fondo introduce color, textura o texto semitransparente, esa premisa se rompe.
Este es uno de los desafíos más persistentes en la extracción automatizada de documentos. No existe una solución única que funcione para todos los casos. Pero entender por qué falla te da una ventaja práctica: puedes diagnosticar la causa específica en tu documento, aplicar la solución correcta y saber cuándo la limitación está en la herramienta, no en el documento.
Estas son las cuatro formas más comunes en que los fondos de color y las marcas de agua provocan fallos en la extracción por OCR, y qué hacer con cada una.
Causa 1: Bajo contraste — cuando el texto se funde con el fondo
La binarización es lo primero que hace la mayoría de los motores de OCR: convierten cada píxel a blanco o negro usando un valor umbral. Cualquier píxel más oscuro que el umbral se convierte en un posible carácter; cualquier cosa más clara se considera fondo. Esto funciona perfectamente con tinta negra intensa sobre papel blanco brillante. Falla cuando la diferencia entre el color del texto y el color del fondo cae por debajo de cierta relación.
Ejemplo concreto: Una factura de proveedor con un encabezado azul marino y texto blanco que dice "FACTURA" y "Plazo neto 30 días". El encabezado es azul oscuro — digamos RGB (20, 40, 100). El texto es blanco — RGB (255, 255, 255). Para el ojo humano, el contraste es excelente. Para un algoritmo de binarización, el fondo azul oscuro cae a un lado del umbral y el texto blanco al otro — a menudo ambos se clasifican como "no lo suficientemente negros". El texto desaparece.
El mismo problema ocurre con texto gris claro sobre cualquier fondo, texto blanco sobre recuadros de color pastel (común en plantillas de facturas modernas) y texto superpuesto en encabezados de tabla con relleno degradado. El problema estructural es el mismo: los píxeles del carácter y los del fondo tienen una luminancia demasiado similar para que el umbral los separe.
Cómo diagnosticarlo: Abre la imagen escaneada en cualquier editor de fotos y aplica un filtro de escala de grises. Si el texto que el OCR no capta se vuelve difícil de leer a simple vista, la binarización es casi con certeza la causa.
Causa 2: Marcas de agua semitransparentes: BORRADOR, CONFIDENCIAL y MUESTRA se leen como contenido real
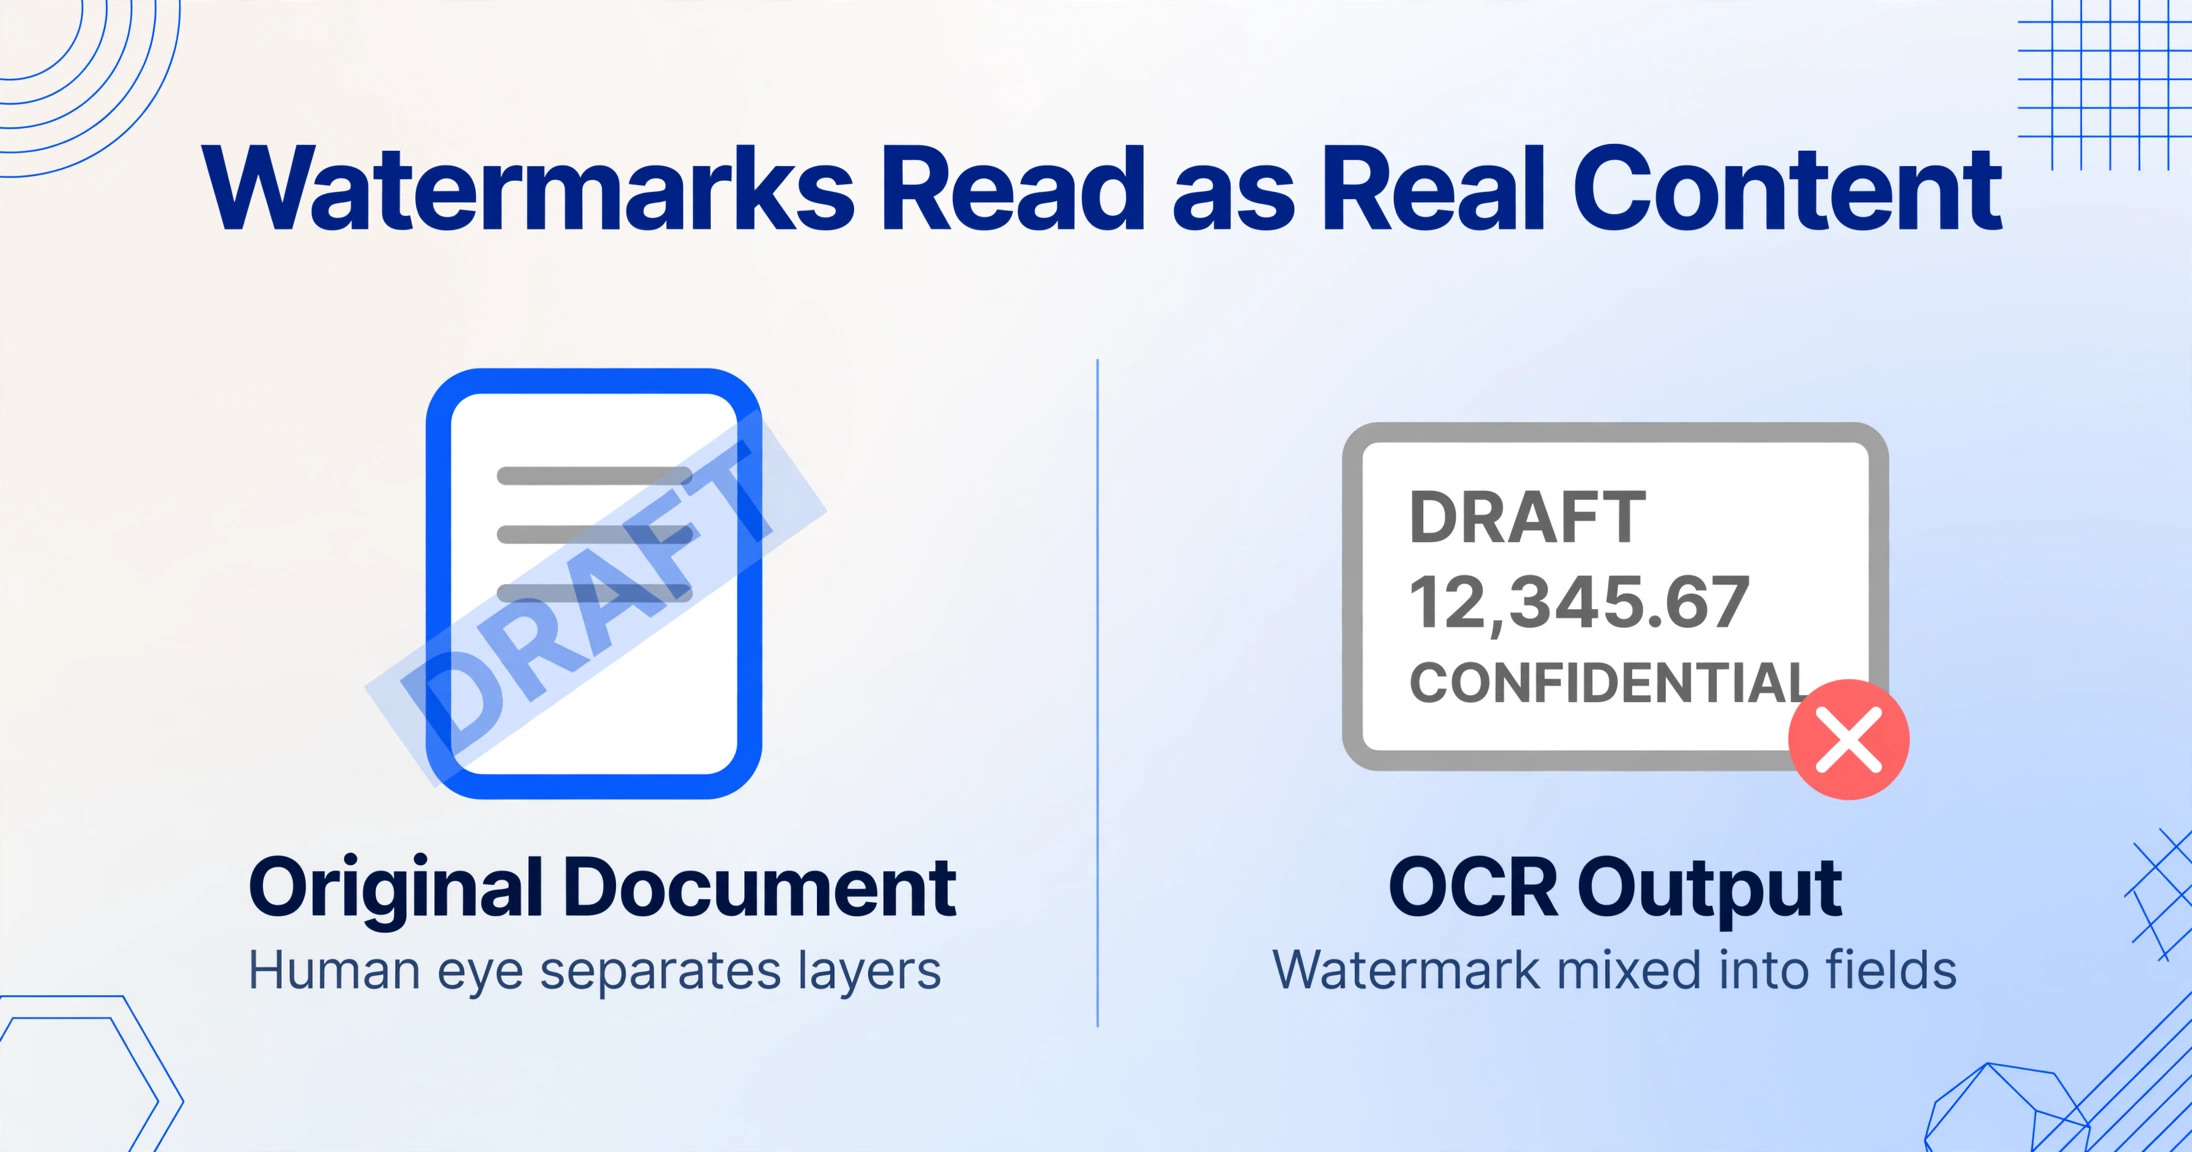
Las marcas de agua están diseñadas para ser visibles al ojo humano sin bloquear el contenido subyacente. Eso las hace útiles para la seguridad de documentos — y desastrosas para el OCR. El texto semitransparente crea valores de píxel que se sitúan en la zona de "quizás texto, quizás fondo" del umbral de binarización.
El resultado es impredecible y varía según el motor. Algunas herramientas de OCR tratan los píxeles de la marca de agua como parte del fondo y los descartan — pero los caracteres subyacentes también se descartan, produciendo campos vacíos. Otras tratan la marca de agua como texto principal y generan algo como BORRADOR 12,345.67 CONFIDENCIAL en lugar del total real de la factura. En el foro de Azure AI Document Intelligence de Microsoft, los usuarios han informado que cadenas de marcas de agua como "MUESTRA" o "ANULADO" se mezclan con los valores de campo extraídos, inflando los recuentos de caracteres y rompiendo las reglas de validación posteriores.
El problema central es que el OCR tradicional no tiene concepto de intención. No puede distinguir entre "BORRADOR" impreso como superposición de seguridad y "BORRADOR" impreso como etiqueta de versión de contrato. Ambos son solo patrones de píxeles que coinciden con un conjunto de caracteres.
Cómo diagnosticarlo: Compruebe si su salida extraída contiene palabras adicionales como "BORRADOR", "CONFIDENCIAL", "MUESTRA" o "COPIA" que no correspondan a ningún campo real de su documento. Si estas palabras aparecen repetidamente en documentos de la misma fuente, la marca de agua es la culpable.
Causa 3: Filas Alternas con Código de Color — Confusión en el Análisis de Diseño
Los colores alternos en las filas — a menudo llamados rayas de cebra — mejoran la legibilidad para el ojo humano. Para el análisis de diseño de OCR, crean una pesadilla de segmentación. El motor de diseño divide la página en regiones de texto, tablas y bloques basándose en una estructura visual consistente. Cuando el color de fondo de cada dos filas cambia de blanco a azul claro o gris, el motor puede interpretar cada fila como un bloque de texto separado en lugar de parte de una tabla continua.
Esto se manifiesta típicamente en tablas extraídas donde las filas aparecen en el orden incorrecto, algunas filas faltan por completo, o la tabla se divide en múltiples tablas separadas para filas pares e impares. El paso de análisis de diseño — que se ejecuta antes del reconocimiento de caracteres — toma una decisión temprana sobre dónde están los límites de la tabla, y las filas de colores hacen que cree demasiados límites.
El problema es particularmente común en estados de cuenta bancarios, informes financieros e informes de cuentas por cobrar vencidas, donde las rayas de cebra son una práctica estándar. Un diseño de estado de cuenta que se ve limpio y organizado para un humano produce una extracción fragmentada que requiere una limpieza manual significativa.
Cómo diagnosticar: Compare el orden de las filas en su salida extraída con el documento original. Si cada dos filas aparece en una tabla separada o la salida alterna entre dos bloques de tabla, está viendo una falla del análisis de diseño causada por los colores alternos.
Causa 4: Texto Resaltado — Cuando el Relleno de Fondo Devora los Caracteres
El resaltador amarillo sobre texto negro es un elemento básico de la revisión de documentos. Para OCR, crea una situación donde el contraste efectivo entre el texto y el fondo disminuye significativamente — no porque el texto sea tenue, sino porque el resaltado llena el espacio negativo dentro y alrededor de cada carácter.
Los motores de OCR dependen del espacio vacío entre los trazos de los caracteres para determinar dónde termina un carácter y comienza el siguiente. Cuando ese espacio negativo se llena con un color brillante — amarillo, verde, rosa — la detección de bordes que separa, por ejemplo, una n de una h pierde la señal. Los caracteres adyacentes parecen fusionarse, produciendo errores de sustitución: "Confirm" se convierte en "C0nfi rm," los montos en dólares pierden dígitos, y los números de factura regresan parcialmente legibles en el mejor de los casos.
Los resaltados digitales en PDF son aún más problemáticos que el marcador físico en papel, porque la capa de resaltado se renderiza como una superposición semitransparente que se sitúa entre la capa de texto y la imagen escaneada, creando un problema de transparencia de tres capas para el cual la binarización nunca fue diseñada.
Cómo diagnosticar: Mire el documento original. Si cualquier texto tiene un resaltado de fondo de color — ya sea amarillo de un marcador de revisor o de color de una anotación digital — y la salida extraída para esos campos específicos contiene caracteres fusionados o dígitos faltantes, el texto resaltado es su causa.
Cómo Corregir Fallos de OCR por Fondo de Color y Marcas de Agua
Ninguna técnica única corrige las cuatro causas. Aquí tiene cinco enfoques prácticos, ordenados de lo más simple a lo más efectivo, junto con la causa que aborda cada uno.
1. Conversión a Escala de Grises + Mejora de Contraste
Antes de enviar un documento a OCR, convierta la imagen a escala de grises y ajuste el contraste manualmente. Esto elimina el color como variable: el motor de OCR recibe una imagen de solo luminancia donde la separación texto-fondo se basa puramente en el brillo. La mayoría del software de escaneo de escritorio y las herramientas PDF (Adobe Acrobat, NAPS2, VueScan) tienen una opción de "escala de grises" o "eliminar color". Aplíquela antes del OCR, no después. Esta corrección es más efectiva para las Causas 1 y 4 (bajo contraste y texto resaltado).
2. Umbral Adaptativo
La binarización estándar aplica un solo umbral a toda la página. El umbral adaptativo calcula un umbral local para cada región, de modo que un documento que tiene tanto un área de encabezado azul oscuro como un área de cuerpo blanco recibe diferentes umbrales en cada zona. Algunas herramientas de OCR exponen esto como una opción de binarización "adaptativa" o "local". Tesseract lo admite mediante las banderas --psm y --oem combinadas con el preprocesamiento de imágenes. Esta corrección ayuda con las Causas 1 y 4 — cualquier caso donde el contraste varía entre diferentes regiones de la misma página.
3. Opción de "Eliminar Fondo" del Escáner
Muchos escáneres empresariales y paquetes de OCR profesionales (ABBYY FineReader, Adobe Acrobat Pro) incluyen un filtro de preprocesamiento de "eliminar fondo" o "eliminación de fondo". Este filtro intenta identificar y eliminar fondos de color uniformes antes de la binarización. Funciona bien en documentos con encabezados de color sólido o fondos de columna (Causa 1), pero típicamente falla con marcas de agua (Causa 2), porque las marcas de agua no son lo suficientemente uniformes para que el filtro las reconozca como "fondo".
4. Extracción Semántica con IA (Procesamiento Consciente de Marcas de Agua)
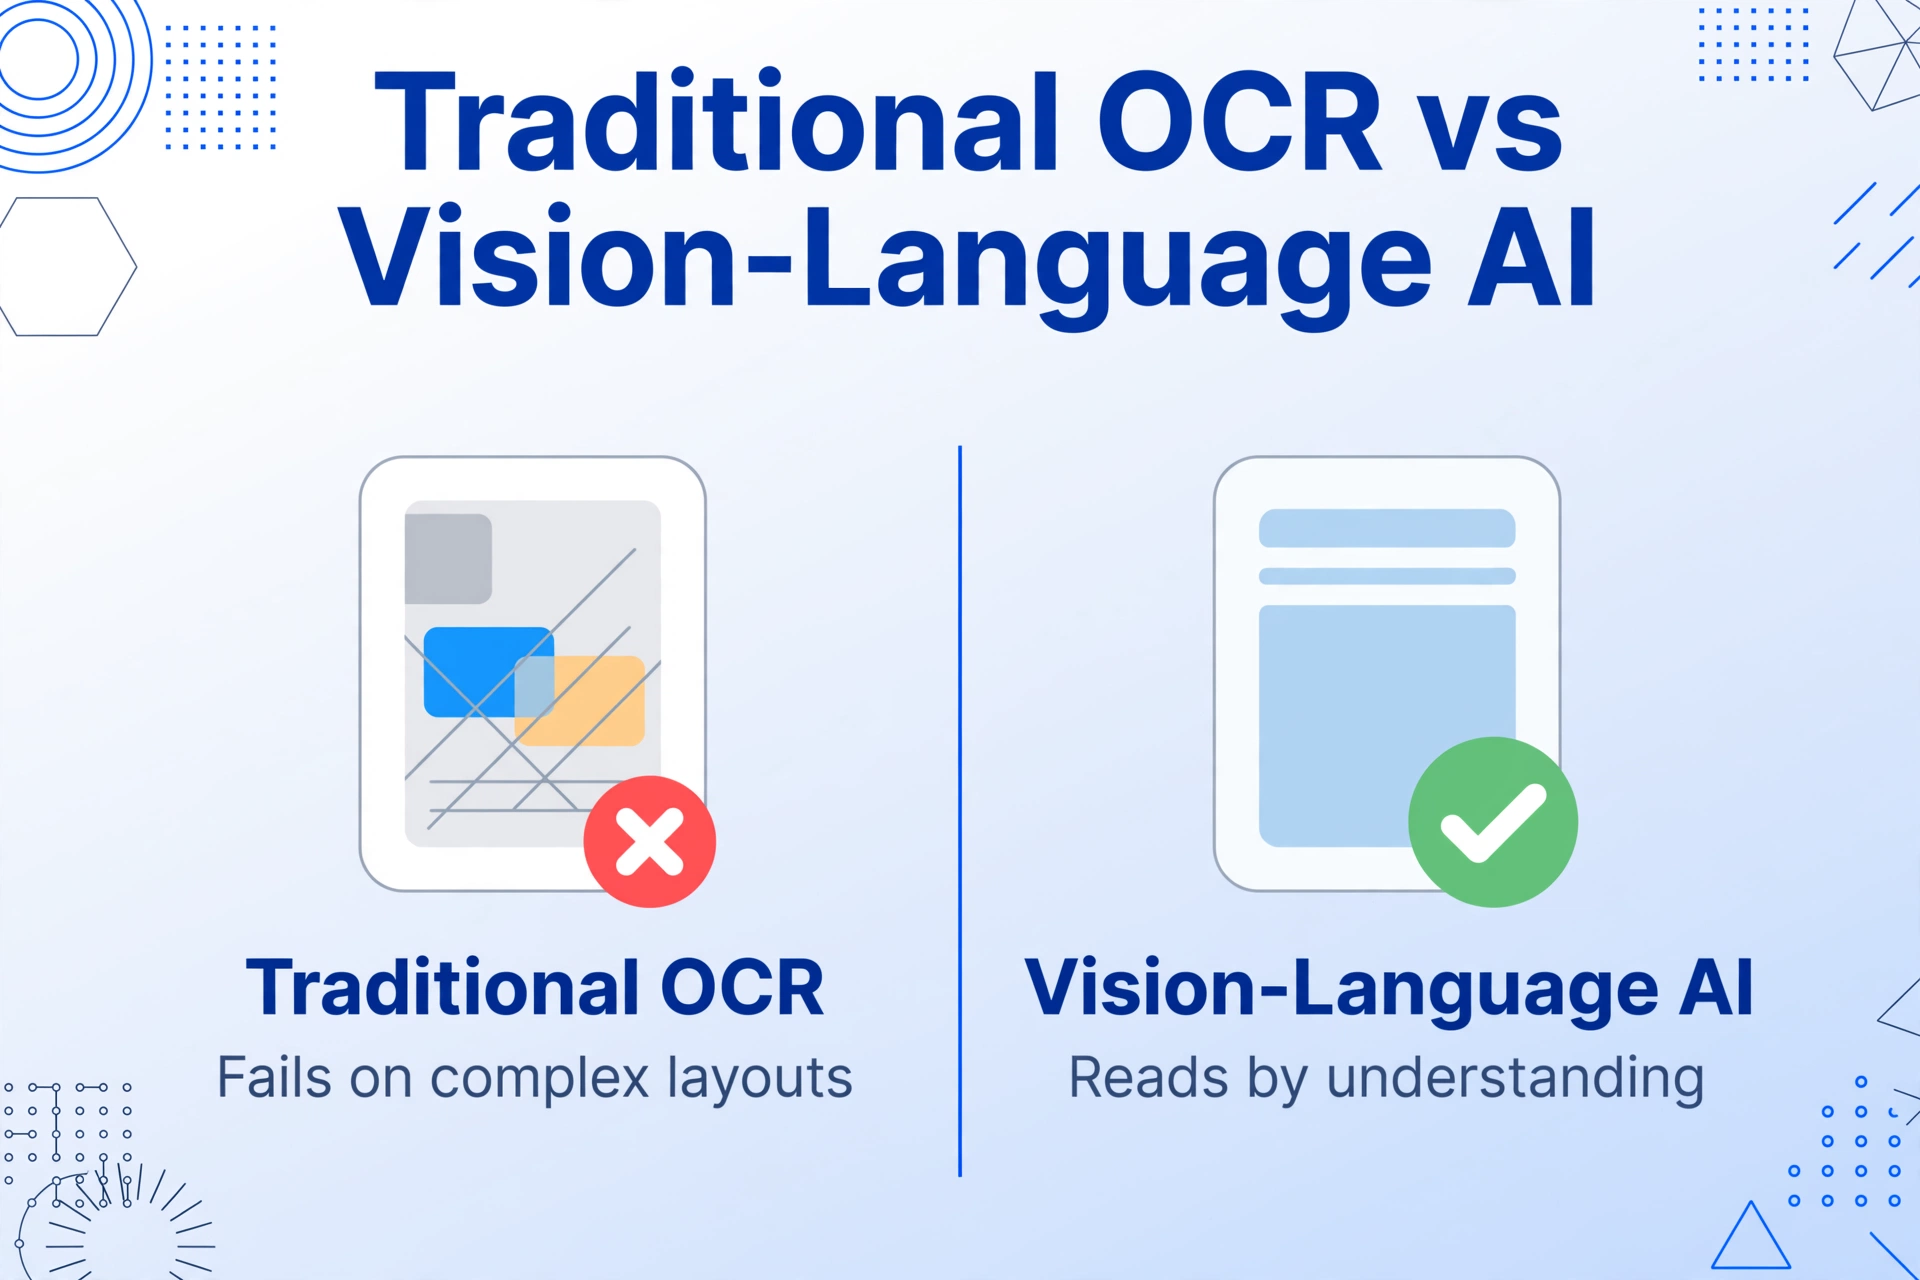
Los modelos de visión y lenguaje (VLM, por sus siglas en inglés), la tecnología detrás de las herramientas modernas de extracción con IA, no dependen de la binarización. Leen el documento como una imagen y comprenden el significado semántico de cada región de texto. Un VLM a menudo puede identificar que "BORRADOR CONFIDENCIAL" que aparece en diagonal en una página es una marca de agua, no un campo de datos, y excluirla del resultado extraído. De manera similar, los VLM manejan fondos de color y tablas con filas alternadas con mayor precisión porque analizan el contexto completo del diseño en lugar de tomar decisiones binarias entre primer plano y fondo.
Esto no es una solución mágica: incluso los mejores VLM pueden confundirse con marcas de agua densas o texto de contraste extremadamente bajo. Pero para las Causas 2 y 3 (marcas de agua y filas alternadas), cambiar de un motor OCR tradicional a una herramienta de extracción basada en VLM es el paso más efectivo que puede tomar. Este es el enfoque que utiliza ImageToTable.ai en su modo A Tabla, donde el modelo interpreta la intención del documento en lugar de sus valores de píxel.
5. Filtrado de Palabras Clave Posterior a la Extracción
Si sus documentos tienen marcas de agua consistentes (como "MUESTRA" en todas las facturas de demostración o "CONFIDENCIAL" en borradores de contratos), un script simple de posprocesamiento puede eliminar estas cadenas conocidas de los campos extraídos. Esto es un parche, no una solución: solo funciona cuando sabe exactamente qué texto no deseado está presente y no ayuda con los datos faltantes causados por el bajo contraste. Pero es rápido, no requiere cambios en las herramientas y limpia de manera confiable la Causa 2 (texto de marca de agua) en documentos predecibles.
Cuándo Escalar: Cómo Reconocer Documentos que Superan el OCR Tradicional
Algunos documentos están fundamentalmente fuera de las capacidades del OCR tradicional, no porque la tecnología sea defectuosa, sino porque el enfoque de extracción en sí mismo es la herramienta incorrecta.
Si sus documentos presentan de manera consistente alguna de estas características, los ajustes de preprocesamiento nunca resolverán el problema por completo:
- Múltiples elementos visuales superpuestos: Marca de agua + encabezado de color + tabla en la misma página. Cada elemento degrada la señal de forma independiente, y el efecto acumulativo supera lo que la umbralización o la eliminación de fondo pueden recuperar.
- Fondos no uniformes entre páginas: Algunas páginas son blancas lisas, otras tienen encabezados azul claro, otras tienen sombras grises escaneadas. Una sola canalización de preprocesamiento no puede adaptarse a las tres.
- Densidad de marca de agua que cubre más del 30% de la página: Las marcas de agua densas significan que, incluso si se filtra el texto de la marca, los píxeles debajo se han alterado lo suficiente como para que las formas originales de los caracteres ya no sean recuperables.
- La extracción ya falla en documentos simples del mismo tipo: Si la herramienta omite campos incluso en facturas limpias con fondo blanco, el problema no es el fondo, sino la herramienta. Añadir color al documento solo ampliará la brecha.
En estos casos, la escalación correcta no es un mejor preprocesamiento, sino una arquitectura de extracción fundamentalmente diferente. Los modelos de visión-lenguaje que extraen comprendiendo en lugar de umbralizando representan el siguiente paso. Y para documentos con diseños excepcionalmente complejos, optar por una guía de preprocesamiento estructurado combinada con una herramienta moderna de extracción con IA ofrece la mejor oportunidad de obtener resultados limpios.
Comprender por qué la precisión disminuye en diferentes estilos de documentos se aborda en profundidad en nuestro artículo sobre por qué la precisión del OCR varía según el tipo de documento, y la solución de problemas de extracción de tablas se aborda específicamente en nuestra guía sobre cómo corregir problemas de extracción con celdas combinadas.
Preguntas Frecuentes
¿Escanear en escala de grises en lugar de color soluciona los problemas de OCR con fondos de color?
Parcialmente. El escaneo en escala de grises elimina el color como variable, lo que ayuda con fondos de color claros (Causa 1). Sin embargo, no soluciona la interferencia de marcas de agua (Causa 2) porque el texto de la marca de agua sigue apareciendo en la salida en escala de grises. Para marcas de agua, necesita un filtrado semántico o una extracción basada en IA que entienda la marca de agua como una capa visual separada.
¿Puede el OCR leer texto blanco sobre un fondo oscuro si aumento el brillo?
A veces, pero no de manera confiable. Aumentar el brillo aclara el fondo oscuro, lo que acerca tanto el fondo como el texto al extremo blanco del umbral. Lo que realmente necesita es un realce de contraste, no un ajuste de brillo: aumentar la diferencia entre la luminancia del texto y la del fondo, no mover ambos en la misma dirección. Herramientas como el umbral adaptativo o CLAHE (ecualización de histograma adaptativa con límite de contraste) hacen esto de manera más efectiva que los simples controles deslizantes de brillo.
¿Por qué mi herramienta de OCR lee el texto de la marca de agua en algunos documentos y en otros no?
Los diferentes motores de OCR utilizan diferentes algoritmos de binarización. Algunos motores (como Tesseract con la configuración predeterminada) son más agresivos al tratar todo como texto potencial, lo que los hace más propensos a leer marcas de agua. Otros (como ABBYY FineReader) aplican más preprocesamiento para suprimir elementos de fondo antes de la binarización. La misma marca de agua puede producir resultados de extracción completamente diferentes entre herramientas porque la canalización de preprocesamiento — no el motor de reconocimiento de caracteres — determina si la marca de agua sobrevive hasta la etapa de reconocimiento.
¿La extracción impulsada por IA resolverá por completo los problemas de fondos de color y marcas de agua?
Los modelos de visión por IA son significativamente más tolerantes a los fondos de color y las marcas de agua que el OCR tradicional: manejan las Causas 2, 3 y la mayor parte de la Causa 1 mucho mejor porque no dependen de la binarización. Sin embargo, no son perfectos. El contraste extremadamente bajo (texto blanco sobre un fondo blanquecino), las marcas de agua densas que cubren grandes porciones del documento y los reflejos digitales intensos aún pueden confundir a los VLM. La respuesta honesta es que este sigue siendo uno de los problemas más difíciles en la extracción de documentos, pero las herramientas modernas de IA han cerrado la brecha sustancialmente: de "falla en la mayoría de los documentos de color" a "tiene éxito en la mayoría, pero falla en casos extremos".
¿Puedo eliminar una marca de agua de un PDF antes de ejecutar el OCR?
Las marcas de agua en PDF a veces están en una capa de renderizado separada que se puede eliminar con herramientas de edición de PDF como Adobe Acrobat Pro, PDFpen o herramientas de línea de comandos como qpdf o cpdf. Sin embargo, las marcas de agua que se han aplanado en la imagen (rasterizadas durante la creación del PDF o el escaneo) no se pueden eliminar: están permanentemente integradas en los valores de píxeles. Para marcas de agua aplanadas, la solución debe ocurrir a nivel de extracción, no a nivel de documento.
Pruebe sus documentos con fondos de color en un extractor moderno con IA
Cargue una imagen o un PDF y compruebe si la extracción semántica maneja su marca de agua o su diseño de color mejor que el OCR tradicional.
Pruébelo ahora →Sin registro. Resultados en 10 segundos.