Melhores Ferramentas de Extração de
Documentos Logísticos em 2026: 9 Testadas
Testamos nove ferramentas de extração de documentos executando os mesmos 50 documentos logísticos — conhecimentos de embarque marítimo de sete grandes transportadoras (Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE, Evergreen), conhecimentos aéreos, notas de entrega rodoviárias com assinaturas manuscritas e números de lacre, romaneios de embalagem, faturas de frete e formulários de declaração aduaneira — em cada plataforma, medindo a precisão em nível de campo em dados específicos da logística, como números de contêiner, códigos SCAC, códigos SH, números de lacre, códigos portuários (UN/LOCODE) e termos de frete (FOB, CIF, FCA).
Principais Conclusões
- Oito das nove ferramentas pontuaram acima de 90% em um conhecimento de embarque marítimo limpo — depois quatro caíram abaixo de 50% nos números de lacre manuscritos que determinam se um estorno de frete se sustenta.
- As ferramentas de extração treinadas em contas a pagar não falhavam por OCR ruim — seus conjuntos de treinamento as ensinaram a encontrar totais de faturas e nomes de fornecedores, mas nunca lhes mostraram um código SCAC, um prefixo de número de contêiner ou um termo de frete, então as ferramentas literalmente não sabem que esses campos existem.
- As três ferramentas que se mantiveram acima de 80% em comprovantes de entrega manuscritos liam os campos pelo significado semântico em vez das coordenadas do modelo — ou seja, um número de lacre rabiscado na margem recebe o mesmo tratamento que um impresso em sua caixa designada.
Divulgação: O ImageToTable.ai é nosso produto e aparece nesta análise. Nós o incluímos porque acreditamos que sua abordagem — extração sem modelo, baseada em nomes de colunas — resolve uma lacuna específica no processamento de documentos logísticos. As outras oito ferramentas são avaliadas de forma independente. Todo link externo usa rel="nofollow noopener" — não repassamos autoridade de link para as ferramentas que analisamos.
Se você trabalha em logística — agenciamento de cargas, logística terceirizada, despacho aduaneiro, gestão de armazém —, os documentos que você processa todos os dias quase não têm nada em comum com as faturas que uma equipe típica de contas a pagar lida. Um conhecimento de embarque marítimo traz números de contêiner, nomes de navios, códigos portuários, termos de frete, códigos SCAC e números de lacre que não têm equivalente em uma fatura de fornecedor. Um comprovante de entrega chega com assinaturas manuscritas e anotações rabiscadas nas margens. Uma fatura de frete detalha cobranças por classe NMFC, códigos de taxas acessórias e percentuais de sobretaxa de combustível. E todos esses documentos chegam em formatos que variam conforme a transportadora, a companhia marítima, o país de origem e o modal de transporte.
As ferramentas de extração que dominam as listas de uso geral — criadas e treinadas com faturas de fornecedores, recibos e formulários fiscais — muitas vezes deixam passar completamente esses campos específicos da logística, ou os retornam em formatos que geram mais trabalho de limpeza do que economizam. Este guia testa nove ferramentas especificamente nos tipos de documento e de campo que as operações logísticas realmente lidam.
Como Testamos: 50 Documentos Logísticos, 4 Categorias de Documento, 9 Ferramentas
Cada ferramenta foi testada usando seu teste gratuito, demo ou plano autoatendimento. Nenhum fornecedor recebeu aviso prévio. Testamos cada documento individualmente — não por meio de chamadas de API em lote — para medir a experiência pronta para uso que um coordenador de logística típico ou gerente de operações de agenciamento de cargas encontraria.
O conjunto de teste de 50 documentos foi dividido da seguinte forma:
- 12 conhecimentos de embarque marítimos — cobrindo Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE e Evergreen. Incluía conhecimentos de embarque nominativos (originais), conhecimentos de embarque multimodais cobrindo transporte marítimo + terrestre, e formatos de conhecimento de embarque master (MBL) e conhecimento de embarque house (HBL). Cinco dos doze incluíam anotações carimbadas à mão — correções de número do lacre, ajustes de peso do contêiner e ordens de troca de consignatário — escritas sobre o texto impresso.
- 8 conhecimentos aéreos — cobrindo combinações expressas (FedEx Express, DHL) e de agente de carga MAWB/HAWB. Incluía um scan de baixa qualidade de um conhecimento aéreo impresso em papel térmico com texto desfocado.
- 12 notas de entrega e comprovantes de entrega (PODs) — confirmações de entrega de transportadoras rodoviárias com itens de linha impressos e campos manuscritos: assinaturas, carimbos de data/hora de entrega, anotações de danos ("1 caixa amassada — recusada") e anotações de quantidade parcial. Este foi o tipo de documento com a maior densidade de manuscrito no conjunto de teste.
- 10 romaneios de embalagem — documentos de embalagem de fornecedores e 3PL com itens de linha no nível do item, contagens de caixas, números de rastreamento e referências do remetente. Incluía três com códigos de envio internacional (códigos SH, marcações de país de origem).
- 8 faturas de frete — faturas de transportadoras LTL e de encomendas com classes NMFC, taxas acessórias, itens de linha de sobretaxa de combustível e referências cruzadas PRO/BOL.
Medimos três coisas por extração: precisão no nível do campo em campos específicos de logística (número do contêiner, código SCAC, código SH, número do lacre, código portuário UN/LOCODE, termos de frete), tolerância a manuscrito (a precisão degradou em conteúdo anotado à mão ou manuscrito vs. campos impressos por máquina) e independência de formato (os resultados de extração de conhecimento de embarque se mantiveram estáveis entre variações de layout das transportadoras, ou a precisão caiu quando um conhecimento de embarque da Maersk foi seguido por um formato da MSC).
Em conhecimentos de embarque marítimos limpos, impressos por máquina, das principais transportadoras, oito de nove ferramentas pontuaram 90%+ de precisão no nível do campo em campos padrão (remetente, consignatário, navio, portos). Em campos específicos de logística — consistência de formato do número do contêiner, extração de código SCAC, identificação de termo de frete — as melhores ferramentas ficaram acima de 85%, enquanto as duas piores caíram abaixo de 60%. Em anotações manuscritas de POD, a variação foi ainda maior: três ferramentas mantiveram precisão acima de 80%, enquanto quatro ficaram abaixo de 50%.
Comparação Rápida: 9 Ferramentas de Extração de Documentos Logísticos
| Ferramenta | Melhor Para | Preço Inicial | Campos Logísticos* | Manuscrito | Independência de Formato |
|---|---|---|---|---|---|
| ImageToTable.ai | Extração sem modelo em todos os formatos de transportadora | Plano gratuito (50 páginas/mês); pago a partir de ~$15/mês | Completo — colunas personalizadas | Alta (85-95%) | Completa — extração semântica |
| Rossum | Logística empresarial + AP com fluxo de revisão humana | ~$1.500/mês | Forte — habilidades em documentos logísticos | Média (70-85%) | Boa — IA cognitiva se adapta a layouts |
| Nanonets | Extração API-first com treinamento de modelo personalizado | ~$499/mês | Moderada — campos personalizados por modelo treinado | Média (65-80% com treinamento) | Moderada — precisa de 10+ amostras por layout |
| Docsumo | Fluxos com muita verificação e validação entre documentos | A partir de $299/mês | Moderada — modelos logísticos pré-construídos | Média (65-80%) | Moderada — pré-treinado + treinamento personalizado |
| ABBYY Vantage | Logística global com OCR em 200+ idiomas | Personalizado (geralmente empresarial) | Moderada — marketplace de Vantage Skills | Alta (85-90%) | Moderada — baseada em skills, precisa de configuração |
| Amazon Textract | Pipelines de extração nativos da AWS personalizados | Pagamento por página (~$0,0015/página) | Básica — chave-valor genérico + tabelas | Baixa (50-65%) | Moderada — API de layout detecta tabelas |
| Docparser | Faturas de transportadora com formato consistente | A partir de $32,50/mês | Baixa — mapeamento de campos por modelo | Baixa (40-55%) | Baixa — baseada em modelo, quebra com mudança de formato |
| FormX | Extração pré-construída para documentos de envio | Pagamento por página; personalizado | Moderada — modelos pré-construídos de documentos de envio | Média (60-75%) | Moderada — extratores para modelos comuns |
| Parseur | E-mail para dados estruturados em logística | A partir de $39/mês | Baixa — mapeamento de campos por modelo | Baixa (35-50%) | Baixa — OCR por modelo/zona |
*Campos específicos de logística incluem números de contêiner, códigos SCAC, códigos SH, números de lacre, identificadores portuários UN/LOCODE e termos de frete (FOB, CIF, FCA, etc.). "Full" significa que a ferramenta consegue extrair qualquer campo logístico personalizado sem pré-configuração.
ImageToTable.ai — Melhor para Extração de Documentos Logísticos independente de formato
Melhor para: Equipes de logística — agentes de carga, 3PLs, despachantes aduaneiros — que processam documentos de várias transportadoras e precisam de um único fluxo de extração que funcione em todos os formatos sem configuração por transportadora.
Não ideal para: Grandes empresas que precisam de roteamento de aprovação integrado, orquestração de fluxo de trabalho integrada ao ERP ou filas de revisão humana para tratamento de exceções em escala.
O ImageToTable.ai usa o que chama de Extração de Colunas Personalizadas — você digita os nomes das colunas que deseja extrair (por exemplo, "Container Number", "SCAC Code", "HS Code", "Port of Loading", "Freight Terms"), e a IA localiza esses valores em qualquer documento por compreensão semântica, e não por posição de pixel. Essa é a principal diferença em relação às ferramentas baseadas em modelo e é o que mais importa para operações logísticas, em que um BOL da Maersk, um BOL da MSC e um BOL da COSCO compartilham o mesmo conteúdo de informação, mas o exibem em layouts completamente diferentes, com rótulos de campo distintos.
No nosso conjunto de teste de 50 documentos, o ImageToTable.ai apresentou a maior precisão em nível de campo nos campos específicos de logística — números de contêiner, códigos SCAC, números de lacre, códigos portuários e termos de frete — sem qualquer pré-treinamento ou configuração de modelo por transportadora. Os comprovantes de entrega manuscritos foram o diferencial: números de lacre e anotações de entrega manuscritos, que fizeram quatro ferramentas deste teste ficarem abaixo de 50% de precisão, foram extraídos de forma confiável aqui, porque o modelo de visão subjacente é treinado para diferenciar texto impresso, manuscrito, carimbos e marcas de anotação intercalados no mesmo documento.
Um agente de carga de médio porte com quem conversamos processa cerca de 500 BOLs por mês em 15 transportadoras. O fluxo de trabalho anterior usava um extrator baseado em modelo que exigia a manutenção de 15 modelos específicos por transportadora. Quando a Maersk atualizou o layout do seu BOL, o modelo quebrou silenciosamente — os números de BOL apareceram na coluna de data por duas semanas antes que alguém percebesse. Com a extração por nome de coluna, eles definem os campos de saída uma vez, e a IA se adapta automaticamente às mudanças de layout porque lê por significado, não por coordenadas.
Os arquivos são processados com segurança e não são armazenados. Tente enviar um romaneio de embalagem ou BOL para ver o fluxo de extração.
Para um passo a passo detalhado de como a extração de BOL funciona entre formatos de transportadoras e tipos de BOL — conhecimento de embarque nominativo, conhecimento de embarque à ordem, conhecimento de embarque multimodal, conhecimento de embarque master vs. house — consulte nosso guia sobre extração de dados de conhecimento de embarque e o guia completo de extração de BOL. Para extração de romaneio de embalagem, consulte o que é extração de dados de romaneio de embalagem. Se você processa BOLs de mais do que um punhado de transportadoras em uma única execução, consulte nosso guia sobre extração de BOL em lote de várias transportadoras. Para executar a extração nos seus próprios BOLs — marítimo, LTL ou aéreo — use a ferramenta de conhecimento de embarque para Excel.
Rossum — Melhor para Processamento de Documentos Logísticos Empresariais com Revisão Humana
Melhor para: Grandes agentes de carga e 3PLs que precisam de extração por IA combinada com uma interface de revisão humana e integração com ERP, especialmente para documentos logísticos que alimentam fluxos de trabalho de contas a pagar.
Não ideal para: Equipes de logística de pequeno e médio porte com orçamento limitado — os preços começam em torno de $1,500 por mês, o que o coloca fora do alcance de corretores independentes ou pequenos 3PLs.
O mecanismo Aurora AI da Rossum processa documentos logísticos — faturas, BOLs, romaneios de embalagem, documentos aduaneiros — sem configuração por modelo. Sua interface de revisão lado a lado de documento e dados é uma das experiências de usuário mais refinadas do mercado de IDP, e suas integrações com SAP, Coupa e QuickBooks o tornam uma escolha natural para empresas de logística onde a saída de documentos alimenta diretamente um ERP ou TMS.
Em campos específicos de logística, a Rossum teve bom desempenho em documentos no estilo de fatura que carregam totais, datas e referências de fornecedores. A própria documentação de logística da plataforma destaca ponto de embarque, grupo de carregamento e tipo de entrega como campos-alvo. Em nossos testes, números de contêiner e códigos SCAC foram extraídos de forma confiável de PDFs de BOL limpos, mas perderam precisão em documentos com anotações manuscritas sobre o campo do número do contêiner — a interface de revisão humana captura esses casos, mas isso significa que a taxa de automação é menor do que a precisão bruta de extração sugere para aplicações logísticas.
O Porto de Rotterdam e a Wolt são citados como clientes de logística. A arquitetura nativa da nuvem da plataforma e as integrações com os principais ERPs a tornam viável para operações logísticas empresariais, mas o preço mensal e o preço por volume de documentos não escalam bem para equipes de logística menores.
Nanonets — Melhor para Extração de Documentos Logísticos com API-First e Treinamento Personalizado
Melhor para: Empresas de logística com equipes de desenvolvimento internas que desejam treinar modelos de extração personalizados para formatos específicos de transportadoras ou tipos de documentos e integrar via API.
Não ideal para: Equipes de operações logísticas sem recursos técnicos dedicados — a configuração exige integração via API, rotulagem de amostras e treinamento de modelo por tipo de documento.
O Nanonets suporta mais de 300 tipos de documentos pré-treinados e oferece treinamento de modelo personalizado com apenas 10 documentos de amostra. Para uma operação logística que processa o mesmo layout de BOL da COSCO milhares de vezes por mês, treinar um modelo dedicado poderia produzir alta precisão. Mas a diversidade de documentos logísticos trabalha contra essa abordagem: um agente de carga que lida com 15 transportadoras vê 15 layouts, e um modelo treinado por transportadora é um contrato de manutenção, não uma configuração única.
No nosso conjunto de testes, o Nanonets teve bom desempenho em campos padrão de documentos limpos impressos por máquina (nome do embarcador, nome da embarcação, portos), mas teve dificuldades com códigos específicos de logística. A extração do número do contêiner foi inconsistente entre transportadoras — capturou "MAEU1234567" de forma confiável de um BOL da Maersk, mas interpretou "MSCU9876543" como dois campos separados em um formato da MSC. O modelo de preços — a partir de aproximadamente $499 por mês — fica entre a acessibilidade do mercado intermediário e o custo empresarial, tornando-o um ajuste potencialmente inadequado para pequenos agentes de carga e limitado demais para grandes 3PLs que precisam de orquestração de fluxo de trabalho.
Docsumo — Melhor para Fluxos de Trabalho Logísticos com Foco em Verificação
Melhor para: Equipes de logística que precisam de validação cruzada de documentos — comparando dados de BOL com romaneios de embalagem, faturas de frete e confirmações de entrega correspondentes — com uma interface robusta de revisão humana.
Não ideal para: Equipes que precisam de extração sem configuração em tipos de documentos que a plataforma não pré-treinou — documentos logísticos personalizados exigem treinamento com mais de 10 amostras.
O Docsumo se posiciona como uma plataforma de IA para documentos empresariais, com modelos pré-treinados para faturas, extratos bancários, documentos fiscais e documentos logísticos. Sua tela de revisão — elogiada por usuários no G2 por ser intuitiva — suporta fluxos de trabalho de verificação cruzada, onde campos extraídos são sinalizados para revisão humana quando a confiança está abaixo do limite.
Nos nossos testes, o modelo logístico pré-treinado do Docsumo capturou números de contêiner e códigos SH de PDFs de BOL limpos com precisão moderada, mas exigiu treinamento de modelo para campos específicos de transportadoras, como códigos SCAC e termos de frete. Os recursos de processamento em lote da plataforma — lidando com vários documentos em uma única passagem — são relevantes para equipes de logística que processam mais de 50 BOLs por lote. O preço começa gratuito para 100 páginas por mês, depois passa para $299 por mês no nível inicial, escalando com o volume. O nível gratuito de entrada é útil para avaliação, mas os limites de páginas o tornam impraticável para o volume logístico contínuo.
Para comparação, um estudo de caso de armazenagem 3PL no site do Docsumo descreve a BiagiBros lidando com mais de 3.000 documentos por mês com 95% de processamento direto e 500 horas economizadas — um benchmark realista para um fluxo de trabalho de documentos criado especificamente para logística.
ABBYY Vantage — Melhor para Processamento Multilíngue de Documentos Logísticos
Melhor para: Equipes de logística global que processam documentos de transporte em vários idiomas e conjuntos de caracteres — conhecimentos de embarque marítimo da COSCO em chinês, conhecimentos aéreos da Nippon Express em japonês, declarações aduaneiras em árabe — onde a cobertura de idiomas é um requisito crítico.
Não ideal para: Equipes que precisam extrair campos logísticos personalizados sem configuração por tipo de documento — o Vantage exige criar ou comprar "skills" por categoria de documento.
O ABBYY Vantage é a evolução empresarial do ABBYY FlexiCapture, um dos motores de OCR mais antigos e confiáveis do mercado. O marketplace de skills do Vantage oferece modelos de extração pré-construídos para tipos comuns de documentos, e o motor de OCR subjacente suporta mais de 200 idiomas — incluindo chinês, japonês, árabe, cirílico e escritas da direita para a esquerda. Essa cobertura de idiomas é genuinamente útil para operações logísticas em que o lote de um único dia pode incluir um conhecimento de embarque marítimo da COSCO em chinês, uma carta de porte ferroviária (CMR) em russo e uma fatura de frete em inglês.
O reconhecimento de manuscrito da ABBYY — uma força herdada de décadas de processamento de formulários — teve bom desempenho nas anotações de entrega manuscritas do nosso conjunto de testes, ficando atrás apenas do ImageToTable.ai e em pé de igualdade com o Rossum. O trade-off é a complexidade de configuração: as skills do Vantage precisam ser configuradas por tipo de documento, e campos logísticos personalizados (códigos SCAC, números de lacre, termos de frete) exigem personalização de skill ou configuração manual de zonas. O preço é personalizado para empresas, normalmente exigindo uma conversa com vendas e compromisso anual, o que o elimina da consideração para operações logísticas menores.
Amazon Textract — Melhor para Construir Pipelines Personalizados de Extração Logística
Melhor para: Equipes de desenvolvimento em empresas de logística ou 3PLs que desejam construir pipelines de extração personalizados na infraestrutura da AWS, com controle total sobre pré-processamento, validação e integração downstream.
Não ideal para: Equipes de operações logísticas sem desenvolvedores dedicados — o Textract não tem interface de usuário, fluxo de revisão nem modelos de extração logística pré-construídos. Você recebe pares chave-valor brutos e tabelas, e tudo além disso é o seu código.
O Amazon Textract é um serviço de machine learning — não uma aplicação. Ele aceita imagens de documentos e retorna texto detectado, pares chave-valor de formulários e estruturas de tabelas. Para uma empresa de logística com uma stack tecnológica nativa da AWS e uma equipe de desenvolvimento, o Textract pode ser a camada de extração em um pipeline personalizado que encaminha dados de BOL para um TMS, valida números de contêiner em relação a registros de reserva e sinaliza discrepâncias de número de lacre para revisão humana.
Nos nossos testes, a extração de tabelas do Textract foi útil para os blocos de itens de linha em romaneios de embalagem e faturas de frete. Seu recurso Queries — que permite solicitar campos específicos em linguagem natural (por exemplo, "Qual é o número do contêiner?") — retornou resultados moderados em BOLs, mas foi inconsistente quando o número do contêiner aparecia em uma barra lateral ou cabeçalho em vez de um campo claramente rotulado. O reconhecimento de manuscrito foi sua área mais fraca: notas de entrega digitalizadas com anotações manuscritas retornaram texto com erros significativos de caracteres.
O preço — pagamento por página, começando em torno de $0.0015 por página para o primeiro nível — parece atraente em baixos volumes, mas pode surpreender em escala logística. Processar 5.000 BOLs de várias páginas por mês nos níveis padrão e de layout do Textract custaria várias centenas de dólares antes de você adicionar o custo de processamento downstream (computação, armazenamento, tempo de desenvolvedor para construir e manter o pipeline).
Docparser — Melhor para faturas de transportadoras com formato consistente
Melhor para: Equipes de logística que recebem grandes volumes de faturas de transportadoras em formatos idênticos — onde cada fatura da FedEx usa o mesmo layout e você quer extrair os itens de cobrança para uma planilha consistente.
Não ideal para: Conhecimentos de embarque de formato variável, documentos multimodais ou qualquer documento logístico cujo layout mude entre fontes — a extração baseada em modelo quebra silenciosamente quando o formato muda.
O Docparser usa uma abordagem de modelo baseado em zonas: você seleciona visualmente os campos em um documento de amostra, e o parser extrai essas coordenadas em todos os documentos subsequentes com o mesmo layout. Isso funciona bem quando o formato permanece idêntico — por exemplo, extrair itens de cobrança de uma fatura de frete da FedEx, onde cada fatura segue o modelo padrão da FedEx.
A limitação fica evidente em operações logísticas com múltiplas transportadoras. Um único lote de 50 conhecimentos de embarque de 12 transportadoras exigiria 12 modelos. Quando uma transportadora atualiza seu layout — as companhias marítimas mudam de marca, se fundem ou trocam de sistema ERP — o modelo quebra, e a extração falha ou retorna dados inúteis sem gerar erro. No nosso conjunto de testes logísticos, o Docparser teve bom desempenho nas faturas de frete de formato consistente (layouts padrão da FedEx e UPS), mas não conseguiu extrair nenhum número de contêiner ou código SCAC utilizável dos conhecimentos de embarque — os nomes e as posições dos campos variavam demais entre as transportadoras para uma abordagem baseada em zonas.
O preço começa em $32.50 por mês, tornando-o o ponto de entrada mais acessível desta comparação para extração baseada em modelo de documentos com o mesmo formato.
FormX — Melhor para extração pré-construída em modelos logísticos comuns
Melhor para: Equipes de logística que processam documentos compatíveis com a biblioteca de extratores pré-construídos do FormX — romaneios de embalagem, etiquetas de envio, faturas comerciais — e querem extração sem treinar seus próprios modelos.
Não ideal para: Documentos logísticos personalizados fora da biblioteca de extratores do FormX, ou documentos com muita escrita à mão — os extratores pré-construídos são projetados para documentos estruturados impressos por máquina.
O FormX oferece extratores para tipos comuns de documentos, incluindo documentos de envio e romaneios de embalagem. A plataforma usa uma combinação de modelos de IA pré-treinados e correspondência de modelos, com uma interface de usuário para revisar os dados extraídos. No nosso conjunto de testes, os extratores de romaneio de embalagem e fatura comercial do FormX tiveram desempenho respeitável em documentos padrão impressos por máquina — descrições de itens, quantidades e totais foram capturados com precisão moderada.
A limitação estava nos campos nativos da logística que não aparecem nas categorias padrão de "documento de envio": códigos SCAC, detalhamentos de itens por código SH, números de lacre e termos de frete. Esses campos foram omitidos ou retornados com formatação inconsistente. A tolerância à escrita à mão foi mediana — típica de ferramentas treinadas principalmente em conjuntos de dados impressos por máquina. O preço é baseado no uso e exige uma cotação personalizada para extração de documentos de envio, dificultando a estimativa de custo antes de iniciar um teste.
Parseur — Melhor para Ingestão de Documentos Logísticos por E-mail
Ideal para: Coordenadores de logística que recebem comprovantes de entrega, conhecimentos de embarque e faturas de frete como anexos de e-mail e querem processá-los automaticamente em uma planilha ou banco de dados.
Não ideal para: Documentos logísticos digitalizados ou fotografados, comprovantes de entrega com muita escrita à mão ou lotes de transportadoras em vários formatos — a camada de OCR do Parseur é básica e sua abordagem de modelo/zonas não se adapta à variação de layout.
O Parseur se destaca em um fluxo logístico específico: a ingestão de documentos que chegam por e-mail. Um coordenador de logística que encaminha comprovantes de entrega dos motoristas para uma fila de processamento, ou um agente de carga que recebe faturas de transportadoras como anexos de e-mail de vários fornecedores, pode configurar o Parseur para detectar documentos recebidos, extrair campos definidos e enviar dados estruturados para uma planilha do Google ou um endpoint de API.
A limitação é que o processamento de documentos do Parseur é fundamentalmente baseado em modelo — você define zonas e regras por remetente ou formato de documento. Para uma equipe de logística que recebe o mesmo modelo de fatura da FedEx do mesmo e-mail remetente todos os dias, isso funciona de forma confiável. Para um agente de carga que recebe PDFs de conhecimentos de embarque de 15 transportadoras diferentes, cada uma com seu próprio formato, a exigência de um modelo por transportadora cria o mesmo fardo de manutenção que o Docparser. A qualidade do OCR em documentos digitalizados e o reconhecimento de escrita à mão são básicos, o que torna o Parseur pouco adequado para os fluxos de notas de entrega e comprovantes de entrega que dominam o volume de documentos logísticos. Os preços começam em $39 por mês para 20 documentos processados, escalando para $117 e $299 por mês para volumes maiores.
Qual Ferramenta de Extração de Documentos Logísticos É Ideal para Sua Operação?
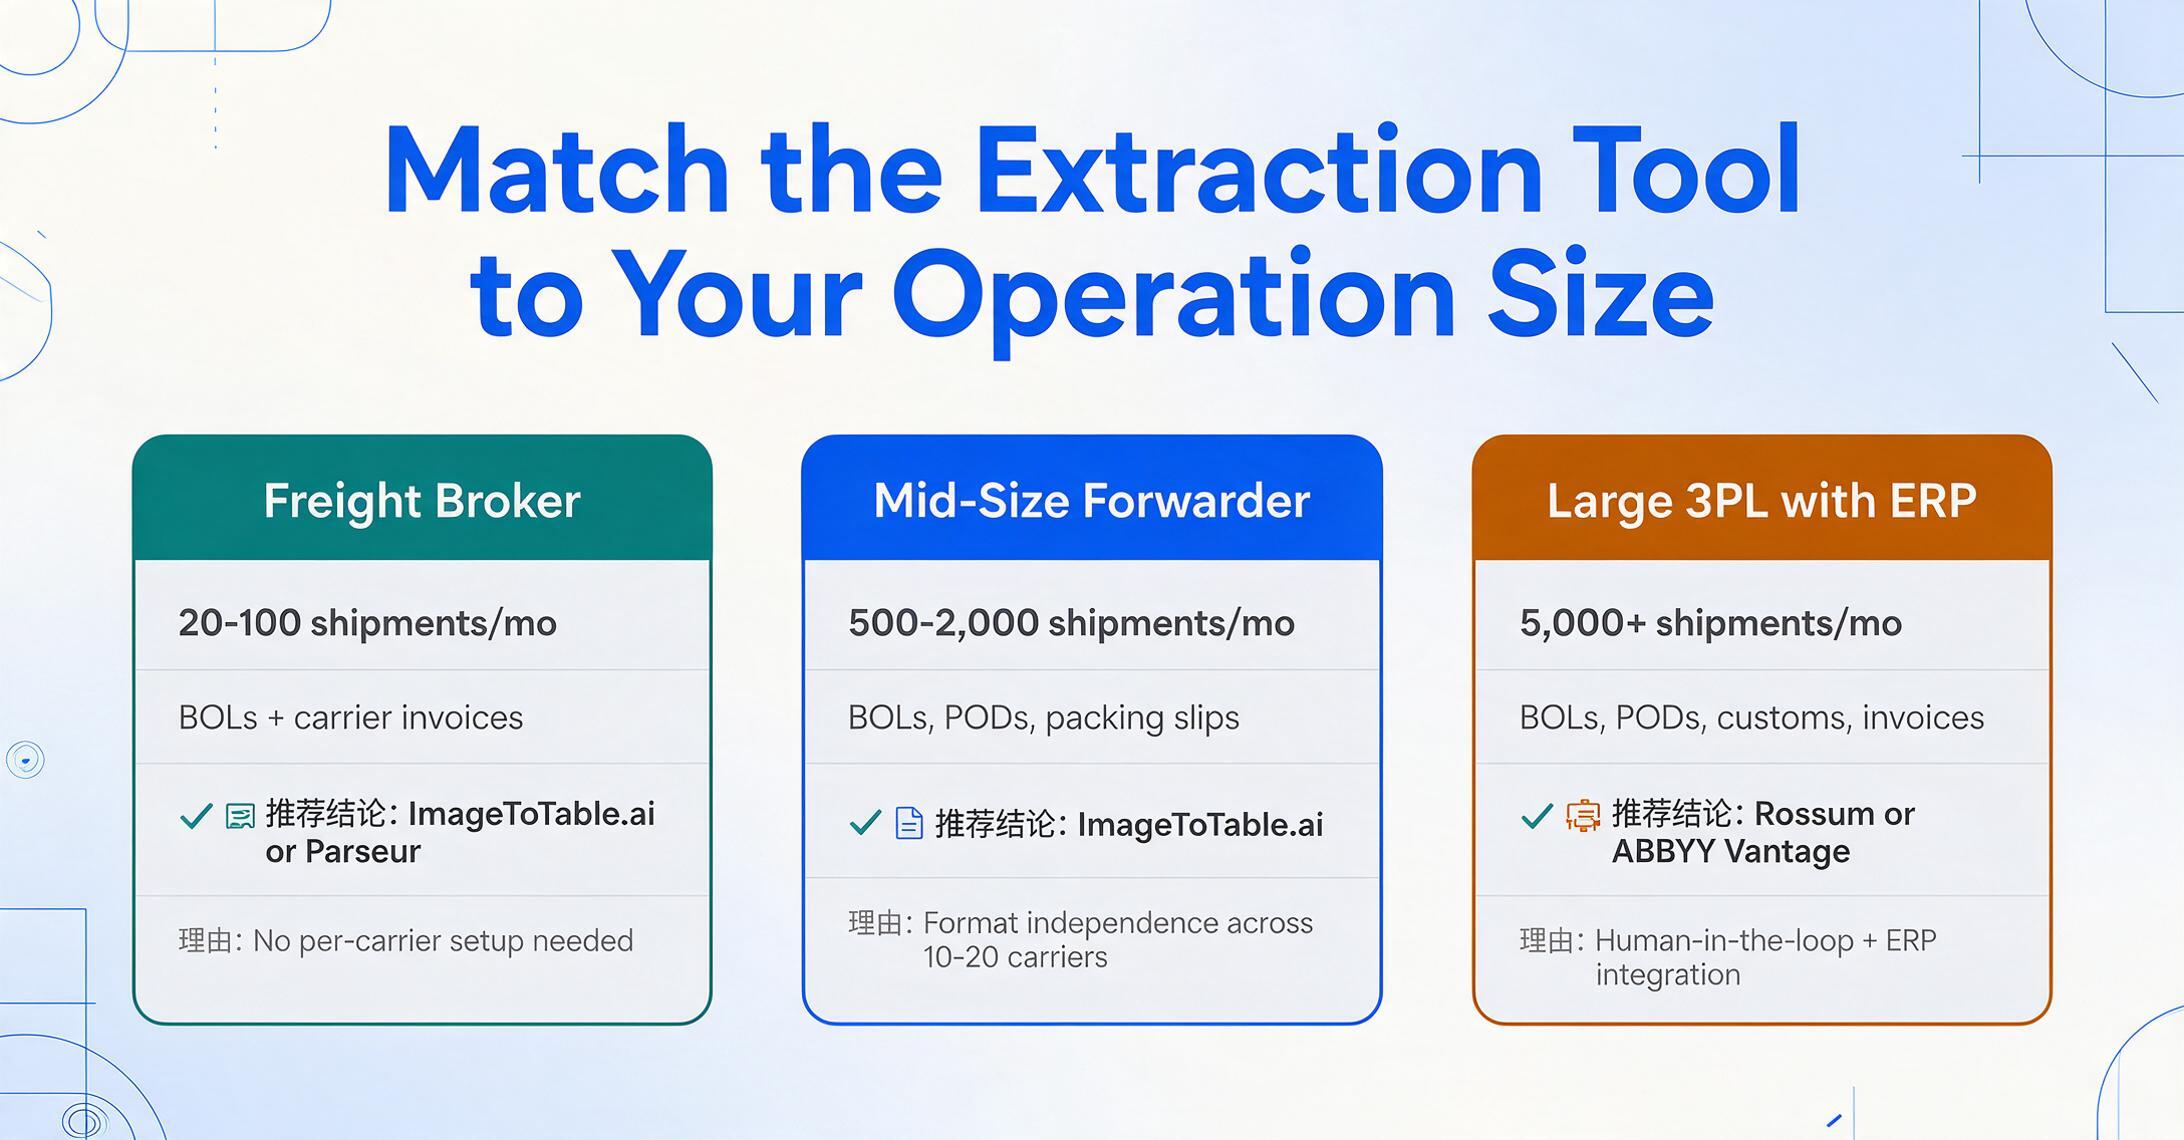
As operações logísticas variam enormemente em escala, mix de tipos de documentos e capacidade técnica. A ferramenta que funciona para um agente de carga autônomo que lida com 50 embarques por mês é diferente da ferramenta de que um 3PL global com 50.000 embarques mensais precisa. Veja como adequar a escolha à operação:
| Seu cenário | Mistura de documentos | Ferramenta recomendada | Motivo |
|---|---|---|---|
| Agente de frete independente, 20-100 embarques/mês | BOLs + faturas de transportadoras, principalmente por e-mail | ImageToTable.ai ou Parseur | Baixo custo, sem necessidade de configuração por transportadora; Parseur se tudo chega por e-mail em formato consistente |
| Agente de carga de médio porte, 500-2.000 embarques/mês | BOLs (marítimo + aéreo), comprovantes de entrega, romaneios de embalagem, faturas de frete, documentos aduaneiros | ImageToTable.ai | Independência de formato em 10-20 transportadoras; tolerância a manuscrito em comprovantes de entrega; sem carga de modelos por transportadora |
| 3PL de grande porte, 5.000+ embarques/mês com integração ERP | Variedade completa: BOLs, comprovantes de entrega, declarações aduaneiras, faturas de frete, romaneios de embalagem, notas de entrega | Rossum ou ABBYY Vantage | Fluxo de trabalho empresarial, revisão humana, integração ERP; orçamento maior comporta o preço |
| Despachante aduaneiro, alto volume de declarações aduaneiras | Documentos de entrada, declarações de código SH, certificados de origem, faturas comerciais | ImageToTable.ai ou Rossum | Necessidade de extração de código SH + consistência de dados entre documentos (BOL, romaneio de embalagem e fatura) |
| Equipe de desenvolvimento interna criando automação logística personalizada | Processamento via API de BOLs e faturas | Amazon Textract ou Nanonets | Design API-first, controle total do pipeline, possibilidade de treinar modelos personalizados por formato de transportadora |
| Processamento de faturas de transportadoras com formato idêntico | Apenas faturas de frete padrão FedEx/UPS | Docparser | Opção mais barata para faturas com modelo consistente — mas só se o formato nunca mudar |
Os Três Desafios de Extração Específicos da Logística que a Maioria das Listas Ignora
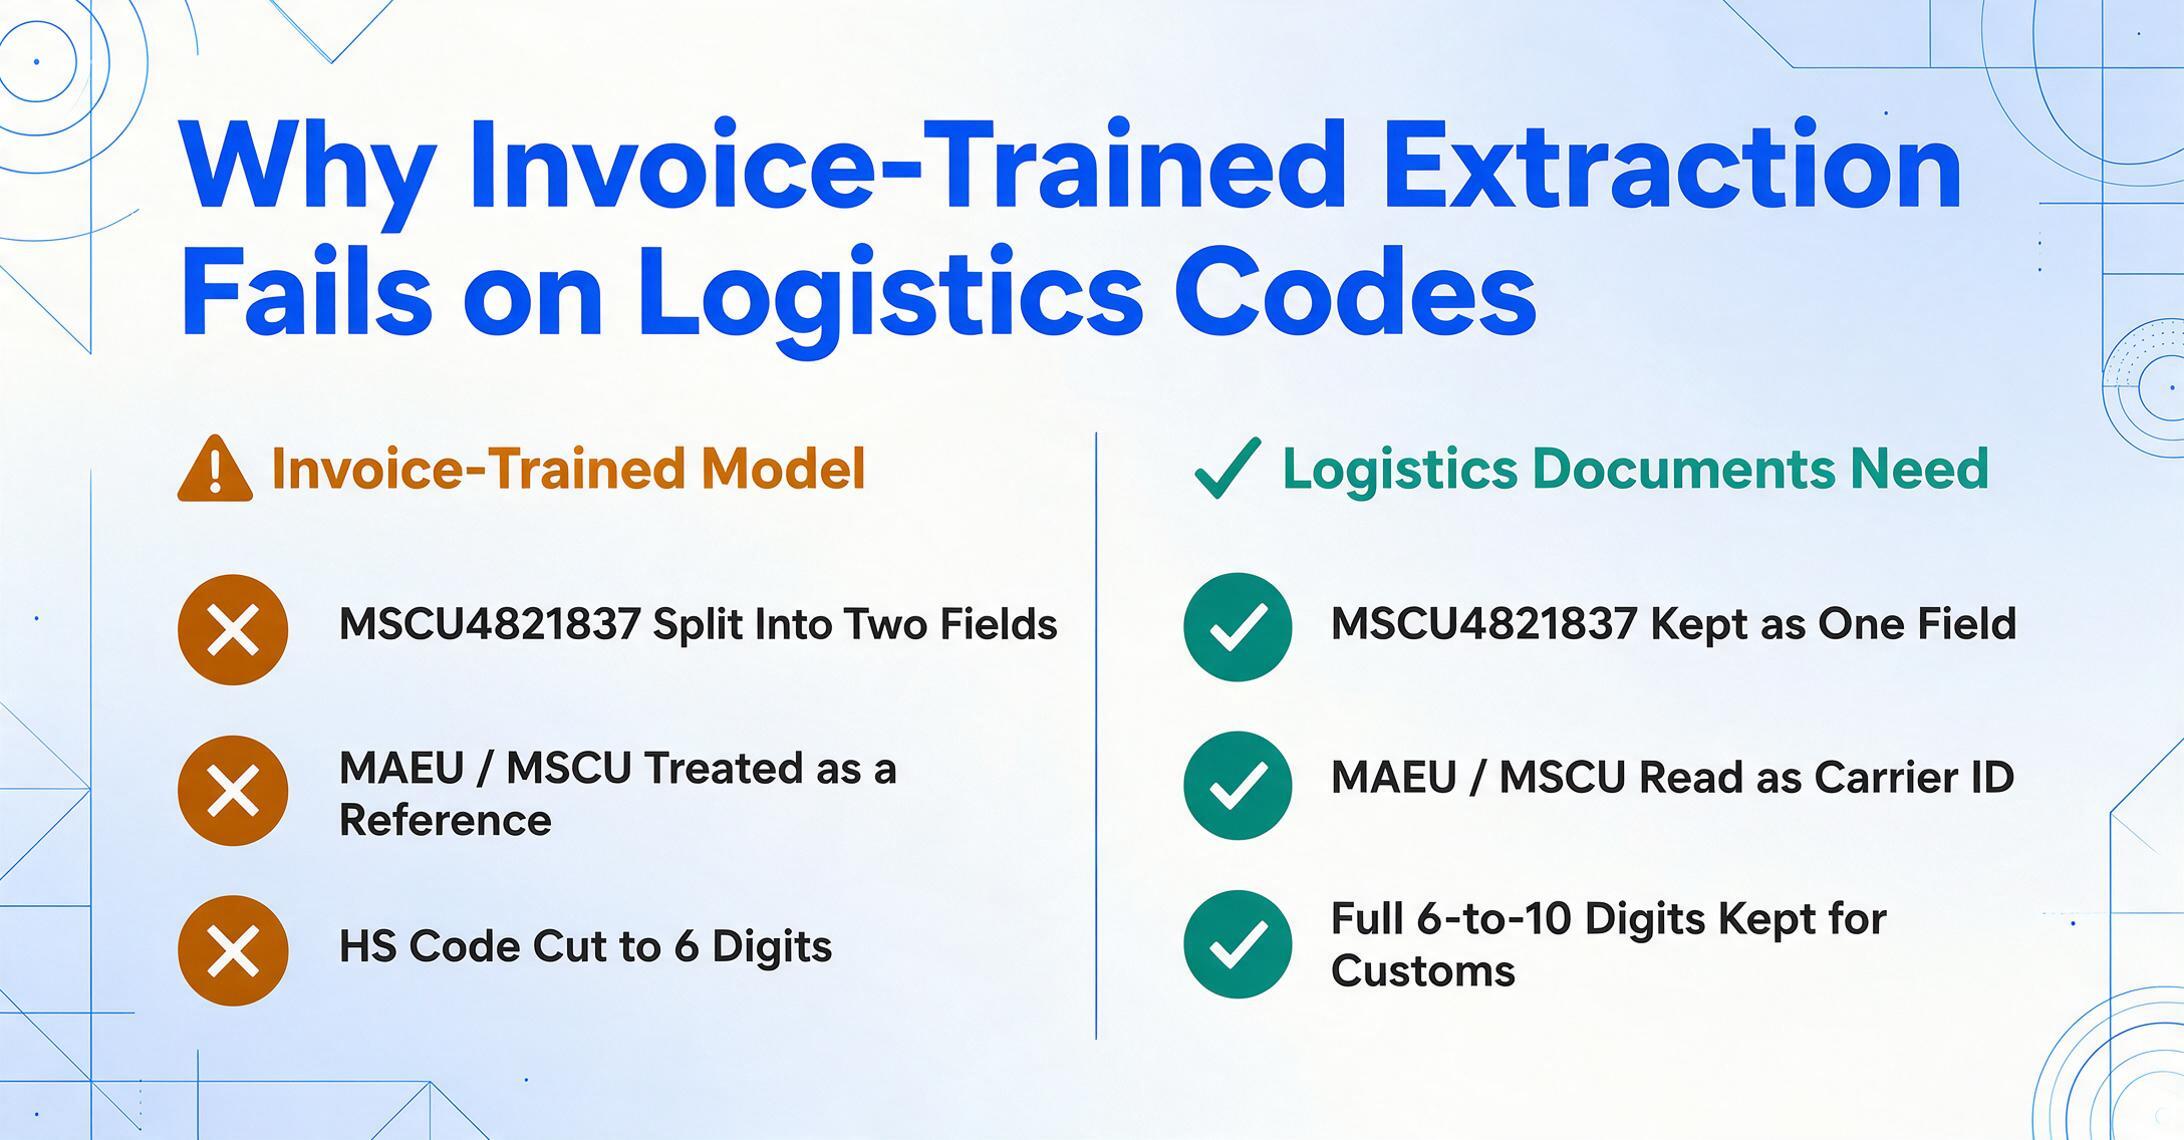
Com base em testes com todas as nove ferramentas, três padrões surgiram que a típica lista de "melhores ferramentas de extração de documentos" não aborda, mas que as operações logísticas encontram todos os dias:
1. Códigos específicos da logística não são campos de fatura. Um número de contêiner (por exemplo, MSCU4821837) segue um formato de prefixo de 4 letras + 7 dígitos que a maioria das ferramentas de extração divide em dois campos ou classifica incorretamente como número de referência. O código SCAC — um identificador de transportadora de 4 letras como "MAEU" (Maersk) ou "MSCU" (MSC) — é um campo obrigatório para declarações aduaneiras (exigências da CBP) que modelos de extração treinados em faturas não reconhecem como um dado distinto. A extração de código SH exige não apenas ler o número, mas preservar a sequência completa de 6 a 10 dígitos, incluindo sufixos específicos do país. Uma ferramenta que extrai os primeiros seis dígitos e descarta a extensão do país retornou dados inutilizáveis para declaração aduaneira. Muitas ferramentas fazem isso.
2. Manuscrito em documentos de logística não é conteúdo opcional — é dado operacional. Um motorista de entrega escreve "recusado 2 ctns" na face de um comprovante de entrega. Um auxiliar de armazém anota à mão o número do lacre quando o contêiner chega com um lacre diferente do registrado no conhecimento de embarque. Uma correção do consignatário é escrita na margem de um conhecimento de embarque na origem. No r/logistics, um usuário descreveu a realidade de forma sucinta: "Você não pode automatizar uma bagunça." Na logística, a "bagunça" costuma ser dados manuscritos que as ferramentas de extração de documentos não foram treinadas para ler, e ela está exatamente nos documentos — comprovantes de entrega, notas de entrega, conhecimentos de embarque corrigidos à mão — onde a precisão mais importa, porque disputas e estornos dependem desses registros. Ferramentas que não lidam com esse conteúdo estão automatizando apenas o subconjunto mais limpo e menos valioso dos documentos de logística.
3. Independência de formato não é um recurso opcional na logística — é o mínimo necessário. Um agente de carga que processa 500 conhecimentos de embarque por mês em 15 transportadoras marítimas, além de conhecimentos aéreos e notas de entrega rodoviárias, não pode manter modelos separados para o formato de cada transportadora e cada tipo de documento. O custo prático da manutenção de modelos — o tempo gasto percebendo que a extração quebrou, diagnosticando qual transportadora atualizou seu layout e reconstruindo o modelo — quase nunca é incluído no preço ou nas comparações dos fornecedores. Ferramentas baseadas em modelo (Docparser, Parseur) parecem mais baratas no papel, mas seu custo total inclui as horas de trabalho gastas na manutenção de modelos, que uma ferramenta independente de formato elimina.
Perguntas frequentes: Extração de documentos logísticos
Qual é a diferença entre um conhecimento de embarque nominativo, um conhecimento de embarque à ordem e um conhecimento de embarque multimodal para fins de extração?
Um conhecimento de embarque nominativo (original) é um documento não negociável emitido para um consignatário nomeado — ele contém campos padrão (embarcador, consignatário, embarcação, portos, descrição da carga, número do contêiner) em um layout normalmente de uma a duas páginas. Um conhecimento de embarque à ordem (negociável) é emitido "à ordem" e pode ser transferido — funciona de forma semelhante para extração, mas pode incluir um campo adicional de "notify party" e espaços de endosso em branco. Um conhecimento de embarque multimodal abrange transporte marítimo + terrestre — ele adiciona campos de local de recebimento, local de entrega e pré-transporte/transporte subsequente que as ferramentas de extração de documentos frequentemente deixam passar porque esperam apenas campos de porto a porto. O padrão FIATA eFBL (FBL eletrônico) é um esforço para padronizar os dados do conhecimento de embarque multimodal, mas a adoção é gradual.
Posso processar conhecimentos de embarque master e house no mesmo lote?
Sim, se sua ferramenta de extração ler documentos semanticamente em vez de por modelo. Um conhecimento de embarque master (MBL) é emitido pela transportadora marítima ao agente de carga. Um conhecimento de embarque house (HBL) é emitido pelo agente de carga ao embarcador. Eles parecem diferentes — cabeçalhos diferentes, rótulos de campo diferentes, estrutura de layout diferente — mas contêm informações sobrepostas (nome da embarcação, portos, número do contêiner, descrição da carga). Uma ferramenta de extração semântica que reconhece "Embarcação" como um conceito vai encontrá-lo em ambos, independentemente do layout visual. Uma ferramenta baseada em modelo exige dois modelos separados.
Como a conformidade com o VGM da SOLAS afeta a extração de dados do conhecimento de embarque?
Desde julho de 2016, os regulamentos SOLAS da Organização Marítima Internacional (IMO) exigem uma Massa Bruta Verificada (VGM) para cada contêiner embalado antes que ele possa ser carregado em uma embarcação. A VGM — composta pelo peso da tara do contêiner + peso da carga — deve ser declarada no conhecimento de embarque ou transmitida separadamente à transportadora e ao terminal. Ao extrair dados do conhecimento de embarque, o valor da VGM e seu método de verificação (Método 1: pesar o contêiner embalado; Método 2: pesar toda a carga e adicionar a tara) devem ser capturados como campos separados. A maioria das ferramentas de extração não distingue a VGM do campo padrão "Peso Bruto" — e os dois valores podem diferir em centenas de quilogramas, causando risco de conformidade se o valor errado alimentar uma declaração aduaneira ou de terminal.
Essas ferramentas conseguem extrair termos de frete (FOB, CIF, FCA) de conhecimentos de embarque?
Apenas ferramentas com compreensão semântica — em que você define "Termos de Frete" como nome de coluna e a IA localiza o termo no documento — capturam termos de frete de forma consistente. Sob os Incoterms 2020, FOB (Free On Board) e CIF (Cost, Insurance, and Freight) se aplicam apenas ao frete marítimo, enquanto FCA (Free Carrier), CIP (Carriage and Insurance Paid To) e DAP (Delivered at Place) cobrem todos os modais. Em um conhecimento de embarque, os termos de frete podem aparecer no bloco de descrição, como um código isolado ou integrados a uma linha de tarifa de frete. Ferramentas baseadas em modelo que procuram "FOB" em uma posição fixa não o encontram quando a transportadora posiciona os termos de forma diferente. A extração semântica o encontra independentemente da posição porque entende o que é um termo de frete e busca o conceito, não a coordenada.
Como a Ordem Executiva da CBP de junho de 2026 sobre fiscalização aduaneira afeta as necessidades de extração de documentos?
A Ordem Executiva da Casa Branca sobre o Fortalecimento da Fiscalização Aduaneira (3 de junho de 2026) determina uma reformulação abrangente dos requisitos de documentação de importação dos EUA. Os Importadores Registrados (IORs) enfrentam novos requisitos, incluindo fornecer à CBP qualquer documentação de exportação enviada às autoridades aduaneiras estrangeiras antes da chegada das mercadorias aos EUA — uma expansão notável do escopo documental. A ordem também exige verificação aprimorada para despachantes aduaneiros, agentes de carga e IORs, com requisitos mais rigorosos de garantia e disponibilidade de registros conforme 19 USC 1508 e 19 CFR Part 163. Para as equipes de logística, isso significa que os documentos que alimentam as declarações aduaneiras — conhecimentos de embarque, faturas comerciais, romaneios de embalagem — devem ser processados com maior precisão e completude, e o fluxo de trabalho de extração deve capturar campos que atendam aos novos requisitos de conformidade (por exemplo, números de referência de exportação estrangeira, maior precisão do código SH).
E quanto ao volume de documentos logísticos? As ferramentas de extração conseguem lidar com milhares de BOLs por mês?
Sim, a maioria das ferramentas nesta comparação consegue escalar para volumes altos — mas o gargalo deixa de ser a velocidade de extração e passa a ser a validação da saída. Com 5.000 BOLs por mês, uma taxa de precisão de 95% no nível de campo significa 250 documentos por mês com pelo menos um campo que precisa de correção manual. A questão do fluxo de trabalho não é "a ferramenta consegue extrair 5.000 BOLs", mas "você consegue revisar 250 exceções sinalizadas sem contratar uma pessoa dedicada ao controle de qualidade?". Rossum e Docsumo oferecem filas integradas de revisão humana. O ImageToTable.ai conta com sinalização baseada em confiança, em que campos com baixa confiança são destacados para revisão. Para operações logísticas com validação intensa, em que o número do contêiner de cada BOL alimenta diretamente uma declaração à CBP, o gerenciamento integrado de exceções é um recurso que vale mais a pena priorizar do que a velocidade de extração.
Consigo extrair número do contêiner, número do lacre e código SH em uma única passagem de tipos de documento mistos?
Sim — se você usar uma ferramenta que ofereça suporte à Extração de Colunas Personalizadas em diferentes tipos de documento. Defina suas colunas de saída (Número do Contêiner, Número do Lacre, Código SH, Código SCAC etc.) uma vez. Envie um lote contendo conhecimentos de embarque marítimo, romaneios de embalagem e faturas de frete. A IA lê cada tipo de documento de forma independente e preenche as colunas onde existem dados correspondentes. Números de contêiner vêm de BOLs e romaneios de embalagem. Códigos SH, de faturas comerciais e declarações aduaneiras. Números de lacre, dos campos de lacre dos BOLs e dos relatórios de troca de contêineres. Campos sem dados correspondentes em um determinado documento simplesmente ficam em branco. Essa abordagem compatível com lote é padrão em ferramentas como ImageToTable.ai e Rossum, mas não está disponível em parsers baseados em modelo ou em zonas, que exigem mapeamento de campos por tipo de documento.
Para uma análise mais aprofundada de como a extração de documentos funciona especificamente para o processamento de conhecimentos de embarque entre transportadoras e tipos de BOL, consulte nosso guia completo de extração de BOL. Para fluxos de trabalho com romaneios de embalagem e notas de entrega, consulte extração de dados de romaneios de embalagem, e para fluxos de trabalho com etiquetas de envio e manifestos, consulte extração de dados de etiquetas de envio e manifestos para Excel. Se você está avaliando se essas ferramentas fazem sentido financeiro para sua operação de frete, compare os números com o custo oculto da entrada manual de dados na logística. Se sua avaliação abrange o pacote completo de embarque — BOLs, faturas de frete, declarações aduaneiras, romaneios de embalagem — e não apenas BOLs, nosso guia de compra de extração de documentos logísticos cobre os critérios de avaliação entre documentos. Para listas que abrangem tipos de documento relacionados, consulte as melhores ferramentas gratuitas de extração de documentos e as melhores ferramentas de extração de documentos para construção.
O fluxo de trabalho do agente de carga funciona com 15 formatos diferentes de transportadoras e uma pilha de comprovantes de entrega manuscritos. Se sua ferramenta atual lida com as faturas da FedEx mas precisa de um modelo separado para cada transportadora marítima, sua automação está incompleta.