Die besten Tools zur Extraktion von
Logistikdokumenten 2026: 9 im Test
Wir haben neun Tools zur Dokumentenextraktion getestet, indem wir dieselben 50 Logistikdokumente — Seekonnossemente von sieben großen Frachtführern (Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE, Evergreen), Luftfrachtbriefe, Lieferscheine mit handschriftlichen Unterschriften und Siegelnummern, Packlisten, Frachtrechnungen und Zollanmeldungsformulare — durch jede Plattform laufen ließen und die feldgenaue Genauigkeit bei logistikspezifischen Datenpunkten wie Containernummern, SCAC-Codes, HS-Codes, Siegelnummern, Hafencodes (UN/LOCODE) und Frachtbedingungen (FOB, CIF, FCA) maßen.
Die wichtigsten Erkenntnisse
- Acht von neun Tools erzielten über 90 % bei einem sauberen Seekonnossement — doch vier fielen unter 50 % bei den handschriftlichen Siegelnummern, die darüber entscheiden, ob eine Fracht-Rückbelastung Bestand hat.
- Die auf Kreditorenbuchhaltung trainierten Extraktionstools scheiterten nicht an schlechtem OCR — ihre Trainingsdaten brachten ihnen bei, Rechnungssummen und Lieferantennamen zu finden, zeigten ihnen aber nie einen SCAC-Code, ein Containernummern-Präfix oder eine Frachtbedingung, sodass die Tools schlicht nicht wissen, dass diese Felder existieren.
- Die drei Tools, die bei handschriftlichen Zustellnachweisen über 80 % hielten, lasen Felder nach semantischer Bedeutung statt nach Vorlagenkoordinaten — das heißt, eine an den Rand gekritzelte Siegelnummer wird genauso behandelt wie eine im dafür vorgesehenen Feld gedruckte.
Offenlegung: ImageToTable.ai ist unser Produkt und erscheint in diesem Test. Wir haben es aufgenommen, weil wir der Meinung sind, dass sein Ansatz – formatunabhängige Extraktion anhand von Spaltennamen – eine konkrete Lücke in der Verarbeitung von Logistikdokumenten schließt. Die anderen acht Tools werden unabhängig bewertet. Jeder externe Link verwendet rel="nofollow noopener" – wir geben keine Link-Equity an die von uns getesteten Tools weiter.
Wenn Sie in der Logistik arbeiten – Spedition, 3PL, Zollabwicklung, Lagerverwaltung –, dann haben die Dokumente, die Sie täglich verarbeiten, fast nichts mit den Rechnungen gemein, die ein typisches Kreditorenteam bearbeitet. Ein Seekonnossement enthält Containernummern, Schiffsnamen, Hafencodes, Frachtbedingungen, SCAC-Codes und Siegelnummern, für die es auf einer Lieferantenrechnung keine Entsprechung gibt. Ein Zustellnachweis kommt mit handschriftlichen Unterschriften und Anmerkungen am Rand. Eine Frachtrechnung schlüsselt Gebühren nach NMFC-Klasse, Nebengebührencodes und Treibstoffzuschlag-Prozentsätzen auf. Und all diese Dokumente kommen in Formaten, die je nach Frachtführer, Reederei, Herkunftsland und Transportart variieren.
Die Extraktionstools, die allgemeine Übersichten dominieren – entwickelt und trainiert auf Lieferantenrechnungen, Belegen und Steuerformularen –, verfehlen diese logistikspezifischen Felder oft völlig oder liefern sie in Formaten zurück, die mehr Nacharbeit verursachen, als sie einsparen. Dieser Leitfaden testet neun Tools speziell mit den Dokumenttypen und Feldtypen, die Logistikbetriebe tatsächlich bearbeiten.
Wie wir getestet haben: 50 Logistikdokumente, 4 Dokumentkategorien, 9 Tools
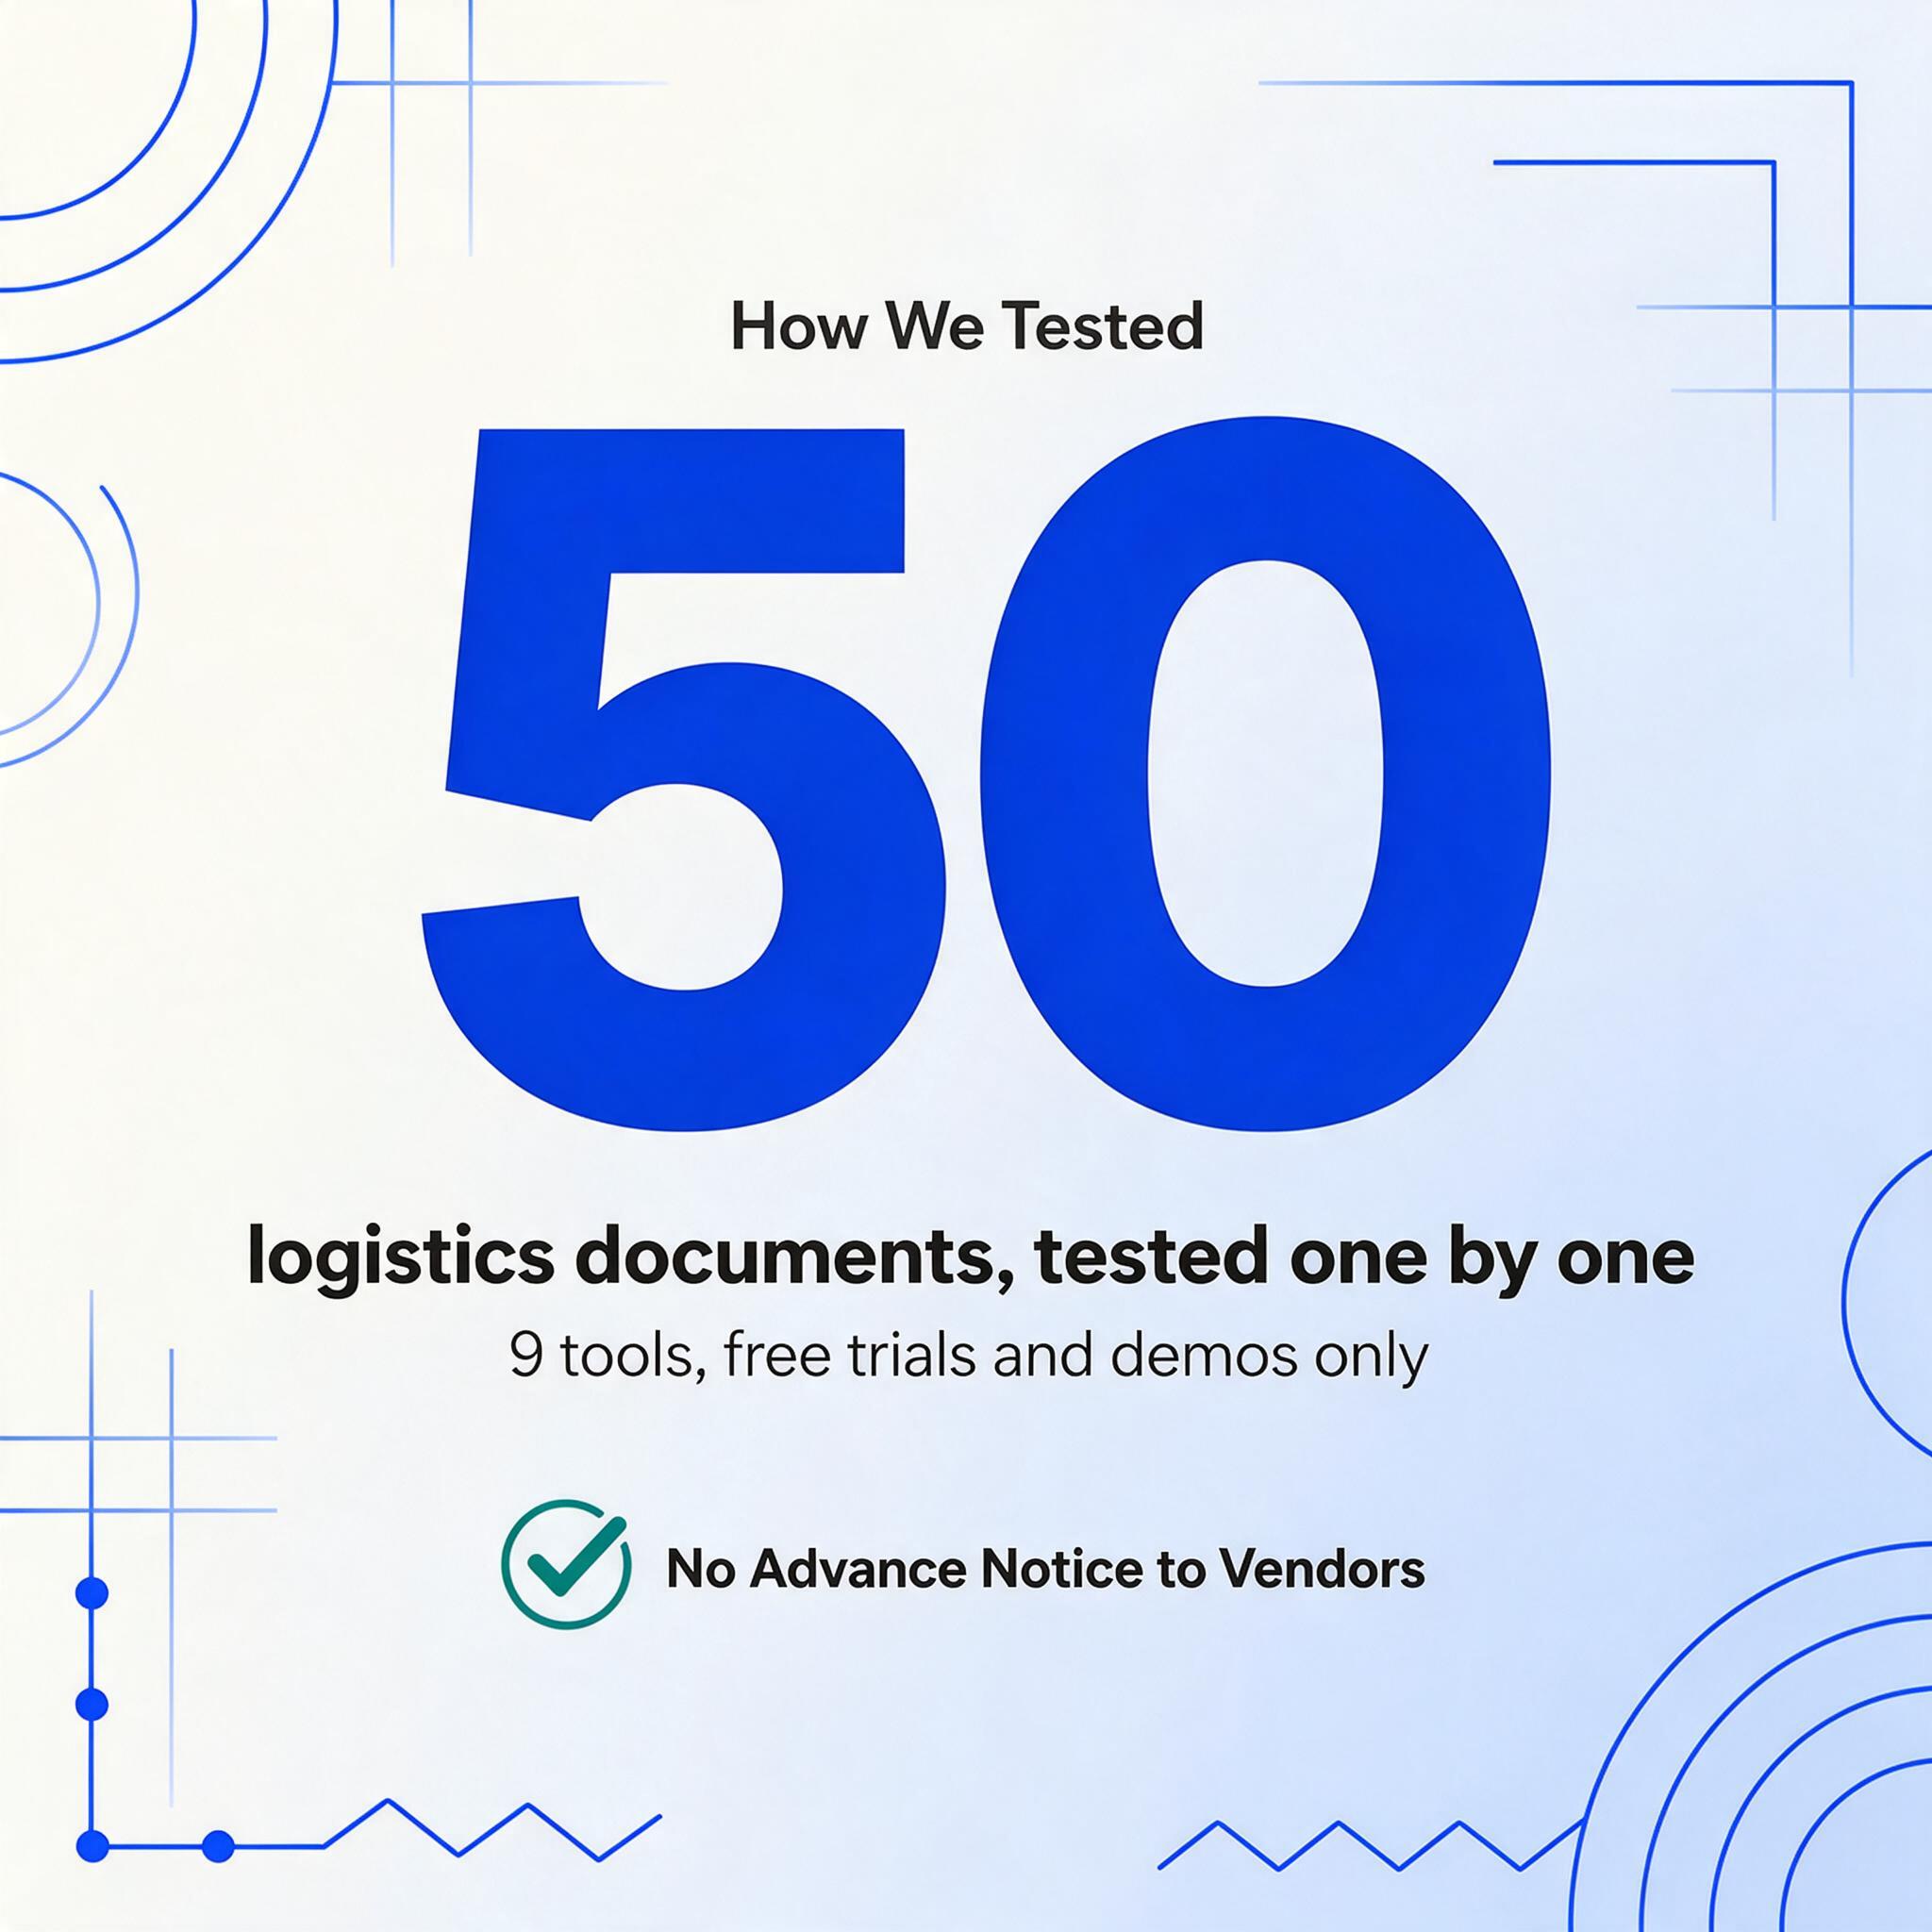
Jedes Tool wurde über seine kostenlose Testversion, Demo oder Self-Service-Stufe getestet. Kein Anbieter wurde vorab informiert. Wir haben jedes Dokument einzeln getestet – nicht über API-Batch-Aufrufe –, um das Out-of-the-Box-Erlebnis zu messen, das ein typischer Logistikkoordinator oder Betriebsleiter einer Spedition vorfindet.
Der Testsatz aus 50 Dokumenten gliederte sich wie folgt:
- 12 Seekonnossemente — von Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE und Evergreen. Enthielten Namenskonnossemente (Original), multimodale Konnossemente für See- und Landtransport sowie sowohl Masterkonnossement (MBL) als auch Hauskonnossement (HBL). Fünf der zwölf enthielten handschriftliche Stempelvermerke — Korrekturen der Siegelnummer, Anpassungen des Containergewichts und Änderungsaufträge des Empfängers — die über den gedruckten Text geschrieben waren.
- 8 Luftfrachtbriefe — von Expressdiensten (FedEx Express, DHL) und Speditions-MAWB/HAWB-Kombinationen. Enthielten einen qualitativ schlechten Scan eines thermogedruckten Luftfrachtbriefs mit unscharfem Text.
- 12 Lieferscheine und Zustellnachweise (PODs) — Lieferbestätigungen von Lkw-Frachtführern mit gedruckten Positionen und handschriftlichen Feldern: Unterschriften, Zustellzeitstempel, Schadensvermerke („1 Karton zerdrückt — zurückgewiesen") und Teilmengenangaben. Dies war die Dokumentenart mit der höchsten Handschriftdichte im Testsatz.
- 10 Packlisten — Lieferanten- und 3PL-Packdokumente mit artikelgenauen Positionen, Kartonanazahlen, Sendungsverfolgungsnummern und Versenderreferenzen. Enthielten drei mit internationalen Versandcodes (HS-Codes, Herkunftslandkennzeichnungen).
- 8 Frachtrechnungen — LTL- und Paketdienst-Rechnungen mit NMFC-Klassen, Nebengebühren, Treibstoffzuschlagspositionen und PRO/BOL-Querverweisen.
Wir haben pro Extraktion drei Dinge gemessen: Feldgenauigkeit bei logistikspezifischen Feldern (Containernummer, SCAC-Code, HS-Code, Siegelnummer, Hafencode UN/LOCODE, Frachtbedingungen), Handschriftentoleranz (verschlechterte sich die Genauigkeit bei handschriftlich annotierten oder handgeschriebenen Inhalten im Vergleich zu maschinengedruckten Feldern) und Formatunabhängigkeit (blieben die BOL-Extraktionsergebnisse über verschiedene Frachtführer-Layouts hinweg stabil, oder sank die Genauigkeit, wenn auf ein Maersk-BOL ein MSC-Format folgte).
Bei sauberen maschinengedruckten Seekonnossementen großer Frachtführer erzielten acht von neun Tools eine Feldgenauigkeit von über 90 % bei Standardfeldern (Versender, Empfänger, Schiff, Häfen). Bei logistikspezifischen Feldern — Formatkonsistenz der Containernummer, SCAC-Code-Extraktion, Identifikation der Frachtbedingungen — blieben die besten Tools über 85 %, während die beiden schlechtesten unter 60 % fielen. Bei handschriftlichen POD-Annotationen war die Streuung noch größer: Drei Tools hielten über 80 % Genauigkeit, während vier unter 50 % fielen.
Kurzvergleich: 9 Tools zur Extraktion von Logistikdokumenten
| Tool | Am besten für | Preise ab | Logistikfelder* | Handschrift | Formatunabhängigkeit |
|---|---|---|---|---|---|
| ImageToTable.ai | Extraktion ohne Vorlage über alle Frachtführerformate hinweg | Kostenlose Stufe (50 Seiten/Monat); kostenpflichtig ab ca. $15/Monat | Vollständig — benutzerdefinierte Spalten | Hoch (85-95%) | Vollständig — semantische Extraktion |
| Rossum | Enterprise-Logistik + Kreditorenbuchhaltung mit Workflow zur manuellen Prüfung | ca. $1.500/Monat | Stark — Fähigkeiten für Logistikdokumente | Mittel (70-85%) | Gut — kognitive KI passt sich an Layouts an |
| Nanonets | API-First-Extraktion mit individuellem Modelltraining | ca. $499/Monat | Mäßig — benutzerdefinierte Felder pro trainiertem Modell | Mittel (65-80% mit Training) | Mäßig — benötigt 10+ Beispiele pro Layout |
| Docsumo | Workflows mit hohem Prüfaufwand und dokumentübergreifender Validierung | Ab $299/Monat | Mäßig — vorgefertigte Logistikmodelle | Mittel (65-80%) | Mäßig — vortrainiert + individuelles Training |
| ABBYY Vantage | Globale Logistik mit OCR für 200+ Sprachen | Individuell (in der Regel Enterprise) | Mäßig — Vantage Skills Marketplace | Hoch (85-90%) | Mäßig — skillbasiert, erfordert Konfiguration |
| Amazon Textract | Individuelle AWS-native Extraktionspipelines | Zahlung pro Seite (ca. $0,0015/Seite) | Grundlegend — generische Schlüssel-Wert-Paare + Tabellen | Niedrig (50-65%) | Mäßig — Layout-API erkennt Tabellen |
| Docparser | Frachtführerrechnungen mit einheitlichem Format | Ab $32,50/Monat | Niedrig — Feldzuordnung pro Vorlage | Niedrig (40-55%) | Niedrig — vorlagenbasiert, bricht bei Formatänderung ab |
| FormX | Vorgefertigte Extraktion für Versanddokumente | Zahlung pro Seite; individuell | Mäßig — vorgefertigte Modelle für Versanddokumente | Mittel (60-75%) | Mäßig — Extraktoren für gängige Vorlagen |
| Parseur | E-Mail-zu-strukturierte-Daten für die Logistik | Ab $39/Monat | Niedrig — Feldzuordnung pro Vorlage | Niedrig (35-50%) | Niedrig — Vorlagen-/zonale OCR |
*Logistik-spezifische Felder umfassen Containernummern, SCAC-Codes, HS-Codes, Siegelnummern, Hafen-UN/LOCODE-Identifikatoren und Frachtbedingungen (FOB, CIF, FCA usw.). „Vollständig" bedeutet, dass das Tool jedes benutzerdefinierte Logistikfeld ohne Vorkonfiguration extrahieren kann.
ImageToTable.ai — Am besten für formatunabhängige Extraktion von Logistikdokumenten
Am besten für: Logistikteams — Spediteure, 3PLs, Zollagenten — die Dokumente von mehreren Frachtführern verarbeiten und einen einzigen Extraktions-Workflow benötigen, der über alle Formate hinweg ohne Einrichtung pro Frachtführer funktioniert.
Nicht ideal für: Große Unternehmen, die integrierte Genehmigungswege, ERP-integrierte Workflow-Orchestrierung oder Human-in-the-Loop-Warteschlangen für Ausnahmemanagement im großen Maßstab benötigen.
ImageToTable.ai verwendet die sogenannte Benutzerdefinierte Spaltenextraktion — Sie geben die Spaltennamen ein, die extrahiert werden sollen (z. B. „Containernummer", „SCAC-Code", „HS-Code", „Verladehafen", „Frachtbedingungen"), und die KI findet diese Werte in jedem Dokument durch semantisches Verständnis statt durch Pixelposition. Dies ist der zentrale Unterschied zu vorlagenbasierten Tools und besonders wichtig für Logistikabläufe, bei denen ein Maersk-BOL, ein MSC-BOL und ein COSCO-BOL denselben Informationsgehalt haben, ihn aber in völlig unterschiedlichen Layouts mit unterschiedlichen Feldbezeichnungen darstellen.
In unserem Testset mit 50 Dokumenten erzielte ImageToTable.ai die höchste feldgenaue Treffsicherheit bei logistik-spezifischen Feldern — Containernummern, SCAC-Codes, Siegelnummern, Hafencodes und Frachtbedingungen — ohne Vortraining oder Vorlagen-Einrichtung pro Frachtführer. Die handgeschriebenen Zustellnachweise waren der entscheidende Unterschied: Handschriftliche Siegelnummern und Lieferanmerkungen, die bei vier Tools in diesem Test zu einer Genauigkeit unter 50 % führten, wurden hier zuverlässig extrahiert, weil das zugrunde liegende Vision-Modell darauf trainiert ist, gedruckten Text, Handschrift, Stempel und Anmerkungszeichen zu unterscheiden, die im selben Dokument ineinander verschachtelt sind.
Ein mittelgroßer Spediteur, mit dem wir gesprochen haben, verarbeitet monatlich rund 500 BOLs über 15 Frachtführer. Sein bisheriger Workflow nutzte einen vorlagenbasierten Extraktor, der 15 frachtführerspezifische Vorlagen pflegen musste. Als Maersk sein BOL-Layout aktualisierte, brach die Vorlage stillschweigend — BOL-Nummern erschienen zwei Wochen lang in der Datumsspalte, bevor es jemand bemerkte. Mit der Spaltennamen-Extraktion definieren sie die Ausgabefelder einmal, und die KI passt sich automatisch an Layoutänderungen an, weil sie nach Bedeutung liest, nicht nach Koordinaten.
Dateien werden sicher verarbeitet und nicht gespeichert. Laden Sie eine Packliste oder ein BOL hoch, um den Extraktionsablauf zu sehen.
Eine ausführliche Erläuterung, wie die BOL-Extraktion über Frachtführerformate und BOL-Typen hinweg funktioniert – Namenskonnossement, Orderkonnossement, multimodales Konnossement, Master- vs. Hauskonnossement – finden Sie in unserem Leitfaden zur Extraktion von Konnossementdaten und im vollständigen Leitfaden zur BOL-Extraktion. Zur Packlistenextraktion siehe Was ist Packlistendatenextraktion. Wenn Sie BOLs von mehr als einer Handvoll Frachtführer in einem Durchlauf verarbeiten, lesen Sie unseren Leitfaden zur Batch-BOL-Extraktion über mehrere Frachtführer hinweg. Um die Extraktion auf Ihren eigenen BOLs auszuführen – See, LTL oder Luft – nutzen Sie das Konnossement-zu-Excel-Tool.
Rossum — Am besten für die Verarbeitung von Unternehmens-Logistikdokumenten mit menschlicher Prüfung
Am besten für: Große Spediteure und 3PLs, die KI-Extraktion in Kombination mit einer menschlichen Prüfungsoberfläche und ERP-Integration benötigen, insbesondere für Logistikdokumente, die in AP-Workflows einfließen.
Nicht ideal für: Kleine und mittlere Logistikteams mit begrenztem Budget – die Preise beginnen bei etwa $1,500 pro Monat, was es für unabhängige Makler oder kleine 3PLs unerschwinglich macht.
Die Aurora-KI-Engine von Rossum verarbeitet Logistikdokumente – Rechnungen, BOLs, Packlisten, Zolldokumente – ohne Konfiguration pro Vorlage. Die nebeneinander angeordnete Oberfläche zur Prüfung von Dokument und Daten gehört zu den ausgefeiltesten Benutzererfahrungen im IDP-Markt, und die Integrationen mit SAP, Coupa und QuickBooks machen sie zur natürlichen Wahl für Logistikunternehmen, bei denen die Dokumentausgabe direkt in ein ERP oder TMS einfließt.
Bei logistikspezifischen Feldern schnitt Rossum bei rechnungsähnlichen Dokumenten mit Summen, Daten und Lieferantenreferenzen gut ab. Die eigene Logistikdokumentation der Plattform hebt Versandstelle, Ladungsgruppe und Lieferart als Zielfelder hervor. In unseren Tests wurden Containernummern und SCAC-Codes aus sauberen BOL-PDFs zuverlässig extrahiert, verloren jedoch an Genauigkeit bei Dokumenten mit handschriftlichen Anmerkungen über dem Feld der Containernummer – die menschliche Prüfungsoberfläche fängt diese ab, aber das bedeutet, dass die Automatisierungsrate bei Logistikanwendungen niedriger ist, als die reine Extraktionsgenauigkeit vermuten lässt.
Der Hafen von Rotterdam und Wolt werden als Logistikkunden genannt. Die cloud-native Architektur der Plattform und die Integrationen mit großen ERPs machen sie für Unternehmens-Logistikbetriebe geeignet, aber die monatliche Preisgestaltung und die volumenbasierte Preisgestaltung pro Dokument skalieren nicht reibungslos für kleinere Logistikteams.
Nanonets — Am besten für API-First-Extraktion von Logistikdokumenten mit individuellem Training
Am besten für: Logistikunternehmen mit eigenen Entwicklungsteams, die individuelle Extraktionsmodelle für bestimmte Frachtführerformate oder Dokumenttypen trainieren und per API integrieren möchten.
Nicht ideal für: Logistikteams ohne dedizierte technische Ressourcen — die Einrichtung erfordert API-Integration, Beispielkennzeichnung und Modelltraining pro Dokumenttyp.
Nanonets unterstützt über 300 vortrainierte Dokumenttypen und bietet individuelles Modelltraining mit nur 10 Beispieldokumenten. Für einen Logistikbetrieb, der dasselbe COSCO-Konnossement-Layout tausendfach pro Monat verarbeitet, könnte ein dediziertes Modell hohe Genauigkeit liefern. Doch die Vielfalt der Logistikdokumente spricht gegen diesen Ansatz: Ein Spediteur, der 15 Frachtführer betreut, sieht 15 Layouts, und ein pro Frachtführer trainiertes Modell ist ein Wartungsvertrag, keine einmalige Einrichtung.
In unserem Testset erzielte Nanonets gute Ergebnisse bei Standardfeldern aus sauberen maschinengedruckten Dokumenten (Name des Versenders, Schiffsname, Häfen), hatte aber Schwierigkeiten mit logistikspezifischen Codes. Die Extraktion der Containernummer war über Frachtführer hinweg inkonsistent — sie erfasste „MAEU1234567" zuverlässig aus einem Maersk-Konnossement, parste aber „MSCU9876543" auf einem MSC-Format als zwei separate Felder. Das Preismodell — ab etwa $499 pro Monat — liegt zwischen Mid-Market-Zugänglichkeit und Enterprise-Kosten, was es für kleine Spediteure potenziell unpassend und für große 3PLs, die Workflow-Orchestrierung benötigen, zu eingeschränkt macht.
Docsumo — Am besten für verifizierungsintensive Logistik-Workflows
Am besten für: Logistikteams, die dokumentübergreifende Validierung benötigen — Abgleich von Konnossementdaten mit entsprechenden Packlisten, Frachtrechnungen und Zustellbestätigungen — mit einer starken Schnittstelle zur menschlichen Prüfung.
Nicht ideal für: Teams, die eine Einrichtung ohne Aufwand für die Extraktion über Dokumenttypen hinweg benötigen, auf die die Plattform nicht vortrainiert ist — individuelle Logistikdokumente erfordern das Training mit 10+ Beispielen.
Docsumo positioniert sich als Dokument-KI-Plattform für Unternehmen mit vortrainierten Modellen für Rechnungen, Kontoauszüge, Steuerdokumente und Logistikdokumente. Der Prüfbildschirm — von Nutzern auf G2 als intuitiv gelobt — unterstützt Workflows zur Querverifizierung, bei denen extrahierte Felder zur menschlichen Prüfung markiert werden, wenn die Konfidenz unter dem Schwellenwert liegt.
In unseren Tests erfasste das vortrainierte Logistikmodell von Docsumo Containernummern und HS-Codes aus sauberen Konnossement-PDFs mit mittlerer Genauigkeit, erforderte jedoch Vorlagentraining für frachtführerspezifische Felder wie SCAC-Codes und Frachtbedingungen. Die Batch-Verarbeitungsfähigkeiten der Plattform — Verarbeitung mehrerer Dokumente in einem Durchgang — sind relevant für Logistikteams, die 50+ Konnossemente pro Batch verarbeiten. Die Preisgestaltung beginnt kostenlos für 100 Seiten pro Monat, dann $299 pro Monat für die Starter-Stufe, skalierend mit dem Volumen. Die kostenlose Einstiegsstufe ist nützlich zur Evaluierung, aber die Seitenlimits machen sie für laufendes Logistikvolumen unpraktisch.
Zum Vergleich: Eine 3PL-Lagerfallstudie auf der Website von Docsumo beschreibt, wie BiagiBros über 3.000 Dokumente pro Monat mit 95 % Straight-Through-Processing und 500 eingesparten Stunden bewältigt — ein realistischer Benchmark für einen zweckgebauten Dokument-Workflow in der Logistik.
ABBYY Vantage — Am besten für mehrsprachige Verarbeitung von Logistikdokumenten
Am besten für: Globale Logistikteams, die Versanddokumente in mehreren Sprachen und Zeichensätzen verarbeiten — chinesische COSCO-Konnossemente, japanische Nippon-Express-Frachtbriefe, arabische Zollanmeldungen —, bei denen die Sprachabdeckung eine kritische Anforderung ist.
Nicht ideal für: Teams, die benutzerdefinierte Logistikfelder ohne Konfiguration pro Dokumenttyp extrahieren müssen — Vantage erfordert das Erstellen oder Kaufen von „Skills“ pro Dokumentkategorie.
ABBYY Vantage ist die Unternehmensweiterentwicklung von ABBYY FlexiCapture, einer der ältesten und zuverlässigsten OCR-Engines auf dem Markt. Der Skills-Marktplatz von Vantage bietet vorgefertigte Extraktionsmodelle für gängige Dokumenttypen, und die zugrunde liegende OCR-Engine unterstützt über 200 Sprachen — darunter Chinesisch, Japanisch, Arabisch, Kyrillisch und Rechts-nach-links-Schriften. Diese Sprachabdeckung ist für Logistikabläufe wirklich nützlich, bei denen ein einziger Tagesstapel ein chinesisches COSCO-Konnossement, einen russischen Eisenbahnfrachtbrief (CMR) und eine englischsprachige Frachtrechnung enthalten kann.
Die Handschrifterkennung von ABBYY — eine traditionelle Stärke aus jahrzehntelanger Formularverarbeitung — schnitt bei den handschriftlichen Lieferanmerkungen in unserem Testset gut ab, nur übertroffen von ImageToTable.ai und gleichauf mit Rossum. Der Kompromiss ist die Konfigurationskomplexität: Vantage-Skills müssen pro Dokumenttyp konfiguriert werden, und benutzerdefinierte Logistikfelder (SCAC-Codes, Siegelnummern, Frachtbedingungen) erfordern Skill-Anpassungen oder manuelle Zoneneinrichtung. Die Preisgestaltung ist unternehmensindividuell und erfordert in der Regel ein Verkaufsgespräch und eine jährliche Verpflichtung, was sie für kleinere Logistikbetriebe von vornherein ausschließt.
Amazon Textract — Am besten für den Aufbau benutzerdefinierter Logistik-Extraktionspipelines
Am besten für: Entwicklungsteams in Logistikunternehmen oder 3PLs, die benutzerdefinierte Extraktionspipelines auf AWS-Infrastruktur aufbauen möchten, mit voller Kontrolle über Vorverarbeitung, Validierung und nachgelagerte Integration.
Nicht ideal für: Logistikbetriebsteams ohne dedizierte Entwickler — Textract hat keine Benutzeroberfläche, keinen Prüf-Workflow und keine vorgefertigten Logistik-Extraktionsmodelle. Sie erhalten rohe Schlüssel-Wert-Paare und Tabellen, und alles darüber hinaus ist Ihr Code.
Amazon Textract ist ein Machine-Learning-Dienst — keine Anwendung. Er nimmt Dokumentbilder entgegen und liefert erkannten Text, Formular-Schlüssel-Wert-Paare und Tabellenstrukturen zurück. Für ein Logistikunternehmen mit einem AWS-nativen Tech-Stack und einem Entwicklungsteam kann Textract die Extraktionsschicht in einer benutzerdefinierten Pipeline sein, die BOL-Daten in ein TMS leitet, Containernummern gegen Buchungsdatensätze validiert und Abweichungen bei Siegelnummern zur manuellen Prüfung markiert.
In unseren Tests war die Tabellenextraktion von Textract für die Positionblöcke auf Packlisten und Frachtrechnungen nützlich. Die Queries-Funktion — mit der Sie bestimmte Felder in natürlicher Sprache abfragen können (z. B. „Wie lautet die Containernummer?“) — lieferte auf BOLs mäßige Ergebnisse, war jedoch inkonsistent, wenn die Containernummer in einer Seitenleiste oder Kopfzeile statt in einem klar beschrifteten Feld erschien. Die Handschrifterkennung war ihr schwächster Bereich: Gescannte Lieferscheine mit handschriftlichen Anmerkungen lieferten Text mit erheblichen Zeichenfehlern.
Die Preisgestaltung — Zahlung pro Seite, ab etwa $0,0015 pro Seite für die erste Stufe — sieht bei geringem Volumen attraktiv aus, kann aber in der Logistikgrößenordnung überraschen. Die Verarbeitung von 5.000 mehrseitigen BOLs pro Monat in den Standard- und Layout-Stufen von Textract würde mehrere hundert Dollar kosten, bevor Sie die nachgelagerten Verarbeitungskosten hinzufügen (Compute, Speicher, Entwicklerzeit für Aufbau und Wartung der Pipeline).
Docparser — Am besten für Frachtrechnungen mit einheitlichem Format
Am besten für: Logistikteams, die große Mengen an Frachtrechnungen in identischen Formaten erhalten — bei denen jede FedEx-Rechnung dasselbe Layout verwendet und Sie Positionen in eine einheitliche Tabelle extrahieren möchten.
Nicht ideal für: BOLs mit variablem Format, multimodale Dokumente oder jedes Logistikdokument, bei dem sich das Layout zwischen Dokumentquellen ändert — vorlagenbasierte Extraktion bricht bei Formatänderungen stillschweigend ab.
Docparser verwendet einen zonenbasierten Vorlagenansatz: Sie wählen die Felder auf einem Beispieldokument visuell aus, und der Parser extrahiert diese Koordinaten bei jedem nachfolgenden Dokument mit demselben Layout. Das funktioniert gut, wenn das Format identisch bleibt — zum Beispiel beim Extrahieren von Gebührenpositionen aus einer FedEx-Frachtrechnung, bei der jede Rechnung der Standardvorlage von FedEx folgt.
Die Einschränkung wird bei Multi-Carrier-Logistikabläufen deutlich. Ein einzelner Batch von 50 BOLs von 12 Frachtführern würde 12 Vorlagen erfordern. Wenn ein Frachtführer sein Layout aktualisiert — Reedereien ändern ihre Marke, fusionieren oder wechseln ERP-Systeme — bricht die Vorlage, und die Extraktion schlägt fehl oder liefert unbrauchbare Daten, ohne einen Fehler auszulösen. In unserem Logistik-Testset erzielte Docparser gute Ergebnisse bei den Frachtrechnungen mit einheitlichem Format (FedEx- und UPS-Standardlayouts), konnte jedoch keine verwertbaren Containernummern oder SCAC-Codes aus BOLs extrahieren — die Feldnamen und -positionen variierten zu stark zwischen den Frachtführern für einen zonenbasierten Ansatz.
Die Preise beginnen bei $32.50 pro Monat, was ihn zum günstigsten Einstiegspunkt in diesem Vergleich für die vorlagenbasierte Extraktion gleichformatiger Dokumente macht.
FormX — Am besten für vorgefertigte Extraktion bei gängigen Logistikvorlagen
Am besten für: Logistikteams, die Dokumente verarbeiten, die zu FormX' Bibliothek vorgefertigter Extraktoren passen — Packlisten, Versandetiketten, Handelsrechnungen — und eine Extraktion ohne eigenes Modelltraining wünschen.
Nicht ideal für: Benutzerdefinierte Logistikdokumente außerhalb der Extraktoren-Bibliothek von FormX oder Dokumente mit viel Handschrift — die vorgefertigten Extraktoren sind für maschinengedruckte strukturierte Dokumente ausgelegt.
FormX bietet Extraktoren für gängige Dokumenttypen, darunter Versanddokumente und Packlisten. Die Plattform kombiniert vortrainierte KI-Modelle mit Vorlagenabgleich und bietet eine Benutzeroberfläche zur Überprüfung extrahierter Daten. In unserem Testset schnitten die Packlisten- und Handelsrechnungs-Extraktoren von FormX bei standardmäßigen maschinengedruckten Dokumenten ordentlich ab — Artikelbeschreibungen, Mengen und Summen wurden mit mittlerer Genauigkeit erfasst.
Die Einschränkung lag bei logistikspezifischen Feldern, die nicht in standardmäßigen Kategorien für „Versanddokumente" erscheinen: SCAC-Codes, HS-Code-Positionsaufschlüsselungen, Siegelnummern und Frachtbedingungen. Diese wurden entweder übersehen oder mit inkonsistenter Formatierung zurückgegeben. Die Handschrift-Toleranz war unspektakulär — typisch für Tools, die primär auf maschinengedruckten Datensätzen trainiert wurden. Die Preisgestaltung ist nutzungsbasiert und erfordert ein individuelles Angebot für die Extraktion von Versanddokumenten, was die Kostenschätzung vor einem Test schwierig macht.
Parseur — Am besten für die E-Mail-basierte Erfassung von Logistikdokumenten geeignet
Am besten für: Logistikkoordinatoren, die Zustellnachweise, Konnossemente und Frachtrechnungen als E-Mail-Anhänge erhalten und diese automatisch in eine Tabelle oder Datenbank einlesen möchten.
Nicht ideal für: Gescannte oder fotografierte Logistikdokumente, handschriftlastige Zustellnachweise oder Batch-Verarbeitung von Frachtführern in verschiedenen Formaten — die OCR-Ebene von Parseur ist einfach gehalten, und der Vorlagen-/Zonenansatz passt sich nicht an Layoutabweichungen an.
Parseur ist auf einen bestimmten Logistik-Workflow spezialisiert: das Erfassen von Dokumenten, die per E-Mail eingehen. Ein Logistikkoordinator, der Zustellnachweise von Fahrern an eine Verarbeitungswarteschlange weiterleitet, oder ein Spediteur, der Frachtrechnungen als E-Mail-Anhänge von mehreren Anbietern erhält, kann Parseur so einrichten, dass eingehende Dokumente erkannt, definierte Felder extrahiert und strukturierte Daten in ein Google Sheet oder einen API-Endpunkt übertragen werden.
Die Einschränkung besteht darin, dass die Dokumentenanalyse von Parseur grundsätzlich vorlagenbasiert ist — Sie definieren Zonen und Regeln pro Dokumentabsender oder Format. Für ein Logistikteam, das täglich dieselbe FedEx-Rechnungsvorlage von derselben Absender-E-Mail-Adresse erhält, funktioniert dies zuverlässig. Für einen Spediteur, der BOL-PDFs von 15 verschiedenen Frachtführern mit jeweils eigenem Format erhält, führt die Anforderung einer Vorlage pro Frachtführer zu demselben Wartungsaufwand wie bei Docparser. Die OCR-Qualität bei gescannten Dokumenten und die Handschrifterkennung sind einfach gehalten, was Parseur für die Workflows mit Lieferscheinen und Zustellnachweisen, die das Volumen an Logistikdokumenten dominieren, wenig geeignet macht. Die Preise beginnen bei $39 pro Monat für 20 analysierte Dokumente und steigen auf $117 und $299 pro Monat für höhere Volumina.
Welches Tool zur Extraktion von Logistikdokumenten ist das richtige für Ihren Betrieb?
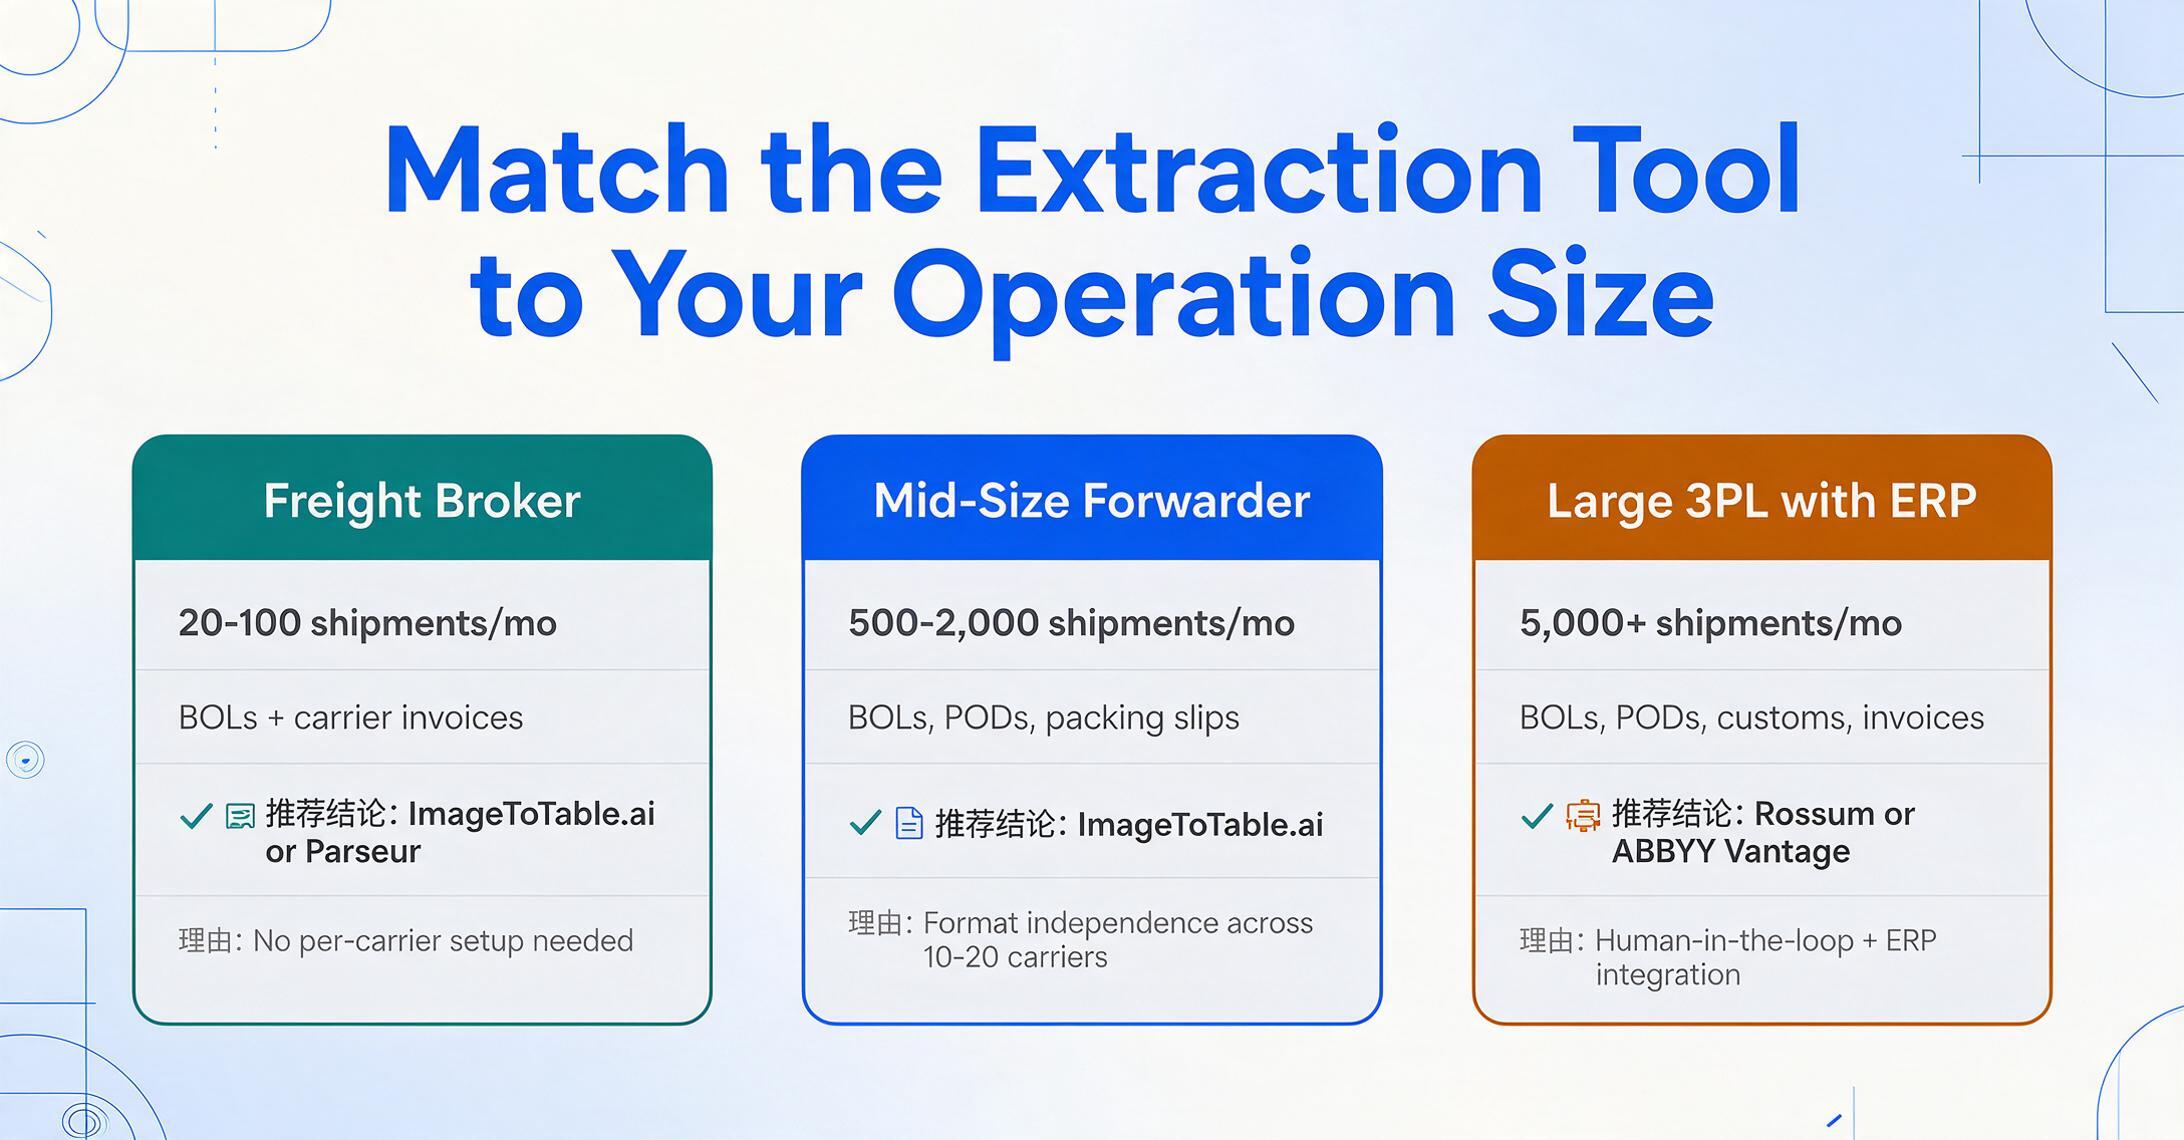
Logistikbetriebe unterscheiden sich enorm in Größe, Dokumentenmix und technischer Ausstattung. Das Tool, das für einen einzelnen Frachtmakler mit 50 Sendungen pro Monat funktioniert, ist ein anderes als das Tool, das ein globales 3PL mit 50.000 monatlichen Sendungen benötigt. So treffen Sie die passende Wahl für Ihren Betrieb:
| Ihr Szenario | Dokumentenmix | Empfohlenes Tool | Begründung |
|---|---|---|---|
| Unabhängiger Frachtmakler, 20-100 Sendungen/Monat | BOLs + Frachtrechnungen, meist per E-Mail | ImageToTable.ai oder Parseur | Geringe Kosten, keine Carrier-Einrichtung nötig; Parseur, wenn alles per E-Mail in konsistentem Format eingeht |
| Mittelgroßer Spediteur, 500-2.000 Sendungen/Monat | BOLs (See + Luft), Zustellnachweise, Packlisten, Frachtrechnungen, Zolldokumente | ImageToTable.ai | Formatunabhängigkeit über 10-20 Carrier; Handschrift-Toleranz bei Zustellnachweisen; kein Aufwand pro Carrier-Vorlage |
| Großer 3PL, 5.000+ Sendungen/Monat mit ERP-Integration | Volle Bandbreite: BOLs, Zustellnachweise, Zollanmeldungen, Frachtrechnungen, Packlisten, Lieferscheine | Rossum oder ABBYY Vantage | Enterprise-Workflow, Human-in-the-Loop, ERP-Integration; höheres Budget deckt die Preise ab |
| Zollagentur, hohes Volumen an Zollanmeldungen | Anmeldungsdokumente, HS-Code-Erklärungen, Ursprungszeugnisse, Handelsrechnungen | ImageToTable.ai oder Rossum | HS-Code-Extraktion + dokumentübergreifende Datenkonsistenz über BOL, Packliste und Rechnung nötig |
| Internes Entwicklerteam für individuelle Logistik-Automatisierung | API-gesteuerte Verarbeitung von BOLs und Rechnungen | Amazon Textract oder Nanonets | API-First-Design, volle Kontrolle über die Pipeline, eigene Modelle pro Carrier-Format trainierbar |
| Verarbeitung von Carrier-Rechnungen im gleichen Format | Nur FedEx/UPS-Standard-Frachtrechnungen | Docparser | Günstigste Option für vorlagenkonsistente Rechnungen — aber nur, wenn sich das Format nie ändert |
Die drei logistik-spezifischen Extraktionsherausforderungen, die die meisten Vergleiche übersehen
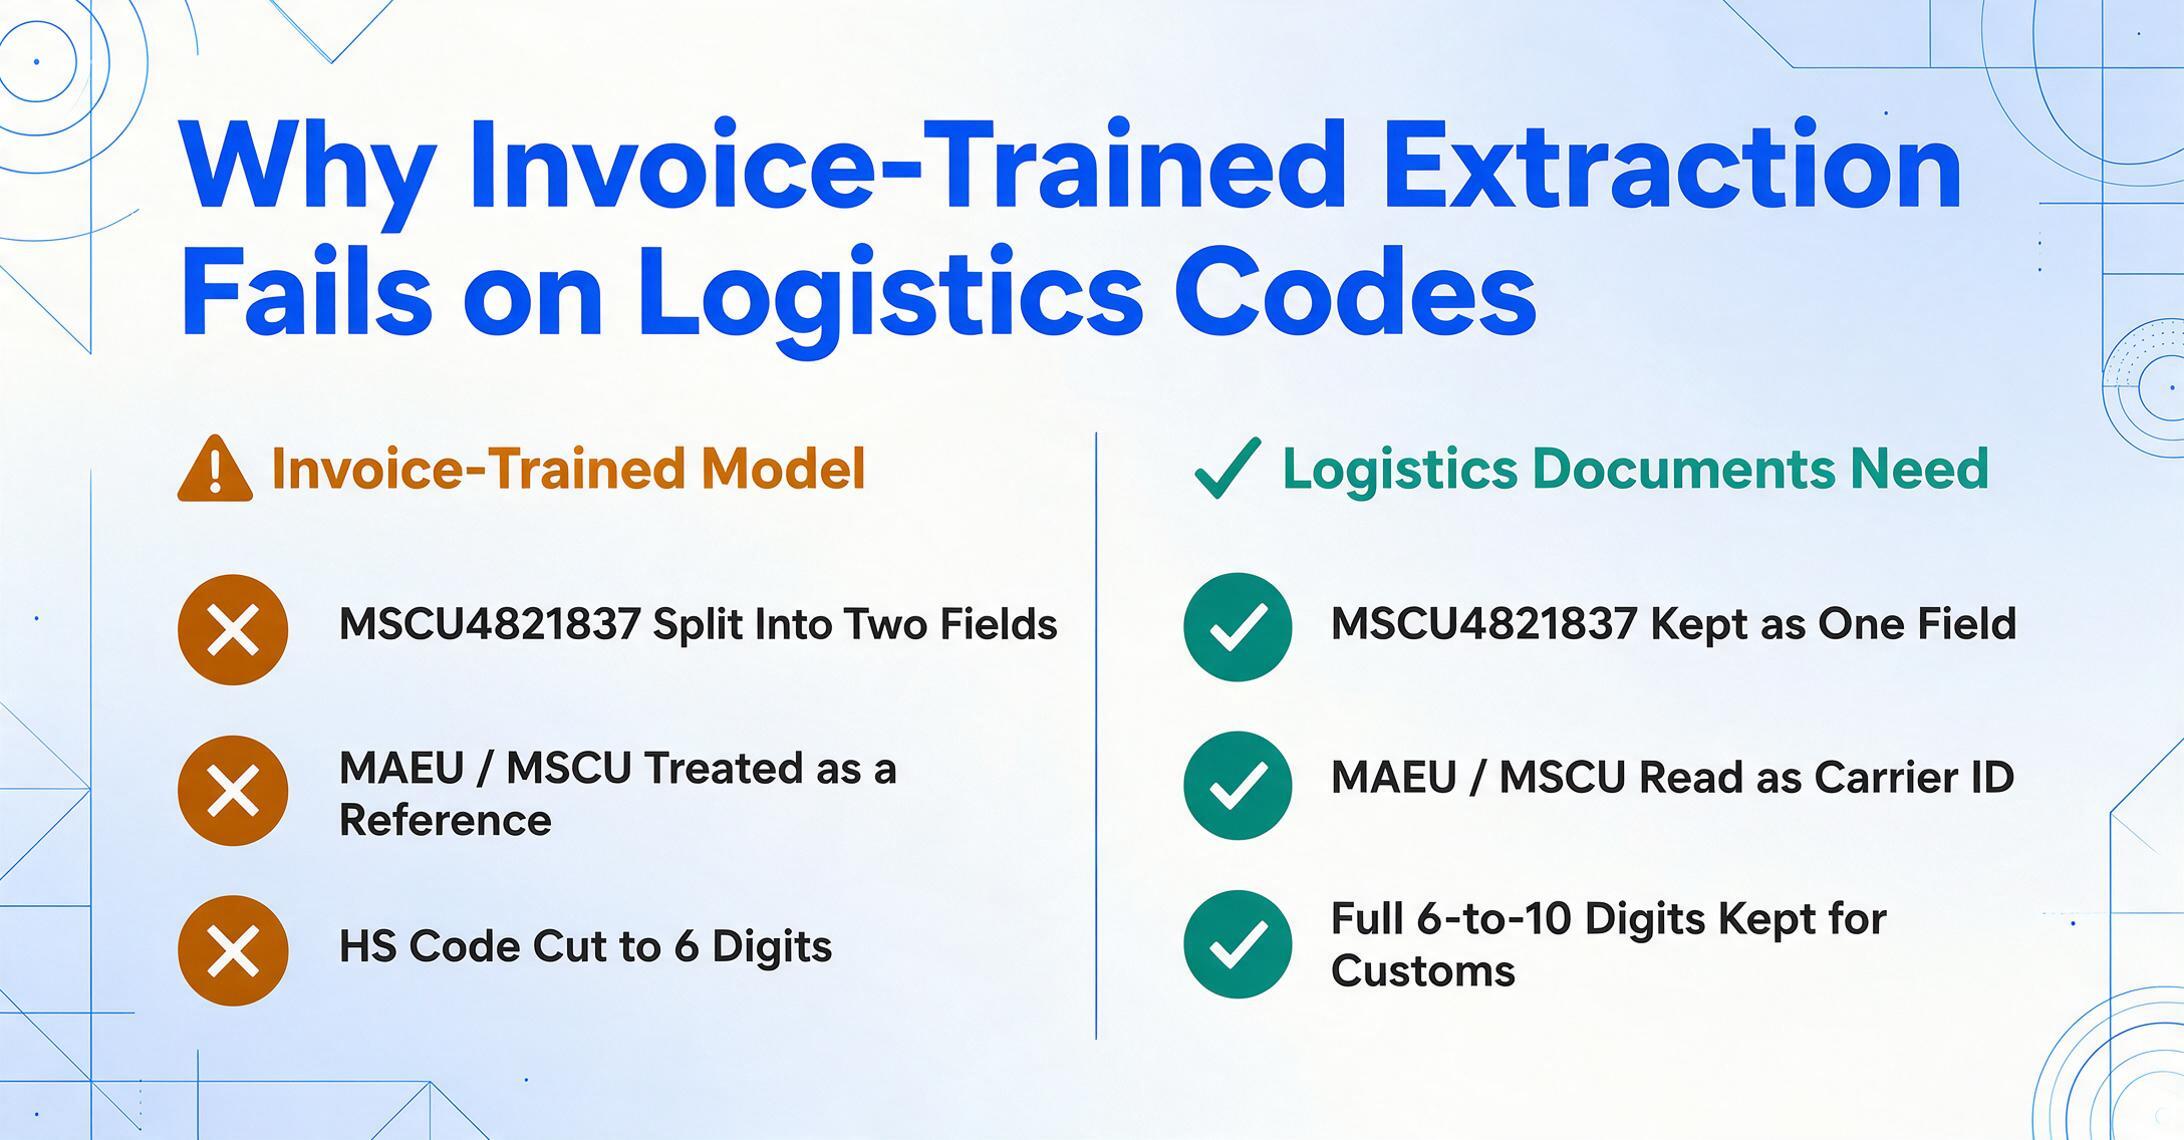
Basierend auf Tests mit allen neun Tools zeigten sich drei Muster, die der typische Vergleich der „besten Dokumentenextraktion" nicht anspricht, die aber im Logistikbetrieb täglich auftreten:
1. Logistik-spezifische Codes sind keine Rechnungsfelder. Eine Containernummer (z. B. MSCU4821837) folgt dem Format 4-Buchstaben-Präfix + 7 Ziffern, das die meisten Extraktionstools entweder in zwei Felder aufteilen oder fälschlich als Referenznummer einordnen. Der SCAC-Code — ein 4-Buchstaben-Carrier-Identifikator wie „MAEU" (Maersk) oder „MSCU" (MSC) — ist ein Pflichtfeld für Zollanmeldungen (CBP-Anforderungen), das rechnungstrainierte Extraktionsmodelle nicht als eigenständigen Datenpunkt erkennen. Die HS-Code-Extraktion erfordert nicht nur das Lesen der Nummer, sondern die Bewahrung der vollständigen 6- bis 10-stelligen Zeichenfolge einschließlich länderspezifischer Suffixe. Ein Tool, das die ersten sechs Ziffern extrahiert und die Ländererweiterung weglässt, hat Daten geliefert, die für die Zollanmeldung unbrauchbar sind. Viele Tools tun genau das.
2. Handschrift auf Logistikdokumenten ist kein optionaler Inhalt — sie sind operative Daten. Ein Lieferfahrer schreibt „refused 2 ctns" quer über einen Zustellnachweis. Ein Lagerangestellter annotiert die Siegelnummer handschriftlich, wenn der Container mit einem anderen Siegel ankommt als im Konnossement vermerkt. Eine Korrektur des Empfängers wird an den Rand eines Konnossements am Ursprungsort geschrieben. Auf r/logistics beschrieb ein Nutzer die Realität treffend: „You can't automate a mess." In der Logistik ist das „Chaos" oft handschriftliche Daten, die Dokumentenextraktionstools nicht zu lesen gelernt haben — und sie stehen genau auf den Dokumenten — Zustellnachweise, Lieferscheine, handschriftlich korrigierte Konnossemente —, bei denen Genauigkeit am wichtigsten ist, weil Streitfälle und Rückbelastungen von diesen Aufzeichnungen abhängen. Tools, die diesen Inhalt nicht verarbeiten, automatisieren nur die sauberere, weniger wertvolle Teilmenge der Logistikdokumente.
3. Formatunabhängigkeit ist in der Logistik keine optionale Funktion — sie ist Grundvoraussetzung. Ein Spediteur, der 500 Konnossemente pro Monat über 15 Seefrachtcarrier plus Luftfrachtbriefe und LKW-Lieferscheine verarbeitet, kann keine separaten Vorlagen für jedes Carrier-Format und jeden Dokumententyp pflegen. Die praktischen Kosten der Vorlagenpflege — die Zeit, um zu bemerken, dass die Extraktion nicht mehr funktioniert, herauszufinden, welcher Carrier sein Layout geändert hat, und die Vorlage neu zu erstellen — werden fast nie in die Anbieterpreise oder Vergleiche einbezogen. Vorlagenbasierte Tools (Docparser, Parseur) erscheinen auf dem Papier günstiger, aber ihre Gesamtkosten umfassen die Arbeitsstunden für die Vorlagenpflege, die ein formatunabhängiges Tool eliminiert.
FAQ: Extraktion von Logistikdokumenten
Was ist der Unterschied zwischen einem Namenskonnossement, einem Orderkonnossement und einem multimodalen Konnossement für die Extraktion?
Ein Namenskonnossement (Original) ist ein nicht übertragbares Dokument, das auf einen namentlich genannten Empfänger ausgestellt wird — es enthält Standardfelder (Versender, Empfänger, Schiff, Häfen, Warenbeschreibung, Containernummer) auf einem typischerweise ein- bis zweiseitigen Layout. Ein Orderkonnossement (übertragbar) wird „an Order" ausgestellt und kann übertragen werden — für die Extraktion funktioniert es ähnlich, kann aber ein zusätzliches Feld „Notify Party" und Leerfelder für das Indossament enthalten. Ein multimodales Konnossement deckt See- und Inlandstransport ab — es fügt Felder für Übernahmeort, Ablieferungsort sowie Vor- und Nachlauf hinzu, die Extraktionstools oft übersehen, weil sie nur Hafen-zu-Hafen-Felder erwarten. Der FIATA-eFBL-Standard (elektronisches FBL) ist ein Bestreben, multimodale Konnossementdaten zu standardisieren, doch die Akzeptanz ist allmählich.
Kann ich Masterkonnossemente und Hauskonnossemente im selben Batch verarbeiten?
Ja, wenn Ihr Extraktionstool Dokumente semantisch statt nach Vorlage liest. Ein Masterkonnossement (MBL) wird von der Seefrachtgesellschaft an den Spediteur ausgestellt. Ein Hauskonnossement (HBL) wird vom Spediteur an den Versender ausgestellt. Sie sehen unterschiedlich aus — andere Kopfzeilen, andere Feldbezeichnungen, andere Layoutstruktur — enthalten aber überlappende Informationen (Schiffsname, Häfen, Containernummer, Warenbeschreibung). Ein semantisches Extraktionstool, das „Vessel" als Konzept erkennt, findet es in beiden, unabhängig vom visuellen Layout. Ein vorlagenbasiertes Tool benötigt zwei separate Vorlagen.
Wie wirkt sich die SOLAS-VGM-Konformität auf die Extraktion von Konnossementdaten aus?
Seit Juli 2016 verlangen die SOLAS-Vorschriften der International Maritime Organization (IMO) eine verifizierte Bruttomasse (VGM) für jeden beladenen Container, bevor er auf ein Schiff verladen werden darf. Die VGM — bestehend aus Container-Taragewicht + Ladungsgewicht — muss auf dem Konnossement angegeben oder separat an Frachtführer und Terminal übermittelt werden. Bei der Extraktion von Konnossementdaten sollten der VGM-Wert und seine Verifizierungsmethode (Methode 1: Wiegen des beladenen Containers; Methode 2: Wiegen der gesamten Ladung und Hinzufügen der Tara) als separate Felder erfasst werden. Die meisten Extraktionstools unterscheiden die VGM nicht vom Standardfeld „Gross Weight" — und die beiden Werte können um Hunderte Kilogramm abweichen, was ein Compliance-Risiko darstellt, wenn der falsche Wert in eine Zoll- oder Terminalanmeldung einfließt.
Können diese Tools Frachtbedingungen (FOB, CIF, FCA) aus Konnossementen extrahieren?
Nur Tools mit semantischem Verständnis – bei denen Sie „Frachtbedingungen“ als Spaltennamen definieren und die KI den Begriff im Dokument findet – erfassen Frachtbedingungen zuverlässig. Nach Incoterms 2020 gelten FOB (Free On Board) und CIF (Cost, Insurance, and Freight) nur für Seefracht, während FCA (Free Carrier), CIP (Carriage and Insurance Paid To) und DAP (Delivered at Place) alle Verkehrsträger abdecken. Auf einem Konnossement können Frachtbedingungen im Beschreibungsblock, als eigenständiger Code oder in eine Frachtratenzeile integriert erscheinen. Vorlagenbasierte Tools, die „FOB“ an einer festen Position suchen, übersehen ihn, wenn der Frachtführer die Bedingungen anders platziert. Die semantische Extraktion findet ihn unabhängig von der Position, weil sie versteht, was eine Frachtbedingung ist, und nach dem Konzept sucht, nicht nach der Koordinate.
Wie wirkt sich die CBP-Executive-Order vom Juni 2026 zur Zollabwicklung auf den Bedarf an Dokumentenextraktion aus?
Die Executive Order des Weißen Hauses zur Stärkung der Zollabwicklung (3. Juni 2026) ordnet eine umfassende Überarbeitung der US-Importdokumentationsanforderungen an. Zugelassene Einführer (IORs) sehen sich neuen Anforderungen gegenüber, darunter die Pflicht, CBP alle Ausfuhrdokumente bereitzustellen, die vor der Ankunft der Waren in den USA bei ausländischen Zollbehörden eingereicht wurden – eine bemerkenswerte Erweiterung des Dokumentenumfangs. Die Order verlangt außerdem eine verstärkte Prüfung von Zollagenten, Spediteuren und IORs, mit strengeren Bürgschafts- und Aufzeichnungsverfügbarkeitsanforderungen gemäß 19 USC 1508 und 19 CFR Part 163. Für Logistikteams bedeutet dies, dass die Dokumente, die in Zollanmeldungen einfließen – Konnossemente, Handelsrechnungen, Packlisten – mit höherer Genauigkeit und Vollständigkeit verarbeitet werden müssen, und der Extraktionsworkflow Felder erfassen muss, die neue Compliance-Anforderungen unterstützen (z. B. ausländische Ausfuhrreferenznummern, erhöhte HS-Code-Präzision).
Wie sieht es mit dem Dokumentenvolumen in der Logistik aus? Können Extraktionstools Tausende BOLs pro Monat verarbeiten?
Ja, die meisten Tools in diesem Vergleich können hohe Volumina bewältigen – doch der Engpass verschiebt sich von der Extraktionsgeschwindigkeit zur Validierung der Ergebnisse. Bei 5.000 BOLs pro Monat bedeutet eine feldgenaue Trefferquote von 95 %, dass bei 250 Dokumenten pro Monat mindestens ein Feld manuell korrigiert werden muss. Die entscheidende Frage lautet nicht „Kann das Tool 5.000 BOLs extrahieren?", sondern „Können Sie 250 markierte Ausnahmen prüfen, ohne eine eigene QC-Kraft einzustellen?" Rossum und Docsumo bieten integrierte Human-in-the-Loop-Warteschlangen. ImageToTable.ai setzt auf konfidenzbasierte Markierung, bei der Felder mit geringer Konfidenz zur Prüfung hervorgehoben werden. Für validierungsintensive Logistikabläufe, bei denen die Containernummer jedes BOL direkt in eine CBP-Anmeldung einfließt, ist integriertes Ausnahmemanagement ein Feature, das Sie höher priorisieren sollten als die Extraktionsgeschwindigkeit.
Kann ich Containernummer, Siegelnummer und HS-Code in einem Durchgang aus gemischten Dokumenttypen extrahieren?
Ja – wenn Sie ein Tool verwenden, das benutzerdefinierte Spaltenextraktion über verschiedene Dokumenttypen hinweg unterstützt. Definieren Sie Ihre Ausgabespalten (Containernummer, Siegelnummer, HS-Code, SCAC-Code usw.) einmal. Laden Sie einen Batch hoch, der Seekonnossemente, Packlisten und Frachtrechnungen enthält. Die KI liest jeden Dokumenttyp unabhängig und befüllt die Spalten, in denen passende Daten vorhanden sind. Containernummern stammen aus BOLs und Packlisten. HS-Codes aus Handelsrechnungen und Zollanmeldungen. Siegelnummern aus den Siegel-Feldern der BOLs und Container-Interchange-Berichten. Felder ohne passende Daten in einem bestimmten Dokument bleiben einfach leer. Dieser batch-kompatible Ansatz ist Standard bei Tools wie ImageToTable.ai und Rossum, aber nicht verfügbar bei vorlagen- oder zonenbasierten Parsern, die eine feldbezogene Zuordnung pro Dokumenttyp erfordern.
Einen tieferen Einblick, wie die Dokumentenextraktion speziell für die Verarbeitung von Konnossementen über Frachtführer und BOL-Typen hinweg funktioniert, finden Sie in unserem vollständigen Leitfaden zur BOL-Extraktion. Für Workflows mit Packlisten und Lieferscheinen siehe Extraktion von Packlistendaten, und für Workflows mit Versandetiketten und Manifesten siehe Extrahieren von Versandetiketten- und Manifestdaten nach Excel. Wenn Sie abwägen, ob diese Tools für Ihren Frachtbetrieb finanziell sinnvoll sind, vergleichen Sie die Zahlen mit den versteckten Kosten manueller Dateneingabe in der Logistik. Wenn Ihre Bewertung das gesamte Versandpaket umfasst – BOLs, Frachtrechnungen, Zollanmeldungen, Packlisten – und nicht nur BOLs, deckt unser Kaufratgeber zur Logistik-Dokumentenextraktion die dokumentübergreifenden Bewertungskriterien ab. Für Übersichten zu verwandten Dokumenttypen siehe die besten kostenlosen Dokumentenextraktionstools und die beste Dokumentenextraktion für das Bauwesen.
Der Workflow eines Spediteurs läuft über 15 verschiedene Frachtführer-Formate und einen Stapel handschriftlicher Zustellnachweise. Wenn Ihr aktuelles Tool die FedEx-Rechnungen verarbeitet, aber für jeden Seefrachtführer eine separate Vorlage benötigt, ist Ihre Automatisierung unvollständig.