Las mejores herramientas de extracción de
documentos logísticos en 2026: 9 probadas
Probamos nueve herramientas de extracción de documentos ejecutando los mismos 50 documentos logísticos — conocimientos de embarque marítimos de siete grandes transportistas (Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE, Evergreen), guías aéreas, notas de entrega de camión con firmas manuscritas y números de precinto, albaranes de embalaje, facturas de flete y formularios de declaración de aduanas — a través de cada plataforma, midiendo la precisión a nivel de campo en puntos de datos específicos de logística como números de contenedor, códigos SCAC, códigos SA, números de precinto, códigos portuarios (UN/LOCODE) y términos de flete (FOB, CIF, FCA).
Conclusiones clave
- Ocho de nueve herramientas superaron el 90% en un conocimiento de embarque marítimo limpio — luego cuatro cayeron por debajo del 50% en los números de precinto manuscritos que determinan si un contracargo de flete se mantiene.
- Las herramientas de extracción entrenadas con AP no fallaban por un mal OCR — sus conjuntos de entrenamiento les enseñaron a encontrar totales de facturas y nombres de proveedores, pero nunca les mostraron un código SCAC, un prefijo de número de contenedor o un término de flete, por lo que las herramientas literalmente no saben que estos campos existen.
- Las tres herramientas que se mantuvieron por encima del 80% en comprobantes de entrega manuscritos leían los campos por significado semántico en lugar de por coordenadas de plantilla — lo que significa que un número de precinto garabateado en el margen recibe el mismo tratamiento que uno impreso en su casilla designada.
Divulgación: ImageToTable.ai es nuestro producto y aparece en esta reseña. Lo hemos incluido porque creemos que su enfoque — extracción sin plantilla, basada en nombres de columnas — aborda una brecha específica en el procesamiento de documentos logísticos. Las otras ocho herramientas se evalúan de forma independiente. Todos los enlaces externos usan rel="nofollow noopener" — no transferimos autoridad de enlace a las herramientas que reseñamos.
Si usted trabaja en logística — transporte de carga, logística de terceros, agencias de aduanas, gestión de almacenes — los documentos que procesa a diario casi no comparten nada con las facturas que maneja un equipo típico de cuentas por pagar. Un conocimiento de embarque marítimo incluye números de contenedor, nombres de buques, códigos portuarios, términos de flete, códigos SCAC y números de precinto que no tienen equivalente en una factura de proveedor. Un comprobante de entrega llega con firmas manuscritas y anotaciones garabateadas en los márgenes. Una factura de flete desglosa los cargos por clase NMFC, códigos de cargos accesorios y porcentajes de recargo por combustible. Y todos estos documentos llegan en formatos que varían según el transportista, la línea naviera, el país de origen y el modo de transporte.
Las herramientas de extracción que dominan los resúmenes de propósito general — creadas y entrenadas con facturas de proveedores, recibos y formularios de impuestos — a menudo omiten por completo estos campos específicos de logística, o los devuelven en formatos que generan más trabajo de limpieza del que ahorran. Esta guía evalúa nueve herramientas específicamente sobre los tipos de documentos y campos que las operaciones logísticas realmente manejan.
Cómo Probamos: 50 Documentos Logísticos, 4 Categorías de Documentos, 9 Herramientas
Cada herramienta se probó usando su prueba gratuita, demostración o nivel de autoservicio. Ningún proveedor recibió aviso previo. Probamos cada documento individualmente — no mediante llamadas API por lotes — para medir la experiencia inicial que encontraría un coordinador logístico típico o un gerente de operaciones de una empresa de transporte de carga.
El conjunto de prueba de 50 documentos se desglosó de la siguiente manera:
- 12 conocimientos de embarque marítimo — que cubren Maersk, MSC, CMA CGM, COSCO, Hapag-Lloyd, ONE y Evergreen. Se incluyeron conocimientos de embarque nominativos (originales), conocimientos de embarque multimodales que cubren transporte marítimo e interior, y formatos tanto de conocimiento de embarque máster (MBL) como hijo (HBL). Cinco de los doce incluían anotaciones con sello manual: correcciones de número de precinto, ajustes de peso del contenedor y órdenes de cambio de consignatario, escritas sobre el texto impreso.
- 8 guías aéreas — que cubren expreso (FedEx Express, DHL) y combinaciones MAWB/HAWB de transitarios. Se incluyó un escaneo de baja calidad de una guía aérea impresa térmicamente con texto borroso.
- 12 notas de entrega y comprobantes de entrega (POD) — confirmaciones de entrega de transportistas de camión con partidas impresas y campos manuscritos: firmas, marcas de tiempo de entrega, anotaciones de daños («1 cartón aplastado — rechazado») y anotaciones de cantidades parciales. Este fue el tipo de documento con mayor densidad de escritura manual en el conjunto de prueba.
- 10 albaranes de embalaje — documentos de embalaje de proveedores y 3PL con partidas a nivel de artículo, recuentos de cartones, números de seguimiento y referencias del remitente. Se incluyeron tres con códigos de envío internacionales (códigos SA, marcas de país de origen).
- 8 facturas de flete — facturas de transportistas LTL y de paquetería con clases NMFC, cargos accesorios, partidas de recargo por combustible y referencias cruzadas PRO/BOL.
Medimos tres aspectos por extracción: precisión a nivel de campo en campos específicos de logística (número de contenedor, código SCAC, código SA, número de precinto, código portuario UN/LOCODE, términos de flete), tolerancia a escritura manual (¿disminuyó la precisión en contenido anotado o manuscrito frente a campos impresos por máquina?) e independencia del formato (¿se mantuvieron estables los resultados de extracción de conocimientos de embarque entre variaciones de diseño de transportistas, o disminuyó la precisión cuando un conocimiento de embarque de Maersk era seguido por un formato de MSC?).
En conocimientos de embarque marítimo limpios impresos por máquina de transportistas principales, ocho de nueve herramientas obtuvieron una precisión a nivel de campo del 90% o más en campos estándar (remitente, consignatario, buque, puertos). En campos específicos de logística — consistencia del formato del número de contenedor, extracción del código SCAC, identificación de términos de flete — las mejores herramientas se mantuvieron por encima del 85%, mientras que las dos últimas cayeron por debajo del 60%. En anotaciones manuscritas de POD, la brecha fue aún mayor: tres herramientas mantuvieron una precisión superior al 80%, mientras que cuatro cayeron por debajo del 50%.
Comparación rápida: 9 herramientas de extracción de documentos logísticos
| Herramienta | Ideal para | Precio desde | Campos logísticos* | Escritura a mano | Independencia del formato |
|---|---|---|---|---|---|
| ImageToTable.ai | Extracción sin plantilla en todos los formatos de transportistas | Plan gratuito (50 páginas/mes); de pago desde ~$15/mes | Completo — columnas personalizadas | Alta (85-95%) | Completa — extracción semántica |
| Rossum | Logística empresarial + cuentas por pagar con flujo de revisión humana | ~$1,500/mes | Fuerte — habilidades en documentos logísticos | Media (70-85%) | Buena — IA cognitiva que se adapta a los diseños |
| Nanonets | Extracción API-first con entrenamiento de modelos personalizados | ~$499/mes | Moderada — campos personalizados por modelo entrenado | Media (65-80% con entrenamiento) | Moderada — requiere 10+ muestras por diseño |
| Docsumo | Flujos de trabajo con alta verificación y validación entre documentos | Desde $299/mes | Moderada — modelos logísticos predefinidos | Media (65-80%) | Moderada — preentrenada + entrenamiento personalizado |
| ABBYY Vantage | Logística global con OCR en más de 200 idiomas | Personalizado (típicamente empresarial) | Moderada — mercado de habilidades Vantage | Alta (85-90%) | Moderada — basada en habilidades, requiere configuración |
| Amazon Textract | Pipelines de extracción personalizados nativos de AWS | Pago por página (~$0.0015/página) | Básica — clave-valor genérico + tablas | Baja (50-65%) | Moderada — la API de diseño detecta tablas |
| Docparser | Facturas de transportistas con formato consistente | Desde $32.50/mes | Baja — mapeo de campos por plantilla | Baja (40-55%) | Baja — basada en plantillas, falla ante cambios de formato |
| FormX | Extracción predefinida para documentos de envío | Pago por página; personalizado | Moderada — modelos predefinidos de documentos de envío | Media (60-75%) | Moderada — extractores para plantillas comunes |
| Parseur | De correo electrónico a datos estructurados para logística | Desde $39/mes | Baja — mapeo de campos por plantilla | Baja (35-50%) | Baja — OCR por plantilla/zonal |
*Los campos específicos de logística incluyen números de contenedor, códigos SCAC, códigos SA, números de precinto, identificadores portuarios UN/LOCODE y términos de flete (FOB, CIF, FCA, etc.). «Completo» significa que la herramienta puede extraer cualquier campo logístico personalizado sin configuración previa.
ImageToTable.ai — El mejor para extracción de documentos logísticos independiente del formato
Ideal para: Equipos de logística — transitarios, 3PL, agentes de aduanas — que procesan documentos de múltiples transportistas y necesitan un flujo de extracción que funcione con todos los formatos sin configuración por transportista.
No es ideal para: Grandes empresas que necesitan enrutamiento de aprobación integrado, orquestación de flujos de trabajo integrada con ERP, o colas con intervención humana para la gestión de excepciones a gran escala.
ImageToTable.ai utiliza lo que denomina Extracción de Columnas Personalizadas — usted escribe los nombres de las columnas que desea extraer (p. ej., «Número de contenedor», «Código SCAC», «Código SA», «Puerto de carga», «Términos de flete»), y la IA localiza esos valores en cualquier documento mediante comprensión semántica en lugar de posición de píxeles. Esta es la distinción fundamental frente a las herramientas basadas en plantillas y es lo que más importa en operaciones logísticas donde un conocimiento de embarque de Maersk, uno de MSC y uno de COSCO comparten el mismo contenido informativo pero lo muestran en diseños completamente diferentes con distintas etiquetas de campo.
En nuestro conjunto de prueba de 50 documentos, ImageToTable.ai logró la mayor precisión a nivel de campo en los campos específicos de logística — números de contenedor, códigos SCAC, números de precinto, códigos portuarios y términos de flete — sin entrenamiento previo ni configuración de plantillas por transportista. Los comprobantes de entrega manuscritos marcaron la diferencia: los números de precinto manuscritos y las anotaciones de entrega que hicieron que cuatro herramientas de esta prueba cayeran por debajo del 50% de precisión se extrajeron de forma fiable aquí porque el modelo de visión subyacente está entrenado para diferenciar texto impreso, escritura a mano, sellos y marcas de anotación intercalados en el mismo documento.
Un transitario de tamaño mediano con el que hablamos procesa aproximadamente 500 conocimientos de embarque al mes de 15 transportistas. Su flujo de trabajo anterior utilizaba un extractor basado en plantillas que requería mantener 15 plantillas específicas por transportista. Cuando Maersk actualizó el diseño de su conocimiento de embarque, la plantilla falló silenciosamente: los números de BOL aparecieron en la columna de fecha durante dos semanas antes de que alguien lo notara. Con la extracción por nombre de columna, definen los campos de salida una sola vez, y la IA se adapta automáticamente a los cambios de diseño porque lee por significado, no por coordenadas.
Los archivos se procesan de forma segura y no se almacenan. Pruebe a subir un albarán de embalaje o un conocimiento de embarque para ver el flujo de extracción.
Para un recorrido detallado de cómo funciona la extracción de BOL en distintos formatos de transportista y tipos de BOL — conocimiento de embarque nominativo, conocimiento de embarque a la orden, conocimiento de embarque multimodal, máster vs. hijo — consulte nuestra guía sobre extracción de datos de conocimiento de embarque y la guía completa de extracción de BOL. Para la extracción de albaranes de embalaje, consulte qué es la extracción de datos de albaranes de embalaje. Si procesa BOL de más de un puñado de transportistas en una sola ejecución, consulte nuestra guía sobre extracción de BOL por lotes en múltiples transportistas. Para ejecutar la extracción en sus propios BOL — marítimos, LTL o aéreos — use la herramienta de conocimiento de embarque a Excel.
Rossum — Mejor para el Procesamiento de Documentos Logísticos Empresariales con Revisión Humana
Mejor para: Grandes agentes de carga y 3PL que necesitan extracción con IA combinada con una interfaz de revisión humana e integración con ERP, especialmente para documentos logísticos que alimentan flujos de trabajo de AP.
No ideal para: Equipos logísticos pequeños o medianos con presupuestos limitados — los precios comienzan alrededor de $1,500 por mes, lo que lo deja fuera del alcance de corredores independientes o 3PL pequeños.
El motor de IA Aurora de Rossum procesa documentos logísticos — facturas, BOL, listas de empaque, documentos de aduanas — sin configuración por plantilla. Su interfaz de revisión de documentos y datos lado a lado es una de las experiencias de usuario más pulidas en el mercado de IDP, y sus integraciones con SAP, Coupa y QuickBooks lo convierten en un ajuste natural para empresas logísticas donde la salida de documentos alimenta directamente un ERP o TMS.
En campos específicos de logística, Rossum se desempeñó bien en documentos tipo factura que contienen totales, fechas y referencias de proveedor. La documentación logística propia de la plataforma destaca punto de envío, grupo de carga y tipo de entrega como campos objetivo. En nuestras pruebas, los números de contenedor y códigos SCAC se extrajeron de manera confiable de PDF de BOL limpios, pero la precisión disminuyó en documentos con anotaciones manuscritas sobre el campo de número de contenedor — la interfaz de revisión humana los detecta, pero esto significa que la tasa de automatización es más baja de lo que sugiere la precisión de extracción bruta para aplicaciones logísticas.
El Puerto de Róterdam y Wolt se citan como clientes de logística. La arquitectura nativa en la nube de la plataforma y las integraciones con los principales ERP la hacen viable para operaciones logísticas empresariales, pero los precios mensuales y por volumen de documentos no se escalan hacia abajo de manera elegante para equipos logísticos más pequeños.
Nanonets — Mejor para la extracción de documentos logísticos mediante API con entrenamiento personalizado
Ideal para: Empresas de logística con equipos de desarrollo internos que deseen entrenar modelos de extracción personalizados para formatos de transportistas o tipos de documentos específicos e integrarlos mediante API.
No es ideal para: Equipos de operaciones logísticas sin recursos técnicos dedicados — la configuración requiere integración de API, etiquetado de muestras y entrenamiento de modelos por tipo de documento.
Nanonets admite más de 300 tipos de documentos preentrenados y ofrece entrenamiento de modelos personalizados con tan solo 10 documentos de muestra. Para una operación logística que procesa el mismo formato de conocimiento de embarque de COSCO miles de veces al mes, entrenar un modelo dedicado podría producir una alta precisión. Pero la diversidad de documentos logísticos juega en contra de este enfoque: un transitario que maneja 15 transportistas ve 15 formatos, y un modelo entrenado por transportista es un contrato de mantenimiento, no una configuración única.
En nuestro conjunto de pruebas, Nanonets obtuvo buenos resultados en campos estándar de documentos impresos por máquina y limpios (nombre del remitente, nombre del buque, puertos), pero tuvo dificultades con códigos específicos de logística. La extracción del número de contenedor fue inconsistente entre transportistas: capturó "MAEU1234567" de manera confiable de un conocimiento de embarque de Maersk, pero analizó "MSCU9876543" como dos campos separados en un formato de MSC. El modelo de precios — que comienza en aproximadamente $499 al mes — se sitúa entre la accesibilidad del mercado medio y el costo empresarial, lo que lo convierte en un ajuste potencialmente incómodo para pequeños transitarios y demasiado limitado para grandes 3PL que necesitan orquestación de flujos de trabajo.
Docsumo — Mejor para flujos de trabajo logísticos con gran énfasis en verificación
Ideal para: Equipos de logística que necesitan validación entre documentos — comparar datos de conocimientos de embarque con los albaranes de embalaje, facturas de flete y confirmaciones de entrega correspondientes — con una sólida interfaz de revisión humana.
No es ideal para: Equipos que necesitan extracción sin configuración en tipos de documentos que la plataforma no ha preentrenado — los documentos logísticos personalizados requieren entrenar con más de 10 muestras.
Docsumo se posiciona como una plataforma de IA documental para empresas, con modelos preentrenados para facturas, extractos bancarios, documentos fiscales y documentos logísticos. Su pantalla de revisión — elogiada por los usuarios en G2 por ser intuitiva — admite flujos de trabajo de verificación cruzada donde los campos extraídos se marcan para revisión humana cuando la confianza está por debajo del umbral.
En nuestras pruebas, el modelo logístico preentrenado de Docsumo capturó números de contenedor y códigos SA de PDFs de conocimientos de embarque limpios con precisión moderada, pero requirió entrenamiento de plantillas para campos específicos del transportista como códigos SCAC y términos de flete. Las capacidades de procesamiento por lotes de la plataforma — que manejan múltiples documentos en una sola pasada — son relevantes para equipos de logística que procesan más de 50 conocimientos de embarque por lote. Los precios comienzan gratis para 100 páginas al mes, luego pasan a $299 al mes para el nivel inicial, escalando con el volumen. El nivel gratuito de entrada es útil para la evaluación, pero los límites de páginas lo hacen poco práctico para el volumen logístico continuo.
Para comparar, un caso de estudio de almacenamiento 3PL en el sitio de Docsumo describe a BiagiBros manejando más de 3,000 documentos al mes con un 95% de procesamiento directo y 500 horas ahorradas — un punto de referencia realista para un flujo de trabajo documental diseñado específicamente para logística.
ABBYY Vantage: la mejor opción para el procesamiento multilingüe de documentos logísticos
Ideal para: Equipos logísticos globales que procesan documentos de envío en varios idiomas y alfabetos — conocimientos de embarque marítimo de COSCO en chino, guías aéreas de Nippon Express en japonés, declaraciones de aduanas en árabe — donde la cobertura de idiomas es un requisito crítico.
No es ideal para: Equipos que necesitan extraer campos logísticos personalizados sin configuración por tipo de documento — Vantage requiere crear o comprar "skills" (habilidades) por categoría de documento.
ABBYY Vantage es la evolución empresarial de ABBYY FlexiCapture, uno de los motores OCR más antiguos y confiables del mercado. El mercado de skills de Vantage ofrece modelos de extracción preconfigurados para tipos de documentos comunes, y el motor OCR subyacente admite más de 200 idiomas — incluidos chino, japonés, árabe, cirílico y escrituras de derecha a izquierda. Esta cobertura de idiomas es genuinamente útil para operaciones logísticas donde un lote de un solo día podría incluir un conocimiento de embarque marítimo de COSCO en chino, una carta de porte ferroviaria rusa (CMR) y una factura de flete en inglés.
El reconocimiento de escritura a mano de ABBYY — una fortaleza heredada de décadas de procesamiento de formularios — funcionó bien en las anotaciones manuscritas de entrega de nuestro conjunto de pruebas, solo superado por ImageToTable.ai y a la par de Rossum. La contrapartida es la complejidad de configuración: los skills de Vantage deben configurarse por tipo de documento, y los campos logísticos personalizados (códigos SCAC, números de precinto, términos de flete) requieren personalización del skill o configuración manual de zonas. Los precios son personalizados para empresas, generalmente requieren una conversación comercial y un compromiso anual, lo que lo elimina de la consideración para operaciones logísticas más pequeñas.
Amazon Textract: la mejor opción para crear canalizaciones personalizadas de extracción logística
Ideal para: Equipos de desarrollo en empresas de logística o 3PL que quieran crear canalizaciones de extracción personalizadas en la infraestructura de AWS, con control total sobre el preprocesamiento, la validación y la integración posterior.
No es ideal para: Equipos de operaciones logísticas sin desarrolladores dedicados — Textract no tiene interfaz de usuario, ni flujo de revisión, ni modelos de extracción logística preconfigurados. Usted obtiene pares clave-valor y tablas en bruto, y todo lo demás es su código.
Amazon Textract es un servicio de aprendizaje automático — no una aplicación. Acepta imágenes de documentos y devuelve texto detectado, pares clave-valor de formularios y estructuras de tablas. Para una empresa de logística con una pila tecnológica nativa de AWS y un equipo de desarrollo, Textract puede ser la capa de extracción en una canalización personalizada que enruta los datos de los conocimientos de embarque a un TMS, valida los números de contenedor contra los registros de reserva y señala las discrepancias en los números de precinto para revisión humana.
En nuestras pruebas, la extracción de tablas de Textract fue útil para los bloques de partidas en albaranes de embalaje y facturas de flete. Su función Queries — que permite solicitar campos específicos en lenguaje natural (por ejemplo, "¿Cuál es el número de contenedor?") — devolvió resultados moderados en conocimientos de embarque, pero fue inconsistente cuando el número de contenedor aparecía en una barra lateral o encabezado en lugar de un campo claramente etiquetado. El reconocimiento de escritura a mano fue su punto más débil: las notas de entrega escaneadas con anotaciones manuscritas devolvieron texto con errores significativos de caracteres.
Precios — pago por página, desde aproximadamente $0.0015 por página en el primer nivel — parece atractivo en volúmenes bajos, pero puede sorprender a escala logística. Procesar 5,000 conocimientos de embarque multipágina por mes en los niveles estándar y de diseño de Textract costaría varios cientos de dólares antes de agregar el costo de procesamiento posterior (computación, almacenamiento, tiempo de desarrollo para crear y mantener la canalización).
Docparser — Mejor para Facturas de Transportistas con Formato Consistente
Ideal para: Equipos de logística que reciben grandes volúmenes de facturas de transportistas en formatos idénticos — donde cada factura de FedEx usa el mismo diseño y desea extraer cargos por línea de detalle en una hoja de cálculo consistente.
No recomendado para: Conocimientos de embarque de formato variable, documentos multimodales o cualquier documento logístico donde el diseño cambie entre fuentes de documentos — la extracción basada en plantillas falla silenciosamente ante cambios de formato.
Docparser utiliza un enfoque de plantillas basado en zonas: usted selecciona visualmente los campos en un documento de muestra, y el analizador extrae esas coordenadas en cada documento posterior con el mismo diseño. Esto funciona bien cuando el formato permanece idéntico — por ejemplo, al extraer cargos por línea de detalle de una factura de flete de FedEx donde cada factura sigue la plantilla estándar de FedEx.
La limitación se hace evidente en operaciones logísticas con múltiples transportistas. Un solo lote de 50 conocimientos de embarque de 12 transportistas requeriría 12 plantillas. Cuando un transportista actualiza su diseño — las líneas navieras cambian de marca, se fusionan o cambian de sistema ERP — la plantilla se rompe, y la extracción falla o devuelve datos basura sin lanzar un error. En nuestro conjunto de pruebas logísticas, Docparser obtuvo buenos resultados en las facturas de flete de formato consistente (diseños estándar de FedEx y UPS), pero no logró extraer ningún número de contenedor ni código SCAC útil de los conocimientos de embarque — los nombres de campos y posiciones variaban demasiado entre transportistas para un enfoque basado en zonas.
Los precios comienzan en $32.50 por mes, lo que lo convierte en el punto de entrada más asequible en esta comparación para la extracción basada en plantillas de documentos con el mismo formato.
FormX — Mejor para Extracción Preconfigurada en Plantillas Logísticas Comunes
Ideal para: Equipos de logística que procesan documentos que coinciden con la biblioteca de extractores preconfigurados de FormX — albaranes de embalaje, etiquetas de envío, facturas comerciales — y desean extracción sin entrenar sus propios modelos.
No recomendado para: Documentos logísticos personalizados fuera de la biblioteca de extractores de FormX, o documentos con mucho texto manuscrito — los extractores preconfigurados están diseñados para documentos estructurados impresos por máquina.
FormX ofrece extractores para tipos de documentos comunes, incluidos documentos de envío y albaranes de embalaje. La plataforma utiliza una combinación de modelos de IA preentrenados y coincidencia de plantillas, con una interfaz de usuario para revisar los datos extraídos. En nuestro conjunto de pruebas, los extractores de albaranes de embalaje y facturas comerciales de FormX tuvieron un rendimiento aceptable en documentos estándar impresos por máquina — descripciones de artículos, cantidades y totales se capturaron con precisión moderada.
La limitación se presentó en campos nativos de logística que no aparecen en las categorías estándar de "documentos de envío": códigos SCAC, desgloses por línea de detalle de códigos SA, números de precinto y términos de flete. Estos se omitieron o se devolvieron con formato inconsistente. La tolerancia al texto manuscrito fue poco notable — típica de herramientas entrenadas principalmente con conjuntos de datos impresos por máquina. Los precios se basan en el uso y requieren una cotización personalizada para la extracción de documentos de envío, lo que dificulta estimar los costos antes de iniciar una prueba.
Parseur: la mejor opción para la ingesta de documentos logísticos por correo electrónico
Ideal para: Coordinadores logísticos que reciben comprobantes de entrega, conocimientos de embarque y facturas de flete como archivos adjuntos de correo electrónico y desean extraerlos automáticamente a una hoja de cálculo o base de datos.
No es adecuado para: Documentos logísticos escaneados o fotografiados, comprobantes de entrega con muchas anotaciones manuscritas o lotes de transportistas con múltiples formatos: la capa de OCR de Parseur es básica y su enfoque basado en plantillas y zonas no se adapta a las variaciones de diseño.
Parseur destaca en un flujo de trabajo logístico específico: la ingesta de documentos que llegan por correo electrónico. Un coordinador logístico que reenvía comprobantes de entrega de conductores a una cola de procesamiento, o un agente de carga que recibe facturas de transportistas como archivos adjuntos de varios proveedores, puede configurar Parseur para detectar documentos entrantes, extraer los campos definidos y enviar los datos estructurados a una hoja de Google o a un punto final de API.
La limitación es que el análisis de documentos de Parseur se basa fundamentalmente en plantillas: se definen zonas y reglas por remitente o formato de documento. Para un equipo logístico que recibe la misma plantilla de factura de FedEx del mismo correo electrónico del remitente todos los días, esto funciona de manera confiable. Para un agente de carga que recibe PDF de conocimientos de embarque de 15 transportistas diferentes, cada uno con su propio formato, el requisito de una plantilla por transportista crea la misma carga de mantenimiento que Docparser. La calidad del OCR en documentos escaneados y el reconocimiento de escritura a mano son básicos, lo que hace que Parseur sea una mala opción para los flujos de trabajo de notas de entrega y comprobantes de entrega que dominan el volumen de documentos logísticos. Los precios comienzan en $39 por mes para 20 documentos procesados, y aumentan a $117 y $299 por mes para volúmenes más altos.
¿Qué herramienta de extracción de documentos logísticos es la adecuada para su operación?
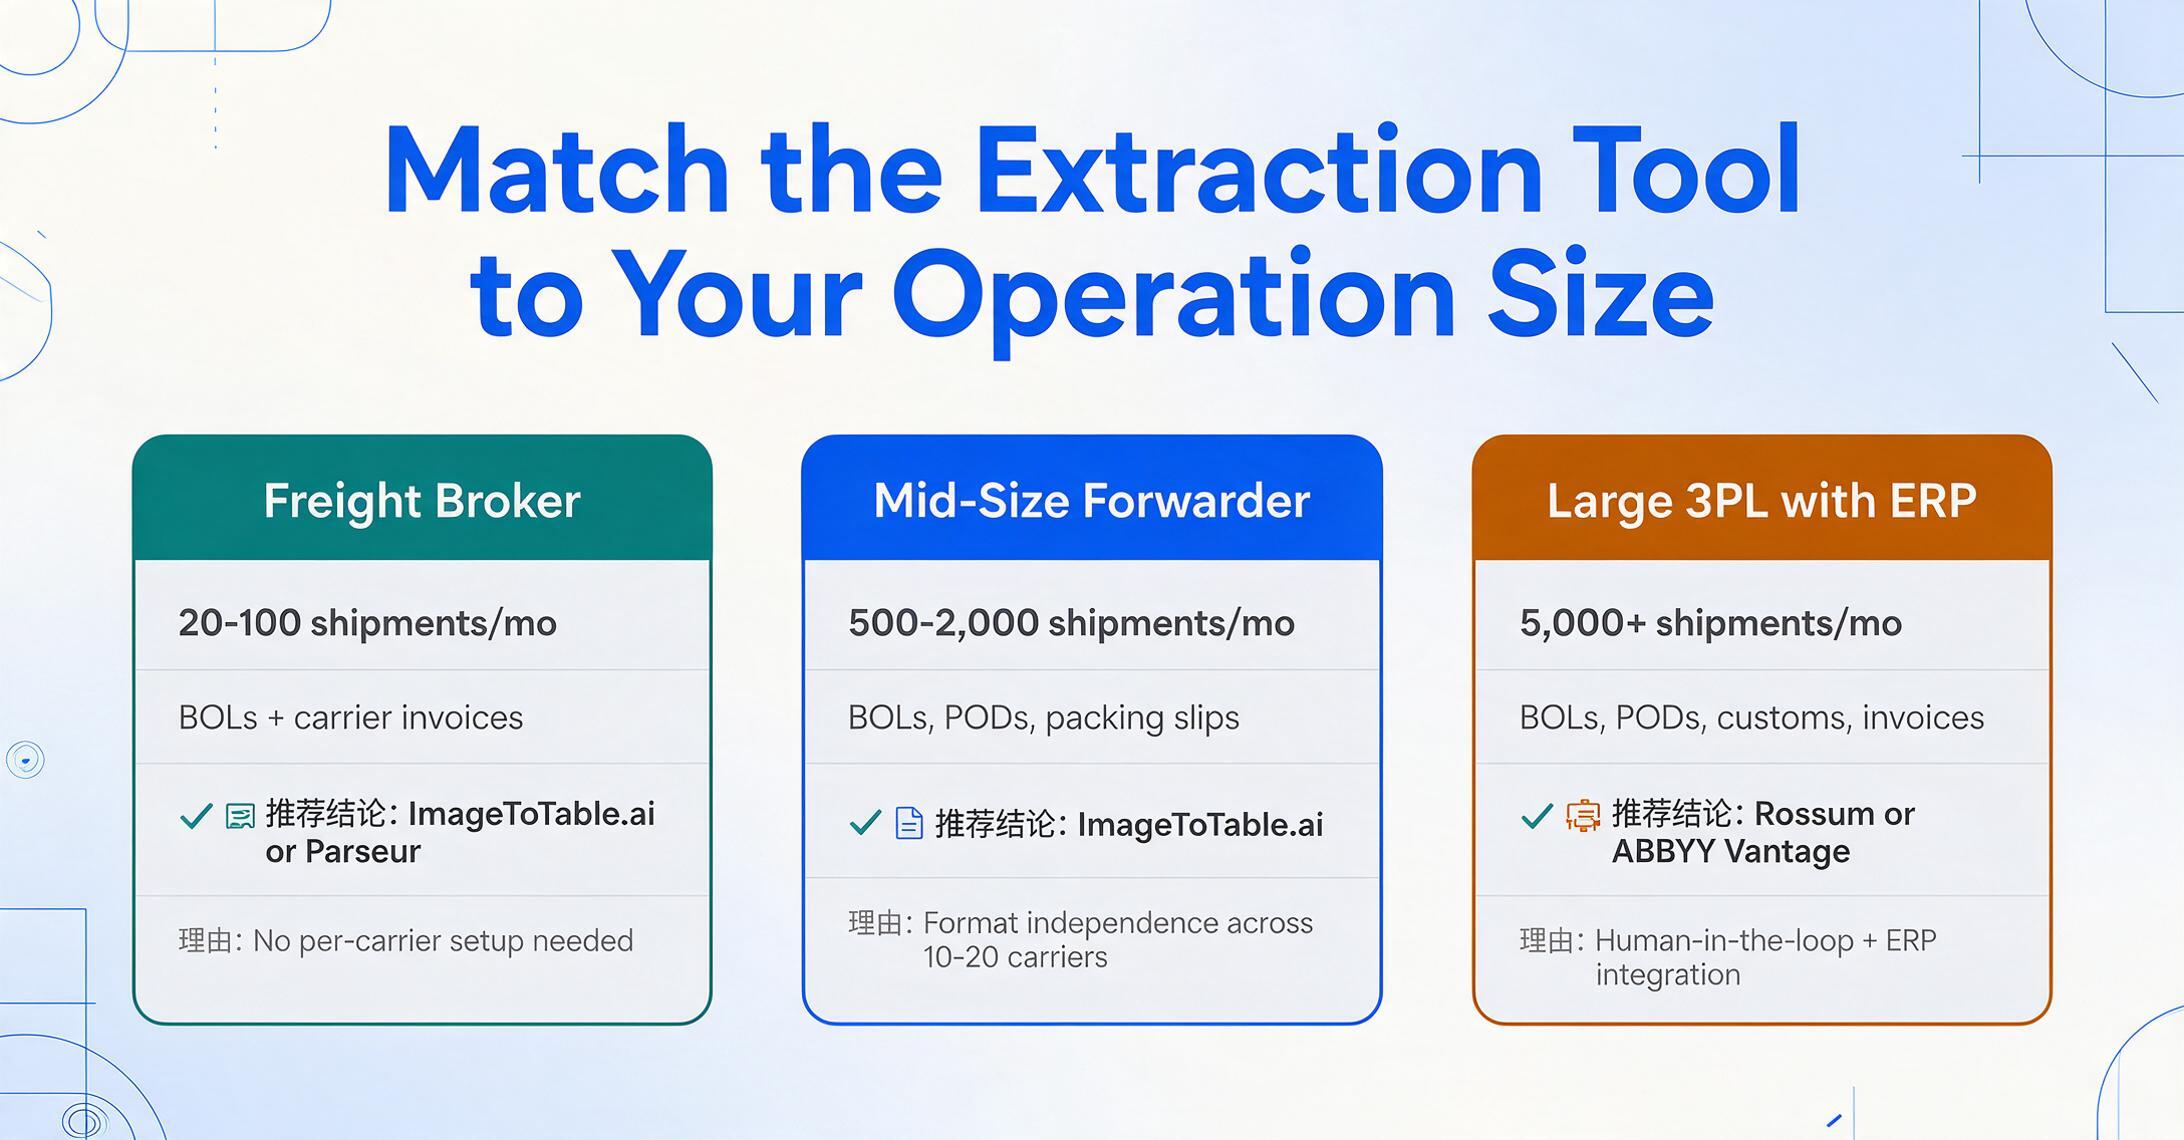
Las operaciones logísticas varían enormemente en escala, combinación de tipos de documentos y capacidad técnica. La herramienta que funciona para un agente de carga independiente que maneja 50 envíos al mes es diferente de la que necesita un 3PL global con 50,000 envíos mensuales. A continuación, le mostramos cómo elegir la opción adecuada para su operación:
| Su escenario | Combinación de documentos | Herramienta recomendada | Motivo |
|---|---|---|---|
| Corredor de flete independiente, 20-100 envíos/mes | Conocimientos de embarque + facturas de transportista, principalmente por correo electrónico | ImageToTable.ai o Parseur | Bajo costo, sin configuración con el transportista; Parseur si todo llega por correo en formato consistente |
| Agente de carga mediano, 500-2,000 envíos/mes | Conocimientos de embarque (marítimos + aéreos), comprobantes de entrega, albaranes de embalaje, facturas de flete, documentos de aduanas | ImageToTable.ai | Independencia del formato en 10-20 transportistas; tolerancia a la escritura manual en comprobantes de entrega; sin carga de plantillas por transportista |
| 3PL grande, 5,000+ envíos/mes con integración ERP | Gama completa: conocimientos de embarque, comprobantes de entrega, declaraciones de aduanas, facturas de flete, listas de embalaje, notas de entrega | Rossum o ABBYY Vantage | Flujo de trabajo empresarial, supervisión humana, integración ERP; un presupuesto mayor respalda el precio |
| Correduría de aduanas, declaraciones de aduanas de alto volumen | Documentos de entrada, declaraciones de código SA, certificados de origen, facturas comerciales | ImageToTable.ai o Rossum | Necesita extracción de código SA + consistencia de datos entre documentos: conocimiento de embarque, lista de embalaje y factura |
| Equipo de desarrollo interno que crea automatización logística personalizada | Procesamiento de conocimientos de embarque y facturas mediante API | Amazon Textract o Nanonets | Diseño API-first, control total del flujo, puede entrenar modelos personalizados por formato de transportista |
| Procesamiento de facturas de transportista con formato uniforme | Solo facturas de flete estándar de FedEx/UPS | Docparser | Opción más económica para facturas con plantilla consistente, pero solo si el formato nunca cambia |
Los tres desafíos de extracción específicos de logística que la mayoría de los resúmenes pasan por alto
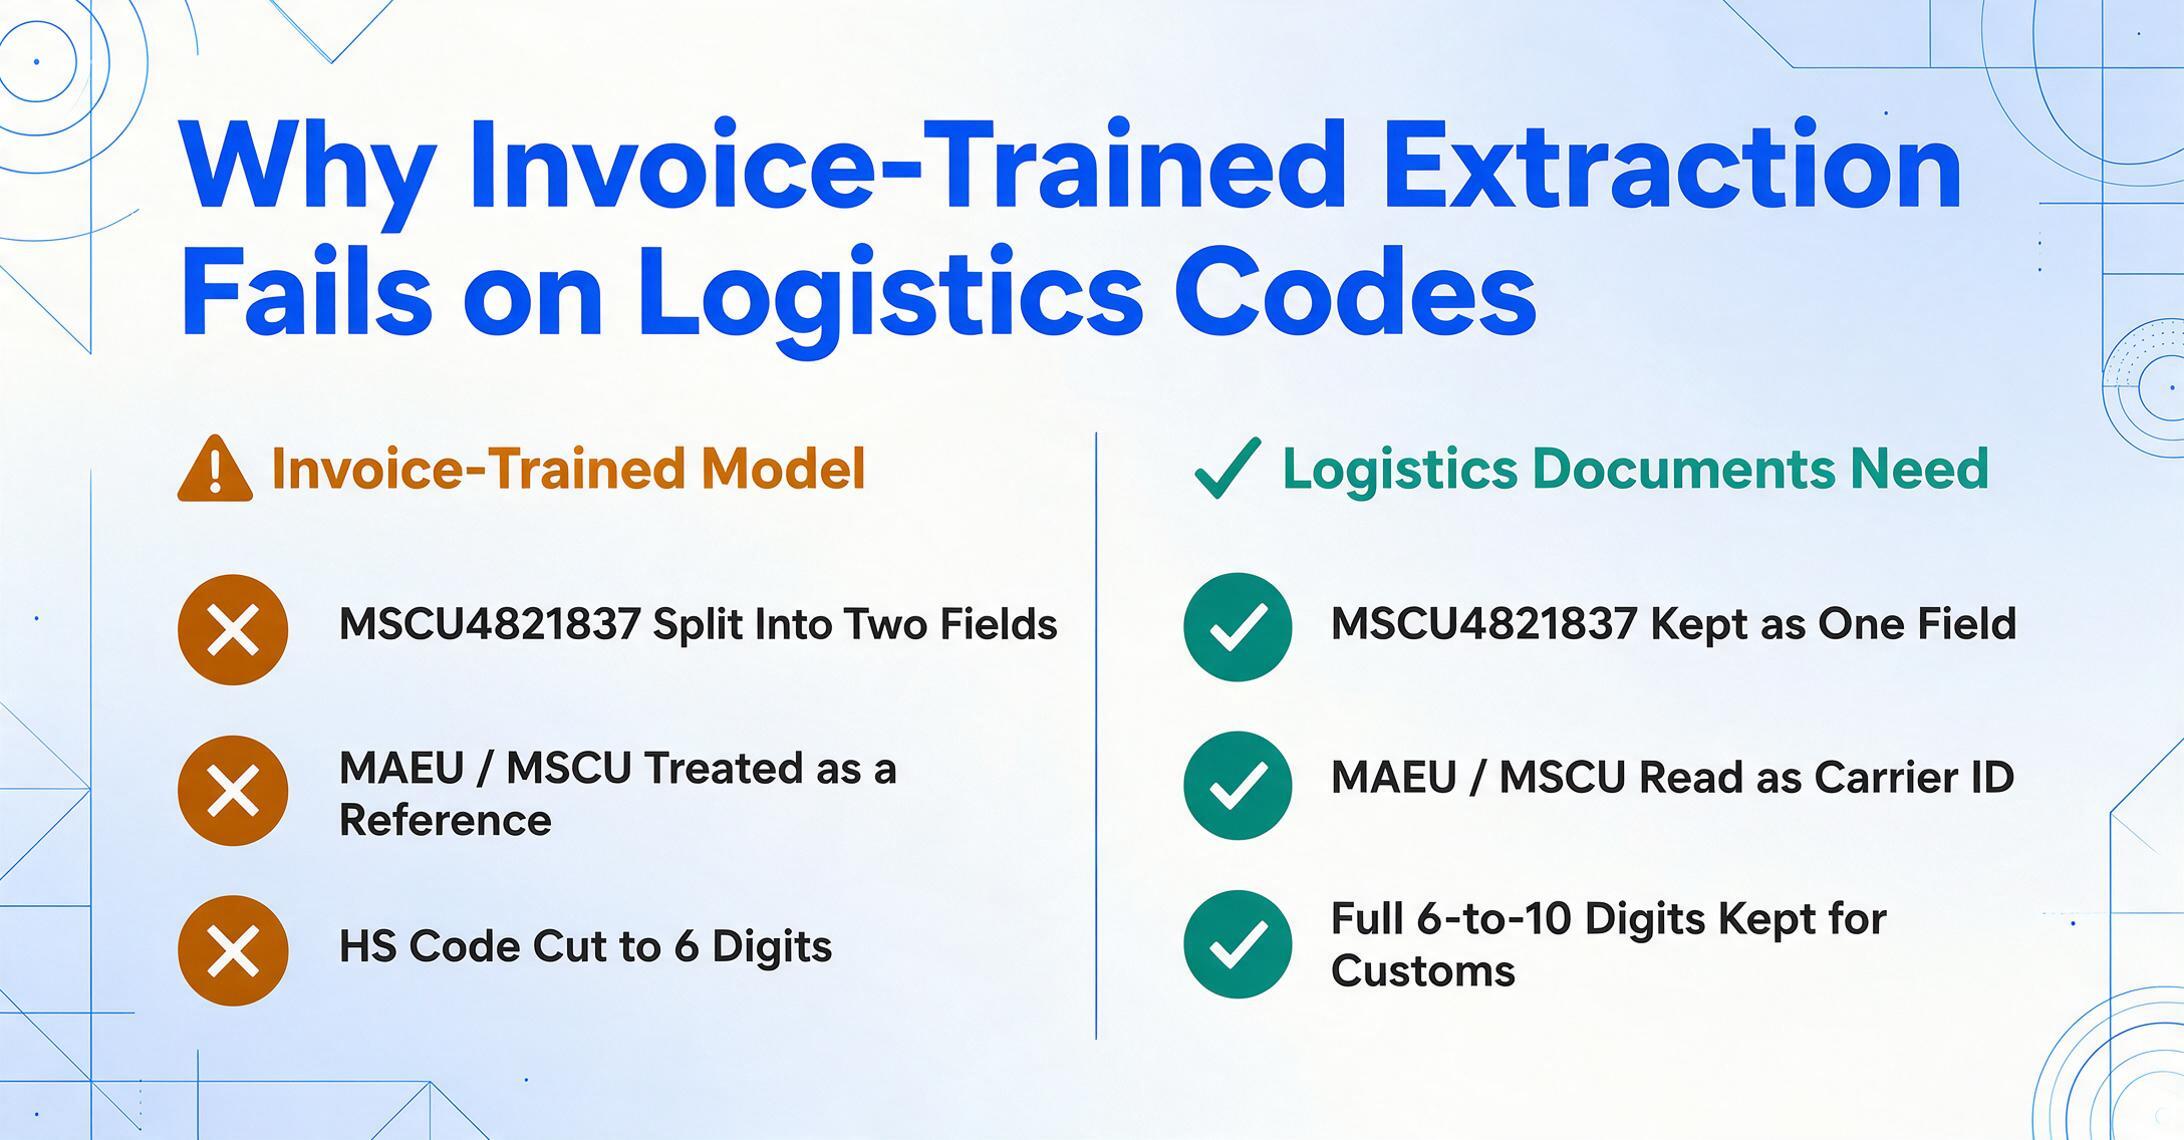
Según las pruebas realizadas en las nueve herramientas, surgieron tres patrones que el típico resumen de "mejor extracción de documentos" no aborda, pero que las operaciones logísticas encuentran a diario:
1. Los códigos específicos de logística no son campos de factura. Un número de contenedor (p. ej., MSCU4821837) sigue un formato de prefijo de 4 letras + 7 dígitos que la mayoría de las herramientas de extracción dividen en dos campos o clasifican erróneamente como número de referencia. El código SCAC — un identificador de transportista de 4 letras como "MAEU" (Maersk) o "MSCU" (MSC) — es un campo obligatorio para las declaraciones de aduanas (requisitos de CBP) que los modelos de extracción entrenados con facturas no reconocen como un dato distinto. La extracción del código SA requiere no solo leer el número, sino conservar la cadena completa de 6 a 10 dígitos, incluidos los sufijos específicos del país. Una herramienta que extrae los primeros seis dígitos y omite la extensión del país devuelve datos inutilizables para la declaración de aduanas. Muchas herramientas hacen esto.
2. La escritura a mano en los documentos logísticos no es contenido opcional — es datos operativos. Un conductor de reparto escribe "rechazadas 2 cajas" en la cara del comprobante de entrega. Un empleado de almacén anota manualmente el número de precinto cuando el contenedor llega con un precinto diferente al registrado en el conocimiento de embarque. Una corrección del consignatario se escribe en el margen de un conocimiento de embarque en origen. En r/logistics, un usuario describió la realidad de forma sucinta: "No se puede automatizar un desorden". En logística, el "desorden" suele ser datos escritos a mano que las herramientas de extracción de documentos no fueron entrenadas para leer, y se encuentra precisamente en los documentos — comprobantes de entrega, notas de entrega, conocimientos de embarque corregidos a mano — donde la precisión importa más, porque las disputas y los contracargos dependen de estos registros. Las herramientas que no manejan este contenido están automatizando solo el subconjunto más limpio y menos valioso de los documentos logísticos.
3. La independencia del formato no es una característica opcional en logística — es un requisito básico. Un agente de carga que procesa 500 conocimientos de embarque al mes de 15 transportistas marítimos, además de guías aéreas y notas de entrega de camiones, no puede mantener plantillas separadas para el formato de cada transportista y cada tipo de documento. El costo práctico del mantenimiento de plantillas — el tiempo dedicado a notar que la extracción falló, diagnosticar qué transportista actualizó su diseño y reconstruir la plantilla — casi nunca se incluye en los precios o comparaciones de los proveedores. Las herramientas basadas en plantillas (Docparser, Parseur) parecen más económicas sobre el papel, pero su costo total incluye las horas de trabajo dedicadas al mantenimiento de plantillas, que una herramienta independiente del formato elimina.
Preguntas frecuentes: Extracción de documentos logísticos
¿Cuál es la diferencia entre un conocimiento de embarque nominativo, uno a la orden y uno multimodal para fines de extracción?
Un conocimiento de embarque nominativo (original) es un documento no negociable emitido a un consignatario designado: contiene campos estándar (embarcador, consignatario, buque, puertos, descripción de la carga, número de contenedor) en un formato típico de una o dos páginas. Un conocimiento de embarque a la orden (negociable) se emite «a la orden» y puede transferirse: funciona de manera similar para la extracción, pero puede incluir un campo adicional de «parte notificada» y espacios en blanco para endosos. Un conocimiento de embarque multimodal cubre el transporte marítimo e interior: añade campos de lugar de recepción, lugar de entrega y transporte previo/posterior que las herramientas de extracción suelen omitir porque esperan solo campos de puerto a puerto. El estándar FIATA eFBL (FBL electrónico) es un esfuerzo por estandarizar los datos del conocimiento de embarque multimodal, aunque su adopción es gradual.
¿Puedo procesar conocimientos de embarque máster e hijo en el mismo lote?
Sí, si su herramienta de extracción lee los documentos de forma semántica y no mediante plantillas. Un conocimiento de embarque máster (MBL) lo emite la naviera al agente de carga. Un conocimiento de embarque hijo (HBL) lo emite el agente al embarcador. Tienen aspecto diferente — distintos encabezados, distintas etiquetas de campo, distinta estructura de diseño — pero contienen información superpuesta (nombre del buque, puertos, número de contenedor, descripción de la carga). Una herramienta de extracción semántica que reconoce «Buque» como concepto lo encontrará en ambos, independientemente del diseño visual. Una herramienta basada en plantillas requiere dos plantillas separadas.
¿Cómo afecta el cumplimiento de SOLAS VGM a la extracción de datos del conocimiento de embarque?
Desde julio de 2016, las regulaciones SOLAS de la Organización Marítima Internacional (OMI) exigen una masa bruta verificada (VGM) para cada contenedor lleno antes de que pueda cargarse en un buque. La VGM — compuesta por la tara del contenedor más el peso de la carga — debe constar en el conocimiento de embarque o transmitirse por separado a la naviera y a la terminal. Al extraer datos del conocimiento de embarque, el valor de la VGM y su método de verificación (Método 1: pesar el contenedor lleno; Método 2: pesar toda la carga y sumar la tara) deben capturarse como campos separados. La mayoría de las herramientas de extracción no distinguen la VGM del campo estándar de «peso bruto», y ambos valores pueden diferir en cientos de kilogramos, lo que genera un riesgo de cumplimiento si el valor incorrecto se introduce en una declaración aduanera o de terminal.
¿Pueden estas herramientas extraer términos de flete (FOB, CIF, FCA) de los conocimientos de embarque?
Solo las herramientas con comprensión semántica — donde usted define "Términos de Flete" como nombre de columna y la IA localiza el término en el documento — capturan consistentemente los términos de flete. Bajo Incoterms 2020, FOB (Free On Board) y CIF (Cost, Insurance, and Freight) aplican solo a flete marítimo, mientras que FCA (Free Carrier), CIP (Carriage and Insurance Paid To) y DAP (Delivered at Place) cubren todos los modos. En un conocimiento de embarque, los términos de flete pueden aparecer en el bloque de descripción, como código independiente, o integrados en una línea de tarifa de flete. Las herramientas basadas en plantillas que buscan "FOB" en una posición fija lo pierden cuando el transportista coloca los términos en otro lugar. La extracción semántica lo encuentra independientemente de la posición porque entiende qué es un término de flete y busca el concepto, no la coordenada.
¿Cómo afecta la Orden Ejecutiva de CBP de junio de 2026 sobre cumplimiento aduanero las necesidades de extracción de documentos?
La Orden Ejecutiva de la Casa Blanca sobre el Fortalecimiento del Cumplimiento Aduanero (3 de junio de 2026) dirige una revisión integral de los requisitos de documentación de importación de EE. UU. Los Importadores registrados (IOR) enfrentan nuevos requisitos, incluido proporcionar a CBP cualquier documentación de exportación presentada ante autoridades aduaneras extranjeras antes de la llegada de las mercancías a EE. UU. — una expansión notable del alcance documental. La orden también exige una verificación mejorada para agentes aduanales, transitarios e IOR, con requisitos más estrictos de fianza y disponibilidad de registros según 19 USC 1508 y 19 CFR Parte 163. Para los equipos logísticos, esto significa que los documentos que alimentan las declaraciones aduaneras — conocimientos de embarque, facturas comerciales, listas de empaque — deben procesarse con mayor precisión y completitud, y el flujo de extracción debe capturar campos que respalden los nuevos requisitos de cumplimiento (p. ej., números de referencia de exportación extranjera, mayor precisión del código SA).
¿Qué pasa con el volumen de documentos logísticos? ¿Pueden las herramientas de extracción manejar miles de BOL al mes?
Sí, la mayoría de las herramientas en esta comparativa pueden escalar a volúmenes altos, pero el cuello de botella pasa de la velocidad de extracción a la validación de resultados. Con 5,000 BOL al mes, una tasa de precisión a nivel de campo del 95 % significa 250 documentos al mes con al menos un campo que requiere corrección manual. La pregunta operativa no es «¿puede la herramienta extraer 5,000 BOL?», sino «¿puede usted revisar 250 excepciones marcadas sin contratar a una persona dedicada al control de calidad?». Rossum y Docsumo ofrecen colas integradas de revisión humana. ImageToTable.ai se basa en el marcado por confianza, donde los campos con baja confianza se resaltan para revisión. Para operaciones logísticas con alta carga de validación, donde el número de contenedor de cada BOL alimenta directamente una declaración ante la CBP, la gestión integrada de excepciones es una función que merece prioridad por encima de la velocidad de extracción.
¿Puedo extraer número de contenedor, número de precinto y código SA en una sola pasada a partir de tipos de documentos mixtos?
Sí, si utiliza una herramienta que admita la Extracción de Columnas Personalizadas entre tipos de documentos. Defina sus columnas de salida (número de contenedor, número de precinto, código SA, código SCAC, etc.) una sola vez. Cargue un lote que contenga conocimientos de embarque marítimo, albaranes de embalaje y facturas de flete. La IA lee cada tipo de documento de forma independiente y completa las columnas donde existen datos coincidentes. Los números de contenedor provienen de los BOL y los albaranes de embalaje. Los códigos SA, de las facturas comerciales y las declaraciones de aduanas. Los números de precinto, de los campos de precinto del BOL y de los informes de intercambio de contenedores. Los campos sin datos coincidentes en un documento determinado simplemente permanecen en blanco. Este enfoque compatible con lotes es estándar en herramientas como ImageToTable.ai y Rossum, pero no está disponible en los analizadores basados en plantillas o zonas que requieren un mapeo de campos por tipo de documento.
Para un análisis más profundo de cómo funciona la extracción de documentos específicamente para el procesamiento de conocimientos de embarque entre transportistas y tipos de BOL, consulte nuestra guía completa de extracción de BOL. Para flujos de trabajo de albaranes de embalaje y notas de entrega, consulte extracción de datos de albaranes de embalaje, y para flujos de trabajo de etiquetas de envío y manifiestos, consulte extracción de datos de etiquetas de envío y manifiestos a Excel. Si está evaluando si estas herramientas tienen sentido financiero para su operación de flete, compare los números con el costo oculto de la captura manual de datos en logística. Si su evaluación abarca el paquete completo de envío (BOL, facturas de flete, declaraciones de aduanas, listas de embalaje) en lugar de solo BOL, nuestra guía del comprador de extracción de documentos logísticos cubre los criterios de evaluación entre documentos. Para resúmenes de tipos de documentos relacionados, consulte las mejores herramientas gratuitas de extracción de documentos y la mejor extracción de documentos para construcción.
El flujo de trabajo del agente de carga se basa en 15 formatos de transportistas diferentes y una pila de comprobantes de entrega manuscritos. Si su herramienta actual maneja las facturas de FedEx pero necesita una plantilla separada para cada transportista marítimo, su automatización está incompleta.